ReAct 循环会推理,但推理不能凭空产生事实。模型训练截止后的产品文档、企业内部的接口约定、用户上传的 PDF,都不在参数记忆里。02 篇结尾说过一句话:工具是 Agent 的手,检索是 Agent 的书架。本篇拆开看这两样东西在 AgentScope Java 里的实现------@Tool 注解驱动的工具系统,三层 RAG 检索链路,MCP 三种传输,以及子 Agent 的两种声明方式。dream-scope 的知识与工具体系也在这篇完整亮相。
先看一条贯穿全文的主线:框架给能力,模块定边界。AgentScope 的 Toolkit、SimpleKnowledge、McpClientBuilder 都是框架侧的积木;dream-scope 要回答的是另一个问题------这些积木放在六边形架构的哪一层,谁组装它们,失败时按什么顺序降级。能力清单可以抄官方文档,边界取舍才是工程文章该写的。
一、工具系统:@Tool 注解驱动的函数调用
AgentScope v2 的工具体系围绕两个类型展开:@Tool 注解标在普通 Java 方法上,Toolkit 是注册中心。一个最小的工具长这样:
bash
public class WeatherTools {

    @Tool(name = "get_weather",
          description = "查询指定城市的天气,返回温度与天气状况")
    public String getWeather(
            @ToolParam(name = "city",
                       description = "城市名称,例如:深圳",
                       required = true)
            String city,
            @ToolParam(name = "unit",
                       description = "温度单位:celsius 或 fahrenheit",
                       required = false)
            String unit) {
        String u = (unit == null) ? "celsius" : unit;
        return "{\"city\":\"" + city + "\",\"temp\":26,\"condition\":\"多云\"}";
    }
}框架侧发生了三件事。第一,Toolkit.registerTool(new WeatherTools()) 反射扫描对象上所有 @Tool 方法,逐个登记。第二,方法签名加 @ToolParam 的描述被组装成 OpenAPI 风格的 JSON Schema,随每次推理发给模型------模型看到的不是 Java 方法,而是一份工具目录。第三,模型决定调用时,框架把 JSON 参数反序列化成方法入参并反射执行,返回值转回消息块进入下一轮推理。
@Tool 注解的属性值得过一遍,每个都对应一个运行期行为:
| 属性 | 默认 | 作用 |
|---|---|---|
| name | 为空时回退方法名 | 模型侧可见的工具标识 |
| description | 空 | 模型决定是否调用的首要依据 |
| strict | false | 强约束参数 JSON Schema |
| readOnly | false | 只读标记,权限与沙箱会参考 |
| concurrencySafe | true | 并发安全标记 |
| externalTool | false | 模型只生成调用,由外部系统执行 |
| stateInjected | false | 向工具注入 Agent 状态 |
有一个设计细节值得对照 Spring AI:AgentScope 强制每个 @ToolParam 写 name。原因是 Java 编译产物默认不含方法参数名,框架拿不到 city 还是 unit 这种信息;显式声明后,schema 生成不依赖 -parameters 编译参数,构建环境少一个隐性前提。工程上这属于"把不确定性消灭在注解里"的做法。
1.1 别把业务上下文交给模型
工具经常需要 userId、sessionId 这类调用上下文。常见的错误做法是让模型传------把 userId 写进工具参数,模型可能填错、可能被提示词注入诱导填别人的。AgentScope 的约定是:方法参数里不带 @ToolParam 的参数,框架按类型从 RuntimeContext 注入,模型全程看不到:
bash
public record UserContext(String tenantId, String userId) {}

@Tool(name = "list_my_orders", description = "查询当前用户的订单")
public String listOrders(UserContext ctx,
                         @ToolParam(name = "status", required = false) String status) {
    return query(ctx.tenantId(), ctx.userId(), status);
}
这个机制和 02 篇的 RuntimeContext 一脉相承:调用身份从 HTTP 层构建,穿过中间件,最终在工具执行点被消费。模型负责"做什么",业务上下文由框架注入,两条信道物理分开。
1.2 异步返回与工具组
工具方法可以直接返回 Mono<String>,框架自动适配,配合 Schedulers.boundedElastic() 把阻塞查询挪出事件循环。对无法改造的阻塞工具,HarnessAgent 还提供异步 offload,把执行丢到独立调度器。
工具数量上来之后,AgentScope 提供 ToolGroup:把一批工具打包成组,默认不激活,再注册一个 meta tool 让模型按需"装备/卸载"工具组。价值在于上下文预算------几十个工具的 schema 全量常驻,每次推理都占 token;按组激活让模型只在需要时看到那批目录。
二、dream-scope 的工具面:三个演示工具与一个检索工具
框架能力看完,回到项目。dream-scope 的 chat 工具集中在一个纯 POJO 类 ChatTools,无 Spring 依赖,由 Toolkit 扫描注册:
bash
@Tool(name = "getCurrentTime", description = "返回服务器当前日期时间(含时区偏移)")
public String getCurrentTime() {
    return OffsetDateTime.now().toString();
}

@Tool(name = "calculate", description = "计算四则运算表达式,支持括号与小数,例如 1+2*3")
public String calculate(
        @ToolParam(name = "expression", description = "数学表达式,仅允许数字、小数点、+ - * / 与括号", required = true)
        String expression) { ... }

@Tool(name = "httpGet", description = "对 http/https URL 发起 GET,返回响应体前 N 个字符")
public String httpGet(...) { ... }
三个工具都是演示位:时间、计算、HTTP GET。真正的主角是第四个------retrieve:
bash
@Tool(name = "retrieve", description = "从知识库检索带编号的参考资料。回答产品、架构或调用方式时先调用,再按 [1][2] 引用")
public String retrieve(
        @ToolParam(name = "query", description = "检索问句,尽量包含专有名词", required = true)
        String query,
        @ToolParam(name = "topK", description = "返回条数,默认 3,上限 8", required = false)
        Integer topK) {
    if (retrievePort == null) {
        return "知识库未配置";
    }
    int limit = topK == null || topK <= 0 ? DEFAULT_TOP_K : Math.min(topK, HARD_MAX_TOP_K);
    var hits = retrievePort.retrieve(query, limit);
    return RetrieveCitations.format(hits);
}
三个细节:
- description 写的是使用时机,不是功能罗列。"回答产品、架构或调用方式时先调用,再按 12 引用"------前半句给模型的触发条件,后半句直接规定引用格式。工具描述是模型路由工具的依据,把使用规范写进描述,比指望系统提示词约束更近。
- topK 有硬上限。模型传 100 也只取 8,防御性钳制在工具边界完成,不信任模型输出。
- retrievePort 为 null 时返回提示语而不是抛异常。知识库未配置是合法运行态(本地无 Key 演示),不是错误。
片段出处:dream-scope-adapter/src/main/java/com/zhu/scope/adapter/tool/ChatTools.java
权限方面呼应 02 篇:chat 主路径 PermissionMode.BYPASS,文件与 Shell 工具关闭,工具面收敛到这四个演示工具加 MCP 挂载。工具越少,模型路由越稳,这是刻意的减法。
三、三层 RAG:一条跨模块的检索链路
retrieve 工具背后的 retrievePort 是整条 RAG 链路的门面,但它只是接口。实现分布在三个模块,各管一段:
bash
HTTP / ChatTools.retrieve
  → RetrievePort(再包 Hybrid + Advanced)
    → SimpleKnowledgeRetrievePort        ← adapter 模块
      → SimpleKnowledge(embed + search)
→ InMemoryStore 或 PgVectorStore ← 向量库二选一| 层 | 类 | 职责 |
|---|---|---|
| adapter | SimpleKnowledgeRetrievePort | 适配官方 SimpleKnowledge,管 embed、入库、切块、向量检索 |
| knowledge | HybridRetrievePort | 向量与关键词双路召回,RRF 融合 |
| knowledge | AdvancedRetrievePort | 叠加问句改写与精排,失败退回内层 |
| web | RagPortsConfig | 组合根:按配置装配唯一 RetrievePort Bean |
分层的依据是依赖方向。adapter 里的类才允许 import io.agentscope(六边形边界,01 篇的 enforcer 在构建期强制);knowledge 模块定义自己的 RetrievePort 接口,写 RRF 融合时看不到 AgentScope 的任何类型;web 的 RagPortsConfig 是组合根,决定生产环境用哪条实现链。检索逻辑因此可以脱离框架单测------给 HybridRetrievePort 注入假端口,RRF 融合的正确性不依赖任何向量库。
3.1 adapter 层:SimpleKnowledgeRetrievePort
这一层做的是"官方组件的工程化包装"。SimpleKnowledge 是 AgentScope 官方的知识抽象,管 embed 和相似度检索;适配器补齐生产要用的部分:
- 向量库二选一 :不传 store 按 embedding 维度建 InMemoryStore(单测、无 PG 的本地演示);传配置则建官方 PgVectorStore,
build()自动 CREATE EXTENSION vector 并建表; - 文件入库分批:大 PDF 整本一次 embed 容易超时,按每批 8 块写入,进度经 ThreadLocal 回调上报(reading / embedding 两个阶段);
- 稳定 id 与来源索引:AgentScope Reader 自带的块 id 不可靠,入库前统一盖自有 docId,payload 写入 source 与 docType------按来源列表、按来源覆盖删除、重启后从 pg 重建索引,都靠这套约定;
- 失败时保正文:embedding 失败抛 EmbeddingIngestException,把已经从 PDF 抽出的正文带上------额度不足时整份文档的解析成果不白费,上层拿正文降级写关键词索引。
切片参数也在这层生效:chunkSize 2000、chunkOverlap 200(配置项 dream-scope.rag.*),只影响文件入库,addText 整段一块不切。
3.2 knowledge 层:HybridRetrievePort 的 RRF 融合
纯向量检索的短板很老:专有名词、型号、代号这类强字面信号,embedding 不一定拉开距离。HybridRetrievePort 的答案是双路召回 + RRF(Reciprocal Rank Fusion):
bash
int fetch = Math.min(topK * 3, Math.max(topK, 32));
List<RetrieveHit> vector = safeRetrieve(primary, query, fetch, source);
List<RetrieveHit> kw = safeRetrieve(keyword, query, fetch, source);
每路多取(约 3 倍候选),RRF 用排名倒数融合,常数 K 取 60------行业里验证过的默认值,让两路的排名平滑互补而不是互相碾压。双路不是摆设,降级逻辑内建在检索流程里:向量这条路空了就用关键词结果,关键词空了就用向量结果,两路全空才返回空。
关键词索引是进程内的 InMemoryKeywordIndex,由 Hybrid 自己维护:向量检索成功后把返回正文镜像进关键词索引;embedding 失败则只写关键词。向量端口不反向持有索引,写权集中在 Hybrid 一处,不会出现两处各写一半的状态。
3.3 knowledge 层:AdvancedRetrievePort 的改写与精排
Hybrid 之上还可以再包一层 AdvancedRetrievePort,叠加两个可选增强:
- 问句改写(DashScopeQueryRewritePort):用便宜的小模型(默认 qwen-turbo)把口语问句扩成检索友好的表述。口语和文档用词经常对不上------"怎么部署"扩成"部署 安装 启动 配置",召回率立刻不同;
- 精排(DashScopeRerankPort):召回负责"别漏",精排负责"排对"。粗排出 top 24,精排模型逐对打分重排,取前 topK。默认模型 gte-rerank-v2,配置默认开启。
两步都遵循同一条纪律:失败退回内层结果。改写服务挂了用原句检索,精排挂了用粗排顺序------增强能力必须表现为增益而不是单点故障。这也解释了配置里 rewrite 默认关、rerank 默认开的取舍:改写收益依赖问句风格,精排收益对文档问答几乎稳定,默认值按风险不对称来定。
四、组合根与降级链:provider 四档
RagPortsConfig 是 web 模块的组合根,决定生产环境检索栈的形态。核心是一个 provider 配置(dream-scope.rag.provider),四档语义:
| provider | 行为 |
|---|---|
| auto(默认) | 有 jdbc + embedding Key → pg;仅 Key → 内存向量;否则或失败 → 关键词 |
| pg / pgvector | 强制 pg,缺 jdbc 或 Key 直接抛错,不静默降级 |
| simple | 强制内存向量,缺 Key 抛错 |
| keyword | 进程内关键词,不调 embedding |
auto 档的降级链值得展开:pg 失败 → 试内存向量 → 再失败 → 关键词。每一档成功后都过 enhance,按开关挂精排与改写。运行期的 embedding 额度类错误(如免费额度用尽)走另一条路:关闭半开的向量端口,切换到关键词索引,检索继续可用------用户搜到的是关键词命中,而不是一条 500。
降级不是无脑兜底。显式指定 pg 却缺配置时直接抛错不启动------配置写明了意图,静默降级反而掩盖问题;只有 auto 档才允许悄悄往下走。自动降级是给"没表态"的容错,显式配置要的是"说到做到",两种语义分开处理。
还有一个重启恢复的细节:sourceIds(来源 → 块 id 索引)在内存里,进程重启即空。组合根启动时检查 pg 表,有数据则从 payload 重建 source 索引、镜像关键词,列表/删除/混合检索照常可用;表为空才灌演示语料,避免重复 upsert。
检索链路整体如下: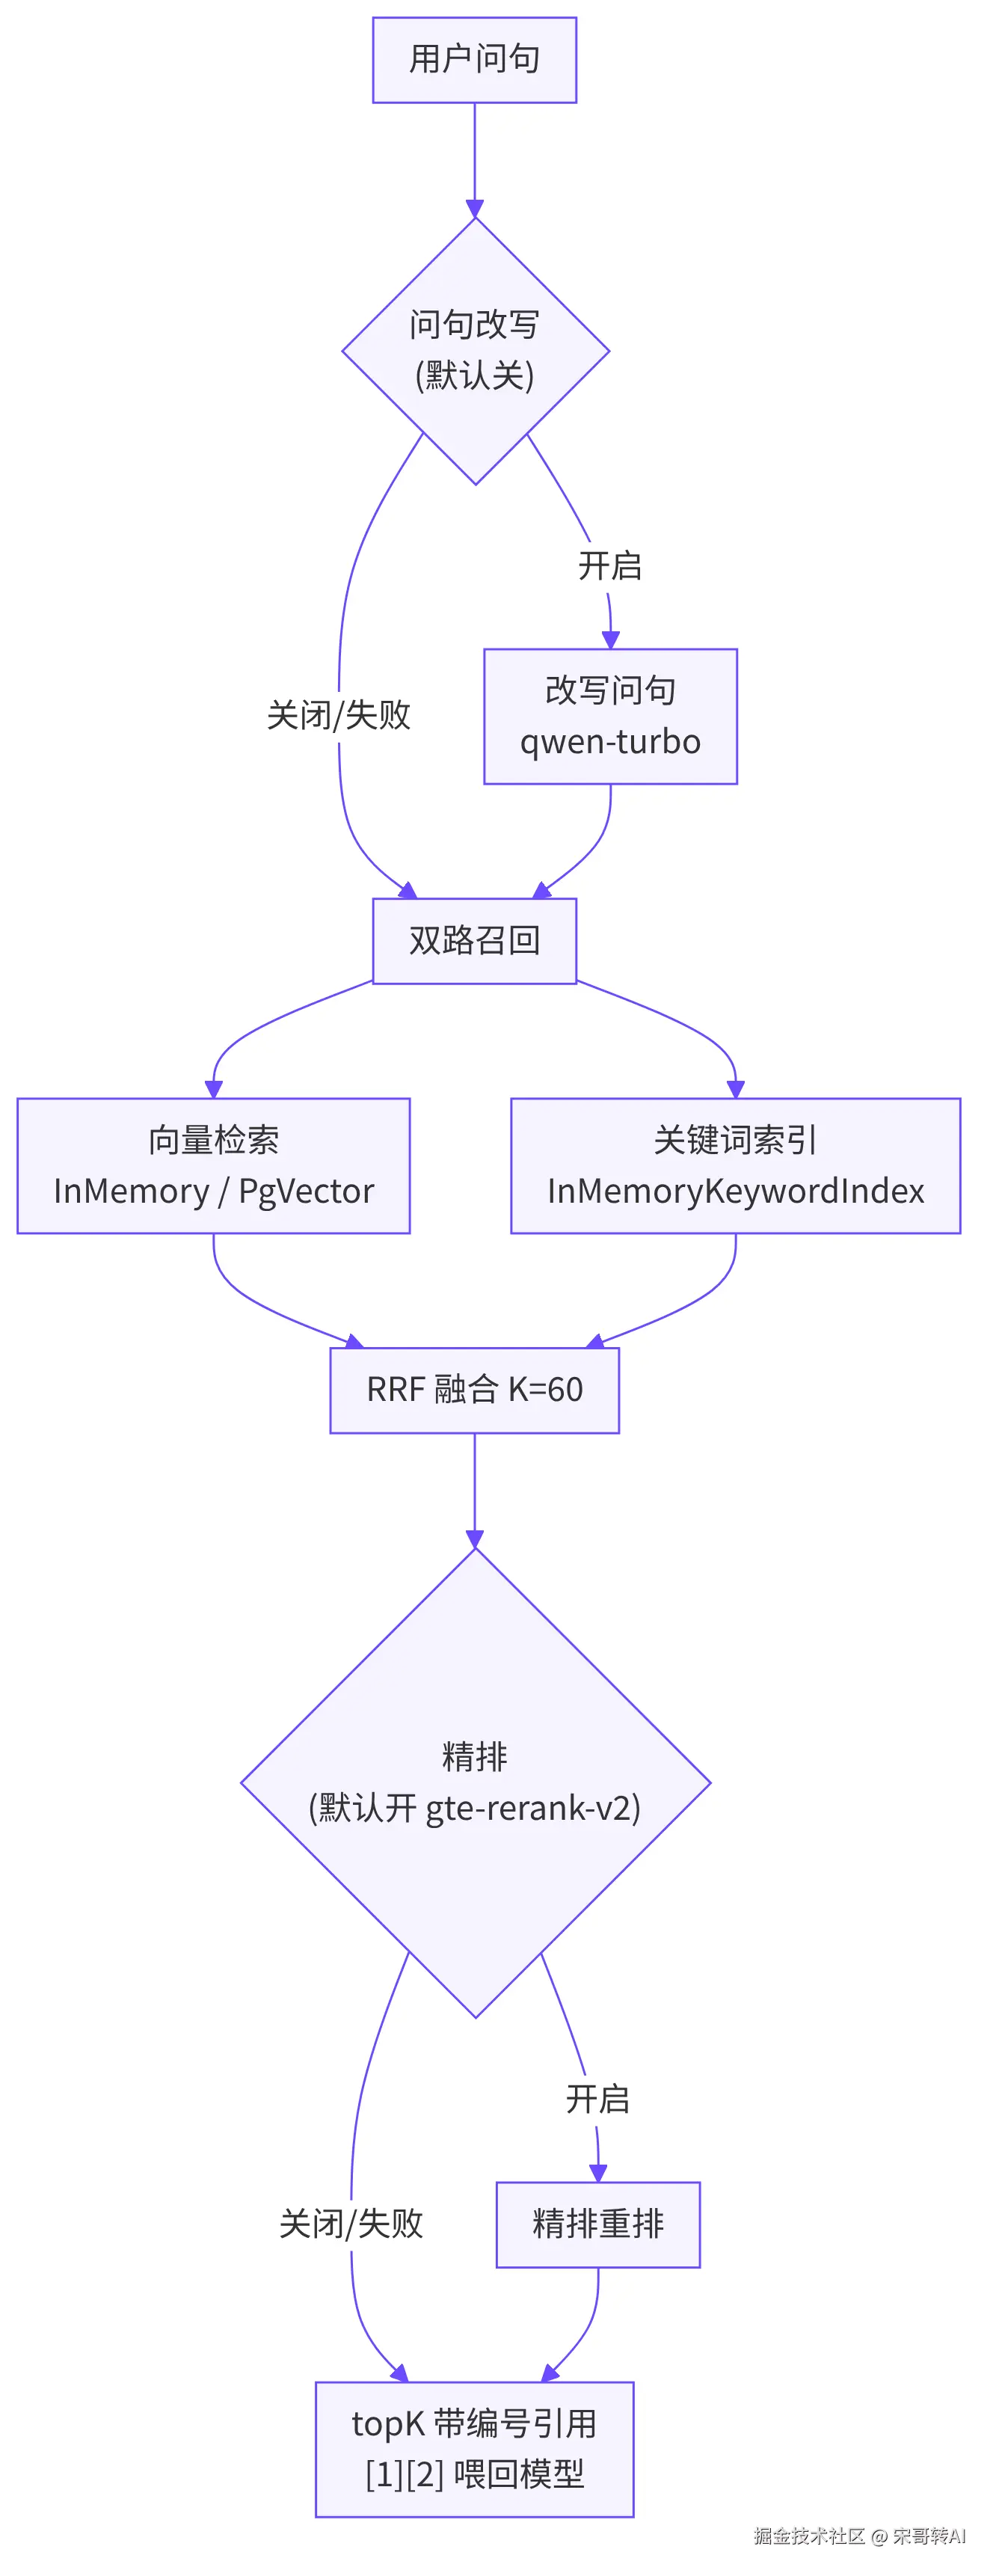
片段出处:dream-scope-web/src/main/java/com/zhu/scope/web/config/RagPortsConfig.java
五、刻意不挂 knowledge():单通道检索的取舍
框架其实内置了一条更"自动"的路:ReActAgent.knowledge() 把知识源挂到 Agent 上,每轮推理前自动检索注入(旧版 GenericRAGHook,已标 @Deprecated)。dream-scope 刻意不用,原因写在两处源码注释里:避免与 retrieve 工具各搜一次、引用两套。
双通道的实际问题不是"多花一次检索",而是一致性:自动注入走一套检索配置,工具调用走另一套,同一轮里模型可能看到两份来源不同、格式不同的资料,引用出处无法归一。收敛成单通道后,检索只发生在 retrieve 工具里,配置、降级、引用格式只有一份,模型看到的资料永远带着 12 编号。
这条取舍顺带回答了"Agentic RAG 还是 Application RAG":AgentScope 官方也在文档里把工具化检索列为推荐形态------RAG 退化为普通工具调用后,权限、压缩、子 Agent 隔离这些机制全部免费复用,框架不需要为检索单开一条隐式注入路径。
5.1 knowledge Agent:只检索,不调模型
单通道之外,dream-scope 还内置了一个特殊的 Agent:id 为 knowledge 的 ScopeKnowledgeAgent。它不走模型,handle 方法就是一次检索:
bash
@Override
public AgentInvokeResult handle(AgentInvokeRequest request) {
    String query = request == null ? "" : request.input();
    var hits = retrievePort.retrieve(query, DEFAULT_TOP_K);   // topK 5
    String formatted = RetrieveCitations.format(hits);
    return new AgentInvokeResult(id(), formatted);
}
它实现的是与 chat Agent 同一个 StreamingAgentHandler 接口,HTTP 侧看来两者无异------请求进、事件出。差别在于没有模型调用:不推理、不消耗 token,检索 top 5 直接返回带编号结果。定位是给前端或调用方一个纯检索出口:搜索页面、调试知识库内容、给第三方系统供数,都不该为此烧一次 LLM。它与 chat 工具共用同一个 RetrievePort Bean,检索口径完全一致。
片段出处:dream-scope-adapter/src/main/java/com/zhu/scope/adapter/ScopeKnowledgeAgent.java
六、MCP:三传输与运行态收敛
工具的第二来源是 MCP(Model Context Protocol)------把外部 MCP Server 的工具挂进 Toolkit。AgentScope 在 core 内置了 MCP 客户端,McpClientBuilder 提供三种传输:
| 传输 | 方法 | 场景 |
|---|---|---|
| stdio | stdioTransport(command, args...) |
本地拉起子进程(npx filesystem 等) |
| SSE | sseTransport(url) |
旧版远端服务 |
| Streamable HTTP | streamableHttpTransport(url) |
新版远端服务,主流方向 |
接入只要两步:builder 建连拿到 McpClientWrapper,Toolkit.registerMcpClient 注册全部工具:
bash
McpClientWrapper mcp = McpClientBuilder.create("demo")
        .streamableHttpTransport("http://127.0.0.1:8093/mcp")
        .timeout(Duration.ofSeconds(30))
        .buildAsync()
        .block();                                  // 异步建连,block 等握手完成

toolkit.registerMcpClient(mcp).block();            // 拉取工具 schema 并注册
之后 MCP 工具与本地 @Tool 在模型侧无差别。生命周期上 McpClientWrapper 持有连接与子进程,应用关闭时逐个 close------dream-scope 的 ChatMcp.closeQuietly 按打开的逆序回收,失败不掩盖主异常。
6.1 web 为什么拒绝 stdio
框架三传输都支持,dream-scope 的 web 模块却在运行态把 stdio 拒了。写 tools.json 时直接抛错:
bash
if ("stdio".equals(normalized)) {
    throw new IllegalArgumentException("mcp stdio transport is not allowed");
}
理由是部署形态。stdio 传输要在宿主机上拉起子进程,适合开发者本机;web 模块的目标环境是容器与服务器,npx 拉子进程意味着镜像里要预装 Node、子进程逃逸出 JVM 的资源管理、故障排查多一层进程树。运行态只留 sse 与 streamableHttp 两种 HTTP 传输,工具来源全部走网络,边界干净。
值得注意的是拒绝的位置:不是在 MCP 建连时才报错,而是启动装配写 tools.json 时就抛------配置错误在启动期暴露,不带病运行。这与 02 篇"条件分支只出现在装配点"的取舍同源。
片段出处:dream-scope-web/src/main/java/com/zhu/scope/web/util/WorkspaceSubagentSeed.java
6.2 工具名用服务端原名
dream-scope 自带一个演示 MCP Server(DemoMcpServer,随 web 端口起在 8093),提供一个 echo 工具。模型看到的工具名是 mcp__demo__echo------这不是框架加的前缀,而是服务端公布的原名,AgentScope 原样注册。
这个细节的工程含义:工具名冲突的治理责任在服务端命名,客户端不做二次加工。多 Server 挂载时各自的名字空间靠服务端自己保证,模型侧看到的目录与 MCP 协议层完全一致,排查问题时不用在"框架改名"和"服务端起名"之间来回对。
七、Subagent:两路径声明与委派工具
第三个能力是子 Agent。AgentScope 的 Subagent 体系解决三件事:上下文隔离(子任务的过程内容不污染主上下文)、专职化(独立提示词与工具面)、后台并行。声明方式有两条路径:
编程式:builder 里直接构造 SubagentDeclaration。dream-scope 只放了一个 summarizer:
bash
static SubagentDeclaration summarizer() {
    return SubagentDeclaration.builder()
            .name(SUMMARIZER_ID)
            .description("把用户给出的文本缩成不超过三句的中文摘要。")
            .inlineAgentsBody("你是摘要子 Agent。禁止调用任何工具。只输出摘要正文,不要标题或前缀。")
            .maxIters(4)
            .build();
}
声明式 :在 workspace 的 subagents/ 目录写 Markdown,文件名即 agent_id。weather-agent 与 flight-agent 两个演示子 Agent 就是这种形态------YAML front matter 写 name、description、maxIters、工具白名单,正文写系统提示词(含固定的假数据格式,不调外部 API)。
两路在 HarnessAgent.build() 时合并注册。规则只有一条硬约束:同一个 agent_id 不能既出现在代码里又出现在文件里------重复声明直接冲突,不留"文件覆盖代码"的隐式优先级。
子 Agent 的运行靠五个内置工具,模型自主调用:
| 工具 | 作用 |
|---|---|
| agent_spawn | 创建/复用子 Agent 并派任务(timeout_seconds=0 转后台) |
| agent_send | 向已有子 Agent 实例继续发消息 |
| task_output | 按 task_id 取后台任务结果 |
| wait_async_results | barrier 等待多个后台任务结果 |
| task_cancel / task_list | 取消/列举后台任务 |
 分配取舍的思路和 MCP 拒 stdio 一致:确定性高的放代码,内容型的放文件。summarizer 是系统行为的一部分(摘要出口),参数稳定,代码声明便于重构时一起评审;天气与航班是演示位,提示词与数据格式会经常调整,Markdown 文件改完重启即生效,不需要碰 Java。声明式路径的文件还天然是给用户/部署方留的配置位------不写代码也能加子 Agent。
片段出处:dream-scope-adapter/src/main/java/com/zhu/scope/adapter/subagent/ChatSubagents.java、dream-scope-web/src/main/resources/workspace/subagents/weather-agent.md
八、本篇学到了什么与 04 预告
框架侧,本篇完成了知识与工具层的四个认知:@Tool 注解驱动 schema 自动生成,无 @ToolParam 的参数由 RuntimeContext 按类型注入------业务上下文不过模型的手;Toolkit 是统一注册中心,本地工具、工具组、MCP 工具在模型侧无差别;RAG 的推荐形态是工具化检索,框架的 knowledge() 自动注入让位于单通道的工具调用;MCP 三传输由 McpClientBuilder 统一提供,stdio 适合本机、HTTP 传输适合服务端。
工程侧,dream-scope 给出了三层检索链路的完整样板:adapter 适配官方组件、knowledge 做 RRF 融合与改写精排、web 组合根按 provider 四档装配------pg、内存向量、关键词逐级降级,失败路径全部有归宿;检索只有一个入口,knowledge Agent 提供不调模型的纯检索出口;MCP 运行态拒绝 stdio、工具名用服务端原名;子 Agent 两路声明、build 合并、同 id 冲突即报错。工具、检索、子 Agent 三块的共同点是:能力全部来自框架,边界全部自己划。
下一篇是主干最后一篇,进入互通层:A2A 协议与 Agent Card------服务怎么被别的 Agent 发现与调用;Nacos 提示词热更新的接线方式与版本兼容的现实限制。
项目信息:
- dream-scope 开源地址:github.com/logosssss/d... (觉得有帮助欢迎 star)
- Dream-SaaS 项目地址:dream-saas.com
有问题评论区见,欢迎交流~