一、研究背景与核心目标
openPangu-2.0 是 openPangu 团队推出的新一代大语言模型系列,旨在解决当前 LLM 从被动对话助手向主动自主智能体演进过程中面临的核心瓶颈:
-
推理成本过高:通用架构在长上下文场景下推理开销巨大
-
长上下文性能退化:扩展上下文窗口时性能严重下降
-
长时程推理错误:标准对齐技术无法防止长轨迹执行中的时序和结构推理错误
核心目标:通过软硬件协同设计方法论,构建高效、可靠、经济的长上下文智能体基础模型。
二、模型架构(三大变体)
| 变体 | 总参数 | 激活参数 | 定位 |
|---|---|---|---|
| openPangu-2.0-Pro | 505B | 18B | 旗舰级 |
| openPangu-2.0-Flash | 92B | 6B | 高效级 |
| 端侧模型 | 30B | 2B | 资源受限设备 |
所有模型原生支持 512K 令牌上下文窗口。
2.1 核心架构创新
(1)逐层混合注意力(DSA + SWA)
-
采用 DSA-SWA-SWA 重复模式(2:1 的 SWA 与 DSA 层比率)
-
SWA 层:窗口大小 512 令牌,捕获局部依赖
-
DSA 层:通过轻量级闪电索引器(LI)动态选择 top-K(如 2048)个相关 KV 条目,实现稀疏全局检索
-
效率优势:介于同构 DSA(DeepSeek-V3.2)和交替 FULL-SWA(Gemma 2)之间,在预填充 FLOPs、解码缓存读取和缓存内存之间取得更优平衡
(2)参数化注意力汇(PAS)
-
每层引入 128 个可学习键值对,吸收冗余注意力
-
缓解注意力汇现象,加速混合 SWA 架构训练收敛
-
推理时作为恒定大小虚拟 KV 条目,开销可忽略
(3)局部上下文调制注意力(ModAttn)
-
通过轻量级因果一维卷积在全局注意力前后注入局部上下文
-
增强细粒度局部语义建模
(4)流形约束超连接(mHC)
-
用 n 个并行残差流替代单一残差流,提升信息流多样性
-
通过三明治归一化和块级后归一化解决"门崩溃"问题
-
下游任务性能显著优于基线(平均 0.615 vs 0.594)
(5)多令牌预测(MTP)
-
部署 3 个 MTP 层,用于自推测解码
-
阶段自适应调度:通用阶段 1 层(λ=0.3)→ 推理阶段 1 层(λ=0.1)→ 退火阶段 3 层(λ=0.3)
-
MTP 内部使用窗口 2048 的滑动窗口注意力
(6)Muon 优化器
-
对所有矩阵形参数应用 Muon,通过 Newton-Schulz 迭代正交化更新矩阵
-
优化器状态内存相比 AdamW 减半
-
注意力 logits 保持稳定(约 20 以内),归因于三明治归一化和块后归一化
(7)分词器
-
重新训练,覆盖中文、英文、代码、行业文档和 188 种低资源语言
-
最终采用单位数字变体,提供更规则的数字级表示
三、预训练
3.1 数据构建
-
语料规模:约 34 万亿高质量令牌
-
三阶段课程:
-
阶段 1 通用(25T 令牌):建立通用知识和语言能力基础
-
阶段 2 推理(8T 令牌):增强深度推理、逻辑和编码
-
阶段 3 退火(1.4T 令牌):精炼智能体能力,保留长文档和复杂轨迹数据
-
3.2 训练细节
-
Flash 模型:批次 36M,峰值学习率 3.0×10⁻⁴
-
Pro 模型:批次 64M,峰值学习率 2.0×10⁻⁴
-
上下文长度逐步扩展:4K → 8K → 32K → 128K → 512K
-
RoPE 基频随上下文长度缩放:10K(4K)→ 6.4M(512K)
3.3 训练基础设施优化
(1)通信重叠与效率
-
消除混合 CP 通信冗余
-
MTP 轻量级 P2P 协议
-
Muon 分布式计算-通信重叠
(2)超级节点感知并行
-
利用 CloudMatrix 384 超级节点亲和分组
-
将 TP、CP、EP 重流量限制在超级节点内
(3)算法与硬件协同设计
-
定制 AscendC 融合算子(mHC、PAS、ModAttn)
-
mHC 层内/层间混合重计算
关键优化:
-
512K 上下文训练:KV CP 通信冗余优化,SWA 层用 P2P 替代 AllGather,FA/DSA 层用 AllToAllV
-
FA 重缩放:灵活回退方案,数学等价于单次全局 softmax
-
分布式 Muon:HyperParallel Muon+,NS 输入聚合优化(AllGather/AllToAll),桶级通信-计算遮蔽
-
MTP 负载均衡:仅主干 P2P 传输,通信减少 75%,训练吞吐量提升约 20%
四、后训练
4.1 三阶段流水线
(1)监督微调(SFT)
-
512K 上下文长度
-
双模式融合(思考/非思考)
-
四大数据领域:推理、通用聊天、编码、长轨迹智能体
(2)并行 RL 专家训练
-
分别训练四个领域专家:推理、通用、智能体、编码
-
使用 GRPO 优化,无 KL 正则化
-
消除跨域干扰
(3)多专家同策略蒸馏(OPD)
-
融合不同 RL 专家能力
-
使用每令牌对数概率差作为优势
-
计算优化:专家顺序加载到共享 NPU 池
4.2 训推不匹配解决
当前实践:
-
FP16 + 动态损失缩放
-
KPop 自适应掩码
-
Rollout 路由重放(R3):流式传输、可扩展数据、掩码 R3、缓存 R3
根因分析(三类):
-
类别 A:显式定义不匹配(数学非等价)
-
类别 B:计算图重排序不匹配(数学等价但数值发散)
-
类别 C:硬件调度非确定性(SplitK、K 轴 swizzling、AtomicAdd)
全对齐方案预览:
-
阶段 I:训练前向与推理预填充严格对齐(解决 A、B)
-
阶段 II:推理解码与训练前向深度算子对齐(解决 C)
五、评估结果
5.1 公共基准
| 类别 | 代表性基准 | Flash 思考 | Pro 思考 |
|---|---|---|---|
| 通用 | IFEval | 95.9 | 94.5 |
| 通用 | SimpleQA Verified | 24.5 | 34.9 |
| 推理 | AIME 2026 | 93.3 | 95.4 |
| 推理 | HLE | 20.3 | 27.1 |
| 智能体 | TAU2-Bench | 88.0 | 81.1 |
| 智能体 | BrowseComp | 57.0 | 65.7 |
| 编码 | LiveCodeBench V6 | 85.1 | 85.7 |
| 编码 | SWE-bench Verified | 63.1 | 68.5 |
关键发现:强基础推理直接赋能复杂智能体行为,后者反过来锐化多步规划和长轨迹上下文处理。
5.2 内部工具评估
-
深度研究与交互式可视化:生成功能网站,包含高保真统计图表、SVG、动画和交互组件
-
全栈迷你应用生成:将高层用户意图转化为生产就绪的原生迷你应用
六、推理优化
6.1 部署配置
-
超低延迟:共置(PD-mix)部署,层特定并行化
-
低延迟:PD 分离架构,解码节点耦合注意力 DP 与 MoE EP
6.2 量化
-
W8A8 整数量化,权重从 1009 GB 压缩至 517 GB(1.95× 减少)
-
逐模块决策:大层 INT8,敏感层 BF16
6.3 算子优化
-
mHC 算子:三部分重构(mhc_sandwich_norm_post_preonly、mhc_pre_split_post_res、sinkhorn)
-
SWA 算子:核内动态微瓦片级掩码跳过,性能提升 30%-40%
-
通信算子:TP AllReduce 优于 EP AlltoAllv(延迟优化 20%),原子排序非 BSP 分派(15%-20%),令牌中心执行模型(25%-30%)
-
图优化:ACL Graph + Npugraph_ex,TPOT 改进 3.2 ms
6.4 并行策略
-
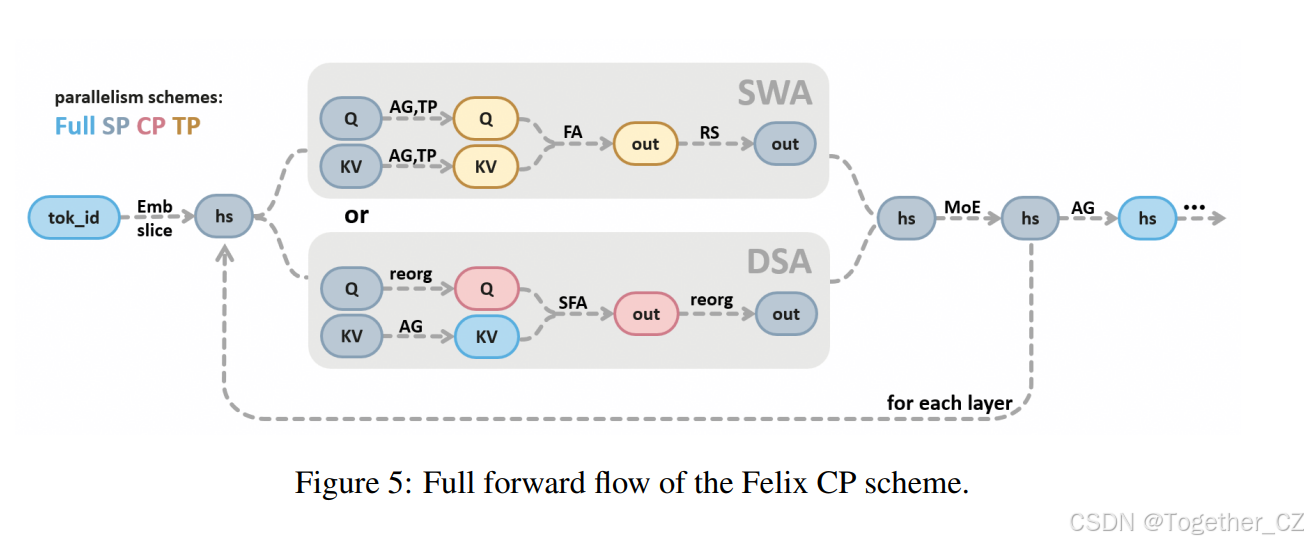
Felix CP:DSA CP + SWA TP + ModAttn SP
-
多流:核心预算控制、Cube/Vector 并行、通信/计算重叠
6.5 KV 缓存管理
-
Omni Cache:以 DRAM 为中心的 KV 管理,KV 空间扩大 10 倍以上,APC 命中率提高 3 倍
-
混合注意力缓存:页大小对齐、步进缓存视图、异构组间前缀缓存
-
ModAttn + MTP + APC:首个开源支持类 Mamba 架构同时支持 MTP 和细粒度 APC 的框架
6.6 推理框架优化
-
异步调度:消除设备侧气泡,AICPU 卸载 Tiling,HCCL AICPU 模式
-
Multi-MTP 全图:静态图执行,跳过预草稿 DP all-reduce
-
LoPT:无损并行分词,16 核 CPU 上 3-5 倍加速,100% 准确
6.7 性能结果
| 模型 | 场景 | TPOT | 吞吐量 |
|---|---|---|---|
| Flash | 128K+8K | 13.0 ms | 1846 tokens/s/NPU |
| Pro | 128K+8K | 18.1 ms | 1326 tokens/s/NPU |
- 128K 输入 TTFT:Flash 2.6s,Pro 3.0s
七、结论与未来工作
核心贡献
-
架构创新:DSA-SWA 混合注意力、mHC、PAS、ModAttn、MTP
-
系统优化:昇腾原生训练和推理基础设施,512K 上下文稳定训练
-
后训练:并行 RL 专家 + OPD 融合 + 训推对齐
-
推理加速:定制算子、并行策略、缓存管理、异步调度
-
实际效用:HarmonyOS AIOS 演进、生成式 UI、全栈应用生成
未来方向
-
扩展沙箱合成流水线,生成大规模高保真执行数据集
-
系统增强代码智能和复杂智能体工作流
-
精炼认知架构,产生动态真实环境中的自主智能体
-
边缘原生能力扩展(麒麟芯片)
这里是自己的论文阅读记录,感兴趣的话可以参考一下,如果需要阅读原文的话可以看这里,如下所示:
项目地址在这里,如下所示:
摘要
我们推出 openPangu-2.0,包含两种主要架构变体:openPangu-2.0-Pro(505B 参数,18B 激活)和 openPangu-2.0-Flash(92B 参数,6B 激活)。此外,我们还提出了一款优化的 30B 参数端侧模型(2B 激活),专为资源受限的执行环境而设计。为最大化智能体性能与系统级效率,我们建立了一套严格的软硬件协同设计方法论,将算法创新与昇腾原生基础设施紧密耦合。在架构层面,我们引入逐层混合注意力架构,将滑动窗口注意力(SWA)与 DeepSeek 稀疏注意力(DSA)交错排列,以提升长上下文推理效率。通过将流形约束超连接(mHC)与 Muon 优化器及针对性稳定化技术相结合,模型在预训练期间实现了更快的训练收敛,且无损失尖峰。在系统层面,定制融合算子与拓扑感知优化消除了关键的内存、计算和网络瓶颈,确保大规模 MoE 架构在扩展至 512K 上下文窗口时的稳定预训练。在后训练阶段,我们将并行专家强化学习与严格的训推对齐方法论协同起来。最后,我们专用的推理引擎利用定制算子优化与并行策略,结合优化的缓存管理和异步调度,在昇腾硬件上实现了卓越的生成吞吐量和超低延迟。
1 引言
近年来,大语言模型(LLM)的进展催生了一场根本性的范式转变,将这些系统从被动的对话助手转变为能够驾驭复杂环境的主动自主智能体。这一演进要求模型能够可靠地执行长上下文规划、精确调用外部工具,并在扩展的执行轨迹中保持认知连贯性。然而,现代部署面临关键瓶颈:通用架构产生高昂的推理成本,并在扩展上下文窗口时遭受严重的性能退化,而标准对齐技术无法在长时程执行中防止时序和结构推理错误。openPangu-2.0 从底层设计出发,旨在解决这些挑战。通过协同定制硬件算子、系统架构、训推对齐的智能体强化学习以及专用推理加速,我们建立了一套严格的软硬件协同设计方法论,为长上下文智能体任务提供高效、可靠且经济的基础。
模型架构。 为建立高效的原生长序列能力,我们在两种架构变体------openPangu-2.0-Pro 和 openPangu-2.0-Flash------中开发了核心架构创新。我们通过逐层混合注意力机制解耦上下文处理,将用于密集局部上下文的滑动窗口注意力(SWA)7 与用于稀疏全局检索的 DeepSeek 稀疏注意力(DSA)14 交错排列。为加速推理,我们在主干上附加了一个三头多令牌预测(MTP)模块 12, 22。此外,将流形约束超连接(mHC)58 与 Muon 优化器 12, 22 相结合,在固定数据预算下显著提升了收敛速度。最后,通过 MoE 负载均衡、mHC 稳定化、MTP 训练策略和 Muon 参数分组等针对性方法,保证了端到端的训练稳定性,确保平滑、无损失尖峰的预训练。
训练基础设施。 在集成复杂架构原语(mHC、Muon 和 MTP)的同时扩展至 512K 上下文窗口,带来了严重的通信和内存瓶颈。为确保长上下文训练稳定性,我们建立了一个系统性协同优化框架,结合无冗余混合上下文并行(CP)、MTP 的轻量级点对点传输、Muon 的分布式重叠以及混合重计算,并由针对 mHC、参数化注意力汇(PAS)和 ModAttn 的定制 AscendC 融合算子大力加速。为充分利用 CloudMatrix 384 超级节点的聚合计算能力,我们部署了精简的、拓扑感知的亲和策略。将重流量限制在超级节点内并最小化外部传输,消除了瓶颈,最大化了硬件利用率。
后训练。 我们的后训练框架遵循三阶段流水线:监督微调(SFT)、并行强化学习(RL)专家训练和多专家同策略蒸馏(OPD)1, 15, 21, 24, 59。在统一的 SFT 阶段之后,我们并行训练 RL 专家,分别在隔离的数据和奖励上优化领域专用策略(推理、通用、智能体和编码),以消除 RL 中的跨域干扰。最后,采用 OPD 训练阶段融合不同的 RL 专家。除了我们当前用于缓解训推不匹配问题的机制外,本报告还预览了将在后续模型迭代中采用的昇腾架构全对齐方案。
推理加速。 我们设计了一个昇腾原生推理框架,将硬件执行逻辑与运行时模型动态紧密耦合。我们的架构引入了定制融合算子------包括推理优化的 mHC 算子和专用集合通信原语------以及新颖的并行策略,如 Felix CP 和每核多流执行。为最大化吞吐量,我们结合了定制量化策略与算子感知的精度保持方案,并集成了混合 KV 缓存管理、无损并行分词 45(LoPT),以及针对 ModAttn 量身定制的自动前缀缓存(APC)和多令牌预测(MTP)的开创性支持。在 128K 上下文长度下,该框架在昇腾 NPU 上释放出卓越的长上下文性能:openPangu-2.0-Flash 实现了 5.63 ms TPOT 的超低延迟和每 NPU 1,846 tokens/s 的生成吞吐量(在 15 ms TPOT 下),而 openPangu-2.0-Pro 达到了 9.55 ms 超低延迟和每 NPU 1,326 tokens/s(在 20 ms TPOT 下)。
性能与应用效用。 评估结果表明,openPangu-2.0 系列在各种通用、推理和智能体基准测试中取得了有竞争力的性能,同时揭示了一个关键的协同反馈循环:强大的基础推理能力直接赋能复杂的智能体行为,而后者反过来又锐化了多步规划和长轨迹上下文处理能力。超越公共基准,我们将 openPangu-2.0 锚定于实际的系统级效用。以智能设备为主要案例研究,我们将模型与推动 HarmonyOS 向真正 AI 原生操作系统(AIOS)演进所需的核心能力对齐。为促进这一演进,我们刻意培育了对意图驱动的生成式用户界面(Generative UI)和执行支撑的软件合成的原生支持。如真实场景所示,openPangu-2.0 可靠地将高层人类意图转化为生产就绪的全栈迷你应用,并将深度研究工作流转化为动态、交互式的知识制品。
2 模型架构
openPangu-2.0 系列包含两个混合专家(MoE)语言模型:openPangu-2.0-Pro(505B 参数,18B 激活)和 openPangu-2.0-Flash(92B 参数,6B 激活)。两个模型原生支持 512K 令牌上下文窗口,整体架构如图 1 所示。为应对长上下文智能体工作负载固有的计算、内存容量和带宽瓶颈,我们引入了一种逐层混合注意力机制,将 DeepSeek 稀疏注意力(DSA)与滑动窗口注意力(SWA)交错排列。该设计优雅地解耦了上下文处理:SWA 层专门捕获局部依赖,而 DSA 层高效检索稀疏全局信息。为实现极高效推理,我们在主干上附加了三个多令牌预测(MTP)层,通过自推测解码大幅加速生成。此外,通过集成流形约束超连接(mHC)并通过 Muon 优化,openPangu-2.0 在相同预训练数据预算下实现了学习效率的显著提升。全面的架构规格详见附录 A.1。
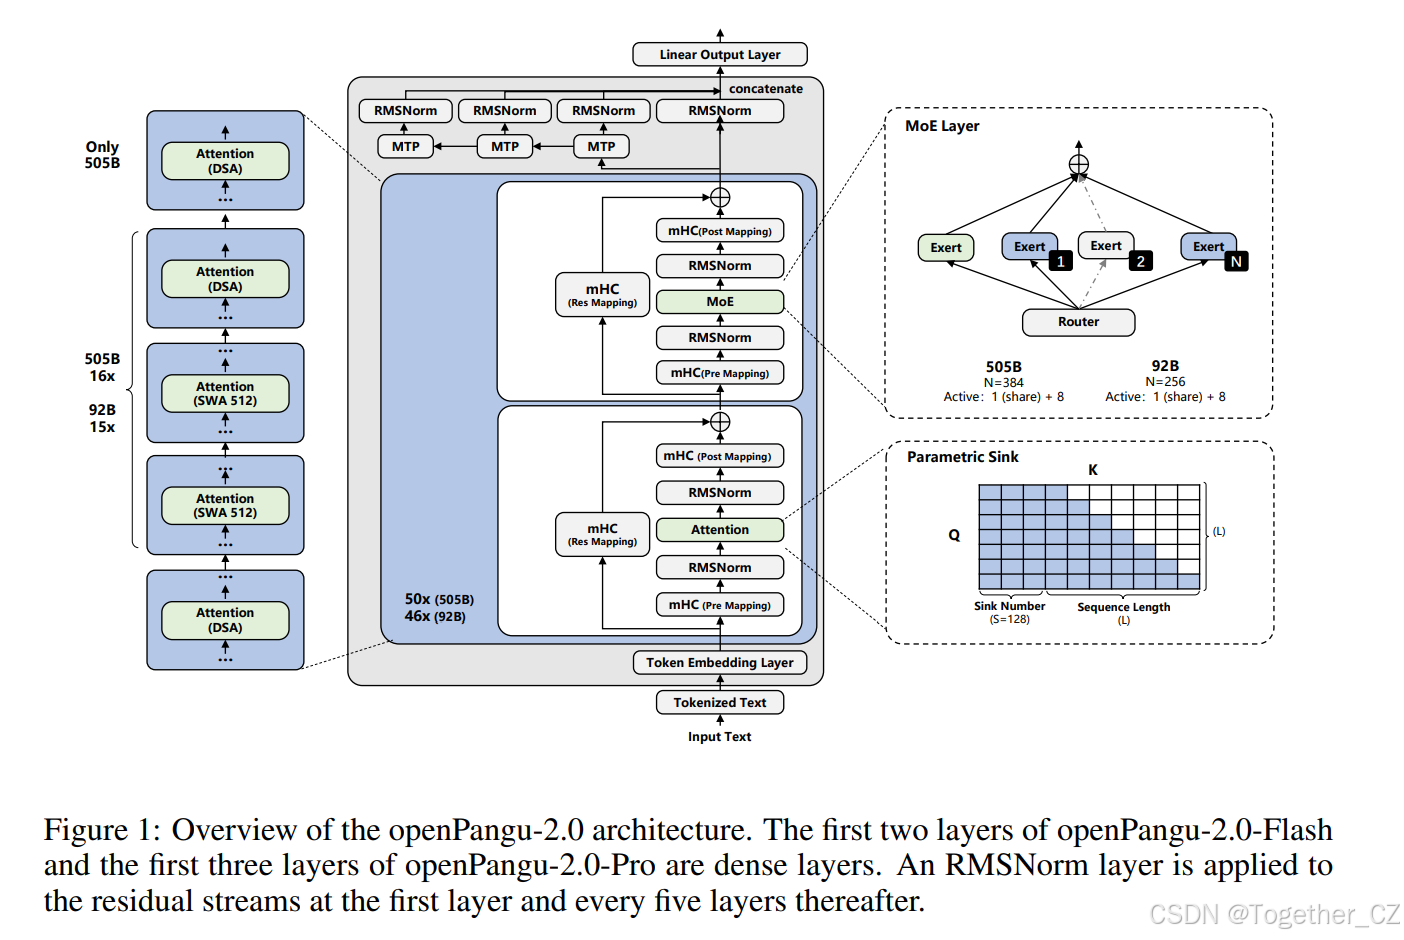
图 1:openPangu-2.0 架构概览。 openPangu-2.0-Flash 的前两层和 openPangu-2.0-Pro 的前三层为稠密层。在第一层及此后每五层,对残差流应用 RMSNorm 层。
2.1 注意力架构
我们的注意力模块从根本上构建于多头潜在注意力(MLA)13 之上,采用 DSA 和 SWA 层的交错堆叠,以大幅降低长上下文场景中的推理开销。为进一步精化注意力表示,我们用参数化注意力汇(PAS)和局部上下文调制注意力(ModAttn)增强标准 MLA 块------前者系统地吸收注意力汇令牌,后者增强细粒度局部语义建模。
SWA。 我们采用重复的 DSA-SWA-SWA 模式,对应 2:1 的 SWA 与 DSA 层比率。在初步实验中,我们观察到虽然更大的比率(如 3:1 和 5:1)在短序列(4K)上保持性能,但在扩展至 32K 和 128K 上下文长度时训练损失退化。SWA 窗口大小设为 512 令牌,SWA 层的 RoPE 49 基频随上下文长度扩展,从 4K 时的 1.0×10⁴ 增至 512K 时的 6.4×10⁶。尽管我们探索了替代窗口大小和 RoPE 基频缩放策略,但它们对最终性能的影响微乎其微。
DSA。 DSA 引入了一个轻量级闪电索引器(LI),动态选择与当前令牌相关的历史键值(KV)条目进行注意力计算,从而消除大量冗余和无关的注意力开销。所选子集限制为固定数量 KK 个令牌(例如 2,048),将全局注意力成本的比例因子从完整上下文长度转移到所选令牌数量。
在 512K 上下文预训练的后期阶段,我们通过重放 512K 训练数据将模型从全注意力(FULL)架构转换为 DSA 架构。在整个转换过程中,为 LI 引入辅助学习目标,以拟合全注意力计算的原生注意力分数,该目标的系数设为 0.1(较大的系数会产生过大梯度,损害训练稳定性)。经过短暂的稠密预热和 100B 令牌的稀疏适应后,模型在下游性能上基本恢复。与 DeepSeek-V3.2 不同,我们的基础模型本质上是 FULL-SWA 混合架构。因此,我们仅将全注意力层转换为 DSA,保持 SWA 层不变。这在结构上解耦了上下文建模:DSA 提取全局依赖,而 SWA 处理局部交互。
PAS。 为缓解注意力汇现象 23, 50, 56------即语义无意义的令牌吸收不成比例的注意力质量------我们用参数化注意力汇(PAS)增强每一层。如图 1 所示,PAS 每层引入 128 个可学习键值对(MLA 的潜在 KV)以吸收冗余注意力。在推理期间,这些充当恒定大小的虚拟 KV 条目,即使在长上下文场景中也仅施加可忽略的计算和缓存开销。经验上,PAS 还加速了混合 SWA 架构的训练收敛。与 gpt-oss 38 中汇机制的详细比较见附录 A.2。
PAS。 为缓解注意力汇现象 23, 50, 56------即语义无意义的令牌吸收不成比例的注意力质量------我们用参数化注意力汇(PAS)增强每一层。如图 1 所示,PAS 每层引入 128 个可学习键值对(MLA 的潜在 KV)以吸收冗余注意力。在推理期间,这些充当恒定大小的虚拟 KV 条目,即使在长上下文场景中也仅施加可忽略的计算和缓存开销。经验上,PAS 还加速了混合 SWA 架构的训练收敛。与 gpt-oss 38 中汇机制的详细比较见附录 A.2。
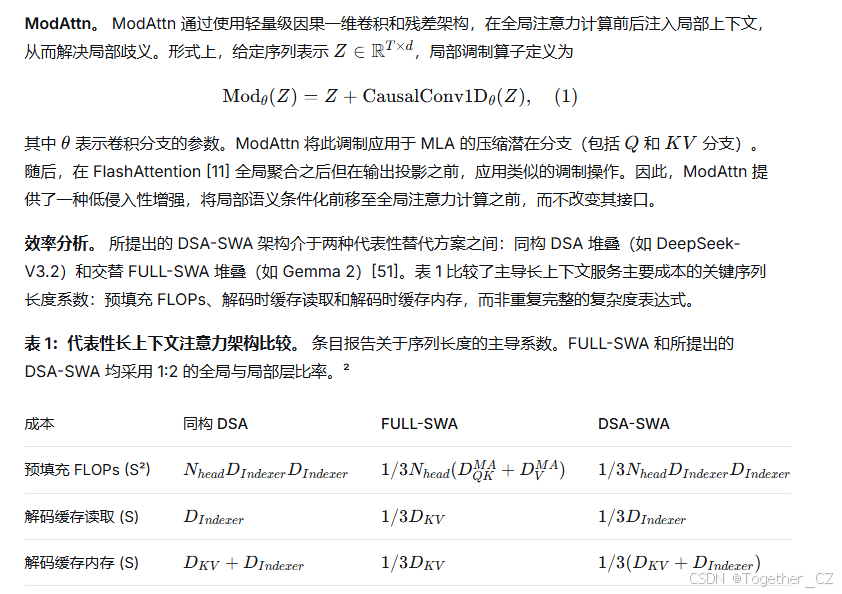
与同构 DSA 堆叠相比,所提出的架构将 DSA 限制在三分之一的层中,在预填充和解码期间按比例降低了全局令牌选择的成本。与交替 FULL-SWA 堆叠相比,它用轻量级索引加稀疏检索替代了稠密全局注意力,将主导二次计算从全注意力表示降至小得多的索引表示,同时降低了解码时缓存读取。因此,所提出的 DSA-SWA 架构在预填充 FLOPs、解码时缓存读取和解码时缓存内存之间实现了更有利的平衡,使其非常适合长上下文服务。
2.2 混合专家
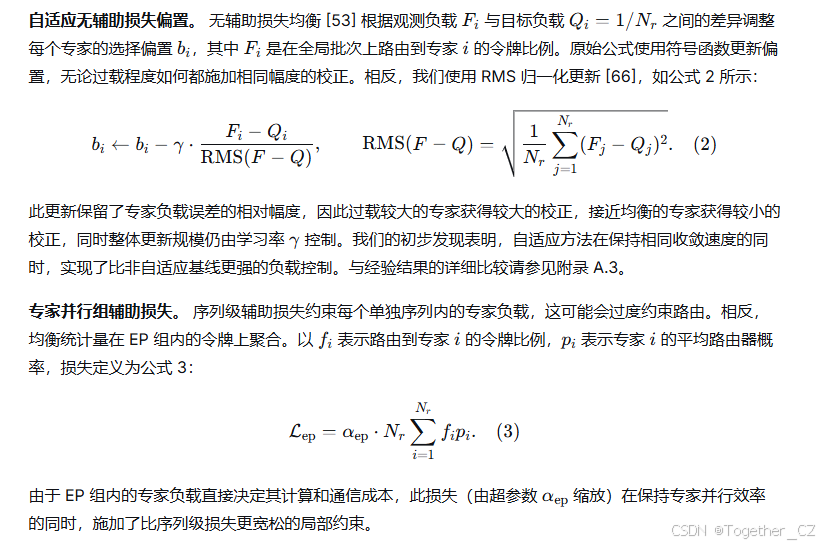
openPangu-2.0 扩大了专家数量(Pro 版本拥有 384 个专家),并采用高稀疏比率(激活 384 个路由专家中的 8 个),这对负载均衡提出了更严格的要求。为在训练期间保持专家工作负载均衡,我们实现了两种互补机制:一种自适应无辅助损失负载均衡策略,用于管理整个全局批次上的均衡;以及一种专家并行组(EP 组)辅助损失,用于控制每个 EP 组内的局部均衡。
2.3 流形约束超连接
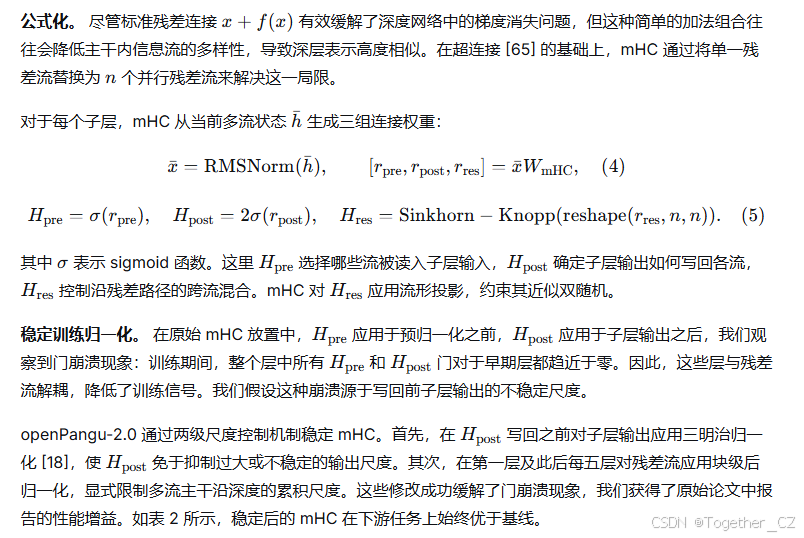
表 2:mHC 与基线(MoE15B-A2B)在 1T 训练令牌后的下游评估。 基线 MoE15B-A2B 采用标准 openPangu-2.0 架构但无 mHC 模块(详细架构超参数见附录 A.1)。EN 和 ZH 列分别是衡量基本英文和中文能力的多任务少样本评估套件,涵盖阅读理解、知识问答等通用 NLP 任务。
| 模型 | EN | ZH | MMLU | CEval | BigBench | MATH | MBPP+ | 平均 |
|---|---|---|---|---|---|---|---|---|
| 基线 | 0.500 | 0.605 | 0.765 | 0.708 | 0.591 | 0.459 | 0.532 | 0.594 |
| mHC | 0.511 | 0.608 | 0.799 | 0.743 | 0.622 | 0.472 | 0.553 | 0.615 |
2.4 多令牌预测
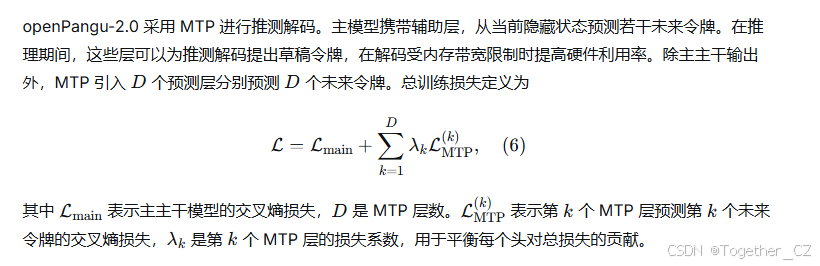
具体而言,部署架构设置 D=3。这为自推测解码器提供了多令牌草稿路径,同时保持主自回归模型不变。为使辅助模块在长上下文中实用,MTP 模块内的所有注意力使用固定窗口为 2048 的滑动窗口注意力。该窗口限制了计算和缓存增长,同时保留了足够的高质量草稿预测所需的局部上下文。
训练策略。 openPangu-2.0 使用阶段自适应 MTP 调度。早期预训练阶段使用一个 MTP 层,系数相对较大为 0.3,以便在表示仍在形成时模型获得更密集的未来令牌监督。在推理阶段,系数降至 0.1,以避免对主推理目标过度正则化。在长上下文扩展阶段,MTP 模块扩展为三层,每层系数保持 0.1(总计 0.3),产生用于推理的最终自推测草稿层。
表 3:按训练阶段划分的 MTP 层数和损失权重。
| 阶段 | 序列长度 | MTP 层数 D | 损失权重 λ |
|---|---|---|---|
| 通用阶段 | 4K | 1 | 0.3 |
| 推理阶段 | 8K | 1 | 0.1 |
| 退火阶段 | 32K, 128K, 512K | 3 | 0.3 |
2.5 Muon 优化器
openPangu-2.0 对所有矩阵形参数应用 Muon 优化器。Muon 通过 Newton-Schulz 迭代正交化更新矩阵,保持更新步骤的近似均匀谱范数。这防止了稀有梯度方向被抑制,有助于长尾知识的获取。此外,由于 Muon 仅跟踪一阶动量,相比 AdamW 将优化器状态内存减半。
在实践中,Muon 优化所有二维及更高维权重张量,而 AdamW 优化词嵌入、预测头、参数化汇参数以及一维参数(如 RMSNorm 权重和 mHC 门系数)。对于 MLA 查询和键值上投影,在应用 Muon 之前将注意力头划分为四组。这种分组与头的结构独立性一致,同时保持更新矩阵足够大以实现稳定正交化。Newton-Schulz 迭代使用固定步数,并采用定制的每次迭代系数以更好地近似正交因子(见附录 A.4)。
先前工作 34 报告 Muon 可能导致注意力 logits(即 QK⊤)爆炸,导致训练不稳定。然而,openPangu-2.0 中的注意力 logits 在整个预训练期间保持稳定。我们将这种稳定性归因于三明治归一化和块后归一化的架构设计,它们显式约束了输出尺度。进一步的实证细节见附录 A.5。
以及键值上投影,在应用 Muon 之前将注意力头划分为四组。这种分组与头的结构独立性一致,同时保持更新矩阵足够大以实现稳定正交化。Newton-Schulz 迭代使用固定步数,并采用定制的每次迭代系数以更好地近似正交因子(见附录 A.4)。
先前工作 34 报告 Muon 可能导致注意力 logits(即 QK⊤)爆炸,导致训练不稳定。然而,openPangu-2.0 中的注意力 logits 在整个预训练期间保持稳定。我们将这种稳定性归因于三明治归一化和块后归一化的架构设计,它们显式约束了输出尺度。进一步的实证细节见附录 A.5。
2.6 分词器
openPangu-1.0 分词器遵循基于令牌共现频率的传统 BPE 词汇设计。尽管对通用文本有效,但它对数字的分割不一致,且在多语言和行业语料上的压缩率相对较低。这一局限与多模态和智能体任务尤为相关,其中数字频繁表示坐标、边界框、索引和工具参数。
openPangu-2.0 使用中文、英文、代码、行业文档和 188 种低资源语言的重新平衡混合语料重新训练分词器。我们还重新设计了数值预分词,并评估了两种变体。3 位数字变体保留适度的数值压缩,而单位数字变体将连续阿拉伯数字拆分为单个数字,以提供统一的数值表示。
我们使用每令牌覆盖的平均字符数来评估分词器效率,值越高表示压缩越好。结果报告于表 4。
表 4:词汇压缩率比较。
| 词汇表 | 词汇量 | 中文 | 英文 | 多语言 | 代码 | 行业 | 平均 |
|---|---|---|---|---|---|---|---|
| openPangu-1.0 | 153,376 | 3.82 | 4.30 | 2.80 | 2.80 | 4.18 | 2.56 |
| openPangu-2.0-digit | 150,400 | 4.04 | 4.27 | 3.37 | 2.77 | 4.51 | 2.71 |
| openPangu-2.0-single-digit | 149,600 | 3.82 | 4.15 | 3.32 | 2.56 | 4.27 | 2.59 |
3 位数字变体实现了最佳整体压缩,尤其在中文、多语言和行业语料上。然而,openPangu-2.0 采用单位数字变体作为最终分词器。尽管这一设计引入了小的压缩损失,但它避免了多数字的频率依赖合并,并为数值推理、多模态定位和工具使用场景提供了更规则的数字级表示。
2.7 端侧模型
该模型采用 30B 参数 MoE 架构,仅 2B 激活参数,实现高效的端侧部署。它采用麒麟感知的量化和剪枝来减少计算和内存开销,实现 50% 的推理加速和 20% 的内存占用降低。为缓解资源受限设备上稀疏 MoE 路由导致的频繁专家交换,专家重用损失鼓励相邻令牌激活相似的专家集,将专家切换频率降低 50%。此外,专家激活预测预判后续令牌可能选择的专家并实现主动预取,从而减少专家加载停顿,将模型吞吐量提升高达 5 倍。这些优化共同使模型的计算、内存访问和专家调度与麒麟硬件的特性对齐,使模型在端侧推理中极为高效。
3 预训练
3.1 数据构建
openPangu-2.0 预训练语料库包含约 34 万亿高质量、多样化令牌,相较 openPangu-1.0 模型有显著升级。我们完全重构了数据构建流水线,以积极扩展语料库规模并延长上下文长度。为优化学习,预训练过程结构化为三阶段课程。每个阶段利用量身定制的数据配方和选择策略,逐步发展模型能力:
阶段 1:通用(25T 令牌):专注于建立稳健的通用知识和广泛语言能力基础。
阶段 2:推理(8T 令牌):目标为增强深度推理、逻辑和高级编码技能。
阶段 3:退火(1.4T 令牌):精炼模型行为和智能体能力。我们有意将长文档和复杂轨迹数据保留至此最终阶段,以最大化模型的自主任务能力。
我们的预训练语料库汇集了多种来源,包括网页、书籍、PDF、多语言文本、代码仓库、STEM(科学、技术、工程和数学)文献、工业领域数据、智能体任务和合成生成数据。在 openPangu-1.0 基础上,我们高度重视扩展 ARC(智能体、推理和代码)数据的多样性和质量。我们通过彻底改革基于规则的启发式方法并集成稳健的基于模型的评估流水线来实现这一点。此外,通过利用多样化的评估工具,我们生成并精炼了高保真合成智能体轨迹,专门赋能 openPangu-2.0 的智能体能力。
为保留来自清洁度或流畅度分数较低的数据样本中的宝贵长尾知识,我们开发了几个专门的微调模型。这些模型重写和标准化文本格式,同时严格保留原始语义。此外,语料库中的每个文档都标注了丰富的元数据,包括:质量和难度分数;主题类别;教育价值。这些详细标签驱动高度精选的、基于课程的采样策略,确保模型在训练的每个阶段都接触到最优数据分布。
3.2 训练细节
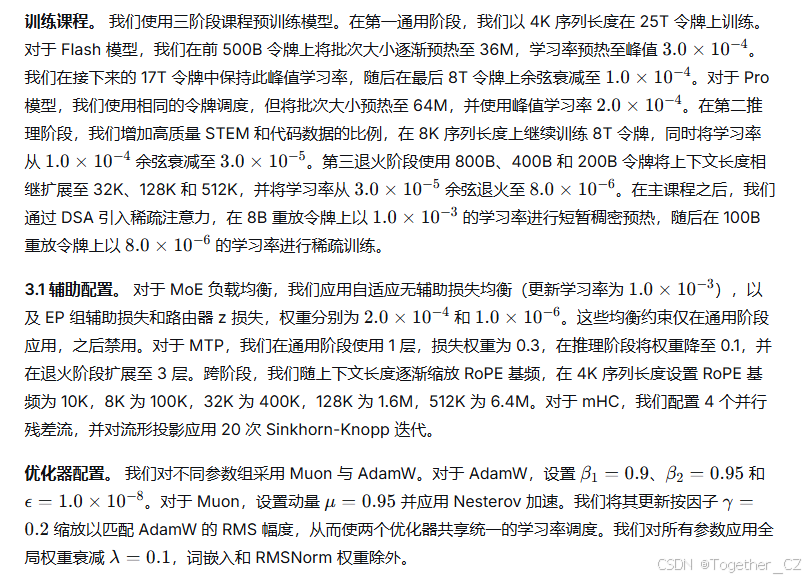
openPangu-2.0-Flash 和 openPangu-2.0-Pro 模型共享相同的训练课程、辅助损失设计和优化器配置,仅在批次大小和学习率调度上有所不同。
3.3 训练基础设施
虽然 openPangu-2.0 构建于 openPangu-1.0 62 的训练基础设施之上,但其升级架构引入了新的系统挑战类别。扩展至 512K 上下文窗口并结合 mHC、Muon、MTP 和 ModAttn 等新组件,导致了高度复杂的分布式通信、严重的激活内存压力,以及新引入算子缺乏高效的昇腾原生实现。
为打破这些瓶颈,我们设计了一个全面的优化框架,聚焦三个关键领域:
通信重叠与效率: 我们的系统消除了混合 CP 通信中的冗余,为 MTP 利用轻量级 P2P 协议,并为 Muon 引入分布式计算-通信重叠。
超级节点感知并行: 我们的并行配置策略利用 CloudMatrix 384 超级节点亲和分组。核心设计原则是将重流量------张量并行(TP)、CP 和专家并行(EP)------严格限制在超级节点内,以利用其高带宽超级平面。
算法与硬件协同设计: 我们为 mHC、PAS 和 ModAttn 开发了定制 AscendC 融合算子,以提供原生硬件加速。为缓解内存压力,我们实现了专为 mHC 量身定制的层内和层间混合重计算。
通过将重型超级节点内通信与外部链路隔离,并将参数网络流量与计算重叠,这种协同设计的架构消除了节点间瓶颈并最大化了硬件吞吐量。
3.3.1 昇腾优化的 mHC 训练
mHC 引入了实际开销:增加的内存占用、繁重的阶段间流量,以及稠密张量操作期间向量处理器的吞吐量瓶颈。我们在以下章节中通过针对性优化解决这些问题。
mHC 层内/层间重计算。 为克服 mHC 激活内存的线性增长(限制了批次大小和长序列训练),我们提出了两种细粒度选择性重计算方案。层内方案仅缓存三个张量(注意力的主干输入、注意力输出和多层感知器(MLP)/MoE 输出),并通过与层内通信重叠来隐藏重计算成本,针对无流水线并行(PP)的设置。对于带虚拟流水线并行(VPP)的 PP,跨层方案仅缓存每个块中第一层的注意力输入,并在通信空闲时隙递归恢复其余部分,不增加额外 FLOPs,且不影响迭代时间。两种方案共享相同核心机制;跨层仅调整 PP 的重计算时机,允许根据资源和目标灵活选择。
3.2 512K 上下文训练
mHC 下的 PP 通信优化。 在 PP 场景中,mHC 和多头 MTP 都会放大隐藏状态------mHC 按流数放大,MTP 按预测头放大。为解决此问题,我们仅跨 PP 边界发送主分支状态,并在目标阶段本地扩展 MTP 输入。这将在多令牌预测训练的负载均衡部分 3.3.4 中详细说明。
昇腾亲和 mHC 融合算子。 我们使用 AscendC 实现 HpreHpre、HpostHpost 和 HresHres 以最大化性能,特别优化向量计算。实现级优化描述如下。
为防止阶段串行执行导致的硬件空闲,我们应用预取策略,消除因等待 CUBE 结果而导致的 Vector 流水线停顿,实现 Vector 和 CUBE 流水线之间的深度重叠。结合多级分层细粒度并行、最小化工作区数据移动以提高 L2 缓存命中率,以及与计算重叠的预取,我们有效隐藏了内存延迟,并为单个算子提供峰值性能。
基于对内存密集和计算密集特性的联合分析,我们使用矩阵维度 nn 作为阈值,在 Vector 和 CUBE 核之间动态切换计算。这种卸载平衡了两个单元之间的瓶颈,并最大化硬件利用率。对于低级指令调优,我们在 Vector 核上采用标准 Muls+Axy 指令序列来实现高精度 FP32 矩阵乘法,在不牺牲精度的情况下充分利用向量核吞吐量。
3.3.2 512K 上下文训练
CP 对于将 Transformer 训练扩展至超长序列至关重要。虽然 Ulysses CP 28 非常高效,但其按头分区要求注意力头数可被 CP 度整除。更关键的是,它与昇腾 NPU 上的稀疏闪存注意力(SFA)算子交互不佳,限制了其在 DSA 训练工作负载中的可行性。为解决此问题,我们在稀疏注意力训练阶段采用键值上下文并行(KV CP)作为默认策略。通过分片序列维度而非头,KV CP 保持与底层稀疏注意力核的完全兼容性。对于全注意力训练,我们引入混合 CP,结合 Ulysses 和 KV CP 以绕过头的可整除性约束,同时与纯 KV CP 相比显著减少通信量和峰值 KV 缓冲区大小。
虽然此框架成功实现了 512K 规模的稳定训练,但将上下文窗口推至如此之远暴露了两个关键瓶颈。具体而言,我们必须解决序列并行导致的冗余 KV 通信,以及将 PAS 高效纳入 DSA 训练的挑战。以下章节描述了我们针对这两个问题的针对性优化。
KV CP 通信冗余优化。 标准 KV CP 沿序列维度从所有 rank 收集全局 KV 令牌。然而,每个 rank 仅需要这些令牌的特定子集用于其本地查询。这在长上下文训练中引入了大量冗余通信,特别是当全局训练样本打包多个短文档时。为消除这种冗余,我们针对 SWA、全注意力(FA)和 DSA 层专门优化了通信:
在 SWA 层中,给定 rank 上的查询张量仅需关注来自前一个 rank 的最后窗口大小个 KV 张量。我们用定向 P2P 通信替换全局 AllGather 通信。每个 rank 现在仅从前一个 rank 接收必要的窗口大小张量,并将其自身传递给下一个。这将通信量从 S⋅B⋅H 大幅减少至 W⋅B⋅H,其中 S 是完整序列长度,W 是滑动窗口大小,B 是批次大小,HH 是隐藏维度。
在 FA 和 DSA 层中,查询仅需要位于前序 rank 上的同一子序列的 KV 张量,而非所有 rank 的 KV 张量。因此,我们用 AllToAllV 替换 AllGather 以消除这种冗余,如图 2 所示。这确保了精确的按需数据传输,因为每个 rank 仅发送和接收子序列所需的精确 KV 段。
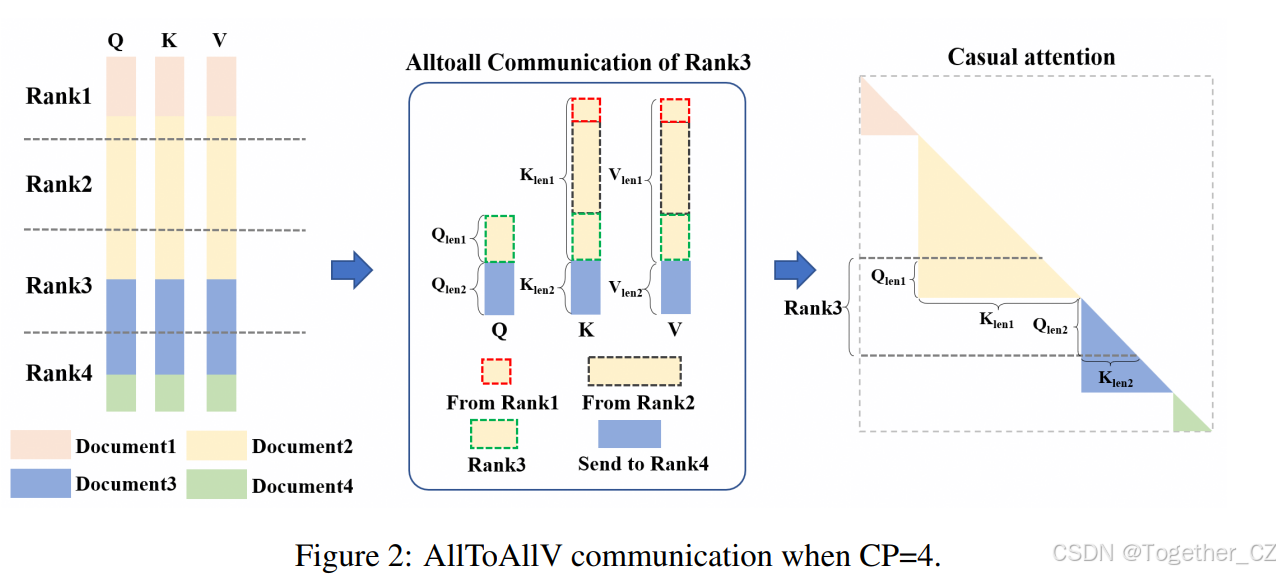
图 2:CP=4 时的 AllToAllV 通信。
FA 重缩放。 PAS 作为可训练键值参数引入,概念上前置到每个序列作为持久注意力锚点。尽管融合 PAS 算子在支持时更高效,但它缺乏多样化训练环境所需的通用性。为弥合这一差距,我们引入 FA 重缩放作为灵活回退。此方法执行两次标准注意力调用,并重建对拼接主序列和汇令牌的单次注意力结果。
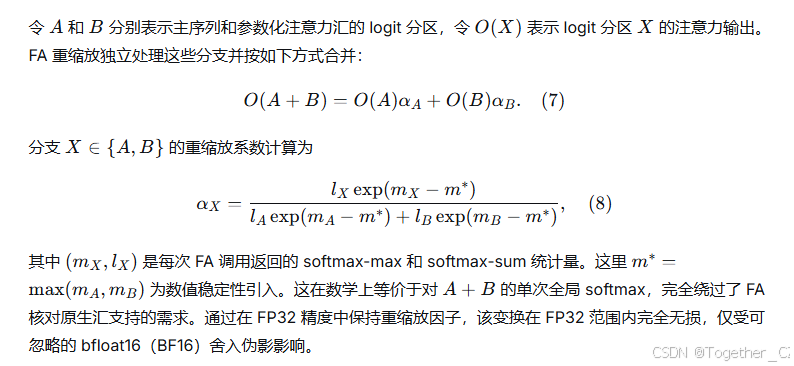
FA 重缩放在部署中高度灵活,因为它完全在标准 FA 调用之上运行,既不产生额外内存也无明显计算开销。这种灵活性对 DSA 训练尤其有价值,后者依赖干净、无汇的稀疏注意力统计来计算 Kullback-Leibler(KL)散度损失。FA 重缩放通过将 SFA 算子严格应用于主序列,同时用轻量级 FA 调用处理汇分支,自然保持了这种隔离。通过公式(7)和(8)合并这些输出,得到包含参数化注意力汇的完整输出。这使得高效的 DSA 训练无需污染 KL 损失或要求冗余的无汇 SFA 传递。
3.3.3 分布式 Muon 优化器
Muon 优化器通过动量矩阵的 Newton-Schulz(NS)正交化实现对称性和曲率自适应。与逐元素优化器相比,它面临三大挑战:NS 计算依赖完整权重矩阵,产生显著的 NS 输入聚合通信开销;NS 迭代受主机端调度约束,导致突出的调度开销;跨 rank 冗余权重计算严重。为解决这些问题,我们提出基于分布式数据并行(DDP)桶实现的 Muon 优化器通信-计算联合优化方案,称为 HyperParallel Muon+。
NS 输入聚合通信优化。 为减少聚合开销,我们提出两种聚合策略------AllGather 和 AllToAll------并为 DDP 桶零冗余优化器(ZeRO)场景 43 实现它们。
在 DDP 桶 ZeRO 场景中,权重分布在桶中,ZeRO 分区均匀划分每个桶。仅分区边界处的权重数据需要通信。AllGather 作为基线方案,聚合整个桶,使每个 rank 持有完整桶权重并可为 NS 迭代提取所需参数。每个 rank 仅处理其本地分区内的权重,而边界权重在多个 rank 上冗余计算。然而,当桶很大且包含多个完整参数而仅边界参数不完整时(与单个参数跨多个桶的小桶相反),AllGather 会产生通信冗余。在这种情况下,采用 AllToAll 方案:首先提取边界参数,排除本地已完整的参数;然后对边界参数执行相邻 rank 交换,即 AllToAllV 语义。注意 AllToAllV 是一种 P2P 通信原语,跨超级节点会产生大量队列缓冲区资源开销,因此不应在大型集群中无限制使用。相应地,为解决 AllToAllV 的跨平面队列溢出问题,我们借鉴 DeepEP 12 的两层通信设计:将数据并行(DP)域分解为 DPouter×DPinner 二维拓扑,其中 DPouter 和 DPinner 分别表示外部和内部维度。外部维度执行对称 AllGather 通信以进行跨超平面扩展,内部维度执行细粒度 AllToAllV 交换,保持在域内可控。
桶级通信-计算遮蔽优化。 为隐藏主机端调度开销,实现了桶级通信-计算遮蔽。当前桶的异步通信在后台运行,而动量/更新矩阵正交化和参数更新在前一个桶上执行,两个操作在时间线上重叠。遮蔽流水线的时序如图 3 所示:桶 i 的通信操作与桶 i−1 的计算操作重叠,其中 i 索引桶,而第一个桶的通信和最后一个桶的计算构成不可遮蔽的暴露开销。当通信延迟小于或等于计算延迟时,通信开销可被完全遮蔽,端到端运行时间仅由纯计算决定。遮蔽收益取决于桶粒度、网络带宽和计算密度之间的相对关系。实际增益遵循相同规则:通信在小规模集群中可被充分遮蔽,而在大规模集群中通信通常成为瓶颈。
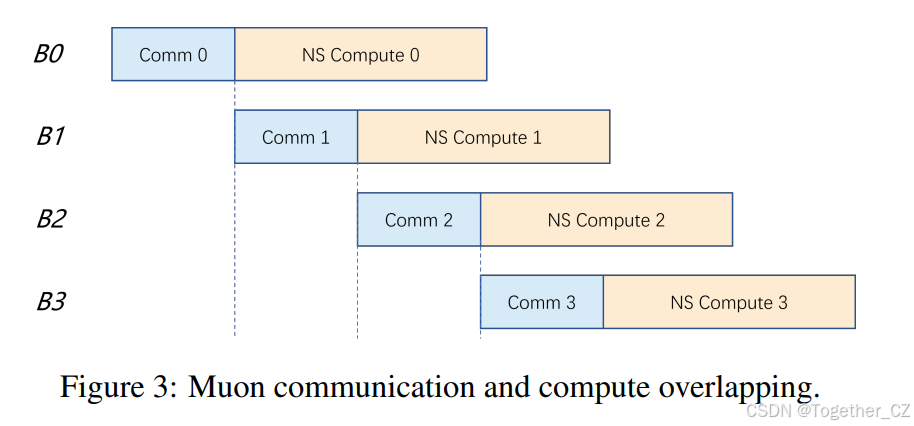
图 3:Muon 通信与计算重叠。
3.3.4 多令牌预测训练的负载均衡
MTP 引入了额外的计算、内存消耗和 PP 通信。当 MTP 与 mHC 结合时,这些成本尤为显著,后者用多个并行残差流替代单一残差流。朴素实现会跨 PP 边界传输与 n×D 成比例的 MTP 状态,其中 n 和 D 保留上述残差流和预测头的含义,而将所有 MTP 层、输出投影和损失计算放在流水线末端会造成严重的尾阶段瓶颈。
openPangu-2.0 通过三种互补优化解决这些问题。首先,正常 PP 边界仅传输 mHC 扩展的主干隐藏状态及其梯度。MTP 辅助状态在包含第一个 MTP 层的阶段本地生成,其梯度保持在消费它们的阶段本地。对于三头 MTP,这将有效 PP 载荷从四个流------一个主干流和三个预测流------减少到一个主干流,将 MTP 相关 P2P 通信减少 75%。在两个 mHC 残差流和三个 MTP 头下,它还避免了朴素设计约 6 倍的通信放大。
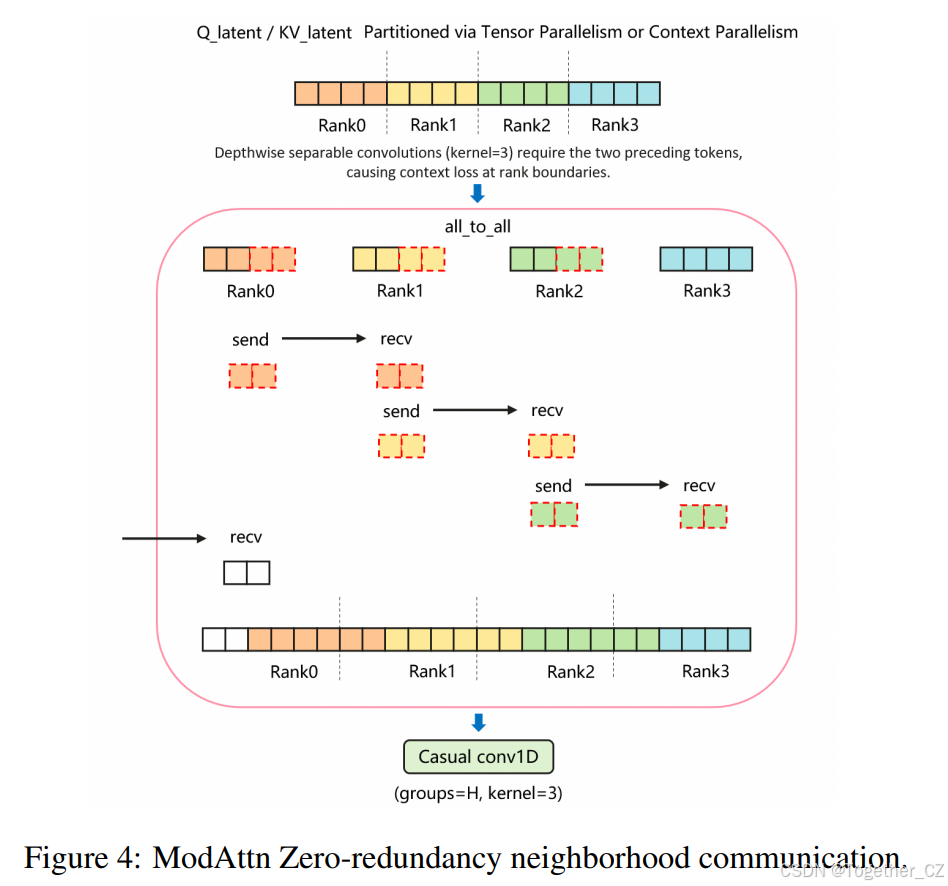
图 4:ModAttn 零冗余邻域通信。
其次,MTP 层参与 PP/VPP 布局,而非集中在最后阶段,允许其计算分布到流水线各阶段。第三,最后阶段的输出投影和损失计算被划分为序列块。每个块执行前向计算后立即执行反向计算,之后其 logits 可被释放。使用 C 个块,理论峰值 logits 驻留可接近完整序列所需 1/C,受缓冲和调度开销影响。
总之,仅主干 P2P 传输、MTP 感知流水线分区和块级立即反向分别缓解了 MTP 训练的通信、计算和内存瓶颈。在 openPangu-2.0 训练配置中,优化布局相比不平衡 MTP 布局将训练吞吐量提高约 20%。
3.3.5 ModAttn 的系统级优化
ModAttn 使用滑动窗口卷积和掩码增强 openPangu-2.0 的 MLA。为解决超长序列中的部署挑战------跨节点边界精度损失、激活内存爆炸和数据移动瓶颈------我们通过三项关键优化重构了系统。
零冗余邻域通信。 序列并行在 ModAttn 的深度卷积中截断边界信息。为高效获取跨设备上下文,我们用 All-to-All 通信机制替换复杂的 P2P 或冗余 AllGather 方法。每个计算节点提取其右边界激活并将其路由到相邻下游节点。接收节点在前向传递期间拼接此数据,恢复完整感受野,如图 4 所示。这保证了单卡等价性且无精度损失。
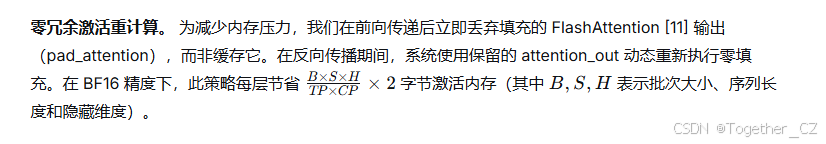
4 后训练
4.1 监督微调(SFT)
在监督微调期间,我们使用 512K 令牌上下文长度以保持长上下文能力。openPangu-2.0 的 SFT 数据集基于双模式融合策略构建,无缝集成思考模式和非思考模式数据。为确保高质量监督,我们在四个核心支柱上实施领域专用构建策略:
| 数据领域 | 构建策略与特征 |
|---|---|
| 推理 | 优先完整思维链和可解释性。每个样本包含显式中间步骤、逻辑论证和严格结果验证。 |
| 通用聊天 | 使用多维评估标准精选,保证响应逻辑清晰、简洁且高度符合人类偏好。 |
| 编码 | 来源于真实 Issue/Pull-Request 对并严格过滤。我们利用跨多种语言的大规模可验证执行环境,特别强调昇腾 C 和用于 HarmonyOS 开发的 ArkTS。 |
| 长轨迹智能体 | 通过多阶段流水线生成,模型使用不同智能体框架在真实 HarmonyOS 和模拟沙箱环境中执行复杂任务。广泛覆盖工具使用、技能使用、文件操作和编码能力。 |
质量控制: 包含错误步骤的轨迹通过环境反馈和奖励模型识别。我们在训练期间掩码这些不正确的转换,强制模型仅从高质量、正确的动作中学习。
4.2 并行强化学习(RL)专家训练
由于异构任务结构和冲突的反馈信号,将强化学习应用于通用大语言模型(LLM)是一项具有挑战性的任务。例如,编码任务具有二元、可验证的结果,而通用对话是开放式和主观的。在单一 RL 阶段优化这些竞争目标往往导致领域干扰和信号失衡。为解决此问题,我们采用并行专家训练策略,分别训练领域专用策略。这将领域特定的策略优化分开,使独立专家更新,同时减少跨域干扰。所有专家策略使用组相对策略优化(GRPO)46 优化,无 KL 正则化项。
4.2.1 推理 RL
推理 RL 受益于可验证、适当挑战性和多样化的任务。为此,我们覆盖四类任务:数学、科学、逻辑游戏和工具集成推理。我们使用以下策展步骤构建候选数据池:
-
质量过滤:使用 LLM 评估器对查询表述评分,丢弃子参数、多部分子问题和模糊答案。
-
多样性平衡:对剩余查询标注多级主题标签和细粒度知识点,确保平衡表示。
对于工具集成推理(例如异步 Jupyter 环境),我们额外对交错思考期间的 Python 解析错误施加惩罚,并掩码早期正确轮次,以便仅惩罚最终错误。
4.2.2 通用 RL
通用 RL 旨在处理多样化的用户面向任务,专注于存在多个有效响应的开放式查询。我们针对四项核心能力:
指令对齐:严格遵守系统提示和上下文中的显式和隐式约束。
事实可靠性:最小化幻觉,拒绝无根据的声明,抑制过度弃权。
长上下文理解:定位、整合和推理分散信息,不丢失长程依赖。
交互质量:确保连贯、简洁和自然的多轮对话。
为支持这些异构目标,我们构建了跨越任务类别、语言、交互格式和难度级别的多样化提示混合。此外,我们采用混合奖励系统支持这些异构目标。确定性约束使用基于规则的奖励,而生成式奖励模型处理细微的语义质量维度。
4.2.3 智能体 RL
智能体 RL 专家掌握跨各种沙箱环境的长时程规划和工具使用。为确保真实世界适应性,训练环境被视为黑盒系统。在智能体 RL 期间,我们采用几种常用和定制技术来增强训练稳定性和样本效率,详述如下:
-
令牌入-令牌出(TITO):消除轨迹生成和策略更新之间的分词不匹配,稳定梯度。
-
在线动态过滤:我们持续跟踪每样本通过率。持续解决的样本从训练循环中动态丢弃,使模型始终处于学习前沿。
-
语法惩罚:格式错误的工具调用(例如缺少参数、无效 JSON)在奖励信号中触发即时、显式的格式错误惩罚。
-
可验证评估:奖励是确定性的,基于训练循环外的客观执行结果,极大降低了奖励黑客风险。
-
热启动初始化:智能体 RL 从通用 RL 检查点初始化,利用其优越的指令遵循和格式正确性基线。
4.2.4 代码 RL
为构建稳健的软件工程和终端交互能力,我们将 RL 数据路由通过专用黑盒框架。网关服务器位于智能体框架和推理引擎之间,将智能体逻辑与 RL 数据流解耦。它捕获令牌级数据(提示、完成、logprobs)并重建完整轨迹用于训练------同样由 TITO 机制稳定。
随着编码能力扩展,奖励黑客风险也随之增加。我们通过自动化辅助监控智能体实时跟踪奖励分布和轨迹模式来应对。它标记异常,发出可解释警报,并提供可操作诊断以快速精炼奖励,提高训练稳定性。
4.3 多专家同策略蒸馏
在分别优化 RL 专家模型后,我们采用同策略蒸馏(OPD)将其互补能力融合回单一统一模型。蒸馏提示从 RL 专家训练中使用的数据集混合中采样。对于每个提示,我们使用当前策略生成轨迹,然后查询相应领域专家提供每令牌监督。OPD 重用 RL 训练目标,但用所选专家与当前策略之间的每令牌对数概率差替换优势:
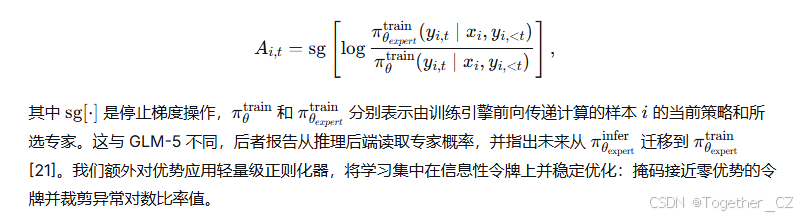
计算优化。 为减少优势计算所需的 NPU 资源,我们将专家顺序加载到共享 NPU 池中,而非为每个专家分配专用 NPU 池。在 rollout 之后,样本按其对应专家分组;对于每组依次加载专家权重,并通过训练引擎前向传递计算其所有样本的专家对数概率。这避免了同时保持所有专家驻留,同时保持相同的每令牌评分程序。
4.4 解决训推不匹配
4.4.1 当前实践
以下段落详述我们用于缓解训推不匹配的具体机制。事实上,没有单一技术适用于所有场景;相反,我们根据模型架构、硬件配置和观察到的不匹配严重程度组合它们。
FP16。 在实践中,我们发现从 BF16 切换到 FP16 是有效的。为解决 FP16 有限动态范围导致的梯度下溢风险,我们集成了成熟的动态损失缩放技术:在每次反向传播前,将损失乘以缩放因子 S 以增加梯度幅度;在反向传播后和梯度裁剪前,通过反缩放恢复梯度至真实幅度;如果任何梯度包含 Inf 或 NaN(即发生溢出),跳过当前优化器步骤并将 S 值减半。
KPop。 在我们的主线 RL 训练中,我们 largely 用 KPop 25 替换 IcePop 52 和传统拒绝采样作为主要校正机制,因为它轻量且针对广泛的训推不匹配。在实践中,我们引入影子超参数机制,在不同训练场景的初始步骤中评估多个候选 ϕ 值,允许我们在确定特定设置之前估计其掩码行为。当训练-rollout 皮尔逊相关系数(PCC)低于 0.99 时,我们选择更严格的 KPop 掩码。相反,当原始训练-rollout PCC 已超过 0.99 时,我们使用更宽松的 ϕ 以避免不必要的过滤并保持模型探索能力。最优 ϕ 依赖于训练,最终应与奖励轨迹、训练稳定性及其他共同反映当前 KPop 设置对鲁棒性和最终性能益处的指标一起确定;上述规则主要用作早期 RL 阶段的冷启动启发式。
Rollout 路由重放。 我们实现的 Rollout 路由重放(R3)36 构建于 VeRL 47 + vLLM 32 社区提出的机制之上,并有以下增强:
-
从推理引擎流式传输路由专家。我们的推理引擎通过现有 OpenAI 兼容流式 API 增量流式传输路由记录。此设计将带宽需求分摊到生成时间线上,而非集中在末尾。
-
可扩展数据传输。社区方法将路由记录直接嵌入 DataProto 并依赖 Ray 37 进行数据传输,这在大规模下成为瓶颈。相反,我们仅将元数据推入 DataProto,并使用 HCCL 通信高效传输路由记录,同时避免不必要的序列长度填充。
-
掩码 R3。在大规模训练中,我们观察到随着 MoE 层加深和序列逐令牌推进,隐藏状态表现出累积发散和严重漂移。我们发现在这种漂移条件下强制完整专家重放会对输出 logits 引入严重失真并导致 PCC 急剧下降,可能触发梯度爆炸或训练发散。为缓解此问题,我们引入自适应阈值机制来量化路由漂移并动态生成路由重放掩码。对于令牌,除非训练期间提出的专家选择与推理期间记录的专家选择之间的重叠超过可调阈值,否则重放被视为不可取。此方法增强了训练-rollout 一致性,特别是对于具有长序列输入的深层 MoE 架构。
-
缓存 R3。考虑需要多轮推理的智能体 RL。解码令牌将在后续轮次中经过预填充。然而,后续预填充可能为生成的令牌产生不同的专家路由选择。缓存 R3 通过持久化每个解码令牌首次生成时记录的专家路由选择,并在训练期间重放这些缓存选择来解决此问题。
4.4.2 训推不匹配的根本原因分析
当实验异步 RL 时,我们观察到上述机制并不总是足以缓解不匹配,这促使我们进行全面根因调查。以下分析为严格匹配解决方案提供了诊断基础。
RL 中的训推不匹配源于在系统栈不同层面表现的异构因素。通过系统分析,我们按失败模式将其分为三类:显式定义不匹配(数学上非等价的公式)、计算图重排序不匹配(数学上等价但由于操作序列改变而数值发散),以及硬件调度非确定性(昇腾 NPU 上微架构执行导致的运行间差异)。
类别 A:显式定义不匹配。 高性能 RL 训练框架(如 VeRL)通常采用"双引擎"架构:训练组件构建于 Megatron-LM 48 等大模型训练框架之上,而推理组件集成 vLLM 等高度优化的推理引擎。此架构迫使系统在训练和推理侧各维护两个独立定义的模型定义脚本。有了这两个模型定义,低级模型细节和配置参数的细微差异几乎不可避免,导致数学上非等价的计算。
类别 B:计算图重排序不匹配。 训练(面向吞吐/反向)和推理(面向延迟)采用不同的加速策略,尽管数学表达式相同,但会重排浮点操作,导致数值发散。我们将其归因于三个根本原因:(i) 部署策略------为同一模块选择不同算法变体,例如 MLA 在吸收(MQA,解码)和非吸收(MHA,训练/预填充)模式之间切换,或 MoE 专家按升序 Expert-ID 顺序(训练)与降序 Top-k 分数顺序(推理)累积;(ii) 并行策略------训练和推理偏好不同的并行策略,这改变浮点累积精度和累积顺序,最终导致数值发散;(iii) 融合算子------核融合隐式重写底层计算图和数值精度;由于训练和推理用不同核实现同一模块,这直接引入数值不匹配,例如不同的 FlashAttention 10 家族、MoE 分派/合并核和采样算子不匹配。
类别 C:硬件调度非确定性。 核的动态执行策略(Tiling)构成最深、最微妙的不一致来源。为加速解码阶段,推理通常启用动态批处理、KV 缓存、分块预填充或 APC 等功能。这意味着在计算相同令牌位置时,训练侧处理完整 2D/3D 张量,而推理侧处理分块或单步 1D 张量,无法在批次和序列维度上保持一致性。NPU 根据输入形状自动选择 tiling 策略,通过以下方式引入运行间非确定性累积:SplitK(跨 AI Core 分区 K 轴累积,例如 MatMul、FlashDecoding)、K 轴 swizzling(交错内存访问以提高 HBM 带宽,例如 MatMul),以及 AtomicAdd(异步多核收集,随机核心到达,例如 AllReduce,其拓扑感知算法如 Ring/Tree 进一步发散)。
更详细的算子和输入形状级实现差异见附录 A.6。
4.4.3 昇腾架构全对齐方案预览
为在昇腾 NPU 上消除这些差异并实现端到端训推对齐,我们设计了逐层渐进白盒对齐方法论。(前提:禁用随机采样并启用确定性通信以冻结生成行为,并完全对齐两侧并行。)
我们的对齐方法论分两个难度递增的阶段进行。阶段 I 针对预填充,其全序列计算在数学上接近训练前向,解决类别 A 和 B 不匹配。阶段 II 处理解码,其中单步、形状不匹配的计算触发更深层的类别 C 不匹配,需要核级干预。
阶段 I:训练前向与推理预填充之间的严格对齐(类别 A 和 B)。 预填充与训练前向共享相同输入序列,使其成为建立对齐基线的自然起点。如附录图 13 所示,我们首先开发了昇腾定制的张量钩子,在训练前向和推理预填充期间捕获逐层输出张量,并将其导出为原始二进制。使用高精度二进制差异比较,我们反向定位数值分叉点,从而纠正类别 A 的显式代码和参数错误。为收敛类别 B 的算子行为,我们进一步在单个算子内为两侧重新实现 FlashAttention(在 omni-ops² 中开源),实现训练和推理之间的完全一致性。
阶段 II:推理解码与训练前向之间的深度算子对齐(类别 C)。 解码的"单步迭代"与训练的"全序列并行"导致严重形状差异,触发类别 C 非确定性------无法仅通过配置解决,需要直接修改算子实现。为弥合这一差距,如附录图 14 所示,我们首先在训练侧构建"原始提示 + 首令牌"输入,将长序列分解为单步结构,对齐训练和推理之间的语义边界。然后我们利用开源 CANN 算子直接修改核 Tiling 策略,约束 SplitK 等优化行为并统一多核并行间的累积轴,之后重新编译和部署定制安装包,消除形状突变导致的底层数值漂移。
总之,这两个阶段沿着深思熟虑的、按深度排序的轨迹覆盖训推不匹配的完整谱系------从表面代码差异,到算子行为发散,再到核级数值漂移------每一层栈都与其匹配对应物固定。这一进展最终在固定并行配置下产生训练和推理之间的充分对齐,为昇腾 NPU 上的后续部署提供完全白盒、可复现的对齐基线。
5 评估
我们跨多种公共基准评估 openPangu-2.0,评估其通用、推理、智能体和编码能力。openPangu-2.0 在广泛的通用能力以及 STEM 推理任务上表现出有竞争力的性能。在智能体基准上,openPangu-2.0-Pro 在技能使用、智能体搜索和各种 Claw 导向任务中表现出色。对于编码任务,虽然模型在基本代码问答和功能实现上表现良好,但在处理复杂、真实世界软件工程工作流时,与顶级模型相比仍有明显差距。除公共基准外,我们利用内部评估工具展示 openPangu-2.0 的实际效用。具体而言,我们展示其执行端到端深度研究并具有交互式可视化,以及自主生成全栈应用的能力。
5.1 公共基准评估
5.1.1 通用与推理
对于通用能力,指令遵循使用 IFEval 64、IFBench 40、Agent-tIF 41 和 SysBench 42 评估,覆盖可验证约束和复杂系统级指令。事实可靠性使用 SimpleQA Verified 26 和 Chinese-SimpleQA 27 评估,衡量短形式事实准确性和幻觉。长上下文理解使用 CL-Bench 20 评估,强调从任务特定上下文中学习和推理。最后,多轮交互使用 MultiChallenge 17 评估,测试多轮对话中的指令保持和一致性。我们在 Humanity's Last Exam(HLE)3 文本子集、AIME 2026 63、HMMT 2026 4、IMO-AnswerBench 35、Apex 16、GPQA-Diamond 44 和 BBEH 31 上评估推理性能。
从表 5 可以看出,openPangu-2.0-Flash 和 openPangu-2.0-Pro 在广泛的通用基准上均取得强劲性能,涵盖上下文学习、指令遵循和多轮理解。对于世界知识和事实可靠性(SimpleQA Verified、Chinese-SimpleQA),openPangu-2.0-Pro 表现出强劲结果,优于 openPangu-2.0-Flash。在 STEM 推理任务上,openPangu-2.0-Pro 提供有竞争力的性能,在 Apex、HLE、IMO-AnswerBench 和 HMMT 2026 等复杂任务上大幅优于 openPangu-2.0-Flash。
5.1.2 通用智能体与编码
对于智能体基准,智能体-工具/技能使用在 Tau2-Bench 6、MCP-Atlas 5、SkillsBench 33 上评估。Claw 导向和真实世界任务根据 PinchBench 2、WildClawBench 19、Claw-Eval 61、GDPVal 39 评估,智能体搜索在 BrowseComp 54 上评估。SkillsBench 使用 OpenCode 作为框架评估。对于 Claw-Eval,仅评估非多模态拆分。对于 GDPVal,我们使用公共 GDPVal 数据集和评分标准进行内部评估,在 GDPVal-AA v2 支架上进行点式任务级评分。对于 BrowseComp,我们采用 15 中的 discardall 上下文管理策略,最多 300 次迭代。对于编码任务,LiveCodeBench V6 29、FeatBench 8、DeepCodeBench 9 和 SWE-bench Verified 30 分别就代码函数生成、功能实现、问答和软件工程进行评估。DeepCodeBench 和 FeatBench 使用 OpenCode 支架评估,SWE-bench Verified 使用 OpenHands 支架评估。
从表 5 我们观察到 openPangu-2.0 在技能使用、智能体搜索和各种 Claw 导向任务中表现出熟练能力。模型在基本代码问答(DeepCodeBench)和功能实现(FeatBench)任务上也表现良好。然而,我们也注意到我们的复杂智能体和编码能力与其他一线模型相比仍存在一定差距。
在我们的内部实验中,我们观察到建立强大的通用知识和推理基线有助于学习更复杂的智能体和编码行为。反过来,在多方面智能体环境中训练增强了基本能力,包括指令遵循、长轨迹上下文处理、多步推理和程序规划。最后,我们发现跨中期训练和后训练扩展高质量、多样化的长轨迹智能体数据和交互环境非常有利,这成为未来模型发布扩展的核心策略之一。
表 5:openPangu-2.0-Flash 和 openPangu-2.0-Pro 在通用、推理、智能体和编码基准上的评估结果。 报告非思考和思考推理模式。粗体结果表示所有 openPangu-2.0 变体中的最佳性能。所有评估使用 top_p 0.8 和温度 1.0 的解码设置进行。
| 基准 | openPangu-2.0-Flash 非思考 | openPangu-2.0-Flash 思考 | openPangu-2.0-Pro 非思考 | openPangu-2.0-Pro 思考 |
|---|---|---|---|---|
| 通用 | ||||
| CL-Bench (Acc) | 15.5 | 20.4 | 17.8 | 19.7 |
| IFEval (PromptStrict) | 89.3 | 95.9 | 90.4 | 94.5 |
| IFBench (PromptStrict) | 54.4 | 79.6 | 59.5 | 79.9 |
| AgentIF ((CSR+ISR)/2) | 43.9 | 44.9 | 42.2 | 44.4 |
| SysBench (ISR) | 87.9 | 91.1 | 82.6 | 90.8 |
| Multichallenge (Acc) | 51.9 | 68.4 | 52.2 | 62.9 |
| SimpleQA Verified (Acc) | 21.6 | 24.5 | 27.1 | 34.9 |
| Chinese-SimpleQA (Acc) | 66.0 | 66.7 | 75.7 | 74.2 |
| 推理 | ||||
| HMMT Feb 2026 (Avg@16) | 63.2 | 76.5 | 63.3 | 86.2 |
| -w/ Python | - | 90.7 | - | 93.2 |
| AIME 2026 (Avg@16) | 86.5 | 93.3 | 87.3 | 95.4 |
| -w/ Python | - | 98.1 | - | 97.9 |
| Apex (Avg@16) | - | 1.0 | 2.1 | 17.7 |
| IMO-AnswerBench (Acc) | 62.3 | 76.5 | 60.8 | 84.3 |
| BBEH (HarmonicMean) | 51.5 | 62.5 | 55.0 | 69.7 |
| GPQA-Diamond (Avg@4) | 79.8 | 83.7 | 81.1 | 87.9 |
| HLE (Acc) | 8.5 | 20.3 | 9.0 | 27.1 |
| 智能体 | ||||
| TAU2-Bench (Avg@3) | 74.0 | 88.0 | 71.6 | 81.1 |
| MCP-Atlas (Acc) | 47.9 | 58.9 | 48.8 | 61.3 |
| SkillsBench (Avg@5) | 40.0 | 42.6 | 47.5 | 48.9 |
| PinchBench (Avg@3) | 82.5 | 85.6 | 88.9 | 84.0 |
| WildClawBench (Avg@3) | 35.0 | 41.5 | 43.1 | 46.5 |
| Claw-Eval (Pass3) | 58.2 | 57.7 | 49.4 | 61.7 |
| GDPVal (Acc) | - | 51.4 | 51.2 | 74.9 |
| BrowseComp (Acc) | - | 57.0 | - | 65.7 |
| 编码 | ||||
| LiveCodeBench V6 (Avg@3) | 50.9 | 85.1 | 74.5 | 85.7 |
| FeatBench (Avg@3) | 45.8 | 45.9 | 48.4 | 47.1 |
| DeepCodeBench (Avg@3) | 70.9 | 76.5 | 72.6 | 74.2 |
| SWE-bench Verified (Avg@3) | 57.6 | 63.1 | 66.8 | 68.5 |
5.2 内部工具评估
5.2.1 深度研究与交互式可视化
深度研究已成为现代 LLM 智能体最突出的应用之一。虽然现有公共基准主要强调信息检索的深度或广度,但实际效用不仅取决于智能体发现了什么,还取决于它如何有效地将原始发现转化为可访问、可操作的知识。关键的是,随着 LLM 在智能体推理和代码生成能力上的进步,一场根本性的模态转变正在进行:知识合成正从静态文本转向动态、视觉和交互式制品。通过利用执行支撑的编码来即时分析、渲染和呈现信息,LLM 智能体使人类能够以前所未有的效率获取、审问和传达复杂见解。
为研究这一端到端能力,我们在内部研究和交付工具中部署 openPangu-2.0-Flash。该工具使模型能够使用搜索工具、编码工具和可视化前端开发环境。它不返回仅文本段落序列,而是生成一个功能网站,通过协调的文本、视觉和交互呈现研究发现。
展示可在 Deep Diver Live 找到,涵盖各种真实世界应用场景,包括全面行业调查、学术文献综述和教程生成。在实践中展示这一愿景,openPangu-2.0 超越简单文本摘要,生成高保真统计图表、复杂可缩放矢量图形(SVG)和清晰概念示意图。关键的是,模型擅长创建动态内容,包括流畅的信息动画和完全响应的交互组件,从而将静态信息转化为沉浸式知识探索体验。
5.2.2 全栈迷你应用生成
与仅前端网页生成不同,全栈应用生成是更苛刻的智能体任务:智能体必须连接前端、后端、数据库、实时服务和部署,同时平衡视觉和交互质量与端到端功能正确性。除传统桌面应用外,移动平台上的生成式迷你应用------尤其是构建于 HarmonyOS 等原生工具链上的------预示着人机交互的根本性范式转变。
为严格评估 openPangu-2.0 在此挑战性任务上的表现,我们建立了程序化优先的评估流水线,专注于端到端功能正确性和交互质量。基准查询被分解为原子功能声明,每个声明标注验证类型和关键性级别。对于每个生成的应用,计算机使用智能体主动与应用界面交互以收集多模态证据,包括 UI 树、渲染截图和运行时轨迹。多阶段验证级联检查这些信号,调用视觉语言评判器处理感知或主观属性,并将结果聚合为关键性加权功能分数。
通过这一全面评估框架,openPangu-2.0 在各种真实世界领域展示了卓越的端到端生成能力,可靠地保持高功能正确性和响应式交互质量。具体展示可在 Deep Diver Live 探索。代表性示例包括集成路线映射和交互式日程的个性化旅行行程规划器,以及具有实时数据管道和动态图表的定向股票跟踪助手。这些应用表明 openPangu-2.0 能够可靠地将高层用户意图转化为生产就绪的交互式原生迷你应用------为按需、移动优先的软件合成未来奠定坚实基础。
6 推理
openPangu-2.0 系列采用大规模稀疏混合专家(MoE)架构,配合混合注意力机制(SWA:DSA 比率 2:1),为长序列任务带来显著优势。为最大化昇腾硬件上的服务效率,我们引入全面的优化套件。这些技术分为五个核心类别:
-
算子创新:实现新颖融合算子,包括用于推理的专用 mHC 算子和 Pangu 特定注意力汇算子。
-
并行与执行范式:引入新并行模型,如 Felix CP 和每核多流执行。
-
缓存管理:混合 KV 缓存系统,具有 Omni Cache、开创性 APC 和针对 ModAttn(类 Mamba 架构)的 Multi-MTP 支持。
-
框架增强:系统级升级,包括全图 Multi-MTP 和无损并行分词(LoPT)。
-
量化:整体量化方案,旨在平衡精度、算子效率和并行处理。
这些集成设计共同在昇腾 910C 上释放出卓越性能:
-
openPangu-2.0-Flash:实现 128K 超低延迟 5.63 ms TPOT 和每 NPU 1,846 tokens/s 吞吐量(在 15 ms TPOT 下)。
-
openPangu-2.0-Pro:实现 128K 超低延迟 9.55 ms TPOT 和每 NPU 1,326 tokens/s(在 20 ms TPOT 下)。
6.1 部署
我们引入两种推理配置,针对不同操作需求:超低延迟变体优先极端单请求响应性,低延迟层级平衡吞吐量和解码延迟以应对通用工作负载。
超低延迟配置采用共置(PD-mix)部署,应用层特定并行化:SWA 层用 TP,MoE 层用 EP,DSA 层用动态策略,在预填充期间利用 CP 并通过冗余权重在解码期间切换到 TP。相反,低延迟版本采用 PD 分离架构。其预填充节点镜像超低延迟变体的精确并行拓扑,而解码节点将注意力 DP 与 MoE 专家并行耦合,以在大规模下优化整体吞吐量。
6.1.1 量化格式
我们通过静态对称输出通道权重量化和动态每令牌激活量化对 openPangu-2.0 应用 W8A8 整数量化。以 Pro 变体为例,这将权重占用从约 1009 GB 压缩至 517 GB,实现 1.95 倍减少。校准利用通道级平滑------将激活除以并乘以权重 s 以保持层输出------同时通过解耦指数 (a,b) 的二维搜索放宽 SmoothQuant 55 的刚性 a+b=1 约束。对于关键的上投影,输入和输出侧平滑系数在交替轮次中迭代优化直至收敛。
是否量化单个模块由联合评估内存节省、算子能力、精度敏感性、性能和多流调度决定。虽然大层产生最佳压缩增益,但若干因素限制特定组件使用 BF16:限于 BF16 输入的融合算子、离散选择之前的层(例如 TopK 路由和索引)对量化噪声敏感、误差累积残差路径、开销超过节省的小层,以及已被侧流窗口隐藏的算子。完整的逐模块决策映射详见 A.8(表 11)。
6.2 昇腾算子性能优化
算子的总执行时间通常包括设备时间(计算或内存访问)、核启动开销和主机调度开销。在低延迟和超低延迟场景中,核启动开销和主机调度现在占整体执行时间的越来越大比例,因此我们设计了多个融合和定制算子,与图模式多流并行协同工作。
6.2.1 计算算子优化
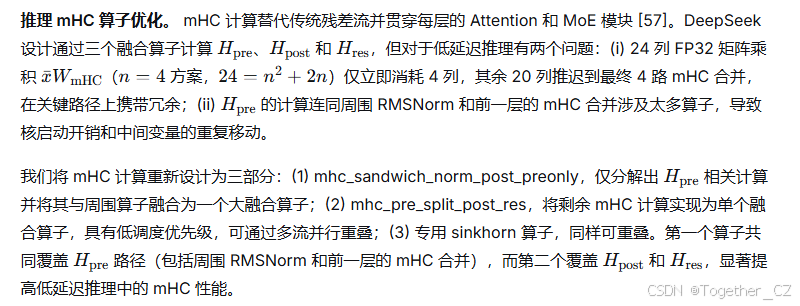
SWA 算子优化。 在 SWA 架构中,参数化注意力汇机制缓解注意力分数聚焦首令牌导致的表示退化。我们提出核内动态微瓦片级掩码跳过算法:将 L1 上的粗粒度基本块拆分为与计算阵列物理维度对齐的微瓦片,在 L1 到 L0 移动之前绕过"全无效"微瓦片,消除冗余计算和内存访问。此方案将参数化注意力汇保持在 L1 中驻留,将 tiling 调度卸载到 AI CPU,并动态调整基本块粒度以实现多核负载均衡。SWA 算子实现 30%~40% 的性能提升。
除上述算子外,我们还针对 Pangu 特定特征对 DSA、LI 和 MoeInitRouting 算子进行详细性能优化。这些算子的源代码将与本工作一起开源。
6.2.2 通信算子优化
通信效率直接影响端到端性能。我们在两个层面优化通信:首先,选择适当的并行策略和集合算法;其次,在确定通信模式后减少算子启动、同步、量化和数据移动开销。本节介绍单节点低延迟场景的三项关键技术------TP AllReduce 优于 EP AlltoAllv、通过原子排序的非 BSP 异步流水线,以及减少通信内的计算和内存开销。
超低延迟中 TP AllReduce 优于 EP AlltoAllv。 在超低延迟场景中,我们用冗余本地门控和注意力 TP 后的一次性 AllReduce 替换传统 EP 的两次 AlltoAllv 操作(分派 + 合并),只要增加的通信和计算成本小于一个 RTT 就是有益的。在超低延迟 openPangu-2.0 Flash 部署上,这将端到端延迟优化约 20%。
通过原子排序的非 BSP 分派。 在分派中,每个令牌的写入位置取决于前序令牌的目标专家信息,因此慢 rank 拖累整个重排序。我们通过非 BSP 异步流水线消除全核同步:写入偏移通过硬件原子递增(AtomicAdd,每个专家一个计数器)获得,无需核间协商,并将 AtomicAdd 与 Store 融合使用推语义在接收方计算目标地址。原子排序将分派延迟优化 15%~20%(在 16P/HiddenSize-4096 设置上为 5μs)。
减少通信算子中的计算和内存开销。 传统 MoE 分派为每个路由专家重复读取和量化每个令牌。相反,我们采用以令牌为中心的执行模型,每个令牌在分派到所有路由专家之前读取和量化一次。这消除了依赖 Top-K 的冗余计算,将分派延迟减少 25%~30%,并将端到端延迟提高最多 5%。
6.2.3 图优化
在低延迟推理中,CANN 提供 ACL Graph 加速方案(CUDA Graph 的昇腾对应物)和 Npugraph_ex,一个基于 CANN 的 PyTorch FX 图优化组件,通过 torch.compile 入口连接到 ACL Graph。Npugraph_ex 提供两个互补功能:静态核编译,提前完成标量计算、内存地址推导和循环边界确定,使运行时避免重复参数解析和同步点插入;以及 Superkernel,通过子函数调用将多个连续或逻辑相关的核融合为一个统一超级核,以减少启动次数。在 openPangu-2.0 超低延迟场景中,同时启用两者可带来 3.2 ms 的 TPOT 改进(1.2 ms 来自静态核编译,2 ms 来自 Superkernel)。
6.3 并行策略
如 6.1 节所述,openPangu-2.0 的 MoE 部分在 Atlas A3 上采用经典 EP 部署。Attention 部分在预填充侧使用 DSA CP + SWA TP,在解码侧使用注意力 DP,预填充侧 Attention 部署最复杂------这也带来显著性能优势,展现模型在长序列上的高性能特性。在整个模型计算中,我们采用多流并行策略,包括通信与计算、Cube 与 Vector,以及跨 AI Core 多流,以最大化利用昇腾硬件。
6.3.1 Felix CP:注意力模块并行策略
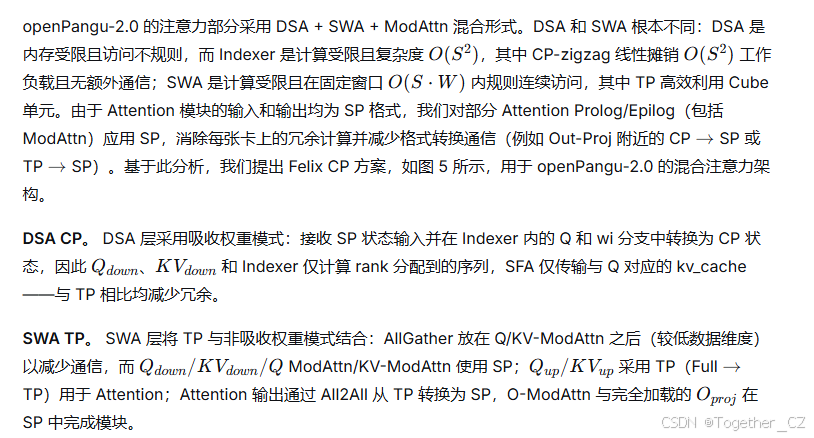
ModAttn-SP。 ModAttn SP 依赖两个主要组件:本地元数据构建和并行计算。在元数据阶段,每个 rank 独立处理前缀缓存块信息,并将本地 KV 块映射到全局状态。计算阶段然后从全局 KV 池检索该 rank 的运行缓存,并在全局同步更新缓存之前执行融合卷积核。关键的是,这代表了首个支持类 Mamba 架构 APC 的开源 SP 实现,并可推广到其他类 Mamba 网络。
6.3.2 多流
openPangu-2.0 实现显式核心预算控制的双流架构,以最大化 NPU 利用率。每个昇腾 910C 芯片集成 24 个 Cube 核(AIC)和 48 个 Vector 核(AIV)。在单流调度下,算子顺序运行,尽管资源需求不冲突,专用计算核仍处于空闲。我们使用三种互补机制回收此容量:
-
核心预算控制。将所有权重分配给单个算子在解码路径上效率低下:小形状 Vector 核产生高每核启动开销,并发流争用物理核心。我们限制每个算子的 AIC/AIV 占用,使两个流都适合芯片边界。
-
Cube/Vector 并行。MLA 序言具有自然互补的工作负载:Q 路径由 Cube 密集型 GEMM 主导,而 KV/mHC 路径主要由 Vector 操作组成。在不同流上运行这些使 AIC 和 AIV 流水线同时活跃。此外,我们将大 Q 投影拆分为两个平衡的子投影跨流,缩短关键路径。
-
通信/计算重叠。在 MoE 块中,我们将共享专家计算卸载到侧流,使其执行与路由流水线及其通信尾部重叠 62。
6.4 KV 缓存管理
6.4.1 Omni Cache
当代推理引擎在 HBM 中维护 KV 块池,这带来两个基本限制。HBM 资源争用:块池与模型权重竞争稀缺 HBM,因此一旦加载权重,单个 A3 设备缺乏剩余容量来容纳 openPangu 512K 令牌序列的 KV。长上下文 KV 容量不足:留给 KV 的 HBM 仅能容纳少数长上下文请求,因此历史 KV 几乎立即被逐出,使 APC 命中率趋近于零并限制解码并发。
一个关键观察启发了我们的设计。我们区分 KV 缓冲区------当前前向传递中注意力主动读取的 KV 子集------和 KV 缓存------其余部分,包括历史 KV 和未占用槽位。只有 KV 缓冲区需要 HBM 带宽;KV 缓存仅消耗容量。这一区分允许以 DRAM 为中心的架构,其中 KV 缓存驻留在主机内存中,达到 TB 级规模,而 KV 缓冲区仅在预填充期间占用 HBM------减少为单个层共享缓冲区,跨层重用并为每层计算保持。
以 DRAM 为中心的 KV 管理。 图 6 对比了与现有基于 HBM 的块池的内存布局。
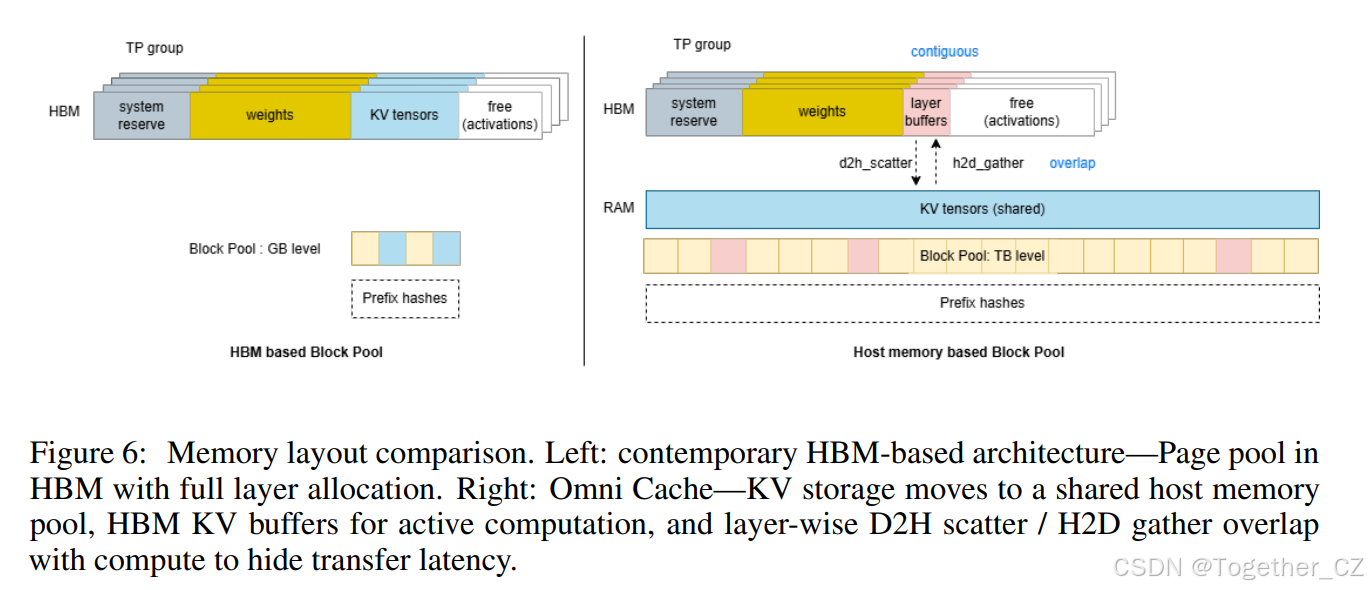
图 6:内存布局比较。 左:当代基于 HBM 的架构------页池在 HBM 中,全层分配。右:Omni Cache------KV 存储移至共享主机内存池,HBM KV 缓冲区用于活跃计算,逐层 D2H 分散/H2D 收集与计算重叠以隐藏传输延迟。
使用 openPangu,Omni Cache 将原生 KV 空间扩大 10 倍以上,APC 命中率提高 3 倍。释放的 HBM 允许预填充节点部署在单个 A3 上,最大批次令牌增加 4 倍,同时仍支持 512K 长序列。
6.4.2 混合注意力与 KV 缓存管理
openPangu-2.0 系列暴露异构注意力结构:DSA 保留压缩注意力缓存加索引器状态;MLA/SWA 存储共享压缩 KV 和 RoPE;ModAttn 是三个因果卷积模块(Q/压缩 KV/输出路径)的类 Mamba 边界状态。设计目标是保留 vLLM 的 Single BlockPool 抽象:所有带缓存的层从单个面向块的池中提取,并参与一个公共前缀缓存协商,而每个后端根据自己的核布局解释块负载。
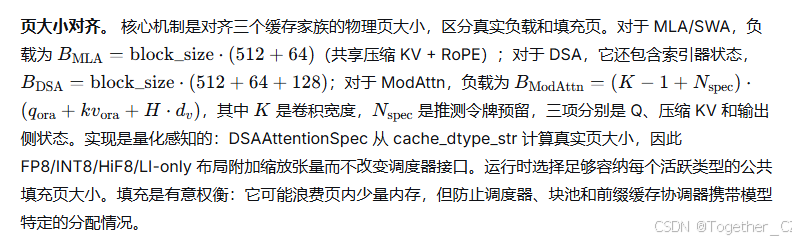
步进缓存视图与 KV 规范。 对齐的页分配为一个原始内存张量,每个后端通过 torch.as_strided 视图重新解释它,其第一 stride 跳过完整填充页大小,自动跳过填充。vLLM 接口通过三个 Pangu 特定 KV 缓存规范扩展:DSAAttentionSpec(理解 DSA 负载和量化格式)、ShareKVSlidingWindowSpec(将 MLA/SWA 建模为共享 KV 存储的滑动窗口)和 MomeSpec(扩展 vLLM 的 MambaSpec,记录三个状态形状/数据类型、卷积核大小和推测令牌预留)。相应管理器保持 vLLM 其余部分不变:DSA 使用正常全注意力管理器,MLA/SWA 使用共享 KV 的滑动窗口管理器,ModAttn 使用 MomeManager,将缓存视为边界状态缓存(像 Mamba,仅需要最新有效卷积边界状态,而非所有历史状态)。
异构组间前缀缓存。 混合前缀缓存要求每个缓存组通过 vLLM 的不动点协商(候选命中长度递减直到所有组同意)就单一可重用前缀长度达成一致。对于 DSA 等全注意力组,缓存查找是向下闭合的,因此管理器从左到右扫描并返回连续缓存块序列。对于启用 APC 的 ModAttn,缓存块扩展至 ⌈L/block_size⌉;我们将令牌分组为 block_size 令牌块,并缓存每块最后 (K−1) 个令牌作为前缀缓存。由于 ModAttn 块存储恢复计算所需的边界状态,MomeManager 从右到左搜索并在最新可用块停止;较早位置用空块填充,使逻辑命中长度保持 num_blocks * block_size,而物理活跃状态可能仅是最终 ModAttn 边界块。
对于 MTP 或 EAGLE 风格推测解码,全注意力组可能丢弃最终命中块,以便为推测验证重新计算隐藏状态;将相同规则应用于 ModAttn 将不正确,因为 ModAttn 重用取决于最新有效状态而非连续隐藏状态序列。因此 Pangu 协调器仅将 EAGLE 标志传递给全注意力组;ModAttn 组继续参与相同不动点协商,但其命中逻辑保持类 Mamba。
支持 MTP 和 APC 的 ModAttn。 当 MTP 和 APC 同时运行时,ModAttn 缓存管理复杂度达到峰值,因为未验证的推测令牌可能在验证或覆盖之前临时填充前缀缓存块。为解决此问题,我们的框架跨调度步骤跟踪接受的推测令牌数,并应用动态校正以保证准确的缓存读取定位。这代表了首个能够同时支持 MTP 和细粒度 APC 的类 Mamba 架构开源框架,提供可轻松扩展到 Gated DeltaNet 60 和 Deepseek Compressed Sparse Attention 15 等架构的通用解决方案。
6.5 推理框架优化
除混合 KV 缓存管理外,我们在 openPangu NPU 推理引擎中引入三项互补优化以最小化端到端延迟:(a) 细粒度异步调度以消除设备侧气泡,(b) Multi-MTP 全图模式保证每个解码步骤在静态图内执行,以及 (c) LoPT,一种显著减少 TTFT 的无损并行分词器。
昇腾 NPU 推理的异步调度优化。 我们将 vLLM V1 的异步调度框架适配到我们的混合注意力模型(启用 MTP-3),用于大规模 EP 和 DP 部署。在此设置中,我们识别三个关键同步瓶颈:(i) MTP 验证引入的可变接受长度依赖,(ii) 多个 KVCache 组的频繁 CPU 侧 Tiling 调用,以及 (iii) 阻塞 DP 级批次协调通信。为解决第一个瓶颈,我们通过独立异步复制流返回采样结果和草稿令牌,消除推测解码 D2H 阻塞点。通过采用事件流水线------即将当前复制的完成通知与后续计算核的启动链接------我们将 CPU 等待时间与 NPU 计算完全重叠。对于第二个瓶颈,我们将 CPU 侧 Tiling 卸载到片上 AICPU(ARM 核)。该核直接访问驻留在 NPU HBM 中的序列状态张量,并异步将 Tiling 元数据写入缓冲区。此设计消除所有 D2H 和 H2D 往返,并与 AICore 计算并发运行。最后,对于 DP 同步,我们用专用 HCCL ProcessGroup 以 AICPU 模式(即将集合通信卸载到片上 ARM 核)替换阻塞 CPU 侧 Gloo AllReduce。在此设置中,整个 H2D-AllReduce-D2H 链在 ARM 核上完全异步执行。因此,它消耗零 AICore 周期,且从不阻塞 EngineCore 线程。
Multi MTP 与全图。 在 NPU 图模式中支持推测解码引入三个复合工程挑战,我们解决如下:(1) Multi-MTP 集成:我们完成缺失的框架侧调用逻辑,确保正确执行流进入指定 MTP 层。(2) 全图支持:除传统 Decode-Only 模式外,我们的 omnipnu 运行时引入全图模式。在此模式下,即使令牌极少的请求(例如 1-3 个令牌)也被强制进入静态图,避免昂贵的图捕获重新编译,并保证解码步骤在 PD(预填充-解码)分离部署下一致地在图模式中运行。为实现此目标,算子原生接受通过 query_start_loc 具有动态边界的 TND(Token × Num_heads × Dim)输入,而草稿器在填充模式下运行并调整图控制逻辑。(3) 通信优化:在 multi-MTP 填充模式中,草稿模型的输入形状与目标模型完全对齐,这允许我们安全跳过预草稿 DP all-reduce。结果,每个解码步骤节省一次 all-reduce 操作,带来随 DP 大小线性扩展的每步性能增益。
LoPT:无损并行分词加速框架。 随着上下文长度增长(高达 1M 令牌),主流分词器(BPE、WordPiece)固有的顺序性使分词成为不可忽视的瓶颈。朴素分块并行分词遭受边界伪影:相同子串在不同位置可能分词不同。我们提出 LoPT 45,它保留重叠拆分但用"字符位置匹配"替换"令牌 ID 匹配"------记录每个令牌的字符起始/结束位置并按位置而非 ID 匹配,从根本上解决上下文引起的歧义。LoPT 产生与串行分词严格相同的输出(在代码、自然语言和多语言文本上 100% 准确),并在 16 核 CPU 上实现 3-5 倍加速,重叠开销低于 5%。LoPT 与令牌级 APC 深度集成,避免单令牌错位导致 APC 哈希匹配失败。详情见附录 A.9。
6.6 性能结果
6.6.1 模型架构理论分析
我们分析 openPangu-2.0 混合 DSA:SWA 架构在长上下文预填充和解码工作负载下的注意力效率。
注意力效率。 长上下文服务开销由预填充计算、驻留 KV 缓存内存和解码缓存流量主导。我们部署 1:2 比率的动态稀疏注意力(DSA)与滑动窗口注意力(SWA):SWA 将注意力限制在固定窗口 W,而 DSA 通过轻量级闪电索引器扫描全局上下文,并仅对 top-K 选定令牌执行核心注意力。
表 7:openPangu-2.0 低延迟吞吐量。
| 模型 | ISL + OSL | TPOT (ms) | 批次大小 | TPS(每 NPU 令牌/秒) |
|---|---|---|---|---|
| openPangu-2.0-Flash | 8K+1K | 16.2 | 48 | 2963 |
| openPangu-2.0-Flash | 128K+8K | 13.0 | 24 | 1846 |
| openPangu-2.0-Pro | 8K+1K | 23.2 | 40 | 1727 |
| openPangu-2.0-Pro | 128K+8K | 18.1 | 24 | 1326 |
在真实数据和真实工作负载下,单批次输入序列长度 128K,实测 Flash 模型 TTFT 为 2.6 秒,Pro 模型 TTFT 为 3.0 秒;见图 8。
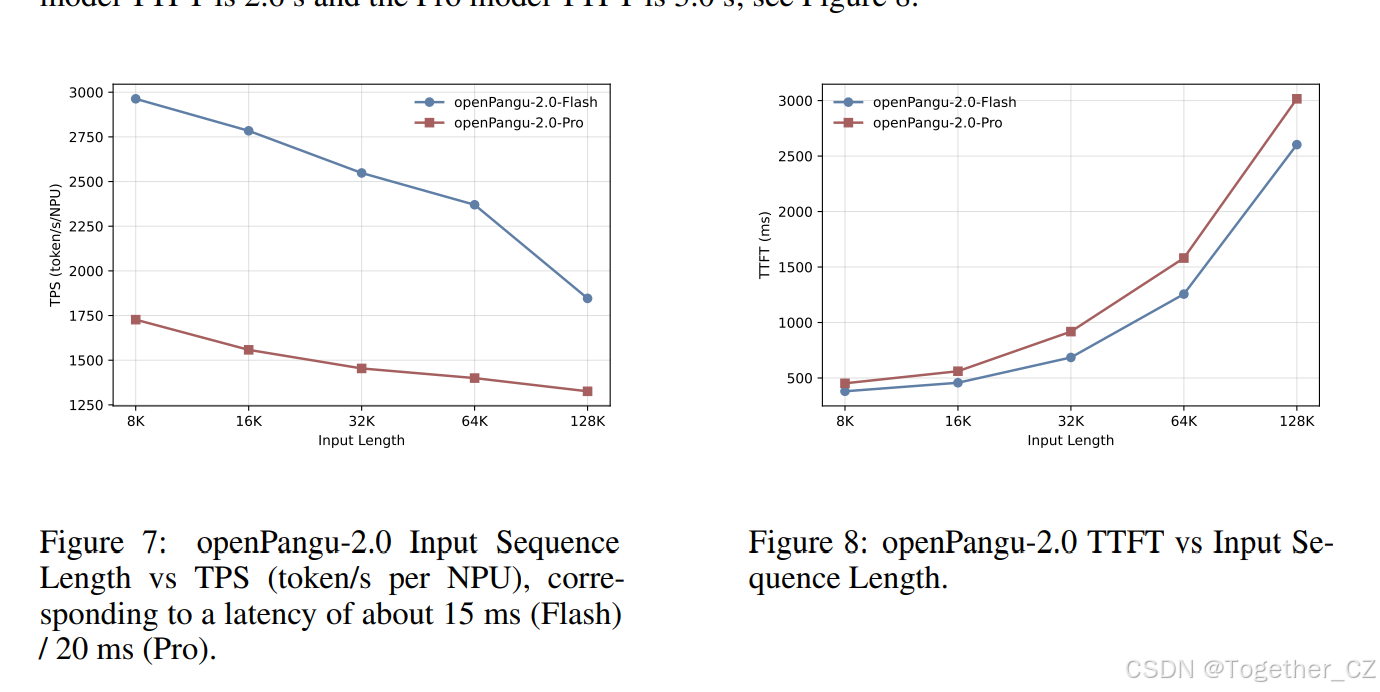
图 7:openPangu-2.0 输入序列长度 vs TPS(每 NPU 令牌/秒),对应约 15 ms(Flash)/ 20 ms(Pro)延迟。图 8:openPangu-2.0 TTFT vs 输入序列长度。
7 结论与未来工作
我们介绍了 openPangu-2.0,一个旨在赋能能够进行一致长上下文推理的智能体的全栈升级。通过以昇腾平台为中心的严格软硬件协同设计方法论,我们解决了大规模 MoE 训练、长时程对齐和推理效率的关键瓶颈。通过将架构创新与专用推理引擎(利用定制算子优化、高级并行和异步调度)协同,openPangu-2.0 系列实现了卓越的推理延迟和吞吐量。全面评估表明,在标准通用、STEM 推理和智能体基准上具有高度竞争力的性能。关键的是,我们的愿景超越静态基准熟练度,优先考虑真实世界系统效用。openPangu 战略定位为驱动智能设备、汽车系统、ICT 基础设施和华为云中智能体应用的核心竞争力。同时,我们正积极扩展边缘原生能力,利用麒麟芯片架构推动端侧智能的边界。
虽然基础缩放定律继续驱动性能,但扩展焦点正从静态知识吸收转向长轨迹、交互式数据------从被动知道模型向主动行动智能体系统的转变。为驱动这一演进,我们的研究路线图仍锚定昇腾硬件生态系统,我们将扩展基于沙箱的合成流水线,在复杂、开放式场景中生成大规模、高保真执行数据集。在未来几个月,通过模型的 successive 迭代,我们的目标是系统性地增强 openPangu 在代码智能和复杂智能体工作流中的核心能力。最终,这种执行驱动的方法旨在精炼模型的底层认知架构,产生能够在动态真实世界环境中推理和解决多步工作流的自主智能体。