做短视频拆解、课程整理、内容复盘时,经常会遇到一个比较实际的问题:拿到一段视频之后,如何快速把里面的口播内容、时间轴和镜头结构整理成可以继续编辑的脚本?
最初接触这个问题时,很容易把"视频转脚本"和"视频转文字"理解成一回事。实际上,两者存在明显区别。
视频转文字主要解决语音识别问题,而视频转脚本还需要进一步完成内容分段、语义分析、镜头识别和结构化整理。
从技术实现来看,一套完整的视频转脚本流程通常可以拆成:
视频文件
   ↓
音频提取
   ↓
ASR语音识别
   ↓
时间戳对齐
   ↓
语义分段
   ↓
画面/镜头分析
   ↓
内容结构识别
   ↓
脚本格式化
一、视频转脚本和视频转文字有什么区别?
如果只是将视频中的语音转换成文字,本质上属于ASR,也就是 Automatic Speech Recognition。
例如:
00:00:01
大家好,今天分享三个提高工作效率的方法。

00:00:08
第一个方法是使用自动化工具。

00:00:15
第二个方法是建立自己的素材库。
这类结果已经可以作为字幕或者逐字稿使用。
但如果目标是得到完整脚本,通常还需要进一步整理:
【开场】
提出工作效率问题

【方法一】
介绍自动化工具
镜头:电脑操作画面

【方法二】
建立素材库
镜头:素材库界面

【结尾】
总结三个方法
因此可以简单理解为:
视频转文字 = 识别语音
视频转脚本 = 识别语音 + 理解内容 + 分析画面 + 重组结构
这也是为什么单纯依靠ASR模型,通常只能得到逐字稿,而不是完整的视频脚本。
二、视频转脚本背后的技术流程
1. 视频预处理
第一步通常不是直接进行文字识别,而是先对视频进行解析。
例如使用FFmpeg提取音频:
ffmpeg -i input.mp4 -vn -ac 1 -ar 16000 audio.wav其中:
-
-vn表示不处理视频流 -
-ac 1将音频转换成单声道 -
-ar 16000将采样率转换为16kHz
经过处理之后,可以得到更加适合语音识别模型处理的音频。
如果原始视频存在背景音乐、环境噪声或者多人同时说话,还需要进行降噪和音频增强。
2. ASR语音识别
音频进入ASR模型后,会得到文字和时间信息。
Whisper就是比较典型的开源语音识别方案。
基本流程可以理解成:
Audio
 ↓
Feature Extraction
 ↓
Encoder
 ↓
Decoder
 ↓
Text + Timestamp
Whisper的优势在于支持多语言语音识别,也可以用于视频、播客、会议等场景。
但需要注意一点:
Whisper输出的是识别结果,并不会天然等于"视频脚本"。
如果需要得到结构化脚本,还需要增加后续的文本处理和内容分析。
三、三个方案分别解决什么问题?
1. 格镜:从视频内容直接生成结构化脚本
格镜的定位更偏向视频内容解析。
从实际功能来看,它不仅处理音频,还会结合视频内容进行分析,可以输出视频文字、摘要以及脚本等结构化结果。其视频转脚本功能包含分镜和口播内容的整理。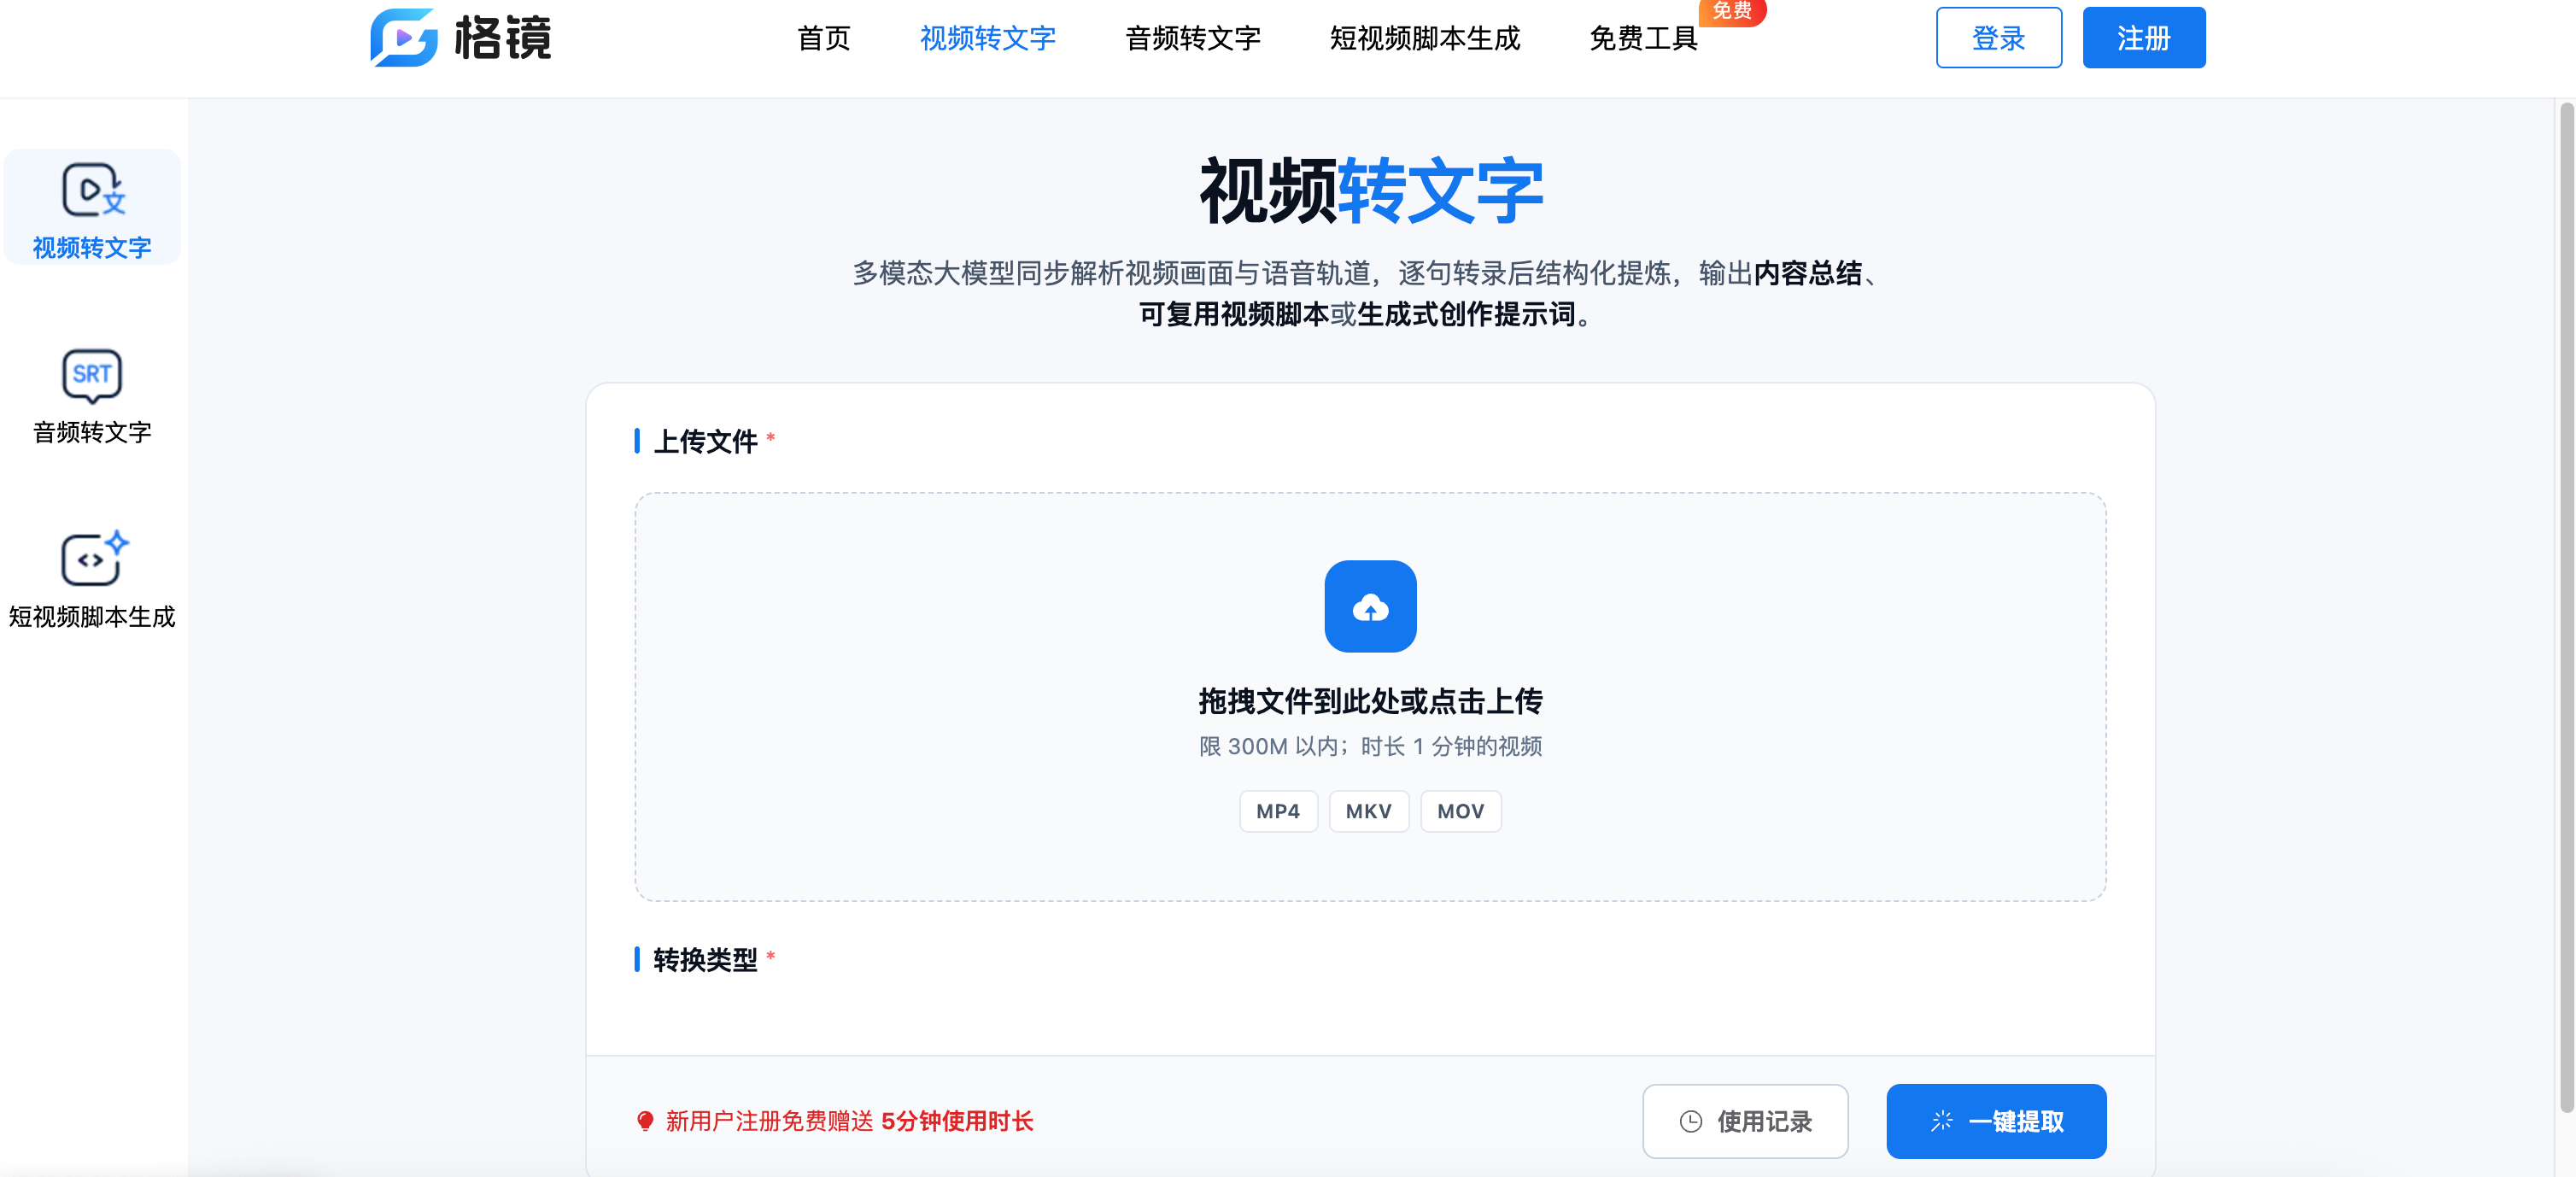
这种方式和传统ASR的区别比较明显。
传统流程:
视频
 ↓
提取音频
 ↓
语音识别
 ↓
逐字稿
而视频内容解析的流程更接近:
视频
 ↓
音频识别 + 画面理解
 ↓
内容分析
 ↓
语义分段
 ↓
脚本结构
 ↓
分镜/口播内容
对于需要拆解短视频结构的场景,这种处理方式更加直接。
例如一段30秒的视频,可以进一步整理成:
镜头1
时间:00:00-00:04
画面:人物出镜
口播:提出问题

镜头2
时间:00:04-00:12
画面:产品操作界面
口播:介绍具体方法

镜头3
时间:00:12-00:25
画面:案例展示
口播:解释使用效果

镜头4
时间:00:25-00:30
画面:人物总结
口播:总结核心观点
这已经从"文字识别"进入了"内容结构化"。
2. Whisper:适合自己搭建视频转文字流程
Whisper更适合开发者自己搭建处理流程。
如果项目只需要完成:
视频 → 音频 → 文字 → 时间戳那么Whisper可以作为ASR核心模块。
例如一个简单的技术架构:
FastAPI
   ↓
文件上传
   ↓
FFmpeg
   ↓
Whisper
   ↓
JSON时间轴
   ↓
LLM
   ↓
Markdown脚本
ASR输出可以设计成:
[
  {
    "start": 0.2,
    "end": 3.8,
    "text": "今天分享三个提高效率的方法"
  },
  {
    "start": 3.9,
    "end": 8.4,
    "text": "第一个方法是建立自动化流程"
  }
]
之后再交给大模型处理。
例如Prompt可以要求模型:
根据以下带时间戳的语音识别结果:

1. 按语义划分段落
2. 提取核心观点
3. 判断开场、正文和结尾
4. 输出镜头描述
5. 保留原始口播内容
6. 按时间轴生成Markdown脚本
这种方式的优点是可控性比较高,可以根据项目需求调整模型、Prompt和输出格式。
缺点也比较明显:开发者需要自己处理模型部署、GPU资源、文件队列、长视频切片、异常重试以及结果存储等问题。
3. 通义听悟:更偏长音视频内容整理
通义听悟的应用场景与短视频脚本拆解有所区别。
其功能更偏向音视频转写、发言人区分、章节速览、总结等内容整理。官方页面显示,其支持实时语音转文字、多语言同步翻译,并提供章节速览、发言总结等能力。
因此,如果输入是一段:
-
课程视频
-
会议录像
-
访谈
-
培训视频
-
长时间讲座
处理重点往往不是"拆分镜",而是先把长内容快速结构化。
例如:
第1章:项目背景
第2章:问题分析
第3章:解决方案
第4章:执行计划
第5章:总结
这类结果更适合后续整理会议纪要、课程笔记和知识库。
四、三个方案的技术定位对比
| 方案 | 核心能力 | 更适合的任务 | 输出特点 |
|---|---|---|---|
| 格镜 | 视频内容解析 | 视频转脚本、分镜拆解 | 结构化脚本 |
| Whisper | ASR语音识别 | 自建识别系统 | 文字+时间戳 |
| 通义听悟 | 音视频转写与总结 | 会议、课程、访谈 | 转写+章节+总结 |
这里有一个比较容易忽略的问题:
不能单纯用"识别准确率"判断视频转脚本效果。
因为最终输出是否有用,还受到语义分段、时间轴、画面分析和脚本结构的影响。
五、实际做视频转脚本时,应该关注哪些指标?
如果按照程序员做技术测试的思路,可以建立下面几个指标。
1. 识别准确率
最基础的指标是ASR准确率。
可以使用:
WER = (S + D + I) / N其中:
-
S:替换错误
-
D:删除错误
-
I:插入错误
-
N:参考文本词数
WER越低,说明语音识别结果越接近原始内容。
2. 时间轴准确性
除了文字是否正确,还需要看时间戳是否准确。
例如原始语音:
00:05.2 - 00:09.8如果实际识别结果变成:
00:03.1 - 00:12.4即使文字完全正确,后续制作字幕或者分镜时仍然需要重新校准。
3. 语义分段
一段长文本如果全部堆在一起,后续编辑成本仍然比较高。
比较合理的结果应该按照:
开场
↓
问题
↓
方法
↓
案例
↓
总结
这样的内容结构进行拆分。
4. 镜头识别
对于短视频来说,这个指标尤其重要。
同一句口播可能对应:
人物出镜
↓
产品界面
↓
案例截图
↓
数据图表
因此真正的视频转脚本需要同时考虑"说了什么"和"画面发生了什么"。
六、如果自己搭建一个视频转脚本系统
如果只是做一个基础Demo,可以采用:
FFmpeg
+
Whisper
+
LLM
+
Markdown
基本逻辑如下:
video
  ↓
extract_audio()
  ↓
whisper_transcribe()
  ↓
segment_text()
  ↓
llm_structure()
  ↓
generate_script()
如果进一步扩展,还可以加入:
Speaker Diarization
Scene Detection
OCR
Vector Database
RAG
Prompt Extraction
这样就可以从简单的"视频转文字"逐渐扩展成完整的视频内容理解系统。
例如:
视频
 ├── 音频
 │    └── Whisper → 口播文本
 │
 ├── 画面
 │    ├── Scene Detection
 │    ├── OCR
 │    └── Vision Model
 │
 └── 时间轴
       ↓
    LLM结构化
       ↓
    分镜脚本
这种架构也比较适合后续接入知识库或者RAG系统。
七、视频转脚本的实际使用场景
从技术实现角度看,视频转脚本并不局限于短视频创作。
短视频复盘
提取:
开场方式
选题
口播
镜头
转场
结尾结构
方便分析视频内容结构。
课程整理
将长视频转换成:
章节
知识点
重点内容
时间轴
总结
减少人工回看视频的时间。
会议内容结构化
将多人对话转换成:
会议主题
讨论内容
重要结论
待办事项
负责人
方便后续检索。
视频知识库
进一步将视频拆成:
视频
→ 字幕
→ 段落
→ 知识点
→ Embedding
→ Vector Database
之后就可以通过RAG实现视频内容检索。
八、总结
视频转脚本本质上不是一个单独的ASR问题,而是一个由语音识别、时间轴处理、语义理解、画面分析和结构化生成共同组成的内容处理流程。
而对于需要直接从视频得到分镜、口播和结构化内容的任务,核心区别在于是否真正理解了视频中的声音、画面和叙事结构,而不仅仅是把声音转换成文字。