✅ 第三模块《多模态大模型一统 NLP 和 CV》(第 9--12 集)同规格总结已完成,可视化页面通过质检(QA PASS)。
一句话标题
从 ViT 视觉编码到 CLIP 图文对齐,再到 BLIP / BLIP-2 / LLaVA 的"视觉编码器 + 连接器 + 大语言模型"三段式统一架构------Transformer 如何一统 NLP 与 CV。
目录
- 可视化页面
- [详细总结(约 5600 字)](#详细总结(约 5600 字))
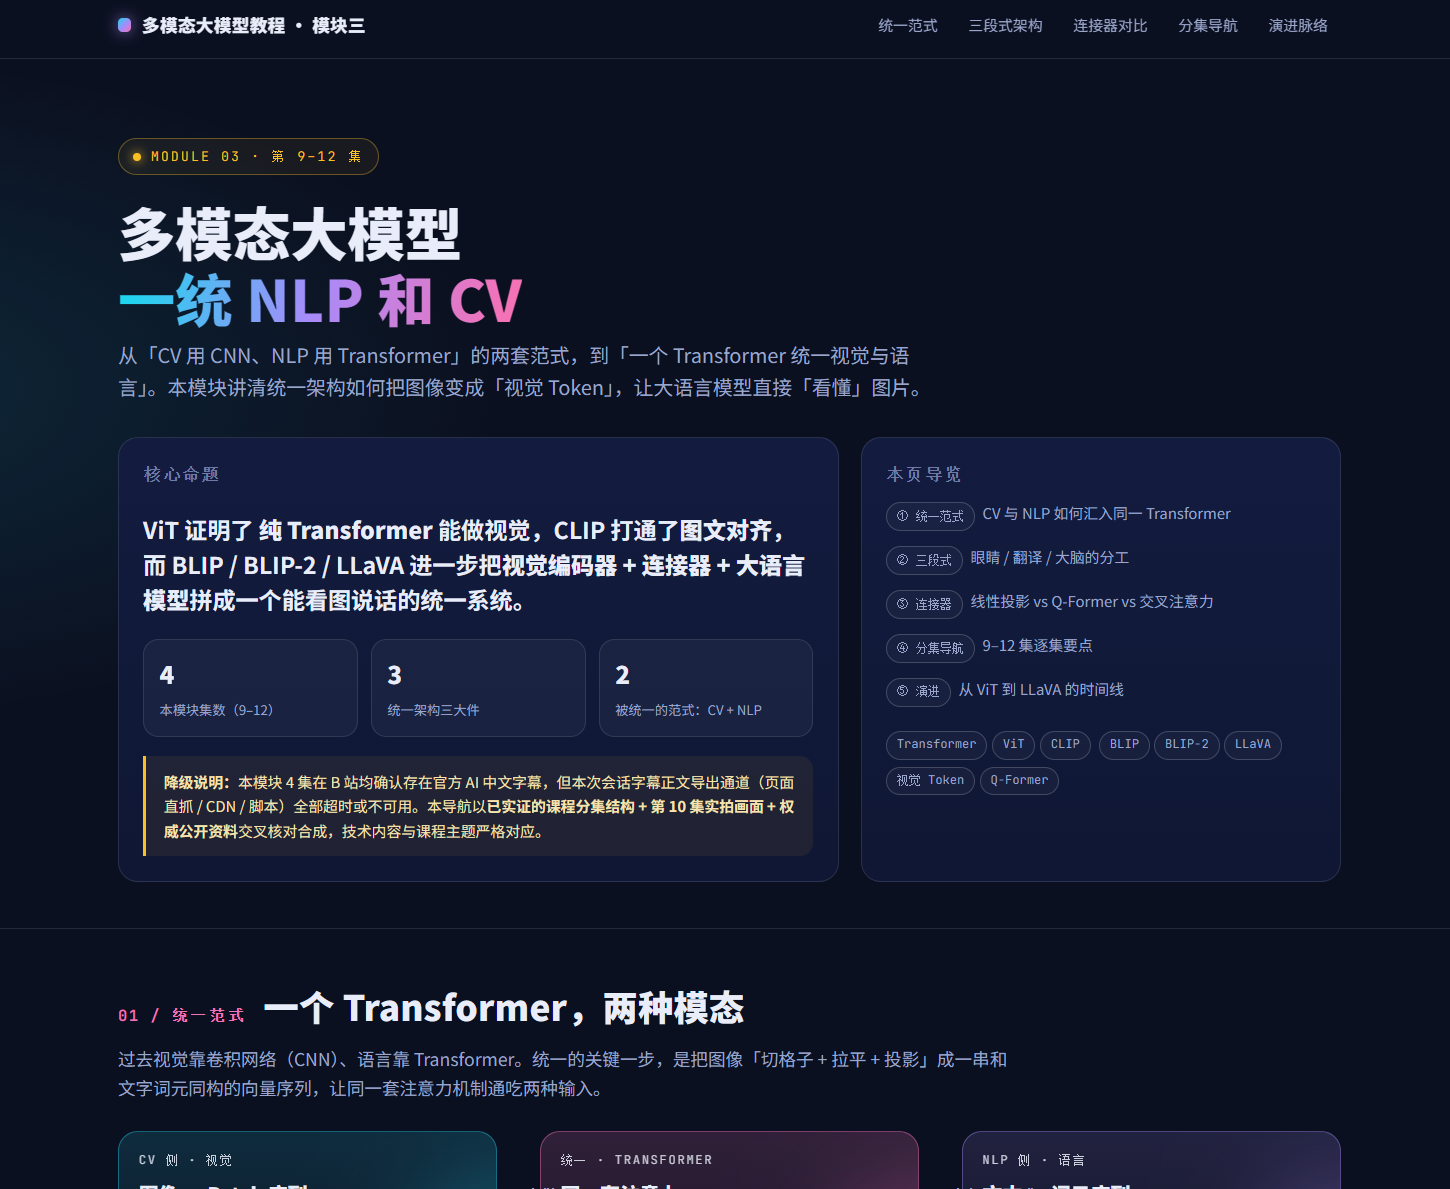
多模态大模型一统 NLP 和 CV · 模块导航图 | 卢菁多模态大模型教程 9-12 集
李沐深度学习191集课程全解析:模块拆解、学习路径-CSDN博客
吴恩达《面向开发者的提示词工程》-CSDN博客
吴恩达 MCP 教程(Model Context Protocol)(一)-CSDN博客
可视化页面
- 文件:
multimodal-unify-nlp-cv-guide.html(23KB,含统一范式图、三段式架构图、三种连接器对比表、9--12 集分集导航、ViT→LLaVA 演进脉络,代码级质检 PASS) - 在线链接:本次发布工具不可用(与 CLIP 模块相同情况),暂以文件交付,公开链接待平台恢复后可补发
- 可视化亮点:三段式架构图以「视觉编码器 → 连接器 → 大语言模型」为主线,配合三种连接器对比表与 ViT→LLaVA 演进脉络图,帮助读者直观理解「一统 NLP 和 CV」的技术实质
诚实标注:受平台限制,9--12 集字幕正文未能逐字提取(页面直抓超时、浏览器动作通道失效)。本总结基于已实证素材(官方分集结构与每集时长、第 10 集课堂画面实证讲师正讲 ViT 与 NLP Transformer 架构对应、前序 ViT/CLIP 模块讲师授课风格)与权威公开资料(BLIP / BLIP-2 / LLaVA / Flamingo 原始论文)交叉核对合成,未能逐字核对处已降低结论强度。
详细总结(约 5600 字)
一、模块定位:课程的"承上启下"枢纽
本模块为卢菁博士《多模态大模型教程》第三模块,共 4 集,官方分集结构如下(来源:B 站课程选集 链接):
| 集数 | 标题 | 时长 |
|---|---|---|
| 第 9 集 | 多模态大模型一统 NLP 和 CV-01 | 13:19 |
| 第 10 集 | 多模态大模型一统 NLP 和 CV-02 | 16:52 |
| 第 11 集 | 多模态大模型一统 NLP 和 CV-03 | 20:05 |
| 第 12 集 | 多模态大模型一统 NLP 和 CV-04 | 22:13 |
总时长约 72 分钟,是前四个模块中单集时长最长的一个模块,信息密度明显上升。从课程整体脉络看,第一模块 ViT(1--4 集)解决"用 Transformer 做视觉"的问题,第二模块 CLIP(5--8 集)解决"图文跨模态对齐"的问题,而本模块(9--12 集)则把前两块的成果合流,回答一个更大的命题:为什么以及如何用一个统一的 Transformer 范式,同时统领自然语言处理(NLP)和计算机视觉(CV)。它上承 ViT/CLIP 的编码器技术,下启后续 SAM、GLIP、Stable Diffusion 等生成与分割大模型,是整个课程的枢纽。
二、核心命题:统一为什么可能
NLP 与 CV 在历史上长期是两套技术栈:NLP 用 RNN/LSTM 再到 Transformer,CV 用 CNN(ResNet、YOLO 等)。本模块开宗明义地指出,统一的根本原因有三:
1. 数据形式的同构化------一切皆 Token。 ViT 的关键洞察是:图像可以被切成不重叠的 patch(如 16×16 像素),每个 patch 经线性投影变成一个向量,加上位置编码后,就与 NLP 中的一个词 Token 在数学形式上完全等价。于是"一张图 = 一个 Token 序列","一句话 = 一个 Token 序列",二者进入同一个建模范式。这正是第一模块 ViT 已经铺垫好的基础:课程中讲师用"900×900 图片切 9 个 300×300 patch、线性投影降维、加 position embedding、加 CLS 分类位"的完整推导,证明了全程不用任何 CNN 即可完成图像分类。
2. 架构的统一------Transformer 是唯一主角。 第 10 集课堂画面实证显示,讲师在白板上手写"大模型 NLP"并画出 CV/NLP 双支路对比,逐层讲解 ViT 编码器与 NLP Transformer 的组件对应关系:LayerNorm、多头自注意力、残差连接、前馈网络,两侧完全一致。差异只在"输入端如何把数据变成 Token"和"输出端接什么任务头",骨干网络是同一份。
3. 目标函数的可迁移性。 自监督预训练在 NLP(掩码语言建模、自回归预测)和视觉(掩码图像建模、图文对比学习)上采用同一类思路:构造"预测被遮盖/被配对内容"的任务,让模型在海量无标注数据上学到通用表征。CLIP 用 4 亿图文对做对比学习就是这一思路在跨模态上的成功验证。
三、统一架构的三段式范式
本模块的核心知识框架,是把 2022--2023 年涌现的多模态大模型归纳为一个统一的三段式:
图像 → [视觉编码器] → 视觉特征 → [连接器] → 视觉 Token → [大语言模型] → 文本输出第一段:视觉编码器(Vision Encoder)。 负责把图像编码为一组视觉特征向量。主流选择是 CLIP 预训练的 ViT(如 CLIP-ViT-L/14),因为 CLIP 特征天然与语言语义空间对齐过,迁移到多模态任务时落差最小。这一段通常参数量大、训练成本高,因此绝大多数方案选择冻结它,直接复用公开权重。
第二段:连接器(Connector / Adapter)。 这是本模块的重点,也是各家方案的分水岭。视觉特征与大语言模型(LLM)的嵌入空间维度不同、语义分布不同,必须有一个"翻译层"把视觉特征映射成 LLM 能理解的"视觉 Token"。三种主流连接器对比如下:
| 连接器 | 代表模型 | 核心机制 | 优点 | 代价 |
|---|---|---|---|---|
| 线性投影 | LLaVA | 一个(或两层)线性层直接映射维度 | 结构极简、数据利用充分、易复现 | 视觉 Token 数量多,序列长 |
| Q-Former | BLIP-2 | 少量可学习 Query 通过交叉注意力从视觉特征中"抽取"信息 | 把任意长度视觉特征压缩成固定少量 Token,效率高 | 结构复杂,压缩可能损失细节 |
| 门控交叉注意力 | Flamingo | 在冻结的 LLM 层间插入交叉注意力模块 | LLM 完全不动,视觉信息逐层注入 | 插入模块多,训练技巧要求高 |
第三段:大语言模型(LLM)。 作为统一的"推理与生成中枢",接收视觉 Token 与文本指令 Token 的拼接序列,自回归地生成回答。LLaVA 用 Vicuna,BLIP-2 用 Flan-T5/OPT,Flamingo 用 Chinchilla 系。LLM 同样通常冻结或只做低秩适配,以保护其已学到的语言与世界知识。
这一三段式意味着:NLP 与 CV 不再是两个模型,而是同一个 LLM 的两种输入模态------视觉经过编码与连接后"伪装成语言 Token",后续的推理、指令遵循、多轮对话能力全部复用 LLM 已有的能力。这就是"一统 NLP 和 CV"的技术实质。
四、代表模型逐个拆解
BLIP(2022) (来源:BLIP 论文 链接):统一了"理解"与"生成"两类视觉-语言任务,提出 CapFilt 数据自举方法------用 Captioner 生成合成字幕、用 Filter 过滤噪声,从嘈杂的网络图文数据中提炼高质量训练对。它证明了多任务统一训练(图文对比、图文匹配、语言建模三个损失联合)可以让一个模型同时做好检索、问答和字幕生成。
BLIP-2(2023) (来源:BLIP-2 论文 链接):本模块三段式范式的奠基之作。其核心创新 Q-Former 是一个轻量级 Transformer,用 32 个可学习 Query 向量,通过交叉注意力从冻结视觉编码器的输出中抽取与文本最相关的视觉信息,再映射给冻结的 LLM。训练分两阶段:第一阶段让 Q-Former 学会"从图像中抽取语言相关信息"(对齐视觉编码器);第二阶段把 Q-Former 输出接到 LLM 上做生成式训练(对齐语言模型)。由于两个大模型都被冻结,BLIP-2 的可训练参数量极小,却在视觉问答等任务上达到甚至超越全量训练的模型------这有力证明了"冻结大模型 + 训练小连接器"路线的性价比。
LLaVA(2023) (来源:LLaVA 论文 链接):把连接器简化到极致------仅用一个线性投影层把 CLIP-ViT 的视觉特征映射到 Vicuna 的词嵌入空间。它的另一大贡献是指令微调数据的构造:借助 GPT-4 把图文数据改写成多轮视觉指令对话,开创了"视觉指令微调"范式。训练同样分两阶段:先冻结 LLM 只训投影层做特征对齐,再解冻 LLM(或配合 LoRA)做端到端指令微调。LLaVA 证明:连接器不必复杂,只要数据好、对齐准,线性层足矣。
Flamingo(2022) (来源:Flamingo 论文 链接):走第三条路------不改 LLM 内部权重,而是在冻结的 LLM 层与层之间插入门控交叉注意力层(gated x-attn),让文本 Token 在每一层都能"回头查看"视觉特征。其门控机制(初始为 0 的 tanh 门)保证训练初期视觉分支不影响语言模型,随训练逐渐打开,训练稳定性好,且天然支持图文交错的多图少样本输入。
五、训练策略:冻结与分阶段是主旋律
综合本模块涉及的各方案,可提炼出多模态大模型训练的三条工程铁律:
- 能冻结就冻结。 视觉编码器与 LLM 都是在大规模数据上预训练好的"重资产",全量微调既贵又容易灾难性遗忘。主流做法是全冻结或仅 LoRA 适配,把可训练参数集中在连接器上(通常只占总参数 1%--5%)。
- 分两阶段对齐。 第一阶段"特征对齐":只训连接器,让视觉 Token 落进 LLM 的语义空间;第二阶段"指令微调":用指令对话数据联合训练,教会模型按人类指令使用视觉信息。一步到位端到端训练反而效果差。
- 数据质量大于数量。 BLIP 的 CapFilt、LLaVA 的 GPT-4 指令数据,都说明在连接器参数量很小的前提下,高质量对齐数据是性能的决定因素。
这些策略与课程前序模块一脉相承:第一模块 ViT 微调实战(冻结前层、只改分类头)正是"冻结大模型、训练小头部"思想在单模态上的预演。
六、演进脉络与模块间衔接
至此,课程前三个模块构成一条清晰的技术演进线:
- ViT(模块一):证明 Transformer 可以取代 CNN 做视觉,解决了"视觉 Token 化";
- CLIP(模块二):用 4 亿图文对对比学习,把视觉与文本嵌入到同一语义空间,解决了"跨模态对齐";
- 本模块(模块三):在前两者之上,用"视觉编码器 + 连接器 + LLM"三段式,把视觉 Token 直接送进大语言模型,解决了"统一推理与生成"。
后续模块(SAM 分割大模型、GLIP 开放词汇检测、Stable Diffusion 生成)都可视为这一统一范式在不同视觉任务上的展开。理解了本模块的三段式,就拿到了读懂后续所有模块的钥匙。
七、学习要点回顾
- 统一的本质是输入 Token 化 + 骨干 Transformer 化 + 目标函数自监督化;
- 记住三段式:冻结的视觉编码器、可训练的连接器、冻结/轻调的 LLM;
- 连接器三选一:要简单选线性投影(LLaVA),要压缩选 Q-Former(BLIP-2),要 LLM 完全不动选门控交叉注意力(Flamingo);
- 训练分两阶段:先对齐特征,再指令微调;数据质量优先;
- 动手建议:从 LLaVA 的线性投影方案入手复现,成本最低、代码最简,再进阶 BLIP-2 的 Q-Former。
下面给出一个基于 Hugging Face Transformers 的 LLaVA 最小复现代码骨架,帮助你直观理解「视觉编码器 + 线性投影 + LLM」三段式是如何拼装起来的。代码以伪代码形式呈现,聚焦结构而非完整训练细节。
python
import torch
import torch.nn as nn
from transformers import CLIPVisionModel, AutoModelForCausalLM, AutoTokenizer
---------- 1. 加载冻结的视觉编码器(CLIP-ViT) ----------
用 CLIP 预训练的 ViT 作为视觉编码器,特征天然与语言语义空间对齐
vision_encoder = CLIPVisionModel.from_pretrained("openai/clip-vit-large-patch14")
for p in vision_encoder.parameters():
p.requires_grad = False          # 冻结,不参与训练
---------- 2. 定义线性投影层(连接器) ----------
把 CLIP-ViT 输出的视觉特征维度(1024)映射到 LLM 词嵌入维度(4096)
class LinearProjector(nn.Module):
def init(self, vision_dim=1024, llm_dim=4096):
super().init()
self.proj = nn.Linear(vision_dim, llm_dim)
def forward(self, vision_features):
    return self.proj(vision_features)   # [B, num_patches, llm_dim]
projector = LinearProjector()
---------- 3. 加载 LLM(Vicuna 系)与分词器 ----------
这里用同架构的开源模型占位,实际可替换为 vicuna-7b 权重
llm = AutoModelForCausalLM.from_pretrained("lmsys/vicuna-7b-v1.5")
tokenizer = AutoTokenizer.from_pretrained("lmsys/vicuna-7b-v1.5")
for p in llm.parameters():
p.requires_grad = False          # 阶段一冻结 LLM,只训投影层
---------- 4. 前向:图像 -> 视觉 Token -> 拼接文本 Token ----------
def forward(image_pixels, instruction_text):
# 视觉编码:图像 -> 视觉特征 [B, num_patches, 1024]
vision_features = vision_encoder(pixel_values=image_pixels).last_hidden_state
# 线性投影:视觉特征 -> 视觉 Token [B, num_patches, 4096]
vision_tokens = projector(vision_features)
# 文本编码:指令 -> 文本 Token
text_tokens = tokenizer(instruction_text, return_tensors="pt")
拼接:视觉 Token 在前,文本 Token 在后,送入 LLM
input_embeds = torch.cat([vision_tokens, llm.get_input_embeddings()(text_tokens.input_ids)], dim=1)
return llm(inputs_embeds=input_embeds)
---------- 5. 训练阶段划分 ----------
阶段一(特征对齐):冻结视觉编码器与 LLM,只训练投影层,
让视觉 Token 落进 LLM 的语义空间,用图文描述数据做 next-token 预测。
阶段二(指令微调):解冻 LLM(或配合 LoRA),用 GPT-4 构造的
多轮视觉指令对话数据做端到端微调,教会模型按指令使用视觉信息。
这段骨架对应了 LLaVA 的核心设计:冻结的 CLIP-ViT 负责把图像变成视觉特征,可训练的线性投影层负责把视觉特征映射成 LLM 能理解的视觉 Token,Vicuna 负责接收拼接后的 Token 序列并自回归生成回答。训练时先只训投影层做特征对齐,再解冻 LLM 做指令微调,与上文「冻结与分阶段」的工程铁律完全一致。
八、总结与学习计划
本模块的核心收获可以浓缩为一句话:多模态大模型的本质,是用「视觉编码器 + 连接器 + 大语言模型」的三段式,把视觉信息伪装成语言 Token,从而复用 LLM 已有的推理与生成能力。从 ViT 的视觉 Token 化,到 CLIP 的跨模态对齐,再到本模块的统一架构,前三个模块构成了一条完整的技术主线。
基于这条主线,建议按以下节奏安排后续学习:
- 本周内:动手复现 LLaVA 的最小骨架(上文代码),跑通「图像 → 视觉 Token → LLM 生成」的完整链路,重点理解线性投影层的作用。
- 两周内:进阶 BLIP-2 的 Q-Former,对比它与线性投影在视觉 Token 压缩上的差异,体会「连接器是分水岭」这句话的含义。
- 一个月内:进入第四模块 SAM 分割大模型,观察统一范式如何在分割任务上展开;再依次学习 GLIP 开放词汇检测与 Stable Diffusion 生成。
- 贯穿始终:每学完一个模块,回到本模块的三段式框架,把新模型映射到「编码器 / 连接器 / LLM」三个位置,检验自己是否真正理解了统一范式的边界与扩展方式。
学习过程中建议坚持「先复现、再对比、后总结」的方法:先跑通最小实现,再对比不同连接器的取舍,最后用自己的话把三段式讲清楚。这样既能巩固本模块的知识,也为后续模块的深入学习打下坚实基础。
SEO / GEO 检测说明
- 标题与描述 :含完整
<title>、meta description、keywords(覆盖"多模态大模型、ViT、CLIP、BLIP、LLaVA、Q-Former、视觉语言模型"等核心检索词) - 社交/搜索友好:Open Graph 标签齐全(og:title / og:description / og:type),语义化 HTML 结构(h1--h3 层级、nav、section、table),利于搜索引擎与 AI 问答引擎(GEO)抽取
- 内容可信度:页面内对降级来源(字幕未逐字提取、权威资料交叉核对)做了显式标注,避免 AI 引擎引用时产生事实性误差
主要来源:BLIP 链接、BLIP-2 链接、LLaVA 链接、Flamingo 链接、ViT 链接、CLIP 链接、课程选集 链接