大家好,我是数据库小学妹 👋我踩过的坑,你别再踩。
我第一次做信创迁移,评估报告上写着兼容率 95%,功能测试全绿。上线两周后,客服反馈同一个单据被录入两次。我第一反应是不可能。数据是脚本一条条搬过去的,条数能对上,怎么会多出来。
后来把两边的数据摊开,一条条比。问题不在搬,在搬完之后。有一类带空值的联合唯一键,在原来那边算冲突,到新库这边却不算了。就这一条差异,脚本搬得再准也救不回来。
那次教训让我记住了一句话:数据迁移这件事,搬得动只是及格,搬得对才算过关。 今天我们不聊某个工具怎么用,聊一件更靠前的事:数据迁移到底怎么做,才不至于上线两周后又返工。
一、先给结论:数据迁移是一条六步闭环,少一步就得返工
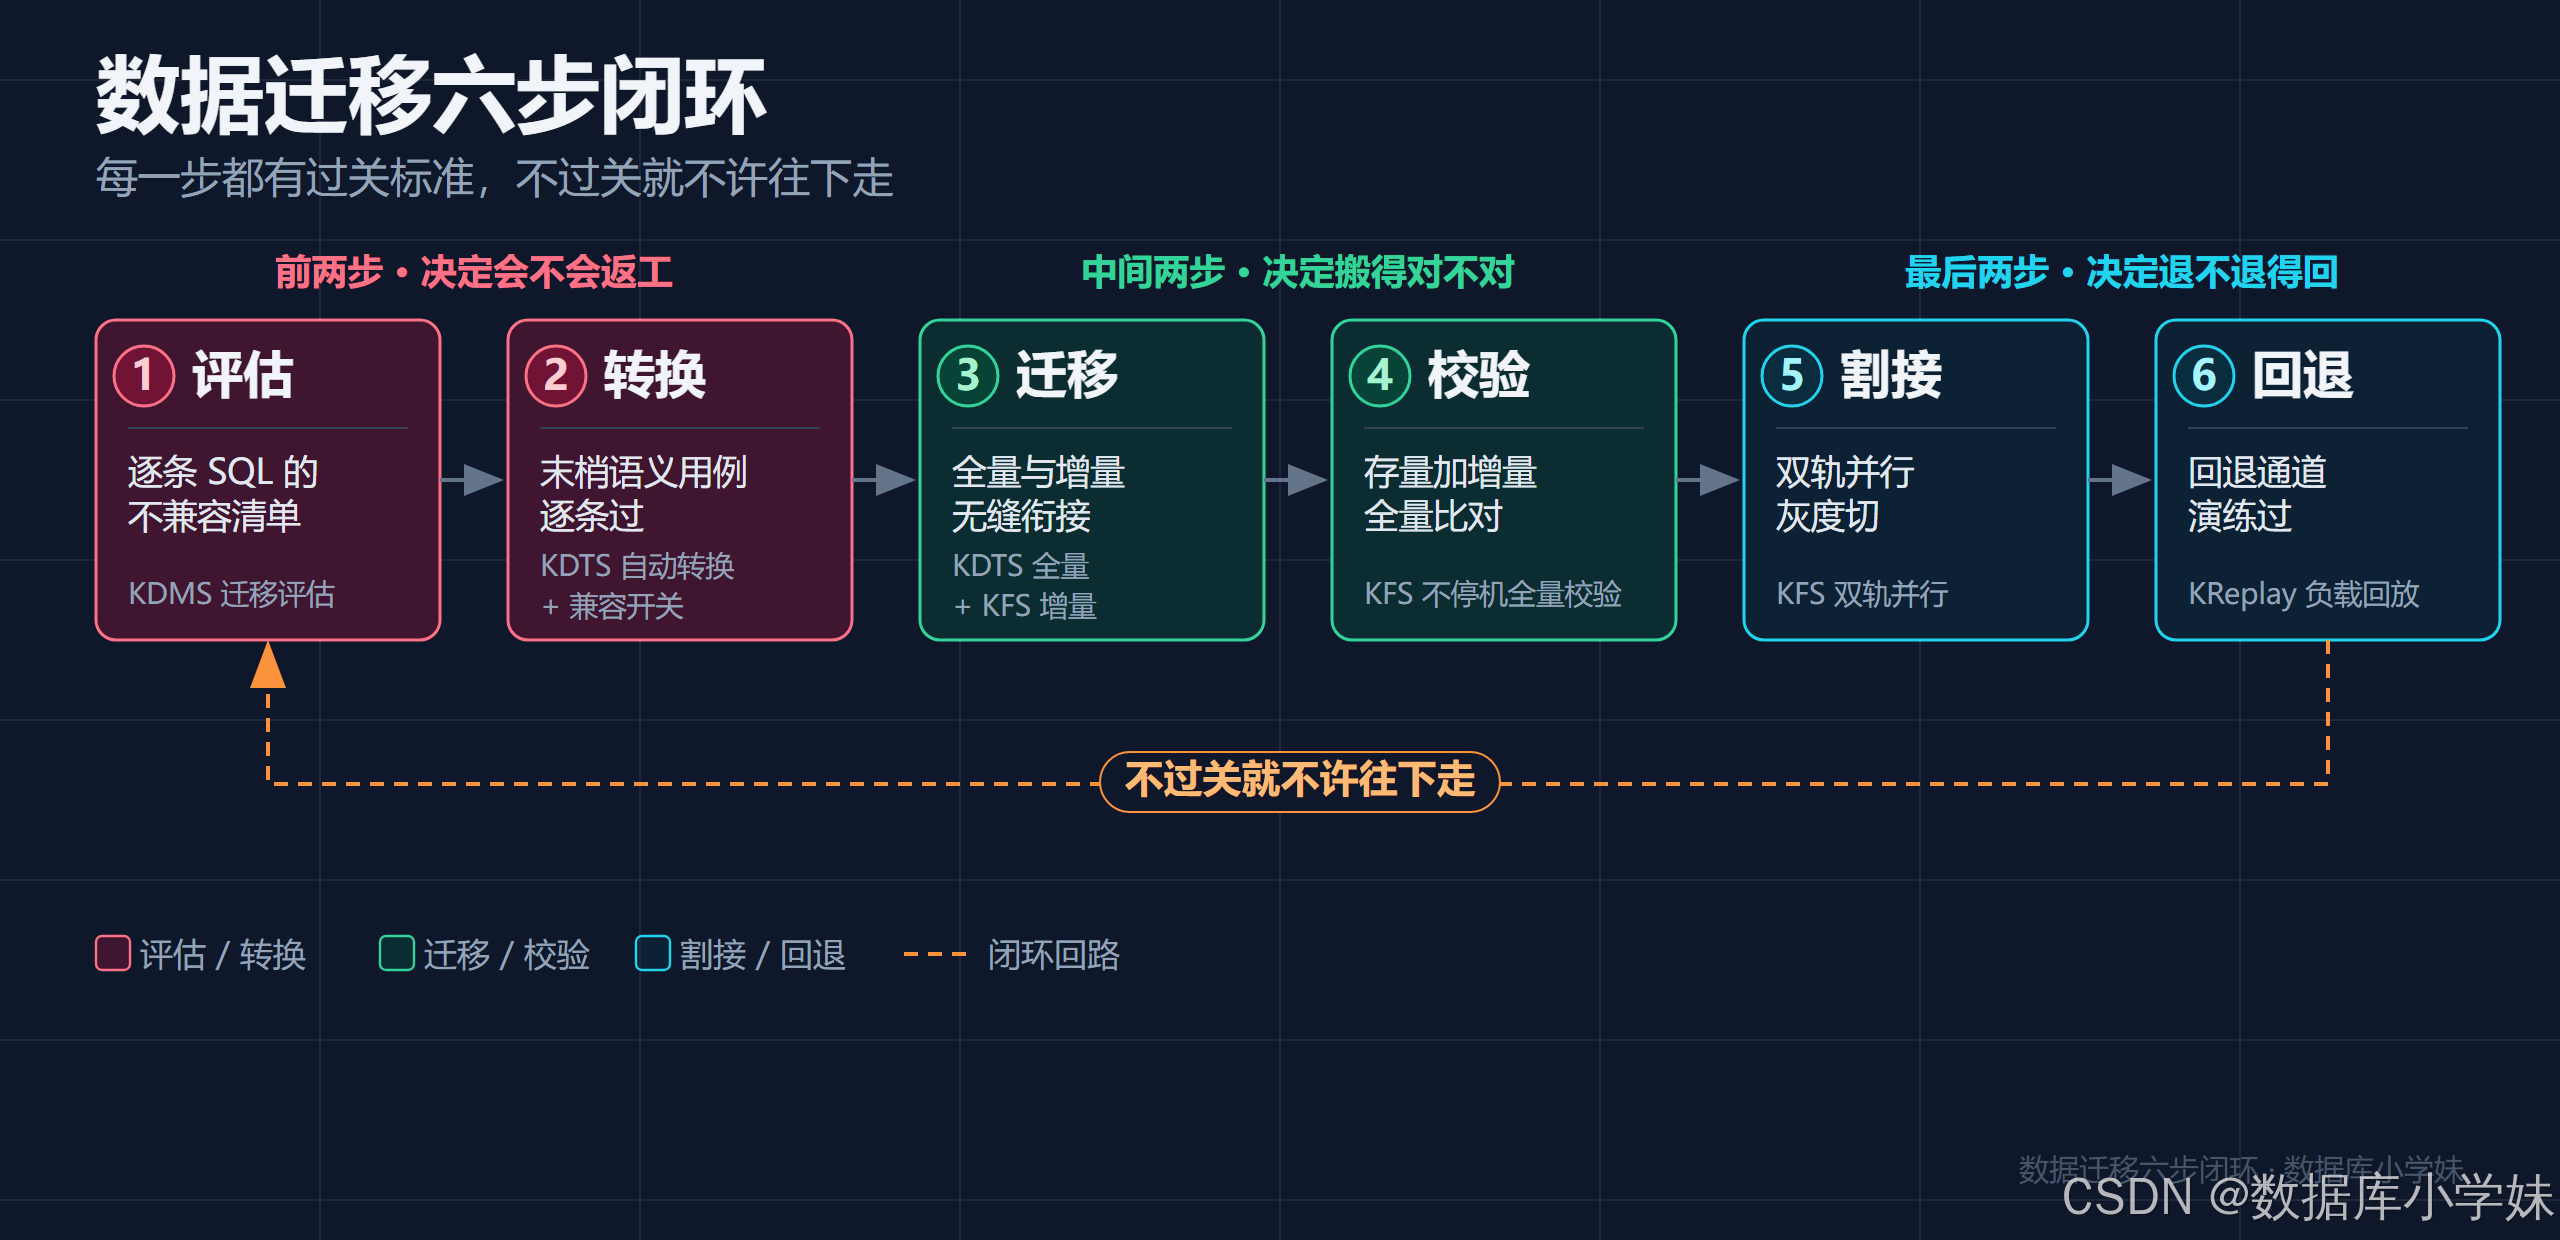
回答上面那个问题,我的答案只有一句:把它当成一条六步闭环,每一步都有过关标准,不过关就不许往下走。
六步分别是评估、转换、迁移、校验、割接、回退。前两步管会不会返工,中间两步管搬得对不对。出事了退不退得回来,看的是最后两步。下面这张表是全文骨架。
| 步骤 | 要回答的问题 | 过关标准 | 金仓对应能力 |
|---|---|---|---|
| ① 评估 | 到底要改多少? | 逐条 SQL 的不兼容清单 | KDMS 迁移评估 |
| ② 转换 | 改完跑得对吗? | 末梢语义用例逐条过 | KDTS 自动转换 + 兼容开关 |
| ③ 迁移 | 数据怎么搬干净? | 全量与增量无缝衔接 | KDTS 全量 + Kingbase FlySync 增量 |
| ④ 校验 | 怎么证明搬对了? | 存量加增量全量比对 | KFS 不停机全量校验 |
| ⑤ 割接 | 什么时候切? | 双轨并行,灰度切 | KFS 双轨并行 |
| ⑥ 回退 | 出事怎么回去? | 回退通道演练过 | KReplay 负载回放 |
二、第一步和第二步:兼容率 95% 是最危险的数字
先说评估。很多项目的评估,是把表、存储过程、触发器数量数一遍,再按"经验比例"估个改造量。我一开始也这么干,觉得心里有数。后来才明白,对象数量说明不了改造量。有的存储过程上千行,早没人调用了;有的触发器只有十几行,却卡在核心交易链路上。只看数量等于没看,真正要盘的是业务依赖度。
兼容率更麻烦。它不是一个数字能概括的,而是要分层。 我把它拆成四层,你可以拿去当验收尺:
- 语法级:语句能不能解析、会不会报语法错。这是门槛,不是目标
- 基础语义级:函数返回值、运算符优先级、隐式转换规则,结果对不对得上
- 末梢语义级:那 5% 藏身的地方,只在生产的高并发和边界条件下才暴露
- 性能级:语义对齐之后还得跑得动,跑批窗口能不能按时关
第三层最难。开头那个空值唯一键的坑,就出在这层。国产数据库想替掉 Oracle,兼容这关必须过。金仓的做法是把差异一个个列成开关:
| 兼容开关 | 影响的语义点 |
|---|---|
ora_input_emptystr_isnull |
空串是否按 NULL 处理 |
ignore_zero_number |
number 类型输出是否忽略末尾连续的 0 |
trunc_compatible |
trunc 函数返回的 timestamp 是否与原库一致 |
nls_length_semantics |
字符串长度按 char 还是 byte 计 |
ora_numop_style |
integer 操作符是否按 numeric 处理 |
ora_open_cursors |
同一会话可同时打开的游标上限 |
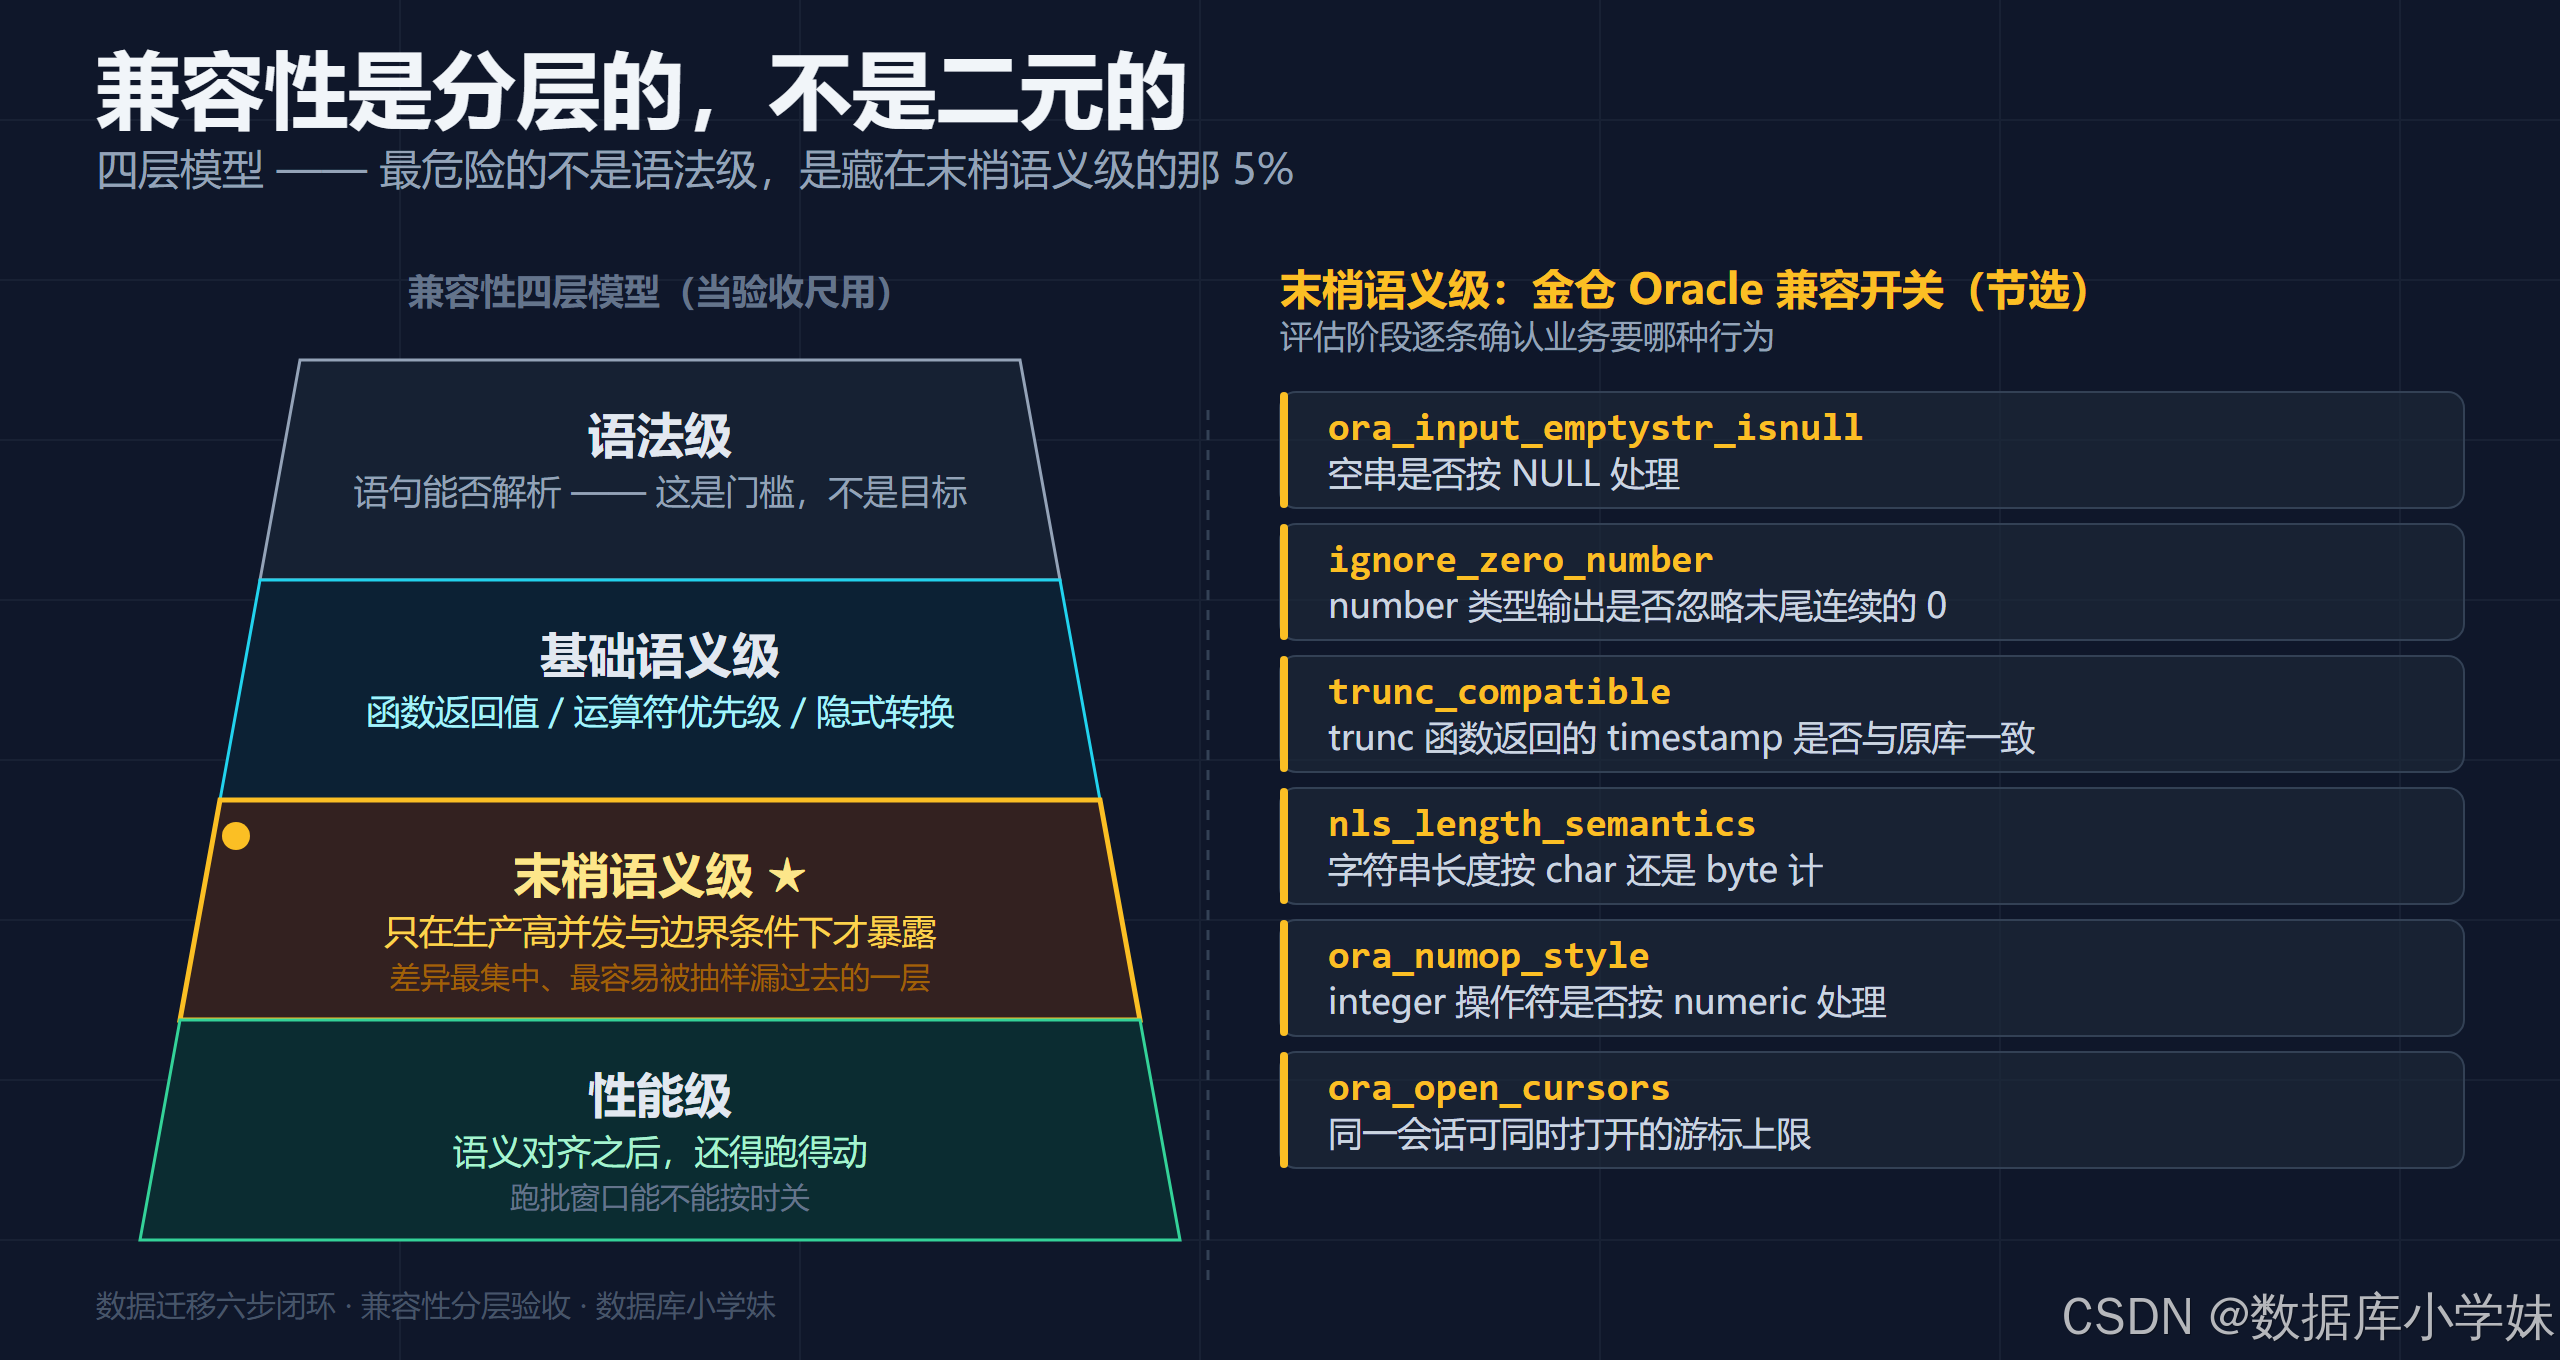
我第一次看到这张表时愣了一下。空串算不算 NULL,number 输出带不带末尾的零,这些细枝末节居然要单独设开关。后来才想通:要一字不差地对齐,就得把差异一条条列出来,而不是含糊地说"高度兼容"。 好处也在这儿:对不上翻个开关就行,不用回头改业务代码。评估阶段要做的,就是拿这张表逐条确认业务要哪种行为。
评估这关过了,才轮到转换。我的体会只有一句:改得越少,风险越小。
改多少,取决于兼容做到了哪一层。语法级靠工具自动转换,语义级得人工啃硬骨头。我在一个真实项目里见过一份改造清单,全是对象类型上的差异:类型继承、子对象赋值给父对象、treat 函数做类型转换、order 函数做实例比较、方法重载。这些在源库能跑,到目标库就得改写。触发器也一样,TRIGGER_NESTLEVEL() 得换成 SYS_TRIGGER_DEPTH(),功能等价,名字变了。
这类活靠人工一条条改,太慢也不保险。金仓配了对应的工具:KDMS 出清单,KDTS 做自动转换。KDMS 的评估数据来自三层:静态扫描代码文件里的 SQL、动态追踪应用运行时真正执行的 SQL、再从历史日志里挖存量负载。扫描完生成一份评估报告,哪些语法不兼容、要改多少、工作量大在哪,都能量化、能复核。我的习惯是,报告出来先不急着信,自己抽几十条最复杂的 SQL 对着看一遍。报告是路线图,不是终点。
三、第三步:全量搬完只是开始,增量衔接才是关键
开搬之前先做个取舍:停服迁移,还是不停服迁移。 停服简单、干净,代价是业务要停;不停服复杂,但业务不停。判断的尺子只有一把:停机窗口有多长。数据量小、窗口宽裕,停服就够了;核心系统动不动几个 T,窗口只有几十分钟,那就得走不停服。
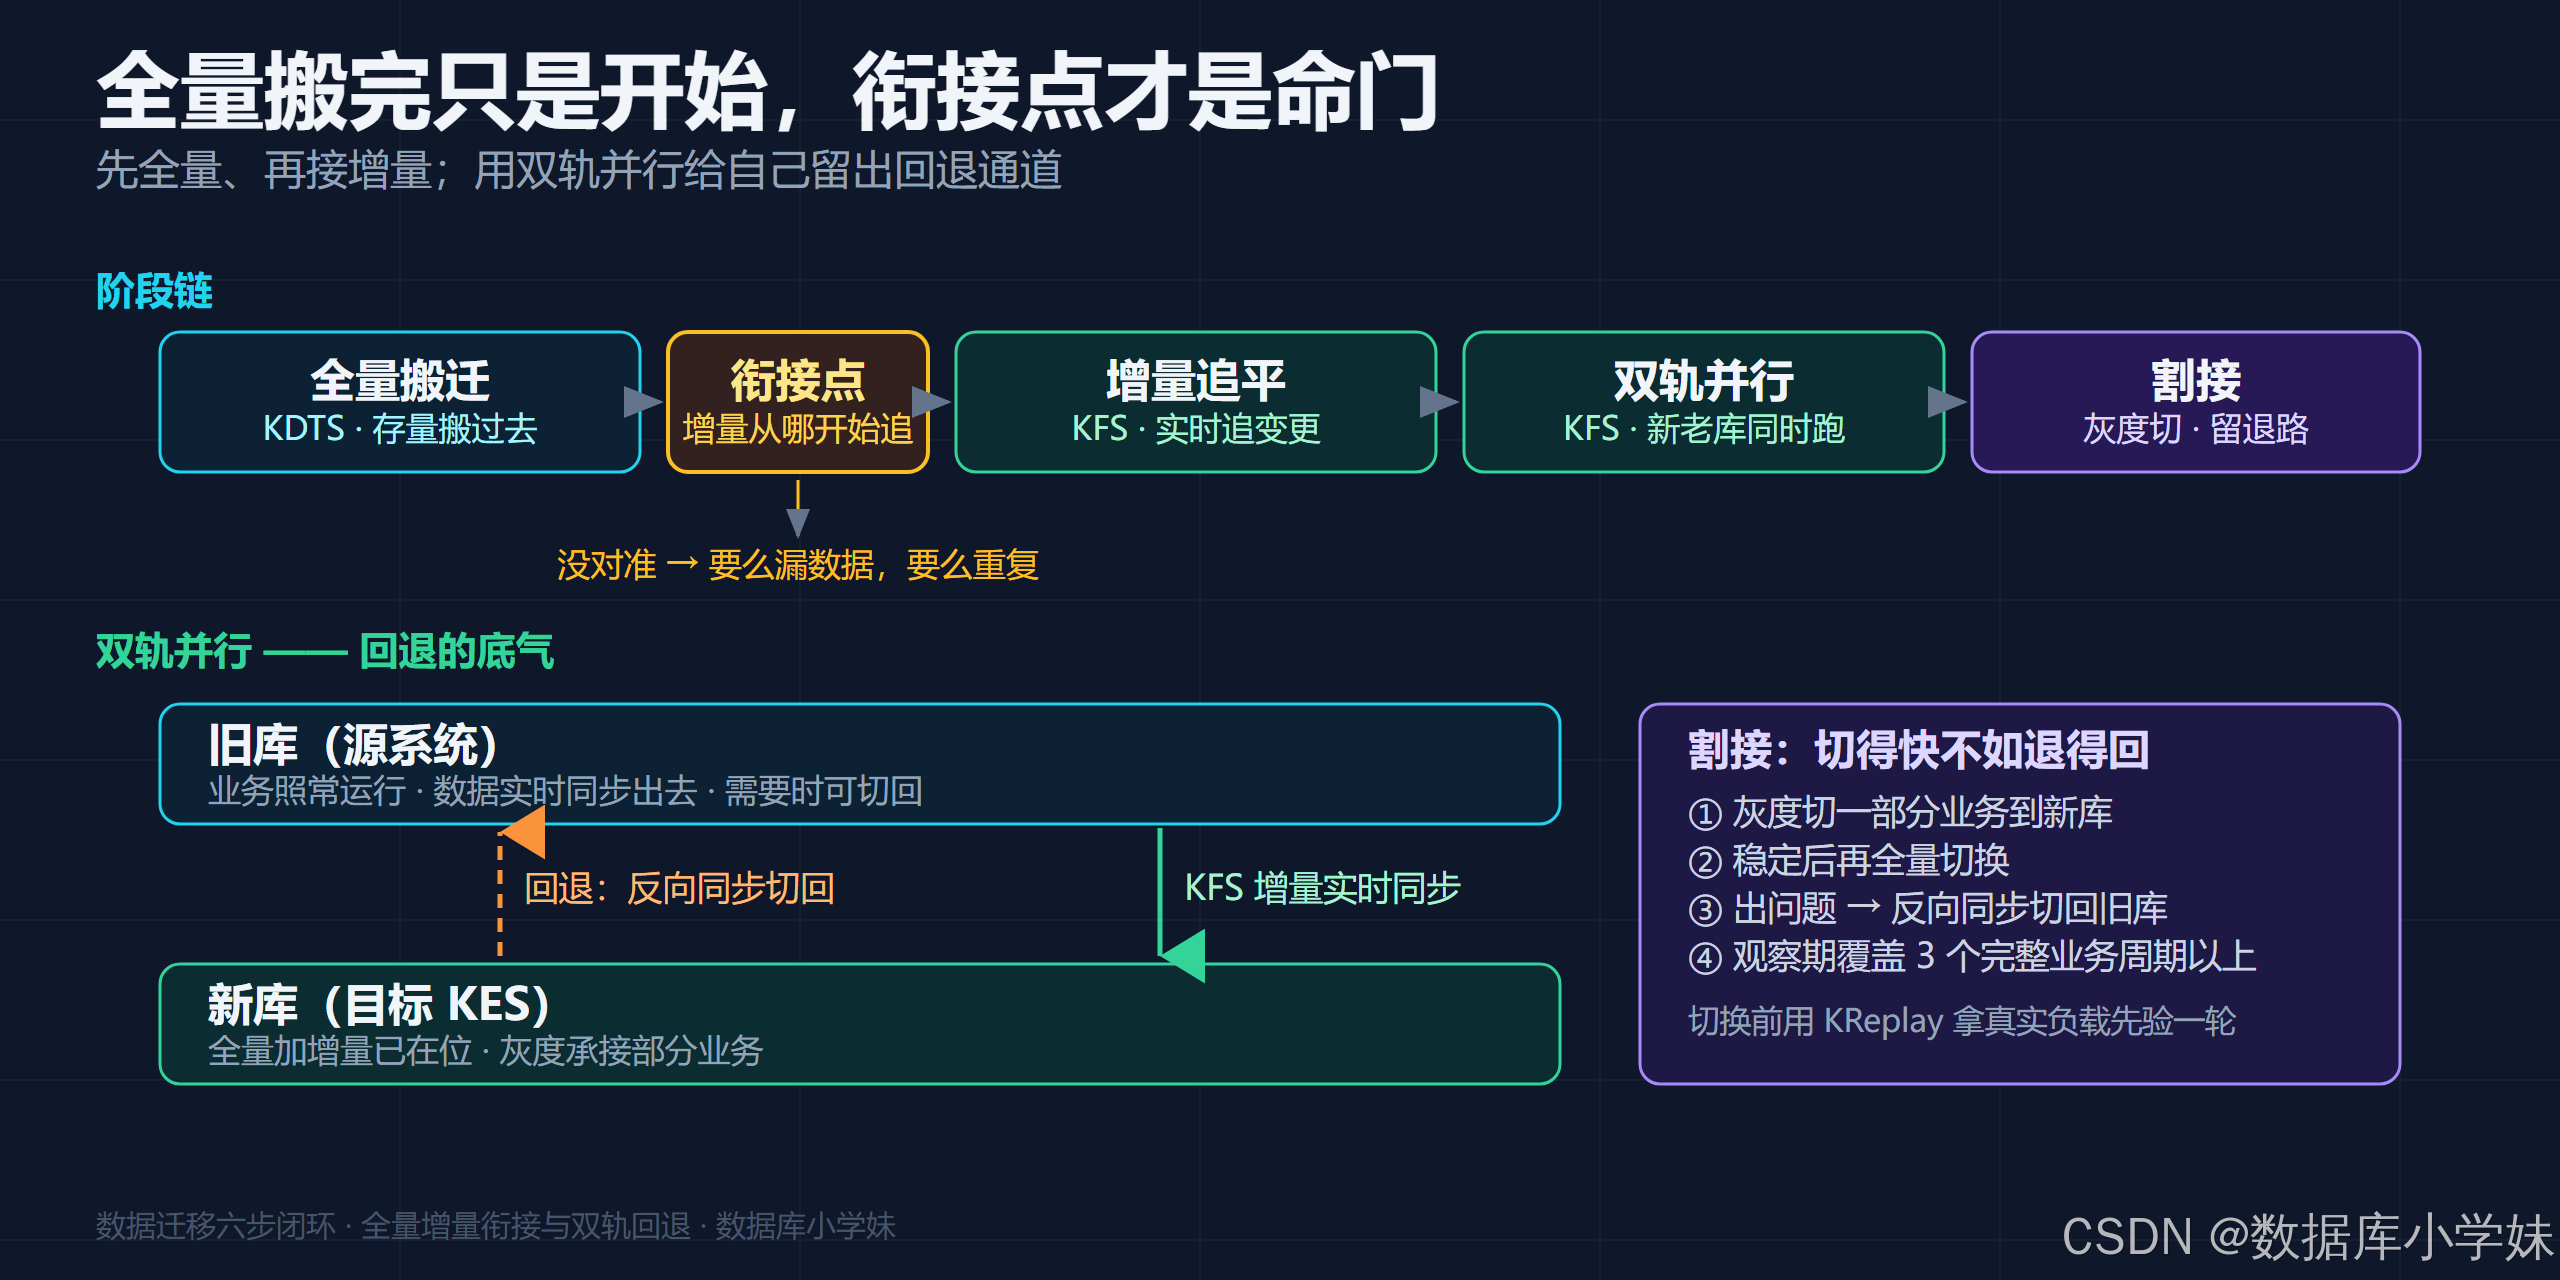
不停服的思路不复杂:先做全量,再接增量。 全量把存量搬过去,增量把搬迁期间产生的新变更追上去。最容易出问题的是衔接点:全量结束的那一瞬间,增量从哪里开始追。衔接没对准,要么漏数据,要么重复。
全量和增量,得分成两件事来配工具。金仓的分工是:全量搬运用 KDTS,增量同步用 KFS(Kingbase FlySync,金仓异构数据同步软件)。KDTS 做全量时支持数据类型映射匹配。哪条搬失败了,整批不会跟着停,回头单独补那一条就行。KFS 负责把增量实时追平,迁移期间业务照常写。
传统增量是另一套做法,基于触发器加中间表:源表一变,触发器把主键写进中间表,再写个程序不停扫。这套能用,但要往源库上挂触发器,对业务有侵入。KFS 走的是日志层捕获,基本无侵入。医疗、金融这类核心系统更愿意用它做增量,原因就在这儿。
全量搬迁本身也有性能讲究。KDTS 的性能调优手册里给过一个理想值:200G/H。实际跑不跑得到,得看瓶颈在哪一端。用 jstack 看迁移进程的线程状态就能判断,读线程一直占着,瓶颈在读取端;写线程一直占着,瓶颈在写入端。搬迁日志里也有现成数据,取一段,用「最后一条大小减第一条大小」除以「最后一条时间减第一条时间」,实时速率就出来了。这些数字才是停机窗口够不够的依据。
还有个细节容易漏。同构的物理迁移,比如单实例迁到集群,很多人直接拷 data 目录。拷之前得先手工建一次检查点,wal 日志大的先备份再清理;跨主机拷贝的时间,要按网络带宽和节点数算进去。这几步不做,停机窗口就是拍脑袋拍出来的。
四、第四步:校验,最容易糊弄,也最不能糊弄
到校验这一步,很多团队就开始赶工期了。做法通常是抽样比对:抽几千行出来,对得上,就算过了。抽样比对最大的问题,是它永远抽不到边界值。 而边界值恰恰是最容易出差异的地方。开头说的那个带空值的联合唯一键,抽样抽一百次也未必碰到一次。
所以校验的正确做法是全量比对,不是抽样。 存量数据全量比一遍,增量数据也得比。更彻底的做法,是把它放到不停机的前提下去做:业务还在写,比对还在跑,最后把差异项拉出来逐条修复。要做到这一步,并不轻松。金仓的 KFS 里配了一整套方案,业务不用停,存量加增量一起验。
工具能帮你把活干完,但替不了你做决定:差异出现了,哪些必须修、哪些可以接受,得业务方来定。 我在这里也失误过一次。当时为了保证工期,我把校验范围缩小到了几个核心表,觉得其他表"逻辑简单,不会有事"。结果上线后出问题的,正是一张看起来最简单的字典表,它的排序规则和原来不一样。这件事之后我改了做法:校验范围由业务方和 DBA 一起定,不接受我一个人的判断。
五、第五步和第六步:割接与回退,退路比速度重要
校验通过,到了最要命的一步:割接。割接就是一刀切,切过去发现性能不达标,业务方已经炸了,这时候想回去,回滚窗口可能早过了。所以割接的第一原则不是切得快,是留退路。
留退路分两层。第一层是能不能回退。做法是双轨并行:新老两套库并行跑,数据实时同步,业务先灰度切一部分过去,稳了再全量切。真出问题,反向同步切回去。这套实时同步靠的,就是金仓的 KFS。官方的割接流程里,最后一步写的就是"割接后观察或回退",观察期建议覆盖三个完整业务周期以上。
第二层是切之前到底验没验过。这个我一开始也不当回事,觉得压测脚本写得好就行。后来看了一个真实的迁移复盘才改观:团队把生产环境 24 小时的完整负载抓下来,在 1:1 的测试环境里原样重放,加压减压各来一轮。除了显性报错,还翻出一批平时压不出来的差异,都在上线前暴露了。这些,人手写的压测脚本基本覆盖不到。对应的工具是 KReplay,负载回放。
六步走完,我把它压成三句话,你可以贴在项目文档第一页:
- 评估不定量不迁------拿不出逐条 SQL 清单,就别谈工期
- 校验不全量不切------抽样过的库,不算验过
- 回退没通道不上------没有回退方案的割接,就是赌博
六、一个案例:2TB 核心系统,六步怎么走完
理论说完了,拿一个公开案例把六步串一遍。某三甲医院的临床数据中心,核心业务原来跑 Oracle 11g,要迁到金仓 KES。医疗系统容不得中断,又是信创替换的重点场景,选型上没多少余地。
规模不算小:数据量超 2TB,日均增量超 1GB,日均事务 1200 万以上,忙时 3 万 TPM 以上,高峰活动连接不低于 300。从选型适配到上线切换,历时 7 个月。
这六步他们大致是这么走的。评估 做量化扫描,把改造量算清楚。转换 靠高兼容性把改动压到最小。迁移 拉双轨并行,同步延迟压在 1 秒以内。校验 把全量迁移后的库,用原有备库变成一套准生产测试环境,挑 5 个关键业务场景手工测处理速度,取多次平均。结论很坦率:5 个场景新旧库互有高低,但都小于或接近 100 毫秒,没有数量级落差。割接 用灰度切换,整体花了一个月,每个模块上线的业务暂停控制在 5 分钟以内。回退通道全程留着。上线后稳定运行超过 9 个月,数据量长到 2.34TB。
我看完最大的感受是:真正把项目做稳的,不是某个工具多强,是每一步都留了验证和回退。工具能把活干到八成,剩下两成的判断得人来做。
七、数据迁移启动前,先问自己三个问题
第一,改造量有没有量化报告? 要的是逐条 SQL 的不兼容扫描结果,不是一张对象数量清单。也别只看兼容率那个数字,尤其别信"完全兼容",抽最复杂的几十条 SQL 实测,看执行计划和响应时间。
第二,全量和增量怎么衔接? 衔接点定在哪、怎么验证没漏没重,要能说出具体方案。校验是全量还是抽样,也在这一步定死。只做抽样的,等于没验。
第三,割接有没有双轨并行和明确的回退方案? 回退的判断依据、谁有权启动、窗口多长,都得提前写死。
再补一句:项目交付后,团队里谁还接得住? 这个问题不想清楚,前面做得再好,后面也可能还回去。金仓这套工具链在这件事上帮了忙:KDMS 管评估、KDTS 管迁移、KFS 管同步和校验、KReplay 管负载验证、KStudio 管日常运维,评估到运维能串起来,不用东家买一个西家凑一个。工具链降低了门槛,接得住的人自然就多了。
八、数据迁移避坑清单
别用抽样比对代替全量校验。 抽样永远抽不到边界值,而差异几乎都藏在边界上。我那次空值唯一键的坑,就是这么漏过去的。
评估报告出来先抽检。 工具扫描的逻辑和业务人工盘点的逻辑不一样,两边对一遍,能捞出差出来的对象。这一步花半天,能省后面好几周。
观察期别太短。 有些问题一个月才露一次头,比如月末结账、季度报表。我当时的项目只留了两周,事后回想是真冒险。官方建议观察期覆盖三个完整业务周期以上,这个建议很实在。
写在最后
回到开头那个问题:数据迁移怎么做才不返工?我的答案是,别把它当成一次"搬数据",把它当成一条六步闭环:评估、转换、迁移、校验、割接、回退,每一步都有过关标准。
我在这条路上真正借上力的,是有人把"不确定"变成了"可测"。评估用 KDMS 出量化报告,迁移有 KDTS 管全量、KFS 管增量,校验能不停机做全量比对,割接有双轨并行随时回退,上线前还有 KReplay 拿真实负载验一遍。金仓这套工具链做的事,是把每个环节的不可控往可控的方向拉一点点。串成一句话,就是改得少、搬得准、验得全、退得回。这四个词我写在了自己复盘模板的第一页。但工具管的是"有没有退路",怎么设计退路,还得靠人。
我现在养成一个习惯:每上一个高风险方案,先写回退方案,再写实施步骤。实施步骤写错了是加班,回退方案没写,可能是过年加班。
你们做数据迁移的时候,最怕的是哪一环?欢迎评论区聊聊,我也想听听你们踩过的坑。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见 👋