根据阿里云官方公告,云数据库 InfluxDB® 版已进入退市周期,2026‑10‑23 将正式停止服务、释放实例数据。实例释放后未迁出数据将随之丢失,大量使用 InfluxDB Line Protocol 写入、InfluxQL 查询的企业,正面临历史数据导出、业务链路改造、数据库选型替换的现实压力。
距离正式下线窗口期已不足两个月,完整迁移不止是更换数据库实例,还包含源端盘点、PoC 验证、写入链路改造、历史数据回灌、查询改写、业务并行观察等一系列工作,数据体量越大,所需预留的实施周期就越长。
针对受该版本退市影响的企业用户,KaiwuDB 可提供一对一迁移评估、PoC 验证、专家咨询与专属迁移优惠。扫描文末二维码即可提交需求,获取专属技术对接。
文章目录
- [一、为什么 KaiwuDB 适合作为替代选型](#一、为什么 KaiwuDB 适合作为替代选型)
-
- [1. 写入链路改造量极低,业务改动小](#1. 写入链路改造量极低,业务改动小)
- [2. 配套完整异构迁移工具,无需自研脚本](#2. 配套完整异构迁移工具,无需自研脚本)
- [3. 不止"平替":时序与关系同库,拓展业务能力边界](#3. 不止“平替”:时序与关系同库,拓展业务能力边界)
- [4. 企业版/开源版双形态,适配不同规模业务](#4. 企业版/开源版双形态,适配不同规模业务)
- 二、迁移前必做
-
- 完成源端业务盘点
- [核心概念映射:理解 measurement 与时序表模型](#核心概念映射:理解 measurement 与时序表模型)
- [写入链路切换:改 URL,不改数据格式](#写入链路切换:改 URL,不改数据格式)
- [查询改造:从 InfluxQL 过渡到 SQL 时序扩展语法](#查询改造:从 InfluxQL 过渡到 SQL 时序扩展语法)
- 三、迁移之后:把能力往前推一步
- [四、InfluxDB 迁移至 KaiwuDB 常见问题 FAQ](#四、InfluxDB 迁移至 KaiwuDB 常见问题 FAQ)
-
- [1. 原有 Line Protocol 写入程序可以直接接入 KaiwuDB 吗?](#1. 原有 Line Protocol 写入程序可以直接接入 KaiwuDB 吗?)
- [2. InfluxDB 历史数据如何迁移到 KaiwuDB?](#2. InfluxDB 历史数据如何迁移到 KaiwuDB?)
- [3. 原有 InfluxQL 查询可以直接在 KaiwuDB 中运行吗?](#3. 原有 InfluxQL 查询可以直接在 KaiwuDB 中运行吗?)
- [4. 为什么迁移时要先开启双写,再搬迁历史数据?](#4. 为什么迁移时要先开启双写,再搬迁历史数据?)
- 相关参考:
本文围绕 InfluxDB 1.x/2.x 迁移至 KaiwuDB,梳理 Line Protocol 与 Telegraf 接入、KDTS 历史数据迁移、主标签设计、InfluxQL 查询改写和双写切换流程。读完本文,你可以据此完成迁移前盘点与 PoC 验证,并制定降低数据遗漏和业务中断风险的实施方案。
一、为什么 KaiwuDB 适合作为替代选型
迁移的本质不是"换个数据库",更是一次优化数据架构的机会。KaiwuDB 作为面向 AIoT 场景的企业级多模时序数据库,在迁移适配、工具链、架构能力、版本形态上具备多重优势:
1. 写入链路改造量极低,业务改动小
KaiwuDB 原生兼容 InfluxDB Line Protocol 协议,提供专用 RESTful 接口。
绝大多数现有采集程序、Telegraf 采集任务**无需修改数据格式,仅修改 URL、认证信息、目标库名即可完成接入,**全程不需要在数据格式层面动刀。支持先双写验证,验证无误后再切换主流量,最大程度降低业务改造风险。
2. 配套完整异构迁移工具,无需自研脚本
KaiwuDB 自带异构迁移工具 KDTS,原生支持 InfluxDB 1.x / 2.x → KaiwuDB 时序引擎 的迁移:
-
支持仅结构、仅数据、结构 + 数据三种迁移方式;
-
支持全量迁移与增量同步,可按时间维度对数据源分片、分批读取;
-
提供一致性校验与修复;
-
迁移完成后自动输出完整迁移报告(含迁移概况、性能指标、异常信息);
-
既提供图形化界面 (可视化配置、进度条、实时日志),也提供**命令行**** **Headless 模式,可对接自动化 CI/CD 流程。
历史数据的"按时间窗口分批搬运 + 分批校验 + 断点重来",是工具自带能力,省去团队自行开发迁移脚本的成本。
历史数据迁移实操完整指南:https://www.kaiwudb.com/blog/98240651715585025
3. 不止"平替":时序与关系同库,拓展业务能力边界
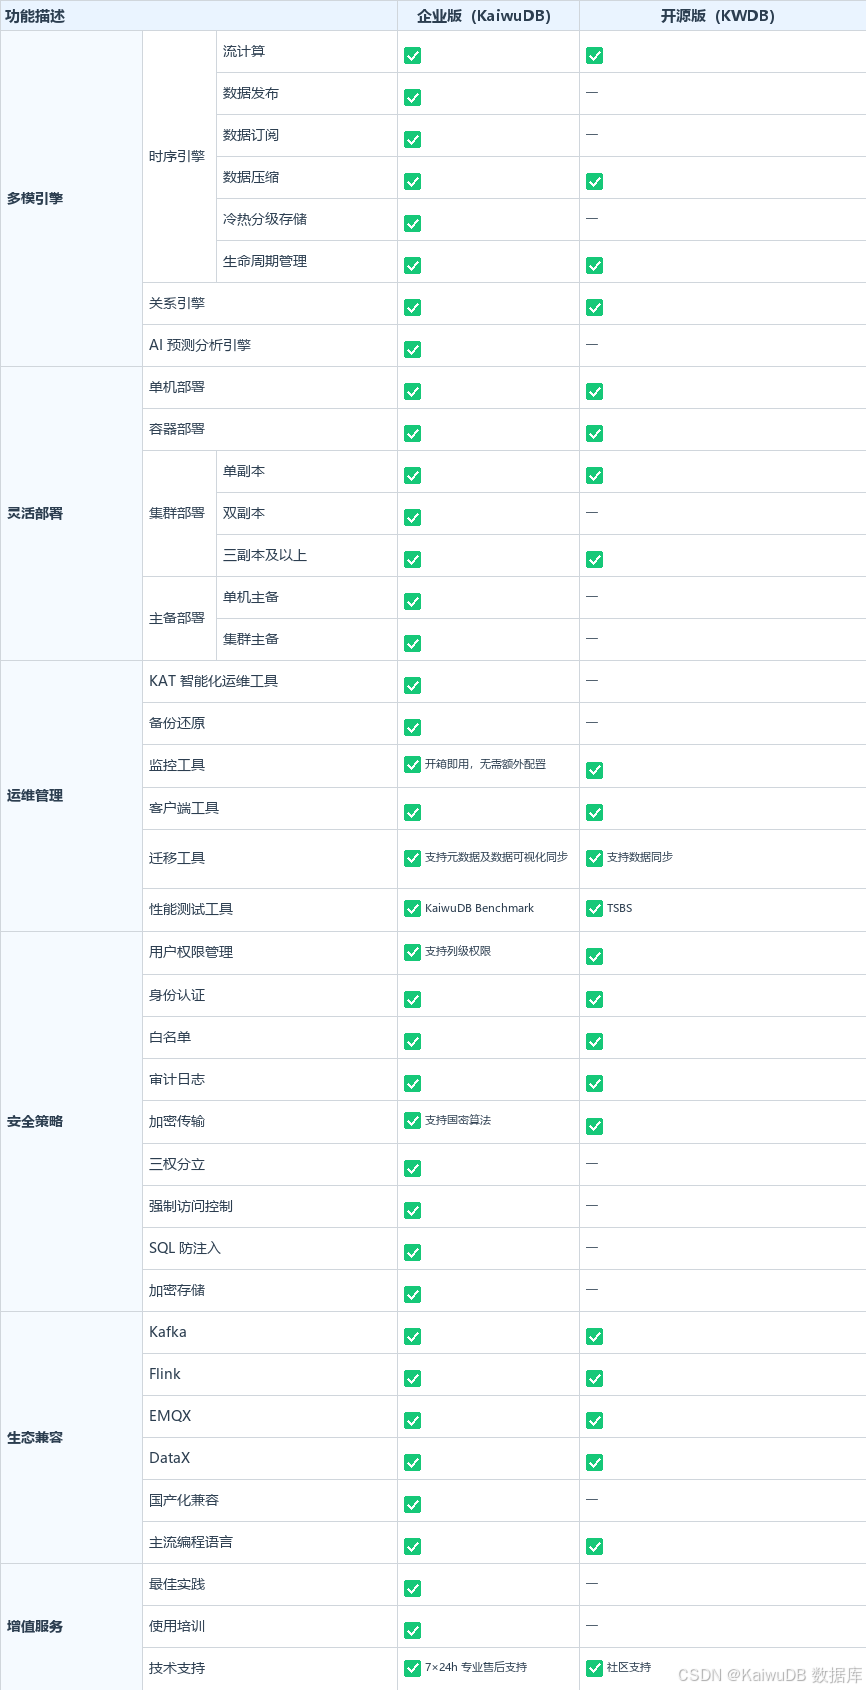
区别于单一时序数据库,KaiwuDB 一套数据库实例同时支持时序 + 关系双引擎:
-
设备时序指标与资产、工单、组织等业务关系数据可同库存储,直接 JOIN 查询,不必再维护"时序库 + 中间同步组建 + 业务库"的复杂架构;
-
内置流计算、数据发布订阅能力,开箱即用智能降采样、预计算加速、数据推送 Kafka,无需外挂 Flink/Spark 组件;
-
支持实时压缩,库/表级生命周期管理、冷热分级存储,有效控制存储成本;
-
三权分立、多层级访问控制、全生命周期审计、SQL防注入等完备的企业级安全能力;
-
兼容 EMQX、Kafka、Flink 等主流物联网生态组件,支持 C/C++、Java、Python 等主流语言接口。
4. 企业版/开源版双形态,适配不同规模业务
-
开源版 KWDB:可满足存储查询基础诉求,适合单机房、单副本集群的中小型项目;
-
企业版 KaiwuDB:支持集群双 / 三副本、冷热分级存储、数据订阅、AI 预测分析引擎,面向生产高可用、异地同步等企业级场景。
二、迁移前必做
完成源端业务盘点
正式启动迁移之前,建议完成源端信息盘点,盘点越充分,PoC 验证越高效,返工越少:
-
库/Bucket、保留策略(RP)、数据保存周期;
-
Measurement 清单、tag/field 字段、时间精度;
-
写入客户端/采集器:应用直写、Telegraf 等采集组件清单、认证方式;
-
关键查询资产:InfluxQL 语句、大屏报表、告警规则、对外接口;
-
数据规模:历史总数据量、日增量、series 基数、峰值写入吞吐;
-
业务可接受切换窗口、业务观察周期。
建议优先选取 1‑2 个典型 Measurement 做完整 PoC 验证,跑通写入、查询、性能、存储占用全链路,再全量铺开。
核心概念映射:理解 measurement 与时序表模型
InfluxDB 的 measurement、tag、field 可以平滑映射到 KaiwuDB 时序表。这里有一个生产环境非常关键的设计点:主标签 PRIMARY TAGS。
主标签用于区分不同设备 / 传感器实体,数据库会自动为主标签构建索引、按主标签做数据分区。
-
自动建表模式会生成无业务含义的哈希 primary_tag,适合快速验证;
-
生产强烈建议手工建表,把业务高频过滤、分组的字段(如 device_id、host)设置为主标签,否则海量数据场景下会出现全表扫描、查询性能严重退化。
完整模型映射、建表示例、字段类型映射,详见上方迁移实操博客。
写入链路切换:改 URL,不改数据格式
KaiwuDB 提供两套适配接口,最大程度降低采集侧改造:
-
Line Protocol 无模式写入接口:直接复用原有 Line 协议数据,仅调整接口地址与鉴权;
-
Telegraf 适配接口:Telegraf 用户仅修改 outputs.http 配置,data_format 保持 influx 即可。
官方推荐的低风险切换流程:
-
准备目标环境,手工建表并合理配置主标签,确认生命周期等参数;
-
优先开启业务双写,保护迁移过程中的增量数据;
-
使用 KDTS 分批迁移双写启动之前的历史数据;
-
停止旧写入,完成最后增量窗口数据对齐;
-
执行数据一致性校验,核对记录数、时间戳、业务查询结果;
-
灰度切换读流量到 KaiwuDB,开启业务观察期;
-
观察无异常后下线旧 InfluxDB 链路。
❗重要避坑:不要先迁移历史数据,再开启双写,会产生数据缺口。
查询改造:从 InfluxQL 过渡到 SQL 时序扩展语法
KaiwuDB 使用标准 SQL + 时序扩展函数,原有 InfluxQL 的时间过滤、聚合、分组、last 取值、时间窗口、缺失值填充等能力均可等价实现。
常用查询语法对照示例,依旧可查阅迁移实操博客。
💡性能关键点:把高频过滤分组字段设置为主标签,查询条件命中主标签,才能充分发挥索引与分区能力,避免大表扫描。
三、迁移之后:把能力往前推一步
完成基础迁移之后,不必止步于 "跑通业务",可以逐步启用 KaiwuDB 内置能力,替代原有外部组件:
-
流计算:数据库内部完成实时降采样、预计算;
-
数据推送:时序数据变化实时推送至 Kafka,服务大屏、告警;
-
多模融合:时序数据与资产、工单关系表直接 JOIN;
-
AI 预测引擎:实现时序异常检测、趋势预判。
以上能力建议迁移完成后分步骤上线,不要和数据库切换同步实施。
四、InfluxDB 迁移至 KaiwuDB 常见问题 FAQ
1. 原有 Line Protocol 写入程序可以直接接入 KaiwuDB 吗?
KaiwuDB 原生兼容 InfluxDB Line Protocol,并提供相应的 RESTful 写入接口。现有采集程序通常可以继续沿用原来的数据格式,主要调整写入 URL、认证信息和目标库名。
如果使用 Telegraf 采集数据,可以修改 `outputs.http` 配置,并继续使用 `influx` 数据格式。正式切换前,建议选取典型 Measurement 验证字段类型、时间精度、写入吞吐和异常处理逻辑。
2. InfluxDB 历史数据如何迁移到 KaiwuDB?
可以使用 KaiwuDB 异构迁移工具 KDTS,将 InfluxDB 1.x 或 2.x 中的数据迁移至 KaiwuDB 时序引擎。KDTS 支持仅迁移结构、仅迁移数据以及同时迁移结构和数据,也支持全量迁移与增量同步。
对于数据量较大的实例,可以按照时间范围对数据分片,分批完成读取、写入和校验。迁移过程中还可以进行一致性检查与异常修复,迁移完成后生成包含迁移概况、性能指标和异常信息的报告。
3. 原有 InfluxQL 查询可以直接在 KaiwuDB 中运行吗?
不能直接照搬,需要改写为 KaiwuDB 支持的标准 SQL 与时序扩展语法。InfluxQL 中常用的时间过滤、聚合、分组、最新值查询、时间窗口和缺失值填充等能力,都可以通过对应的 SQL 语法实现。
迁移前应重点盘点大屏报表、告警规则、应用接口和定时任务中的关键查询,并在 PoC 阶段逐条验证查询结果和性能。对于经常参与过滤或分组的字段,建议将其设计为主标签,使查询能够命中索引和数据分区。
4. 为什么迁移时要先开启双写,再搬迁历史数据?
先开启双写,可以保证迁移期间产生的新数据同时进入 InfluxDB 和 KaiwuDB。双写稳定后,再使用 KDTS 迁移双写开始时间之前的历史数据,可以避免迁移过程中出现增量数据缺口。
推荐的顺序是:完成 KaiwuDB 建表与参数配置、开启双写、迁移历史数据、停止旧库写入、补齐最后的增量窗口、执行一致性校验,最后再灰度切换读流量。如果先迁移历史数据、后开启双写,两者之间产生的数据可能无法被完整覆盖。
受此次产品退市影响的团队,我们可以为您提供:
✅ 源端业务梳理评估
✅ 免费 PoC 环境验证
✅ KDTS 迁移工具配置调优指导
✅ InfluxQL 到 KaiwuDB SQL 改写咨询
✅ 企业专属迁移优惠
即刻扫码提交企业信息,获取 1 对 1 技术专家对接
