🔥小叶-duck:个人主页
❄️个人专栏:《Data-Structure-Learning》《C++入门到进阶&自我学习过程记录》
《Linux系统从入门到实践》《Linux网络从入门到实践》
✨未择之路,不须回头
已择之路,纵是荆棘遍野,亦作花海遨游
目录
[1.1 回顾 listen 接口](#1.1 回顾 listen 接口)
[1.2 引出第二参数 backlog](#1.2 引出第二参数 backlog)
[1.3 内核两个 TCP 连接队列](#1.3 内核两个 TCP 连接队列)
[1.4 TCP连接的三次握手时序与队列关联](#1.4 TCP连接的三次握手时序与队列关联)
[1.5 实验验证:backlog 的效果](#1.5 实验验证:backlog 的效果)
[1.6 全连接队列模型与核心误区](#1.6 全连接队列模型与核心误区)
[1.7 全连接队列的设计取舍](#1.7 全连接队列的设计取舍)
[2.1 核心问题](#2.1 核心问题)
[2.2 完整链路总览(从进程到 TCP 连接)](#2.2 完整链路总览(从进程到 TCP 连接))
[2.3 逐层拆解分析](#2.3 逐层拆解分析)
[2.4 三个"缓冲区/队列"与三种"就绪"](#2.4 三个"缓冲区/队列"与三种"就绪")
前言
在前面 Linux 网络编程的学习中,我们已经掌握了 TCP 三次握手、Socket 基础接口等核心知识。很多同学在使用
listen编写服务端代码时,往往只是简单给第二个参数 backlog 填一个数字,并不清楚这个参数在内核里究竟代表什么含义,也容易混淆半连接队列、全连接队列,产生不少经典理解误区。本文将围绕**
listen** 的 backlog 参数展开,结合内核的两套 TCP 连接队列,搭配三次握手时序和实验验证,理清连接队列的模型与设计取舍。之后我们再进一步拆解 "连接" 本身,梳理从进程到 TCP 连接的完整链路,区分缓冲区、队列与就绪状态的概念。
一、理解listen的第二个参数
1.1 回顾 listen 接口
cpp
#include <sys/socket.h>
int listen(int sockfd, int backlog);-
**
sockfd:**监听套接字描述符。 -
backlog:本节主角,决定内核全连接队列的容量。 -
**返回值:**成功 0,失败 -1。
1.2 引出第二参数 backlog
listen 的第二个参数 backlog ,用于限制全连接队列最多可存放已完成三次握手的连接数量 ,队列最大容量为 backlog + 1。
核心要点:
-
三次握手由操作系统内核 TCP 协议栈自动完成,和应用层
accept无关。 客户端调用connect发起握手,内核独立完成握手流程。 -
即使服务端还没有调用
accept,内核依旧可以完成三次握手 ,将连接放入全连接队列,等待accept读取。 -
若全连接队列已满 ,新客户端发来 SYN 请求时,服务端不再回复 SYN+ACK;客户端会停留在
SYN_SENT状态,超时后连接自动关闭。
1.3 内核两个 TCP 连接队列
理解 backlog 的前提,是分清内核里两个连接队列:
| 队列 | 内容 | 连接状态 | 是否受 backlog 限制 |
|---|---|---|---|
| 半连接队列(SYN queue) | 保存尚未完成三次握手的连接 | SYN_RCVD |
不受 backlog 限制 |
| 全连接队列(accept queue) | 保存三次握手已完成、等待应用层 accept 取走的连接 |
ESTABLISHED |
backlog 限制的就是这个队列的长度 |
-
队列由操作系统内核维护;
-
accept的本质仅仅是从全连接队列取出一条已建立好的连接。
1.4 TCP连接的三次握手时序与队列关联
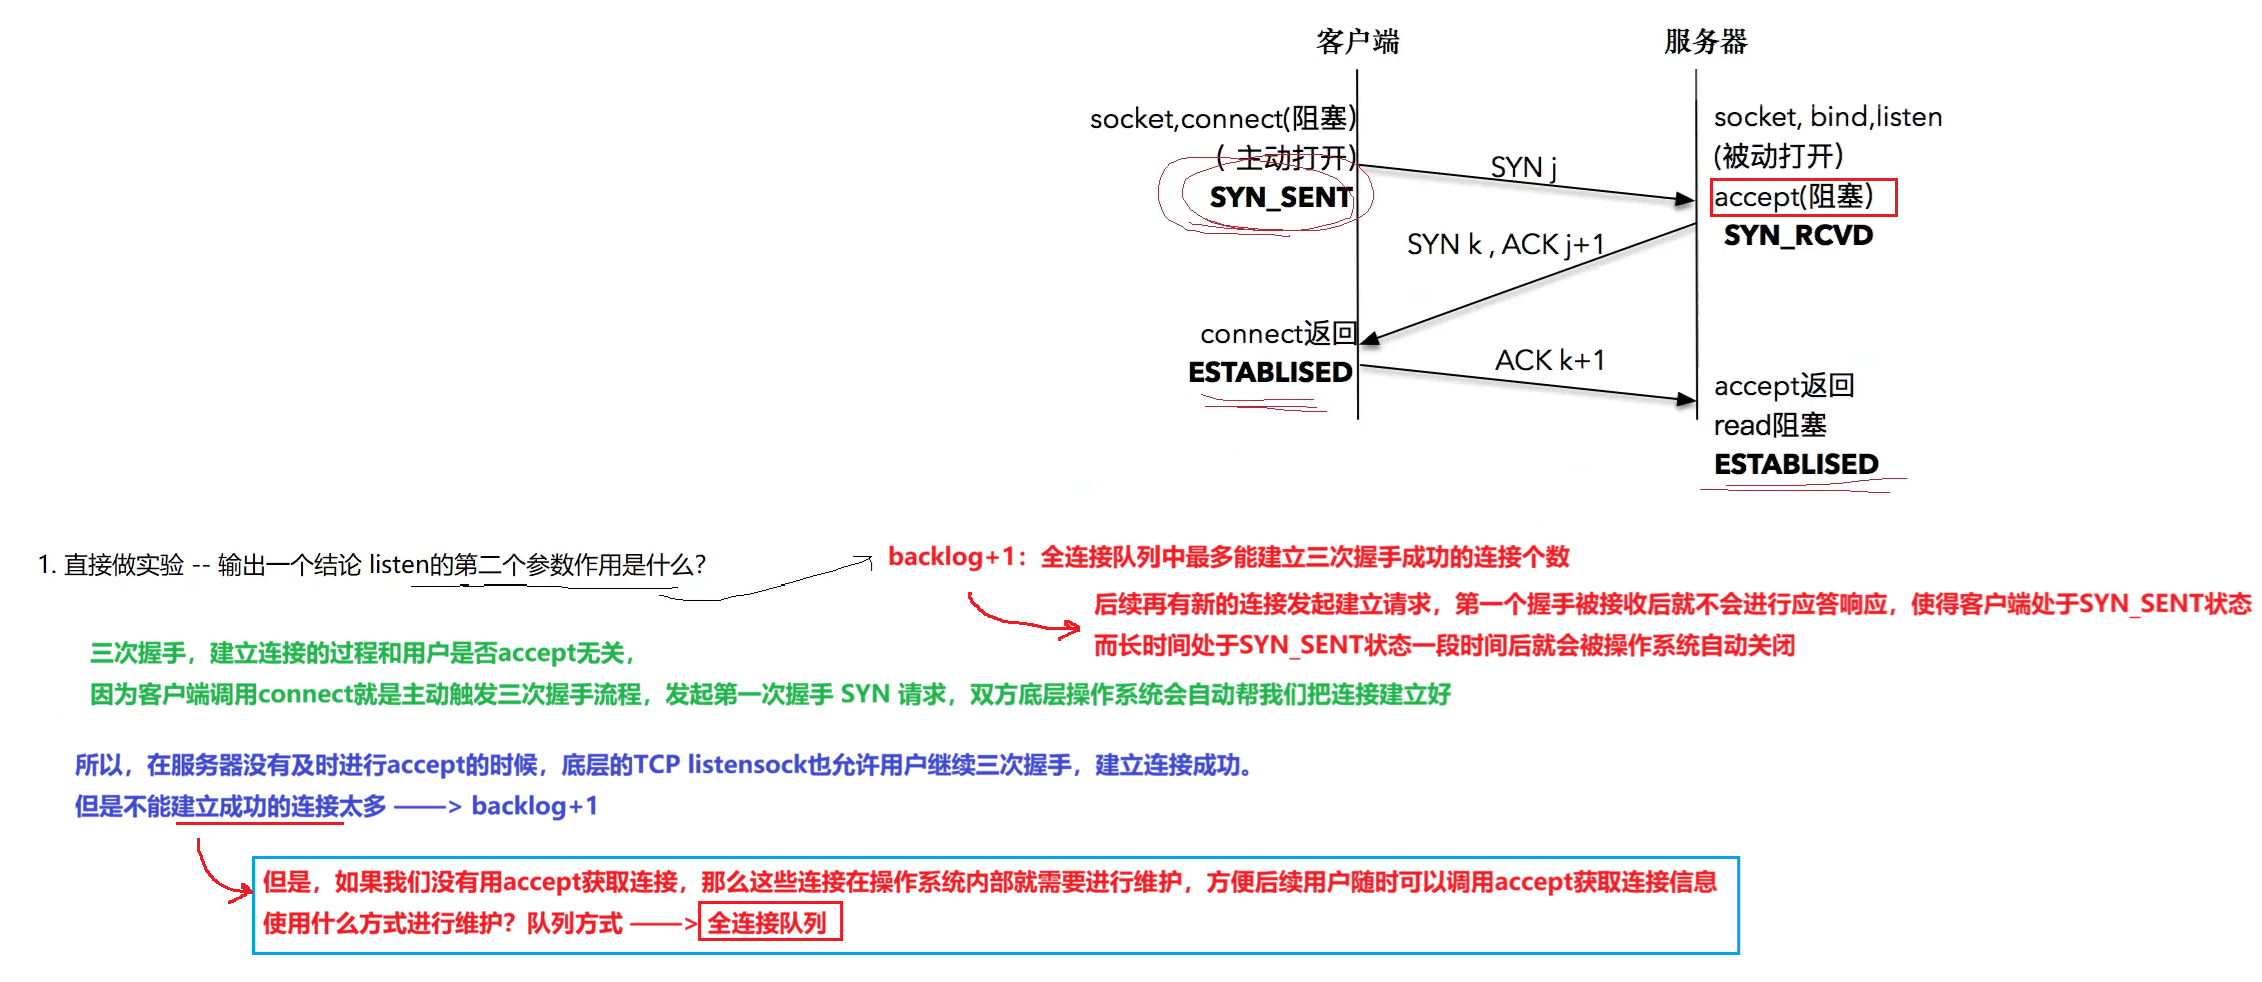
- 客户端调用
connect(),发送 SYN 报文,状态变为SYN_SENT。 - 服务端内核收到 SYN ,连接存入半连接队列 ,回复 SYN+ACK,服务端连接状态变为
SYN_RCVD。 - 客户端收到 SYN+ACK,回复 ACK 报文,客户端状态变为
ESTABLISHED。 - 服务端内核收到 ACK,三次握手完成,服务端连接状态变为
ESTABLISHED。连接从半连接队列移动到全连接队列。 - 服务端应用调用
accept(),从全连接队列取出连接,accept返回
重点: 客户端
connect在收到 SYN+ACK 之后就返回成功,不需要等待服务端执行 accept。这也是为什么"应用层不 accept,客户端依然能 connect 成功并发送数据"的原因------连接已被内核托管。
1.5 实验验证:backlog 的效果
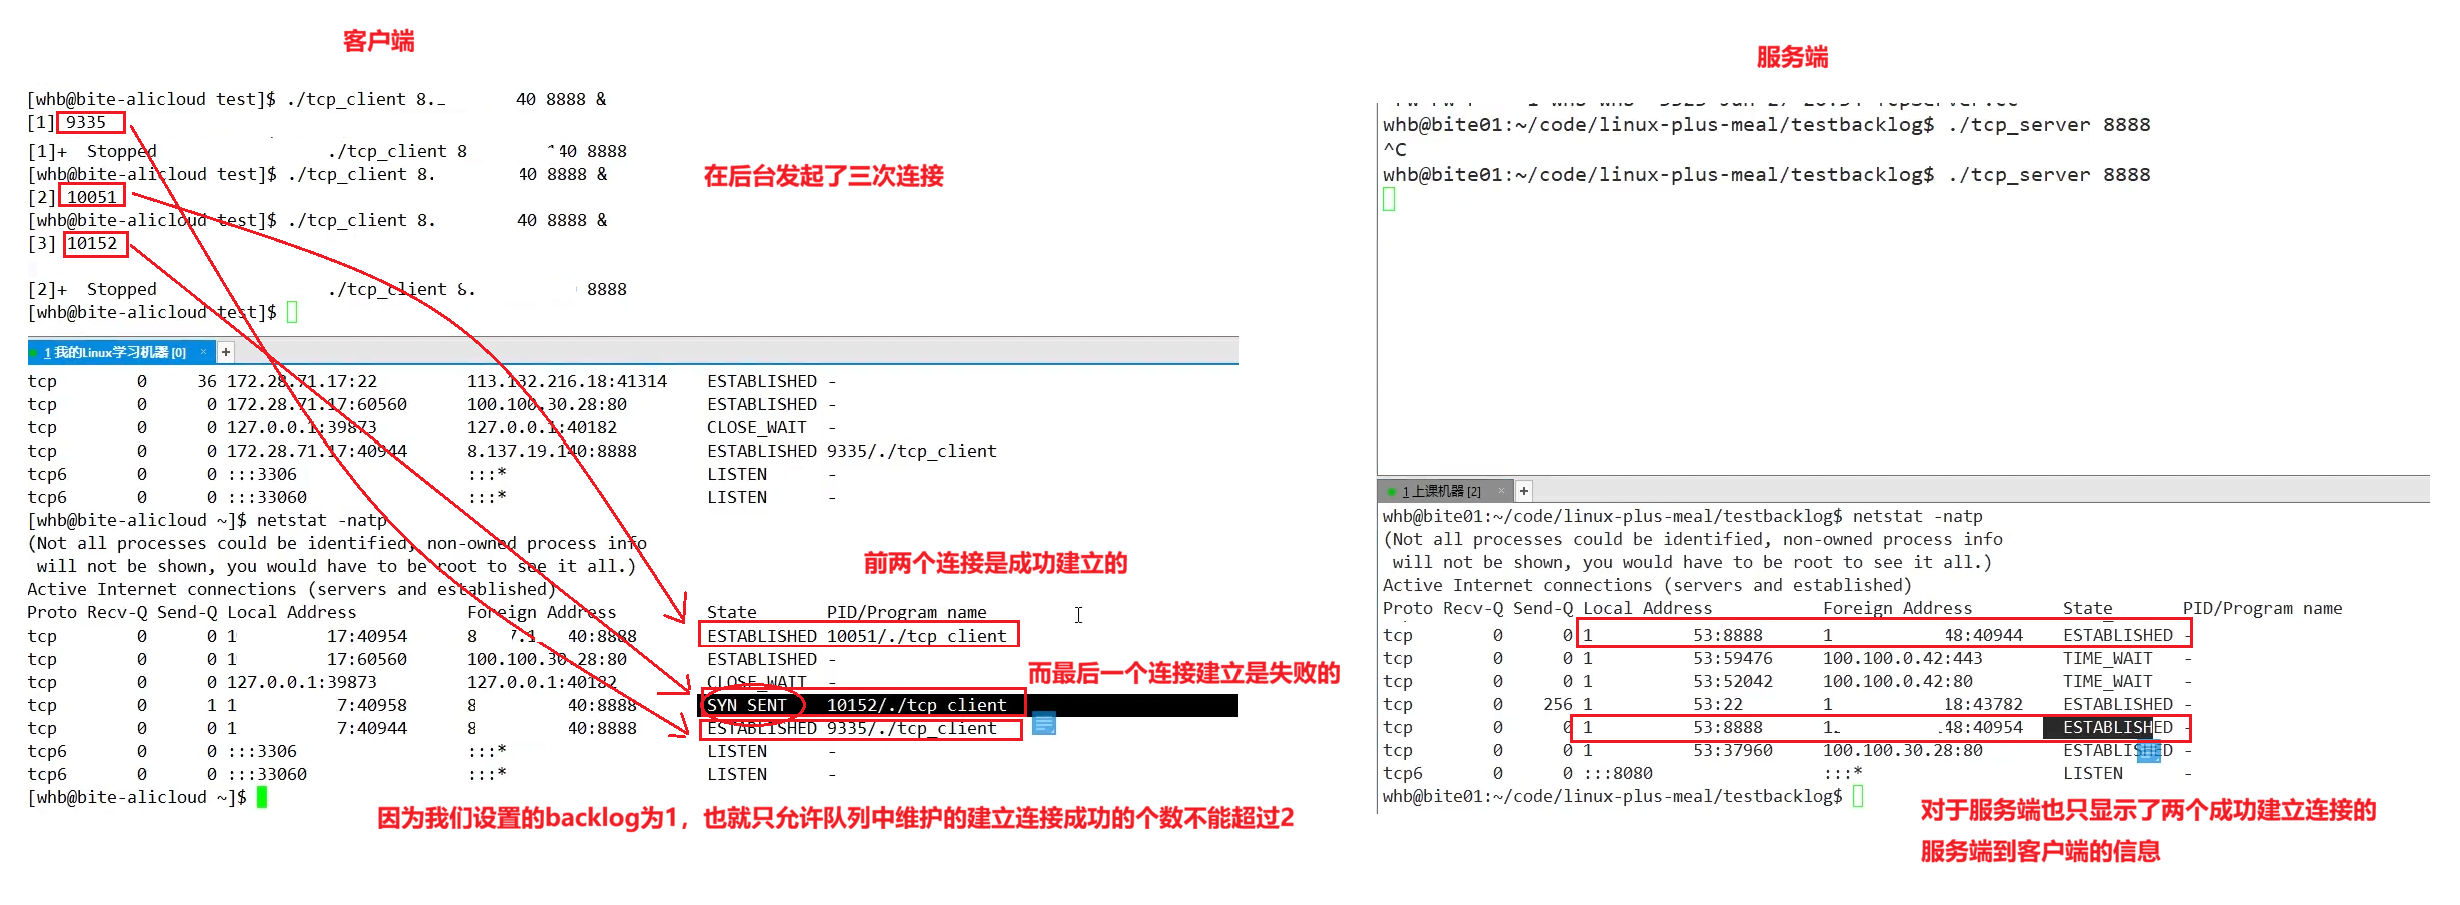
实验配置:
-
服务端
listen设置backlog = 1,则全连接队列最大可存放backlog + 1 = 2条已完成握手连接。 -
服务端暂时不调用
accept消费队列。 -
同时在后台启动 3 个客户端并发连接服务端。
实验现象:
-
前 2 个客户端 :三次握手完整完成,连接状态为
ESTABLISHED,保存在内核全连接队列。 -
第 3 个客户端 :全连接队列已满,服务端不再响应 SYN+ACK ;客户端停留在
SYN_SENT,超时连接失败。 -
使用
netstat查看服务端连接,仅能看到 2 条ESTABLISHED连接。
结论:backlog 直接控制全连接队列能容纳多少条已完成握手的连接。
1.6 全连接队列模型与核心误区
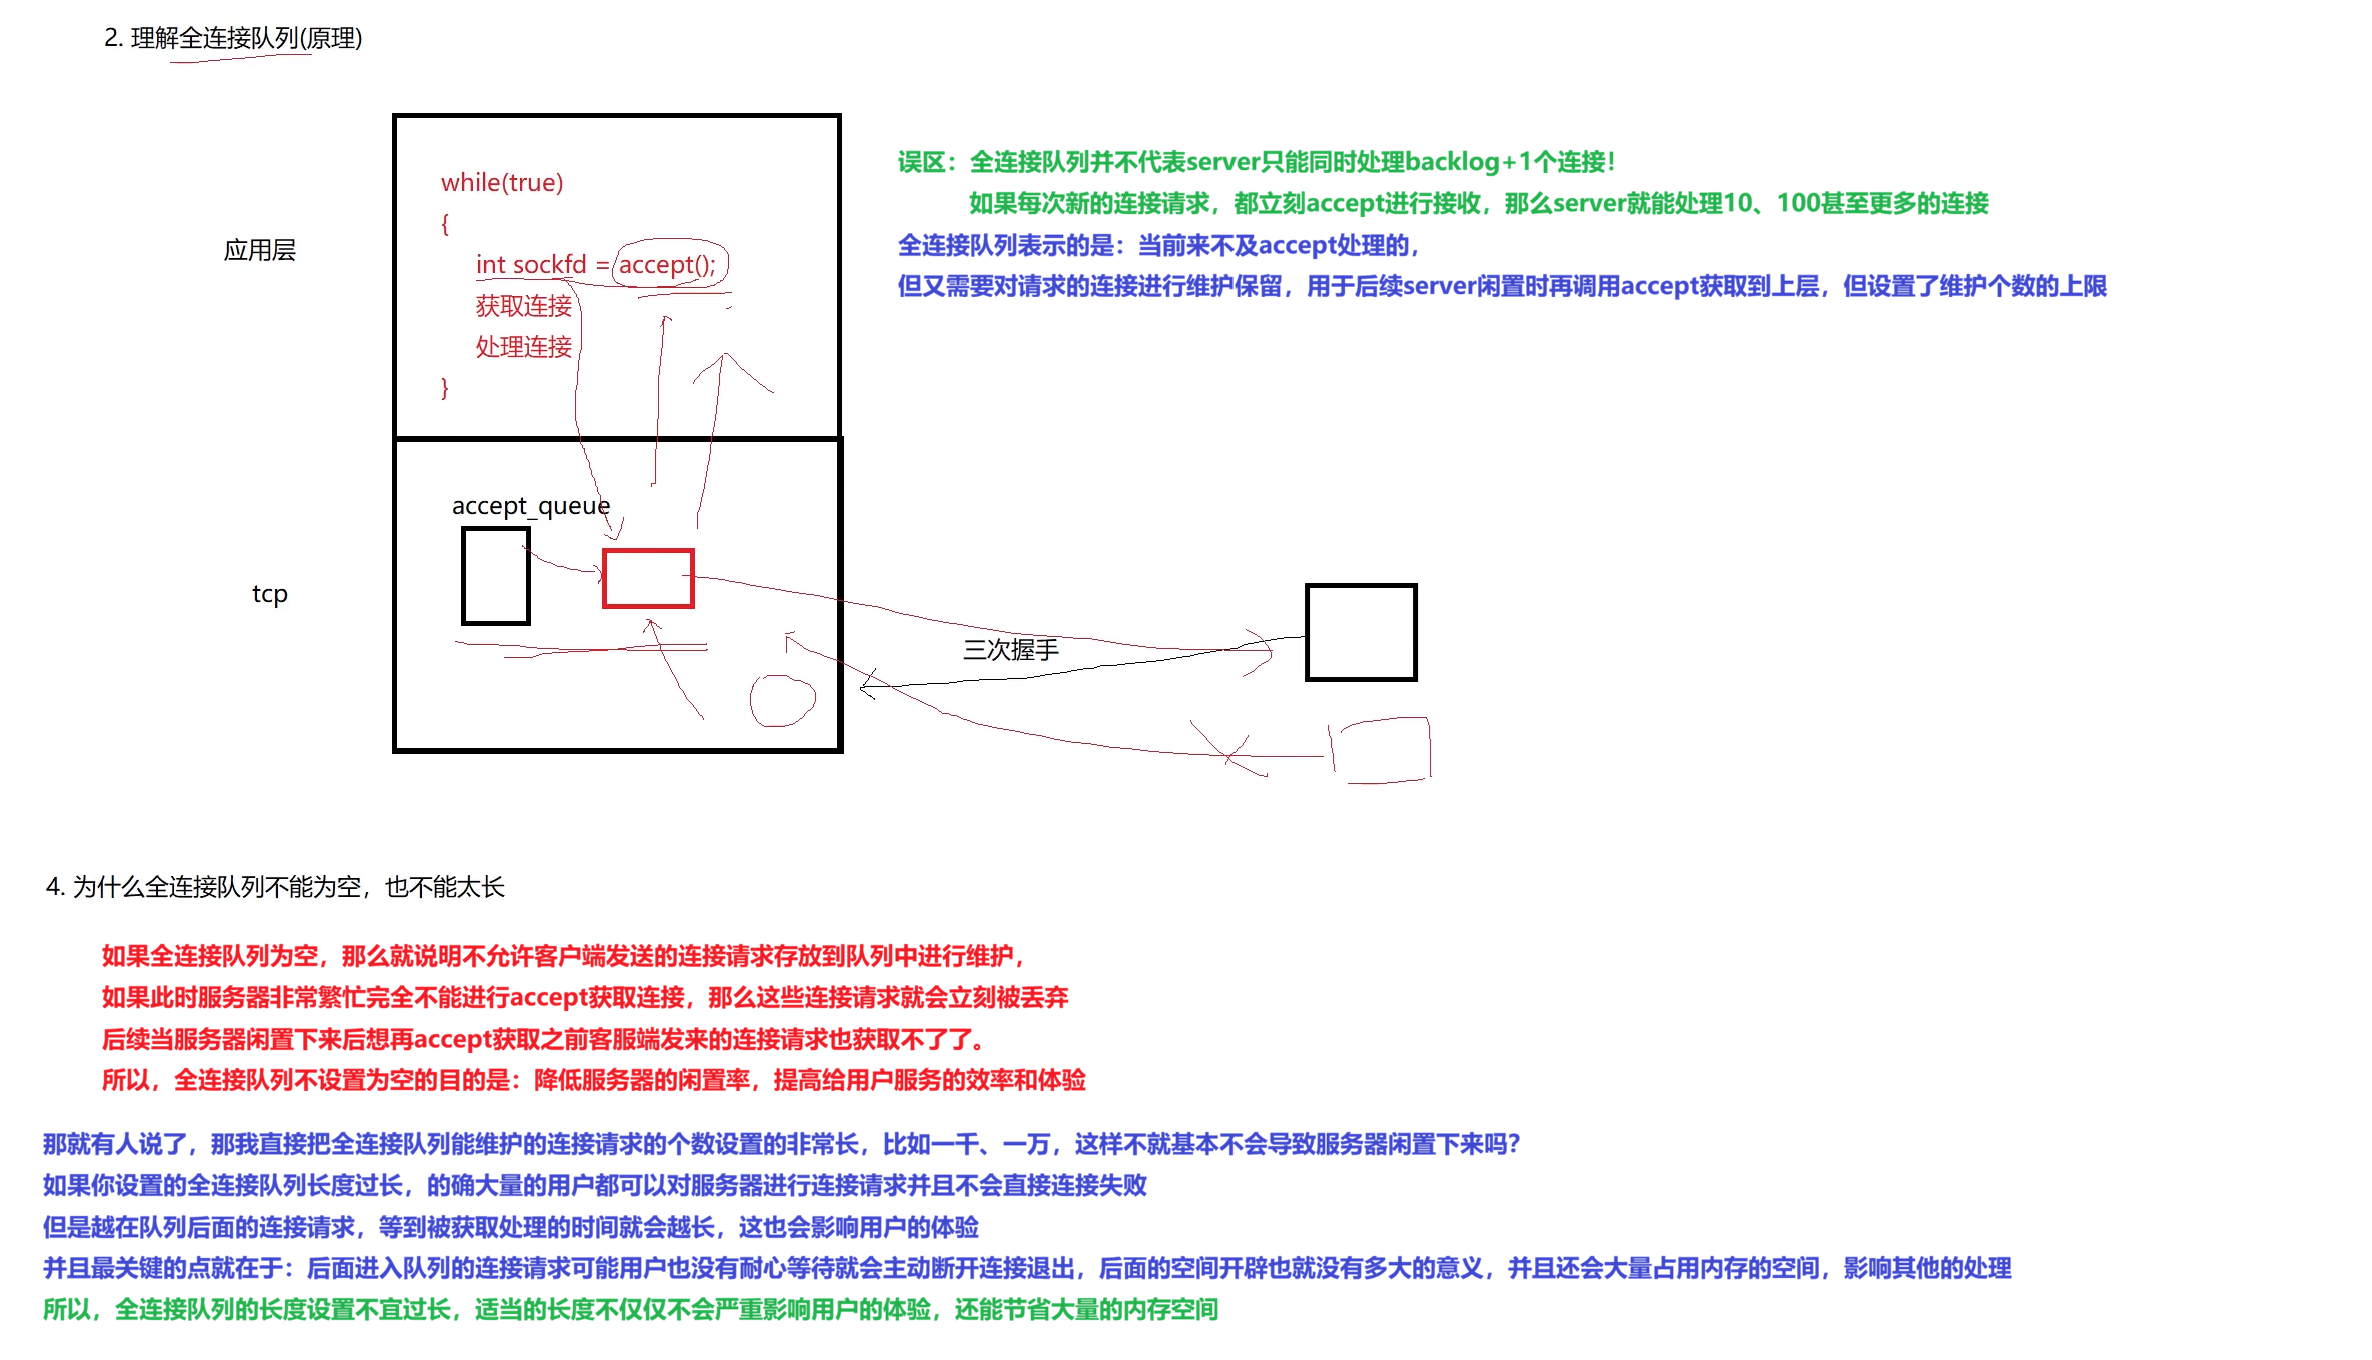
模型结构:
- 应用层 :服务端一般通过循环
accept(),不断从内核全连接队列取出连接,然后处理业务。 - 内核 TCP 层 :维护
accept_queue(全连接队列),作为内核与应用层之间的缓冲。三次握手完成后的连接,放入队列排队等待应用层读取。
高频误区: 全连接队列上限,不等于服务端总共只能处理 backlog+1 个连接 。
如果服务端代码可以及时调用
accept消费队列中的连接,队列不会堆积。服务器可以支持几十、上百甚至更多客户端同时通信。全连接队列的定位: 缓存来不及被 accept 取走、但已经完成握手的连接,用来抹平应用层和内核 TCP 握手的速度差。
1.7 全连接队列的设计取舍
1. 队列不能为空
如果队列容量设置为 0,内核不允许缓存任何已握手连接 。
当服务端繁忙,无法立刻执行 accept,新完成握手的连接会直接丢弃。后续服务端空闲后,也无法恢复这部分连接请求。
队列存在的意义: 平滑服务端短时压力,降低服务闲置率,提升连接成功率。
2. 队列不能设置过长
队列上限配置很大(例如 1000、10000),虽然可以缓存大量连接,但存在明显弊端:
- 排队靠后的连接等待
accept的时间很长,客户端等待时间增加,体验变差。 - 客户端长时间无响应,会主动断开连接,队列里排队的连接失效。
- 每一条 TCP 连接在内核都需要维护 TCP 控制块,队列过大,会占用大量内核内存,挤压其他进程资源。
结论:全连接队列需要设置一个合理适中的值,应对短时间流量波动,同时避免内存浪费和客户端超时。
二、如何理解连接
2.1 核心问题
当我们调用
socket()、accept()得到一个"连接"时,内核里究竟发生了什么?一个"连接"到底是什么?
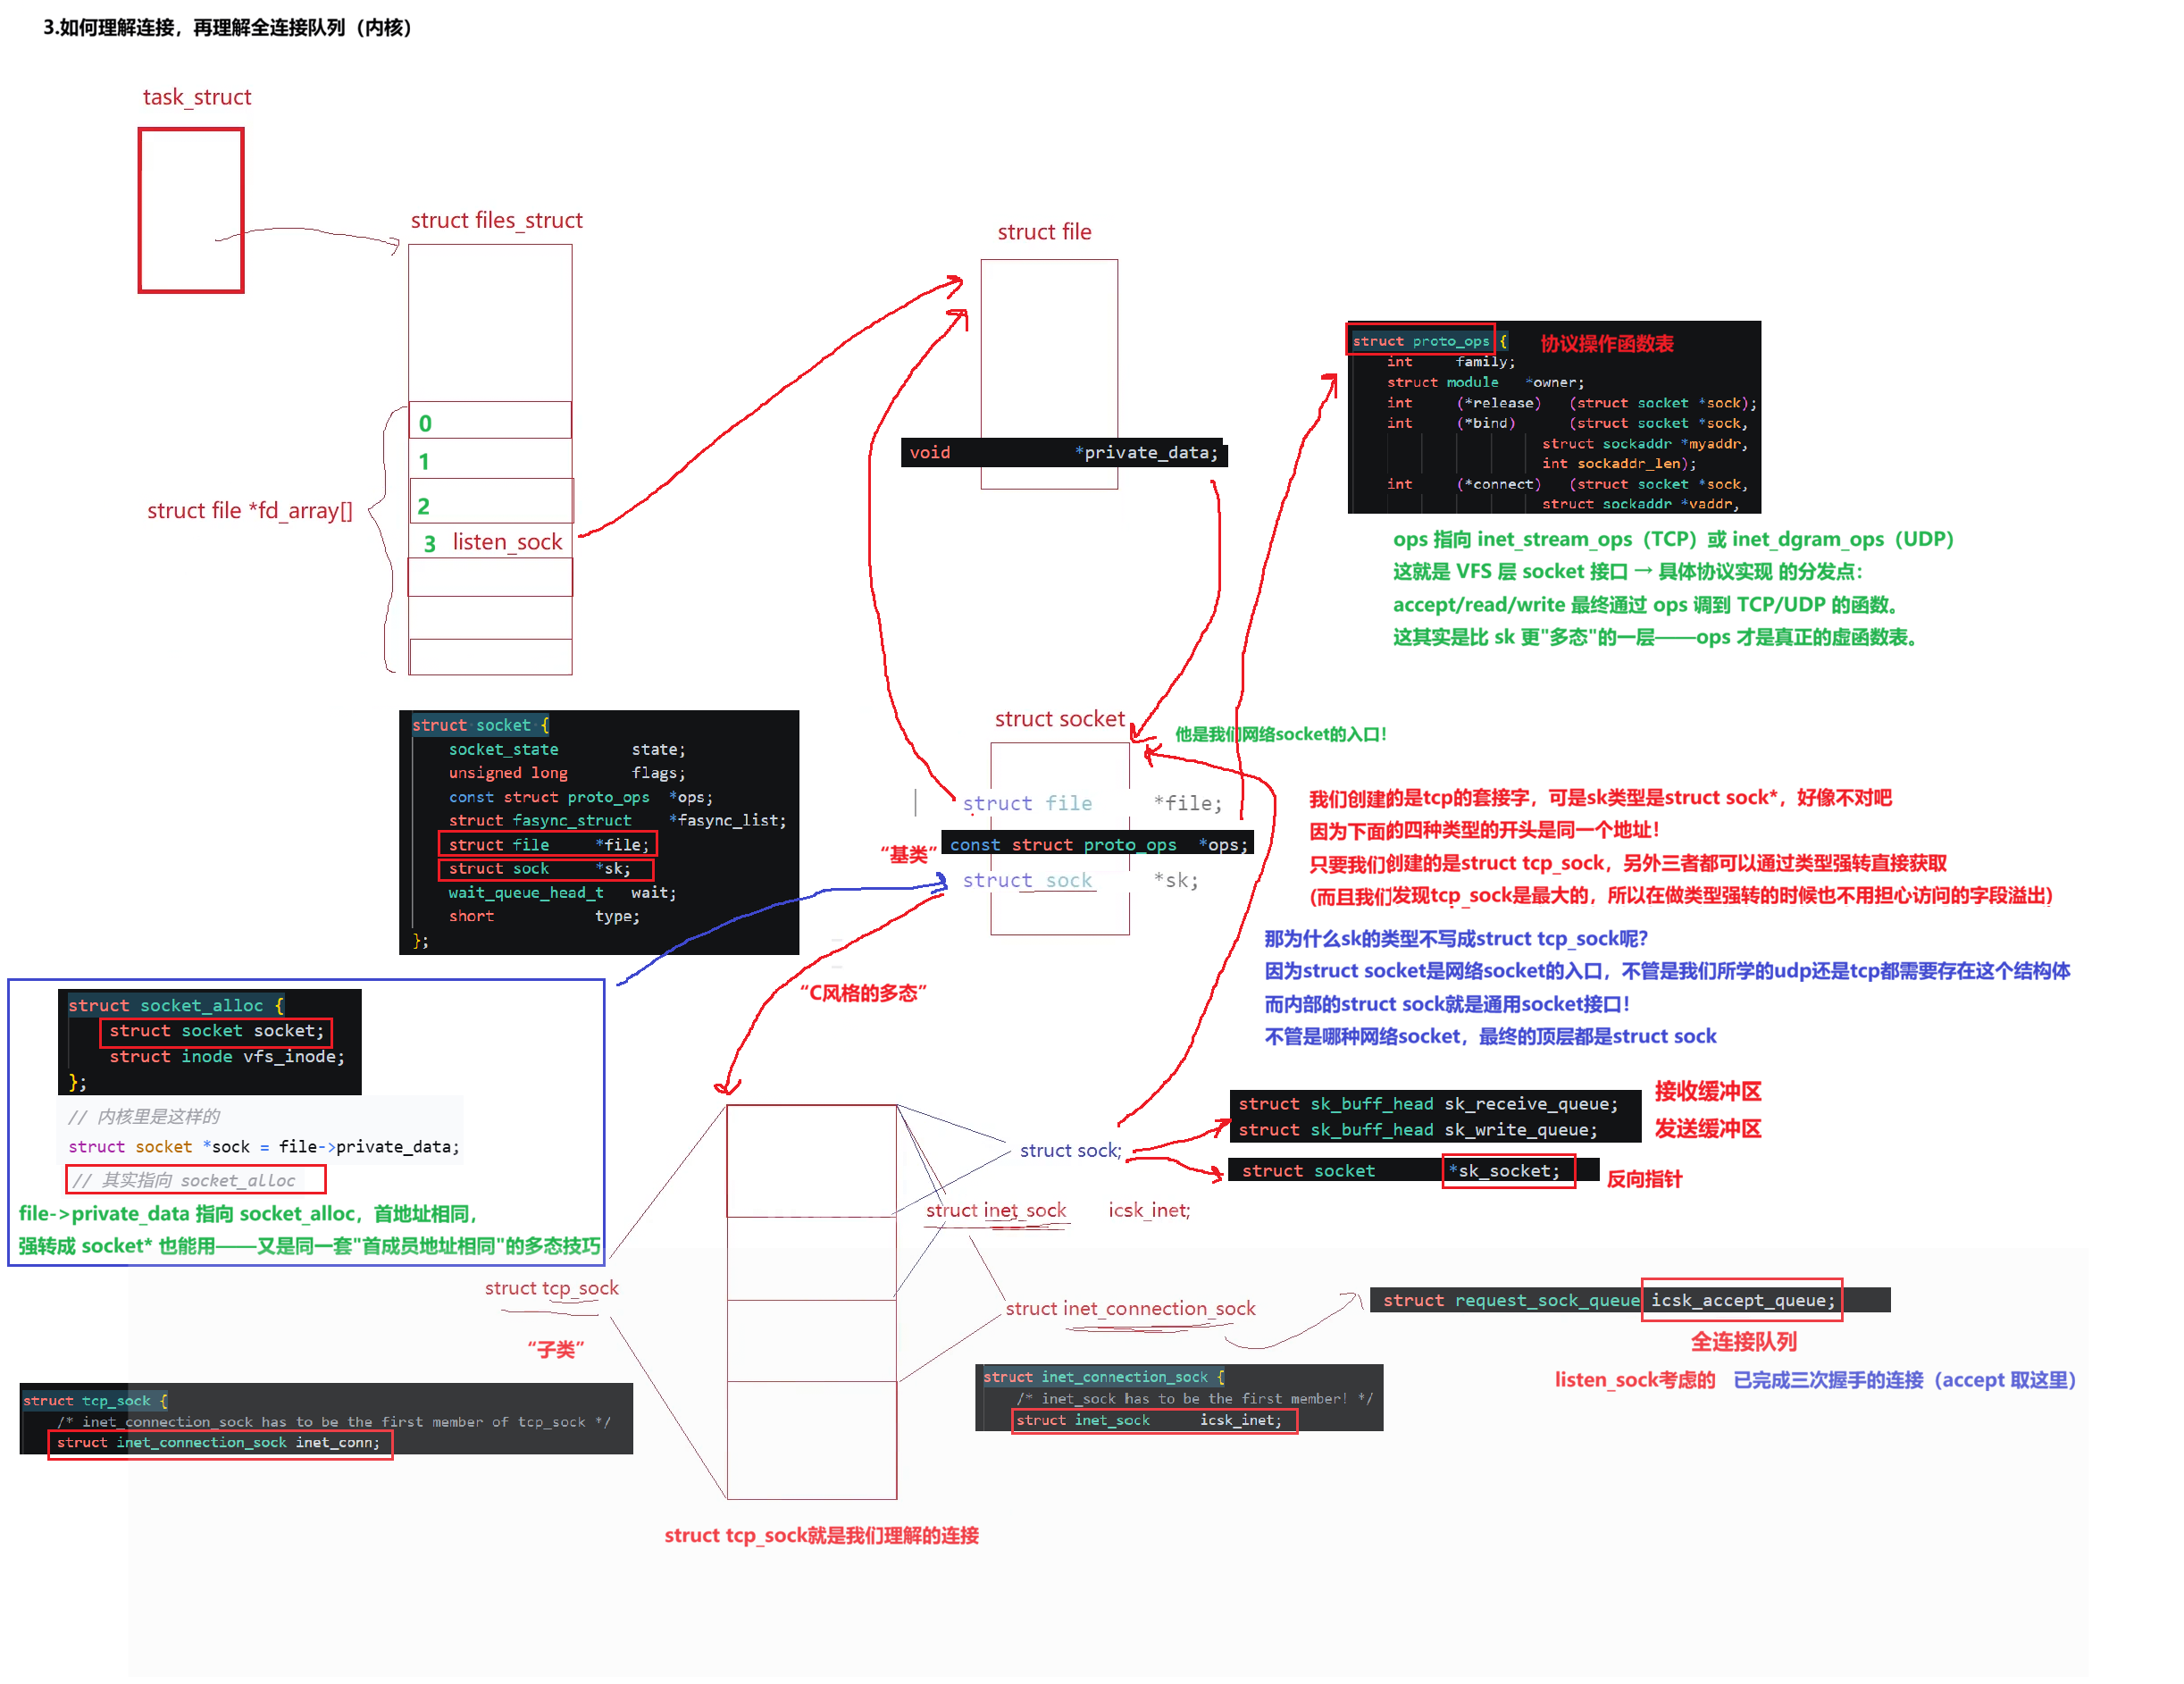
答案:一个连接 = 一条从 task_struct 到 struct tcp_sock 的完整指针链路。
2.2 完整链路总览(从进程到 TCP 连接)
bash
task_struct                        ← 进程
  └─ files_struct                  ← 进程打开的文件表
       └─ fd_array[fd]             ← 文件描述符数组(下标就是 fd)
            └─ struct file         ← VFS 通用文件对象
                 └─ private_data → socket_alloc
                                      ├─ struct socket   ← socket 层(首成员)
                                      │    ├─ ops  → proto_ops  ★虚函数表
                                      │    ├─ file → 回指 struct file
                                      │    └─ sk   → struct sock
                                      └─ struct inode
                                               ↓
                                        struct sock    ← 网络层"基类"
                                          ├─ sk_socket → 回指 struct socket
                                          ├─ sk_receive_queue   ★接收缓冲区
                                          ├─ sk_write_queue     ★发送缓冲区
                                          └─ inet_sock
                                               └─ inet_connection_sock
                                                    ├─ icsk_accept_queue ★全连接队列
└─ tcp_sock ← 我们理解的"连接"每一层用"首成员地址相同"完成向上/向下转型,这就是 C 语言实现的"多态"。
2.3 逐层拆解分析
1. 文件系统视角:进程怎么找到 socket?
| 结构 | 作用 |
|---|---|
task_struct |
进程控制块 |
files_struct |
进程打开的文件表 |
fd_array[] |
fd 数组,下标即 fd(0=stdin, 1=stdout, 2=stderr, 3=listen_sock) |
struct file |
VFS 层统一的文件对象 |
关键点:
-
一切皆文件,socket 也是文件,所以能用 fd 索引到。
-
listen_sock就是fd_array[3]那条链。 -
file->private_data是打通"文件"和"网络"的桥梁。
2. struct file → struct socket_alloc(易错点)
很多人以为 file->private_data 直接指向 socket,其实不是:
cpp
struct socket_alloc {
    struct socket  socket;      // ← 第一个成员
    struct inode   vfs_inode;
};内核分配时,socket 和 inode 是一起分配的 (一个 socket_alloc 容器),所以:
cpp
struct socket *sock = file->private_data;
// 物理上 private_data 指向 socket_alloc,
// 但 socket_alloc 首成员是 socket,首地址相同,
// 所以强转成 socket* 完全能用 ------ 又一次"首成员地址相同"的技巧。
为什么要这样设计?
因为 socket 也需要一个 inode 挂在 VFS 上,两者生命周期一致,一起分配更高效。
3. struct socket:socket 层(不是协议层)
cpp
struct socket {
    socket_state            state;
    short                   type;      // SOCK_STREAM / SOCK_DGRAM
    unsigned long           flags;
    struct file            *file;      // 反向指回 file
    struct sock            *sk;        // 指向协议栈
    const struct proto_ops *ops;       // 协议操作函数表
};
两个关键指针:
| 成员 | 指向 | 作用 |
|---|---|---|
sk |
struct sock |
进入协议栈 |
ops |
proto_ops |
VFS 层 → 具体协议的分发入口 |
ops 才是真正的"虚函数表":
cpp
struct proto_ops {
    int family;
    int (*release)(struct socket *);
    int (*bind)(struct socket *, struct sockaddr *, int);
    int (*connect)(...);
    int (*accept)(...);
    ...
};-
TCP 时
ops = &inet_stream_ops -
UDP 时
ops = &inet_dgram_ops -
用户调用
accept/read/write,最终通过ops分发到 TCP/UDP 的具体实现。
这是比
sk更"多态"的一层 ------sk是"数据",ops是"行为"。
4. struct sock:网络层"基类"
cpp
struct sock {
    ...
    struct socket  *sk_socket;        // 反向指回 socket
    struct sk_buff_head sk_receive_queue;   // 接收缓冲区
    struct sk_buff_head sk_write_queue;     // 发送缓冲区
    ...
};
为什么 socket 里的成员类型是 struct socket * 而不是直接是 struct tcp_sock *?
struct socket 是通用网络套接字入口 ,TCP/UDP/RAW 都要经过它,所以它只能持有通用的 struct sock*,不能持有某个具体协议的类型。
具体是 TCP 还是 UDP,由 type、ops、sk->sk_protocol 在运行时决定。
这就是"面向接口编程"在内核里的体现:
-
socket面向文件系统,统一所有协议。 -
sock面向协议栈,统一所有协议的"基类"。 -
具体协议(tcp_sock 等) 才是最终实现。
这层的两个缓冲区:
| 成员 | 对应 | 就绪条件 |
|---|---|---|
sk_receive_queue |
接收缓冲区 | 非空 → 可读 |
sk_write_queue |
发送缓冲区 | 非满 → 可写 |
5. 协议继承链:sock → inet_sock → inet_connection_sock → tcp_sock
bash
struct sock                       ← 通用网络基类
  └─ struct inet_sock             ← IPv4 层(加 IP 相关信息)
       └─ struct inet_connection_sock  ← 面向连接层(加连接管理)
            └─ struct tcp_sock     ← TCP 专有(加 TCP 状态机、滑动窗口等)
每层都是"首成员嵌套":
cpp
struct tcp_sock {
    struct inet_connection_sock inet_conn;   // 第一个成员
    ...
};

struct inet_connection_sock {
    struct inet_sock icsk_inet;              // 第一个成员
    ...
};

struct inet_sock {
    struct sock sk;                          // 第一个成员
    ...
};
所以:
-
向上转型(子→父)安全 :
tcp_sock*→sock*,直接强转即可,因为sock字段一定在。 -
向下转型(父→子)需谨慎:只有确认是 TCP 时才能转。
这才是"不用怕越界"的真正原因 ------ 因为子结构体物理上包含了父结构体,向上转永远不会越界。
6. 全连接队列:icsk_accept_queue(listen_sock 关心的核心)
cpp
struct inet_connection_sock {
    struct inet_sock           icsk_inet;        // 首成员
    struct request_sock_queue  icsk_accept_queue;  // ★连接队列
    ...
};重要澄清:icsk_accept_queue 里同时管两个队列:
| 队列 | 内容 | 触发 select 可读? |
|---|---|---|
| 半连接队列(SYN queue) | 收到 SYN、还没完成三次握手 | 不 |
| 全连接队列(accept queue) | 三次握手完成,等待 accept | 是 |
listensockfd可读 ⇔ 全连接队列非空 ⇔ 可以 accept。SYN Flood 攻击打的就是半连接队列 ------ 只发 SYN 不回 ACK,把半连接队列塞满。
2.4 三个"缓冲区/队列"与三种"就绪"
这是后续学习理解 select/epoll 的基础:
| fd 类型 | 检查对象 | 就绪条件 | 就绪后的动作 |
|---|---|---|---|
| 监听 fd | 全连接队列(icsk_accept_queue) |
非空 | accept |
| 连接 fd(读) | 接收缓冲区(sk_receive_queue) |
非空 | read |
| 连接 fd(写) | 发送缓冲区(sk_write_queue) |
非满 | write |
三条规则:
-
监听 fd 可读 = 有新连接 → 必须 accept,否则死循环。
-
连接 fd 可读 = 有数据 → 必须 read,否则死循环。
-
连接 fd 可写 = 缓冲区有空间(平时就就绪)→ 只在发送未完成时才关注,发完立即摘掉,否则空转。
结束语
本篇加餐我们从 listen 的 backlog 参数切入,拆解了内核中半连接队列与全连接队列的工作机制,结合三次握手时序纠正了很多常见理解误区,也通过实验理解了队列的设计取舍。之后我们逐层拆解了 TCP 连接的完整链路,区分了各类缓冲区、队列与就绪状态。
TCP 连接并不是简单停留在三次握手的理论层面,内核的队列模型才是服务端监听、接收连接真正的底层实现。理解这套机制,能帮我们在编写高并发服务端代码时合理设置 backlog,同时应对相关面试考点。