一.IO 的基本概念
I/O(input/output) 也就是我们说的输入和输出,在冯诺依曼体系结构当中,将数据从输入设备拷贝到内存就叫作输入,将数据从内存拷贝到输出设备就叫作输出。
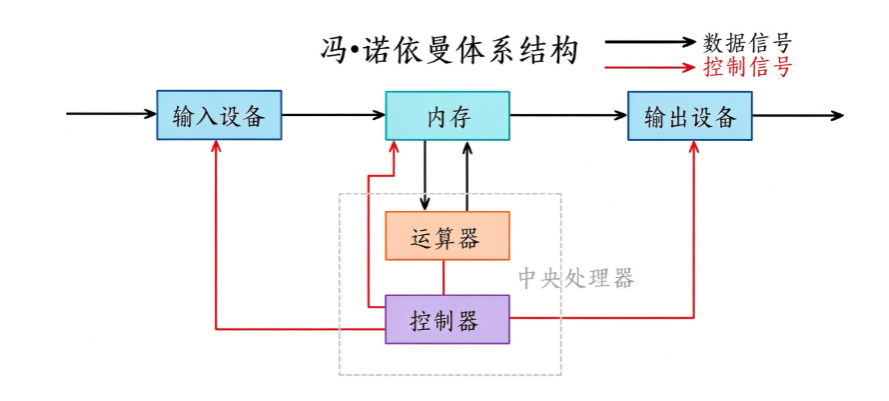
- 对文件执行读写操作本质就是 IO 操作,文件 IO 对应的硬件外设是磁盘。
- 对网络进行读写操作同样属于 IO 操作,网络 IO 对应的硬件外设是网卡。
总结:IO 就是主机和外部设备之间的数据传输。
OS 如何得知外设中有数据可读取?
输入操作,本质是操作系统把数据从外设拷贝到内存。操作系统需要有一种机制,判断对应外设是否已经准备好数据。
并不是操作系统发起读取时,外设就一定有数据可读 。**举个例子:**访问服务器时,客户端发出请求报文后,需要等待网卡收到服务器返回的响应。此时服务器可能还没收到请求、正在处理请求,或是响应报文还在网络上传输。操作系统不会持续主动轮询检测外设是否有数据。轮询会严重降低系统效率,绝大多数查询都是无效的空检测,白白消耗 CPU 资源。
操作系统实际依靠中断机制感知外设数据就绪。当外设准备好了数据,外设会向 CPU 内的中断控制器发送中断信号;中断控制器再根据中断信号的优先级,提交给 CPU。
每个中断信号都绑定了对应的中断处理程序。记录中断信号与中断处理程序映射关系的表,叫做中断向量表。CPU 收到中断信号后,会暂停当前正在执行的程序,查询中断向量表,执行对应的中断处理程序;中断处理完成之后,再回到原来被暂停的程序继续执行。
注意:CPU 不直接和外设进行数据层面的交互。但是外设可以直接向 CPU 内部的控制器发送控制信号(中断信号就属于这类控制信号)
目前IO 最主要的问题就是效率问题**,IO 的效率很低**。
以读取数据为例: 调用 read/recv 时,如果底层缓冲区没有数据,read/recv 就会阻塞等待。 调用 read/recv 时,如果底层缓冲区存在数据,read/recv 就执行数据拷贝(学习 TCP 时会了解,read/recv 这类接口本质就是完成数据拷贝)。
所以,IO 的本质分为两部分:等待(等待 IO 条件就绪) + 数据拷贝(IO 就绪后,把数据拷贝到内存或者向外设拷贝数据)。 只要缓冲区没有数据,read /recv 就会持续阻塞等待,直到缓冲区收到数据,再执行拷贝。read/recv 的大量时间都消耗在等待上,这就是阻塞 IO 低效的根源。
所有 IO 过程,都包含等待和拷贝两个阶段。在大多数实际场景里,等待耗费的时间远大于数据拷贝耗费的时间 。
OS 如何处理从网卡中读取到的数据包?
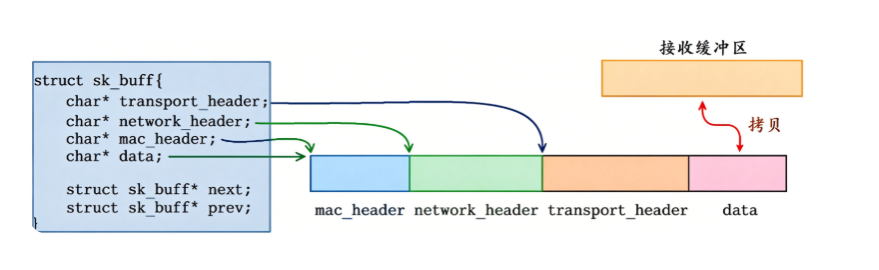
操作系统随时都可能收到大量数据包,内核需要对数据包进行统一管理。管理思路就是先描述,再组织 :在内核中存在sk_buff结构体,专门用来保存、管理收发数据包的相关信息。
简化版的 sk_buff 结构:
cpp
struct sk_buff{
    char* transport_header;
    char* network_header;
    char* mac_header;
    char* data;

    struct sk_buff* next;
    struct sk_buff* prev;
};操作系统从网卡读取数据包之后,会逐层把数据包交给链路层、网络层、传输层、应用层完成解包与分用,最后把数据包里的数据交付给上层应用。
那结合 sk_buff 结构体来看,数据包的解包和分用具体是怎么实现的?
- 操作系统从网卡拿到数据包,会创建一个
sk_buff结构体。用sk_buff里的data指针指向这个数据包;同时把多个sk_buff通过next、prev指针组织成双向链表。操作系统对数据包的管理,本质就是对这个双向链表做增删改查。- 首先交给链路层处理、解包分用:让
sk_buff的mac_header指针指向数据包起始位置。向后读取链路层头部,剩下的数据载荷,交给上层。到此完成链路层解包。- 链路层向上交付给网络层解包分用。这里的向上交付不会拷贝数据,只需要修改指针:让
sk_buff中的network_header指针,指向链路层头部之后的数据。向后读取网络层头部,完成网络层解包。- 传输层处理同理:修改
sk_buff的transport_header指针,指向网络层头部之后的数据。读取传输层头部,完成传输层解包。- 传输层解包完成后,根据 TCP/UDP 协议,把剩余的数据拷贝到对应传输层的接收缓冲区,等待上层用户读取。
发送数据时,也会对数据进行封装:操作系统会按照协议层次,依次在数据前面添加对应的协议报头。
但要注意:应用层以下的封装和解包,不能简单理解为 "每层都在频繁拷贝数据"。实际上,数据包的主体存储位置通常并没有发生变化,内核主要是通过 sk_buff 结构体中的不同指针,来标记和操作同一组网络数据。
例如:
mac_header:指向链路层报头起始位置;network_header:指向网络层报头起始位置;transport_header:指向传输层报头起始位置;data:指向实际数据载荷。
每层协议处理时,并不需要把整个数据重新复制一遍,而是让指针指向不同位置,从而快速定位本层协议头部。这是 sk_buff 提升处理效率的重要原因。
不过,内核中的 sk_buff 并不像上述模型这么简单,它需要同时满足两个核心目标:
1. 处理效率要高
网络报文需要在链路层、网络层、传输层之间快速传递。如果每层都拷贝一次数据,会产生很大的性能开销。因此,sk_buff 的设计必须尽量减少数据拷贝,通过指针移动、内存区域共享和灵活的缓冲区管理,提高协议处理速度。
2. 兼容所有网络协议
sk_buff 不是为某一种协议单独设计的,而是内核网络协议栈的通用数据结构。它必须能够同时支持 Ethernet、IP、TCP、UDP、ICMP、ARP 等不同协议,因此结构设计需要足够通用,既能描述各层报头,又能管理复杂的报文操作。
简单记忆:sk_buff 像一张多功能标签纸,贴在同一块网络数据上,不同指针分别指向 MAC 头、IP 头、TCP/UDP 头和数据区。
如何提高 IO 效率?
想办法在单位时间内,让等待的比重降低,这样 IO 的效率就提高了。
二.五种 IO 模型
我们可以把IO 的过程跟钓鱼的过进行类比的。
- 钓鱼这件事同样可以拆成等和拷贝两个步骤。这里的等,就是等待鱼咬钩;拷贝,就是鱼上钩之后,把鱼从河里转移到鱼桶里。
- IO 操作里,等待消耗的时间通常远大于数据拷贝的耗时,钓鱼也是一样。钓鱼大部分时间都在静静等待鱼上钩,一旦鱼咬钩,只需要很短时间就能把鱼 "拷贝" 上岸。
IO:等待外设数据就绪(等) + 拷贝数据到内存(拷贝) 钓鱼:等待鱼咬钩(等) + 把鱼捞进桶(拷贝)
考点:IO 的瓶颈大多在等待,而不是拷贝数据。
看下面五个人的不同钓鱼方式:
- 张三:拿 1 根鱼竿,鱼钩抛入水中后,一直盯着浮漂,不做其他任何事,直到鱼上钩,再挥竿把鱼钓上来。(阻塞 IO)
- 李四:拿 1 根鱼竿,鱼钩抛入水中后,可以去做别的事,每隔一段时间就过来查看浮漂状态。如果鱼上钩就起竿,没鱼就继续忙自己的事。(非阻塞轮询 IO)
- 王五:拿 1 根鱼竿,鱼钩抛入水中,在竿梢绑上铃铛,之后就可以去做别的事情。铃铛响代表鱼上钩,此时再来起竿;铃铛不响就不用管这根鱼竿。(信号驱动 IO)
- 赵六:准备 100 根鱼竿,全部抛入水中,然后定期查看这 100 个浮漂。哪根鱼竿有鱼上钩,就拉起对应的鱼竿。(IO 多路复用 / 多路转接)
- 田七:作为负责人,他想钓鱼,但需要立刻赶回公司开会。于是拿出一根鱼竿,交给司机去垂钓。等司机把鱼桶装满之后,再打电话通知他。(异步 IO)
补充一下:
- 阻塞 IO:全程死等,不能干别的;
- 非阻塞轮询:不断主动检查,反复询问有没有就绪;
- 信号驱动:外设就绪主动发信号通知;
- IO 多路复用:一次性监控多个 IO,哪个就绪处理哪个;
- 异步 IO:全程交给内核完成等待 + 拷贝,完成后通知应用。
张三、李四和王五钓鱼的效率一样吗?
张三、李四和王五钓鱼的整体效率本质是相同的。 他们钓鱼的底层流程没有区别:都需要先等待鱼咬钩,鱼上钩之后再把鱼钓上来。
其次,三人都只使用一根鱼竿等待鱼上钩。河里的鱼咬任意一个鱼钩的概率是均等的。
所以张三、李四、王五三人钓鱼的效率相同,差异只在于等待鱼上钩的方式不同。张三原地阻塞等待;李四定时主动查看浮漂;王五依靠铃铛收到通知。
阻塞 IO、非阻塞轮询 IO、信号驱动 IO,三者的等待时间和数据拷贝耗时基本一致,效率上限相同,只是等待的实现方式不同。它们都需要应用程序自己完成后续的数据拷贝操作。
谁的效率更高?
赵六的效率更高。赵六可以同时监控多根鱼竿,让等待的时间重叠在一起,单位时间内有鱼上钩的概率大幅提升。
假设赵六准备 97 根鱼竿,张三、李四、王五各持 1 根,总共 100 根鱼竿。鱼咬任意鱼钩的概率均等,鱼咬到张三、李四、王五单根鱼竿的概率各为 1%,而咬到赵六鱼竿的总概率达到 97%。
在单位时间内,赵六这边出现鱼上钩事件的概率,是张三、李四、王五单人的 97 倍。高效钓鱼的核心就是减少无效等待的占比,增加实际捞鱼(拷贝)的时间。赵六可以一次性等待多个鱼竿,实现等待时间复用,所以四个人当中赵六的效率最高。
如何看待田七钓鱼方式?
田七把钓鱼这件事交给司机去完成,自己返回公司处理别的事务。他并不关心司机采用哪种方式钓鱼,司机可以用张三、李四、王五、赵六任意一种方案;田七只需要等司机通知,确认鱼桶是否装满。
田七本人不参与钓鱼的全过程,只是下发钓鱼任务,实际钓鱼的是司机。在司机钓鱼的这段时间里,田七可以去做其他任何工作。如果把钓鱼类比成 IO 操作,田七这种模式就是异步 IO。
反观张三、李四、王五、赵六,都需要自己等待鱼上钩,鱼上钩之后还要自己完成捞鱼动作。映射到 IO 模型里,代表应用程序需要自己完成数据拷贝,所以这四种都属于同步 IO。
- 同步 IO:应用进程需要亲自处理等待或者数据拷贝。
- 异步 IO:内核负责完成等待 + 数据拷贝全部工作,任务全部完成后通知应用程序,应用全程不用参与等待和拷贝。
简单记忆:同步 IO 要自己动手(等或拷贝);异步 IO 全部交给内核,做完通知你。
通过这个钓鱼例子可以看出:阻塞 IO、非阻塞 IO 和信号驱动 IO,并不能提升 IO 本身的效率 。但非阻塞 IO 和信号驱动 IO,可以提升程序整体的任务处理效率。
在这个钓鱼场景里,所有事物都可以和 IO 模型里的概念一一对应:
- 鱼 --> 数据
- 河 --> 内核
- 浮标 --> 文件描述符的就绪事件
- 每一个人 --> 执行流(进程 / 线程)
- 司机 --> 操作系统
- 鱼竿 --> 文件描述符 / 套接字
- 装鱼的桶 --> 用户缓冲区
1.阻塞 IO
在内核将数据准备好之前,系统调用会一直等待。阻塞 IO 是最常见的 IO 模型,所有的套接字,默认都是阻塞方式。
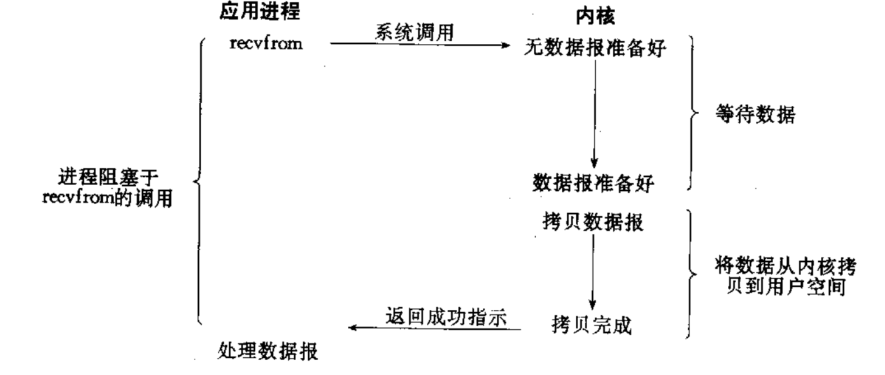
图的过程如下:
调用 recvfrom 从套接字读取数据时,如果底层数据还没有准备好,进程就需要等待数据就绪;数据就绪之后,再把数据从内核拷贝到用户空间,最后 recvfrom 函数才会返回。
在 recvfrom 等待数据就绪的这段时间,用户视角下进程 / 线程处于阻塞状态。本质上是操作系统把该进程或线程修改为非就绪状态,放入等待队列。等数据就绪后,操作系统再把它从等待队列唤醒,接着进程完成内核到用户空间的数据拷贝。
以阻塞方式执行 IO 的进程或线程,在等待和拷贝的整个阶段函数都不会返回,表现为程序卡住,这就是阻塞 IO
2.非阻塞 IO
如果内核还未将数据准备好, 系统调⽤仍然会直接返回, 并且返回EWOULDBLOCK错误
码.
⾮阻塞IO往往需要程序员循环的⽅式反复尝试读写⽂件描述符, 这个过程称为轮询. 这对CPU来说是较⼤的浪费, ⼀般只有特定场景下才使⽤.
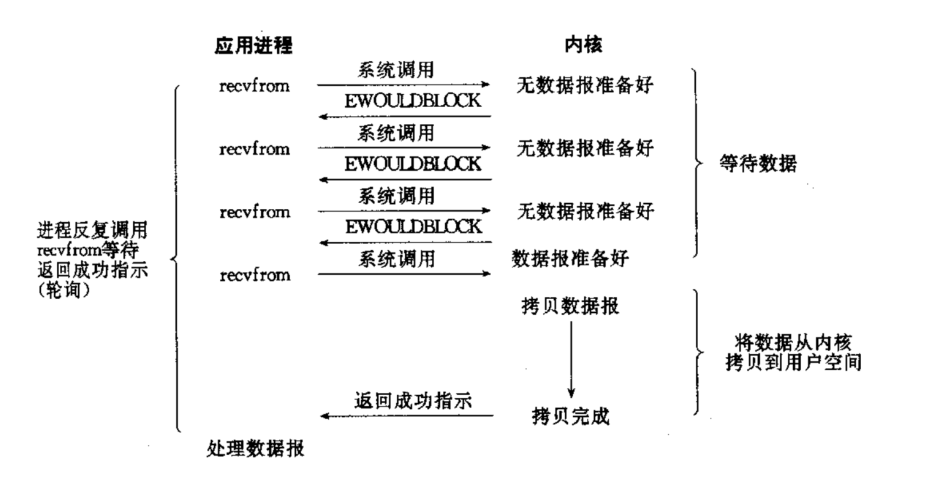
当调用 recvfrom,以非阻塞方式从套接字读取数据时,如果底层数据尚未就绪,recvfrom 会立刻返回错误,不会让进程 / 线程阻塞等待。
因为本次没有读到数据,进程 / 线程需要反复调用 recvfrom,主动检查底层数据是否就绪。每次检查如果数据依旧未就绪,函数就继续报错返回;直到某次调用检测到数据就绪,才会把数据从内核拷贝到用户空间,然后成功返回。
每次调用 recvfrom 读取数据,哪怕数据没有准备好,函数都会立即返回。在用户视角,进程或线程不会卡住,这就是非阻塞 IO。
阻塞 IO 和非阻塞 IO 的核心区别:阻塞 IO 在数据未就绪时,由操作系统负责等待和检测;非阻塞 IO 在数据未就绪时,由用户进程主动反复发起检测(轮询) 。
阻塞 IO 让 OS 帮你等;非阻塞 IO 自己循环反复查,查到就绪为止。
3.信号驱动 IO
内核将数据准备好的时候, 使⽤SIGIO信号通知应⽤程序进⾏IO操作
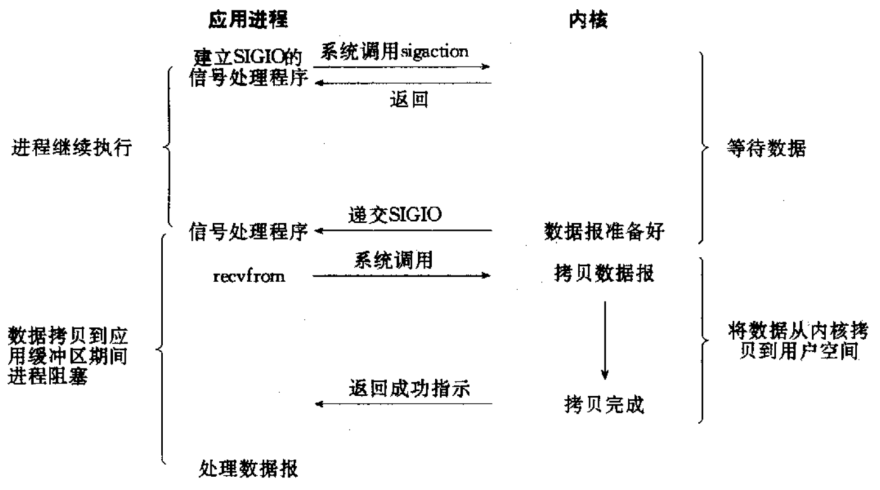
当底层数据就绪后,会向当前进程 / 线程发送 SIGIO 信号。我们可以使用 signal 或者 sigaction 函数自定义 SIGIO 的信号处理函数,把要执行的 IO 操作写在这个处理函数里面。一旦底层数据就绪,系统就会自动执行这个信号处理函数。
举例:如果要调用 recvfrom 从套接字读取数据,就可以把这个读取操作写进 SIGIO 的信号处理程序。 当底层数据就绪,操作系统递送 SIGIO 信号,会自动执行预先定义好的信号处理函数,由进程完成将数据从内核拷贝到用户空间的操作。
信号的产生是异步的,但信号驱动 IO 属于同步 IO。 信号产生是异步的,信号可以在任意时刻触发。但信号驱动 IO 仍然归类为同步 IO:当数据就绪触发信号后,进程需要暂停当前工作,去执行数据拷贝操作,进程依旧需要亲自参与 IO 的拷贝环节。
判断一个 IO 过程是同步还是异步的,其本质就是看当前进程或线程是否需要参与 IO 过程,若参与即为同步 IO,否则为异步 IO。
4.IO 多路转接
从流程图上看起来和阻塞 IO 有些类似,IO 多路转接也被称为 IO 多路复用,实际上最核心在于 IO 多路转接能够同时等待多个文件描述符的就绪状态。
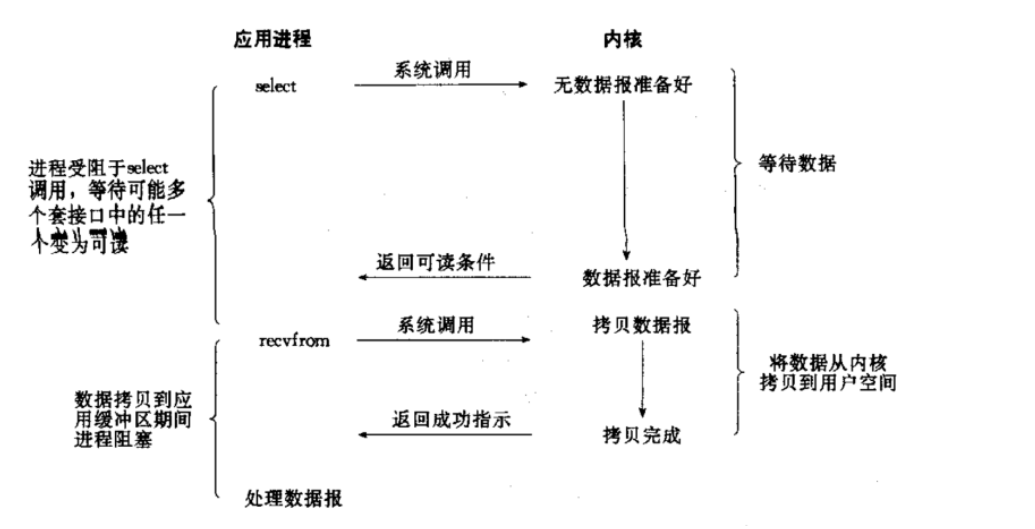
IO 多路转接的思想:
IO 的过程分为等待和拷贝两个步骤,recvfrom 这类接口底层实际上会完成两件事:数据未就绪时执行等待,数据就绪后执行数据拷贝。
虽然 recvfrom 本身具备等待能力,但这类接口一次只能等待一个文件描述符的就绪事件,IO 处理效率很低。
因此系统提供了三组接口:select、poll、epoll。这一组多路转接接口的核心工作就是专门负责等待,我们可以把全部等待工作交给它们。
多路转接接口可以一次性同时等待多个文件描述符,实现多个 IO 的等待时间重叠。当检测到某个文件描述符数据就绪后,再调用对应的 recvfrom 函数完成数据拷贝;此时调用 recvfrom 不再需要等待,直接执行拷贝。
IO 多路转接可以类比成帮多人排队的黄牛:多路转接接口本身不做数据拷贝,只负责等待。黄牛可以一次性帮多个人排队,让多个人排队等待的时间重叠在一起。
5.异步 IO
由内核在数据拷贝完成时,通知应用程序(而信号驱动是告诉应用程序何时可以开始拷贝数据)。
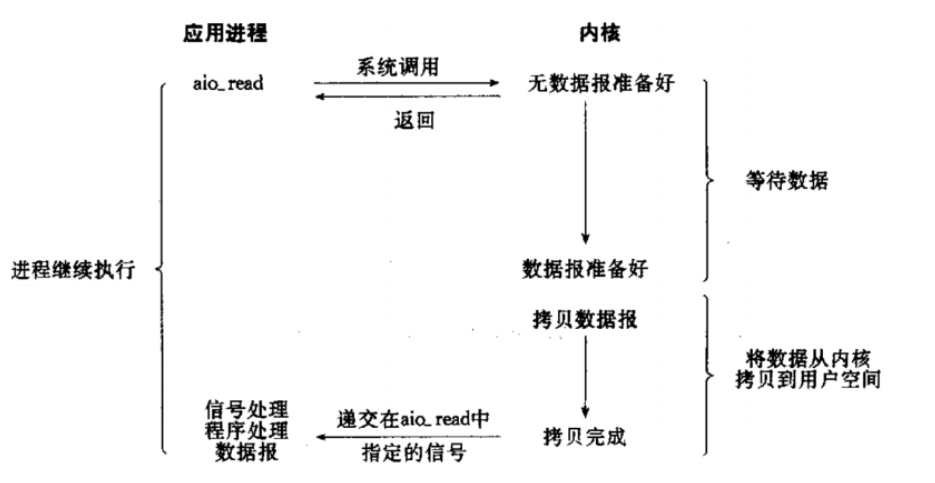
- 进行异步 IO 时,需要调用异步 IO 专用接口。异步 IO 接口调用之后会立刻返回。异步 IO 不需要调用者自己做 "等待" 和 "拷贝",等待数据就绪、内核向用户空间拷贝数据这两步全部由操作系统完成,应用程序只需要发起 IO 请求。
- 当整套 IO 操作全部完成之后,操作系统再来通知应用程序。所以执行异步 IO 的进程 / 线程,不需要参与 IO 过程里的任何细节。
6.小结
任何 IO 过程,都包含两个步骤:等待 和 拷贝。
在真实业务场景里,等待消耗的时间通常远大于拷贝耗时。想要提升 IO 效率,最核心思路就是尽可能减少单位时间内的等待耗时。
三.高级 IO 的重要概念
1.同步通信 VS 异步通信(Synchronous Communication / Asynchronous Communication)
同步与异步,关注的是消息通信的机制。
所谓同步: 发起调用 之后,如果没有拿到结果,调用 就不会返回。一旦调用 返回,就能拿到返回值。简单来说,由调用者主动等待调用结果。
异步刚好相反:调用 发出后会直接返回,此时还没有得到最终结果。也就是说,发起异步调用 后,调用者 无法立刻获取结果。后续由被调用 方,通过状态标记、通知或者回调函数的方式,告知调用者 ,完成这次调用的后续处理。
为什么非阻塞 IO 在没有得到结果之前就返回了?
- IO 分为等待和拷贝两个步骤。调用
recvfrom执行非阻塞 IO 时,如果数据还未就绪,函数会直接返回。这次返回并不代表完成了一次完整 IO,属于错误返回。- 所以进程 / 线程需要反复调用
recvfrom,通过轮询持续检测数据是否就绪。直到某次轮询发现数据就绪,将数据从内核拷贝到用户空间,才算完成一次完整的 IO。- 因此非阻塞 IO 虽然在没拿到数据时就提前返回,但进程后续还要不断轮询检测。可以理解为这次 IO 任务并没有真正结束;只有当轮询检测到数据就绪,并且完成数据拷贝,才算这次调用真正完成。
在学习多进程、多线程的时候,我们也提到过同步和互斥,但这里的同步通信,和进程间的同步是完全不相干的概念。
- 进程 / 线程同步:是在保证数据安全的前提下,让进程、线程按照特定顺序访问临界资源,避免饥饿问题,描述的是多个进程或线程之间的协作关系。
- 同步 IO:描述的是进程 / 线程和操作系统之间的关系,关注进程 / 线程是否需要主动参与 IO 的处理过程。
注意:尤其是在访问临界资源的时候,一定要分清这个 "同步",到底是同步 / 异步通信里的同步,还是同步与互斥里的同步。
2.阻塞 VS 非阻塞
阻塞和非阻塞关注的是程序在等待调用结果(消息,返回值)时的状态。
- 阻塞调用是指调用结果返回之前,当前线程会被挂起。调用线程只有在得到结果之后才会返回。
- 非阻塞调用指在不能立刻得到结果之前,该调用不会阻塞当前线程。
3.其他⾼级IO
⾮阻塞IO,纪录锁,系统V流机制,I/O多路转接(也叫I/O多路复⽤),readv和writev函数以及存储映射IO(mmap),这些统称为⾼级IO.
我们此处重点讨论的是I/O多路转接
4.妖怪蒸唐僧的例子(4 种组合,对应同步 / 异步 + 阻塞 / 非阻塞)
区分两组独立概念: 同步 / 异步:谁通知结果 阻塞 / 非阻塞:等待时线程会不会挂起
- 同步阻塞 妖怪点着火,一直守在蒸锅旁边,原地不动,什么别的事都不干。直到锅烧开、唐僧蒸熟,才开始下一步。等待期间妖怪完全卡住,不能做任何其他工作。
- 同步非阻塞 妖怪点着火,去山洞干别的活。每隔一段时间过来查看蒸锅,没熟就回去继续干活,隔一会再来检查。不会原地卡住,但必须自己反复主动轮询查看状态。
- 异步阻塞(几乎不用,了解即可) 妖怪安排小妖盯着蒸锅,熟了之后来通知妖怪。但妖怪不离开,原地坐着等小妖消息,什么事都不干。(现实中基本不会这么用)
- 异步非阻塞 妖怪吩咐小妖看管蒸锅,蒸熟之后再来通知自己。交代完事情妖怪直接离开,去做别的工作,不用守在蒸锅旁边,也不用主动过来查看。等全部完成,小妖再来通知妖怪。
小结:
- 同步:妖怪自己要参与后续处理;
- 异步:交给小妖完成全部流程,做完通知妖怪;
- 阻塞:等待的时候原地不动,不能干别的;
- 非阻塞:等待的时候可以去做其他任务。