♻️ 资源
大小: 3.34MB
➡️ 资源下载: https://download.csdn.net/download/s1t16/87484800 https://download.csdn.net/download/s1t16/87484800
实现 TINY+ 编译器
实验概述
【实验目的】
构造一个将 TINY+ 高级程序设计语言转换为 TINY+ 虚拟机上的中间代码的编译器。
整个实验包括两个部分:实验一完成 TINY+ 编译器的词法分析器部分;实验二完成 TINY+ 编译器的语法分析器部分、语义分析器部分及中间代码生成器部分。
【实验环境】
Microsoft VisuaStudio 2015
C++ 语言实现
实验内容
实验一、 实现 TINY+ 编译器的词法分析器
【实验目的及要求】
学生在该实验中构造 TINY+ 语言的词法分析程序。具体要求如下:
1 词法分析器的输入是源程序文件,输出是单词(token)流。
2 构造的词法分析器必须遵循最长子串原则,例如字符串':=' 应该被识别为一个代表赋值符号的单词,而不是识别为两个单词':'和 '='。
3 词法分析器识别出的单词应该被表示成二元组的形式(Kind, Value),其中 Kind 表示单词的种类,Value 表示单词的实际值。要求用如下符号表示不同种类的单词:
KEY 表示关键字;
SYM 表示特殊符号;
ID 表示标识符;
NUM 表述数字常量
STR 表示字符串常量
4 词法分析器的任务除了完成对单词的识别之外,还要检查程序中的词法错误,给出错误的信息以及错误在源程序中出现的位置(所在的行号)。词法错误的种类包括:
非法符号,词法分析器可能识别到一个 TINY+ 程序的字母表中不允许的符号,例如,词法分析器在一个源程序中识别到 $,应报告一个词法错误,发现了一个非法符号;
字符串类型的单词 STRING,单引号不匹配。例如,源程序中出现' scanner,词法分析分析器应报告错误"字符串缺少右引号";
注释的括号不匹配。例如源程序中出现{this is an example,词法分析器应报告错误"注释缺少右括号"。
算法分析实验过程:
1.在 main 函数中将 NO_ANALYZE、NO_CODE、PARSE 设置为 TRUE,使程序只进行词法分析过程。
2.由于增加了关键字(keyword),TINY 语言关键字如下:
|-------------|-------------------------------------------|
| Tiny 关键字 | if,then,else,end ,repeat,until,read,write |
| Tiny+ 新增关键字 | Or,and ,int,bool,char,while,do |
其中所有的关键字是程序设计语言保留使用的,并且用小写字母表示,用户自己定义的标识符不能和关键字重复。
3.特殊符号定义:
|------------|-------------------------------------------------|
| Tiny 符号 | { } ; := + - /()<=** |
| Tiny+ 新增符号 | > <= >= , ' |
4.词法分析器中识别的单词用二元组形式表示(Kind,Value),其中 Kind 表示单词的种类,Value 表示单词的实际值。要求用如下符号表示不同种类的单词:
|-----|-------|
| KEY | 关键字 |
| SYM | 特殊符号 |
| ID | 标识符 |
| NUM | 数字常量 |
| STR | 字符串常量 |
5,词法分析器的任务除了完成对单词的识别之外,还要检查程序中的词法错误,给出错误的信息以及错误在源程序中出现的位置(所在的行号)。词法错误的种类包括:
非法符号,词法分析器可能识别到一个 TINY+ 程序的字母表中不允许的符号,例如,词法分析器在一个源程序中识别到 $,应报告一个词法错误,发现了一个非法符号;
字符串类型的单词 STRING,单引号不匹配。例如,源程序中出现' scanner,词法分析分析器应报告错误"字符串缺少右引号";
注释的括号不匹配。例如源程序中出现{this is an example,词法分析器应报告错误"注释缺少右括号"。
实验过程:
在 GLOBALS.h 中的 TokenType 枚举中增加相应的类型:
|--------|--------|--------|--------|
| 关键词 | 特殊符号 | | |
| 新增枚举定义 | 对应的关键词 | 新增枚举定义 | 对应特殊符号 |
| OR | or | RT | > |
| AND | and | LTEQ | <= |
| INT | Int | RTEQ | >= |
| BOOL | bool | COMMA | , |
| CHAR | char | CO | ' |
| WHILE | while | | |
| DO | do | | |
在 SCAN.C 的 getToken()函数中进行相应修改,让程序能够正确识别新添加的关键词以及特殊符号,并且对程序出错进行相应提示)
词法分析测试结果
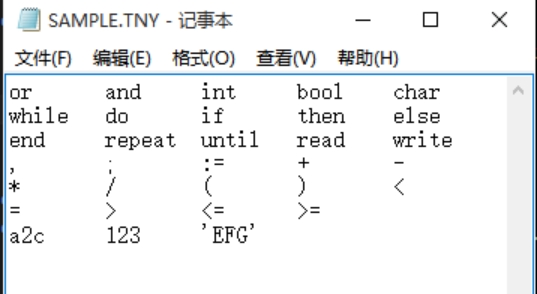
测试一:
输入:
输出:
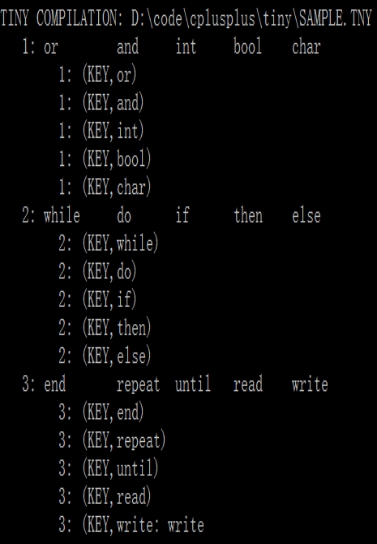
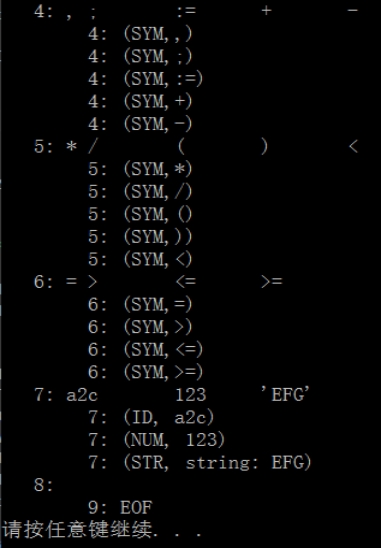
测试二:
输入:
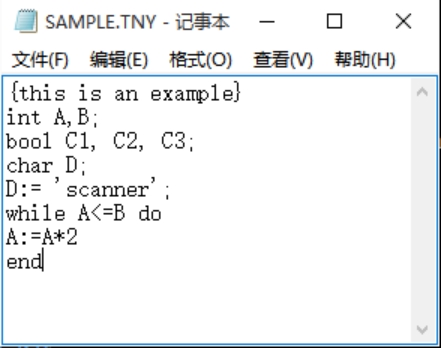
输出:
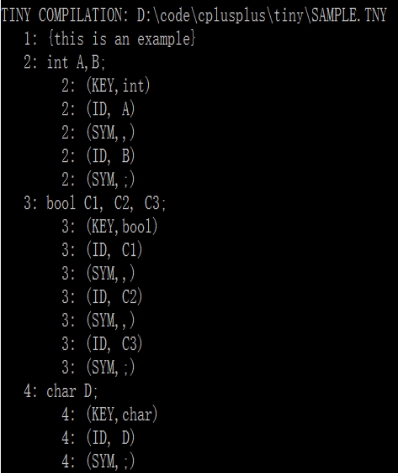
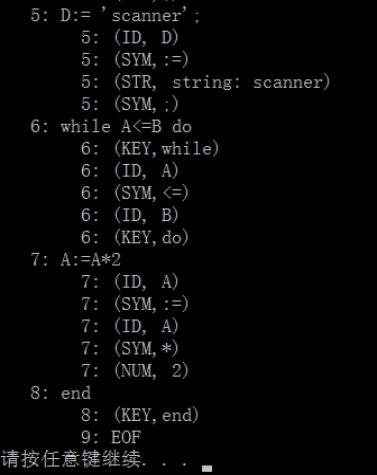
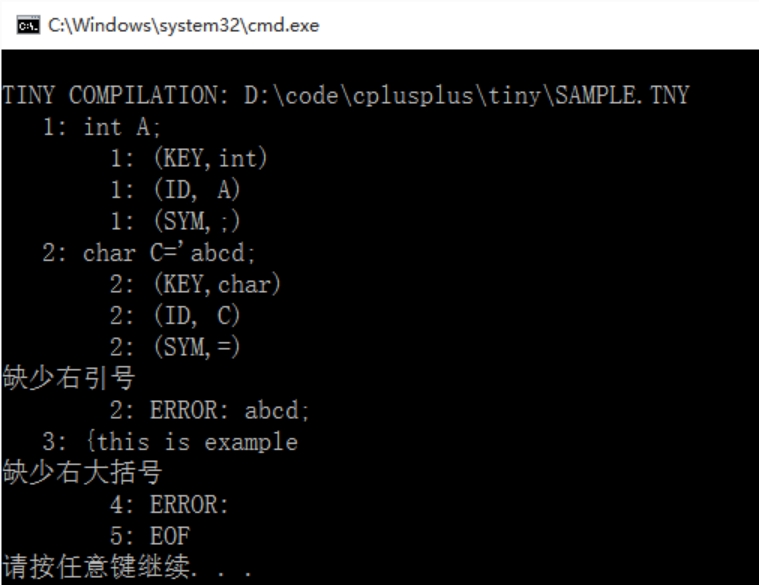
测试三:(测试错误提示)
输入:
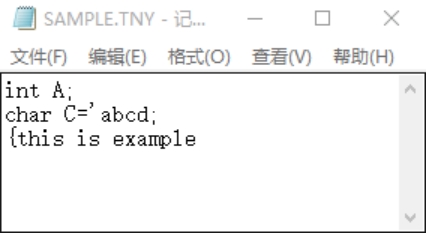
输出:
实验二、实现 TINY+ 的语法分析器、语义分析器以及中间代码生成器
*【实验目的及要求】
学生在该实验中构造 TINY+ 语言的语法分析器、语义分析器以及中间代码生成器,具体要求如下:
1 为 TINY+ 构造一个递归下降语法分析器。该语法分析器对词法分析器生成的单词序列进行语法分析,产生一颗抽象语法树作为语法分析器的输出。
2 构造 TINY+ 的语义分析器,该语义分析器构建符号表,然后检查程序中的语义错误。
3 构造 TINY+ 的中间代码生成系,该中间代码生成器将 TINY+ 程序翻译为三地址中间代码。
4 要求能检查程序中语法和语义错误,具体包括:
a) 语法错误:
语法结构的开始符号以及跟随符号错误;
标识符错误,例如在程序的变量声明中,关键字 int 后没有跟随标识符;
括号不匹配的错误,例如左括号(和右括号 )不匹配。
符号错误,例如赋值语句中要求使用的正确符号是':=',而在关系比较表达式要求使用的正确符号是'='。
b) 语义错误:
一个标识符没有声明就使用,以及一个标识符被声明不止一次。
一个条件表达式的类型不是布尔类型 bool。
一个二元操作符的两个操作数的类型不相等。
赋值语句左右部的类型不相等。
语法分析实验过程:
1.在 main 函数中将 NO_ANALYZE、NO_CODE 设置为 TRUE,使程序只进行 PARSE(语法分析)过程。
2.Tiny+ 的语法 EBNF 定义如下:
1rogram		->	declarations stmt-sequence
2declarations	-> dec; declarations |ε
3decl		-> type-specifier varlist
4type-specifier	-> int | boo| char
5varlist	-> identifier { , identifier }
6stmt-sequence	-> statement { ; statement }
7statement	-> if-stmt | repeat-stmt | assign-stmt | read-stmt | write-stmt | while-stmt
8while-stmt -> while bool-exp do stmt-sequence end
9if-stmt	-> if  bool-exp then stmt-sequence [else stmt-sequence] end
10repeat-stmt	-> repeat stmt-sequence untibool-exp
11assign-stmt	-> identifier:=exp
12read-stmt	-> read identifier
13write-stmt	-> write exp
14exp	-> arithmetic-exp | bool-exp | string-exp
15arithmetic-exp	-> term { addop term }
16addop	-> + | -
17term	-> factor { mulop factor }
18mulop	-> * | /
19factor	->  (arithmetic-exp) | number | identifier
20 bool-exp	-> bterm { or bterm }
21 bterm	-> bfactor { and  bfactor}
22 bfactor	-> comparison-exp
23 comparison-exp -> arithmetic-exp comparison-op arithmetic-exp
24 comparison-op	-> < | = | > | >= | <=
tring-exp		-> string
3.根据 EBNF 的定义,修改 PARSE.C 文件,构造递归下降语法分析器,产生一棵语法树。
基本语法树木的结构如下:
|------------------|---------------------------------------------------------------------------------|-------------------------------------------------------------------------|
| 语句系列 | 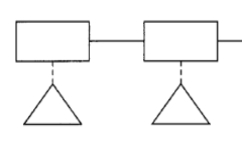 | 语句间通过链表相连,除了第一条语句,其他语句均可通过前一个语句的->slibing 查找到。 |
| If 语句 | 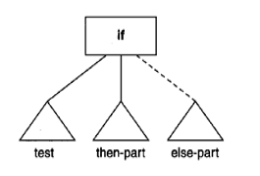 | test 位于 If 语句的 child0,then-part 为 child1,else-part 为 child2 |
| Repeat | 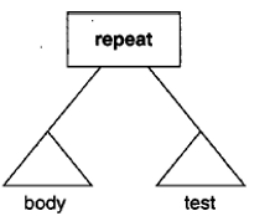 | Body 位于 repeat 语句中的 child0,test 位于 chlid1 |
| Assign | 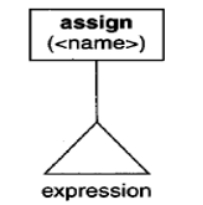 | Expression 位于 assign 语句 child0 |
| write | 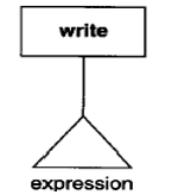 | Expression 位于 write 的 child0 |
| Op 逻辑运算 | 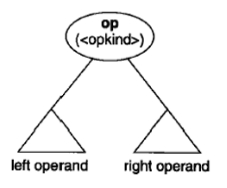 | Left-operand 位于 op 语句的 child0,Right-opreand 位于语句的 child1; |
| while | 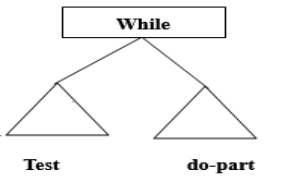 | Test 位于 while 语句的 child0Do-part 位于 child1 |
| Define 如:int A,B | 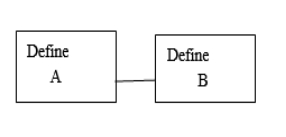 | B 位于 A 的 slibing 中,其中 A、B 的子节点均未赋值(此处留给将来拓展用) |
新建一个 define 的结点类型,用来识别定义语句.
重写 tiny 中不适合的语法分析树枝,按照新的 ENBF 定义写出合适的分析函数,从而构建出正确语法树。
语法分析测试结果:
测试一:
输入:
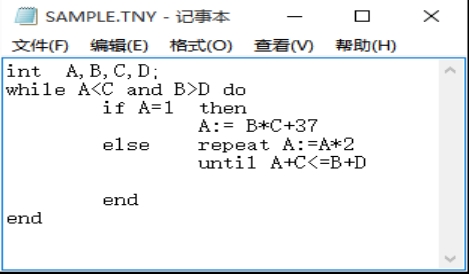
输出:
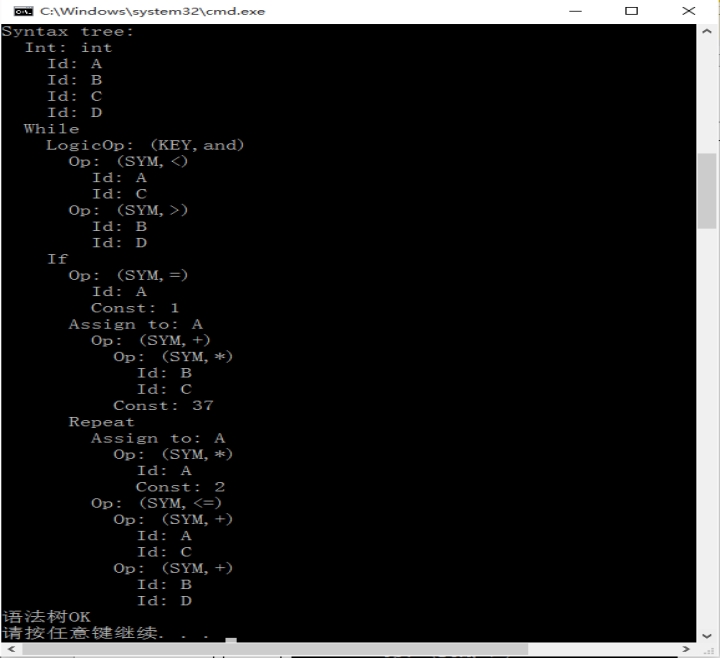
语义分析实验过程:
1 在 main 函数中将 NO_CODE 设置为 TRUE,使程序进行语义分析过程。
2 一个用 TINY+ 语言编写的程序包括变量的声明和语句序列两个部分。变量声明部分可以为空,但一个 TINY+ 程序至少要包含一条语句。
a) 所有的变量在使用之前必须声明,并且每个变量只能被声明一次。
b) 变量以及表达式的类型可以是整型 int,布尔类型 bool 或者字符串类型 char,必须对变量的使用和表达式进行类型检查。
3 构建语义分析器主要包括
符号表的设计以及符号表的相应操作
- 符号表保存信息:变量的地址信息、变量被访问的行号
- 变量以其变量名 ID,通过链式 hash 储存查找到相应数据。
语义分析程序本身的操作,包括符号表的构建以及类型检查。
- 符号表的创建:
前序遍历语法树:
当遇到定义的语法结点时候,将其变量新增到哈希表中,并存储其行号位置;
遇到含有变量的非定义语句的结点时,查找该变量位于哈希表中的位置,将该行号储存到哈希相应表项的 next 位置。
- 类型检查:
后续遍历语法树,对每一个结点进行语义判断:
1.if 语句结点中,if-test(child0)的类型必定为 boolean,
- while 语句结点中,while-test(child0)的类型必定为 boolean,
- op 算术运算结点中,child0、child1必须为 integer 类型
- op 逻辑运算结点中,child0、child1必须为 boolean
- 赋值运算结点中,child0、child1的类型必须一致
- ......
在后续遍历语法树中,查看变量是否非法使用:
- 当结点为 ID 结点时候,在哈希表中查看是否已经定义。
- 如果该结点为定义语句结点,则判断此变量是否重复定义。
- 如果该变量已经定义,则将变量的 type(类型)赋于定义时候的类型
- 进入上一层遍历,当其类型不符合上一层所需类型时候提示错误。(即如在赋值语句中,该变量的类型与赋值语句另一个子节点的类型不一致,提示语义错误)。
词法分析测试结果
测试一:
输入:
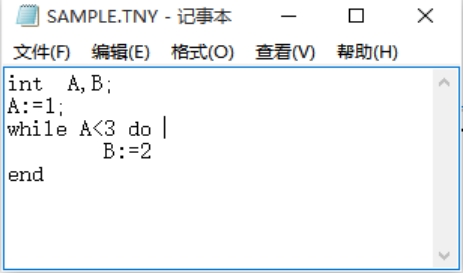
输出:
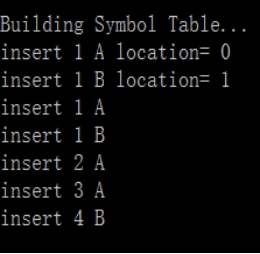
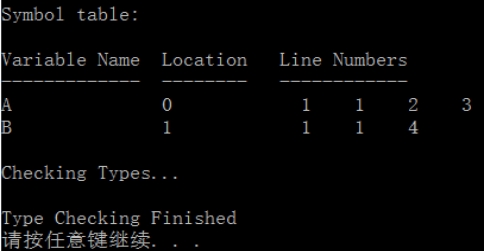
测试二:
输入:
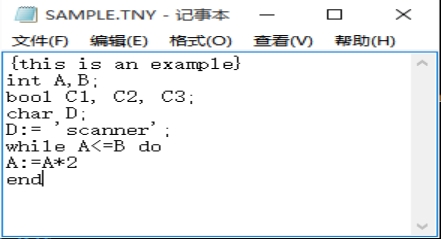
输出:
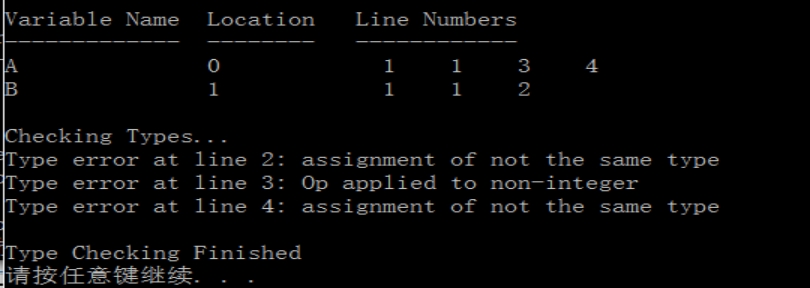
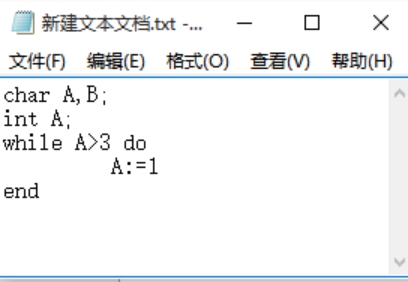
测试三:(测试错误提示)
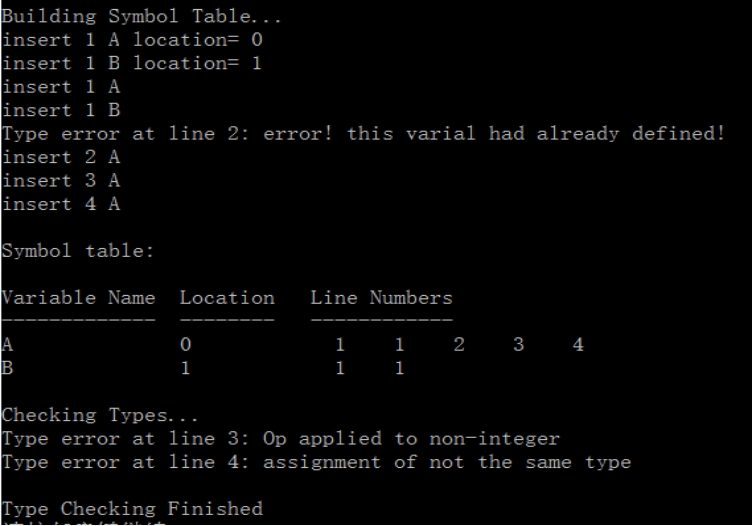
输入:代码中有三处错误:
a) A 重复定义
b) A>3 中 A 为 char 型,比较错误
c)A:=1 中赋值错误。类型不一致
输出:
中间代码生成实验过程:
1 在 main 函数中将 NO_PARSE、NO_ANALYZE、NO_CODE 设置为 FALSE,使程序进行中间代码生成过程。
2 构造 TINY+ 的中间代码生成系,该中间代码生成器将 TINY+ 程序翻译为三地址中间代码。
3 在原 tiny 中间代码生成器的实现位于 cgen.c 和 cgen.h 中。其接口为 codeGen(TreeNodesyntaxTree,char codefile).
主要功能为:
函数的开始,产生一些注释以及建立运行时环境的指令。
对语法树调用 cGen 函数,对每一个语法树结点生成相应指令
最后生成 HALT 指令,结束目标代码生成。
注释以及指令均写在某指定.tm 文件上,供 TM 程序调用并且运行。
4 Tiny+ 在 tiny 的基础上进行修改。其中 codeGen 函数将保持不变,修改其 cGen 函数即可。
修改 cGen 函数调用的 getExp()函数。
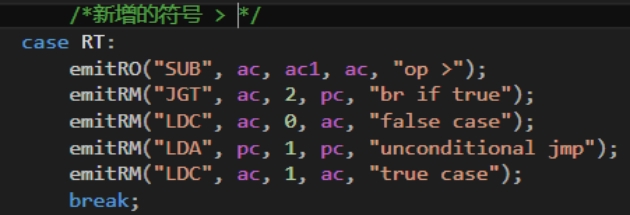
增加 OpK 的类型,即在原有功能代码基础上,增加新增符号其操作的中间代码生成步骤。即新增符号 RT,EQ,LTEQ,RTEQ.
如增加">"的中间代码生成过程
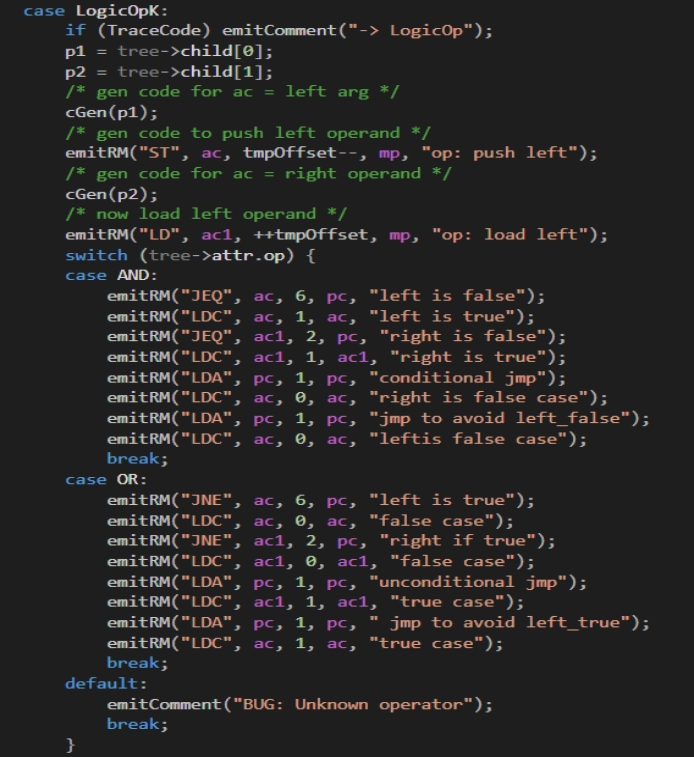
增加 LogicOpK 的处理(即增加 AND、OR 的中间代码的生成)
此处中间代码生成比算术运算的中间代码复杂得多,根据 TM 程序的指令以及其操作原理,写出 AND 和 OR 中间生成代码功能:
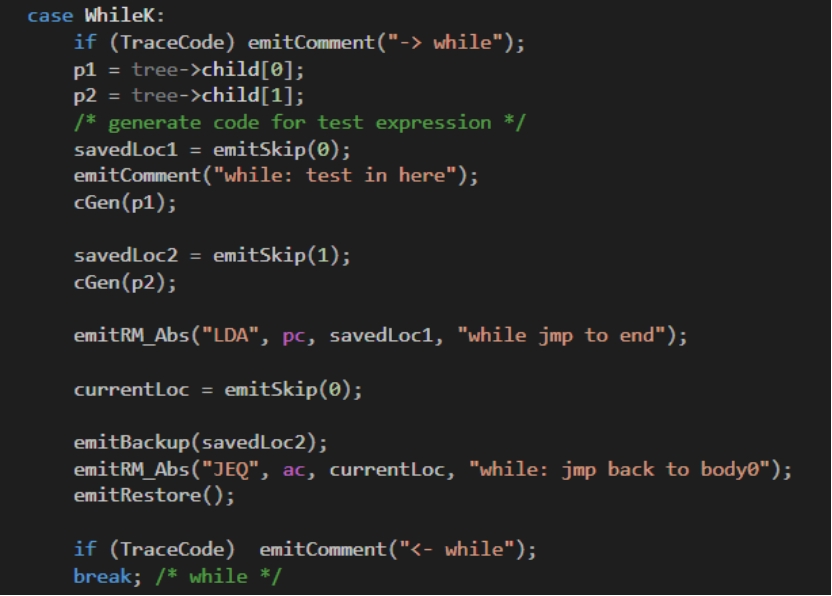
5 修改 cGen 函数调用的 getStmt()函数。增加语句 while 的中间代码生成。
此处通过 Tiny+ 文法规则产生对于的三地址中间代码属性,完成 while 生成中间代码功能。
中间代码测试结果
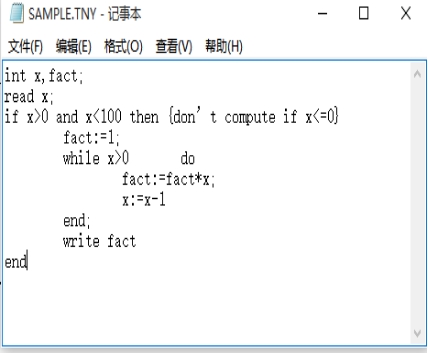
测试一:
输入:
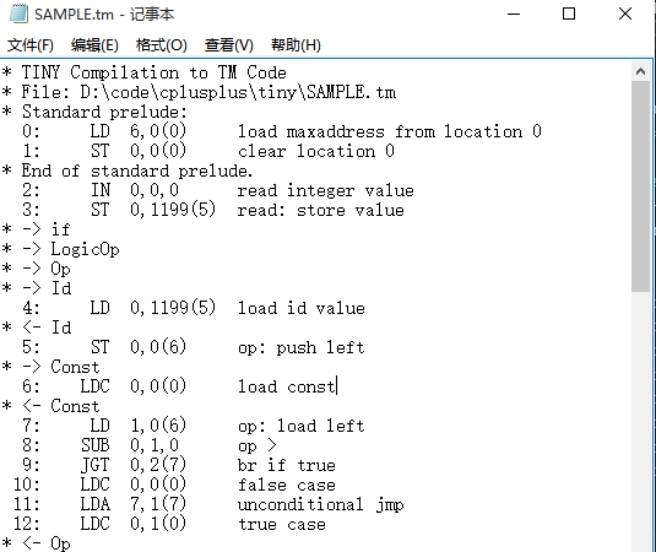
输出: