昨天我们入门了深度学习的核心概念和 PyTorch 的 Tensor 基础操作。但如果只停留在创建张量、做做加减乘除,离真正训练一个模型还差得远。今天我们继续深入------掌握张量的形状操作与拼接,理解自动微分的原理,走通模型训练的五步循环,最后用一个线性回归案例把所有知识串起来。
这篇文章是从"会用 PyTorch"到"能训练模型"的关键一跃。
一、张量的形状操作
在深度学习中,数据在不同层之间流动时,形状经常需要变换。把一个图像张量从 [批量, 通道, 高, 宽] 变成 [批量, 高×宽×通道],把一个特征矩阵转置------这些都需要形状操作。
查看形状
import torch

t = torch.randn(2, 3, 4)
print(t.shape)    # torch.Size([2, 3, 4])
print(t.size())   # torch.Size([2, 3, 4])
.shape 是属性,.size() 是方法,两者结果完全一样。看到 torch.Size([2, 3, 4]) 就知道这个张量有 3 个维度,分别有 2、3、4 个元素。
修改形状
t = torch.randn(2, 3, 4)  # 24个元素

# reshape:改变形状,不改变数据
t1 = t.reshape(6, 4)      # 变成 [6, 4]
t2 = t.reshape(2, 12)     # 变成 [2, 12]

# view:同样改变形状,但要求内存连续
t3 = t.view(6, 4)         # 变成 [6, 4]
reshape 和 view 看起来一样,但有一个关键区别:view 要求张量的物理内存是连续的 。如果一个张量经过了维度交换(transpose)等操作,物理内存不再连续,view 就会报错,而 reshape 仍然可以工作(它会自动处理内存问题)。
判断内存是否连续可以用 .contiguous 属性。如果需要让不连续的张量变连续,调用 .contiguous() 方法即可:
t = torch.randn(2, 3)
t_t = t.transpose(0, 1)  # 交换维度后内存不连续
# t_t.view(6)  # 报错!
t_t.contiguous().view(6) # 正常工作实际项目中,推荐统一使用 reshape ,它更安全,不会因为内存不连续而报错。但如果你追求极致性能,view 不涉及数据拷贝,比 reshape 更快------在确定内存连续的情况下用 view 是更好的选择。理解两者的底层差异,比记住"用哪个"更重要。
一个常见场景:CNN 的全连接层之前,需要把 [batch, channels, height, width] 的四维张量变成 [batch, channels × height × width] 的二维张量。这时就用 reshape(batch, -1)-------1 表示自动推断这一维的大小,非常方便。
增删维度
# unsqueeze:增加一个大小为1的维度
t = torch.randn(3, 4)
t1 = t.unsqueeze(0)   # [1, 3, 4]  在第0维增加
t2 = t.unsqueeze(2)   # [3, 1, 4]  在第2维增加

# squeeze:删除大小为1的维度
t3 = t1.squeeze(0)    # [3, 4]  删除第0维
t4 = t1.squeeze()     # [3, 4]  删除所有大小为1的维度
unsqueeze 在深度学习中极为常用------比如把一个样本 [3, 224, 224] 变成 [1, 3, 224, 224] 加上 batch 维度,就是用 unsqueeze(0) 完成的。squeeze 则是反向操作,去掉多余的维度。
调整维度顺序
t = torch.randn(2, 3, 4)

# transpose:交换两个维度
t1 = t.transpose(1, 2)  # [2, 4, 3]  交换第1和第2维

# permute:批量交换所有维度
t2 = t.permute(2, 0, 1)  # [4, 2, 3]  按指定顺序重排所有维度
transpose 只能交换两个维度,permute 可以一次性重排所有维度。在图像处理中,permute 特别常用------PyTorch 默认图片格式是 [C, H, W](通道、高、宽),但很多数据加载器给出的是 [H, W, C],就需要用 permute(2, 0, 1) 来转换。
形状操作在深度学习中的使用频率非常高。一个典型的 CNN 数据流是这样的:输入图片 [B, 3, 224, 224] 经过卷积层变成 [B, 64, 56, 56],进入全连接层前用 reshape 展平为 [B, 64×56×56],输出后再用 reshape 恢复形状。如果形状搞错了,PyTorch 报错信息通常很清晰------它会告诉你期望的形状和实际的形状,根据报错信息调整即可。
二、张量的拼接
深度学习中经常需要把多个张量拼到一起------比如把多个 batch 的特征拼接,或者把不同层的输出合并。
cat:同维度拼接
a = torch.randn(2, 3)
b = torch.randn(2, 3)

# dim=0:上下拼接(沿行方向),不产生新维度
c1 = torch.cat([a, b], dim=0)  # [4, 3]

# dim=1:左右拼接(沿列方向),不产生新维度
c2 = torch.cat([a, b], dim=1)  # [2, 6]
cat 的特点是不会产生新的维度 ------两个 [2, 3] 的张量沿 dim=0 拼接,结果是 [4, 3],维度数不变,还是二维。
stack:新维度拼接
a = torch.randn(2, 3)
b = torch.randn(2, 3)

# stack:产生一个新的维度
c = torch.stack([a, b], dim=0)  # [2, 2, 3]  新增了第0维
stack 和 cat 的区别在于:stack 会产生一个新的维度 。两个 [2, 3] 的张量用 stack 拼接,结果是 [2, 2, 3]------多了一个维度。这就像把两张照片叠成一摞,多出了"第几张"这个维度。
简单记忆:cat 是拼接,stack 是堆叠 。不想增加维度用 cat,想增加维度用 stack。
选择 cat 还是 stack 取决于你的需求。比如你有 4 张图片 [3, 224, 224],想组成一个 batch------那就用 stack 把它们堆叠成 [4, 3, 224, 224],新增了 batch 维度。但如果你已经有两个 batch [32, 3, 224, 224] 和 [16, 3, 224, 224],想合成一个 [48, 3, 224, 224] 的大 batch------那就用 cat 沿 dim=0 拼接,不增加维度。理解了"是否需要新维度"这个判断标准,选 cat 还是 stack 就不会纠结了。
三、张量的自动微分
自动微分是 PyTorch 的灵魂功能,也是深度学习能"自动训练"的核心。理解了它,你就理解了 PyTorch 为什么能自动更新模型参数。
梯度是什么
梯度是多个参数的偏导数组成的一个向量。对于损失函数 L = f(w₁, w₂, ..., wₙ),梯度就是 [∂L/∂w₁, ∂L/∂w₂, ..., ∂L/∂wₙ]。梯度的方向是损失增加最快的方向,所以参数更新时要沿着梯度的反方向走------这就是梯度下降。
自动微分的四步流程
import torch

# 第一步:在张量中设置 requires_grad=True
w = torch.tensor([1.0, 2.0, 3.0], requires_grad=True)

# 第二步:前向传播,构建计算图(PyTorch自动记录运算过程)
y = w * 2 + 1
loss = y.sum()

# 第三步:反向传播,自动计算梯度
loss.backward()

# 第四步:获取梯度结果
print(w.grad)  # tensor([2., 2., 2.])
设置 requires_grad=True 后,PyTorch 会自动跟踪这个张量的所有运算,构建一个计算图 ------记录每一步操作的函数和依赖关系。调用 .backward() 时,PyTorch 沿着计算图反向追溯,用链式法则自动算出每个参数的梯度,结果存在 .grad 属性中。
上面例子中,y = w * 2 + 1,loss = y.sum(),所以 ∂loss/∂w = 2------梯度确实是 [2, 2, 2]。
一个关键陷阱:梯度清零
# 梯度会累加!必须每次反向传播前清零
w = torch.tensor([1.0], requires_grad=True)

# 第一轮
y1 = (w * 3).sum()
y1.backward()
print(w.grad)  # tensor([3.])

# 第二轮------不清零的话梯度会累加
y2 = (w * 3).sum()
y2.backward()
print(w.grad) # tensor([6.]) 错误!是3+3=6梯度每轮训练会自动累加------这是 PyTorch 的设计,在某些场景(如梯度累积,用小 batch 模拟大 batch)有用,但在常规训练中会导致梯度越来越大,必须每次训练前清零:
w.grad.zero_()  # 手动清零
# 或用优化器清零(更常用)
optimizer.zero_grad()
这个陷阱几乎每个 PyTorch 初学者都踩过------训练几轮发现 loss 越来越大,模型预测越来越离谱,debug 半天最后发现是梯度没清零。养成习惯:写训练循环的第一行永远是 optimizer.zero_grad(),就像出门前先检查钥匙一样自然。
还有一个细节值得注意:.backward() 默认只能对标量(只有一个元素的张量)调用。如果你的 loss 是一个向量,需要传入梯度参数:loss.backward(gradient=torch.ones_like(loss))。但在实际项目中,损失函数通常输出标量,所以这个问题不常见。
四、模型训练的五步循环
有了前面的基础,现在来看 PyTorch 模型训练的核心流程。不管网络多复杂,训练过程都遵循这五步循环:
# === 训练循环 ===
for epoch in range(epochs):
    for x, y in dataloader:
        # 1. 梯度清零
        optimizer.zero_grad()

        # 2. 前向传播
        output = model(x)

        # 3. 计算损失
        loss = criterion(output, y)

        # 4. 反向传播(自动计算梯度)
        loss.backward()

        # 5. 参数更新(沿梯度反方向更新参数)
        optimizer.step()
五步的含义:
梯度清零 (zero_grad):清空上一轮累积的梯度。这是最容易被遗忘但最重要的一步------忘了清零,梯度就会像滚雪球一样越滚越大,模型直接崩掉。
前向传播 (model(x)):把数据送入模型,得到预测结果。这一步是"用当前参数算一遍预测"。
计算损失 (criterion(output, y)):用损失函数衡量预测值和真实值的差距。分类问题常用交叉熵损失,回归问题常用均方误差。
反向传播 (loss.backward()):PyTorch 自动从 loss 出发,沿计算图反向计算每个参数的梯度。你不需要手动求导,框架全部搞定。
参数更新 (optimizer.step()):优化器根据梯度更新参数,沿着梯度的反方向走一步。学习率决定了步子大小。
这五步构成了深度学习训练的最小完整循环。理解了它,你看任何 PyTorch 训练代码都不会迷路------不管多复杂的模型,核心都是这个循环。
还有一个概念需要注意:epoch vs batch vs iteration。一个 epoch 是把所有训练数据跑完一遍;一个 batch 是一次送入模型的一批数据(如 32 条);一个 iteration 是一次前向+反向传播的过程。如果 1000 条数据、batch_size=32,一个 epoch 大约需要 32 个 iteration。五步循环的每一轮就是一个 iteration。
另外,训练循环中经常需要加上 model.train() 和 model.eval() 的切换。model.train() 告诉模型处于训练模式,Dropout 会随机丢弃神经元、BatchNorm 会更新运行统计量;model.eval() 告诉模型处于评估模式,Dropout 关闭、BatchNorm 使用固定统计量。训练时调用 model.train(),验证或测试时调用 model.eval(),这也是一个容易遗漏的细节。
五、实战案例:线性回归
理论讲完了,用一个完整的线性回归案例把所有知识串起来。这个案例涵盖了从数据创建到模型保存的完整流程。
完整流程
import torch
import torch.nn as nn
from torch.utils.data import DataLoader, TensorDataset
from sklearn.datasets import make_regression
from torch.utils.tensorboard import SummaryWriter

# 1. 数据创建
X, y = make_regression(n_samples=500, n_features=5, noise=10, random_state=42)
X = torch.FloatTensor(X)
y = torch.FloatTensor(y).unsqueeze(1)  # 增加维度 [500] → [500, 1]

# 2. TensorBoard 可视化
writer = SummaryWriter('runs/linear_regression')

# 3. 构建 DataLoader,设置批次
dataset = TensorDataset(X, y)
dataloader = DataLoader(dataset, batch_size=32, shuffle=True)

# 4. 创建模型
model = nn.Linear(5, 1)  # 5个特征 → 1个输出

# 5. 创建损失函数
criterion = nn.MSELoss()

# 6. 创建优化器
optimizer = torch.optim.SGD(model.parameters(), lr=0.001)

# 7. 模型训练
for epoch in range(100):
    total_loss = 0
    for batch_x, batch_y in dataloader:
        optimizer.zero_grad()          # 梯度清零
        output = model(batch_x)        # 前向传播
        loss = criterion(output, batch_y)  # 计算损失
        loss.backward()                # 反向传播
        optimizer.step()               # 参数更新
        total_loss += loss.item()

    writer.add_scalar('Loss', total_loss / len(dataloader), epoch)
    if (epoch + 1) % 20 == 0:
        print(f"Epoch {epoch+1}, Loss: {total_loss/len(dataloader):.4f}")

# 8. 保存模型
torch.save(model.state_dict(), 'linear_model.pth')

# 9. 加载模型
loaded_model = nn.Linear(5, 1)
loaded_model.load_state_dict(torch.load('linear_model.pth'))
loaded_model.eval()

# 10. 结果预测
with torch.no_grad():  # 预测时不需要计算梯度
    test_x = torch.FloatTensor([[1.0, 2.0, 3.0, 4.0, 5.0]])
    prediction = loaded_model(test_x)
    print(f"预测结果: {prediction.item():.4f}")
流程解读
这个案例覆盖了十个步骤,每一步都有讲究:
数据创建 用 make_regression 生成回归数据,这是 sklearn 提供的便捷函数。注意 unsqueeze(1) 把标签从一维变成二维------这是 PyTorch 的要求,nn.Linear 的输入输出都需要是二维的 [batch_size, features]。
DataLoader 负责把数据分批次送入模型。batch_size=32 表示每次送 32 条样本,shuffle=True 表示每个 epoch 打乱数据顺序。分批训练既节省内存又能让梯度更有随机性。
模型创建 用 nn.Linear(5, 1) 创建一个线性层------5 个输入特征,1 个输出值,这就是最简单的神经网络。复杂的模型也只是把多个层组合起来。
优化器用 SGD(随机梯度下降),学习率 0.001。学习率的选择和前面线性回归中学到的一样------太大震荡,太小太慢。除了 SGD,PyTorch 还提供了 Adam、RMSprop 等优化器,其中 Adam 是最常用的"万能"优化器,通常不需要太多调参就能取得不错的效果。
模型保存与加载 用 state_dict() 保存模型参数(不是保存整个模型),加载时先创建相同结构的模型再加载参数。这是 PyTorch 推荐的保存方式------更灵活、更安全。保存整个模型(torch.save(model, ...))虽然在代码上更简洁,但它依赖于 Python 的 pickle 序列化,加载时必须保证模型类的定义在同一个路径下,迁移性差。而 state_dict 只保存参数数值,不依赖类定义,更适合实际部署。
预测 时用 torch.no_grad() 包裹------告诉 PyTorch 不需要构建计算图、不需要计算梯度,节省内存和计算。model.eval() 把模型切换到评估模式(影响 Dropout 和 BatchNorm 的行为)。这两个在预测时缺一不可------no_grad() 省内存,eval() 保证行为正确。
TensorBoard 在案例中承担了"训练监控"的角色。通过 writer.add_scalar('Loss', loss_value, epoch) 把每轮的 loss 写入日志,启动 TensorBoard 后就能在浏览器中看到 loss 的下降曲线。如果曲线平滑下降,说明训练正常;如果曲线剧烈震荡或停滞,就需要排查问题。这种"可视化训练过程"的能力在调参时极其重要。
TensorBoard 可视化
案例中用到了 TensorBoard ,它是 TensorFlow 生态中诞生但已被 PyTorch 广泛采用的可视化工具。通过 SummaryWriter 把训练过程中的 loss 写入日志,然后在终端启动 TensorBoard 就能看到 loss 曲线的变化趋势------是下降还是震荡,有没有收敛。
tensorboard --logdir=runs/linear_regression打开浏览器就能看到实时更新的训练曲线。在调参时,TensorBoard 是你的"仪表盘"------学习率合不合适、模型有没有过拟合,看一眼曲线就知道了。
六、学习心得与建议
第一,形状操作是 PyTorch 的基本功。 深度学习代码中一半的 bug 都和形状有关------维度对不上、batch 维度忘了加、通道顺序搞反了。把 reshape、unsqueeze、permute 这些操作练到肌肉记忆,调试效率会大幅提升。
第二,自动微分是 PyTorch 的灵魂。 你不需要手动推导梯度、不需要实现反向传播------requires_grad=True + backward() 搞定一切。但你要理解它的工作原理:计算图、链式法则、梯度累加。理解了这些,遇到梯度爆炸、梯度消失等问题时才知道怎么排查。
第三,五步训练循环要背下来。 zero_grad → forward → loss → backward → step,这五步是所有 PyTorch 训练代码的骨架。不管模型多复杂,核心都是这个循环。把它刻在脑子里,读任何训练代码都能快速抓住主线。
第四,线性回归案例是最好的起点。 虽然它简单,但包含了完整的训练流程------数据加载、模型定义、损失函数、优化器、训练循环、模型保存加载、预测。后面学 CNN、RNN、Transformer,变化的只是模型结构,外围的训练流程几乎一模一样。把这个案例吃透,后面学任何模型都是"换汤不换药"。
第五,善用 TensorBoard。 很多初学者训练完才知道效果不好,却不知道问题出在哪。TensorBoard 能让你实时看到 loss 曲线的变化------如果 loss 一直不降,可能是学习率太小或模型太简单;如果 loss 突然飙升,可能是梯度爆炸或学习率太大;如果 loss 降到一定程度就不动了,可能是陷入了局部最优。训练不盲目,先让过程可视化。
写在最后
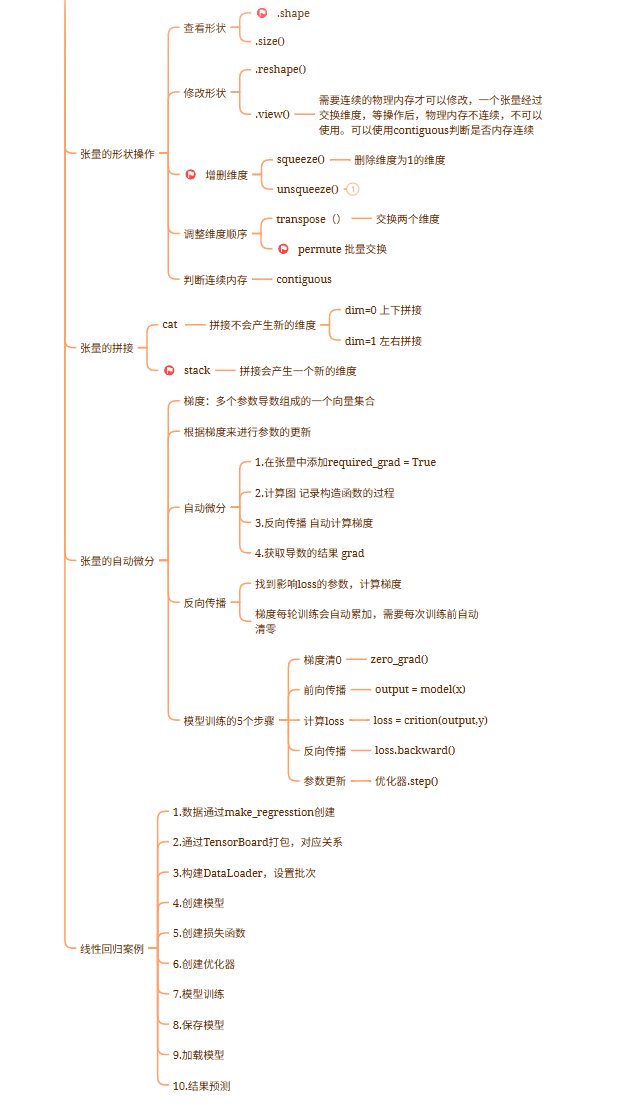
从昨天的 Tensor 基础到今天的模型训练全流程,我们完成了 PyTorch 的核心入门。张量的形状操作和拼接是工具,自动微分是引擎,五步训练循环是骨架,线性回归案例是验证------四者合在一起,就是一个完整的 PyTorch 模型训练知识体系。
回顾这一路:从机器学习概述到线性回归,从 KNN 到决策树与集成学习,从聚类到深度学习概念,再到今天的 PyTorch 模型训练------我们走过了一条从浅到深、从理论到实践的完整学习路径。每一篇文章都不是孤立的,它们层层递进,前一篇为后一篇铺路,后一篇在前一篇的基础上深入。
深度学习的大门已经打开,接下来的路------CNN 处理图像、RNN 处理文本、Transformer 大杀四方------都是在今天这个基础上搭建更复杂的模型结构。骨架已经搭好,剩下的就是往上面添砖加瓦。
如果这篇文章对你有帮助,欢迎点赞收藏。下一篇我们将用 PyTorch 搭建更复杂的神经网络模型,敬请关注。