用 Laya 决策模型(JEV 的开源实现)做一个智能家居决策 Demo
一句话结论:把「用户说的一句话」直接变成「结构化的家电控制决策」,这件事用 Laya(开源版 JEV) 这种「决策原生」模型来做,比用通用大模型 + 一堆 prompt 工程要优雅得多。
一、先搞清楚:JEV / Laya 到底是什么
我们平时熟悉的 LLM(GPT、Claude 之类)是「生成式」的,给它一段话,它吐出一段话。但决策这件事本质上是「在有限选项里做选择」,不是「写文章」。
JEV(Judgement / Evaluation / Verification) 是一套决策模型范式,把「判断」建模成一组决策原语(Decision Primitives):
choice:从有限候选里选一个(意图、设备、时间......)noul:是否 / 有无(可执行性)score:序数量表打分(紧急度)
Laya 就是 JEV 的开源实现 ,模型本体是一个 322M 参数的 ModernBERT(laya multilingual 0.3.4),走的是非自回归的 System-1 路径------它不是一边一个字一个字地生成,而是把问题(questions)和状态(state)拼成序列,前向一次就直接得到每个问题的选项 logits,再 softmax 出概率。这意味着它快、确定、可解释、带置信度。
对智能家居场景来说,「快 + 带概率 + 结构化输出」几乎是刚需:你不想为了识别一句「关掉洗衣机」去等一个 70B 模型慢慢吐字。
我的 Demo 仓库地址:https://gitee.com/han-fan/laya.git
二、我的核心思路:把「一切」都建模成决策
Laya 官方更偏向「领域决策」,通常配合 NER 做实体抽取。但我这次想做的是一次**「全 Laya 决策」的尝试**------不接 NER,直接把意图 + 所有槽位都表达成 Laya 的决策原语。
在 backend/schema.py 里我定义了 6 个决策问题:
| 决策(question) | 类型 | 说明 |
|---|---|---|
intent |
choice | 6 类家电意图:询问食谱 / 启动 / 停止 / 预约 / 制作 / 其他 |
device |
choice | 20 种设备:烤箱、电饭煲、空气炸锅、洗衣机...... |
time_expr |
choice | 9 种时间表达:立即 / 早上 / 具体时刻 / 具体日期...... |
recipe |
choice | 16 种食谱:红烧肉、鸡翅、粥、蛋糕...... |
executable |
noul | 指令是否足够明确、可直接执行(0~1 概率值) |
urgency |
score | 紧急程度:不急(0) / 一般(1) / 尽快(2) |
「意图 + 槽位如何全部被建模为决策」)
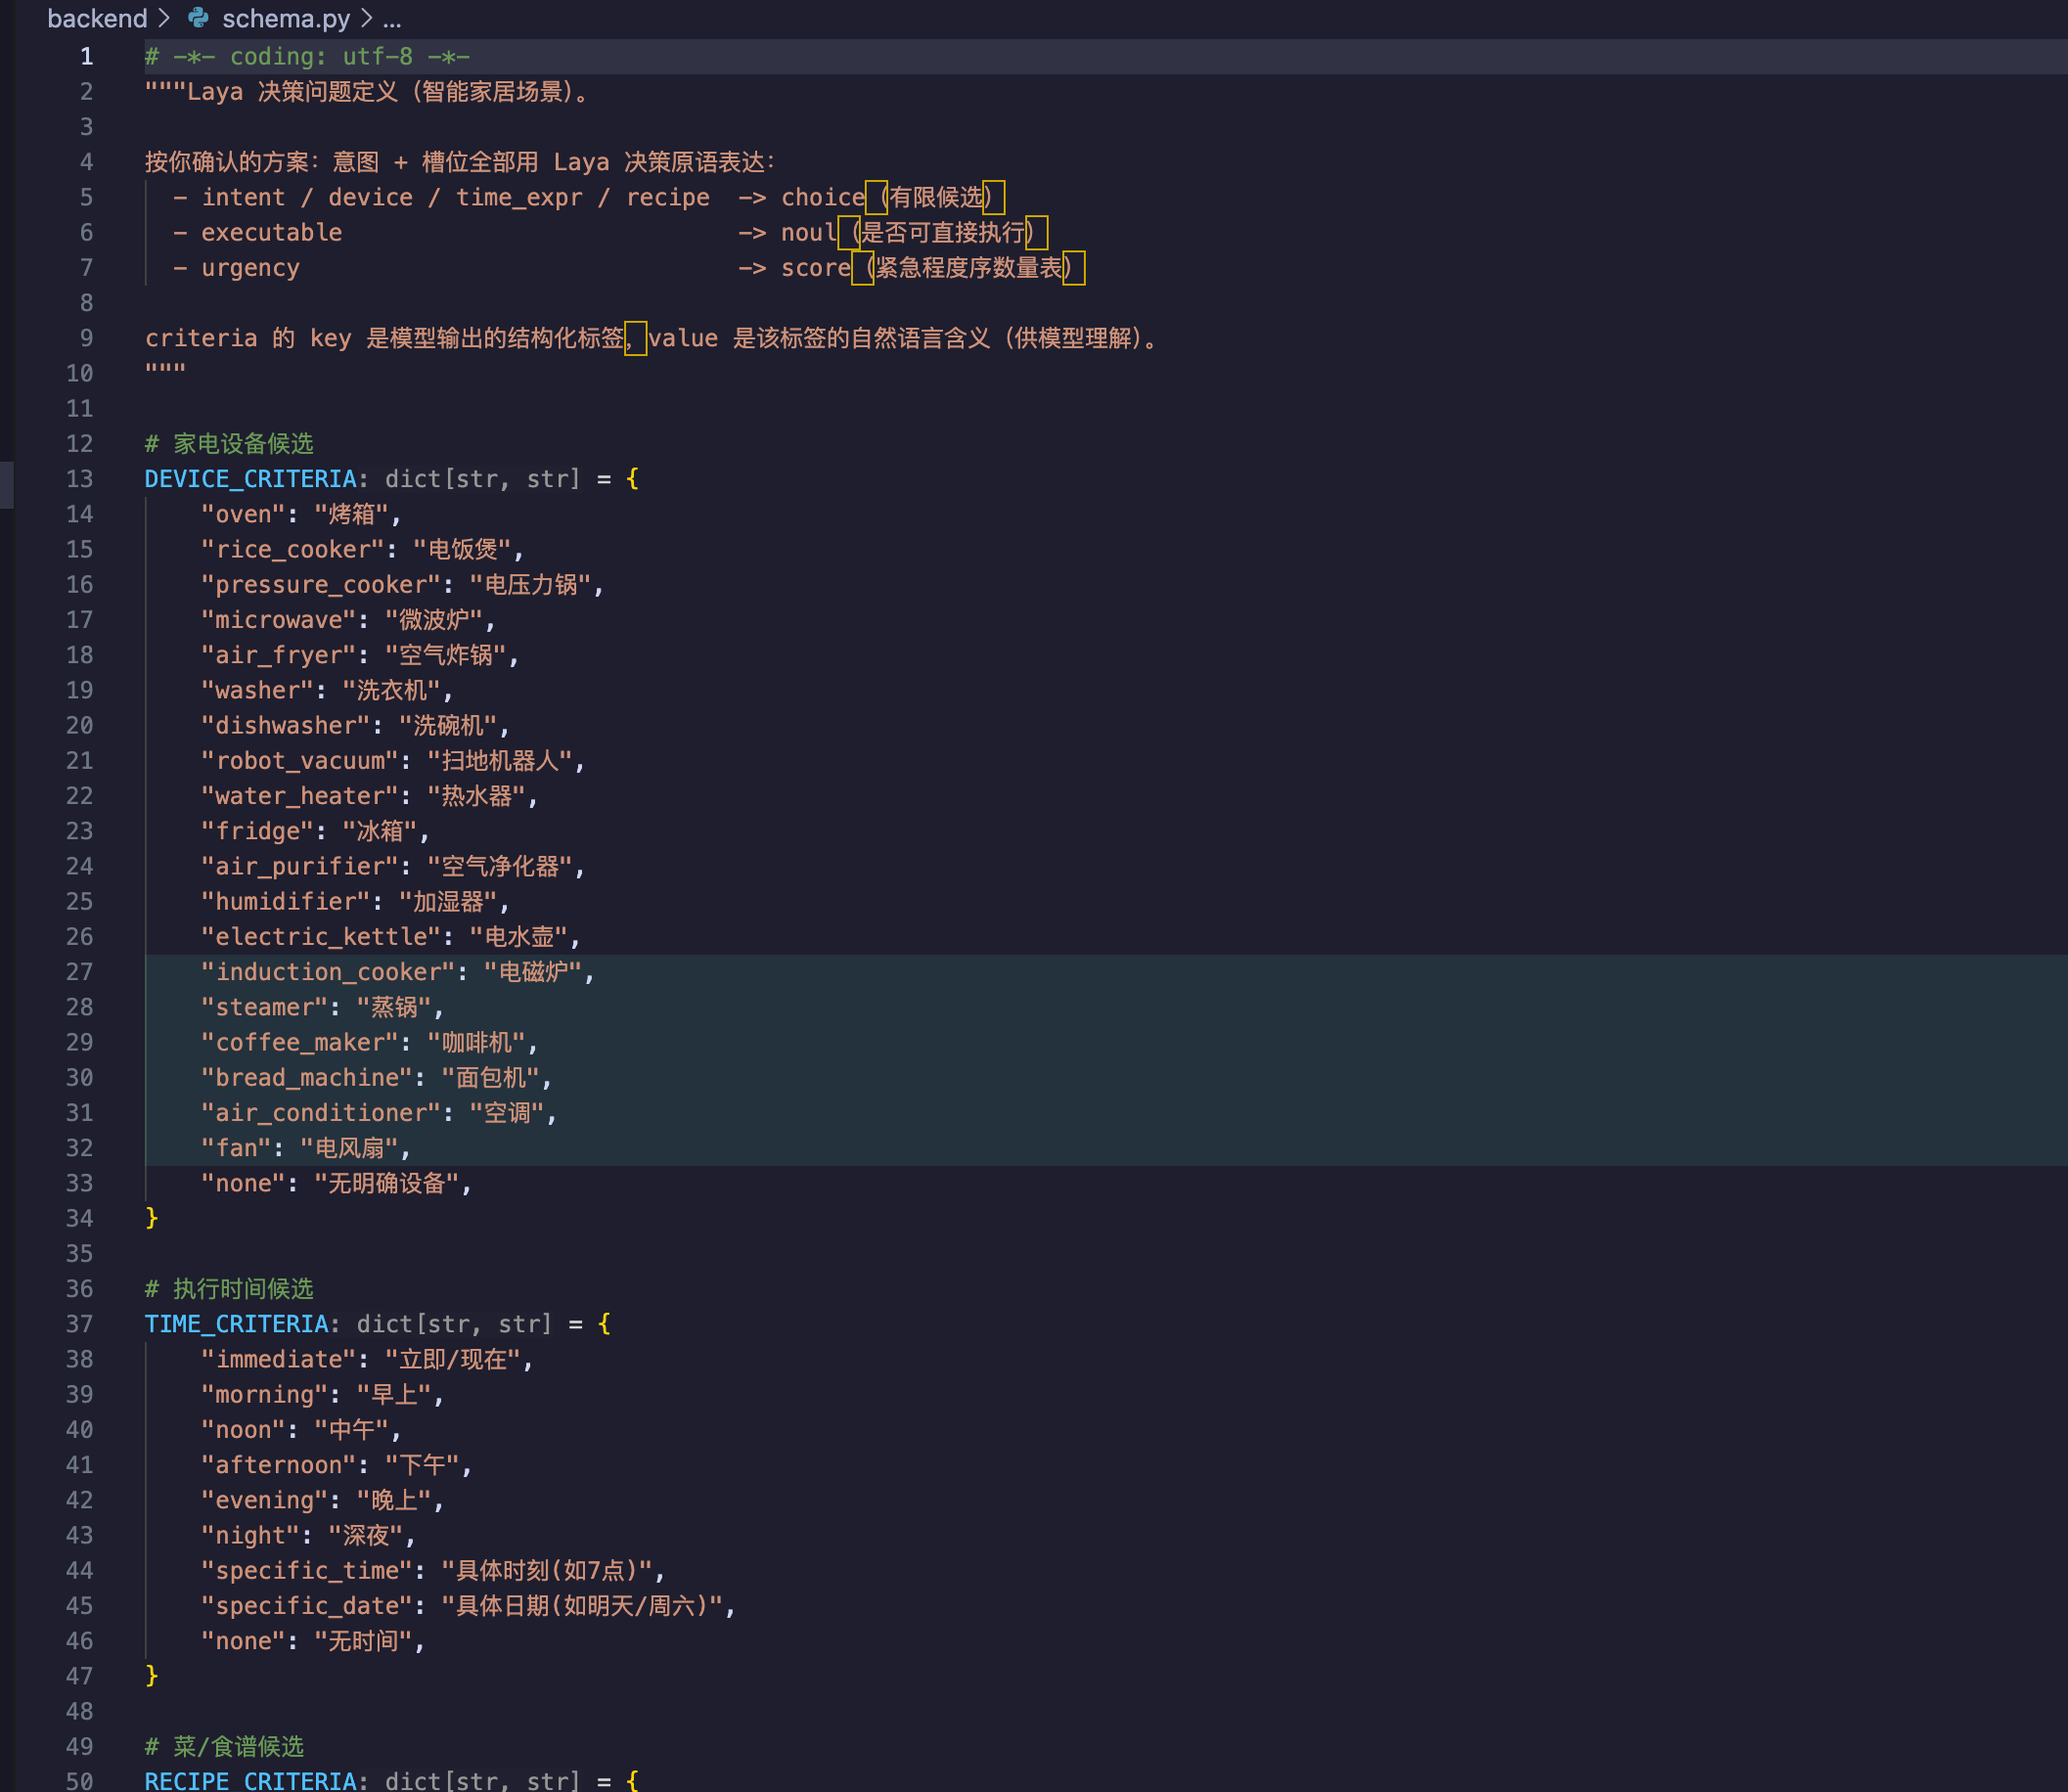
一次 decide(text) 的调用,就是把用户的自然语言 state={"text": ...} 和这 6 个问题一起喂给 Laya,模型一次性返回每个问题的「选项 + 置信度 + 概率分布」。这正是 JEV 想要的表达力:同一个输入,多个正交的判断,每一个都带概率。
三、整体架构:前后端 + 真实模型优先
我把项目做成了「能跑起来、能看效果」的 Demo,而不是停留在 notebook 里。
浏览器(React)
   │  自然语言指令 text
   │  fetch POST /api/decide
   ▼
前端 vite :5173  ──/api 代理──▶  后端 FastAPI :8000
                                    │
                                    │ Decider.decide(text)
                                    ▼
                              Laya Agent(真实) 或 mock_answers(兜底)
                                    │
                          laya.load(multilingual) 基座
                          + load_state_dict(sh_laya_sft)   ← 覆盖决策头/encoder
                                    │
                              DecisionModel(ModernBERT) 前向
                              build_sequence → model.forward → 每题选项 logits → softmax
                                    │
                                    ▼
                          决策原语 answers: intent/device/time_expr/recipe/executable/urgency
   ◀── 决策原语 JSON(含概率/置信度/时长) ───────────────────┘
后端关键点在 backend/decider.py 的 Decider 类,它做了两件很重要的事:
- 真实模型优先 + 规则兜底 :加载不到权重(没下模型 / 没 GPU)时,自动回退到
mock_answers()这个确定性规则分类器,保证页面永远能跑、能展示完整的「输入结构 / 输出结构 / 时延 / 匹配结果」。但兜底只是演示链路,不代表模型能力。 - 模型本地化 & 离线 :所有 HF 权重缓存放到项目内的
backend/.cache/huggingface,在import laya之前强制HF_HOME指向它;命中本地缓存就设HF_HUB_OFFLINE=1,彻底不依赖全局~/.cache,删掉仓库就清理干净,不污染环境。
「自然语言 → 结构化决策」
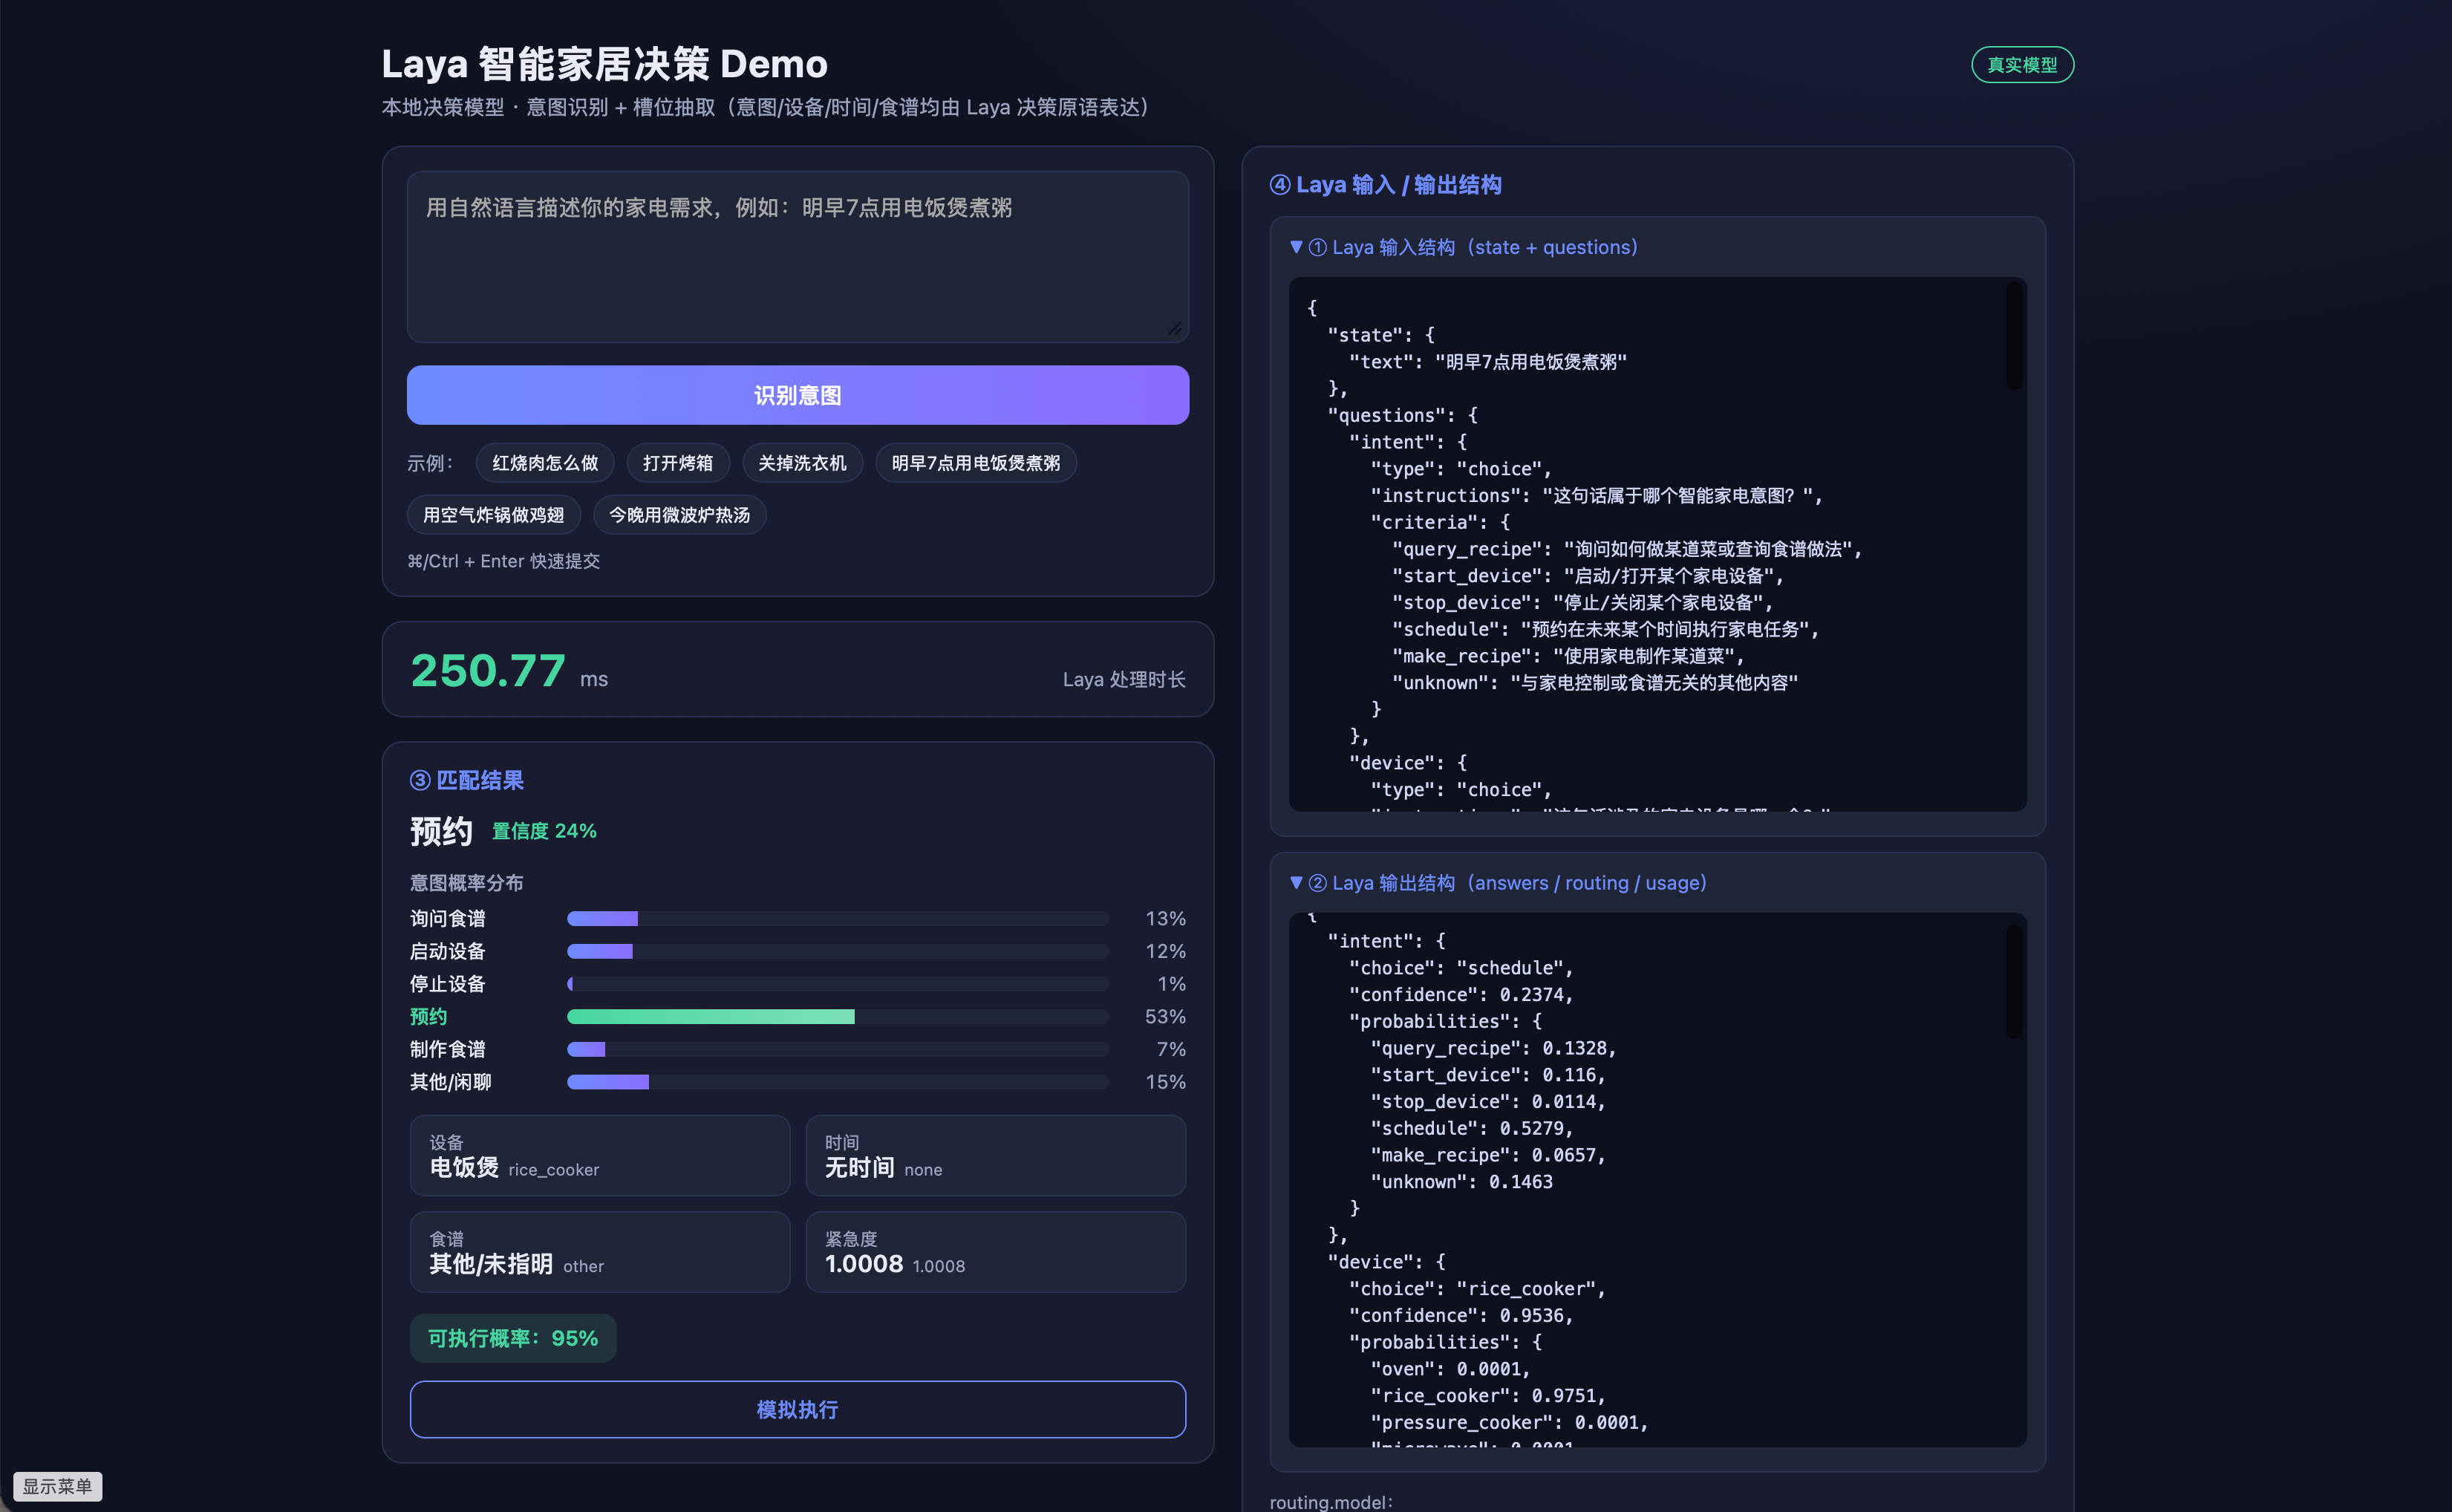
前端(React + Vite)展示得很直观:
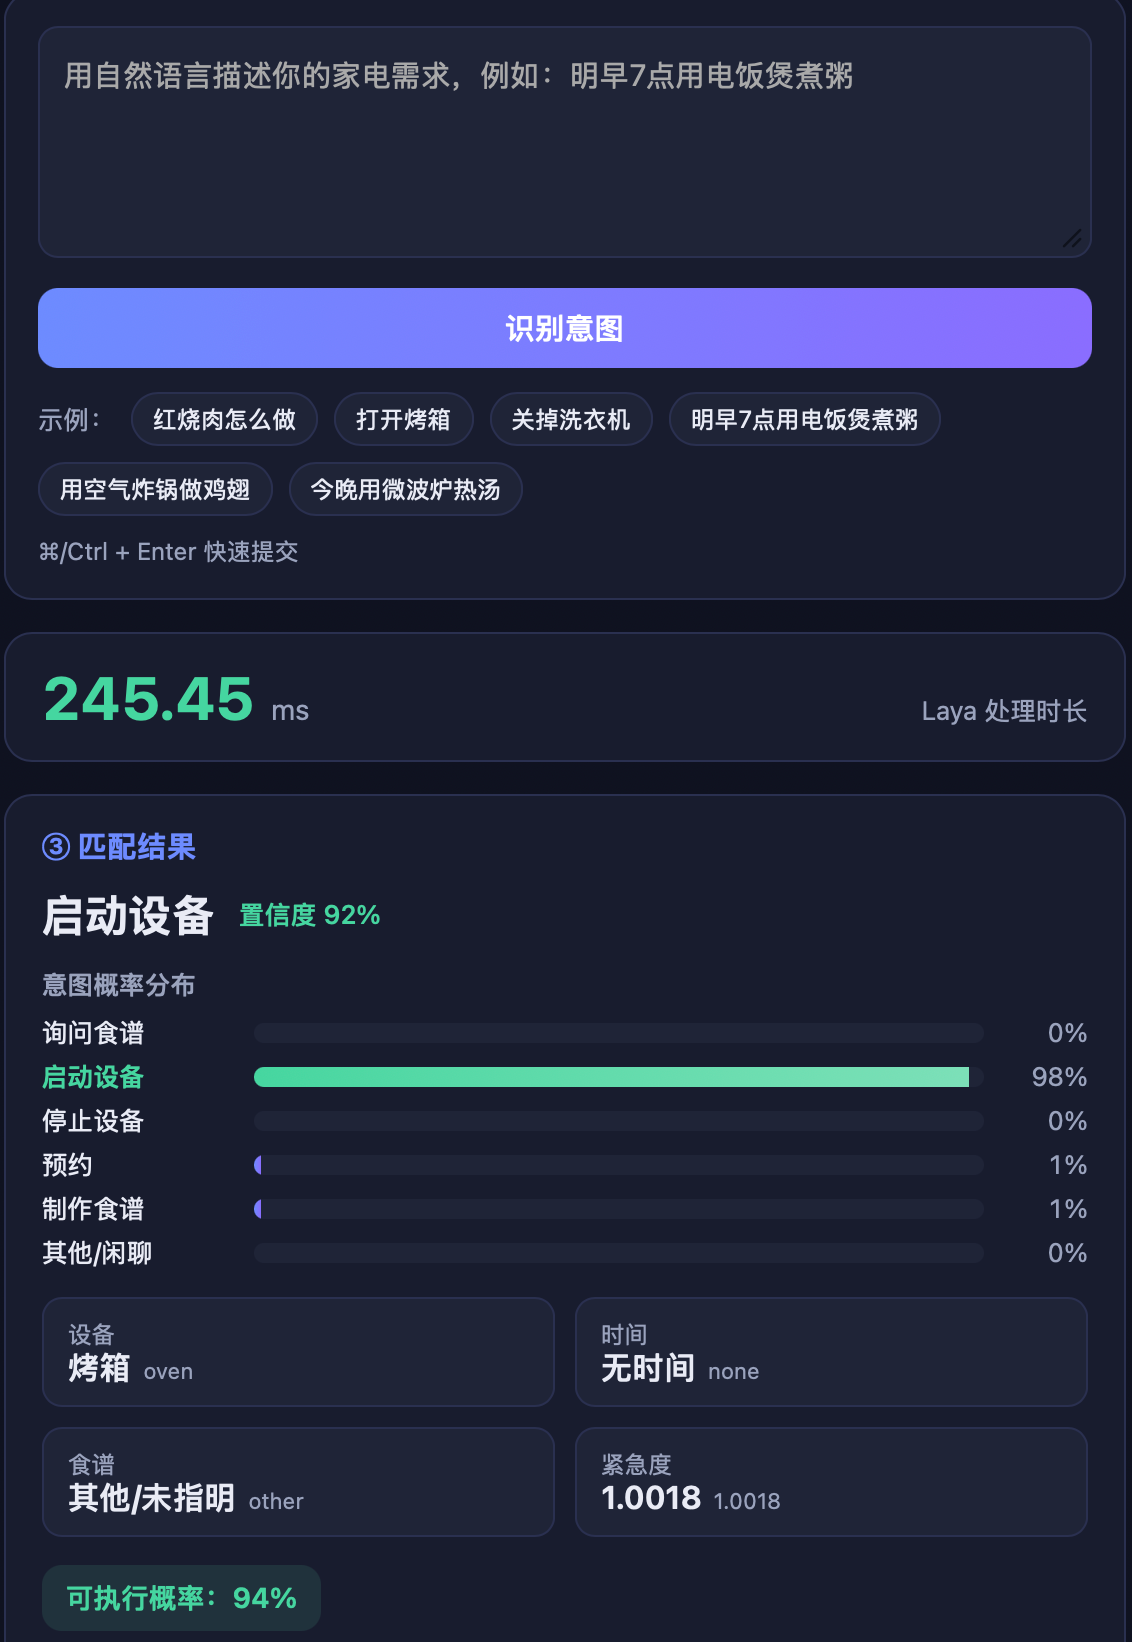
InputBox:输入框 + 示例快捷词MatchResult:意图 / 设备 / 时间 / 食谱 / 紧急度的结果卡片 + 置信度ProbBar:每个选项的概率条形图(能直观看到模型「有多确定」)IOStructure:原始state + questions与answers/routing/usage的 JSON,方便调试
ProbBar 概率条形图特写
四、为什么必须微调:base 模型在智能家居上「近随机」
这里踩到一个坑,也正好印证了 JEV/Laya 的设计定位------它是「微调基座」,不是开箱即用的决策服务。
官方给的 base 模型在 typed-decisions 上准确率大约 0.36(接近随机) ,用领域数据特化微调后能到 0.766。智能家居(中文 + 家电意图 + 槽位)显然是个特殊领域,不微调基本不可用。
于是我做了本地监督微调(SFT):
- 数据 :
dataset/build_dataset.py生成 740 条中文智能家电对话(train 740 / val 130),覆盖 6 意图 + 设备 / 时间 / 食谱 / 紧急度槽位,含烤箱、电饭煲、空气炸锅、咖啡机、空调等多设备与大量口语化表达。 - 策略 :冻结 ModernBERT 编码器,只微调决策头(head / scorer / type_emb / act_head),训练 3 个 epoch。
- 硬件 :Apple Silicon 的 MPS 实跑(不是 Colab),配置
HF_HOME指向项目内权重,完全离线。
结果(实测,MPS,8 条连续请求):
- 微调后 val reward:0.653 → 0.837(Δ+0.185)
- 单次请求 avg 207ms / p50 203ms(区间 182--238ms),首条含预热约 280ms
- base 模型在
schedule(预约)/recipe槽位偏弱(和官方「领域近随机 ~0.36」一致),SFT 后明显改善。
几个真实微调模型的例子:
- 「用空气炸锅做鸡翅」→
make_recipe / air_fryer(置信度 0.96) - 「关掉洗衣机」→
stop_device / washer(0.81) - 「打开烤箱」→
start_device / oven(0.99) - 「明早 7 点用电饭煲煮粥」→ 正确识别
schedule意图与时间槽位
微调前后对比 右前左后
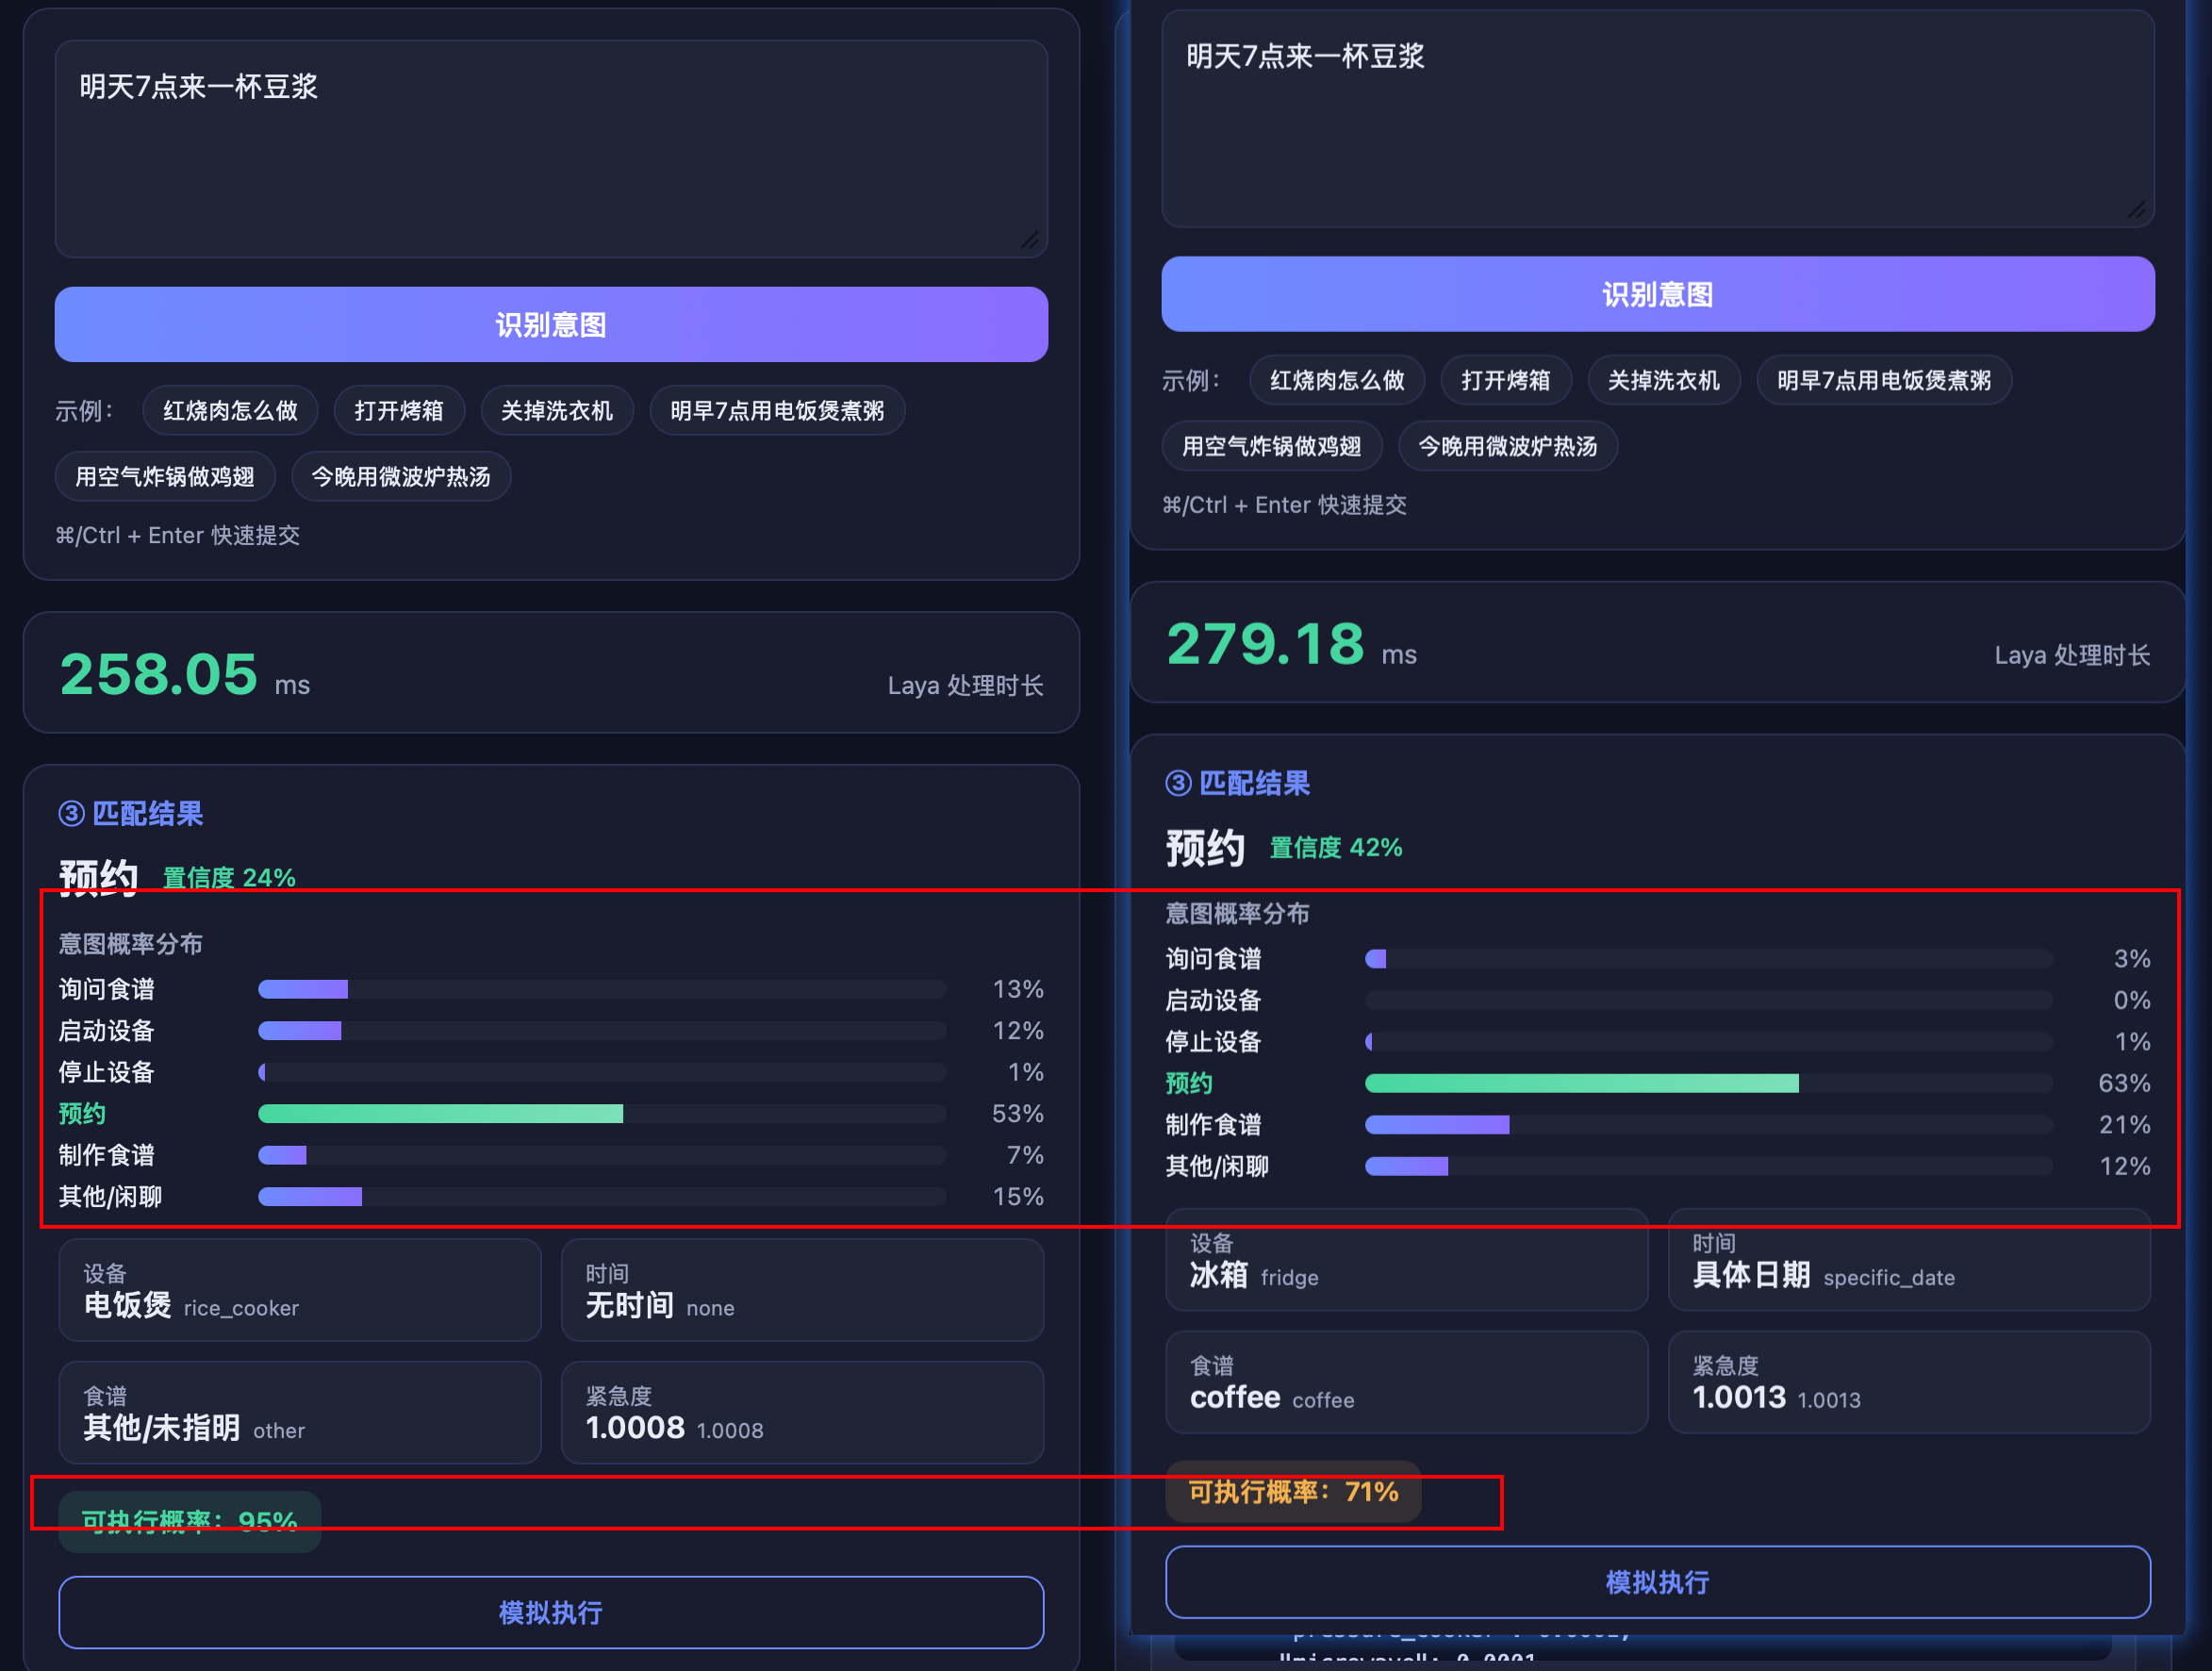
微调链路是:smart_home_train.jsonl → 复现 laya 前向((state, questions)→gold 选项索引)做交叉熵 → 仅更新决策头 → 导出 DecisionModel.state_dict 到 sh_laya_sft/pytorch_model.bin。后端加载时就是「laya.load 基座 + load_state_dict 微调权重」两步,Demo 直接生效。
五、踩过的几个坑(经验贴)
HF_HOME必须在import laya/torch之前设置 ,否则会回退到全局~/.cache,我一开始就因为这个把权重下到了全局还不知道。现在decider.py/finetune.py/app.py都在最顶部强制设置。- base 模型不能直接用,一定要微调,否则家电意图基本随机。
- MPS 不是 GPU :Apple Silicon 能用
mps后端加速,但要显式判断torch.backends.mps.is_available(),否则默认走 CPU 会慢好几倍。 - 决策模型 ≠ NER :Laya 只做结构化决策,不做实体抽取。我把槽位也塞进
choice决策,是一次「全决策」的激进尝试,对长尾设备/食谱覆盖有限,后续可以考虑「Laya 决策 + 轻量 NER」混合。
六、怎么跑起来
bash
# 后端(Python 3.9+)
cd backend && python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt        # laya 0.3.4 + torch 2.8.0

# 前端
cd ../frontend && npm install
bash
# 终端 A:后端(真实模型 + 本地微调 checkpoint,端口 8000)
cd backend && source .venv/bin/activate
LAYA_FINETUNED=./finetune/sh_laya_sft uvicorn app:app --port 8000
# 仅规则兜底(无需模型):LAYA_MOCK=1 uvicorn app:app --port 8000

# 终端 B:前端(端口 5173,/api 反代到 8000)
cd frontend && npm run dev
# 浏览器打开 http://localhost:5173
自测接口:
bash
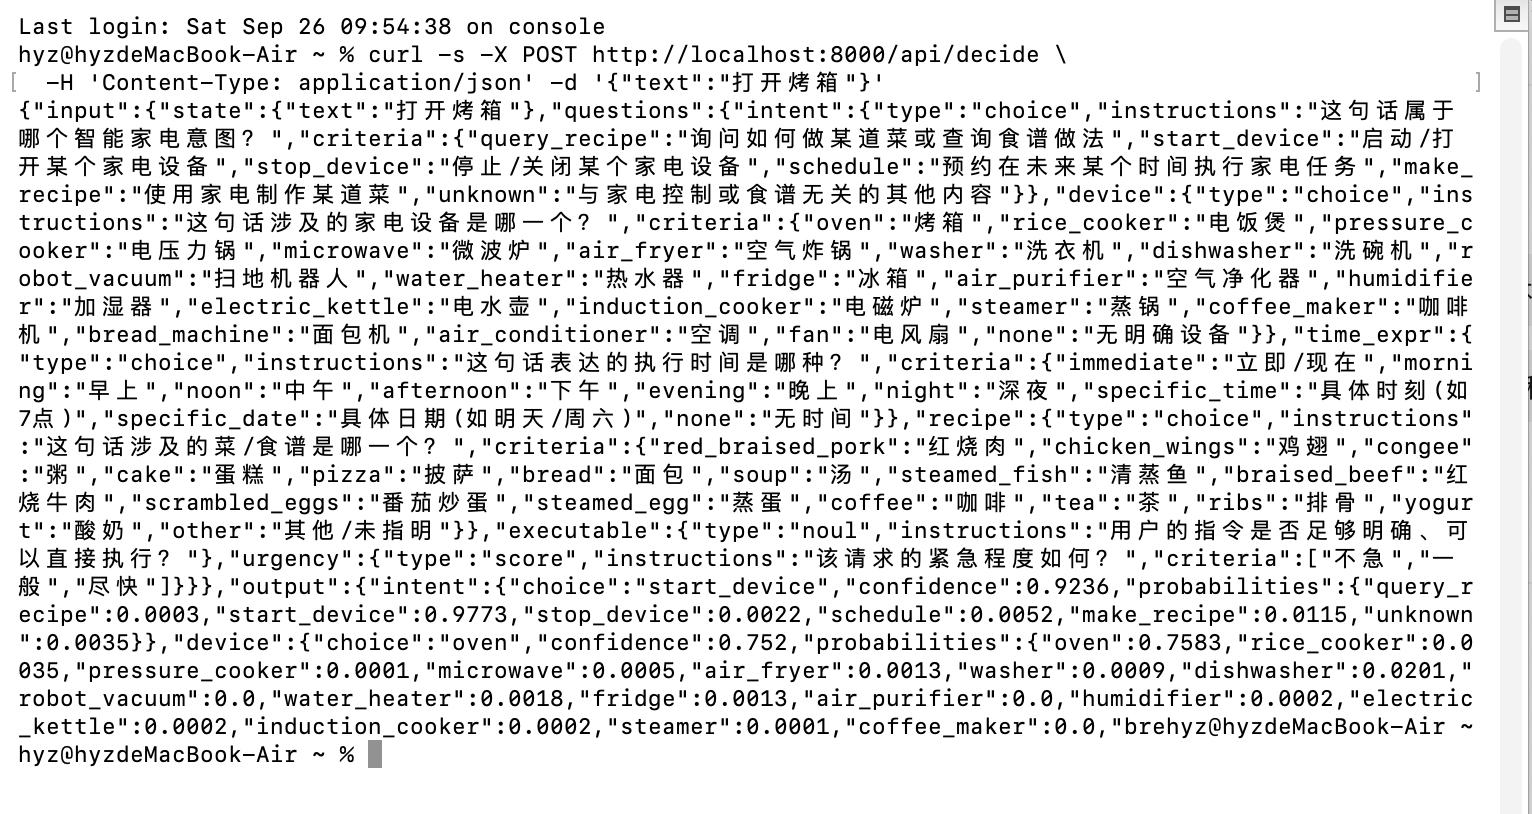
curl -s -X POST http://localhost:8000/api/decide \
  -H 'Content-Type: application/json' -d '{"text":"打开烤箱"}'
终端运行截图
七、总结与下一步
这次尝试验证了我的判断:用 JEV 范式的决策模型(Laya 开源版)来做智能家居决策,路线是通的。相比「通用大模型 + prompt + 一堆后处理」,它的优势很明显:
- 输出天生结构化,每个决策都带置信度,便于做阈值拦截和可解释展示;
- 非自回归、延迟低(MPS 上 ~200ms),适合嵌入式/本地化部署;
- 微调成本低,冻结编码器只训决策头,单卡/本地就能跑。
但也清楚它的边界:base 模型需要领域微调才可用;纯决策不擅长开放实体;长尾覆盖依赖数据集规模。
接下来我打算:① 扩充数据集到更大规模、覆盖更多方言口语;② 试官方更高阶的 RLCD / GRPO 强化学习微调;③ 把决策结果真正接到家电 MQTT / 智能家居中枢去「执行」,而不只是展示。
如果你也对「用决策模型替代一部分 LLM 调用」感兴趣,欢迎到仓库看看,也欢迎交流:https://gitee.com/han-fan/laya.git
本文基于我在 laya(JEV 开源实现)上的智能家居决策 Demo 实践整理,项目已开源,包含数据集、微调脚本、前后端体验页完整代码。