 新手最常问的问题是"哪个 API 最好用",但这个问题问早了。你真正该问的是:以我现在的水平,下一个该练什么?
数据 API 的学习是有顺序的------顺序错了,你会把时间全花在调试接口参数上,而真正该练的数据处理功夫一点没长。这篇文章把它拆成五级台阶,每级都给出可验收的练手任务和对应平台。
一、先纠正一个认知:你缺的不是 API,是数据处理的功夫
很多人上手第一天就去研究"怎么拿到全市场 Tick 数据",结果拿到几十万行数据之后,发现自己连 groupby 都写不顺,更别说算复权、拼多表。
一个残酷但有用的判断标准:
如果给你一份现成的 CSV 行情文件,你不能在半小时内算出 5 日/20 日均线并画出金叉点,那么现在学任何 API 都是浪费时间。
数据的获取只是一次性的工程问题,数据的处理才是量化里反复要用的能力。先把后者练出来,前者学起来会快得多------因为你会清楚地知道"我需要什么字段",而不是"别人说这个接口很全"。
二、五级台阶:从"能跑通一行代码"到"数据不再断"
先看全貌。这张图是整篇文章的骨架,后面逐级展开: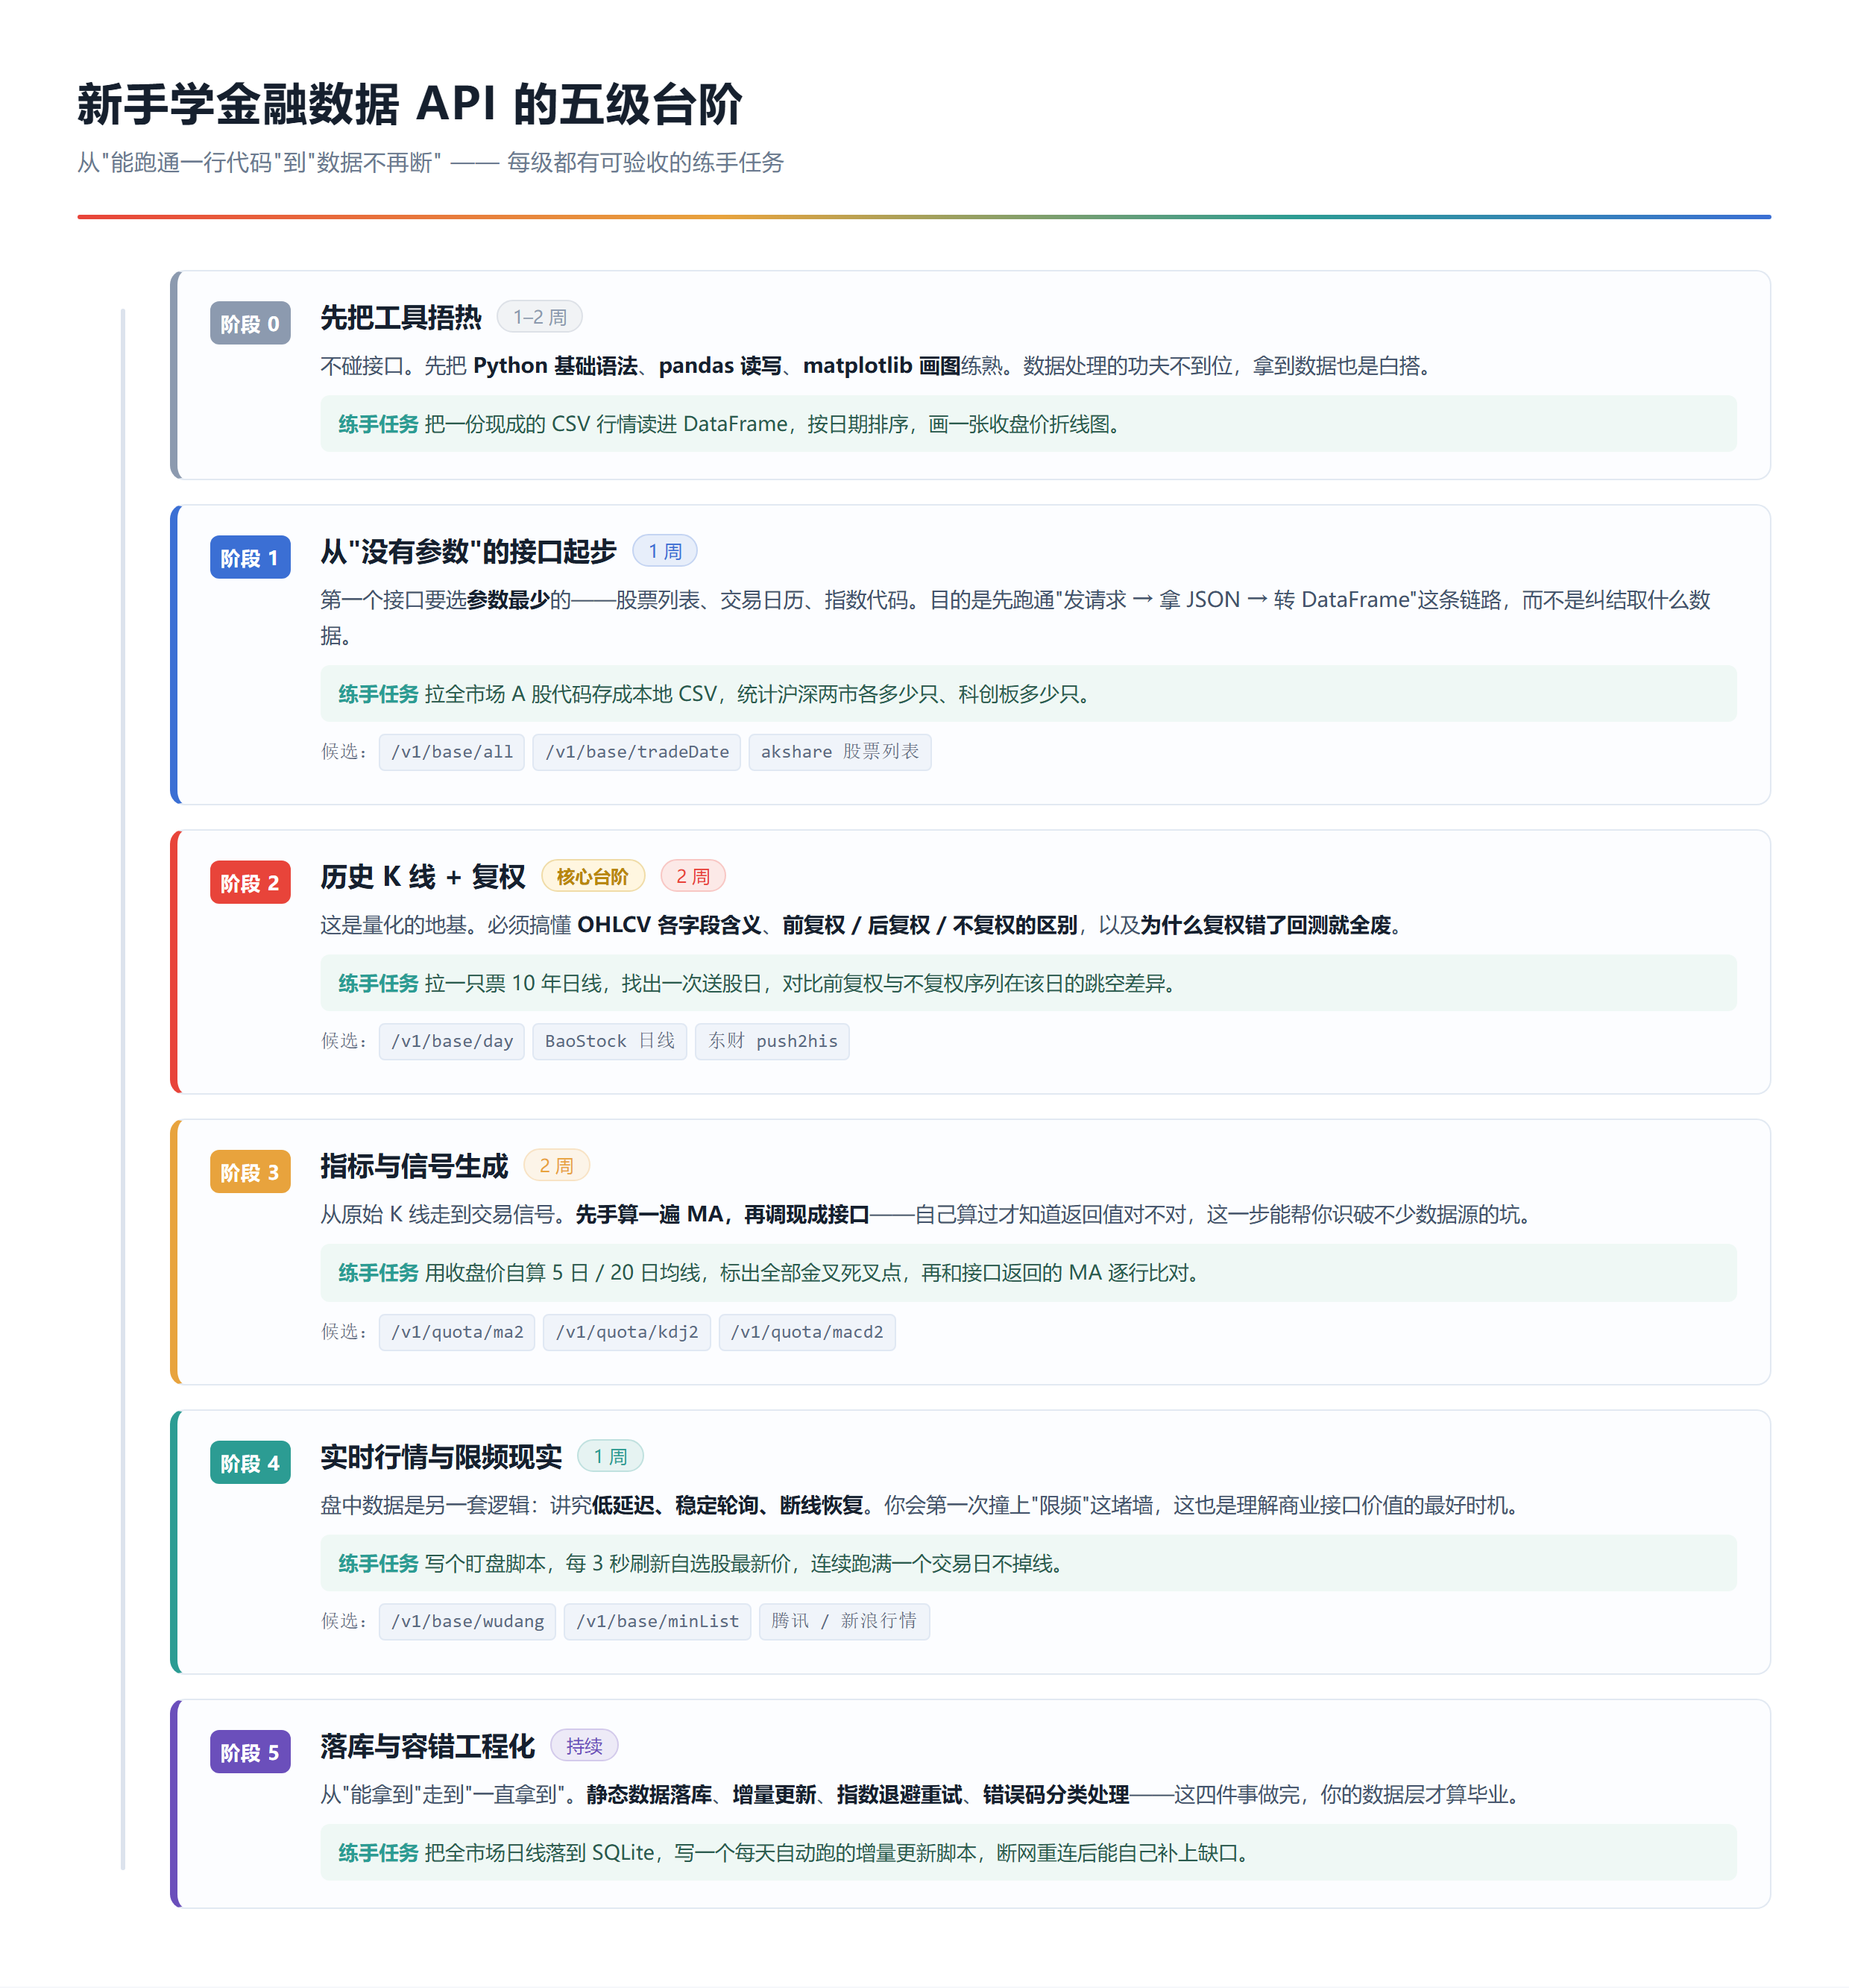
图 1:五级台阶全貌,每级都有可验收的练手任务
注意其中一个判断:第一个接口要选参数最少的那个。 新手最容易掉进的坑是------一上手就选一个带七八个参数的接口,把时间耗在猜参数上,而不是理解数据。
三、逐级展开
阶段 0 · 先把工具捂热(1--2 周)
不碰任何接口。 先把这三样练熟:Python 基础语法、pandas 读写与筛选、matplotlib 画图。
练手任务:找一份现成的行情 CSV,读进 DataFrame,按日期排序,画一张收盘价折线图。
python
```python
import pandas as pd
import matplotlib.pyplot as plt

# 让 matplotlib 正常显示中文
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei"]
plt.rcParams["axes.unicode_minus"] = False

df = pd.read_csv("sample_kline.csv", parse_dates=["date"])
df = df.sort_values("date").reset_index(drop=True)

print(df.head())
print(df.dtypes)          # ← 养成习惯:先看类型,日期是不是真的 datetime

plt.figure(figsize=(12, 4))
plt.plot(df["date"], df["close"])
plt.title("收盘价走势")
plt.tight_layout()
plt.show()
```
验收标准 :日期列是 datetime64 而不是 object。这一点没做到,后面所有按日期筛选的代码都会出问题。
阶段 1 · 从"没有参数"的接口起步(1 周)
第一个接口要选参数最少 的。股票列表、交易日历、指数代码------这类接口的目的不是取到什么数据,而是先跑通"发请求 → 拿 JSON → 转 DataFrame"这条链路。
StockAPI 的 A 股列表接口就是个好起点:它的请求参数表格是空的,一个参数都不用传 ,请求频率限制也很宽松(2 次/天),因为文档明确建议用户只在本地留一份: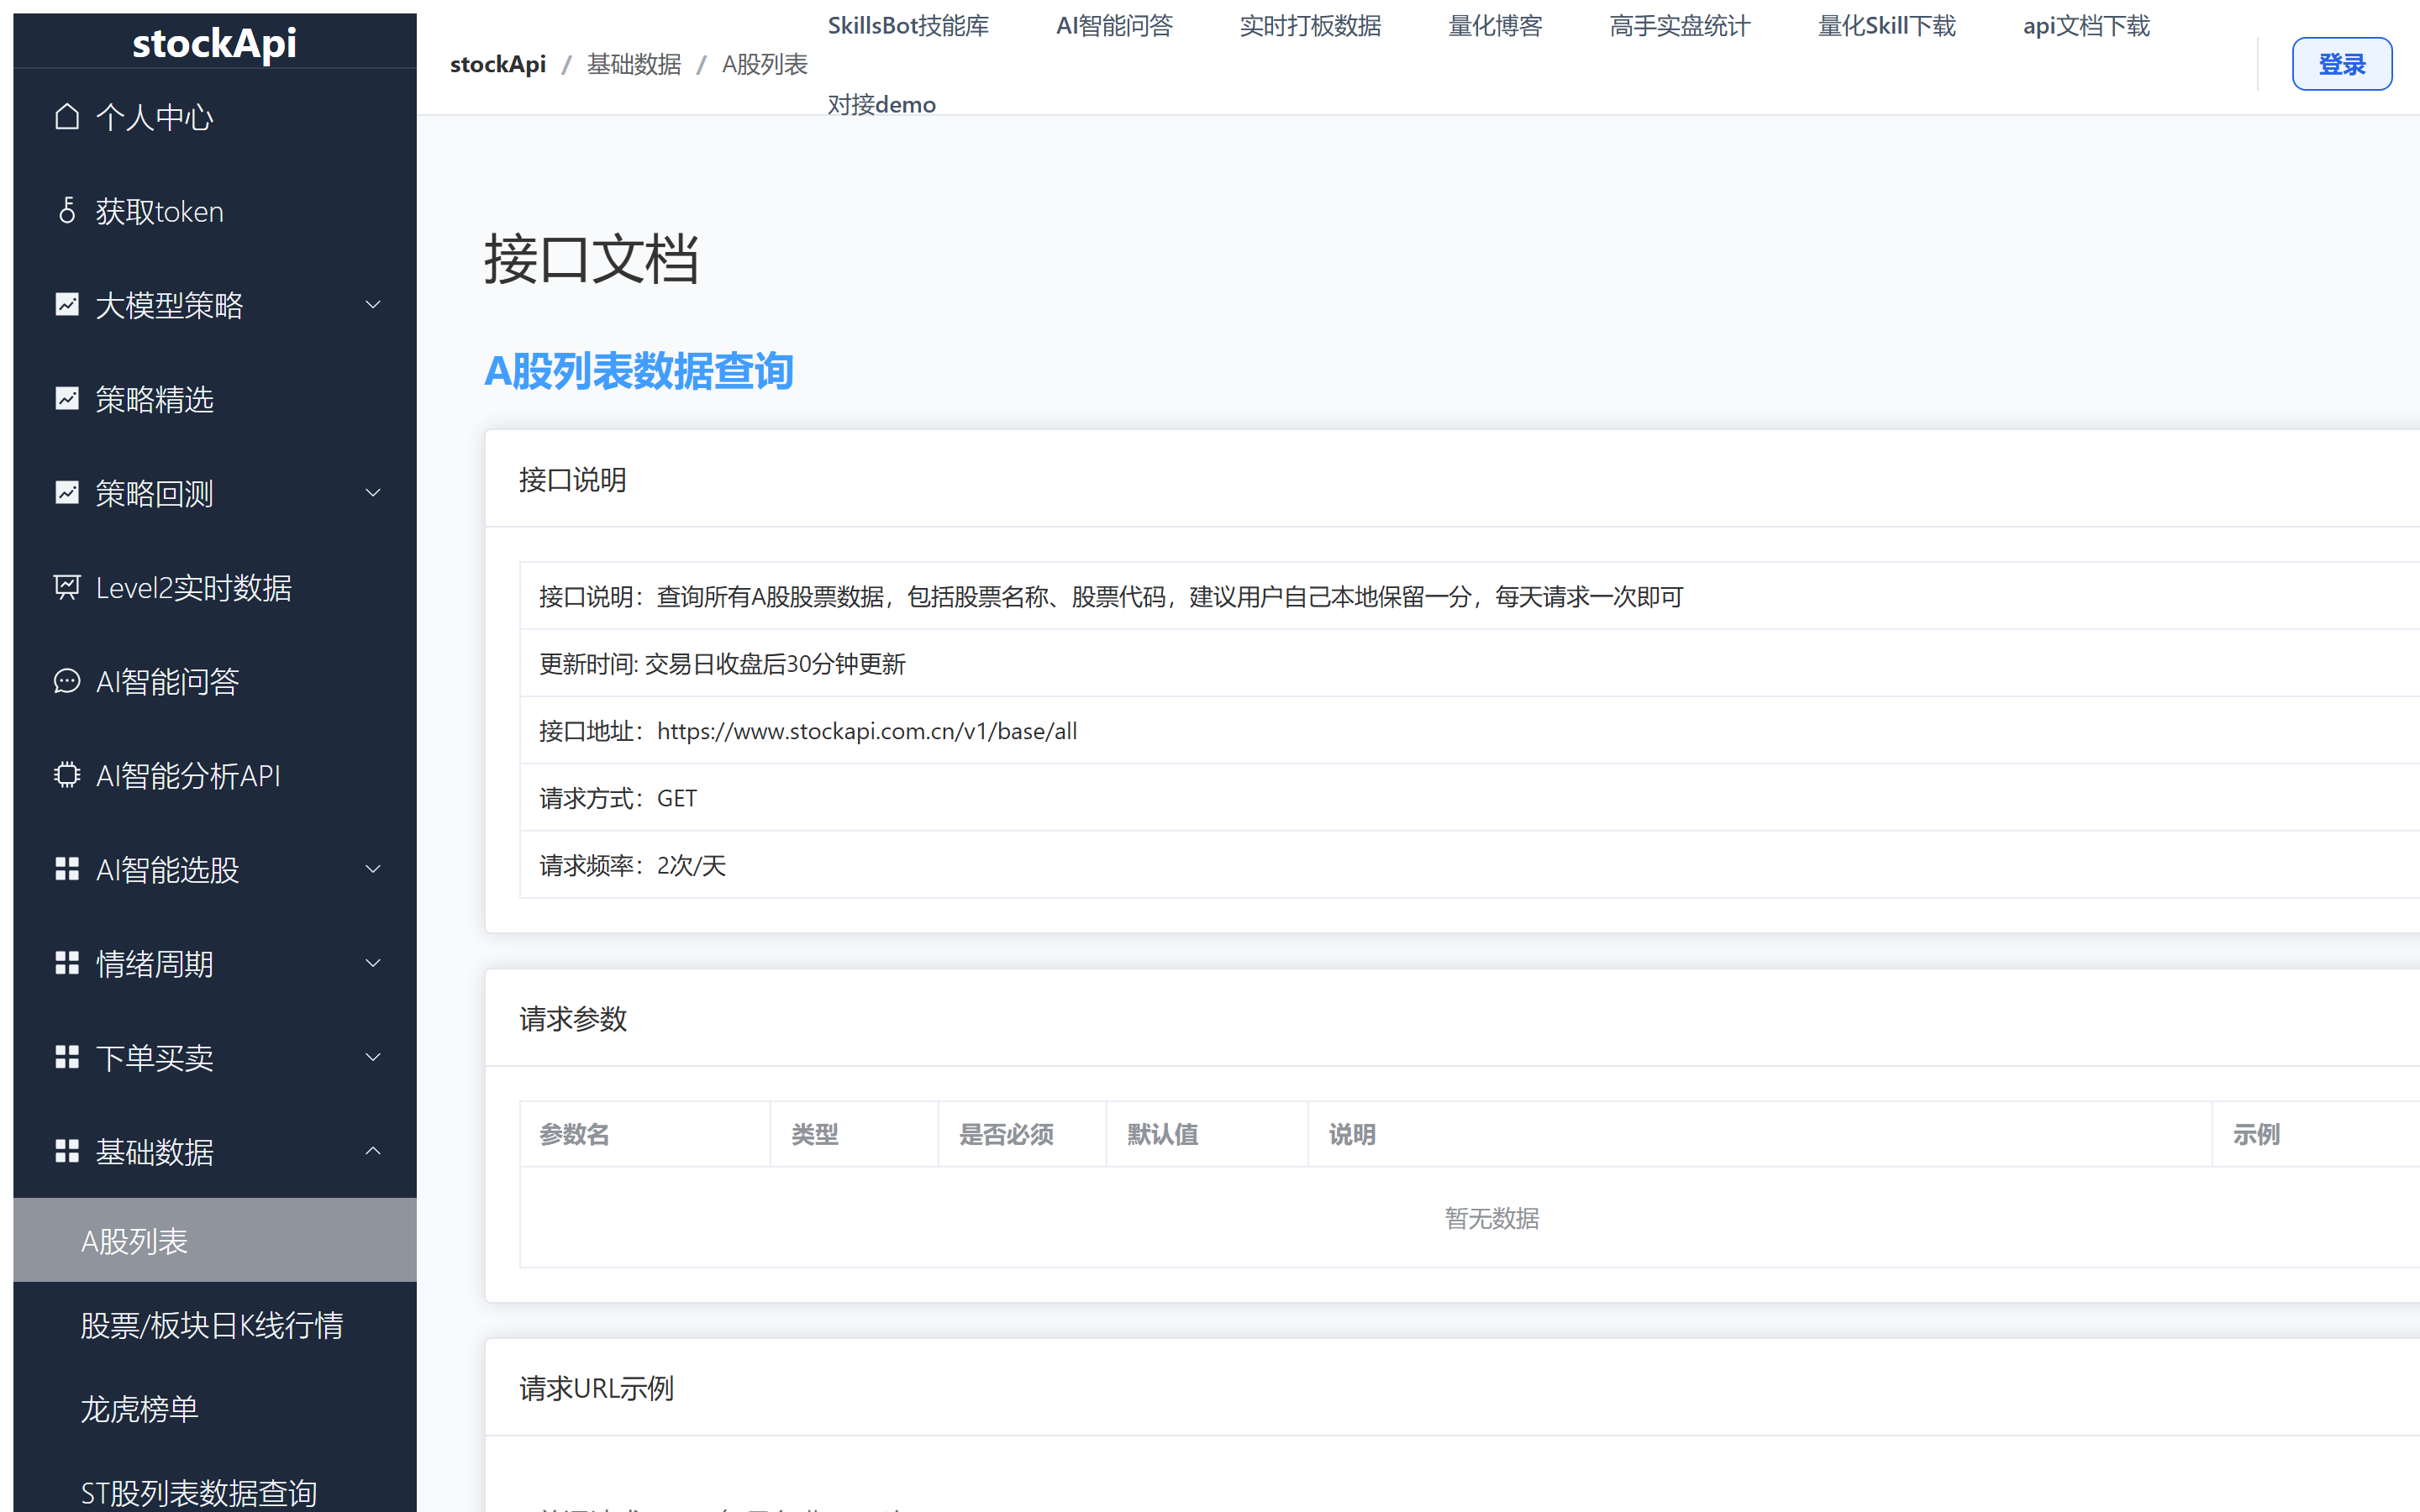
图 2:A 股列表接口------请求参数为空,最适合作为第一个练手的接口
python
```python
import requests
import pandas as pd

# 第一个接口:不需要任何参数
resp = requests.get("https://www.stockapi.com.cn/v1/base/all", timeout=10)
body = resp.json()

print("返回码:", body["code"], "| 状态:", body["msg"])   # 20000 表示成功

df = pd.DataFrame(body["data"])
print(df.head())
print(f"全市场共 {len(df)} 只标的")

# 落成 CSV,这正是接口文档建议的做法
df.to_csv("all_a_stocks.csv", index=False, encoding="utf-8-sig")
```练手任务:把全市场 A 股代码存成本地 CSV,然后统计:沪市多少只、深市多少只、科创板多少只。
验收标准 :你能说出"为什么这个接口限制 2 次/天却毫无影响"------因为它是静态数据,每天同步一次就够,真正该被调用的是本地 CSV。
第二个接口可以换成交易日历 ,它只多一个参数,但会让你第一次接触到"按日期查询"这个模式: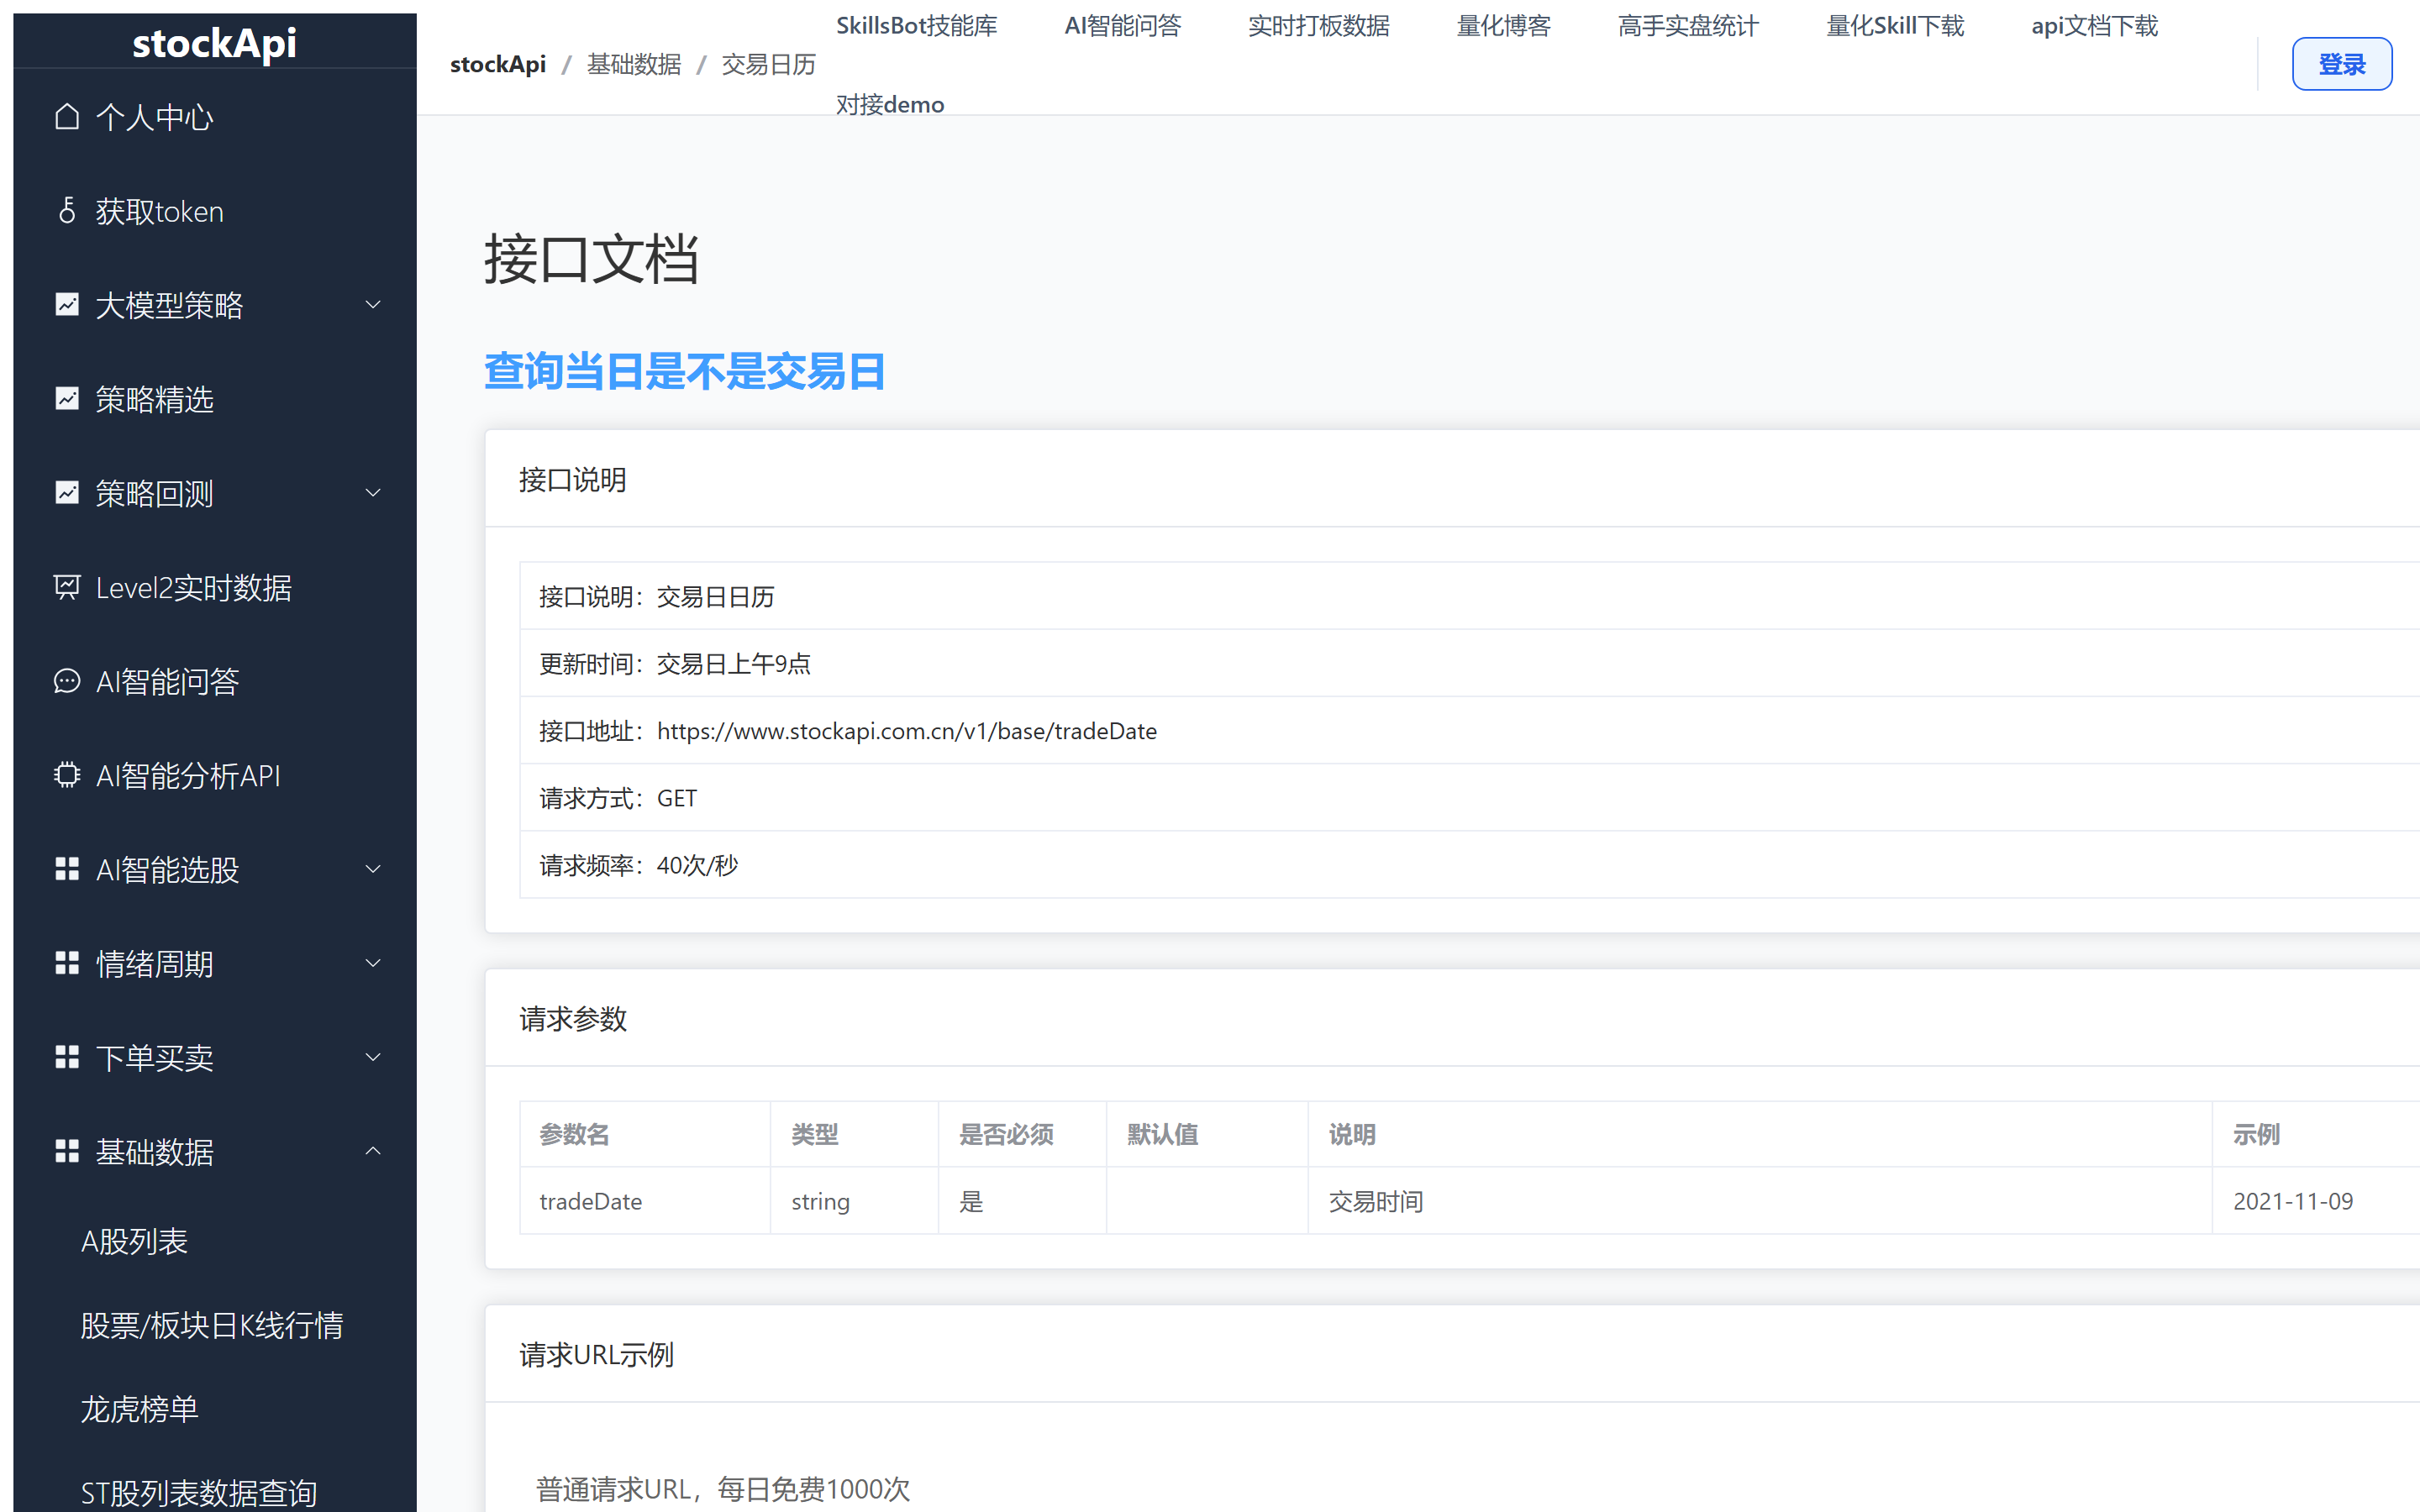
图 3:交易日历接口------参数比上一个多,但仍足够简单
阶段 2 · 历史 K 线 + 复权(2 周)★ 核心台阶
这是整个学习路径里最重要的一级。 必须在这级把三件事搞清楚:
- OHLCV 各字段的含义------开盘、最高、最低、收盘、成交量;
- 三种复权口径的区别------前复权、后复权、不复权;
- 为什么复权错了,回测就全废。
前复权以"最新价格"为基准回溯调整历史价格,所以你看到的历史曲线会随每一次新的除权除息而整体变化;后复权以"最早价格"为基准向前推算,历史序列一旦生成就不会再变。两者没有对错,用途不同:看盘用前复权,长期收益分析用后复权。
StockAPI 的日/周/月 K 线接口把口径直接写在文档里------数据为前复权 ,交易日 16:00 更新: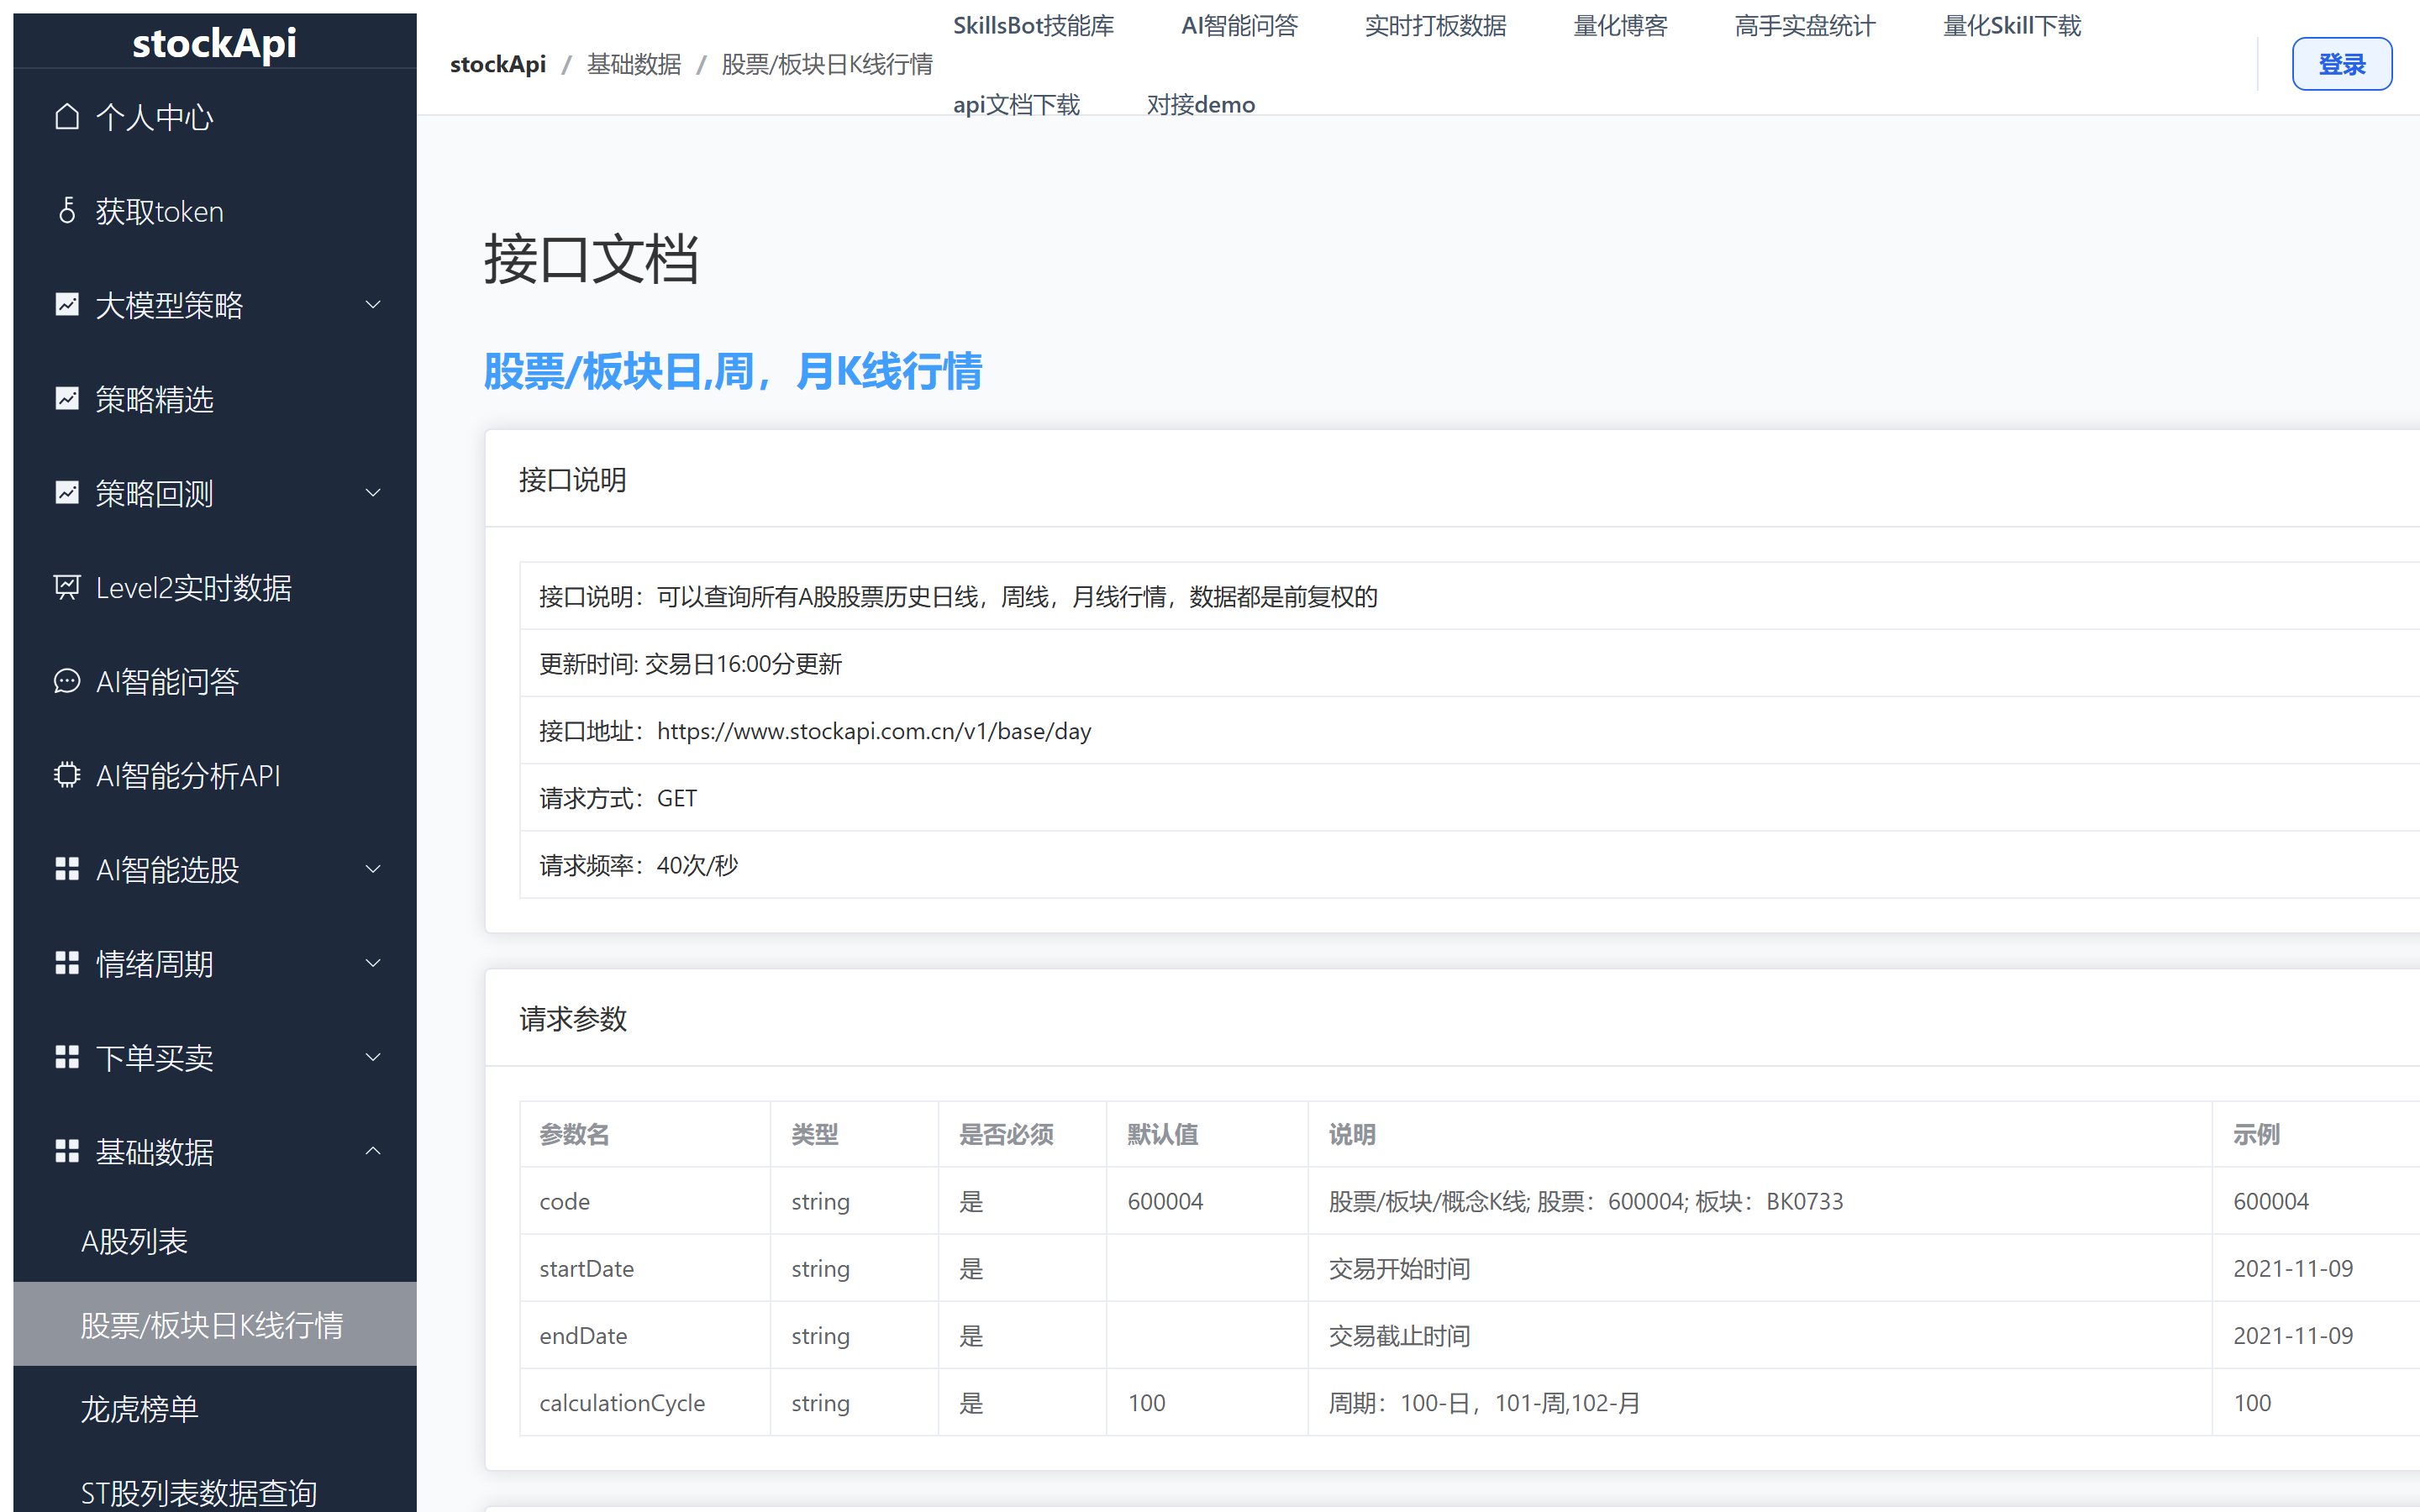
图 4:K 线接口文档,复权口径和更新时间都标在接口说明里
练手任务:拉一只票 10 年日线,找出一次送股日,对比前复权与不复权序列在该日前后的跳空差异,并解释为什么前复权序列是平滑的。验收标准:你能向别人讲清楚"为什么我用前复权数据做的回测,过半年再跑结果会变"。
阶段 3 · 指标与信号生成(2 周)
从原始 K 线走到交易信号。这一级有个关键要求:先手算一遍,再调现成接口。
自己用 pandas 算过 MA,你才会知道返回值该长什么样。之后无论接口给你什么格式------是嵌套的 Object[] 还是扁平数组------你都能一眼看出对不对。
算出来之后,再拿接口返回值对账。StockAPI 把常用指标都做成了独立接口,KDJ 这类指标还允许自定义周期参数: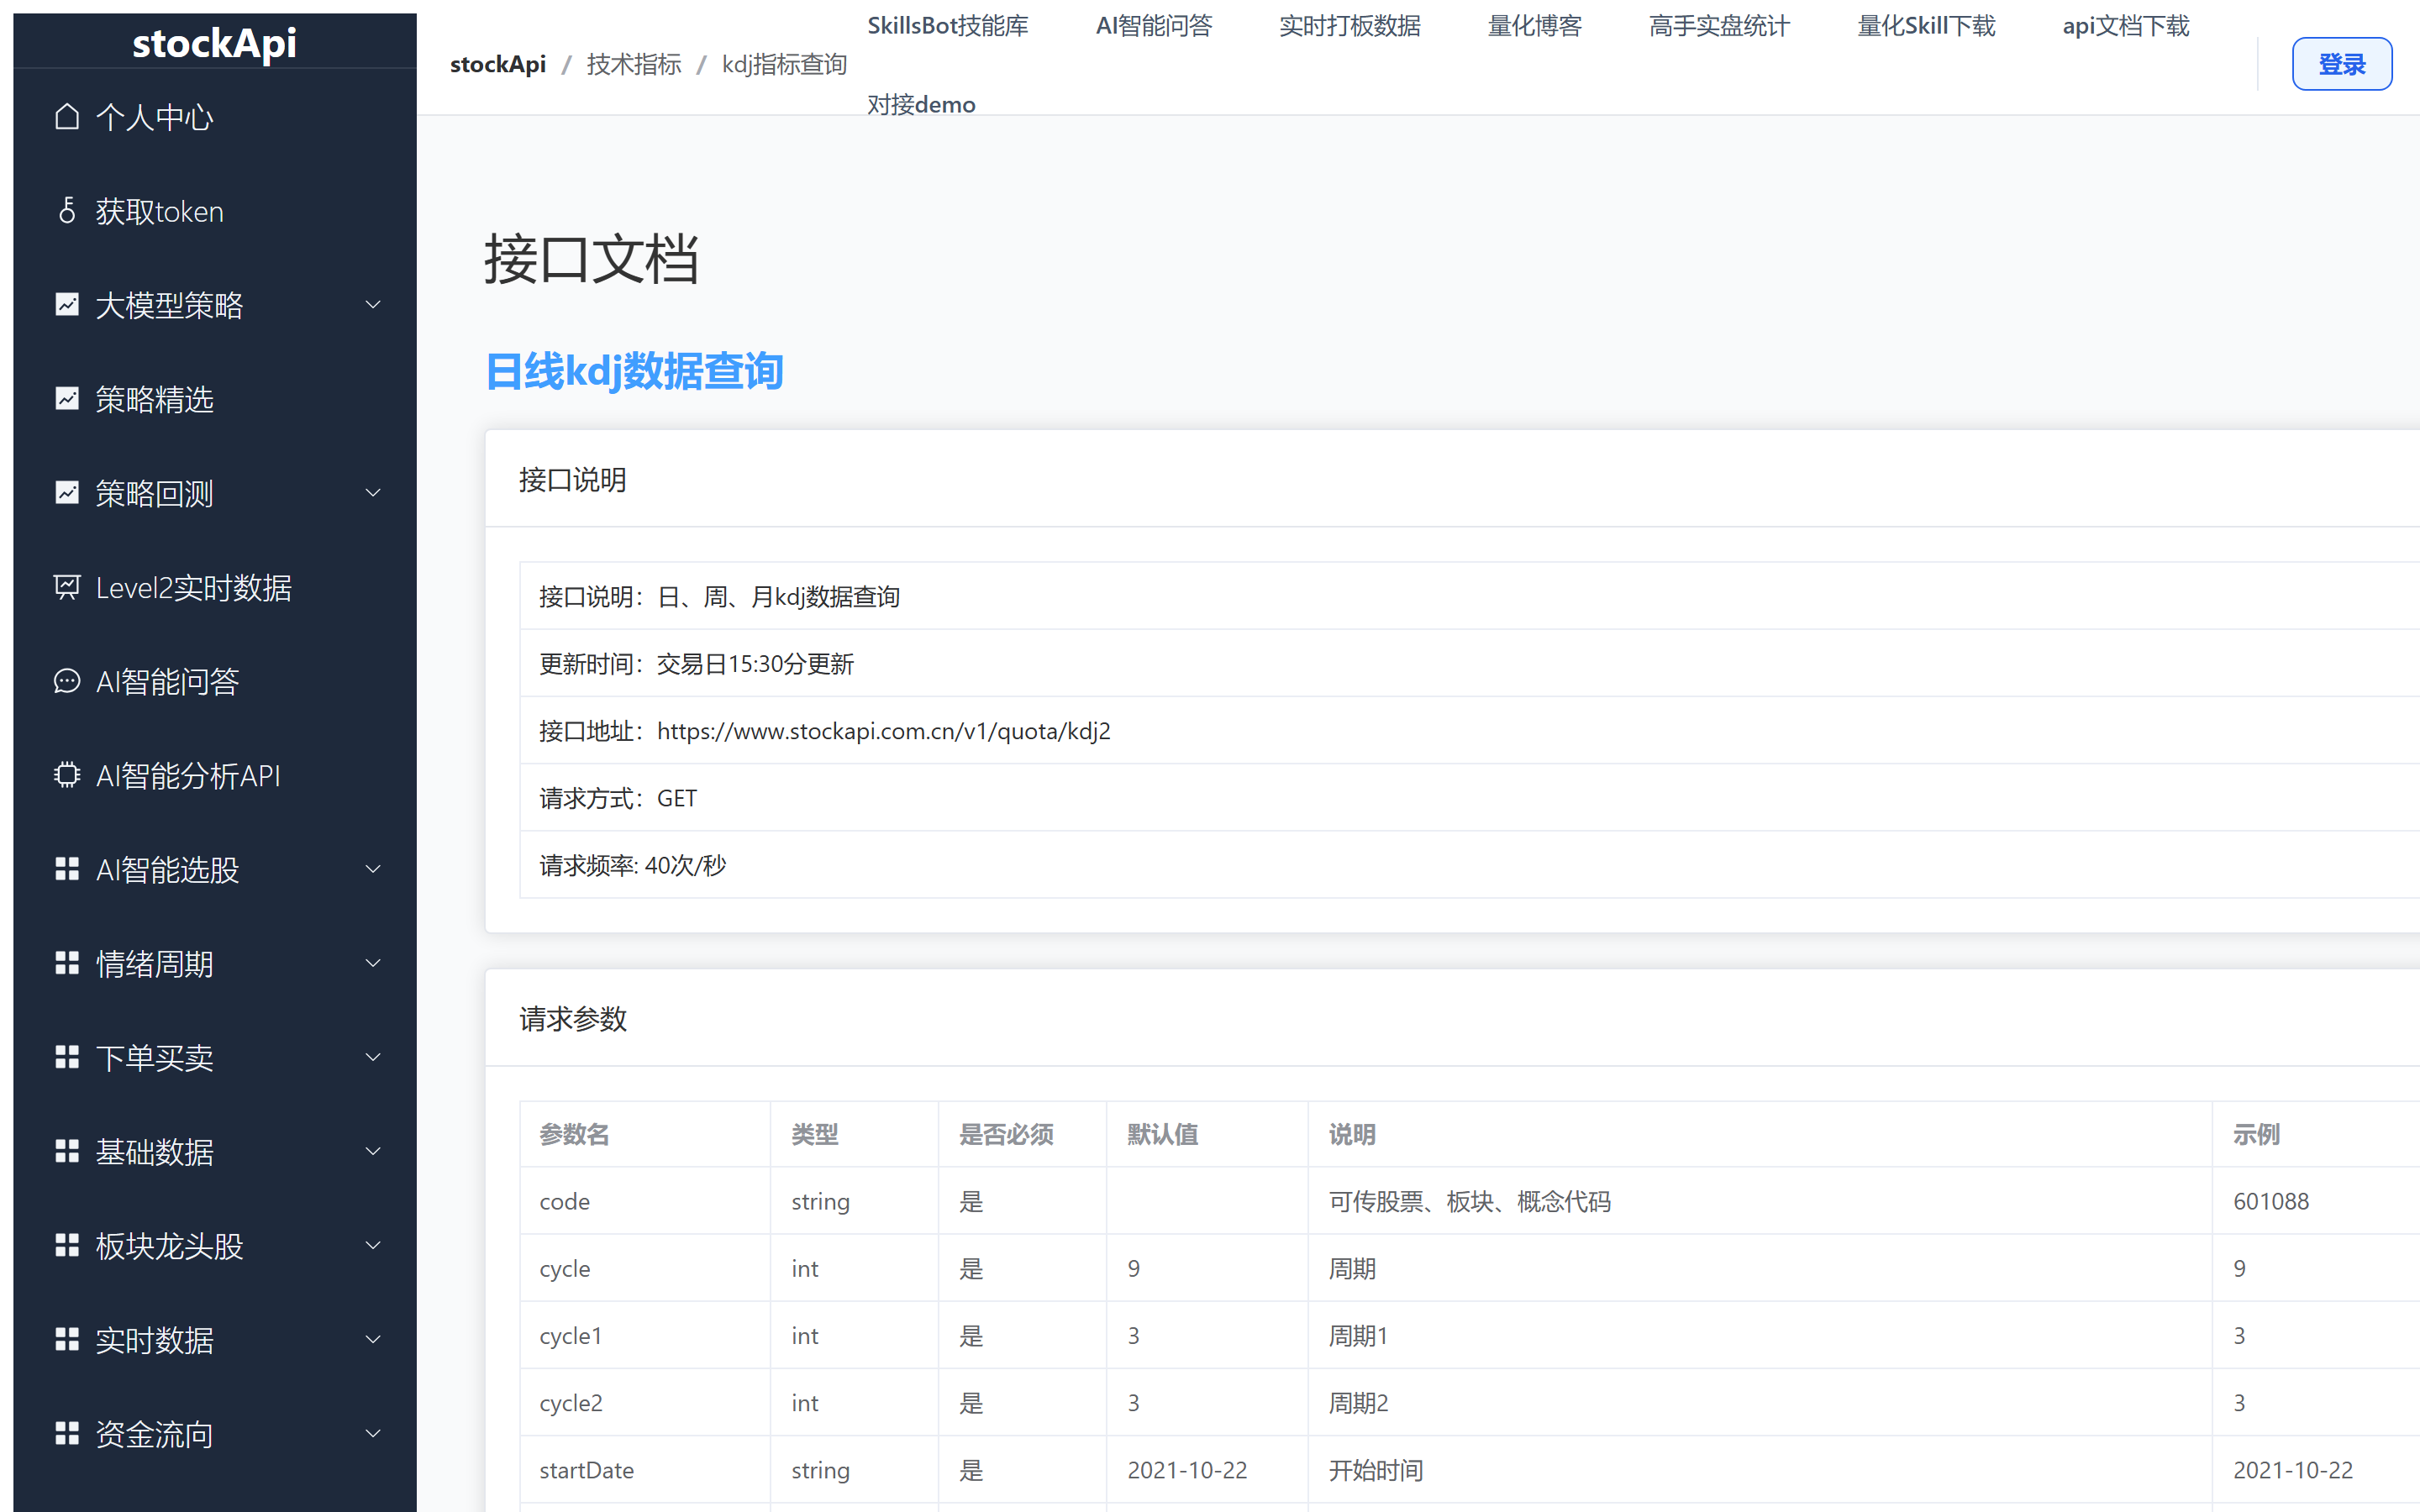
图 5:指标类接口,周期与计算参数都可以传
练手任务:用收盘价自算 5 日 / 20 日均线,标出全部金叉死叉点;再调接口拿一次 MA,逐行比对两者的差异。
验收标准 :如果两者对不上,你能定位到是复权口径不同 、周期参数不同 ,还是停牌日的处理方式不同------这比"对上了"更有价值。
阶段 4 · 实时行情与限频现实(1 周)
盘中数据是另一套逻辑:讲究低延迟、稳定轮询、断线恢复。你会第一次撞上"限频"这堵墙。
这一级最重要的收获不是技术,而是认知:你会亲手体会到为什么免费接口做不了生产。当你的盯盘脚本因为超频而静默返回空数据时,你就真正理解了商业接口在卖什么。
python
```python
import time
import requests
import pandas as pd

watch = ["600519", "000858", "300750"]
rows = []

for _ in range(3):                       # 只轮询 3 轮,避免触发限频
    for code in watch:
        try:
            r = requests.get("https://www.stockapi.com.cn/v1/base/wudang",
                             params={"code": code}, timeout=5).json()
            # 注意:接口文档标注该接口仅在 9:25-15:00 有数据
            rows.append({"code": code, "resp_code": r.get("code")})
        except requests.RequestException as e:
            rows.append({"code": code, "resp_code": type(e).__name__})
    time.sleep(3)                        # 行情本身就是几秒一个快照,1 秒轮询是浪费

print(pd.DataFrame(rows))
```练手任务:写一个盯盘脚本,每 3 秒刷新自选股,连续跑满一个交易日不掉线,并把每次失败的原因记录下来。
阶段 5 · 落库与容错工程化(持续)
从"能拿到"走到"一直拿到"。这四件事做完,你的数据层才算毕业:
- 静态数据落库------股票列表、交易日历、指数成分,每天同步一次到本地;
- 增量更新------只拉上次更新时间之后的数据,而不是每次全量重拉;
- 指数退避重试------失败后按 1s、2s、4s 退避,而不是硬扛;
- 错误码分类------把"额度用完""参数错误""网络超时"分开处理,因为它们的应对方式完全不同。
python
```python
import sqlite3
import pandas as pd
import requests

conn = sqlite3.connect("market.db")

def incremental_update(code, table="kline"):
    """增量拉取:只取本地已有的最后一天之后的数据。"""
    cur = conn.execute(f"SELECT MAX(date) FROM {table} WHERE code = ?", (code,))
    last = cur.fetchone()[0]

    start = last or "2016-01-01"
    body = requests.get(
        "https://www.stockapi.com.cn/v1/base/day",
        params={"code": code, "startDate": start,
                "endDate": "2026-09-25", "calculationCycle": 100},
        timeout=10,
    ).json()

    if body.get("code") != 20000:
        # 分类处理:额度耗尽不该重试,参数错误不该重试,网络问题才该重试
        print(f"{code} 拉取失败: {body.get('code')} {body.get('msg')}")
        return 0

    df = pd.DataFrame(body["data"])
    if df.empty:
        return 0
    df.to_sql(table, conn, if_exists="append", index=False)
    return len(df)
```
⚠️ 上面的示例里,响应字段名以官网「响应参数」表格标注为准------不同接口的命名不统一,写代码前先核对一遍,别照抄任何博客。
练手任务:把全市场日线落到 SQLite,写一个每天自动跑的增量更新脚本,断网重连后能自己补上缺口。
四、一次请求要跨过五道关
认识到这一层,你才真正理解"接口"这个抽象背后有多少坑。新手以为"调接口 = 拿数据",实际上中间隔着五个会静默失败 的地方: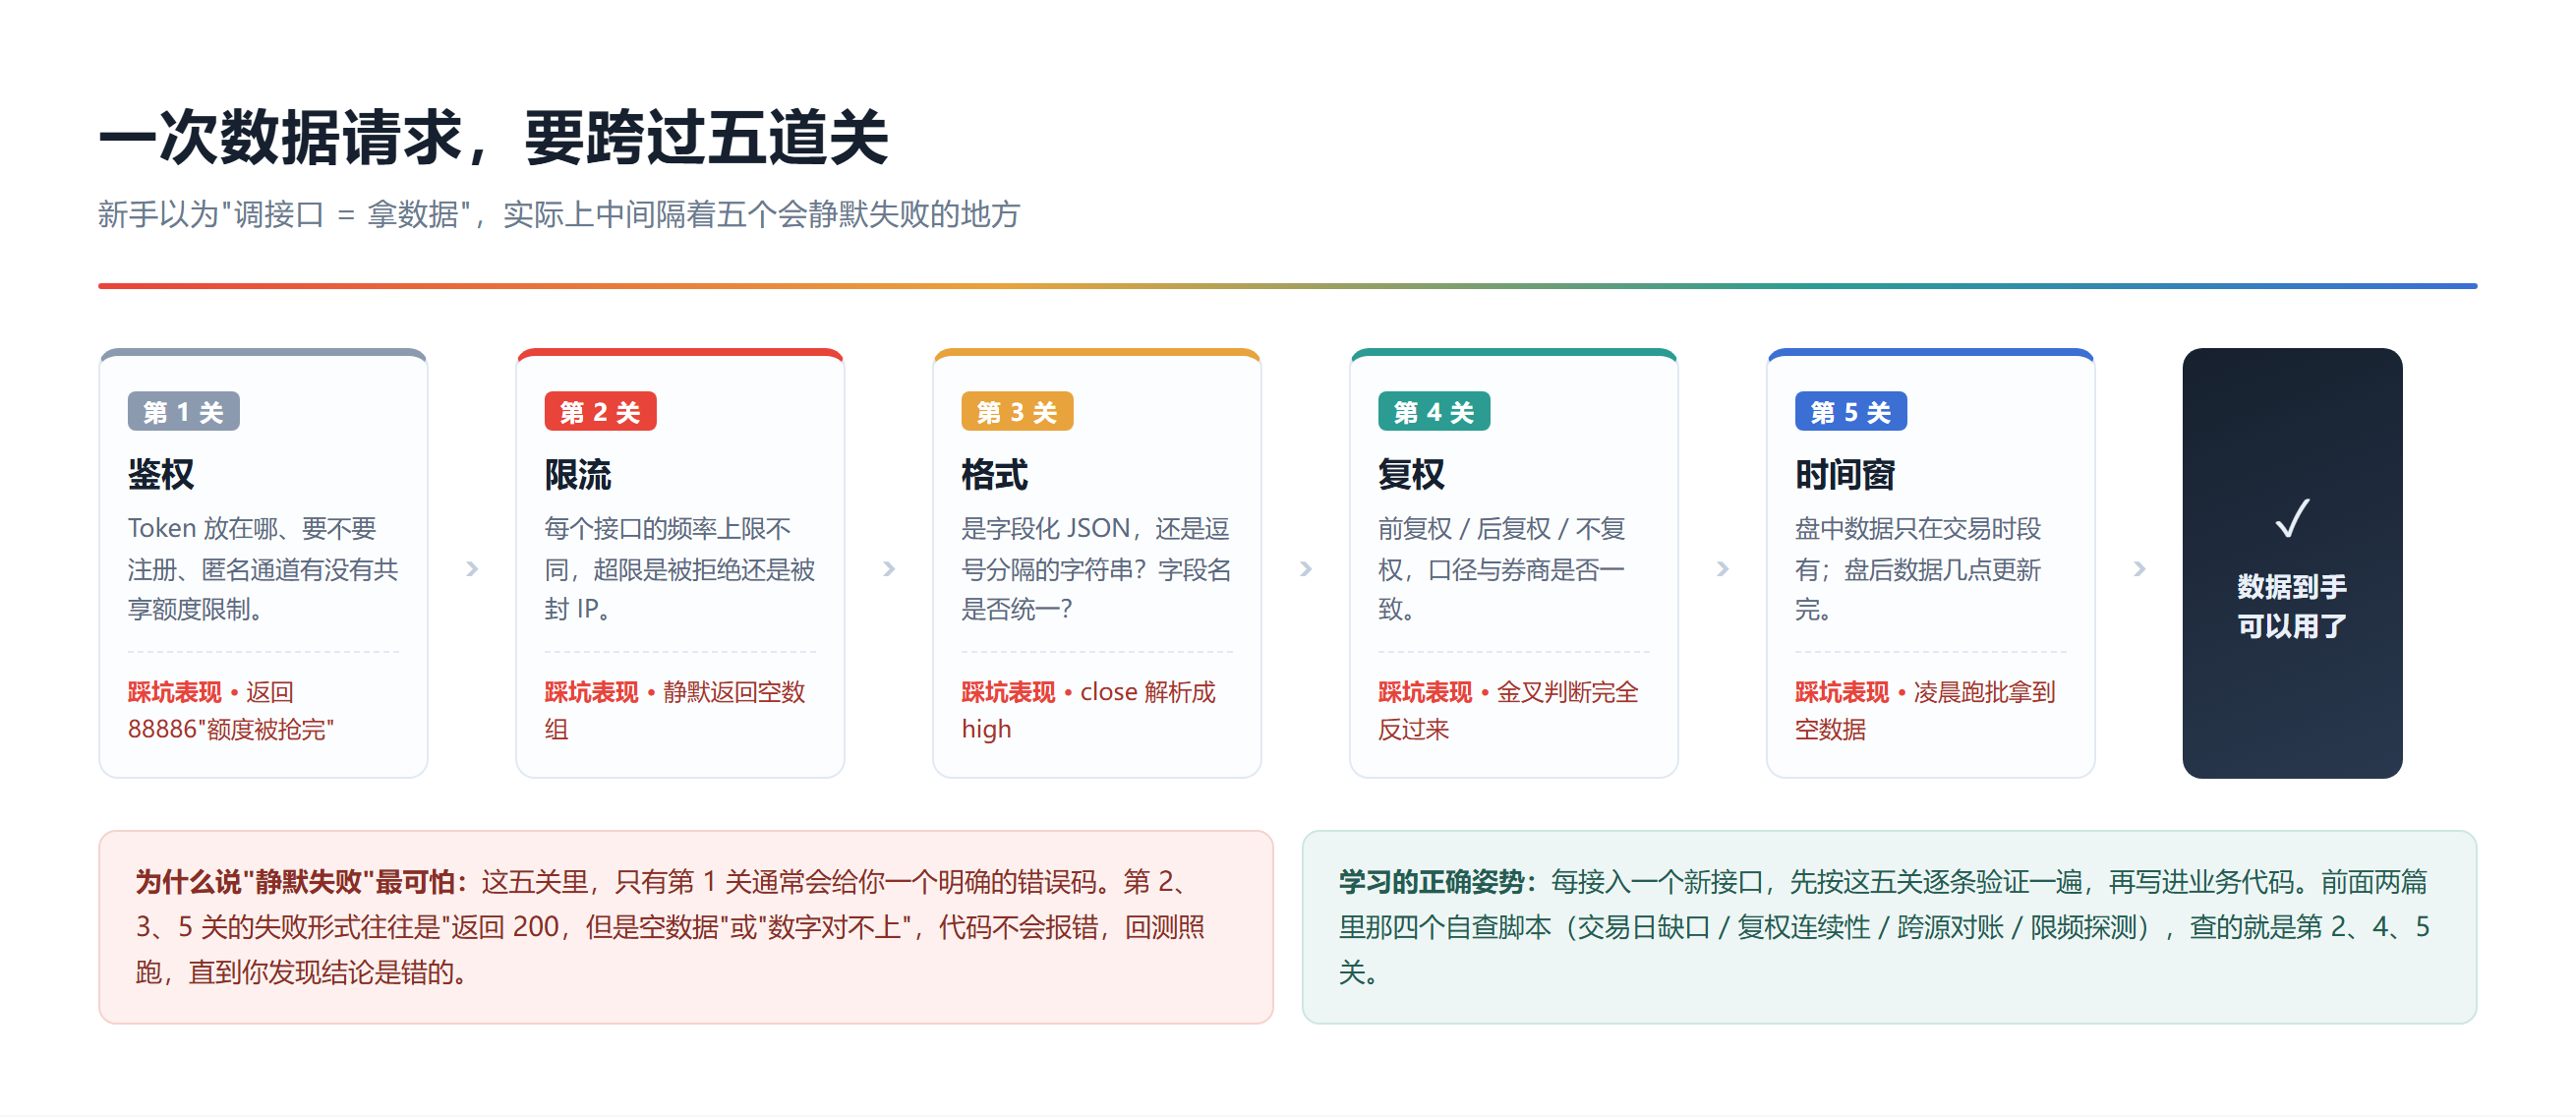
图 6:五道关,其中只有第 1 关通常会给你明确的错误码
为什么说"静默失败"最可怕 :这五关里,只有鉴权那一关通常会返回一个明确的错误码。限流、格式、时间窗这三关的失败形式往往是"HTTP 200,但是空数据"或者"数字对不上"------代码不会报错,回测照跑,直到你发现结论是错的。
所以正确的学习姿势是:每接入一个新接口,先按这五关逐条验证一遍,再写进业务代码。
五、各阶段该用哪个平台
不同平台适合不同的学习阶段。下面这几张是各家的官方页面,可以自己去看。
阶段 1--2 的首选:BaoStock。 免注册、匿名登录、三种复权口径可传参,日线数据扎实。它的知识库把「每日更新」「A股K线数据」「指数数据」的 API 说明分门别类放在一起:
图 7:BaoStock 官方知识库入口
阶段 2--3 的补充:Tushare Pro。 它的接口分类导航本身就适合当"接口地图"来读,能帮你建立"金融数据到底有哪些维度"的整体认知。另外它的股票代码规范(.SH / .SZ / .BJ / .HK)值得早点记住:
图 8:Tushare 的数据接口分类与代码后缀规范
找另类数据:AkShare。 但要理解它的工作机制。翻它的文档,每个接口下面都写着一行 「目标地址」------指向的是交易所或门户网站的页面:
图 9:AkShare 文档里的"目标地址"------它的数据来自抓取网页
这就是为什么 AkShare 适合盘后做研究,而不适合放进每天定时跑的生产脚本:源站改一次前端结构,接口就失效。
阶段 1、4、5 的通行做法:REST + JSON 接口。 比如前面反复用到的 A 股列表、K 线、盘口接口,都属于这一类。它的文档是"每个接口一张说明表"的形式,官方整理了一份把全部 84 个接口平铺的总览页(每个带 ID 和版本号):
图 10:接口总览页,可作为"接口地图"通读一遍
stockapi提供了 Python、Java、PHP、C++、C#、C、Node.js 七种语言的对接示例------新手可以直接对照自己常用的语言抄第一段代码:
图 11:多语言对接示例,七种语言任选
六、新手最容易踩的五个坑
1. 一开始就追求"全市场 Tick 级数据"。 Tick 数据量级是日线的几百倍,你还没有能力处理它。先用日线把全流程走通,再考虑提高频率。
2. 把数据拉下来就以为是自己的了。 存成 CSV 不等于拥有数据。CSV 无法响应交易所的事后修正(比如配股除权日调整),你手里的文件会慢慢变成过期信息。
3. 不设 min_periods。 df["close"].rolling(20).mean() 默认会给你前 19 行的部分计算结果,看着像均线,其实是垃圾值。不加 min_periods 是新手最常见的隐性 bug。
4. 用 sleep(1) 硬扛限频。 先搞清楚接口的频率上限是多少,再设计轮询间隔。行情本身几秒才更新一次快照,1 秒轮询除了浪费额度没有任何收益。
5. 直接照抄博客里的字段名。 包括这篇。字段名以官方「响应参数」表格为准 ------不同接口的命名不统一,抄错一个字段名,close 会静默变成别的列,而且不报错。
风险提示:本文涉及的接口信息均取自各平台公开文档,回测结果基于历史数据,历史表现不代表未来收益。本文不构成任何投资建议。