查询返回字段含义
新增一条索引及文档,用_search进行索引查询
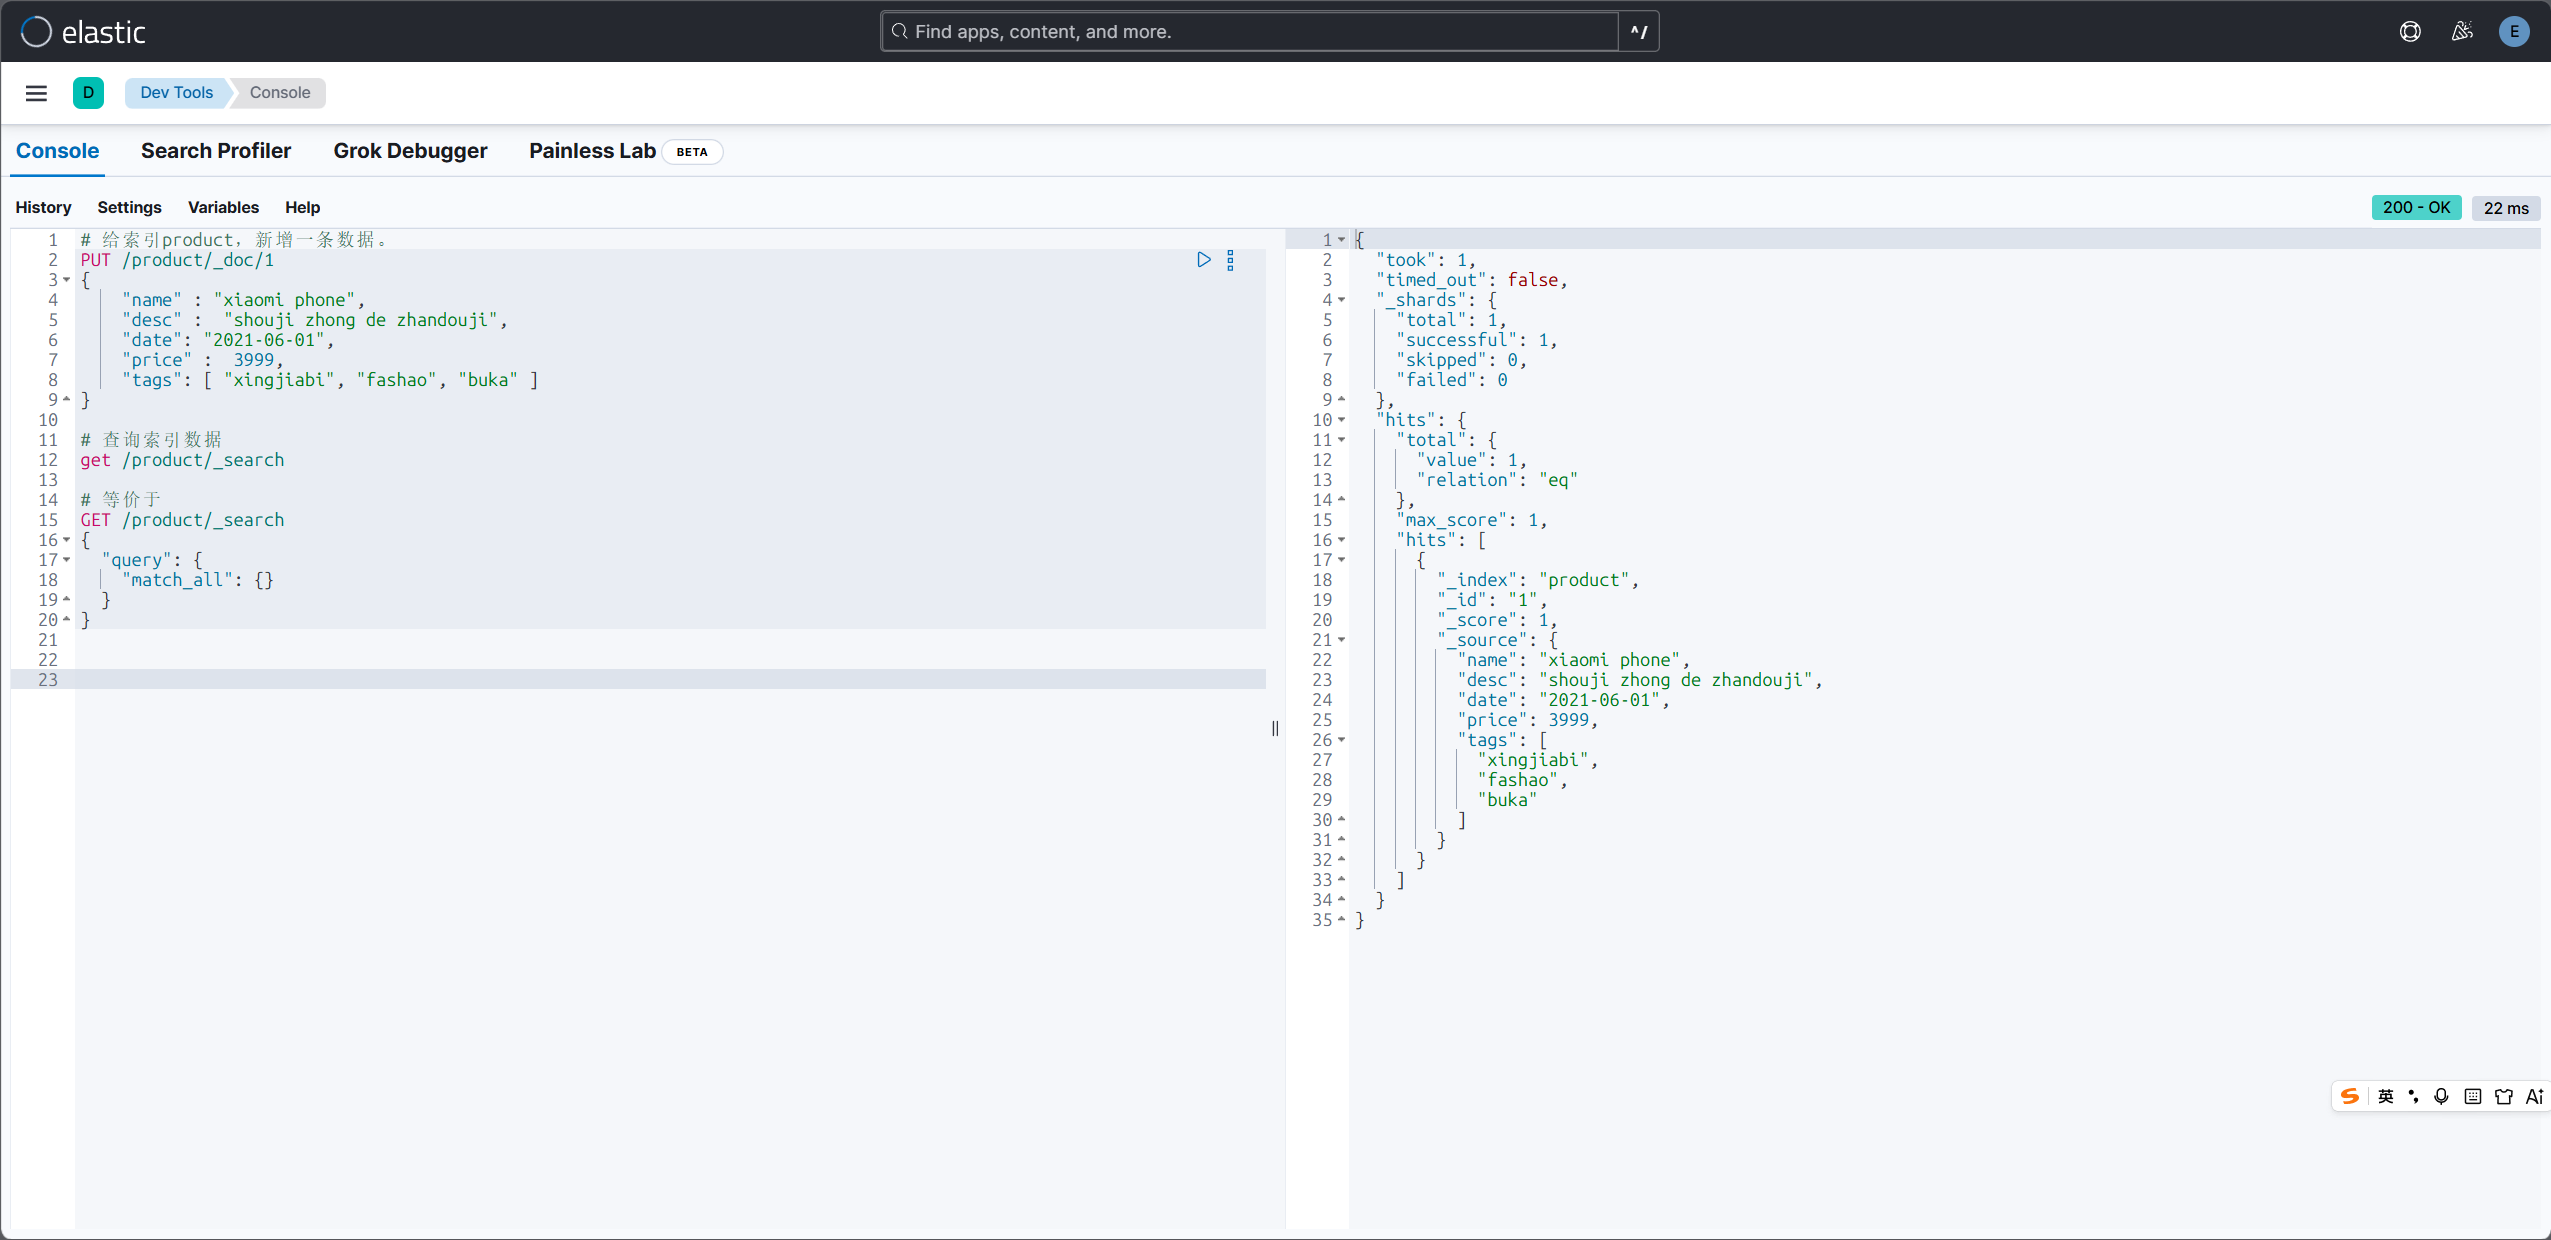
返回结果:
java
{
  #查询耗时,单位毫秒。这个查询花了 1ms 执行(仅 ES 服务端执行时间,不包含网络传输耗时)
  "took": 1,
  # 查询是否超时。false没有超时;true代表部分分片查询超时,返回的结果是不完整的。
  "timed_out": false,
  # 分片统计
  "_shards": {
    # 本次查询一共需要访问 1 个分片
    "total": 1,
    # 成功执行返回的分片数量 1
    "successful": 1,
    # 跳过的分片(分片预过滤,不需要查询)
    "skipped": 0,
    # 查询失败的分片,0 代表无分片异常
    "failed": 0
  },
  # 命中文档结果集(最核心)
  "hits": {
    # 匹配条件的文档总数
    "total": {
      # 符合查询条件总共有 1 条文档
      "value": 1,
      # eq:精确值,总数就是value;gte:大于等于(ES 默认,超过 10000 条时,不会精确计数,只会告诉你至少多少条,节省性能)
      "relation": "eq"
    },
    # 本次结果集中,最高的相关性打分 _score。这里最高分是 1
    "max_score": 1,
    # 存放每一条命中文档
    "hits": [
      {
        # 文档所属索引名 product
        "_index": "product",
        # 文档唯一 id
        "_id": "1",
        # 查询上下文的相关性分数。filter 上下文查询这里永远是1.0,不做相关性打分。
        "_score": 1,
        # 原始文档数据,就是你存入 ES 的 json 原始内容,默认返回。可以通过_source:false关闭返回,节省带宽。
        "_source": {
          "name": "xiaomi phone",
          "desc": "shouji zhong de zhandouji",
          "date": "2021-06-01",
          "price": 3999,
          "tags": [
            "xingjiabi",
            "fashao",
            "buka"
          ]
        }
      }
    ]
  }
}
_source过滤
_source是返回文档源数据,支持添加过滤,减少要输出的字段,节约带宽,es底层仍然是读取所有数据,不会提升查询速度。
1、请求体里的 _source
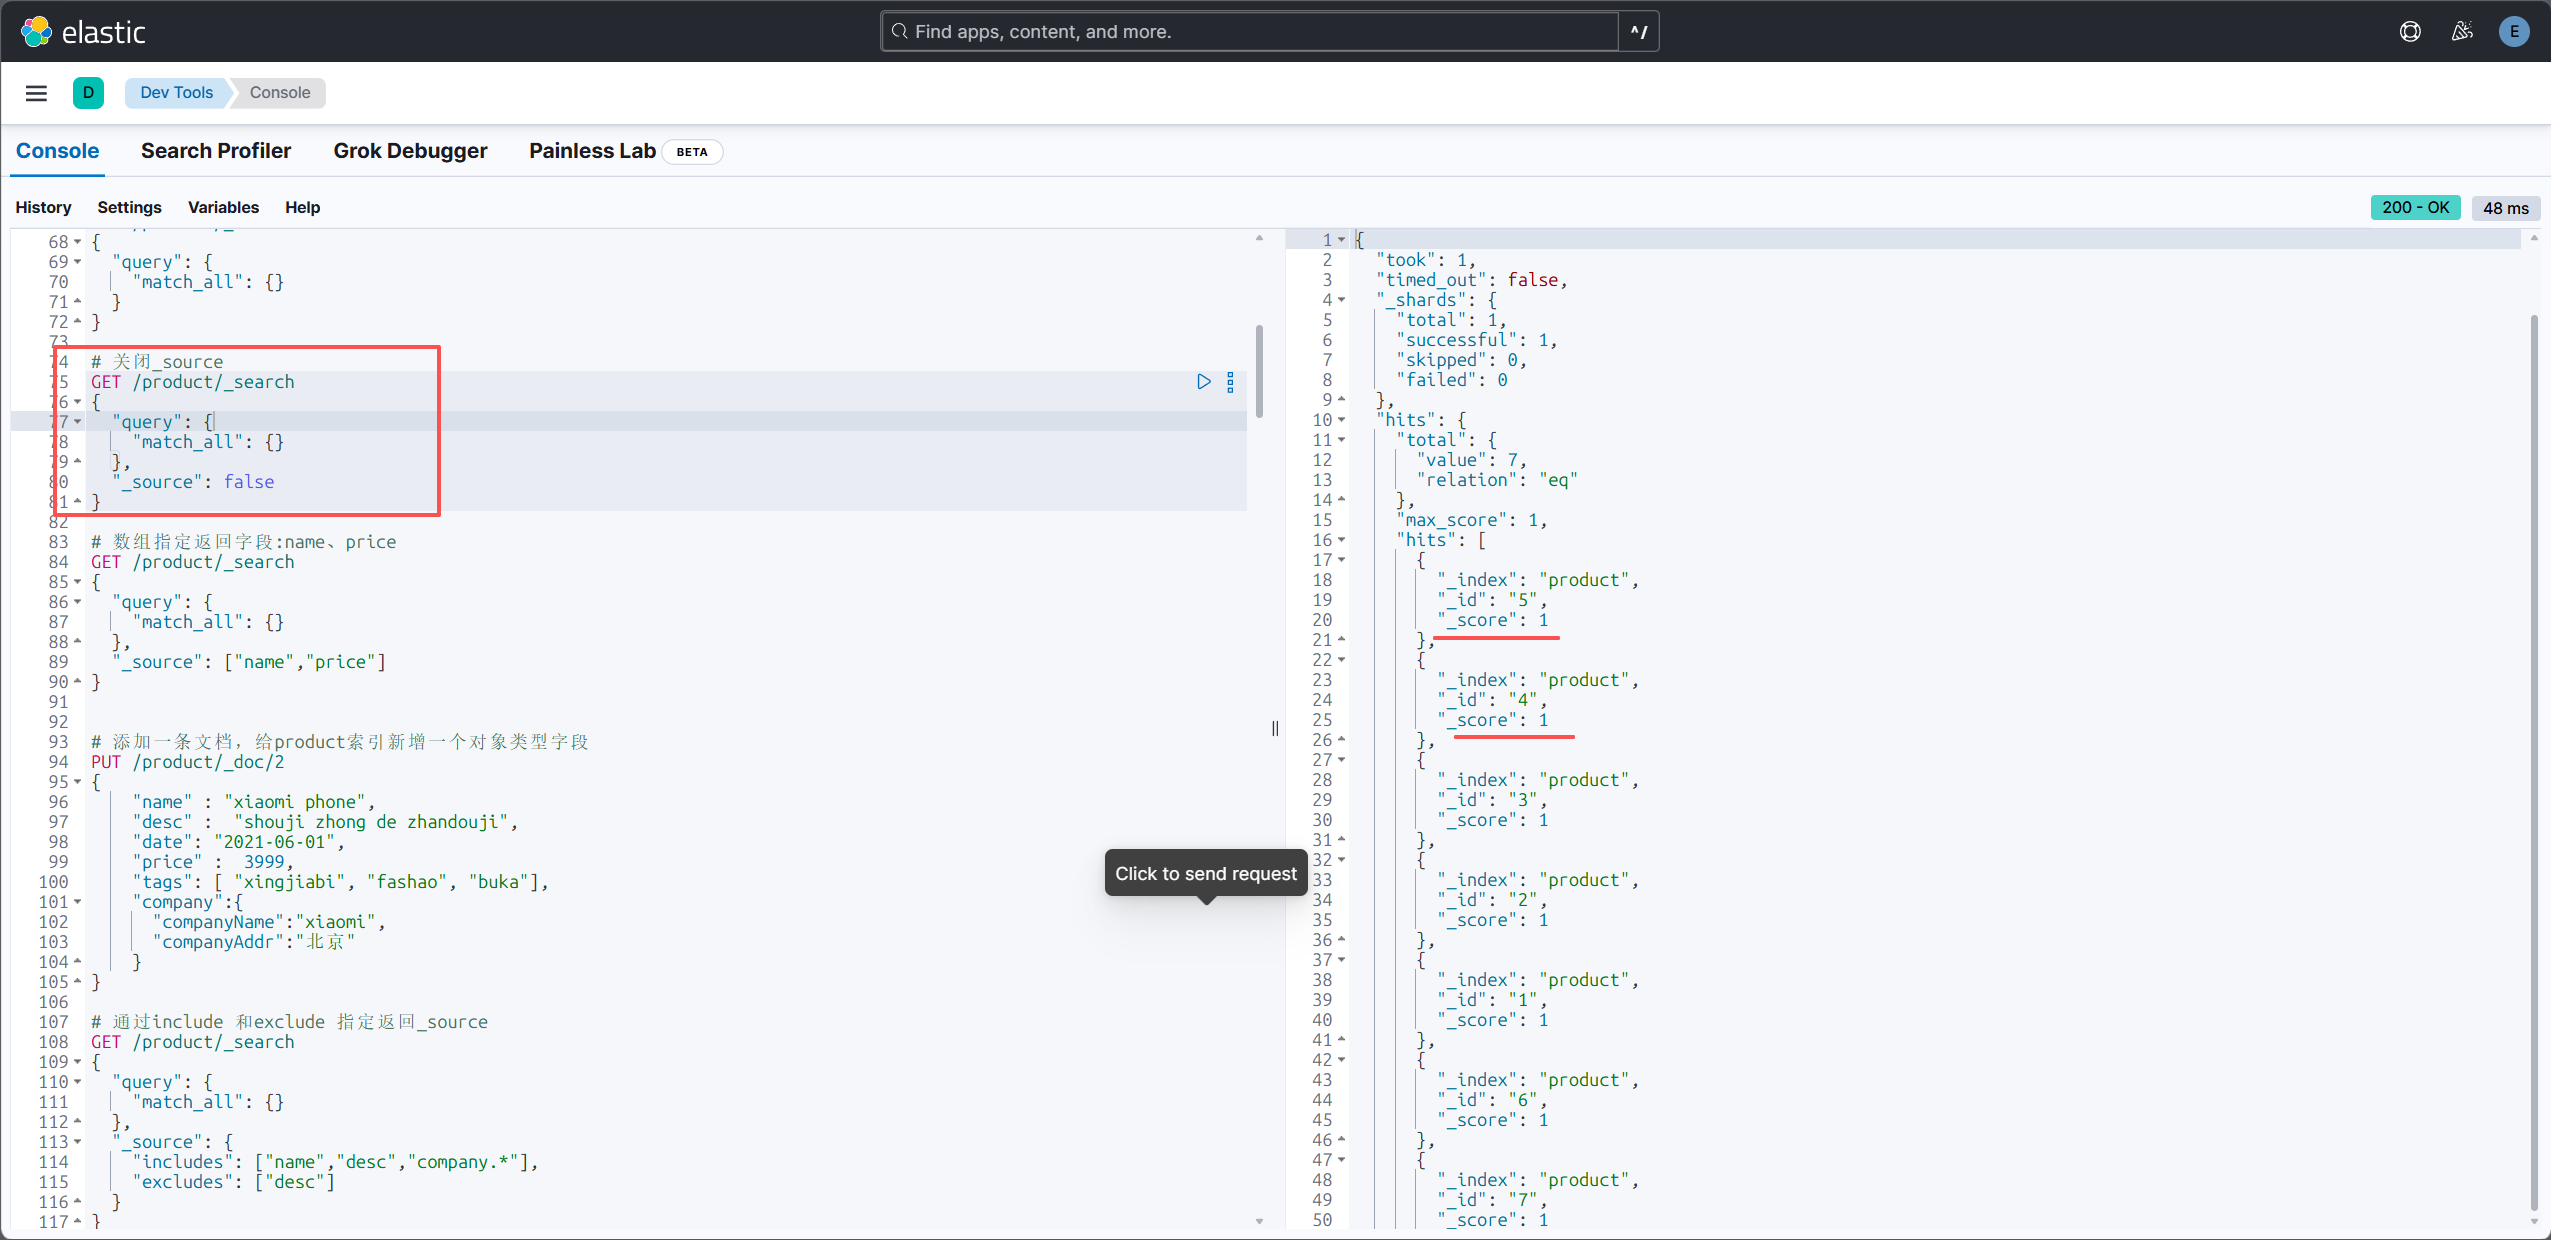
- 关闭返回 _source
java
# 关闭_source
GET /product/_search
{
  "query": {
    "match_all": {}
  },
  "_source": false
}
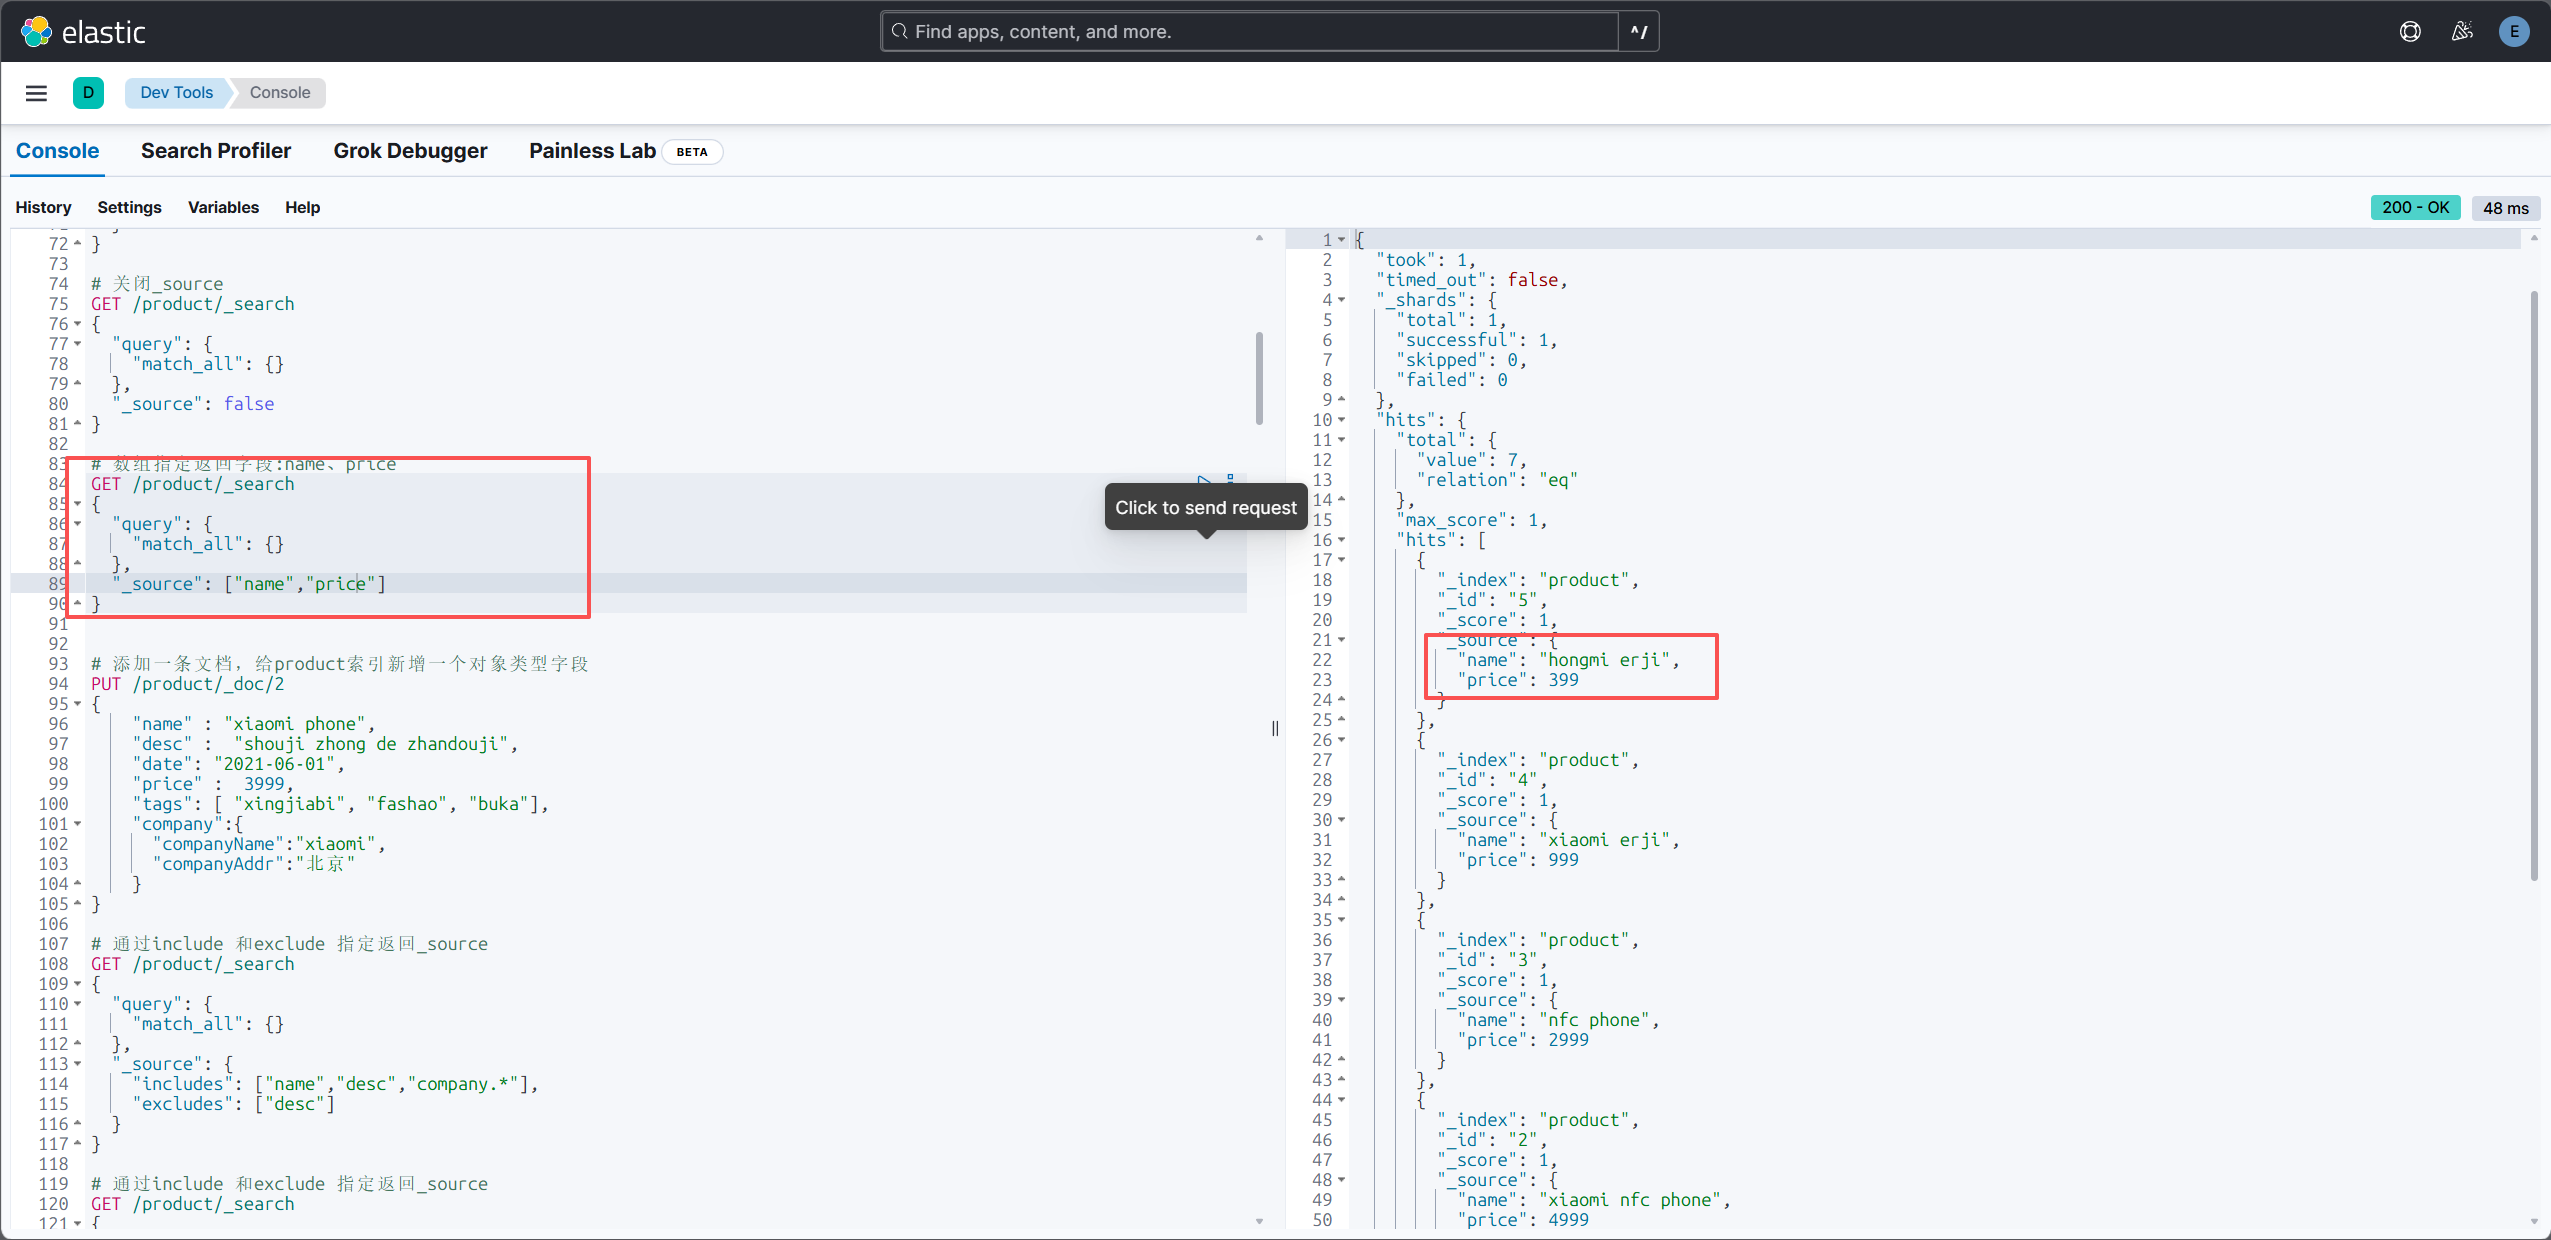
- 数组,指定要返回哪些字段
java
# 数组指定返回字段:name、price
GET /product/_search
{
  "query": {
    "match_all": {}
  },
  "_source": ["name","price"]
}
- 对象形式
includes + excludes,支持通配符*
java
GET /product/_search
{
  "query": {
    "match_all": {}
  },
  "_source": {
    "includes": ["name","desc","company.*"],
    "excludes": ["desc"]
  }
}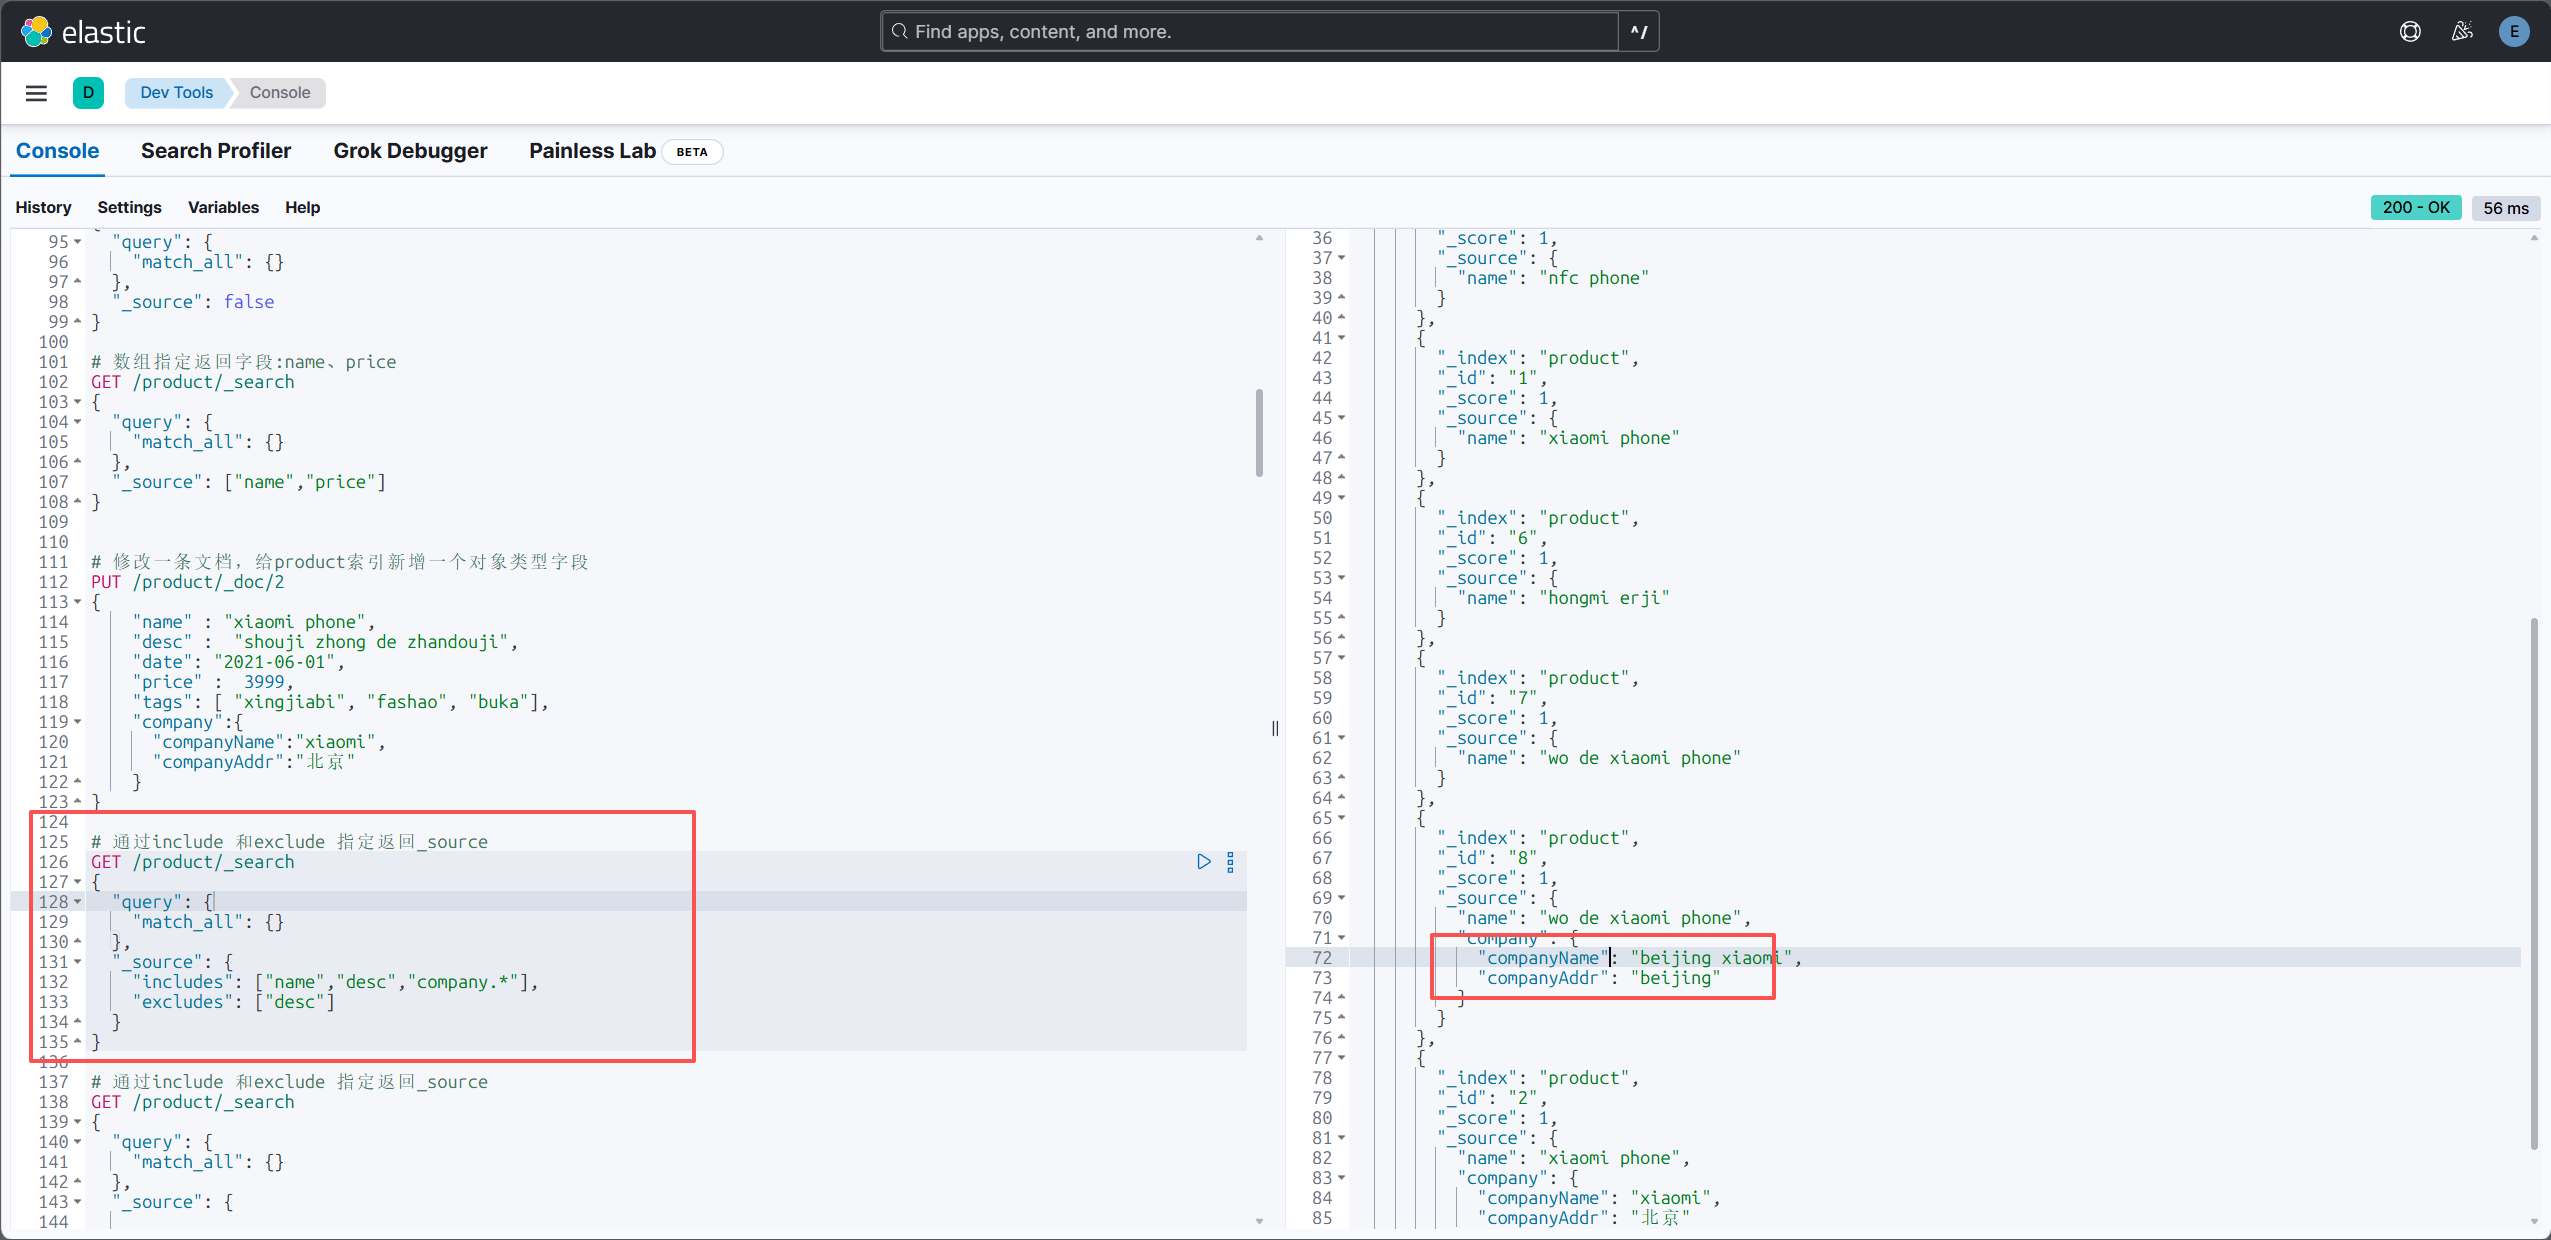
includes:包含的字段(白名单)excludes:从白名单里再剔除字段(黑名单)
支持嵌套对象写法:user.address.city,通配符obj.*
2、URL 查询参数
用法同写在请求体中一样
_source_includes=name,price_source_excludes=desc,date
java
# 查询prouct索引的所有文档记录,_source中只返回包含d开头的字段,排除desc
GET /product/_search?_source_includes=d*&_source_excludes=desc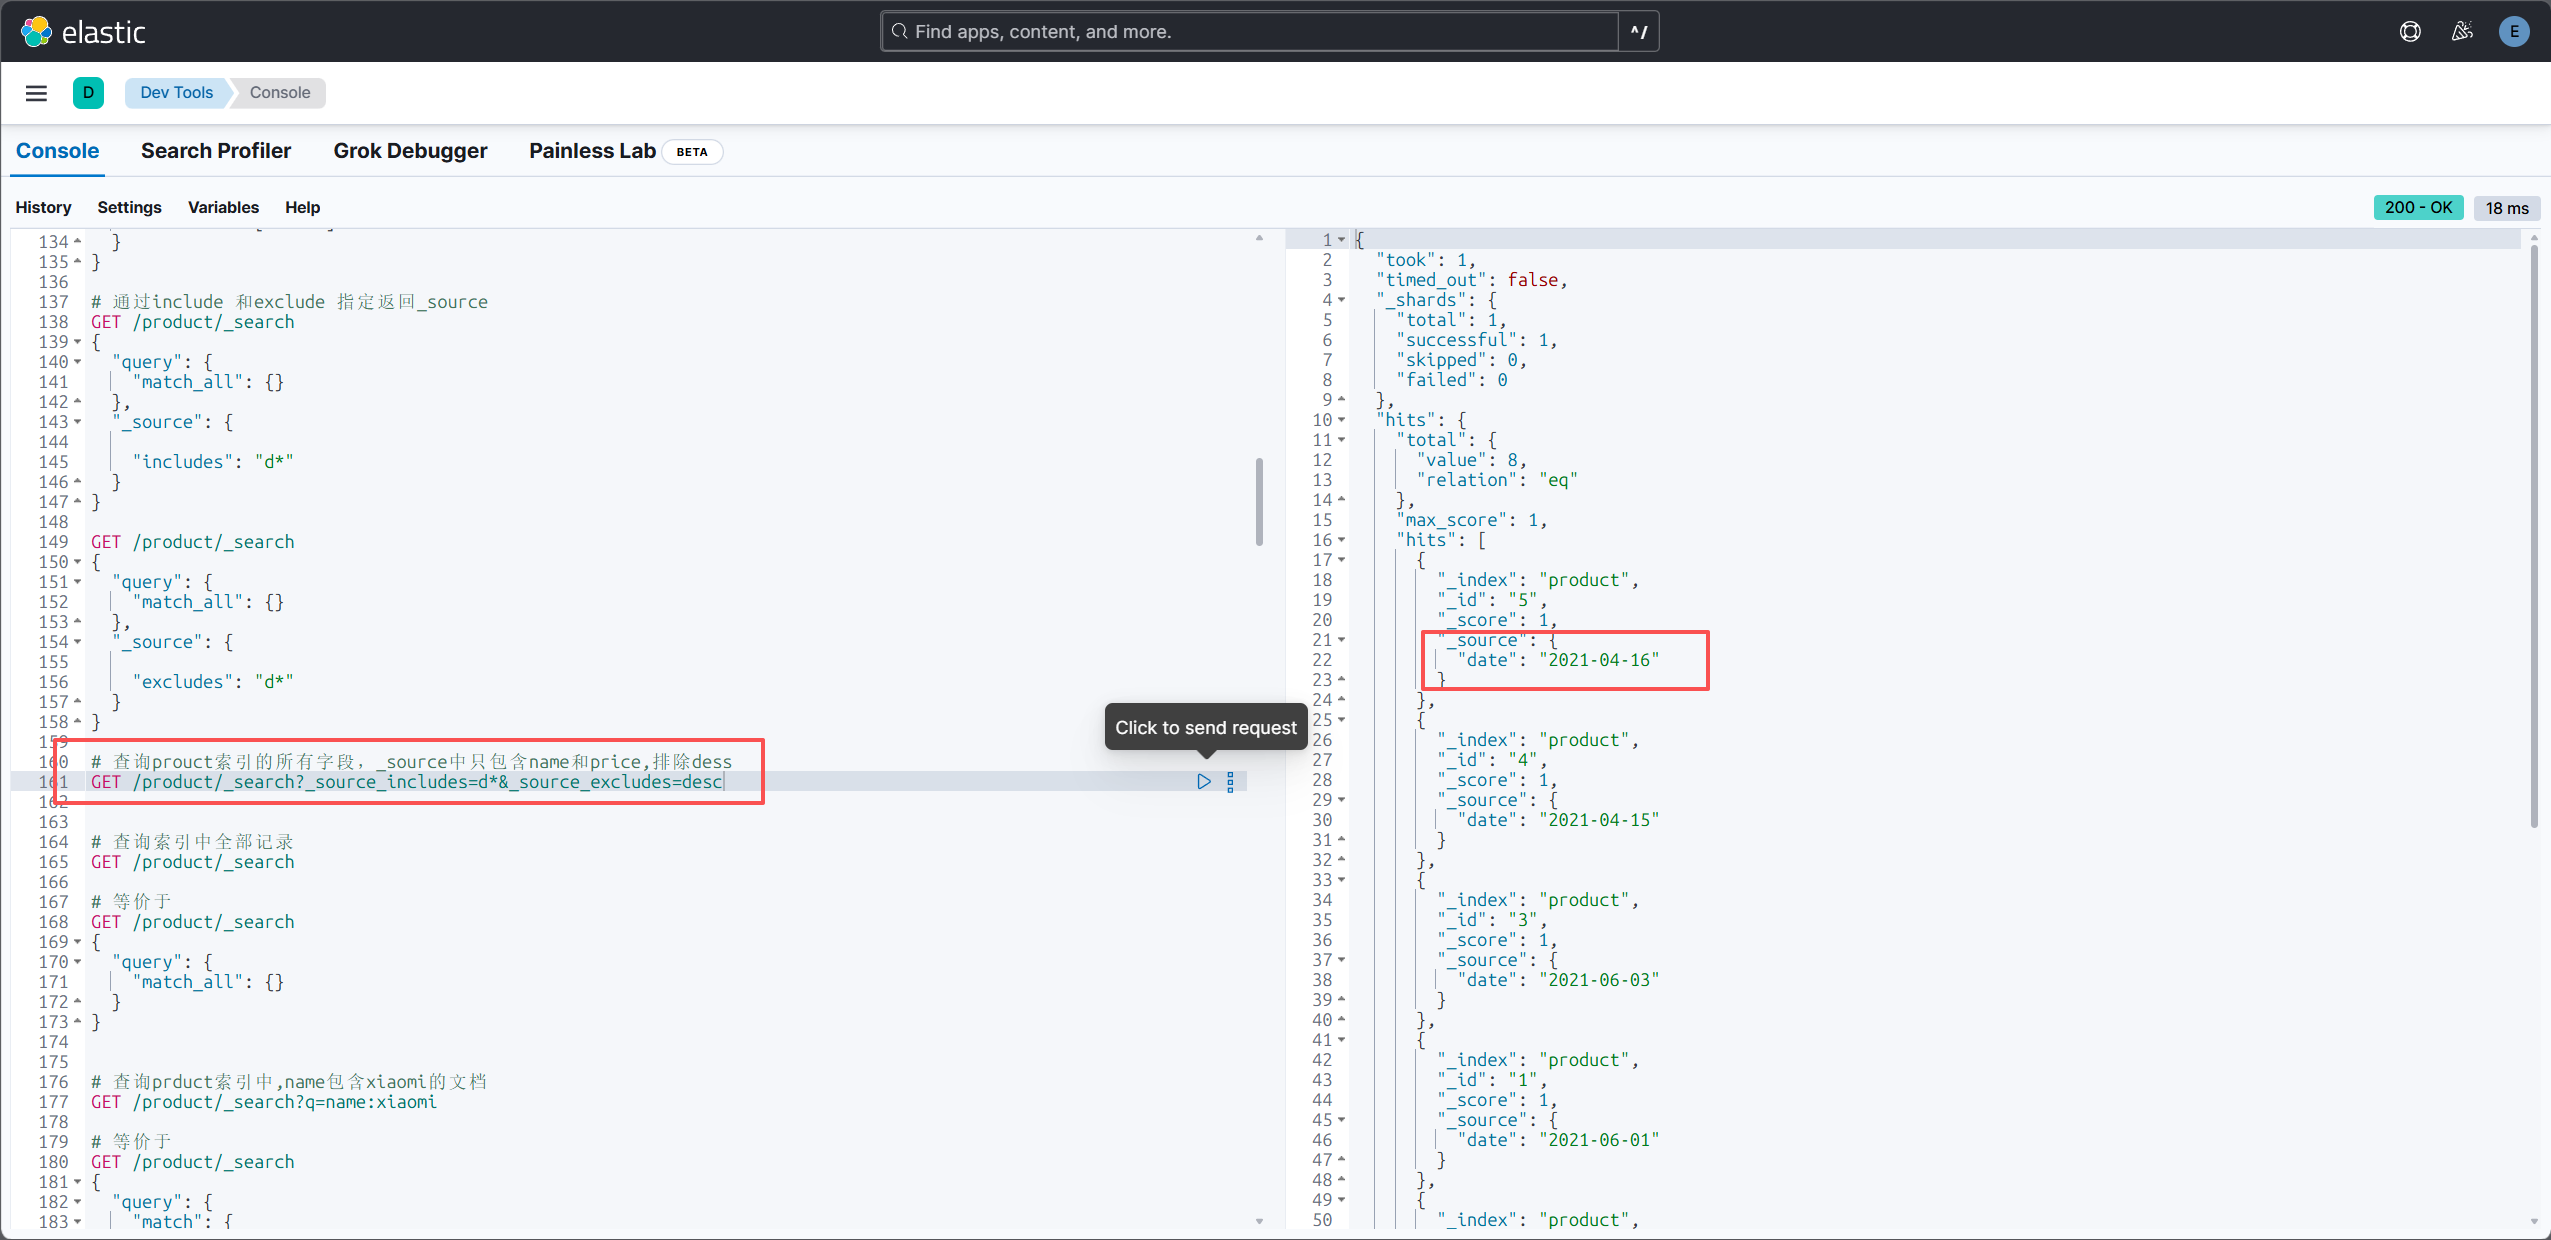
3、Mapping 层面永久过滤
在索引 mapping 中定义_source.includes / _source.excludes,索引存储时就移除字段,无法恢复,一般不推荐业务使用
java
PUT product
{
  "mappings": {
    "_source": {
      "includes": ["name"],
      "excludes": ["desc"]
    }
  }
}
GET查询
通过get index/_search可以直接查询数据
java
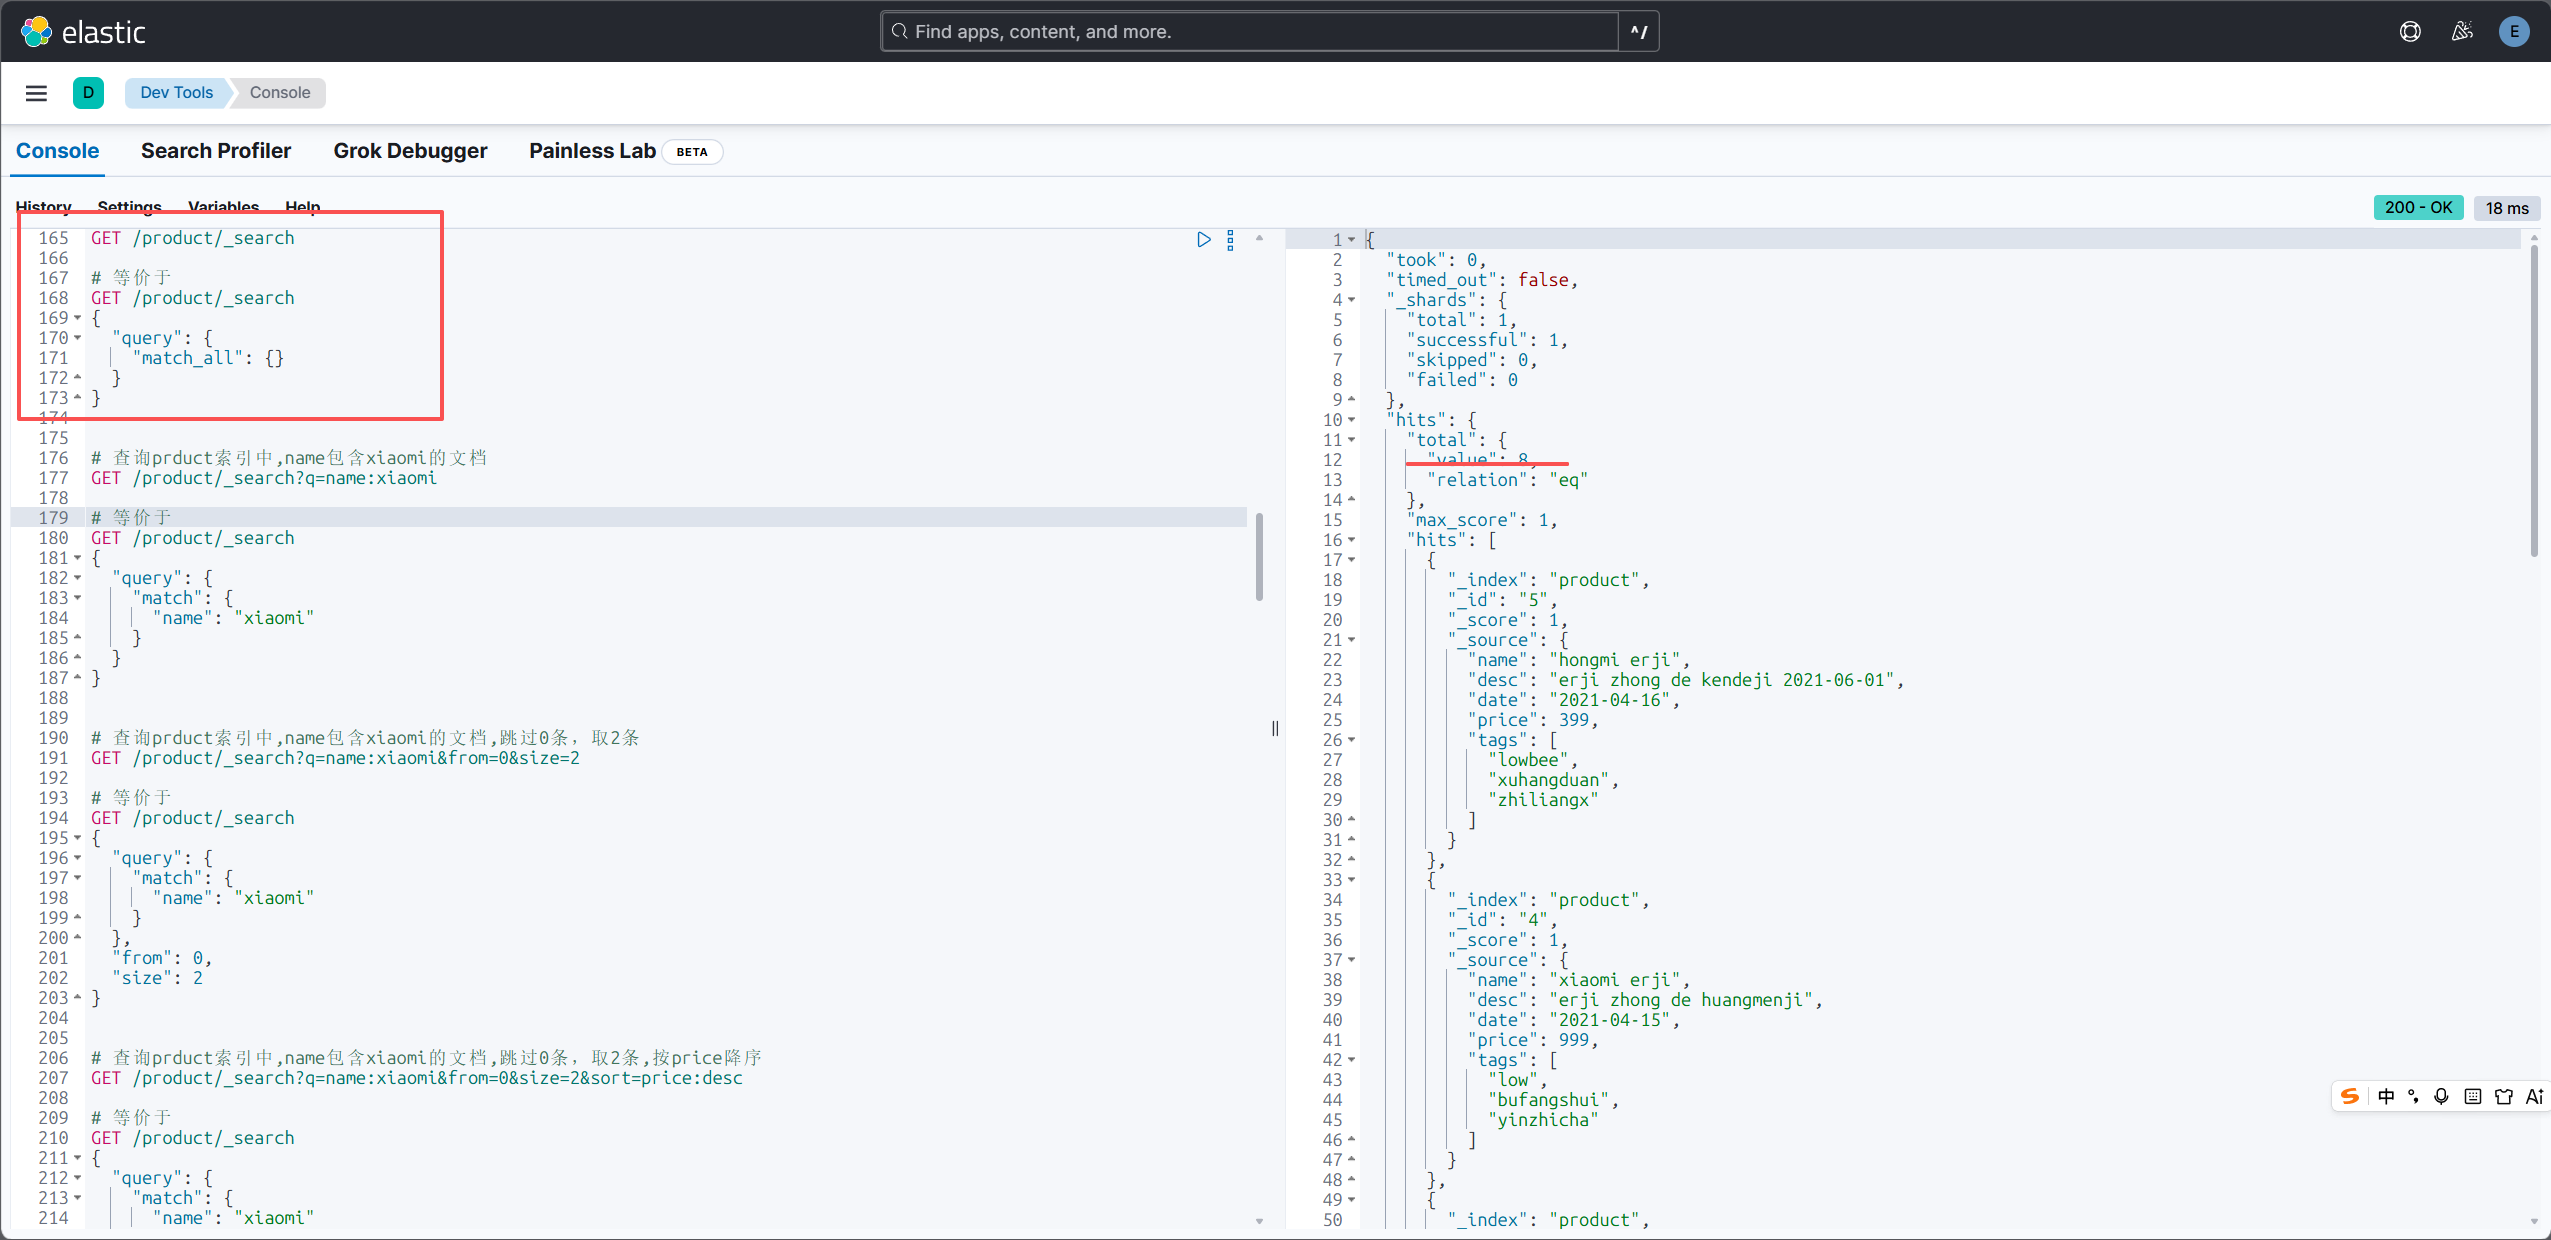
# 查询索引中全部记录
GET /product/_search

# 等价于
GET /product/_search
{
  "query": {
    "match_all": {}
  }
}
带查询条件
java
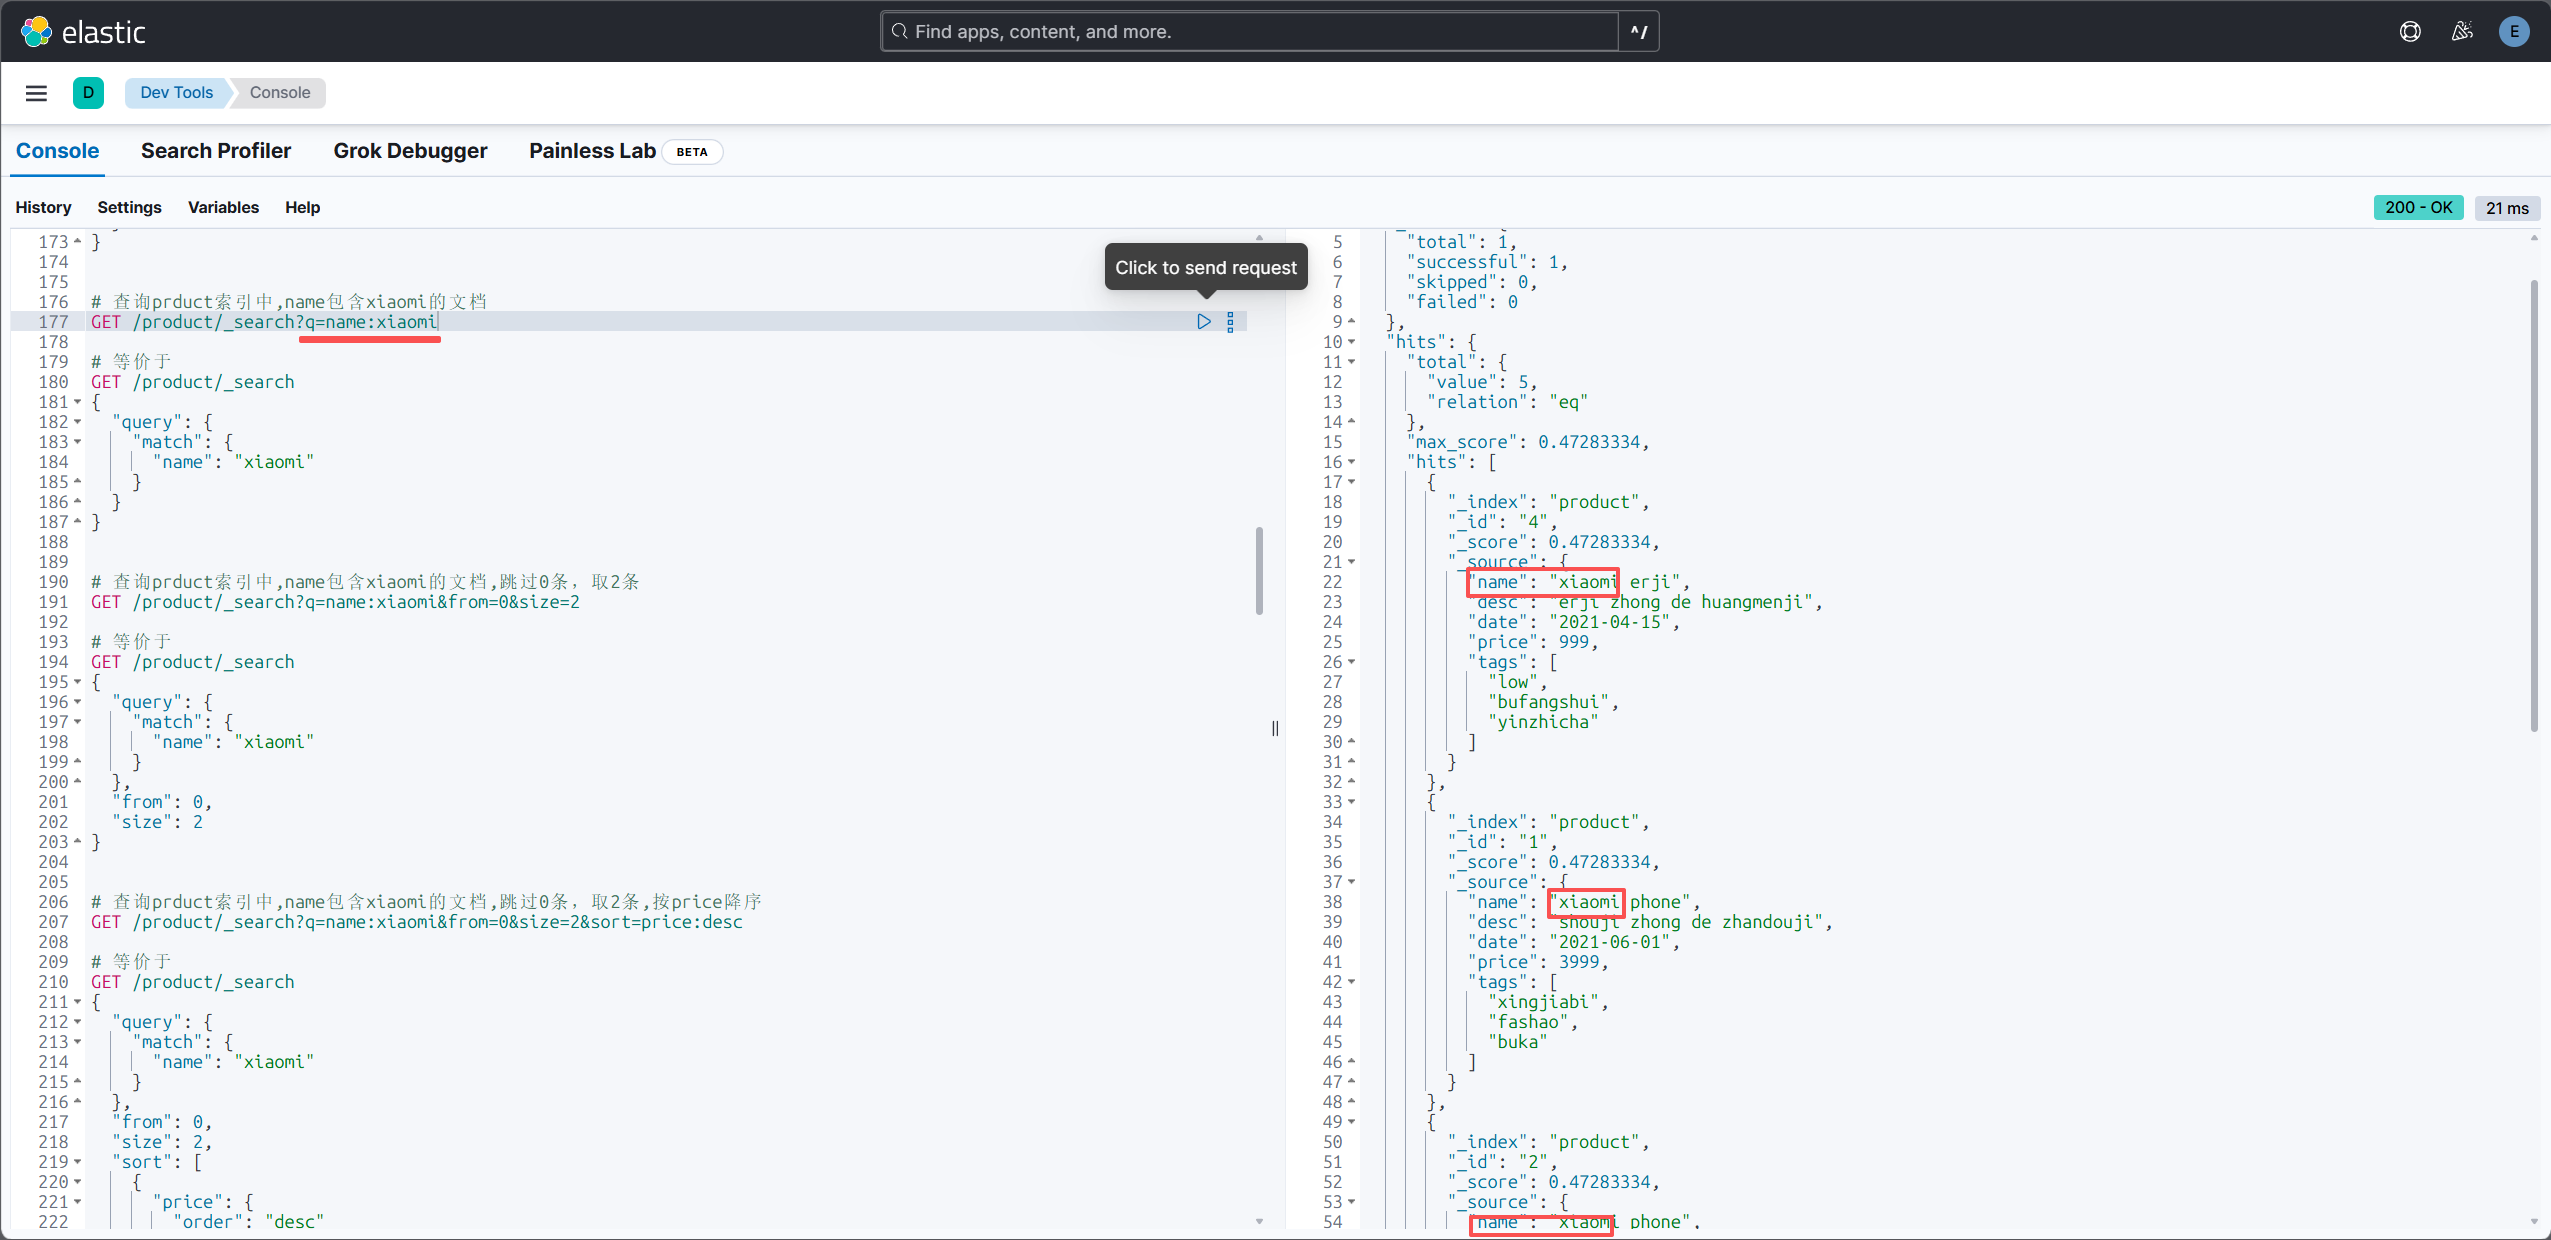
# 查询prduct索引中,name包含xiaomi的文档
GET /product/_search?q=name:xiaomi

# 等价于
GET /product/_search
{
  "query": {
    "match": {
      "name": "xiaomi"
    }
  }
}
带分页
java
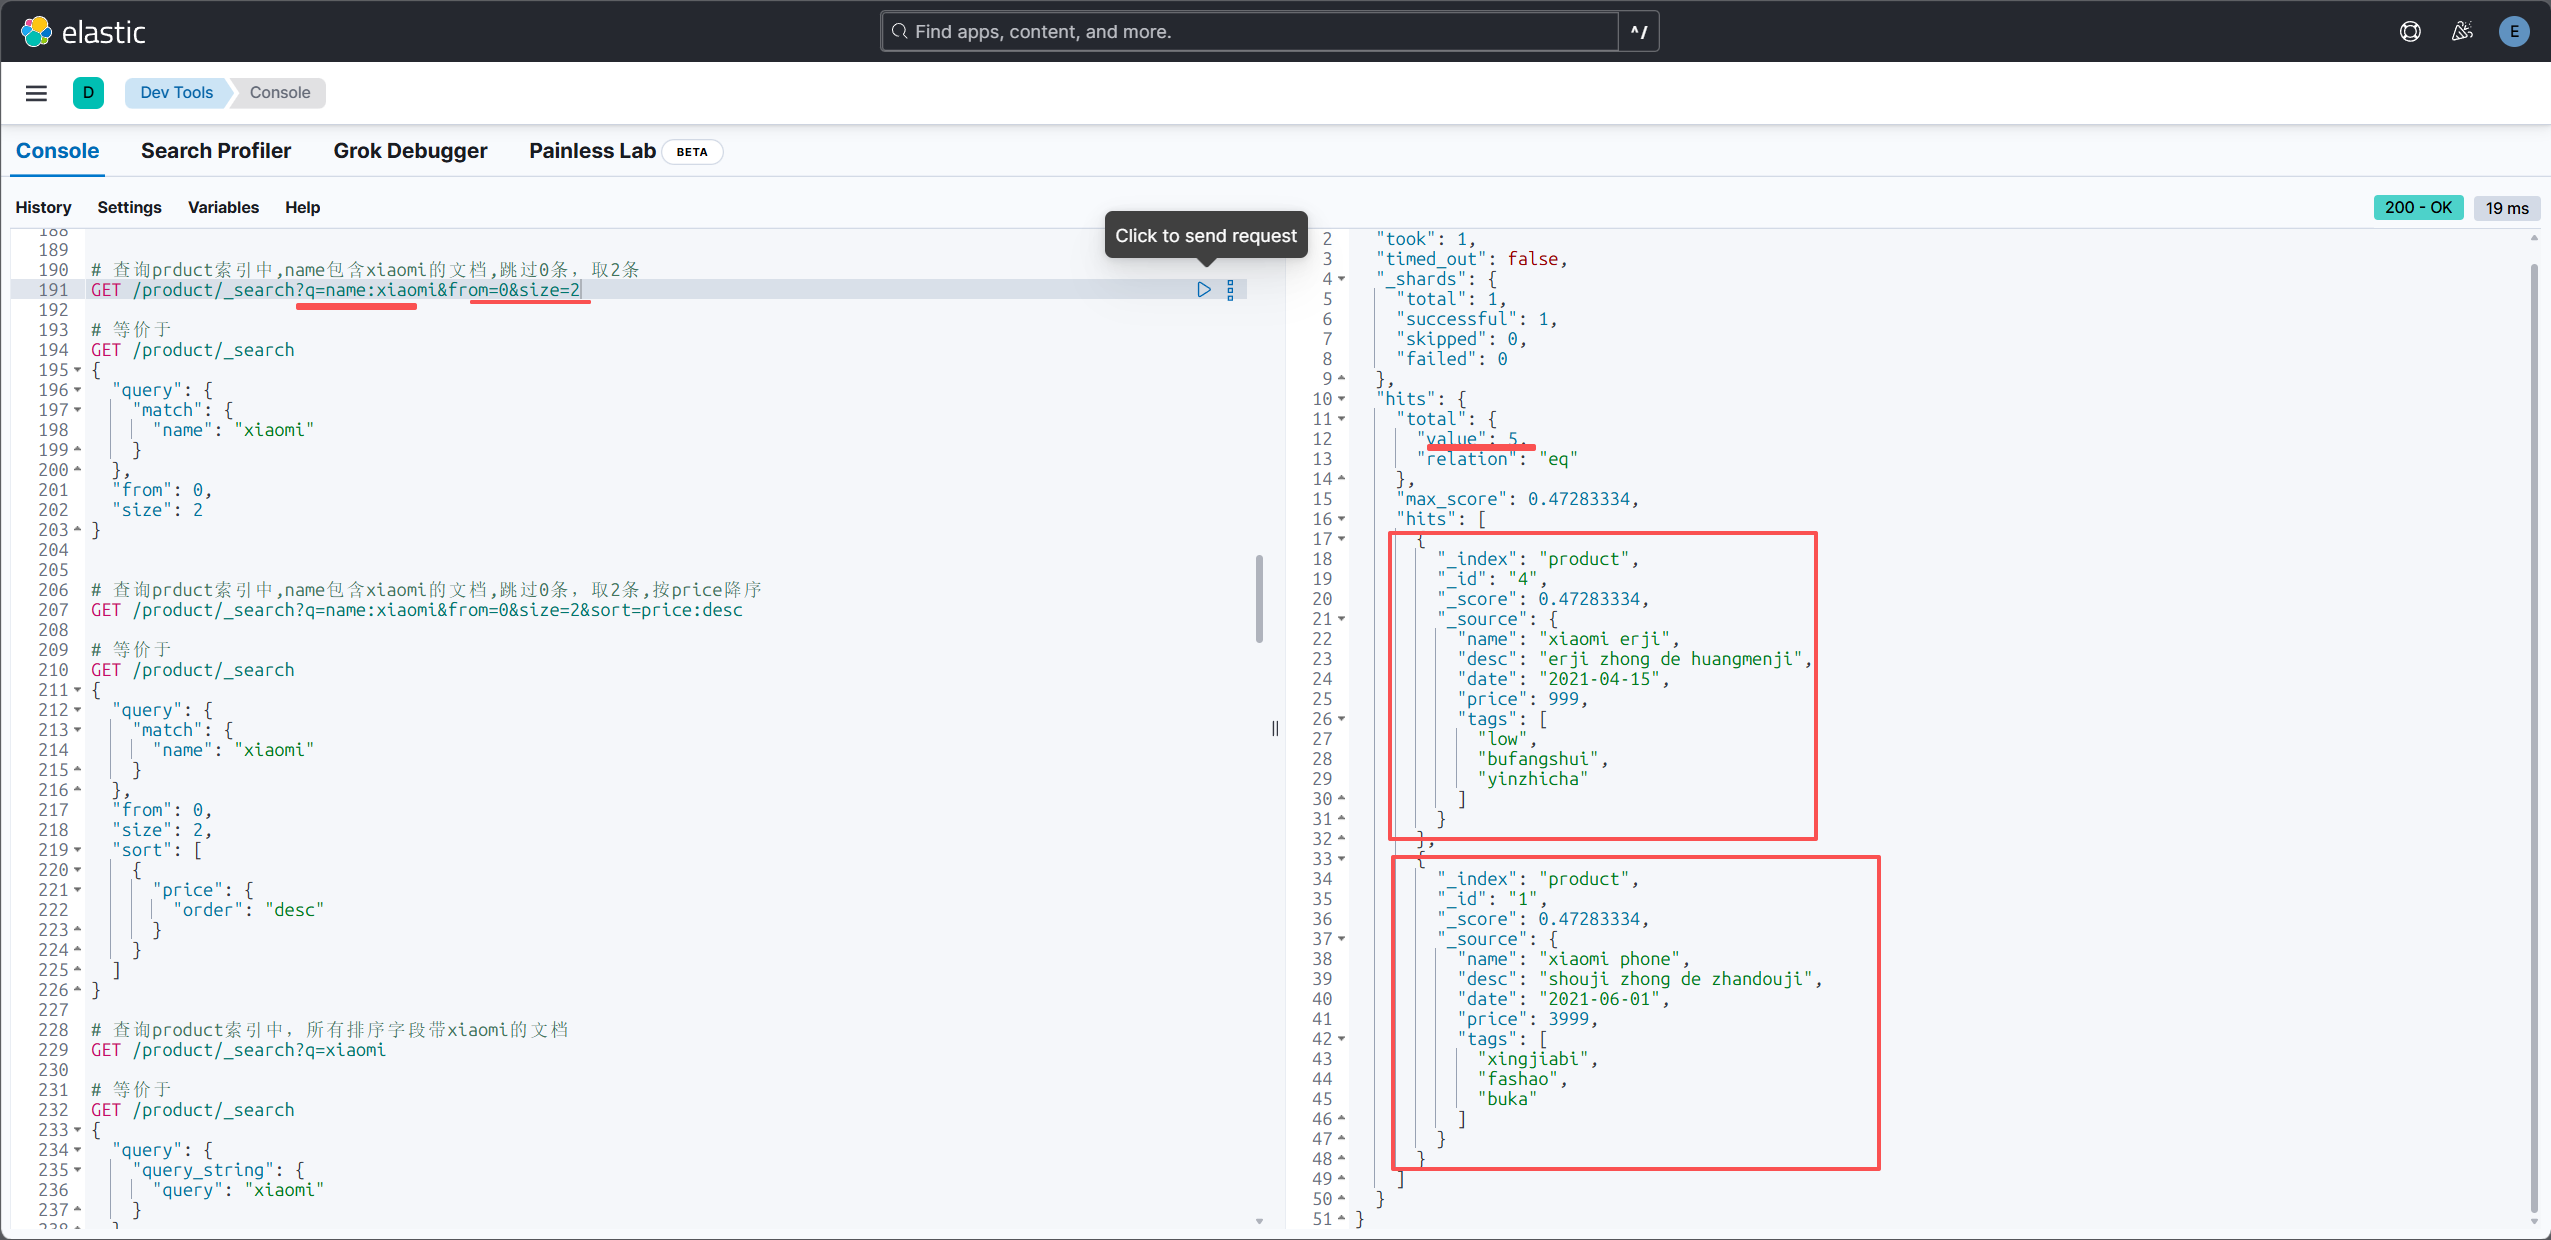
# 查询prduct索引中,name包含xiaomi的文档,跳过0条,取2条
GET /product/_search?q=name:xiaomi&from=0&size=2

# 等价于
GET /product/_search
{
  "query": {
    "match": {
      "name": "xiaomi"
    }
  },
  "from": 0,
  "size": 2
}
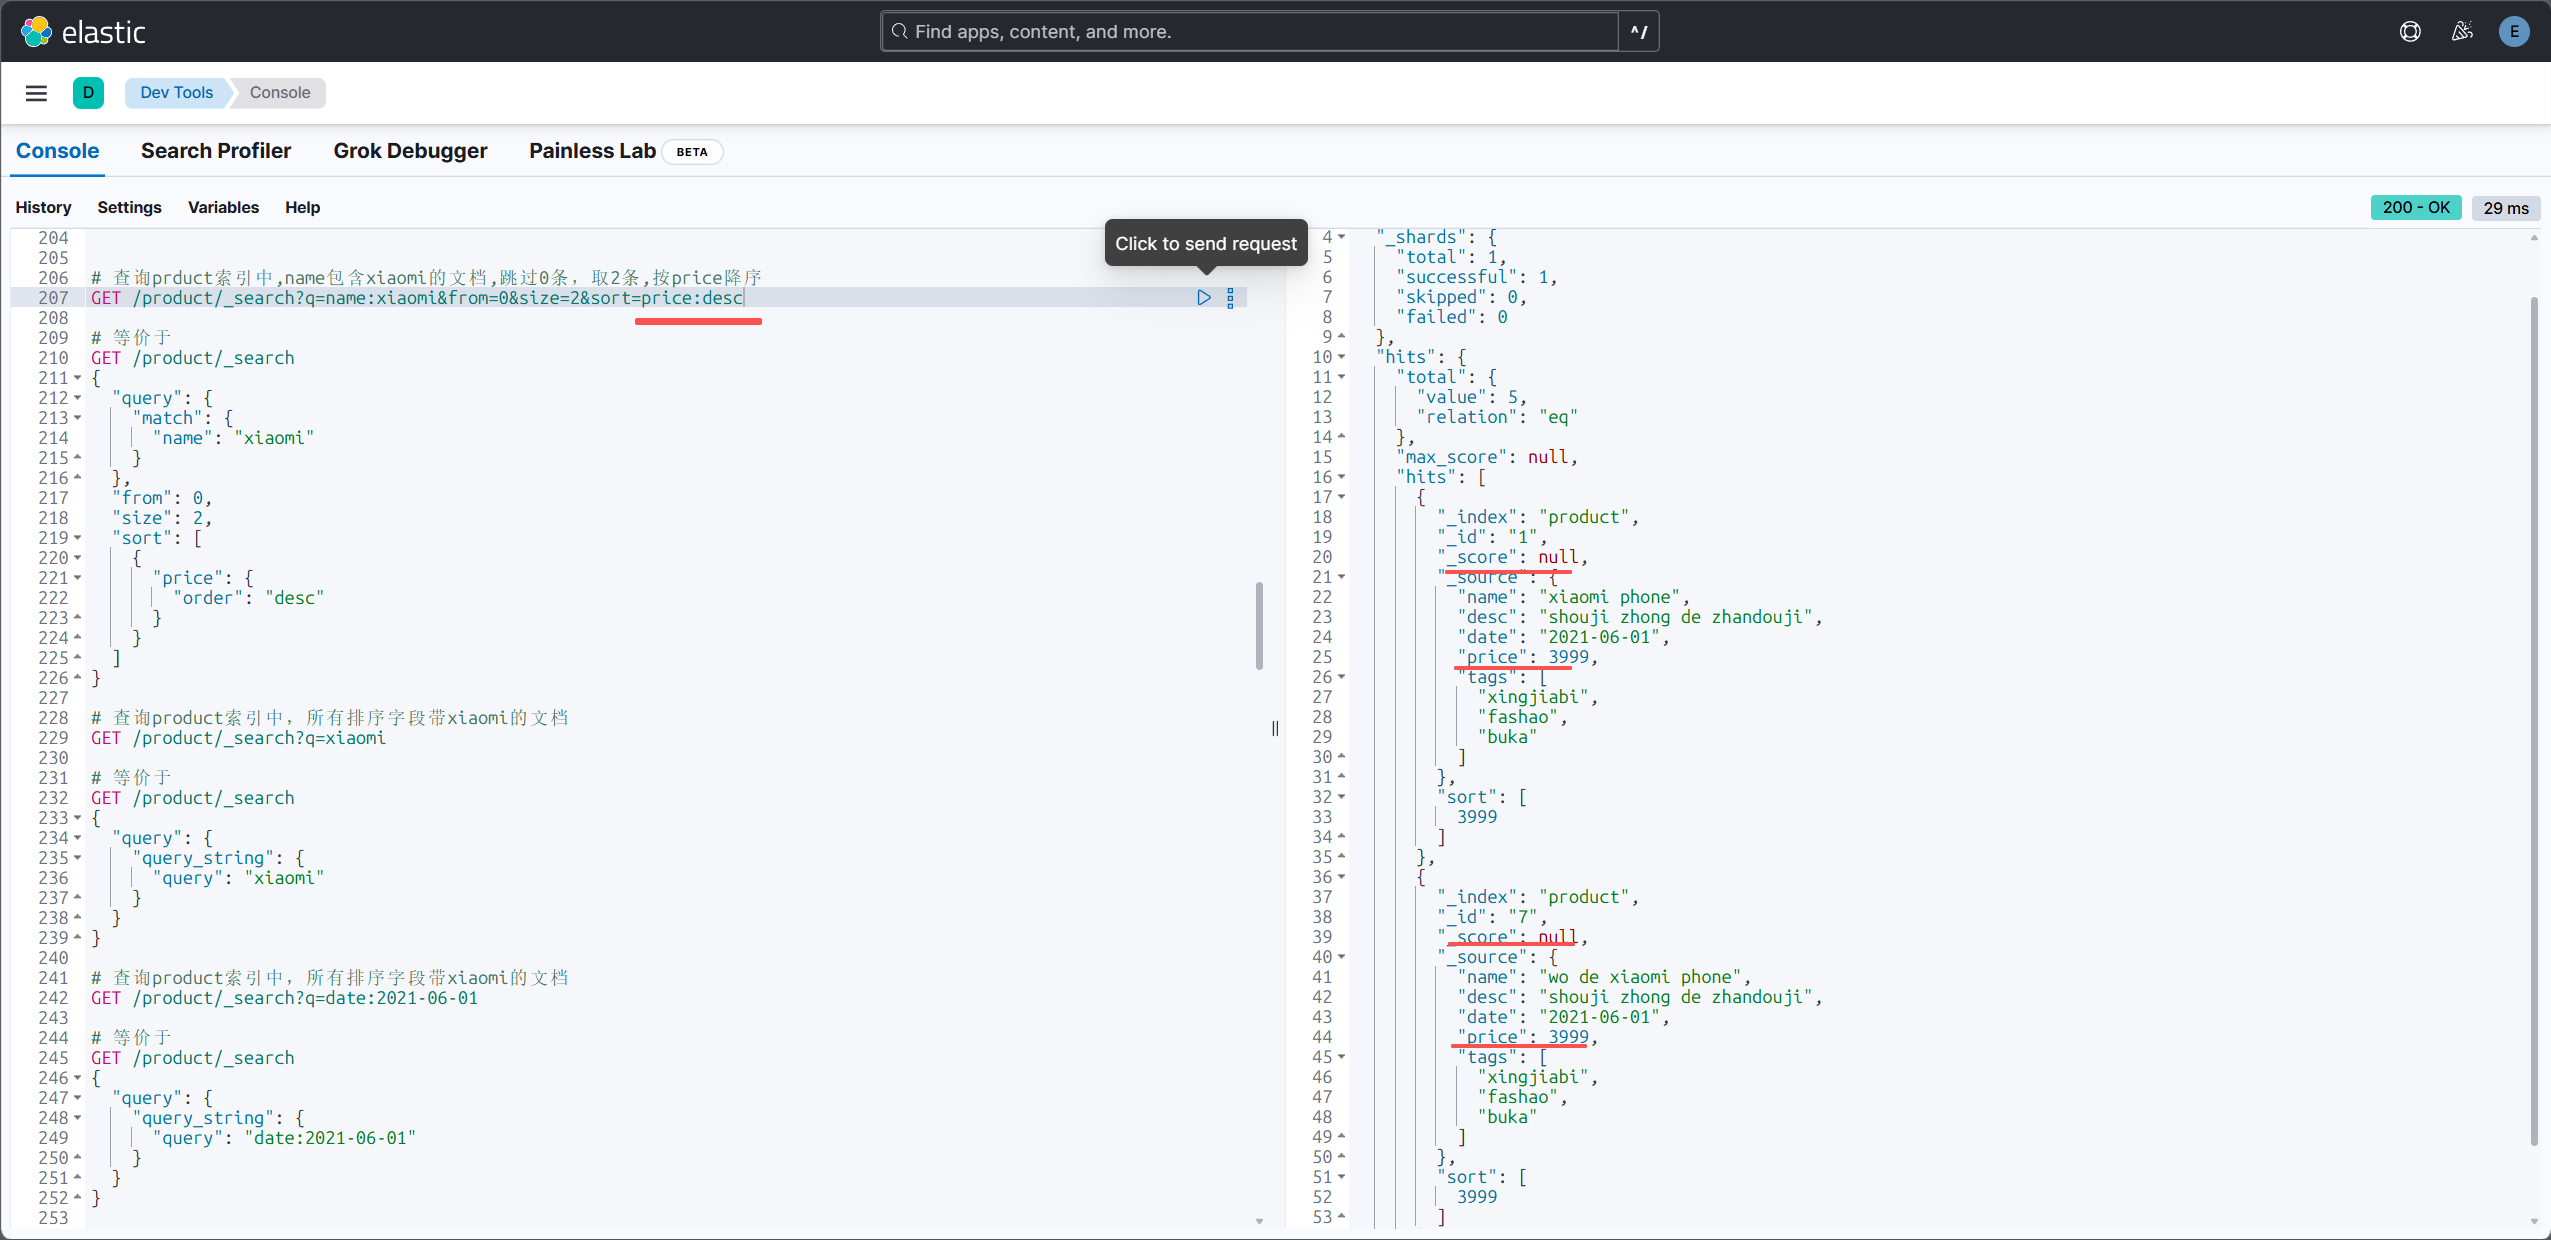
带排序
java
# 查询prduct索引中,name包含xiaomi的文档,跳过0条,取2条,按price降序
GET /product/_search?q=name:xiaomi&from=0&size=2&sort=price:desc

# 等价于
GET /product/_search
{
  "query": {
    "match": {
      "name": "xiaomi"
    }
  },
  "from": 0,
  "size": 2,
  "sort": [
    {
      "price": {
        "order": "desc"
      }
    }
  ]
}
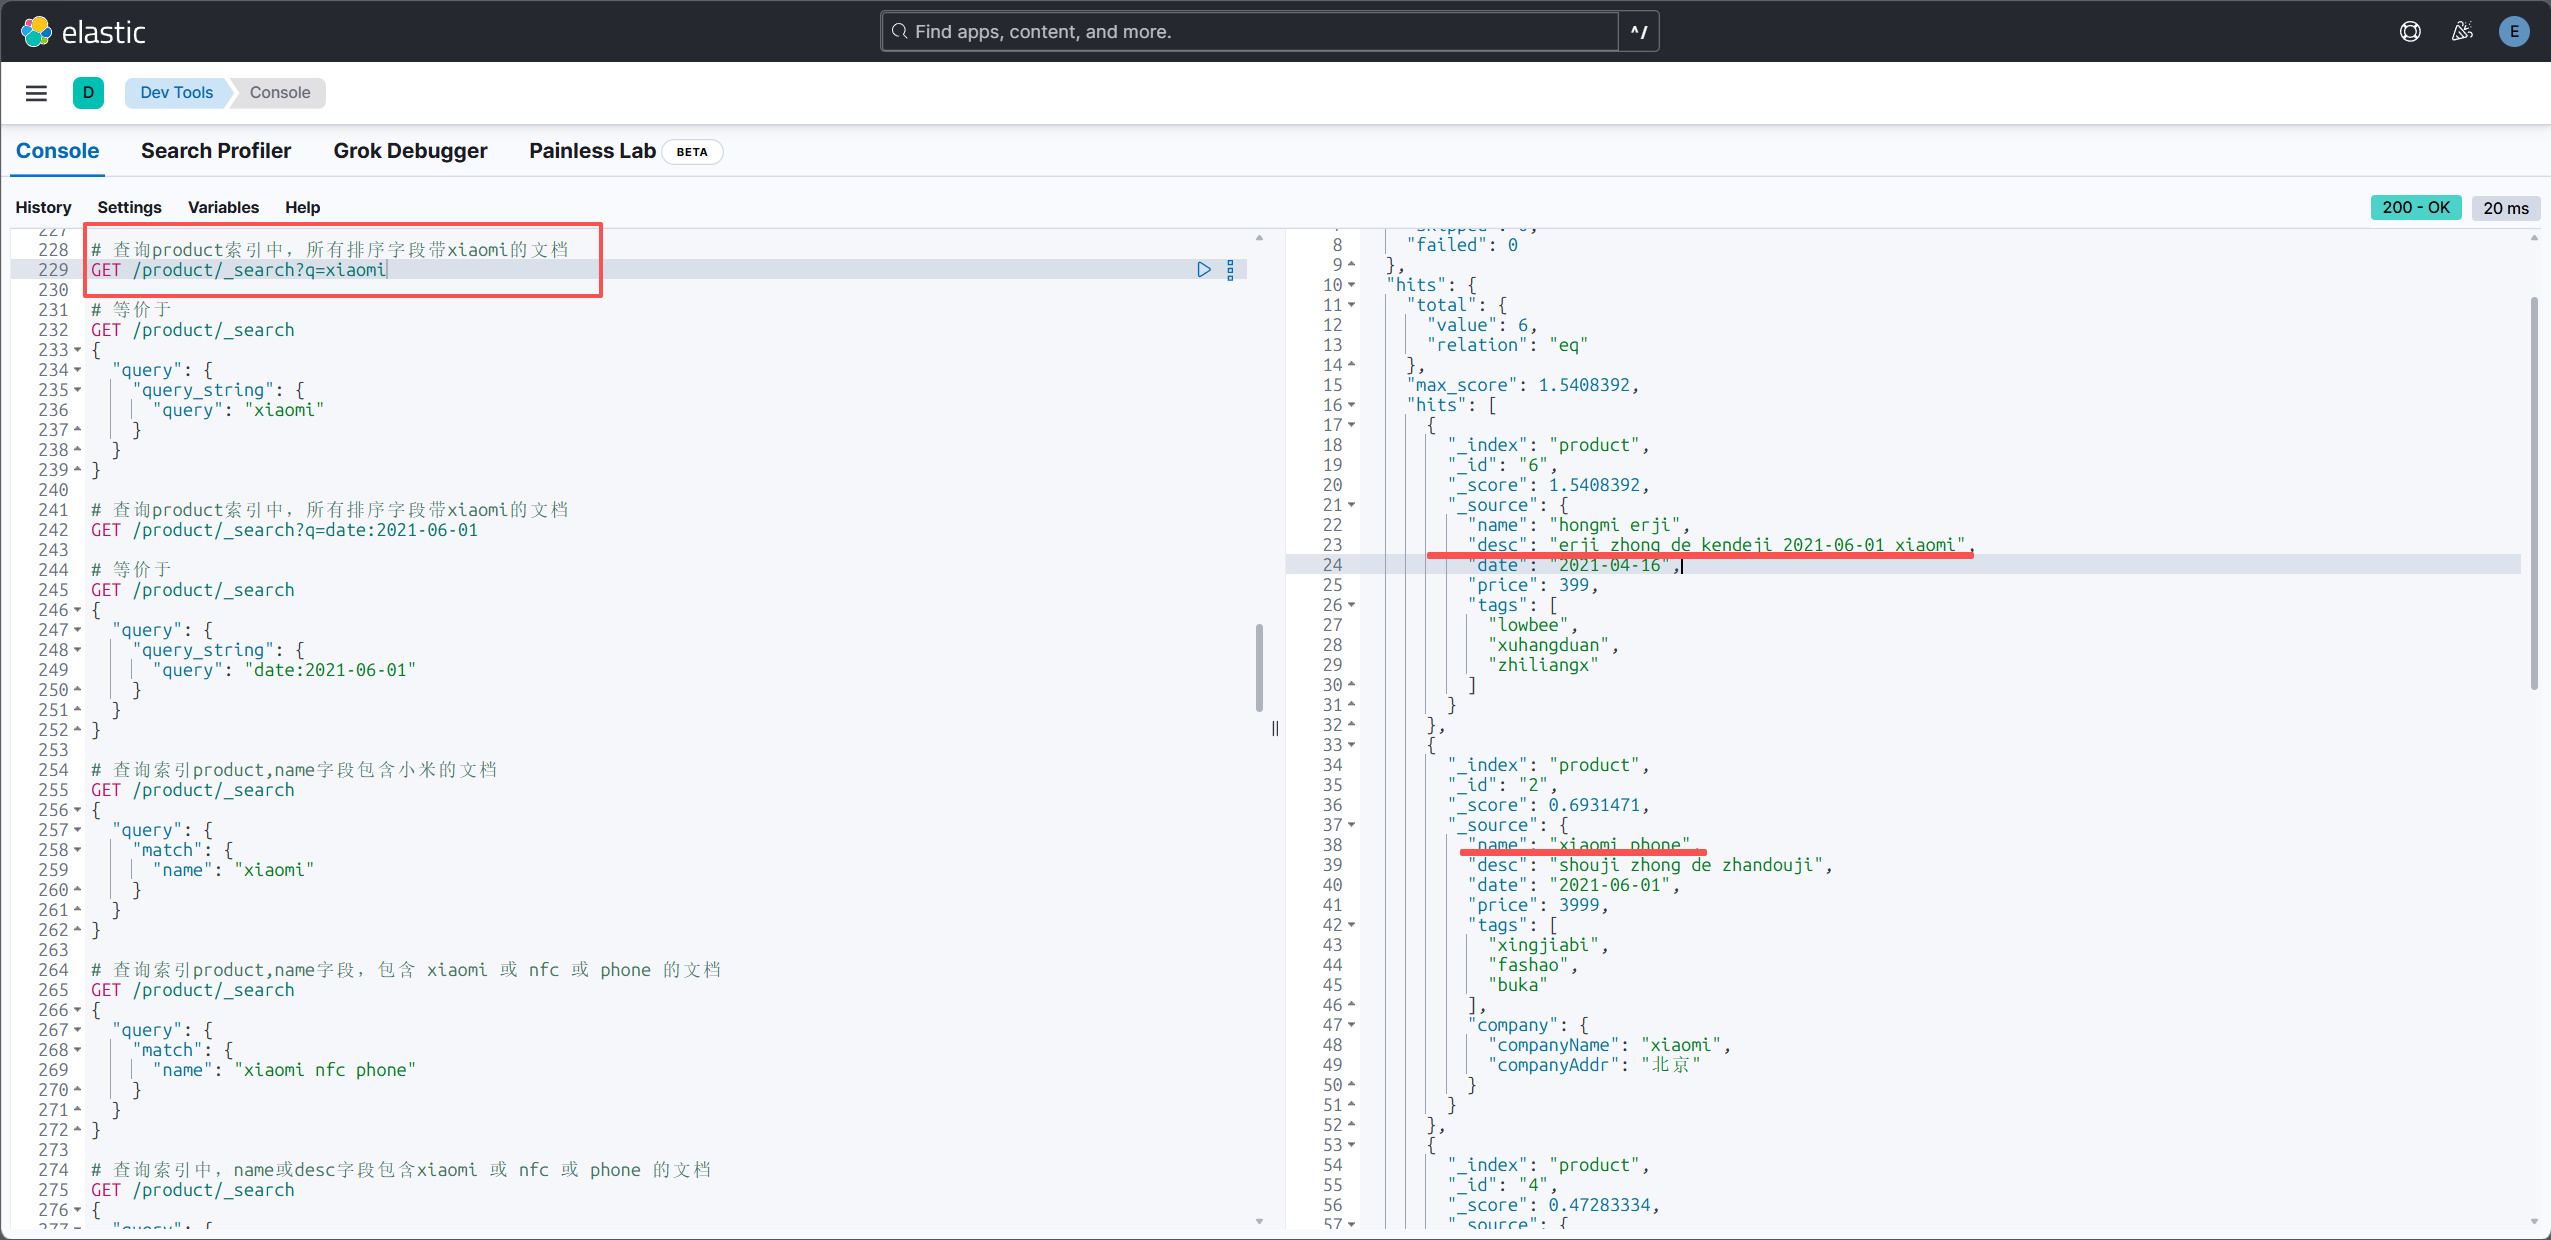
在所有支持索引查询的字段查询
java
# 查询product索引中,所有排序字段带xiaomi的文档
GET /product/_search?q=xiaomi

# 等价于
GET /product/_search
{
  "query": {
    "query_string": {
      "query": "xiaomi"
    }
  }
}
日期字段查询,日期字段不会分词。
java
# 查询product索引中,所有排序字段带xiaomi的文档
GET /product/_search?q=date:2021-06-01

# 等价于
GET /product/_search
{
  "query": {
    "query_string": {
      "query": "date:2021-06-01"
    }
  }
}
match查询
match 查询会对查询条件分词,只要索引字段有能匹配的字段就能查到
java
# 查询索引product,name字段包含小米的文档
GET /product/_search
{
  "query": {
    "match": {
      "name": "xiaomi"
    }
  }
}

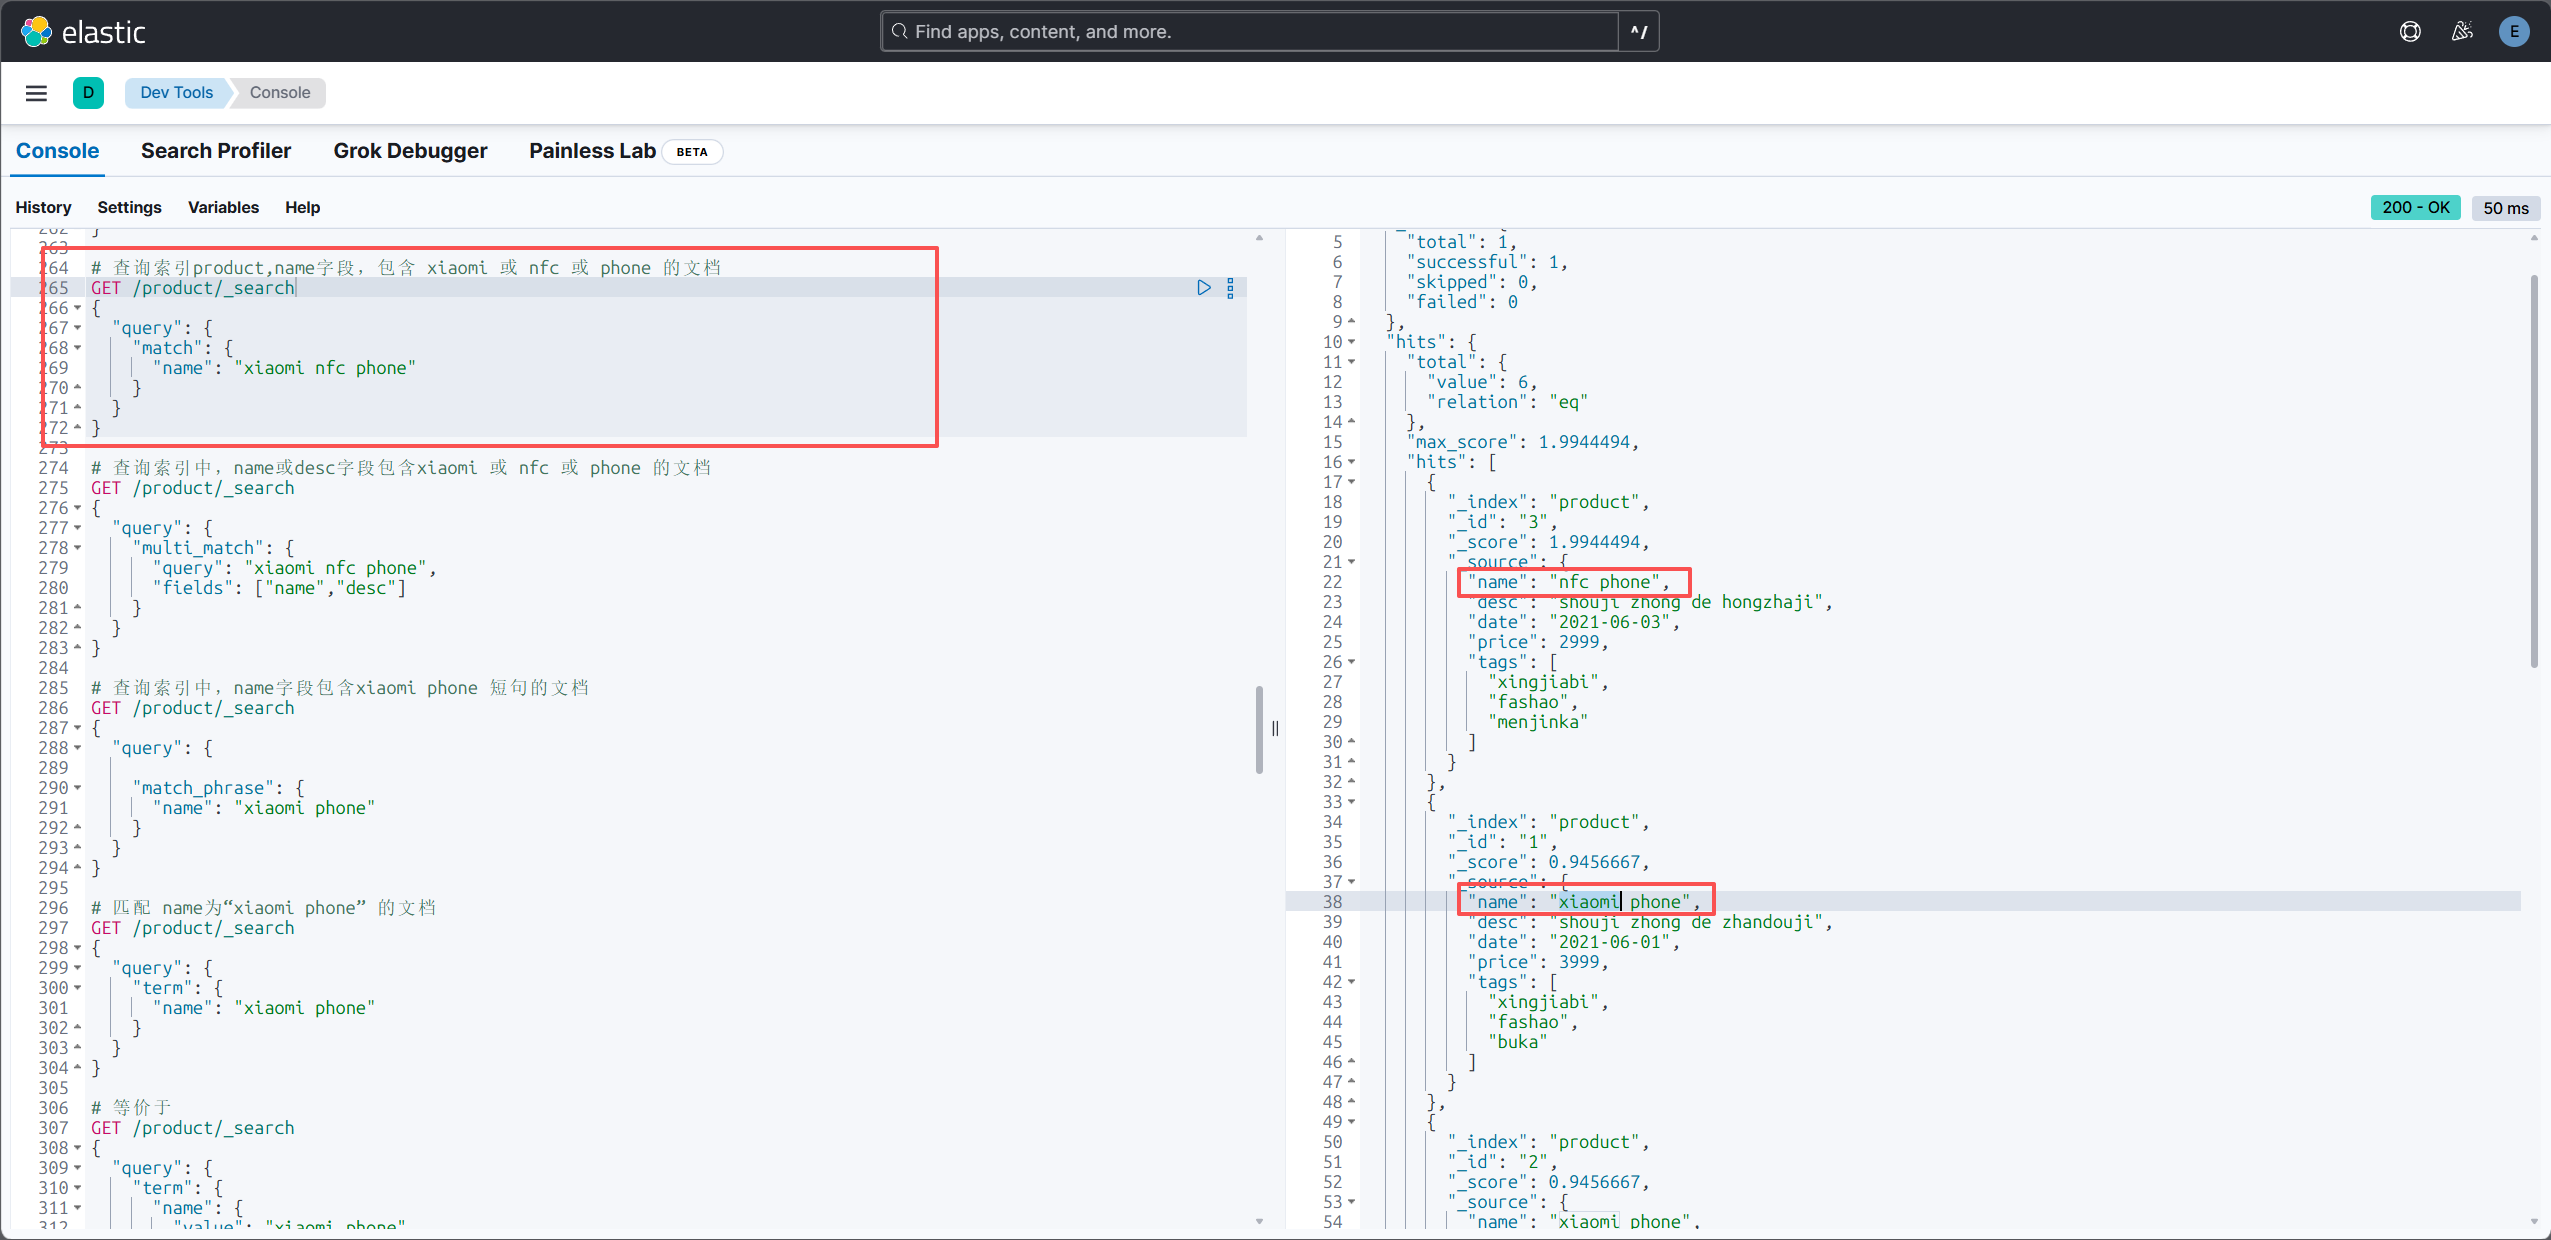
# 查询索引product,name字段,包含 xiaomi 或 nfc 或 phone 的文档
GET /product/_search
{
  "query": {
    "match": {
      "name": "xiaomi nfc phone"
    }
  }
}
查询条件"xiaomi nfc phone"也会被分词,只要有一个词匹配就算匹配成功。默认按评分字段'_score'排序,匹配的越多,排序越靠前。
match_all查询
match_all 匹配全部文档 。它本身不支持写字段条件 ,它只有两个可选参数:boost、_name。
java
{
  "match_all": {
    "boost": 1.2,   // 给这个查询的分数加权,默认1.0
    "_name": "all"  // 查询命名,用于profile/命中标记,调试用
  }
}
multi_match查询
在多个字段中全文搜索,查询条件会分词,只要有一个条件匹配就返回
java
# 查询索引中,name或desc字段包含xiaomi 或 nfc 或 phone 的文档
GET /product/_search
{
  "query": {
    "multi_match": {
      "query": "xiaomi nfc phone",
      "fields": ["name","desc"]
    }
  }
}
match_phrase 查询
match_phrase 会对检索文本分词,要求分词后的词在文档中连续、并且顺序一致,还可以控制词之间允许的间隔 slop。
java
# 查询索引中,name字段包含xiaomi phone短句的文档,xiaomi和phone都存在且连续、顺序一致。
GET /product/_search
{
  "query": {

    "match_phrase": {
      "name": "xiaomi phone"
    }
  }
}
trem-精确匹配
于match查询不同,trem查询不会对要查询的字段进行分词,要求文档中对应字段完全包含才会匹配。
java
# 匹配 name为"xiaomi phone" 的文档
GET /product/_search
{
  "query": {
    "term": {
      "name": "xiaomi phone"
    }
  }
}

# 等价于
GET /product/_search
{
  "query": {
    "term": {
      "name": {
        "value": "xiaomi phone"
      }
    }
  }
}
注意:text类型的name为"xiaomi phone"的数据不能被term匹配,因为存储时会被分词,不能用于精确匹配。
match_phrase和term的区别
match_phrase会对搜索条件分词,只要分词后的词条在目标文档的倒排索引中都存在、连续且顺序一致就能被检索。
term不会对查询条件分词,需要目标文档字段字段的倒排索引存在完整的文本才能被检索。
terms查询
terms相当于同时精确匹配多个查询条件,相当于in。
java
# 查询tags字段包含lowbee或zhong的文档
GET /product/_search
{
  "query": {
    "terms": {
      "tags": [
        "lowbee",
        "zhong"
      ]
    }
  }
}
range查询
range用户范围查询,用于数值、日期、ip类型的查询,text/keyword 一般不用于 range。
java
# 查询price大于等于2999并且小于等于4999的文档
GET /product/_search
{
  "query": {
    "range": {
      "price": {
        "gte": 2999,
        "lte": 4999
      }
    }
  }
}

# 查询日期 大于2021-06-01且小于2021-06-03的文档
GET /product/_search
{
  "query": {
    "range": {
      "date": {
        "gt": "2021-06-01",
        "lt": "2021-06-03"
      }
    }
  }
}
es中提供了对日期的计算方法:
锚点日期 + || + 运算,锚点可以是 now 或者写死日期字符串Elastic
支持:+(加)、-(减)、/(向下舍入 / 取整),单位支持:y 年、M 月、w 周、d 天、h 小时、m 分钟、s 秒
java
"gte": "now-1d",       // 当前时间 -1天
"gte": "2021-06-01||+1M"    // 2021-06-01 加1个月
"gte": "2021-06-01||/d"     // 舍入到当天零点(向下取整天)
"gte": "now||/M"            // 舍入到当月第一天零点
bool查询
bool 是复合查询(Compound Query) ,本身不直接匹配文档,作用是组合多个子查询 ,通过 4 个子句来控制多个条件之间的逻辑关系(AND / OR / NOT)。
核心:把多个小查询(term/range/match 等)拼装在一起,并且区分查询上下文(算分) 和过滤上下文(不算分)。
| 子句 | 逻辑含义 | 上下文 | 是否算_score |
|---|---|---|---|
must |
必须满足(AND) | 查询上下文 | ✅ 参与打分 |
should |
可以满足(OR) | 查询上下文 | ✅ 满足就加分 |
filter |
必须满足(AND) | 过滤上下文 | ❌ 不打分,可缓存 |
must_not |
必须不满足(NOT) | 过滤上下文 | ❌ 不打分,可缓存 |
must:条件一定要成立,并且这个条件会参与相关性打分。filter:条件一定要成立 ,但是不参与打分 ,ES 会尝试缓存,性能更好;纯筛选条件优先放 filter。must_not:条件一定不能成立,过滤上下文,不打分。should:可选条件,满足的文档分数更高。- 如果 bool 里没有 must /filter:should 至少满足 1 条才算命中;
- 如果 bool 里有 must /filter:should 只是加分项,不强制满足。
must + filter示例
name 必须匹配 xiaomi(全文检索打分),并且价格≥3000(过滤,不打分)
java
# name有xiaomi,价格大于3000
GET product/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "name": "xiaomi"
          }
        }
      ],
      "filter": [
        {
          "range": {
            "price": {
              "gte": 3000
            }
          }
        }
      ]
    }
  }
}
should
匹配 name 含 xiaomi 或者 tags 是 xingjiabi
java
# 名字包含xiaomi 或者tags包含xingjiabi
GET /product/_search
{
  "query": {
    "bool": {
      "should": [
        {
          "match": {
            "name": "xiaomi"
          }
        },
        {
          "term": {
            "tags": "xingjiabi"
          }
        }
      ],
      "minimum_should_match": 1
    }
  }
}minimum_should_match:should 最少需要满足几条。当 bool 没有 must/filter 时,默认值是 1。有must/filter时默认等于0,满足只做加分。
must_not 排除
只排除数据不参与评分
java
# 价格不能大于 5000
GET /product/_search
{
  "query": {
    "bool": {
      "must_not": [
        {
          "range": {
            "price": {
              "gte": 5000
            }
          }
        }
      ]
    }
  }
}
bool嵌套
java
# 从tags包含xingjiabi或价格小于等于4000的数据中筛选name包含xiaomi的文档
GET product/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "match": {
            "name": "xiaomi"
          }
        }
      ],
      "filter": [
        {
          "bool": {
            "should": [
              {
                "term": {
                  "tags": "xingjiabi"
                }
              },
              {
                "range": {
                  "price": {
                    "lte": 4000
                  }
                }
              }
            ]
          }
        }
      ]
    }
  }
}
filter过滤数据,包含一个子查询:tags包含xingjiabi或者价格小于等于4000,再匹配name中包含xiaomi