作者:来自 Elastic David Pilato
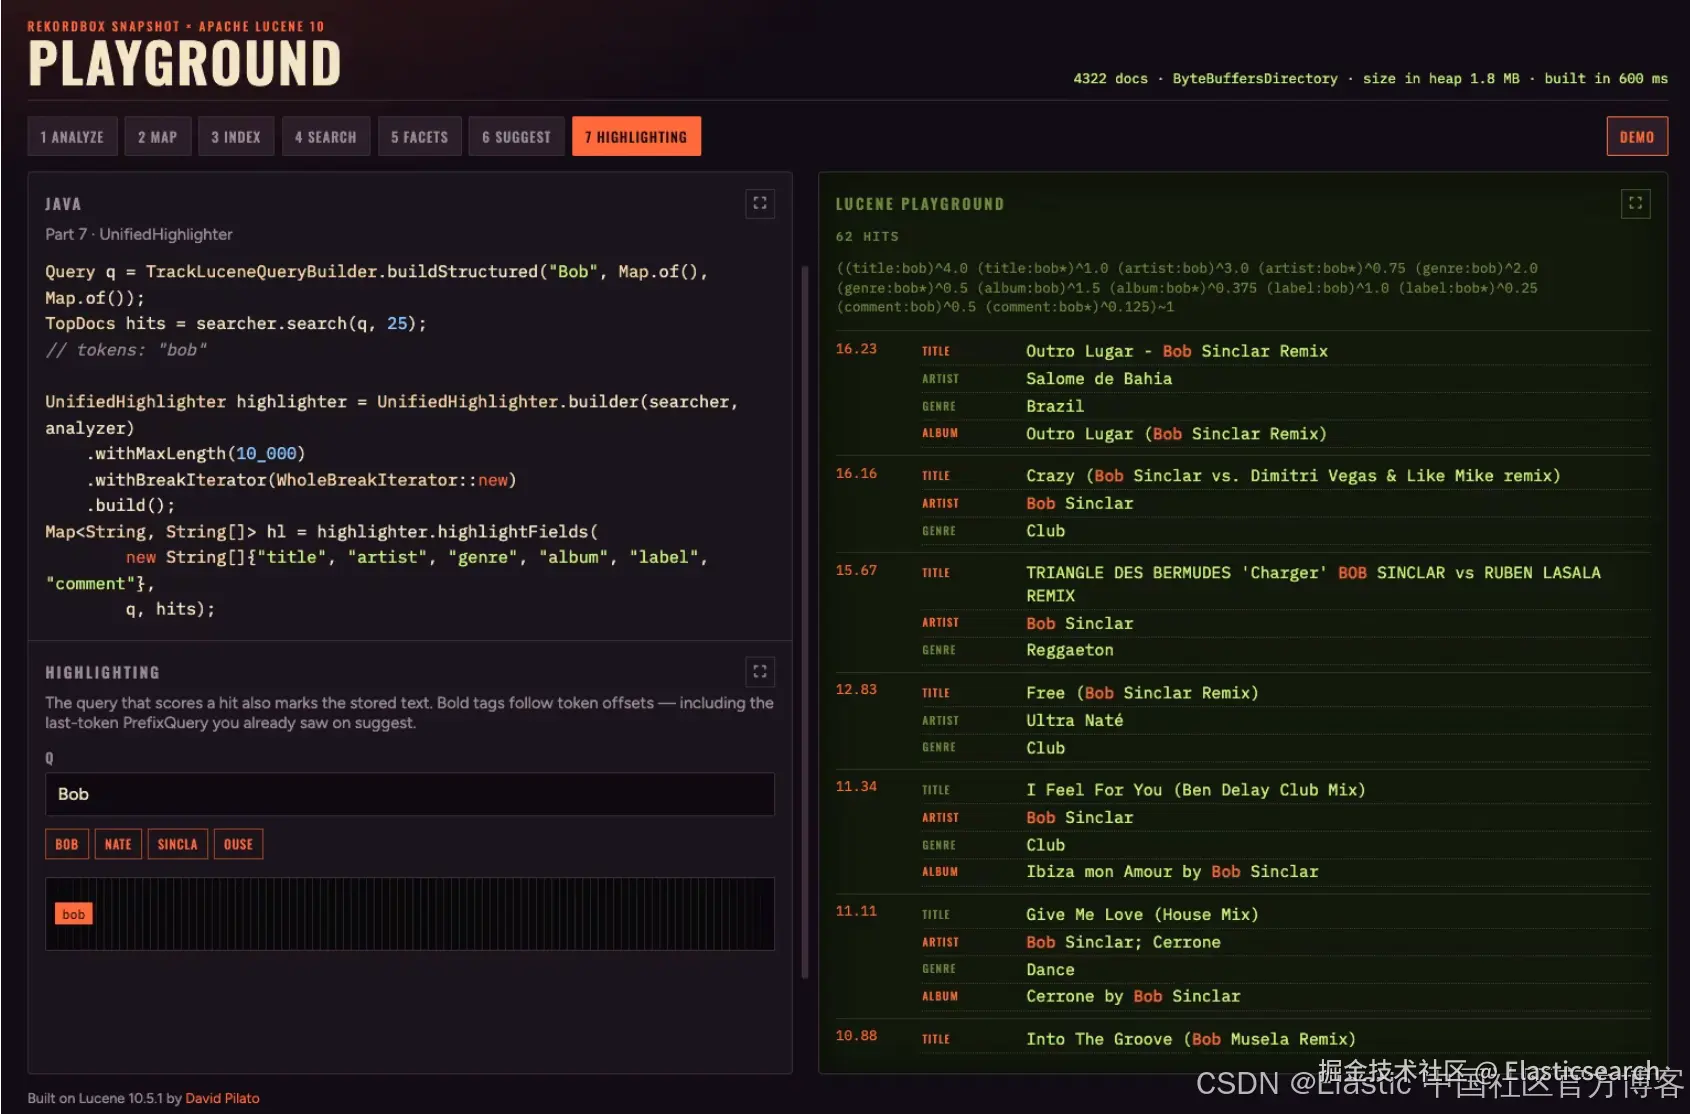
假设我们找到了一些与查询匹配的文档。但我们怎么知道,它具体匹配了文本中的什么位置?让我们尝试将存储的 title、artist 或 genre 中匹配的 token 加粗。
Suggest 和 highlighting 在 UI 中看起来很相似 ------ 两者都会用 <b> 包裹匹配的字母 ------ 但它们并不是同一个调用。
AnalyzingInfixSuggester.lookup(..., highlight=true) 从第二个 dictionary 中返回一个显示字符串 (highlightKey)。chip 的值保持干净(key);加粗 markup 从不会被存储。
UnifiedHighlighter 运行在 track 索引 上,使用刚刚为搜索结果评分的相同 Query 。它读取存储的字段文本并标记 token 的 offset ------ 包括尾随的 PrefixQuery(sincla → <b>Sinclar</b>)。
一个是"帮我编写 query"。另一个是"告诉我这一行为什么匹配"。
高亮我的搜索结果
Highlighting 位于自己的 artifact 中:
xml
`

1.  <dependency>
2.    <groupId>org.apache.lucene</groupId>
3.    <artifactId>lucene-highlighter</artifactId>
4.    <version>10.5.1</version>
5.  </dependency>

`AI写代码
WholeBreakIterator 会将完整的存储值作为一个 fragment ------ 对于较短的 metadata 字段,不进行句子切分。使用与 playground 相同的 builder:
java
`
1. Query bob = new BooleanQuery.Builder()
2. .add(new BoostQuery(new TermQuery(new Term("title", "bob")), 4.0f), BooleanClause.Occur.SHOULD)
3. .add(new BoostQuery(new PrefixQuery(new Term("title", "bob")), 1.0f), BooleanClause.Occur.SHOULD)
4. .add(new BoostQuery(new TermQuery(new Term("artist", "bob")), 3.0f), BooleanClause.Occur.SHOULD)
5. .add(new BoostQuery(new PrefixQuery(new Term("artist", "bob")), 0.75f), BooleanClause.Occur.SHOULD)
6. // ... genre^2 / album^1.5 / label^1 / comment^0.5 (+ prefixes) ...
7. .setMinimumNumberShouldMatch(1)
8. .build();
10. // Search and retrieve the 10 first hits
11. TopDocs hits = searcher.search(bob, 10);
13. UnifiedHighlighter highlighter = UnifiedHighlighter.builder(searcher, analyzer)
14. .withMaxLength(10_000)
15. .withBreakIterator(WholeBreakIterator::new)
16. .build();
17. Map<String, String[]> hl = highlighter.highlightFields(
18. new String[]{"title", "artist", "genre", "album", "label", "comment"},
19. bob, hits);
`AI写代码字段必须设置为 Field.Store.YES,否则 Lucene 无法提取源数据来进行 highlighting。
每个字段都对应一个并行数组 ------ 每个搜索结果对应一个 snippet。缺失或为空的 snippet 表示该字段没有为该文档贡献 markup。将这个 map 作为仅用于显示的 HTML 交给模板;chip 和 URL 仍然使用干净的 Bean。
q=Bob 会在 token 匹配的位置将其包裹起来:
css
`

1.  Outro Lugar - <b>Bob</b> Sinclar Remix
2.  Crazy (<b>Bob</b> Sinclar vs. Dimitri Vegas & Like Mike remix)

`AI写代码
即使对于 PrefixQuery 也是如此,尽管高亮的是整个 term,而不仅仅是输入的前缀:
css
`Outro Lugar - Bob <b>Sinclar</b> Remix`AI写代码Lucene 中的工作原理
搜索回答的是"哪些文档包含这个 term?"Highlighting 回答的是"存储的字符串中的什么位置?"两者读取的是相同的倒排索引 ------ 只是向下深入了一层。
还记得我们在上一篇文章中生成的 posting list 吗?
markdown
`

1.  artist:bob       →  1, 2, 3
2.  artist:claude    →  4, 5
3.  artist:francois  →  4, 5, 6
4.  artist:marley    →  2
5.  artist:sinclar   →  1, 3
6.  artist:valery    →  6

`AI写代码
实际上,它不仅为每个 term 生成了 posting list,还记录了这些 term 在每个文档中的位置。
Phrase query 的 positions
每个 posting 还会存储 positions:该 term 在该字段 token stream 中的位置序号(从 0 开始)。
例如,考虑 artist 名称"Claude François",它被分词为两个 term:claude 和 francois。这些 term 在文档中的位置如下:
| 位置 | Term |
|---|---|
| 0 | claude |
| 1 | francois |
对于 artist 名称 François "Valéry"(被分词为 francois 和 valery),位置如下:
| 位置 | Term |
|---|---|
| 0 | francois |
| 1 | valery |
对于 "Earth Wind and Fire ",位置如下:
| 位置 | Term |
|---|---|
| 0 | earth |
| 1 | wind |
| 2 | and |
| 3 | fire |
如果你搜索 francois valery,你会得到文档"François Valéry",因为其中一个查询 term 匹配了该文档。如果你搜索 valery francois,它会返回完全相同的两个文档,因为在简单的 conjunction query 中,term 的顺序并不重要。
如果顺序很重要呢?这种情况下,你需要使用 phrase query 或 span query 来强制要求 term 的顺序。这就是 term positions 发挥作用的地方。
Offsets 标记字符
但 highlighting 还需要再多一步:将 position 映射回存储的 原始字符串(Field.Store.YES)中的字符。
在分析阶段,每个 token 还会携带指向原始字符串的字符 offset ------ start 包含,end 不包含:
markdown
`

1.  "Earth Wind and Fire"
2.   earth         → [0, 5)
3.   wind          → [6, 10)
4.   and           → [11, 14)
5.   fire          → [15, 19)

`AI写代码
UnifiedHighlighter 会在存储的值上重新运行相同的 analyzer,保留满足 query 的 token(TermQuery wind,或者匹配 wind 的 PrefixQuery win*),然后使用 <b></b> HTML 标签包裹这些 [start, end) 切片:
css
`Earth <b>Wind</b> and Fire`AI写代码现在,你只需要调整 CSS,使其呈现出你希望的样式即可。
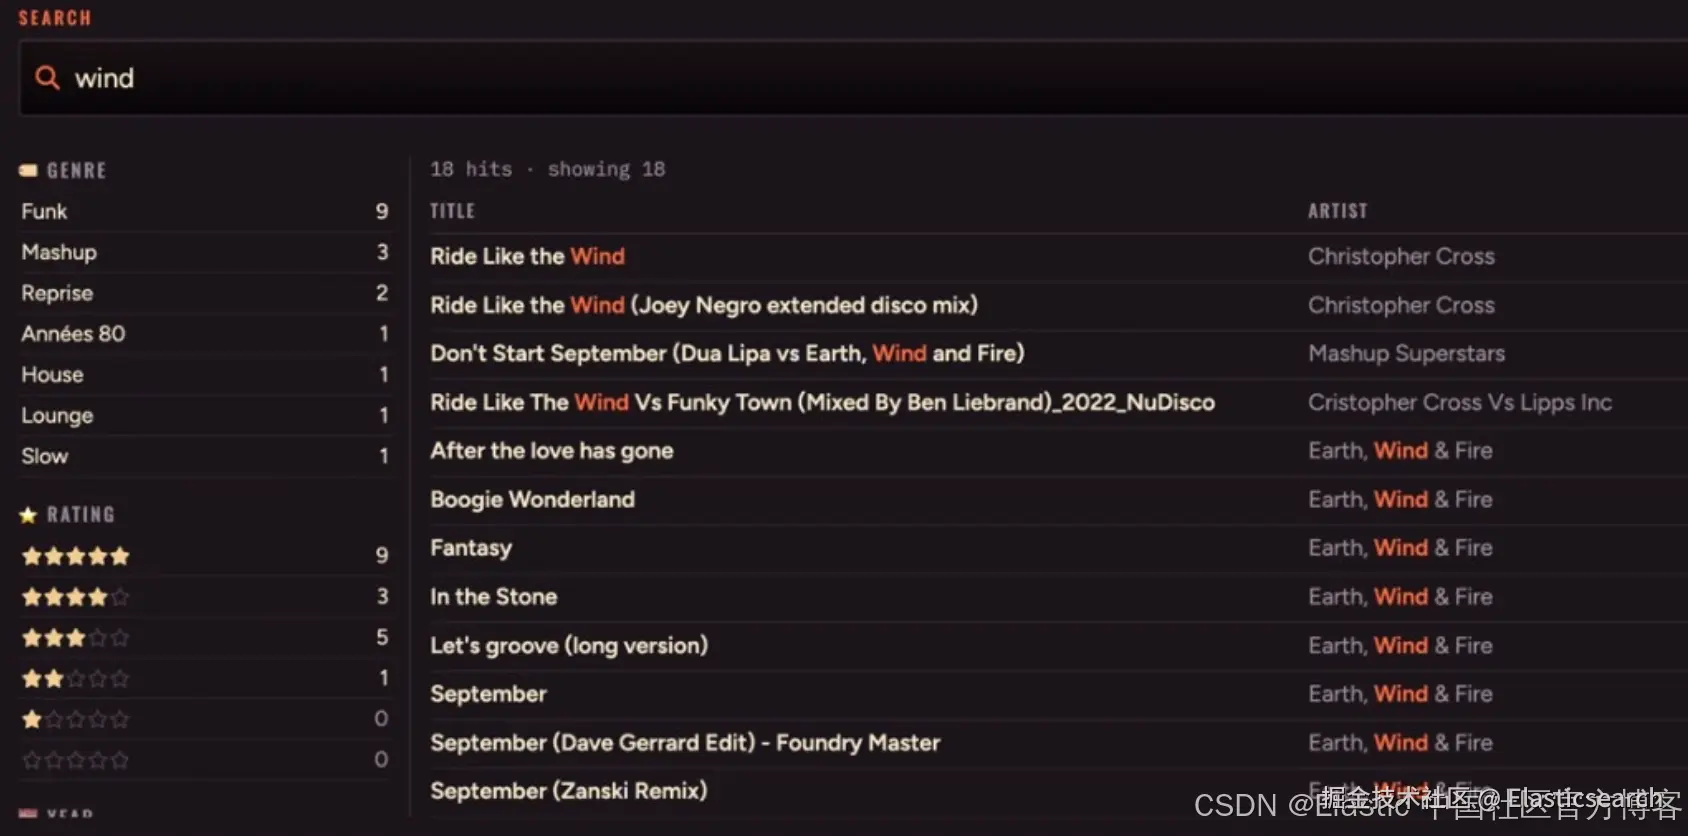
q=wind ------ 在 Earth, Wind & Fire 以及 Ride Like the Wind 等标题中显示橙色的 <b>Wind</b>。
完整 Demo 位于 GitHub:lucene-search-tracks。
原文:Search your beans with Lucene --- Highlighting | David Pilato