文章目录
- 前言
- 零、论文基本信息
- 一、背景:长期个性化为什么不能只靠"记得更多"
-
- [1. Full Context 的上限](#1. Full Context 的上限)
- [2. 向量记忆的碎片化](#2. 向量记忆的碎片化)
- [3. 静态 Persona Profile 的问题](#3. 静态 Persona Profile 的问题)
- [二、相关工作:Inside Out 改变的不是检索器,而是记忆接口](#二、相关工作:Inside Out 改变的不是检索器,而是记忆接口)
-
- [1. 长期记忆系统](#1. 长期记忆系统)
- [2. 个性化对话](#2. 个性化对话)
- [3. 与普通知识图谱的差别](#3. 与普通知识图谱的差别)
- 三、方法总览:从对话流到可演化用户状态
- 四、PersonaTree:用稳定树干约束无限增长
-
- [1. 为什么需要 schema](#1. 为什么需要 schema)
- [2. 可控增长并不等于固定内容](#2. 可控增长并不等于固定内容)
- [3. 对话分块](#3. 对话分块)
- 五、四类原子操作:让记忆更新变得可执行
-
- [1. ADD](#1. ADD)
- [2. UPDATE](#2. UPDATE)
- [3. DELETE](#3. DELETE)
- [4. NO_OP](#4. NO_OP)
- [5. 为什么要把更新限制成操作语言](#5. 为什么要把更新限制成操作语言)
- 六、安全执行与版本化:模型不直接修改数据库
- 七、MemListener:让小模型专门负责听取和维护记忆
-
- [1. 训练数据怎样得到](#1. 训练数据怎样得到)
- [2. SFT:先学会合法地"说操作语言"](#2. SFT:先学会合法地“说操作语言”)
- [3. 为什么还需要过程奖励 RL](#3. 为什么还需要过程奖励 RL)
- [4. 关键训练配置](#4. 关键训练配置)
- 八、自适应回答:树负责稳定状态,历史负责细节证据
-
- [1. Fast Mode](#1. Fast Mode)
- [2. Agentic Recall and Fusion](#2. Agentic Recall and Fusion)
- [3. Router 的工程意义](#3. Router 的工程意义)
- 九、实验设置
-
- [1. 数据集与任务](#1. 数据集与任务)
- [2. Baseline](#2. Baseline)
- [十、主实验:PersonaTree 是否优于完整历史与现有记忆系统](#十、主实验:PersonaTree 是否优于完整历史与现有记忆系统)
-
- [1. 改进集中在哪些能力](#1. 改进集中在哪些能力)
- [2. 仍然存在的异常和边界](#2. 仍然存在的异常和边界)
- 十一、MemListener:小模型真的能承担记忆维护吗
- 十二、消融实验
-
- [1. Fast Mode、Router 与完整 Agentic 模式](#1. Fast Mode、Router 与完整 Agentic 模式)
- [2. 直接生成操作还是先抽取再转换](#2. 直接生成操作还是先抽取再转换)
- [3. SFT 与 RL](#3. SFT 与 RL)
- 十三、超参数、效率与鲁棒性
-
- [1. 对话块窗口](#1. 对话块窗口)
- [2. 跨抽取模型鲁棒性](#2. 跨抽取模型鲁棒性)
- [3. 多维能力分布](#3. 多维能力分布)
- 十四、失败案例与证据边界
-
- [1. 只依赖树会丢失长尾细节](#1. 只依赖树会丢失长尾细节)
- [2. 固定 schema 会形成认知边界](#2. 固定 schema 会形成认知边界)
- [3. 覆盖式 UPDATE 可能抹平时间结构](#3. 覆盖式 UPDATE 可能抹平时间结构)
- [4. 极少 DELETE 既是保守,也可能是滞后](#4. 极少 DELETE 既是保守,也可能是滞后)
- [十五、与 Agent Memory 系列方法的横向比较](#十五、与 Agent Memory 系列方法的横向比较)
- [十六、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十六、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:把项目记忆改造成可执行状态树](#1. Coding Agent:把项目记忆改造成可执行状态树)
- [2. Tool Agent:把长期配置与事件日志分开](#2. Tool Agent:把长期配置与事件日志分开)
- [3. Multi-Agent:由专用 Memory Agent 维护共享状态](#3. Multi-Agent:由专用 Memory Agent 维护共享状态)
- [4. 生产系统应补充的字段](#4. 生产系统应补充的字段)
- 十七、局限性
-
- [1. Schema 的覆盖范围有限](#1. Schema 的覆盖范围有限)
- [2. 当前状态表示缺少显式时间与证据](#2. 当前状态表示缺少显式时间与证据)
- [3. 训练依赖强模型合成与人工核验](#3. 训练依赖强模型合成与人工核验)
- [4. Judge 与任务标签的可靠性](#4. Judge 与任务标签的可靠性)
- [5. 评测规模与统计证据有限](#5. 评测规模与统计证据有限)
- [6. 隐私风险不因结构化而消失](#6. 隐私风险不因结构化而消失)
- 十八、我的理解与启发
-
- [1. PersonaTree 更像数据库中的 materialized view](#1. PersonaTree 更像数据库中的 materialized view)
- [2. 论文真正重要的是 write path,而不是 read path](#2. 论文真正重要的是 write path,而不是 read path)
- [3. 小模型维护记忆是很有潜力的系统分工](#3. 小模型维护记忆是很有潜力的系统分工)
- [4. 固定 schema 与开放世界之间仍有张力](#4. 固定 schema 与开放世界之间仍有张力)
- 十九、总结
- 参考资料
前言
长期对话 Agent 面临一个很现实的矛盾:用户会一直说下去,但模型上下文不可能无限增长。
最简单的方案是保存完整对话,需要时直接拼回上下文;更常见的方案是把历史切成片段,放进向量库,再按当前问题检索。前者很快遭遇 token 成本和噪声累积,后者虽然缓解了长度问题,却容易把"一个持续变化的人"拆成许多彼此孤立的事实。
例如,用户最初说自己喜欢热闹的旅行,几个月后因为工作压力开始偏好安静、小规模的活动。一个真正理解用户的系统,不应同时取回两条互相冲突的记录,也不应粗暴删除过去。它需要知道:哪些信息构成较稳定的人格特征,哪些是会变化的偏好,新的表达应当补充、更新还是撤销旧状态。
在此前的 Agent Memory 系列里,A-MEM 关注记忆之间如何自组织和建立链接,MemoryOS 关注多层存储与生命周期,MAGMA、CoM 等方法分别从多粒度组织和压缩角度控制长期上下文,ReMemR1 与 Mem²Evolve 则进一步讨论记忆怎样回访和演化。Inside Out 选择了另一条路线:它不再把长期个性化记忆视为不断扩张的"历史材料库",而是视为一个需要持续维护的用户状态。
论文以 PersonaTree 作为这个状态的显式载体:树干由预定义 schema 约束,枝叶保存用户在生理、心理与社会层面的核心特征;新对话不直接追加为记忆,而是先被翻译成 ADD、UPDATE、DELETE 或 NO_OP 操作,再安全地执行到树上。为了让这一过程不依赖昂贵大模型,作者还训练了轻量 MemListener 专门负责记忆编辑。
本文的唯一核心增量可以概括为:
Inside Out 将无限对话中的长期个性化记忆,从"持续追加和检索文本"重新定义为"在理论 schema 约束下执行可解释原子操作的用户状态演化",并用经过过程奖励强化学习的轻量 MemListener 稳定维护这棵 PersonaTree。
自适应生成、agentic recall 和训练细节都服务于这条主线:前者决定怎样消费这份状态,后者决定怎样低成本、可控制地更新它。
零、论文基本信息
- 论文名称:Inside Out: Evolving User-Centric Core Memory Trees for Long-Term Personalized Dialogue Systems
- 发表平台:Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics(ACL 2026 Long Papers)
- 代码仓库 :MemTensor/InsideOut
- 作者:Jihao Zhao, Ding Chen, Zhaoxin Fan, Kerun Xu, Mengting Hu, Bo Tang, Feiyu Xiong, Zhiyu Li
一、背景:长期个性化为什么不能只靠"记得更多"
1. Full Context 的上限
完整拼接历史看似不会遗忘,但它把问题交给了模型的上下文窗口:
- 历史越长,推理和生成成本越高;
- 相关信息在长上下文中被大量无关内容稀释;
- 新旧偏好同时出现时,模型必须临时完成冲突消解;
- "Lost in the Middle" 使信息存在于上下文中也不等于能被稳定利用。
更重要的是,Full Context 只有历史,没有显式的"当前用户状态"。每次回答都要从头重建用户画像。
2. 向量记忆的碎片化
向量检索把历史切成片段,解决了上下文容量问题,却引入另一种风险:记忆条目通常是孤立事实或摘要,系统缺少一个稳定的全局边界来说明:
- 什么信息值得长期保留;
- 新信息应该落在哪个属性上;
- 何时是补充,何时构成冲突;
- 旧信息是否仍有效;
- 用户画像怎样随时间形成连贯演化。
因此,"召回到相似文本"和"维护一致人格"不是同一件事。
3. 静态 Persona Profile 的问题
预先填写的年龄、职业、兴趣列表很容易使用,但它把 persona 当成固定配置。真实用户并不会一次性提供完整自我介绍,很多偏好、价值观、表达风格和情感模式只能从长期互动中逐步显现,而且会发生变化。
Inside Out 因此提出一个更接近状态管理的问题:
系统能否只依靠持续到来的对话,把隐含的用户特征压缩进一个有边界、可追踪、可修改的结构中,并在回答时保持个性一致?
二、相关工作:Inside Out 改变的不是检索器,而是记忆接口
1. 长期记忆系统
LangMem 将热路径中的记忆操作与后台整合分开;Mem0 使用多层记忆与图关系支持跨会话个性化;A-MEM 借鉴卡片盒方法,让新记忆自动索引、链接并触发旧记忆演化;MemoryOS 用短期、中期、长期层级模拟操作系统式资源管理。
这些方法主要回答"怎样存、怎样连、怎样检索"。Inside Out 更关注一个上游问题:对话进入记忆系统时,应该被编译成什么状态变化。
2. 个性化对话
传统 persona dialogue 往往给模型一组显式 persona sentence,再要求生成一致回答。后续方法扩展到用户画像、偏好建模和参数高效个性化,但很多设置仍假设 persona 已经给定、相对静态。
Inside Out 的输入不是现成画像,而是长对话历史。它必须先发现属性,再判断这条属性是新增、修正、删除还是不值得写入。
3. 与普通知识图谱的差别
PersonaTree 形式上是一棵层级树,但它不是把所有实体关系都结构化。它的根本目标是维护有限容量的用户核心状态,因此叶节点只保存压缩后的描述性字符串,树干则提供稳定的语义边界。
这意味着它主动牺牲开放关系表达能力,换取更新可控、结构可解释和推理上下文稳定。
三、方法总览:从对话流到可演化用户状态
阅读 Figure 1 时,需要沿三条链路看:左下角把历史对话转换为树操作,右上角训练 MemListener,右下角则冻结 MemListener 并用最终 PersonaTree 支持回答。
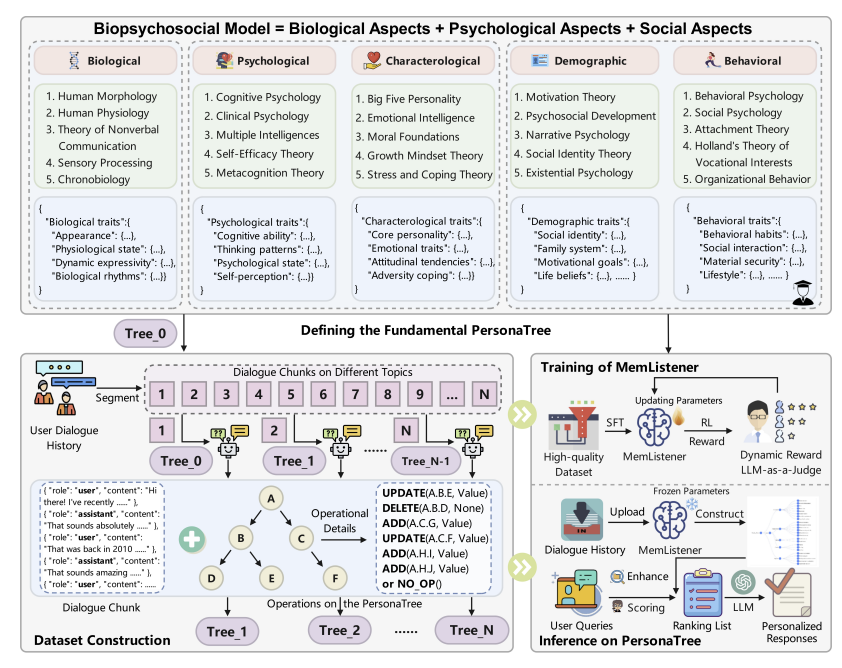
Figure 1:Inside Out 总体框架。 基于生物---心理---社会 schema 初始化 PersonaTree,从分块对话生成原子编辑操作,训练 MemListener,并在推理阶段以结构化记忆增强个性化回答。
整体流程可以拆成三部分:
- Dynamic PersonaTree Evolution:初始化固定语义边界,将连续对话分块,逐块生成并执行树操作;
- MemListener Training:先用 SFT 学会合法操作格式,再用过程奖励强化学习提升语义正确性;
- Adaptive Response Generation:简单问题直接读取 PersonaTree,复杂问题再由树约束 agentic recall,从原始历史补充细节。
论文的问题定义也体现了这种变化。设用户历史为:
H = { x 1 , y 1 , ... , x t , y t } H=\{x_1,y_1,\ldots,x_t,y_t\} H={x1,y1,...,xt,yt}
其中 x t x_t xt 是用户输入, y t y_t yt 是系统回复。传统方案直接在有限窗口内估计:
P ( y t ∣ H t − k : t ) P(y_t\mid H_{t-k:t}) P(yt∣Ht−k:t)
Inside Out 引入显式用户状态 T t \mathcal{T}_t Tt,将任务改写为状态更新与状态条件生成:
T t = f update ( T t − 1 , D t ) \mathcal{T}t=f{\text{update}}(\mathcal{T}_{t-1},D_t) Tt=fupdate(Tt−1,Dt)
y t = f gen ( x t , T t , f recall ( T t , H ) ) y_t=f_{\text{gen}}\bigl(x_t,\mathcal{T}t,f{\text{recall}}(\mathcal{T}_t,H)\bigr) yt=fgen(xt,Tt,frecall(Tt,H))
D t D_t Dt 是当前对话块, f update f_{\text{update}} fupdate 负责更新树, f recall f_{\text{recall}} frecall 在复杂查询下从完整历史召回证据, f gen f_{\text{gen}} fgen 则同时利用当前问题、树状态和必要的历史细节生成回答。
这两个公式揭示了论文的关键分工:PersonaTree 不试图保存所有证据,它保存的是当前压缩状态;原始历史仍保留,必要时作为可追溯证据库使用。
四、PersonaTree:用稳定树干约束无限增长
1. 为什么需要 schema
如果让模型自由生成用户属性,树会不断产生近义节点、粒度不一致的字段和难以合并的分支。例如"喜欢跑步""运动偏好""健身习惯"可能被写到三个位置。
Inside Out 先用 Biopsychosocial Model 确定三类核心边界:
- Biological:生理状态、外观、身体节律、感知等;
- Psychological:认知、思维模式、自我感知、人格、情绪、态度等;
- Social:人口统计、社会身份、家庭、动机、生活信念、行为与社会互动等。
树干和可写叶节点由 schema 规定,每个叶节点存储一个描述性字符串。schema 控制"能记什么",字符串则保留比离散标签更丰富的语义。
2. 可控增长并不等于固定内容
树的语义空间相对稳定,但叶节点内容会被持续改写;扩展策略也允许在规定位置创建新 path。因此它不是静态 profile,也不是完全自由的知识图谱,而是介于两者之间:
稳定语义边界 + 动态叶状态 \text{稳定语义边界}+\text{动态叶状态} 稳定语义边界+动态叶状态
这正是"Inside Out"的含义:人格状态从内部核心结构向外生长,而不是把外部发生过的一切都堆进来。
3. 对话分块
历史被切分为连续对话块 ( D 1 , l d o t s , D N ) (D_1,ldots,D_N) (D1,ldots,DN),每个块包含 w w w 个对话轮次。对每个 D t D_t Dt,系统加载旧树 T t − 1 \mathcal{T}_{t-1} Tt−1 和规则集 R \mathcal{R} R,生成操作列表 O t \mathcal{O}_t Ot,执行后得到新版本 T t \mathcal{T}_t Tt。
分块是重要超参数:块太小会丢失上下文,让模型把临时表达误写成稳定属性;块太大则混入多个主题,时间关系和关键变化会被稀释。
五、四类原子操作:让记忆更新变得可执行
1. ADD
ADD ( p a t h , v a l u e ) \operatorname{ADD}(path,value) ADD(path,value)
当目标属性尚未记录时,在允许的 path 写入描述性文本。若扩展策略允许,也可以在指定 schema 下创建新路径。
例如,树中没有饮食限制,用户明确说"我现在对乳糖不耐受",系统可以新增相应叶节点。
2. UPDATE
UPDATE ( p a t h , v a l u e ) \operatorname{UPDATE}(path,value) UPDATE(path,value)
当叶节点已有内容,新对话对它进行补充、细化或修正时,使用覆盖式重写。新 value 必须整合仍然有效的旧信息,不能只留下最新一句。
这是四类操作中最核心的一种。论文完整数据统计中,UPDATE 有 5310 次,远高于 ADD 的 1248 次,说明长期个性化的本质不是不断收集新事实,而是持续校准已有用户状态。
3. DELETE
DELETE ( p a t h , N o n e ) \operatorname{DELETE}(path,None) DELETE(path,None)
只有当对话明确说明某条旧信息已失效、被否定或应当移除时才删除。论文统计中只有 7 次 DELETE,说明它被设计为非常保守的操作。
这既减少误删,也暴露出一个问题:很多现实偏好不是被明确否定,而是逐渐过时。没有时间衰减或置信度机制时,系统可能长期保留已不准确的信息。
4. NO_OP
NO_OP ( ) \operatorname{NO\_OP}() NO_OP()
当当前对话块没有值得进入长期核心记忆的信息时,不做任何修改。它是抑制噪声累积的关键门控,而不是"没有抽取成功"的错误状态。
5. 为什么要把更新限制成操作语言
结构化操作带来三个直接好处:
- 可验证:可以检查 path 是否允许、value 是否为字符串、格式是否合法;
- 可解释:每次状态变化都有明确动作类型;
- 可回滚:每次执行后持久化一个树版本,便于追踪演化。
相比让大模型直接输出一整棵新树,原子操作降低了无关节点被意外改写的风险。
六、安全执行与版本化:模型不直接修改数据库
操作生成后,解析执行层充当 safety gate:
- 检查 path 是否指向允许写入的叶节点;
- 检查 value 是否为字符串或合法删除标记;
- 对过长 value 进行压缩,满足单叶容量预算;
- 严格按操作执行,不在执行层做第二次语义改写;
- 将结果持久化成 JSON 文件或 JSON 数据库中的新版本。
这里有一个清晰的责任边界:语义冲突由 MemListener 在生成操作时处理,执行层只负责结构和容量安全。如果新旧信息冲突,模型要基于语义、时间顺序和叙事一致性决定保留什么。
这种设计比"解析器顺便合并文本"更容易审计,但也把很大压力放在操作生成模型上:只要模型错误理解了冲突,后端仍会忠实执行错误更新。
七、MemListener:让小模型专门负责听取和维护记忆
1. 训练数据怎样得到
作者从 HaluMem 和 PersonaMem 选择与隐式用户特征相关的数据,以动态 PersonaTree 更新流程为骨架,使用 DeepSeek-R1-0528 生成监督信号,再人工过滤:
- 非法操作语法;
- 错误 path;
- 语义不一致的写入。
最终构造约 28K 指令数据。论文使用 PersonaMem 15K 进行纯 SFT;在两阶段设置中,用 HaluMem 13K 做 SFT warm-up,再用 PersonaMem 0.5K 做过程奖励 RL。
这说明 MemListener 并非无监督从用户对话中自我成长。它依赖强模型合成、人工核验和已有 benchmark 数据,部署时只是把昂贵能力蒸馏到小模型中。
2. SFT:先学会合法地"说操作语言"
输入 s s s 包含对话块、旧树状态和更新规则,目标 o o o 是正确操作序列。标准自回归损失为:
L SFT ( θ ) = − 1 τ ∑ t = 1 τ log P θ ( o t ∣ o < t , s ) \mathcal{L}{\text{SFT}}(\theta) =-\frac{1}{\tau}\sum{t=1}^{\tau}\log P_\theta(o_t\mid o_{<t},s) LSFT(θ)=−τ1t=1∑τlogPθ(ot∣o<t,s)
τ \tau τ 是目标序列长度, θ \theta θ 是 MemListener 参数。SFT 的目标首先是让模型稳定输出严格格式,并学会 path、操作类型与 value 的基本映射。
3. 为什么还需要过程奖励 RL
操作序列可能语法正确,但语义仍然有问题:漏掉关键属性、选错 path、错误覆盖旧信息,或者生成重复操作。作者使用 Qwen3-32B reasoning mode 作为动态 Judge,将预测操作与人工核验的 ground truth 比较,输出 − 1 , 1 -1,1 −1,1 连续得分。
训练采用 DAPO 风格的组相对优化。对同一输入采样 G = 8 G=8 G=8 个候选输出 y i y_i yi,得到序列奖励:
R i = R ( y i , y ∗ ; s ) , R i ∈ − 1 , 1 R_i=R(y_i,y^*;s),\qquad R_i\in-1,1 Ri=R(yi,y∗;s),Ri∈−1,1
组内标准化后得到优势:
A ^ i , t = R i − mean ( { R j } j = 1 G ) std ( { R j } j = 1 G ) \hat{A}{i,t}=\frac{R_i-\operatorname{mean}(\{R_j\}{j=1}^{G})} {\operatorname{std}(\{R_j\}_{j=1}^{G})} A^i,t=std({Rj}j=1G)Ri−mean({Rj}j=1G)
token 级重要性比率为:
r i , t ( θ ) = π θ ( y i , t ∣ s , y i , < t ) π θ old ( y i , t ∣ s , y i , < t ) r_{i,t}(\theta)= \frac{\pi_\theta(y_{i,t}\mid s,y_{i,<t})} {\pi_{\theta_{\text{old}}}(y_{i,t}\mid s,y_{i,<t})} ri,t(θ)=πθold(yi,t∣s,yi,<t)πθ(yi,t∣s,yi,<t)
优化使用非对称裁剪, ϵ l o w = 0.2 \epsilon_{low}=0.2 ϵlow=0.2, ϵ h i g h = 0.28 \epsilon_{high}=0.28 ϵhigh=0.28。较宽的上界给低概率但高奖励的探索 token 更多提升空间。论文还启用动态采样,过滤全对或全错导致组内优势退化的样本。
我的理解是,这里的"process reward"更准确地说是对完整操作过程/序列质量进行细粒度语义评价,再把序列奖励分配到 token 级更新;论文并没有为每一步树编辑提供独立环境奖励。
4. 关键训练配置
| 配置 | 数值 |
|---|---|
| 训练方式 | Full fine-tuning |
| 精度 | bfloat16 |
| 学习率 | 1 × 10 − 6 1\times10^{-6} 1×10⁻⁶ |
| Epoch | 1 |
| 最大上下文长度 | 11264 |
| 最大生成长度 | 512 |
| 每组采样数 | 8 |
| Temperature / Top-p / Top-k | 1.0 / 0.9 / 50 |
| 裁剪范围 | 0.2 / 0.28 |
| KL 系数 β \beta β | 0.001 |
| 最大重采样次数 | 3 |
Table 5:DAPO 训练超参数。 MemListener 使用长上下文、组内 8 候选、非对称裁剪与动态重采样完成过程奖励对齐。
八、自适应回答:树负责稳定状态,历史负责细节证据
1. Fast Mode
对延迟敏感或 PersonaTree 已能覆盖的问题,系统把非空叶节点作为个性化 prior,与当前查询一起输入回答模型,一次生成答案。
优点是延迟低、上下文短、persona 一致;缺点是叶节点是压缩摘要,可能缺少具体事件、原话和时间细节。
2. Agentic Recall and Fusion
当用户明确要求更多细节,或查询具有长尾特征时,系统进入 agentic 模式:
- 根据查询 q q q 和最终树 T N \mathcal{T}N TN 生成多个扩展查询 { q ~ ( k ) } k = 1 K \{\tilde q^{(k)}\}{k=1}^{K} {q~(k)}k=1K;
- 并行检索候选历史片段 { d j ( k ) } \{d_j^{(k)}\} {dj(k)};
- 使用 BGE-Reranker-Large 重排并融合为上下文 C C C;
- 基于 q , T N , C q,\\mathcal{T}_N,C q,TN,C 生成最终答案。
PersonaTree 在这里同时承担两个角色:它既是可直接使用的压缩记忆,也是深度检索的约束器。这样可以避免 agentic recall 完全脱离当前用户状态,在海量历史里任意搜索。
3. Router 的工程意义
论文比较三种推理路径:
w/ PersonaTree:只使用快速模式;w/ PersonaTree + Router:按需触发检索;PersonaTree-ALL:始终使用完整 agentic recall 与 fusion。
Router 的目标不是追求绝对最高分,而是在接近完整模式的同时减少不必要检索。这种分层路径比对所有请求都启动 Agent 更符合生产场景。
九、实验设置
1. 数据集与任务
论文在 PersonaMem 上评测。每个样本包含用户静态人口属性与随时间变化的动态特征;历史约由 10 段多轮对话按时间拼接而成,总长度约 32K token,覆盖 15 类真实个性化任务。
评测包含七类能力:
- Recall-Facts:回忆用户分享的事实;
- Pref-Rec:给出符合偏好的推荐;
- New-Ideas:提出新的个性化想法;
- Recall-Reason:回忆偏好背后的原因;
- Pref-Evol:追踪偏好变化;
- Gen-New:向新场景泛化;
- Recall-User:回忆用户提及的信息。
主指标为准确率与七类能力的 Overall 聚合分数。
2. Baseline
论文比较 Only LLM、完整历史 ALLDialogue、LangMem、Mem0、A-Mem 和 MemoryOS。所有需要检索的系统统一使用 BGE-M3,BGE-Reranker-Large 重排,取回 4 条,并尽量保持检索上下文长度一致。
主实验固定 DeepSeek-R1-0528 作为各记忆系统的抽取模型,再分别用 DeepSeek-V3.1、Longcat-Flash-Chat 和 DeepSeek-R1-0528 作为回答模型。PersonaTree 还比较未训练模型、SFT 模型和 SFT+RL 模型。
十、主实验:PersonaTree 是否优于完整历史与现有记忆系统
原始 Table 1 列数很宽,下面先复现最关键的 Overall 结果,再讨论细分能力。
| 回答模型 | Only LLM | ALLDialogue | LangMem | Mem0 | A-Mem | MemoryOS | PersonaTree 最佳 |
|---|---|---|---|---|---|---|---|
| DeepSeek-V3.1 | 52.63 | 63.84 | 57.05 | 60.44 | 59.76 | 62.48 | 71.31 |
| Longcat-Flash-Chat | 54.33 | 61.80 | 58.23 | 59.59 | 60.95 | 65.03 | 75.38 |
| DeepSeek-R1-0528 | 44.14 | 64.86 | 54.84 | 49.41 | 47.37 | 62.65 | 76.06 |
Table 1:PersonaMem 主实验 Overall。 PersonaTree 在三种回答模型上均优于无记忆、完整历史和四种长期记忆系统。
三组结果呈现出一致趋势:
- DeepSeek-V3.1 上,71.31 比 ALLDialogue 高 7.47,比最强记忆 baseline MemoryOS 高 8.83;
- Longcat 上,75.38 比 ALLDialogue 高 13.58,比 MemoryOS 高 10.35;
- DeepSeek-R1 上,76.06 比 ALLDialogue 高 11.20,比 MemoryOS 高 13.41。
这些结果支持"结构化当前状态比完整历史更容易利用"。完整历史理论上保留了全部信息,却被噪声和超长上下文拖累;PersonaTree 主动压缩后反而更准确。
1. 改进集中在哪些能力
以 DeepSeek-R1 作为回答模型时,PersonaTree 最佳配置相对 ALLDialogue:
- Pref-Rec:63.64 → 81.82,提升 18.18;
- New-Ideas:11.83 → 29.03,提升 17.20;
- Recall-Reason:84.85 → 92.93;
- Pref-Evol:73.38 → 84.17。
这说明树不仅帮助记住事实,更重要的是维护偏好与原因之间的连贯状态。特别是 Pref-Evol,它直接对应论文的"动态 persona"主张。
2. 仍然存在的异常和边界
并非每个子指标都由同一 PersonaTree 配置获胜。例如不同小模型在 Recall-User、Pref-Rec 上存在明显波动;只用 fast mode 时 New-Ideas 往往下降最大。说明高度压缩的树擅长稳定属性,却容易丢失产生新想法所需的具体情境。
此外,论文给出的是准确率,没有报告多次运行的方差或显著性检验。对于样本数较少的子类,数个百分点差异需要谨慎解释。
十一、MemListener:小模型真的能承担记忆维护吗
| Tree 操作模型 | DeepSeek-V3.1 回答 | Longcat 回答 | DeepSeek-R1 回答 | 平均记忆长度 |
|---|---|---|---|---|
| Qwen2.5-7B-Instruct | 55.18 | 55.18 | 50.08 | 1852.08 |
| Qwen3-8B | 52.97 | 54.33 | 47.71 | 1392.49 |
| GPT-4o-mini | 55.86 | 58.23 | 55.18 | 1154.35 |
| DeepSeek-V3.1 | 60.03 | 62.31 | 61.80 | 2227.78 |
| DeepSeek-R1-0528 | 60.61 | 63.33 | 63.50 | 1844.19 |
| Gemini-3-Pro | 61.29 | 63.16 | 63.16 | 2252.89 |
| Qwen2.5-7B SFT+RL | 62.82 | 64.35 | 64.01 | 2626.05 |
| Qwen3-8B SFT+RL | 61.97 | 65.20 | 65.70 | 2348.49 |
Table 2:不同 PersonaTree 操作模型。 经过 SFT+RL 的 7B/8B MemListener 达到或超过多个强推理模型,同时将记忆上下文保持在约 2.2K~2.6K token。
ALLDialogue 需要约 32K token,而训练后的 PersonaTree 平均只需 2.2K~2.6K,压缩到原来的约 7%~8%。更重要的是,小模型并非仅生成更短摘要,它必须输出可执行更新,并使后续回答准确率超过强模型维护的树。
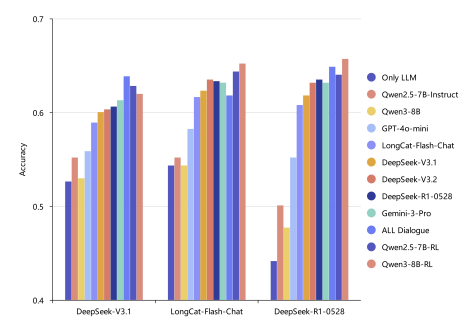
Figure 3:记忆操作模型总体表现。 未训练的小模型明显落后,SFT+RL 后的 Qwen 7B/8B 在三种回答模型上获得稳定提升。
这组结果支持"小模型维护记忆,大模型负责回答"的系统分工。不过比较仍受到训练数据差异影响:强模型是直接调用,MemListener 则针对任务进行了专门训练,因此"超过 Gemini-3-Pro"不等于通用能力更强,而是说明专用蒸馏值得做。
十二、消融实验
1. Fast Mode、Router 与完整 Agentic 模式
| 回答模型 | 仅 PersonaTree | PersonaTree + Router | PersonaTree-ALL |
|---|---|---|---|
| DeepSeek-V3.1 | 61.97 | 70.12 | 70.80 |
| Longcat-Flash-Chat | 65.20 | 71.82 | 75.38 |
| DeepSeek-R1-0528 | 65.70 | 74.19 | 76.06 |
Table 7:生成路径消融。 只读 PersonaTree 已有收益,Router 进一步接近完整 agentic recall,始终检索的 PersonaTree-ALL 获得最高分。
只使用 PersonaTree 时,模型已经获得稳定用户状态,但与完整模式仍相差 8~10 分。说明压缩记忆不能完全替代原始证据。Router 恢复了大部分差距,是实际系统中更有价值的折中。
2. 直接生成操作还是先抽取再转换
| 抽取模型 | 生成策略 | DeepSeek-V3.1 | Longcat | DeepSeek-R1 |
|---|---|---|---|---|
| DeepSeek-V3.1 | 两阶段 | 58.91 | 60.78 | 58.74 |
| 直接生成 | 60.03 | 62.31 | 61.80 | |
| Longcat | 两阶段 | 58.57 | 59.59 | 58.40 |
| 直接生成 | 58.91 | 61.63 | 60.78 | |
| DeepSeek-R1 | 两阶段 | 59.76 | 60.95 | 62.31 |
| 直接生成 | 60.61 | 63.33 | 63.50 |
Table 3:操作生成策略。 直接从对话和旧树生成原子操作,在所有抽取模型与回答模型组合上优于"先抽信息、再转操作"。
两阶段管线会在中间表示丢失时间顺序、冲突关系和细粒度语义,随后再转换成操作时误差继续累积。直接生成把"抽取什么"和"如何修改旧状态"放在同一次条件推理中,提升约 0.34~3.06 分。
3. SFT 与 RL
Qwen2.5-7B 经 SFT+RL 后,在三个回答模型上得到 62.82、64.35、64.01;Qwen3-8B 对应 61.97、65.20、65.70。相较未训练版本,提升不是格式层面的微调,而会传导到最终个性化回答。
但论文没有单列"只有 SFT warm-up、再使用完全相同数据规模追加非 RL 训练"的严格预算对照,因此 RL 增益中可能同时包含数据来源和训练阶段差异。
十三、超参数、效率与鲁棒性
1. 对话块窗口
| Tree 抽取模型 | 回答模型 | w = 1 w=1 w=1 | w = 3 w=3 w=3 | w = 5 w=5 w=5 | w = 7 w=7 w=7 | w = 10 w=10 w=10 | w = 13 w=13 w=13 | w = 15 w=15 w=15 |
|---|---|---|---|---|---|---|---|---|
| DeepSeek-R1 | DeepSeek-V3.1 | 59.42 | 60.61 | 58.74 | 58.57 | 60.10 | 59.25 | 58.74 |
| DeepSeek-R1 | Longcat | 62.82 | 63.33 | 62.48 | 62.65 | 62.65 | 62.31 | 62.48 |
| DeepSeek-R1 | DeepSeek-R1 | 60.95 | 63.50 | 59.93 | 60.27 | 59.25 | 62.65 | 61.29 |
| Qwen2.5-7B-RL | DeepSeek-V3.1 | 60.78 | 62.82 | 58.91 | 61.12 | 59.25 | 57.56 | 59.59 |
| Qwen2.5-7B-RL | Longcat | 62.14 | 64.35 | 63.67 | 61.29 | 64.18 | 62.82 | 61.97 |
| Qwen2.5-7B-RL | DeepSeek-R1 | 62.82 | 64.01 | 60.78 | 62.82 | 60.95 | 61.29 | 62.14 |
Table 4:对话分块窗口敏感性。 每块 3 轮对话在两种抽取模型和三种回答模型上最稳定。
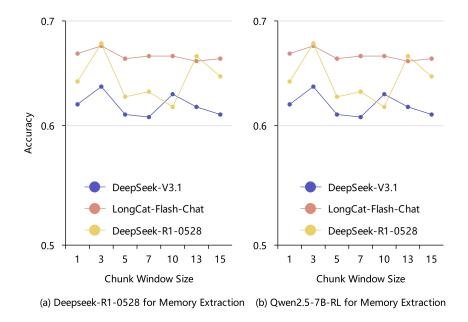
Figure 4:对话分块窗口曲线。 w = 3 w=3 w=3 在不同抽取与回答模型组合下形成较稳定峰值,过小导致碎片化,过大导致主题混合。
窗口并非越大越好。 w = 1 w=1 w=1 缺少判断稳定属性所需的局部语境; w ≥ 10 w\ge 10 w≥10 则让多个主题和时间变化混在一个操作决策里。 w = 3 w=3 w=3 是本文数据上的折中,并不意味着所有对话域都应固定为 3。
2. 跨抽取模型鲁棒性
附录将统一抽取器从 DeepSeek-R1-0528 换成 DeepSeek-V3.1,PersonaTree-ALL 在三种回答模型上仍达到 70.80、73.34 和 74.53,分别比 ALLDialogue 高 6.96、11.54 和 9.67。
这说明收益不完全依赖某个特定的强抽取模型。但不同抽取模型共享相同 schema、操作语法和评测任务,因此还不能推断到任意领域树结构。
3. 多维能力分布
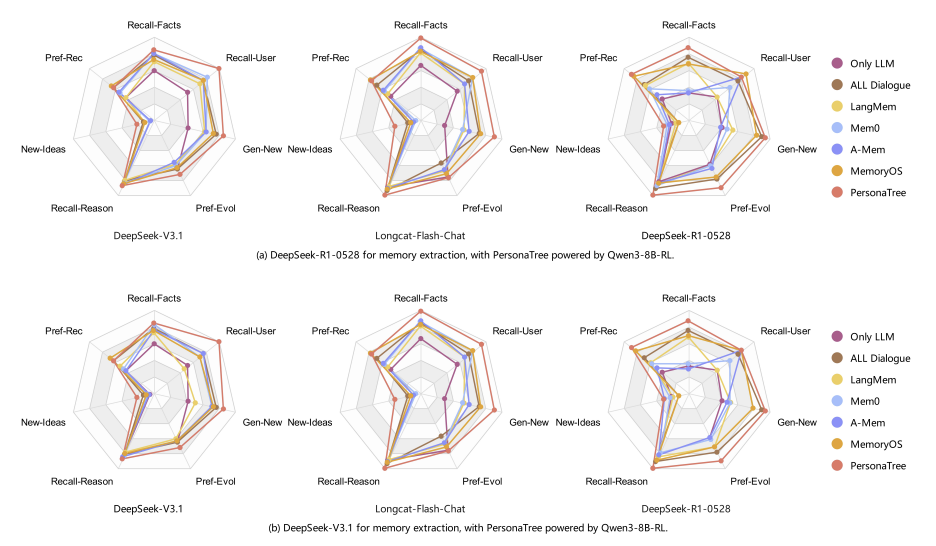
Figure 2:多维能力雷达图。 在两种记忆抽取设置和三种回答模型下,PersonaTree 的优势覆盖事实、偏好、原因、演化与新场景生成等多个维度。
雷达图表明优势不是只靠某一个 Recall 指标拉高,尤其在 New-Ideas、Gen-New 和 Recall-Reason 上,PersonaTree 的外扩更明显。这与"树提供稳定状态、agentic recall 补充细节"的双层设计相符。
十四、失败案例与证据边界
论文没有单列逐例失败案例,因此不能凭空补造具体对话。但从实验和机制中可以确认几类失败边界。
1. 只依赖树会丢失长尾细节
Fast Mode 相比 PersonaTree-ALL 在三个回答模型上落后 8.83、10.18 和 10.36 分。最明显的退化出现在 New-Ideas 一类需要细节组合的任务。这说明 PersonaTree 是高信号状态,不是完整历史替代品。
2. 固定 schema 会形成认知边界
schema 能抑制无限增长,也会决定系统"看得见什么"。不在生物---心理---社会预定义空间中的领域技能、任务状态或复杂关系,可能被迫塞进近似字段,或者直接被判定为 NO_OP。
3. 覆盖式 UPDATE 可能抹平时间结构
叶节点以字符串覆盖重写,新旧状态只通过版本文件间接保存。对于"以前喜欢、现在不喜欢、特定情境下又例外"这类时间条件,单一当前字符串可能无法表达完整演化。
4. 极少 DELETE 既是保守,也可能是滞后
全数据只有 7 次 DELETE。它降低了错误遗忘风险,但也可能意味着系统更倾向于整合或覆盖,而不是清理过时信息。长期运行时,旧内容能否真正退出核心记忆尚未得到验证。
十五、与 Agent Memory 系列方法的横向比较
| 方法 | 核心记忆单位 | 主要解决的问题 | 与 Inside Out 的区别 |
|---|---|---|---|
| Mem0 | 多层事实与关系记忆 | 跨会话存储、检索和生产部署 | Mem0 更强调通用记忆基础设施;Inside Out 把用户核心状态限制在 persona schema 内 |
| A-MEM | 带标签、描述和链接的原子记忆 | 自组织关联与记忆演化 | A-MEM 让记忆网络自由生长;Inside Out 用固定树干和四类操作控制增长 |
| MemoryOS | 短期---中期---长期记忆层 | 生命周期与层级迁移 | MemoryOS 管理不同时间层;Inside Out 管理单个用户状态的语义更新 |
| MAGMA | 多粒度、异构记忆 | 不同尺度记忆的组织与协同 | MAGMA 关注多种记忆如何共存;Inside Out 聚焦 persona 这一类核心状态 |
| CoM | 压缩后的长程记忆 | 降低上下文成本并保留关键信息 | CoM 重点是压缩;Inside Out 进一步给压缩状态规定可执行更新接口 |
| ReMemR1 | 可回访历史的更新过程 | 写入时修复早期不可逆信息损失 | ReMemR1 允许回看旧记忆;Inside Out 通过旧树条件和版本化完成增量状态改写 |
| Mem²Evolve | 随经验持续演化的记忆 | 记忆如何在线更新和自我改进 | 两者都重视演化;Inside Out 的演化被严格约束为 persona tree operations |
| ReasoningBank | 推理策略与防错规则 | 从成功和失败轨迹提炼可迁移经验 | ReasoningBank 记"如何做任务";Inside Out 记"用户是谁以及如何变化" |
Inside Out 最大的区别是把 memory write API 明确化。它不允许任意"新增一条记忆",而要求每次变化说明目标 path、操作类型和新状态。这种接口非常适合强治理、强个性一致性的场景。
它也可以与其他方法组合:PersonaTree 作为核心用户状态,MemoryOS 管理不同时间层,A-MEM 保存自由关联事件,ReasoningBank 保存工具和推理经验,agentic recall 再按任务组合这些来源。
十六、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已经验证的实验结论。
1. Coding Agent:把项目记忆改造成可执行状态树
Coding Agent 的长期记忆可以不再是一堆历史 PR 摘要,而是一棵受 schema 约束的项目状态树:
architecture:模块职责与依赖边界;conventions:测试、命名、错误处理约定;environment:构建命令、运行时和版本;known_issues:当前仍有效的问题;decisions:已接受的设计选择及理由。
每次任务结束后只允许 ADD/UPDATE/DELETE/NO_OP,并保留版本。这样可以避免把临时调试信息永久写成项目事实。
2. Tool Agent:把长期配置与事件日志分开
工具执行日志应保留在 evidence store,核心树只维护当前可执行状态,例如账号范围、权限边界、默认资源和用户偏好。复杂操作先读状态树,只有缺细节时再回查日志。
这对应论文的"PersonaTree 快速模式 + agentic recall"双层架构。
3. Multi-Agent:由专用 Memory Agent 维护共享状态
MemListener 的分工启发一种多 Agent 架构:任务 Agent 专注执行,独立 Memory Agent 监听消息并生成结构化状态操作,后端验证后写入共享树。
优势是业务 Agent 不必在每次推理中同时承担记忆整理;风险是 Memory Agent 一旦错误更新,影响会扩散到所有协作者,因此需要版本、审批和回滚。
4. 生产系统应补充的字段
在四类操作之外,我会建议增加:
timestamp:状态何时生效;source:来自哪段对话或工具结果;confidence:抽取和冲突处理的置信度;scope:全局有效还是特定场景有效;supersedes:本次更新替代哪个历史版本。
它们能缓解论文自己承认的时间、证据溯源和多版本共存问题。
十七、局限性
1. Schema 的覆盖范围有限
论文使用 Biopsychosocial schema,适合人物建模,但不一定适合专业技能、任务状态或跨领域关系。作者也承认未来需要可组合子树或插件式模块。
2. 当前状态表示缺少显式时间与证据
叶节点主要是描述字符串,没有原生时间戳、置信度和 source pointer。版本化能看出树前后变化,却不等于回答时能直接解释"这条结论来自哪里、何时仍然有效"。
3. 训练依赖强模型合成与人工核验
28K 指令并不是自然产生的金标准。DeepSeek-R1-0528 负责生成监督信号,再由人工过滤。数据生成模型的偏差可能被蒸馏到 MemListener 中。
4. Judge 与任务标签的可靠性
RL 使用 Qwen3-32B 作为 Judge 对完整操作序列打连续分。论文没有给出 Judge 与人工评审的一致率,也没有系统分析错误奖励如何污染树操作。
5. 评测规模与统计证据有限
实验集中在 PersonaMem,虽然跨抽取模型和回答模型结果一致,但尚缺少真实多年交互、跨语言用户、多人共享设备和对抗性隐私场景。主表也没有置信区间或显著性检验。
6. 隐私风险不因结构化而消失
显式树确实更容易做访问控制、编辑与撤销,但它也把敏感偏好、心理特征和社会身份集中成高价值画像。生产部署仍需字段分级、最小化收集、用户可见性和删除证明。
十八、我的理解与启发
1. PersonaTree 更像数据库中的 materialized view
完整历史是事件日志,PersonaTree 是由日志持续维护的当前视图。它不替代事件源,而是让高频查询无需每次扫描全部历史。
用系统设计语言表达,就是:
Dialogue Event Log → MemListener Versioned Persona State \text{Dialogue Event Log} \xrightarrow{\text{MemListener}} \text{Versioned Persona State} Dialogue Event LogMemListener Versioned Persona State
复杂查询再从状态视图跳回事件日志取证。这比单纯称它为"树形记忆"更能解释其价值。
2. 论文真正重要的是 write path,而不是 read path
很多 Agent Memory 工作把主要精力放在检索:向量、图、多跳、重排。Inside Out 的亮点在写入侧------每条对话先经过 value judgment,再生成明确状态操作。
只要写入质量足够高,读取甚至可以非常简单;而写入侧失控时,再强的检索器也只是在噪声中搜索。
3. 小模型维护记忆是很有潜力的系统分工
长期记忆更新频率高、格式稳定、领域边界明确,适合用小模型专门化。大模型只在复杂回答与深度召回时出现,可以显著降低长期系统成本。
不过,小模型的便宜不应掩盖错误的长期影响。记忆写入是高杠杆操作,比一次回答错误更危险,因此应配套可回滚、抽样审计和高风险字段二次确认。
4. 固定 schema 与开放世界之间仍有张力
Inside Out 用 schema 换来了稳定和可解释性,但用户总会说出设计者没预料到的事情。真正成熟的系统可能需要两层结构:
- 核心树保存稳定、受治理的高价值状态;
- 开放事件层保存难以归类的证据和弱结构记忆;
- 当某类开放事件反复出现,再由受控机制升级 schema。
这样可以避免树无限膨胀,也不会把 schema 之外的信息全部丢掉。
十九、总结
Inside Out 解决的不是"怎样从更长历史里检索更多内容",而是"怎样把不断到来的对话维护成一个一致、紧凑、可解释的用户状态"。
PersonaTree 用生物---心理---社会 schema 限制长期记忆的语义边界;ADD、UPDATE、DELETE、NO_OP 将记忆演化变成可验证操作;MemListener 通过 SFT 和过程奖励 RL 学会由对话与旧树直接生成操作;回答阶段则在快速树读取与按需 agentic recall 之间切换。
实验表明,约 2.2K~2.6K token 的结构化树可以超过 32K 完整历史以及 LangMem、Mem0、A-Mem、MemoryOS,多种回答模型和抽取模型下趋势一致。与此同时,Fast Mode 与完整模式之间的差距、固定 schema 的边界、极少 DELETE、缺乏时间和证据元数据,都说明它仍是一套有明确适用范围的个性化状态管理方案,而不是通用记忆终局。
一句话总结:
Inside Out 的核心贡献,是为长期个性化记忆建立了一个受 schema 约束、由原子操作驱动、可由小模型持续维护的用户状态接口,让"记住用户"从文本堆积问题变成可治理的状态演化问题。