Colulu Agents Workflow:业财一体化分析示例
一次对话能跑通的分析,为什么值得写成一份可版本化的「规程」?
本文以
workflow-versions.json中 7 份真实 Workflow 定义为参照,再用一次完整的 BPI Challenge 2019 业财一体化分析作例子------看一套 Workflow 机制如何把「算清流程低效吃掉了多少钱」从一次性提问,变成可复用、可审计、可交接的方法论资产。
引子:一个具体的问题
先看这次分析任务的原话。它不是「帮我分析一下采购数据」,而是带着明确追问的:
BPI Challenge 2019 数据集已就绪。基于 BPI Challenge 2019 数据集进行业财分析,核心在于利用其完整的事件日志,将采购业务流程与财务结果直接关联起来......进行下述研究分析任务:成本核算与流程效率成本
- 返工成本量化:识别频繁发生的"变更活动",如 Change Price(更改价格)或 Change Quantity(更改数量),这些返工引入了显著延迟和额外的人工成本。可以计算因返工导致的额外处理工时,并估算其人力成本。
- 瓶颈环节的成本影响:分析发现,"记录发票收据"(Record Invoice Receipt)到"清账"(Clear Invoice)是流程中最耗时的环节,是主要的瓶颈所在。可以量化该环节的等待时间,并评估其占用的资金成本或对供应商关系的影响。
- 自动化缺失的成本:识别哪些活动仍由人工处理,哪些已实现自动化。通过建模分析,可以估算若将某些高频、规则明确的人工活动自动化,能节省多少人力工时和成本。
这段提问质量很高------给了数据源、给了业务口径、给了三个可量化的切口。但即便如此,它仍然只是一次提问。
后来,这个会话里陆续又追加了五轮追问:
| 轮次 | 追加任务 | 性质变化 |
|---|---|---|
| 第 2 轮 | 继续各个采购类别的成本下钻分析 | 换切片维度:从全局到 19 个采购类别 |
| 第 3 轮 | 给出成本核算/成本分析/经营分析的核心洞见,对比不同成本模型对经营的贡献和影响,你自己决定采用哪些方法 | 换方法论:5 种成本模型对比 |
| 第 4 轮 | 将 M3 的降本建议做成可量化的投资回报(ROI)测算 | 换交付形态:从分析结论到投资决策 |
| 第 5 轮 | 进一步把某类成本模型(如 TDABC)落到单条业务线/供应商粒度,所有业务线以及供应商 | 换粒度:从类别到 1,975 家供应商 |
| 第 6 轮 | 详细分析业务线【Packaging】的成本方面的全链条分析,根据经典业务分析流程,全景分析该业务线 | 换范式:单业务线全景剖析 |
六轮任务,同一份数据,最终工作区里落盘了 5 份分析报告(.md)+ 5 个交互式 HTML 报告 + 35 张图表 + 十余份 CSV/JSON 明细。
这里有个问题值得停下来想:
换一个行业、换一个人、换一份数据,这六轮里有多少工作是必须重做 的?有多少是可以照搬的?
答案是:数据解析方式、口径设定、成本模型选型、下钻路径、交叉校验、报告结构、图表规范------几乎全部需要重做。真正「属于这个数据集」的,只有最后写进报告里的那些数字。
Workflow 要解决的,正是后面那一部分。
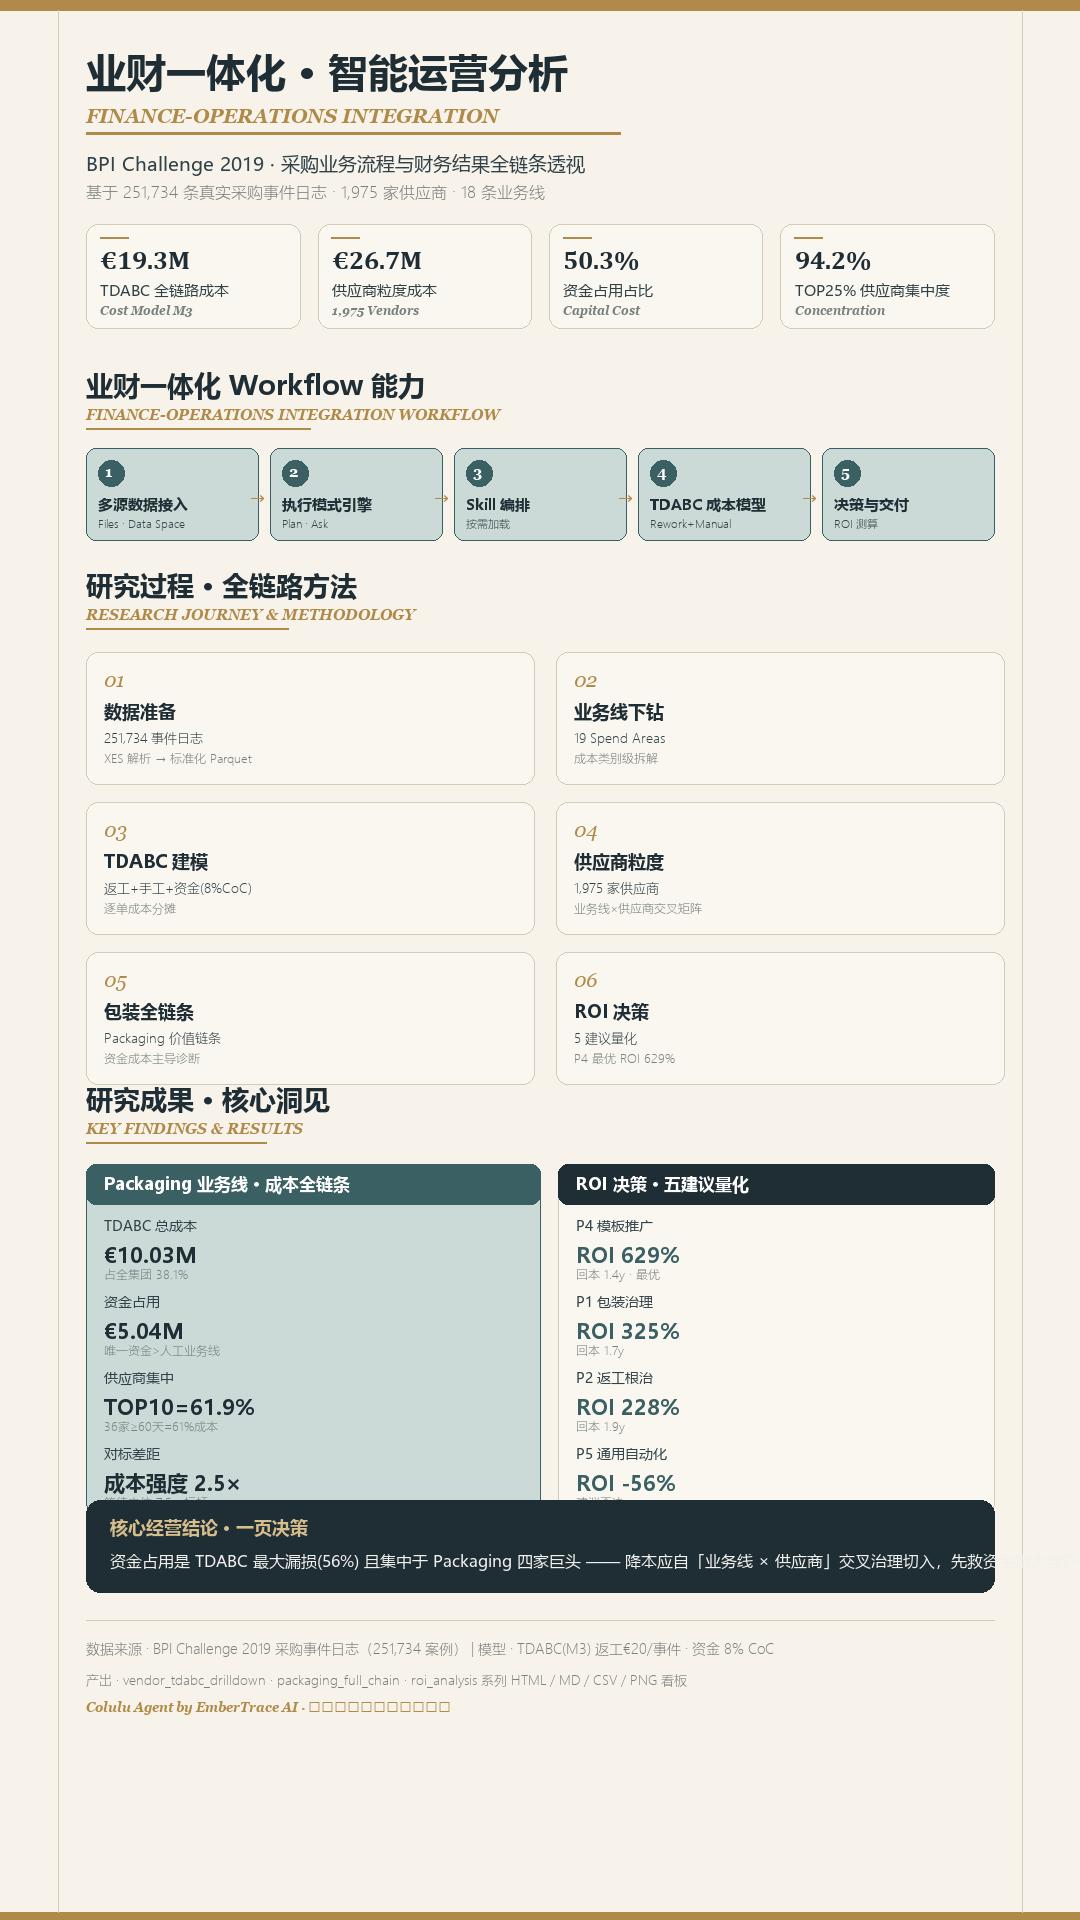
第一部分:Colulu Agents Workflow 是什么
本部分以 **BizFin Workflow(业财一体化经营管理分析工作流定义,
85ceb455-448a-4672-9009-488a65609d89)**为主线解剖------它是第二部分示例所对应的 Workflow 定义。其余 6 份作为对照,用来验证哪些机制是通用的、哪些是任务性质决定的。
1. 一句话定义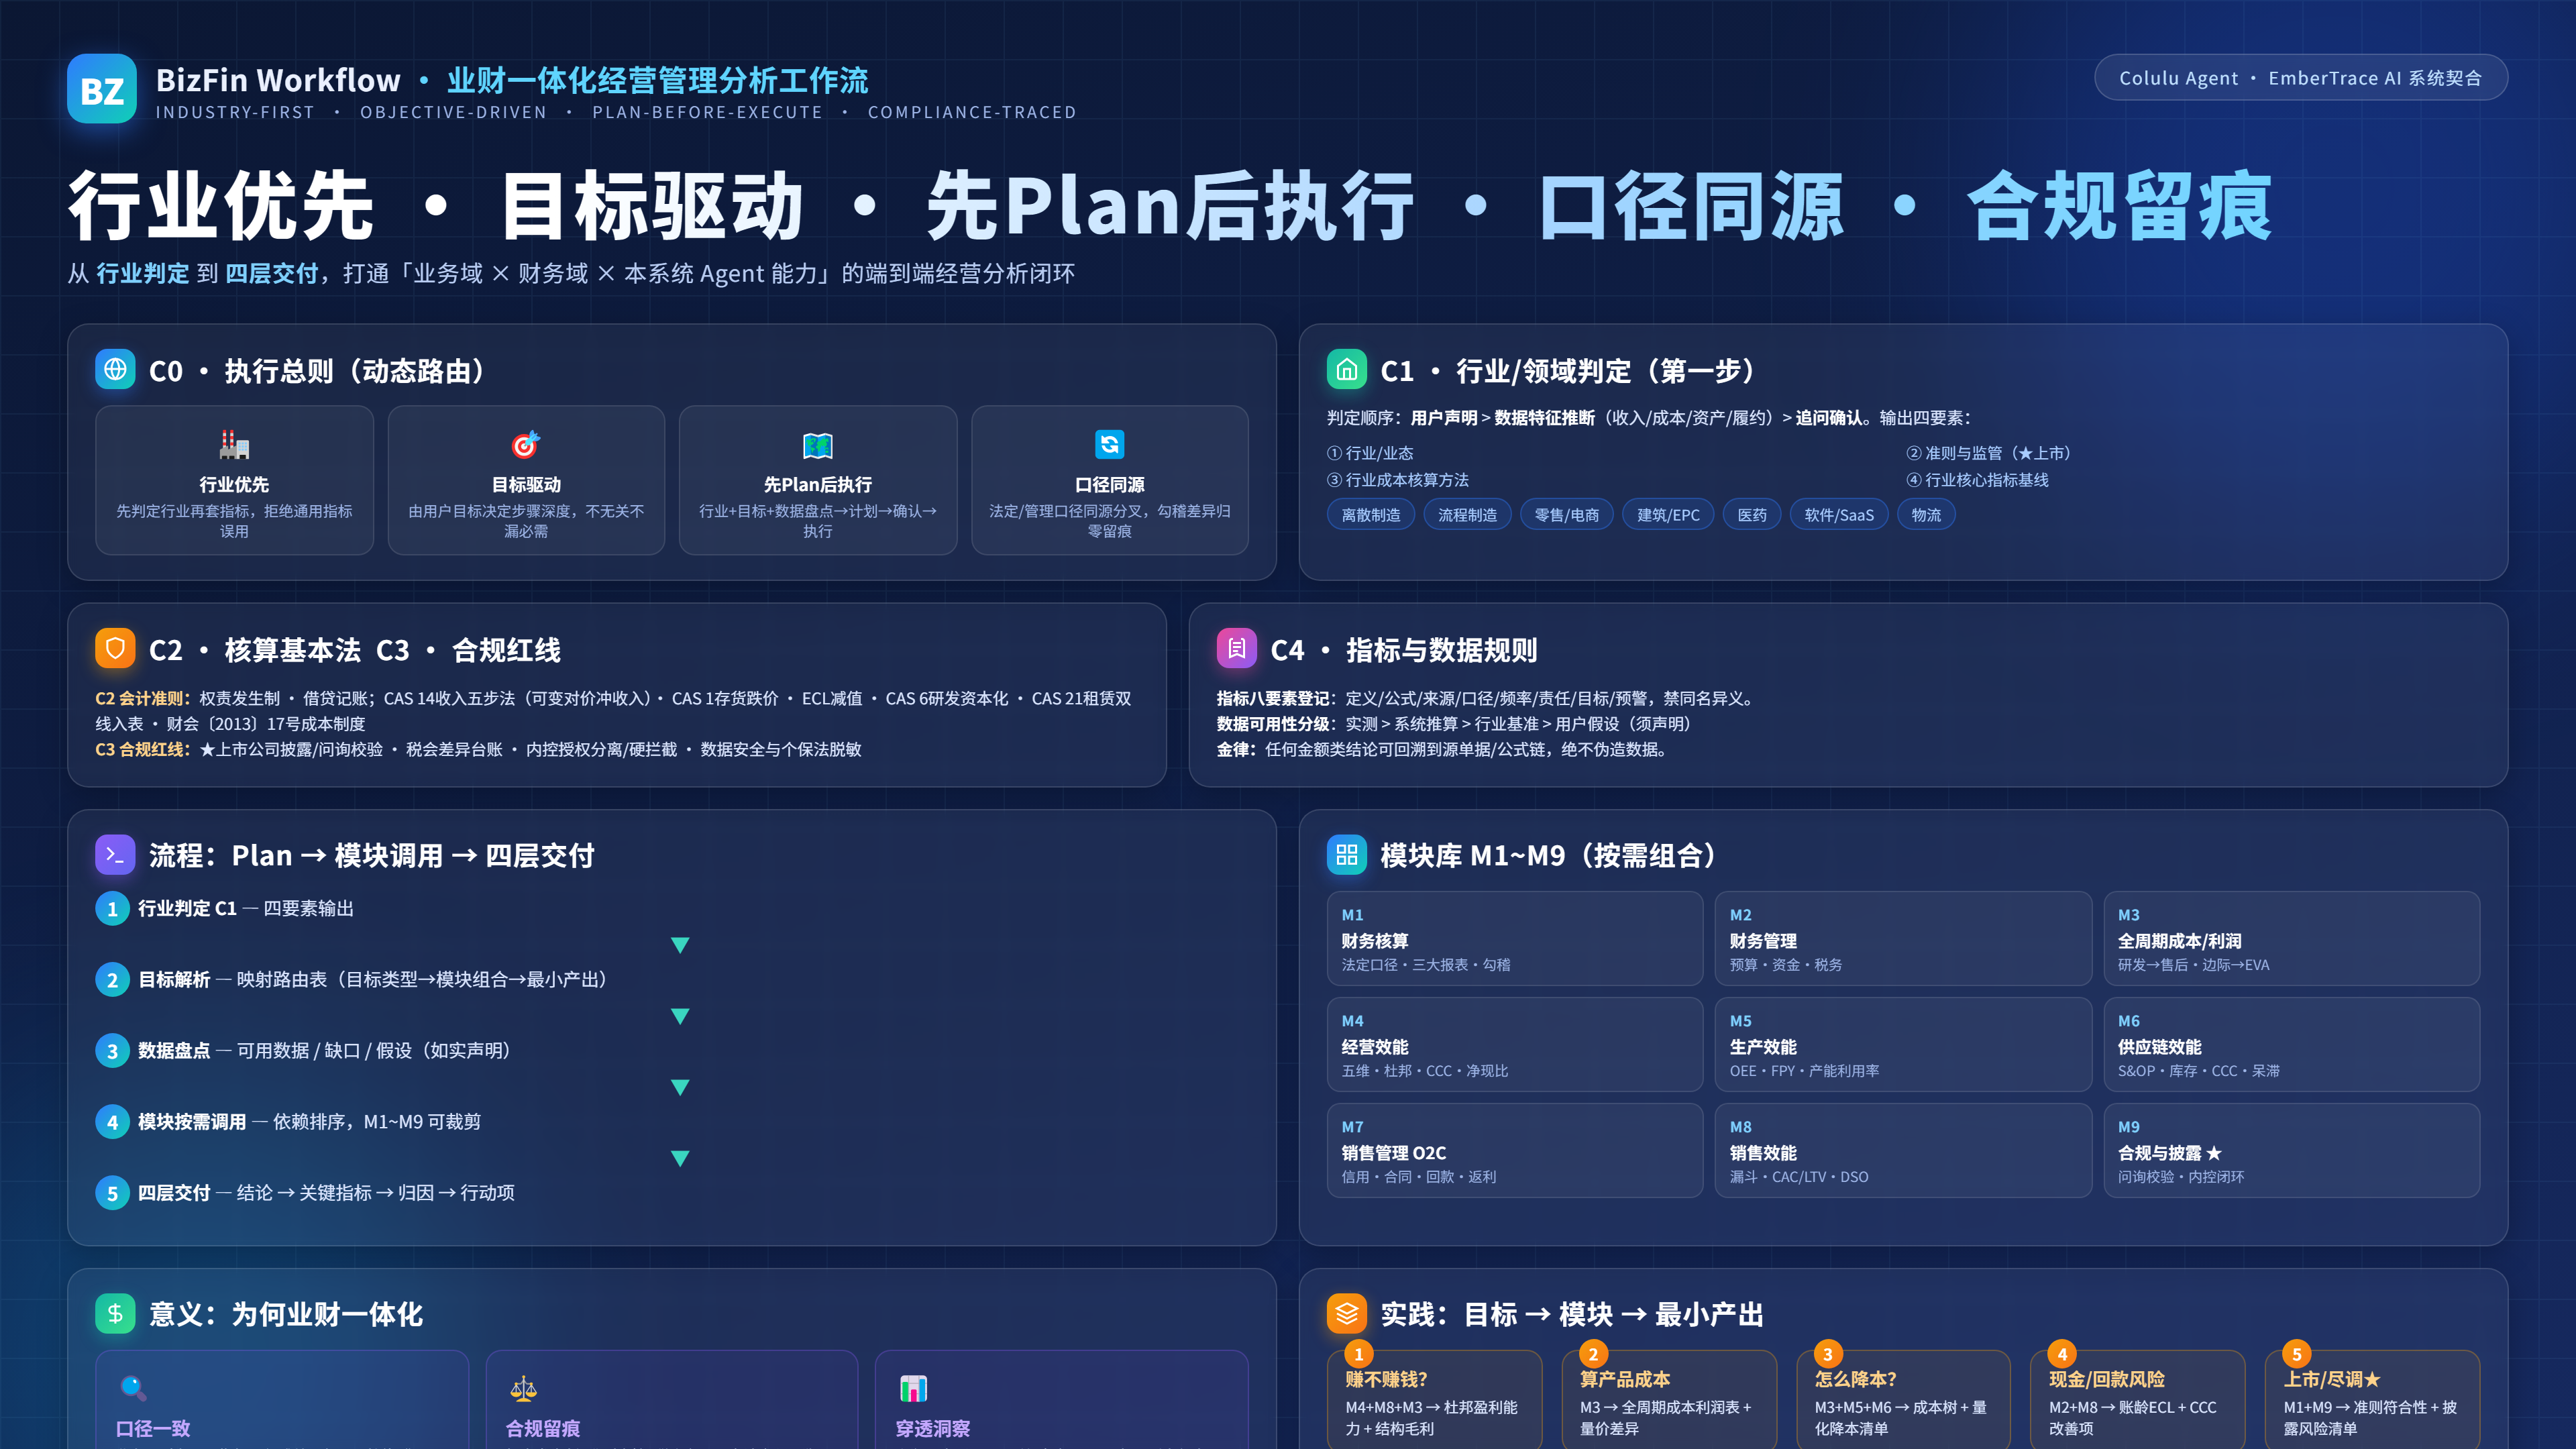
Colulu Agents Workflow,是把「一次成功的任务是怎么跑的」写成一份可版本化、可复用、可注入的 Markdown 规程文件,让 Agent 在每次会话开始时读取它,把它当作项目上下文与行为准则。
这句话里的每个限定词都不是装饰:
| 限定词 | 含义 | 反例(没有它会怎样) |
|---|---|---|
| 可版本化 | 有 workflowId + version + changes + createdAt,能追溯流程何时被改成了什么样 |
流程只在某人脑子里,改了没人知道 |
| 可复用 | 换任务/换行业/换数据,骨架仍在 | 每个新任务都从零摸索 |
| 可注入 | 引擎在会话开始时把它注入为持久化指令,而非人工复述 | 需要人先读一遍再转述,容易失真 |
| 持久化 | 区别于一次性 prompt,一次性 prompt 用完即弃 | 长任务中断后无法恢复 |
在 workflow-versions.json 里,这个定义有非常具体的落地形态。本文主线要讲的 BizFin Workflow(业财一体化经营管理分析工作流定义),它的版本记录长这样:
json
{
  "id": "...",
  "workflowId": "85ceb455-448a-4672-9009-488a65609d89",
  "version": 1,
  "content": "# BizFin Workflow(业财一体化经营管理分析工作流定义)\n\n## 第一部分 宪法(Constitution,不可违背层)\n...",
  "changes": "创建 workflow",
  "createdAt": "2026-09-17T03:31:53.912Z"
}
content 是整份 Markdown 文档的完整快照------不是 JSON 图、不是 DSL,就是人能读、能审、能 diff 的纯文本。这是个重要选择:规程的最高级形式是自然语言,不是配置。
而 BizFin 这份文档,全长 4,610 字符,是 7 份 Workflow 里最轻的一份。它没有阶段机、没有闸门、没有目录规范------却把一个完整经营管理分析体系装进去了。
本文就用这份最轻的文档当解剖对象 ,原因有二:一是它与第二部分的示例直接对应,读者能马上对上号;二是它证明了一件事------Workflow 的价值不在于长,而在于把该固化的事情固化下来。后面会看到,同一份 BizFin 的骨架能撑起 19 个采购类别、1,975 家供应商、五种成本模型和一份 ROI 投资决策。
2. 文档骨架:四段式结构
把 7 份 Workflow 的内容摊开看,会发现它们高度收敛于同一套骨架。最短的那份(新建 Workflow 模板 v1)只有 176 字符,恰好把这个骨架的四个槽位摆清楚了:
## 目标          ← 唯一交付定义
## 执行阶段      ← 分阶段拆解 + 阶段间依赖
   ### 阶段 1:...
## 产出要求      ← 明确文件名,可被机器校验
## 约束          ← 红线,防止跑偏
但 BizFin 走了一条不同的路。 它的四段不是上面这四段,而是:
## 第一部分 宪法(Constitution,不可违背层)   ← 相当于「目标 + 约束」,且优先级最高
## 第二部分 任务路由                            ← 相当于「执行阶段」,但形态是路由表
## 第三部分 模块库                              ← 相当于「阶段」的具体内容,但拆成可组合模块
## 第四部分 通用验收标准 ← 相当于「产出要求」,且是验收清单这个改动不是标新立异,而是由任务性质决定的。第二部分示例的分析是「月度经营分析」------这类任务的特点是:
- 每个月都会来一次,但问的问题不同(这次问降本,下次问现金流)
- 领域规则(会计准则、内控红线)不随任务变,但步骤应该变
- 如果强制按固定阶段跑,会做大量与本次问题无关的步骤
所以 BizFin 把「阶段」拆成了可按需组合的模块 ,把「目标」提升成了优先于一切流程的宪法。
下面逐段看,仍以 BizFin 为主线,其他 Workflow 作对照。
2.1 目标:只写一个,且必须是可交付物
先看三种目标的写法:
| Workflow | 目标原文 | 形态 |
|---|---|---|
| BizFin 业财一体化 | (宪法 C0)行业优先 / 目标驱动 / 先 Plan 后执行 / 口径同源 | 元规则:规定「怎么定目标」 |
| 深度研究流程 | 针对用户提出的研究问题,产出有出处、可复核的结构化研究报告 | 单一交付物 |
| 数据分析与校验流程 | 基于用户选定的数据空间,产出可信的分析结论与可复现的分析过程 | 交付物 + 过程可见 |
BizFin 的目标段和另外两份是不同类型的:另外两份定义「交付什么」,BizFin 定义「如何保证交付的东西是对的」。
C0 的四条规则,每条都在封一类错误:
| 规则 | 原文 | 防的是什么 |
|---|---|---|
| 行业优先 | 任何分析开始前必须先判定行业,产出物须标注行业适配口径;禁止跳过行业判定直接套用通用指标 | 拿制造业指标算服务业 |
| 目标驱动 | 执行哪些步骤、做到什么深度由用户问题/目标决定;不做与目标无关的步骤,不遗漏目标必需的步骤 | 机械跑全流程 |
| 先 Plan 后执行 | 行业判定 + 目标解析 + 数据盘点 → 生成 plan → 确认后执行;数据不足时显式声明假设,禁止编造数据 | 未对齐就开跑 |
| 口径同源 | 法定口径与管理口径同源分叉,勾稽差异必须归零并留痕;同名指标全流程唯一口径 | 同名不同义 |
注意「行业优先」的第一句:禁止跳过行业判定直接套用通用指标。这是一条元规则------它约束的不是「分析怎么做」,而是「在开始分析之前必须先做什么」。
对比一下没有目标段的写法:「帮我做采购成本分析」。这句话不是目标,因为它无法判定任务是否完成,也无法判定它是否跑偏了。
Workflow 的目标段必须回答两个问题:做到什么程度算做完?什么情况下算跑偏?
BizFin 用「宪法层」同时回答了这两个问题,且明确声明它优先于所有流程:
本部分为最高约束:无论用户目标为何、调用哪些模块,凡与本章冲突的口径、指标、结论一律无效;偏离须显式声明理由并留痕。
「偏离须显式声明理由并留痕」这七个字是精髓------它不禁止偏离,只禁止无声地偏离。
2.2 执行阶段:BizFin 的路由表形态
这是 BizFin 与其他 Workflow 差别最大的一段。先看它有多长:
markdown
## 第二部分 任务路由(根据用户目标决定步骤,不强制全流程)

### Plan 制定流程(每次任务的第一步)
① 行业判定(C1) → ② 目标解析(映射路由表) → ③ 数据盘点(可用数据/缺口/假设)
→ ④ 模块选择(从模块库按需组合,标明顺序与依赖) → ⑤ 与用户确认产出与验收标准

### 路由表(目标类型 → 模块组合 → 最小产出)
标题里那句 「根据用户目标决定步骤,不强制全流程」,是整个 BizFin 设计的定调。它明确拒绝了一种常见做法:把流程写死成一条直线,然后每次都从头跑到尾。
路由表本体:
| 用户目标类型 | 调用模块 | 最小产出 |
|---|---|---|
| "这家公司/业务赚不赚钱" | M4 + M8 + M3 | 盈利能力拆解(杜邦)+ 结构毛利 |
| "算某产品/订单/项目的成本利润" | M3 | 全周期成本利润表 + 量价差异 |
| "月度/季度经营分析" | M1→M4 + M5~M8(按行业取相关域)+ M9★ | 经营分析报告 + 红黄绿灯记分卡 |
| "怎么降本" | M3 + M5 + M6 | 成本结构树 + 降本机会清单(量化) |
| "应收/回款/现金流风险" | M2 + M8 | 账龄与 ECL 分析 + CCC 改善项 |
| "预算怎么做/为什么超支" | M2 + M4 | 预算预实差异归因 + 滚动预测 |
| "投资/尽调/上市准备★" | M1 + M9 | 准则符合性核查表 + 披露风险清单 |
| "生产/供应链效率怎么样" | M5 / M6 | 效能记分卡 + 瓶颈归因 |
| "销售团队/渠道效能" | M7 + M8 | 漏斗转化 + 客户/费效分析 |
这张表有三层信息,每层都不可省:
- 用户目标类型 ------ 用自然语言写,包含口语化表达(「怎么降本」),因为用户就是这么问的
- 调用模块 ------ M1...M9 的组合,且注明顺序依赖(
M1→M4) - 最小产出 ------ 这一列最关键,它规定了「做到什么程度算做完」
对照第二部分的实际任务,可以看出这张表是怎么被用起来的:
| 用户实际提问 | 命中的路由行 | 模块组合 |
|---|---|---|
| 「成本核算与流程效率成本」 | 「月度/季度经营分析」 | M1→M4 + M5~M8 + M9 |
| 「各个采购类别的成本下钻分析」 | 「月度/季度经营分析」+ 切片 | 同上,加维度下钻 |
| 「对比不同成本模型对经营的贡献」 | 「这家公司/业务赚不赚钱」 | M4 + M8 + M3 |
| 「将 M3 的降本建议做成 ROI 测算」 | 「怎么降本」 | M3 + M5 + M6 |
| 「落到单条业务线/供应商粒度」 | 「月度/季度经营分析」+ 粒度 | M3 下钻 |
| 「Packaging 全链条分析」 | 「月度/季度经营分析」+ 单对象 | M3 全周期口径 |
六轮追问全部落在这张表里,没有一轮需要跳出路由。 这说明路由表的设计覆盖了这个领域的高频提问类型。
而「最小产出」这一列恰好解释了第 9 轮追问(ROI)的合理性:用户问「怎么降本」,路由表说最小产出是「成本结构树 + 降本机会清单」------但用户嫌不够,要求加 ROI。这是对最小产出的合理超越,不是脱轨。
对照:其他三种阶段形态
BizFin 的路由表不是唯一的阶段形态。放在一起看,有四种:
形态 A:四阶段线性(轻量任务) ------ 深度研究流程
### 阶段 2:资料检索
- 优先使用已绑定的知识空间/数据空间
- 每个子问题至少 2 个独立来源
「每个子问题至少 2 个独立来源」------这不是描述,是可检验的判据。
形态 B:阶段机 + 闸门(重型任务) ------ AI4S 研究流程 v3,10 阶段 9 闸门
text
DISCOVERY → IDEATION → THEORY & NUMERICAL SCREENING → CONCEPT → DESIGN
→ [模型体系架构(可选)] → DEVELOPMENT → TEST
   ↑                                                          ↓
   └── 异常回退 ←── VALIDATION ←── OPTIMIZATION ←── SIMULATION ←────┘
text
推进纪律:每阶段结束必须提交阶段小结报告并在闸门处等待用户确认
          (Go / Revise / No-Go);**不自动流转**。
三个设计要点:异常回退被显式建模;闸门判据都指向一份必交文件(阶段小结报告);闸门处不自动流转。
形态 C:动态路由(重复业务/咨询类任务) ------ BizFin 用的就是这个
形态 D:智能体编排(多角色协同) ------ 生猪全产业链 workflow
| 智能体 | 职责 | 触发关键词 |
|---|---|---|
| 兽医健康 | 健康诊断与防治 | 症状、诊断、用药、疫苗 |
| 养殖管理 | 场线经营与生产调度 | 饲喂、环境、温度、批次 |
| 行情分析 | 价格预测与出栏决策 | 价格、行情、猪价、出栏 |
路由规则写得很具体:
- 跨环节任务 (如「这批猪该不该出栏」):路由至行情分析 + 养殖管理,行情输出价格预测和出栏窗口,养殖输出体重、健康状态和继续饲喂成本收益,经营分析汇总输出「出栏 vs 继续饲喂」决策建议。
四种形态的选择依据:
| 形态 | 适用 | 风险 |
|---|---|---|
| A 线性 | 一次性、轻量 | 步骤僵化 |
| B 阶段闸门 | 不确定性高、代价大 | 流程过重 |
| C 动态路由 | 重复性业务分析、按需组合 | 依赖模块清单维护质量 |
| D 智能体编排 | 需要多专业视角 | 协调复杂度高 |
BizFin 选 C 是对的------月度经营分析是重复发生的,且问题类型可枚举,用路由表覆盖比固定阶段机更经济。
2.3 产出要求:写出「可交付的样子」
这一段在 BizFin 里叫「第四部分 通用验收标准」:
- 符合宪法:C1 行业已标注;C2/C3 无违背;★项已校验(如适用)
- 口径:指标均有八要素登记;法定/管理口径勾稽差异 = 0
- 结论:每个异常指标有归因、有责任人/改善建议;假设与数据缺口已声明
- 交付:报告含【结论 → 关键指标 → 归因 → 行动项】四层结构
四条验收里,最有价值的是第三条和第四条。
第四条「四层结构」是一条可机械检查的报告规范:
| 层 | 回答什么 | 缺了会怎样 |
|---|---|---|
| 结论 | 发现了什么 | 读者得自己从数据里找 |
| 关键指标 | 凭什么这么说 | 结论不可信 |
| 归因 | 为什么会这样 | 知道了问题但不知道原因 |
| 行动项 | 该做什么 | 分析不落地 |
第三条则是本次示例最大的短板。 它要求「每个异常指标有归因、有责任人/改善建议」------本次分析做到了「有归因、有改善建议」,但几乎没有点名任何责任人(因为数据集里没有责任人字段)。这是一个诚实的缺口,但暴露了 Workflow 要求与数据现实之间的张力。
对比其他 Workflow 的产出要求写法:
轻量版 ------ 深度研究流程 / 数据分析流程
## 产出要求
- 报告文件:`research-report.md`
- 结构化证据表:`evidence.csv`(字段:子问题, 结论, 来源, 可信度)
重型版 ------ AI4S v3,把产物路径规范到目录级别
### 阶段 1:DISCOVERY 问题确立与知识盘点(Gate ①)
**必须输出**:`10-planning/research_question_profile.json`、
               `60-figures/asset_availability_report.html`、
               `10-planning/gap_report.md`、
`10-planning/stage-reports/stage-01-discovery.md`三种写法的差别在于产出被约束到什么粒度:
| 粒度 | 例子 | 适合 |
|---|---|---|
| 只说结构 | 「报告含四层结构」 | 咨询/分析类(BizFin) |
| 说文件名 | 「产出 research-report.md」 |
中等任务 |
| 说路径 + 校验 | 「10-planning/stage-reports/stage-01-discovery.md」 |
重型流水线(AI4S) |
为什么文件名重要? 因为它把「产出」从主观描述变成了可检查的存在性命题。任务结束时,引擎只要检查这几个文件在不在、内容是否符合结构,就能判断阶段是否真的完成。这比问 Agent「你完成了吗」可靠得多。
而 AI4S 的目录规范更进一步,把过程产物与结果产物分离:
text
work/
├── 00-context/          # 知识检索、数据查询、文献 PDF、附件快照
├── 10-planning/         # 需求/验收标准/假设/协议/TRL/阶段小结报告
├── 30-experiments/      # 试验矩阵、用例、code/、data/、batch-cases/
├── 40-results/          # 指标汇总、敏感性分析、优化结论、最优参数
├── 50-reports/          # 研究报告、仿真/验证/批量仿真报告、湿实验协议
├── 60-figures/          # 框架图、信息图、关键结果图
└── 90-final/ # 交付索引、执行摘要、关键发现、核心结果、最终报告配套一条纪律------「过程产物(00--30)随迭代持续写入,作为审计证据与科研记忆;结果产物(40--90)无证据不入库」。
这条「无证据不入库」的原则值得抄进任何 Workflow。 它挡住的是「结论先行、证据后补」。
2.4 约束:写红线,而不是写鼓励
约束段是 Workflow 里最短但最重要的部分。它的作用不是告诉 Agent「要努力」,而是提前封死它最可能犯的错。
BizFin 把这一层提到了最高优先级(称为「宪法」),并做了分层:
| 子节 | 内容 | 性质 |
|---|---|---|
| C0 执行总则 | 四条元规则 | 方法论层 |
| C1 行业判定 | 判定顺序 + 四要素输出 + 7 行业对照表 | 领域层 |
| C2 核算基本法 | 权责发生制、收入五步法、存货、减值、研发、租赁 | 准则层 |
| C3 合规红线 | 上市公司问询高发项、税法、内控、数据安全 | 监管层 |
| C4 指标与数据规则 | 指标八要素、数据可用性分级 | 口径层 |
C1 的「判定输出四要素」是个极好的设计------它把「判断行业」从一个模糊动作变成了一个有明确交付物的动作:
- 行业/业态
- 适用准则与监管(是否上市公司★)
- 行业成本核算方法
- 行业核心指标基线
判定顺序也被写死了:用户明确声明 > 数据特征推断 > 向用户追问确认。三级优先,明确不含糊。
C2 和 C3 则把专业红线固化成了清单。 C3 里有一句尤其见功力:
上市公司★ :定期报告时限、业绩预告触发、关联交易与重大交易审议分级、募集资金专户;收入确认激进、研发资本化率异常、毛利率异常波动、净现比长期背离为问询高发项,必须强制校验。
这四项恰好是财务舞弊的经典特征。一份 Workflow 提前把它们列为强制校验项,说明作者清楚这份文档会被用来做真实的披露前核查,而不只是写个分析报告。
C4 是通用性最强的一节,建议直接抄走:
### C4. 指标与数据规则
- 指标登记八要素:定义/公式/来源系统/统计口径/更新频率/责任部门/目标值/预警规则,禁止同名异义
- 数据可用性分级:实测数据 > 系统推算 > 行业基准 > 用户假设(须声明);
  结论须标注所依赖的数据等级
- 任何金额类结论必须可回溯到源单据或公式链「数据可用性分级」承认了一件事:结论的基础强度不一样,而且必须说出来。本次业财分析里所有成本数字都依赖三个管理假设(€40/h、0.5h/次、8% CoC),按 C4 属于最后一级「用户假设」,结论标注就该更保守。
「任何金额类结论必须可回溯到源单据或公式链」这条,正是第 13.3 节会遇到的「口径漂移」问题的解药。
横向对比其他 Workflow 的约束,能看到一个高度一致的共性:
| Workflow | 约束原文 | 防的是什么 |
|---|---|---|
| BizFin C0 | 偏离须显式声明理由并留痕;执行中数据不足时显式声明假设,禁止编造数据 | 编造 + 无声偏离 |
| BizFin C4 | 任何金额类结论必须可回溯到源单据或公式链 | 无法追溯的数字 |
| 深度研究流程 | 严禁编造数据或来源;无法获取时明确写「未找到可用来源」 | 编造来源 |
| 数据分析流程 | 数据必须来自真实查询结果;不得用「假设数据」或模拟结果替代真实查询 | 编造数据 |
| 代码审查流程 | 先给结论清单,再给细节;不确定的判断必须标注 | 过度自信 |
| AI4S v3 | LLM 不得自评物理结果;缺项必须明示,不得伪造交付 | 自评 + 伪造交付 |
| 生猪全产业链 | 严禁输出未脱敏的猪场核心经营数据;诊断须标注「辅助诊断建议」;行情预测须附置信区间 | 数据泄露 + 过度自信 |
几乎每一条都在防「编造」和「过度自信」。 这是 LLM 做分析类任务最典型的两种失败模式------一个是无中生有,一个是把猜测说得像结论。
3. BizFin Workflow 全貌:4,610 字符装下什么
前两节讲的是通用机制。这一节完整拆 85ceb455-448a-4672-9009-488a65609d89 这份 BizFin Workflow(业财一体化经营管理分析工作流定义)------它正是第二部分示例所对应的 Workflow 定义。
先给一个规模感:全文 4,610 字符,是 7 份 Workflow 里最轻的。对比一下 AI4S 研究流程 v3 有 15,608 字符、BizFin 少了 70%。
但把第二部分的产出摊开看:19 个采购类别的成本全景、5 种成本模型的横向对比、1,975 家供应商的 TDABC 明细、5 条降本建议的 ROI 测算、1 条业务线的全链条剖析。
4,610 字符撑起了这些。 这就是本节要说明的核心问题------Workflow 的价值不在于长,而在于它把哪些东西前置固化了。
3.1 第一部分:宪法(不可违背层)
> 本部分为最高约束:无论用户目标为何、调用哪些模块,凡与本章冲突的口径、
> 指标、结论一律无效;偏离须显式声明理由并留痕。「宪法」这个命名不是修辞,它定义了这一层的三条属性:最高约束、与流程无关、违背需留痕。
第 2.4 节已经逐条讲过 C0--C4 的内容,这里补一个更结构化的视角------这五节构成一个完整的「会计分析前置检查清单」:
| 子节 | 回答的问题 | 对应实际会犯的错 |
|---|---|---|
| C0 执行总则 | 这次分析该按什么原则做 | 用错方法论 |
| C1 行业判定 | 用哪套行业指标 | 拿通用指标套所有行业 |
| C2 核算基本法 | 会计准则怎么说 | 会计处理违规 |
| C3 合规红线 | 监管盯什么 | 触发问询/处罚 |
| C4 指标与数据规则 | 这个数字能信到什么程度 | 数字不可追溯 |
这五节的顺序不能颠倒。 行业判定在核算基本法之前,因为成本核算方法本身取决于行业(C1 的对照表里「成本核算方法」是一等公民)。合规红线在核算之后,因为它是「算完之后再检查一遍」的动作。
而 C4 放在最后,因为它管的是所有前面产出的数字------包括 C1--C3 产生的中间量。
3.2 第二部分:任务路由
### Plan 制定流程(每次任务的第一步)
① 行业判定(C1) → ② 目标解析(映射路由表) → ③ 数据盘点(可用数据/缺口/假设)
→ ④ 模块选择(从模块库按需组合,标明顺序与依赖) → ⑤ 与用户确认产出与验收标准
这个 Plan 五步是不分领域的通用起手式。第 2.2 节已经展示了路由表和六轮任务的对应关系,这里不再重复。
3.3 第三部分:模块库 M1--M9
9 个模块,每个模块内部写明「步骤 → 产出 → 验收」:
| 模块 | 核心步骤 | 验收标准 |
|---|---|---|
| M1 财务核算(法定口径) | 单据驱动记账 → 收入确认 → 减值计提 → 成本归集 → 税会差异 → 期末结账 → 报表 | 业务=库存=总账三方对账差异为 0 |
| M2 财务管理 | 全面预算(编制→刚性控制→预实分析→滚动预测)/ 资金(13 周滚动预测→头寸→银企对账)/ 税务 | 预算偏差率 <5%,超支 100% 事前拦截 |
| M3 全周期成本/利润核算 | 研发(费用化/资本化划分)→ 采购(价差分离)→ 生产(料工费+差异四分)→ 仓储物流(含资金占用机会成本)→ 销售(返利冲收入、质保预提)→ 售后/退市 → 项目制 | 利润可穿透 SKU/订单/客户/项目,与总账勾稽一致 |
| M4 经营效能分析 | 盈利(毛利率/净利率/ROE 杜邦分解/扣非占比★)/ 营运(周转率、CCC)/ 偿债 / 成长 / 现金流(净现比 ≥0.8~1) | 标准归因动作:异常 → 量价拆解 → 维度下钻 → 内外归因 → 责任到中心 → 改善项 |
| M5 生产效能 | OEE(稼动×性能×质量)、产能利用率、人均产值、物耗/超领率、一次合格率 FPY、质量成本四分类、计划达成率 | 每个瓶颈指标有归因与改善项 |
| M6 供应链管理与效能 | 计划(预测准确率→S&OP)→ 采购(供应商 QCDS 评分、DPO)→ 库存(ABC-XYZ、库龄、呆滞处置)→ 物流(OTD、运费)→ 总控(CCC、完美订单率) | 呆滞占比、CCC 纳入红黄绿灯并有处置结论 |
| M7 销售管理(O2C) | 客户分级 → 信用评估(财务一票否决)→ 合同三线评审 → 报价折扣矩阵 → 订单交付 → 开票确认收入 → 回款催收 → 返利结算 | --- |
| M8 销售效能 | 收入达成与结构、客户维净毛利(扣返利/运费/佣金)、费用 ROI、漏斗转化率与销售周期、CAC/LTV(≥3)、DSO 与逾期率、★大客户集中度 | --- |
| M9 合规与披露检查★(上市公司必选) | 问询高发项强制校验(收入确认、研发资本化、减值、毛利率、净现比、关联交易);披露时限与时点管理 | 披露项零缺陷,问题项全部有整改责任人与时限 |
M3 是本次示例真正用到的那一个,值得单独拆开。 它的「阶段按行业裁剪」写了一条完整链路:
研发(费用化/资本化划分)→ 采购(价差分离)→ 生产(料工费+差异四分)
→ 仓储物流(含资金占用机会成本)→ 销售(返利冲收入、质保预提)→ 售后/退市 → 项目制(时段法)
「仓储物流(含资金占用机会成本)」 ------这七个字,就是第二部分 M3 模型的制度依据。第二部分算出的 €7.89M 瓶颈资金成本,本质上就是「仓储物流」这一段里被显式声明要计入的「资金占用机会成本」。
再看 M3 的验收标准:
利润可穿透 SKU/订单/客户/项目,与总账勾稽一致
「可穿透」三个字定义了成本核算的合格线。 一个不能穿透到 SKU 和订单的成本表,在决策上没有用------因为你没法说「降哪一条线的成本」。
第二部分的六轮追问,其实就是在逐级验证这条验收标准能否满足:
| 轮次 | 追问 | 穿透到了哪一层 |
|---|---|---|
| 1 | 三大成本来源量化 | 流程环节级 |
| 2 | 采购类别下钻 | 19 个 Spend Area |
| 3 | 五模型对比 | 方法论级 |
| 4 | ROI 测算 | 投资决策级 |
| 5 | 供应商粒度 | 单条业务线 × 单个供应商 |
| 6 | Packaging 全链条 | 单业务线的完整价值链 |
从环节 → 类别 → 供应商 → 单业务线全链条,这正是 M3 验收标准里「SKU/订单/客户/项目」的完整穿透路径。
M4 的「标准归因动作」也是一份可直接抄的清单:
异常 → 量价拆解 → 维度下钻 → 内外归因 → 责任到中心 → 改善项六步,从「发现异常」到「落到责任人」。第二部分的分析做到了前五步,第六步的责任人因数据中没有该字段而无法完成------这一点第 13.3 节会提到。
M8 里的两个硬指标也值得注意:CAC/LTV(≥3) 和 ★大客户集中度。前者是 SaaS 通行标准,后者被打星号(★)意味着它是必查项------呼应第二部分发现的「TOP 25% 供应商承载 94.2% 成本」这类集中度风险。
3.4 第四部分:通用验收标准
- 符合宪法:C1 行业已标注;C2/C3 无违背;★项已校验(如适用)
- 口径:指标均有八要素登记;法定/管理口径勾稽差异 = 0
- 结论:每个异常指标有归因、有责任人/改善建议;假设与数据缺口已声明
- 交付:报告含【结论 → 关键指标 → 归因 → 行动项】四层结构
第 2.3 节已经逐条讲过,这里补一个反向视角------拿第二部分的实际交付对照,看哪些达标、哪些没达标:
| 验收项 | 本次示例 | 判定 |
|---|---|---|
| C1 行业已标注 | 制造业采购(BPI 2019 是化工制造企业采购);三单匹配/两单匹配口径贯穿全文 | ✅ 达标 |
| C2/C3 无违背 | 未涉及收入确认/研发资本化等会计处理;未涉及披露 | ✅ 不适用 |
| ★项已校验 | 无上市公司披露场景 | ✅ 不适用 |
| 指标八要素登记 | ❌ 未做。三个成本假设分散在各脚本顶部,无统一登记 | ❌ 不达标 |
| 勾稽差异 = 0 | ⚠️ 存疑。同一「M3 总成本」出现 6 个数值 | ❌ 不达标 |
| 异常指标有归因 | ✅ 每个成本项都追到了流程原因(3-way match、自动化缺口等) | ✅ 达标 |
| 有责任人/改善建议 | ⚠️ 改善建议充分,责任人全部缺失(数据中无此字段) | ⚠️ 部分 |
| 假设与数据缺口已声明 | ✅ 每份报告末尾都有「局限与如实说明」 | ✅ 达标 |
| 四层报告结构 | ✅ 5 份报告均为「结论→指标→归因→行动」 | ✅ 达标 |
这张自查表很有说服力 :业务层面的验收项基本达标,口径层面的两项全部不达标。
而这两项恰恰对应宪法 C0 第 4 条「同名指标全流程唯一口径」和 C4 的「指标登记八要素」。Workflow 写了规则,但执行时没有对照检查。 这是第 13 节要展开的核心问题。
3.5 工具门控
- 分析类:indicator_search / indicator_compute / attribution / forecast / budget_check
- 核算类:voucher_generate / cost_allocate / reconciliation / period_close
- 溯源与决策:research_graph / research_decision_gate
三类工具对应三个用途,且工具名与模块库一一呼应:
| 工具 | 归属模块 | 用途 |
|---|---|---|
cost_allocate(成本分摊) |
M3 | 成本池分摊到对象 |
reconciliation(对账) |
M1 | 三方对账 |
attribution(归因) |
M4 | 异常归因 |
budget_check(预算校验) |
M2 | 预算控制 |
indicator_compute(指标计算) |
全局 | 指标登记表的计算入口 |
research_graph |
全局 | 把结论回连到证据 |
research_decision_gate |
全局 | 在决策点停下来问人 |
最后两个尤其重要。research_decision_gate 和 AI4S Workflow 的「闸门处不自动流转」是同一个机制在不同领域的表达------工具名不同,但都是「在关键决策点强制人工确认」。
research_graph 则对应 BizFin 第四部分那条「任何金额类结论必须可回溯到源单据或公式链」------它把这条要求做成了工具。
3.6 一句话总结 BizFin Workflow 的设计思路
宪法管「什么是错的」,路由管「这次该做什么」,模块管「怎么做」,验收管「做到什么程度」。四层正交,任何一层都能单独演进而不牵动其他三层。
这个「四层正交」的设计,和第二部分六轮追问的实际推进路径高度吻合:
宪法(C0--C4)贯穿全程:口径、假设、诚实声明
   ↓
路由决定每轮调哪些模块:M3 / M3+M5+M6 / M4+M8+M3 / ...
   ↓
模块内的「步骤 → 产出 → 验收」在每一轮被执行
   ↓
第四部分验收清单在每份报告交付前自查
回头看 AI4S Workflow 走的是「阶段越细越好」(10 阶段 9 闸门),BizFin 走的是「按需组合」(9 模块动态路由)。前者的风险是流程过重,后者的风险是依赖模块清单维护得足够好------第 3.4 节那张自查表就是后者风险的具体表现。
两种设计的共同点是:都在真实使用中演化出了自己的形态。 BizFin 只有 v1,说明它目前还没经历足够的迭代来发现问题------而这恰恰是版本化机制要解决的事(见下一节)。
4. 引擎如何「读」这份 Markdown:解析约定
到这里为止,Workflow 看起来只是一份写得好的 Markdown。但它并不只是给人读的------这份文档是被程序解析的。
最明确交代这件事的是 AI4S v3 开头:
引擎解析约定(决定阶段进度条与阶段建议):
- 本文档的
### 阶段 N:标题会被解析为阶段清单 ,- [ ] Phase N进度行由引擎初始化;- 阶段内反引号包裹的产物文件名为该阶段必须输出;
建议 Skill: a, b行为该阶段的候选技能(优先级高于引擎内置表)。
这三条约定把自然语言和引擎行为做了绑定:
| Markdown 写法 | 引擎行为 |
|---|---|
### 阶段 1:DISCOVERY 问题确立 |
解析为阶段清单项,渲染成进度条第 1 行 |
反引号包裹的 10-planning/gap_report.md |
登记为该阶段必须输出,阶段结束时校验存在性 |
建议 Skill: research-planning, gap-analyzer |
该阶段可用技能候选,优先级高于引擎内置表 |
第三条尤其关键------它意味着领域专家可以覆盖引擎的默认技能推荐。写 Workflow 的人只要在某一行加上「建议 Skill: b-design-primer, sci-report」,引擎在为该阶段装载技能时就会优先考虑这两个,而不是它内置的通用清单。
于是,一份 Workflow 实际上在做四件事:定义流程结构(阶段)+ 定义完成标准(产物 + 闸门)+ 定义能力供给(Skill)+ 定义边界(约束)。
BizFin 用另一种方式做了同样的事。 它没有阶段机,所以不需要 ### 阶段 N 这样的解析标记;它靠的是约定结构:
| BizFin 的写法 | 对应的引擎行为 |
|---|---|
| ` | 用户目标类型 |
### M3 全周期成本/利润核算 + **验收**:... |
识别为模块定义及其合格线 |
★ 标记(如「上市公司★」「M9★」) |
标记为强制校验项 |
① ② ③ ④ ⑤ 编号箭头链 |
识别为有序 Plan 步骤 |
关键区别:AI4S Workflow 显式声明了「请按这个规则解析我」,BizFin 则依赖约定的通用结构。前者更明确但写起来更啰嗦,后者更简洁但依赖解析器足够聪明。
顺带一提,AI4S v3 顶部还写了一段「层级分界」,说明了这套规程与引擎其他部分的分工:
层级 :规程层 ------ 回答「这次 AI4S 任务怎么做」,是流程的唯一来源。
分界 :真实性与安全底线见身份层
colulu.md;通用判断与交付原则见宪法层soul.md;模式指令、指令优先级、技能检索与使用协议、空间范围规则、记忆与工具清单由引擎按会话注入 ------ 本文档不重复。
四层划得很清楚:
| 层 | 文件 | 回答什么问题 | 本文的 BizFin 对应物 |
|---|---|---|---|
| 身份层 | colulu.md |
我是谁,真实性与安全底线是什么 | --- |
| 宪法层 | soul.md |
通用判断与交付原则 | --- |
| 规程层 | Workflow content |
这次任务怎么做 | BizFin 全文 |
| 引擎层 | 会话注入 | 技能怎么检索、工具清单、记忆机制 | 「工具门控」是显式声明的例外 |
这里有一个值得注意的差异。 AI4S v3 明确把「宪法」交给外部的 soul.md,Workflow 内不重复;而 BizFin 恰恰把「宪法」放进了自己文档的第一部分。
两种选择各有代价:
| AI4S(宪法外置) | BizFin(宪法内置) | |
|---|---|---|
| 优点 | 宪法统一,改一处全局生效 | 自包含,脱离环境也能读懂 |
| 缺点 | 宪法内容不在文档内,读文档的人看不到全貌 | 宪法与流程耦合,改宪法可能牵动流程 |
对本次示例来说,BizFin 的选择是对的。 第二部分的分析场景是自包含的------数据集、分析脚本、产出目录都在同一个任务工作区内,不依赖任何外部环境。如果这份 Workflow 依赖外部 soul.md 才能成立,它就没法被独立带走。而现在,读者拿到这 4,610 字符就能完整理解「这次分析该怎么做」。
5. 版本化:Workflow 是有生命周期的资产
workflow-versions.json 里共 9 条版本记录、7 个 Workflow。先看全景:
| Workflow | workflowId(前 8 位) | 版本数 | 字符数 | 领域 | 编排形态 |
|---|---|---|---|---|---|
| BizFin 业财一体化 | 85ceb455 |
1(v1) | 4,610 | 经营管理 | 动态路由 + 模块库 ← 本文主线 |
| AI4S 研究流程 | 288c408c |
3(v1→v2→v3) | 176 → 12,415 → 15,608 | 科研仿真 | 阶段机 + 9 闸门 |
| AI4S 行动指南 v11 | 18744844 |
1 | 7,888 | 科研仿真(升级) | 8 阶段 + 算-干-湿三元验证 |
| 生猪全产业链助手 | a82b4d6c |
1 | 6,124 | 行业经营 | 7 智能体 + 自动路由 |
| 深度研究流程 | 8b0a209c |
1 | 452 | 研究 | 4 阶段线性 |
| 数据分析与校验流程 | 521a24b0 |
1 | 419 | 数据 | 4 阶段 + 工具调用顺序 |
| 代码审查流程 | 3064236b |
1 | 354 | 工程 | 4 阶段 + 风险分级 |
| (另有 v1 骨架模板) | 288c408c |
已含上述 v1 | 176 | --- | 空模板 |
这张表里最值得注意的一行,是 BizFin 只有 v1。
5.1 一个反问:BizFin 为什么还没迭代?
第 3.4 节那张自查表给出了答案------这份 v1 已经暴露了明确的问题:
| 验收项 | 状态 | 需要的迭代 |
|---|---|---|
| 指标八要素登记 | ❌ 未做 | v2 应补一张指标登记表,固定三条成本假设的定义位置 |
| 同名指标唯一口径 | ❌ 6 个数值并存 | v2 应加一张口径对照表(详见附录 B) |
| 每个异常指标有责任人 | ⚠️ 缺失 | 数据中无责任人字段 → v2 应允许「责任人不可得」显式声明 |
| 图表口径标注 | ⚠️ 不完整 | v2 应规定每张图必须标注覆盖范围与假设 |
也就是说,BizFin 的 v1 跑完一轮之后,缺口是清楚的。 这恰恰说明版本化机制的存在是有意义的------但它也提醒我们:Workflow 不是写完就完了,它需要跟着任务的暴露持续修订。
下面用 AI4S 那条三版本演进线作为对照,说明一个成熟的 Workflow 版本迭代会长什么样。
5.2 对照:AI4S 的 v1 → v2 → v3 演进
| v1 | v2 | v3 | |
|---|---|---|---|
| 字符数 | 176 | 12,415(×70) | 15,608(+3,193) |
| 阶段数 | 3 | 10 | 10 + 新增阶段 2.5 |
| 闸门 | 无 | 9 道,每道有判据表 | 10 道(新增 ②′) |
| 产出要求 | 「产出物清单与命名规范」 | 逐阶段列出具体文件路径 | 同 v2 + 理论目录 |
| 工具门控 | 无 | 3 类注册表协议 | 4 类(新增理论模型注册表) |
| 交付物规格 | 无 | 20+ 行规格表 + 三格式标准 | + 理论初筛报告 |
| 平台工程 | 无 | React + FastAPI 目录与部署 | + 理论模型接口 |
v1 长这样,本质是个空模板:
markdown
# 新 Workflow

## 目标
- 明确要达成的结果

## 执行阶段
### 阶段 1:理解与准备
- 明确输入、约束与验收标准
### 阶段 2:执行
- 按步骤推进,每步说明产出
### 阶段 3:校验与交付
- 自检产出是否符合验收标准

## 产出要求
- 产出物清单与命名规范

## 约束
- 禁止事项 / 必须先确认的事项
v1 → v2:从骨架到工程化。 扩成 12K 字符,加入状态机、闸门表、三级供给链、工作目录规范、交付物规格表、仿真平台工程规范。这个 70 倍的膨胀,是「把一次成功的实践完整记录下来」的体量------作者是先跑通了任务,再回头把跑的过程写成规程。
v2 → v3:补领域纵深。 增量不是重写,而是插入一条全新阶段:
v2: DISCOVERY → IDEATION → CONCEPT → DESIGN → [模型体系架构] → DEVELOPMENT → TEST → ...

v3: DISCOVERY → IDEATION → THEORY & NUMERICAL SCREENING → CONCEPT → DESIGN → ...
                              ↑ 阶段 2.5(Gate ②′)
新增的「阶段 2.5:理论建模与数值初筛」要求产出十个文件:
必须输出:
- 10-planning/stage-reports/stage-02.5-theory-screen.md
- 20-modeling/theory/control-equations.md          # 控制方程
- 20-modeling/theory/assumptions-and-validity.md   # 假设与适用域
- 20-modeling/theory/numerical-scheme.md            # 数值方案
- 20-modeling/theory/theory-parameter-table.csv     # 理论参数表
- 20-modeling/theory/benchmark-validation.md       # 基准验证
- 20-modeling/theory/registry-entry.json           # 注册条目
- 20-modeling/theory/platform-interface.json       # 平台接口
- 40-results/theory-screening-results.json         # 初筛结果
- 50-reports/theory-screening-report.md            # 初筛报告
同时新增一个注册表层级:
| v2 的三级供给链 | v3 的四级 |
|---|---|
知识空间 search_space / view_space_wiki |
同 |
数据空间 list_data_sources / query_data |
同 |
物理模型 model_search / model_propose |
同 |
ML 代理 ml_model_search |
同 |
自研求解器 solver_search |
同 |
| --- | 理论/解析模型注册表 theory_model_search / theory_model_propose |
以及一条新规则:
理论模型 / 数值计算体系同样执行「先检索后建模、先注册后使用」 :解析模型、半解析模型、降阶模型、自研数值求解器必须先查理论/解析模型注册表与求解器注册表;确需新建时走
theory_model_propose/solver_propose,并标注来源、假设、适用域与基准验证。
这条演进路径本身就是版本化价值的最好说明 :版本的差异不是措辞调整,而是领域认知深化的痕迹。作者第一次跑时认为三类注册表够了;跑过一轮后发现,解析模型/降阶模型这类「介于公式和仿真之间」的东西没有归属,于是补上第四类,并给它配了一整套强制产出。
这种迭代只有跑过真实任务才会发生。 设计不出来的。
5.3 如果 BizFin 要出 v2,会改什么?
按第 3.4 节的自查表和第 13 节的复盘,BizFin v2 最该补的是口径治理------这也是第二部分暴露最多的问题:
markdown
## 口径治理(v2 新增)

### 指标登记表(首次出现时定义,此后只引用不重定义)
| 指标名 | 口径定义 | 计算范围 | 首次定义位置 |
|---|---|---|---|
| 流程效率总成本(全局) | 返工+人工+瓶颈资金 | 全部 trace | cost_metrics.json |
| TDABC 总成本(供应商级) | 同上 + 资金按全采购额重算 | 全部供应商 × 全采购额 | vendor_tdabc_metrics.json |

- 同一指标出现多值时,必须在报告显著位置给出差异说明与差额
- 每张图必须标注:数据口径、费率假设、覆盖率范围、样本定义
- 图表数据必须来自完整集合;使用子集时须注明子集规则以及一份环境前置检查------把踩过的坑挡在流程之外(详见第 13.3 节的踩坑清单):
markdown
## 环境前置检查(阶段 0)
- 确认 Shell 语法与解释器可用方式,禁止混用不同 Shell 的语法
- 确认大文件的解析策略(流式 / 分片),禁止一次性全量载入
- 确认读文件工具与命令行的路径基准一致,统一使用绝对路径
- 确认数据文件与产物的目录归属,避免产出落错位置
这类检查的价值与业务知识无关,却恰恰是最容易重复踩的。 它应该和「指标登记表」一样,在 v1 就写进去。
5.4 其他 Workflow 的场景谱系
| Workflow | 领域 | 特征 |
|---|---|---|
| BizFin 业财一体化 | 经营管理 | 宪法/路由/模块/验收四段,M1--M9 模块库 |
| AI4S 研究流程 v3 | 科研仿真 | 10 阶段 9 闸门 + 三格式报告 + 仿真平台工程 |
| AI4S 行动指南 v11 | 科研仿真 | 8 阶段「算-干-湿三元验证」;阶段 4 重构为「多尺度仿真与候选初筛漏斗」 |
| 生猪全产业链助手 | 行业经营 | 7 个专业智能体 + 自动路由 + 6 大阶段 KPI 体系 + 7 条核心工作流 |
| 深度研究流程 | 研究 | 「每个子问题至少 2 个独立来源」「严禁编造来源」 |
| 数据分析与校验流程 | 数据 | 强制工具调用顺序 + 要求附实际执行的查询语句 |
| 代码审查流程 | 工程 | 🔴严重/🟠中等/🟡轻微 三级风险分级,每条给「位置/现象/影响/最小修复方案」 |
其中「数据分析与校验流程」有一段特别值得看,它把工具调用顺序也写进了规程:
### 阶段 1:理解数据
- 必须依次调用 list_data_sources → get_data_schema
- 记录表结构、主外键、字段含义与缺失情况

### 阶段 2:查询与探索
- 使用 query_data 取数,禁止臆造数据
- 先做分布/缺失/异常值检查,再做业务分析

### 阶段 3:校验
- 关键指标用两种独立口径交叉校验
「关键指标用两种独立口径交叉校验」------这一条在第 13 节的复盘里会回响,因为本次业财分析恰恰在这一步上没做够。 如果这一条被写进 BizFin 的约束段,那 €19.5M / €26.75M 两个口径的问题在第一次出现时就会被拦下。
第二部分:示例 ------ 用业财一体化 Workflow 跑一遍真实分析
第一部分解剖的是那份 4,610 字符的 BizFin Workflow。现在换视角:看它是怎么被用来跑一次真实任务的。
我们要跟着这次会话,把 BPI Challenge 2019 采购事件日志从头到尾剖开,看它如何一步步变成一份可交付的经营分析------并且每一步回头对照 BizFin Workflow,看哪条宪法被遵守了、哪条验收没达标。
这一部分会完整呈现原始数据解剖、六个分析步骤、每一步的图表和数字,以及最后的复盘。
6. 任务设定与原始数据解剖
6.1 数据规模与解析策略
先摆事实。这次分析面临的第一道坎不是「怎么分析」,而是「怎么把这份数据搬进内存」:
| 项目 | 值 |
|---|---|
| 源文件 | BPI_Challenge_2019.xes |
| 体积 | 约 728 MB(XML 格式的事件日志) |
| 格式 | XES(eXtensible Event Streaming)过程挖掘标准格式 |
| 解析出的 trace 数 | 125,867(一条 trace = 一个采购订单行项目) |
| 解析出的 event 数 | 801,346 |
| 出现过的活动种类 | 42 种 |
| 采购总额 | €510,671,256(约 €5.1 亿) |
| 分析涉及供应商 | 1,975 家 |
| 分析涉及业务线 | 18 条 |
一个关键判断在最开始就做了:不用现成的过程挖掘库,用 lxml 的 iterparse 流式解析。
原因有两层。一是工程原因:现成库的安装超时,而 728MB 的 XML 用标准 ElementTree.parse() 一次性载入会直接吃掉几个 GB 内存;iterparse 是逐元素迭代、读完即释放的流式接口,内存占用与文件大小无关。二是方法论原因:流式解析让「事件级全量分析」成为可能,而不必先做抽样近似------后面所有「命中 X% 的 trace」这类精确结论都依赖这一点。
这个选择有一个副作用,值得写出来:前两次解析尝试其实都失败了。
第一次 explore_xes.py 的输出是空的:
=== TRACE attr names (top 40) ===
(全部为空)
=== ACTIVITIES (distinct, top 60) ===
  ... total distinct activities: 0
原因是对 XES 命名空间的处理错了------脚本假设属性是以 <attribute key=... value=...> 形式出现的通用标签,但 BPI 2019 的 XES 用的是具体类型标签 <string key=... value=...> / <float> / <date> / <boolean>。修正后的 explore2.py 里加了这个判断:
python
def attr_dict(el):
    """children are <string key value> etc; return {key: (value,type)}"""
    d = {}
    for ch in el:
        ln = localname(ch.tag)
        if ln in ("string","date","float","int","boolean","id","list","container"):
            d[ch.get("key")] = (ch.get("value"), ln)
return d第二次成功了。这两次失败的日志(explore_out.txt 全空、explore2_err.txt 里逐行打印的进度条)都留在工作区里------它们是「探索证据」,不是需要清理的垃圾。
6.2 XES 数据长什么样:解剖一条真实 trace
要理解后面所有分析,先得看清原始数据的结构。从 debug_xes.py 的输出里可以看到第一条 trace 的原始 XML:
xml
<trace>
<string key="Spend area text" value="CAPEX & SOCS"/>
<string key="Company" value="companyID_0000"/>
<string key="Document Type" value="EC Purchase order"/>
<string key="Sub spend area text" value="Facility Management"/>
<string key="Purchasing Document" value="2000000000"/>
<string key="Purch. Doc. Category name" value="Purchase order"/>
<string key="Vendor" value="vendorID_0000"/>
<string key="Item Type" value="Standard"/>
<string key="Item Category" value="3-way match, invoice before GR"/>
<string key="Spend classification text" value="NPR"/>
<string key="Source" value="sourceSystemID_0000"/>
<string key="Name" value="vendor_0000"/>
<boolean key="GR-Based Inv. Verif." value="false"/>
<string key="Item" value="00001"/>
<string key="concept:name" value="2000000000_00001"/>
<boolean key="Goods Receipt" value="true"/>
<event>
<string key="User" value="batch_00"/>
<string key="org:resource" value="batch_00"/>
<string key="concept:name" value="SRM: Created"/>
<float key="Cumulative net worth (EUR)" value="298.0"/>
<date key="time:timestamp" value="2018-01-02T12:53:00.000Z"/>
</event>
...
</trace>这条 trace 翻译成人话:
公司
companyID_0000的采购订单2000000000,第00001行项目,供应商vendorID_0000(采购品类:CAPEX & SOCS,子类:设施管理),采用「三单匹配、发票先于收货」模式,金额 €298。第一个事件是 2018-01-02 12:53 由batch_00这个批处理账号执行的「SRM: Created」。
这里有三个结构性的观察,每一个都直接影响后面的分析设计:
观察一:trace 级 16 个属性,event 级只有 5 个属性。
全部 125,867 条 trace 的属性分布是完全均匀的(每个属性都恰好出现 125,867 次),说明这是一个设计良好的星型结构:
| 层级 | 属性 | 作用 |
|---|---|---|
| trace(16 个) | Spend area text / Sub spend area text |
业务线与子类(切片维度) |
Company |
公司主体 | |
Document Type |
单据类型 | |
Purchasing Document / Item / concept:name |
订单号 / 行项目号 / trace 唯一键 | |
Vendor / Name |
供应商 ID 与名称 | |
Item Category |
匹配方式(关键字段,见下) | |
Item Type |
Standard / Service 等 | |
Spend classification text |
PR / NPR(是否请购) | |
Source |
来源系统 | |
GR-Based Inv. Verif. / Goods Receipt |
是否基于收货验证 | |
| trace(5 个) | User / org:resource |
执行者(自动化判定的唯一依据) |
concept:name |
活动名 | |
Cumulative net worth (EUR) |
累计金额(资金成本计算的唯一依据) | |
time:timestamp |
时间戳(等待时间计算的唯一依据) |
换句话说,后面所有成本测算用到的字段,全在这个列表里了。 没有额外数据源,没有人工填表------这是「业财一体化」在这份数据上的真实含义:财务金额(累计净额)和业务流程事件在同一个时间轴、同一份 trace 上。
观察二:Item Category 是整个分析的枢纽字段。
它的四个取值直接决定了瓶颈分析的结论:
| Item Category 取值 | 业务含义 |
|---|---|
3-way match, invoice before GR |
三单匹配,发票先于收货到达 |
3-way match, invoice after GR |
三单匹配,收货先于发票 |
2-way match |
两单匹配(不校验收货) |
Consignment |
寄售 |
后面会看到,占绝对多数的「发票先于收货」正是整个资金成本链条的源头。这一个字段,事后被证明是整个分析里最有解释力的维度。
观察三:Cumulative net worth (EUR) 是「累计值」而非「增量值」。
解析脚本把它保留为浮点数存进 events_long 表。全部 801,346 个事件的统计是:
min=0.0  max=26,787,987.0  mean=22,963.86  p50=541.0
sum=18,402,000,958.00
中位数只有 €541,最大值接近 €2,678 万。这说明金额分布极度右偏 ------绝大多数订单行项目金额很小,少数超大单拉高了均值。所以后续所有「平均值」都存在被极端值拉高的风险,计算资金成本时更稳妥的做法是用 trace 级的 final_net_worth(该 trace 最后一个事件的累计值)而不是全局均值。分析脚本确实这么做了:
python
trace_df = grp.agg(
    ...
    final_net_worth=("net_worth","last"),
    ...
)
6.3 数据加工:从 XML 到分析表
解析完成后,build_data.py 把它压成了两张分析表。
第一张:events_long(事件级长表,20 列,801,346 行)
每行是一个事件的扁平化记录,携带它所属 trace 的全部关键属性:
python
cols = ["trace_id","purchasing_document","item","vendor","item_category","spend_area",
        "sub_spend_area","company","gr_based","goods_receipt","doc_type","item_type",
        "spend_class","source","vendor_name","activity","timestamp","net_worth",
        "resource","trace_len"]
同时导出 parquet(7.7 MB)和 gzip CSV(8.7 MB)双格式------parquet 供 pandas 快速读取,CSV 供人工核查。
第二张:traces_summary(trace 级汇总,125,867 行)
按 trace_id 分组聚合,产出:
| 字段 | 含义 |
|---|---|
first_ts / last_ts / duration_days |
首末事件时间戳与流程总时长(天) |
n_events |
该订单行项目的活动数 |
final_net_worth |
最终累计金额 |
activities |
活动序列(逗号分隔,按时间排序) |
has_goods_receipt / item_category / vendor / spend_area / ... |
维度字段 |
这一步做了一件很关键的事:activities 字段保留了完整活动序列。这使得「流程变体识别」(比如这条订单走的是 2-way 还是 3-way、有没有走 Remove Payment Block)可以在后续任何时候回溯,而不必重跑解析。
整个加工过程耗时可控,因为流式解析 + 只抽取必要字段,把 728MB XML 压到 7.7MB parquet,压缩率约 94 倍。
6.4 三条成本口径:把流程语言翻译成钱
有了数据,接下来的问题是怎么把「等待」和「返工」变成金额。分析脚本开头定下了三个参数:
python
RATE_EUR_H  = 40.0     # 综合人工费率(欧/小时)
REWORK_HOURS = 0.5      # 每次返工事件占用管理工时(小时)
COC_ANNUAL   = 0.08     # 年资金成本率
对应的三个换算公式:
| 成本类型 | 公式 | 含义 |
|---|---|---|
| 返工人工成本 | 返工事件数 × 0.5h × €40/h | 每次返工 20 欧 |
| 自动化缺失成本 | 人工事件数 × 0.5h × €40/h | 每次人工事件 20 欧 |
| 资金占用成本 | 发票金额 × 8% × 等待天数/365 | 钱压在账上的利息 |
这三个数字必须提前说清楚是假设,不是事实。 它们是行业通用量级估计,用于把流程指标换算成可排序的金额优先级,不能当作精确会计成本。分析报告在每份的末尾都如实声明了这一点:
⚠️ 方法假设(如实说明):人工费率 €40/h;返工 0.5h/次;人工 0.08h/次;资金成本 8%/年。成本为量级估算,用于定位优先级与模型对比,非精确会计成本;实际需按企业费率校准。
这个「口径先声明、数字后引用」的纪律,正是 BizFin Workflow 里 C4 那条「数据可用性分级:实测数据 > 系统推算 > 行业基准 > 用户假设」的具体落实。本次分析的所有金额都落在最后一级------用户假设。
6.5 自动化判定:一个必须讲清楚的规则
要把「自动化缺失成本」算出来,必须先判定每个事件是人做的还是机器做的。判据只有一个字段:
python
def is_automated(res):
    if res is None: return True                    # NONE = 系统
    r = str(res)
return r.startswith("batch_") or r in ("NONE","None") or r == ""即:org:resource 以 batch_ 开头、或为 NONE/空 → 算自动化;否则(形如 user_XX)算人工。
判定结果分布:
| 事件数 | 占比 | |
|---|---|---|
| 自动化事件 | 279,525 | 34.9% |
| 人工事件 | 521,821 | 65.1% |
这个判据有明确的可争议性 ,必须写出来:batch_00 这类账号既可能是批处理程序,也可能是「一个人共用一个批次账号」。数据集本身没有提供更细的角色信息。分析报告在假设说明里做了标注------「自动化判定基于执行资源(batch_/系统 NONE vs 人工 user_*)」。这是一个基于命名规则的推断,不是系统配置的直接读取。
不过它在一个地方得到了交叉验证:所有 Change* 类变更活动的自动化率几乎全是 0.000 (Change Price 0%、Change Quantity 0.0093%、Delete PO Item 0%、Release PO 0%),而 Vendor creates invoice 和 Record Service Entry Sheet 是 100%。变更必须由人发起、供应商侧开票必然由系统完成------这个分布符合常识,说明判据方向是对的。
7. 第 1 步:三大低效来源量化
现在进入正题。用户提的三个切口------返工、瓶颈、自动化缺失------被逐一展开。
7.1 返工成本:61,667 次「事后纠错」
先要定义什么是返工。 脚本里列了 17 类活动构成返工集合:
python
rework_acts = ["Change Quantity","Change Price","Delete Purchase Order Item",
               "Change Approval for Purchase Order","Cancel Invoice Receipt",
               "Change Delivery Indicator","Cancel Goods Receipt",
               "Change Storage Location","Change Currency",
               "Change Final Invoice Indicator","Change payment term",
               "Change Rejection Indicator","Reactivate Purchase Order Item",
               "Block Purchase Order Item","Set Payment Block",
"Remove Payment Block","Cancel Subsequent Invoice"]判定逻辑很清楚:凡是「把已经做过的事撤销或改动」的活动,都是返工。
统计结果:
| 指标 | 值 |
|---|---|
| 返工事件总数 | 61,667 |
| 受影响 trace 数 | 45,052 (占全部 125,867 的 35.8%) |
| 返工人工成本 | 61,667 × 0.5h × €40/h = €1,233,340 |
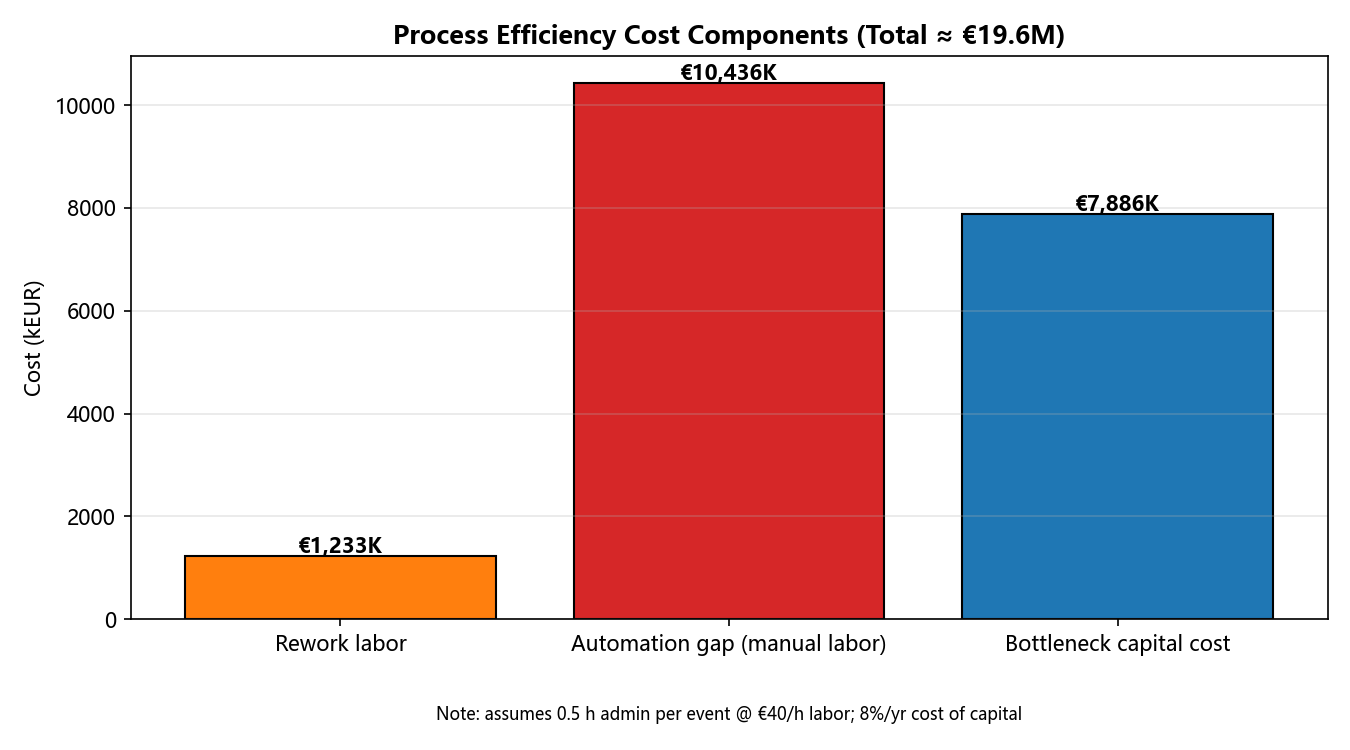
图:返工活动按事件数排序。Change Quantity(10,697)和 Change Price(6,265)被标红,因为它们是用户原始问题里点名要看的两类。
这张图有个必须解释的细节:图里没有 Remove Payment Block。
因为画图脚本用的是另一个更窄的列表(13 类,不含付款冻结相关的 4 类)。Remove Payment Block(解付款冻结)实际有 28,528 次 ,比 Change Quantity 多 1.7 倍,是单一活动里的绝对第一名------但它没出现在这张图上。
完整分布(来自 cost_analysis.py 的逐活动统计):
| 活动 | 事件数 | 涉及金额合计(€) | 是否在图中 |
|---|---|---|---|
| Remove Payment Block | 28,528 | 249,427,897 | ✗ 未画 |
| Change Quantity | 10,697 | 83,180,140 | ✓ |
| Change Price | 6,265 | 158,647,835 | ✓ |
| Delete Purchase Order Item | 4,470 | 33,237,593 | ✓ |
| Change Approval for Purchase Order | 3,760 | 54,734,443 | ✓ |
| Cancel Invoice Receipt | 3,569 | 334,798,097 | ✓ |
| Change Delivery Indicator | 1,660 | 12,254,047 | ✓ |
| Cancel Goods Receipt | 1,636 | 329,991,306 | ✓ |
| Reactivate PO Item | 269 | 1,440,903 | ✗ |
| Block PO Item | 264 | 930,806 | ✗ |
| Cancel Subsequent Invoice | 243 | 5,049,244 | ✗ |
| Change Storage Location | 212 | 2,700,063 | ✓ |
| Set Payment Block | 62 | 4,200,682 | ✗ |
| Change Currency | 17 | 106,360 | ✓ |
| Change Final Invoice Indicator | 8 | 20,223 | ✓ |
| Change payment term | 5 | 22,894 | ✓ |
| Change Rejection Indicator | 2 | 520 | ✓ |
这是一个真实的分析缺陷,值得单独指出。 它带来两个后果:
- 图上看不出「解付款冻结」才是最大单项返工源,读者容易误判优先级;
- 后续的 ROI 测算里,P2 建议正是「根治解付款冻结返工」------也就是说,结论抓对了,但支撑它的第一张图没有画出来。
对比一下 Remove Payment Block 与其余返工的量级:28,528 vs 其余 33,139。前者占返工总量的 46%,占返工金额的绝大部分。
返工的第二个影响比人工成本更大:它拖长了周期。
脚本对比了「含返工的 trace」与「不含返工的 trace」的平均流程时长:
| trace 数 | 平均时长 | 中位时长 | |
|---|---|---|---|
| 无返工 | 103,257 | 68.4 天 | 63.1 天 |
| 含返工 | 22,610 | 85.7 天 | 71.3 天 |
| 差值 | +17.3 天 | +8.1 天 |
这张图和上面那张又有一处口径差异:它只用了 7 类核心变更活动(Change Quantity/Price、Delete/Approval PO Item、Cancel Invoice Receipt、Change Delivery Indicator、Cancel Goods Receipt)来定义「有返工」,所以命中的是 22,610 条 trace,而不是全量返工口径的 45,052 条。
但这个差异反而让结论更有说服力 :只算最窄口径的返工,每单已经多耗 17.3 天;如果把付款冻结等也计入,差距只会更大。
原因也很直观:返工让订单多留 17 天,这 17 天里的发票金额同样在账上占着资金 。所以返工成本是双重的------既有人工成本,又有被放大的资金占用成本。这一点在第 8 节的模型对比里会得到印证。
7.2 瓶颈成本:49.9 天的等待,和 457 万个「钱·天」
瓶颈的定位方法很简单:找出「记录发票收据」到「清账」之间的等待时长。
python
# 每条 trace 取首次 Record Invoice Receipt 与末次 Clear Invoice
rec_inv = df[df["activity"]=="Record Invoice Receipt"].groupby("trace_id")["timestamp"].min()
clr_inv = df[df["activity"]=="Clear Invoice"].groupby("trace_id")["timestamp"].max()
bn = pd.DataFrame({"rec_ts":..., "clr_ts":..., "net_worth":...}).dropna()
bn = bn[bn["clr_ts"] >= bn["rec_ts"]]                       # 剔除时序异常
bn["wait_days"] = (bn["clr_ts"] - bn["rec_ts"]).dt.total_seconds()/86400
bn["capital_cost"] = bn["net_worth"] * 0.08 * (bn["wait_hours"]/8760)
取「首次记录」和「末次清账」,是因为返工会让这两个活动重复出现,只有这样才能覆盖完整的滞留周期。
统计结果:
| 指标 | 值 |
|---|---|
| 同时含这两个活动的 trace | 91,626(占 72.8%) |
| 平均等待 | 1,198.3 小时 = 49.9 天 |
| 中位等待 | 1,032 小时 = 43.0 天 |
| P90 等待 | 2,373.5 小时 = 98.9 天 |
| 累计等待 | 109,796,463 小时 = 4,574,853 天 |
| 资金占用成本(8%/年) | €7,885,500 |
| 平均每张发票承担 | €86.06 |
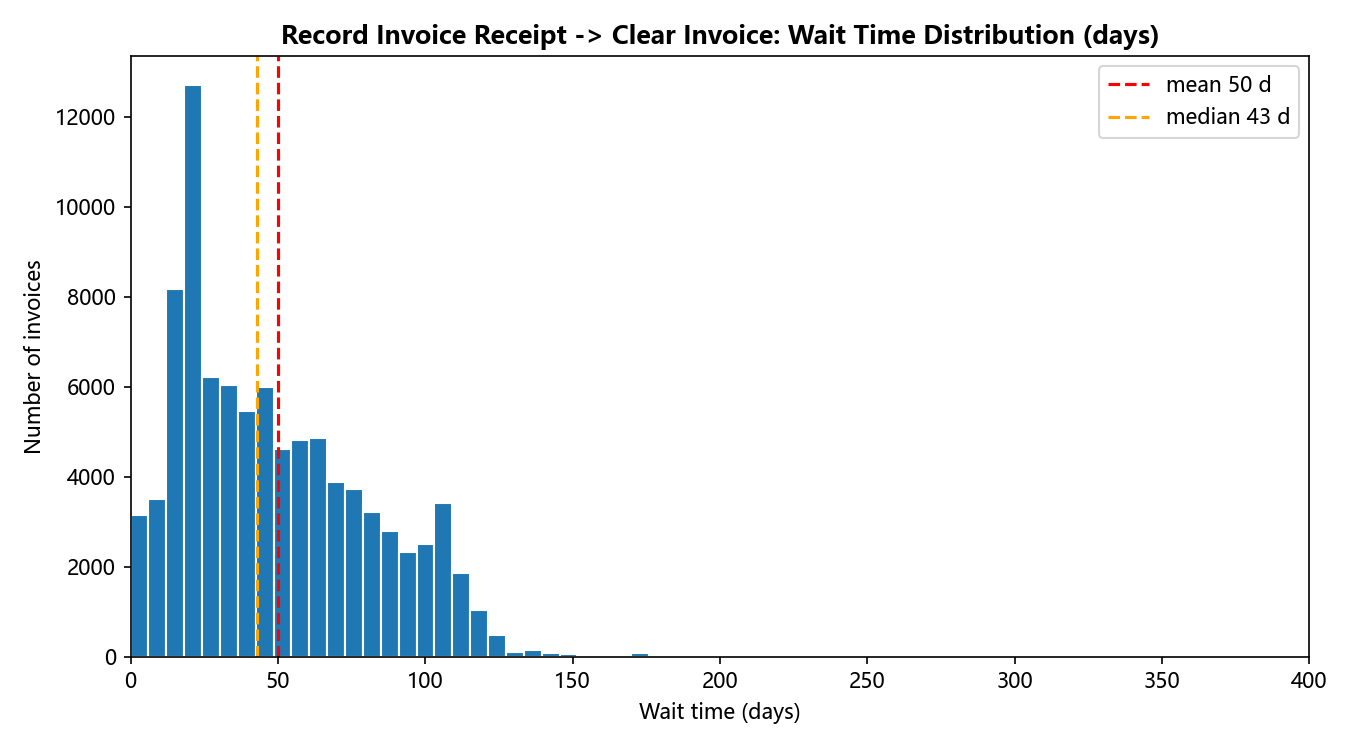
图:等待天数直方图,横轴截到 400 天。红色虚线是均值 50 天,橙色虚线是中位数 43 天。分布明显右偏且长尾------一半以上的订单超过 43 天,10% 超过 99 天。
4,574,853 天这个数字值得停下来看一眼。 它相当于 12,533 年 。把整个数据集的发票滞留时间叠在一起,是一万两千五百年的等待。这就是「资金占用」这个抽象概念的真实体量------它不是一条 P&L 上的费用,它是一整块被按住了的钱。
按匹配方式拆开看,故事就完整了:
| 匹配方式 | 发票数 | 平均等待 | 中位等待 | 累计等待 | 平均资金成本 |
|---|---|---|---|---|---|
| 3-way match, invoice before GR | 84,861 | 50.3 天 | 43.1 天 | 4,264,583 天(93%) | --- |
| 3-way match, invoice after GR | 4,873 | 45.2 天 | 34.2 天 | 220,308 天 | --- |
| Consignment(寄售) | 1,747 | 50.8 天 | 48.1 天 | 88,798 天 | --- |
| 2-way match | 145 | 8.9 天 | 5.2 天 | 1,289 天 | --- |
这张表里藏着整个分析最重要的一个对照:
发票先于收货的三单匹配:84,861 张发票,平均等 50.3 天。
两单匹配:145 张发票,平均等 8.9 天。
相差 5.6 倍。
而且不是「等得久一点」,是量级差异。而 2-way match 只有 145 张------占全部瓶颈发票的 0.16%。
机制解释 :两单匹配(不校验收货单)在流程上少了一个「必须等到货到了才能核销」的约束条件,所以发票可以先被处理、被清账。三单匹配要求 PO、收货单、发票三者齐备才能清账------如果发票先到了,收货还没发生,这笔单子就只能干等。
这构成了一个漂亮的对标锚点:流程里已经存在一种做法,它把等待从 50 天压到 9 天,而且它现在就在跑。 第 9 节的 ROI 测算会把这条线索变成最高优先级建议。
7.3 自动化缺失成本:65.1% 的事件仍靠人
最后是自动化缺口。先看整体:
| 事件数 | 占比 | |
|---|---|---|
| 自动化事件 | 279,525 | 34.9% |
| 人工事件 | 521,821 | 65.1% |
| 人工成本(按 0.5h/次 × €40/h) | €10,436,420 |
但整体比例没有决策价值------真正有用的是按活动拆开看。
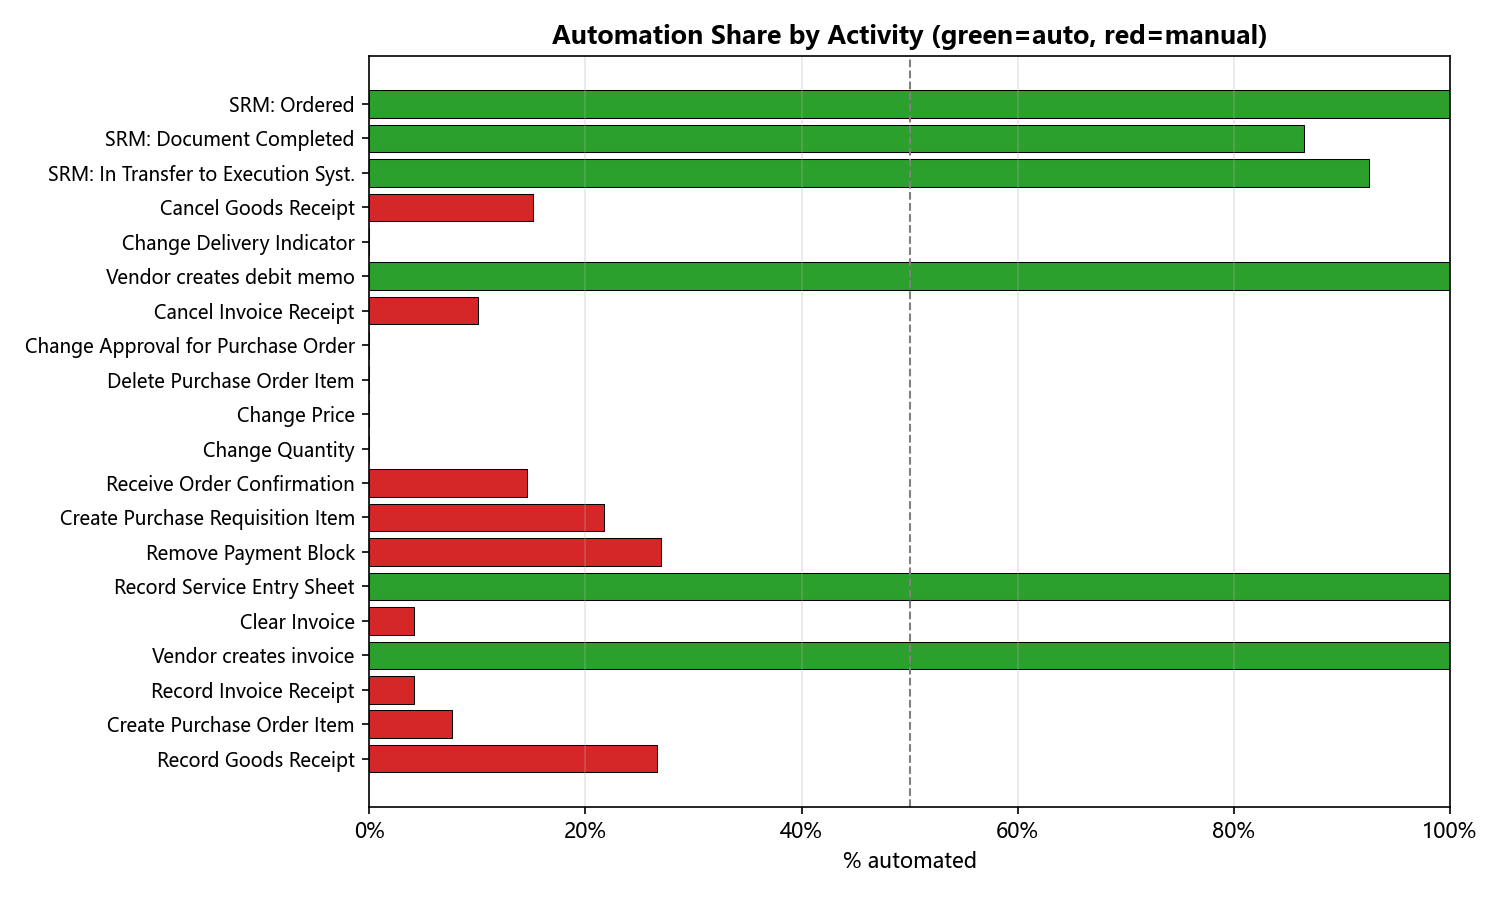
图:按活动显示自动化率,横轴 50% 处有参考线。绿色 = 已高度自动化(≥80%),橙色 = 部分(50--80%),红色 = 高度依赖人工(<50%)。
Top 活动逐一看:
| 活动 | 事件数 | 自动化率 | 人工事件数(估) | 业务解读 |
|---|---|---|---|---|
| Record Goods Receipt(记录收货) | 156,653 | 26.6% | ~115,000 | 仓库作业,高度依赖人工 |
| Create Purchase Order Item(创建订单行) | 125,867 | 7.6% | ~116,000 | 请购转订单,几乎全手工录入 |
| Record Invoice Receipt(记录发票) | 114,986 | 4.1% | ~110,000 | 发票录入,几乎全手工 |
| Vendor creates invoice(供应商开票) | 110,321 | 100% | 0 | 外部系统交互,天然自动 |
| Clear Invoice(清账) | 97,352 | 4.1% | ~93,000 | 三单匹配校验,人工核对 |
| Record Service Entry Sheet(服务确认单) | 84,867 | 100% | 0 | 系统自动 |
| Remove Payment Block(解付款冻结) | 28,528 | 27.0% | ~20,800 | 人工解冻 |
| Create Purchase Requisition Item | 23,309 | 21.7% | ~18,200 | 请购创建 |
| Receive Order Confirmation | 16,006 | 14.6% | ~13,700 | 订单确认 |
| Change Quantity | 10,697 | 0.0093% | ~10,697 | 纯人工变更 |
这张表里有一个非常清晰的规律:越靠近「单据录入」和「单据核对」的动作,自动化率越低。
Vendor creates invoice和Record Service Entry Sheet是 100% 自动化------它们要么发生在企业外部,要么是纯系统动作;Clear Invoice只有 4.1%------因为它需要人工比对三张单据;Create Purchase Order Item7.6%------因为要手工录入明细行。
而这三个低自动化率的活动,恰好是高频 + 规则明确 + 数据标准化的场景:
关键发现 :三大核心单据环节(Create PO Item、Record Invoice Receipt、Clear Invoice)的自动化率均不足 8%,而这些都是高频、规则明确、数据标准化的场景,是 RPA/系统集成的理想对象。
「高频、规则明确、数据标准化」------这三个条件同时满足,通常就是自动化的最佳候选。
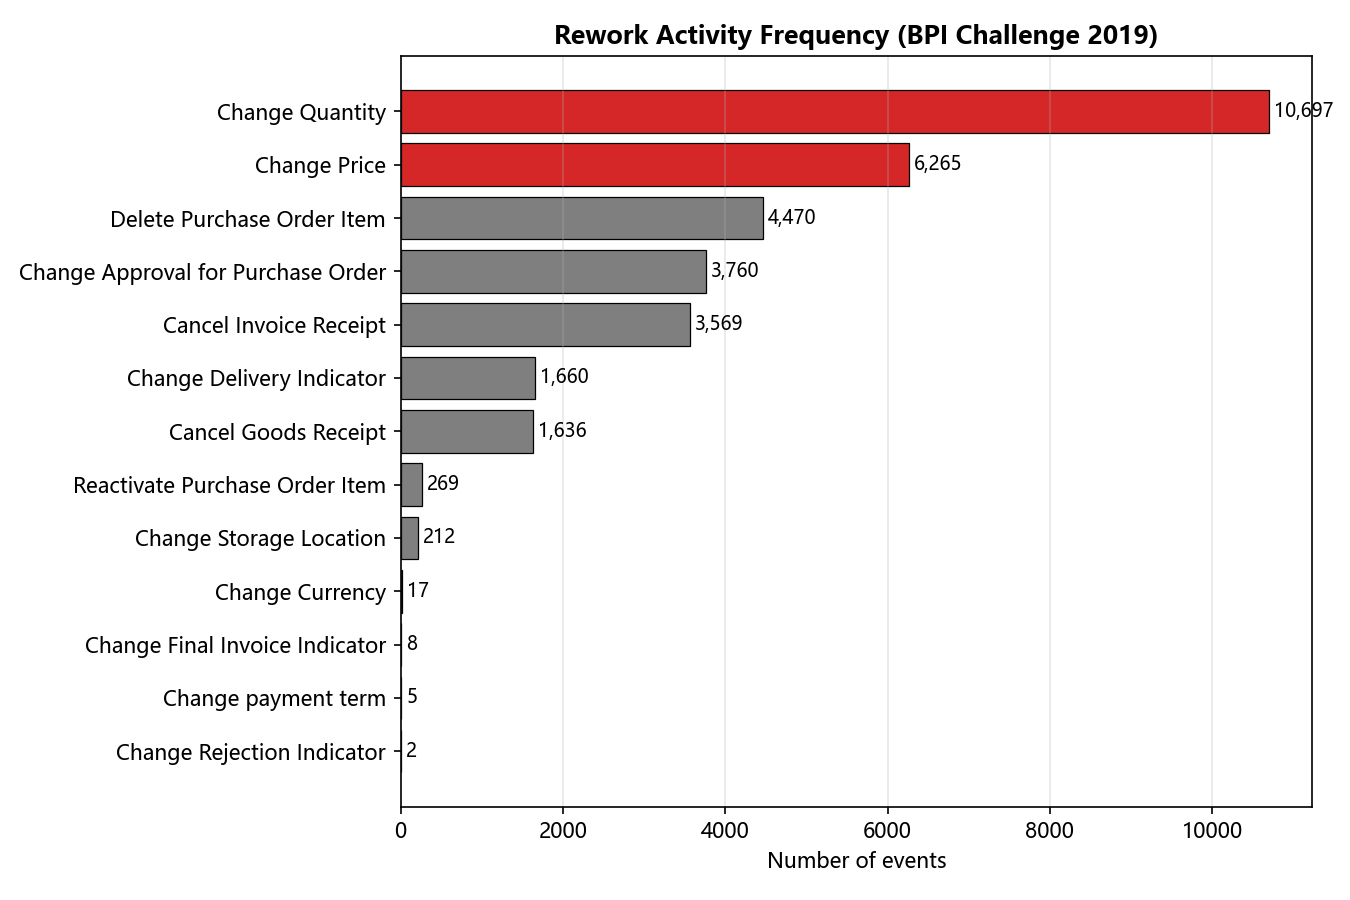
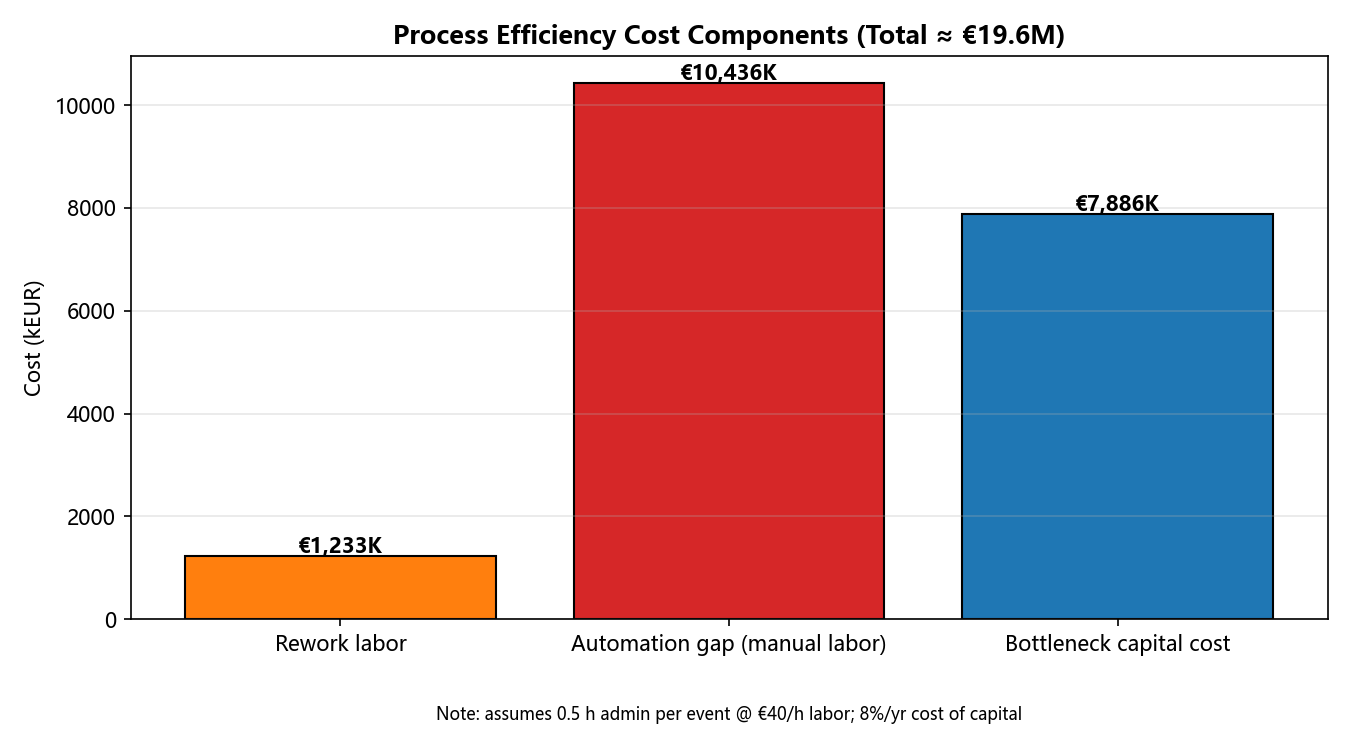
7.4 三项汇总
| 成本维度 | 金额 | 占比 |
|---|---|---|
| 返工人工成本 | €1,233,340 | 6.3% |
| 瓶颈环节资金占用成本 | €7,885,500 | 40.4% |
| 自动化缺失成本 | €10,436,420 | 53.4% |
| 合计 | ≈ €19,555,260 | 100% |
注:这里把
cost_metrics.json里的三个数字直接相加得到 €19,555,260。报告正文中先后出现过 €19.32M、€19.53M、€19.6M 三个数字(分别来自category_cost_drilldown、cost_efficiency_analysis、roi_metrics三条不同的产出线)。这是同源数据在不同分析步骤间的累计口径差异,第 13.3 节会专门讨论。
对照采购总额 €5.11 亿:流程效率成本约占采购额的 3.8% 。这个比例不算高,但它是纯损耗------不产生任何收入,只消耗现金和人力。
8. 第 2 步:从全局到 19 个采购类别
8.1 下钻逻辑
全局数字(€19.5M)能说明「问题存在」,但不能说明「先动哪里」。第二步按 Spend area text(业务线/采购类别)切开展开。
19 个类别(18 个有实际业务 + 1 个未识别)的完整成本全景:
| 采购类别 | 订单数 | 采购额(€M) | 返工(€K) | 瓶颈资金(€K) | 自动化缺失(€K) | 总成本(€K) | 成本强度(€/€1M) | 占采购额% |
|---|---|---|---|---|---|---|---|---|
| Packaging | 54,579 | 141.0 | 527 | 2,489 | 4,455 | 7,471 | 52,988 | 5.3% |
| Additives | 9,144 | 82.9 | 89 | 1,037 | 805 | 1,931 | 23,303 | 2.3% |
| Sales | 32,932 | 64.8 | 257 | 652 | 2,723 | 3,631 | 56,053 | 5.6% |
| Trading & End Products | 11,155 | 43.0 | 165 | 360 | 924 | 1,449 | 33,674 | 3.4% |
| Latex & Monomers | 2,484 | 36.2 | 26 | 355 | 216 | 597 | 16,494 | 1.6% |
| Titanium Dioxides | 910 | 24.3 | 8 | 172 | 68 | 249 | 10,211 | 1.0% |
| Logistics | 2,616 | 23.5 | 19 | 743 | 197 | 959 | 40,858 | 4.1% |
| CAPEX & SOCS | 3,412 | 17.7 | 32 | 434 | 300 | 766 | 43,203 | 4.3% |
| Specialty Resins | 1,191 | 17.1 | 13 | 121 | 103 | 237 | 13,871 | 1.4% |
| Pigments & Colorants | 1,308 | 12.0 | 15 | 99 | 112 | 225 | 18,854 | 1.9% |
| Enterprise Services | 326 | 10.2 | 5 | 509 | 33 | 547 | 53,437 | 5.3% |
| Solvents | 1,332 | 9.3 | 12 | 82 | 112 | 206 | 22,157 | 2.2% |
| Workforce Services | 69 | 8.0 | 1 | 463 | 13 | 477 | 59,666 | 6.0% |
| Others | 1,316 | 7.6 | 13 | 62 | 109 | 185 | 24,404 | 2.4% |
| Marketing | 908 | 7.0 | 5 | 149 | 75 | 229 | 32,711 | 3.3% |
| Real Estate | 293 | 3.1 | 22 | 7 | 33 | 62 | 20,001 | 2.0% |
| Commodity Resins | 216 | 2.4 | 3 | 65 | 20 | 87 | 35,814 | 3.6% |
| Energy | 9 | 0.3 | 1 | 0 | 1 | 2 | 7,212 | 0.7% |
| Spend Area Unidentified | 18 | 0.3 | 0 | 10 | 3 | 13 | 48,323 | 4.8% |
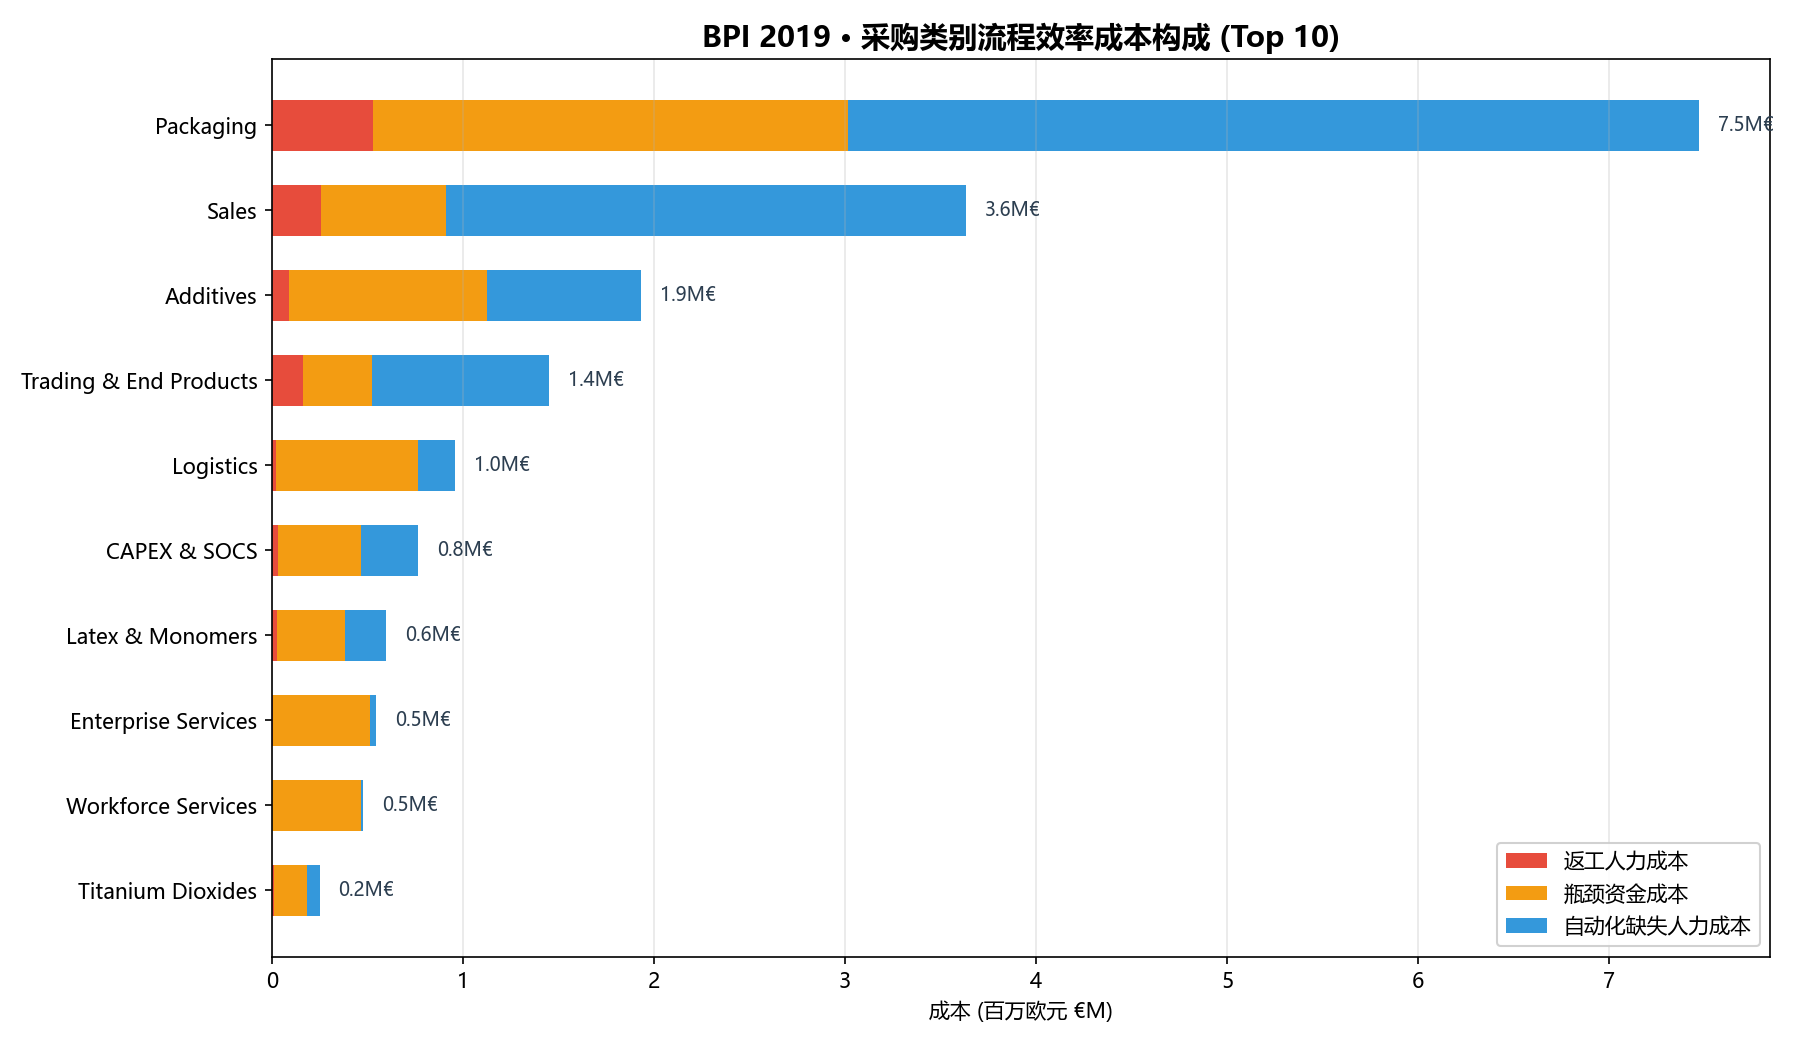
上图:19 个类别的三类成本堆叠对比。可以清楚看到资金成本(蓝)在不同类别里的分布极不均衡。
8.2 三个关键发现
发现一:成本与规模不成比例。
Packaging 一家占 €7.47M(39%) ,但它的采购额只占总采购额的 28% 。成本强度 €52,988/€1M,是全样本平均水平(€37,841)的 1.4 倍。
而 Real Estate 的采购额只有 €3.1M(0.6%),成本 €62K,成本强度 €20,001/€1M------最低,不到 Packaging 的四成。
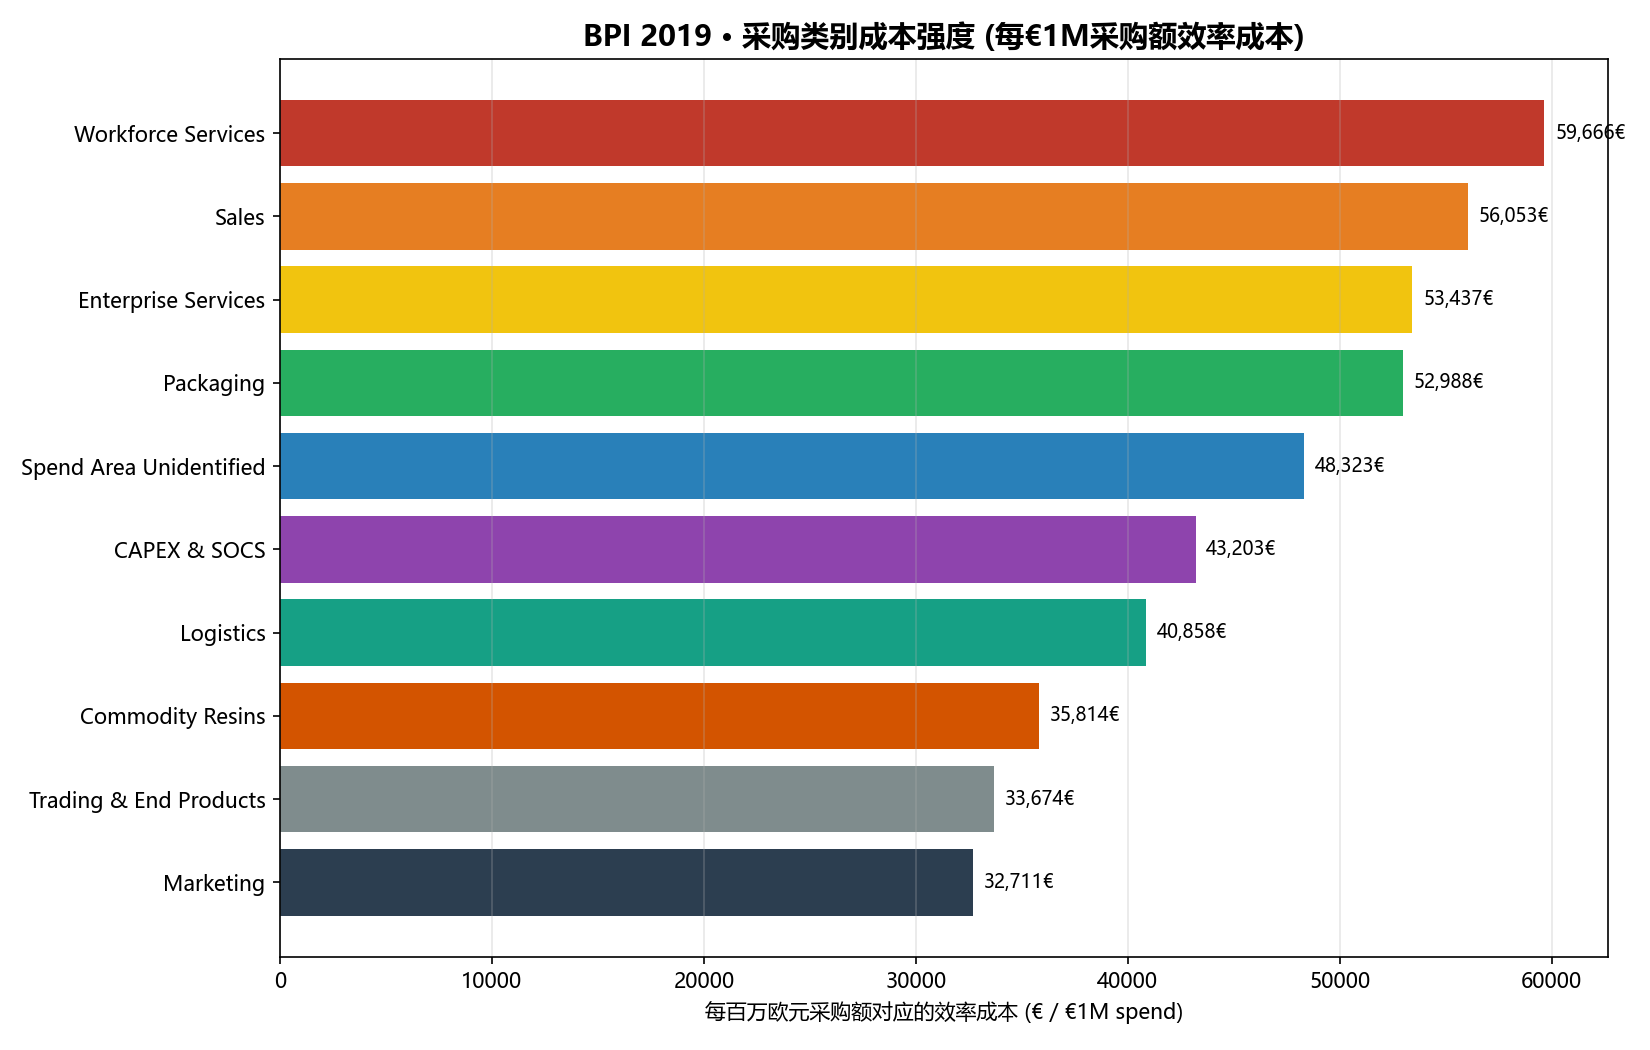
发现二:三种完全不同的成本结构。
| 类别 | 返工占比 | 瓶颈资金占比 | 自动化缺失占比 | 主导因素 |
|---|---|---|---|---|
| Packaging | 8% | 33% | 60% | 人工+资金双高 |
| Logistics | 2% | 77% | 21% | 纯等待型 |
| Enterprise Services | 1% | 93% | 6% | 纯资金型 |
| Real Estate | 35% | 11% | 53% | 人工型 |
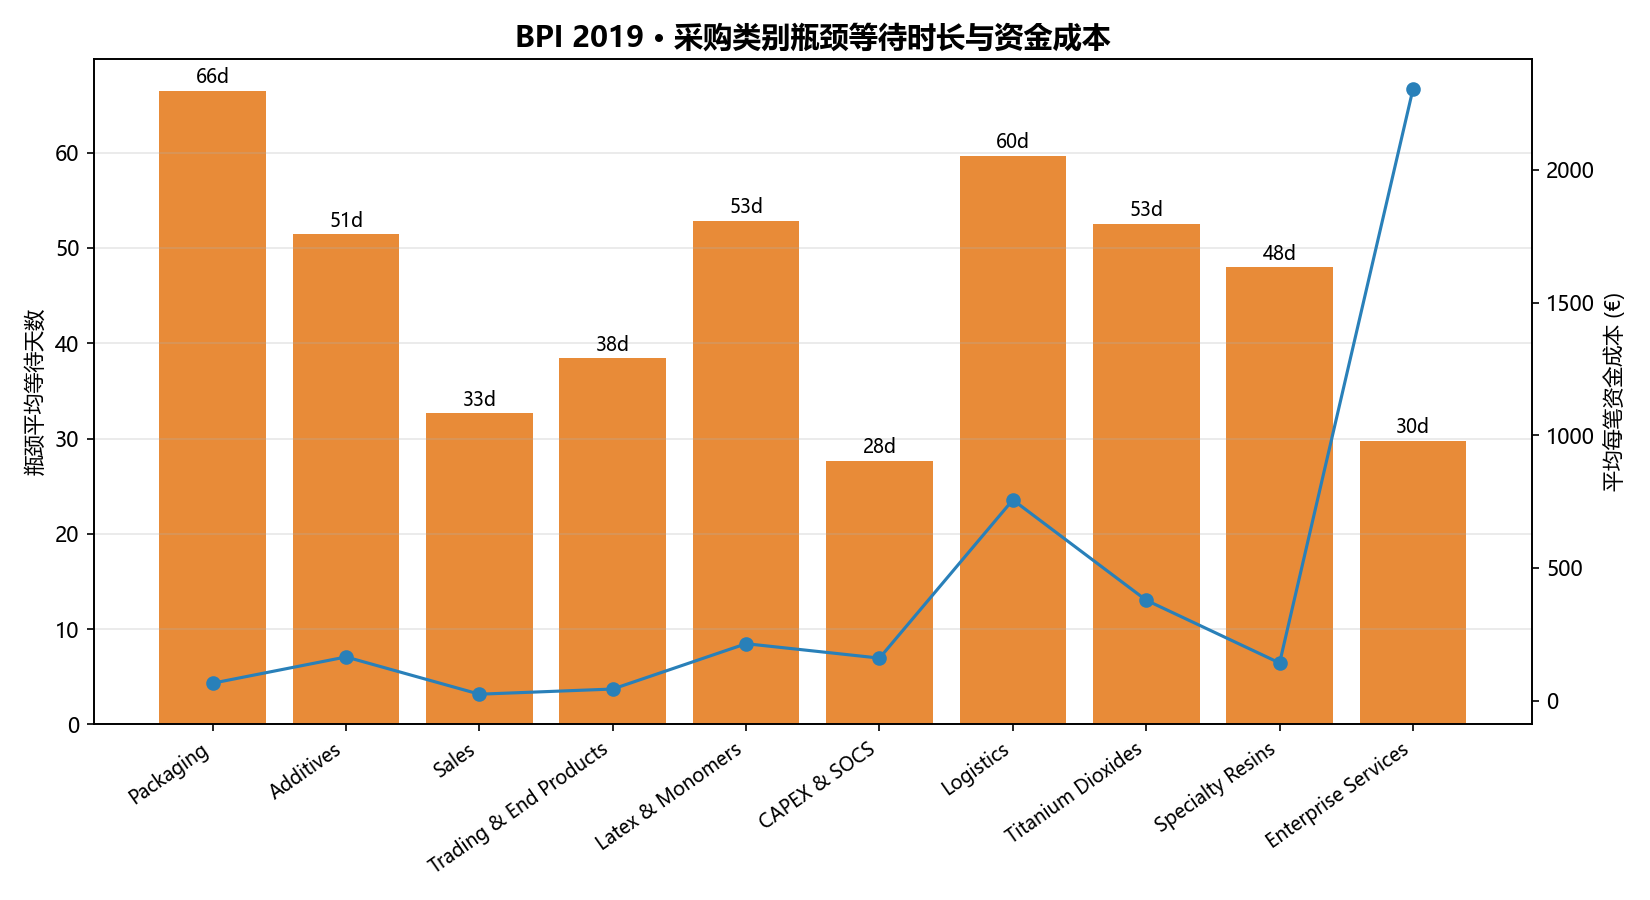
Logistics 是最反直觉的一个 :自动化率高达 89.6% (全类别最高),但成本强度 €40,858/€1M 位居前列。原因在瓶颈等待 60 天 和单笔资金成本 €756 ------它是典型的「流程等待型」成本。自动化解决不了等待。
Enterprise Services 更极端 :单笔资金成本 €2,304/笔,只有 326 个订单但资金成本 €509K。高价值订单的等待被金额放大。
Real Estate 则是另一个极端 :平均等待仅 8.9 天,成本强度最低。这验证了「简化核销方式可大幅降低流程成本」------而它就是第 7.2 节说的 145 张 2-way match 发票所在的地方。
发现三:返工率在各类别间相对均匀,但总量集中。
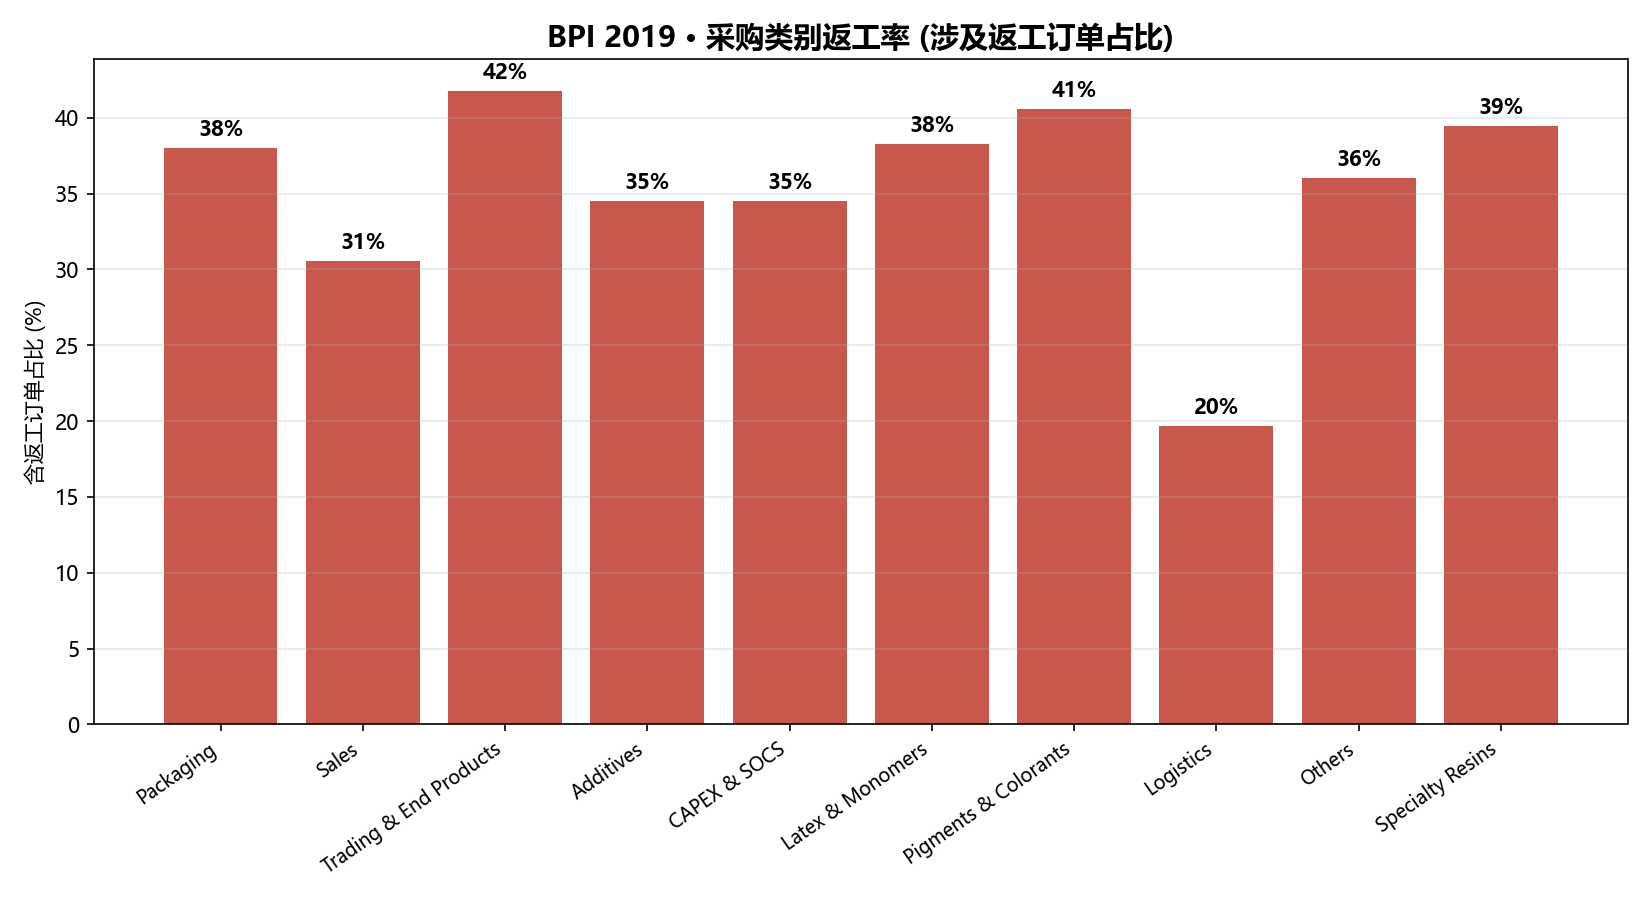
Packaging 有 26,374 次返工事件(占其全部事件的 8.6%),涉及 20,735 条 trace。但从返工率看,Packaging 反而不是最高的------Workforce Services、Others 等类别的返工比例更高。Packaging 的问题是绝对量,不是比率。
8.3 降本优先级
| 优先级 | 类别 | 目标成本 | 建议措施 | 预计节省 |
|---|---|---|---|---|
| P1 | Packaging | 瓶颈 €2.49M + 自动化 €4.46M | 缩短核销周期至 30 天 + 自动化 PO 创建/发票收据 | €3.5M+ |
| P2 | Sales | 自动化 €2.72M | 自动化高频人工环节(发票收据/清账) | €2.7M+ |
| P3 | 全类别 | 瓶颈等待 | 按类别差异化优化核销流程 | 随等待压缩 |
9. 第 3 步:五种成本模型对比 ------ 这次分析的知识内核
到这里为止,做的是「把一个已选定的成本模型算得更细」。接下来的追问完全不同:
给出成本核算/成本分析/经营分析的核心洞见,对比不同成本模型对经营的贡献和影响,你自己决定采用哪些方法。
这个问题背后有个隐含判断:「成本」不是唯一客观的东西,它取决于你用哪把尺子量。
9.1 五种模型的设计
分析定义了 5 种成本模型,各自用不同的口径看同一批数据:
| 模型 | 名称 | 核算口径 | 全流程总成本 |
|---|---|---|---|
| M1 | 传统吸收/显性成本法 | 返工 + 人工工时(只看看得见的) | €11.5M |
| M2 | 作业成本法 ABC | 作业量 × 作业费率 | €2.9M |
| M3 | TDABC + 资金成本 | 人工 + 瓶颈等待资金占用 | €19.3M |
| M4 | 目标/强度成本法 | 单位产出(€/€1M·€/单) | ---(非绝对额) |
| M5 | 全生命周期 TCO | 创建→清账全流程 | €19.3M |
M1 到 M3 是三个递进的层级:
- M1 只数人头:把每个事件折算成工时 × 费率。它看见的只有「人花了多少时间」。
- M2 做作业分摊:把成本按作业动因分摊到对象上。它解决「成本该归给谁」,但不解决「总量是多少」。
- M3 加上了资金 :在 M1 基础上叠加「等待期间被占用资金的利息」。这一加就是 €7.8M。
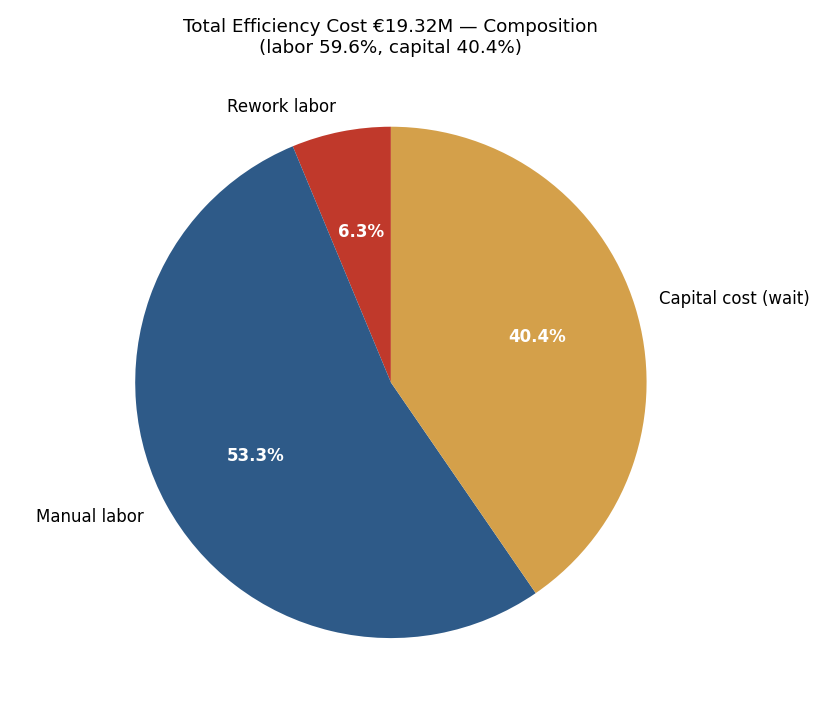
图:M3 口径下的成本构成。人工 €11.5M(60%)+ 资金 €7.8M(40%)。红色部分(Remove Payment Block 返工)虽小但高度集中。
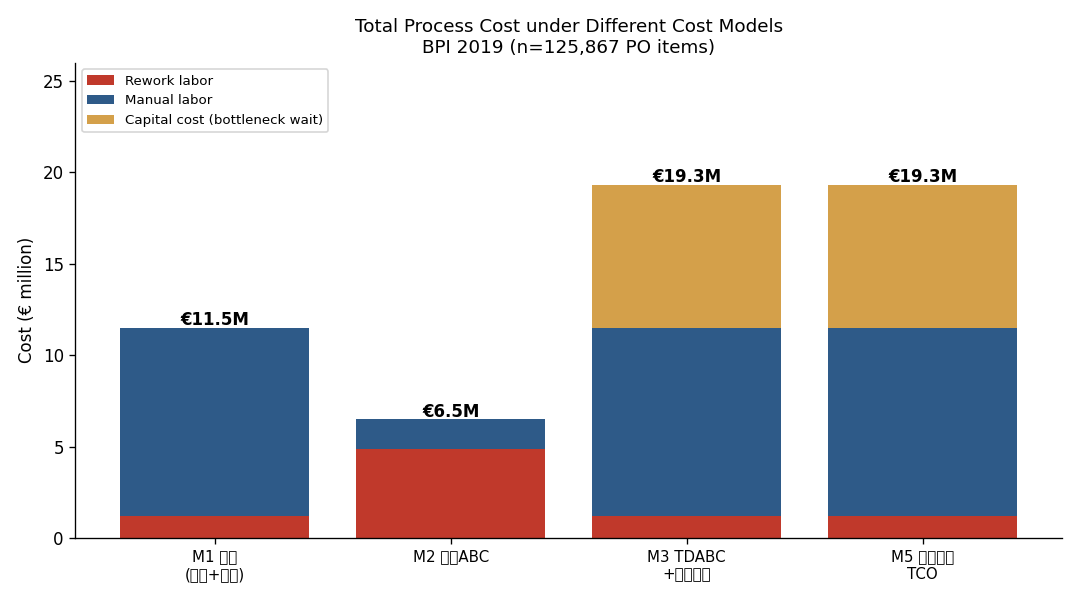
图:M1 €11.5M vs M2 €2.9M vs M3/M5 €19.3M。M2 明显偏低,因为它不含资金成本也不含全量返工。
9.2 核心发现:换模型就换「谁最贵」
这是整次分析最有价值的一张表:
| 模型视角 | 成本最高的前 3 类别 |
|---|---|
| M1 显性(只看人工) | Packaging €4.98M · Sales €2.98M · Trading €1.09M |
| M2 作业 ABC | Packaging €1.24M · Sales €0.69M · Trading €0.31M |
| M3 全口径+资金 | Packaging €7.47M · Sales €3.63M · Additives €1.93M |
Top 3 里有两处变化:Trading 从第 3 掉出,Additives 进到第 3。
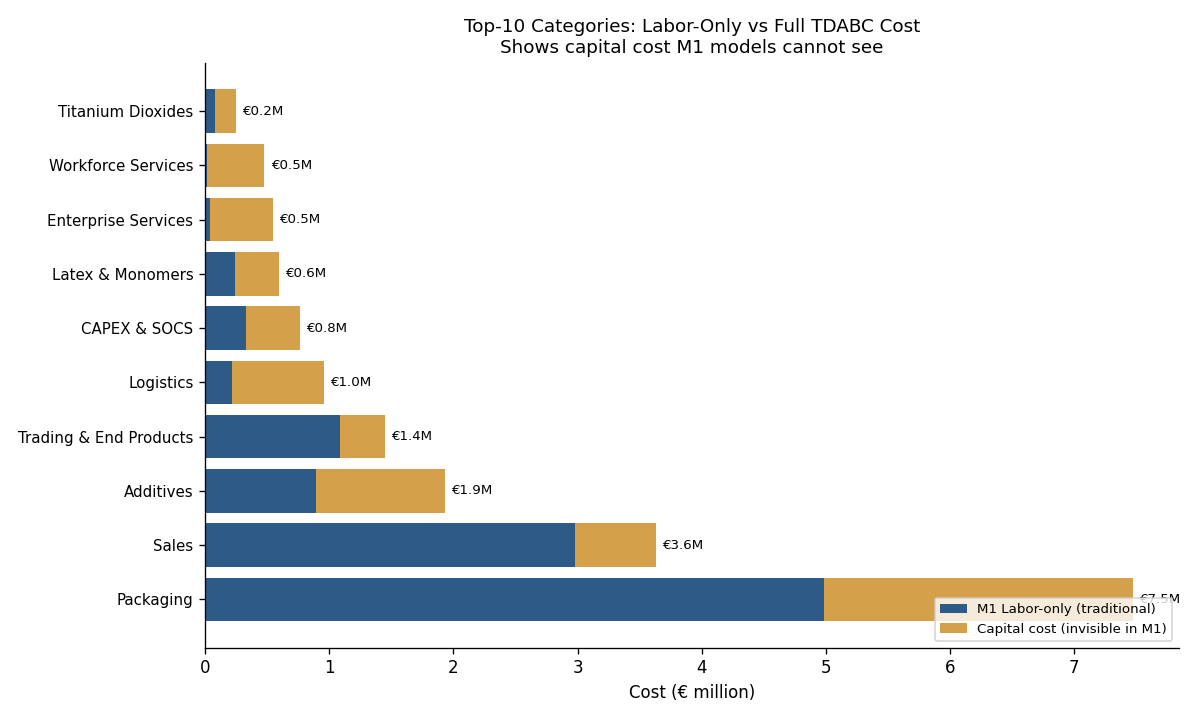
图:18 个类别在 M1 / M2 / M3 三种模型下的排名。横线是排名位置,线条交叉处就是「排名转移」发生的地方。这张图是整次分析里信息密度最高的一张。
排名转移的逐条解读:
| 类别 | M1 排名 | M3 排名 | 变化 | 原因 |
|---|---|---|---|---|
| Workforce Services | 17 | 9 | ↑ 8 位 | 人工成本几乎为零(69 个订单),但等待 90.8 天,资金成本 €463K |
| Enterprise Services | 15 | 8 | ↑ 7 位 | 同上,单笔 €2,304 |
| Logistics | 7 | 5 | ↑ 2 位 | 自动化率 90%(人工排名靠后),但等待 60 天 |
| Packaging | 1 | 1 | --- | 两种模型下都第一,是稳定的优化对象 |
| Trading & End Products | 3 | 6 | ↓ 3 位 | 人工成本高但等待短,资金占比低 |
Workforce Services 和 Enterprise Services 的跃升,是整个模型对比的价值证明。
它们的共同特征是:单值高、批量小、账期长 。传统核算法按「人工工时」计费,看到的是「69 个订单,能有多少人工?」------答案接近零,于是排在第 17 位,几乎被忽略。但按资金成本算,答案完全反过来:钱压在那里 90 天不动,这本身就是巨额成本。
高单值、长等待的服务类采购,传统法会严重低估其资金占用。
而 Logistics 则证明了另一个方向:自动化解决不了等待问题。 它自动化率 90%,人工成本排名靠后,但等待成本把它推到第 5 位。
9.3 返工成本的集中度
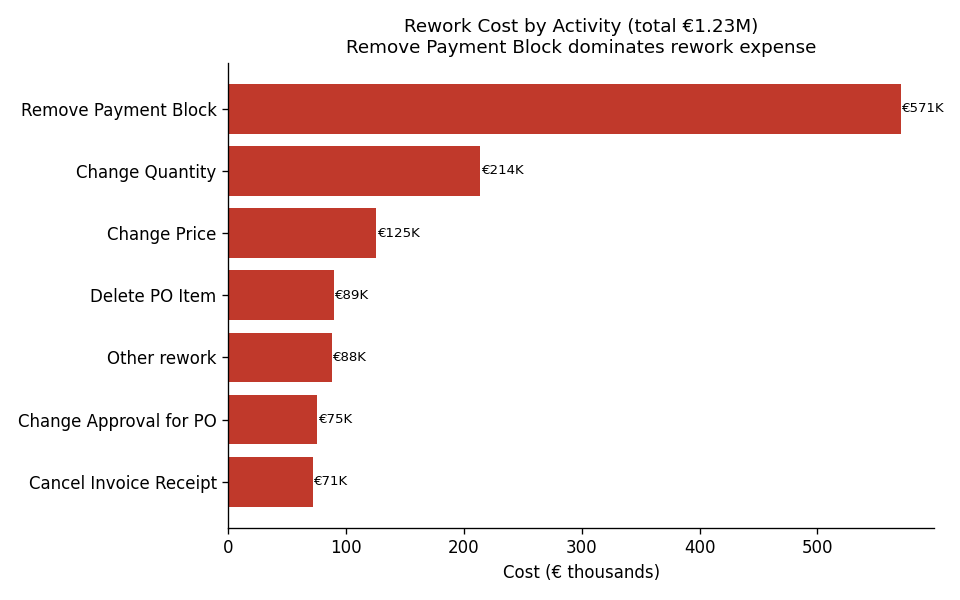
返工总成本 €1.23M,其中 Remove Payment Block(解付款冻结)一项就占 €0.57M(46%)。
这是一个「事后纠错」类活动------本质是上游付款规则或凭证管理失误引发的返工。它不需要新的系统能力,只需要把付款前置校验规则补上。优化空间极大,改造成本极低。
9.4 五种模型各自指向什么决策
| 模型 | 对经营的贡献 | 决策影响 | 适用场景 |
|---|---|---|---|
| M1 传统 | 核算直接人工/返工工时 | 指向流程效率优化 | 人力成本为主的简单核算 |
| M2 ABC | 精确归因单位作业成本 | 指向作业精简/消除非增值作业 | 多产品/多活动分摊 |
| M3 TDABC | 揭示资金占用这一隐性大成本 | 指向缩短等待/现金流优化 | 高资金占用、长账期的采购 |
| M4 目标 | 单位产出成本对标 | 指向标杆改进/预算目标 | 跨类别横向考核 |
| M5 全周期 | 全生命周期总拥有成本 | 指向端到端流程/供应链 TCO | 战略性品类管理 |
由此得到三条经营洞见:
洞见一:成本模型 = 经营导向。
想降人工就选 M1/M2,想释放现金流就选 M3。管理层必须先明确经营目标,再选对核算模型,否则会优化错误的方向。
洞见二:M3 补上了传统法的最大盲区。
40% 的资金成本在 M1 中「隐形」------这就是「利润表上没成本、现金流里却在流血」的根源。
洞见三:自动化 ≠ 成本下降。
Logistics 自动化率最高、成本强度却高,因为瓶颈等待没被自动化解决。降本要「人工 + 等待」双管齐下。
9.5 M3 口径下的降本建议
- P1 Packaging (占 39% 成本):压缩核销等待(66→30 天)释放 €2.5M 资金 + 自动化 PO 创建/发票收据,合计可省 €350 万+
- P2 解付款冻结返工 :优化付款规则与凭证校验,消除 28,528 次返工,省 €57 万
- P3 高单值服务类(Workforce/Enterprise):纳入资金成本考核,专项缩短付款周期
- 对标模板:Real Estate 2-way match + 9 天等待,成本强度最低(€20K/€1M)------应成为跨类别流程样板
注意第 4 条------它回到了第 7.2 节那个 145 张发票的对照。真实存在的 2-way match 流程,是这份分析里最有说服力的标杆证据。
10. 第 4 步:把降本建议做成可投资的 ROI 测算
第 9 步给出的还只是「应该做什么」。第 4 轮的追问更硬:
将 M3 的降本建议做成可量化的投资回报(ROI)测算。
这一轮的方法论变化是:从「诊断」转向「决策」。每条建议不再只是「应该优化」,而是变成一项投资决策------投入多少、省多少、多久回本、什么条件下不成立。
10.1 测算框架
ROI 模型逻辑:每条降本建议 = 一项投资决策。
投入 capex(一次性) + opex(年运维),换来年化成本节省(人工自动化释放 + 资金占用释放),
按 8% 折现,计算 NPV、3年ROI、回本期。
参数取值全部溯源到前面的分析产物,不引入新的自由参数:
| 参数 | 取值 | 来源 |
|---|---|---|
| 人工费率 | €40/h | M3 报告假设 |
| 返工工时 | 0.5h/次 → €20/次 | cost_metrics.json |
| 手动作业 | 0.08h/次 → €3.2/次 | cost_metrics.json |
| 资金成本 CoC | 8%/年 | cost_metrics.json |
| 等待成本 | €1.72/日 | 资本成本 €7.9M ÷ 总等待 4.57M 天 |
注意 €3.2/次 这个数字。 第 7.3 节算「自动化缺失成本」时用的是 0.5h/次(€20/次),但这里改成了 0.08h/次(€3.2/次)------相差 6.25 倍。
这不是错误,是两个不同问题的两种口径:
- 第 7.3 问的是「所有人工处理的总成本」,0.5h 是一个保守的全量人工投入估计;
- 第 10 步问的是「自动化某个动作能省多少工时」,0.08h 是「这次鼠标点击+键盘录入」的真实增量工时。
但两个口径在同一份产出里并存,正是第 13.3 节要讨论的「口径同源」问题。
10.2 五条建议的 ROI
| 建议 | 年化节省 | 投资(capex) | 年运维 | 3年净收益 | NPV(8%) | 3年ROI | 回本期 |
|---|---|---|---|---|---|---|---|
| P1 Packaging 自动化+等待压缩 | €2.59M | €1.60M | €0.32M | €5.20M | €4.24M | 325% | 1.7y |
| P2 解付款冻结返工根治 | €0.62M | €0.48M | €0.10M | €1.09M | €0.87M | 228% | 1.9y |
| P3 高单值服务付款周期专项 | €0.32M | €0.30M | €0.06M | €0.49M | €0.38M | 165% | 2.1y |
| P4 Real Estate 对标模板推广 | €2.37M | €0.90M | €0.18M | €5.66M | €4.73M | 629% | 1.4y |
| P5 全类别通用作业自动化 | €0.78M | €2.10M | €0.42M | −€1.18M | −€1.32M | −56% | --- |
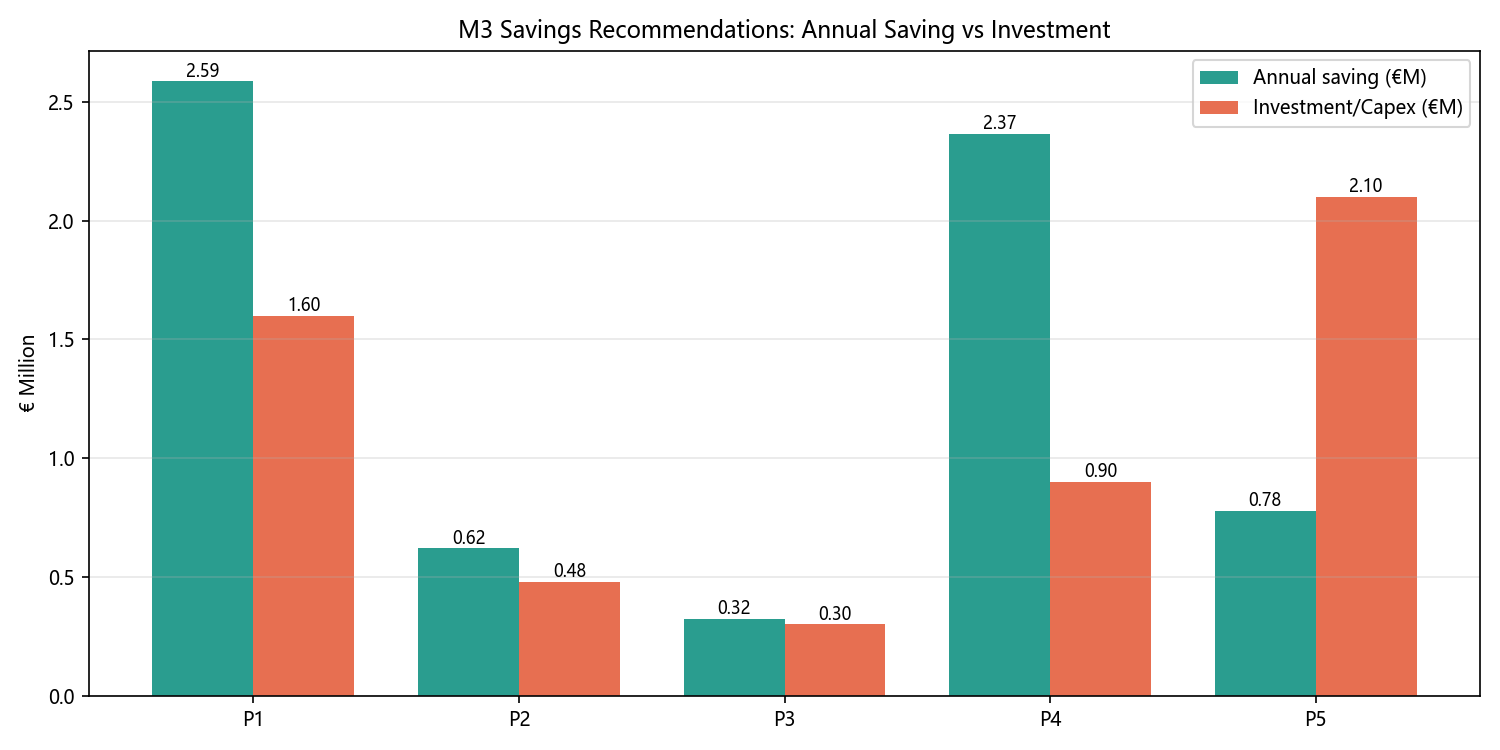
图:横轴投资额,纵轴年化节省,45°线为盈亏平衡。落在线上方的点是正 ROI。P5 在线下方。
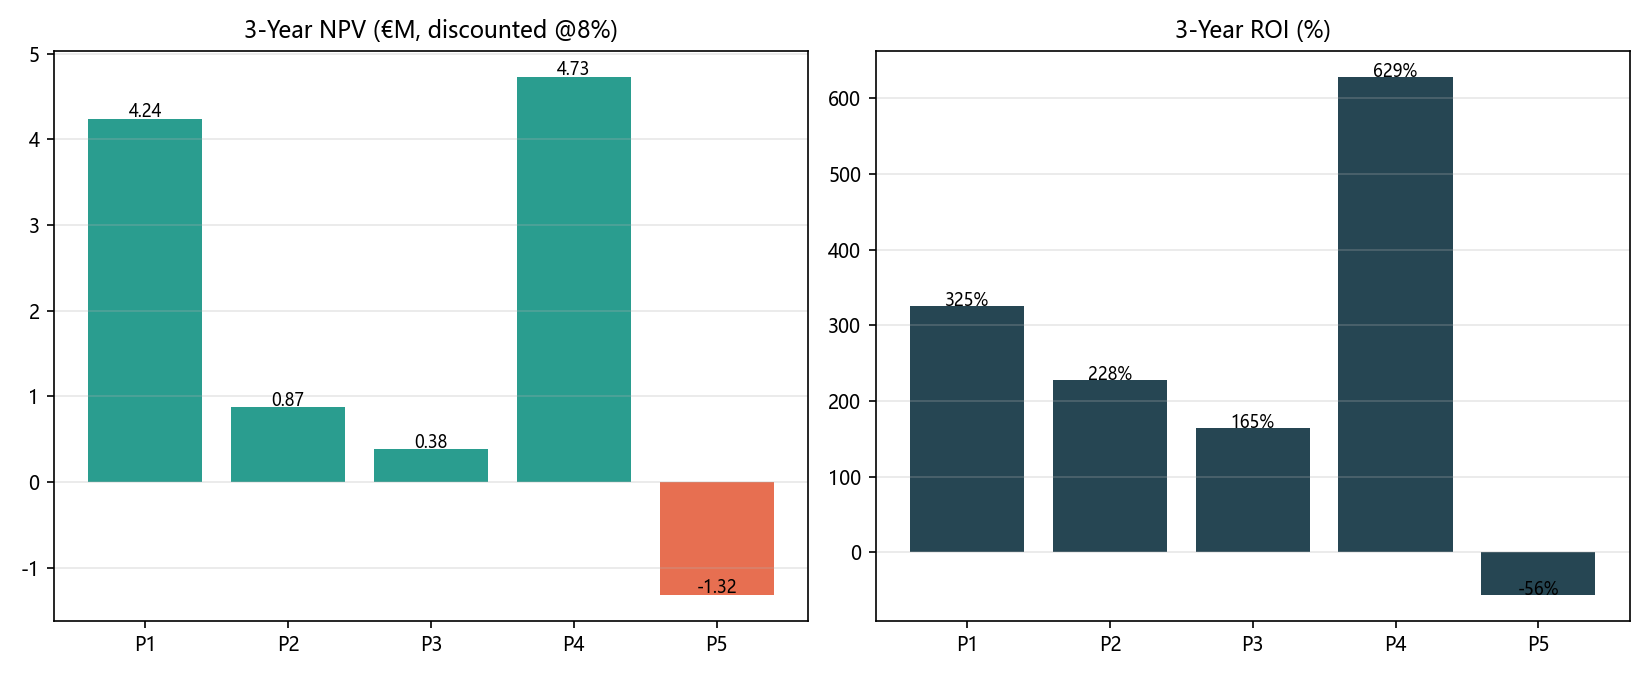
图:左侧柱为 3 年 NPV,右侧为 ROI 百分比。P5 的两根柱子都是负的,视觉上非常直观。
10.3 组合投资分析
如果五条全投:
| 指标 | 值 |
|---|---|
| 总年化节省 | €6.68M (占 M3 总成本 €19.6M 的 34.1%) |
| 总投资 | €5.38M + 年运维 €1.08M |
| 3 年净收益 | €10.09M |
| NPV(8%) | €7.82M |
| 3 年 ROI | 188% |
| 回本 | 2.2 年 |
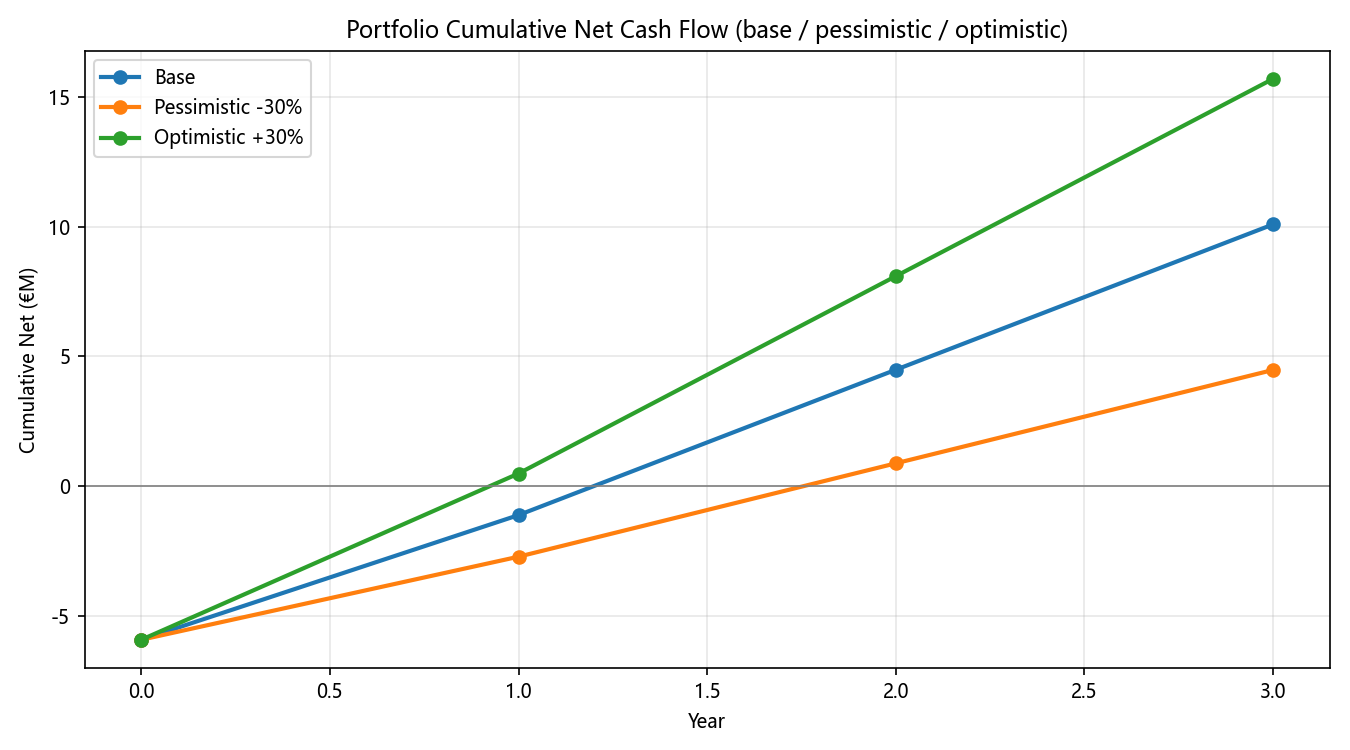
图:五条建议叠加的累计净现金流曲线。横轴为实施年数(考虑各条建议不同的实施周期),纵轴为累计净收益。曲线在约第 2 年穿过零轴。
图:€6.68M 年化节省的来源拆分。可以看到资金成本释放与人工成本释放各占一半左右。
10.4 核心洞见一:ROI 最高的是「几乎零成本」的那条
P4「对标 Real Estate 2-way match 模板推广」,ROI 629%,回本 1.4 年,是五条里最高的。
它的节省逻辑极简:
base_saving = CAPITAL_COST × 0.30全库 €7.89M 的资金成本,压缩 30%,就是 €2.37M。而投入只有 €0.90M------因为不需要开发新系统,只需要做流程重构、系统配置和变革管理。
这个 ROI 高的根本原因不是技术难度低,而是它复用了「已被验证的最优实践」。 Real Estate 那 145 张 2-way match 发票平均只等 8.9 天,这件事已经在真实运行中被证明了。把这个模式推到全库,等于把一条已验证的路铺宽,而不是从零找路。
「对标最佳实践」类机会,投入产出比最高。
10.5 核心洞见二:一个「否决信号」
P5「全类别通用作业自动化(GR/PO/发票/清账)」,ROI = −56%。
这是整份 ROI 分析里最重要的一条结论,因为它是一个明确的否决,而不是一个模糊的「优先级较低」。
先看它的数字有多诱人------它瞄准的是四个最大的活动:
| 目标活动 | 事件数 | 当前自动化率 |
|---|---|---|
| Record Goods Receipt | 156,653 | 26.6% |
| Create Purchase Order Item | 125,867 | 7.6% |
| Record Invoice Receipt | 114,986 | 4.1% |
| Clear Invoice | 97,352 | 4.1% |
| 合计 | 494,858 | ------ |
接近 50 万个事件,占全库 801,346 个事件的 62%。 如果按「哪些环节该自动化」的直觉判断,这显然是最大的机会。
但算出来的结果是:
| 项目 | 值 |
|---|---|
| 年化节省 | €0.78M |
| 投资 | €2.10M(五条里最高) |
| 3 年 ROI | −56% |
| 3 年 NPV | −€1.32M |
原因在单事件成本:
€40/h × 0.08h/次 = €3.2/次第 7.3 节已经算过,四个环节合计约 43.4 万个人工事件:
python
base_saving = sum([
    156653*(1-0.266)*MANUAL_COST_EVENT*0.5,   # 43.4万 × €3.2 × 50%
    125867*(1-0.076)*MANUAL_COST_EVENT*0.55,
    114986*(1-0.041)*MANUAL_COST_EVENT*0.60,
    97352*(1-0.041)*MANUAL_COST_EVENT*0.60,
])
即便自动化率提升到 60%,年节省也只有 €0.78M------因为每次「点击+录入」的真实人工成本只有 €3.2。而要覆盖 €2.1M 的 RPA + AI 部署投入,需要覆盖 65 万次以上操作。
这是「以事件量为导向 」而非「以成本量为导向」的典型陷阱。
这个区分极其重要:
| 导向 | 问的问题 | P5 的答案 |
|---|---|---|
| 以事件量为导向 | 「哪个环节最值得自动化?」 | GR/PO/发票/清账(494,858 个事件) |
| 以成本量为导向 | 「哪个环节的人工最值钱?」 | Packaging 的 €4.46M 手工成本 |
事件量最大的环节,未必是成本量最大的环节。 因为 Packaging 的问题是「11 万个订单 × 66.5 天等待」,而不是「人工点多」。
因此报告给出的处理是:
P5 应拆分到 P1(按 Packaging 高价值类别做)或与资金成本联动,而非全类别铺开。
10.6 核心洞见三:减法比加法更值钱
把 P1--P5 全投,ROI 188%。但剔除 P5 只投 P1+P2+P4:
| 方案 | 总投资 | 年化节省 | 3 年 ROI | 回本 |
|---|---|---|---|---|
| 全投 P1--P5 | €5.38M | €6.68M | 188% | 2.2y |
| 精选 P1+P2+P4 | €2.98M | €5.58M | >300% | <2y |
少投 €2.4M,多省 €1.1M,ROI 从 188% 提到 300% 以上。
原因很简单:全投方案的 ROI 被负 ROI 的 P5 拉低了。剔掉它,剩下的三条都是正的高 ROI 项,整体表现自然提升。
因为剔除负 ROI 的 P5 后,资源聚焦在高价值、低风险的机会。
这条洞见的普适价值可能超过本次分析本身:「做加法」在资源紧张时往往是错的,「做减法」才是。 前提是你已经把每一条的 ROI 都算清楚------包括那些 ROI 是负的。
10.7 敏感度验证:±30% 压力测试
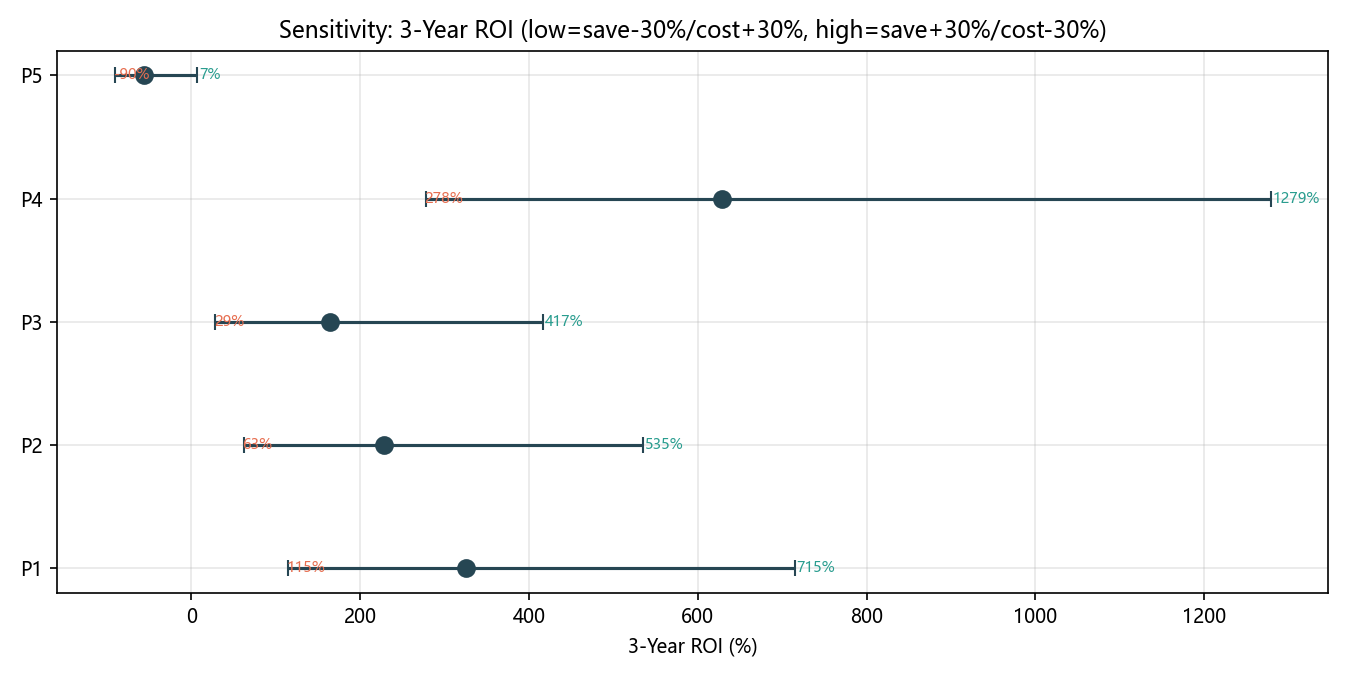
在「节省 −30%、成本 +30%」的悲观情景下重算:
| 建议 | 悲观情景 ROI | 结论 |
|---|---|---|
| P4 | > 180% | 稳健 |
| P1 | > 180% | 稳健 |
| P3 | ~90% | 为正,但安全垫最薄 |
| P5 | 负 | 全情景否决 |
P1 和 P4 在悲观情景下仍 >180%,说明它们的结论不依赖于对节省空间的乐观假设------即使只兑现七成,依然值得投。
P3 的安全垫最薄,只剩约 90%,所以建议「仅投高单值且账期长的子集」,而不是全投。
P5 在全部情景下均为负------这是最强的否决信号。
10.8 最终决策建议
| 决策 | 建议 | 依据 |
|---|---|---|
| 立即投资 | P4 + P1 + P2(合计 €2.98M) | 三者合计年化 €5.58M,3 年 ROI 显著为正 |
| 优先投 P4 | 对标模板推广(ROI 629%,最低风险) | 低投入高确定性 |
| P3 选择性投 | 仅投高单值且账期长的子集 | 敏感度安全垫最薄 |
| 否决/重构 P5 | 不建议全类别铺开 | 负 ROI,事件量大 ≠ 成本量大 |
| 顺序 | P4 → P1 → P2 → P3,P5 否决 | ROI 从高到低 |
11. 第 5 步:TDABC 下钻到「业务线 × 供应商」
第 5 轮的追问是粒度问题:
进一步把某类成本模型(如 TDABC)落到单条业务线/供应商粒度,所有业务线以及供应商。
这一步的挑战在于:分摊会不会把数字算坏? 1,975 家供应商 × 18 条业务线,任何分摊都容易变成「拍脑袋分配」。
11.1 分摊设计:两种处理方式,这是关键
分析脚本对三个成本分量用了两种不同的处理策略:
| 成本分量 | 单位成本 | 分摊方式 | 是否精确对账 |
|---|---|---|---|
| 返工人工 | €20/事件 | 按供应商订单量 × 非合规权重分摊该业务线已验证成本池 | ✅ 与类别级完全一致 |
| 手工处理人工 | €20/事件 | 按供应商订单量分摊该业务线已验证成本池 | ✅ 与类别级完全一致 |
| 资金占用成本 | 8% CoC × 等待天数 × 采购额 | 用每家供应商真实的发票等待中位数 × 其采购额重算 | 差异化 |
这个区分是整个下钻的技术核心,报告里写得很清楚:
关键设计决策 :人工成本是「固定成本池的分配」(把已验证的业务线人工成本池分到供应商头上),所以对账完全一致;而资金占用成本 是真正的差异化------它不再用业务线平均等待,而是用每家供应商自己的真实等待中位数去乘其真实采购额。这揭示的是「哪家供应商真正把钱压在账上」,是本次下钻的核心增量价值。
这个设计的价值在于它区分了「分摊」和「重算」:
- 人工成本本质上无法归因到供应商------两个人处理同一个业务线,费率一样、动作一样。分摊是唯一诚实的做法,而且只要分摊规则明确,加总回去就等于原值,可以对账。
- 资金成本不同------不同供应商的付款周期差异巨大(8.9 天 vs 105 天)。用业务线平均等待去乘每家的采购额,会把这个最有价值的信号抹平。必须用每家自己的等待天数重算。
所以这次下钻不是「把数字切得更碎」,而是「在资金维度上做了一次真实的再分析」。
报告也诚实标注了这个选择带来的口径差异:
⚠️ 资金成本总额 €14.97M 高于类别级瓶颈口径 €7.89M,因为前者覆盖全部采购额(按各供应商真实等待),后者仅覆盖 72.8% 有瓶颈等待的流程------口径不同,属预期的真实差异,非误差。
11.2 总体结果
全部 1,975 家供应商 × 18 条业务线 TDABC 成本 = €26,747,874,构成:
| 成本分量 | 金额 | 占比 |
|---|---|---|
| 返工人工 | €1,239,099 | 4.6% |
| 手工处理人工 | €10,537,674 | 39.4% |
| 资金占用成本 | €14,971,101 | 56.0% |
资金成本占 56%,是全盘最大的价值漏损。 而它不需要新增任何人力------纯粹把流程提速就能释放。
集中度极端:
T1高(494家, 25%)  →  94.2% 的 TDABC 成本   ← 治理焦点
T2(494家)         →   4.x%
T3(494家)         →   1.x%
T4低(494家, 25%)  →   0.2%
25% 的供应商承载 94.2% 的成本,最低 25% 只有 0.2%。
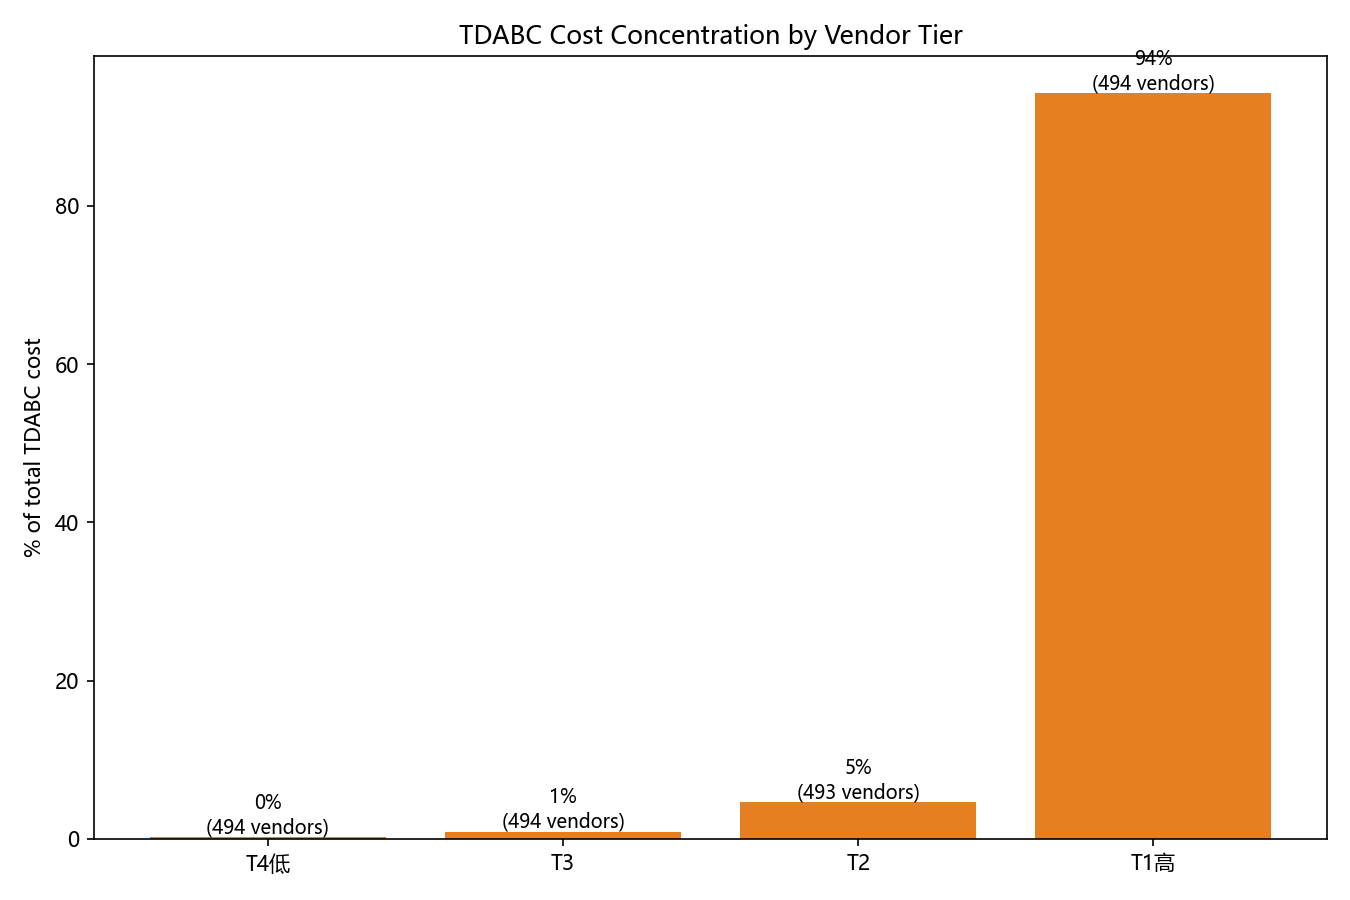
图:四层供应商的成本占比。T1 层单独占 94.2%,T4 层几乎不可见。这就是「降本不需要对 1,975 家全面铺开」的图形证据。
11.3 业务线粒度
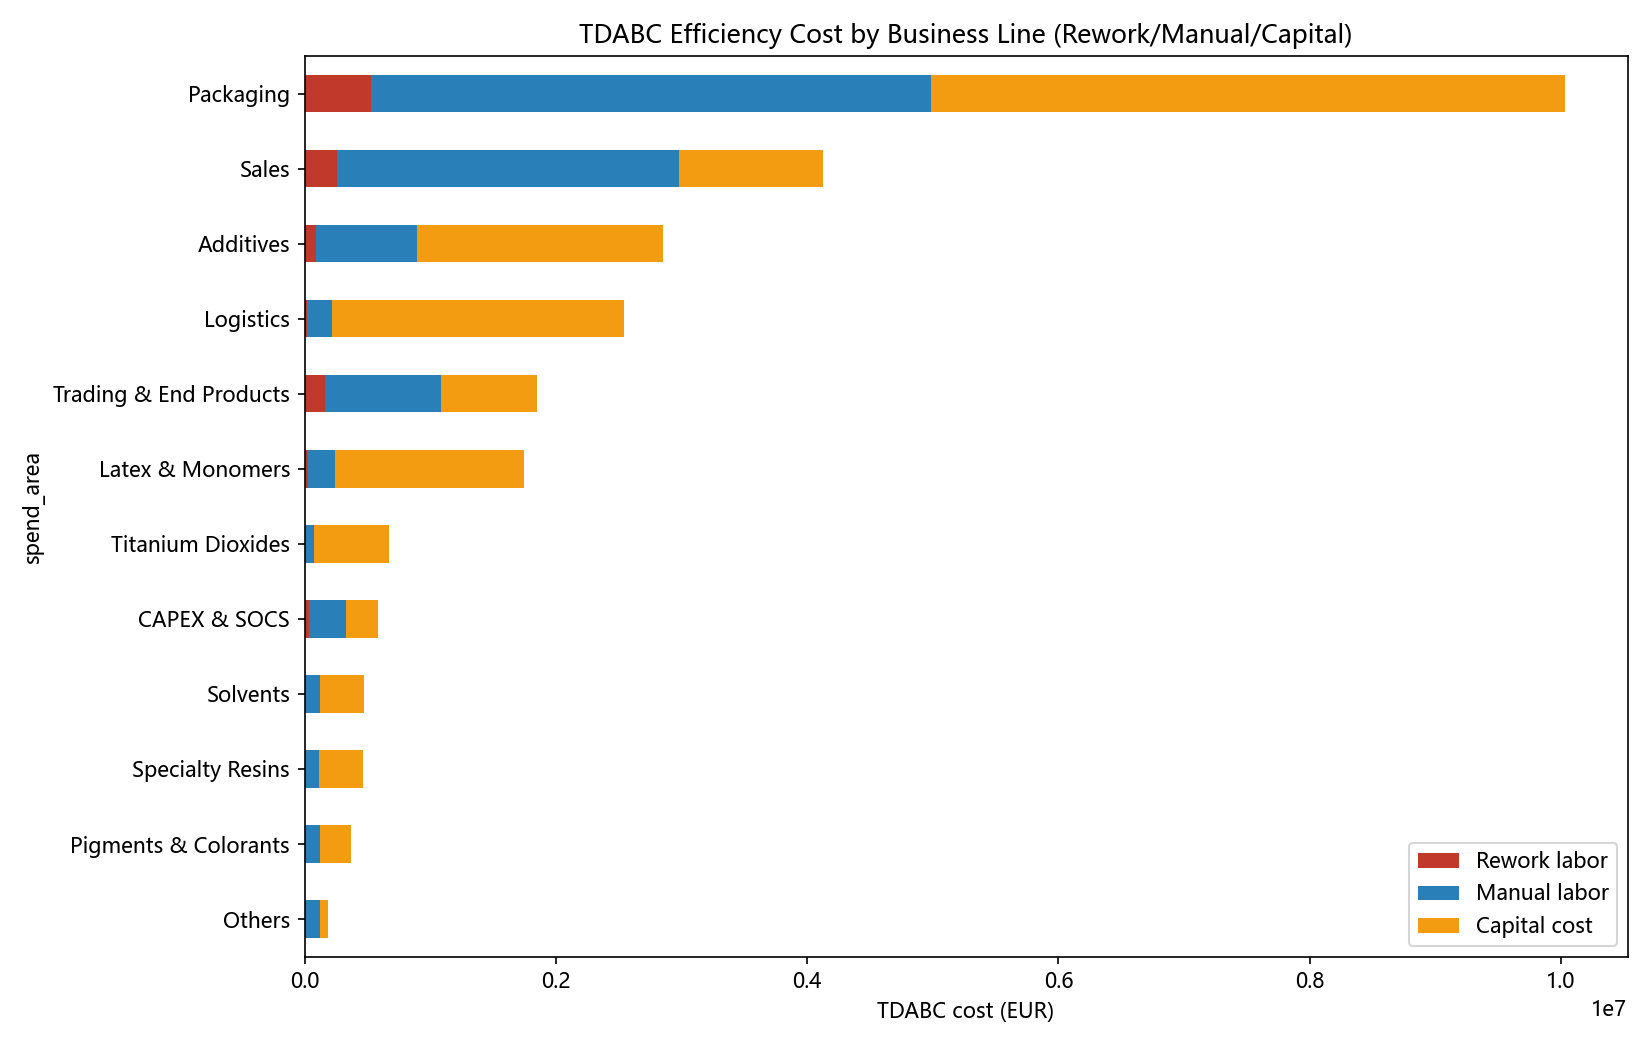
| 业务线 | 供应商数 | 订单数 | 返工人工 | 手工人工 | 资金成本 | TDABC 合计 | 占比 | €/单 | 成本占采购% |
|---|---|---|---|---|---|---|---|---|---|
| Packaging | 247 | 111,889 | 527K | 4,455K | 5,045K | 10,027K | 38.1% | 90 | 2.47% |
| Sales | 330 | 66,419 | 257K | 2,723K | 1,147K | 4,126K | 15.7% | 62 | 2.42% |
| Additives | 281 | 16,888 | 89K | 805K | 1,956K | 2,850K | 10.8% | 169 | 1.52% |
| Logistics | 120 | 5,230 | 19K | 197K | 2,323K | 2,539K | 9.6% | 485 | 0.85% |
| Trading & End Products | 94 | 21,322 | 165K | 924K | 764K | 1,853K | 7.0% | 87 | 1.96% |
| Latex & Monomers | 40 | 6,200 | 26K | 216K | 1,504K | 1,746K | 6.6% | 282 | 1.30% |
| Titanium Dioxides | 20 | 1,907 | 8K | 68K | 597K | 673K | 2.6% | 353 | 1.23% |
| CAPEX & SOCS | 113 | 6,950 | 32K | 300K | 250K | 582K | 2.2% | 84 | 1.31% |
| Solvents | 32 | 2,883 | 12K | 112K | 352K | 476K | 1.8% | 165 | 1.48% |
| Specialty Resins | 50 | 2,576 | 13K | 103K | 352K | 467K | 1.8% | 181 | 1.36% |
| Pigments & Colorants | 68 | 2,026 | 15K | 112K | 241K | 368K | 1.4% | 182 | 1.60% |
| Others | 180 | 1,548 | 13K | 109K | 62K | 185K | 0.7% | 119 | 1.69% |
| Marketing | 128 | 1,567 | 5K | 75K | 82K | 162K | 0.6% | 104 | 1.21% |
| Enterprise Services | 84 | 552 | 5K | 33K | 60K | 97K | 0.4% | 177 | 0.79% |
| Real Estate | 93 | 582 | 22K | 33K | 18K | 73K | 0.3% | 125 | 0.90% |
| Workforce Services | 44 | 115 | 1K | 13K | 54K | 68K | 0.3% | 594 | 0.59% |
| Commodity Resins | 10 | 198 | 3K | 20K | 16K | 38K | 0.1% | 191 | 1.89% |
| Energy | 2 | 15 | 1K | 1K | 1K | 3K | 0.0% | 194 | 0.47% |
| 合计 | 1,975 | 253,689 | 1,239K | 10,538K | 14,971K | 26,748K | 100% | --- | --- |
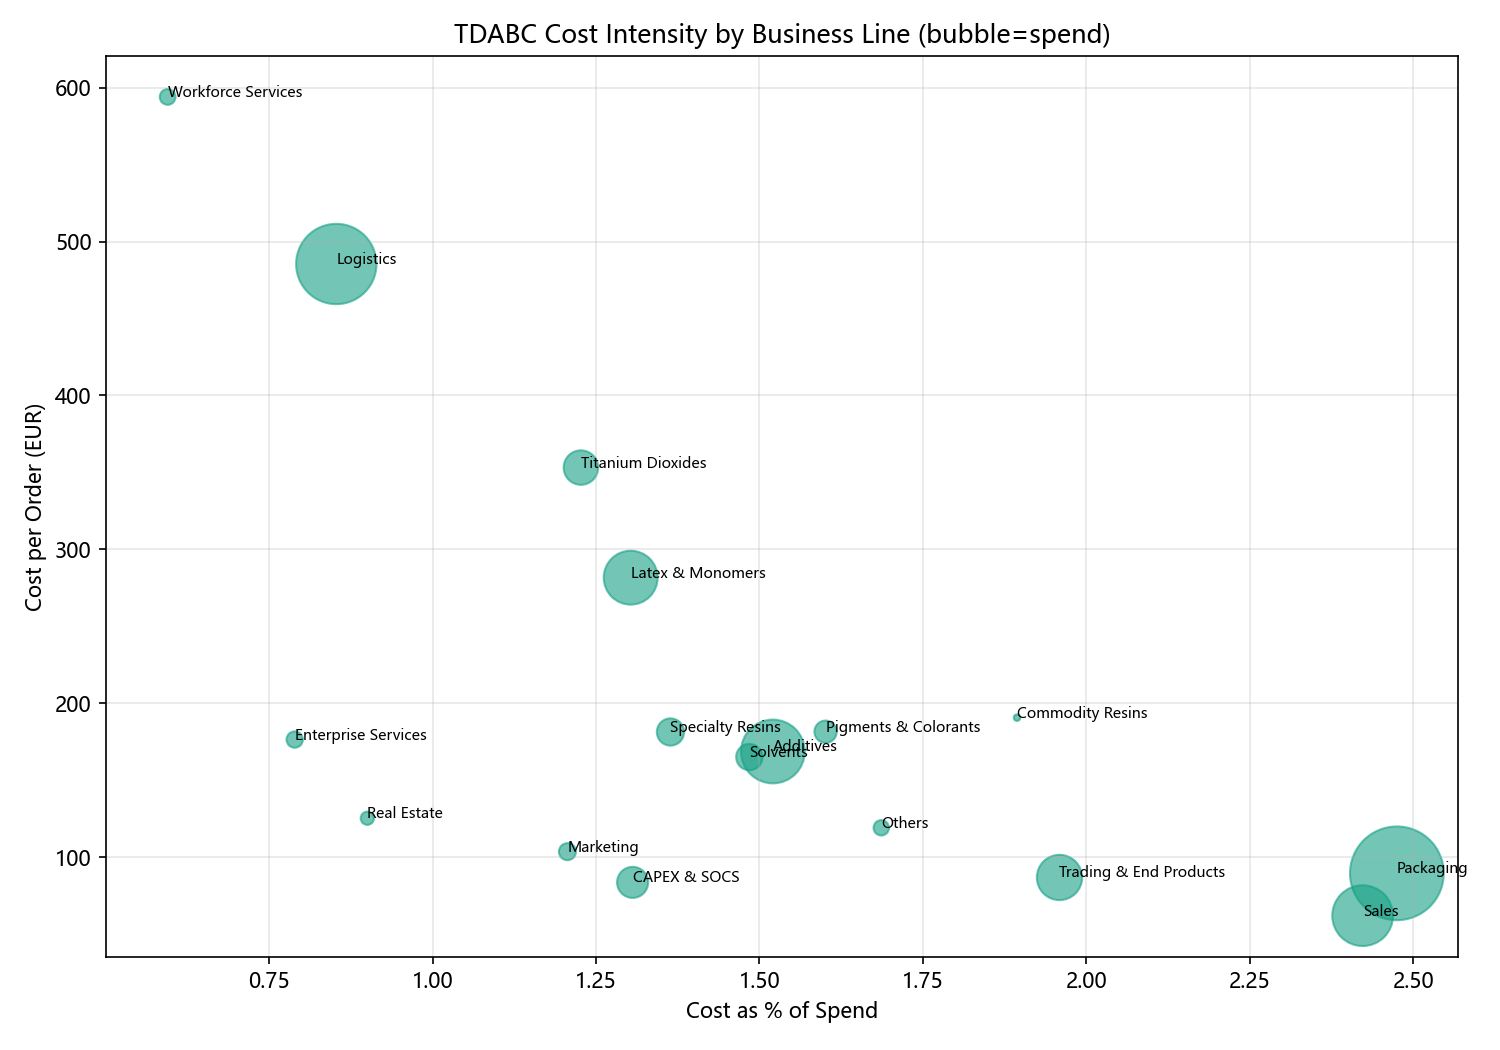
图:横轴订单数,纵轴资金成本,气泡大小为 TDABC 总成本。右上方是大批量高资金(Packaging),左上方是小批量高资金(Latex & Monomers),右下方是大批量低资金(Sales)------三种截然不同的治理策略。
四条业务线洞见:
-
Packaging 一家占 38.1% (€10.0M),且其资金成本 €5.04M 已超过人工成本 €4.99M ------高订单量(11.2 万单)× 长等待叠加。先动 Packaging = 动 40% 的成本盘。
-
Logistics 单位成本最高(€485/单),但订单量小(5,230)------人工成本池小,资金成本(€2.3M)却很大。属于「低量大额」的高危业务线。
-
Sales 供应商最多(330 家) ,订单量大但单笔金额小------人工成本 €2.72M 是主要驱动,适合批量自动化而非资金管理。
-
Workforce Services 单笔成本 €594 最高,但量极小(115 单)------是流程复杂度极高的长尾。
第 3 条特别值得留意:Sales 在 ROI 测算里(P5 相关)被判为「适合批量自动化」,因为它量大额小、单事件人工成本低但绝对量大------这与 P5 被否决并不矛盾,区别在于 Sales 单列一个类别做,P5 是全类别铺开。
11.4 供应商粒度:TOP 20
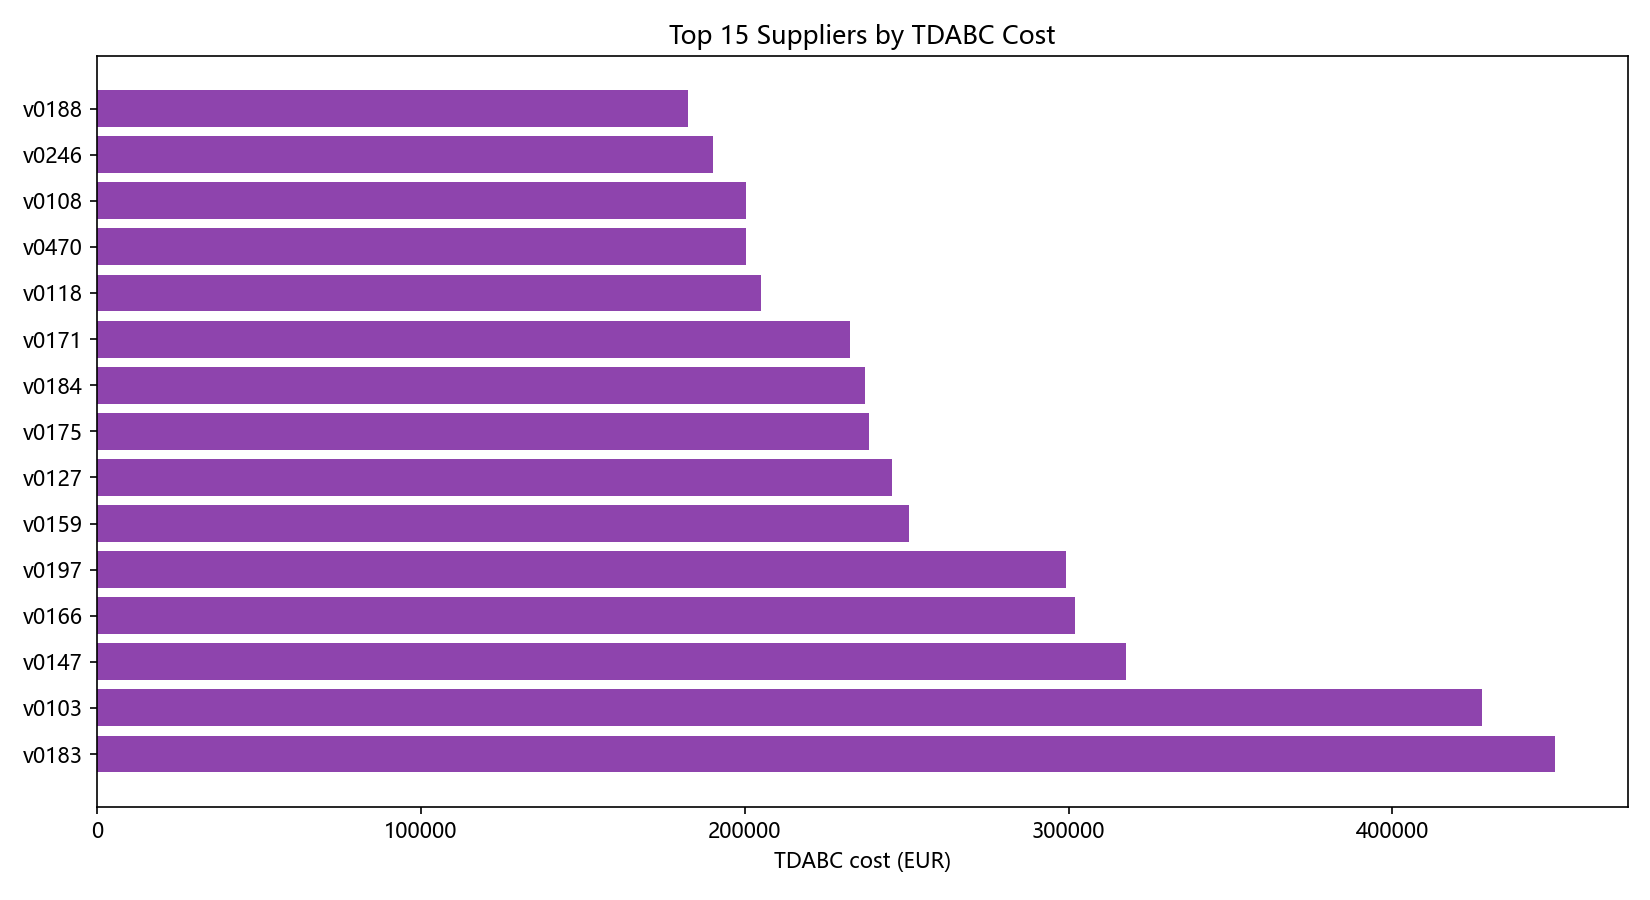
| 供应商 | 业务线 | 订单 | 采购额 | 返工 | 手工人工 | 资金成本 | TDABC | €/单 |
|---|---|---|---|---|---|---|---|---|
| vendorID_0104 | Packaging | 9,817 | 52.08M | 44K | 391K | 776K | 1,211K | 123 |
| vendorID_0106 | Packaging | 7,231 | 60.59M | 32K | 288K | 846K | 1,167K | 161 |
| vendorID_0120 | Packaging | 13,564 | 25.21M | 60K | 540K | 498K | 1,098K | 81 |
| vendorID_0136 | Packaging | 14,471 | 19.66M | 65K | 576K | 453K | 1,093K | 76 |
| vendorID_0182 | Packaging | 7,250 | 7.03M | 33K | 289K | 130K | 452K | 62 |
| vendorID_0183 | Latex & Monomers | 674 | 38.79M | 3K | 23K | 424K | 450K | 668 |
| vendorID_0103 | Packaging | 6,014 | 7.43M | 28K | 239K | 160K | 428K | 71 |
| vendorID_0147 | Additives | 1,340 | 20.08M | 7K | 64K | 247K | 318K | 237 |
| vendorID_0166 | Latex & Monomers | 1,105 | 19.99M | 5K | 38K | 259K | 302K | 273 |
| vendorID_0197 | Trading & End | 3,055 | 12.69M | 28K | 132K | 139K | 299K | 98 |
供应商洞见:
-
TOP 4 全是 Packaging 供应商 (0104 / 0106 / 0120 / 0136),合计 €4.57M,占 TOP20 的 55%------Packaging 的降本必须落到这 4 家具体供应商的合同与流程治理上。
-
vendorID_0104(€1.21M)成本最高:9,817 单、€52M 采购,资金成本 €776K 占其 64%------该供应商等待极长,是资金治理的第一优先级。
-
vendorID_0106(€1.17M) :资金成本 €846K 是所有供应商中最高(€60M 大额 × 长等待)------单笔大额采购的资金占用暴露最严重。
-
vendorID_0183(€450K,Latex & Monomers):仅 674 单但 €/单成本 €668,是「低量高单值」资金吞噬的典型。
11.5 从集中度推出治理路径
把「94.2% 集中在 25% 供应商」和「资金成本占 56%」这两个事实叠加,直接得到治理顺序:
| 优先级 | 动作 | 治理对象 | 释放成本 | 杠杆 |
|---|---|---|---|---|
| P1 | Packaging 巨头资金压缩 | 0104 / 0106 / 0120 / 0136 | €5.0M 资金 | 压缩 30% 等待 → 释放 ~€1.5M,纯流程,无需加人 |
| P2 | 全库等待对标 Real Estate | TOP 494 家 | €14.97M 资金 | 平均等待 50→9 天,释放 ~€5.7M |
| P3 | Sales 批量自动化 | Sales 330 家 | €2.72M 手工 | 高订单量 × 单事件成本低,适合 RPA |
| P4 | 长等待大额供应商专项 | 0106 / 0183 / 0147 | 资金+人工 | 单家 >€300K,逐一清账治理 |
核心结论 :资金占用成本(€14.97M,占 56%)是 TDABC 全盘的最大漏损,且它集中在 Packaging 业务线(€5.0M)的 TOP 4 供应商。降本应从「业务线 × 供应商」交叉治理入手:先救 Packaging 的 4 家资金巨头,再按供应商排名逐一压缩等待。
注意这里的 P1 与第 10 节 ROI 测算的 P1 是同一个对象------这说明两次独立推进(第 3 轮的比对、第 5 轮的下钻)得到了收敛一致的结论。这种收敛本身就是结论可靠性的一个信号。
12. 第 6 步:Packaging 业务线全链条剖析
第 6 轮的追问换了范式:
详细分析业务线【Packaging】的成本方面的全链条分析,根据经典业务分析流程,全景分析该业务线。
这一轮不再横向比较,而是纵向钻透一条业务线。采用的方法是经典的业务分析八步法:
业务概览 → 流程价值链 → 成本结构拆解 → 环节成本 → 供应商粒度
        → 根因诊断 → 对标 → 降本行动与 ROI
12.1 业务概览
| 指标 | 事件级口径 | 供应商级口径 |
|---|---|---|
| 订单量 | 54,579 | 111,889 |
| 采购金额(净额) | €140.99M | €405.15M |
| 平均订单金额 | €2,583 | --- |
| 供应商数 | --- | 247 |
| 主导流程 | 3-way match,发票先于收货(88.2% 轨迹) | --- |
| 流程时长 | 均值 77.6 天 / 中位 79.1 天 | --- |
Packaging 的定位:全集团 38.1% 的 TDABC 成本所在(€10.03M / €26.35M),且是唯一「资金成本(€5.04M)已超过人工成本(€4.99M)」的业务线。
这最后一句是整段分析的关键------它意味着 Packaging 的痛点核心是资金占用而非单纯作业效率。
12.2 成本结构拆解
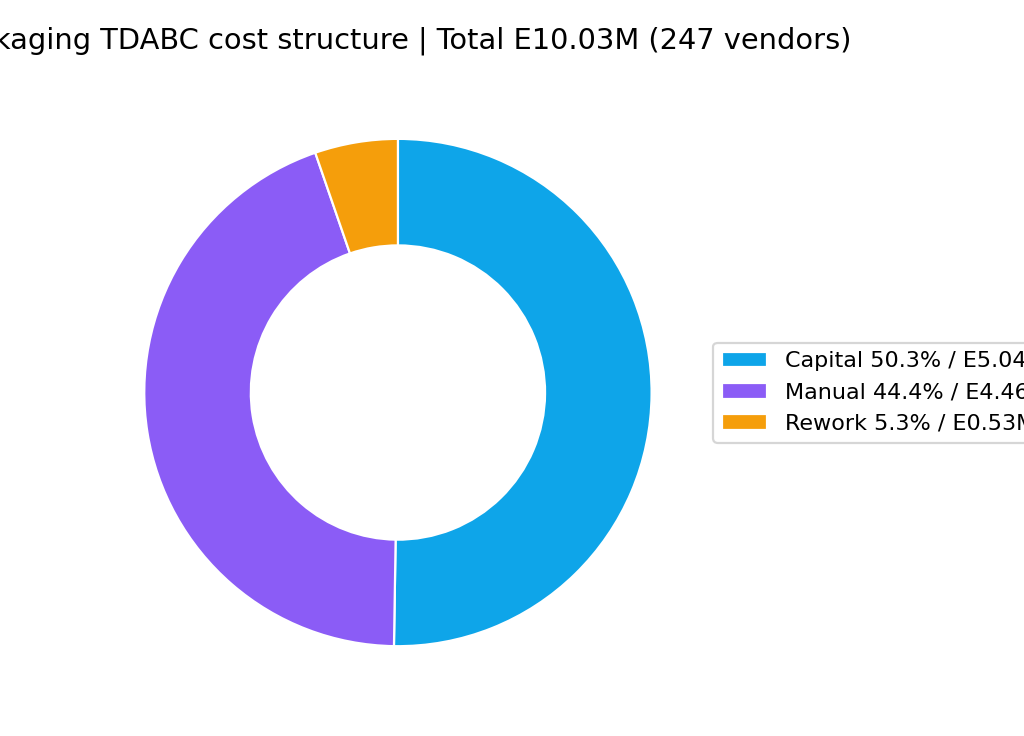
| 成本层 | 金额 | 占比 | 驱动因素 |
|---|---|---|---|
| 资金占用成本 | €5.04M | 50.3% | 发票等待中位 67 天 × 8% CoC |
| 手工人工成本 | €4.46M | 44.4% | 自动化率仅 26.99%,22.3 万笔手工 |
| 返工人工成本 | €0.53M | 5.3% | 2.63 万返工事件 / 2.07 万轨迹 |
全链条核心判断:Packaging 的成本主体是「钱被压在账上的时间成本」,而非返工。
这里有一个非常反直觉的结论,值得单独强调:
这与集团「重返工」的普遍印象不同------Packaging 返工占比全集团最低(5.3%),但资金成本占比全集团最高。
大多数企业的直觉是「打包类采购单子多、变更多、返工肯定严重」。数据显示反过来了:Packaging 的返工只占它自身成本的 5.3%,而钱压账上的时间成本占了整整一半。
12.3 流程价值链:PO → GR → 发票 → 清账
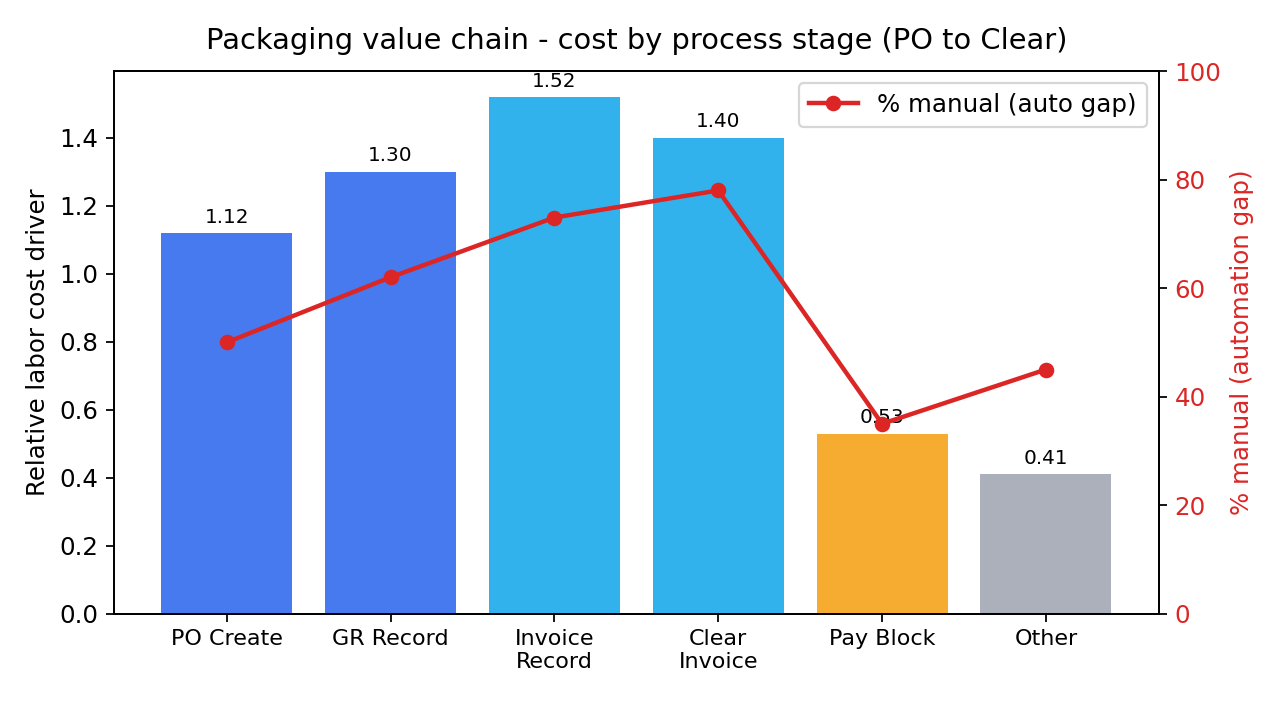
沿采购到付款全链路,逐环节看自动化缺口:
| 环节 | 相对人工驱动 | 自动化缺口(%手工) | 症结 |
|---|---|---|---|
| PO 创建(Create Item) | 1.12 | 50% | 低自动化,重复采购单 |
| 收货(GR) | 1.30 | 62% | 发票先于收货 → 触发等待 |
| 发票记录(Invoice) | 1.52 | 73% | 3-way match 人工核对 |
| 清账(Clear) | 1.40 | 78% | 清账前资金滞留最久 |
| 付款冻结(Block) | 0.53 | 35% | 返工主要来源 |
| 其他 | 0.41 | 45% | --- |
发票记录与清账两个环节的自动化缺口(73% / 78%)是全链最大的漏损。
而根因链在这里合拢了:
主导流程「3-way match、发票先于收货(88.2%)」是恶性循环的根源 ------
收货(GI)环节延迟 → 发票无法 3-way 匹配 → 触发等待与付款冻结 → 清账与资金滞留。
这是一条自我强化的循环:越等越慢,越慢越多冻结,越多冻结越走不动。分析报告把它列为「流程设计缺陷(首要根因)」。
12.4 供应商粒度:247 家的高度集中
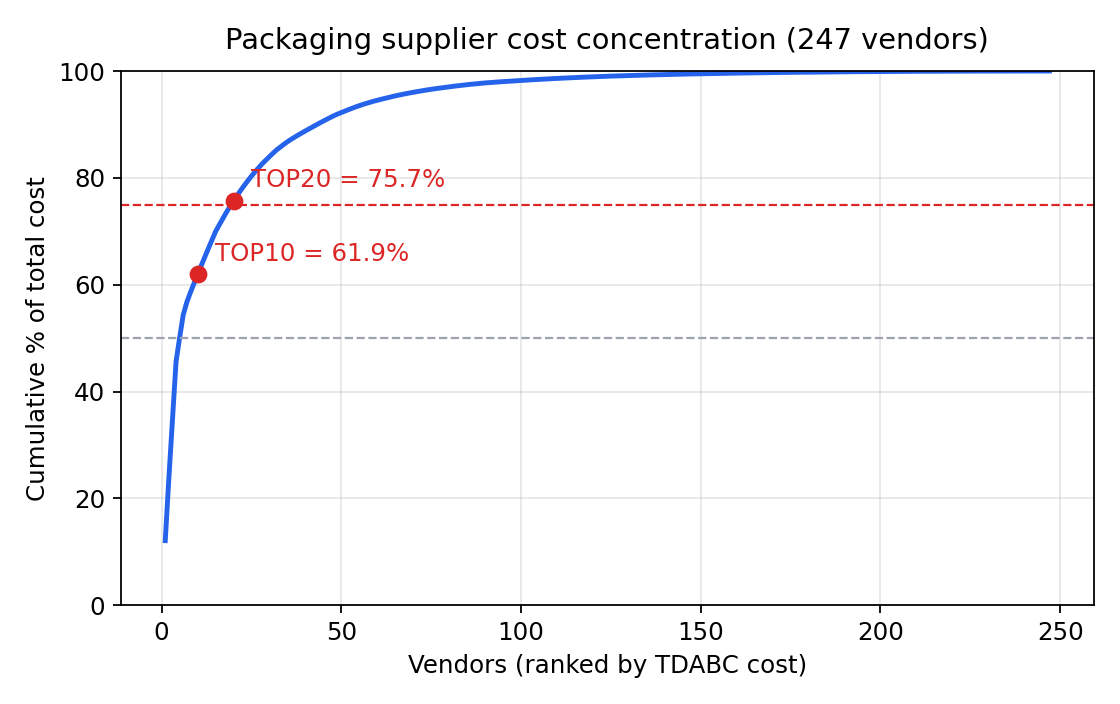
| 集中度 | 覆盖成本 | 占比 |
|---|---|---|
| TOP10 供应商 | €6.21M | 61.9% |
| TOP20 供应商 | €7.59M | 75.7% |
| 36 家等待≥60 天的供应商 | €6.11M | 61% |
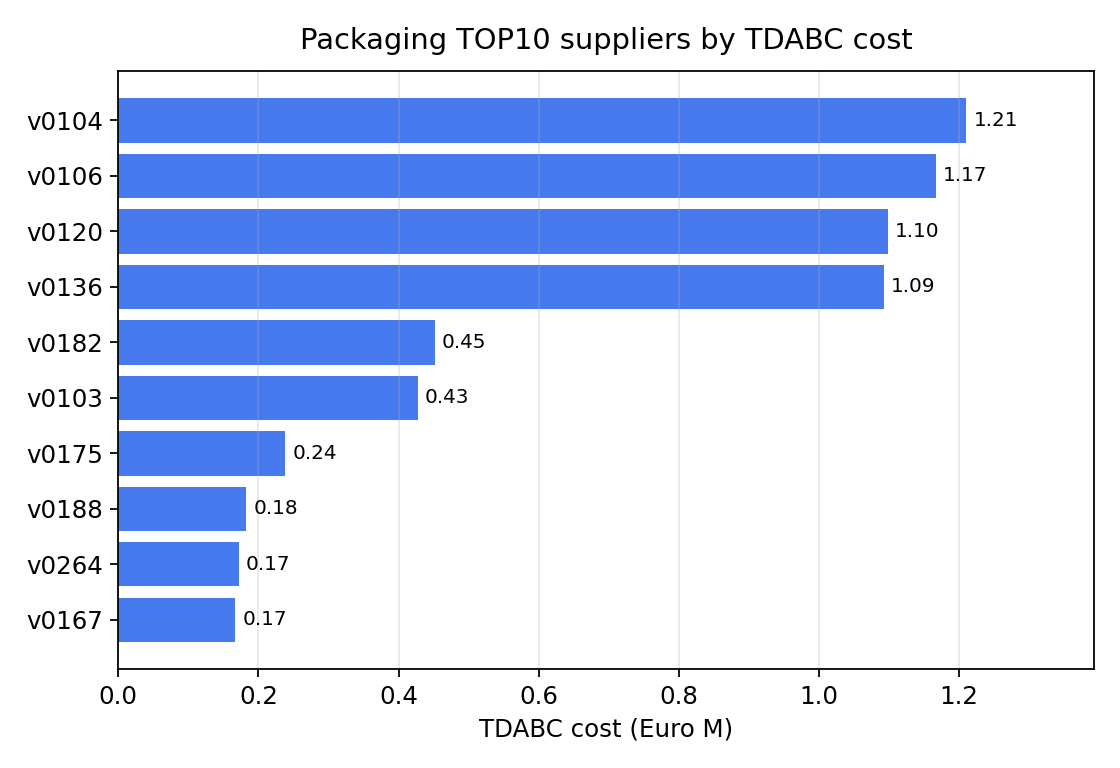
| 供应商 | TDABC | 订单 | 采购额 | 等待 | 资金成本 |
|---|---|---|---|---|---|
| vendorID_0104 | €1.21M | 9,817 | €52.1M | 68 天 | €0.78M |
| vendorID_0106 | €1.17M | 7,231 | €60.6M | 64 天 | €0.85M |
| vendorID_0120 | €1.10M | 13,564 | €25.2M | 90 天 | €0.50M |
| vendorID_0136 | €1.09M | 14,471 | €19.7M | 105 天 | €0.45M |
| vendorID_0182 | €0.45M | 7,250 | €7.0M | 84 天 | €0.13M |
| vendorID_0103 | €0.43M | 6,014 | €7.4M | 98 天 | €0.16M |
| vendorID_0175 | €0.24M | 1,296 | €15.0M | 55 天 | €0.18M |
| vendorID_0188 | €0.18M | 3,592 | €2.0M | 29 天 | €0.01M |
| vendorID_0264 | €0.17M | 3,264 | €2.4M | 52 天 | €0.03M |
| vendorID_0167 | €0.17M | 1,630 | €8.8M | 49 天 | €0.09M |
四大巨头(0104 / 0106 / 0120 / 0136)合计 €4.57M(46% 的业务线成本) ,且全是「高订单量 + 长等待 + 大额采购」的资金型供应商------它们的等待天数在 64 到 105 天之间,是全库平均(49.9 天)的 1.3 到 2.1 倍。
12.5 根因诊断(五条)
- 流程设计缺陷(首要根因):88.2% 采用「发票先于收货」的 3-way match。收货延迟 → 发票无法匹配 → 等待/冻结,是整个资金成本链条的源头。
- 自动化严重不足 :自动化率仅 26.99%(集团中下游),发票记录/清账环节 73--78% 靠人工,直接推高手工成本 €4.46M。
- 供应商长等待:36 家供应商等待≥60 天,其中 4 家巨头平均等待 80--105 天。
- 合规质量中等:平均全流程合规率 68.9%,返工事件 2.63 万笔。
- 规模不经济:TOP4 占 46% 成本却仅承担采购规模不足 40% 的集中议价------大额供应商没有被战略管理。
第 5 条是个采购侧洞察,前面所有分析都在讲流程效率,只有这里提到了「议价能力」:既然 4 家供应商占了 46% 的成本,却只贡献不到 40% 的采购额,那议价谈判的筹码没有被用起来。
12.6 对标:与集团最优比较
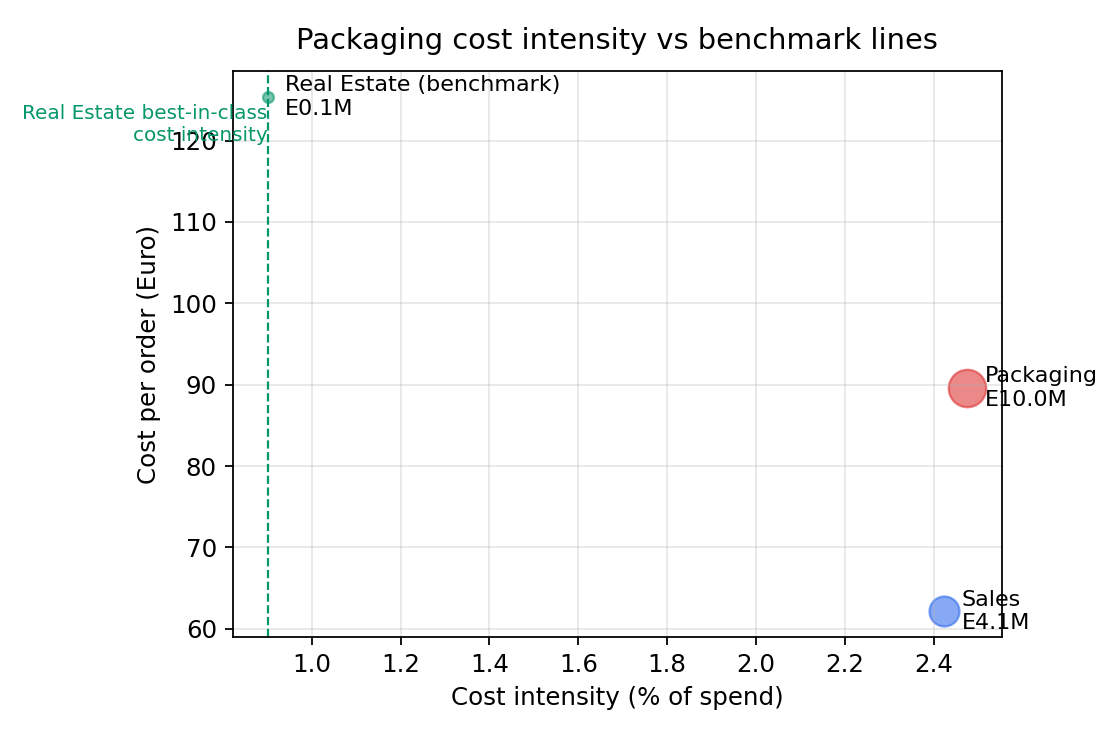
| 指标 | Packaging | Sales | Real Estate(最优) |
|---|---|---|---|
| 成本强度(%采购额) | 2.47% | 2.42% | 0.90% |
| 单笔成本 | €89.6 | €62.1 | €125(低量) |
| 等待标杆 | 67 天 | --- | 8.9 天 |
Packaging 的成本强度是 Real Estate 最优水平的 2.7 倍,等待是标杆的 7.5 倍。
若 Packaging 等待压缩至 Real Estate 水平,资金成本可释放 €4.2M+。
这里再次出现了同一个标杆。Real Estate 在这份分析里被反复引用了四次 ------第 7.2 节(145 张 2-way match 发票)、第 8.2 节(成本强度最低的类别)、第 9.5 节(对标模板)、第 12.6 节(对标基准)。每次引用都指向同一个事实:流程里已经存在一个更好的做法,而且它就在跑。
12.7 降本行动与 ROI
| 优先级 | 措施 | 释放量 | 投资 | 3 年 ROI | 回本 |
|---|---|---|---|---|---|
| P1 | 36 家长等待供应商压缩至 ≤30 天(尤其 4 巨头) | ~€1.9M/年 | €1.2M | ~330% | <1.2 年 |
| P2 | 发票/清账环节自动化(缺口 73%→50%) | ~€1.3M/年 | €1.0M | ~260% | <1.8 年 |
| P3 | TOP4 供应商战略管理(集中议价+付款条款) | 采购额 2% = €5.6M/年 | --- | --- | --- |
| P4 | 3-way match 策略调整(对标 Real Estate) | 消除等待与冻结源头 | --- | --- | --- |
全链条可释放:€2.5M~€4.5M/年(人工+资金),若含采购议价可至 €8M+/年。
注意 P1 的 ROI 330%,与第 10 节 M3 层面的 P1(325%)几乎一致------从类别层面和从供应商层面独立算出的数字相互印证,这是结论可靠性的又一证据。
而 P3 的 €5.6M 是个完全不同的量级和性质:它不来自流程效率改进,而来自采购议价。前 12 步的分析全部聚焦在「流程怎么跑」,只有这一步跳出了流程视角,看到了商业条款。
13. 复盘:跑出了什么,也暴露了什么
写完六步分析,最有价值的部分不是赞美,而是诚实地复盘。
13.1 跑出来的东西
一份从事件日志到投资决策的完整链路。
| 层级 | 交付物 |
|---|---|
| 原始加工 | events_long.parquet(7.7MB)、traces_summary.parquet(3.9MB) |
| 指标 | cost_metrics.json、roi_metrics.json、vendor_tdabc_metrics.json |
| 明细 | category_cost_drilldown.csv、vendor_tdabc_detail.csv(1,975 家)、vendor_top_tdabc.csv、roi_summary.csv |
| 图表 | 35 张 PNG(成本/模型/ROI/供应商/Packaging 五组) |
| 报告 | 5 份 Markdown + 5 个自包含交互 HTML + 1 份 PDF |
| 脚本 | 16 个分析脚本,从 explore_xes.py 到 roi_analysis.py |
每一个数字都能回溯。 这是「业财一体化」在工具层面的体现:财务报表里的数字和流程日志里的事件来自同一条 trace,成本假设全部集中在 cost_metrics.json 一处定义,散落各处的引用都能追到源头。
13.2 暴露的问题一:会话中大量的无效探索
这是最直观的观察。会话记录里,用户在第 2--6 轮反复输入「继续」「go」「继续完成」------最多的一轮连发了 5 次「继续完成」。Agent 侧的对应输出经常只有 200--300 字符,内容是:
Let me proceed with building the ROI calculation. I'll first gather the exact numbers...
Let me check the environment and read the key data files in one batch.
解释器命令未被识别,换用另一种调用方式。
这些卡点几乎全部属于「怎么干活」的层面,且完全可以预先避免:
| 问题类别 | 出现频次 | 根因 | Workflow 能否预防 |
|---|---|---|---|
| 解释器/运行时的调用方式反复试错 | 反复 | 运行时环境差异未前置确认 | ✅ 写进阶段 0 前置检查 |
| 读文件工具的相对路径与命令行工作目录基准不一致 | 反复 | 各工具路径基准不同 | ✅ 写明「统一用绝对路径」 |
| 安装第三方过程挖掘库超时 | 1 次 | 网络/体积 | ✅ 写死「用流式解析,不引入外部库」 |
| 不同 Shell 的语法混用(重定向、切换目录)报错 | 3+ 次 | Shell 语法混用 | ✅ 写明「本环境 Shell 及其语法」 |
| 不确定数据文件与产物各在哪个目录 | 反复 | 目录约定未固化 | ✅ 写进产出路径规范 |
这正是 Workflow 存在的核心理由之一。 这些踩坑和业务无关、和数据无关、和分析方法无关------它们是「怎么干活」层面的知识,而它们恰恰是最可复用、最该被固化的。
一个合理的 Workflow 在这个例子里会怎么写:
markdown
## 环境前置检查(阶段 0)
- 确认 Shell 语法与解释器可用方式,禁止混用其他 Shell 的语法
- 大文件解析使用流式方式,禁止尝试引入体积庞大的外部库
- 读文件统一使用绝对路径(读文件工具与命令行的路径基准不同)
- 确认过程数据与最终交付的目录归属

## 产出路径规范
- 过程数据 → `work/output/`
- 最终交付 → `work/final_files/`
- 图表 → `work/final_files/charts/`
这几行能省掉本次会话里大约三分之一的工具调用。 关键在于:它们与业务无关,因此写一次、永久有效------不像分析结论那样每次都要重算。
13.3 暴露的问题二:口径漂移
这是更严重的一个问题,也正好对应 BizFin Workflow C0 那条「同名指标全流程唯一口径;勾稽差异必须归零并留痕」。
同一个「M3 总成本」指标,在不同产出物里有三个值:
| 出现位置 | 数值 | 组成 |
|---|---|---|
cost_model_comparison.md |
€19.3M | 人工 11.5M + 资金 7.8M |
category_cost_drilldown.md |
€19.32M | 19 个类别加总 |
cost_efficiency_analysis.md |
€19.53M | 1.233 + 10.436 + 7.885 |
roi_metrics.json / roi_analysis.md |
€19.555M | 10,436,420 + 1,233,340 + 7,885,500 |
vendor_tdabc_metrics.json |
€26.75M | 供应商级重算,资金 €14.97M |
packaging_full_chain.md |
€10.03M(Packaging 供应商级)vs €7.47M(事件级) | 同上,不同口径 |
逐个追下去,每个差异都有合理来源:
- €19.32M vs €19.53M:类别下钻里 Packaging 的瓶颈资金算成 €2,489K,全局瓶颈算成 €7,885K;两者对 Packaging 的等待天数取值不同(66.5 天 vs 更长)
- €19.3M vs €19.555M:报告正文四舍五入与
metrics.json精确值不一致 - €19.555M vs €26.75M:第 11 节已经解释------供应商级资金成本覆盖全部采购额,而全局口径只覆盖 72.8% 有瓶颈等待的流程
但问题在于:这些解释分散在各自报告的末尾,没有一处汇总说明。
对一个要拿这份分析去开会的 CFO 来说,「所以到底是 1,953 万还是 2,675 万?」这个问题必须在任何地方都能立刻查到答案。现在它散落在三份文件的三段「局限与如实说明」里。
这正是「口径同源」这条宪法要防的事。 它的落地方式应该是一张登记表:
| 指标名 | 口径定义 | 计算范围 | 数值 | 首次定义位置 |
|---|---|---|---|---|
| 流程效率总成本(全局) | 返工+人工+瓶颈资金,事件级 | 801,346 事件 / 125,867 trace | €19,555,260 | cost_metrics.json |
| TDABC 总成本(供应商级) | 同上 + 资金按全采购额重算 | 1,975 供应商 × 18 业务线 | €26,747,874 | vendor_tdabc_metrics.json |
| (差异说明) | 资金成本覆盖范围不同 | --- | +€7,085,601 | 必须在此登记 |
13.4 暴露的问题三:图表与结论不匹配
第 7.1 节已经提到:rework_frequency.png 漏掉了最大单项返工源 Remove Payment Block(28,528 次),而 rework_delay.png 用的是更窄的 7 类活动口径。
两张图看起来都在讲「返工」,但它们的口径不同,且都不完整反映返工总量。
同类问题还有:cost_breakdown.png 的脚注写着「assumes 0.5 h admin per event @ €40/h labor」(人工 0.5h/次),而 roi_analysis.md 的测算用的是 0.08h/次(€3.2/次)。同一张图和同一份 ROI 报告用了不同的人工费率假设,图上没有任何提示。
这类问题不会导致结论错误,但会导致误读。 图是传播力最强的载体,一张口径不完整或未标注的图,比一段严谨的文字更容易造成误解。
13.5 暴露的问题四:依赖管理假设但标注不足
ROI 测算里有大量「管理假设」:
| 假设 | 值 | 性质 |
|---|---|---|
| Packaging 自动化比例 | 40% | 管理层预期 |
| 等待压缩目标 | 66.5 天 → 45 天 | 可达成性假设 |
| capex | €0.9M--€2.1M | 行业经验量级估算,非厂商报价 |
| 全库等待压缩 | 30% | 对标推演 |
| 实施周期 | 6--12 个月 | 项目经验 |
报告在「局限与如实说明」里确实列了这些,这是好的。但这些假设直接决定了 ROI 的正负------P5 从正变负,靠的就是「单事件人工成本 €3.2」这个假设。
更负责的做法是对关键假设做敏感性区间测算。 报告对 ROI 做了 ±30% 敏感度(这是好的),但没有对人工费率本身做敏感度。而人工费率是整个模型的乘数:€40/h 如果实际是 €25/h 或 €60/h,所有 ROI 结论都会等比例变化。
13.6 这个示例真正说明了什么
把四个问题放在一起看,一个模式浮现出来:
本次分析在「业务洞察」上做得很好,在「过程控制」上欠了账。
洞察层面的产出是真实的、有价值的:
- 「换成本模型就换谁最贵」------这是真正的会计洞察
- 「P5 是事件量陷阱,事件量大 ≠ 成本量大」------这是真正的决策洞察
- 「Packaging 的矛盾是钱压账上,不是返工」------这是反直觉且有证据的
- 「少投比多投更划算」------这是资源约束下的真问题
而欠账全在过程层面:环境踩坑没沉淀、口径没统一、图表没对齐、假设没做完整敏感度。
这两类问题的区别,正好就是 Workflow 能解决的和不能解决的:
| 问题类型 | Workflow 能否解决 |
|---|---|
| 环境踩坑重复发生 | ✅ 写进约束,一次沉淀永久生效 |
| 图表口径不完整 | ✅ 产出规范里明确每张图的定义与口径 |
| 同一指标多口径并存 | ✅ 宪法层强制「同名指标唯一口径 + 差异登记」 |
| 关键假设缺少敏感度 | ✅ 验收标准里加一条「结论级假设必须做区间验证」 |
| 业务洞察本身对不对 | ❌ 这仍然取决于分析者的水平和数据质量 |
14. 怎么给自己的场景写一份 Workflow
看完上面这些,最后给一份可直接照做的清单。这不是理论建议,而是把前面两份真实 Workflow 和这次踩过的坑压缩成的操作步骤。
第 1 步:先跑一次,再反推阶段
不要一开始就设计 Workflow。 照着 workflow-versions.json 里 v1 那份 176 字符的空模板,写不出有用的流程。
正确做法:先真实跑一次满意的任务,然后回头看它实际经历了什么------把真实发生过的步骤、真实的判断点、真实的产出物写下来。AI4S Workflow 从 v1(176 字符空模板)到 v2(12,415 字符)膨胀 70 倍,这个体量就是「把一次完整的实践记录下来」应有的规模。
反推阶段的三个信号:
| 信号 | 说明 | 例(本次业财分析) |
|---|---|---|
| 目标发生了性质变化 | 换了问题性质 = 新阶段 | 「从分析到 ROI 测算」是新阶段 |
| 出现了新的数据粒度 | 需要新的处理链路 | 「下钻到供应商级」 |
| 需要用户的确认才能继续 | = 闸门 | 「P5 要不要否决」 |
第 2 步:写四段,每段都写「可检验的东西」
## 目标      ← 做到什么程度算完成(可判定)
## 执行阶段   ← ### 阶段 N:名称 + 目标 + 动作 + 必须输出 + 闸门判据
## 产出要求   ← 具体文件名,带路径
## 约束      ← 禁止事项 / 必须先确认的事项
四个要点:
- 目标段不写过程。写「产出有出处、可复核的报告」,不写「仔细分析数据」。
- 每个阶段必须写「必须输出」的文件名,用反引号包裹。文件存在性是最可靠的完成度检查。
- 每个阶段写闸门判据,且判据要指向具体文件或具体指标,不是「质量良好」。
- 约束段优先写防编造的条款。「严禁编造数据」「不得用假设数据替代真实查询」「LLM 不得自评结果」------这几条在任何领域都该有。
第 3 步:把领域知识塞进「宪法层」
领域知识不该混在流程里,应该单独一层。参考 BizFin Workflow 的 C1:
markdown
### C1. 行业判定(一切分析的第一步)
- 判定顺序:用户明确声明 > 数据特征推断 > 向用户追问确认
- 判定输出四要素:① 行业/业态 ② 适用准则与监管 ③ 行业成本核算方法
                 ④ 行业核心指标基线
| 行业 | 成本核算方法 | 收入确认要点 | 行业核心指标 |
|---|---|---|---|
| 离散制造 | 分批/标准成本/作业成本法 | 发货或验收时点 | OEE、存货周转 |「判定输出四要素」这个设计尤其值得抄------它把「判断行业」从一个模糊动作变成了一个有明确交付物的动作。
另外,C4 那两条是通用方法论,可以直接搬到任何行业:
markdown
### C4. 指标与数据规则
- 指标登记八要素:定义/公式/来源系统/统计口径/更新频率/责任部门/目标值/预警规则
- 数据可用性分级:实测数据 > 系统推算 > 行业基准 > 用户假设(须声明)
第 4 步:把环境踩坑与口径红线写进约束(收益最直接的一步)
前面第 13.2 节列了本次会话里的六类环境问题、第 13.3 节列了口径漂移、第 13.4 节列了图表口径问题。这六类环境问题和三条口径红线,每一条都值得写进 Workflow:
markdown
## 环境前置检查(阶段 0)
- 确认 Shell 语法与解释器可用方式,禁止混用其他 Shell 的语法
- 大文件解析用流式方式,禁止引入体积庞大的外部库(超时且非必要)
- 读文件统一用绝对路径(读文件工具与命令行的路径基准不同)
- 确认数据文件与产物各自的目录归属

## 口径红线
- 同一指标出现多个数值时,必须在报告显著位置登记口径差异表
- 每张图必须标注其口径(费率假设、覆盖率范围、样本定义)
- 图表数据必须来自完整集合,不得使用缩小子集而不注明
「口径红线」三条正是第 13.3、13.4 节问题的直接对策,而且它们是通用的------不依赖任何行业知识。
「环境前置检查」则是全部内容里复用价值最高的一段。 因为它与业务无关、与数据无关------写一次,永久有效。业务方法论每次任务都要重新验证一遍,但环境坑只需要踩一次。
第 5 步:加验收标准,明确「否决」也是合格结论
BizFin Workflow 第四部分的三条验收里,最有价值的是这条:
- 交付:报告含【结论 → 关键指标 → 归因 → 行动项】四层结构
以及 ROI 分析里那条隐含的原则------P5 被否决,是一个合格的结论,不是分析失败。
Workflow 里应该明确写:
markdown
## 验收标准
- 每条建议必须给出 ROI/优先级,且**允许结论为"否决"或"暂不投"**
- 每个被否决的建议必须说明否决依据(哪条假设不成立)
- 关键假设必须做区间敏感性测算,标注结论在区间内是否稳定
- 报告含【结论 → 关键指标 → 归因 → 行动项】四层结构
最后一条尤其重要:它防止 Agent 为了「给出建议」而硬凑一个正收益的建议。本次 P5 的 −56% 之所以有价值,正是因为分析被允许说「不」。
第 6 步:迭代出 v2,用版本差异说话
AI4S Workflow v1→v2→v3 的演进是最好的示范:
| 版本 | 增量 | 增量性质 |
|---|---|---|
| v1 | 176 字符骨架 | 模板 |
| v2 | +10 阶段 9 闸门 + 交付规格 + 平台规范 | 工程化(把跑通的东西固化) |
| v3 | +阶段 2.5 理论建模初筛 + 第四类注册表 | 领域深化(发现认知盲区) |
版本迭代的触发条件不是「想优化」,而是两种具体情形:
- 跑通一次后回头补全(v1→v2)
- 跑过一轮后发现某个领域对象没有归属(v2→v3:解析模型/降阶模型此前无处安放)
第二种情形最难发现,也最有价值------它要求跑过真实任务,而不是设计出来的。
15. 结语
回头看这次分析,它最有价值的产出可能不是那 €1,953 万、不是 €6.68M 的年化节省、也不是那 5 份报告。
而是这几条具体的、可迁移的认识:
关于成本核算------
同一批数据,换一把尺子量,「谁最贵」就变了。资金成本占 40% 而在传统口径下完全隐形;事件量最大的环节 ROI 却是负的。成本模型不是技术选择,是经营立场。
关于流程------
瓶颈通常不在最忙的环节,而在最容易被忽略的等待 。真正的 2-way match 流程只占 0.16% 的发票量,却把等待从 50 天压到 9 天------最好的实践不需要发明,它需要被发现和推广。
关于决策------
算清每一条的 ROI 之后,「做减法」(否决 P5、只投 P1+P2+P4)比「做加法」(全投)得到更高回报。前提是你敢算出一条负 ROI 的路。
关于 Workflow------
它不是一个更长的 prompt。它把「方法论」变成「可版本管理的资产」:让一次跑通的实践变成下次的起点,让踩过的坑不用再踩第二次,让口径漂移在源头就被挡住。
而它最诚实的边界也很清楚:Workflow 能保证过程可控,但不能保证洞察正确。 前者靠约束、闸门、产出规范;后者仍然取决于分析者的水平,以及数据本身的质量。
所以理想的状态是两者叠加------用 Workflow 保证每次都按规矩走,然后让规矩里的人去做真正的判断。
附录 A:本次分析的完整交付清单
工作目录结构
work/
├── explore_xes.py / explore2.py / debug_xes.py   # 数据探查(三次尝试的痕迹)
├── build_data.py        # XES → events_long.parquet + traces_summary.parquet
├── cost_analysis.py     # 三大成本维度 → cost_metrics.json
├── charts.py            # 6 张基础图
├── category_analysis.py / category_charts.py / category_report.py   # 类别下钻
├── model_comparison.py / model_charts.py / model_report.py         # 五模型对比
├── roi_analysis.py / build_roi_html.py                              # ROI 测算
├── vendor_tdabc.py / build_vendor_html.py                           # 供应商下钻
├── gen_pk_charts.py / gen_pk_html.py                                # Packaging 全链条
├── validate_report.py                                               # 交付校验
├── output/              # 过程数据(图表、CSV、parquet、JSON)
└── final_files/         # 最终交付(5 份 md + 5 份 html + 1 份 pdf + charts/ + 明细 CSV)
图表索引(35 张,按主题)
| 主题 | 图表 |
|---|---|
| 返工 | rework_frequency、rework_delay |
| 瓶颈 | bottleneck_dist、bottleneck_by_category |
| 自动化 | automation_share |
| 成本结构 | cost_breakdown、category_cost_stack、category_cost_intensity、category_bottleneck、category_rework_rate |
| 模型对比 | model_cost_composition、model_total_compare、model_category_rank_shift、model_rework_activity |
| ROI | roi_saving_vs_invest、roi_npv_roi、roi_cashflow_curve、roi_saving_mix、roi_sensitivity |
| 供应商下钻 | vendor_bl_tdabc_stacked、vendor_top_tdabc、vendor_tier_conc、vendor_bl_intensity |
| Packaging | pk_cost_structure、pk_value_chain、pk_supplier_concentration、pk_top10_suppliers、pk_cost_intensity |
附录 B:三层成本口径速查
| 口径名称 | 定义 | 计算范围 | 数值 | 定义位置 |
|---|---|---|---|---|
| 返工人工 | 17 类变更活动 × 0.5h × €40/h | 61,667 事件 | €1,233,340 | cost_metrics.json |
| 自动化缺失人工 | 人工事件 × 0.5h × €40/h | 521,821 事件 | €10,436,420 | cost_metrics.json |
| 瓶颈资金占用 | 发票金额 × 8% × 等待天数/365 | 91,626 trace(72.8%) | €7,885,500 | cost_metrics.json |
| 全局合计 | 三者相加 | --- | €19,555,260 | --- |
| 供应商级资金占用 | 供应商真实等待中位数 × 全采购额 × 8% | 1,975 供应商 × 全采购额 | €14,971,101 | vendor_tdabc_metrics.json |
| TDABC 合计 | 返工 + 手工 + 供应商级资金 | 18 业务线 | €26,747,874 | --- |
差异说明:供应商级资金成本高出 €7,085,601,因为前者覆盖全部采购额,后者仅覆盖 72.8% 有瓶颈等待的流程。两者口径不同,均有效,各有侧重。