ASCII:最早的字符编码标准 只包含英文大小写字母、数字、标点和控制符,共 128 个,用 1 个字节表示,不能表示中文;
GBK:中文编码标准,兼容 ASCII;一个汉字通常占 2 字节,收录大量汉字、符号,主要用于简体中文环境;
Unicode:统一字符集,给全世界字符统一编号;---中介商;
UTF-8:Unicode 的一种编码方式,是变长编码,是unicode的子级。其中英文占 1 字节,中文占 3 字节,emoji 占4 字节;能够兼容 ASCII,互联网最常用编码方式
日文要转换为中文:需要通过unicode码为中间商,先转换为unicode码,再转换为中文;
python
s="你好"  #utf8格式
print(type(s))
s_to_gbk=s.encode('utf-8').decode('gbk')  #utf8编码后解码为gbk
print(s_to_gbk)
print(type(s_to_gbk))
gbk_to_utf8=s_to_gbk.encode('gbk').decode('utf-8')  #转换为gbk后,编码后再解码为utf8
print(gbk_to_utf8)
print("-----")
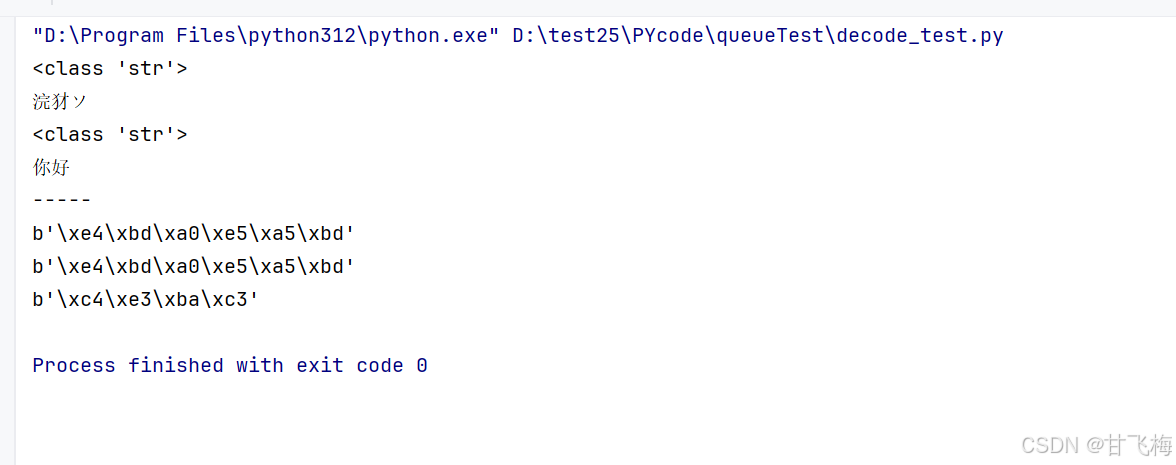
print(s.encode())  #默认utf8,把字符串编码成字节序列,"你好"占 4 个字节
print(s.encode("utf-8"))  #同上,"你好"占 6 个字节
print(s.encode("gbk"))  #"你好"占 4 个字节
运行结果: