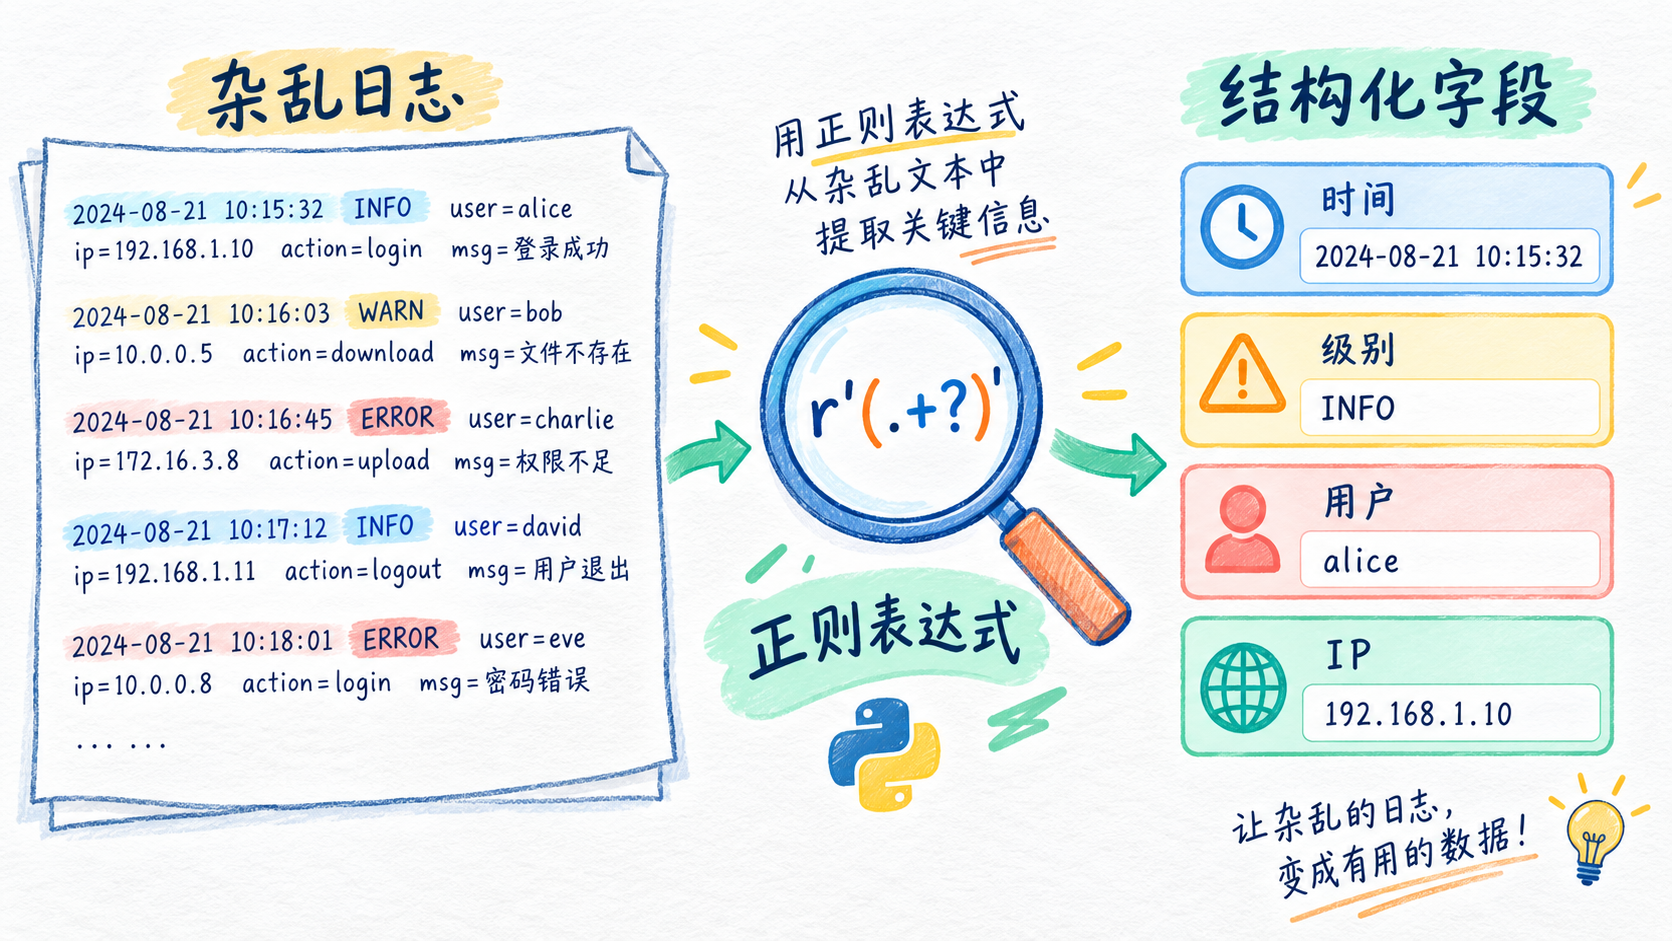
相信大家平时都见过这样的内容,内容里明明有我们需要的信息,但它们都混杂在一大段文字里。比如日志中的时间和 IP,聊天记录里的手机号和邮箱,没法像 JSON 或 CSV 那样直接按字段读取。
思维导图
这种时候,正则表达式就很适合用来处理文本匹配。今天我们从第一次匹配开始,逐步讲清楚查找、分组、替换和拆分,最后再写一个日志解析脚本。
一、正则表达式是什么
正则表达式可以理解成一套文本规则。我们先写出目标内容的特征,再让程序按这套规则去查找。
例如,下面这段文字中包含一个订单号:
python
text = "订单号:A20260919,状态:已发货"如果订单号始终由一个大写字母和八位数字组成,它的规则可以写成:
[A-Z]\d{8}其中 [A-Z] 代表一位大写字母,\d{8} 代表连续八位数字。正则表达式本身并不负责读取文件,它处理的是字符串。日志文件、网页内容或者 CSV 字段,读成字符串以后都能交给它匹配。
二、使用 re.search() 完成第一次匹配
Python 的正则功能放在标准库 re 中,不需要另外安装。先用 search() 找出订单号中的数字:
python
import re

text = "订单号:A20260919"
result = re.search(r"\d+", text)

print(result)
\d 表示数字,后面的 + 表示前一个规则可以出现一次或多次。运行以后会得到一个 Match 对象:
<re.Match object; span=(5, 13), match='20260919'>Match 对象里保存了匹配内容和位置。一般会通过这些方法读取:
python
print(result.group())
print(result.start())
print(result.end())
print(result.span())
输出结果:
20260919
5
13
(5, 13)
start() 是起始下标,end() 是结束位置,span() 会把两者放进一个元组。
没有找到内容时,search() 返回 None。直接调用 group() 会报错,实际使用时要先判断:
python
result = re.search(r"\d+", "订单暂未生成")

if result:
    print(result.group())
else:
    print("没有找到订单号")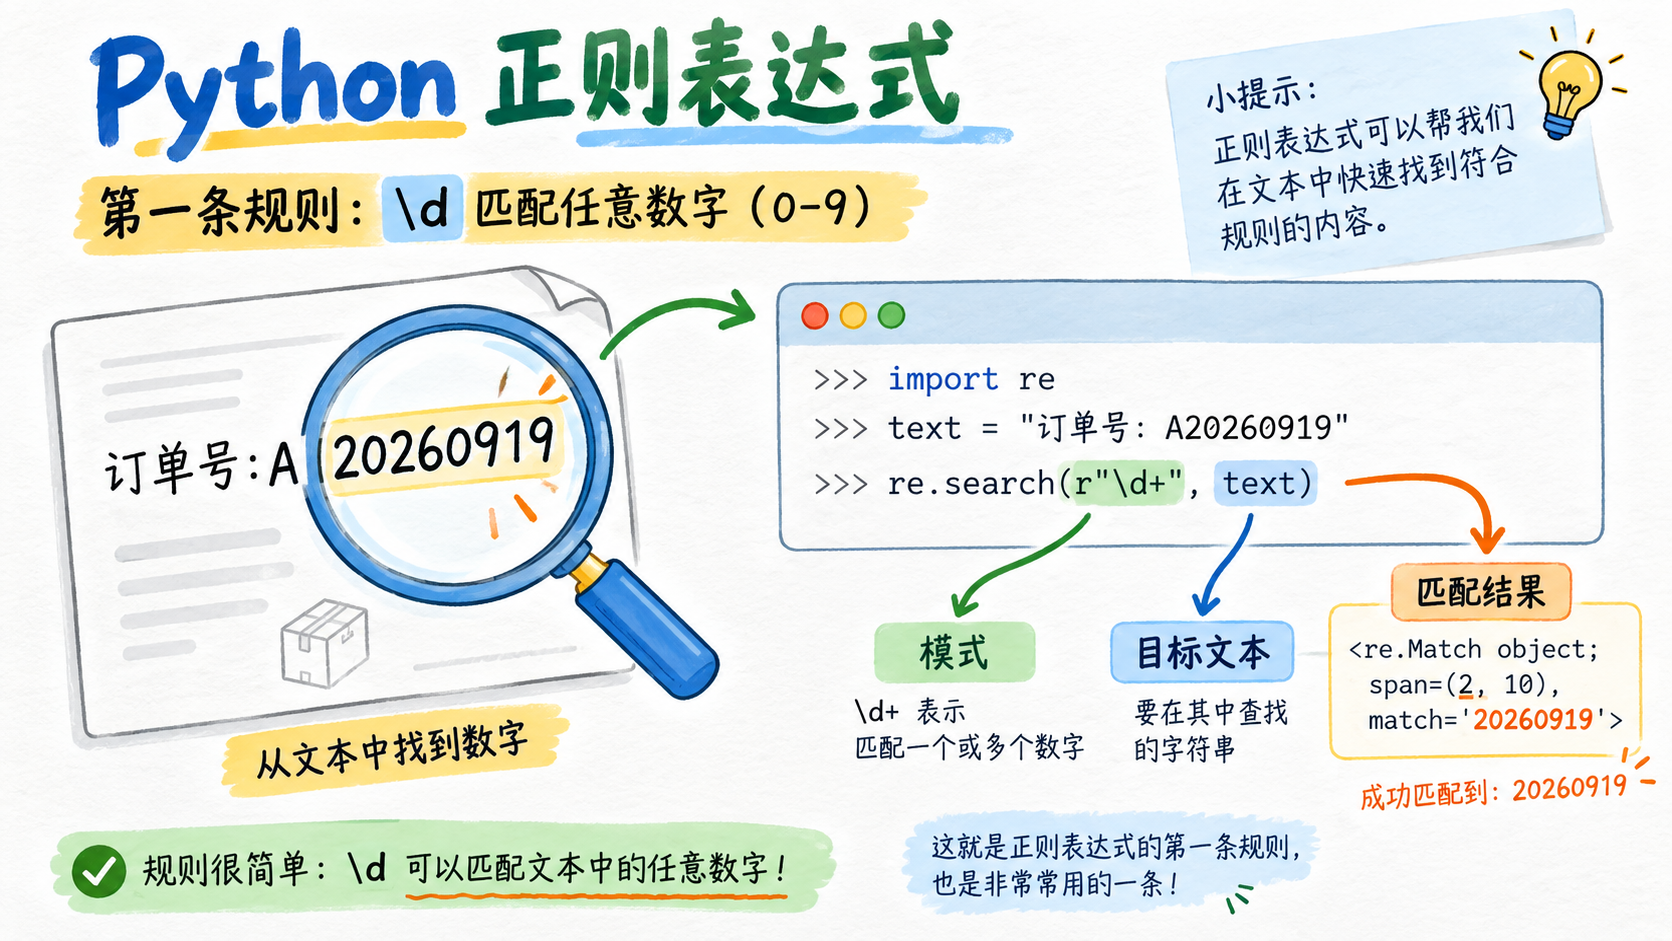
三、为什么正则前面经常带 r
正则表达式中经常出现反斜杠。Python 字符串也使用反斜杠表示转义字符,例如 \n 是换行,\t 是制表符。两套规则写在一起,很容易把反斜杠写乱。
在字符串前加 r,可以创建原始字符串:
python
pattern = r"\d+"这里的 r 只影响 Python 解析字符串的方式,最终交给正则引擎的规则还是 \d+。写正则时建议默认使用原始字符串。
需要匹配反斜杠本身时,正则中仍然要写两个反斜杠:
python
text = r"C:\Users\ivan\notes.txt"
result = re.search(r"\\Users\\", text)

print(result.group())
四、search、match 和 fullmatch 有什么区别
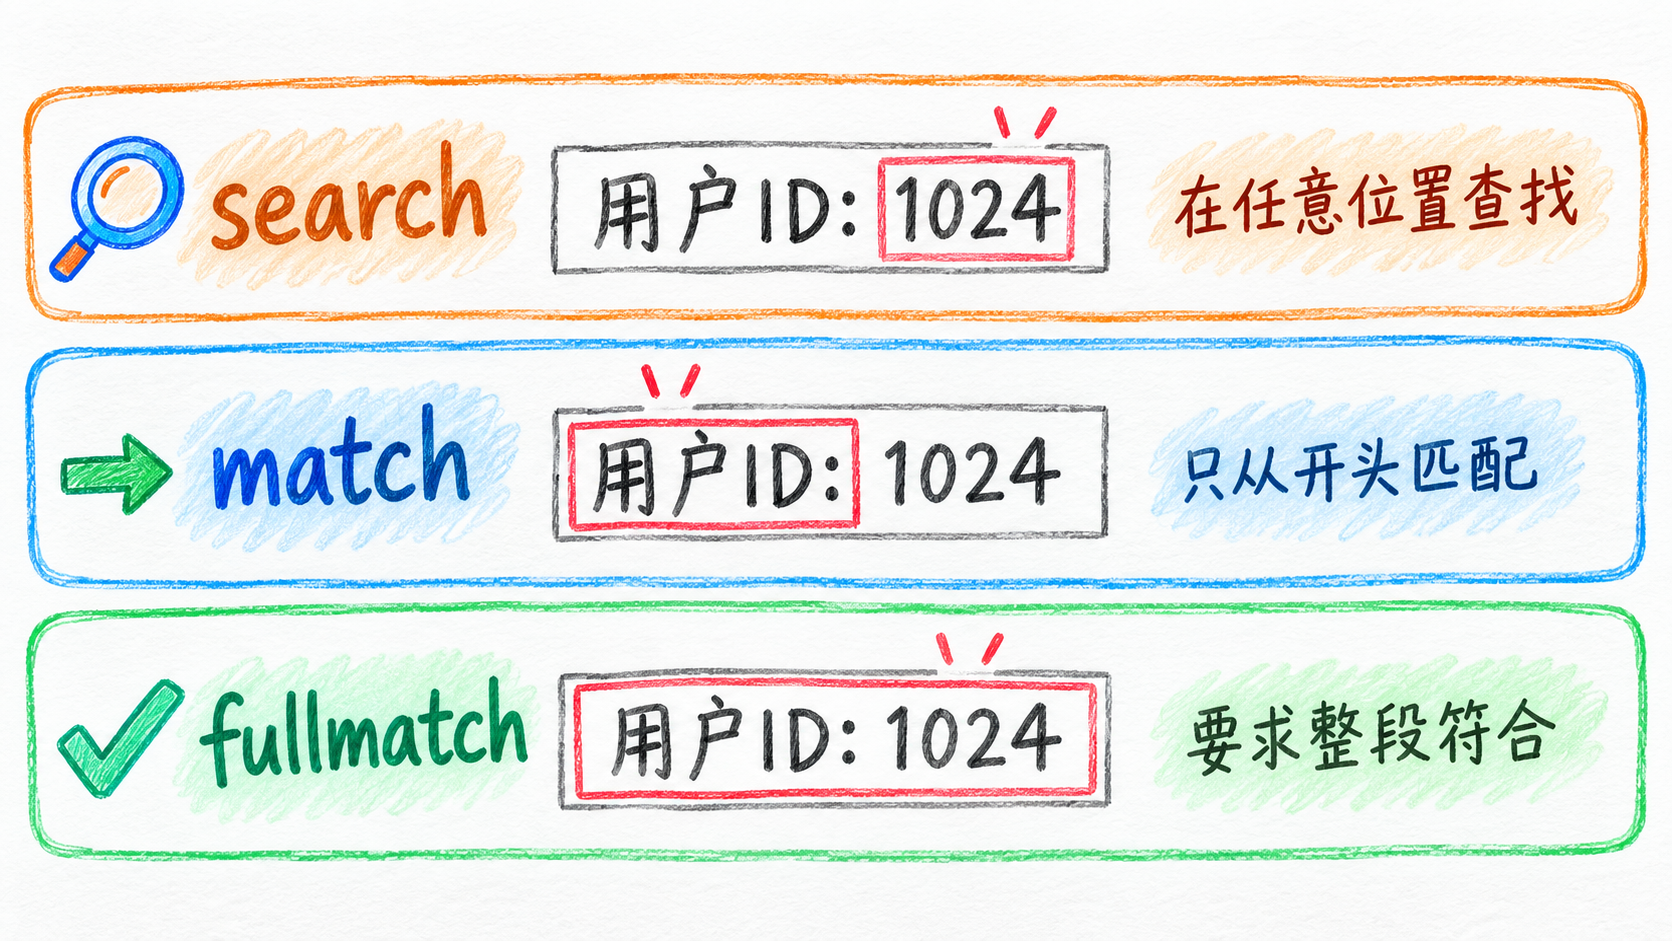
这三个方法都会返回 Match 对象,区别在于从哪里开始找,以及需要匹配多少内容。
search() 会在整个字符串中查找第一个符合规则的位置:
python
import re

text = "用户ID: 1024"

result = re.search(r"\d+", text)
print(result.group())
match() 只检查字符串开头:
python
print(re.match(r"用户", text))
print(re.match(r"\d+", text))
第二次返回 None,因为数字不在开头。
fullmatch() 要求整段字符串都符合规则,很适合校验格式:
python
order_id = "A20260919"

if re.fullmatch(r"[A-Z]\d{8}", order_id):
    print("订单号格式正确")
else:
    print("订单号格式错误")
查找一段内容时用 search(),检查开头时用 match(),校验完整格式时用 fullmatch()。
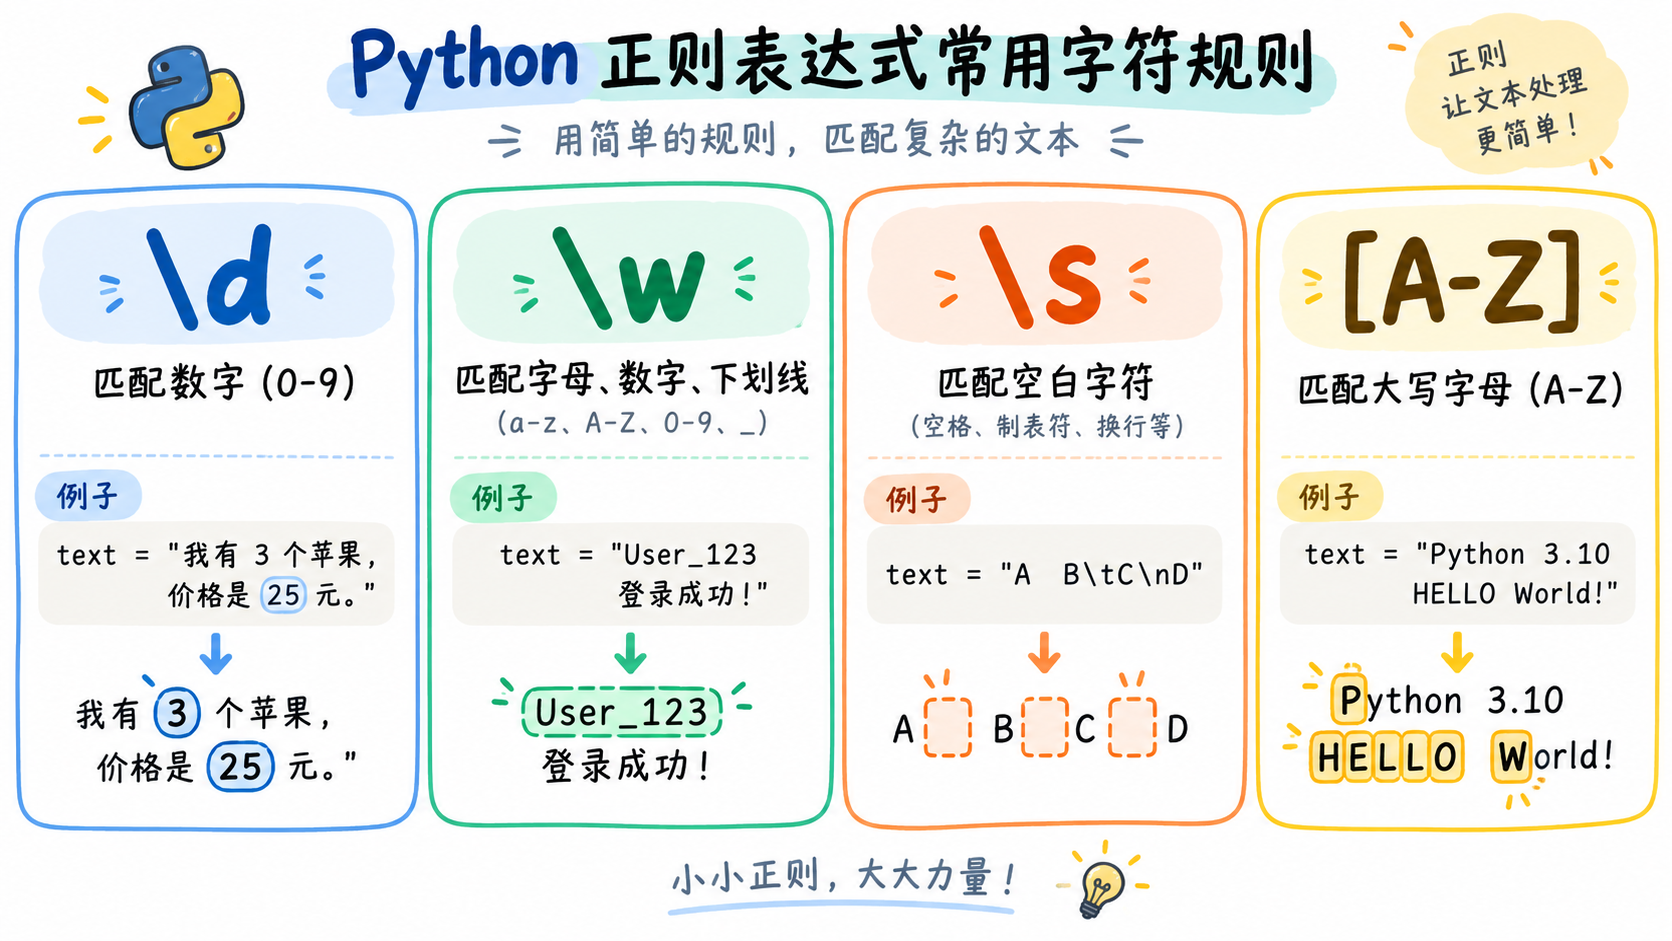
五、常用字符规则
正则中最常见的几个规则如下:
| 规则 | 含义 | 示例 |
|---|---|---|
\d |
数字 | 0 到 9 |
\D |
非数字 | 字母、中文、符号 |
\w |
Unicode 字母、数字和下划线 | user_01、中文 |
\W |
不属于 \w 的字符 |
空格和多数标点 |
\s |
空白字符 | 空格、制表符、换行 |
\S |
非空白字符 | 普通可见文字 |
. |
除换行以外的任意字符 | 字母、数字、标点 |
下面从一段文字中找出价格:
python
text = "键盘价格 299 元,鼠标价格 129 元"
prices = re.findall(r"\d+", text)

print(prices)
输出结果:
python
['299', '129']\w 在 Python 3 中默认能匹配中文。如果只想匹配英文字母、数字和下划线,可以明确写成 [A-Za-z0-9_],不要把两者当成完全相同的规则。
六、使用字符集合限制范围
方括号可以列出允许出现的字符:
python
text = "订单 A102、B205、c308"
orders = re.findall(r"[A-Z]\d+", text)

print(orders)
输出:
python
['A102', 'B205'][A-Z] 只匹配大写英文字母,小写的 c308 不符合规则。常见写法还有:
[abc]        匹配 a、b 或 c
[0-9]        匹配一位数字
[a-zA-Z]     匹配一位英文字母
[^0-9]       匹配非数字字符
方括号开头的 ^ 表示排除。它放在方括号外时,含义会变成字符串开头,后面会单独讲。
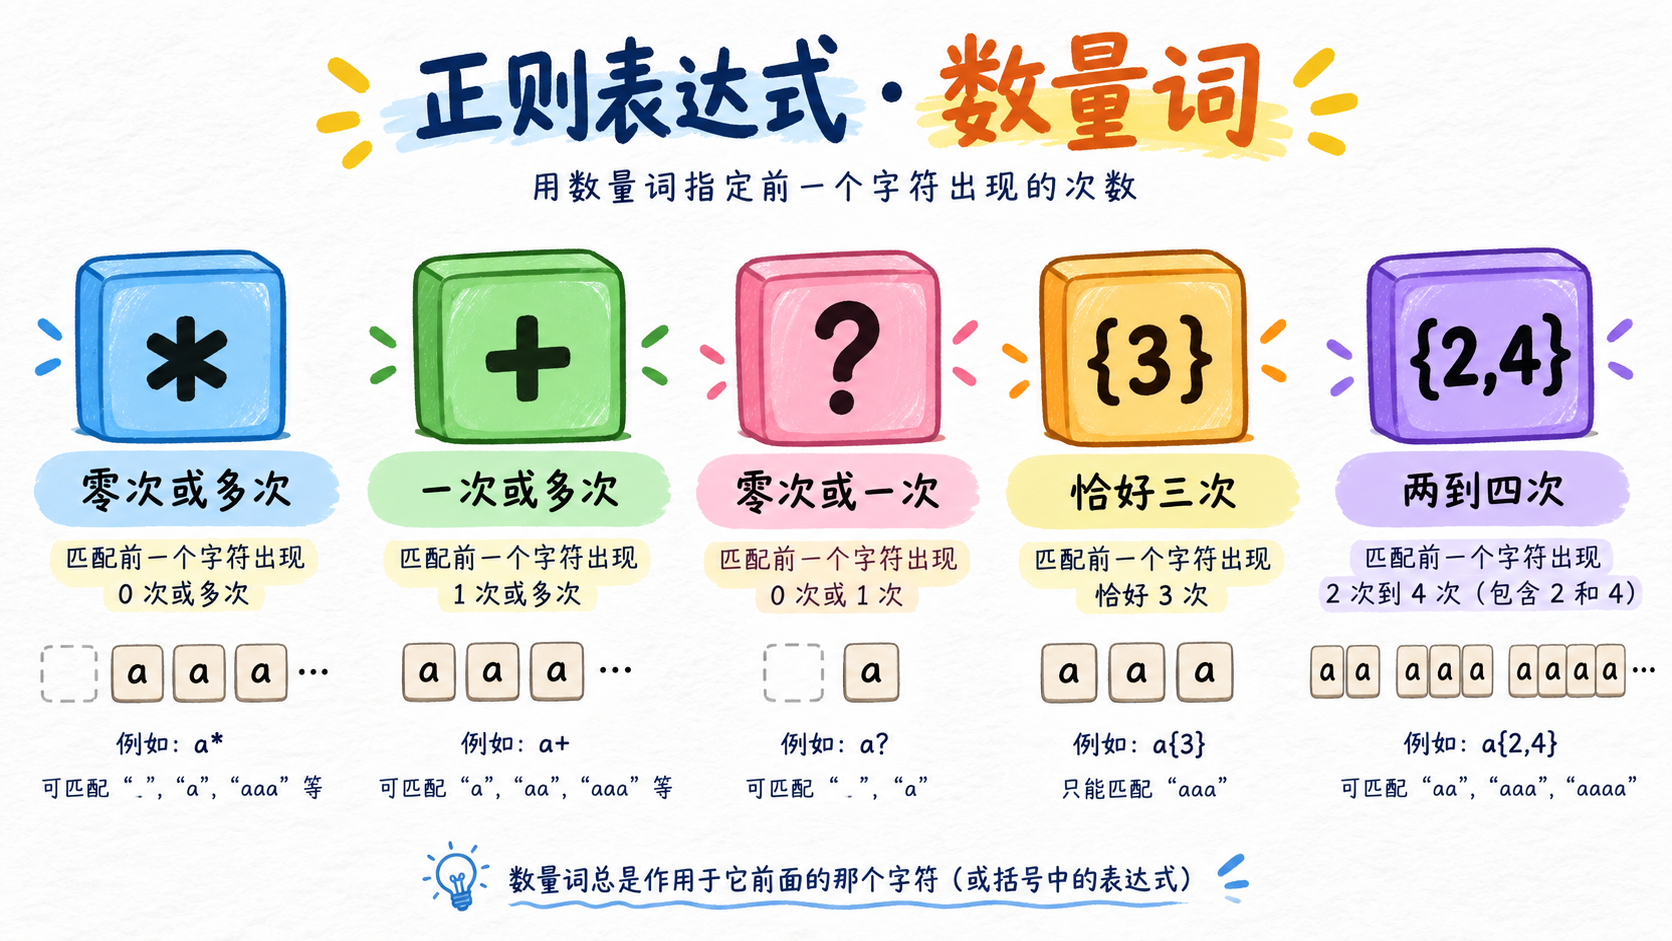
七、数量词控制出现次数
字符规则只说明"匹配什么",数量词负责说明"出现几次"。
| 数量词 | 含义 |
|---|---|
* |
零次或多次 |
+ |
一次或多次 |
? |
零次或一次 |
{m} |
恰好 m 次 |
{m,n} |
最少 m 次,最多 n 次 |
{m,} |
最少 m 次 |
使用数量词检查手机号的基本结构:
python
phone = "13812345678"
result = re.fullmatch(r"1[3-9]\d{9}", phone)

print(bool(result))
1 是固定开头,[3-9] 匹配第二位,\d{9} 要求后面还有九位数字。这里检查的是常见手机号格式,不能证明号码真实存在。
八、使用锚点限制开头和结尾
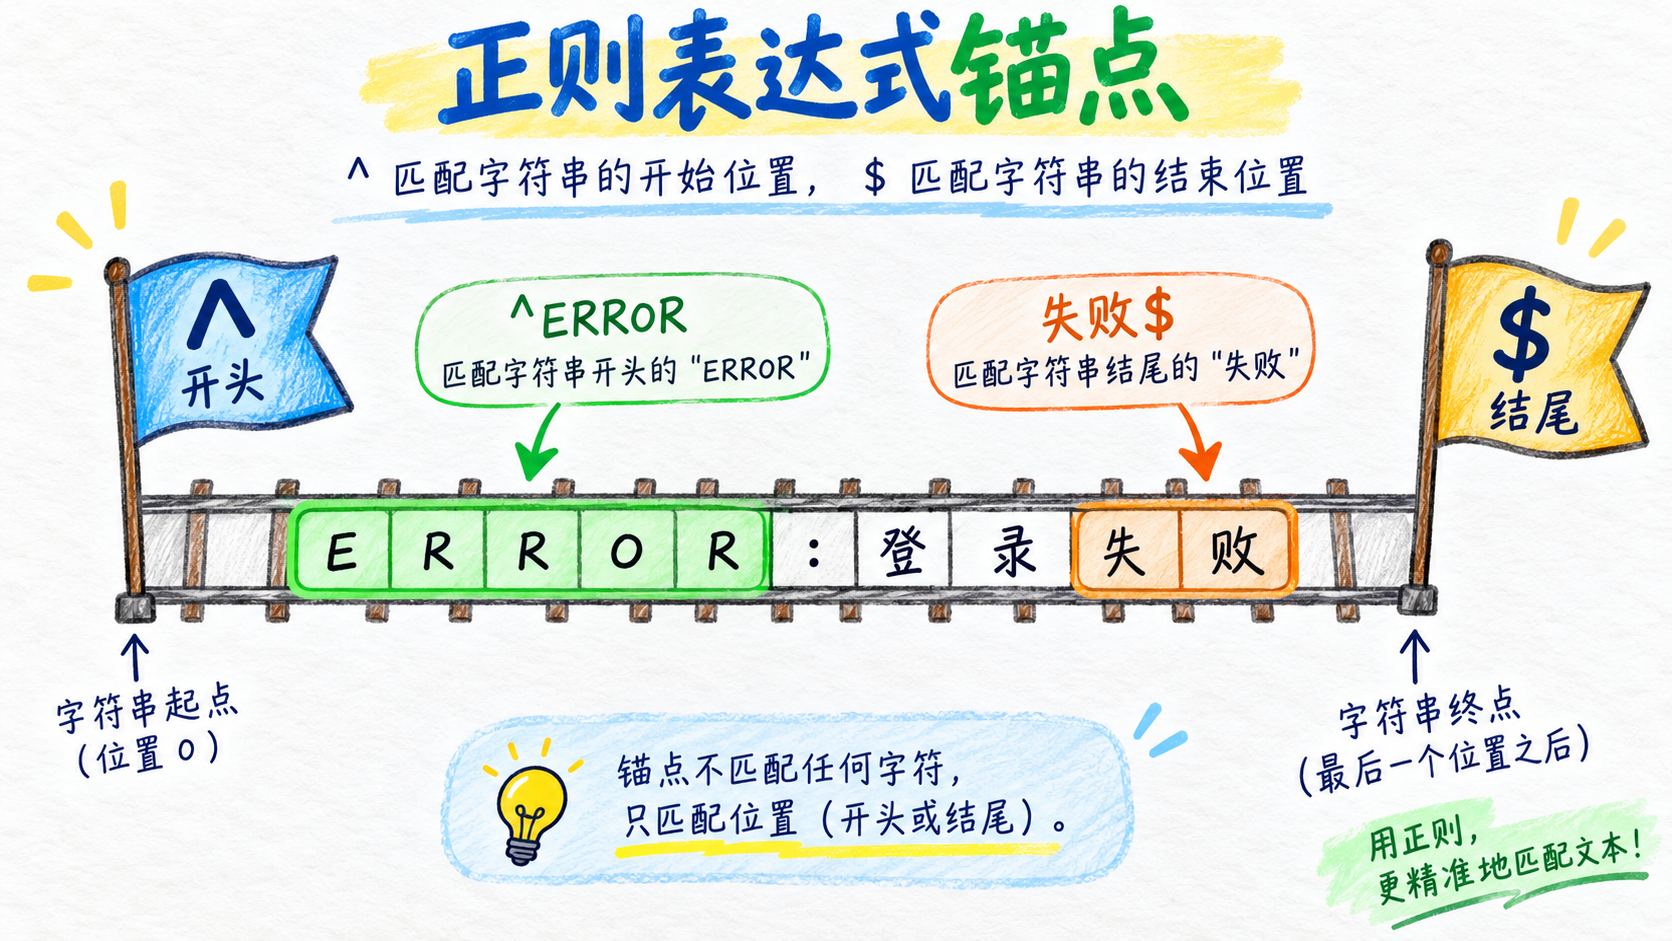
^ 表示字符串开头,$ 表示字符串结尾:
python
text = "ERROR: 登录失败"

print(bool(re.search(r"^ERROR", text)))
print(bool(re.search(r"失败$", text)))
两次结果都是 True。锚点匹配的是位置,本身不会占用字符。
校验一整段内容时,也可以直接使用 fullmatch():
python
username = "ivan_2026"

if re.fullmatch(r"[A-Za-z][A-Za-z0-9_]{3,15}", username):
    print("用户名可用")
这个规则要求用户名以英文字母开头,总长度为 4 到 16 位,后面可以使用字母、数字和下划线。
九、分组:一次取出多个字段
圆括号可以把一段规则放进一个分组。下面从日期中分别取出年、月、日:
python
import re

date_text = "2026-09-19"
result = re.fullmatch(
    r"(\d{4})-(\d{2})-(\d{2})",
    date_text,
)

if result:
    print(result.group(0))
    print(result.group(1))
    print(result.group(2))
    print(result.group(3))
    print(result.groups())
group(0) 是完整匹配,后面的编号按左括号出现的顺序排列。groups() 会一次返回所有分组:
2026-09-19
2026
09
19
('2026', '09', '19')
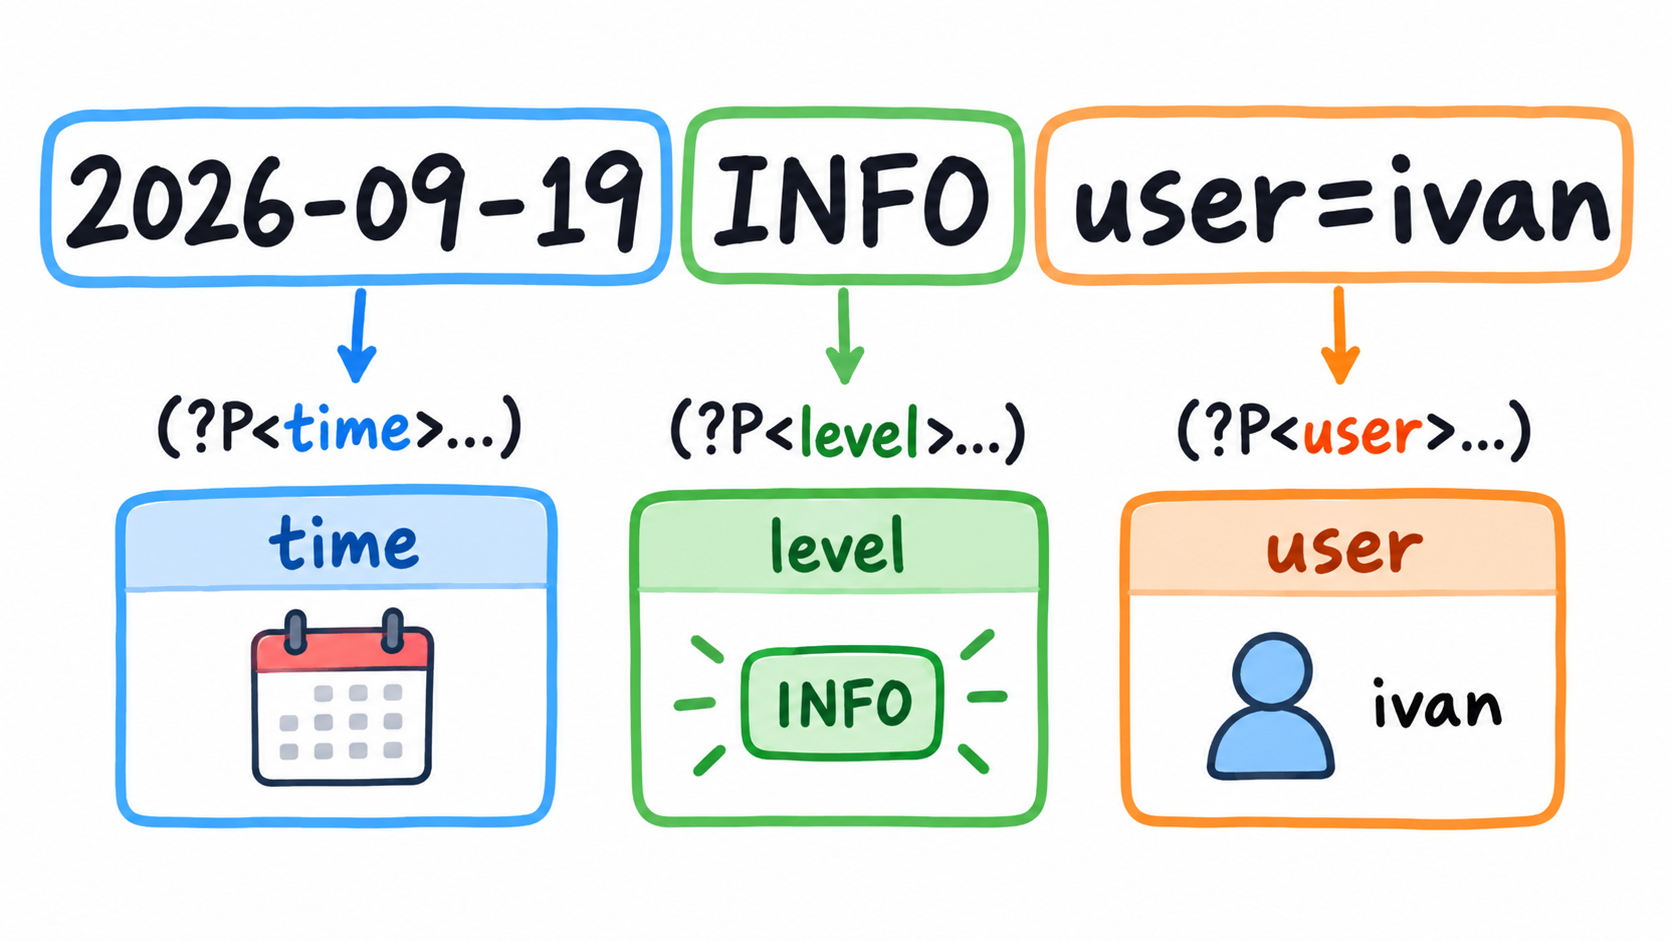
分组多起来以后,记编号很不方便。这时可以给分组命名:
python
pattern = (
    r"(?P<year>\d{4})-"
    r"(?P<month>\d{2})-"
    r"(?P<day>\d{2})"
)

result = re.fullmatch(pattern, date_text)

if result:
    print(result.group("year"))
    print(result.groupdict())
groupdict() 会把命名分组整理成字典:
python
{'year': '2026', 'month': '09', 'day': '19'}解析日志、订单和接口返回文本时,命名分组比数字编号更容易维护。
十、只分组,不保存内容
有时圆括号只是为了把几条规则放在一起,并不需要把内容保存成分组。可以使用 (?:...):
python
text = "图片:cover.jpg,附件:report.pdf"
files = re.findall(r"\w+\.(?:jpg|png|pdf)", text)

print(files)
输出:
python
['cover.jpg', 'report.pdf']如果写成 (jpg|png|pdf),findall() 会优先返回捕获分组里的扩展名。这里使用非捕获分组,得到的才是完整文件名。
竖线 | 表示多个规则任选一个:
INFO|WARNING|ERROR它能匹配三种日志级别中的任意一种。
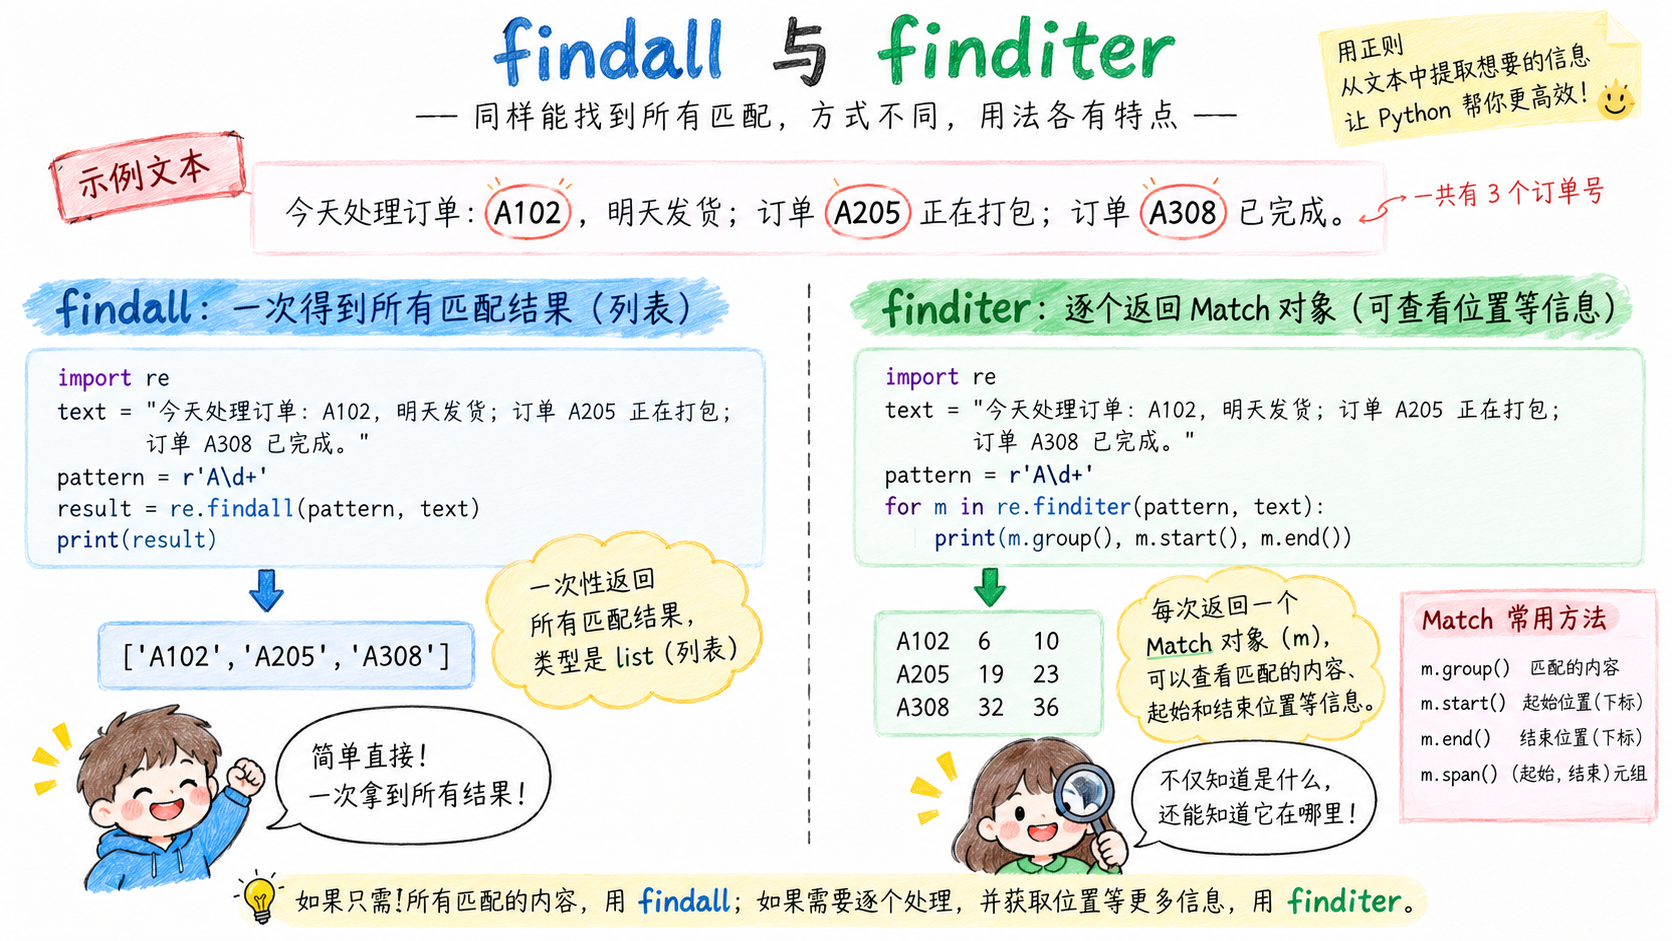
十一、findall 和 finditer 批量查找
search() 只返回第一个匹配。想拿到所有结果,可以使用 findall():
python
text = "今天处理 A102,明天处理 A205,A308 已完成"
orders = re.findall(r"[A-Z]\d+", text)

print(orders)
输出:
python
['A102', 'A205', 'A308']还需要每个结果的位置时,使用 finditer():
python
for match in re.finditer(r"[A-Z]\d+", text):
    print(
        match.group(),
        match.start(),
        match.end(),
    )
finditer() 返回一个迭代器,不会提前把所有 Match 对象放进列表。数据比较多,或者需要逐个查看分组和位置时,它更合适。
十二、贪婪匹配和非贪婪匹配
数量词默认会尽量多匹配。下面这段 HTML 中有两个标签:
python
html = "<p>Python</p><p>正则表达式</p>"
print(re.findall(r"<p>.*</p>", html))
.* 会从第一个 <p> 一直匹配到最后一个 </p>:
python
['<p>Python</p><p>正则表达式</p>']在数量词后面加 ?,可以改成非贪婪匹配:
python
print(re.findall(r"<p>.*?</p>", html))这次得到两个结果:
python
['<p>Python</p>', '<p>正则表达式</p>']这个例子适合说明贪婪规则,真实 HTML 的结构远比它复杂。需要可靠地解析网页时,应该使用 HTML 解析库,不要只靠一条正则处理整份页面。
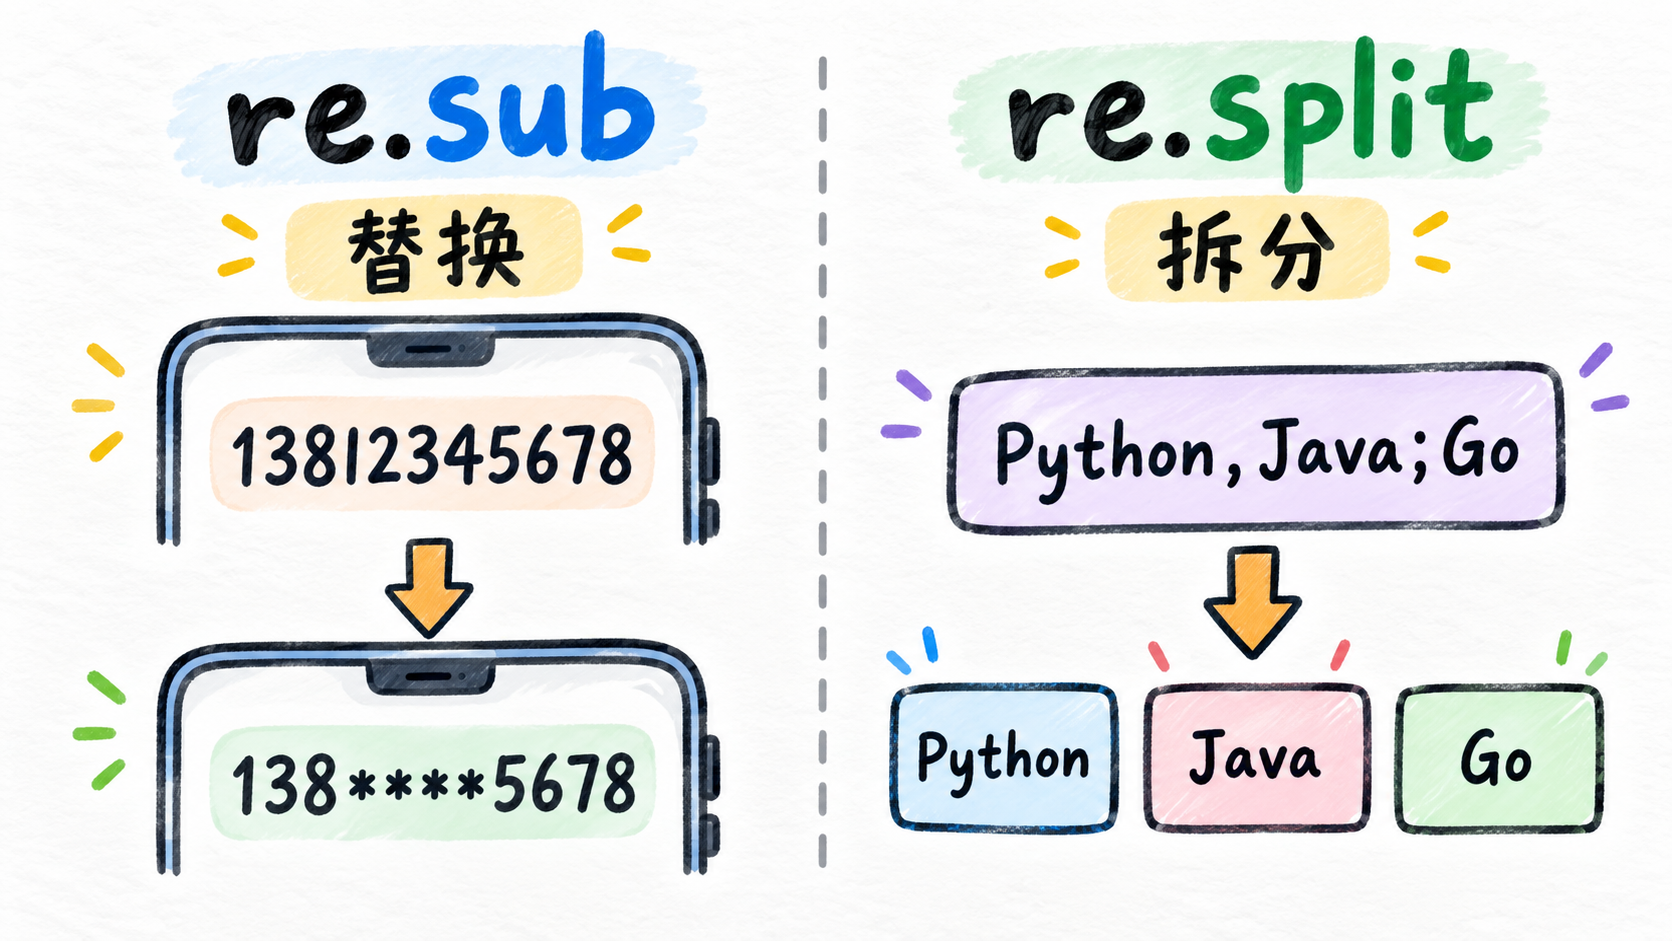
十三、使用 re.sub() 替换内容
re.sub() 会把符合规则的内容替换掉。处理手机号脱敏时,可以保留前三位和后四位:
python
import re

phone = "13812345678"
masked = re.sub(
    r"(\d{3})\d{4}(\d{4})",
    r"\1****\2",
    phone,
)

print(masked)
输出:
138****5678替换字符串中的 \1 和 \2 引用了第一个、第二个分组。分组较多时,可以改用命名分组:
python
pattern = r"(?P<start>\d{3})\d{4}(?P<end>\d{4})"
masked = re.sub(
    pattern,
    r"\g<start>****\g<end>",
    phone,
)
替换逻辑需要计算时,可以把函数传给 sub():
python
text = "商品价格 299 元,优惠价 199 元"

def add_currency(match):
    price = match.group()
    return f"¥{price}"

result = re.sub(r"\d+", add_currency, text)
print(result)
十四、使用 re.split() 拆分内容
普通字符串的 split() 只能方便地处理一种固定分隔符。文本中混用了逗号、分号和空格时,可以使用 re.split():
python
text = "Python,Java;Go Rust"
languages = re.split(r"[,;\s]+", text)

print(languages)
输出:
python
['Python', 'Java', 'Go', 'Rust'][,;\s]+ 表示一个或多个逗号、分号或空白字符。实际数据结尾可能还带分隔符,可以顺手去掉空字符串:
python
languages = [
    item
    for item in re.split(r"[,;\s]+", text)
    if item
]
十五、重复使用规则时先编译
同一条规则需要使用多次时,可以用 re.compile() 创建正则对象:
python
import re

order_pattern = re.compile(r"[A-Z]\d{3}")

texts = [
    "新订单 A102 已创建",
    "B205 等待付款",
    "没有订单号",
]

for text in texts:
    result = order_pattern.search(text)

    if result:
        print(result.group())
编译后的对象也有 search()、findall()、sub() 等方法。这样写能把规则集中放在一个位置,名称也能说明它是用来匹配什么的。
十六、常用匹配标志
匹配标志可以改变正则的工作方式。忽略英文字母大小写时,使用 re.IGNORECASE:
python
text = "Error: file not found"
result = re.search(
    r"error",
    text,
    flags=re.IGNORECASE,
)

print(result.group())处理多行文本时,re.MULTILINE 会让 ^ 和 $ 匹配每一行的开头和结尾:
python
logs = """INFO: 启动成功
ERROR: 数据库连接失败
INFO: 开始重试"""

errors = re.findall(
    r"^ERROR:.*$",
    logs,
    flags=re.MULTILINE,
)

print(errors)
. 默认不匹配换行。需要让它跨行匹配时,可以使用 re.DOTALL。多个标志能用 | 组合:
python
flags = re.IGNORECASE | re.MULTILINE十七、写正则时容易踩的坑
最常见的问题是规则写得太宽。比如 .* 什么都能接,短文本里看不出问题,换一批数据就可能吞掉多余内容。能写清字符范围时,尽量使用 [A-Z]、\d{4} 这类具体规则。
第二个问题是忘记处理 None。search() 和 fullmatch() 都有匹配失败的时候,调用 group() 以前先判断结果。
还要留意捕获分组对 findall() 返回值的影响:
python
text = "A102 B205"

print(re.findall(r"[A-Z]\d+", text))
print(re.findall(r"([A-Z])\d+", text))
第二条规则包含捕获分组,结果会变成 ['A', 'B']。如果括号只用来控制范围,改成 (?:[A-Z])。
正则也不适合承担所有格式校验。邮箱地址、URL 和 HTML 都有许多边界情况。教程里常见的邮箱规则可以拿来提取简单地址,不能当作完整标准的验证器。
十八、综合示例:解析日志并导出 CSV
现在把正则和上一章的 CSV 连起来。我们准备一份 app.log:
2026-09-19 10:15:32 INFO user=ivan action=login ip=192.168.1.10
2026-09-19 10:16:03 WARNING user=alice action=download ip=10.0.0.5
这是一行无法识别的内容
2026-09-19 10:18:45 ERROR user=bob action=upload ip=172.16.3.8
项目结构如下:
regex_demo/
├─ parse_log.py
├─ data/
│  └─ app.log
└─ output/
在 parse_log.py 中写入:
python
from pathlib import Path
import csv
import re

base_dir = Path(__file__).resolve().parent
log_file = base_dir / "data" / "app.log"
output_dir = base_dir / "output"
csv_file = output_dir / "log_report.csv"

output_dir.mkdir(parents=True, exist_ok=True)

log_pattern = re.compile(
    r"^(?P<time>\d{4}-\d{2}-\d{2} "
    r"\d{2}:\d{2}:\d{2})\s+"
    r"(?P<level>INFO|WARNING|ERROR)\s+"
    r"user=(?P<user>\w+)\s+"
    r"action=(?P<action>\w+)\s+"
    r"ip=(?P<ip>(?:\d{1,3}\.){3}\d{1,3})$"
)

records = []
failed_lines = []

with log_file.open("r", encoding="utf-8") as file:
    for line_number, line in enumerate(file, start=1):
        line = line.strip()

        if not line:
            continue

        result = log_pattern.fullmatch(line)

        if result:
            records.append(result.groupdict())
        else:
            failed_lines.append((line_number, line))

fieldnames = [
    "time",
    "level",
    "user",
    "action",
    "ip",
]

with csv_file.open(
    "w",
    encoding="utf-8-sig",
    newline="",
) as file:
    writer = csv.DictWriter(
        file,
        fieldnames=fieldnames,
    )
    writer.writeheader()
    writer.writerows(records)

print(f"成功解析:{len(records)} 行")
print(f"解析失败:{len(failed_lines)} 行")
print(f"CSV 文件:{csv_file}")

for line_number, content in failed_lines:
    print(f"第 {line_number} 行无法识别:{content}")
这里使用命名分组直接生成字典,再交给 csv.DictWriter() 写入文件。无法匹配的行没有被悄悄丢掉,程序会保存行号和原内容,方便回头检查规则或原始数据。
IP 的规则 (?:\d{1,3}\.){3}\d{1,3} 只检查"由四段一到三位数字组成"的外形,没有继续判断每一段是否处于 0 到 255。需要严格验证 IP 时,可以把匹配结果交给标准库 ipaddress 再检查。
生成的 log_report.csv 如下:
time,level,user,action,ip
2026-09-19 10:15:32,INFO,ivan,login,192.168.1.10
2026-09-19 10:16:03,WARNING,alice,download,10.0.0.5
2026-09-19 10:18:45,ERROR,bob,upload,172.16.3.8
!10-log-pipeline.png
十九、练习
练习一:提取所有价格
准备字符串 "键盘 299 元,鼠标 129 元,显示器 1599 元",使用正则提取所有价格,并把结果转换成整数列表。
练习二:检查订单号
订单号由两个大写字母和六位数字组成。使用 fullmatch() 分别检查 AB123456、A123456 和 ab123456。
练习三:提取邮箱
从一段文本中提取形如 name@example.com 的简单邮箱地址。先处理常见英文字母、数字、点、下划线和连字符,不需要覆盖所有邮箱标准。
练习四:隐藏身份证号
把十八位身份证号的中间八位替换成星号,只保留前六位和后四位。使用捕获分组保留两端内容。
练习五:解析文件名
从 report_2026-09-19.csv 中取出文件类型和日期,分别保存到命名分组 date 和 extension 中。
练习六:统计错误日志
读取一份日志文件,使用 re.MULTILINE 找出所有以 ERROR 开头的行。再从每一行中提取时间和错误内容,并写入 CSV 文件。
学正则时没必要先背完所有符号。先把目标文本找出来,标清哪些内容固定、哪些内容会变,再把它们换成字符规则和数量词。规则写完后多准备几条正常数据和异常数据测试,比盯着一条样例反复修改更容易发现问题。