**摘要:**本文系统介绍 Redis 这一基于内存的键值型 NoSQL 数据库。内容涵盖非关系型数据库的基本概念与 BASE 理论,Redis 的安装与常用命令,以及 String、List、Set、Hash、SortedSet 等核心数据结构的底层实现、特点与典型业务场景,并通过对比表格帮助读者快速掌握各类型的适用场景。
一、非关系型数据库
NoSQL 全称Not Only SQL ,译为 "不仅仅是 SQL",不是完全抛弃 SQL,而是不使用传统关系模型 的数据库,是为解决关系型数据库(MySQL/Oracle)在海量数据、高并发、数据模型灵活场景下的短板诞生的。
关系型数据库 VS 非关系型数据库
关系型:表、行、列,固定 Schema,外键,事务强一致,用 SQL。
NoSQL:无固定表结构,大多放弃强事务,横向扩展容易。
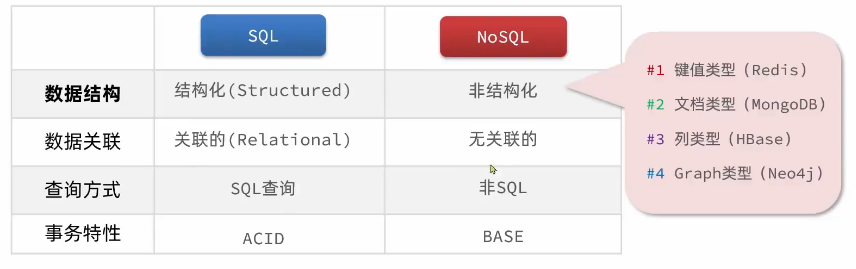
BASE:Basically Available, Soft state, Eventually consistent
1. Basically Available(基本可用) 分布式系统出现故障 / 网络分区时,不会完全宕机,尽可能对外提供服务。
不是 100% 随时可用,可能会有降级:响应变慢、部分功能不可用、返回旧数据,但服务还能访问。 例子:网站部分分片挂了,还能展示大部分商品,少数页面异常
2. Soft state(软状态) 允许数据中间状态,状态不需要时刻一致。 节点之间数据同步有延迟,在同步完成前,不同节点读到的数据可以不一样。
对比 ACID 的硬状态:事务完成前,外界看不到中间状态。 软状态:数据可以处于 "正在同步中" 这个临时状态,不需要立刻全局统一。
3. Eventually Consistent(最终一致性) 经过一段时间,所有副本数据最终会同步成一样。 在这个同步窗口内,读可能读到旧数据;等待同步完成后,所有节点数据一致。
重点:不保证实时一致,只保证一段时间后一致。
认识Redis
Redis诞生于2009年全称是Remote Dictionary Server,远程词典服务器,是一个基于内存的键值型NoSQL数据库。
特征:
- 键值(key-value)型,value支持多种不同数据结构,功能丰富
- 单线程,每个命令具备原子性
- 低延迟,速度快(基于内存、IO多路复用、良好的编码)。
- 支持数据持久化
- 支持主从集群、分片集群
- 支持多语言客户端
二、 Redis安装
可从GitHub上直接下载Redis的相关版本或访问Redis的官方网站进行下载,请注意:Redis官方作者并未出版过Windows版本,所有的Windows版本是由微软在后期进行开发的版本。
参考版本:
链接: https://pan.baidu.com/s/1DvYtXtIM_5ndduUU3G4cKw?pwd=b8u9 提取码: b8u9
Redis集群只一款针对于服务器端的软件,官方的也是Linux版本。读者在学习时可以自行组装虚拟机,组装虚拟机的版本建议使用Radhat或者ubantu。
此外针对于宿主机器和虚拟机的通信,这里建议安装Xshell。
成功在linux安装好Redis后,还需要一个类似于Navicat之类的非关系型数据库的管理工具或者说是图形化的界面。常见的有RDM、RESP。这里推荐:TinyRDM------一款由独立开发者进行开发的,已经在GitHub上获得万🌟的项目
下载地址如下:Tiny RDM | Redis桌面管理客户端
Redis安装放置目录: /usr/local/src
编译解压及制造目录命令:make && make install
一些需要用到的命令:
redis-server
redis-cli
AUTH 你的密码
vi  修改文件
/查询的文件名称
i  插入模式
kill -9 端口号
firewall-cmd --add-port=6379/tcp --permanent
firewall-cmd --reload
三、Redis数据结构
Redis是一个key-value型的数据库,key一般是string类型, value的值多种多样。
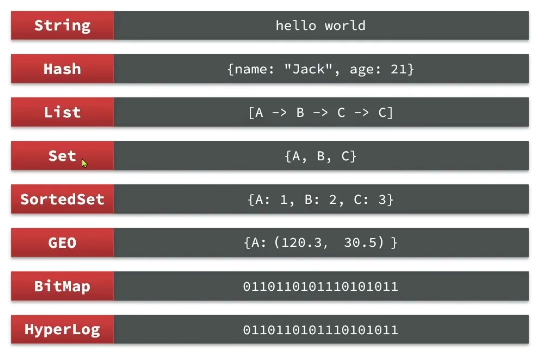
其中前五种是基本数据类型,后三种是引用型数据类型。
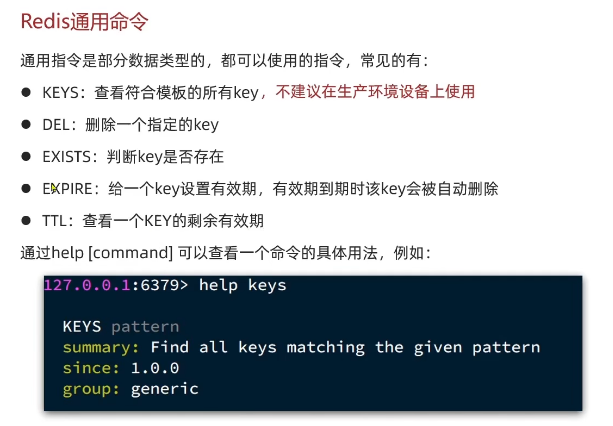
四、命令
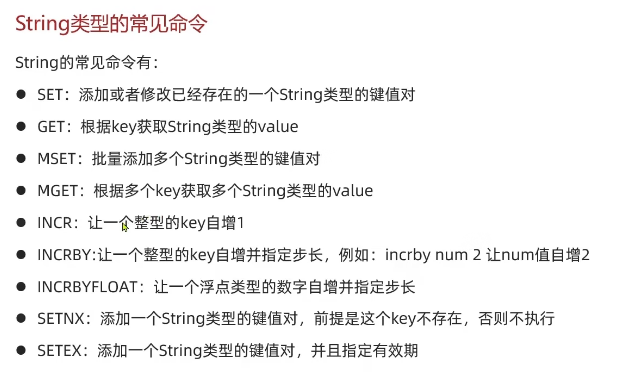
String类型
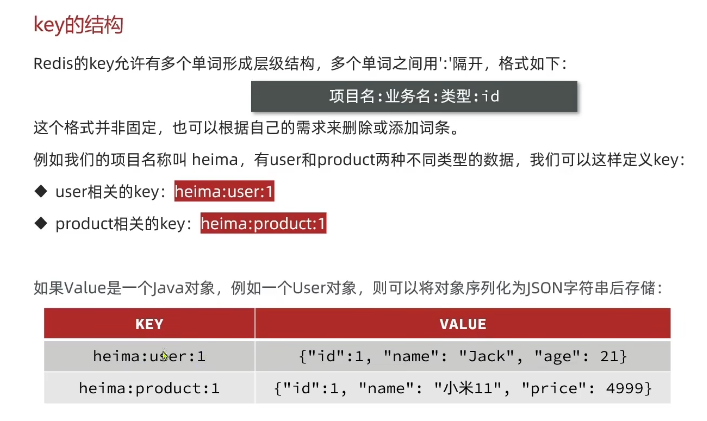
key类型
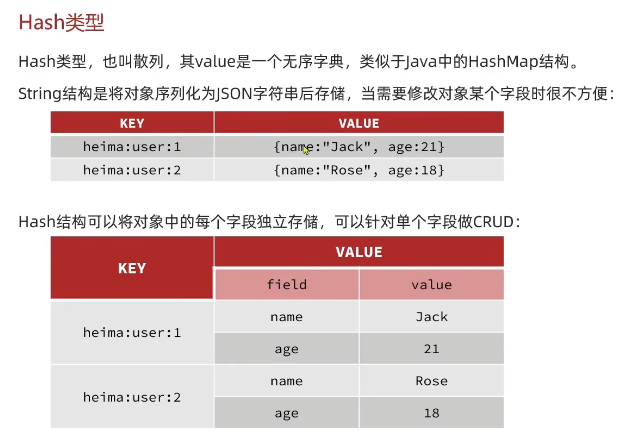
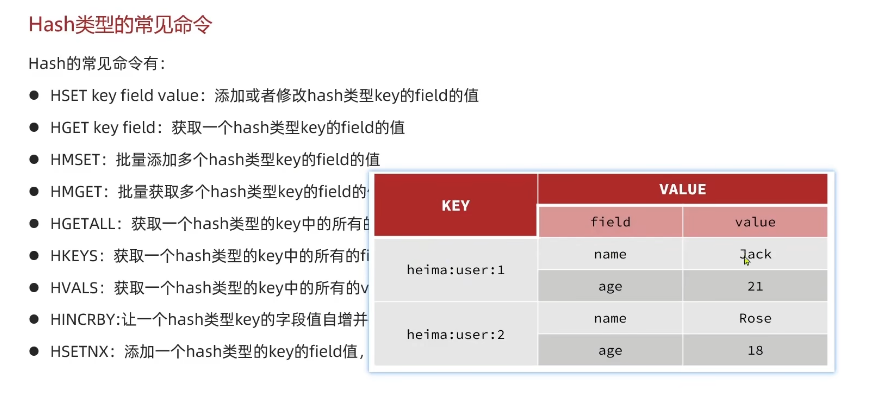
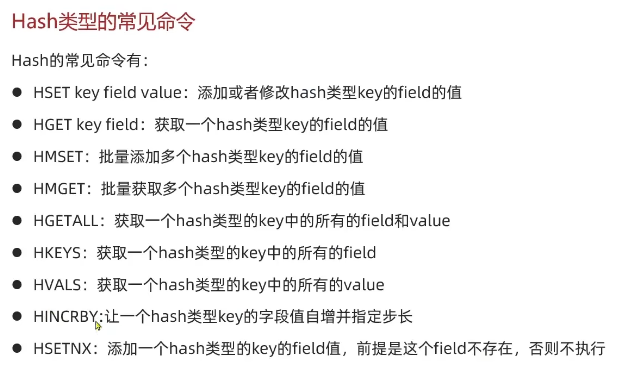
hash类型
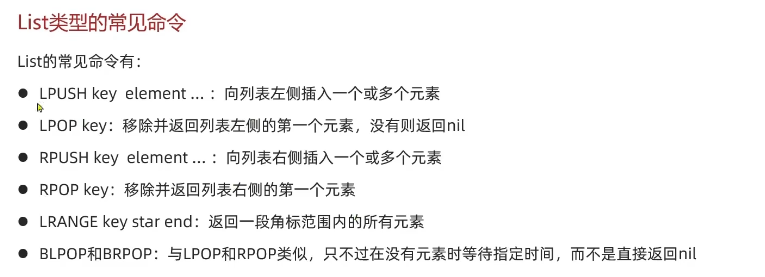
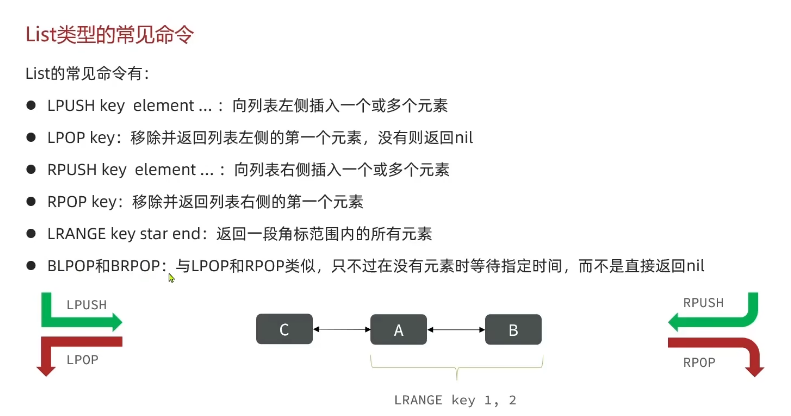
List类型
Redis中的List类型与Java中的LinkedList类似,可以看做是一个双向链表结构。
既可以支持正向检索和也可以支持反向检索。 特征也与LinkedList类似:
-
有序
-
元素可以重复
-
插入和删除快
-
查询速度一般
常用来存储一个有序数据,例如:朋友圈点赞列表,评论列表等。
SET类型
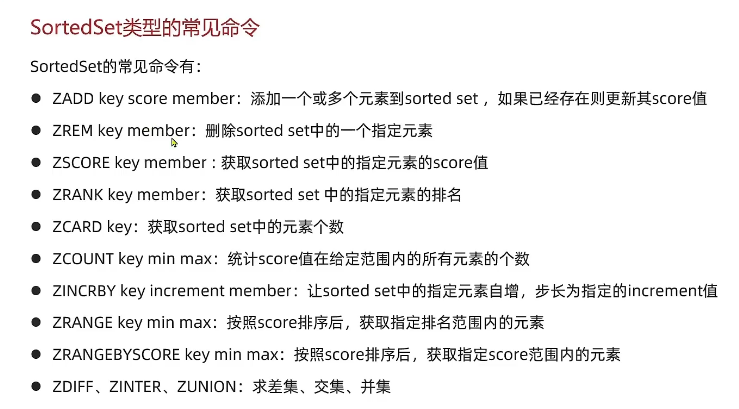
SortedSet类型
Redis的SortedSet是一个可排序的set集合,与Java中的TreeSet有些类似,但底层数据结构却差别很大。SortedSet中的每一个元素都带有一个score属性,可以基于score属性对元素排序,底层的实现是一个跳表(SkipList)加 hash表。
SortedSet具备下列特性:
- 可排序
- 元素不重复
- 查询速度快
因为SortedSet的可排序特性,经常被用来实现排行榜这样的功能。
| 类型 | 底层结构 | 特点 | Java 类比 | 典型业务场景 |
|---|---|---|---|---|
| String | SDS 简单动态字符串 | 最基础,一个 key 对应一个 value,支持字符串 / 数字 / 二进制 | String | 缓存、计数器、分布式锁、session 存储 |
| List | 双向链表 | 有序、元素可重复;头尾增删快,中间查询慢 | LinkedList | 消息队列、评论列表、点赞列表 |
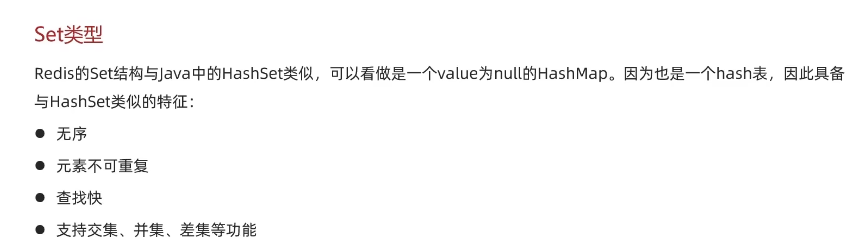
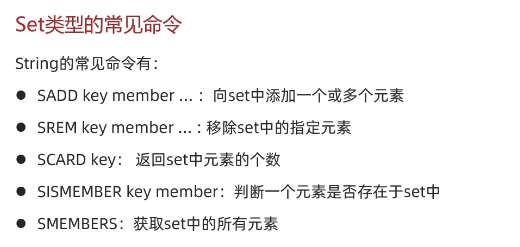
| Set | 哈希表 | 无序、元素不可重复;支持交集 / 并集 / 差集 | HashSet | 好友关系、去重、共同好友 |
| Hash | 哈希表 | key 下存储多个 field-value,适合对象 | HashMap | 用户信息、商品对象缓存 |
| SortedSet(zset) | 跳表 SkipList + hash 表 | 可按 score 排序、元素不重复,查询快 | TreeSet(仅功能类似,底层不同) | 排行榜、延时队列、权重排序 |