Ceph 分布式存储入门与集群部署
本文是 Ceph 分布式存储系列的第一篇,涵盖 Ceph 简介、架构组成、使用 cephadm 完成集群部署与初始化、以及集群基础配置(配置数据库、Monitor、网络)。
第 1 章 Ceph 分布式存储介绍
存储中用户角色
云存储用户角色
在一个比较大的云存储环境中,可能存在不同职责的存储用户。
存储管理员
- 存储管理员作为主要角色,执行以下任务:、
- 安装、配置和维护 Ceph 存储集群。
- 对基础架构架构师进行有关 Ceph 功能和特性的培训。
- 告知用户有关 Ceph 数据表示和方法的信息,作为他们数据应用程序的选择。
- 提供弹性和恢复,例如复本、备份和灾难恢复方法。
- 通过基础架构即代码实现自动化和集成。
- 提供对数据分析和高级海量数据挖掘的访问。
存储操作员
- 存储操作员协助存储集群的日常操作,通常不如存储管理员经验丰富。
- 存储操作员主要使用 Ceph Dashboard GUI 来查看和响应集群警报和统计信息。
- 存储操作员还负责日常存储管理任务,例如更换故障存储设备。
其他存储相关的角色
其他直接使用 Ceph 的角色包括应用程序开发人员、项目经理和具有数据处理、数据仓库、大数据和类
似应用程序需求的服务管理员。存储管理员经常与这些角色进行交流。定义这些关系有助于说明存储管
理员职责,并阐明存储管理员范围的任务限制或边界。
-
云操作员 ,管理组织中的云资源,例如 OpenStack 或 OpenShift 基础设施。存储管理员与云操作
员密切合作,维护 Ceph 集群。
-
自动化工程师,负责为常见的重复任务创建剧本。
-
应用程序开发人员(DevOps 开发人员) ,可以是原始代码开发人员、维护人员或其他负责应用程
序正确部署和行为的云用户。存储管理员与应用程序开发人员协调以确保存储资源可用、设置配额
并保护应用程序存储。
-
服务管理员 ,管理最终用户服务(不同于操作系统服务)。服务管理员具有与项目经理类似的角
色,但针对的是现有的生产服务产品。
-
部署工程师(DevOps 工程师) ,在更大的环境中,专职人员与存储管理员和应用程序开发人员一
起执行、管理和调整应用程序部署。
-
应用架构师 ,应用程序架构师可以在 Ceph 基础架构布局与资源可用性、扩展和延迟之间建立关
联。这种架构专业知识可帮助存储管理员有效地设计复杂的应用程序部署。为了支持云用户及其应
用程序,存储管理员必须了解资源可用性、扩展和延迟的这些相同方面。
-
基础架构架构师 ,存储管理员必须掌握存储集群的架构布局,才能管理资源位置、容量和延迟。
Ceph 集群部署和维护的基础架构架构师是存储管理员的主要信息来源。 基础架构架构师可能是云
服务提供商员工或供应商解决方案架构师或顾问。
-
数据中心操作员 ,是较低 Ceph 存储基础设施层的角色,负责数据供应。数据中心操作员通常受雇
于公共云服务提供商或私有数据中心云中组织的内部 IT 团队。
组织中用户角色
由于组织之间的人员配备、技能、安全性和规模不同,因此角色的实施通常不同。 尽管角色有时与个人
相匹配,但用户通常会根据他们的工作职责承担多个角色。
- 在电信服务提供商和云服务提供商中,常见的角色是云操作员、存储操作员、基础架构架构师和云
服务开发人员,通常只消费存储而不维护它们。 - 在银行、金融等需要安全、私有、专用基础架构的组织中,所有角色都由内部人员配备。 存储管理
员、云操作员和基础架构架构师角色充当服务提供商并支持所有其他角色。 - 在大学和较小的实施中,技术支持人员可以承担所有角色。 一个人可能会承担存储管理员、基础架
构架构师和云操作员角色。
Ceph 介绍
Ceph 简介
-
Ceph 是一款开源、分布式、软件定义存储 。
-
Ceph 具备极高的可用性、 扩展性和易用性, 用于存储海量数据。
-
Ceph 存储可部署在通用服务器上, 这些服务器的CPU可以是x86架构, 也可以是ARM架构。
-
Ceph 支持在同一集群内既有x86主机,又有ARM 主机。
软件定义 software-defined storage (SDS)
Ceph 技术优势
- 采用 RADOS 系统将所有数据作为对象, 存储在存储池中。
- 去中心化, 客户端可根据CRUSH算法自行计算出对象存储位置, 然后进行数据读写。
- 集群可自动进行扩展、 数据再平衡、 数据恢复等。
Ceph 使用场景
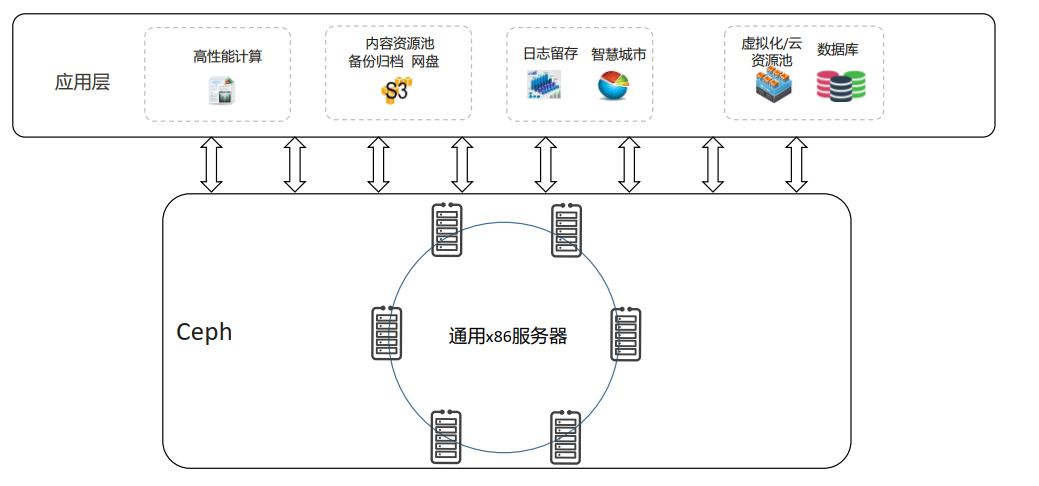
Ceph 历史
- Ceph是圣克鲁兹加利福尼亚大学的 **Sage Weil 在2003年开发的,他的博士学位项目的一部分。**初
始的项目原型是大约 40000 行 C++代码的 Ceph 文件系统,于 2006 年遵循 LGPL 协议(Lesser
GUN Public License)开源。Ceph没有采用双重许可模式,也就不存在只针对企业版的特性。 - 2003-2007 年是Ceph的研究开发时期。在这期间,它的核心组件逐步形成,并且社区对项目的贡献
开始逐渐变大。 - 2007年年末,Ceph已经越来越成熟,并开始等待孵化。
- 2012年4月,Sage Weil 在 DreamHost 的资助下成立了 Inktank 公司,主要目的是提供广泛的
Ceph 专业服务和技术支持。 - 2014年4月,Inktank 成为红帽大家庭的一员 ,Inktank Ceph Enterprise 也变为Ceph 存储。
此外,Ceph也与Linux内核、SUSE、OpenStack项目、CloudStack等项目进行了整合。一些公司将
Ceph整合为存储设备产品的核心,如富士通的CD10000项目和SANDisk的InfiniFlash。
上游 Ceph 版本
参考链接: https://docs.ceph.com/en/latest/releases/
统计时间:2025-05
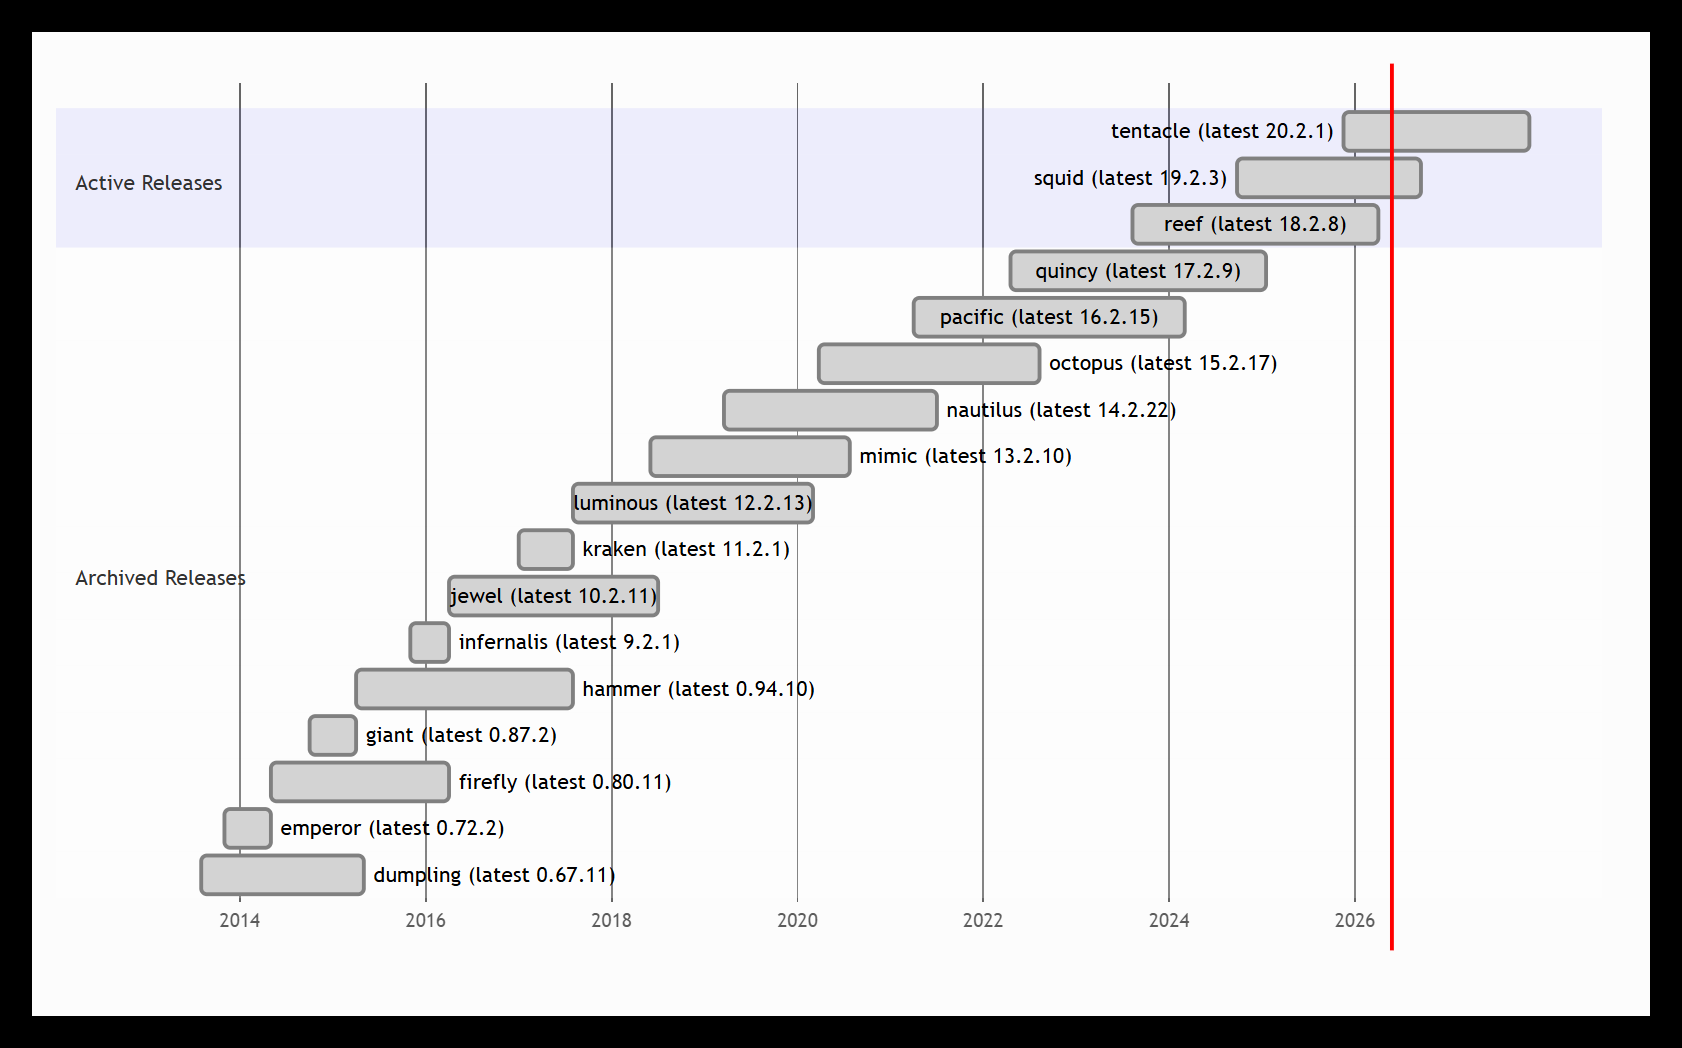
| Release code name | Version | LTS | Release date | Retirement date |
|---|---|---|---|---|
| Argonaut | 0.48.x | July 2012 | retired | |
| Bobtail | 0.56.x | January 2013 | retired | |
| Cuttlefish | 0.61.x | May 2013 | retired | |
| Dumpling | 0.67.x | Yes | August 2013 | May 2015 |
| Emperor | 0.72.x | November 2013 | May 2014 | |
| Firefly | 0.80.x | Yes | May 2014 | December 2015 |
| Giant | 0.87.x | October 2014 | May 2015 | |
| Hammer | 0.94.x | Yes | April 2015 | August 2017 |
| Infernalis | 9.2.x | November 2015 | April 2016 | |
| Jewel | 10.2.x | Yes | April 2016 | June 2018 |
| Kraken | 11.2.x | January 2017 | August 2017 | |
| Luminous | 12.2.x | Yes | August 2017 | January 2020 |
| Mimic | 13.2.x | Yes | June 2018 | April 2020 |
| nautilus | 14.2.x | Yes | March 2019 | June 2021 |
| octopus | 15.2.x | Yes | 2020-03-23 | 2022-06-01 |
| pacific | 16.2.x | Yes | 2021-03-31 | 2023-06-01 |
| Quincy | 17.2.x | Yes | 2022-04-19 | 2024-06-01 |
| Reef | 18.2.X | Yes | 2023-08-07 | 2025-08-01 |
| Squid | 19.2.X | Yes | 2024-09-26 | 2026-09-19 |
自Infernalis起,上游 Ceph 采用了新的版本号编号方案:每一稳定发行版主要版本号递增1。
- 2017年年底之前,上游CEPH项目每年发布两个稳定版本。
- 截止到Luminous版本,上游项目交替发布开发版本和长期稳定(LTS)版本。稳定版本发布后,将
- 停止更新开发版本。红帽的RHCS产品与社区的LTS版本的CEPH生命周期一致。
- 从 Nautilus release (14.2.0)开始,每年 March 1st 发布一个稳定版本。稳定版本周期大概2年。
版本格式 x.y.z 说明:
-
x identifies the release cycle (e.g., 13 for Mimic).
-
y identifies the release type:
-
x.0.z - development releases (for early testers and the brave at heart)
-
x.1.z - release candidates (for test clusters, brave users)
-
x.2.z - stable/bugfix releases (for users)
-
-
z identifies the release number
企业版 Ceph 存储
Ceph 存储
-
Ceph 存储是一个企业级别的、软件定义的、支持数千客户端、存储容量 EB 级别的分布式数据对象存储,提供统一存储(对象、块和文件存储)。
-
**Ceph 存储与 Ceph 项目的关系,类似于RHEL与Fedora关系。**红帽定期将来自上游项目的最新变化整合到企业版、并提供专业支持。红帽对Ceph存储的改进也会以开源形式回馈到上游项目。
-
红帽为企业版Ceph 存储提供36个月支持,比上游支持长1年。
Ceph 架构介绍
Ceph集群架构简介
Ceph存储是一种分布式数据对象存储。这是一种企业级软件定义存储解决方案,可扩展至数以千计数据访问量在艾字节以上的客户端。Ceph旨在提供卓越的性能、可靠性和可扩展性。
Ceph采用模块化分布式架构,包含下列元素:
- 对象存储后端,称为RADOS(可靠的自主分布式对象存储)
- 与RADOS交互的多种访问方式
RADOS是一种自我修复、自我管理、基于软件的对象存储。
Ceph访问方式-简介
Ceph提供以下访问Ceph集群的方法:
-
Ceph原生API(librados)
-
Ceph块设备(RBD、librbd),也称为 RADOS块设备(RBD)镜像
-
Ceph对象网关(RADOSGW、librgw)
-
Ceph文件系统(CephFS、libcephfs)
Ceph存储后端组件-简介
- **监控器(MON)**维护集群状态映射。它们可帮助其他守护进程互相协调。
- **对象存储设备(OSD)**存储数据并处理数据复制、恢复和重新平衡。
- **管理器(MGR)**通过基于浏览器的仪表板和RESTAPI,跟踪运行时指标并公开集群信息。
- **元数据服务器(MDS)**存储CephFS使用的元数据(而非对象存储或块存储),以便客户端能够高效运行 POSIX命令。
这些守护进程可以扩展,以满足所部署的存储集群的要求。
下图描述了Ceph集群的四种数据访问方法、支持访问方式的库,以及管理和存储数据的底层Ceph组件。
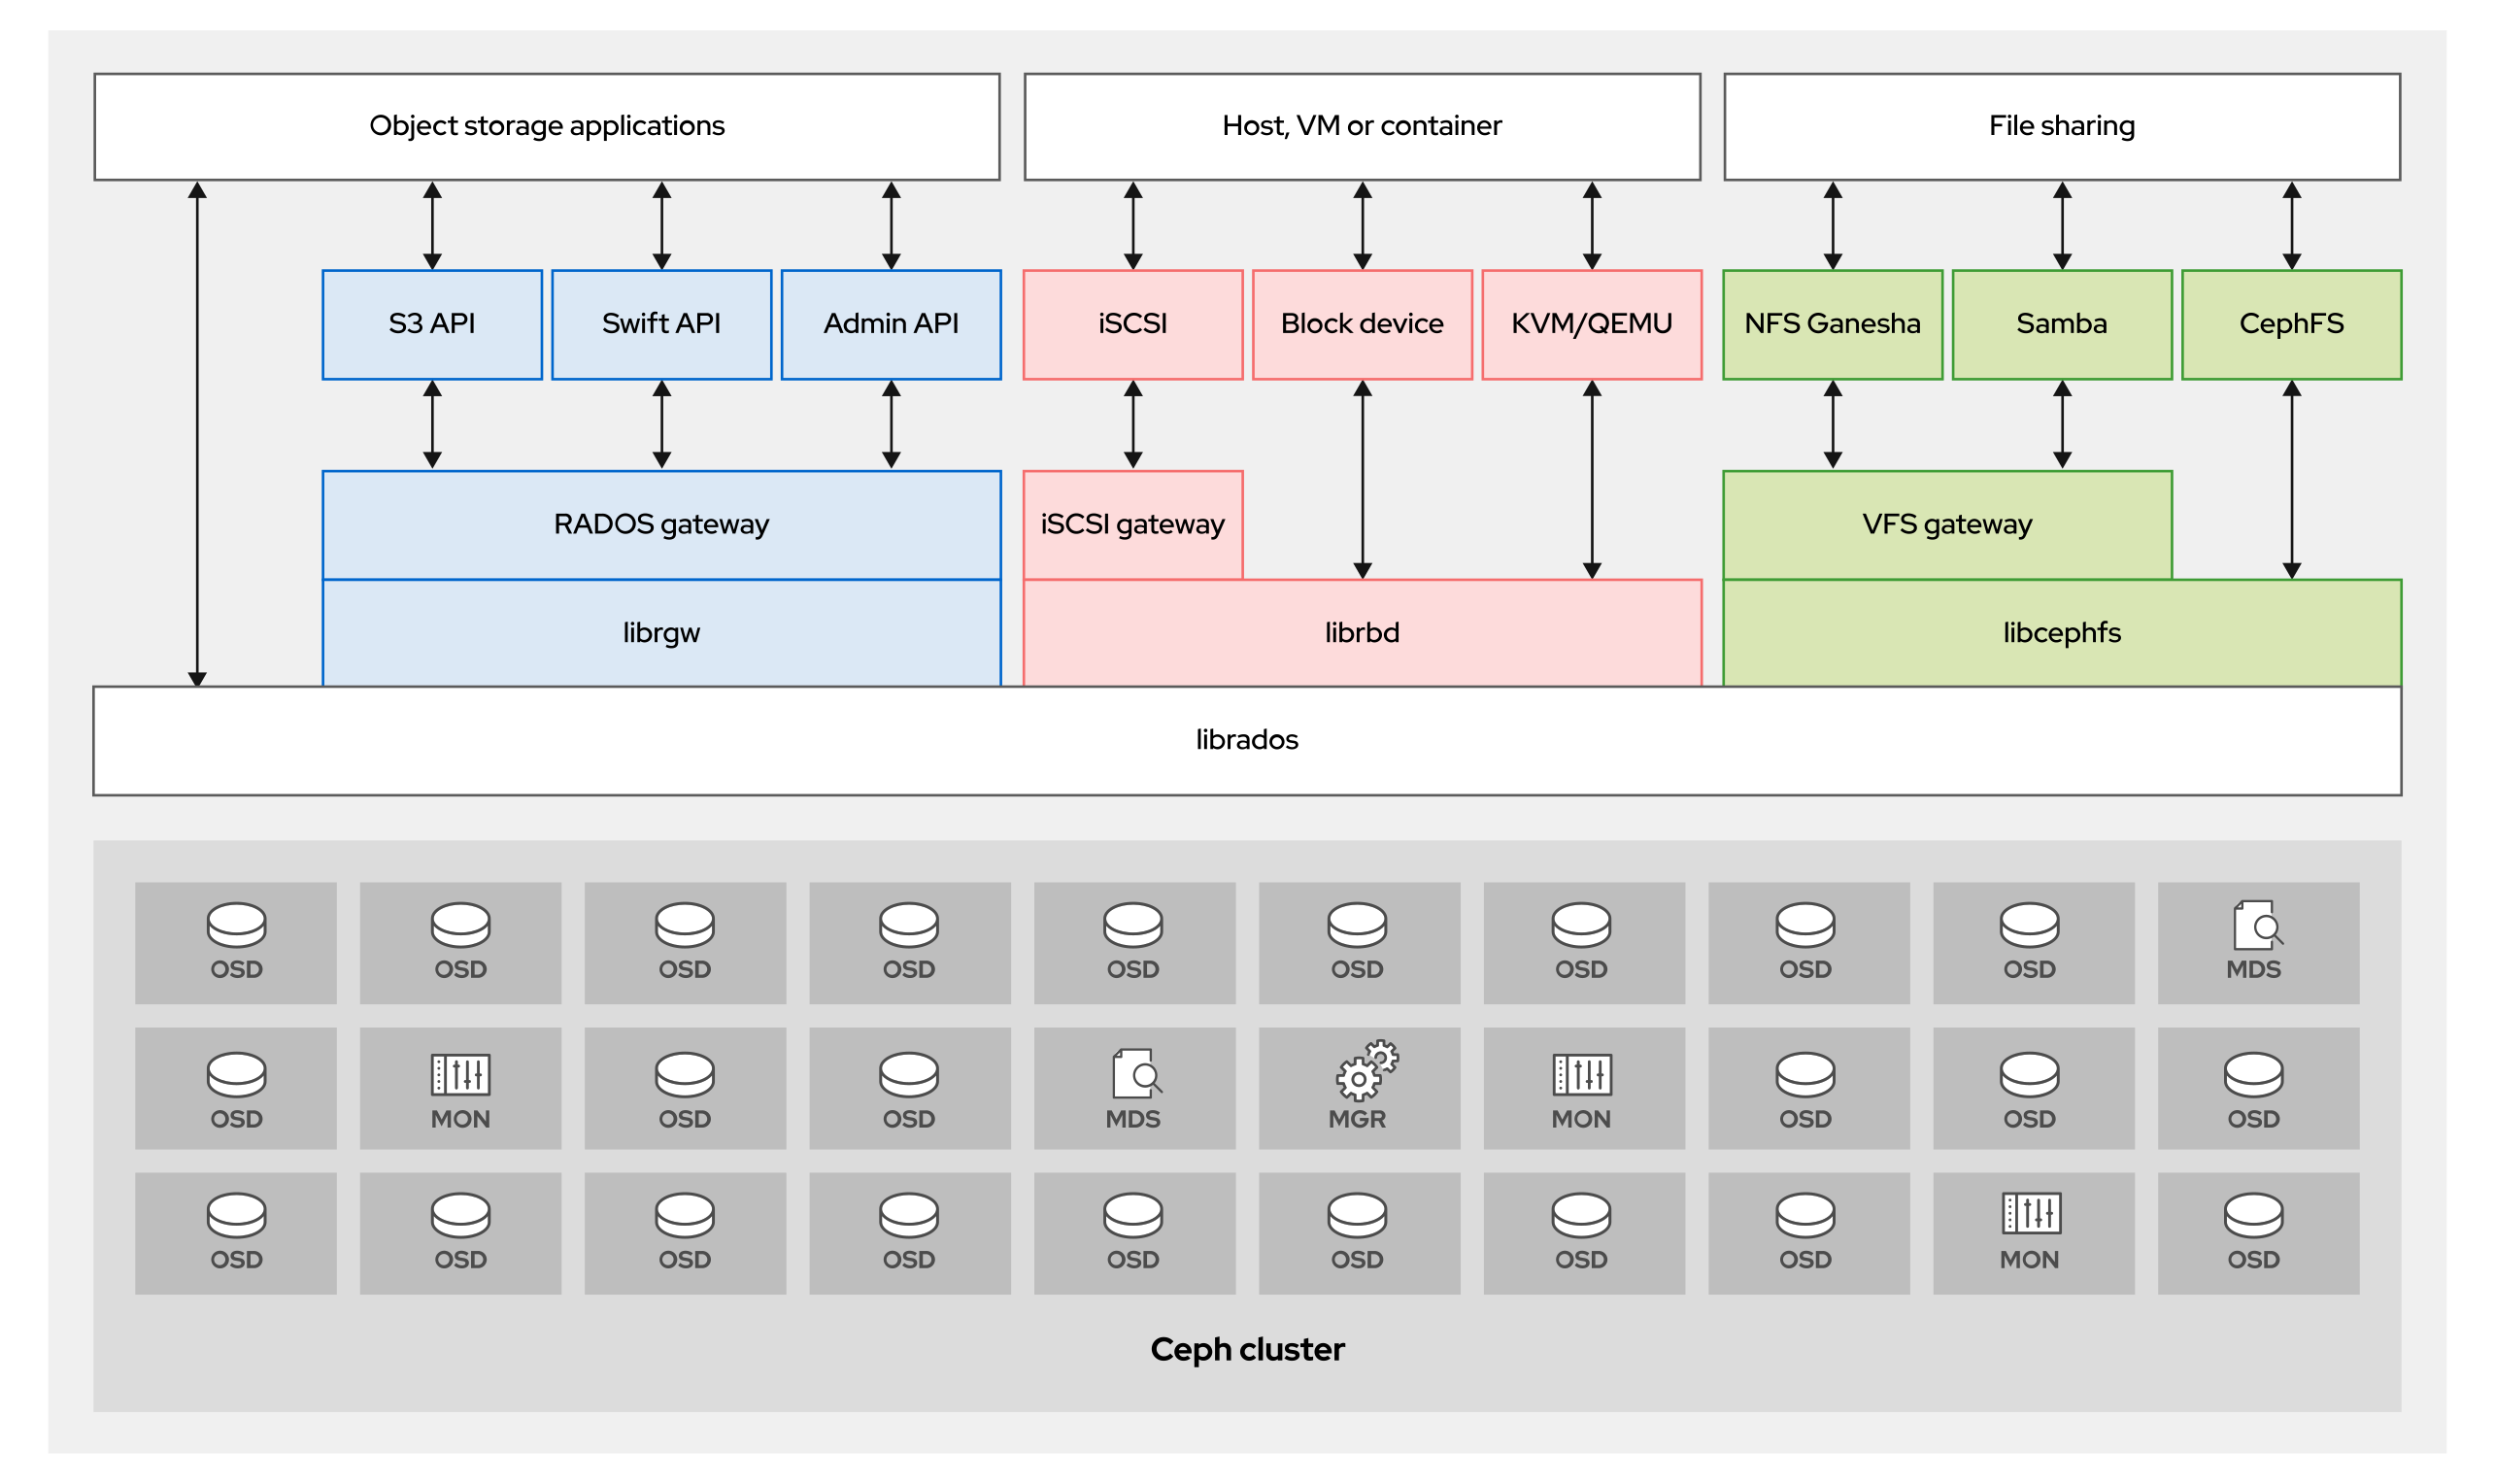
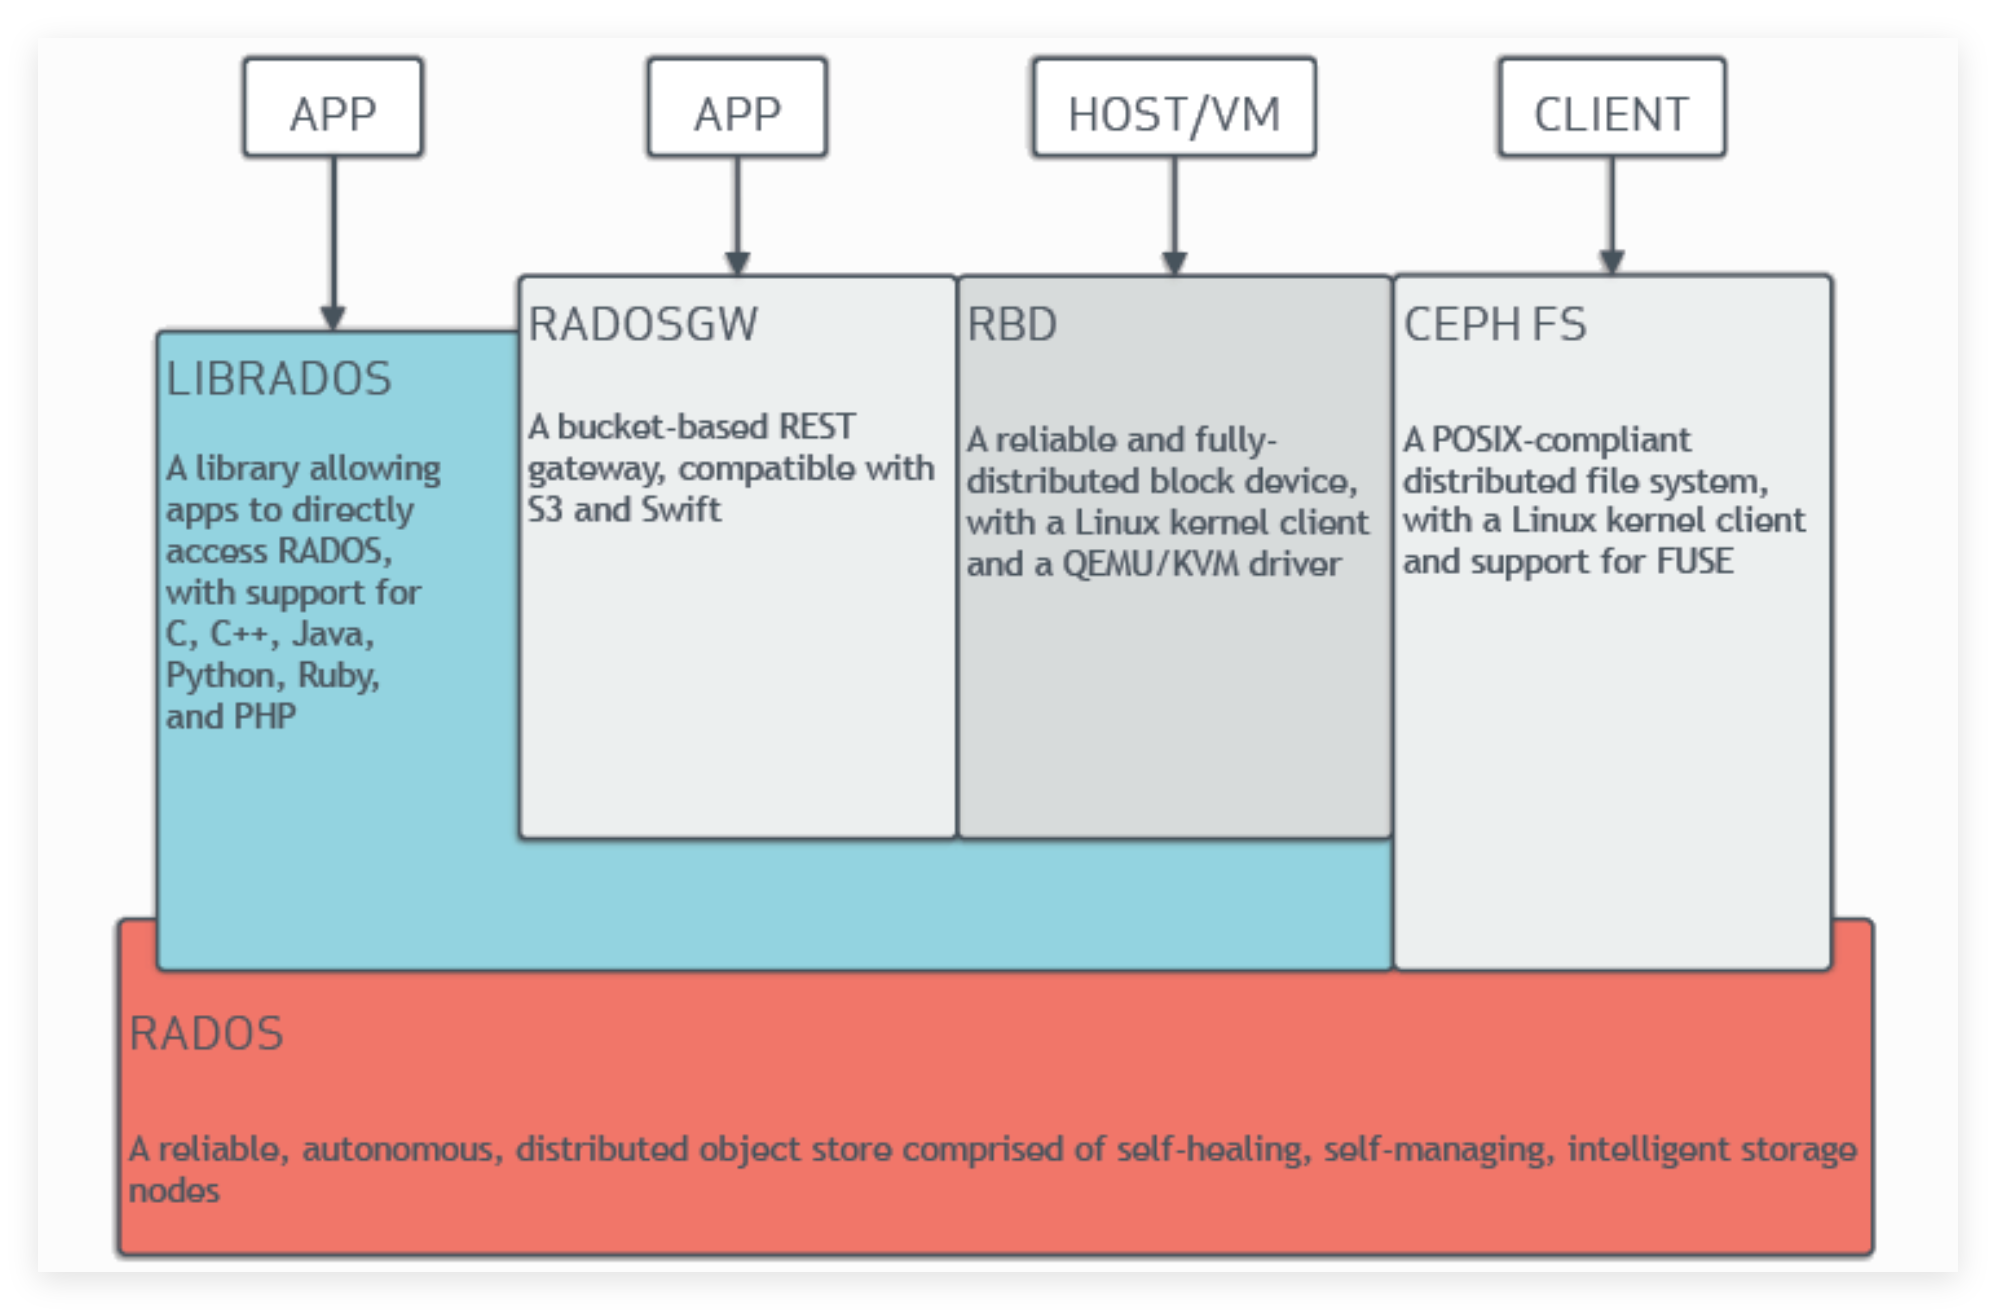
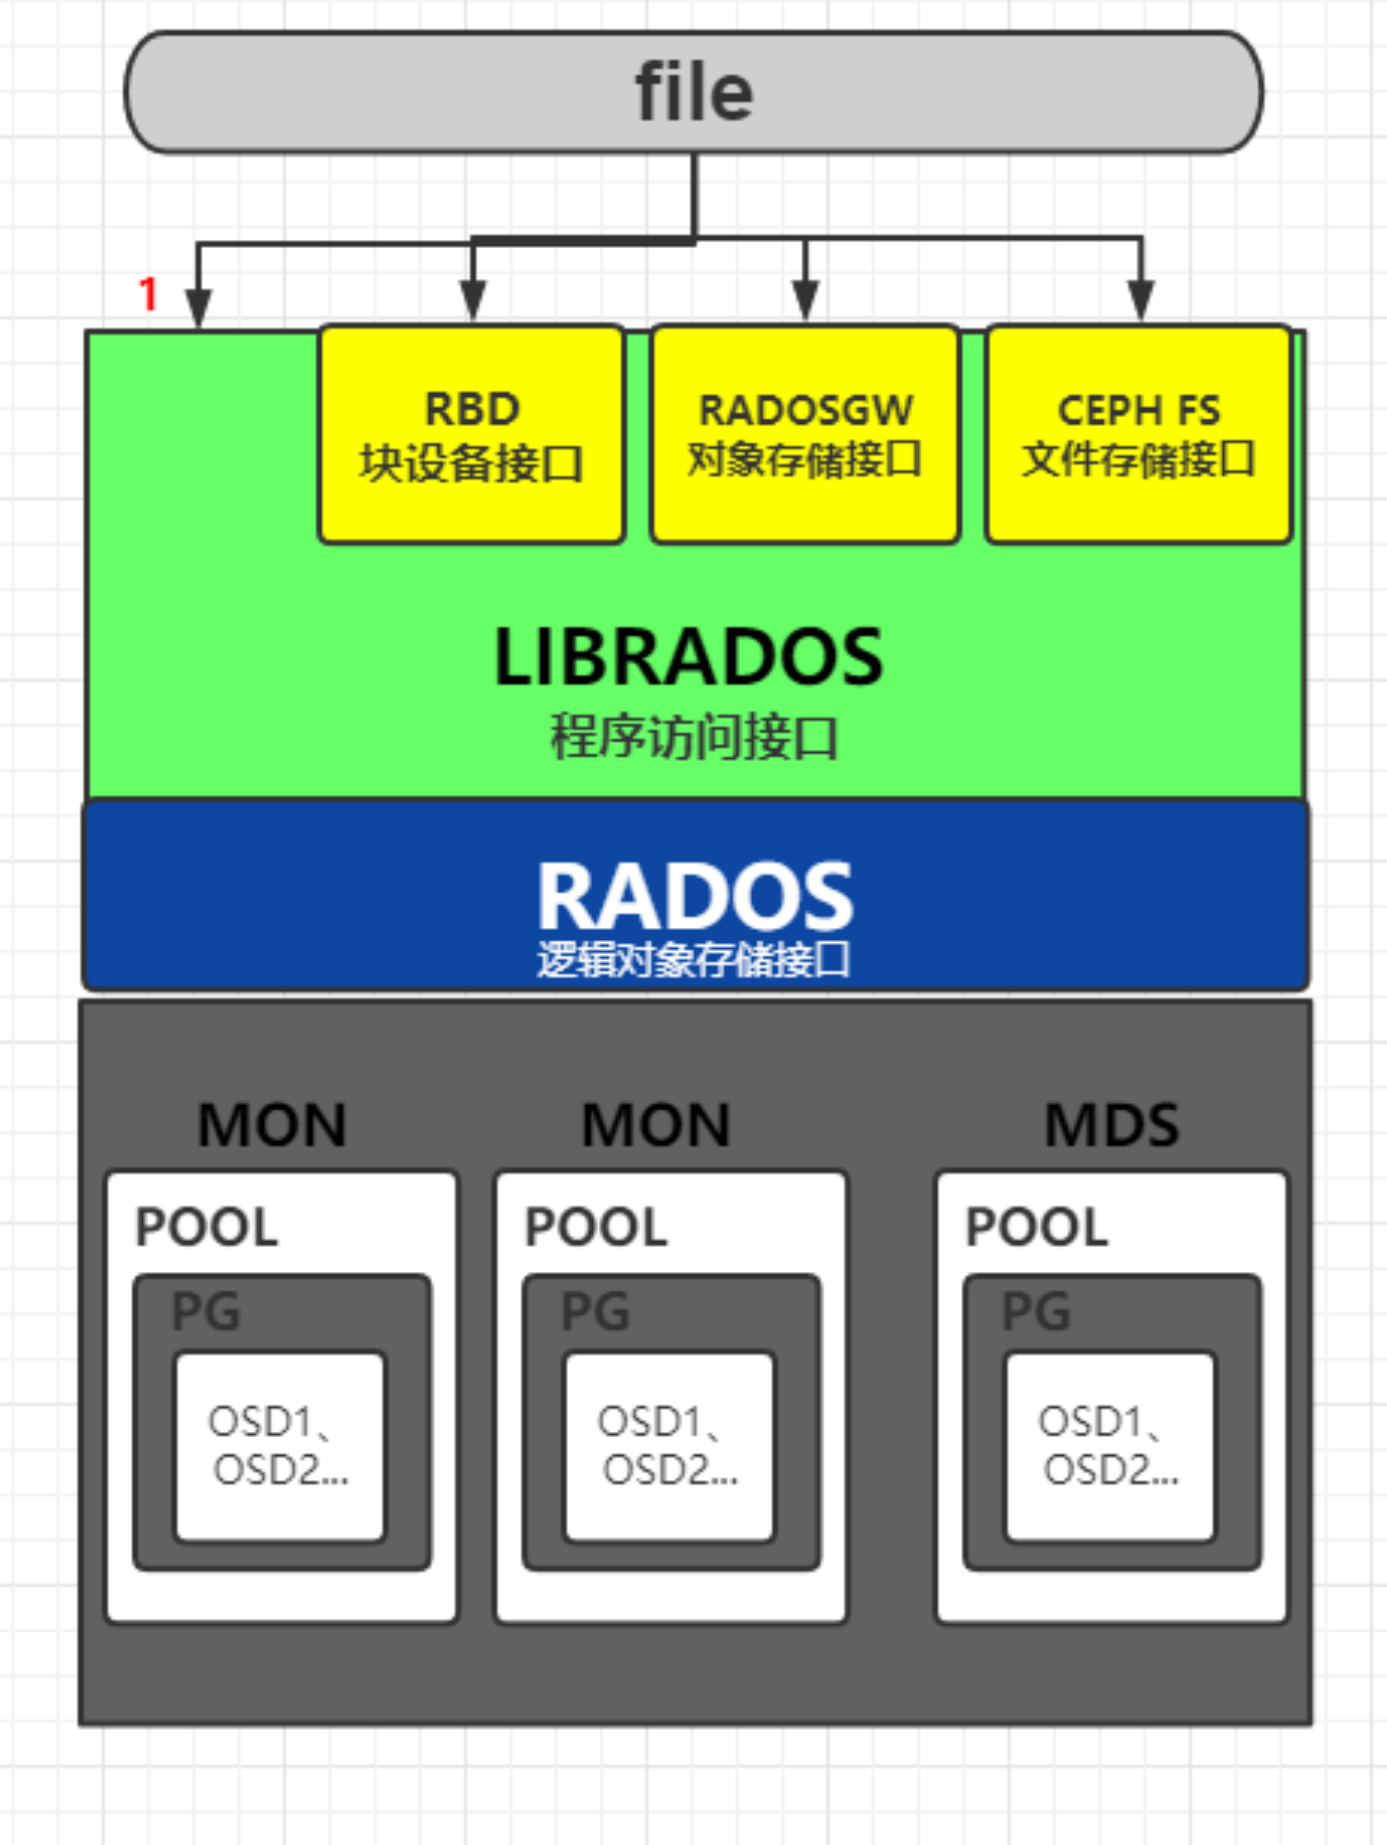
Ceph使用RADOS提供对象存储,通过librados封装库提供多种存储方式的文件和对象转换。外层通过RGW(Object,有原生的API,而且也兼容Swift和S3的API,适合单客户端使用)、RBD(Block,支持精简配置、快照、克隆,适合多客户端有目录结构)、CephFS(File,Posix接口,支持快照,社会和更新变动少的数据,没有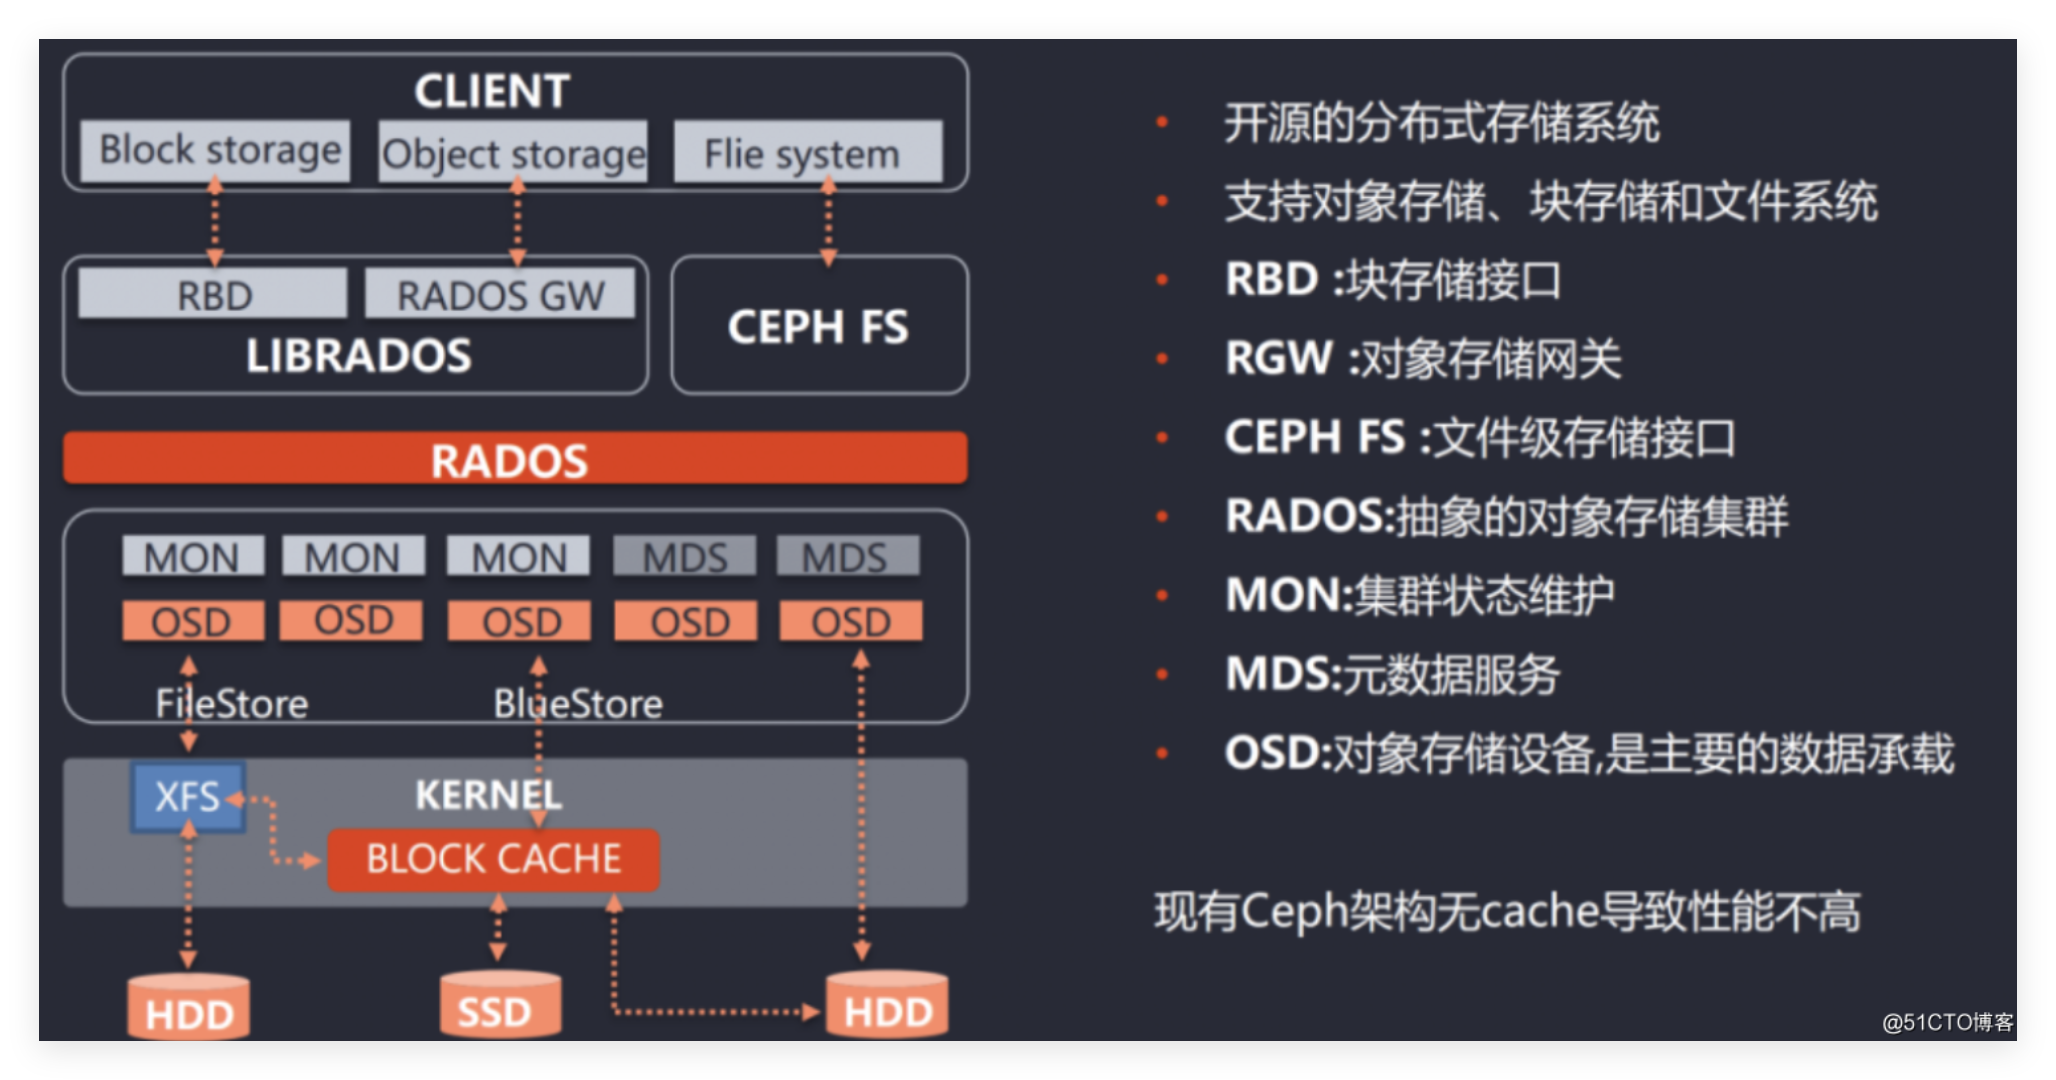 目录结构不能直接打开)将数据写入存储
Ceph访问方式-详细
Ceph原生API(librados)
实施Ceph块设备、Ceph对象网关等其他Ceph接口的基础库为librados。librados库是原生C语言库,可以让应用直接与RADOS协作来访问Ceph集群存储的对象。也有类似的库适用于C++、Java、Python、Ruby、Erlang和 PHP。
为最大化性能,请编写软件以直接与librados配合使用。这种方式可以在改进Ceph环境中存储性能方面达到最佳效果。为了简化对Ceph存储的访问,您可以改为使用所提供的更高级访问方式,如ceph块设备、Ceph对象网关(RADOSGW)和CephFS。
Ceph块设备(RBD、librbd)
Ceph块设备(RADOS块设备或RBD)通过RBD镜像在Ceph集群内提供块存储。Ceph分散在集群不同的OSD中构成RBD镜像的个体对象。由于组成RBD的对象分布到不同的OSD,对块设备的访问自动并行处理。
RBD提供下列功能:
- Ceph集群中虚拟磁盘的存储
- Linux内核中的挂载支持
- QEMU、KVM和 OpenStack Cinder 的启动支持
Ceph对象网关(RADOS网关、librgw)
Ceph对象网关(RADOS网关、RADOSGW或RGW)是使用librados构建的对象存储接口。它使用这个库来与Ceph集群通信,并且直接写入到OSD进程。它通过RESTfulAPI为应用提供了网关,并且支持两种接口:Amazon S3和 OpenStack Swift。
Ceph对象网关提供扩展支持,它不限制部署的网关数量,而且支持标准的HTTP负载均衡器。Ceph对象网关包括以下用例:
- 镜像存储(例如,SmugMug和TumbIr)
- 备份服务
- 文件存储和共享(例如,Dropbox)
Ceph文件系统(CephFS、libcephfs)
Ceph文件系统(CephFS)是一种并行文件系统,提供可扩展的、单层级结构共享磁盘。红帽Ceph存储可为CephFS提供生产环境支持,包括快照支持。
Ceph元数据服务器(MDS)管理与CephFS中存储的文件相关联的元数据,包括文件访问、更改和修改时间戳。
存储访问方式选择
-
为了最大限度地提高性能,请编写用户的应用程序以直接使用 librados 。
-
如果想简化对Ceph存储的访问,也可以使用其他三种访问方式。
Ceph后端存储组件-详细
RADOS(Reliable ,Autonomic ,Distributed Object Store),即可靠的、自主的、分布式的对象存储,是Ceph存储系统的核心。Ceph的所有优秀特性都是由RADOS提供的 ,包括分布式对象存储、高可用性、高可靠性、没有单点故障、自我修复以及自我管理等。Ceph中的一切数据都以对象的形式存储,RADOS负责存储这些对象,而不考虑它们的数据类型。
Ceph监视器(MON)
- MON 必须就集群的状态达成共识 ,才能对外提供服务。
- Ceph 集群配置奇数个监视器,以确保监视器在对集群状态进行投票时可以建立法定人数。
- 要使 Ceph 存储集群正常运行和访问,必须有超过一半的已配置监视器正常工作。
- Ceph Monitor (MON) 是维护集群映射的守护进程。 集群映射是多个映射的集合,包含有关集群状态及其配置的信息。 Ceph 必须处理每个集群事件,更新相应的映射,并将更新后的映射复本到每个 MON 守护进程。
Ceph对象存储设备(OSD)
Ceph 对象存储设备 (OSD) 将存储设备连接到 Ceph 存储集群。 单个存储服务器可以运行多个 OSD 守护进程并为集群提供多个 OSD。
Ceph 客户端和 OSD 守护进程使用可扩展哈希下的受控复制 (CRUSH) 算法来高效地计算有关对象位置的信息,而不是依赖于中央查找表。
CRUSH映射
**CRUSH 将每个对象分配给一个放置组 (PG),也就是单个哈希存储桶, PG 将对象映射给多个OSD。**PG 是对象(应用层)和 OSD(物理层)之间的抽象层。 CRUSH 使用伪随机放置算法将对象分布在 PG 之间,并使用规则来确定 PG 到 OSD 的映射。 如果发生故障,Ceph 会将 PG 重新映射到不同的物理设备 (OSD) 并同步它们的内容以匹配配置的数据保护规则。
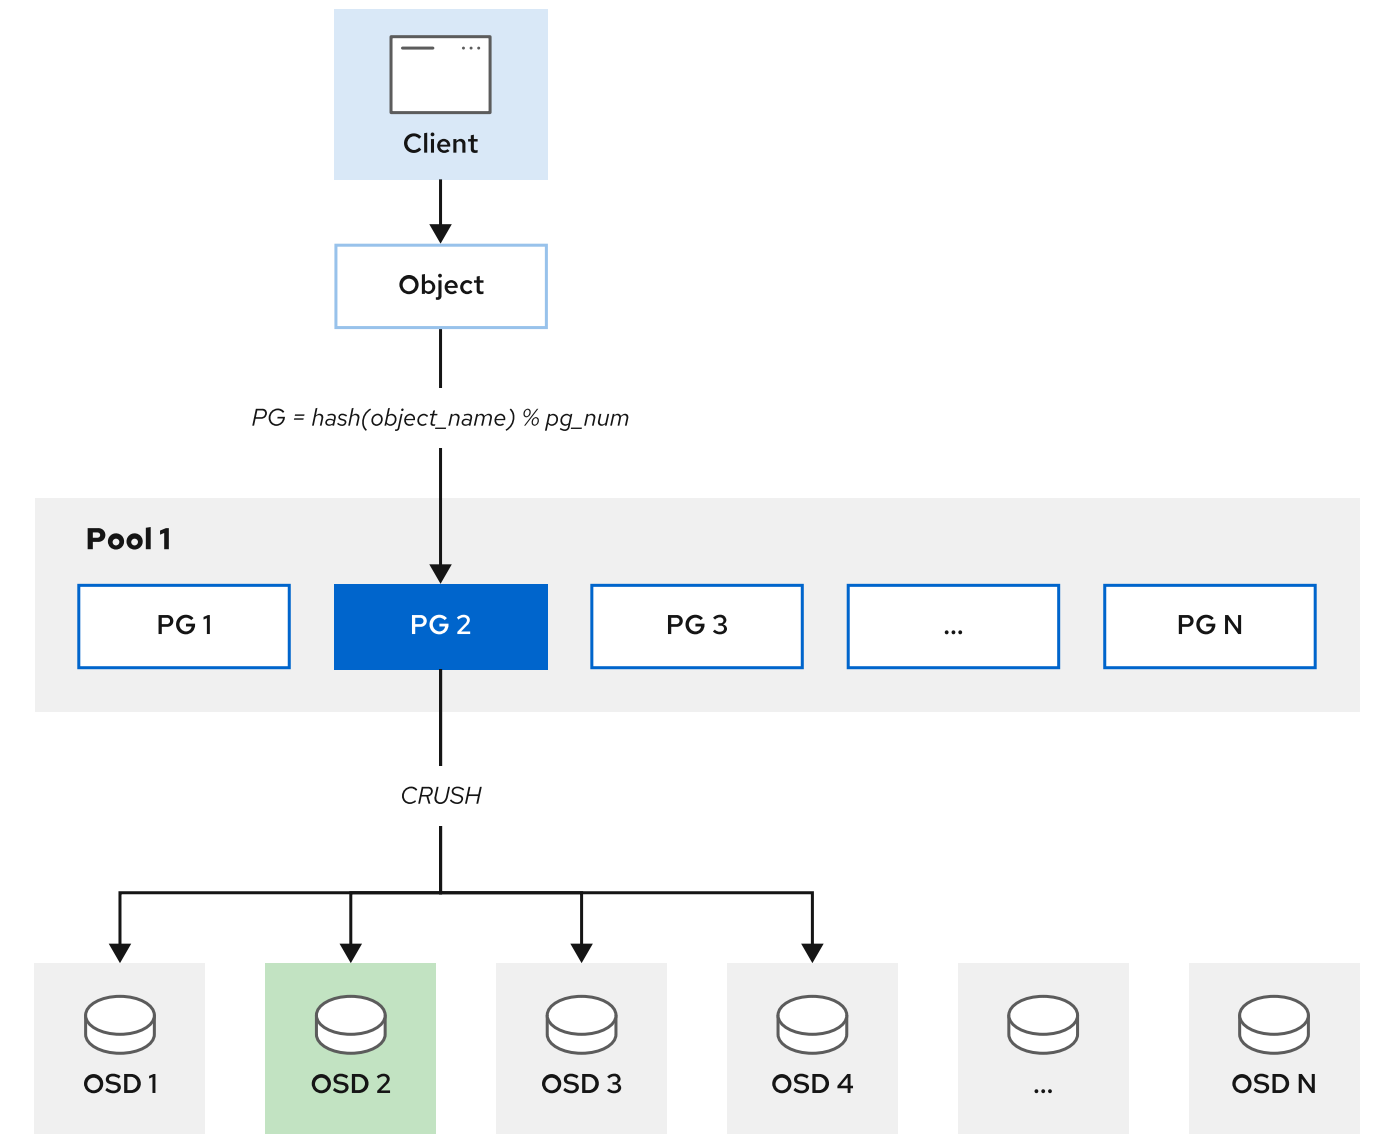
主要,次要OSD
与对象关联的多个OSD中,其中一个 OSD 是对象归置组的主 OSD,Ceph 客户端在读取或写入数据时总是联系主 OSD。 其他 OSD 是次要 OSD,在集群发生故障时确保数据的弹性可靠。
主要 OSD 功能:
- 服务所有 I/O 请求
- 复本和保护数据
- 检查数据一致性
- 重新平衡数据
- 恢复数据
次要 OSD 功能:
- 始终在主 OSD 的控制下行动
- 可以变为主 OSD
!WARNING
运行 OSD 的主机不得使用基于内核的客户端挂载 Ceph RBD 映像或 CephFS 文件系统。 由于内存死锁或之前会话上挂起的阻塞 I/O,挂载的资源可能会变得无响应。
**典型的Ceph集群部署方案:为每个物理磁盘创建一个OSD守护进程。**OSD也支持以更灵活的方式部署OSD守护进程,比如每个磁盘、每个主机或者每个RAID卷创建一个OSD守护进程。
**如下图:**Ceph集群包涵3个Monitor,多个OSD服务器。其中一个OSD服务器提供5个OSD,每个OSD守护进程对应一个存储设备。各个存储设备使用文件系统格式化,目前仅支持XFS文件系统。XFS文件系统上默认启用扩展属性,用于存储有关内部对象状态、快照元数据和Ceph RADOS网关ACL的信息。
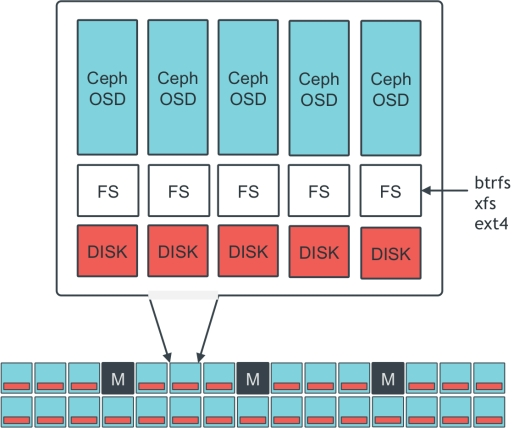
OSD日志 :每个OSD都有自己的OSD日志,OSD日志与文件系统日志无关,用于提升OSD操作写性能。**客户端的写请求常常是随机的,OSD进程按顺序将请求写入到日志。**这让主机文件系统有更多的时间来合并写操作,提高写效率,从而提高了性能。在所有OSD日志记录了写请求之后,CEPH集群通知客户端写入完成,然后将OSD日志的内容应用到后端文件系统。应用完成后,回收已经提交的日志请求,以回收日志存储设备上的空间。
-
当OSD或者存储服务器故障:如果日志未应用到文件系统,则根据日志将数据replay到文件系统;如果已经应用到后端文件系统,则根据复本恢复。
-
OSD日志最好配置为独立的、速度快的磁盘上,例如SSD,性能和写效率更好。
Ceph管理器(MGR)
- Ceph Manager(MGR)负责集群大部分数据统计。
- **如果集群中没有MGR,不会影响客户端I/O操作。**但是,将不能查询集群统计数据。为避免这种情形,建议为每个集群至少部署两个Ceph Managers,每个Managers运行在独立的失败域中。
- MGR 守护程序提供集中访问从集群收集的所有数据,并为存储管理员提供一个简单的 Web 仪表板。 MGR 守护进程还可以将状态信息导出到外部监控服务器,例如 Zabbix。
Ceph元数据服务器(MDS)
- Ceph 元数据服务器 (MDS) 管理 Ceph 文件系统 (CephFS) 元数据。
- MDS提供符合 POSIX 的共享文件系统元数据管理,包括所有权、时间戳和模式。
- MDS 使用 RADOS 存储元数据, 将文件 inode 映射到对象以及 Ceph 在树中存储数据的位置。
- 访问 CephFS 文件系统的客户端首先向 MDS 发送请求,MDS 提供客户端 获取文件内容所需的信息以便从正确的OSD获取文件内容。
集群映射(Cluster Map)
前面我们提到,MON维护集群映射。
Ceph 客户端和 OSD 通过集群映射确定数据存储位置。
五个映射表示集群拓扑,统称为集群映射。Ceph监控器守护进程维护集群映射。CephMON集群在监控器守护进程出现故障时确保高可用性。
集群映射有:
- 监视器映射(Monitor Map) , 包含集群的 fs id; 每个监视器(monitor)的位置、名称、地址和端口; 和地图时间戳。 fsid 是一个唯一的、自动生成的标识符 (UUID),用于标识 Ceph 集群。Ceph Monitor 守护进程维护集群映射。 使用 ceph mon dump 命令查看监视器图。
- OSD映射(OSD Map) , 包含集群的 fs id、池列表、复本大小、归置组编号、OSD 列表及其状态以及映射时间戳。 使用 ceph osd dump 命令查看 OSD 映射。
- 放置组映射(Placement Group Map) ,包含 PG 版本; 使用百分比; 每个归置组的详细信息,例如 PG ID、Up Set、Acting Set、PG 的状态、每个池的数据使用统计信息; 和地图时间戳。 使用 ceph pg dump 命令查看 PG Map 统计信息。
- CRUSH映射(CRUSH Map) , 包含存储设备列表、故障域层次结构(例如设备、主机、机架、行、房间)以及在存储数据时遍历层次结构的规则。 使用 ceph osd crush dump 命令查看 cursh Map 统计信息。
- 元数据服务器映射(MDS map) ,包含用于存储元数据的池、元数据服务器列表、元数据服务器状态和映射时间戳。 使用 ceph fs dump 命令查看 MDS 映射。
其他 map:
- Manager map ,包含 Manager 服务器列表、Manager 服务器状态和映射时间戳。 使用 ceph mgr dump 命令查看 MGR 映射。
- Service map ,包含RGW信息,如果集群中安装了RGW。 使用 ceph service dump 命令查看 rgw 统计信息。
第 2 章 Ceph 分布式存储 部署
Ceph 集群安装介绍
Ceph 集群安装方式
官方推荐部署方式:
- Cephadm:基于容器部署,支持 Octopus 及以后版本,部署完成后可通过命令行和图形界面进行ceph集群的管理。
- Rook:基于 kubernetes 部署,支持 Nautilus 及以后版本,部署完成后可通过命令行和图形界面进行ceph集群的管理,同时可通过 kubernetes 对组件所在 pod 进行管理。
其他部署方式:
- ceph-ansible,通过ansible进行ceph部署
- ceph-deploy,已经不再维护,不建议使用该方式部署
- DeepSea,通过salt进行ceph部署
- 手动部署
Ceph 集群 最小硬件规格
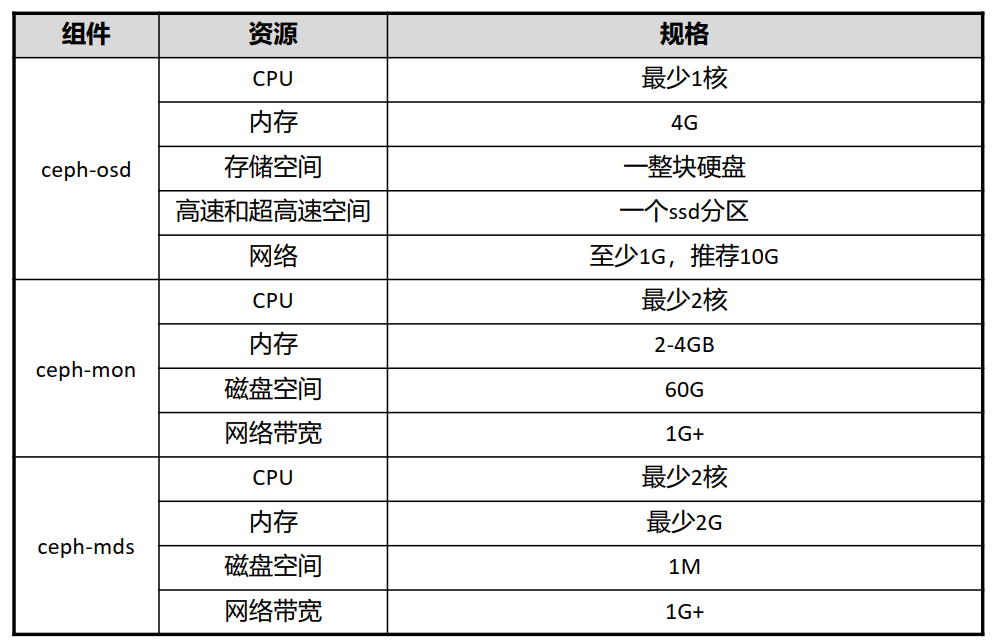
此处的最小硬件规格指的是在实际生产中的规格,实验手册中的规格会比此表中的规格小。
关于OSD的资源需注意:
- 每增加一个osd服务,就需要增加列出的资源。
- OSD的CPU资源最少是1核,后续根据带宽和IOPS进行调整,每200-500MB/s增加一核,或者每1000-3000IOPS增加一核。
- OSD的内存可以选择2G-4G,可以实现基本功能,但是会有卡顿。
Ceph 服务端口
| 服务 | 端口 | 描述 |
|---|---|---|
| MON | 6789、 3300 | 用于Ceph集群内部通信端口 |
| OSD | 6800-7300 | 每个osd占用四个端口,分别用于通过public网络与客户端和MON通信、 通过cluster网络或public网络与其他OSD数据通信、通过cluster网络或 public进行心跳数据包交换,其中用于心跳通信的端口需两个 |
| MDS | 6800-7300 | 用于与元数据服务器通信 |
| MGR | 8443 | 用于以SSL的方式登录ceph的图形化页面 |
| RESTful 管理模块 | 8003 | 用于以SSL的方式与RESTful管理模块通信 |
| Prometheus 管理模块 | 9283 | 用于与ceph的Prometheus插件通信 |
| Prometheus 告警管理 | 9093 | 用于与Prometheus的告警管理服务通信 |
| Prometheus 节点导出器 | 9100 | 用于与Prometheus节点导出器进程通信 |
| Grafana 服务器 | 3000 | 用于与Grafana服务通信 |
| RGW | 80 | 用于RADOSGW通信,如果client.rgw的配置为空, cephadm就使用默认 的80端口 |
| Ceph iSCSI 网关 | 9287 | 用于与ceph iSCSI网关通信 |
说明:
- 所有端口都是TCP协议。
- 在实验手册中,为了降低安装难度,直接关闭了firewalld及SELinux。
Cephadm 简介
-
Cephadm 是一个ceph全生命周期管理工具, 通过"引导( bootstrapping ) " 可创建一个包含一个MON和一个MGR的单节点集群, 后续可通过自带的编排接口进行集群的扩容、 主机添加、 服务部署。
-
Cephadm 使用容器部署 Ceph,大大降低了部署 Ceph 集群的复杂性和包依赖性。
-
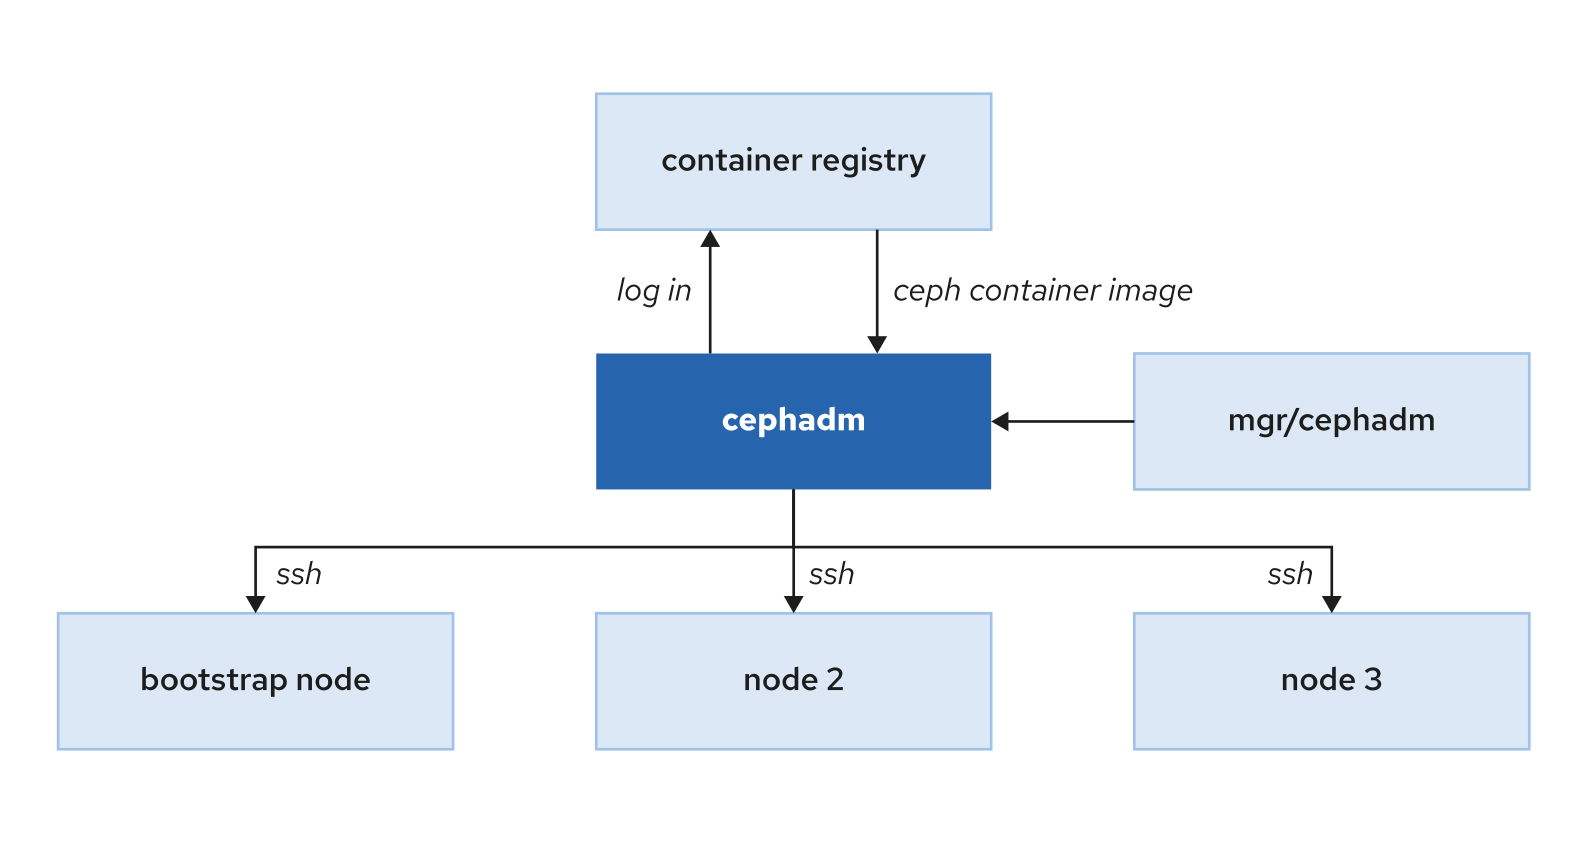
cephadm 软件包安装在集群第一个节点中,该节点充当引导节点。Cephadm 是部署新集群时启动的第一个守护程序,同时也是管理器守护程序 (MGR) 中的一个模块。
Cephadm 与其他服务交互
-
Cephadm 登录容器镜像仓库来拉取 Ceph 镜像并在使用该镜像的节点上部署服务。
-
Cephadm 使用 SSH 连接,向集群添加新主机、添加存储或监控这些主机。
Cephadm 管理接口
Ceph 使用容器化部署,首先创建一个最小的集群,只有一个主机(引导节点)和两个守护进程(监视器和管理器守护进程)。
Ceph 提供两个管理接口:Ceph CLI 和 Dashboard GUI,用于配置 Ceph 守护进程和服务以及扩展或收缩集群。
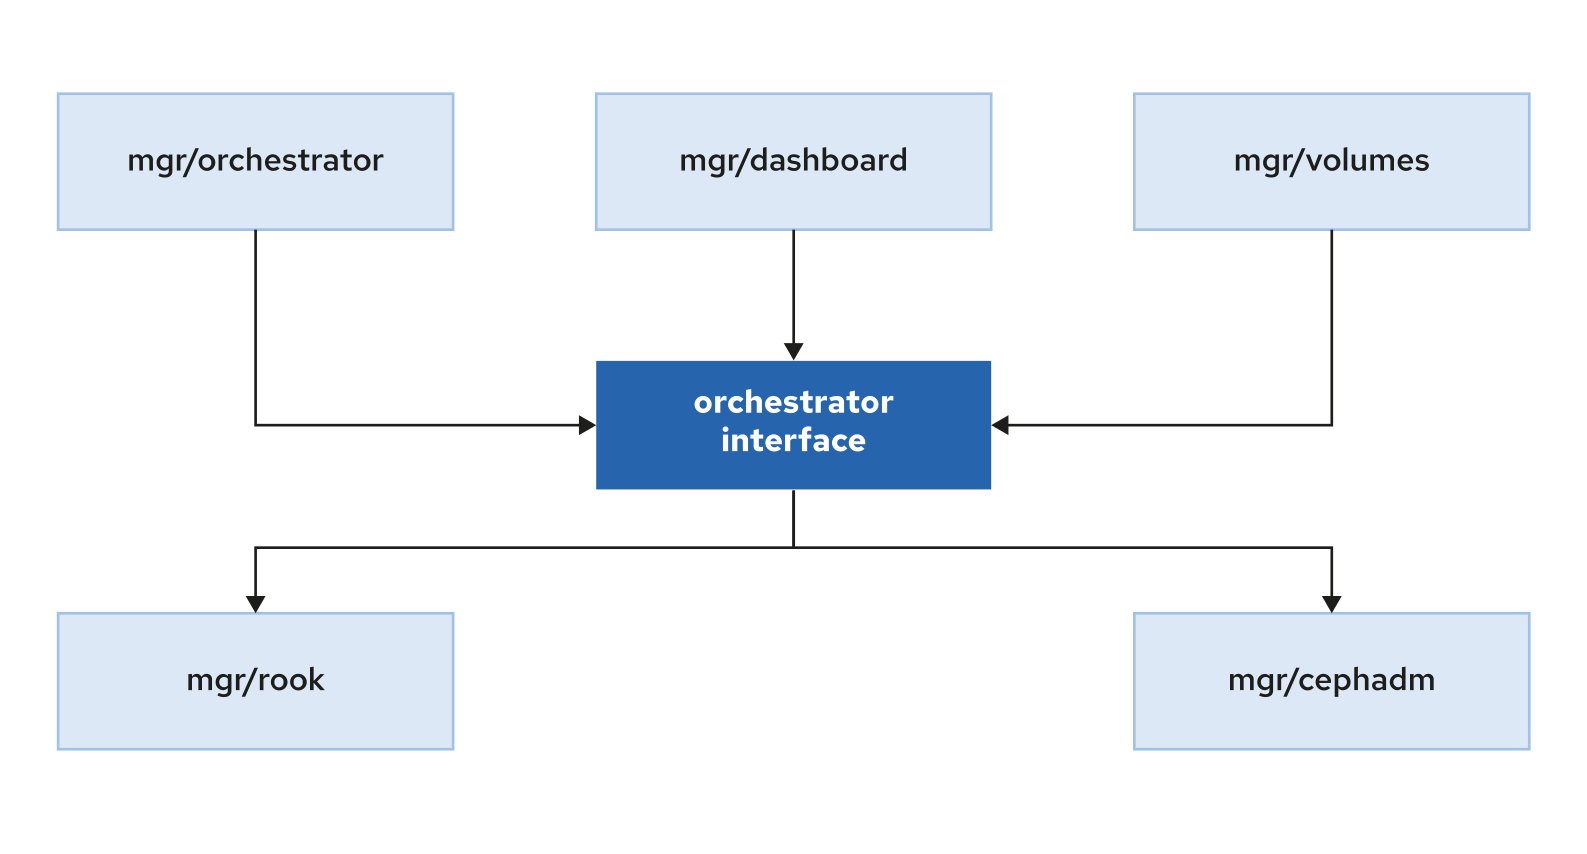
cephadm 工具与 Ceph Manager 编排模块交互,Ceph Manager Orchestrator 再与其他组件交互:
Ceph CLI 接口
cephadm shell 命令启动一个容器化版本的 shell,容器中安装了所有必需的 Ceph 包。该命令应该只在引导节点中运行,因为在引导集群时只有该节点可以访问 /etc/ceph 中的管理密钥环。
实际情况,在集群中其他节点也可以执行,例如ceph1。
bash
[root@ceph1 ~]# cephadm shell
Inferring fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Using recent ceph image quay.io/ceph/ceph@sha256:f15b41add2c01a65229b0db515d2dd57925636ea39678ccc682a49e2e9713d98
[ceph: root@ceph1 /]#
还可以通过容器化的 shell 直接运行命令:cephadm shell -- command。
bash
[root@ceph1 ~]# cephadm shell -- ceph status
Inferring fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Using recent ceph image quay.io/ceph/ceph@sha256:f15b41add2c01a65229b0db515d2dd57925636ea39678ccc682a49e2e9713d98
  cluster:
    id:     2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
    health: HEALTH_OK

  services:
    mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 12m)
    mgr: ceph2.oetbal(active, since 11m), standbys: ceph1.laogao.cloud.zoqmbt, ceph3.npaxvt
    osd: 9 osds: 9 up (since 12m), 9 in (since 3w)

  data:
    pools:   1 pools, 1 pgs
    objects: 0 objects, 0 B
    usage:   2.6 GiB used, 177 GiB / 180 GiB avail
    pgs:     1 active+clean
为了操作方便,可以直接在物理主机执行ceph命令,需要安装ceph-common软件包。
bash
[root@ceph1 ~]# dnf install -y ceph-common
[root@ceph1 ~]# ceph status
Ceph Dashboard 接口
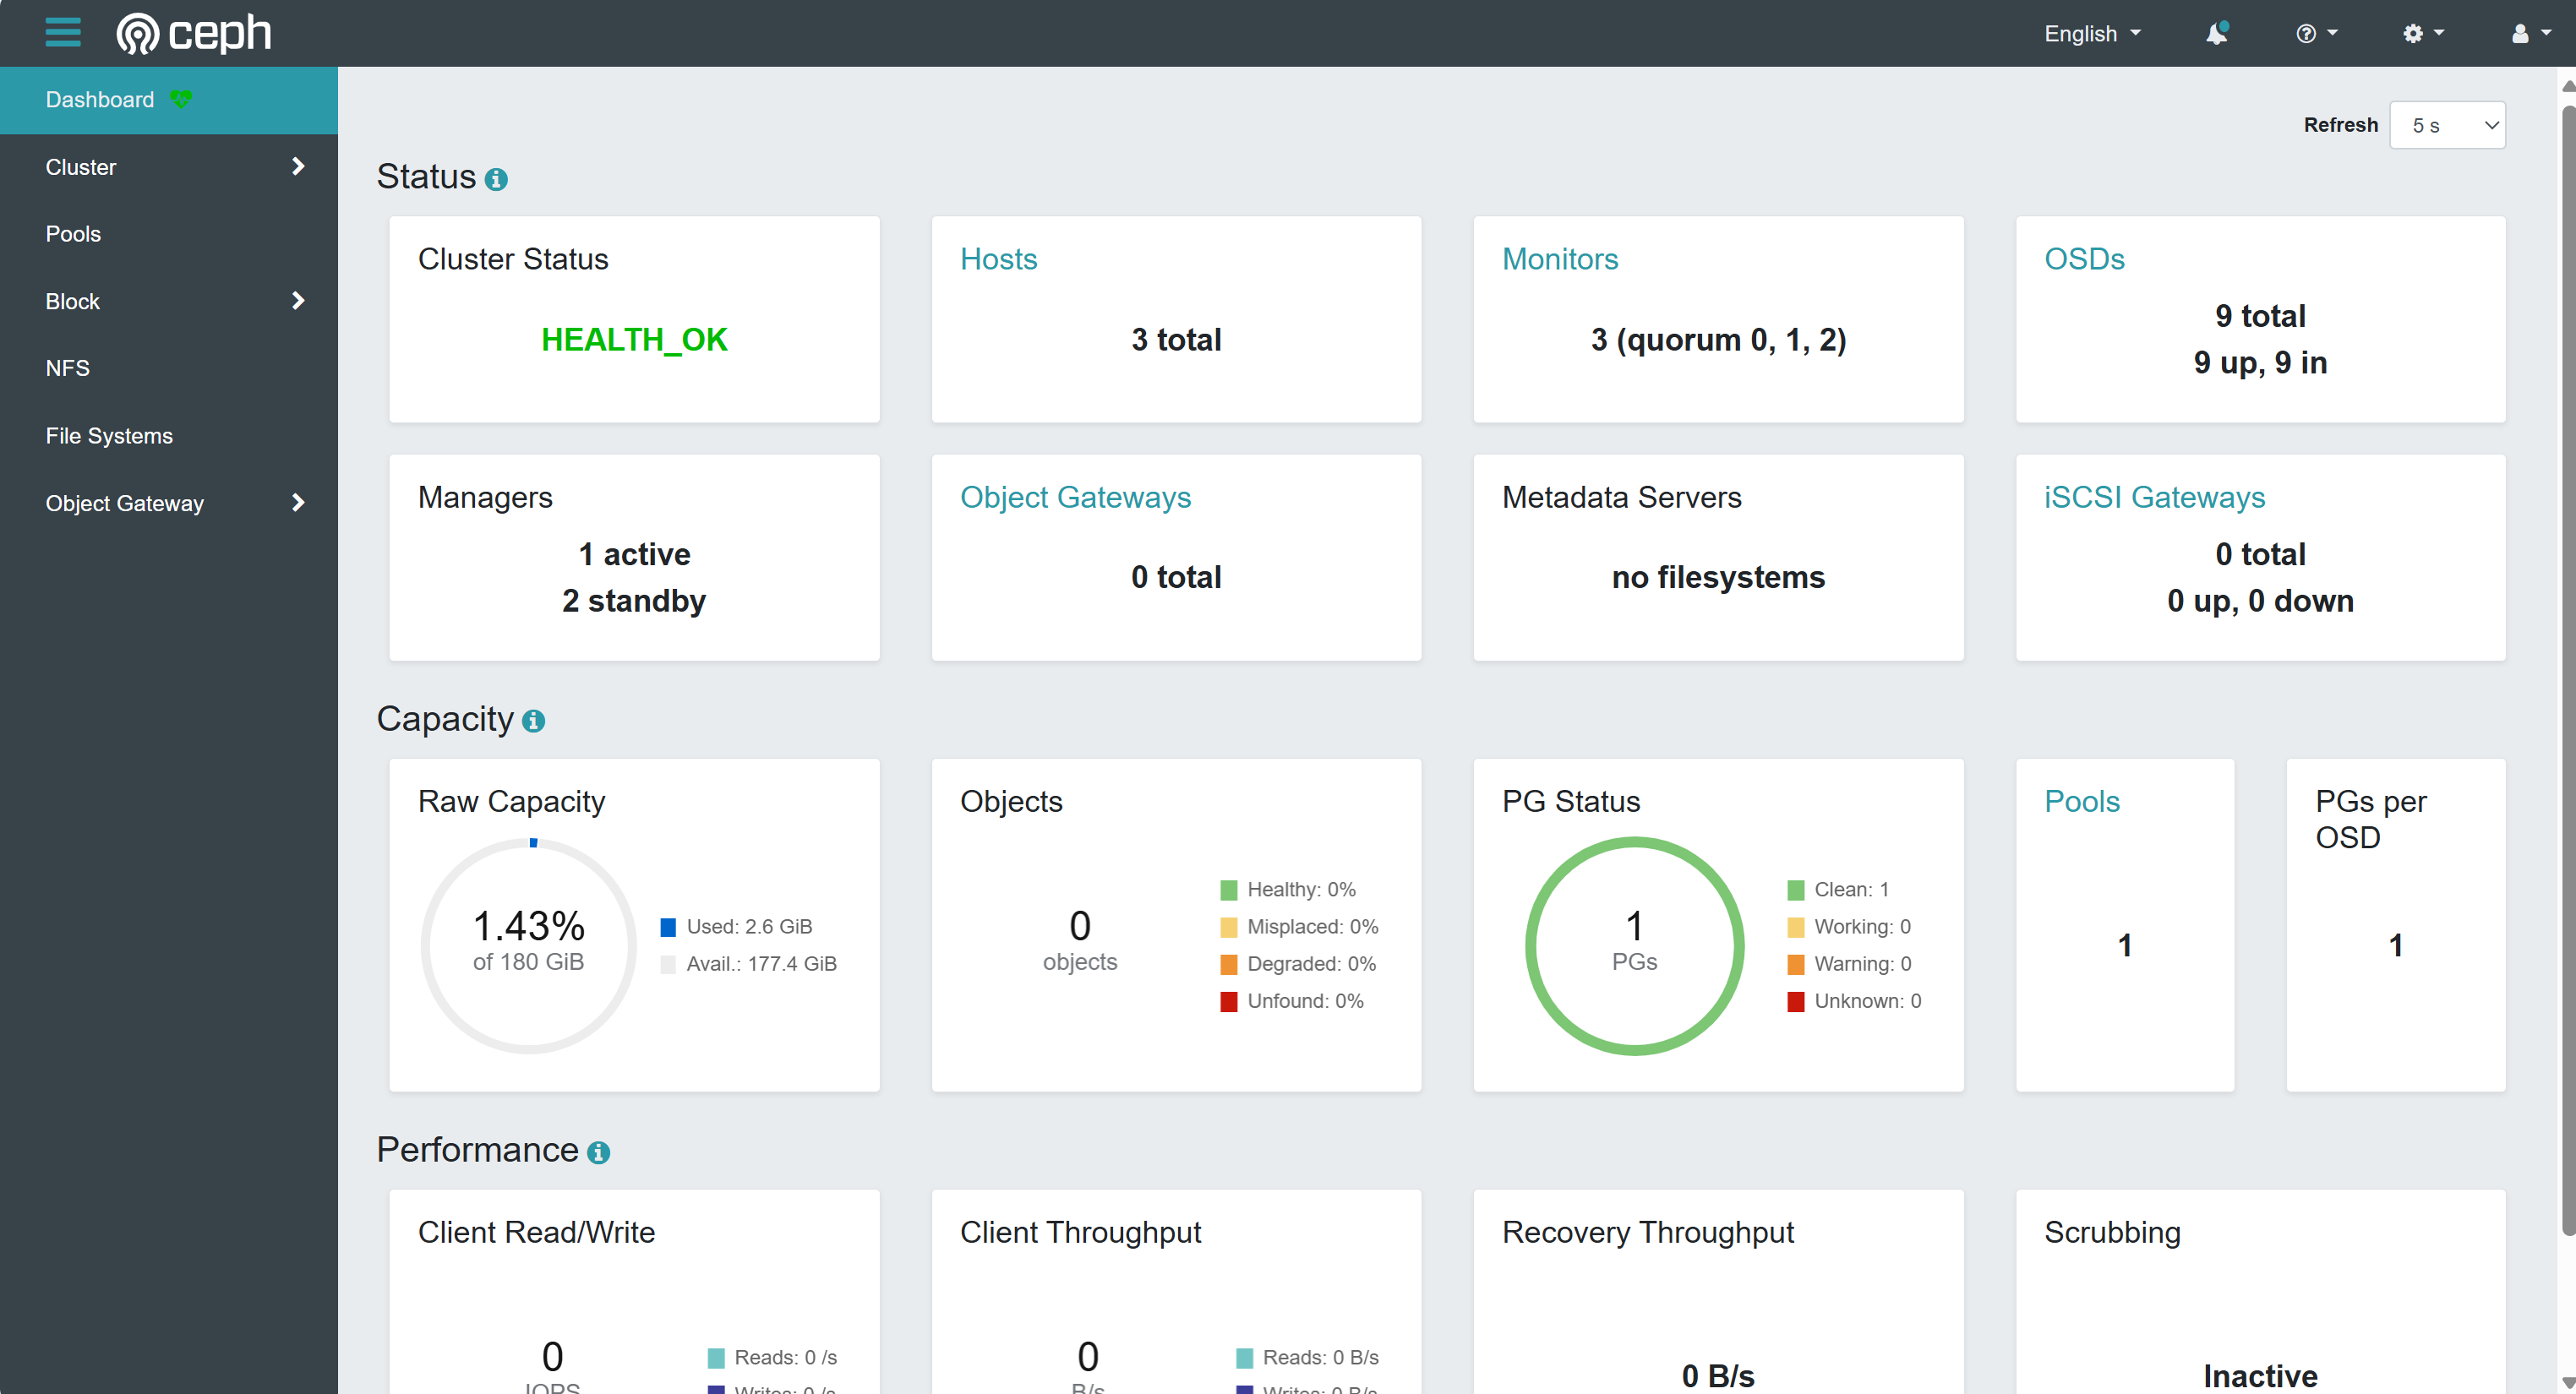
Ceph Dashboard GUI 是一个基于 Web 的应用程序,用于监视和管理集群。 Ceph Dashboard GUI 得到了增强,可通过此界面执行许多集群任务,比 Ceph CLI 更直观的方式提供集群信息。
与 Ceph CLI 一样,Dashboard GUI Web 是 ceph-mgr 守护进程的一个模块。 默认情况下,Ceph 在创建集群时将 Dashboard GUI 部署在引导节点,并使用 TCP 端口 8443。
Ceph Dashboard GUI 提供以下功能:
- 用户和角色管理,用户可以创建具有多个权限和角色的不同用户帐户。
- 单点登录,仪表板 GUI 允许通过外部身份提供者进行身份验证。
- 审计,用户可以将仪表板配置为记录所有 REST API 请求。
- 安全,默认情况下,仪表板使用 SSL/TLS 来保护所有 HTTP 连接。
Ceph Dashboard GUI 还实现了集群管理和监控功能:
- 管理功能
- 使用 CRUSH 地图查看集群层次结构
- 启用、编辑和禁用管理器模块
- 创建、删除和管理 OSD
- 管理 iSCSI
- 管理池
- 监控功能
- 检查整体集群健康状况
- 查看集群中的主机及其服务
- 查看日志
- 查看集群警报
- 检查集群容量
下图显示了仪表板 GUI 的状态屏幕,可以快速查看一些重要的集群参数,例如集群状态、集群中的主机数量或 OSD 数量。
Ceph 集群安装过程
Ceph 集群环境说明
部署方法:cephadm
操作系统:Centos Stream 8(最小化安装)
硬件配置:2 cpu、8G memory、1个系统盘+3个20G数据盘
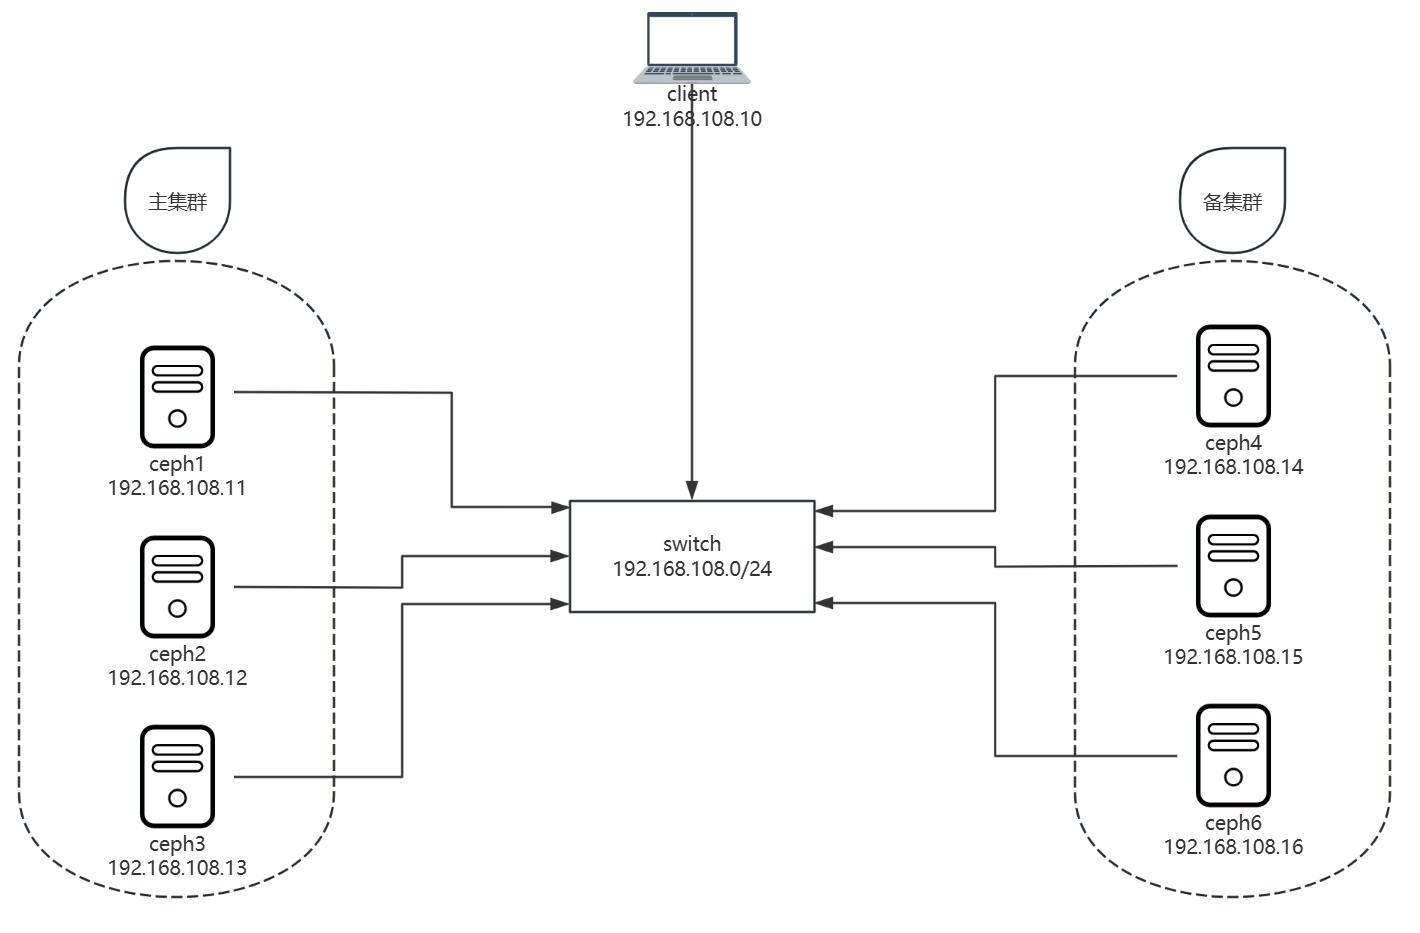
本教材共使用7台虚拟机:
- 客户端:client
- 主集群:ceph1、ceph2、ceph3
- 备集群:ceph4、ceph5、ceph6
| 主机名 | IP 地址 | 角色 |
|---|---|---|
| client.laogao.cloud | 192.168.108.10 | 客户端节点 |
| ceph1.laogao.cloud | 192.168.108.11 | 主集群-ceph 节点 |
| ceph2.laogao.cloud | 192.168.108.12 | 主集群-ceph 节点 |
| ceph3.laogao.cloud | 192.168.108.13 | 主集群-ceph 节点 |
| ceph4.laogao.cloud | 192.168.108.14 | 备集群-ceph 节点 |
| ceph5.laogao.cloud | 192.168.108.15 | 备集群-ceph 节点 |
| ceph6.laogao.cloud | 192.168.108.16 | 备集群-ceph 节点 |
网络拓扑如下图所示:
准备虚拟机模板
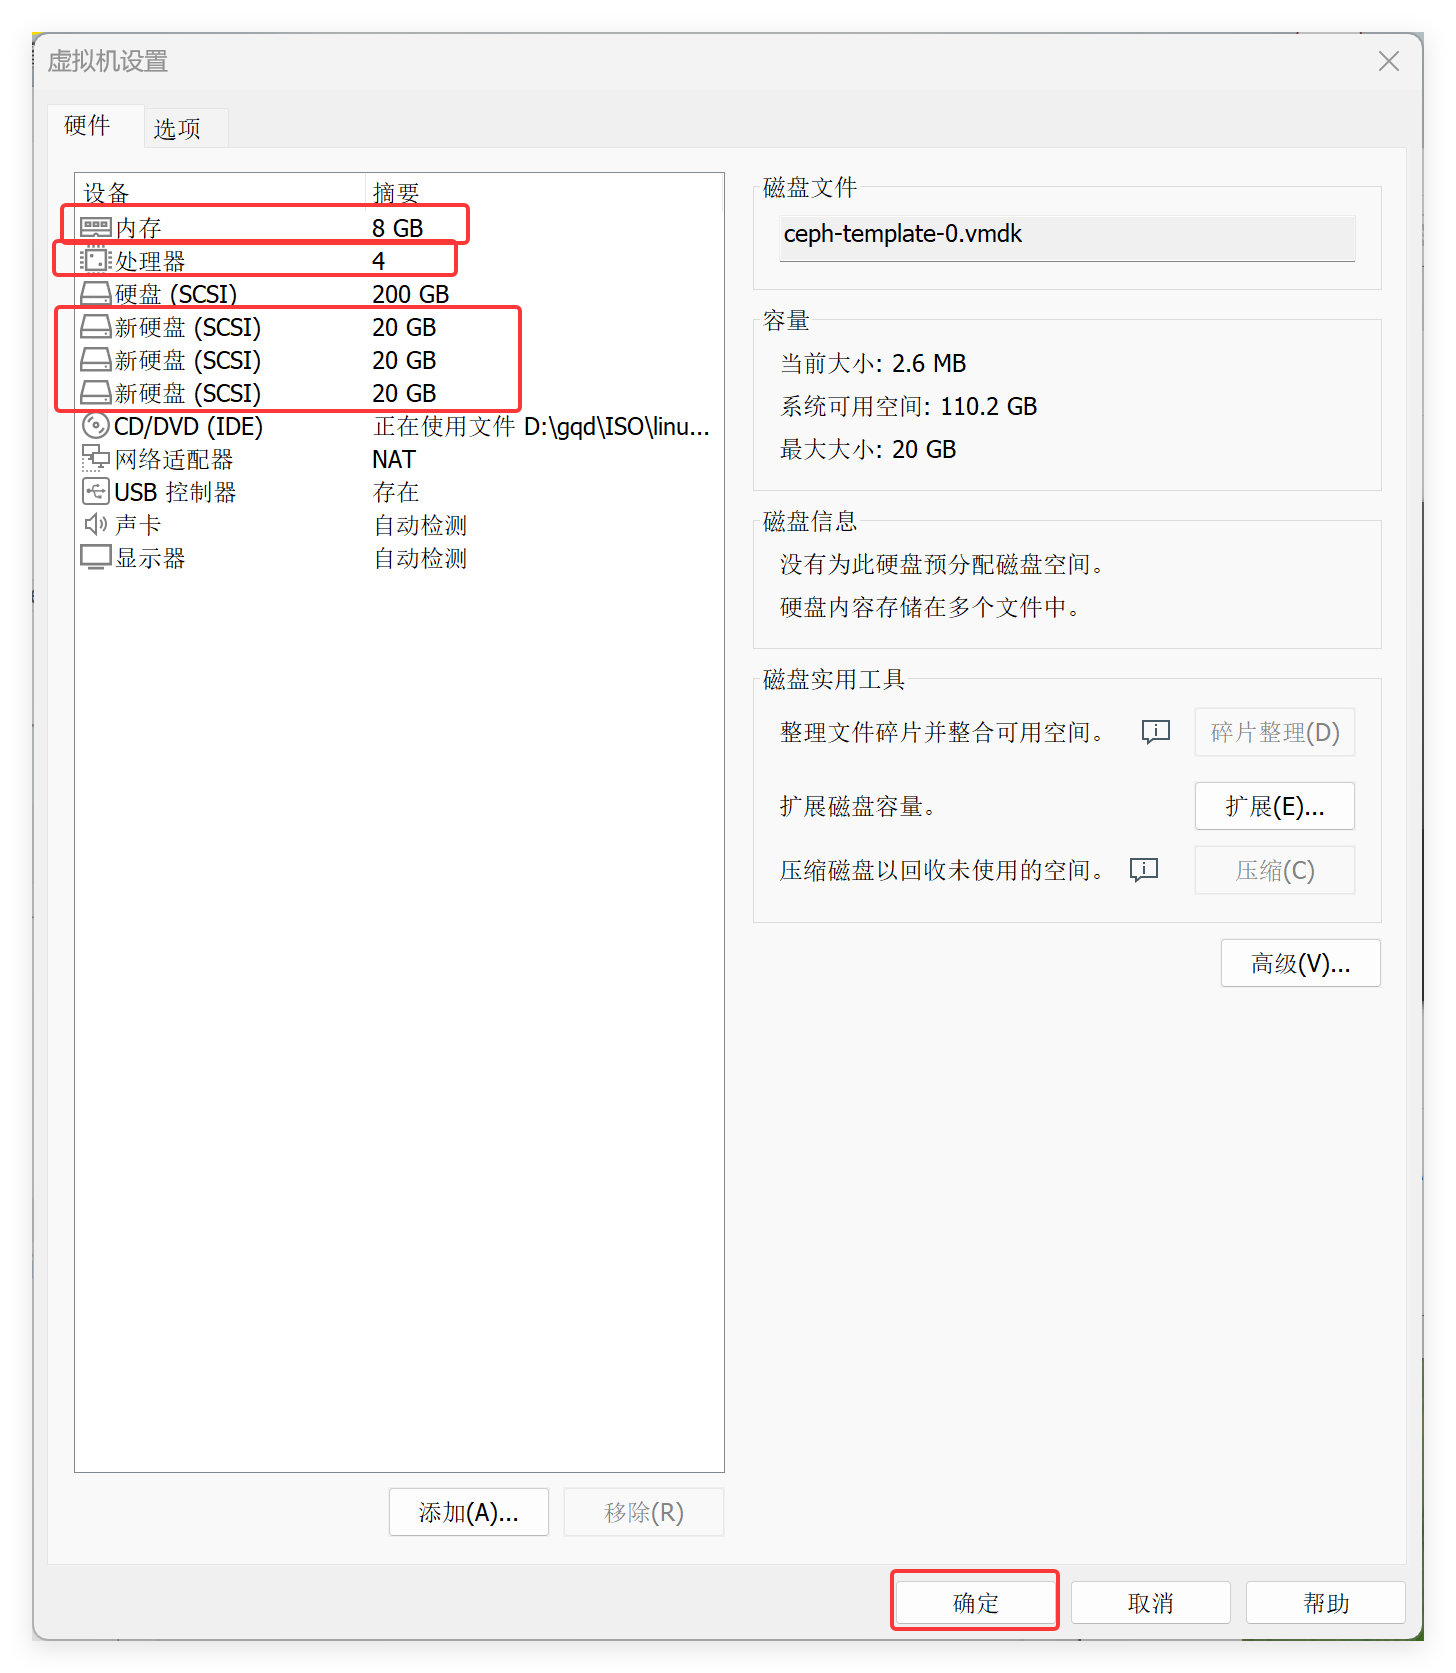
基于CentOS-Stream-8-template模板克隆出ceph-template
根据实验硬件要求,更改ceph-template硬件配置。
内存:8GB
处理器:4
添加3块20G SCSI新硬盘
bash
# 1 配置主机名解析
[root@localhost ~]# cat >> /etc/hosts << EOF

###### ceph ######
192.168.108.10 client.laogao.cloud client
192.168.108.11 ceph1.laogao.cloud ceph1
192.168.108.12 ceph2.laogao.cloud ceph2
192.168.108.13 ceph3.laogao.cloud ceph3
192.168.108.14 ceph4.laogao.cloud ceph4
192.168.108.15 ceph5.laogao.cloud ceph5
192.168.108.16 ceph6.laogao.cloud ceph6
EOF

# 2 关闭 SELinux
[root@localhost ~]# sed -ri 's/^SELINUX=.*/SELINUX=disabled/g' /etc/selinux/config

# 3 关闭防火墙
[root@localhost ~]# systemctl disable firewalld --now

# 4 配置yum仓库
[root@localhost ~]# cat << 'EOF' > /etc/yum.repos.d/ceph.repo
[Ceph]
name=Ceph
baseurl=https://mirrors.aliyun.com/centos-vault/8-stream/storage/x86_64/ceph-pacific
enabled=1
gpgcheck=0
EOF

# 5 安装基础软件包
[root@localhost ~]# dnf install -y bash-completion vim lrzsz unzip rsync sshpass tar

# 6 配置时间同步
[root@localhost ~]# dnf install -y chrony
[root@localhost ~]# systemctl enable chronyd --now

# 7 安装 cephadm
[root@localhost ~]# dnf install -y cephadm
[root@localhost ~]# cephadm --help
usage: cephadm [-h] [--image IMAGE] [--docker] [--data-dir DATA_DIR]
               [--log-dir LOG_DIR] [--logrotate-dir LOGROTATE_DIR]
               [--sysctl-dir SYSCTL_DIR] [--unit-dir UNIT_DIR] [--verbose]
               [--timeout TIMEOUT] [--retry RETRY] [--env ENV]
               [--no-container-init]
               {version,pull,inspect-image,ls,list-networks,adopt,rm-daemon,rm-cluster,run,shell,enter,ceph-volume,zap-osds,unit,logs,bootstrap,deploy,check-host,prepare-host,add-repo,rm-repo,install,registry-login,gather-facts,exporter,host-maintenance,disk-rescan}
               ...

Bootstrap Ceph daemons with systemd and containers.

positional arguments:
  {version,pull,inspect-image,ls,list-networks,adopt,rm-daemon,rm-cluster,run,shell,enter,ceph-volume,zap-osds,unit,logs,bootstrap,deploy,check-host,prepare-host,add-repo,rm-repo,install,registry-login,gather-facts,exporter,host-maintenance,disk-rescan}
                        sub-command
    version             get ceph version from container
    pull                pull the default container image
    inspect-image       inspect local container image
    ls                  list daemon instances on this host
......

# 安装 cephadm 的时候,会自动安装官方推荐的容器引擎 podman
[root@localhost ~]# rpm -q podman
podman-4.9.4-0.1.module_el8+971+3d3df00d.x86_64

# 8 提前下载镜像
[root@localhost ~]#
podman pull quay.io/ceph/ceph:v16
podman pull quay.io/ceph/ceph-grafana:8.3.5
podman pull quay.io/prometheus/node-exporter:v1.3.1
podman pull quay.io/prometheus/alertmanager:v0.23.0
podman pull quay.io/prometheus/prometheus:v2.33.4


#  准备配置主机脚本
[root@localhost ~]# cat > /usr/local/bin/sethost <<'EOF'
#!/bin/bash
hostnamectl set-hostname ceph$1.laogao.cloud
nmcli connection modify ens160 ipv4.method manual ipv4.addresses 192.168.108.1$1/24 ipv4.gateway 192.168.108.2 ipv4.dns 192.168.108.2
init 0
EOF

[root@localhost ~]# chmod +x /usr/local/bin/sethost
关机虚拟机,并打快照。
准备集群节点
使用完全克隆方式,克隆出其他虚拟机,并配置主机名和IP地址。
bash
#ceph1到ceph6按以下修改
[root@localhost ~]# sethost 1     #ceph1用1,ceph2到ceph6分别为2-6

#client使用CentOS-Stream-8-template克隆,做以下修改
[root@localhost ~]# hostnamectl set-hostname client.laogao.cloud
[root@localhost ~]# nmcli connection modify ens160 ipv4.method manual ipv4.addresses 192.168.108.10/24 ipv4.gateway 192.168.108.2 ipv4.dns 192.168.108.2
[root@localhost ~]#
Ceph 集群初始化
Ceph 初始化
bash
[root@ceph1 ~]# cephadm bootstrap --mon-ip 192.168.108.11 --allow-fqdn-hostname --initial-dashboard-user admin --initial-dashboard-password laogao@123 --dashboard-password-noupdate选项说明:
- --mon-ip 192.168.108.11,指定 monitor ip。
- --allow-fqdn-hostname,指定允许使用长名称。当主机名是长名称时,初始化时必须使用该参数。
- --initial-dashboard-user admin,指定 Web UI 登录的管理员账户。
- --initial-dashboard-password laogao@123,指定 Web UI 登录的管理员账户对应密码。
- --dashboard-password-noupdate,指定不要更新 Web UI 登录密码。
输出信息如下:
yaml
Verifying podman|docker is present...
Verifying lvm2 is present...
Verifying time synchronization is in place...
Unit chronyd.service is enabled and running
Repeating the final host check...
podman (/usr/bin/podman) version 4.9.4 is present
systemctl is present
lvcreate is present
Unit chronyd.service is enabled and running
Host looks OK
Cluster fsid: 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
Verifying IP 192.168.108.11 port 3300 ...
Verifying IP 192.168.108.11 port 6789 ...
Mon IP `192.168.108.11` is in CIDR network `192.168.108.0/24`
Mon IP `192.168.108.11` is in CIDR network `192.168.108.0/24`
Internal network (--cluster-network) has not been provided, OSD replication will default to the public_network
Pulling container image quay.io/ceph/ceph:v16...
Ceph version: ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)
Extracting ceph user uid/gid from container image...
Creating initial keys...
Creating initial monmap...
Creating mon...
Waiting for mon to start...
Waiting for mon...
mon is available
Assimilating anything we can from ceph.conf...
Generating new minimal ceph.conf...
Restarting the monitor...
Setting public_network to 192.168.108.0/24 in mon config section
Wrote config to /etc/ceph/ceph.conf
Wrote keyring to /etc/ceph/ceph.client.admin.keyring
Creating mgr...
Verifying port 9283 ...
Waiting for mgr to start...
Waiting for mgr...
mgr not available, waiting (1/15)...
mgr not available, waiting (2/15)...
mgr not available, waiting (3/15)...
mgr is available
Enabling cephadm module...
Waiting for the mgr to restart...
Waiting for mgr epoch 5...
mgr epoch 5 is available
Setting orchestrator backend to cephadm...
Generating ssh key...
Wrote public SSH key to /etc/ceph/ceph.pub
Adding key to root@localhost authorized_keys...
Adding host ceph1.laogao.cloud...
Deploying mon service with default placement...
Deploying mgr service with default placement...
Deploying crash service with default placement...
Deploying prometheus service with default placement...
Deploying grafana service with default placement...
Deploying node-exporter service with default placement...
Deploying alertmanager service with default placement...
Enabling the dashboard module...
Waiting for the mgr to restart...
Waiting for mgr epoch 9...
mgr epoch 9 is available
Generating a dashboard self-signed certificate...
Creating initial admin user...
Fetching dashboard port number...
Ceph Dashboard is now available at:

             URL: https://ceph1.laogao.cloud:8443/
            User: admin
        Password: laogao@123

Enabling client.admin keyring and conf on hosts with "admin" label
Enabling autotune for osd_memory_target
You can access the Ceph CLI as following in case of multi-cluster or non-default config:

        sudo /usr/sbin/cephadm shell --fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e -c /etc/ceph/ceph.conf -k /etc/ceph/ceph.client.admin.keyring

Or, if you are only running a single cluster on this host:

        sudo /usr/sbin/cephadm shell

Please consider enabling telemetry to help improve Ceph:

        ceph telemetry on

For more information see:

        https://docs.ceph.com/en/pacific/mgr/telemetry/

Bootstrap complete.
输出信息说明
Dashboard 登录信息
yaml
Ceph Dashboard is now available at:

             URL: https://ceph1.laogao.cloud:8443/
            User: admin
        Password: laogao@123
客户端访问方法
bash
Enabling client.admin keyring and conf on hosts with "admin" label
Enabling autotune for osd_memory_target
You can access the Ceph CLI as following in case of multi-cluster or non-default config:

        sudo /usr/sbin/cephadm shell --fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e -c /etc/ceph/ceph.conf -k /etc/ceph/ceph.client.admin.keyring

Or, if you are only running a single cluster on this host:

        sudo /usr/sbin/cephadm shell
启用遥测
发送匿名数据给社区,以改善Ceph。
yaml
Please consider enabling telemetry to help improve Ceph:

        ceph telemetry on
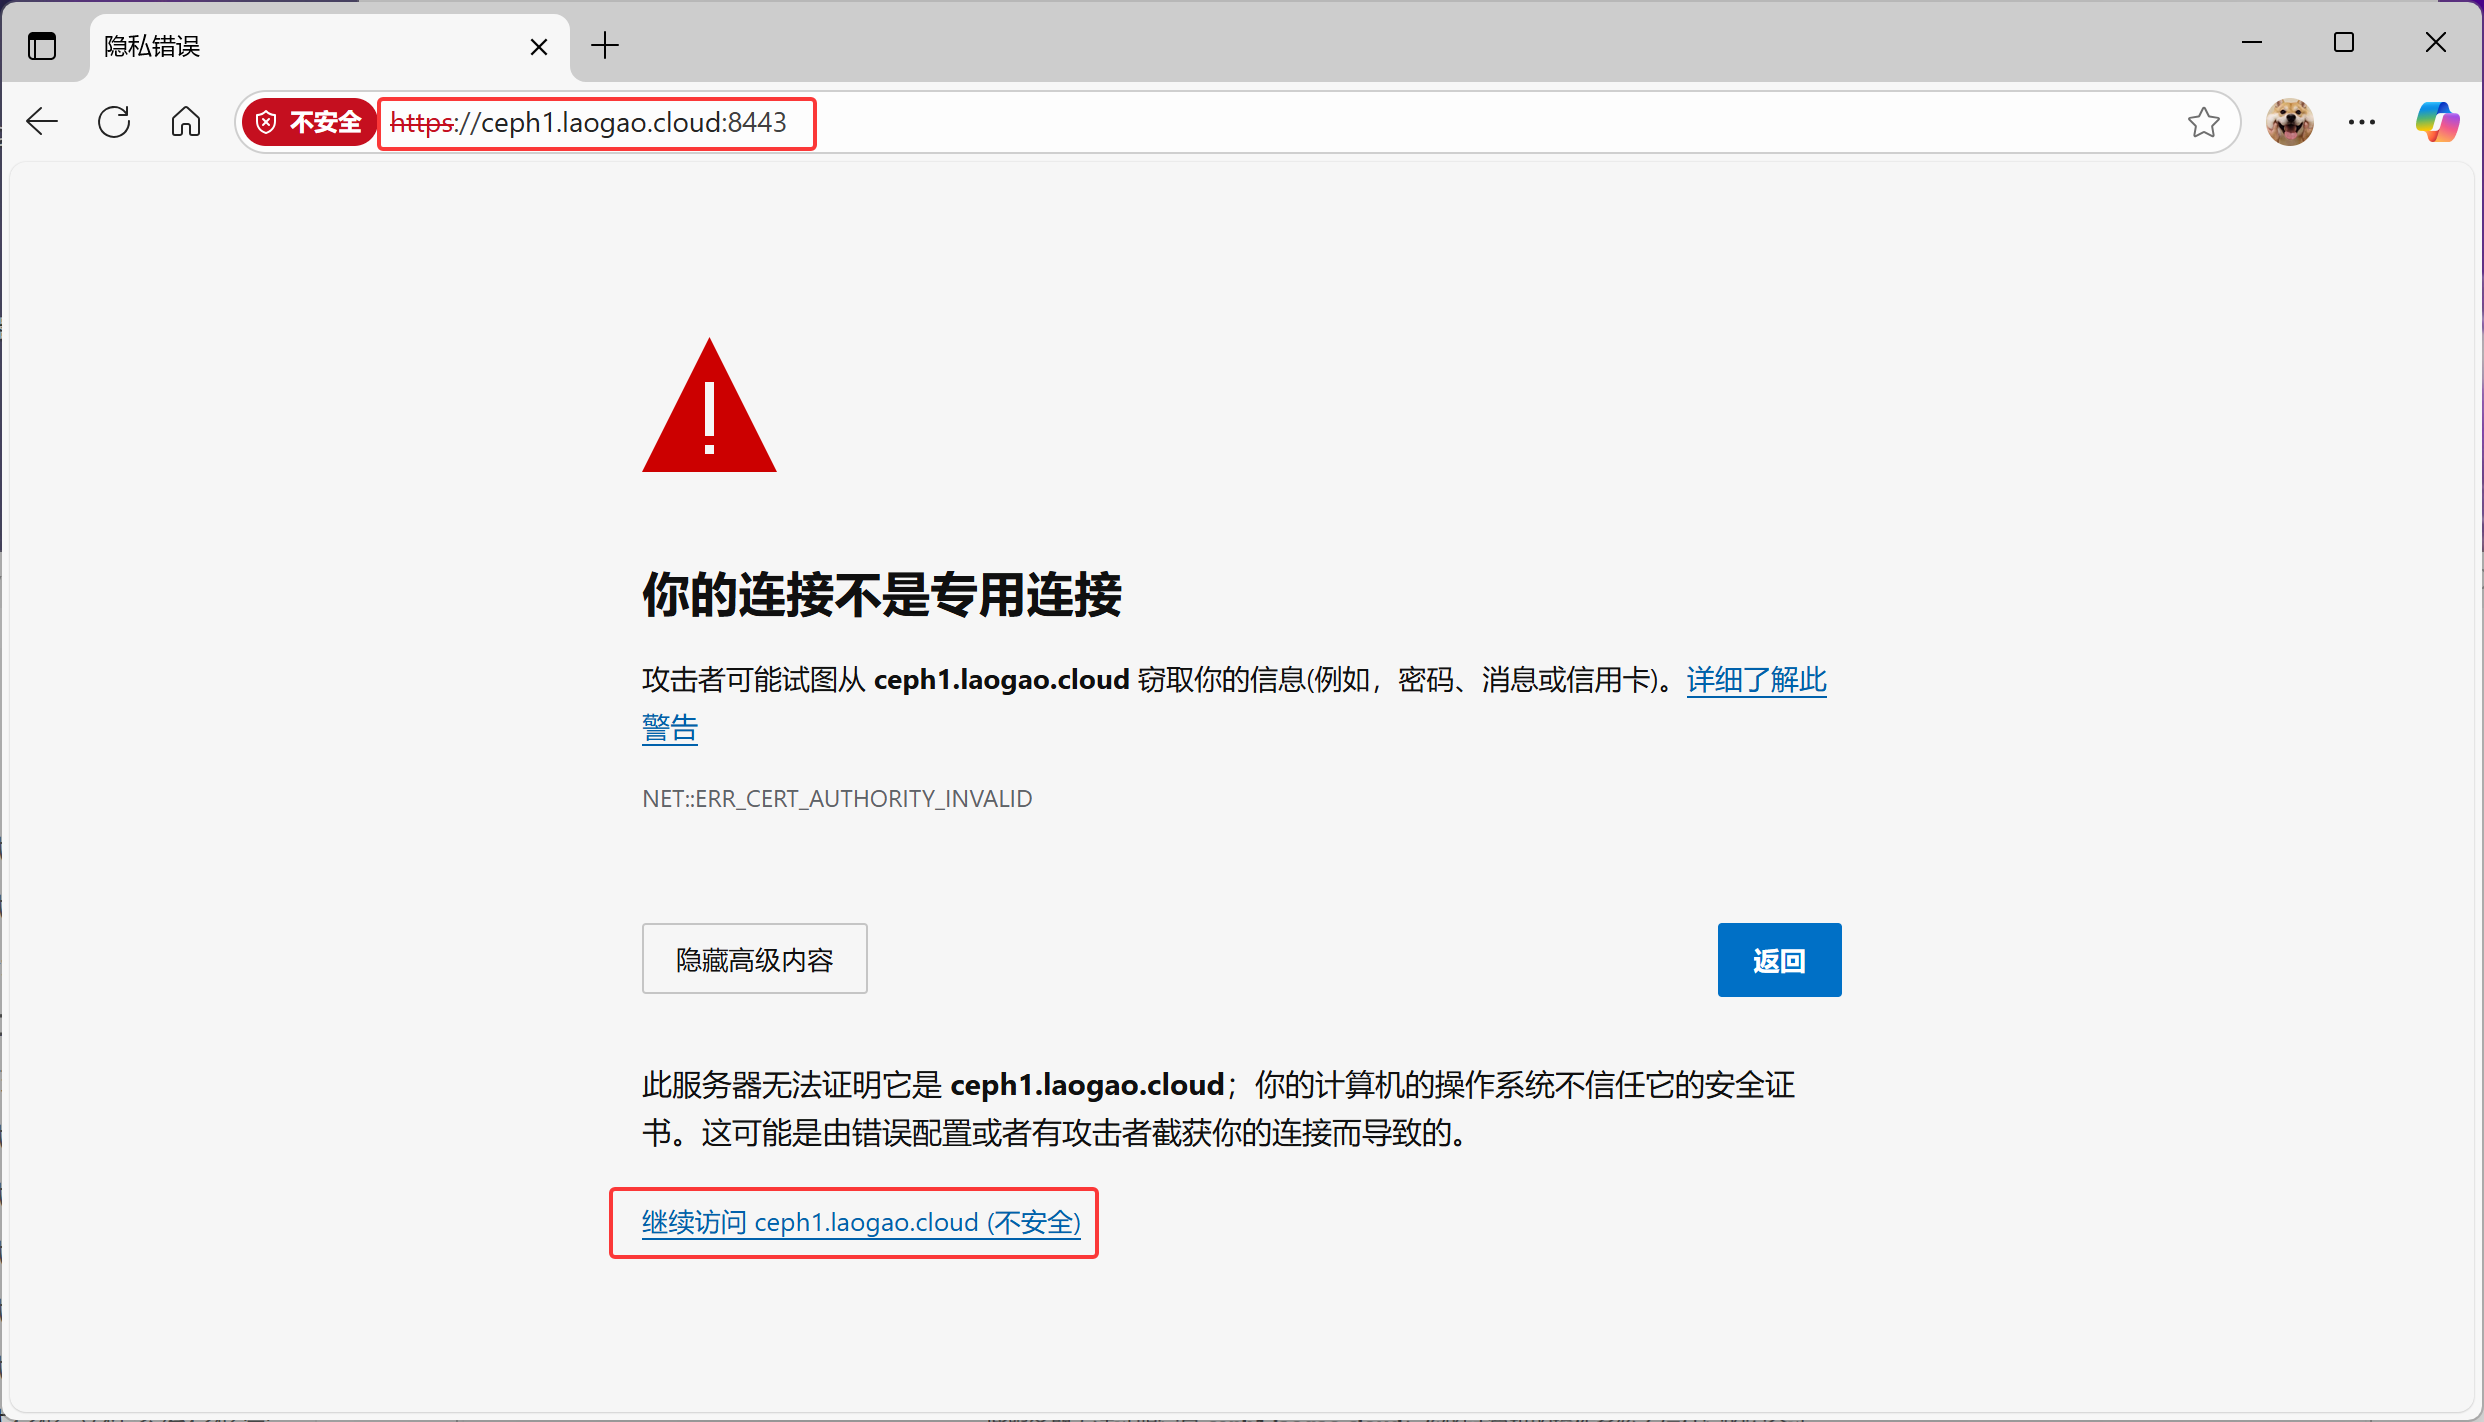
访问 dashboard
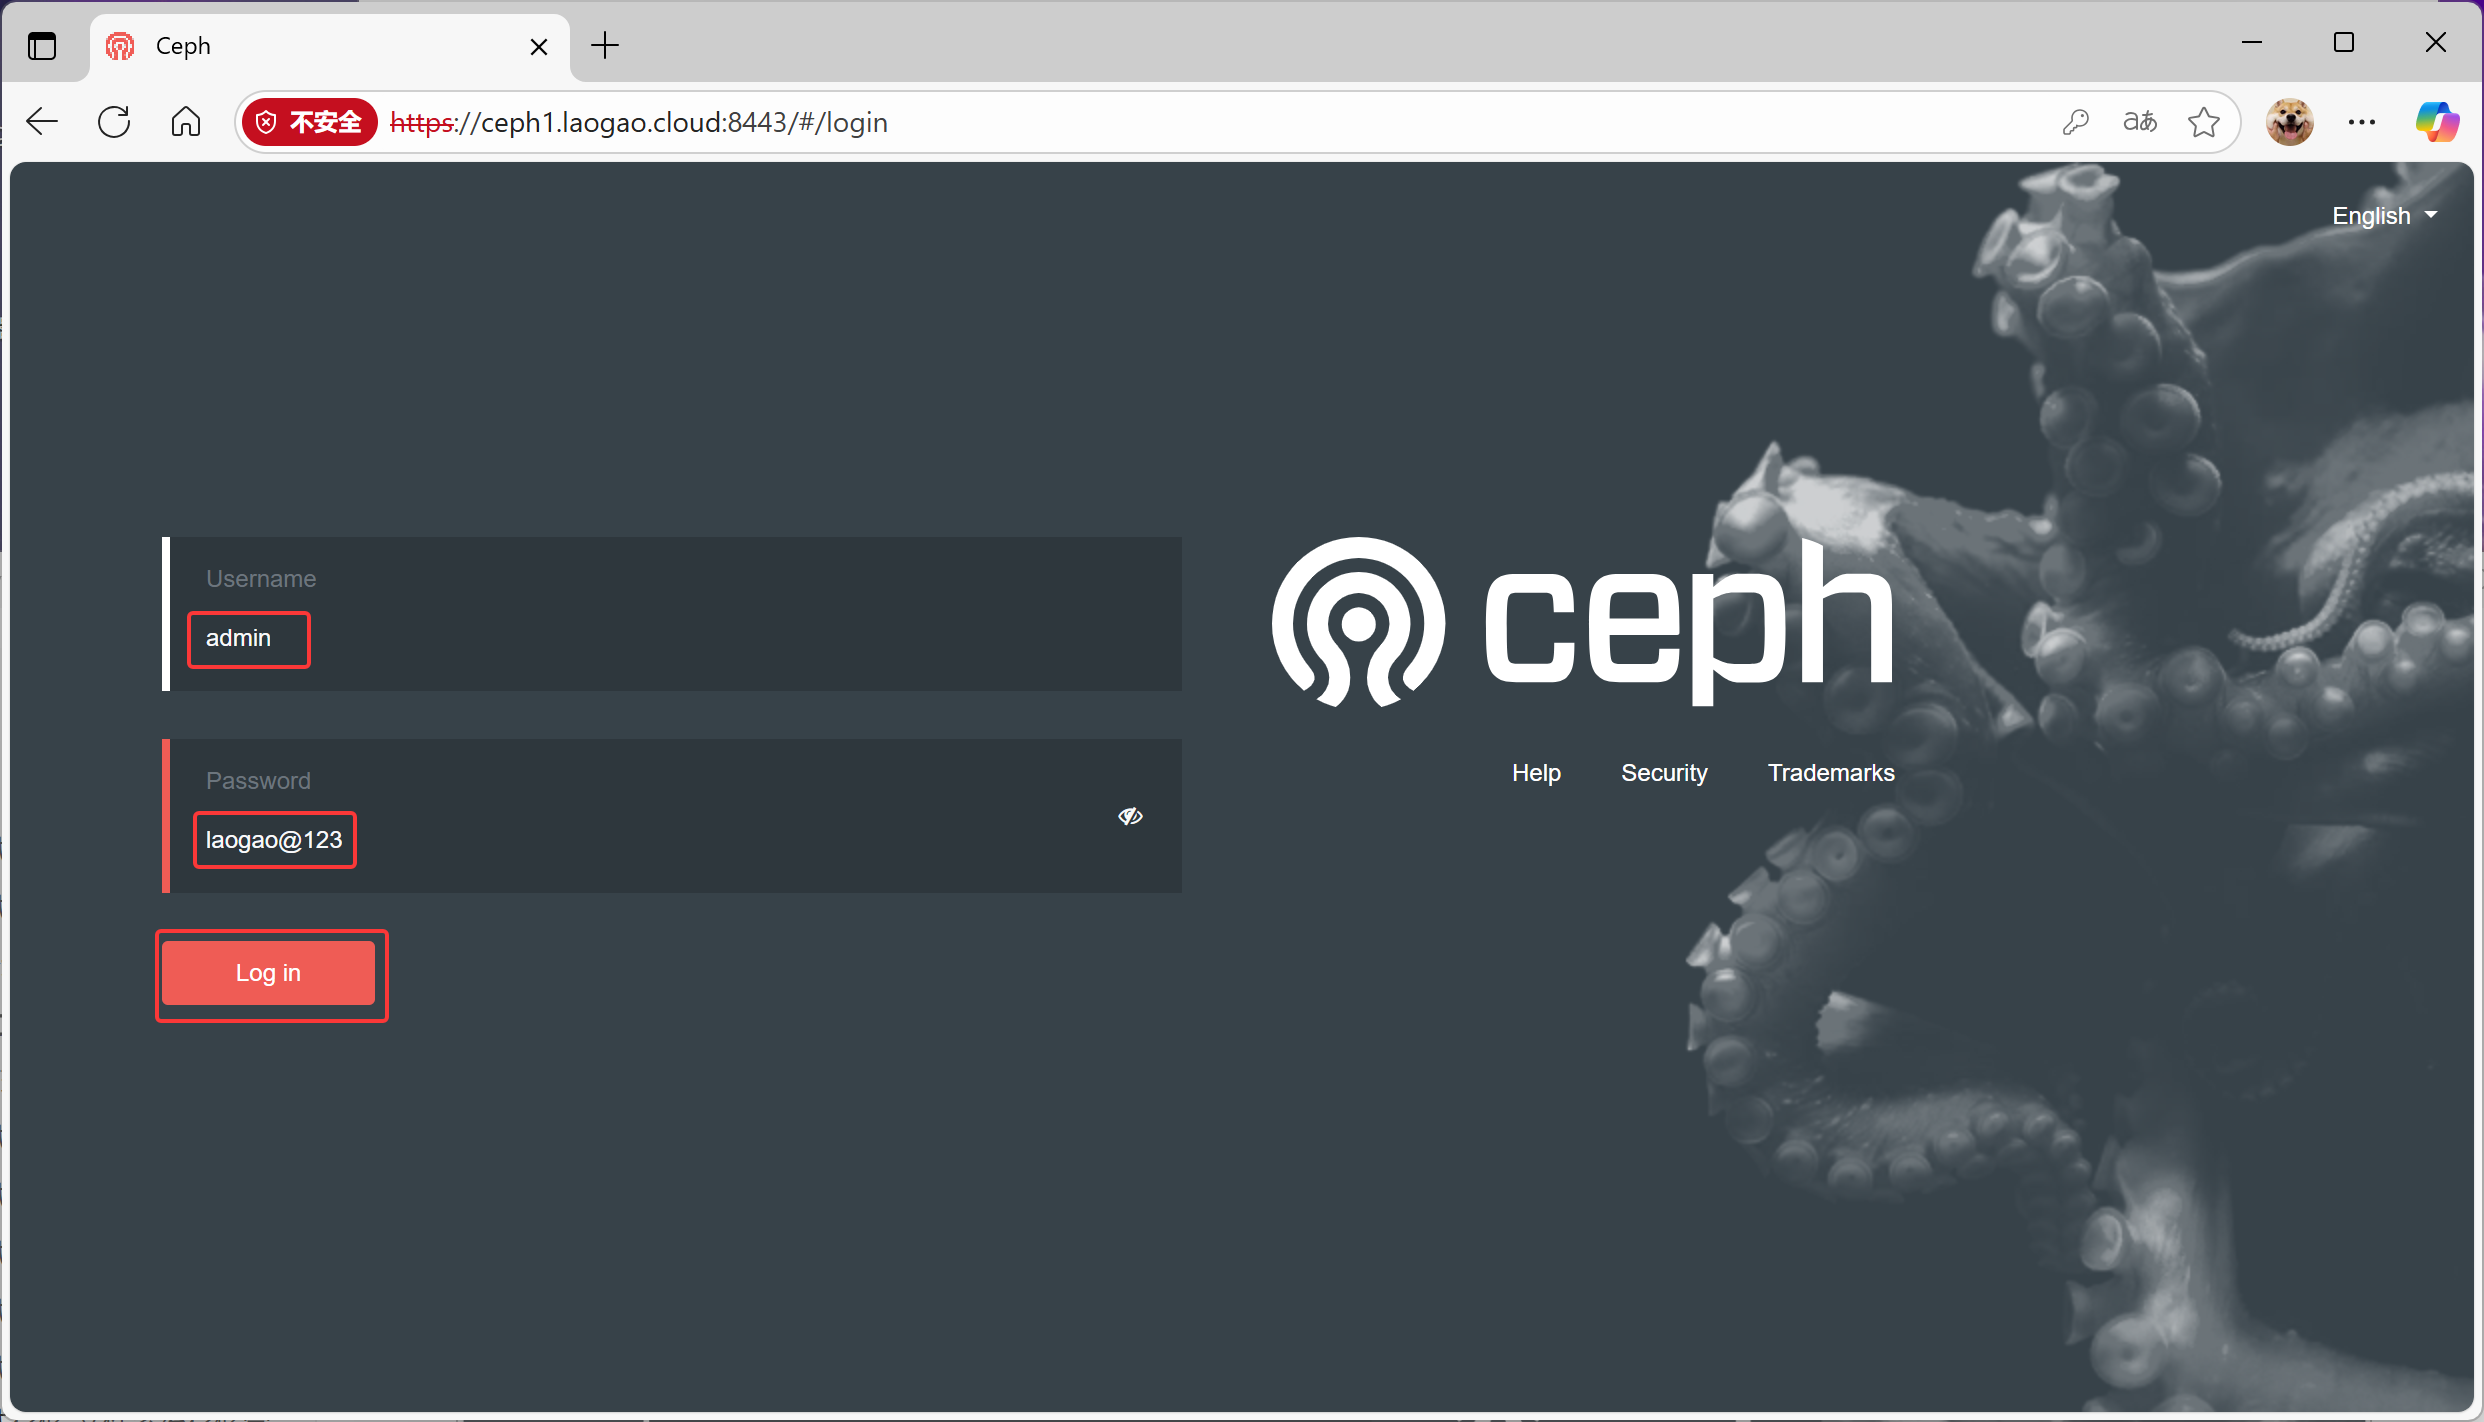
登录
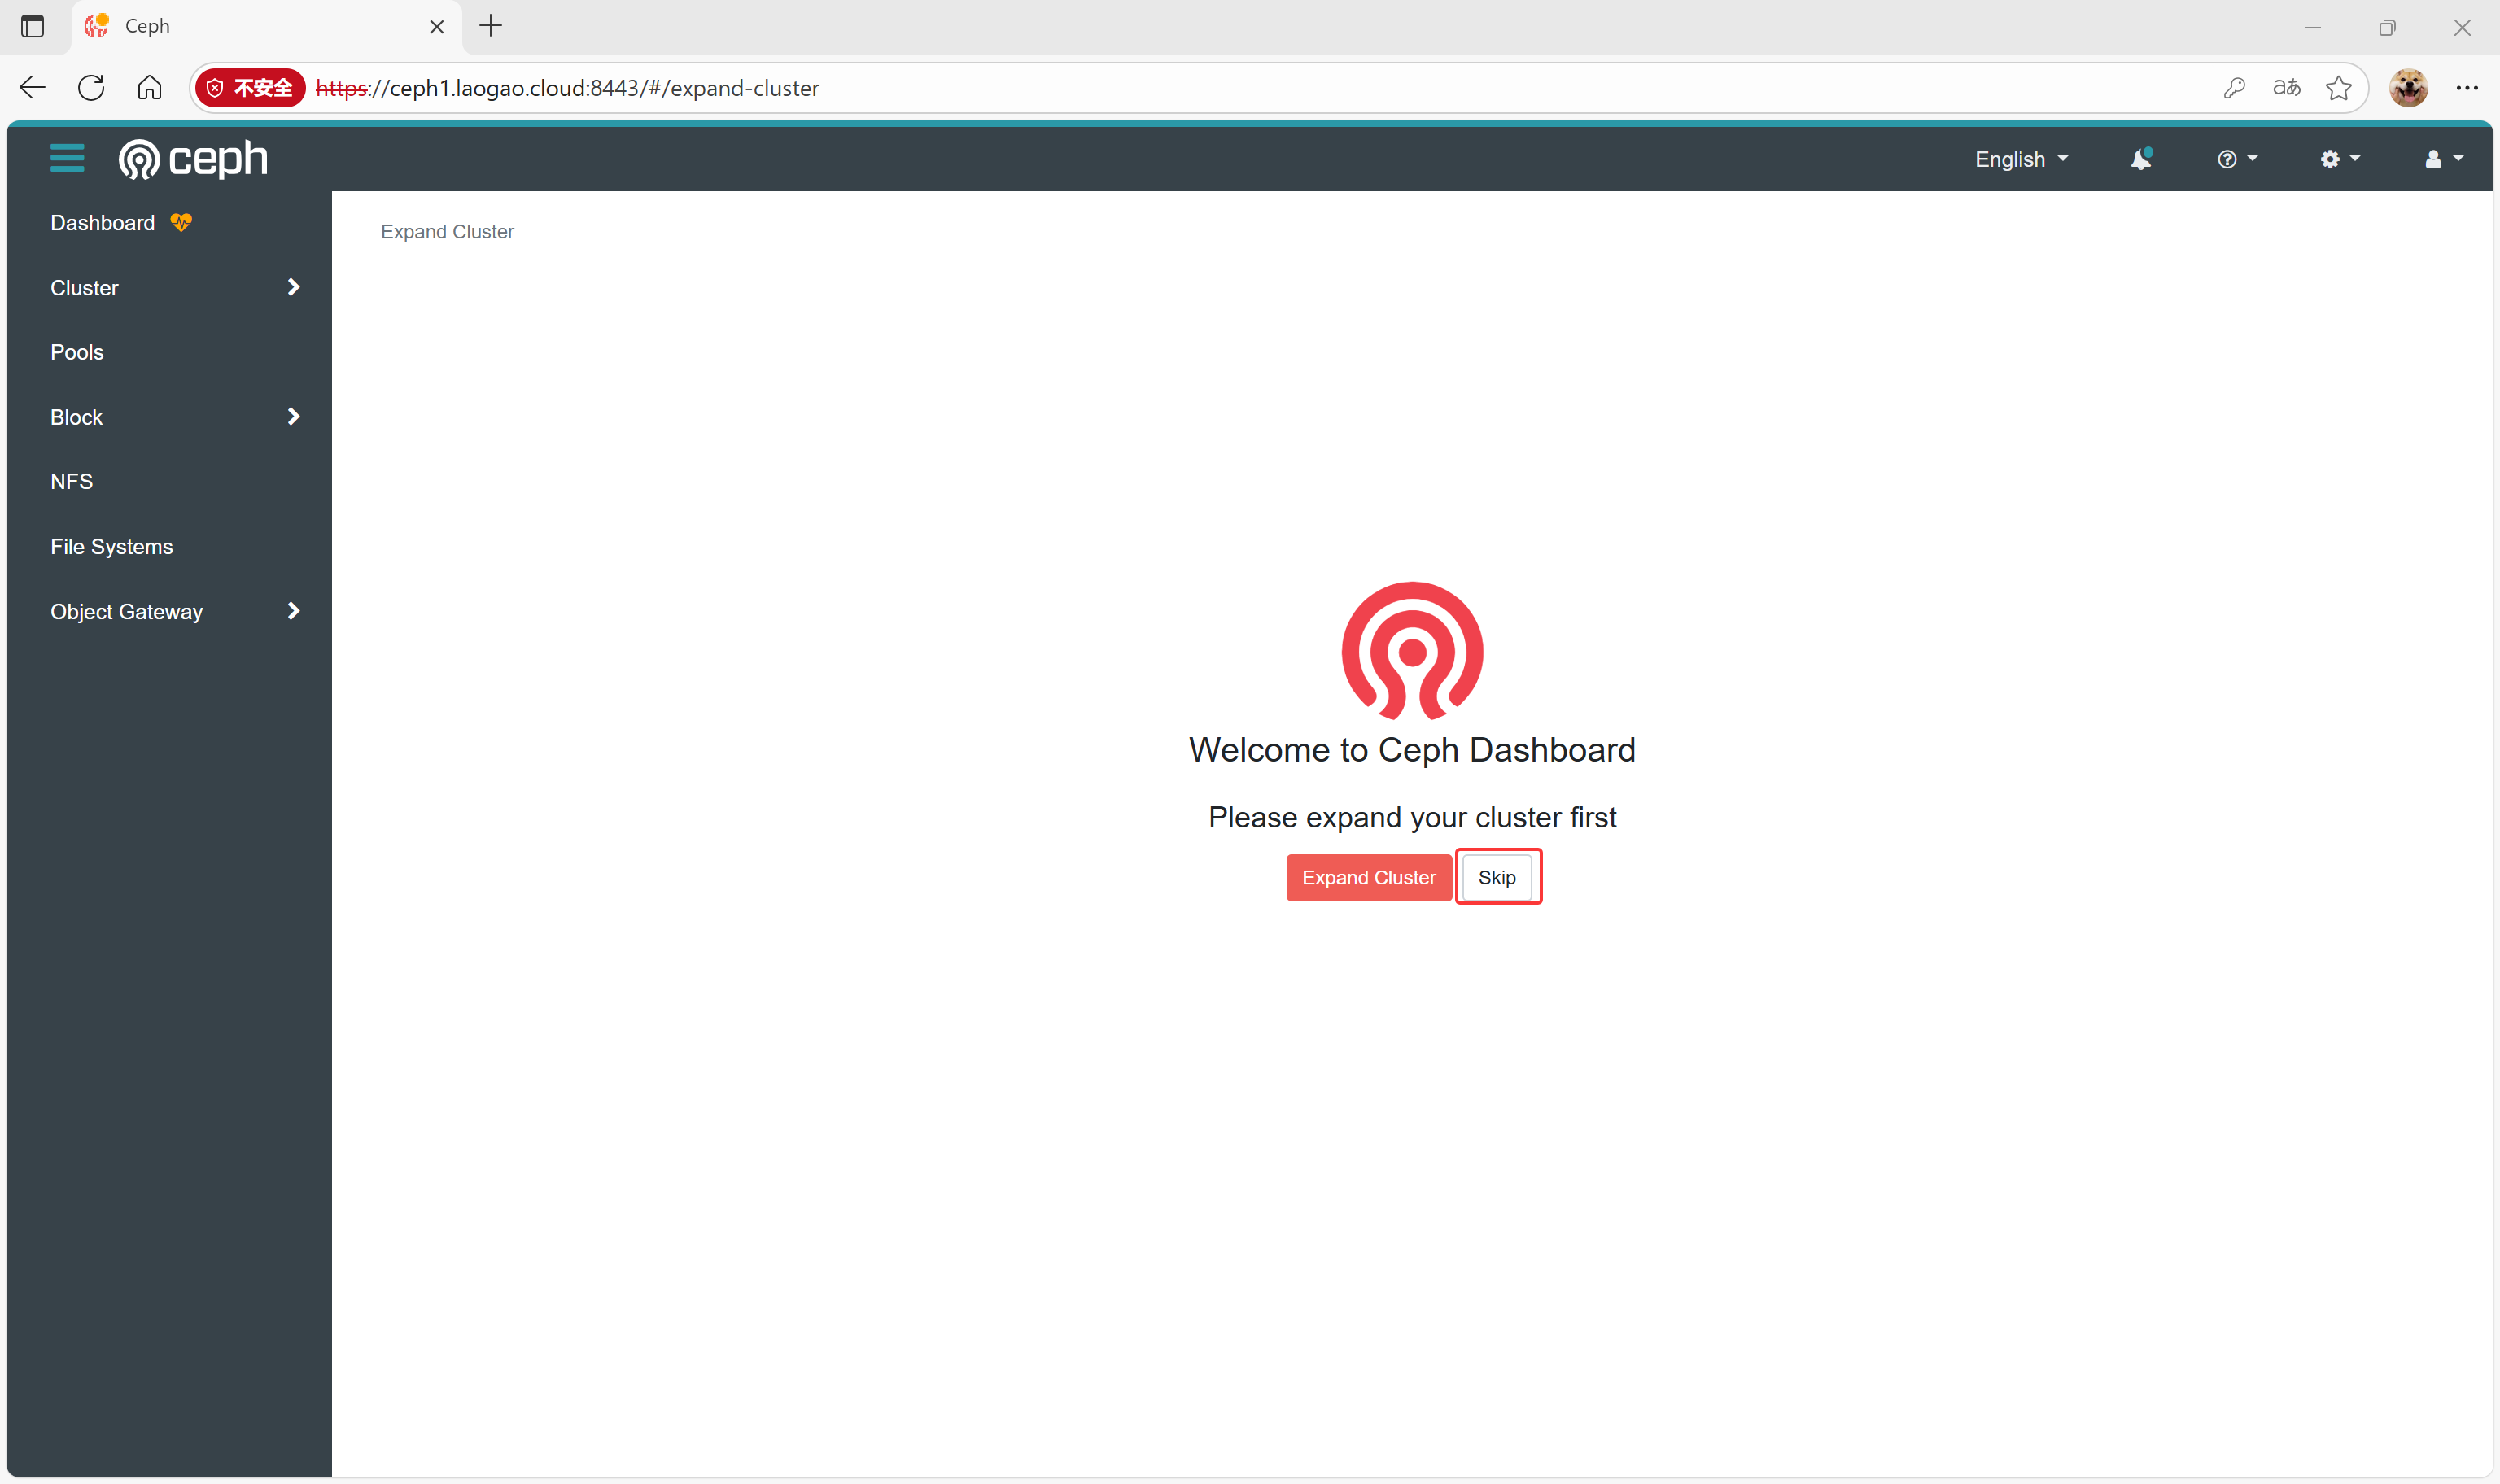
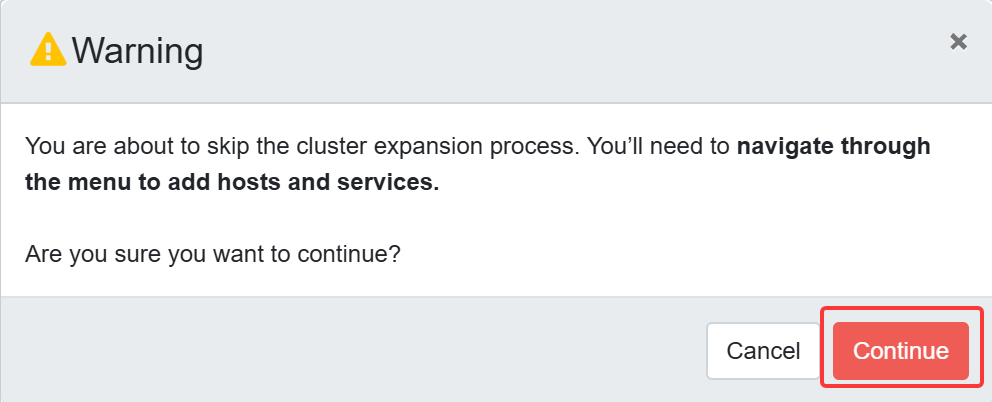
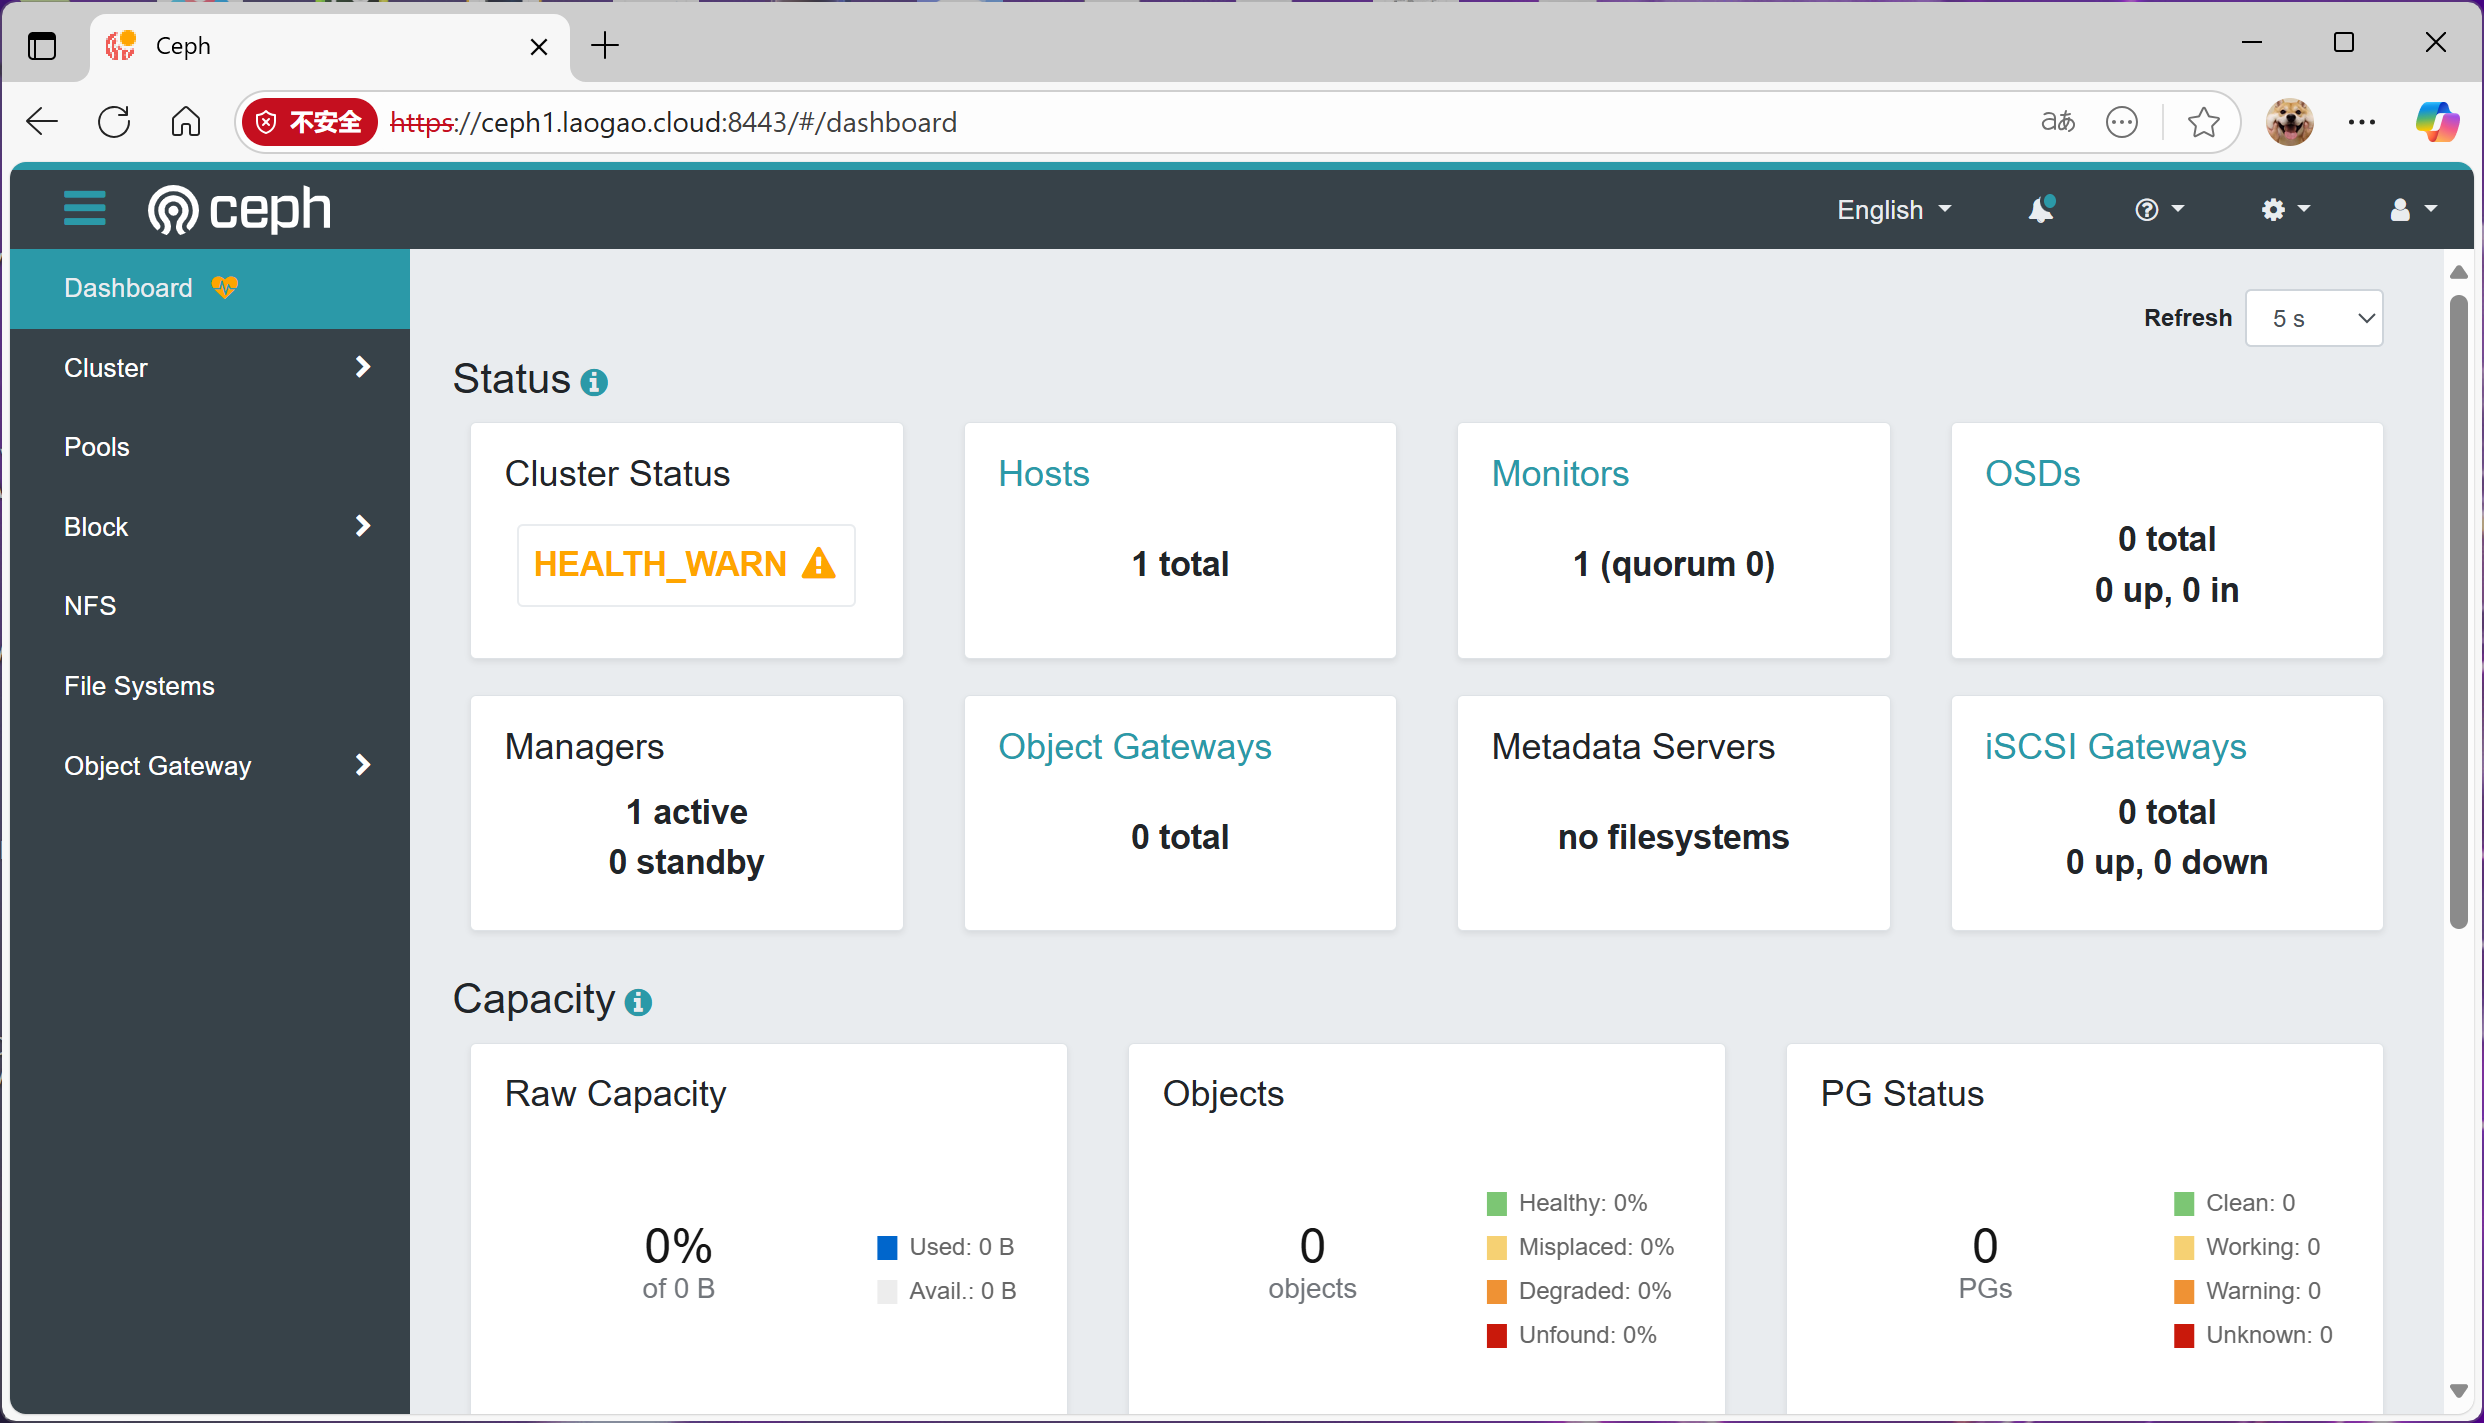
添加节点
添加节点过程:
- Ceph采用共享秘钥进行身份验证, 使用命令"ceph cephadm get-pub-key" 获取到主机接入集群时所需的ssh 公钥。
- 获取到公钥后, 使用该公钥实现对节点的免密ssh管理。
- 使用命令"ceph orch host add" 添加主机。
bash
# 为了配置方便,我们在ceph1上安装ceph客户端工具 ceph-common
[root@ceph1 ~]# dnf install -y ceph-common

# 获取集群公钥
[root@ceph1 ~]# ceph cephadm get-pub-key > ~/ceph.pub

# 推送公钥到其他节点
[root@ceph1 ~]# ssh-copy-id -f -i ~/ceph.pub root@ceph2.laogao.cloud
[root@ceph1 ~]# ssh-copy-id -f -i ~/ceph.pub root@ceph3.laogao.cloud

# 添加节点
[root@ceph1 ~]# ceph orch host add ceph2.laogao.cloud
Added host 'ceph2.laogao.cloud' with addr '192.168.108.12'
[root@ceph1 ~]# ceph orch host add ceph3.laogao.cloud
Added host 'ceph3.laogao.cloud' with addr '192.168.108.13'

[root@ceph1 ~]# ceph orch host ls
HOST                ADDR            LABELS  STATUS
ceph1.laogao.cloud  192.168.108.11  _admin
ceph2.laogao.cloud  192.168.108.12
ceph3.laogao.cloud  192.168.108.13
3 hosts in cluster

# 等待自动部署服务到其他节点,部署完成后效果如下:
[root@ceph1 ~]# ceph orch ls
NAME           PORTS        RUNNING  REFRESHED  AGE  PLACEMENT
alertmanager   ?:9093,9094      1/1  8m ago     9m   count:1
crash                           3/3  8m ago     9m   *
grafana        ?:3000           1/1  8m ago     9m   count:1
mgr                             2/2  8m ago     9m   count:2
mon                             3/5  8m ago     9m   count:5
node-exporter  ?:9100           3/3  8m ago     9m   *
prometheus     ?:9095           1/1  8m ago     9m   count:1
# crash 3/3个
# mgr 2/2个
# mon 3/5个
# node-exporter 3/3个
部署 mon 和 mgr
bash
# 禁用 mon 和 mgr 服务的自动扩展功能
[root@ceph1 ~]# ceph orch apply mon --unmanaged=true
[root@ceph1 ~]# ceph orch apply mgr --unmanaged=true
[root@ceph1 ~]# ceph orch ls
NAME           PORTS        RUNNING  REFRESHED  AGE  PLACEMENT
alertmanager   ?:9093,9094      1/1  56s ago    12m  count:1
crash                           3/3  57s ago    12m  *
grafana        ?:3000           1/1  56s ago    12m  count:1
mgr                             2/2  57s ago    3s   <unmanaged>
mon                             3/5  57s ago    8s   <unmanaged>
node-exporter  ?:9100           3/3  57s ago    12m  *
prometheus     ?:9095           1/1  56s ago    12m  count:1
# mon 和 mgr 的 PLACEMENT 状态为 <unmanaged>

# 配置主机标签,ceph2 和 ceph3 添加标签" _admin"
[root@ceph1 ~]# ceph orch host label add ceph2.laogao.cloud _admin
Added label _admin to host ceph2.laogao.cloud
[root@ceph1 ~]# ceph orch host label add ceph3.laogao.cloud _admin
Added label _admin to host ceph3.laogao.cloud
[root@ceph1 ~]# ceph orch host ls
HOST                ADDR            LABELS  STATUS
ceph1.laogao.cloud  192.168.108.11  _admin
ceph2.laogao.cloud  192.168.108.12  _admin
ceph3.laogao.cloud  192.168.108.13  _admin
3 hosts in cluster

# 将 mon 和 mgr 组件部署到具有_admin标签的节点上
[root@ceph1 ~]# ceph orch apply mon --placement="label:_admin"
Scheduled mon update...
[root@ceph1 ~]# ceph orch apply mgr --placement="label:_admin"
Scheduled mgr update...
#观察现象
[root@ceph1 ~]# ceph orch ls | egrep 'mon|mgr'
mgr                             3/3  2m ago     14s  label:_admin
mon                             3/3  2m ago     28s  label:_admin

[root@ceph1 ~]# ceph orch ps | egrep 'mon|mgr'
部署 OSD
bash
# 将所有主机上闲置的硬盘添加为 OSD
[root@ceph1 ~]# ceph orch apply osd --all-available-devices
Scheduled osd.all-available-devices update...
验证
查看集群中部署的服务
bash
[root@ceph1 ~]# ceph orch ls
NAME                       PORTS        RUNNING  REFRESHED  AGE  PLACEMENT
alertmanager               ?:9093,9094      1/1  3s ago     15m  count:1
crash                                       3/3  4s ago     15m  *
grafana                    ?:3000           1/1  3s ago     15m  count:1
mgr                                         3/3  4s ago     2m   label:_admin
mon                                         3/3  4s ago     2m   label:_admin
node-exporter              ?:9100           3/3  4s ago     15m  *
osd.all-available-devices                     9  4s ago     25s  *
prometheus                 ?:9095           1/1  3s ago     15m  count:1
部分输出说明:
- RUNNING:服务的运行状态,前一个数字表示当前运行的服务数量,后一个数字表示系统根据策略或配置推荐的服务部署数量。
- PLACEMENT :为服务编排器部署服务时提供的参数,编排器可根据该参数判断服务所部署的节点,常见的 placement 包括:
- 具体节点名称,例如:
--placement=ceph2 - 标签,例如:
--placement="label:mylabel" - 数量,例如:
--placement="3 host1 host2 host3" unmanaged,表示服务不自动部署。通过设置--unmanaged为true打开该功能,设置为false关闭该功能>
- 具体节点名称,例如:
查看集群状态
bash
[root@ceph1 ~]# ceph -s
  cluster:
    id:     2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
    health: HEALTH_OK

  services:
    mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 6m)
    mgr: ceph1.laogao.cloud.zoqmbt(active, since 15m), standbys: ceph2.oetbal, ceph3.npaxvt
    osd: 9 osds: 9 up (since 30s), 9 in (since 45s)

  data:
    pools:   1 pools, 1 pgs
    objects: 0 objects, 0 B
    usage:   2.6 GiB used, 177 GiB / 180 GiB avail
    pgs:     1 active+clean
命令
ceph -s对应的长命令为ceph --status。
输出包含:MON、 MGR及OSD的状态,包括数量、位置及运行时间。
集群的健康状态可分为:
- HEALTH_OK:表示健康状态良好
- HEALTH_WARN:表示集群存在告警,需进行排查处理后,可转为HEALTH_OK
- HEALTH_ERR:表示集群存在比较严重的错误,需要立即处理
查看集群 osd 结构
bash
[root@ceph1 ~]# ceph osd tree
ID  CLASS  WEIGHT   TYPE NAME       STATUS  REWEIGHT  PRI-AFF
-1         0.17537  root default
-3         0.05846      host ceph1
 0    hdd  0.01949          osd.0       up   1.00000  1.00000
 3    hdd  0.01949          osd.3       up   1.00000  1.00000
 6    hdd  0.01949          osd.6       up   1.00000  1.00000
-5         0.05846      host ceph2
 2    hdd  0.01949          osd.2       up   1.00000  1.00000
 4    hdd  0.01949          osd.4       up   1.00000  1.00000
 7    hdd  0.01949          osd.7       up   1.00000  1.00000
-7         0.05846      host ceph3
 1    hdd  0.01949          osd.1       up   1.00000  1.00000
 5    hdd  0.01949          osd.5       up   1.00000  1.00000
 8    hdd  0.01949          osd.8       up   1.00000  1.00000
查看集群组件
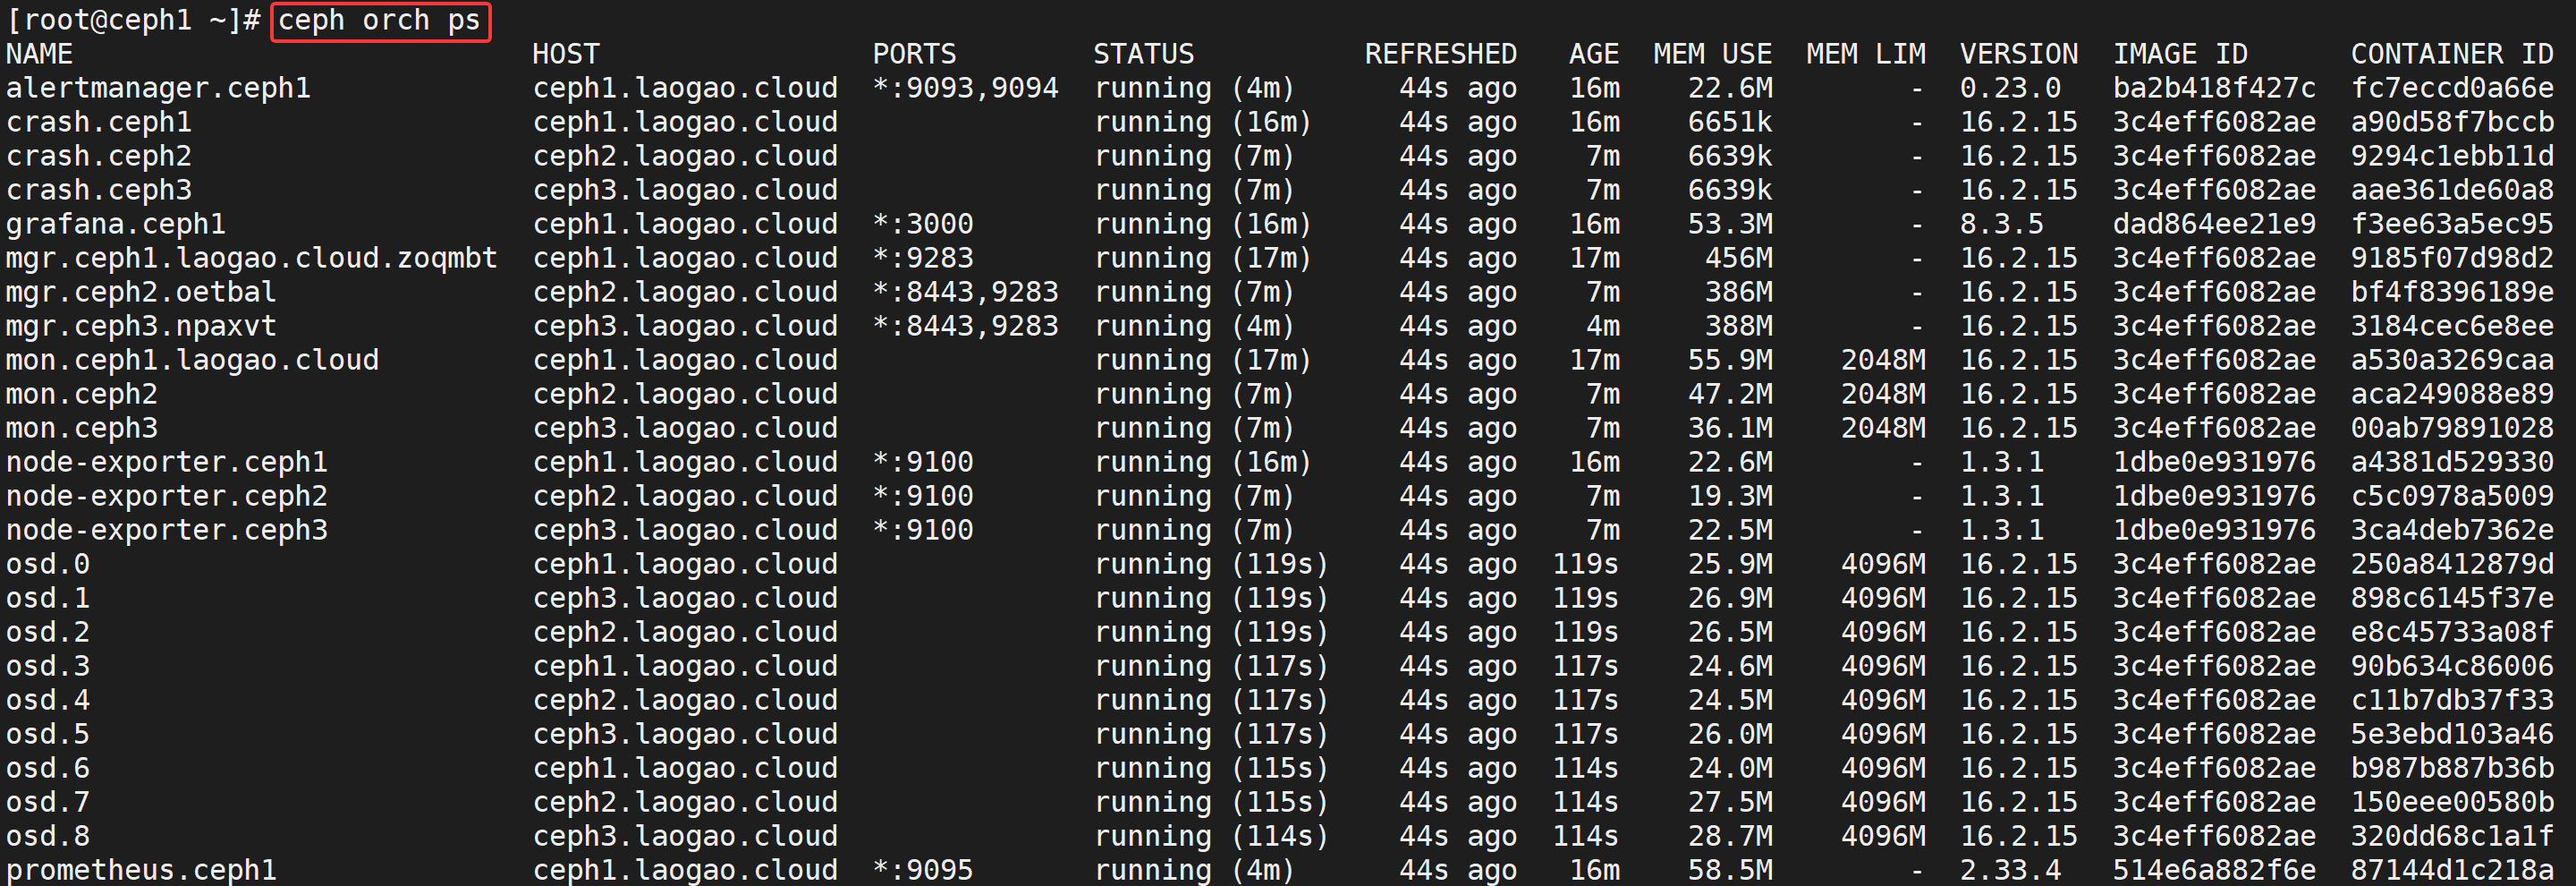
集群中运行的主要组件:
- mgr,ceph 管理程序
- monitor,ceph 监视器
- osd,ceph 对象存储进程
- rgw,ceph 对象存储网关
其他组件:
- crash,崩溃数据收集模块
- prometheus,监控组件
- grafana,监控数据展示dashboard
- alertmanager,prometheus告警组件
- node_exporter,prometheus节点数据收集组件
查询出服务的具体情况后, 可对指定服务进一步操作:
- 使用命令
ceph orch daemon start|stop|restart|redeploy|reconfig <service_name>对指定服务进行启动、停止、重启等操作。 - 使用命令
ceph orch daemon rm <service_name> [--force]可删除指定服务。
!TIP
这时关闭所有ceph存储节点。并打快照,便于后续做实验。
Ceph 集群组件管理
ceph orch 命令
ceph orch 命令与编排器模块交互,编排器模块是ceph-mgr的插件,与外部编排服务交互。
ceph orch 命令支持多个外部编排器:
- host:物理节点
- service type:服务类型,如nfs, mds, osd, mon, rgw, mgr, iscsi
- Service:逻辑服务
- Daemon:进程
cephadm使用的特殊标签:
- _no_schedule:不在此类标签的节点上部署或调度任何服务。
- _no_autotune_memory:不对此类标签的节点进行内存调优。
- _admin:自动将ceph.conf和ceph.client.admin.keyring发送到此类标签的节点上。
禁用服务自动扩展
Ceph 集群服务自动扩展功能,会自动部署ceph组件到存储节点。如果想手动管理 ceph 服务,则需要禁用 ceph 服务自动扩展功能。
bash
# 查看 mon 服务
[root@ceph1 ~]# ceph orch ls mon
NAME  PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
mon              3/3  90s ago    8m   label:_admin

# 禁用 mon 服务自动扩展
[root@ceph1 ~]# ceph orch apply mon --unmanaged=true
[root@ceph1 ~]# ceph orch ls mon
NAME  PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
mon              3/5  118s ago   4s   <unmanaged>

# 启用 mon 服务自动扩展
[root@ceph1 ~]# ceph orch apply mon --unmanaged=false
[root@ceph1 ~]# ceph orch ls mon
NAME  PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
mon              3/5  2m ago     4s   count:5

# 通过标签部署 mon 服务
[root@ceph1 ~]# ceph orch apply mon --placement="label:_admin"
Scheduled mon update...
[root@ceph1 ~]# ceph orch ls mon
NAME  PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
mon              3/3  3m ago     15s  label:_admin
删除服务
以 crash 服务为例。
bash
# 禁用服务自动扩展
[root@ceph1 ~]# ceph orch apply crash --unmanaged=true
[root@ceph1 ~]# ceph orch ls crash
NAME   PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
crash             3/3  3m ago     5s   <unmanaged>

# 查看服务中实例
[root@ceph1 ~]# ceph orch ps | grep crash
crash.ceph1   ceph1.laogao.cloud   running (5m)   4m ago  24m 6639k   -  16.2.15  3c4eff6082ae  5aea4634442b
crash.ceph2   ceph2.laogao.cloud   running (5m)   4m ago  15m 6639k   -  16.2.15  3c4eff6082ae  51d5f1e1d75c
crash.ceph3   ceph3.laogao.cloud   running (4m)   4m ago  15m 6647k   -  16.2.15  3c4eff6082ae  406b2a7b9d93

# 删除特定实例
[root@ceph1 ~]# ceph orch daemon rm crash.ceph1
Removed crash.ceph1 from host 'ceph1.laogao.cloud'
[root@ceph1 ~]# ceph orch ps | grep crash
crash.ceph2   ceph2.laogao.cloud   running (9m)   8m ago  19m 6639k   -  16.2.15  3c4eff6082ae  51d5f1e1d75c
crash.ceph3   ceph3.laogao.cloud   running (8m)   8m ago  19m 6647k   -  16.2.15  3c4eff6082ae  406b2a7b9d93

# 删除服务
[root@ceph1 ~]# ceph orch rm crash
Removed service crash
[root@ceph1 ~]# ceph orch ls crash                  #这里需要快点查看
NAME   PORTS  RUNNING  REFRESHED   AGE  PLACEMENT
crash             1/3  <deleting>  50s  <unmanaged>
[root@ceph1 ~]# ceph orch ls crash
No services reported
部署服务
使用 ceph 的编排器部署服务, 有两种方式:
-
apply 方式:定义了服务状态,由编排器根据参数自动寻找合适的节点进行服务部署。
语法:
ceph orch apply <service_type> [--placement=<placement_string>] [--unmanaged]例如:
ceph orch apply crash和ceph orch apply mon --placement="label:_admin"。 -
daemon add 方式:根据命令中的参数,直接进行服务部署。
语法:
ceph orch daemon add <daemon_type> <placement>
命令orch apply osd [--all-available-devices]将节点上的所有可用设备配置为OSD。
bash
[root@ceph1 ~]# ceph orch apply crash
Scheduled crash update...

# 刚删除的服务,又部署回来了
[root@ceph1 ~]# ceph orch ls
NAME                       PORTS        RUNNING  REFRESHED  AGE  PLACEMENT
alertmanager               ?:9093,9094      1/1  2m ago     18h  count:1
crash                                       3/3  2m ago     2m   *
删除 OSD
确定 OSD 和设备关系
bash
[root@ceph1 ~]# ceph osd tree
ID  CLASS  WEIGHT   TYPE NAME       STATUS  REWEIGHT  PRI-AFF
-1         0.17537  root default
-3         0.05846      host ceph1                                       #主机ceph1下的硬盘
 0    hdd  0.01949          osd.0       up   1.00000  1.00000            #看不出来osd.0对应哪块磁盘
 3    hdd  0.01949          osd.3       up   1.00000  1.00000
 6    hdd  0.01949          osd.6       up   1.00000  1.00000
-5         0.05846      host ceph2
 2    hdd  0.01949          osd.2       up   1.00000  1.00000
 4    hdd  0.01949          osd.4       up   1.00000  1.00000
 7    hdd  0.01949          osd.7       up   1.00000  1.00000
-7         0.05846      host ceph3
 1    hdd  0.01949          osd.1       up   1.00000  1.00000
 5    hdd  0.01949          osd.5       up   1.00000  1.00000
 8    hdd  0.01949          osd.8       up   1.00000  1.00000

# 获取集群id
[root@ceph1 ~]# ceph -s | grep id
    id:     2faf683a-7cbf-11f0-b5ba-000c29e0ad0e

# 登录到ceph1上确认osd.0使用的块设备
[root@ceph1 ~]# ls -l /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/osd.0/block
lrwxrwxrwx 1 ceph ceph 93 Aug 19 14:01 /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/osd.0/block -> /dev/ceph-c92942fb-f959-4255-b8e6-751fab70fa79/osd-block-2ed79b2f-d825-4829-b4b0-59879d2ad99c

# 59879d2ad99c是块设备名称最后一串字符
[root@ceph1 ~]# lsblk | grep -B1 59879d2ad99c
sdb                                                                                8:16   0    20G  0 disk
└─ceph--c92942fb--f959--4255--b8e6--751fab70fa79-osd--block--2ed79b2f--d825--4829--b4b0--59879d2ad99c 253:4    0    20G  0 lvm
# 确认osd.0对应sdb

# 用下面命令也可以
[root@ceph1 ~]# ceph osd metadata 0           #0是osd编号
[root@ceph1 ~]# ceph osd metadata 0
{
    "id": 0,
    "arch": "x86_64",
    "back_addr": "[v2:192.168.108.11:6802/914648970,v1:192.168.108.11:6803/914648970]",
    "back_iface": "",
    "bluefs": "1",
    "bluefs_dedicated_db": "0",
    "bluefs_dedicated_wal": "0",
    "bluefs_single_shared_device": "1",
    "bluestore_bdev_access_mode": "blk",
    "bluestore_bdev_block_size": "4096",
    "bluestore_bdev_dev_node": "/dev/dm-2",
    "bluestore_bdev_devices": "sdb",                   看这里`
    "bluestore_bdev_driver": "KernelDevice",
    "bluestore_bdev_partition_path": "/dev/dm-2",
    "bluestore_bdev_rotational": "1",
    "bluestore_bdev_size": "21470642176",
    "bluestore_bdev_support_discard": "0",
    "bluestore_bdev_type": "hdd",
    "bluestore_min_alloc_size": "4096",
    "ceph_release": "pacific",
    "ceph_version": "ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)",
    "ceph_version_short": "16.2.15",
    "ceph_version_when_created": "ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)",
    "container_hostname": "ceph1.laogao.cloud",
    "container_image": "quay.io/ceph/ceph@sha256:6ba107eb55617994a9e6ed49fb938828c2ed3121aa19ceeffbf8e28608535d94",
    "cpu": "Intel(R) Core(TM) Ultra 9 185H",
    "created_at": "2026-03-27T06:01:45.491319Z",
    "default_device_class": "hdd",
    "device_ids": "",
    "device_paths": "sdb=/dev/disk/by-path/pci-0000:00:10.0-scsi-0:0:1:0",
    "devices": "sdb",
    "distro": "centos",
    "distro_description": "CentOS Stream 8",
    "distro_version": "8",
    "front_addr": "[v2:192.168.108.11:6800/914648970,v1:192.168.108.11:6801/914648970]",
    "front_iface": "",
    "hb_back_addr": "[v2:192.168.108.11:6806/914648970,v1:192.168.108.11:6807/914648970]",
    "hb_front_addr": "[v2:192.168.108.11:6804/914648970,v1:192.168.108.11:6805/914648970]",
    "hostname": "ceph1.laogao.cloud",
    "journal_rotational": "1",
    "kernel_description": "#1 SMP Thu May 30 04:13:58 UTC 2024",
    "kernel_version": "4.18.0-553.6.1.el8.x86_64",
    "mem_swap_kb": "8245244",
    "mem_total_kb": "7849664",
    "network_numa_unknown_ifaces": "back_iface,front_iface",
    "objectstore_numa_unknown_devices": "sdb",
    "os": "Linux",
    "osd_data": "/var/lib/ceph/osd/ceph-0",
    "osd_objectstore": "bluestore",
    "osdspec_affinity": "all-available-devices",
    "rotational": "1"
}
脚本实现
bash[root@ceph1 ~]# vim /usr/local/bin/show-osd-device
bash#!/bin/bash # author laogao # date 2025-08-19 # Description 确认 osd 和 device 之间对应关系 # usage 在ceph node 上执行 cluster_id=$(ceph -s|grep id |awk '{print $2}') cd /var/lib/ceph/${cluster_id} for osd in osd.* do device_id=$(ls -l $osd/block | awk -F '-' '{print $NF}') device=/dev/$(lsblk |grep -B1 ${device_id} |grep -v ${device_id} | awk '{print $1}') echo $osd : $device done
bash[root@ceph1 ~]# chmod +x /usr/local/bin/show-osd-device执行效果
bash[root@ceph1 ~]# show-osd-device osd.0 : /dev/sdb osd.3 : /dev/sdc osd.6 : /dev/sdd
✅ 编排删除
编排删除做了什么?
- 自动 drain 数据(如果未提前 out,某些版本会拒绝)
- 通过 cephadm 在目标主机上停止 OSD 容器
- 自动执行:
ceph osd crush removeceph auth delceph osd rm
- (可选)自动 zap 磁盘/LVM (加
--zap参数) - 更新 orchestrator 内部状态,避免 reconcile 时重
示例:删除 osd.0
bash
# 禁用 osd 服务自动扩展
[root@ceph1 ~]# ceph orch apply osd --all-available-devices --unmanaged=true
[root@ceph1 ~]# ceph orch ls osd
NAME                       PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
osd.all-available-devices               9  7m ago     6s   <unmanaged>


# 第一种(先标记out,再删除)
[root@ceph1 ~]# ceph osd out osd.0
[root@ceph1 ~]# ceph orch osd rm 0

# 删除device上数据
# 删除前lsblk看下sdb
[root@ceph1 ~]# ceph orch device zap ceph1.laogao.cloud /dev/sdb --force    #看osd0管理的是/dev/sdb还是啥
zap successful for /dev/sdb on ceph1.laogao.cloud

# 确认结果
[root@ceph1 ~]# ceph orch device ls
[root@ceph1 ~]# ceph orch device ls | grep ceph1.*sdb
ceph1.laogao.cloud  /dev/sdb  hdd                                          20.0G  Yes        72s ago

[root@ceph1 ~]# lsblk
[root@ceph1 ~]# lsblk /dev/sdb
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT
sdb    8:16   0  20G  0 disk

# 第二种 直接删除加格式化磁盘
[root@ceph1 ~]# ceph osd out osd.3
[root@ceph1 ~]# ceph orch osd rm 3 --force --zap


# 添加回来
[root@ceph1 ~]# ceph orch apply osd --all-available-devices
#RUNNING重新变为9
[root@ceph1 ~]# ceph orch ls osd
NAME                       PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
osd.all-available-devices               9  6m ago     29s  *
❌手动删除
这是传统方式,在 没有 orchestrator 或旧版 Ceph 中常见,在 cephadm 集群中不推荐。
bash
# 将OSD标记为 出群(迁移数据),等待集群数据重平衡完成(ceph -s 看到 active+clean)
[root@ceph1 ~]# ceph osd out osd.0

# 确认osd.0在哪个节点
[root@ceph1 ~]# ceph osd tree

# 手动停服务(登录主机)
[root@ceph1 ~]# systemctl stop ceph-<fsid>@osd.0.service   # 或 podman stop ...
[root@ceph1 ~]# ceph osd tree

# 从CRUSH地图删除OSD
[root@ceph1 ~]# ceph osd crush remove osd.0
removed item id 0 name 'osd.0' from crush map
[root@ceph1 ~]# ceph osd tree

# 删除OSD认证密钥
[root@ceph1 ~]# ceph auth del osd.0
updated

# 从集群中删除OSD
[root@ceph1 ~]# ceph osd rm 0
removed osd.0
[root@ceph1 ~]# ceph osd tree

# 解除磁盘占用(可选,用于重新使用磁盘)
[root@ceph1 ~]# cephadm shell -- ceph-volume lvm zap /dev/sdb --destroy
风险:
- 漏步骤 :比如忘了
auth del,导致 OSD ID 无法复用。 - 顺序错误:先删 daemon 再 out,可能引发 PG 异常。
- 磁盘残留:LVM 未清理,新 OSD 无法部署到同一设备。
- Orchestrator 不知情 :下次
ceph orch apply osd --all-available-devices可能报错或忽略该设备。
删除主机
从集群中删除主机流程:
- 禁用集群所有服务自动扩展
- 查看待删除主机上当前运行的服务
- 停止待删除主机上的所有服务
- 删除主机上的所有服务
- 删除osd在CRUSH中的映射
- 擦除osd盘中的数据
- 从集群中删除主机
示例:删除 ceph2
首先,禁用集群中所有ceph服务自动扩展,进制自动部署osd。
bash
[root@ceph1 ~]# for service in $(ceph orch ls |grep -v -e NAME -e osd| awk '{print $1}');do ceph orch apply $service --unmanaged=true;done
[root@ceph1 ~]# ceph orch apply osd --all-available-devices --unmanaged=true其次,删除主机上运行的服务。
bash
# 查看ceph2上运行的daemon
[root@ceph1 ~]# ceph orch ps |grep ceph2 |awk '{print $1}'
crash.ceph2
mgr.ceph2.oetbal
mon.ceph2
node-exporter.ceph2
osd.2
osd.4
osd.7

# 删除相应 daemon
[root@ceph1 ~]# for daemon in $(ceph orch ps |grep ceph2 |awk '{print $1}');do ceph orch daemon rm $daemon --force;done

# 手动清理crush信息
[root@ceph1 ~]# ceph osd crush rm osd.2
[root@ceph1 ~]# ceph osd crush rm osd.4
[root@ceph1 ~]# ceph osd crush rm osd.7
[root@ceph1 ~]# ceph osd crush rm ceph2
[root@ceph1 ~]# ceph osd rm 2 4 7

# 清理磁盘数据
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdb --force
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdc --force
[root@ceph1 ~]# ceph orch device zap ceph2.laogao.cloud /dev/sdd --force然后,删除主机。
bash
[root@ceph1 ~]# ceph orch host rm ceph2

[root@ceph1 ~]# ceph orch host ls             #查看现象ceph2被移除
HOST                ADDR            LABELS  STATUS
ceph1.laogao.cloud  192.168.108.11  _admin
ceph3.laogao.cloud  192.168.108.13  _admin
2 hosts in cluster最后,删除ceph2中相应ceph遗留文件。
bash
[root@ceph2 ~]# rm -rf /var/lib/ceph
[root@ceph2 ~]# rm -rf /etc/ceph /etc/systemd/system/ceph*
[root@ceph2 ~]# rm -rf /var/log/ceph
实验完成后,恢复环境。
恢复环境-还原快照
第 3 章 Ceph 分布式存储 集群配置
管理集群配置
Ceph 集群配置概述
Ceph 配置选项具有唯一名称,该名称由下划线连接的小写字符组成。有些配置选项会包含短划线(中横杠)或空格字符。推荐做法:使用下划线。
Ceph 守护进程会从以下某个来源访问其配置:
- 编译中的默认值
- 集中配置数据库
- 存储在本地主机上的配置文件
- 环境变量
- 命令行参数
- 运行时覆盖
当存在多个设置源时,配置生效原则:
- 较新设置将覆盖较早设置源中的设置。
- 配置文件会在启动时配置守护进程。
- 配置文件设置会覆盖存储在中央数据库中的设置。
- 监控器 (MON) 节点管理集中配置数据库。
生效过程:
- 启动时,Ceph 守护进程解析命令行选项、环境变量和本地集群配置文件提供的配置选项。
- 然后,守护进程会联系 MON 集群来检索存储在集中配置数据库中的配置选项。
注意:Ceph 存储优先使用集中配置数据库中配置,弃用 ceph.conf 集群配置文件。
修改集群配置文件
Ceph会去以下目录中查找集群相关配置文件:
- CEPH_CONF 环境变量中包含的路径
- -c path/path:由命令行参数"-c"指定的路径
- ./$cluster.conf
- ~/.ceph/$cluster.conf
- /etc/ceph/$cluster.conf,默认位置。
每个 Ceph 节点都会存储一个本地配置文件,默认位置是 /etc/ceph/ceph.conf。cephadm 工具会使用最小选项集创建初始 Ceph 配置文件。
配置文件采用 INI 文件格式,其中内容涵盖 Ceph 守护进程和客户端配置。每个部分都使用 [name] 标头定义的名称,以及一个或多个键值对参数。
ini
[name]
parameter1 = value1
parameter2 = value2
使用井号 (#) 或分号 (😉 禁用设置或添加注释。
在引导集群时,可以借助集群配置文件,自定义引导集群。
示例:
bash
# cephadm bootstrap --config ceph-config.yaml配置部分
Ceph 使用所应用的守护进程或客户端的部分,将配置选项分组,确定是存储在配置文件中还是存储在配置数据库中。
- global 部分,存储所有守护进程(包括客户端)共有的一般配置,可为单个守护进程或客户端创建调用部分来覆盖 global 参数。
- mon 部分,存储监控器 (MON) 的配置。
- osd 部分,存储 OSD 守护进程的配置。
- mgr 部分,存储管理器 (MGR) 的配置。
- mds 部分,存储元数据服务器 (MDS) 的配置。
- client 部分,存储应用到所有 Ceph 客户客户端的配置。
良好的示例文件参见 /usr/share/doc/ceph/sample.ceph.conf,该文件由 ceph-common 软件包提供。
实例设置
实例设置适用于特定守护进程,名称格式为:[daemon-type.instance-ID]。
ini
[mon]
# Settings for all mon daemons

[mon.ceph1]
# Settings that apply to the specific MON daemon running on ceph1
同样的名称还适用于 osd、mgr、mds 和 client 部分。
- OSD 守护进程的实例 ID 始终为数字,例如 osd.0。
- 客户端的实例 ID 是有效的用户名,例如 client.operator3。
元变量
元变量是由 Ceph 定义的变量。用户可使用它们来简化配置。
- $cluster ,Ceph 存储 5 集群的名称。默认集群名称为 ceph。
- $type ,守护进程类型,如监控器的值为 mon 。OSD 使用 osd ,元数据服务器使用 mds ,管理器使用 mgr ,客户端软件使用 client。
- id∗∗,守护进程实例ID。对于此变量,∗∗ceph1∗∗上监控器的值为∗∗ceph1∗∗。∗∗osd.1∗∗的∗∗id**,守护进程实例 ID。对于此变量,**ceph1** 上监控器的值为 **ceph1**。**osd.1** 的 **id∗∗,守护进程实例ID。对于此变量,∗∗ceph1∗∗上监控器的值为∗∗ceph1∗∗。∗∗osd.1∗∗的∗∗id 值为 1 ,客户端应用的值为用户名。
- name∗∗,守护进程名称和实例ID。此变量是∗∗name**,守护进程名称和实例 ID。此变量是 **name∗∗,守护进程名称和实例ID。此变量是∗∗type.$id 的简写。
- $host,运行守护进程的主机的名称。
bash
## Metavariables
# $cluster    ; Expands to the Ceph Storage Cluster name. Useful
#             ; when running multiple Ceph Storage Clusters
#             ; on the same hardware.
#             ; Example: /etc/ceph/$cluster.keyring
#             ; (Default: ceph)
#
# $type       ; Expands to one of mds, osd, or mon, depending on
#             ; the type of the instant daemon.
#             ; Example: /var/lib/ceph/$type
#
# $id         ; Expands to the daemon identifier. For osd.0, this
#             ; would be 0; for mds.a, it would be a.
#             ; Example: /var/lib/ceph/$type/$cluster-$id
#
# $host       ; Expands to the host name of the instant daemon.
#
# $name       ; Expands to $type.$id.
#             ; Example: /var/run/ceph/$cluster-$name.asok
使用集群配置数据库
集群配置数据库由 MON 节点集中管理:
- 在守护进程启动之前,暂时更改设置。
- 在守护进程运行时,更改大部分设置。
- 将永久设置存储在数据库中。
Ceph集中配置数据库默认存放在 MON 节点 /var/lib/ceph/fsid/mon.fsid/mon.fsid/mon.host/store.db中。
使用 ceph config 命令,查询和配置集中配置数据库。
ceph config ls
列出集群数据库中所有配置条目。
bash
[root@ceph1 ~]# ceph config ls
host
fsid
public_addr
public_addrv
public_bind_addr
cluster_addr
public_network
public_network_interface
cluster_network
cluster_network_interface
......
ceph config help <key>
查看集群数据库中特定配置帮助信息。 是 ceph config ls 命令列出的条目。
bash
[root@ceph1 ~]# ceph config help host
host - local hostname
  (str, basic)
  Default:
  Can update at runtime: false
  Services: [common]
  Tags: [network]

if blank, ceph assumes the short hostname (hostname -s)

[root@ceph1 ~]# ceph config help fsid
fsid - cluster fsid (uuid)
  (uuid, basic)
  Default: 00000000-0000-0000-0000-000000000000
  Can update at runtime: false
  Services: [common]
  Tags: [service]
ceph config dump
显示集群配置 数据库设置。显示的是当前所有生效的配置项(包括默认值和已被修改的值)
ceph config dump 显示的是:
- 所有被显式设置过 (通过
ceph config set或旧版ceph.conf)的配置项; - 不显示纯默认值(即从未被设置、完全使用 Ceph 内置默认的配置项)。
bash
[root@ceph1 ~]# ceph config dump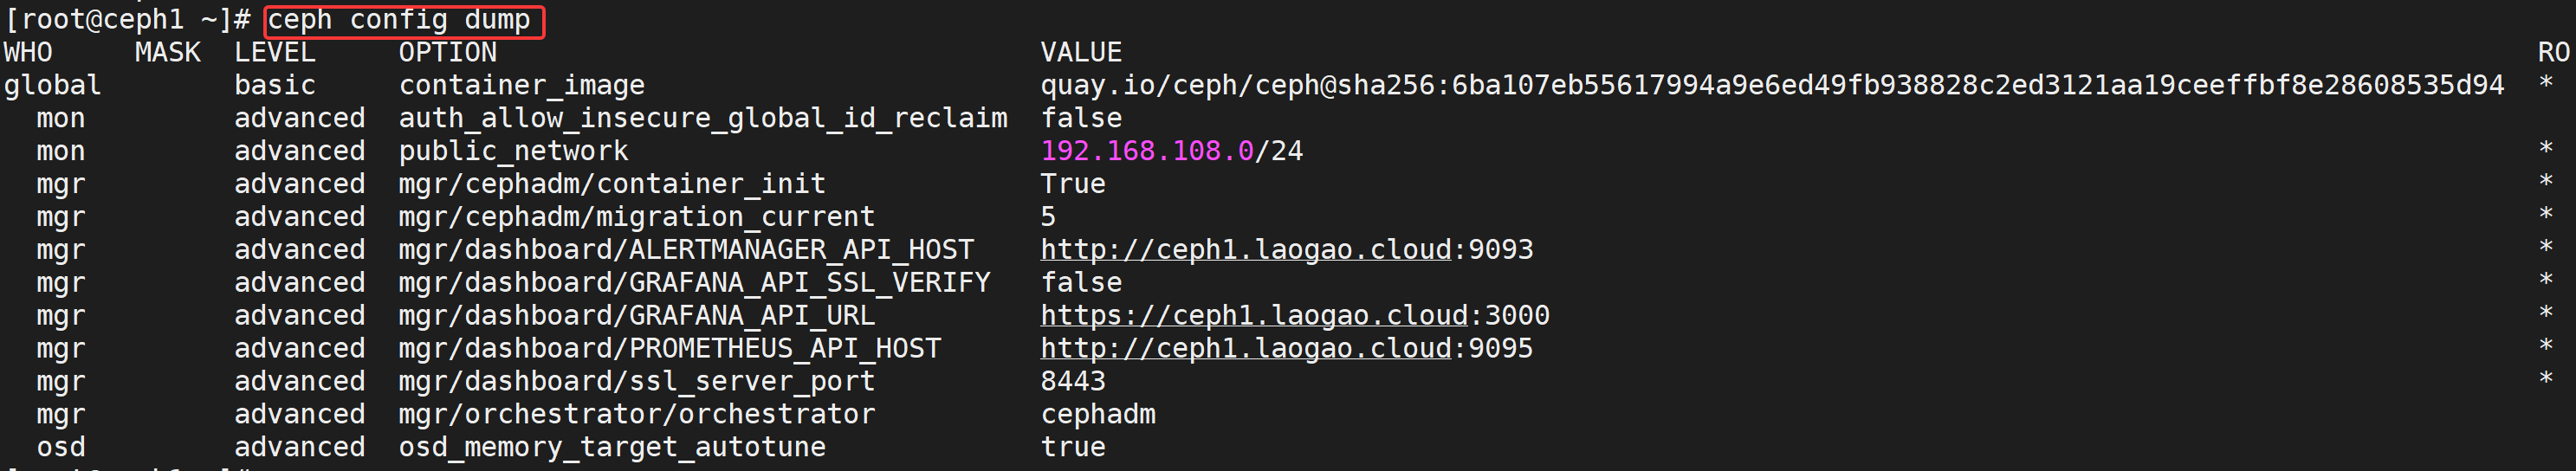
ceph config show type.type.type.id ``
仅显示被显式设置过的配置项, 查看"用户自定义了哪些配置"
只列出通过以下方式显式设置过的配置:
ceph config set ...- 旧版
ceph.conf中定义并被加载的项
bash
[root@ceph1 ~]# ceph config show mon.ceph1.laogao.cloud

[root@ceph1 ~]# ceph config show mon.ceph1.laogao.cloud public_network
192.168.108.0/24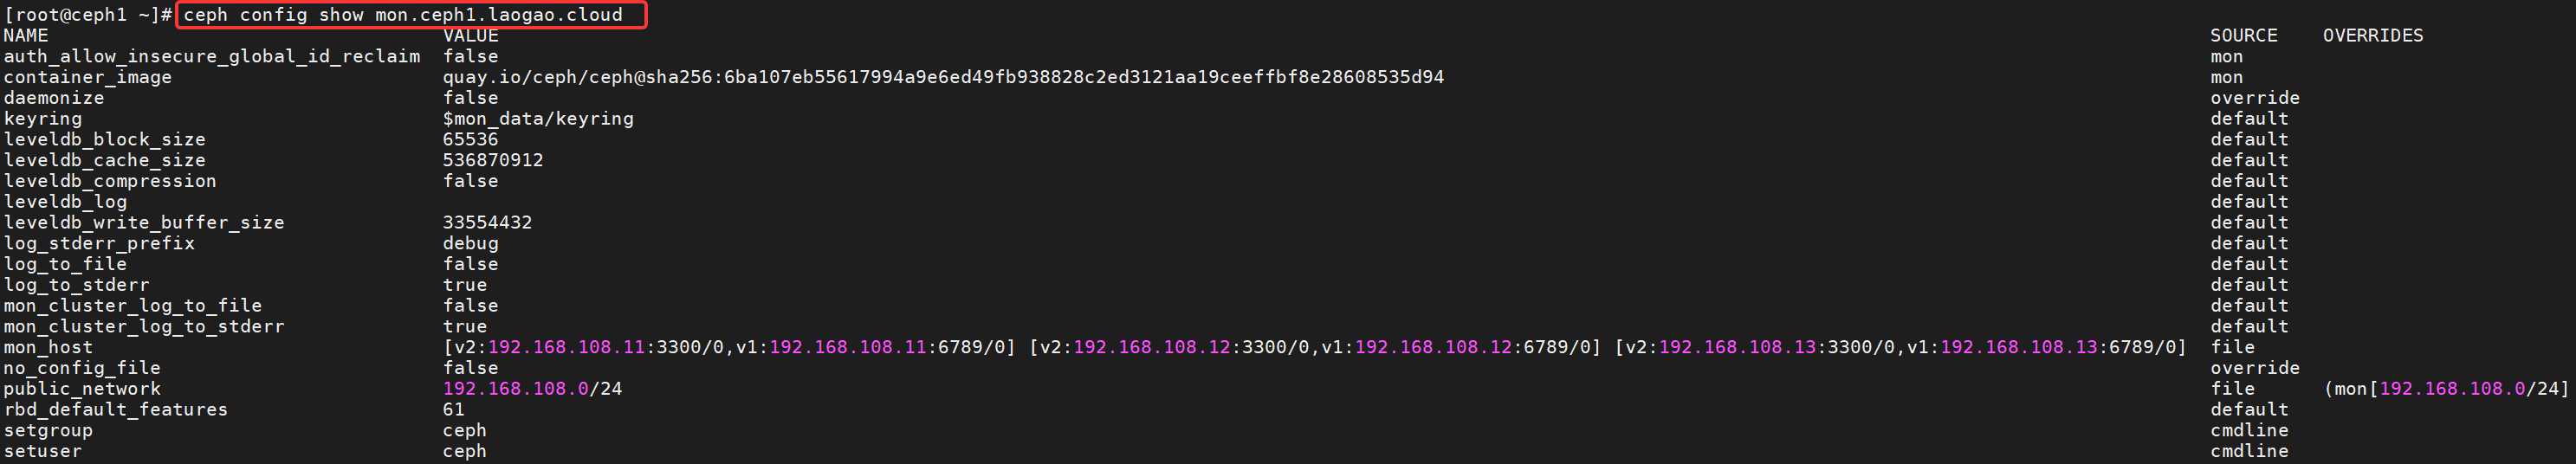
ceph config show-with-defaults type.type.type.id
显示所有配置项 + 当前值(包括默认值),查看"完整运行时配置",用于排错或审计
- 列出 Ceph 支持的所有可配置项(数百项!)
- 每一项都显示其 当前生效的值(无论是默认值还是被覆盖的值)
- 用于全面了解集群的完整配置状态
bash
[root@ceph1 ~]# ceph config show-with-defaults mon.ceph1.laogao.cloud
NAME                                                        VALUE
admin_socket                                                $run_dir/$cluster-$name.asok
admin_socket_mode
auth_allow_insecure_global_id_reclaim                       false
auth_client_required                                        cephx, none
auth_cluster_required                                       cephx
auth_debug                                                  false
auth_expose_insecure_global_id_reclaim                      true
auth_mon_ticket_ttl                                         259200.000000
auth_service_required                                       cephx
auth_service_ticket_ttl                                     3600.000000
auth_supported
bdev_aio                                                    true
......
ceph config get type.type.type.id ``
获得集群数据库中特定配置设置。精准点查
bash
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud
WHO     MASK  LEVEL     OPTION                                 VALUE                                                                                      RO
mon           advanced  auth_allow_insecure_global_id_reclaim  false
global        basic     container_image                        quay.io/ceph/ceph@sha256:6ba107eb55617994a9e6ed49fb938828c2ed3121aa19ceeffbf8e28608535d94  *
mon           advanced  public_network                         192.168.108.0/24

[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud public_network
192.168.108.0/24
ceph config set type.type.type.id <key> <value>
设置集群数据库中特定配置选项。
工作原理:
- 修改 Monitor 维护的 集中式配置数据库
- 所有符合条件的 daemon(如所有 OSD)会自动拉取新配置并应用
- 配置持久存储在 Monitor 的 KV store 中
bash
# 设置特定类型所有实例
[root@ceph1 ~]# ceph config set mon mon_allow_pool_delete false

# 设置特定类型特定实例
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true

[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true
ceph config rm type.type.type.id ``
清除集群数据库中特定配置选项。--删除该参数还原默认配置的意思
bash
[root@ceph1 ~]# ceph config rm mon.ceph1.laogao.cloud mon_allow_pool_delete

[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false
ceph config log [<num:int>]
显示集群最近配置历史记录,默认显示10条,类似于linux中history命令。
bash
[root@ceph1 ~]# ceph config log
--- 16 --- 2025-08-19T08:08:00.450868+0000 ---
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
--- 15 --- 2025-08-19T08:07:01.547157+0000 ---
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
--- 14 --- 2025-08-19T08:05:20.097053+0000 ---
+ mon/mon_allow_pool_delete = false
......

# 只显示最近更改的两条记录
[root@ceph1 ~]# ceph config log 2
--- 16 --- 2025-08-19T08:08:00.450868+0000 ---
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
--- 15 --- 2025-08-19T08:07:01.547157+0000 ---
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
ceph config reset [<num:int>]
回滚集群数据中特定配置为 num 指定的历史版本。
准备实验环境:
bash
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete true    #产生log 20记录
[root@ceph1 ~]# ceph config set mon.ceph1.laogao.cloud mon_allow_pool_delete false   #产生log 21记录
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
false               #此刻为false
[root@ceph1 ~]# ceph config log 2
--- 21 --- 2025-08-19T08:23:11.722223+0000 ---
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
--- 20 --- 2025-08-19T08:23:07.709101+0000 ---
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
回滚配置到log 20的版本
bash
[root@ceph1 ~]# ceph config reset 20
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete   #验证回到log 20的true
true
[root@ceph1 ~]# ceph config log 1
--- 22 --- 2025-08-19T08:25:27.045753+0000 --- reset to 20 ---      #从22回滚到20
- mon.ceph1.laogao.cloud/mon_allow_pool_delete = false
+ mon.ceph1.laogao.cloud/mon_allow_pool_delete = true
集群引导选项
集群引导选项提供启动集群所需的信息。MON 读取 mon map 和 ceph.conf 文件,以确定如何与其他 MON 通信,并与其他 MON 并建立仲裁。
mon_ip 选项列出集群监控器。**此选项必不可少,并且不能存储在配置数据库中。**为避免使用集群配置文件,Ceph 集群支持使用 DNS 服务记录提供 mon_host 列表。
本地集群配置文件 ceph.conf 还可包含其他选项:
- mon_host_override,集群监视器的初始列表。
- mon_dns_serv_name,用于检查通过 DNS 识别的集群监控器的 DNS SRV 记录的名称。
- mon_data、osd_data 、mds_data 、mgr_data,定义守护进程的本地数据存储目录。
- keyring 、keyfile 和 key,使用监控器进行身份验证的身份验证凭据。
在运行时覆盖配置设置
Ceph支持在守护进程运行时,临时更改大部分配置选项。
ceph tell 命令
向 daemon "发消息"
工作原理:
- 直接与指定的运行中 daemon 通信(通过 admin socket 或网络)
- 常用于执行管理命令(如 compact leveldb、flush cache)
- 若用于配置,需通过
injectargs模拟"启动参数"
ceph tell $type.$id config 命令可临时覆盖配置选项,并要求所配置的MON和守护进程都在运行。
ceph tell $type.$id config show,获取守护进程的所有运行时设置。ceph tell $type.$id config get,获取守护进程的特定运行时设置。ceph tell $type.$id config set,设置守护进程的特定运行时设置。当守护进程重启时,这些临时设置将恢复为原始值。
示例:
bash
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "true"
}

[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config set mon_allow_pool_delete false
{
    "success": "mon_allow_pool_delete = 'false' "
}

# 临时更改的值已生效
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "false"
}

# 集群数据库中值仍然为true
[root@ceph1 ~]# ceph config get mon.ceph1.laogao.cloud mon_allow_pool_delete
true

# 重启守护进程,生效的值恢复为数据库中设置的值
[root@ceph1 ~]# ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "true"
}
注意:使用此命令更改的设置在守护进程重启后会恢复为原始设置。
ceph tell $type.$id config 命令接受通配符,以获取或设置同一类型的所有守护进程的值。
bash
[root@ceph1 ~]# ceph tell mon.* config get mon_allow_pool_delete
mon.ceph1.laogao.cloud: {
    "mon_allow_pool_delete": "true"
}
mon.ceph2: {
    "mon_allow_pool_delete": "false"
}
mon.ceph3: {
    "mon_allow_pool_delete": "false"
}
ceph config set和ceph tell命令对比
| 特性 | ceph config set |
ceph tell ... injectargs |
|---|---|---|
| 配置存储位置 | Monitor 配置数据库 | 仅内存(daemon 进程内) |
| 是否持久 | ✅ 是 | ❌ 否 |
| 是否批量生效 | ✅(如 osd 影响所有) |
❌(必须指定具体实例,如 osd.0) |
| 能否用于非配置操作 | ❌ 仅配置 | ✅(如 compact, flush) |
是否被 ceph config get 识别 |
✅ 是 | ❌ 否 |
| 适用场景 | 长期配置、运维策略 | 紧急排错、临时调试 |
💡 使用建议
- 日常调优、生产配置 → 用
ceph config set - 紧急排查问题、临时抓日志 → 用
ceph tell osd.0 injectargs --debug_xxx=20 - 执行管理动作(非配置) → 必须用
ceph tell(如compact,cache-flush)
ceph daemon 命令
Ceph支持在集群特定节点上使用 ceph daemon $type.$id config 命令临时覆盖配置选项。该命令不需要连接 MON ,但要求对应的守护进程要运行,所以即使 MON 未运行,该命令仍可发挥作用,有助于故障排除。
-
ceph daemon $type.$id config show,获得特定守护进程运行时所有设置。bash# 在ceph1上只能查看和设置ceph1上运行的相关进程设置 [root@ceph1 ~]# cephadm shell [ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config show { "name": "mon.ceph1.laogao.cloud", "cluster": "ceph", "admin_socket": "/var/run/ceph/ceph-mon.ceph1.laogao.cloud.asok", "admin_socket_mode": "", "auth_allow_insecure_global_id_reclaim": "false", "auth_client_required": "cephx, none", "auth_cluster_required": "cephx", "auth_debug": "false", "auth_expose_insecure_global_id_reclaim": "true", "auth_mon_ticket_ttl": "259200.000000", "auth_service_required": "cephx", ...... -
ceph daemon $type.$id config get,获得守护进程运行时特定设置。bash[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete { "mon_allow_pool_delete": "true" } -
ceph daemon $type.$id config set,设置守护进程运行时特定设置。bash[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config set mon_allow_pool_delete false { "success": "mon_allow_pool_delete = 'false' " } [ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete { "mon_allow_pool_delete": "false" }
注意:使用此命令更改的设置在守护进程重启后会恢复为原始设置。
bash
[ceph: root@ceph1 /]# ceph orch daemon restart mon.ceph1.laogao.cloud
Scheduled to restart mon.ceph1.laogao.cloud on host 'ceph1.laogao.cloud'
[ceph: root@ceph1 /]# ceph daemon mon.ceph1.laogao.cloud config get mon_allow_pool_delete
{
    "mon_allow_pool_delete": "true"
}Web UI 更改
-
打开 Web 浏览器并导航到 https://ceph1.laogao.cloud:8443。必要时,接受证书警告。
输入用户名(admin)和密码(laogao@123) 登录。
-
在 Ceph 控制面板 Web UI 中,单击 Cluster > Configuration 以显示 Configuration Settings 页面。
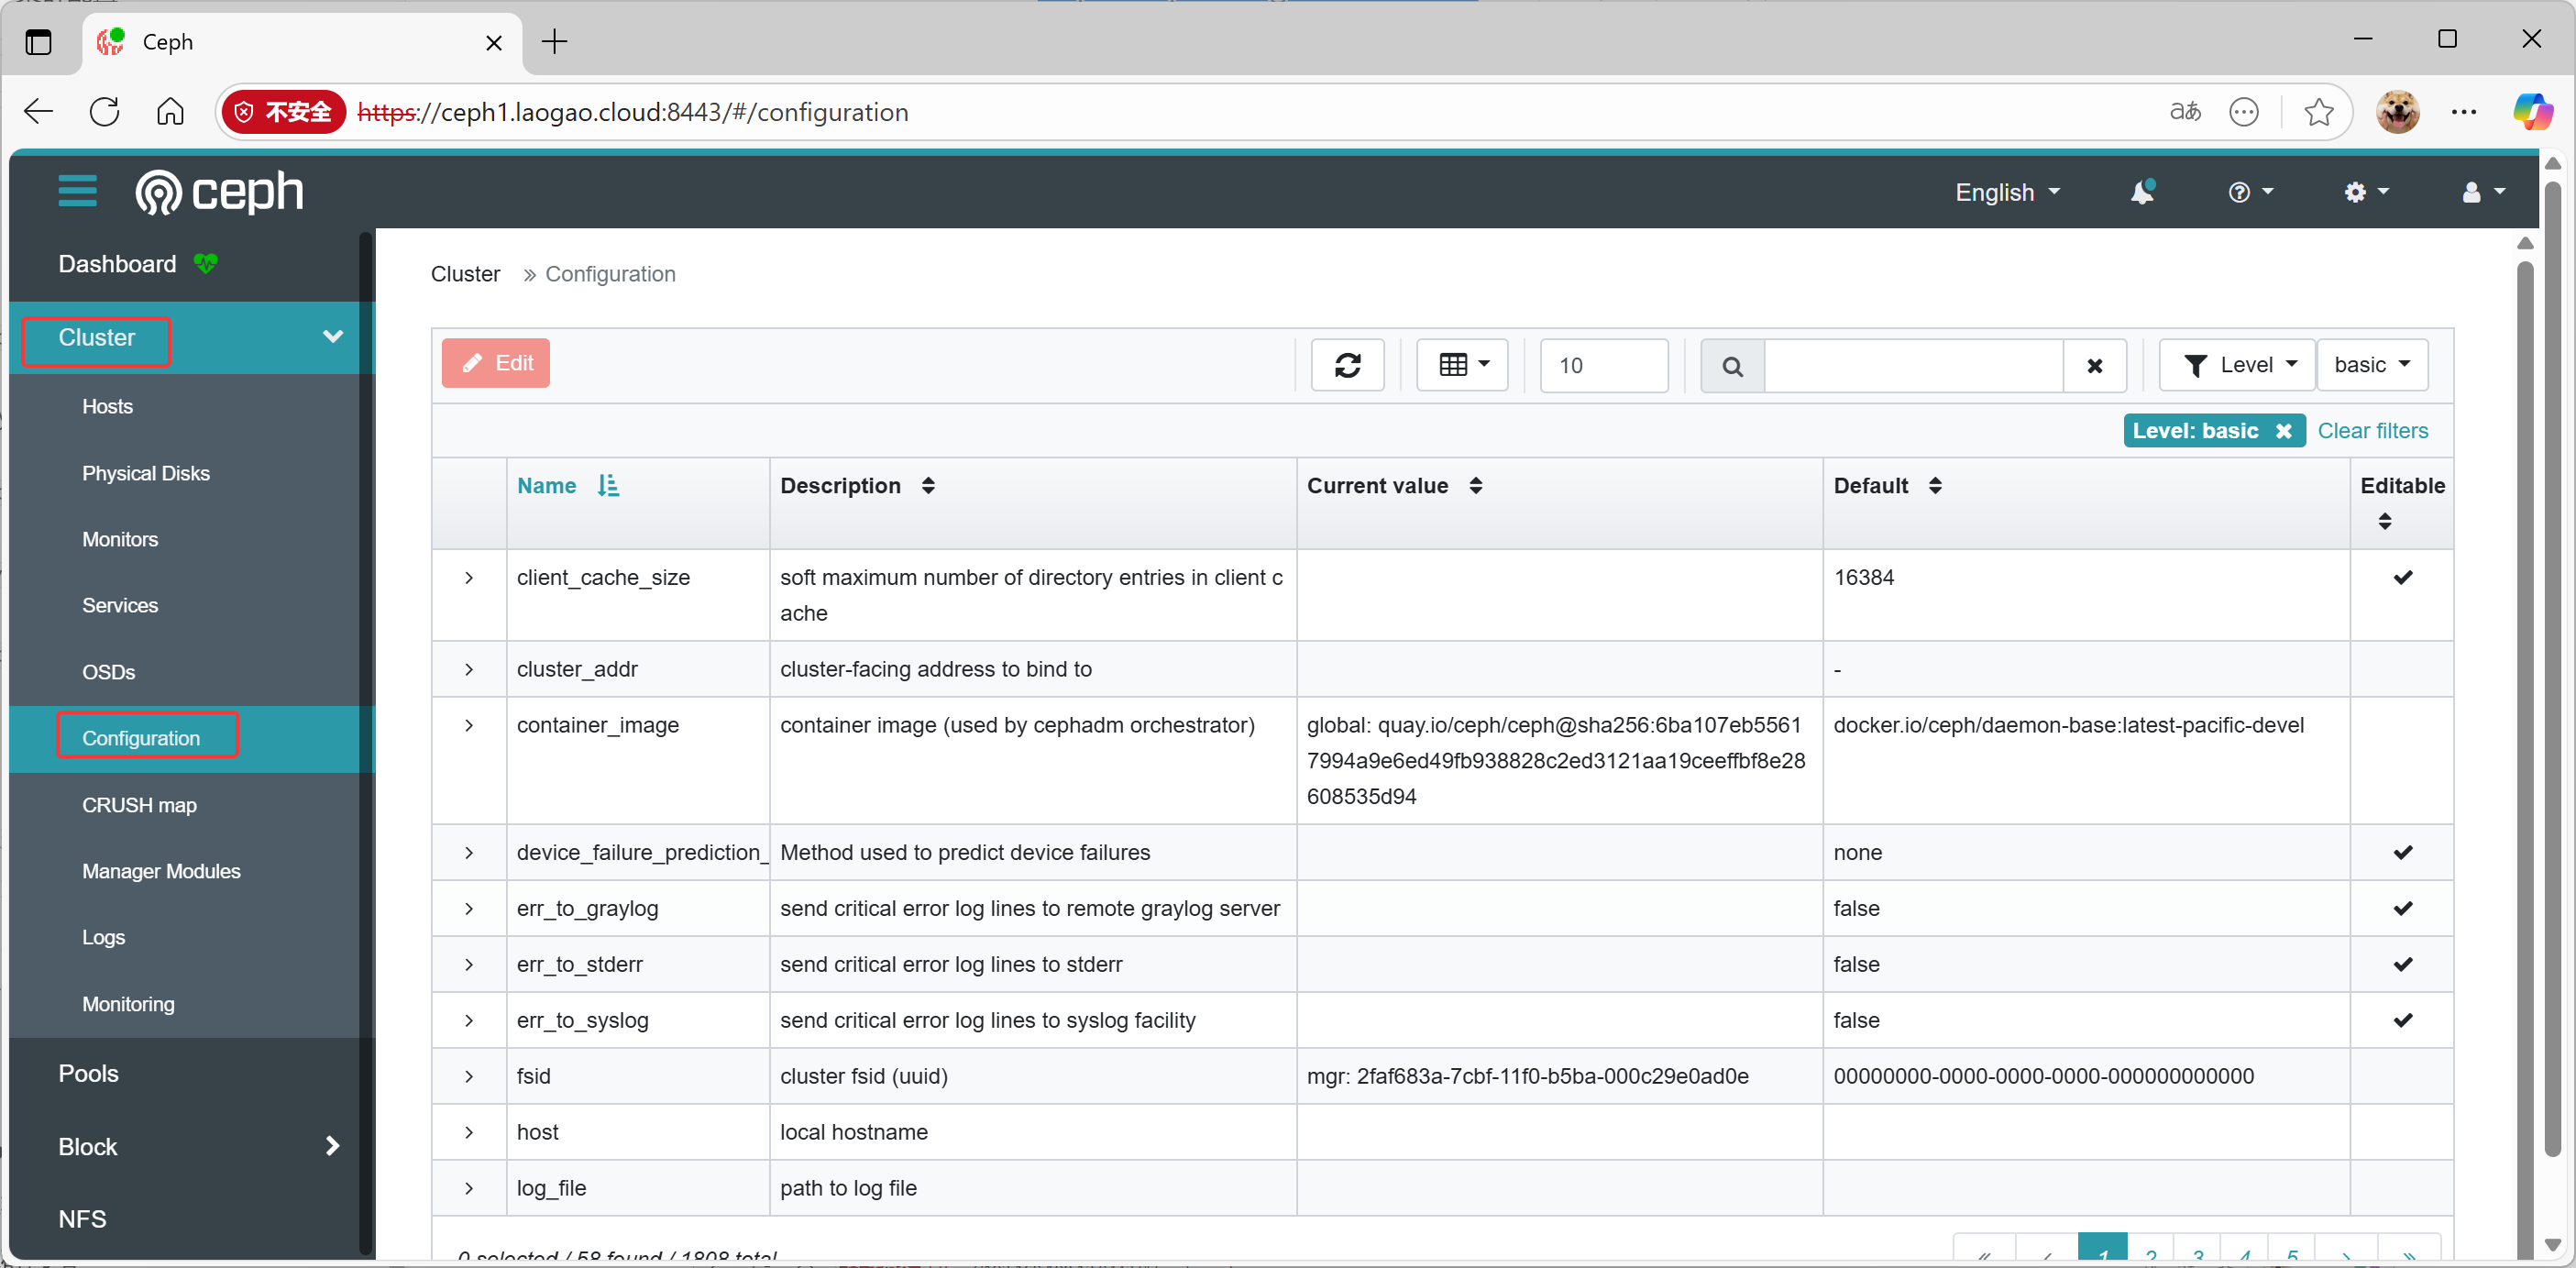
-
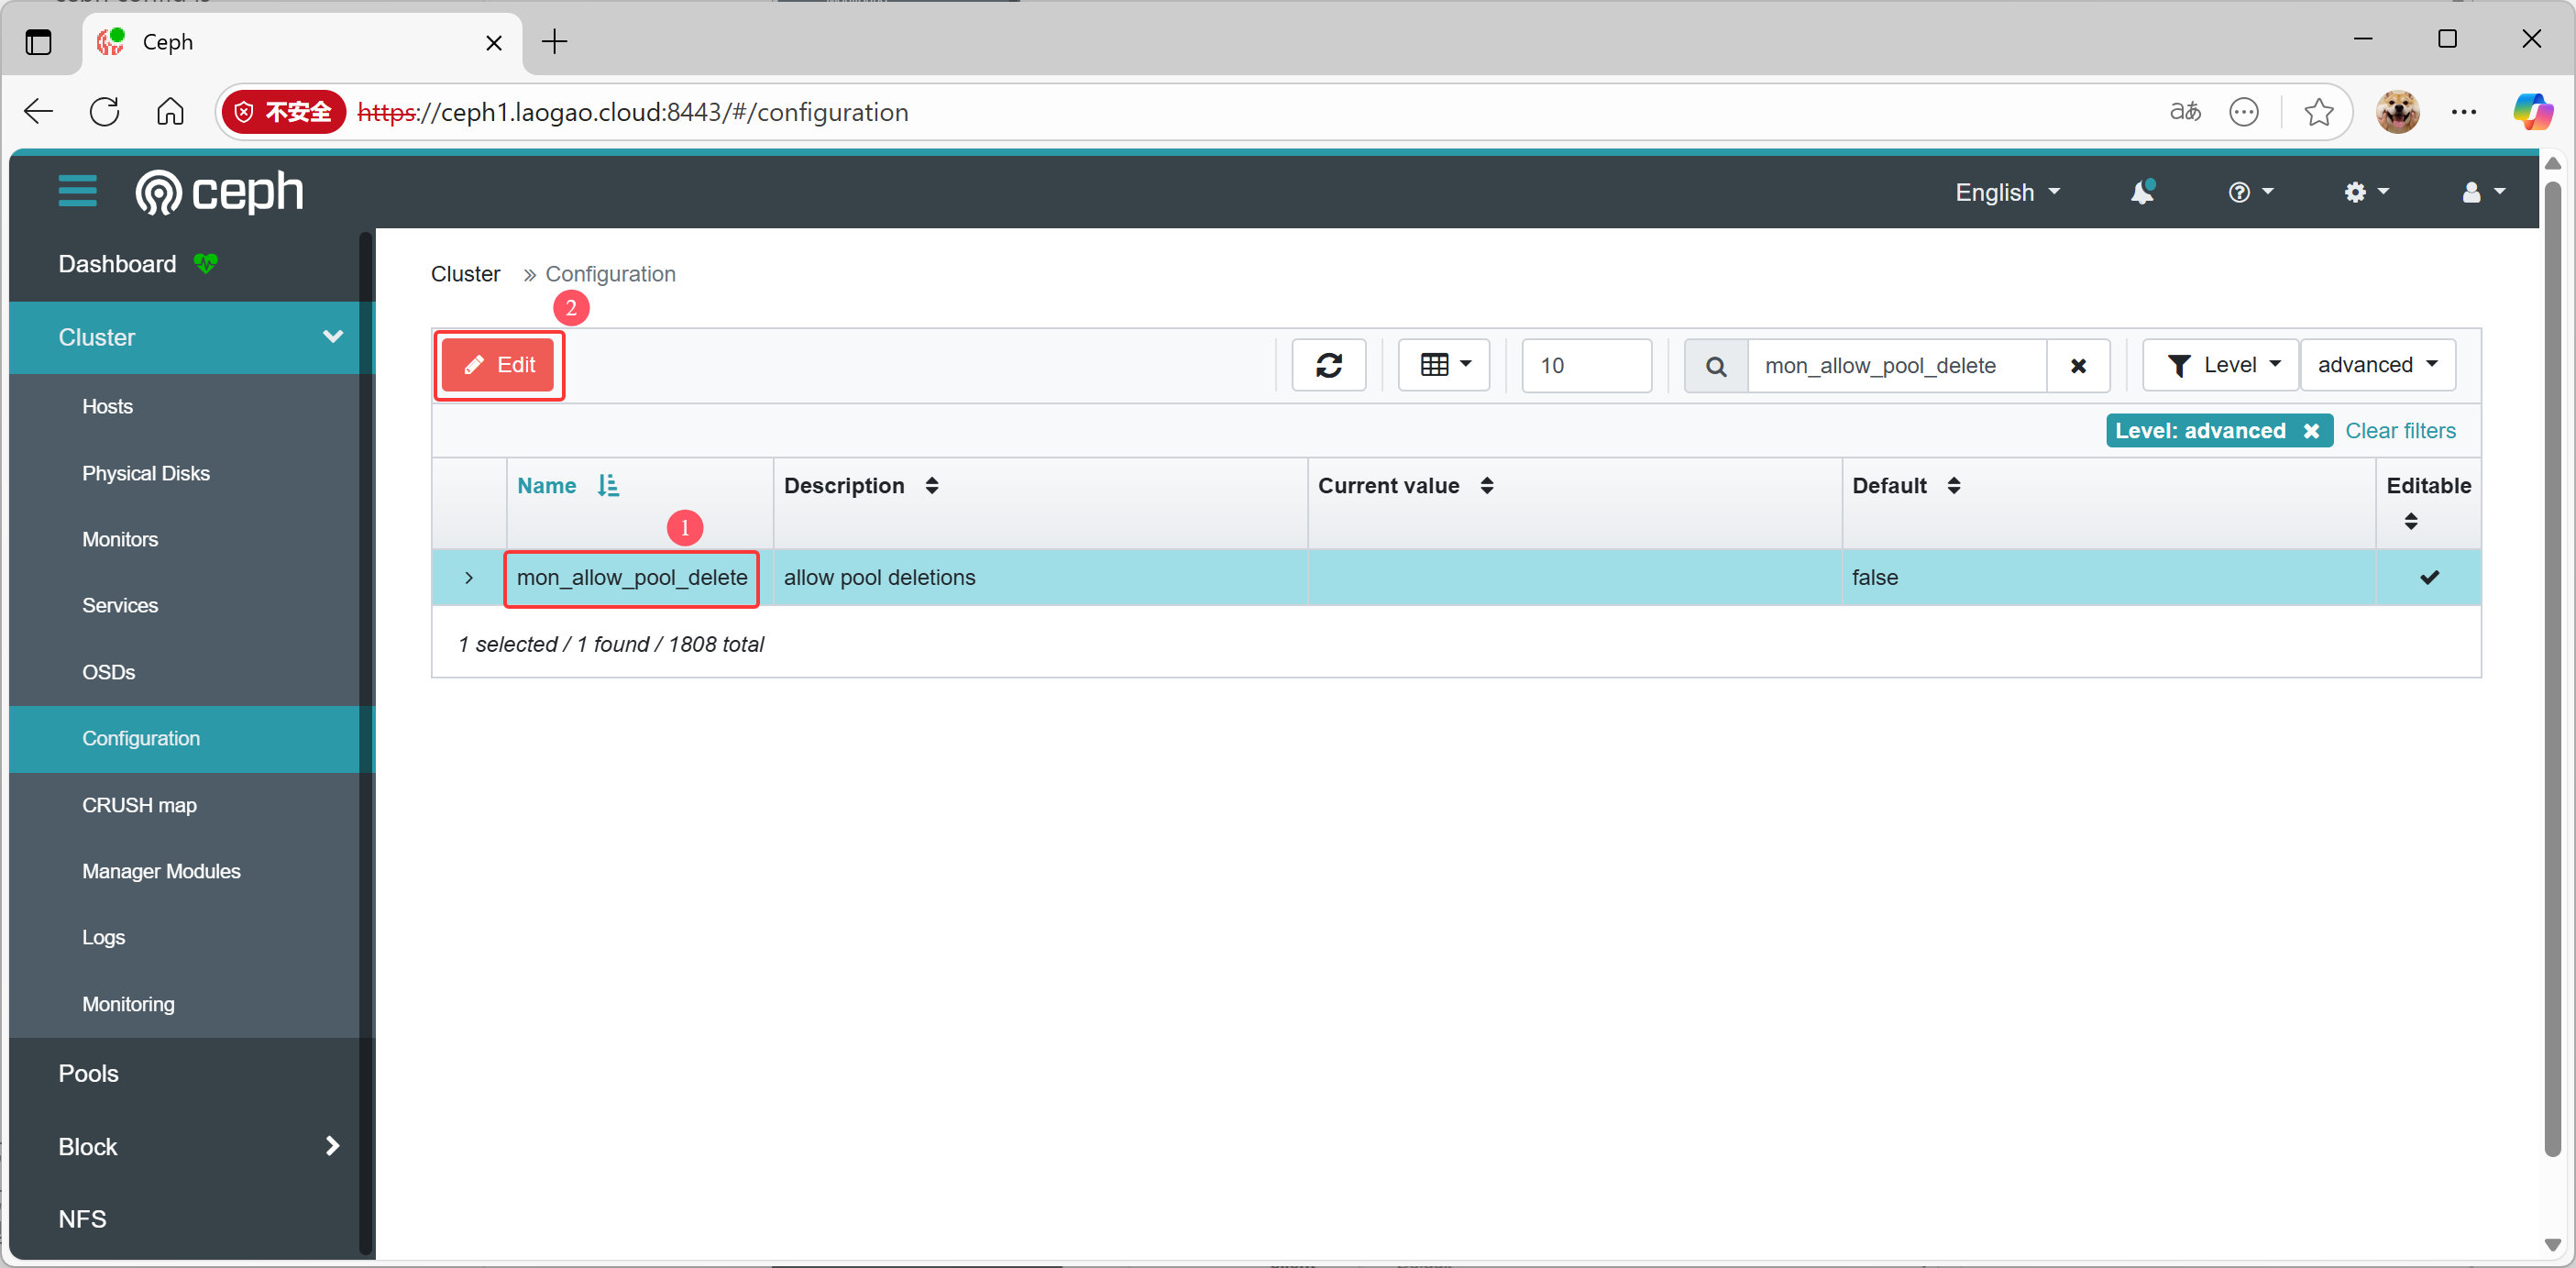
从 advanced 菜单中选择 advanced 选项,以查看高级配置选项。在搜索栏中键入mon_allow_pool_delete 来查找设置。
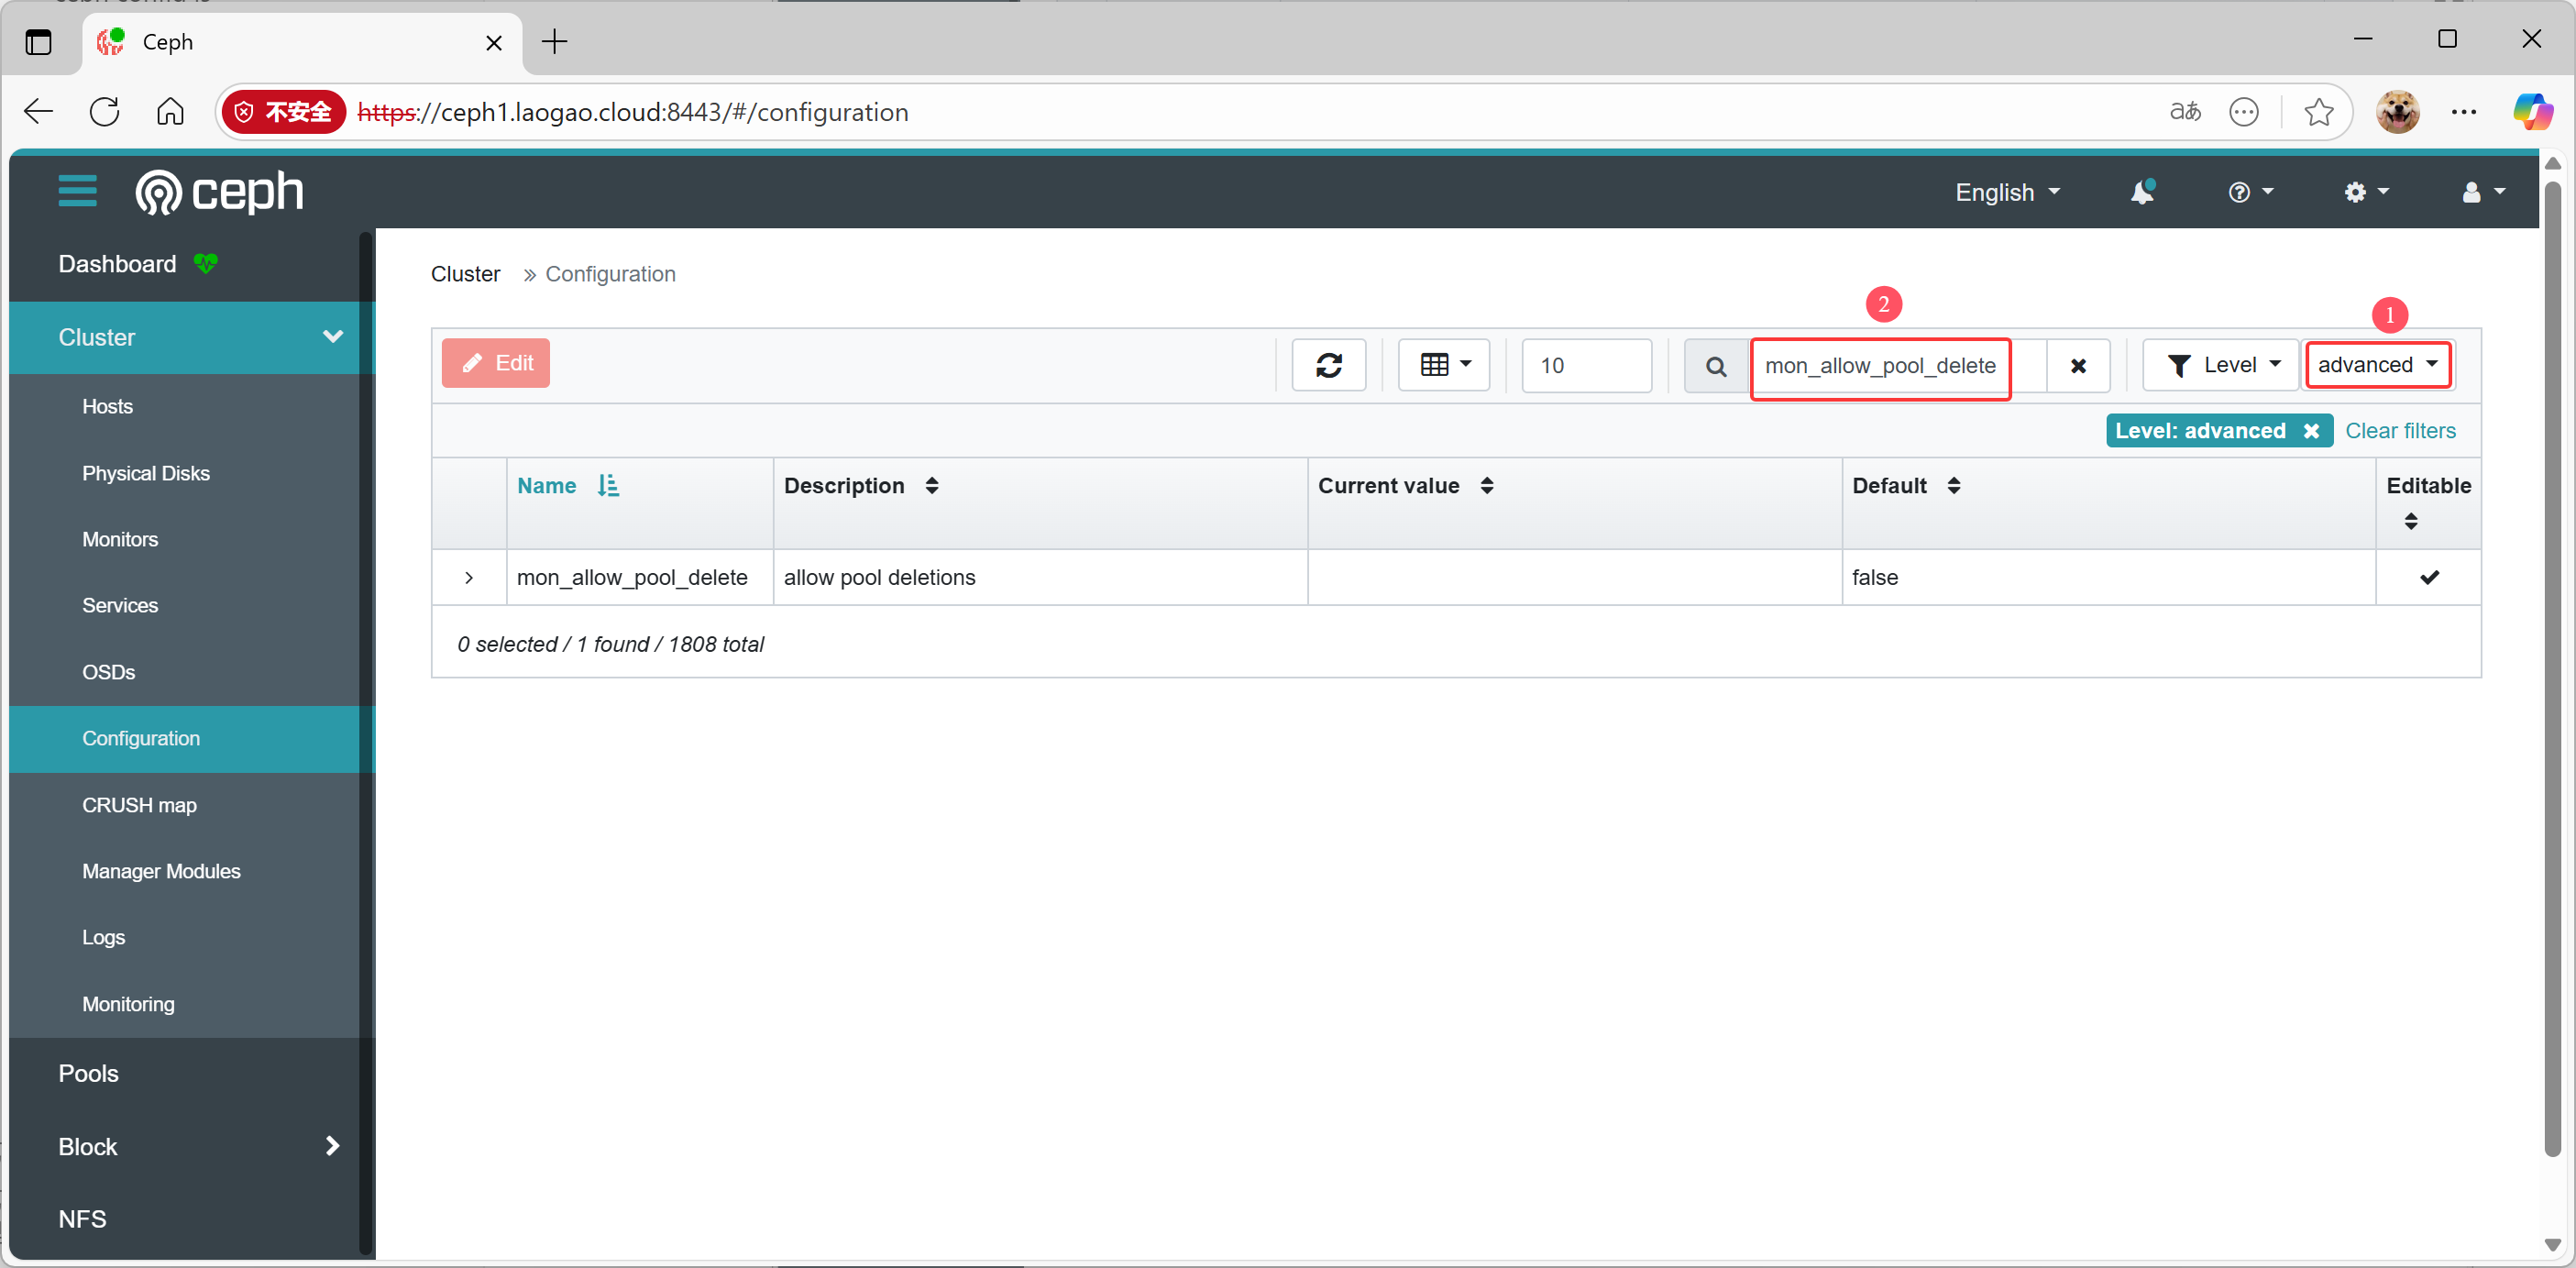
-
单击 mon_allow_pool_delete,然后单击 Edit。
-
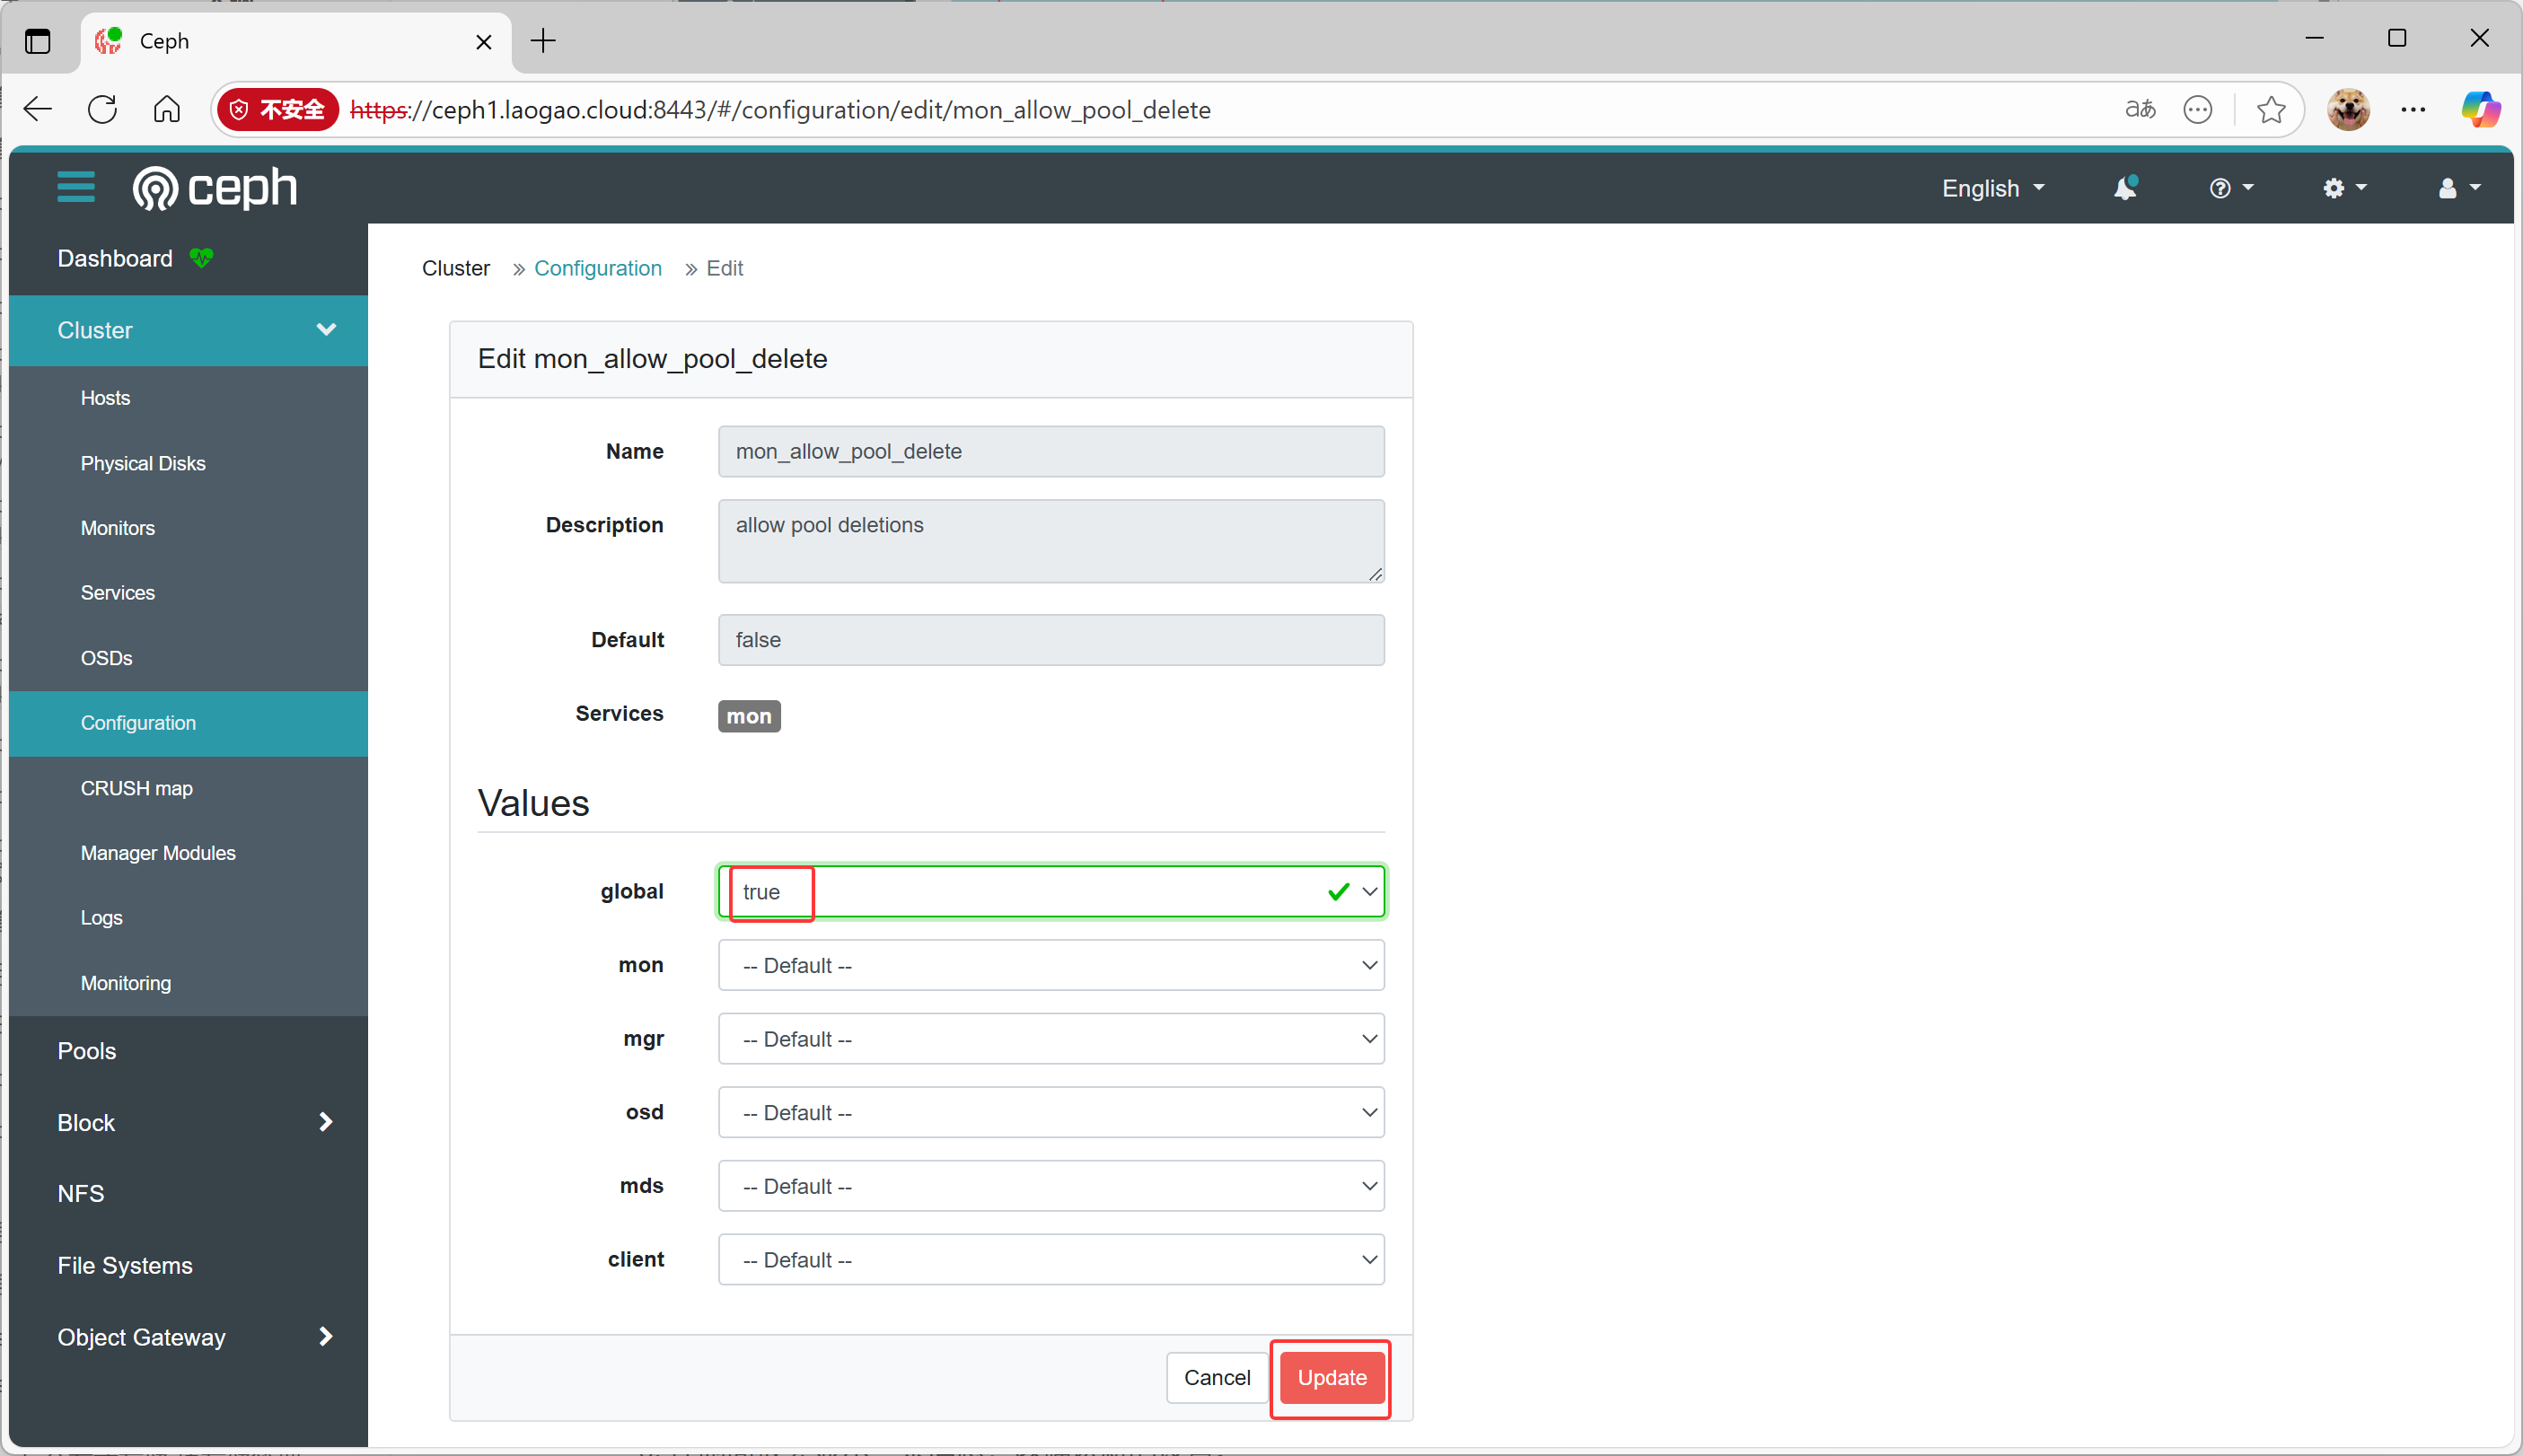
编辑 mon_allow_pool_delete 设置,将 global 值设置为 true,然后单击Update。
-
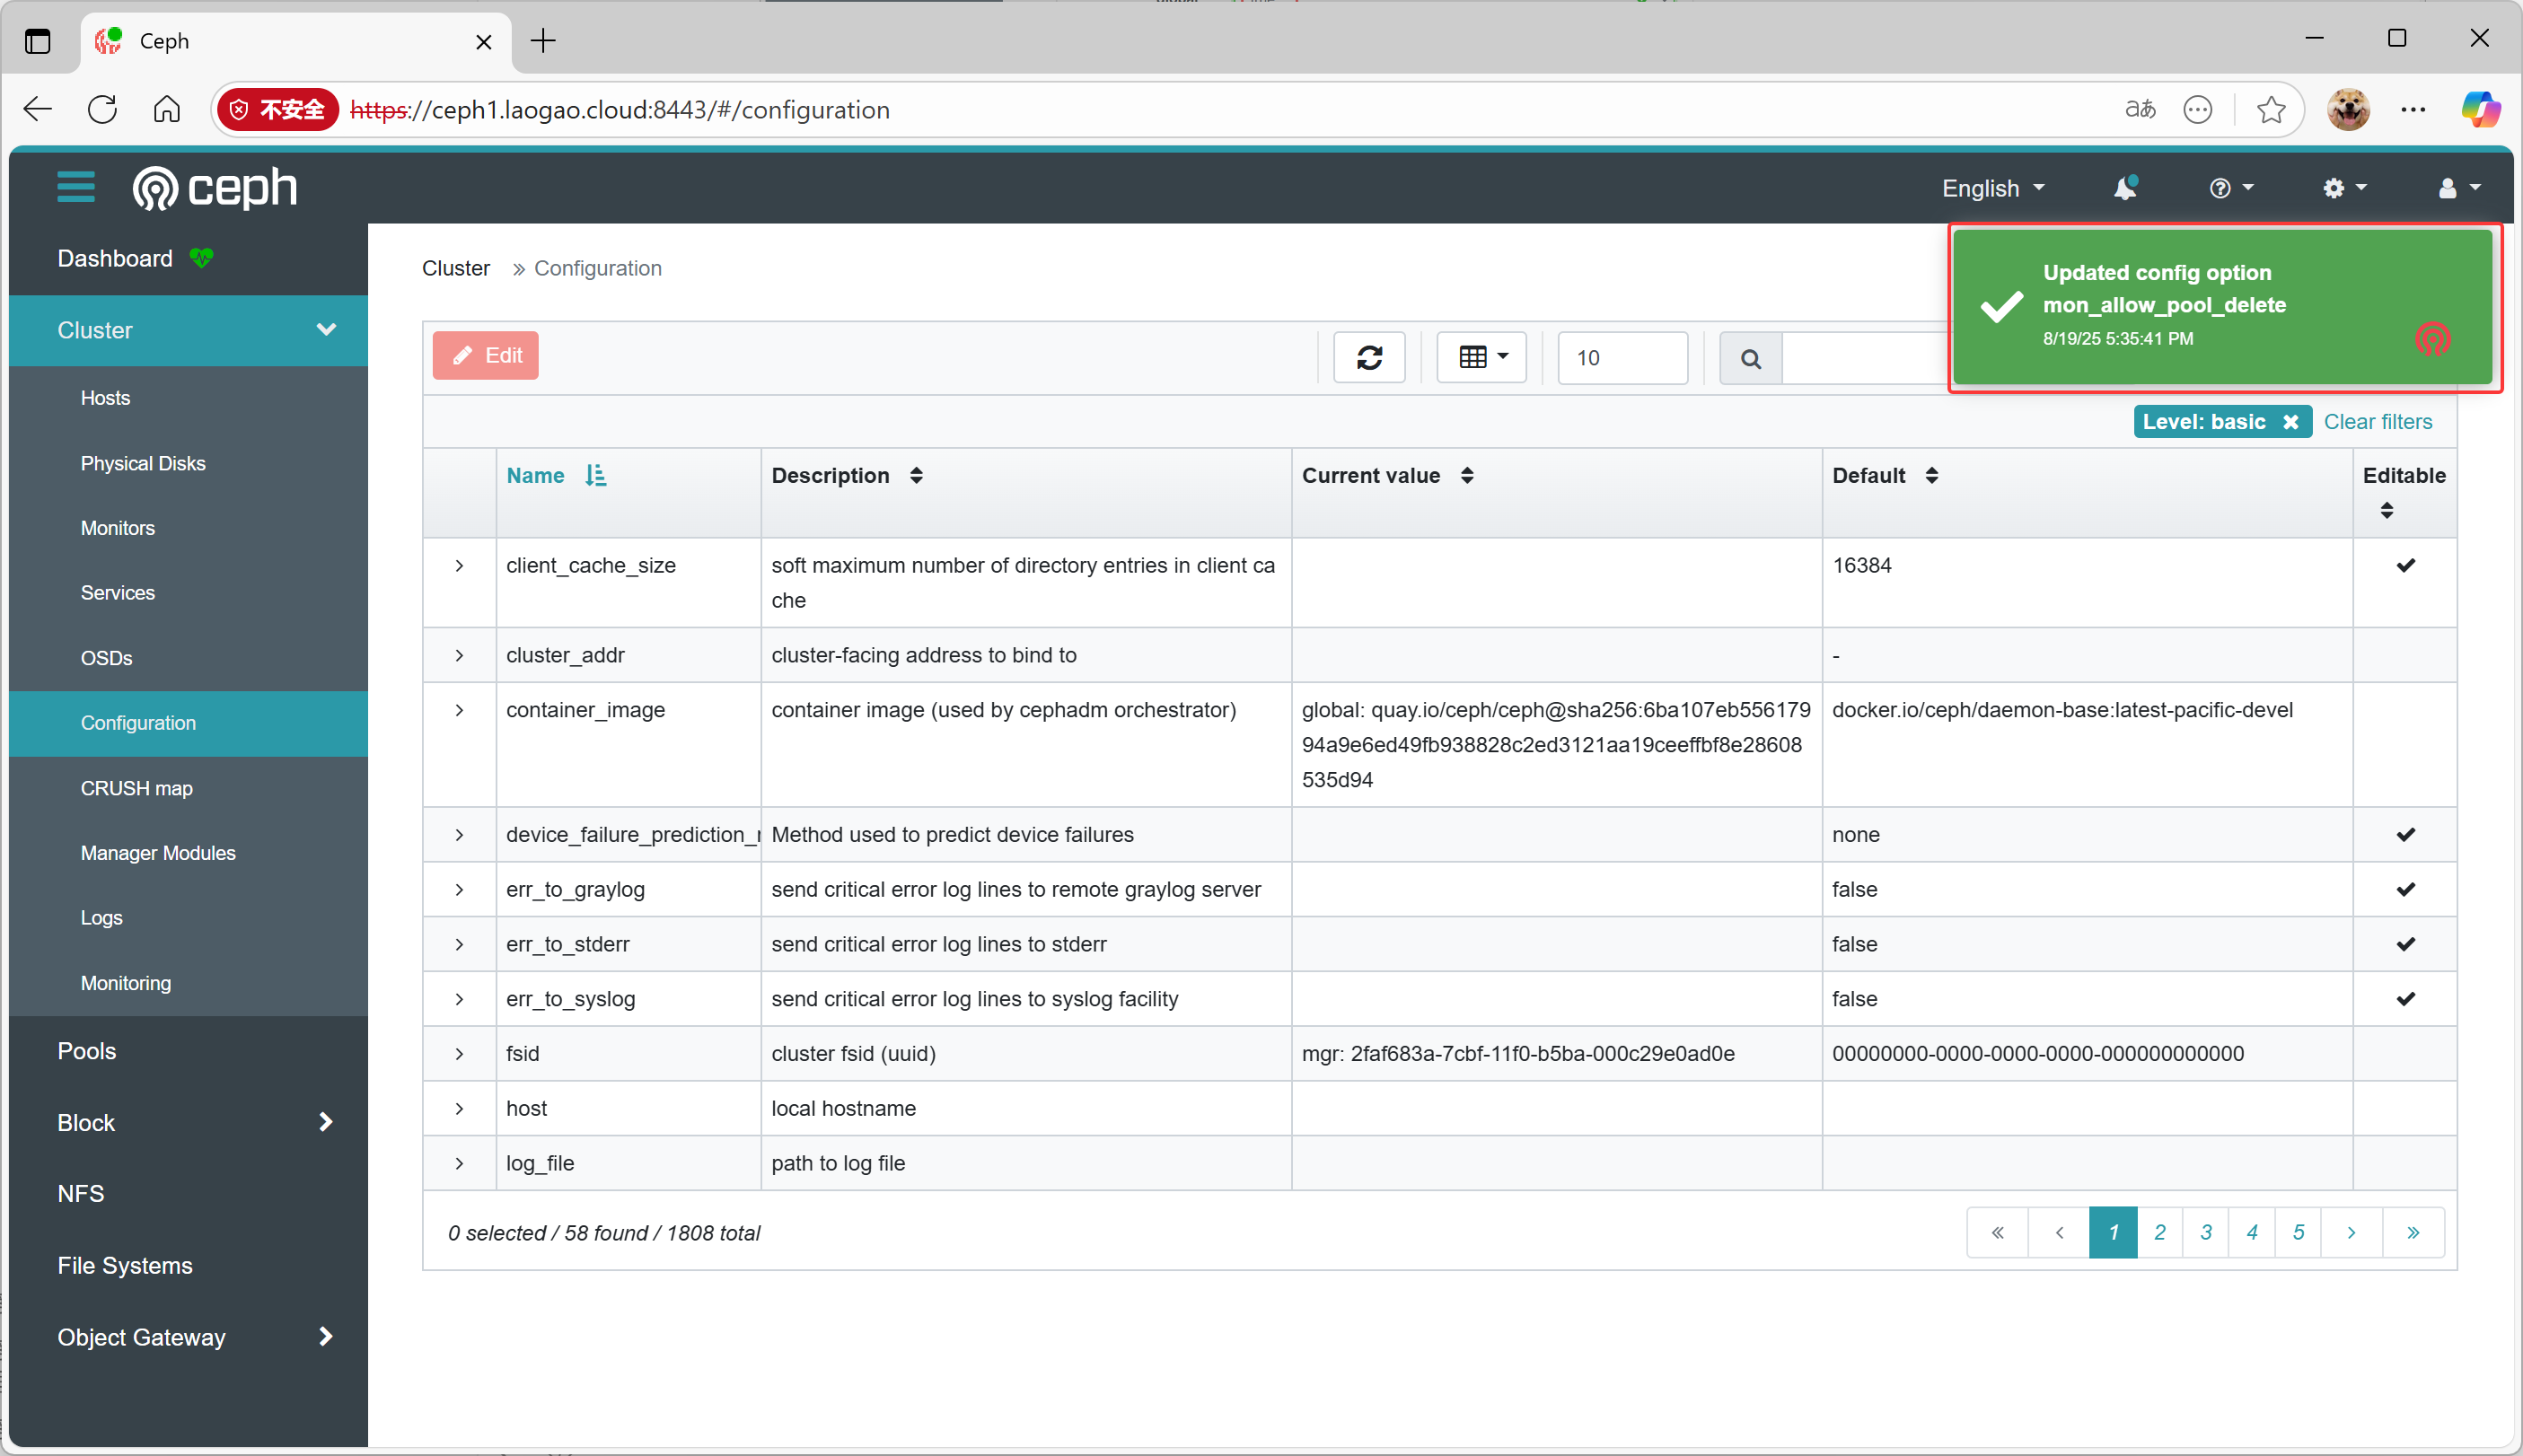
控制面板会显示一条消息,以确认新的设置。
配置集群监控器 Monitor
配置 Ceph 监控器
Ceph监控器(MON)存储和维护客户端用于查找MON和OSD节点的集群映射。Ceph客户端必须连接到MON以检索集群映射,然后才能读取或写入任何数据到OSD。因此,正确配置集群MON至关重要。
MON 采用 一种 Paxos 变体算法来选举领导者,在分布式计算机集之间达成一致。
各MON分别具有以下其中一个角色:
- Leader:第一个获得集群映射最新版本的 MON。
- Provider:拥有最新版本的集群映射,但不是 Leader 的 MON。
- Requester :没有最新版本的集群映射,必须先与 Provider 同步,然后才能重新加入仲裁的 MON。
**一旦有新的 MON 加入集群,便会进行同步。**每个 MON 都会定期检查相邻监控器是否已有更新版本的集群映射。如果相邻 MON 具有新版本的集群映射,则必须同步并获取相应集群映射。
**集群中的大多数 MON 必须处于运行状态,以建立仲裁。**例如,如果部署了五个 MON,则必须运行三个才能建立仲裁。**在生产 Ceph 集群中至少部署三个 MON 节点,以确保高可用性。**Ceph 支持在运行中的集群中添加或删除 MON。
集群配置文件 mon 块中 mon_host 定义 MON 主机 IP 地址(或 DNS 名称)和端口。cephadm 工具不会更新集群配置文件,可以通过第三方工具,例如rsync,让集群配置文件在集群节点之间保持同步的策略。
ini
[global]
        fsid = 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e
        mon_host = [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0] [v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0] [v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]
**重要:**在集群部署和运行期间,建议不要更改 MON 节点 IP 地址。
查看监控器仲裁
-
ceph status命令,检查 MON 仲裁状态。bash[root@ceph1 ~]# ceph status | grep mon mon: 3 daemons, quorum ceph1.laogao.cloud,ceph2,ceph3 (age 11m) -
ceph mon stat命令,检查 MON 仲裁状态。bash[root@ceph1 ceph]# ceph mon stat e3: 3 mons at {ceph1.laogao.cloud=[v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0], ceph2=[v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0], ceph3=[v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0]} removed_ranks: {}, election epoch 16, leader 0 ceph1.laogao.cloud, quorum 0,1,2 ceph1.laogao.cloud,ceph2,ceph3 -
ceph quorum_status -f json-pretty命令,友好的 json 格式输出 MON 仲裁状态。bash[root@ceph1 ~]# ceph quorum_status -f json-prettyjson{ "election_epoch": 16, "quorum": [ 0, 1, 2 ], "quorum_names": [ "ceph1.laogao.cloud", "ceph2", "ceph3" ], "quorum_leader_name": "ceph1.laogao.cloud", "quorum_age": 869, "features": { "quorum_con": "4540138314316775423", "quorum_mon": [ "kraken", "luminous", "mimic", "osdmap-prune", "nautilus", "octopus", "pacific", "elector-pinging" ] }, "monmap": { "epoch": 3, "fsid": "2faf683a-7cbf-11f0-b5ba-000c29e0ad0e", "modified": "2025-08-19T05:51:46.573105Z", "created": "2025-08-19T05:41:50.650957Z", "min_mon_release": 16, "min_mon_release_name": "pacific", "election_strategy": 1, "disallowed_leaders: ": "", "stretch_mode": false, "tiebreaker_mon": "", "removed_ranks: ": "", "features": { "persistent": [ "kraken", "luminous", "mimic", "osdmap-prune", "nautilus", "octopus", "pacific", "elector-pinging" ], "optional": [] }, "mons": [ { "rank": 0, "name": "ceph1.laogao.cloud", "public_addrs": { "addrvec": [ { "type": "v2", "addr": "192.168.108.11:3300", "nonce": 0 }, { "type": "v1", "addr": "192.168.108.11:6789", "nonce": 0 } ] }, "addr": "192.168.108.11:6789/0", "public_addr": "192.168.108.11:6789/0", "priority": 0, "weight": 0, "crush_location": "{}" }, { "rank": 1, "name": "ceph2", "public_addrs": { "addrvec": [ { "type": "v2", "addr": "192.168.108.12:3300", "nonce": 0 }, { "type": "v1", "addr": "192.168.108.12:6789", "nonce": 0 } ] }, "addr": "192.168.108.12:6789/0", "public_addr": "192.168.108.12:6789/0", "priority": 0, "weight": 0, "crush_location": "{}" }, { "rank": 2, "name": "ceph3", "public_addrs": { "addrvec": [ { "type": "v2", "addr": "192.168.108.13:3300", "nonce": 0 }, { "type": "v1", "addr": "192.168.108.13:6789", "nonce": 0 } ] }, "addr": "192.168.108.13:6789/0", "public_addr": "192.168.108.13:6789/0", "priority": 0, "weight": 0, "crush_location": "{}" } ] } } -
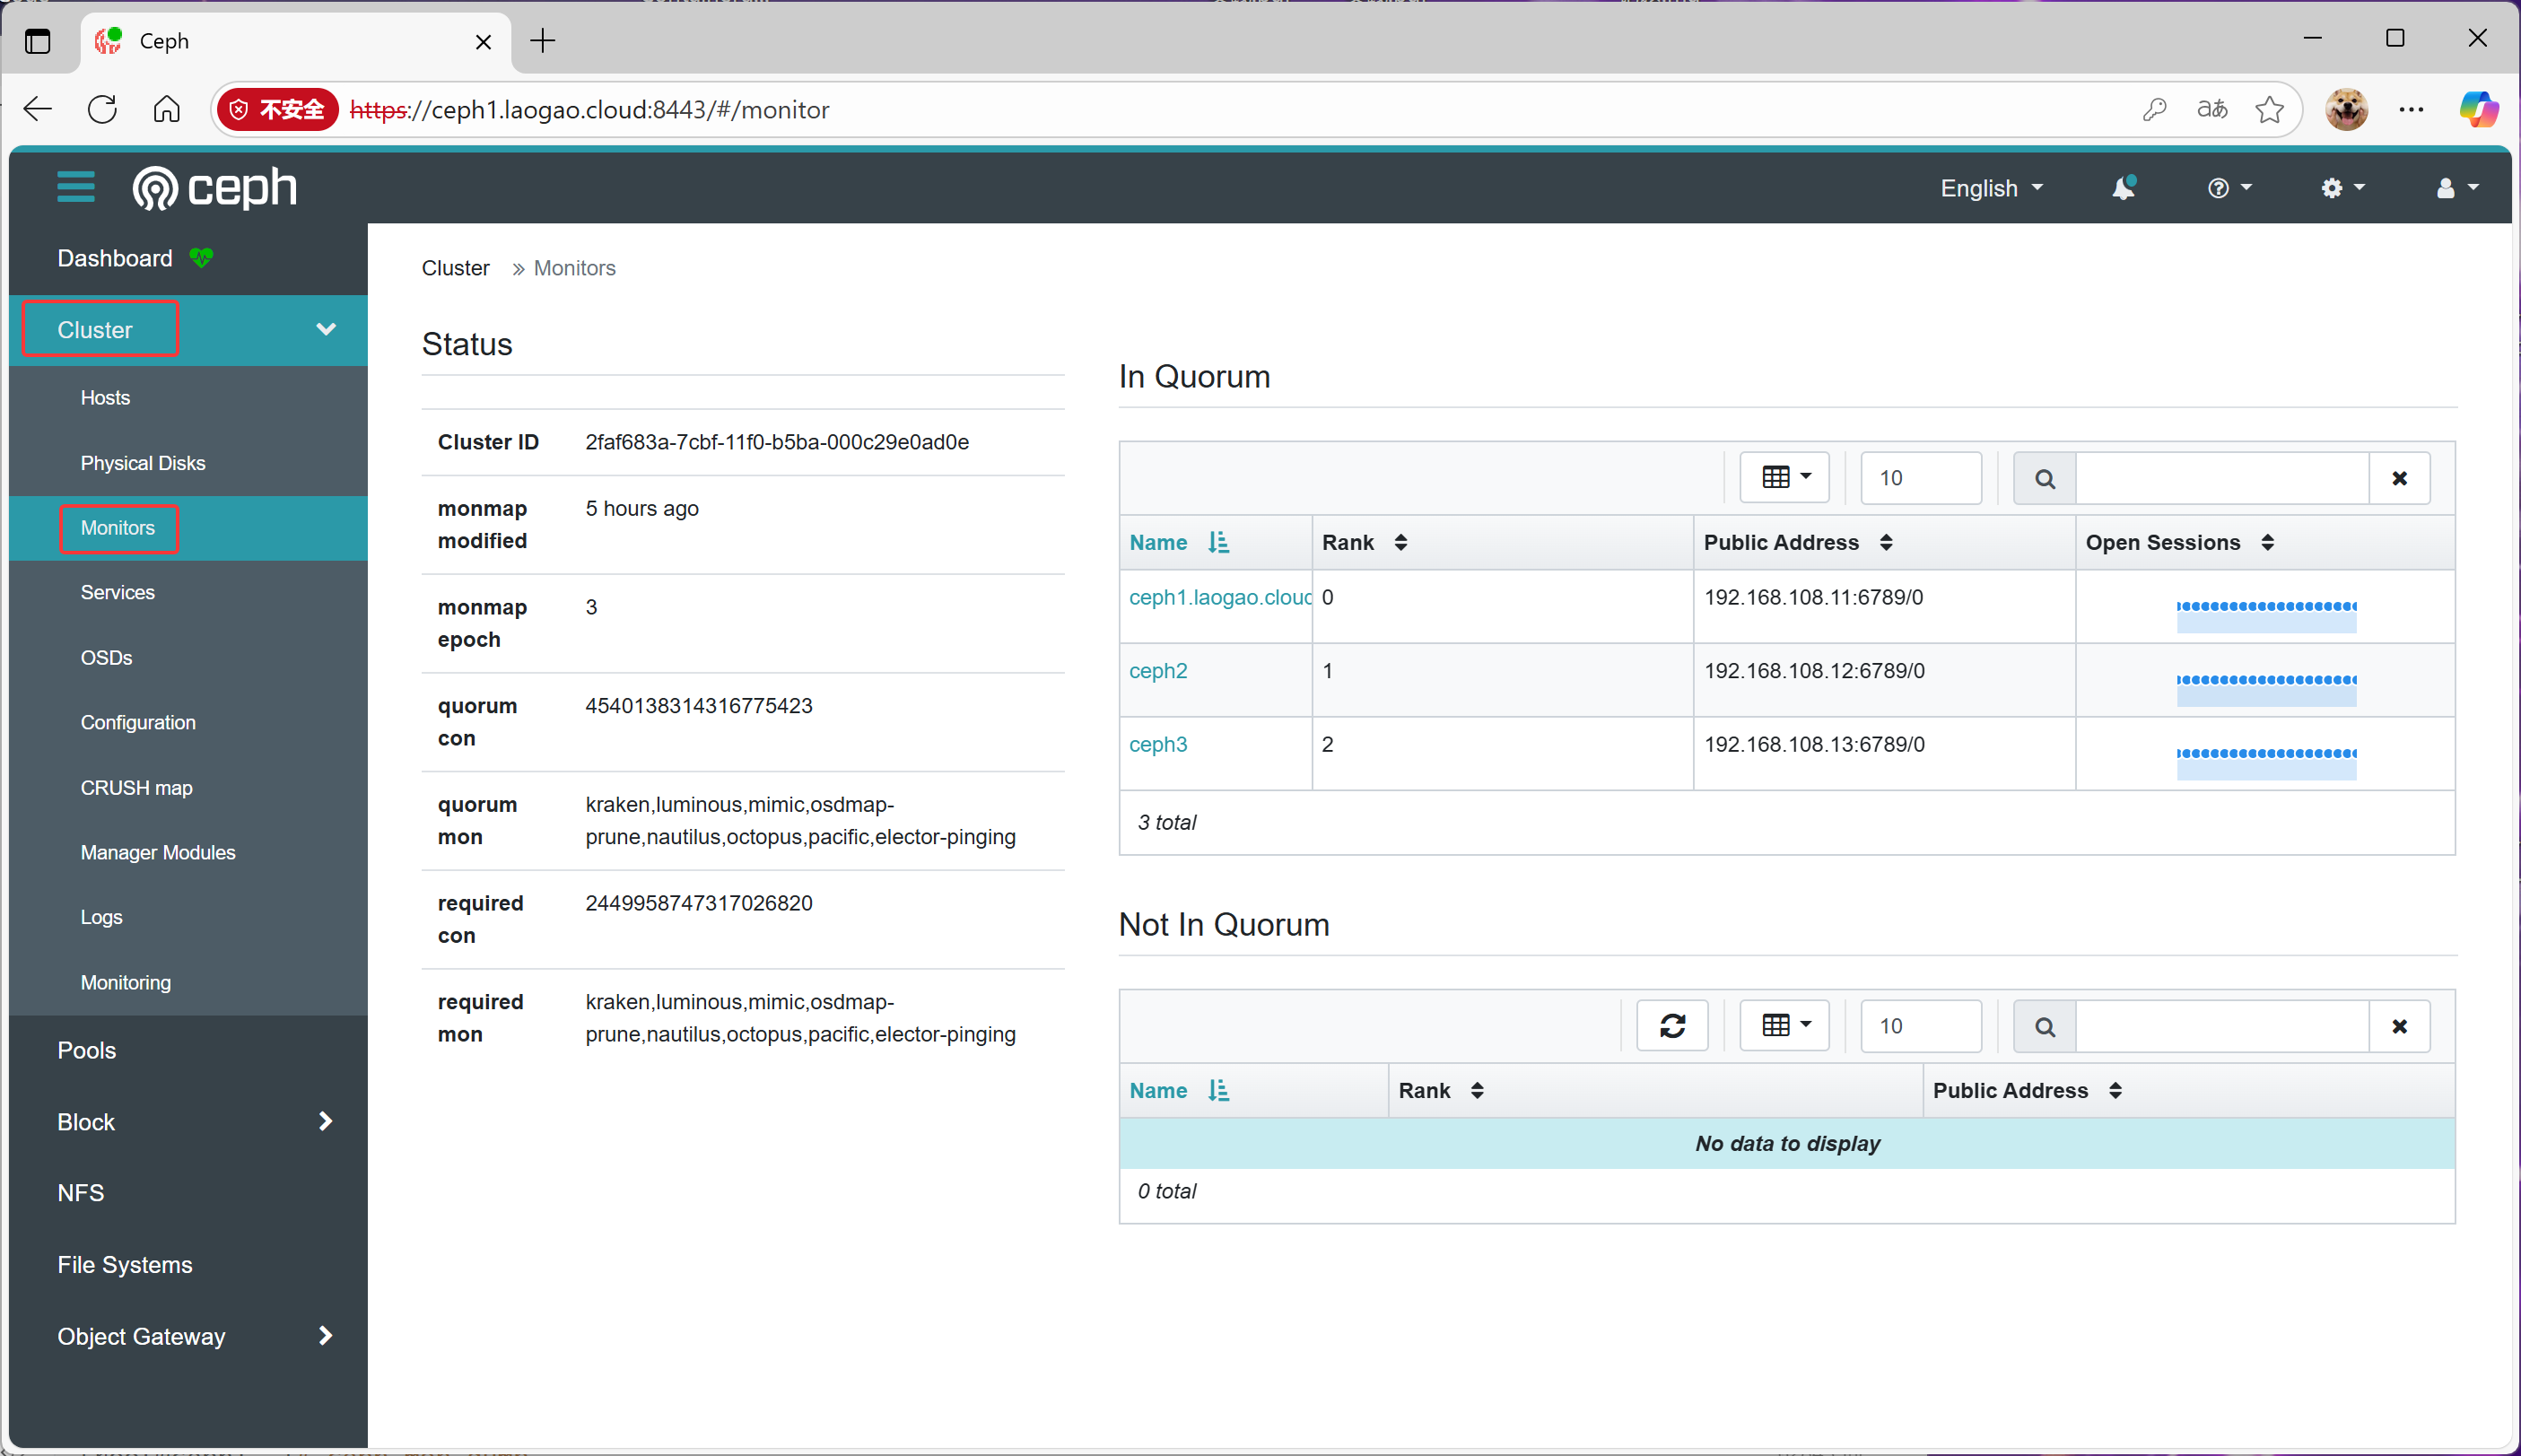
控制面板中查看 MON 的状态:单击Cluster > Monitor。
分析监控器映射
Ceph 集群映射包含:
- MON 映射
- OSD 映射
- PG 映射
- MDS 映射
- CRUSH 映射
MON 映射包含:
- 集群 fsid(文件系统 ID),fsid 是一种自动生成的唯一标识符 (UUID),用于标识 Ceph 集群。
- 各个 MON 节点通信的名称、IP 地址和网络端口。
- 映射版本信息,如 epoch 和最近一次更改时间。MON 节点通过同步更改并就当前版本达成一致来维护映射。
查看当前的 MON 映射
bash
[root@ceph1 ~]# ceph mon dump
epoch 3
fsid 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e            #集群fsid
last_changed 2025-08-19T05:51:46.573105+0000
created 2025-08-19T05:41:50.650957+0000
min_mon_release 16 (pacific)
election_strategy: 1
0: [v2:192.168.108.11:3300/0,v1:192.168.108.11:6789/0] mon.ceph1.laogao.cloud
1: [v2:192.168.108.12:3300/0,v1:192.168.108.12:6789/0] mon.ceph2
2: [v2:192.168.108.13:3300/0,v1:192.168.108.13:6789/0] mon.ceph3
dumped monmap epoch 3
管理集中配置数据库
MON 节点存储和维护集中配置数据库。数据库文件位于 MON 节点,默认位置是:
/var/lib/ceph/$fsid/mon.$host/store.db。
**注意:**不建议更改数据库的位置。
数据库文件会不断增大,改进措施:
-
运行
ceph tell mon.$id compact命令,整合数据库,以提高性能。bash[root@ceph1 ~]# ceph tell mon.ceph1.laogao.cloud compact -
将
mon_compact_on_start配置选项为 TRUE ,以便在每次守护进程启动时压缩数据库。bash[root@ceph1 ~]# ceph config set mon mon_compact_on_start true
设置以下数据库文件大小相关定义,以触发运行状况变化:
- mon_data_size_warn ,当配置数据库文件的大小超过此值时,集群运行状况更改为HEALTH_WARN 。默认值是15 (GB)。
- mon_data_avail_warn ,当包含配置数据库文件的文件系统剩余容量小于或等于此百分比时,将集群运行状况更改为 HEALTH_WARN 。默认值是30 (%)。
- mon_data_avail_crit ,当包含配置数据库的文件系统剩余容量小于或等于此百分比 时,将集群运行状况更改为 HEALTH_ERR 。默认值是5 (%)。
集群验证
Ceph 默认使用 Cephx 协议进行加密身份验证,同时使用共享密钥进行身份验证。默认情况下,Ceph 会启用 Cephx。如有必要,可以禁用 Cephx,但不建议这样做,因为这样会减弱集群的安全性。
使用 ceph config set 命令启用或禁用 Cephx 协议。
bash
[root@ceph1 ~]# ceph config get mon auth_service_required
cephx
[root@ceph1 ~]# ceph config get mon auth_cluster_required
cephx
[root@ceph1 ~]# ceph config get mon auth_client_required
cephx, none
参数说明:
- auth_service_required ,客户端与Ceph services之间通信认证。可用值
cephx和none。 - auth_cluster_required ,Ceph集群守护进程之间通信认证,例如
ceph-mon,ceph-osd,ceph-mds,ceph-mgr。可用值cephx和none。 - auth_client_required ,客户端与Ceph集群之间通信认证。可用值
cephx和none。
官方原话:If this configuration setting is enabled, then Ceph clients can access Ceph services only if those clients authenticate with the Ceph Storage Cluster. Valid settings are
cephxornone.
cephadm 工具创建 client.admin 用户,让用户能够运行管理命令并创建其他 Ceph 客户端用户帐户,用户密钥环存储在 /etc/ceph 目录中。
bash
[root@ceph1 ~]# ls /etc/ceph
ceph.client.admin.keyring  ceph.conf  ceph.pub  rbdmap
守护进程数据目录包含 Cephx 密钥环文件。对于 MON,密钥环文件是:
/var/lib/ceph/fsid/mon.fsid/mon.fsid/mon.host/keyring。
bash
[root@ceph1 ~]# ls /var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring
/var/lib/ceph/2faf683a-7cbf-11f0-b5ba-000c29e0ad0e/mon.ceph1.laogao.cloud/keyring
**密钥环文件以纯文本形式存储机密密钥。**务必使用合适的 Linux 文件权限来保护它们的安全。
使用ceph auth命令创建、查看和管理集群
使用 ceph-authtool 命令创建密钥环文件。
示例:为 MON 节点创建一个密钥环文件。
bash
[root@ceph1 ~]# ceph-authtool --create-keyring /tmp/ceph.mon.keyring --gen-key -n mon. --cap mon 'allow *'
creating /tmp/ceph.mon.keyring

# --create-keyring /tmp/ceph.mon.keyring
创建一个新的密钥环文件(Keyring),路径为 /tmp/ceph.mon.keyring。
# --gen-key -n mon.
生成一个新密钥(--gen-key)。
-n mon. 指定密钥关联的实体名称(Entity Name),这里是 mon.(表示 Monitor 守护进程)。
注意:实体名称通常以守护进程类型开头(如 mon.、osd.),后接节点标识符(如 mon.a)。
# --cap mon 'allow *'
为该密钥分配权限(Capabilities):
mon 表示权限作用于 Monitor 服务。
'allow *' 授予 所有 Monitor 操作的完全权限(如访问集群状态、修改配置等)。
cephadm 工具还会在**/etc/ceph目录中创建client.admin**用户,让您能够运行管理命令并创建其他Ceph客户端用户帐户。
配置集群网络-了解即可
配置公共网络和集群网络
public 网络是所有Ceph集群通信的默认网络。cephadm 工具假定第一个MON守护进程IP地址的网络是public 网络。新的MON守护进程部署在public网络中,除非您明确定义了不同的网络。
Ceph客户端通过集群的public 网络直接向OSD发送请求。OSD复制和恢复流量会使用public 网络,除非您为此配置了单独的cluster网络。
配置单独的cluster 网络可能会减少public网络的流量负载并与后端OSD运维流量进行客户端分流,从而提高集群的性能。
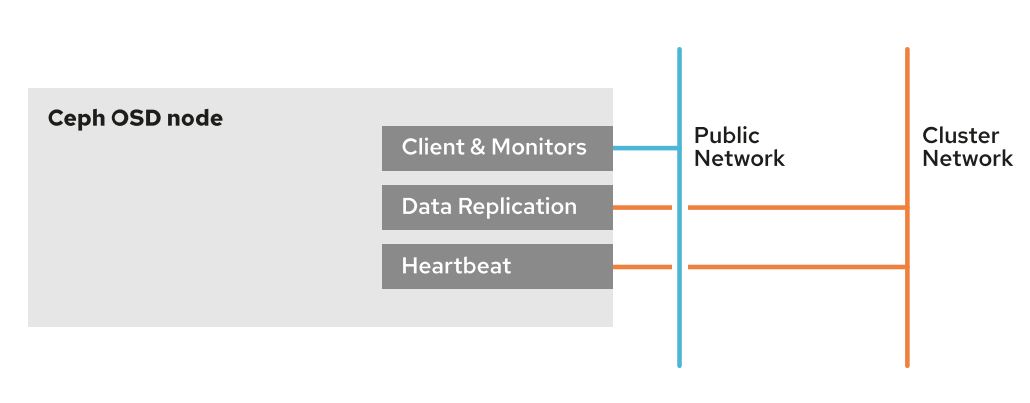
通过执行以下步骤,配置独立 cluster 网络的节点。
-
在每个集群节点上配置一个额外的网络接口。
-
在每个节点的新网络接口上配置适当的 cluster 网络 IP 地址。
-
cephadm bootstrap命令使用--cluster-network选项,在集群引导时定义 cluster网络。
Ceph 支持使用集群配置文件来设置 Public 网络和 Cluster 网络,还可以为每个网络配置多个子网,用逗号分隔。使用 CIDR 表示法表示子网,例如172.25.250.0/24。
ini
[global]
public_network = 192.168.108.0/24,192.168.109.0/24
cluster_network = 192.168.101.0/24
!IMPORTANT
如果为一个网络配置多个子网,这些子网必须能够互相路由。
还可以使用 ceph config set 命令设置 Public 和 cluster 网络。
配置单个守护进程
MON 守护进程需绑定到特定的 IP 地址,但 MGR、OSD 和 MDS 守护进程可绑定至任何可用的 IP 地址。在Ceph 存储 5 中,cephadm 使用 Public 网络执行大部分服务。若要处理 cephadm 部署新守护进程的位置,需先定义服务要使用的特定子网。只有在同一子网中有 IP 地址的主机可用于部署该服务。
将 192.168.108.0/24 子网设置为 MON 守护进程公共网络:
bash
# ceph config set mon public_network 192.168.108.0/24以上命令相当于在集群配置文件中做如下设置:
ini
[mon]
public_network = 192.168.108.0/24
使用 ceph orch daemon add 命令可将守护进程手动部署到特定子网或 IP 地址。
bash
# ceph orch daemon add mon cluster-host02:192.168.108.0/24!TIP
建议使用服务规范文件来管理 Ceph 集群,不建议使用运行时
ceph orch daemon命令更改配置。
运行 IPv6
默认情况下,集群 ms_bind_ipv4 设置的值是 TRUE ,而 ms_bind_ipv6 设置的值是FALSE。
bash
# ceph config get mon.ceph1.laogao.cloud ms_bind_ipv4
true
# ceph config get mon.ceph1.laogao.cloud ms_bind_ipv6
false
要将 Ceph 守护进程绑定至 IPv6 地址,需要:
-
将 ms_bind_ipv6 设置为 TRUE
-
将 ms_bind_ipv4 设置为 FALSE
同时绑定 public_network 和 cluster_network 为IPv6网络。
ini
[global]
public_network = <IPv6 public-network/netmask>
cluster_network = <IPv6 cluster-network/netmask>
启用巨型帧
配置网络 MTU 来支持巨型帧是存储网络中的推荐做法,可以提升性能。在 cluster 网络接口上配置 MTU 值 9000,以支持巨型帧。
!IMPORTANT
通信路径中的所有节点和网络设备必须具有相同的MTU值。对于绑定网络接口,在绑定接口上设置MTU值,基础接口将继承相同的MTU值。
配置网络安全
配置独立的 cluster 网络可以提高集群的安全性和可用性:
- 防止数据在 Public 网络上泄露。
- 减少 Public 网络上的攻击面。
- 防止针对集群某些类型的拒绝服务 (DoS) 攻击。
- 防止 OSD 之间的流量中断。当 OSD 之间的流量中断时,客户端会无法读取和写入数据。
确保流量不在 cluster 和 Public 网络之间路由,以保护后端 cluster 网络。
配置防火墙规则
Ceph OSD 和 MDS 守护进程默认绑定到 6800 到 7300 之间的 TCP 端口。若要配置不同的范围,需更改 ms_bind_port_min 和 ms_bind_port_max 设置。
下表列出了Ceph 存储 5 的默认端口。
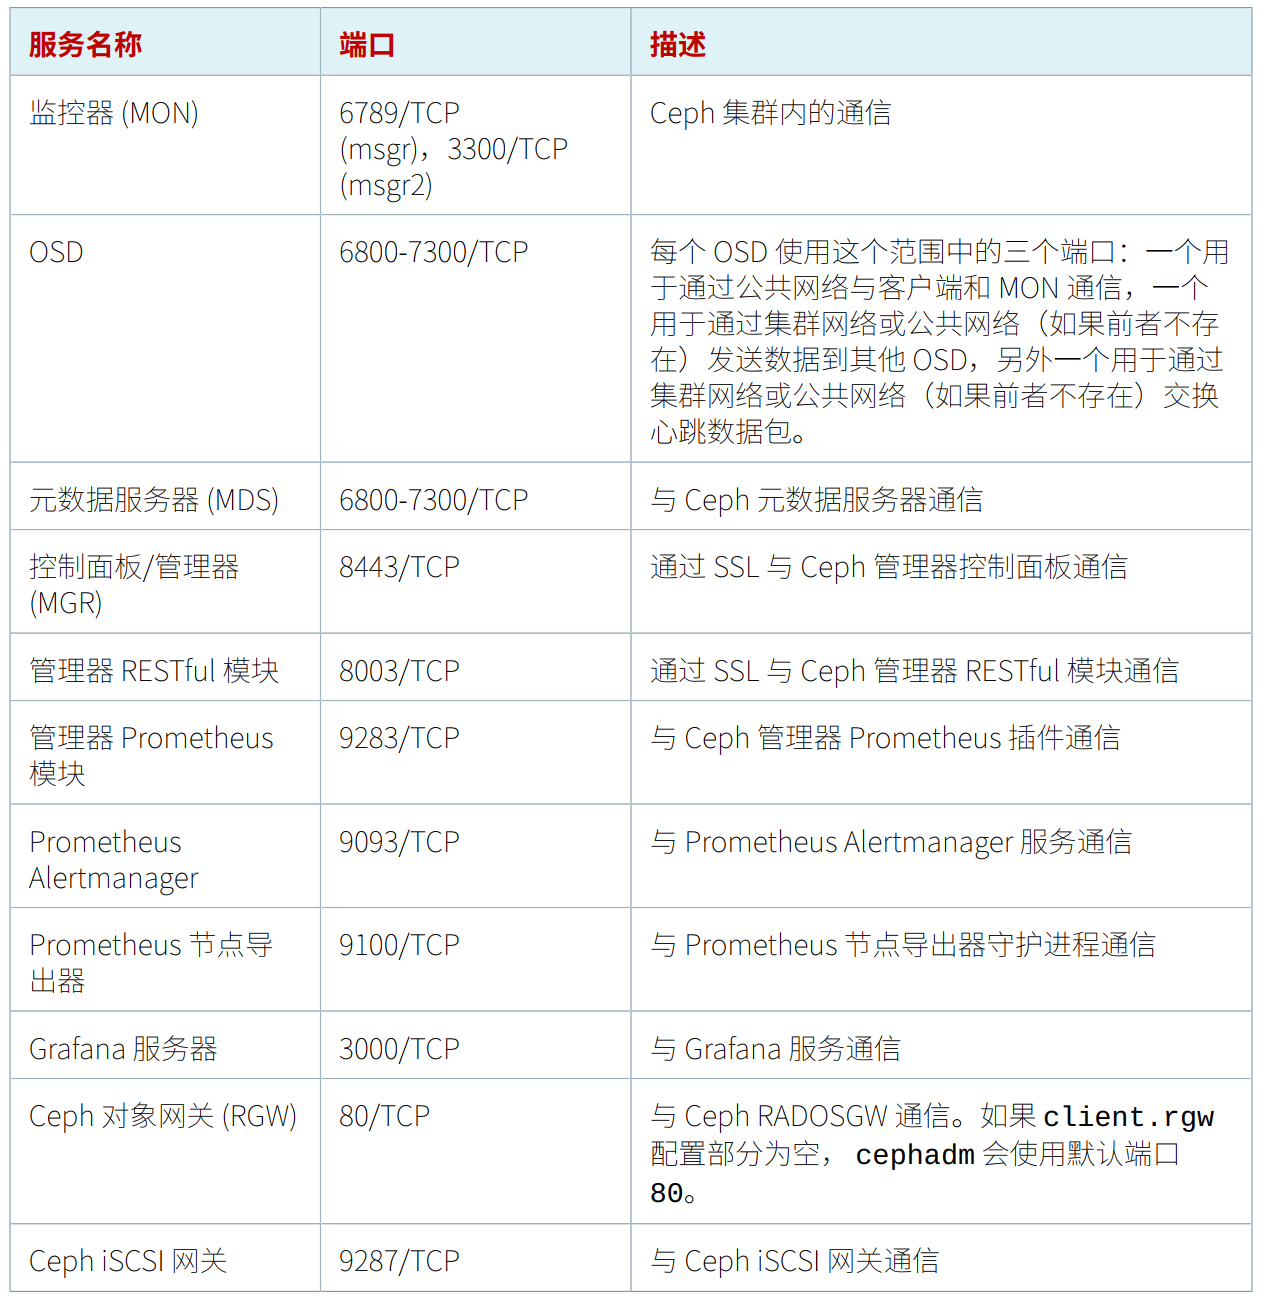
若要使用防火墙保护 MON 节点,需使用 Public 接口和 Public 网络 IP 地址来配置规则。
bash
# firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp
# firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp --permanent
还可通过添加 ceph-mon 服务至防火墙规则来保护 MON 节点。
bash
# firewall-cmd --zone=Public --add-service=ceph-mon
# firewall-cmd --zone=Public --add-service=ceph-mon --permanent
若要配置 cluster 网络,防火墙需要配置 Public 和 cluster 网络规则。客户端通过使用公共网络连接到 OSD,OSD 通过集群网络互相通信。
若要使用防火墙规则保护 OSD 节点,执行以下命令:
bash
# firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp
# firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp --permanent
还可通过添加 ceph 服务至防火墙规则来保护 OSD 节点。
bash
# firewall-cmd --zone=<public-or-cluster> --add-service=ceph
# firewall-cmd --zone=<public-or-cluster> --add-service=ceph --permanent