一、背景:为什么这次把开源时序库放进 POC 名单
团队负责的设备数据平台走到第三年,测点数从五位数涨到了七位数,最初"先存下来再说"的方案开始力不从心:高频测点的磁盘账算不下去,分析任务排队越来越长。于是决定认真做一轮时序数据库 POC。
圈定候选时先看了一圈国外产品,得到的观察比较一致:主流产品的迭代重心明显偏向云托管服务,社区版与商业版的能力边界在持续调整,个别产品还发生过查询语言层面的推倒重来。这些对个人项目无所谓,但工业数据平台是按"跑十年"规划的基础设施,路线的确定性本身就是选型指标。这轮观察之后,我们把 Apache 基金会孵化的开源项目 IoTDB 加进了 POC 名单------Apache 治理意味着路线公开、社区中立,对长期演进的底座来说是个加分项。
下面按两周实测的时间线记录:建模、写入查询、大数据对接、边界摸底,最后落到选型清单。
二、第 1-3 天:数据建模------数据库说"现场的语言"
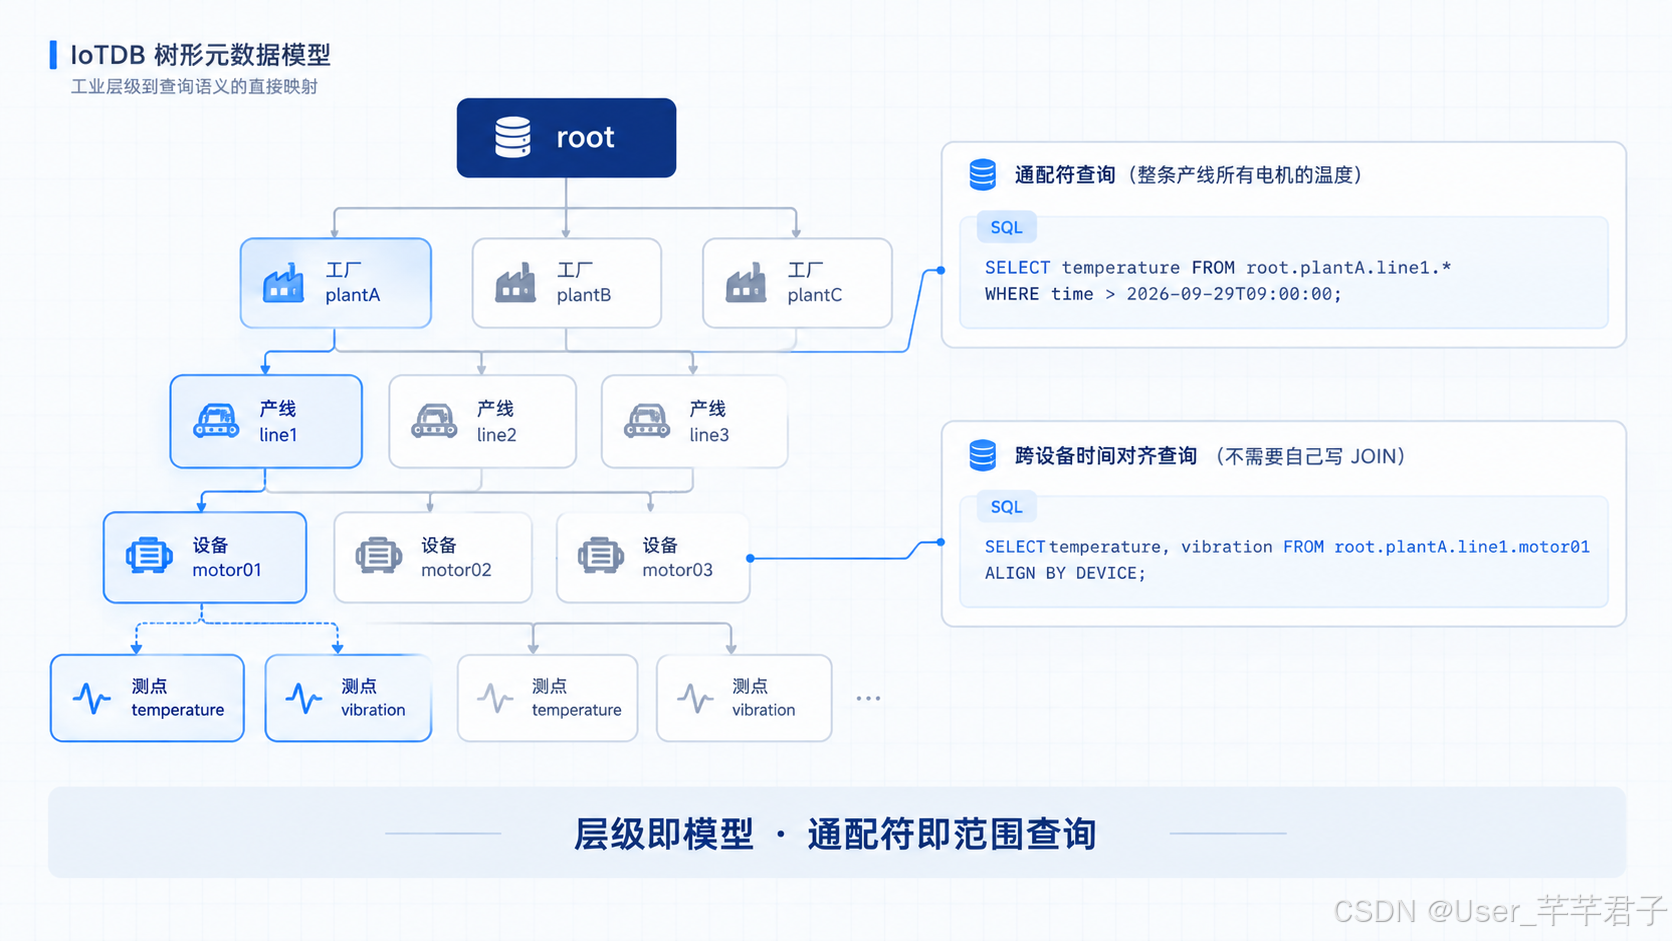
IoTDB 给我的第一印象是建模思路贴合工业现场。它默认用树形元数据模型,层级直接对应"集团---工厂---产线---设备---测点",而不需要先把设备关系硬塞进表结构。启动后用命令行就能开工:
sql
-- 建立存储组与时间序列(root 为根,逐级向下)
CREATE STORAGE GROUP root.plantA.line1;

CREATE TIMESERIES root.plantA.line1.motor01.temperature
    WITH DATATYPE=FLOAT, ENCODING=GORILLA, COMPRESSOR=SNAPPY;

CREATE TIMESERIES root.plantA.line1.motor01.vibration
    WITH DATATYPE=DOUBLE, ENCODING=GORILLA, COMPRESSOR=SNAPPY;

-- 写入一条数据:时间戳 + 测点值
INSERT INTO root.plantA.line1.motor01(timestamp, temperature, vibration)
VALUES (2026-09-29T10:00:00.000, 82.3, 0.417);
这段 DDL 有两个值得注意的细节:一是 ENCODING=GORILLA,针对时序数据的浮点编码,配合列式存储是它高压缩率的来源之一;二是通配符查询可以直接在元数据树上做模糊匹配:
sql
-- 通配符:一条 SQL 拉出整条产线所有电机的温度
SELECT temperature FROM root.plantA.line1.* WHERE time > 2026-09-29T09:00:00;

-- 跨设备时间对齐查询:不需要自己写 JOIN
SELECT temperature, vibration FROM root.plantA.line1.motor01
ALIGN BY DEVICE;
对写惯了关系库的工程师来说,类 SQL 语法基本零门槛;对自动化工程师来说,设备树的层级语义比"表+外键"直观得多。另外 1.x 版本引入了表模型(Table 模型)语义,同一套系统里两种建模并存------面向设备的监控视角用树,面向指标的分析视角用表,不用二选一。
三、第 4-8 天:写入与查询------边写边查和磁盘账
这一周做了三类实测:持续写入压测、边写边查、压缩比测算。环境是 3 台 16C/64GB 的普通虚机,数据形状取自现场最典型的两路------1Hz 温度与 10kHz 振动截断特征值。
先看查询侧,最常用的是降采样聚合(连续查询也可以由系统周期性自动执行):
sql
-- 按天降采样取最大值:长期趋势分析的日常写法
SELECT max_value(temperature), avg(vibration)
FROM root.plantA.line1.motor01
GROUP BY ([2026-09-01, 2026-09-29), 1d);

-- 最近值查询:监控大屏的状态点查
SELECT last_value(temperature)
FROM root.plantA.line1.motor01;
两周下来整理的实测记录(同一负载、同一数据集下的自测数字,仅供参考量级):
| 实测项 | 测试条件 | 结果(量级参考) |
|---|---|---|
| 持续写入 | 3 节点集群,百万级测点模拟 | 千万点/秒量级写入,资源曲线平稳 |
| 边写边查 | 写入洪流中并发状态点查 | 点查延迟稳定在百毫秒以内 |
| 压缩比 | 1kHz 振动 + 1Hz 温度,7 天数据 | 相对原始 CSV 约一个数量级的缩减 |
| 断网续传 | 边缘侧拔网线 10 分钟 | 恢复后数据自动补齐,无缺口 |
两点主观感受:一是磁盘账 ------TsFile 列式存储加专门编码,让"高频数据留三年"从预算问题变成了可选项;二是边写边查的表现,监控点查没有因为写入洪流出现明显劣化,这对 7×24 的设备看板是刚需。
四、第 9-11 天:生态对接------不重构既有大数据体系
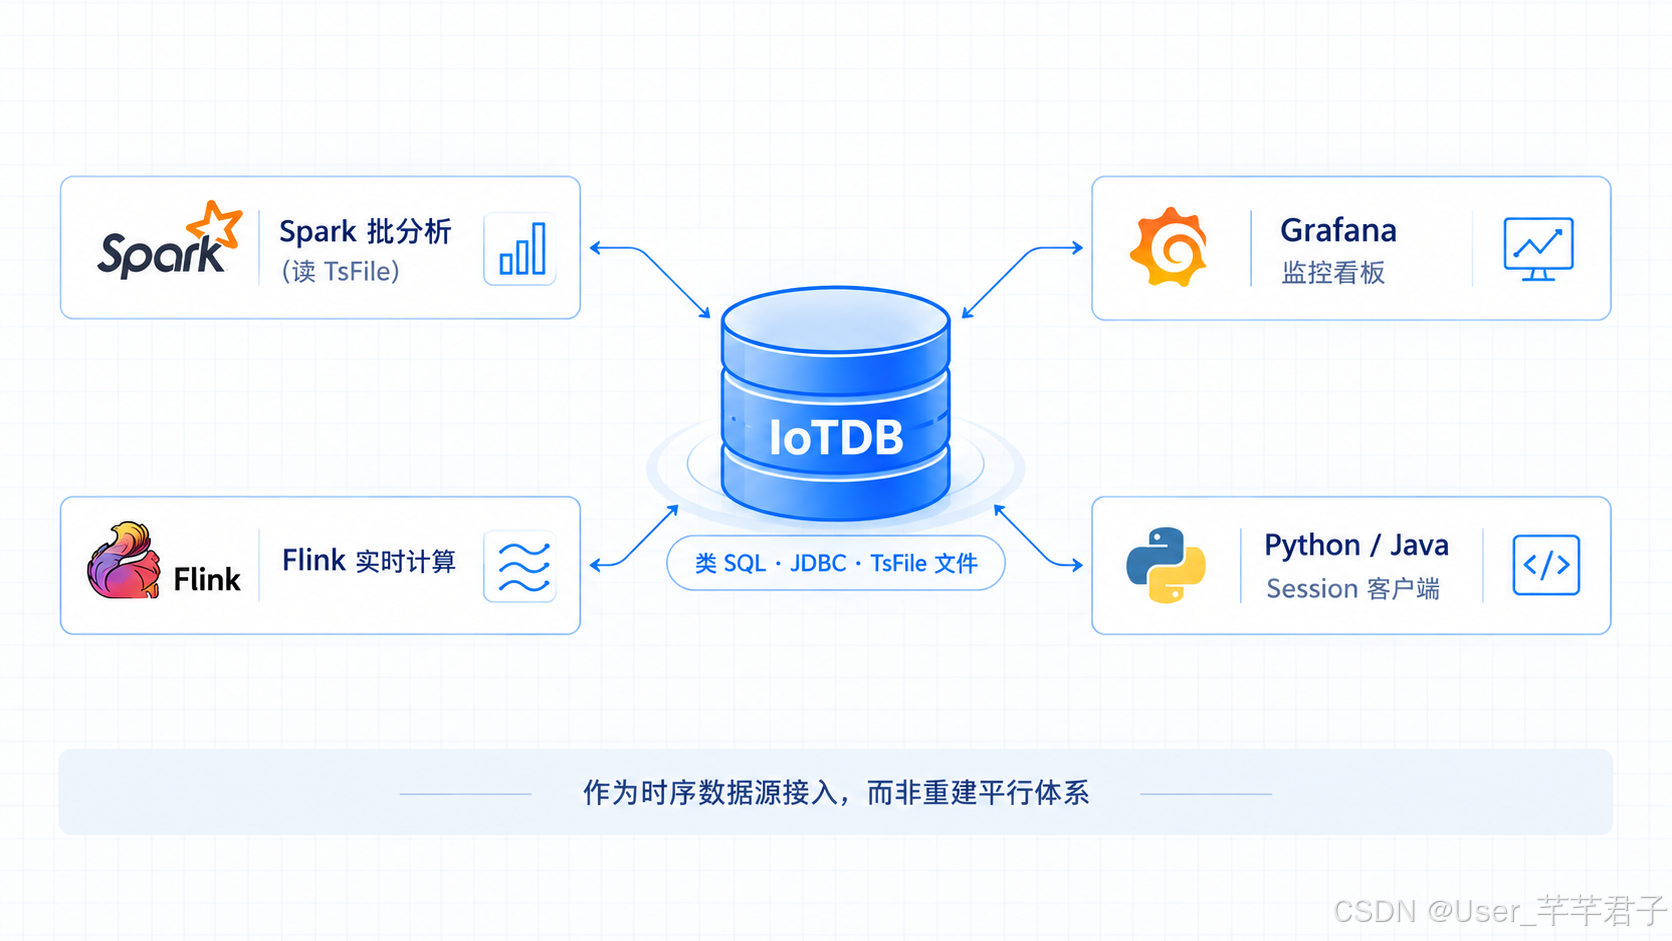
第三周的前半段,验证最关心的问题:能不能不动现有 Spark/Flink 分析栈。答案基本是"能"。IoTDB 对外暴露 JDBC 接口和类 SQL 语言,同时提供 TsFile 的 Spark 连接器------TsFile 文件本身可以直接当 Spark 数据源读:
scala
// Spark 直接读取 TsFile,作为 DataFrame 参与既有批任务
val df = spark.read
  .format("tsfile")
  .option("path", "hdfs://nn/iotdb/data/root.plantA")
  .load()

df.select("time", "root.plantA.line1.motor01.temperature")
  .filter($"time" > lit("2026-09-01"))
  .groupBy(window($"time", "1 hour"))
  .agg(avg("temperature"))
应用侧的写入也不必走 SQL 拼接,各语言 Session 客户端直接操作(以 Python 为例):
python
from iotdb.session import Session

session = Session("127.0.0.1", 6667, "root", "iotdb")
session.open(False)

# 批量写入:比单条 INSERT 高效得多的生产姿势
session.insert_records_of_one_device(
    device_id="root.plantA.line1.motor01",
    measurements=[["temperature", "vibration"]],
    values=[[82.3, 0.417]],
    timestamps=[1759130400000],
)
此外 Grafana 有官方数据源插件,监控大屏对接是配置工作而不是开发工作。这一周的结论:IoTDB 在大数据体系里的定位是"原生公民"------作为时序数据源接入既有架构,而不是要求围绕它重建一套平行体系。对存量团队,这一点比任何单点性能都重要。
五、第 12-14 天:边界摸底------什么场景我不会选它
POC 的最后一项是给"不选"找理由,这比给"选"找理由更重要。实测下来记录几条真实局限:
- 深度分析的函数广度有限。 常用的聚合、降采样、对齐查询都有,但涉及复杂信号处理(如频谱细化、多频数据对齐)时,需要走 UDF 自己写,或者导出到 Spark 做------好在第四章的对接路径让"导出"这条路不疼,但工程师要有预期。
- 企业级能力要看清版本边界。 Apache 社区版完全开源可用,但高可用集群运维、权限管理工具、原厂 SLA 这类能力集中在企业版(天谋科技 Timecho)。自运维能力强的团队用社区版没问题;没有专职 DBA 的团队,建议把企业版的采购评估提前到 POC 阶段一起看。
- 互联网侧的纯指标监控不是它的主场。 如果场景是"应用指标 + 日志型监控",没有设备层级、没有边缘侧诉求,云原生监控栈同样成立,不必为了"时序数据库"这个标签强行引入。
| 场景 | 判断 | 依据 |
|---|---|---|
| 强工业现场(电力/轨交/制造) | 适合 | 树形模型贴合现场层级,端边云协同、断网续传按现场条件设计 |
| 海量高频原始数据长期留存 | 适合 | TsFile 列式高压缩直接改善磁盘账 |
| 既有 Spark/Flink 分析栈 | 适合 | JDBC/连接器齐全,接入成本低 |
| 深度信号分析为主 | 谨慎 | 关键函数可能要 UDF/导出补位 |
| 无专职运维团队 | 谨慎 | 需评估企业版边界与服务 |
| 互联网指标/日志监控 | 不必要 | 无边缘与设备层级诉求,监控栈足够 |
六、选型清单:四道必答题
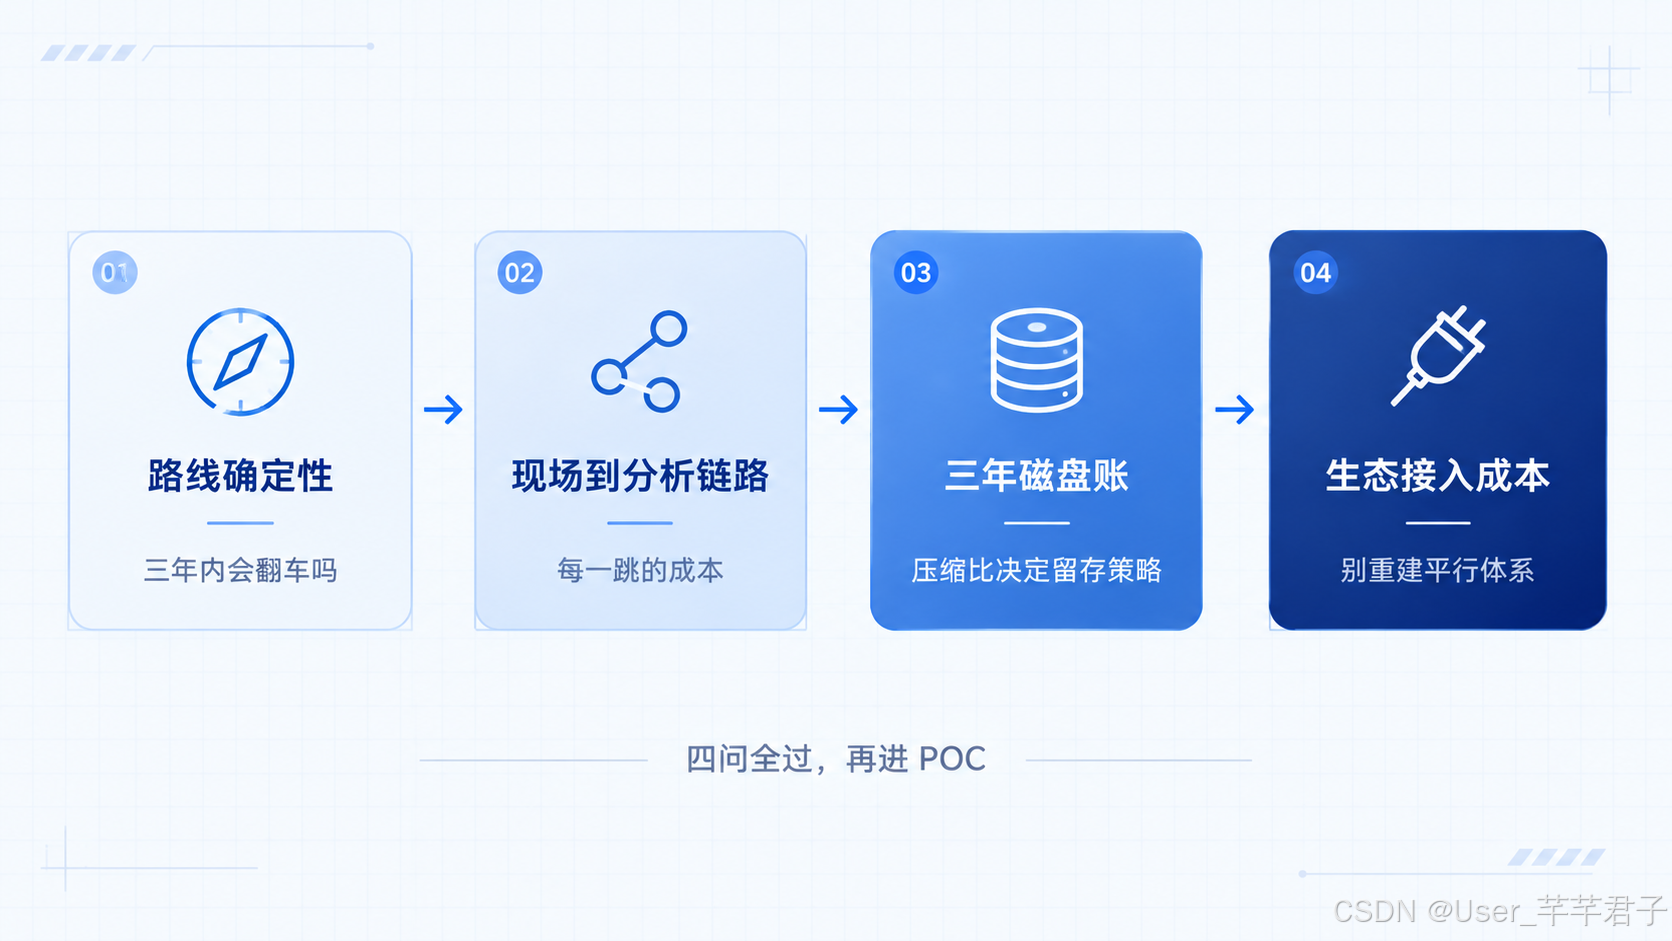
把两周的记录收敛成可以带进评审会的四道题,适用于任何时序数据库候选:
- 路线确定性:项目近三年有没有推翻自身的大版本重写?治理机构是否中立开源?
- 现场到分析的链路:画出设备侧到分析侧的完整数据流,标注每一跳的协议转换、断网缓存与带宽成本。
- 三年磁盘账:拿最典型的一路高频数据测算压缩比与三年存储成本。
- 生态接入成本:列出当前分析栈,逐项验证连接器与接口,"要重建平行体系"的方案直接减分。
结语
两周下来,IoTDB 在这次 POC 里通过了我最看重的几关:建模语言贴近工业现场、磁盘账算得下去、既有大数据体系不用重构。它的边界也清楚:深度分析要自己补位,企业级服务要看清版本边界。 选型这件事没有银弹,本文的所有数字都来自特定环境下的自测。如果你的团队也在做类似评估,建议直接到
https://iotdb.apache.org/zh/Download/ 拉最新版本,把自家最典型的一路数据灌进去跑两周------判断会自然浮现;需要企业级 SLA 与原厂支持的场景,可以在 https://timecho.com做进一步评估。