风控规则为何越来越难由开发独担
风控规则已脱离'一次性编码'范式。监管调整、策略迭代常以小时/天为单位发生,而传统基于代码的规则交付需经历需求评审→开发→测试→发布→服务重启,平均耗时3~5个工作日。当业务要求'今晚上线新反欺诈阈值'时,开发面对的是散落各模块的if-else逻辑、未版本化的Excel策略表,以及难以复现的生产判断路径。
更深层问题是知识结构错位:风控策略的专业性体现在对客户行为、风险信号、监管语义的动态理解;而开发需反复消化业务语义才能转化为DRL或Java代码,知识同步滞后易导致规则偏差。同类判断(如黑名单校验、负债率计算)在信贷、反洗钱、运营系统中被重复实现,形成'规则孤岛',抬高维护成本,加剧口径不一致与审计盲区。
这种失配本质是组织能力与技术载体脱节------规则已是驱动业务增长与风险平衡的核心资产,而非技术附属品。
Drools的强技术性如何抬高协作门槛
Drools在Java生态中具备强大执行能力,但其技术底色天然抬高金融组织协作门槛:
- 规则编写者必须熟悉DRL语法、Spring集成及KIE工作流,业务人员无法直接查看、修改或验证规则;
- 所有变更均需经'业务提需求→开发写规则→测试跑案例→上线看效果'长链路;
- Drools本身不提供开箱即用的可视化配置界面、多级权限管理、节点级执行日志、标准化API封装或异常分级路由能力。
金融机构若选用Drools,需自建整套运维体系,包括:
- 规则仓库与版本管理
- 在线调试台与灰度发布能力
- 执行监控告警与日志追踪
- 数据源中心与版本比对工具
这些投入不仅消耗IT资源,更使规则能力深陷技术栈依赖,难以响应业务变化。Drools的'强执行'并未自然转化为'快交付'------隐性成本在于人力协同损耗、环境迁移风险与审计就绪延迟。
JVS-Rules如何重构技术-业务分工边界
JVS-Rules通过三重解耦重构分工边界:
- 决策编排与变量供给分离
- 规则配置与代码实现分离
- 能力沉淀与系统耦合分离
业务人员使用拖拽式决策流、结构化决策表与评分卡表达判断逻辑;技术人员专注对接数据源、封装函数、提供基础变量。双方在各自专业域内协作,无需彼此'翻译'。
函数计算器采用类Excel公式语法,支持业务人员自主完成如下衍生变量加工:
- 负债率计算
- 逾期次数聚合
- 收入稳定性评分
显著降低对开发的依赖。
JVS-Rules将规则升维为组织级资产:
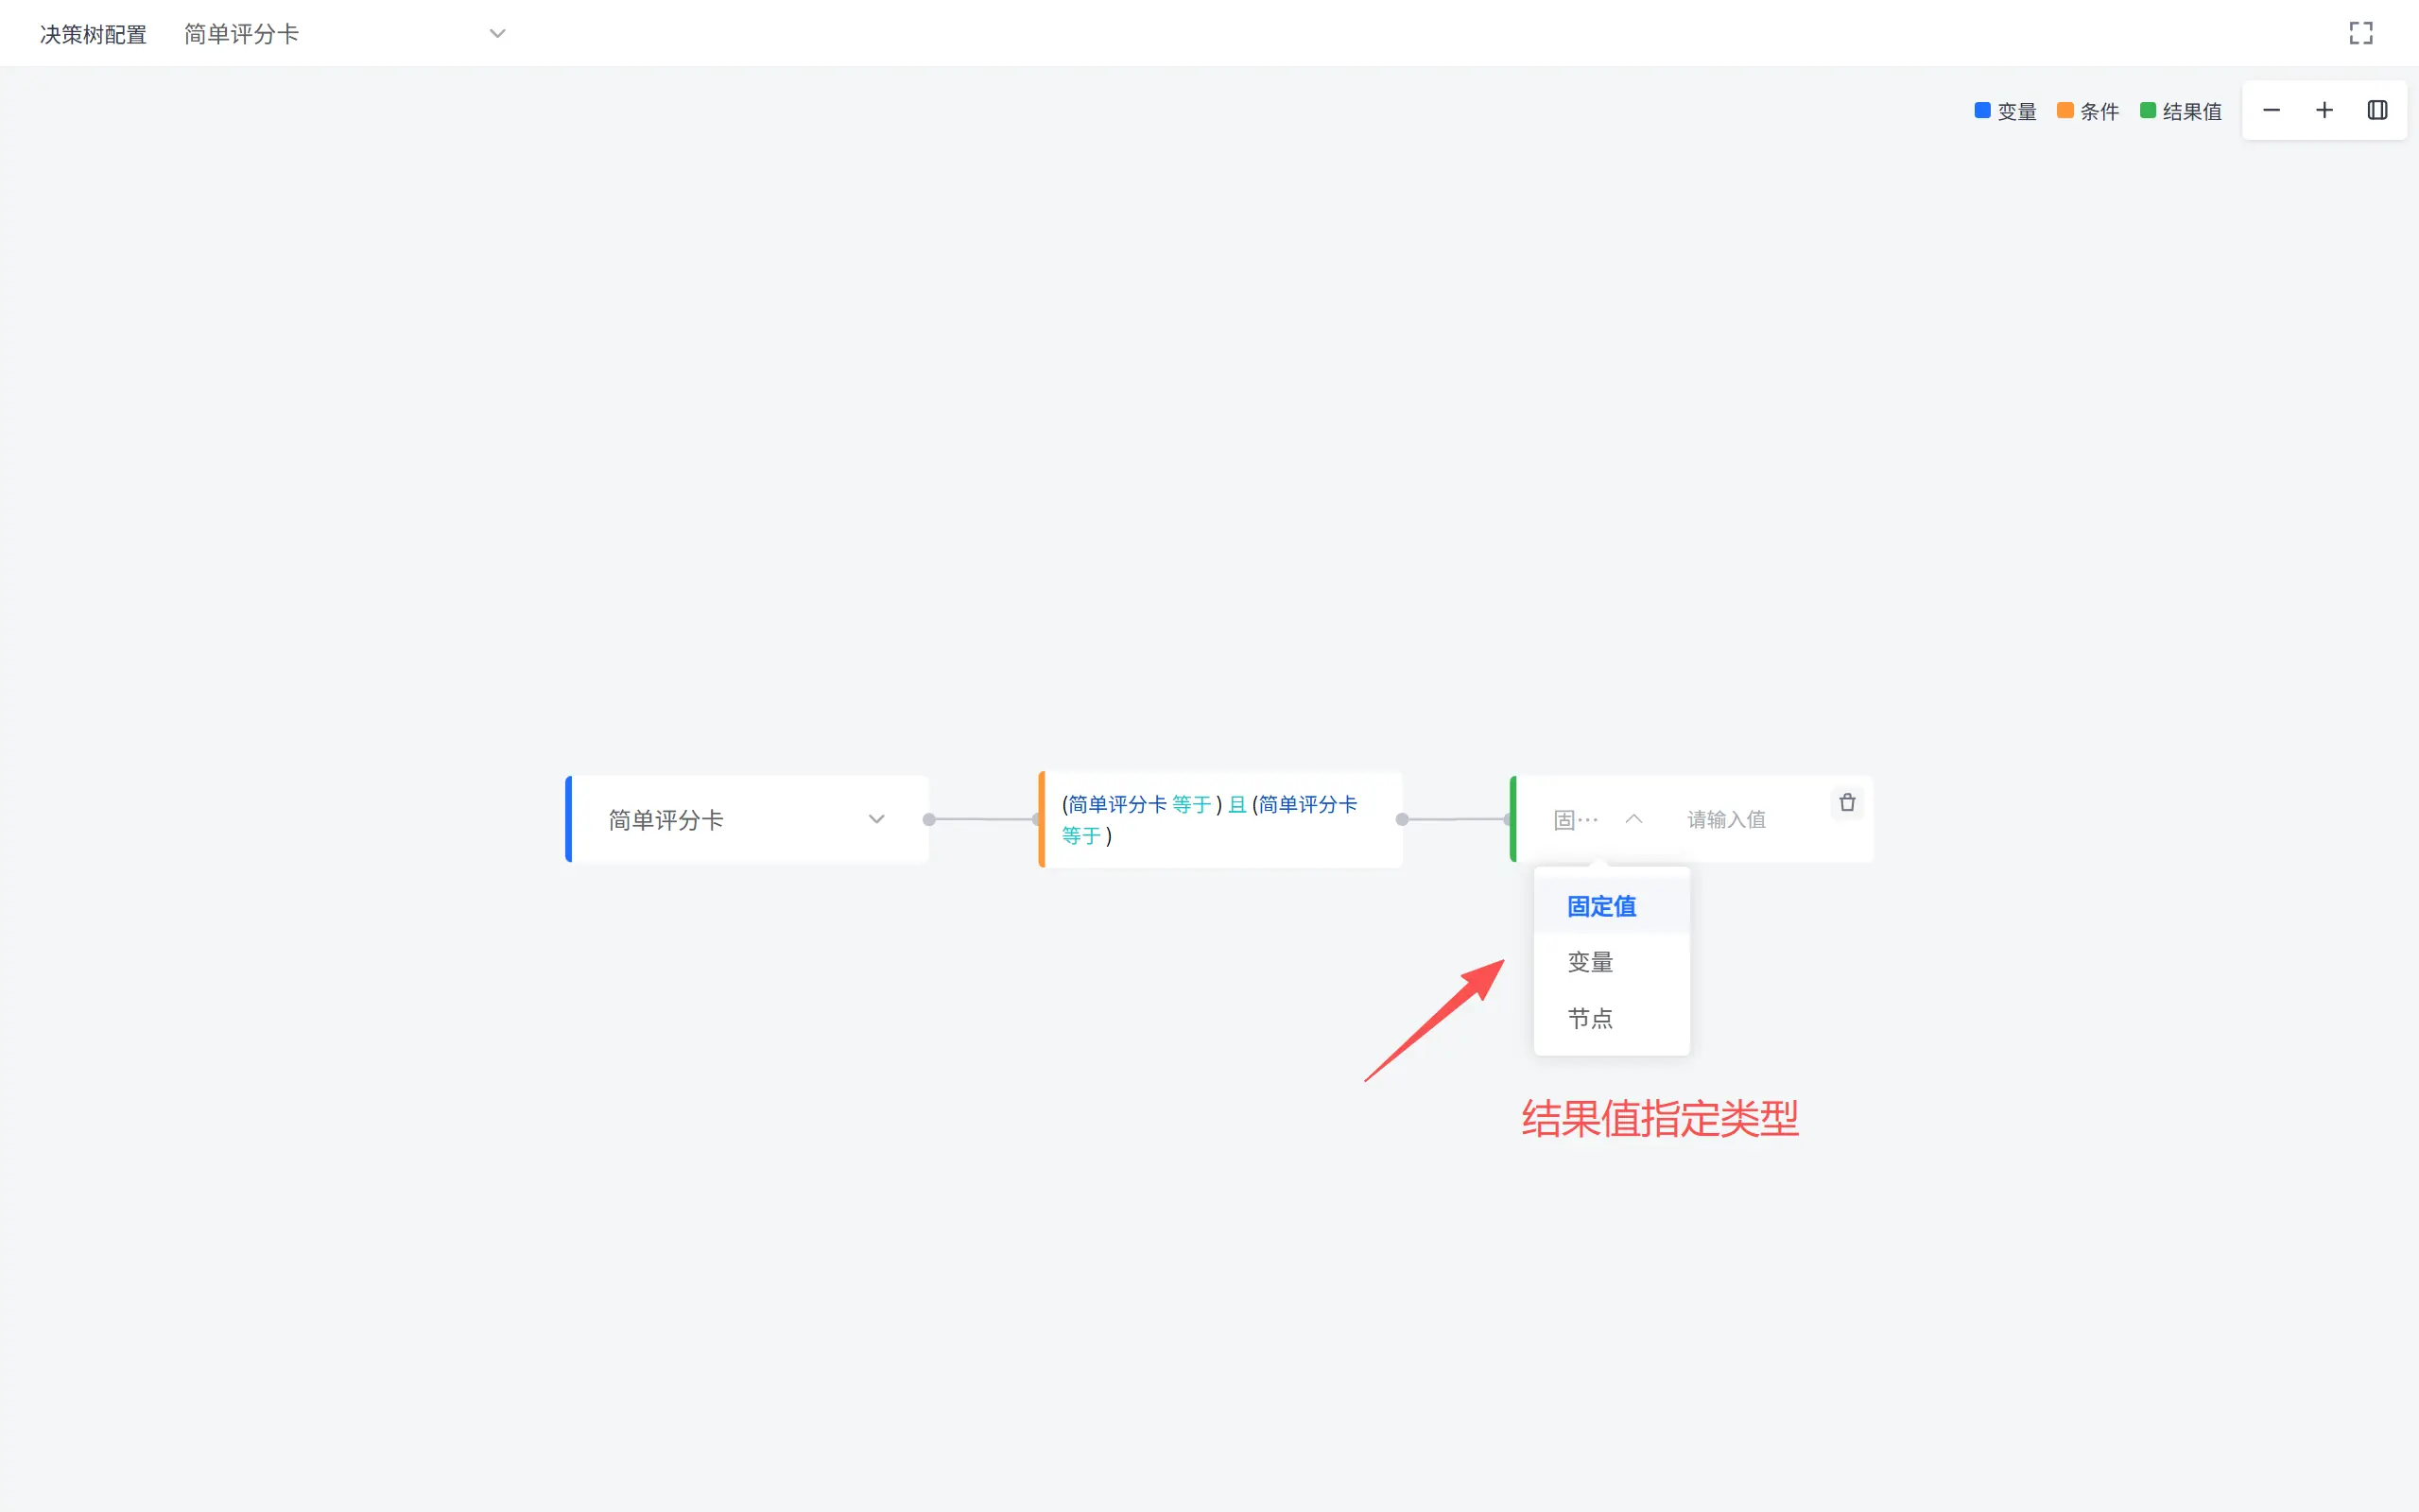
- 每条决策流可独立测试、版本留痕、API开放、跨系统调用
- 执行过程记录节点结果、函数入参/出参、耗时与异常路径
- 满足金融行业对'可解释、可追溯、可复盘'的刚性要求
它不是让业务写代码,而是让业务真正拥有定义判断权的能力。
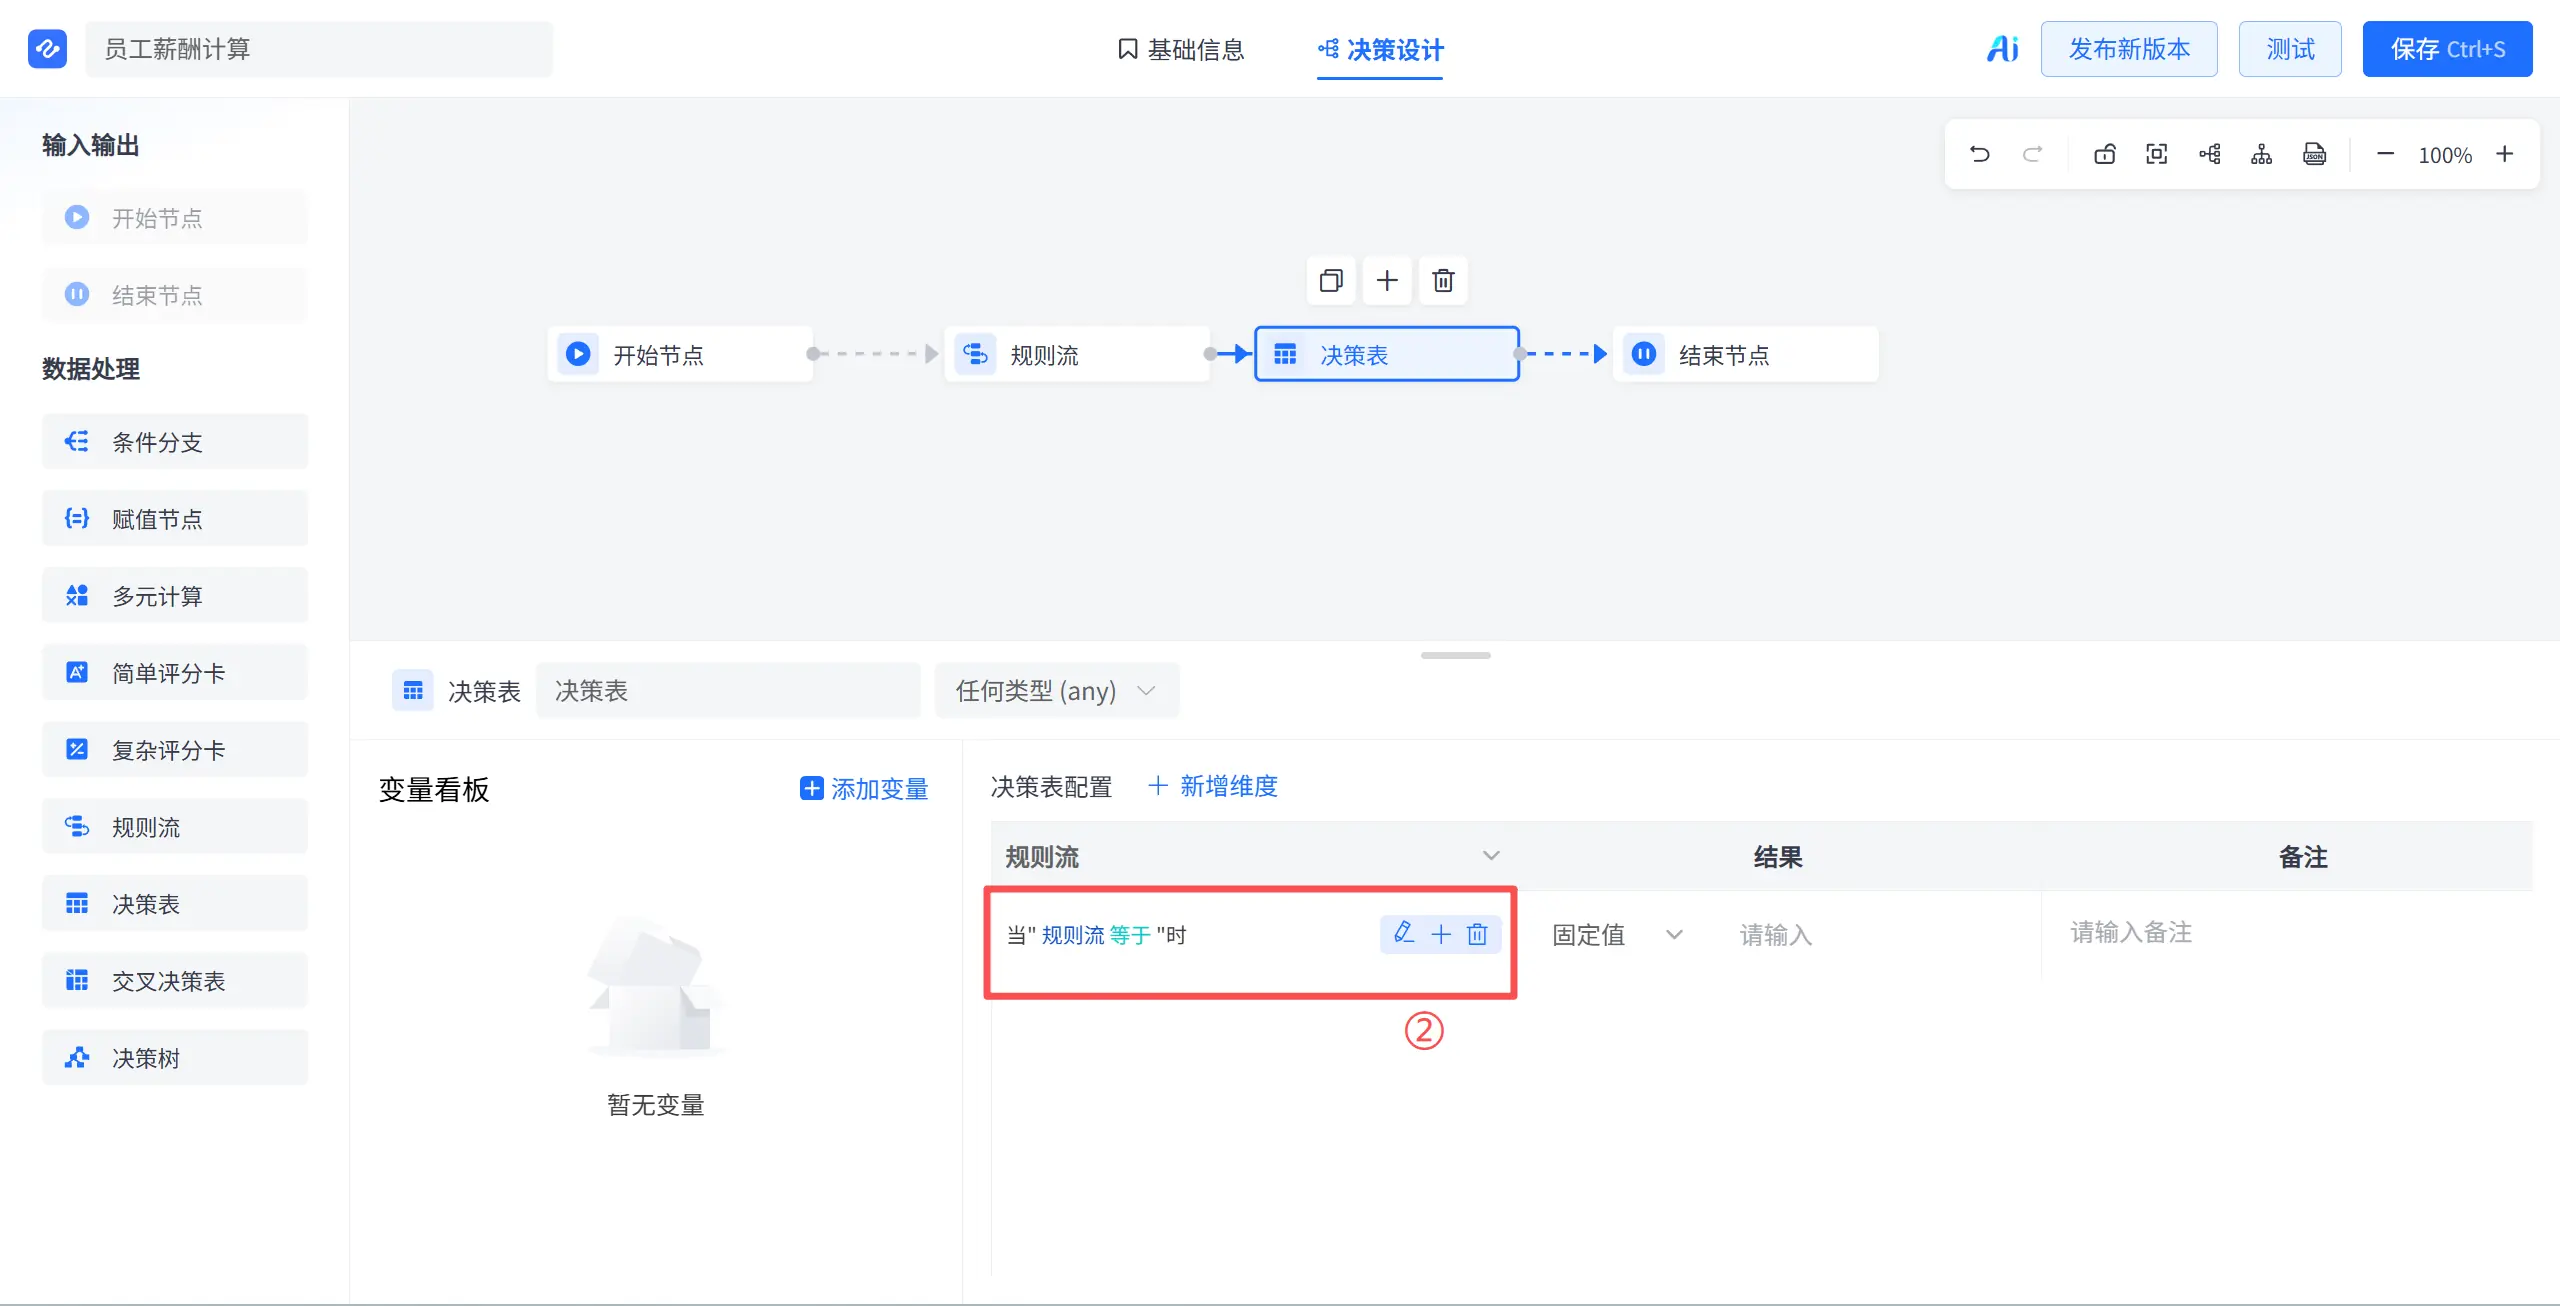
从贷前筛查看决策平台的闭环价值
以贷前实时筛查为例,JVS-Rules覆盖全链路:
- 客户申请数据接入后,自动调用征信API、黑名单库、内部负债数据库
- 通过函数加工生成业务变量:
- 近6个月逾期次数
- 当前负债率
- 决策树逐层判断:
- 年龄合规?
- 收入达标?
- 黑名单命中?
- 负债超限?
- 地区政策允许?
- 最终输出:'自动通过''人工复核'或'拒绝'
政策调整时,风控人员直接在界面修改决策树分支条件或决策表阈值,保存即生效,无需发版、无需重启。
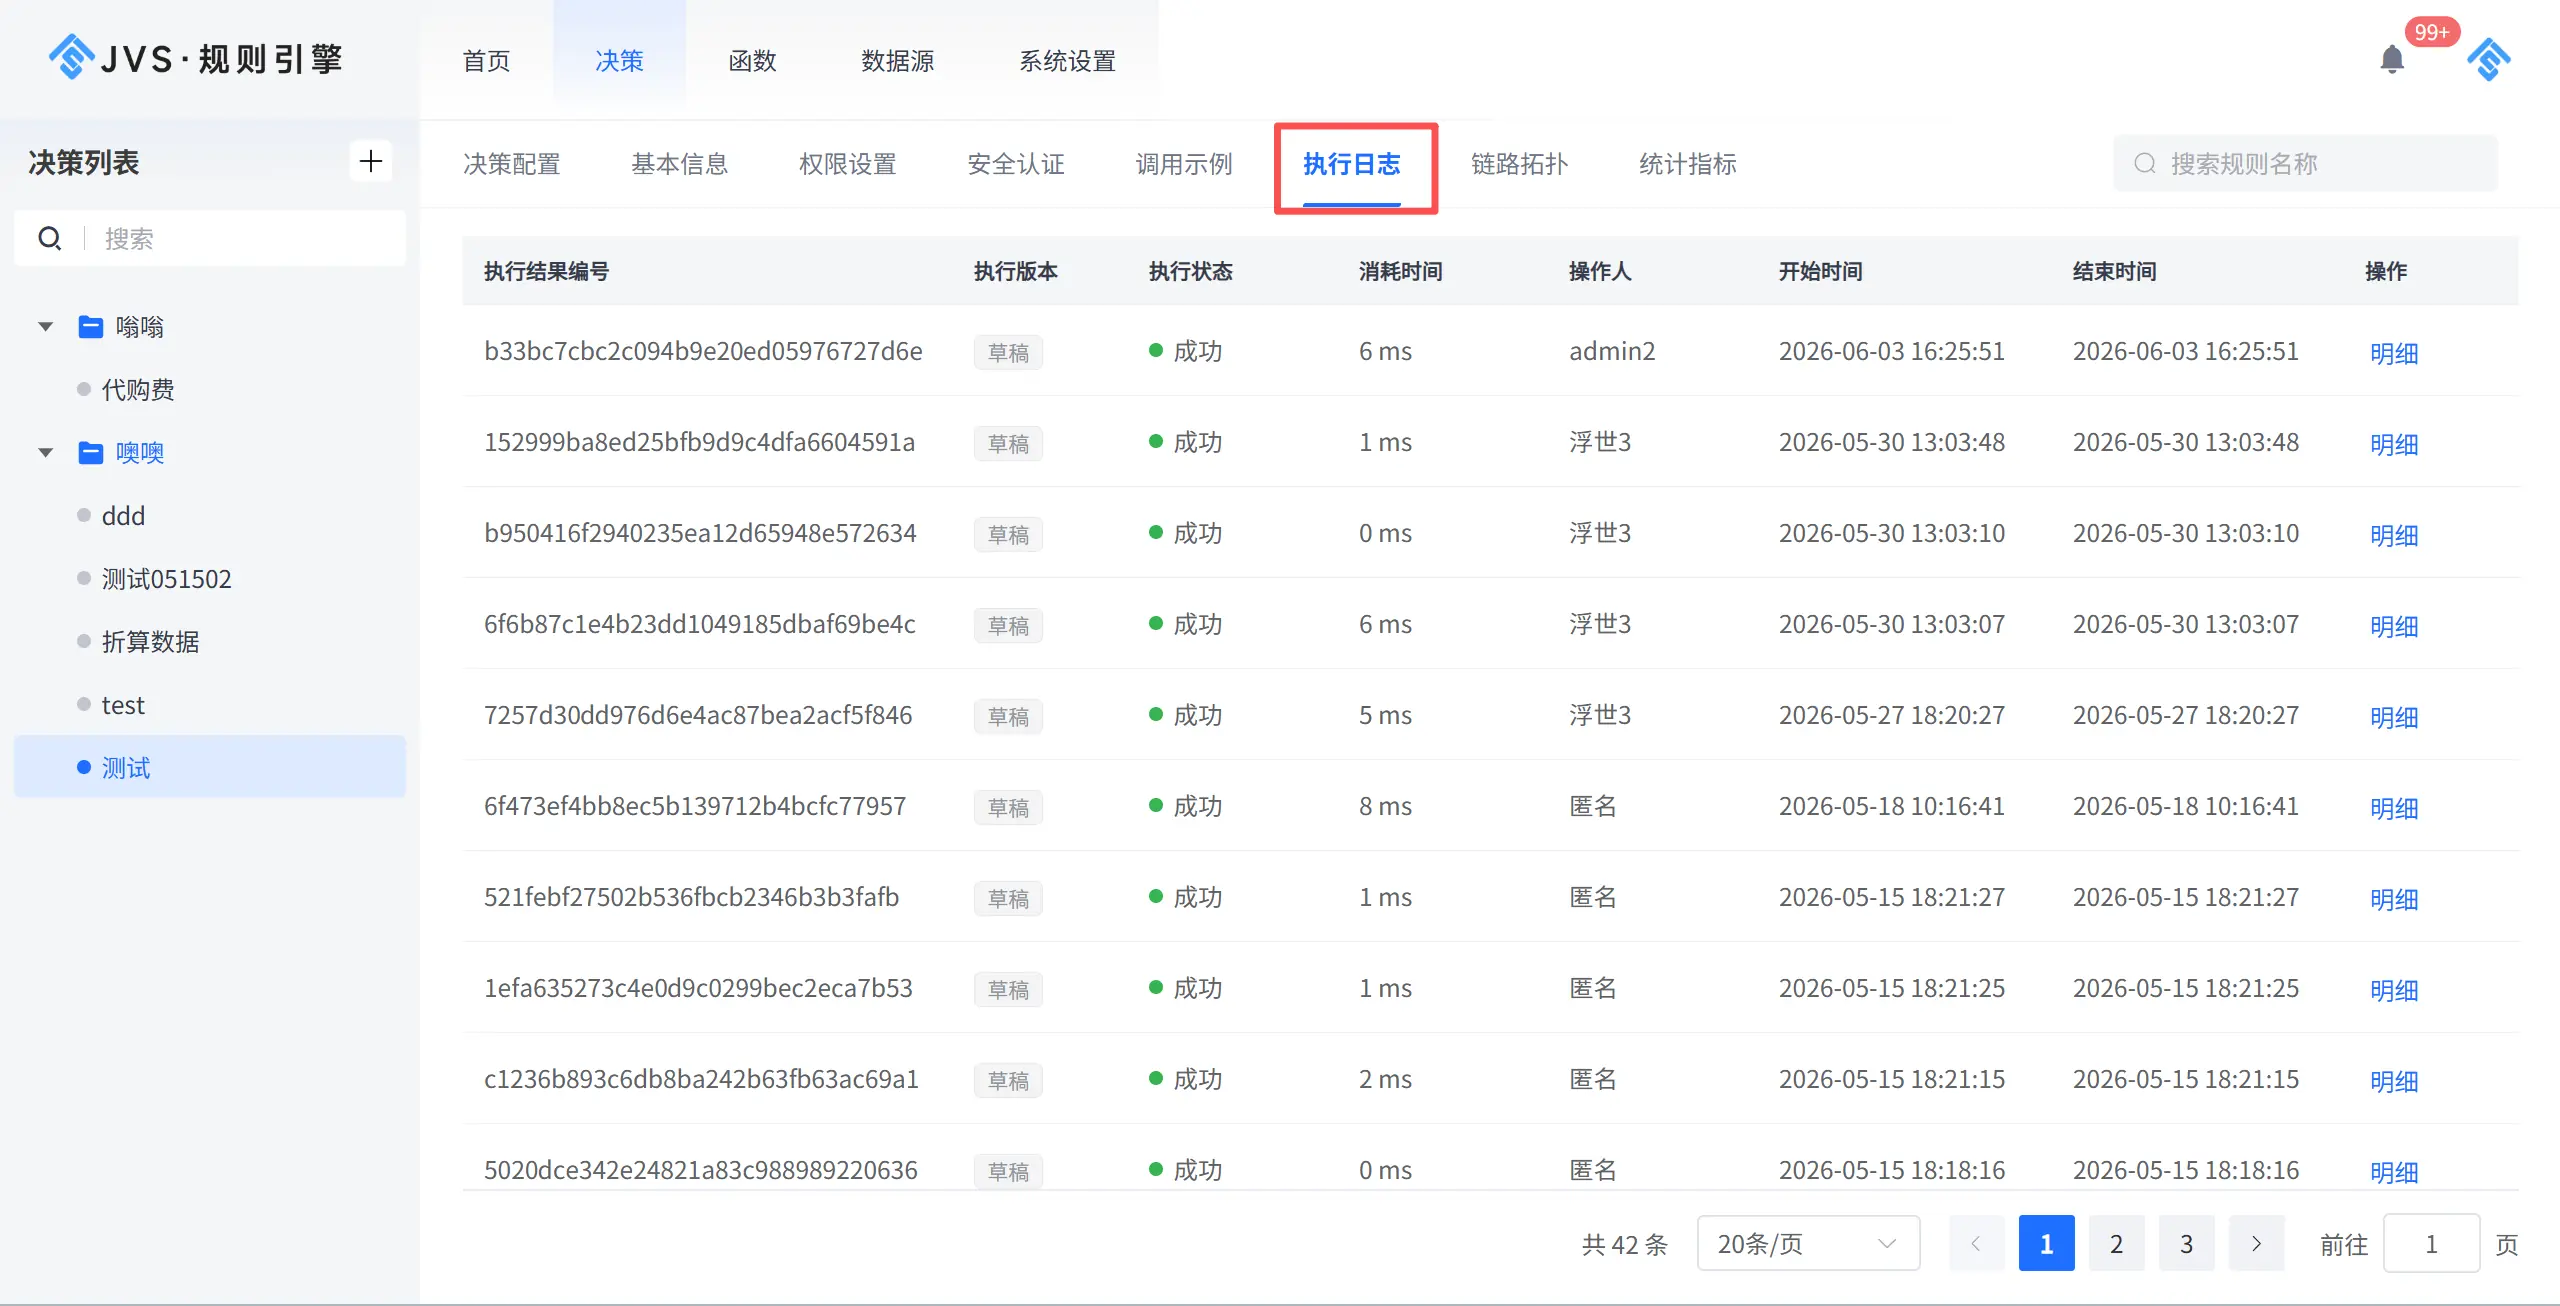
每一次拒绝附带完整执行路径:
- 哪个节点触发拦截
- 外部接口返回值
- 负债率计算过程
- 匹配成功的具体规则
满足监管问询与内部复盘双重需求。
同一套准入规则可被以下系统统一调用:
- 信贷核心系统
- 反欺诈中台
- 客户运营平台
彻底消除'同客异判',实现风控策略的集中治理与一致执行。