最近Opus 5.5真的太顶了,不管是做视频,还是写教程,包括敲代码,都让我为之惊叹。
就连最新发布的 Sonnet 5.5 也是能力出众,速度快的一笔,关键是结果也是令我相当满意。
刚好看到 Claude 官方出了新的焚诀,认真践行了一波,就迫不及待的要分享给大家了。
相信我,你会发现新的世界,你会感觉自己的生产力又上升了一个新的台阶,你甚至会产生这样一种错觉。
GPT-6 Astra 不香了,重置不香了,sol 更看不上了。
说句心里话,模型迭代这么快,我自己的节奏是每次大版本出来,先读官方的提示词指南,再动手改 CLAUDE.md 和常用的 Skill。花一点时间把 Claude Code/Codex 调教好,后面效率和效果都会节省大量时间。
坐稳了,我们出发~
01、删掉 think carefully
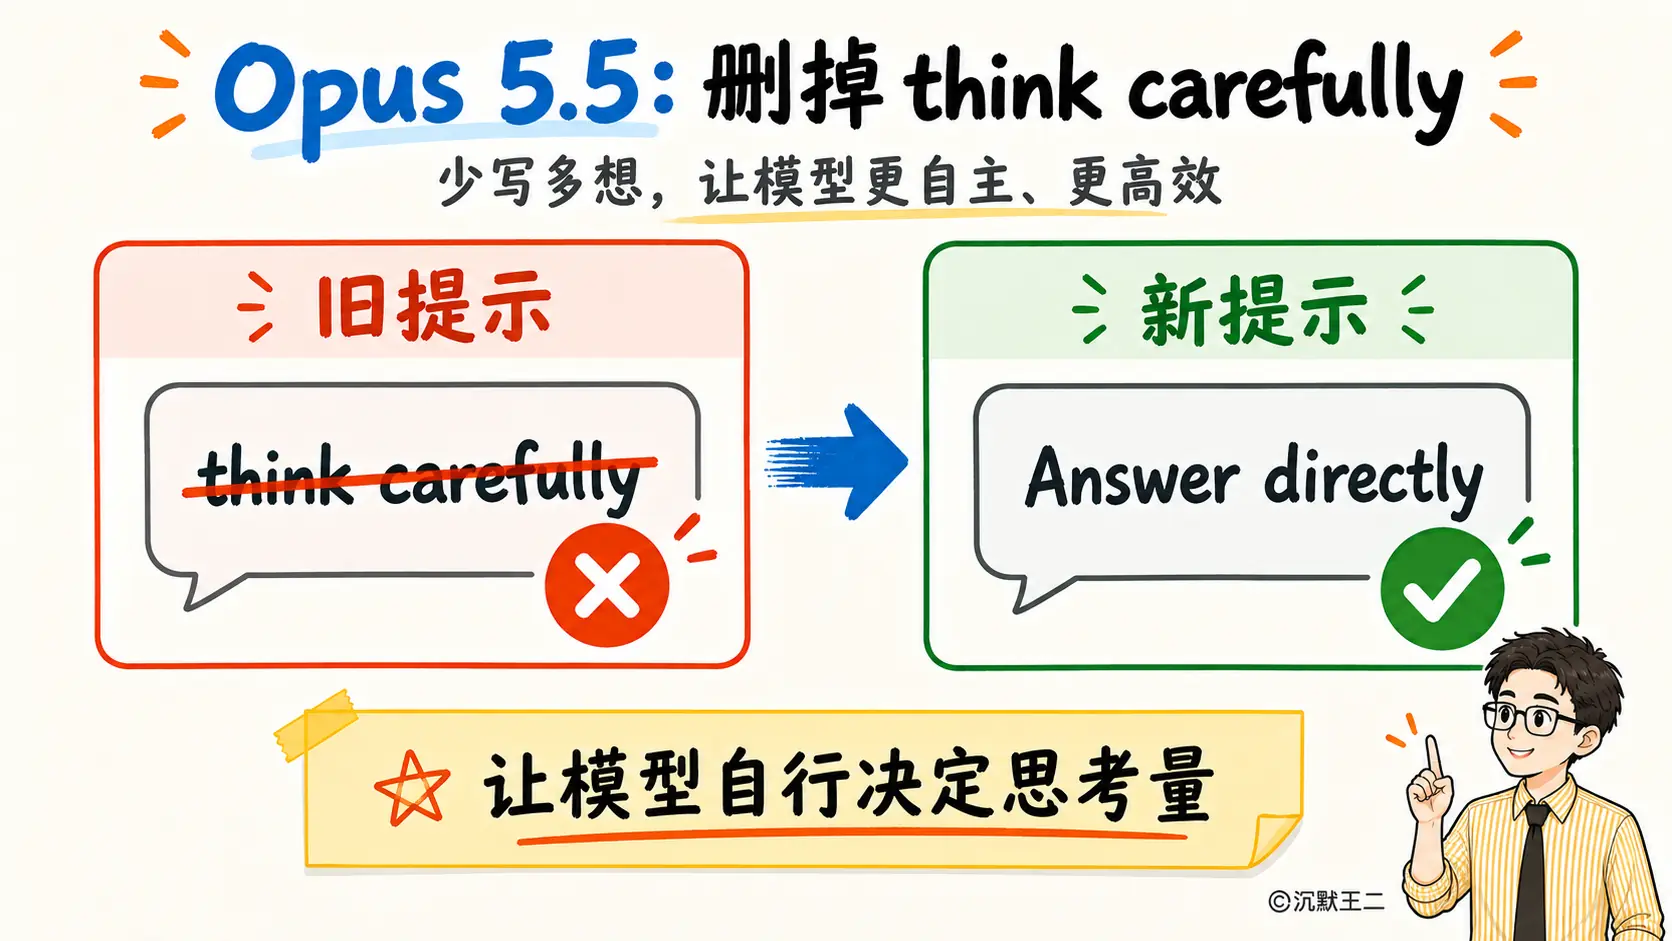
如果你习惯在提示词里加"think carefully"、"一步一步想",以后不要再这样干了。
官方的理由是:
"Opus 5.5 always thinks before it replies, and it decides how much."
翻译翻译就是 Opus 5.5 每次回复前都会思考,想多少由它自己决定。官方还提到,删掉"think carefully"以后,模型回复得更早,并且质量没有下降。
我顺手在自己电脑上搜了一遍。CLAUDE.md、rules 目录和装的所有 Skill 里,把这类指令都删掉了。大家可以用下面这行命令查一下自己的配置。
bash
grep -rniE "think (carefully|hard|step by step)|ultrathink|一步一步|仔细思考" ~/.claude/CLAUDE.md ~/.claude/rules ~/.claude/skills别小看这一小步。
02、effort 到底怎么用?
先说一句,Opus 5.5 需要 Claude Code v2.1.280 或更高版本,还没升级的先跑一下 claude update。
Opus 5.5 默认的档位是 medium,Opus 5 是 high。
很多小伙伴看到这的第一反应是赶紧调回 high,先别急。官方测试里,Opus 5.5 的 medium 在编码和知识工作上已经追平甚至超过了 Opus 5 的 high;好几项编码评测上,low 也接近 Opus 5 的 high,成本低很多。
反过来也要注意。同一个档位下,Opus 5.5 比 Opus 5 想得更多,xhigh 和 max 尤其明显。把 Opus 5 时候用的 xhigh 原样搬过来,一轮要跑更久,token 也烧得更多。
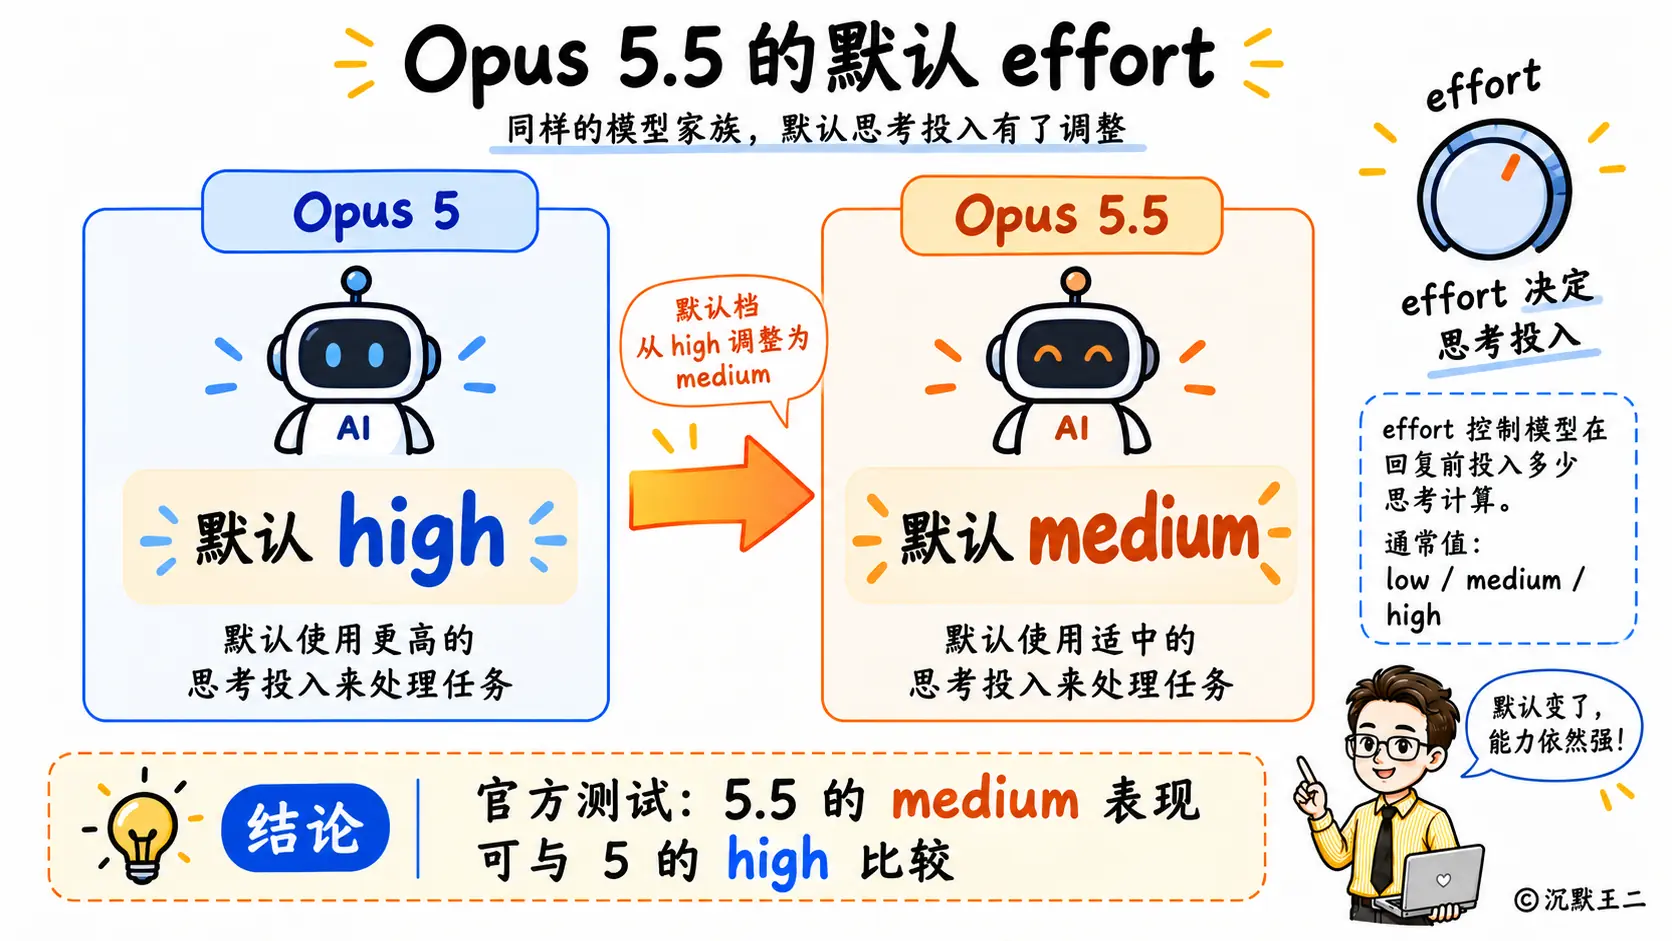
那 effort 到底调的是什么?
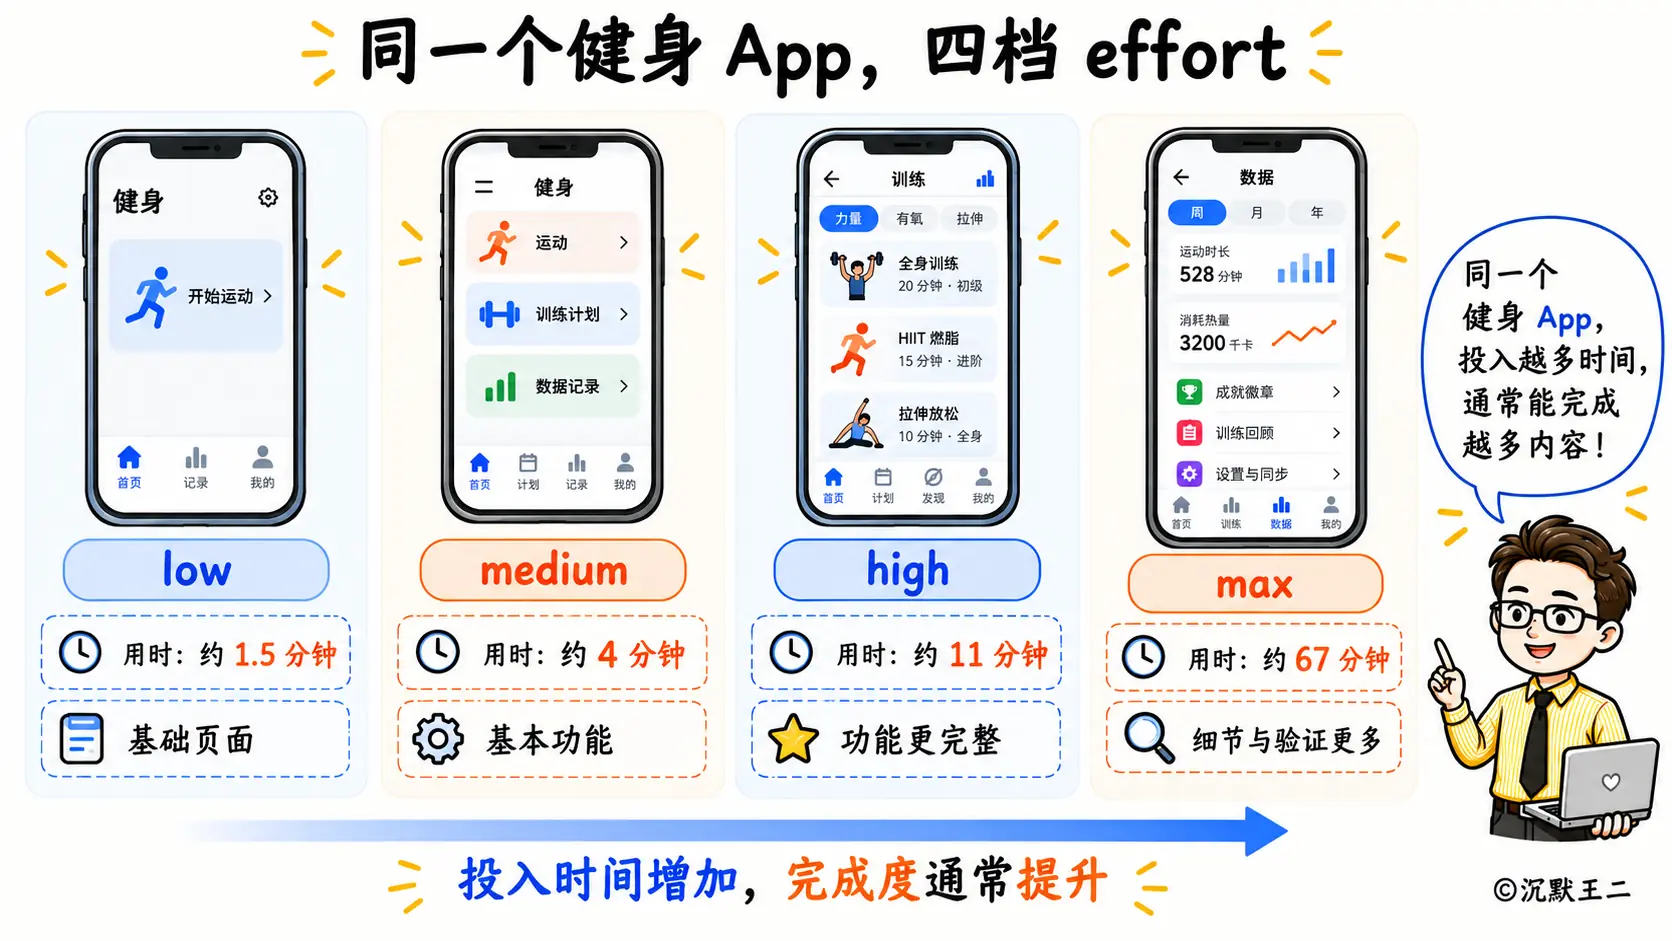
Claude Code 团队的 Thariq Shihipar 专门写了一篇《Spending your effort》,他的结论是,effort 调的主要是 Claude 做多少验证、测多少边界情况,以及替你拿多少主意。
他拿"做一个健身记录 App"这种一句话需求,在 Opus 5.5 上试了四个档位。low 跑了 1.5 分钟,做出来就是一个记录列表加一张简单的图;medium 4 分钟,high 11 分钟;max 跑了 67 分钟,功能丰富得多,连热力图都有了。档位越高,Claude 替你做的决定也越多。
难题上的差距更明显。Terminal-Bench 3.0 里有一道题,要根据崩溃报告修一个存储引擎的 bug,同时不能把数据合并(compaction)搞坏。Opus 5.5 开 low,5 次全挂;开 xhigh,5 次过了 4 次。
low 喜欢上来就改代码,既没预先编译,也没先跑复现脚本。xhigh 每次 11 分钟左右,先把崩溃复现出来,再写随机测试做对照,还专门检查了修到一半的代码能不能被测试抓出来。
不过 Thariq 也发现,调高 effort 能减少"漏掉边界情况"这类失败,但思路一开始就错了的,调多高都救不回来。
我的建议是。
- low:头脑风暴、画草图、机械活,比如批量改名、按已知模式改一堆文件
- medium:范围清楚的日常开发,比如实现一个新功能
- high:medium 卡住了,或者验证很重要、边界情况多,比如在老代码库里修 bug
- xhigh:难题
- max:想让 Claude 完全自己搞定一个难题的时候,只在单个会话里开
Claude Code 里换档很方便,启动时可以指定,会话中途也可以随时切,新档位从下一个请求开始生效。
bash
# 启动时指定
claude --effort low

# 会话中途切换、查看当前档位
/effort high
/effort status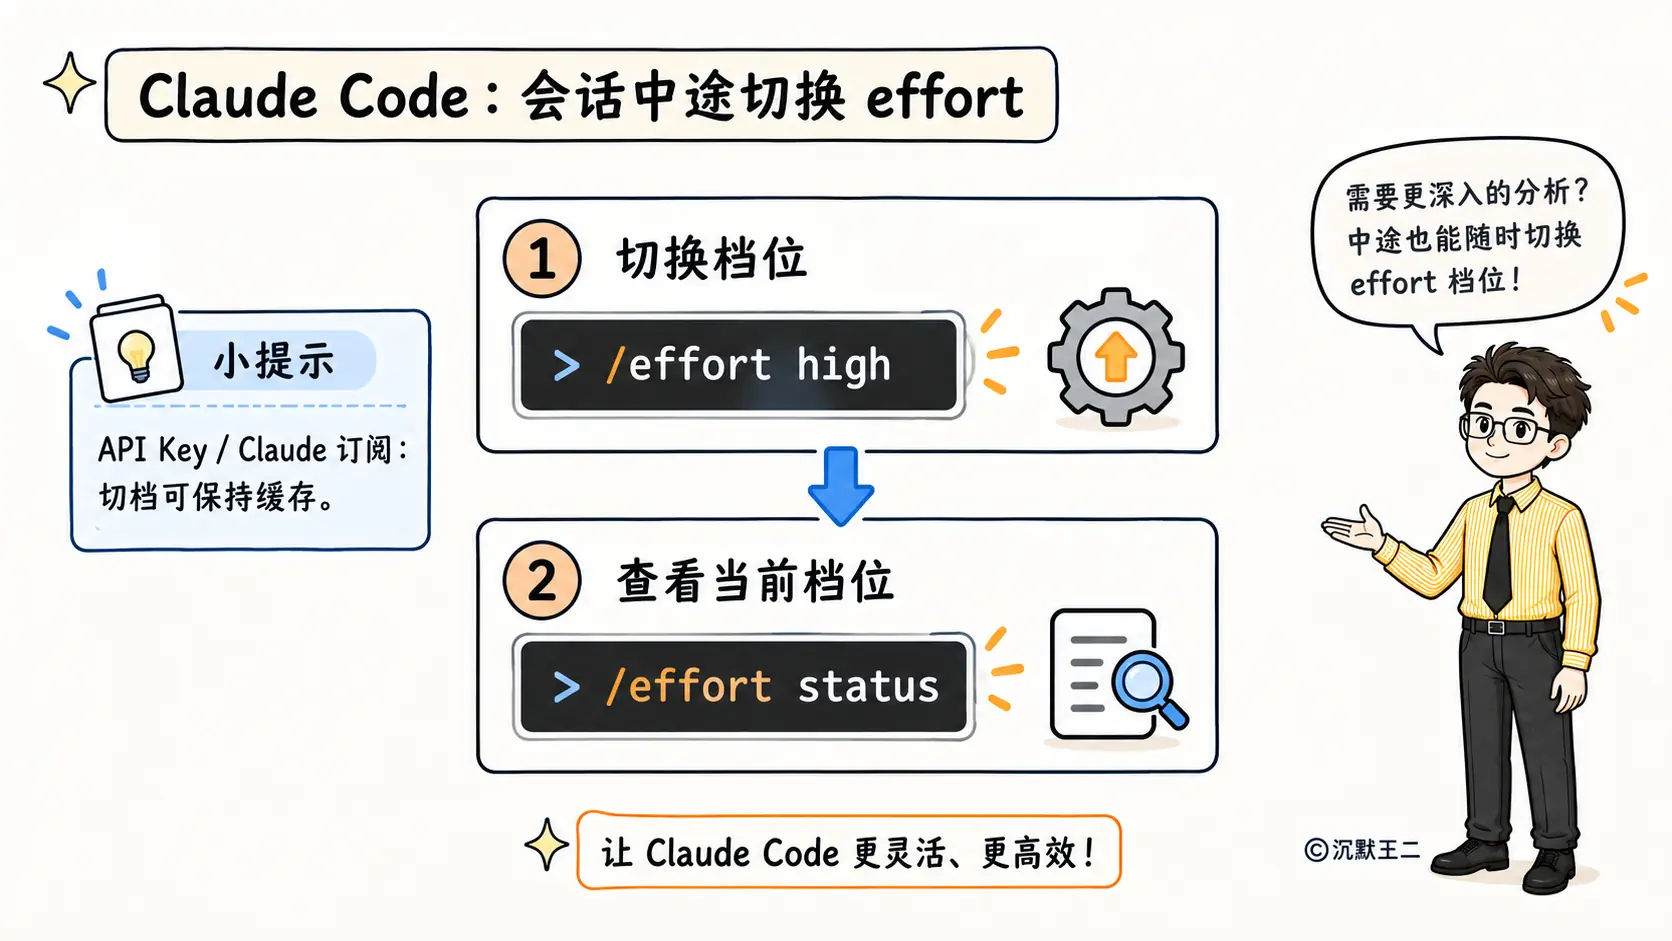
medium 什么时候不够用?
Addy Osmani 在《What a task costs on Opus 5.5》里给了一个很典型的案例。
比如你有一个函数改了一个字段名。medium 会改处理函数,测试也能通过,但客户端的代码它不会动。medium 确实能完成你交代的事,但不会主动去干更多的事。换成 high,它会先花几轮把调用的地方读一遍,再一次性把两个地方都改好。
high 值不值,Addy 也算了一笔账。按 Opus 5.5 的价格,high 在一个任务里会多想 20K token,大约 0.4 刀,差不多等于 10 轮重试。
xhigh 如果在同一个问题上连着栽两次,就别死磕了,官方建议换 Opus 5.5,解决完再切回来。如果已经是最好的模型,那就再调高 effort。
当然了,如果还不行,那一定是你的提示词有问题。
等回复等得着急,可以输入 /fast 打开快速模式。模型还是同一个,速度最多快 2.5 倍,价格是标准模式的两倍。记得在会话一开始就打开,中途才开的话,第一个请求会把整段对话按不走缓存的价格重新算一遍。
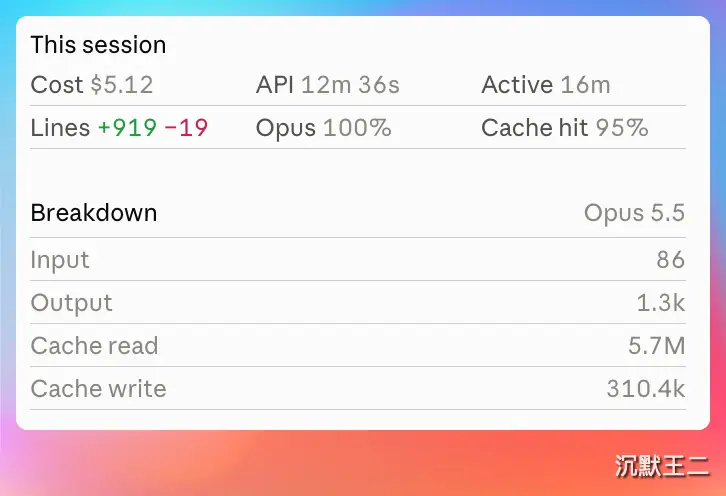
档位开得合不合适,任务跑完输入 /usage 看一眼,一个小改动输出了一大堆 token,多半是档位开高了。
03、把目标写清楚
提示词里最该写清楚的,是做到什么程度算完成。
官方的建议是把整个任务放在一条消息里交代完,写清楚目标,然后放手让它干。Opus 5.5 相比 Opus 5 进步最大的,就是在大仓库里一路改到测试通过这种多步骤的活。目标写清楚了,它自己知道什么时候收手。
我按官方的例子写了一个中文版,三句话分别交代任务、终点线和什么时候停。
把支付相关的接口从旧客户端迁移到新客户端。
完成的标准:所有接口都改用新客户端,旧客户端的代码已删除,测试全部通过。
只有某个测试失败、而且你解释不了原因的时候,才停下来问我。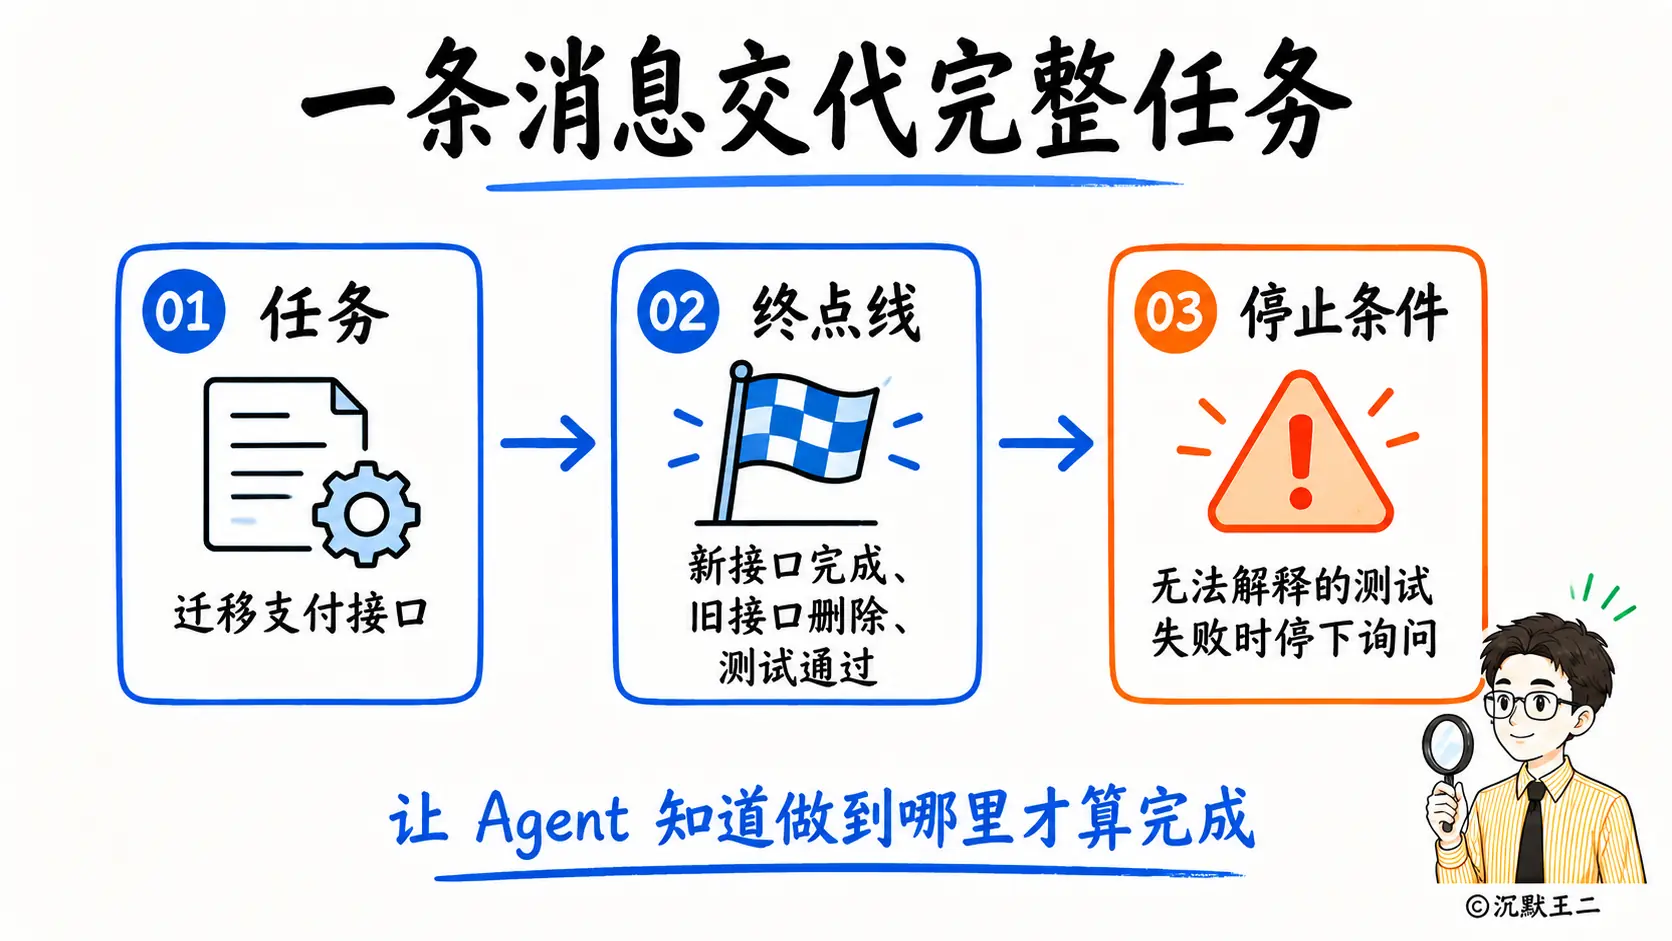
跑到一半想起来还有要求,也不用按 Esc 打断重来。现在一次任务跑得更久,重来的代价更大,直接输入新消息按回车就行,比如"旧的接口名保留成别名",它会带着这条要求接着干。
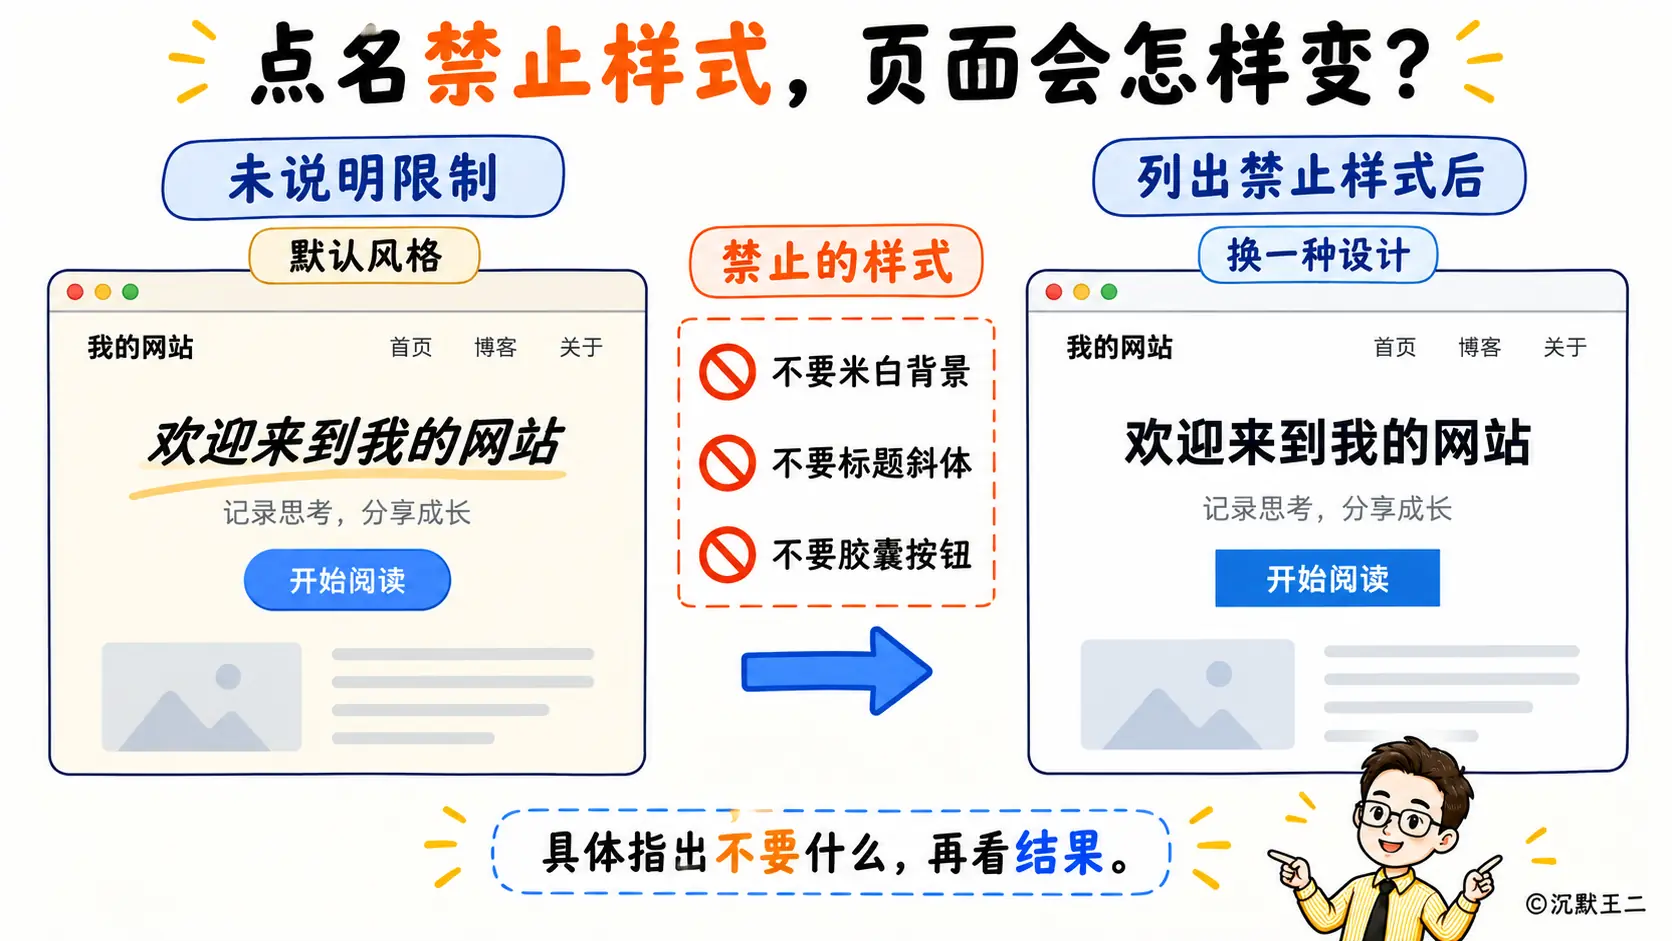
做前端的小伙伴再多记一条。不给设计方向的话,Opus 5.5 会退回默认风格,泛泛地说一句"别做成千篇一律的样子",大多只是从一种默认换成另一种。点名列出不要的具体样式,效果好很多。
做一个个人网站,内容先用占位数据。
不要用米白色或奶油色背景,不要在标题里用斜体强调词,
不要用"01 / 02 / 03"这种编号的章节标签,不要用等宽字体的标签,不要用胶囊形状的按钮。
我每篇文章的章节标题都是 01、02 这样编号的,读到这一条,多少有点被点名的感觉(狗头保护)。
生成出来以后看看它换成了什么,不满意就把新样式也加进列表,再来一轮。
04、别让它跑一半停下来
用 Opus 5.5 跑长任务,大家大概率见过这种场面,它写了一大段总结,最后来一句"要我继续吗?"
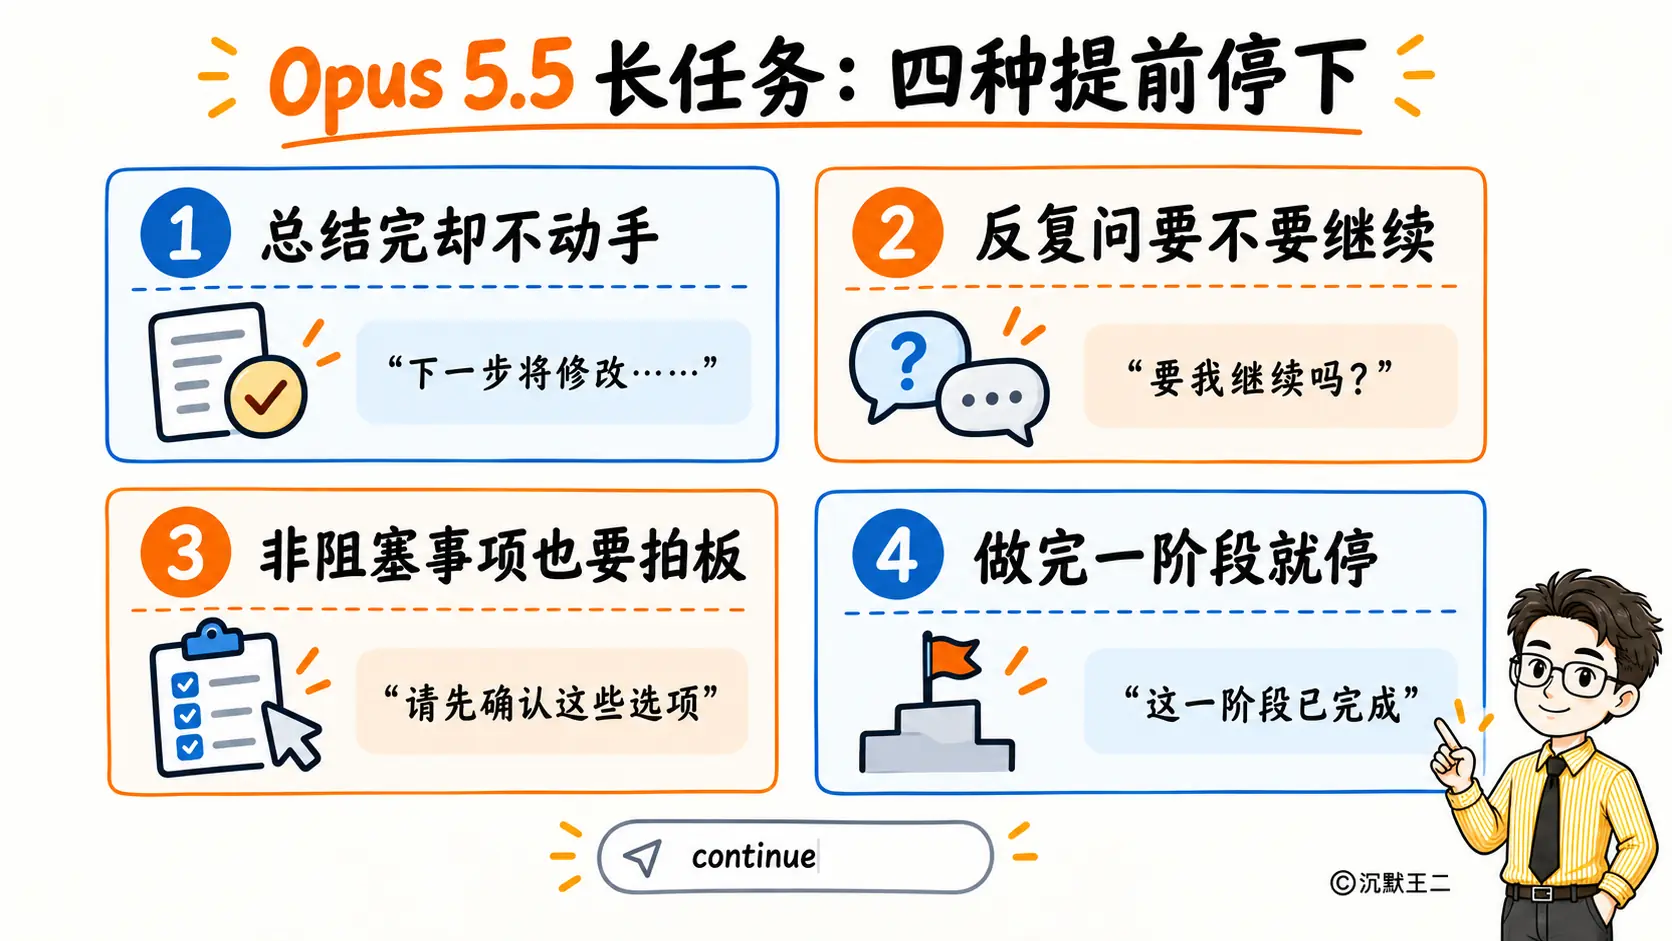
这是 Opus 5.5 的新习惯,边干边汇报。官方把这种提前归纳成了四种。
- 写完一大段总结,说了下一步要做什么,但就是不动手
- 问你"要不要我接着做",然后干等着
- 列出一串让你拍板的事项,可按它自己的说法,这些根本不影响剩下的活
- 觉得这一轮跑得够久了,或者刚做完一个阶段,就停下来汇报
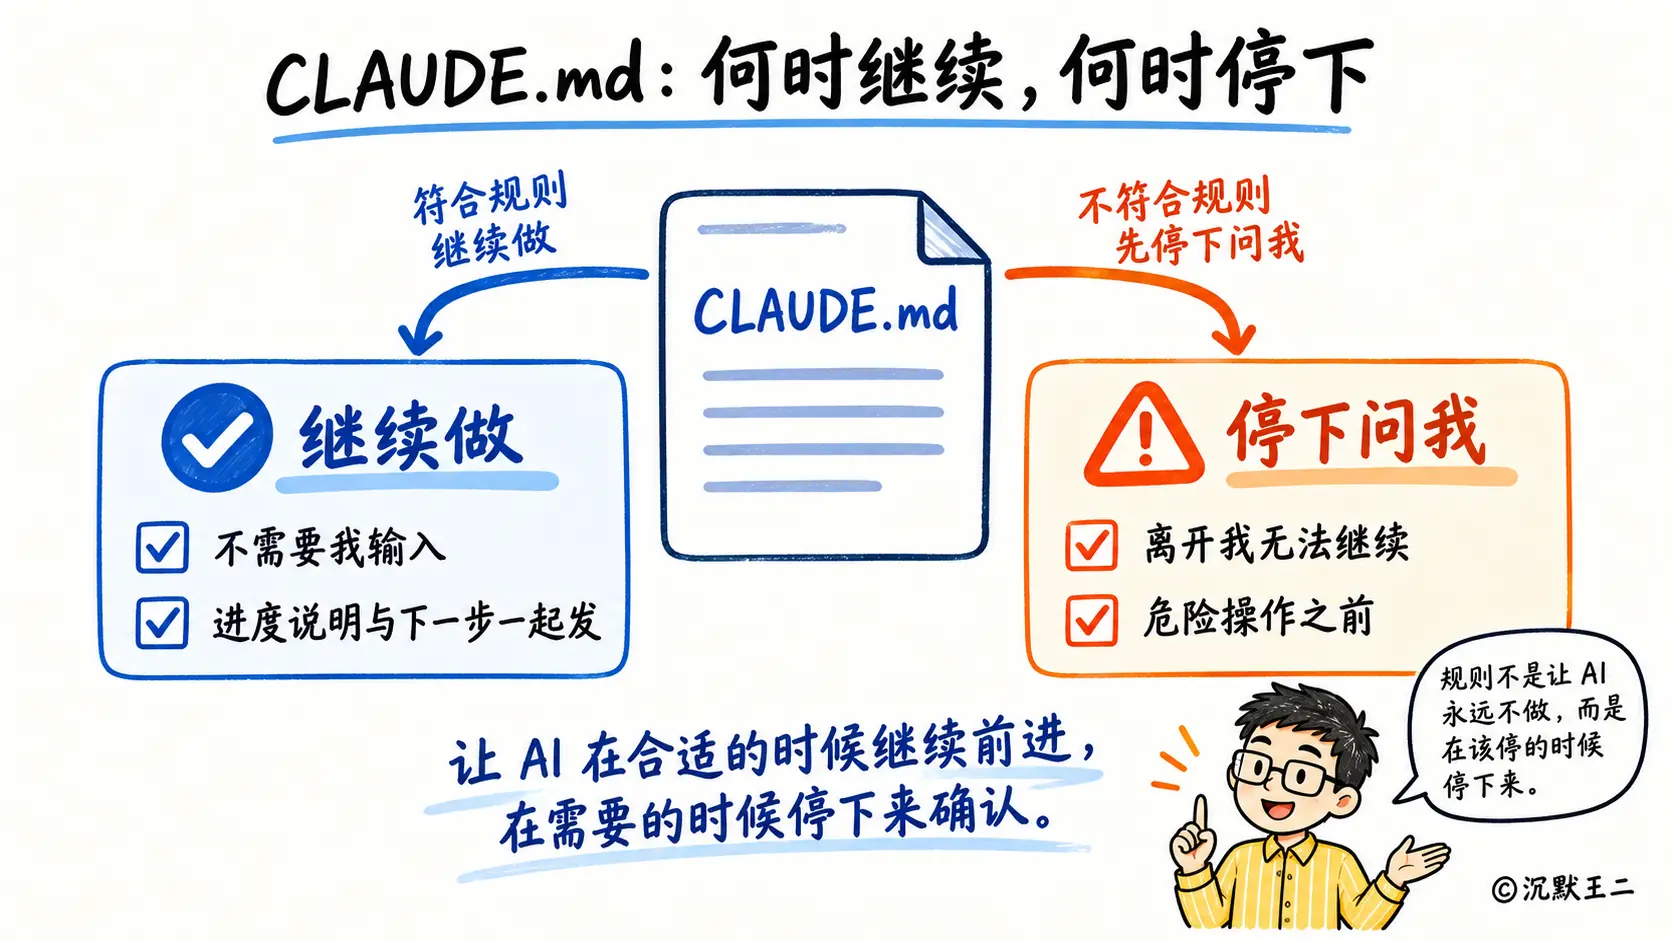
偶尔停一次,回一句"继续"就行。经常这样的话,就该往 CLAUDE.md 里加规则了。官方说 Opus 5.5 对点名这些停顿的指令很听话,下面是我按官方的规则改写的中文版,大家按自己的项目改。
markdown
不需要我输入的步骤,直接继续做。进度说明写在下一步操作的同一条消息里。
只有两种情况停下来问我:离开我就无法继续;要做危险操作之前,比如删除数据、强制推送、改动这个仓库以外的文件。
最后一句一定不要省。
长任务再配一个 TASKS.md。跟它说一句"在 TASKS.md 里维护任务清单,做完一项勾一项,发现新问题就加进去"。任务一长,上下文窗口就会被塞满,Claude Code 会把较早的对话压缩成摘要,写在文件里的清单不受影响。想看进度,直接打开这个文件,不用在终端里往上翻。
05、大活拆给 Sub-agent
审计、迁移、全仓库 review 这类大活,可以直接让 Opus 5.5 拆给多个 Sub-agent 并行做。官方提到,早期测试者已经让它在很少人工干预的情况下,带着一群 Sub-agent 跑完了长时间的审计和迁移。
vbnet
排查 services/ 下每个服务,看有没有这个 issue 里说的重试 bug。
每个服务交给一个单独的 Sub-agent。Sub-agent 汇报回来后,先核对它给的证据,再决定是否采纳。
最后汇总成一张表:服务名、是否受影响、证据。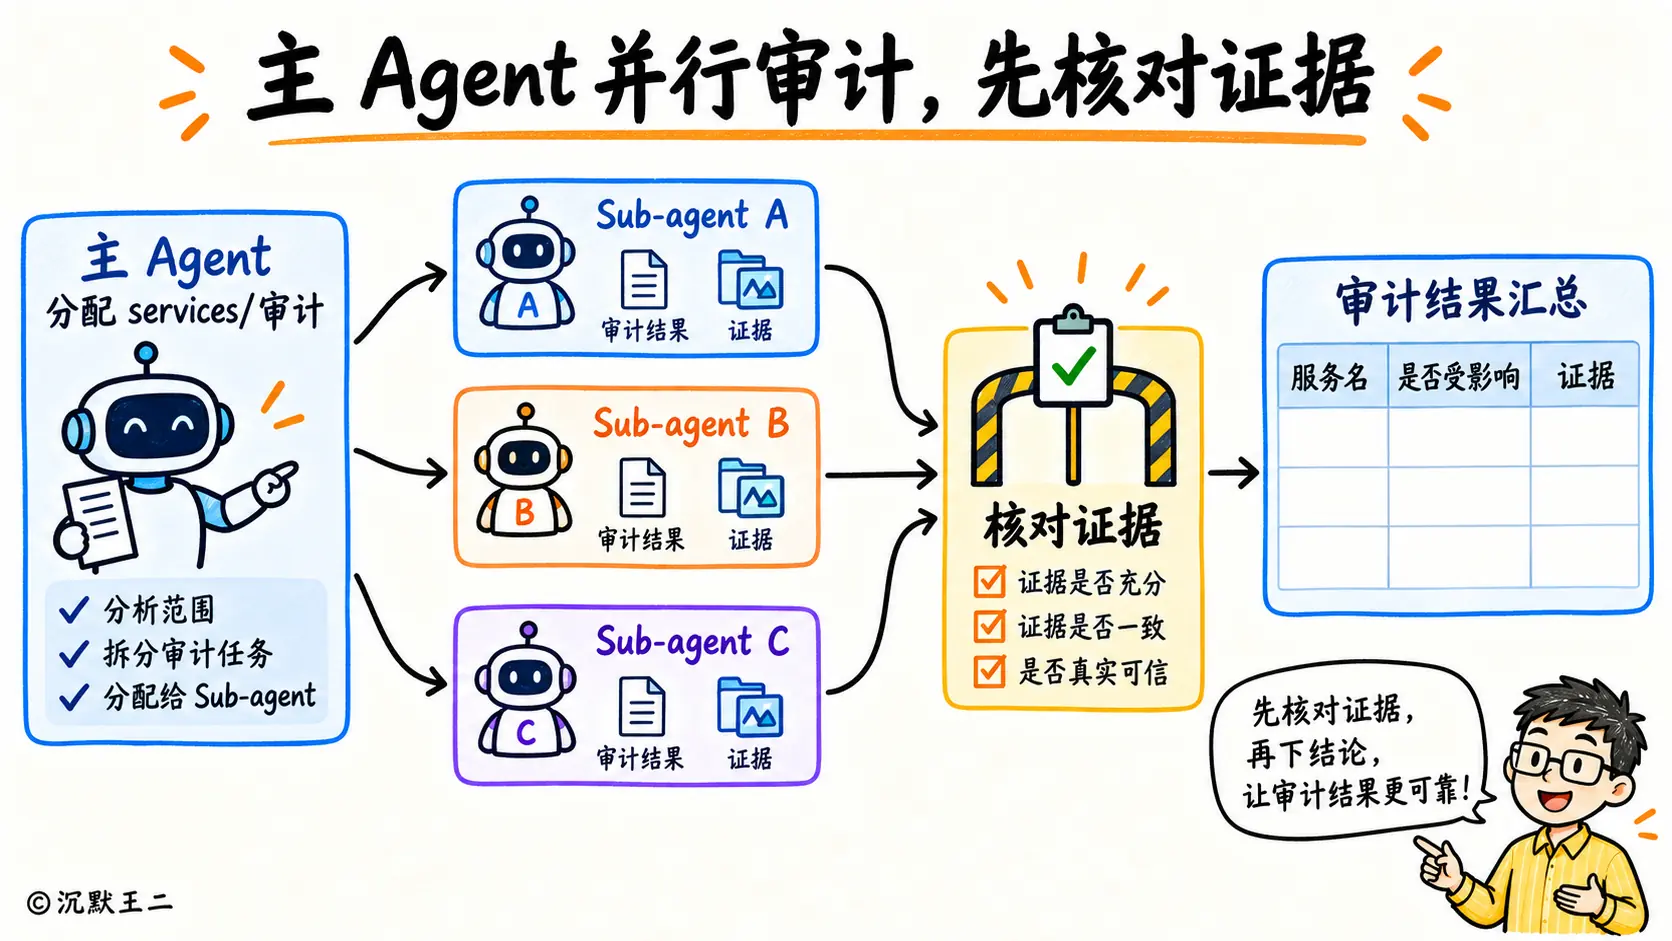
"先核对证据再采纳"这一句我觉得最有用。不核对就直接汇总,一个 Sub-agent 看错了,整张表就跟着错。
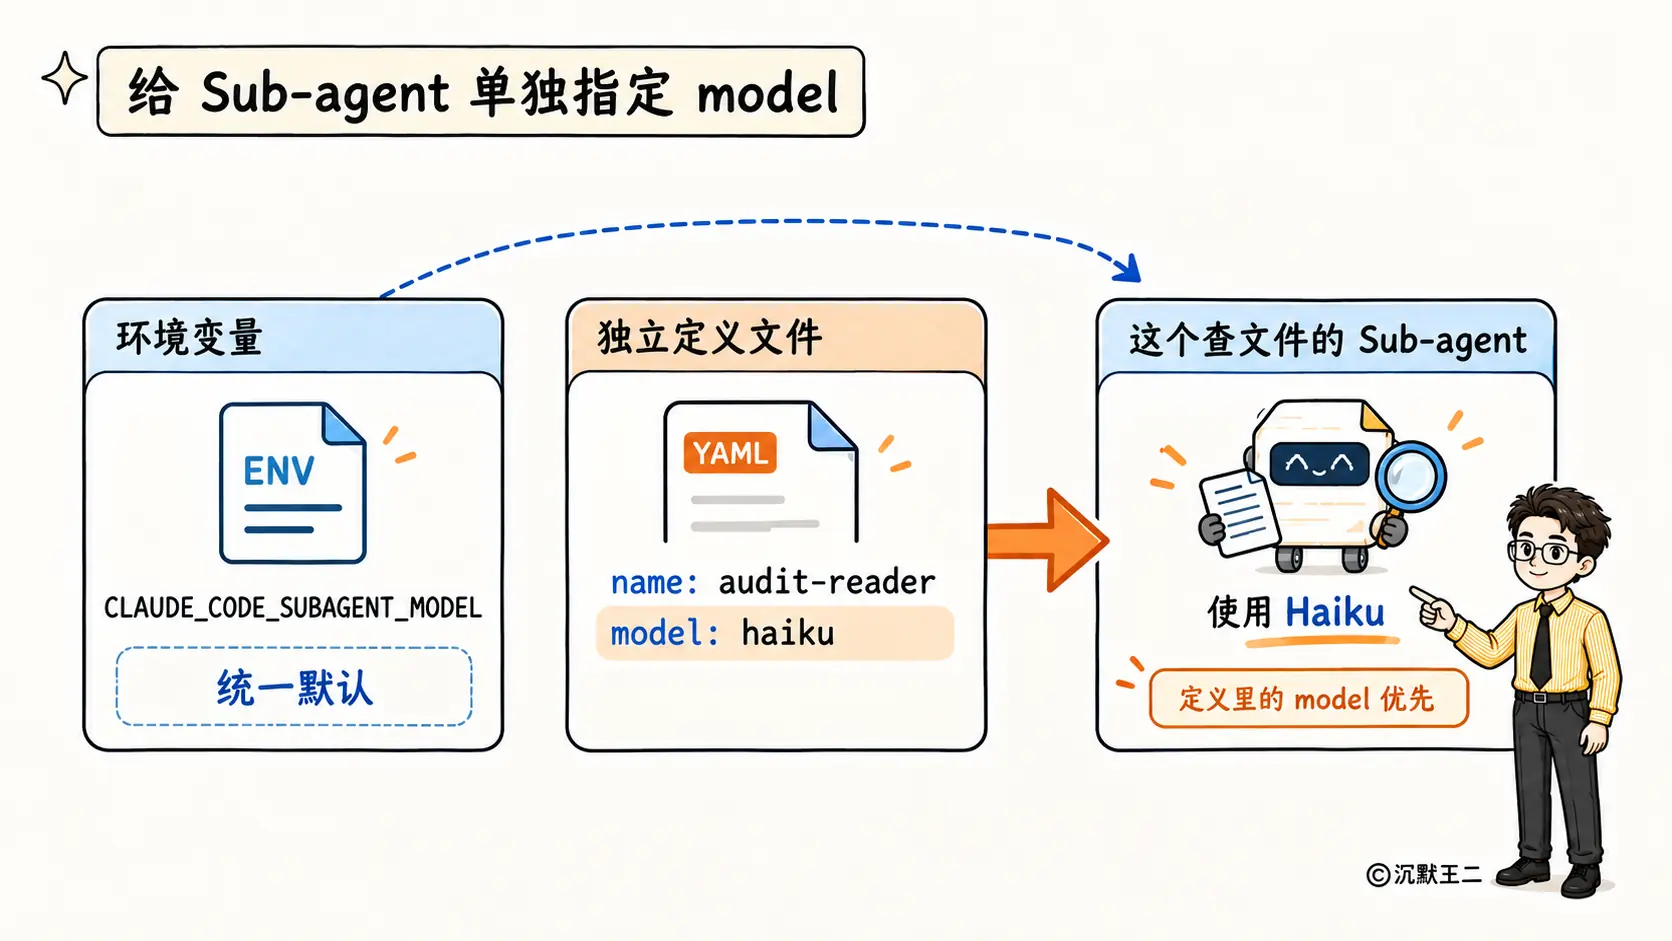
没单独设置的话,Sub-agent 用的是和主会话一样的模型,价格也一样。官方的建议是,查文件、读日志、看测试输出这种只找东西、不写代码的 Sub-agent,放到 Sonnet 或 Haiku 上跑,改代码的活还是留给 Opus 5.5。
在 Sub-agent 的定义里写一行 model: haiku 或 model: sonnet 就行。想让所有 Sub-agent 统一用一个模型,就设置 CLAUDE_CODE_SUBAGENT_MODEL 环境变量,定义里单独写了 model 的,以定义为准。
06、跑完先看它要你做什么
长任务跑完,Claude Code 会给一大段总结。别从头往下读,先找它有什么事在等你处理,比如一个留着没拍板的决定,或者一处等你批准的改动,然后再看其余部分。
官方说 Opus 5.5 的汇报比 Opus 5 清楚,会直接写做了什么、发现了什么、需要你做什么。想固定格式的话,在 CLAUDE.md 里加一句。
markdown
每次运行结束时,用三个标题总结:等我处理的、改了什么、发现了什么。
代码改完,在你自己看之前,先让它 review 一遍。官方引用了一位早期测试者的说法,Opus 5.5 开最低档抓到的 bug 比 Opus 5 开 high 还多,误报也更少。
css
对比 main 分支,review 当前分支的 diff。
只列出你会因此拦下合并的问题。每个问题给出文件和行号、错在哪里、怎么证明它会出错。
让它查资料、分析问题的时候,再加一句"标出所有你没能确认的内容,并说明你去哪里找过"。没核实的地方会被单独标出来,你核对的时候就有了重点。
报错截图、架构图也直接贴给它,别再手敲一遍。官方测试里,Opus 5.5 开最低档从密集图表里读数值,比 Opus 5 开最高档还准。
ending
说真的,希望国模在下一个周期都能坚挺起来,目前来看,都遇到了一些瓶颈。
最近一些版本的模型说实话没有特别惊艳,我个人反而会那DeepSeek Harness+DeepSeek V4.1 Flash作为第三员工。
老外这个说法确实也有道理,希望你我都在前进的道路上一意孤行,哈哈。
下期见。