系列定位 :本文属于「RAG 七层框架」系列的第 4 层(L4 · 文本分块)原理篇,聚焦「为什么分块」这一底层问题。下一篇将进入「怎么分块」的实现与高级索引(四种 Splitter + 父子块 + 层级索引)。
本文目标读者 :已经完成 L3 数据导入,正准备把
Document切成可检索块,却对「块多大、怎么切、切完会怎样」缺乏底层认知的工程师。本文核心命题 :分块不是「把长文本切短」这么简单------它是 RAG 系统里唯一一个同时决定「检索精度」和「生成质量」的环节,而它却常常被当成默认参数随手一填。
一、先说结论:分块是 RAG 的「隐形的天花板」
如果你问一个 RAG 工程师「系统哪里最重要」,大概率会听到「检索」或「生成」。但如果你问「哪里的参数最容易被忽略、又最容易让系统崩盘」,答案几乎总是分块。
原因在于,分块处于一个「承上启下」的关键位置:
- 承上 :它接收 L3 导入的
Document,决定「以什么粒度」去理解这段文本。 - 启下:它决定「以什么粒度」去嵌入、去索引、去检索,最终决定「以什么粒度」把信息喂给生成模型。
这不是一个「参数调优」问题,而是一个「信息粒度」问题。用一句话概括:
你把文本切成什么样,检索就只能在什么样的粒度上「看见」它;生成也只能在什么样的粒度上「使用」它。
在 L3 篇中我们反复强调:「检索质量的上限,在数据进入索引之前就已经被决定了。」而分块,正是「进入索引之前」的最后一道、也是最关键的一道工序。
1.1 一个隐喻:分块像「切菜」
想象你在给一家餐厅备菜。同样的食材,切法不同,做出来的菜完全不同:
- 整颗下锅(不分块):信息都在一起,但检索时「什么都沾一点,什么都抓不住」。
- 切得太碎(块太小):每一块都清晰,但「看不到全貌」,上下文被切断了。
- 切成合适的大小(块合适):既有足够的上下文,又能被精准定位。
分块的本质,就是在「上下文完整性」和「检索精准性」之间找平衡点 。这个平衡点不是固定的,它取决于你的文档类型、查询类型、嵌入模型、以及生成模型的能力。
1.2 本文要讲透的四个原理问题
在进入「怎么分块」之前,必须先回答四个「为什么」:
| 问题 | 一句话答案 | 展开见 |
|---|---|---|
| 为什么要分块? | 让嵌入、索引、存储、检索都在「合理粒度」上进行 | 第二节 |
| 块多大才合适? | 取决于「模型最长上下文」和「嵌入过程的信息压缩率」 | 第三节 |
| 块大小如何影响检索? | 决定「嵌入向量能捕捉多少语义信息」 | 第四节 |
| 块大小如何影响生成? | 决定「喂给生成模型的信息是否被稀释、是否被忽略」 | 第五节 |
这四个问题,构成了分块原理的完整闭环。理解了它们,你就能理解为什么「分块决定检索质量」不是一句口号。
二、为什么要分块:从「一张纸」到「可检索的块」
2.1 不分块会发生什么?
假设你有一份《中华人民共和国民法典》全文,几十万字,直接把它作为一个整体喂给系统。会发生什么?
第一,嵌入模型「装不下」。 大多数嵌入模型(embedding model)的输入长度有限,通常只能处理几百到几千个 token。一份几十万字的文档,要么被截断,要么根本无法一次性编码。
第二,即使「装得下」,嵌入向量也会「失真」。 嵌入的本质是把一段文本压缩成一个向量(通常是 768 维、1024 维或更高)。如果你把几十万字压缩成一个向量,那么这段文本的「语义指纹」就被平均化了------它什么都知道一点,但什么都不精确。当你检索「离婚冷静期」时,这个「什么都包含」的向量无法精准命中。
第三,检索变成「大海捞针」。 即使你强行把整篇文档嵌入,检索时返回的也只会是「整个文档」这个粒度。用户问「民法典第 1077 条关于离婚冷静期的规定」,你返回的是「整部民法典」,这毫无意义。
所以,分块的第一性原理是:
为了让「嵌入、索引、检索、生成」都在一个足够细、又能保留上下文的粒度上进行,必须把长文本分解成适当大小的片段。
2.2 分块到底在「切」什么?
这里要澄清一个常见误区:分块不是简单地按字符数「一刀切」,而是在「语义边界」上切。
一个好的分块,应该是这样的:
- 一个块 = 一个相对完整的信息单元。比如一条法条、一个自然段、一个标题下的内容。
- 一个块 = 一个相对独立的语义主题。比如「离婚冷静期」「夫妻共同财产分割」「子女抚养权归属」。
为什么强调「语义边界」?因为嵌入模型理解的是「语义」,而不是「字符」。如果你把一个完整的语义单元从中间劈开,嵌入向量就会「两头不讨好」------它既不像前半段的意思,也不像后半段的意思。
这正是「主题稀释」问题的根源,我们会在第五节详细展开。
2.3 分块的三个「粒度」维度
理解分块,可以从三个维度看它「切」的是什么:
| 维度 | 切的是什么 | 工具举例 | 适用场景 |
|---|---|---|---|
| 字符粒度 | 按固定字符数硬切 | CharacterTextSplitter |
简单文本、无结构文档 |
| 结构粒度 | 按文档结构(段落、标题、代码块)切 | RecursiveCharacterTextSplitter、Unstructured |
有结构的文档、代码、Markdown |
| 语义粒度 | 按语义相似度/断点切 | SemanticSplitterNodeParser |
语义连贯性要求高的场景 |
这三个粒度,对应了 L4 篇「原理→实现」的演进逻辑。本文先讲清楚「为什么」,下一篇再展开「怎么做」。
三、如何确定分块大小的上限:模型最长上下文
3.1 一个被误解的概念:「上下文长度」
很多人以为「分块大小」应该越小越好,因为「模型上下文有限」。但这里有一个关键区分:
「模型的最长上下文」不等于「分块的最佳大小」。
- 模型最长上下文(context window):是模型能一次性处理的 token 上限,比如 128K、200K。这是「天花板」。
- 分块大小 (chunk size):是你希望检索到、并喂给生成模型的单个信息单元的大小。这是「地板」。
两者完全不是一回事。分块大小应该远小于模型上下文,因为:
- 检索目标不是「塞满上下文」,而是「精准命中」。你希望检索返回的是「最相关的那一小块」,而不是「整篇文档都塞进去」。
- 上下文越长,检索越容易「迷失」。这正是第五节要讲的「lost in the middle」问题。
3.2 如何确定「最大能接受的分块」?
有一个很实用的判断思路:先确定模型能接受的最长上下文,再反推分块上限。
具体来说,你要考虑的是「检索到的最相关块 + 系统提示词 + 用户问题 + 历史对话」的总和,是否在模型上下文窗口内。公式可以概括为:
总上下文 = 系统提示词 + 用户问题 + 检索到的块 × N + 历史对话其中 N 是检索返回的块数量(通常是 top-k,比如 5~10 个)。所以:
scss
单块大小上限 ≈ (模型上下文 - 系统提示词 - 用户问题 - 历史对话) / N举个例子,假设模型上下文是 128K token:
- 系统提示词 + 用户问题 + 历史对话 ≈ 8K token
- 检索返回 top-5 块
- 那么单块大小上限 ≈ (128K - 8K) / 5 ≈ 24K token。
这看起来很大,但这只是一个「物理上限」,不是「最优值」。实际最优值往往远小于这个上限,因为还要考虑「检索精度」和「生成质量」两个约束。
3.3 为什么「物理上限」不等于「最优值」?
因为分块大小有两个相互拉扯的约束:
- 太小:检索精准,但上下文不足,生成时「只见树木不见森林」。
- 太大:上下文充足,但检索变糊,主题被稀释,生成时「迷失在中间」。
这两个约束,正好对应接下来两节要讲的核心原理。所以「确定分块大小」不是解一个「上限方程」,而是解一个「多目标优化」------这也是为什么它常常被当作「经验值」而不是「公式值」。
实操建议 :不要一上来就追求「最大化利用上下文」。先从一个「相对小」的块开始(比如 400~800 token),用检索评测跑一遍,再逐步调大,找到「检索精度」和「生成质量」的平衡点。这也呼应了 2026 年 RAG 工程实践的主流共识------分块大小不是拍脑袋定的,是评测出来的。
四、分块大小如何影响检索精度:理解嵌入过程
这是分块原理里最核心、也最容易被误解的一节。要理解「分块大小为什么影响检索精度」,必须先理解「嵌入模型到底在干什么」。
4.1 嵌入的本质:把一段文本「压缩」成一个向量
嵌入(embedding)的本质,是把一段文本通过神经网络编码成一个高维向量。这个向量可以理解为这段文本的「语义指纹」。
关键点在于:这个「语义指纹」是「平均化」的。 它不是逐词记录,而是把整段文本的语义「压缩」到一个向量里。
这就引出了一个核心矛盾:
一段文本越「杂」,压缩后的向量越「糊」;一段文本越「纯」,压缩后的向量越「准」。
4.2 块太大:语义被「平均化」,检索变糊
假设你把《中华人民共和国民法典》的「婚姻家庭编」整编切成一个块。这个块里包含了结婚、离婚、夫妻财产、子女抚养、收养......几十个不同的主题。
当你把它嵌入成一个向量时,这个向量就成了「婚姻家庭编」的平均语义。现在用户问:
「离婚冷静期是多久?」
这个「平均化」的向量,无法精准命中「离婚冷静期」这个具体概念。因为它在向量空间里,既像「结婚」,也像「离婚」,也像「抚养」,但什么都不精确。检索时,它可能排在「抚养权」块之后,因为「抚养权」块更「纯」。
这就是**「主题稀释」**------一个块里包含的无关主题越多,这个块对「任何单一主题」的检索匹配度就越低。
4.3 块太小:语义被「截断」,上下文丢失
反过来,如果块切得太小,比如把「离婚冷静期」这条法条从中间劈开,只保留前半句「自婚姻登记机关收到离婚登记申请之日起三十日内」,而把后半句「任何一方不愿意离婚的,可以向婚姻登记机关撤回离婚登记申请」切到下一个块。
那么:
- 前半块嵌入后,语义指向「离婚登记申请」,但缺少「三十日」这个关键信息。
- 后半块嵌入后,语义指向「撤回离婚登记申请」,但缺少「三十日」这个前提。
两个块都「残缺」,谁也说不清「离婚冷静期是多久」。 更糟的是,如果用户问题里包含「三十日」,而「三十日」恰好被切到了另一个块,检索就完全失配。
4.4 2026 年的实证结论:块大小与嵌入模型「耦合」
分块大小不是「全局最优值」,而是「跟嵌入模型强耦合」的。2025 年一项横跨多个数据集与嵌入模型的系统研究,给出了非常清晰的实证结论:
- 小块的适用场景 :对于「事实型、实体型」的短答案查询(如 SQuAD),64~128 token 的小块效果最好,
recall@1可达 64.1%;但块增大到 512 token 时,召回率反而下降 10~15%,因为过多上下文引入了噪声。 - 大块的适用场景 :对于需要「广泛上下文理解」的查询(如长文档摘要、跨段推理),512~1024 token 的大块效果更好,因为小块切断了上下文联系。
- 嵌入模型差异 :不同嵌入模型对块大小的敏感度不同。Stella 这类模型受益于更大的块(利用全局上下文做长距离检索);而 Snowflake 这类模型在小块上表现更好(擅长细粒度、实体级匹配)。
这个结论对实际工程有重大启示:
「分块大小」不是一个可以脱离嵌入模型单独调的参数。你换一个嵌入模型,可能就要重新调一遍分块。
4.5 一个「理想分块」的视觉模型
让我们用一个直观的模型来理解「好的分块长什么样」:
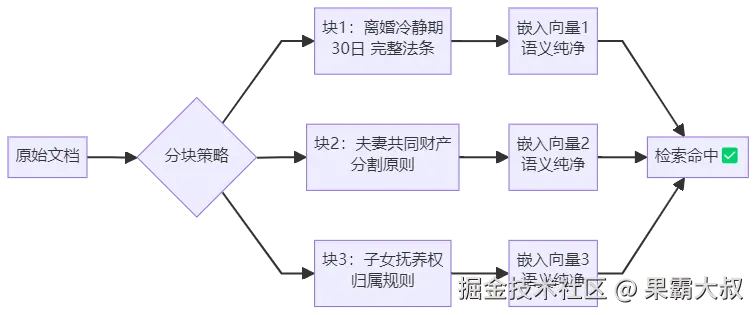
理想的块应该是:每个块内部是「一个完整、独立的语义单元」,块与块之间主题清晰可分。这样嵌入后,每个向量都是「纯」的,检索时能精准命中。
五、分块大小如何影响生成质量:lost in the middle
理解「lost in the middle」,是理解「分块为什么影响生成」的关键。这也是 2024 年以来长上下文研究里最被广泛引用的现象之一。
5.1 什么是「lost in the middle」?
「lost in the middle」指一个现象:大语言模型在处理长上下文时,对「开头」和「结尾」的信息利用得最好,对「中间」的信息利用得最差。 这个现象最早由 Liu et al.(2024)系统性报告,被称为「位置偏差」(positional bias)。
用一句话概括:
模型像人一样,注意力呈「U 型分布」------开头和结尾记得牢,中间容易忘。
5.2 为什么分块会「放大」lost in the middle?
这里有一个容易被忽略的连锁反应:
- 你切了 N 个块。
- 检索返回了 top-k 个块(比如 5 个)。
- 这 5 个块被拼成一个「检索上下文」,喂给生成模型。
- 如果这 5 个块里,真正相关的信息恰好排在「中间」,模型就可能「忽略」它。
举个例子,法律检索场景:
- 用户问:「离婚冷静期是多久?」
- 检索返回了 5 个块,按相似度排序:
- 第 1 名:关于「结婚登记」的块(相似度略低但排前)
- 第 2 名:关于「离婚冷静期 30 日」的块(真正相关)
- 第 3~5 名:关于「财产分割」「抚养权」「收养」的块
如果生成模型对「中间位置」的块(第 2 名)注意力不足,它可能只参考了「结婚登记」和「财产分割」,而忽略了真正回答问题的「离婚冷静期」。最终生成一个「答非所问」的结果。
5.3 分块如何「缓解」lost in the middle?
既然「lost in the middle」是位置偏差,那么分块策略可以从两个方向缓解它:
方向一:让「最相关的块」尽量「少而精」。
如果检索返回的块数量少(比如 top-3 而不是 top-10),那么「真正相关的块」被挤到中间的概率就低。这要求分块足够「纯」,让检索能精准命中,而不是「每个块都沾一点」。
方向二:让「每个块」都是「完整主题」,减少「需要在中间拼接」的需求。
如果每个块都是「一个完整主题」(比如「离婚冷静期:30 日」),那么即使它排在中间,模型也能「独立理解」它,不需要依赖前后块才能读懂。反之,如果块被切得支离破碎,模型必须「跨块拼接」才能理解完整信息,这时候位置偏差的影响就会被放大。
5.4 一个直观的「主题明确小块」思路
用一个「高血压」的例子,可以非常清晰地说明这个原理:
通过合理的分块策略,将知识库中的内容切分为主题明确的小块,如「高血压:常用药物」「高血压:用药禁忌」「高血压:生活方式建议」。
每块保持在 500 字符左右,可以使检索过程更精准地捕捉每个主题的核心信息,并仅将该信息传递给生成模型,从而生成精准的回答,例如「常用的降压药包括药物 A 和药物 B,需要在医生指导下服用」。
这个例子的精髓在于:
分块的最终目的,是让生成模型「只看到它需要的那一小块」,而不是「看到一大堆似是而非的东西」。
5.5 2026 年的新进展:从「被动接受位置偏差」到「主动校准」
值得注意的是,2026 年的研究不再只是「承认 lost in the middle」,而是开始「主动校准」它。例如「Found in the Middle」等研究提出,通过对位置注意力偏差进行校准(calibration),可以显著改善长上下文利用率。
这对 RAG 工程的启示是:
分块策略 + 检索排序策略,应该「联合设计」。分块决定「块的内容纯度」,排序决定「块的呈现位置」。两者配合,才能最大化生成质量。
六、主题稀释:为什么「一个块一个主题」如此重要
6.1 什么是主题稀释?
「主题稀释」是分块里最隐蔽、但也最致命的陷阱。它指的是:
当一个文本块包含多个不同主题时,这个块对「任何一个单一主题」的语义匹配度都会被稀释。
用一个线下旅游知识库的例子来理解:
假设你建了一个包含各地景点和活动的知识库。如果一个文本块同时包含了「五台山、云冈石窟、太原游乐场」的描述,当用户问「适合带小朋友玩的景点」时:
- 这个「综合信息块」的嵌入向量,同时包含了「佛教名山」「唐代造像」「游乐场」三个主题。
- 它既不完全像「游乐场」(适合带小朋友),也不完全像「佛教名山」(不适合带小朋友)。
- 因此,检索时它的相似度得分不会很高 ,因为它被「五台山」「云冈石窟」这两个「不适合小朋友」的主题稀释了。
反之,如果每个景点的信息被独立成块:
- 「五台山:佛教名山」
- 「云冈石窟:唐代造像巅峰」
- 「太原游乐场:暑期攻略」
那么当用户问「适合带小朋友玩的景点」时,「太原游乐场:暑期攻略」这个块就能精准命中,因为它的语义向量是「纯」的,没有被其他主题稀释。
6.2 主题稀释的本质:向量空间的「平均化」
主题稀释的本质,就是我们在第四节讲的「嵌入是平均化压缩」的直接后果。
- 一个块包含的主题越多 → 嵌入向量越「平均」→ 对任何单一主题的匹配度越低。
- 一个块的主题越纯 → 嵌入向量越「尖锐」→ 对目标主题的匹配度越高。
所以,「一个块一个主题」不是洁癖,而是为了让嵌入向量「尖锐」到足以精准命中。
6.3 法律场景中的主题稀释:比想象中更严重
把「主题稀释」放到法律条文检索场景,问题会变得更加严重。因为法律文本有一个特点:一条法条往往包含多个「要件」,而这些要件可能属于不同「主题」。
以《民法典》第 1077 条(离婚冷静期)为例:
自婚姻登记机关收到离婚登记申请之日起三十日内,任何一方不愿意离婚的,可以向婚姻登记机关撤回离婚登记申请。前款规定期限届满后三十日内,双方应当亲自到婚姻登记机关申请发给离婚证;未申请的,视为撤回离婚登记申请。
这一条里其实包含了多个可独立检索的「要件」:
- 申请主体:婚姻登记机关、离婚登记申请
- 冷静期:三十日
- 撤回权:任何一方不愿意离婚,可撤回
- 后续程序:期限届满后三十日内申请发给离婚证
- 视为撤回:未申请则视为撤回
如果把这整条切成一个块,那么当用户问「离婚冷静期是多久」时,这个块里「三十日」这个信息被「申请主体」「撤回权」「后续程序」等主题稀释了------虽然它包含正确答案,但向量匹配度可能不如一个「只讲冷静期」的纯块。
这就是法律场景分块的独特难点:法条是「结构化的」,但用户查询往往是「点状的」。如何在「保留法条完整性」和「让点状查询精准命中」之间取得平衡,是法律 RAG 分块的核心挑战。
6.4 一个「主题稀释」的量化直觉
为了更直观地理解主题稀释,我们可以用一个简化的模型:
假设一个块包含 N 个主题,每个主题的语义强度为 1。
那么嵌入向量对「任一主题」的匹配度 ≈ 1 / N- 1 个主题的块:匹配度 ≈ 1(完美命中)
- 3 个主题的块:匹配度 ≈ 0.33(被稀释)
- 5 个主题的块:匹配度 ≈ 0.2(严重稀释)
这只是一个直觉模型,但方向是对的:主题越多,单一主题的匹配度越低。 这也是为什么「一个块一个主题」是分块的第一原则。
七、用 ChunkViz 可视化分块:让「看不见的切分」变得「看得见」
7.1 为什么需要可视化?
分块是一个「黑盒」操作。你设置了 chunk_size=1000,但你不清楚:
- 1000 个字符会切在「哪里」?
- 切出来的块,语义是否完整?
- 有没有把「离婚冷静期」从中间劈开?
- 有没有把「五台山」和「游乐场」塞进同一个块?
这些问题,光看代码是看不出来的。你需要「看见」你的文档被切成什么样。 这正是 ChunkViz 这类可视化工具的价值。
7.2 ChunkViz 是什么?
ChunkViz 是一个可视化文本分块策略的开源工具,最早由 Greg Kamradt 开发。它的核心功能是:
用不同的颜色,直观地展示「不同的分块策略」是如何切分同一段文本的。
通过 ChunkViz,你可以:
- 对比不同分块策略:固定字符数、递归、语义分块......看它们切出来的块有什么不同。
- 调整参数 :修改
chunk_size、chunk_overlap,实时看到切分结果的变化。 - 定位问题:一眼看出「这个块把完整法条切断了」「那个块把两个主题混在一起了」。
ChunkViz 有在线版本可以直接体验,也有开源仓库可以本地部署(在搜索引擎里搜「ChunkViz」即可找到)。
7.3 用 ChunkViz 调试法律分块的实操思路
假设你在调试「离婚冷静期」这条法条的分块。你可以这样做:
-
把法条文本粘进 ChunkViz。
-
分别用「固定字符数」「递归」「语义」三种策略切一遍。
-
观察:
- 固定字符数策略,是不是把「三十日」从「撤回权」中间切断了?
- 递归策略,是不是按「句号」切分,保留了「三十日」这个完整要件?
- 语义策略,是不是把「申请主体」「冷静期」「撤回权」分成不同块?
-
根据观察调整参数,直到每个块都是「一个完整要件」。
7.4 2026 年的可视化生态:从 ChunkViz 到「检索实验室」
值得注意的是,2026 年的分块可视化已经不只停留在「看切分」,而是演进为「可视化 + 评测」的一体化工具。例如:
- RAG Chunking Lab :一个交互式文档分块工具,可以在浏览器里可视化分块策略,并本地测试检索性能,全程客户端处理、无需后端(关键词:RAG Chunking Lab)。
- Chunk-bench :一个基准评测工具,2026 年的基准显示,同一语料上「最优」与「最差」分块策略之间,召回率差距可达 9%(关键词:chunk-bench)。
这个趋势说明一件事:
分块已经从「凭经验拍脑袋」进入「可视化 + 可评测」的工程化阶段。 未来「调分块」不再是「猜参数」,而是「看可视化 + 跑基准」。
7.5 一个实操建议:把「可视化」纳入你的分块工作流
结合前面的原理,我建议你在搭建 RAG 时,把「可视化」作为分块调试的标准动作:
- 先用 ChunkViz 看:你的文档被切成什么样?有没有语义断裂?有没有主题混杂?
- 再跑基准测:用 Chunk-bench 或自建评测集,测不同分块策略的召回率。
- 最后定参数:基于「可视化观察 + 基准数据」确定最终的分块策略。
这三步,把「分块」从「玄学」变成「工程」。
八、生态增量:2026 年值得关注的分块前沿
这一节我们跳出基础原理,看看分块技术在 2026 年有哪些值得关注的增量。这些增量不是「锦上添花」,而是正在改变「分块」这一环节的底层逻辑。
8.1 分块大小的「实证化」:从经验到数据
前面第四节提到的那项多数据集研究,是分块领域近年来最系统的实证研究之一 。它的核心贡献是:把「分块大小」从一个「经验值」变成了一个「可评测、可优化」的参数。
研究结论可以概括为一张「分块大小 × 查询类型」的决策表:
| 查询类型 | 推荐块大小 | 原因 |
|---|---|---|
| 事实型、实体型短答案(如 SQuAD:某法条是多少条) | 64~128 token | 小块精准命中,避免上下文噪声 |
| 需要广泛上下文理解(如跨段推理、摘要) | 512~1024 token | 大块保留上下文联系 |
| 长距离、全局上下文检索 | 大块(配合长上下文嵌入模型) | 利用全局语义 |
这个决策表的核心启示是:
不要问「分块多大最好」,而要问「我的查询类型是什么」。不同的查询类型,需要不同的分块粒度。
对法律检索平台来说,这意味着:你至少要区分「点状查询」(查某条法条)和「关系型查询」(查某类案件的裁判规则)两类,分别设计分块粒度。
8.2 Contextual Retrieval:给每个块「补上下文」
传统分块最大的痛点,就是「切断上下文」。业界在 2024 年底提出的 Contextual Retrieval(上下文检索),正是为了解决这个问题。
它的核心思路是:
在嵌入/索引之前,先用 LLM 为每个 chunk 生成一段 50~100 token 的「上下文说明」,并把它拼接到块上。
举个例子,假设你切出了一个块:
「自婚姻登记机关收到离婚登记申请之日起三十日内」
如果用 Contextual Retrieval,它会为这个块生成一段上下文说明:
「这段话出自《中华人民共和国民法典》第一千零七十七条,规定的是离婚冷静期。即夫妻双方申请协议离婚后,有三十天的冷静期,任何一方在此期间可以撤回申请。」
然后把这段说明拼接到块上,变成:
「【上下文说明:这段话出自《民法典》第 1077 条,规定离婚冷静期......】自婚姻登记机关收到离婚登记申请之日起三十日内」
效果如何? 数据非常亮眼:
- Contextual Embeddings :将 top-20 检索失败率降低 35%。
- Contextual Embeddings + Contextual BM25 :最高可降低 67%。
为什么有效? 因为它解决了「块被切断后语义残缺」的问题。即使块本身被切断了,附加的上下文说明也能「补全」它的语义,让嵌入向量更「准」。
对法律场景的启示:法律条文尤其适合 Contextual Retrieval。因为法条编号、效力层级、所属编章这些「上下文信息」,恰恰是法律检索最需要、也最容易被切断的。给每个块补上「出处 + 效力层级 + 所属条款结构」,能显著提升检索精度。
业界推荐的起步策略 :先用 recursive 512-token + 10~20% overlap 分块,再叠加 Contextual Retrieval。这是一个「先跑通、再优化」的务实路径。
8.3 Late Chunking:先「全局理解」再「局部切分」
Late Chunking 是 EMNLP 2024 上提出的一种「颠覆传统顺序」的分块思路。
传统分块是先切分、再嵌入:
切分 → 每个块独立嵌入 → 得到 N 个向量Late Chunking 是先嵌入、再切分:
matlab
整篇文档嵌入(长上下文模型) → 在块边界做 mean-pooling → 得到 N 个向量为什么这样更好?
因为传统「先切分再嵌入」的问题在于:每个块在嵌入时,只能看到它自己,看不到上下文。 比如「三十日内」这个块,单独嵌入时不知道它是「离婚冷静期」的三十日,还是「上诉期」的三十日。
而 Late Chunking 用长上下文嵌入模型 (支持 8192 token 的模型)先对整篇文档 编码,让每个 token 的向量都「看见了全局上下文」,然后再在块边界做 mean-pooling,得到保留了跨块上下文的块向量。
成本如何? 存储成本与朴素分块相同,大约是 ColBERT 这类「token 级」检索方法的 1/500。
对法律场景的启示:Late Chunking 特别适合法律文本,因为法律条文里大量存在「同一术语在不同语境下含义不同」的情况(如「三十日」在离婚冷静期和上诉期含义完全不同)。Late Chunking 让每个块「记住」了它所在的上下文,从而避免「语境误判」。
8.4 LangChain 1.0 的分块变化:token-aware splitting
作为系列的核心框架,LangChain 在 1.0 版本对分块也带来了一些值得关注的变化。
变化一:langchain-text-splitters 独立成包。
在 1.0 中,文本分块相关的工具被独立为 langchain-text-splitters 包,不再与核心框架强耦合。这符合 LangChain 1.0「模块化、轻量化」的整体方向。
变化二:token-aware splitting 成为新趋势。
传统的分块(如 CharacterTextSplitter)是按「字符数」切分的。但字符数和 token 数并不等价------一个中文汉字可能占 12 个 token,一个英文单词可能占 13 个 token。 因此,按字符切分往往导致「块的实际 token 数」远大于预期。
1.0 生态中出现了 token-aware splitting 的趋势:用 length_function 按 token 数来切分,而不是按字符数。这样切出来的块,token 数更准确,更符合模型的实际处理能力。
对法律场景的启示 :中文法律文本的字数多、术语密集,强烈建议使用 token-aware splitting。否则,你按 1000 字符切分,实际可能得到 1500~2000 token 的块,远超预期,导致检索和生成都「超载」。
8.5 生态增量小结:三股「改变分块逻辑」的力量
把上面的生态增量汇总一下,可以看到三股正在「改变分块底层逻辑」的力量:
| 力量 | 核心思想 | 解决什么问题 | 对法律场景的价值 |
|---|---|---|---|
| 实证化 | 分块大小是可评测、可优化的参数 | 告别「拍脑袋」 | 区分点状/关系型查询,分别定粒度 |
| Contextual Retrieval | 给每个块「补上下文」 | 解决「切断上下文」 | 补法条编号、效力层级、条款结构 |
| Late Chunking | 先「全局理解」再「局部切分」 | 解决「语境误判」 | 让「三十日」等术语记住所在语境 |
这三股力量告诉我们:2026 年的分块,不再是「简单把文本切短」,而是一个「信息粒度 + 上下文补全 + 全局理解」的综合工程。
九、结合法律条文检索平台:分块策略推演
9.1 法律文本的「特殊性」
前面我们反复强调,法律场景分块比通用场景更复杂。这里我们把法律文本的「特殊性」系统梳理一下:
| 特殊性 | 表现 | 对分块的影响 |
|---|---|---|
| 条款结构 | 法律按「编→章→节→条→款→项」组织 | 分块应尊重条款边界,避免从「条」中间切断 |
| 要件拆分 | 一条法条含多个可独立检索的要件 | 既要保留完整法条,又要让点状要件可精准命中 |
| 术语语境 | 同一术语在不同法条含义不同 | 需要「全局上下文」避免语境误判 |
| 效力层级 | 法律、行政法规、司法解释效力不同 | 分块时保留效力层级元数据,用于过滤 |
| 援引关系 | 法条之间大量交叉引用 | 需要「关系型」建模,而非纯向量 |
9.2 法律场景的「分块策略建议」
基于上面的特殊性,我给出一个法律条文检索平台的「分块策略建议」:
第一层:按「条」为基本分块单位。
法律条文最自然的语义边界是「条」。一条法条通常是一个完整的规范单元。因此,优先按「条」切分,而不是按字符数硬切。
第二层:用「要件」做子块(可选)。
对于一条包含多个要件、且用户常按要件查询的法条(如第 1077 条),可以进一步拆成「要件级」子块。但这需要权衡:子块越细,点状查询越准,但「整条法条」的完整性越弱。
第三层:补充「上下文元数据」。
无论怎么切,都要给每个块补上关键元数据:
- 法条编号(如「民法典第 1077 条」)
- 效力层级(法律/行政法规/司法解释)
- 所属编章(婚姻家庭编)
- 颁布年份、生效日期
这些元数据,正是 Contextual Retrieval 的核心价值所在。
第四层:区分「点状」与「关系型」查询。
- 点状查询(查某条法条):用小块 + 精准检索。
- 关系型查询(查某类案件裁判规则、新旧法替代):用大块 + 关系型建模(如 Graph RAG)。
这也呼应了我们在 L3「表格与数据库篇」的核心判断:点状实体用表格 RAG 按行检索,关系型知识用 Graph RAG,形成「图 + 向量」双路检索。
9.3 一个「法律分块」的实操示例
假设你要分块《民法典》婚姻家庭编,一个「尊重条款结构 + 保留上下文」的分块示例:
python
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_core.documents import Document

# 假设已经通过 L3 解析,得到「按条」切好的 Document 列表
law_docs = [
    Document(
        page_content="第一千零七十七条 自婚姻登记机关收到离婚登记申请之日起三十日内,任何一方不愿意离婚的,可以向婚姻登记机关撤回离婚登记申请。前款规定期限届满后三十日内,双方应当亲自到婚姻登记机关申请发给离婚证;未申请的,视为撤回离婚登记申请。",
        metadata={
            "law_name": "中华人民共和国民法典",
            "article_no": "第一千零七十七条",
            "chapter": "婚姻家庭编",
            "effect_level": "法律",
            "effective_date": "2021-01-01"
        }
    ),
    # ... 其他法条
]

# 使用 token-aware splitting,按 token 而非字符切分
splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=256,   # 按 token 数
    chunk_overlap=32  # 10~20% overlap
)

chunks = splitter.split_documents(law_docs)关键点:
- 用
RecursiveCharacterTextSplitter,它会优先在「段落、句号」等语义边界切分,而不是硬切。 - 用
from_tiktoken_encoder,实现 token-aware splitting,避免「按字符切分导致 token 超载」。 - 保留完整 metadata,为后续 Contextual Retrieval 和过滤检索打基础。
十、总结:分块为什么决定检索质量
回到本文的核心命题。分块之所以决定检索质量,是因为它同时锁定了四个「看不见的边界」:
- 信息粒度的边界:检索只能在「块」的粒度上「看见」信息。块太大,检索变糊;块太小,上下文丢失。
- 语义纯度的边界:嵌入是「平均化压缩」,块的主题越纯,向量越「尖锐」,检索越精准。
- 上下文完整性的边界:块被切断后,语义会残缺;需要 Contextual Retrieval / Late Chunking 来「补全」。
- 生成质量的边界:块在 prompt 中的位置影响「lost in the middle」,分块策略要与检索排序联合设计。
用一句话收束:
分块不是「把长文本切短」,而是「在信息粒度、语义纯度、上下文完整性、生成位置」四个维度上,为整个 RAG 系统设定「检索的视野」和「生成的边界」。
10.1 本文的三个核心判断
- 分块大小不是「全局最优值」,而是「跟嵌入模型、查询类型强耦合」的参数。 换嵌入模型、改查询类型,都要重新调分块。
- 「一个块一个主题」是分块的第一原则。 主题稀释会让嵌入向量「变糊」,导致检索失配。
- 2026 年的分块正在从「玄学」走向「工程」。 分块大小的系统评测、Contextual Retrieval、Late Chunking、可视化评测(ChunkViz / RAG Chunking Lab / chunk-bench),让分块成为「可评测、可优化」的环节。
下一篇预告:从「为什么分块」到「怎么分块」
本文回答了「为什么分块决定检索质量」这个原理问题。但「知道为什么」只是第一步,「知道怎么做」才是落地的关键。
下一篇将进入 L4 的实现与进阶篇,主题是:
《文本分块实现与高级索引:四种 Splitter + 父子块 + 层级索引》
将覆盖:
- 四种 Splitter 的实现对比 :
CharacterTextSplitter、RecursiveCharacterTextSplitter、基于结构的拆分(Unstructured)、SemanticSplitterNodeParser语义分块。 - 滑动窗口句子切分:如何用滑动窗口保留「句子级」的上下文。
- 父子块(Parent-Child Docs):检索用小块(精准),生成用父块(完整上下文)。
- Summary → Details 层级索引:先检索「摘要」,再定位「细节」。
下一篇将是「原理→实现」的落地闭环,敬请期待。