官网:
升级 kubeadm 集群 | Kubernetes
版本偏差策略
修改各节点的k8s安装源
主节点和工作节点都需要修改

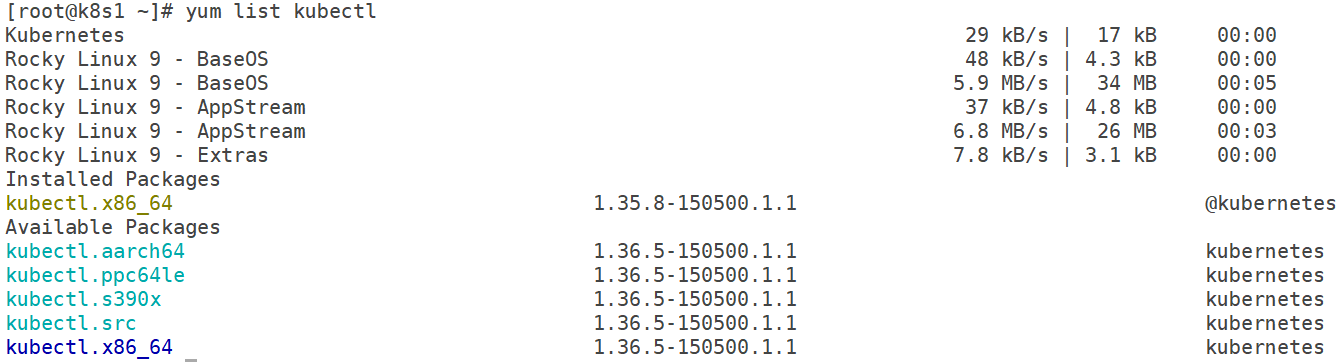
升级 k8smaster节点
升级kubeadm


提前下载k8s升级镜像,并上传至harbor私有仓库
可以新建一个images文件,将需要的镜像名输入
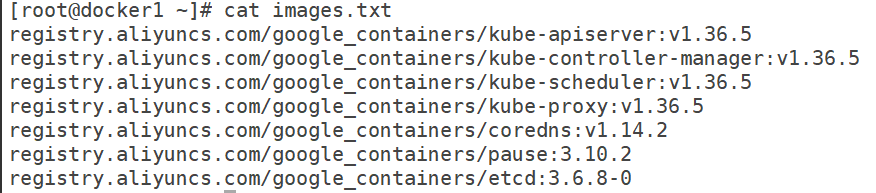
使用以下命令进行逐个拉取
while read img; do docker pull $img; done < images.txt再将文本中的标签改为私有仓库
sed -i 's#registry.aliyuncs.com/google_containers#reg.westos.org/k8s#g' images.txt批量打上标签
while read westos_img; do
  ali_img=$(echo "$westos_img" | sed 's#reg.westos.org/k8s#registry.aliyuncs.com/google_containers#')
  docker tag "$ali_img" "$westos_img"
done < images.txt
批量推送(加入空行判断)
while read img; do
  if [ -n "$img" ];then
    docker push "$img"
  fi
done < images.txt
修改containerd配置


验证升级计划

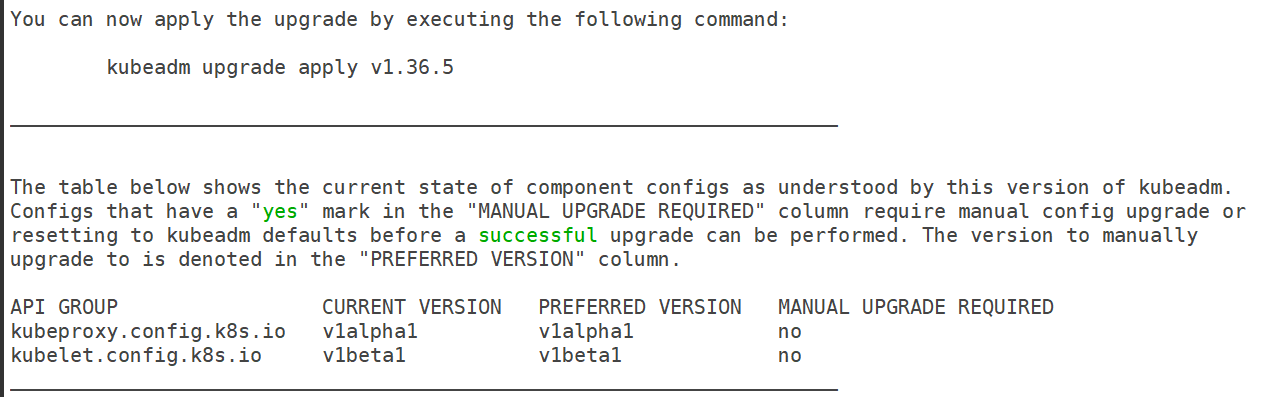
执行升级命令
等待升级完成

成功

如有需要手动升级CNI 驱动插件
如果有多个master节点,可以执行以下命令升级:
kubeadm upgrade node
不需要执行 kubeadm upgrade plan 和更新 CNI 驱动插件的操作
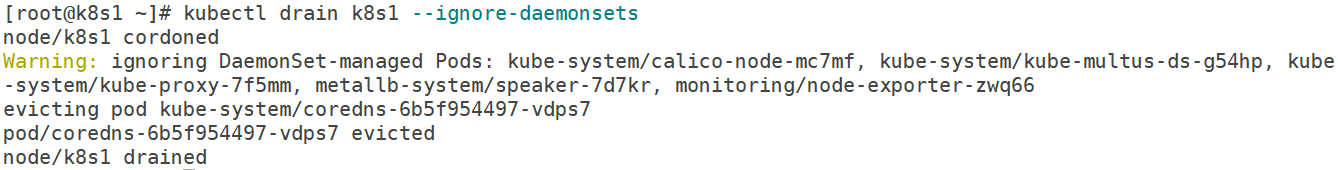
腾空节点
升级 kubelet 和 kubectl

重启kubelet
解除节点的保护
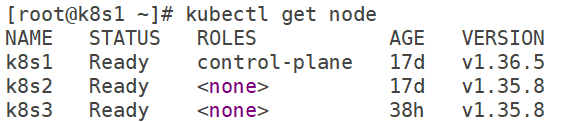
验证集群状态
主节点已升级成功
升级工作节点
最好逐个升级,如果需要同时升级则保证有合适的node可以接纳被驱逐的pod
修改containerd配置



升级kubeadm


执行升级命令


腾空节点(需要在k8s-master节点执行)

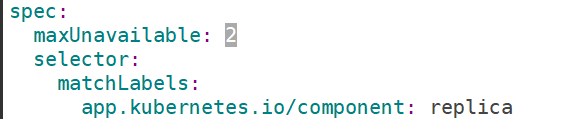
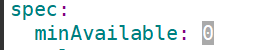
如果出现无法删除的pod,可以修改最大容忍(取决于副本数)和最小可用
升级 kubelet 和 kubectl

重启kubelet

解除节点的保护 ( 需要在k8s-master节点执行 )
其它工作节点以此类推
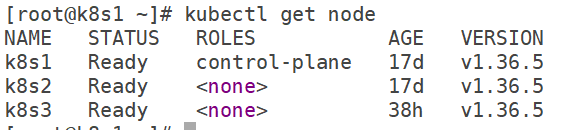
最后验证集群状态
成功
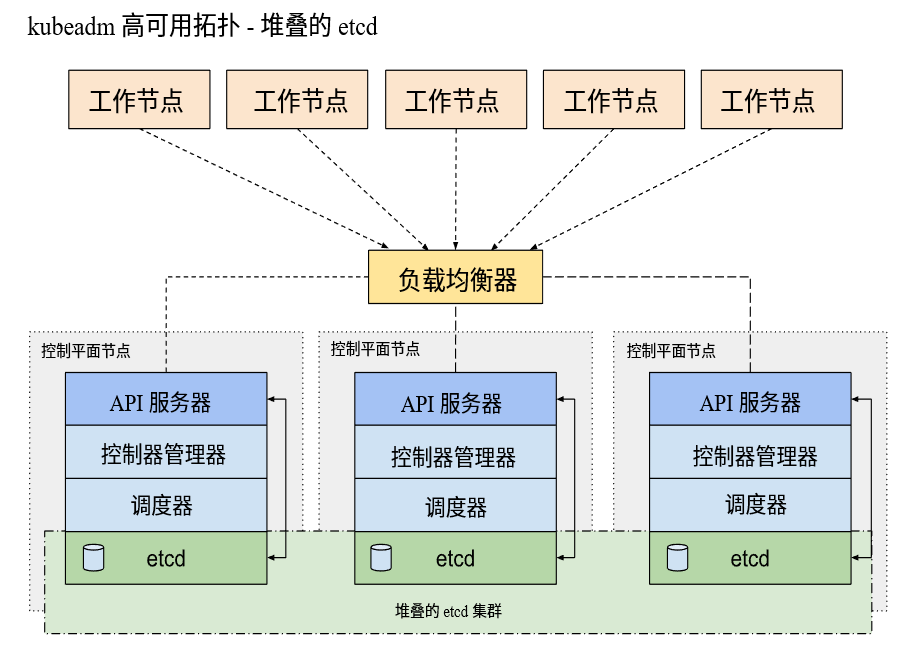
k8s高可用集群
每个控制平面节点运行 kube-apiserver、kube-scheduler 和 kube-controller-manager 实例。 kube-apiserver 使用负载均衡器暴露给工作节点。
每个控制平面节点创建一个本地 etcd 成员(member),这个 etcd 成员只与该节点的 kube-apiserver 通信。 这同样适用于本地 kube-controller-manager 和 kube-scheduler 实例。
这种拓扑将控制平面和 etcd 成员耦合在同一节点上。相对使用外部 etcd 集群, 设置起来更简单,而且更易于副本管理。
HA 集群运行至少三个堆叠的控制平面节点。
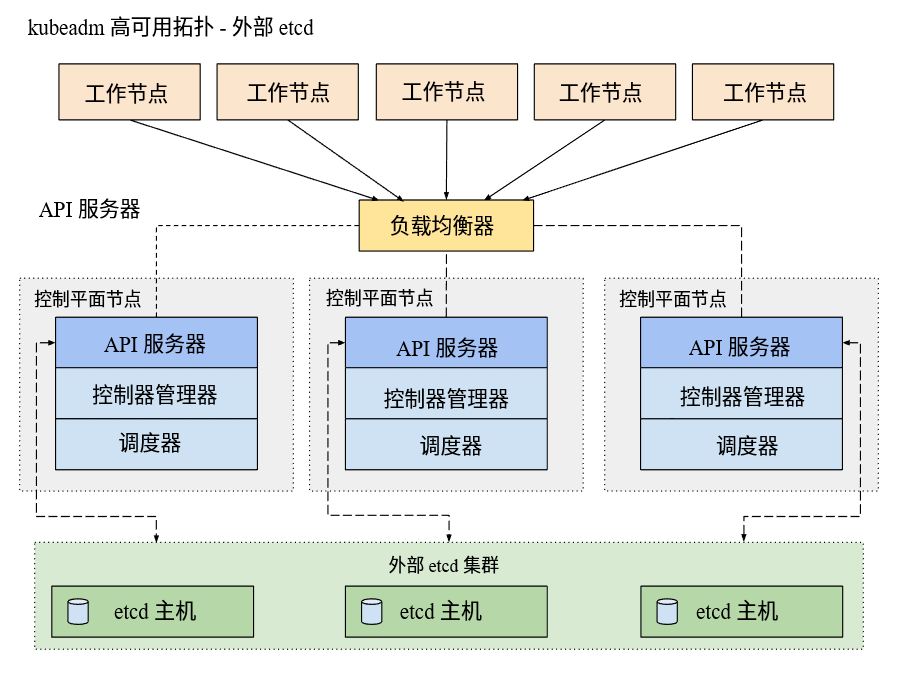
etcd 分布式数据存储集群在独立于控制平面节点的其他节点上运行。
就像堆叠的 etcd 拓扑一样,外部 etcd 拓扑中的每个控制平面节点都会运行 kube-apiserver、kube-scheduler 和 kube-controller-manager 实例。 同样,kube-apiserver 使用负载均衡器暴露给工作节点。但是 etcd 成员在不同的主机上运行, 每个 etcd 主机与每个控制平面节点的 kube-apiserver 通信。
这种拓扑结构解耦了控制平面和 etcd 成员。因此它提供了一种 HA 设置, 其中失去控制平面实例或者 etcd 成员的影响较小,并且不会像堆叠的 HA 拓扑那样影响集群冗余。
但此拓扑需要两倍于堆叠 HA 拓扑的主机数量。 具有此拓扑的 HA 集群至少需要三个用于控制平面节点的主机和三个用于 etcd 节点的主机。
集群环境初始化
实验环境
之前的所有节点reset,重启(如果想要恢复,可以参照之前的k8s的备份与恢复)

所有k8s集群节点执行以下步骤
由于我们使用的是rocky9系统,所以无需升级内核
haproxy负载均衡

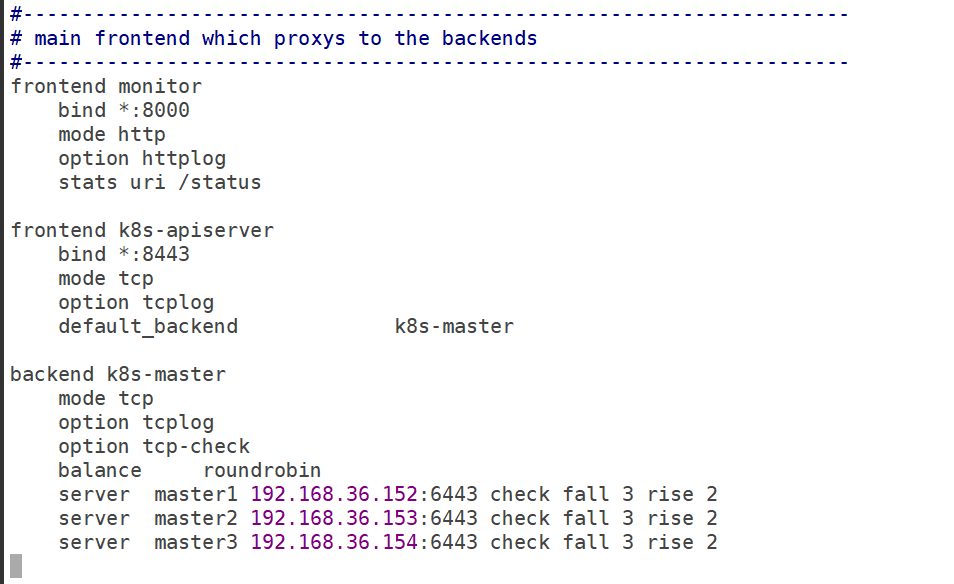
可以直接将编辑好的文件复制到其他节点

启动服务

检查端口

keepalived高可用
安装软件

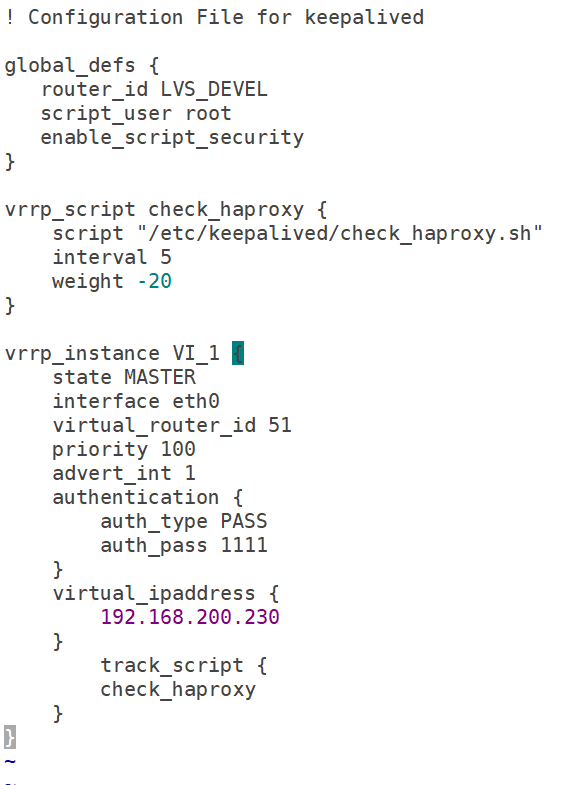
配置keepalived
注意网卡根据实际修改
haproxy检测脚本
#!/bin/bash
if ! ps aux | grep -q haproxy; then
systemctl start haproxy
sleep 2
if ! ps aux | grep -q haproxy; then
systemctl stop keepalived
fi
fi
添加执行权限
启动服务
其它master节点的keepalived配置只需要以下两个参数,其它保持一致:
k8s-master02:
state BACKUP
priority 90
k8s-master03:
state BACKUP
priority 80
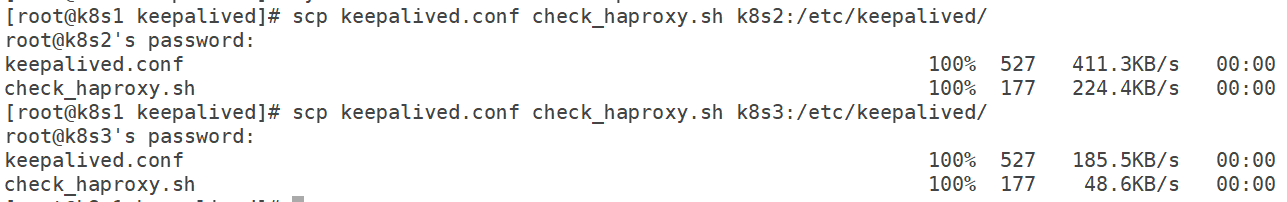
kubeadm部署集群
配置集群初始化文件

apiVersion: kubeadm.k8s.io/v1beta4
bootstrapTokens:
-
groups:
-
system:bootstrappers:kubeadm:default-node-token
token: abcdef.0123456789abcdef
ttl: 24h0m0s
usages:
-
signing
-
authentication
kind: InitConfiguration
localAPIEndpoint:
advertiseAddress: 192.168.154.206 #本机IP
bindPort: 6443
nodeRegistration:
criSocket: unix:///var/run/containerd/containerd.sock
imagePullPolicy: IfNotPresent
imagePullSerial: true
name: k8s1 #本机主机名
taints: null
timeouts:
controlPlaneComponentHealthCheck: 4m0s
discovery: 5m0s
etcdAPICall: 2m0s
kubeletHealthCheck: 4m0s
kubernetesAPICall: 1m0s
tlsBootstrap: 5m0s
upgradeManifests: 5m0s
apiServer:
certSANs: #添加VIP到证书
- 192.168.154.230
apiVersion: kubeadm.k8s.io/v1beta4
caCertificateValidityPeriod: 876000h0m0s
certificateValidityPeriod: 87600h0m0s
certificatesDir: /etc/kubernetes/pki
clusterName: kubernetes
controlPlaneEndpoint: 192.168.154.230:8443 #负载均衡地址端口
controllerManager: {}
dns: {}
encryptionAlgorithm: RSA-2048
etcd:
local:
dataDir: /var/lib/etcd
imageRepository: reg.westos.org/k8s #harbor私有仓库
kind: ClusterConfiguration
kubernetesVersion: 1.36.5 #k8s部署版本
networking:
dnsDomain: cluster.local
serviceSubnet: 10.96.0.0/12 #service网段
podSubnet: 10.244.0.0/16 #Pod网段
proxy: {}
scheduler: {}
apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration
mode: ipvs #kube-proxy使用IPVS模式
ipvs:
scheduler: "rr" #调度算法
strictARP: true #高可用场景必须开启,避免 ARP 冲
初始化集群

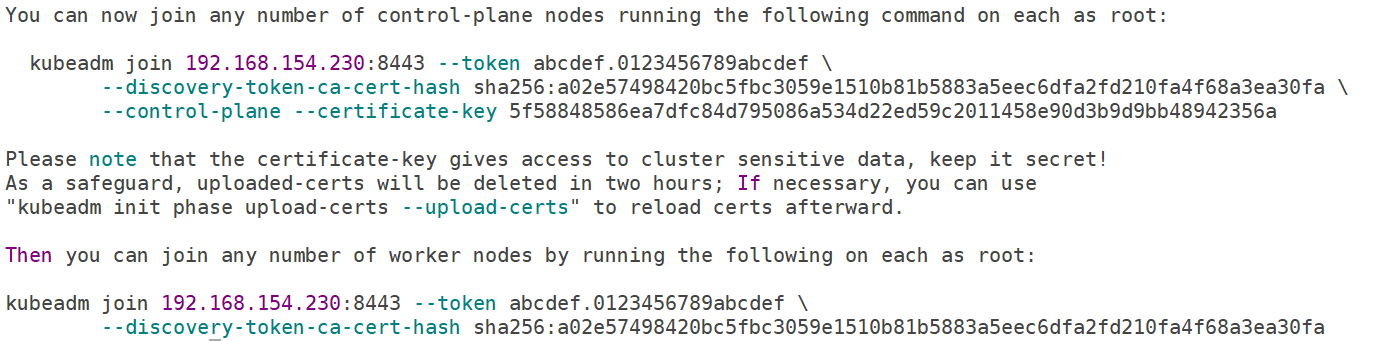
其他两个节点不需要初始化
设置环境变量

写入环境变量文件,确保重启后依然生效

设置kubectl命令补齐
yum install -y bash-completion
echo "source <(kubectl completion bash)" >> ~/.bashrc
source ~/.bashrc
查看集群状态
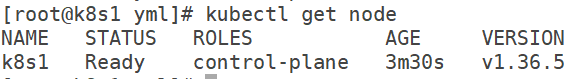
如有报错可以重置节点
kubeadm reset -f --ignore-preflight-errors=all
安装calico网络插件
下载部署文件
wget https://raw.githubusercontent.com/projectcalico/calico/v3.31.0/manifests/calico.yaml
修改镜像位置,指向harbor仓库
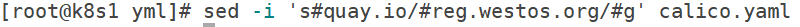
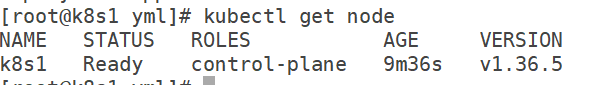
部署网络插件

查看集群状态
扩容master节点
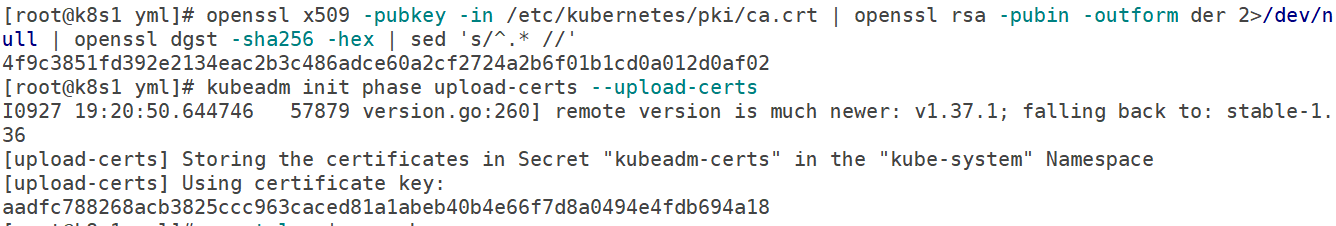
在执行命令之前,确保已完成初始化等必要操作:
certificate-key和token获取,注意虚拟ip

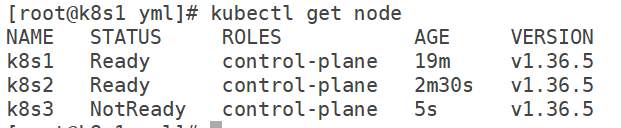
查看集群状态
扩容worker节点
worker节点的初始化详情可见之前的扩容教程
加入之前确保初始化完成


查看集群状态
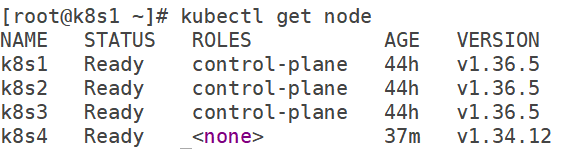
节点添加标签
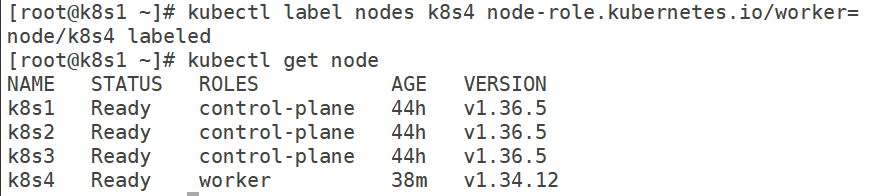
查看etcd集群主从关系
Step 1:获取当前 Master 节点主机名称
host=$(hostname)
Step 2:获取 etcd 节点 pod 名称
etcd=(kubectl get pod -n kube-system \| grep 'Running' \| grep etcd \| head -n 1 \| awk '{print 1}')
Step 3:获取 etcd 目录
cert_dir="/etc/kubernetes/pki/etcd"
以上信息也可以从 /etc/kubernetes/manifests/etcd.yaml 中获取
Step 4: 查询 etcd 集群成员信息
kubectl -n kube-system exec ${etcd} -- \
sh -c "ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 --cert={cert_dir}/server.crt --key={cert_dir}/server.key --cacert=${cert_dir}/ca.crt member list -w table"
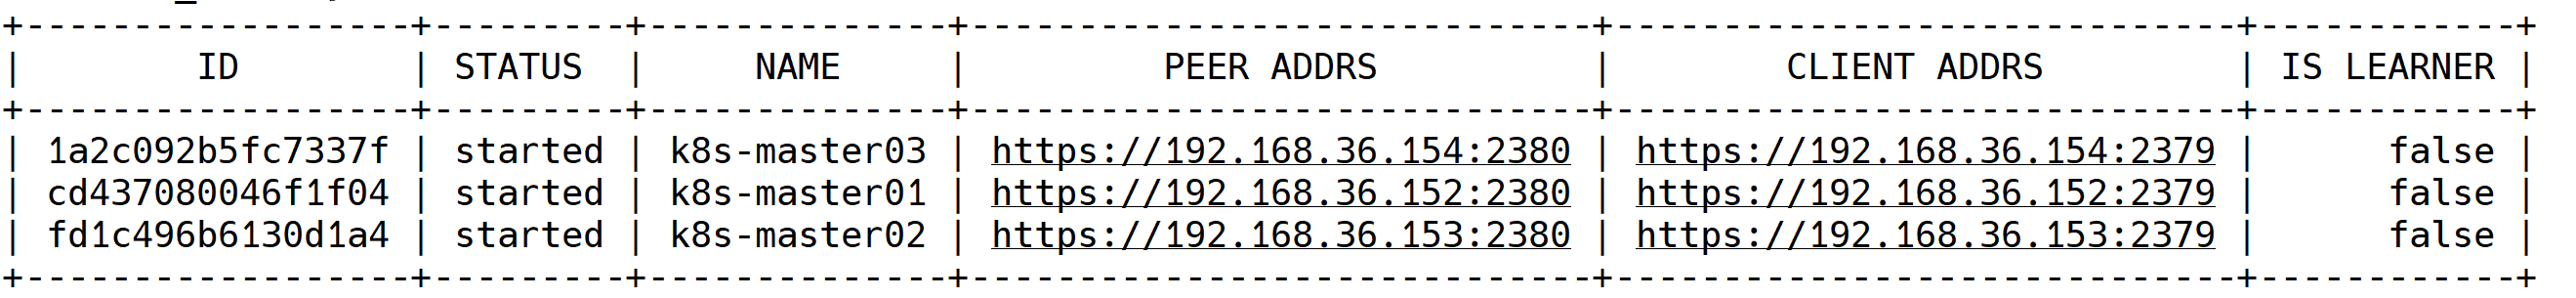
Step 5: 仅查询当前节点
kubectl -n kube-system exec ${etcd} -- \
sh -c "ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 --cert={cert_dir}/server.crt --key={cert_dir}/server.key --cacert=${cert_dir}/ca.crt endpoint status -w table"
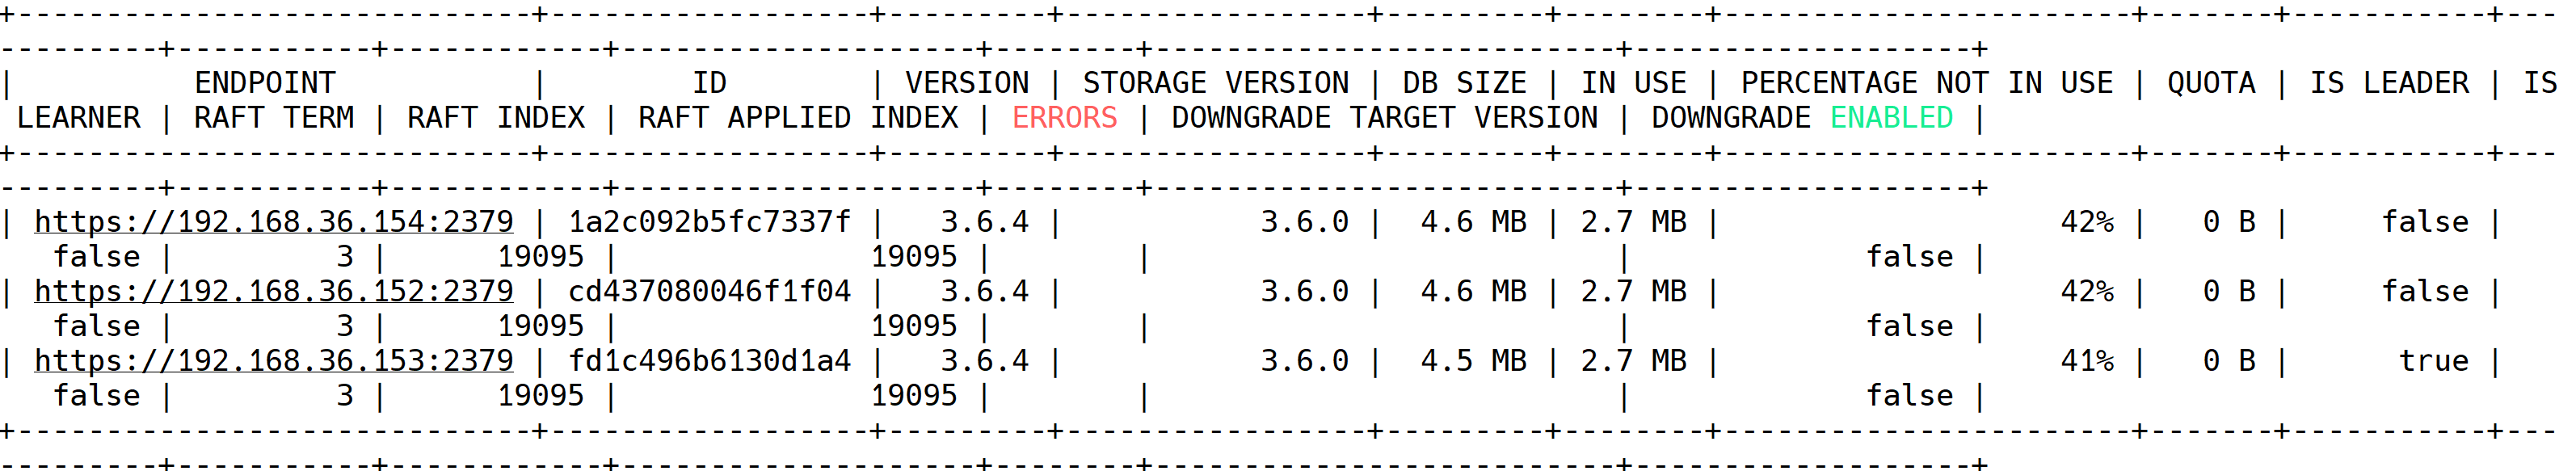
Step 6:查询所有节点
kubectl -n kube-system exec ${etcd} -- \
sh -c "ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 --cert={cert_dir}/server.crt --key={cert_dir}/server.key --cacert=${cert_dir}/ca.crt endpoint status --cluster -w table"
Step 7:查询所有 key
kubectl -n kube-system exec {etcd} -- sh -c "ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 --cert={cert_dir}/server.crt --key={cert_dir}/server.key --cacert={cert_dir}/ca.crt get / --prefix --keys-only" | grep -v ^$
Step 8:查询某个 key 对应的 value
kubectl -n kube-system exec ${etcd} -- \
sh -c "ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 --cert={cert_dir}/server.crt --key={cert_dir}/server.key --cacert=${cert_dir}/ca.crt get /registry/services/specs/kube-system/kube-dns"
kube-vip 云原生高可用
将刚才的集群初始化,停止haproxy和keepalived服务,最后重启清除多余的ip


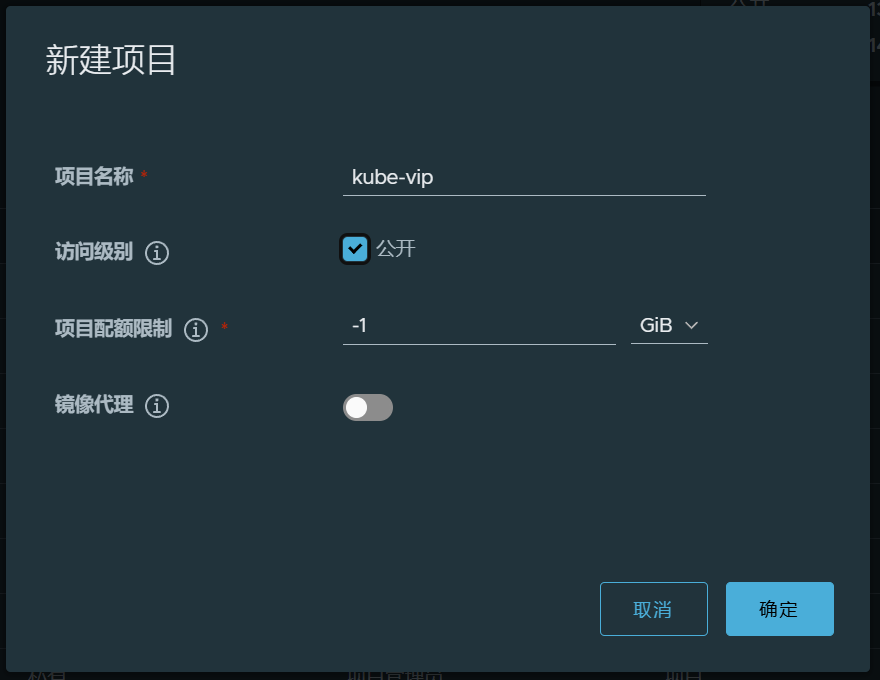
上传镜像至harbor仓库

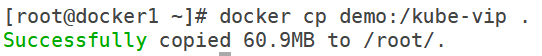
从镜像中拷贝二进制文件

拷贝到所有master节点
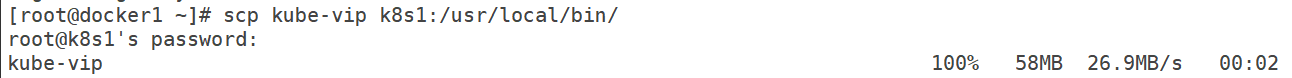
在所有master节点上部署kube-vip
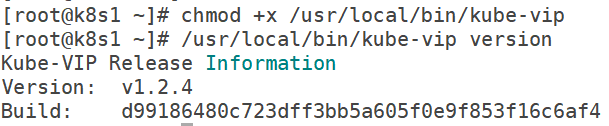
第一个master节点初始化时需要修改下授权文件
需要在以下文件中将8443端口改为6443


部署文件放在静态pod的路径,kubelet会自动拉起pod
apiVersion: v1
kind: Pod
metadata:
name: kube-vip
namespace: kube-system
spec:
containers:
-
args:
-
manager
env:
- name: vip_arp
value: "true"
- name: port
value: "6443"
- name: vip_nodename
valueFrom:
fieldRef:
fieldPath: spec.nodeName
- name: vip_interface
value: ens33
- name: vip_subnet
value: "32"
- name: dns_mode
value: first
- name: cp_enable
value: "true"
- name: cp_namespace
value: kube-system
- name: svc_enable
value: "true"
- name: svc_leasename
value: plndr-svcs-lock
- name: vip_leaderelection
value: "true"
- name: vip_leasename
value: plndr-cp-lock
- name: vip_leaseduration
value: "5"
- name: vip_renewdeadline
value: "3"
- name: vip_retryperiod
value: "1"
- name: address
value: 192.168.154.230
- name: prometheus_server
value: :2112
image: reg.westos.org/kube-vip/kube-vip:v1.2.4
imagePullPolicy: IfNotPresent
name: kube-vip
resources: {}
securityContext:
capabilities:
add:
-
NET_ADMIN
-
NET_RAW
drop:
- ALL
volumeMounts:
- mountPath: /etc/kubernetes/admin.conf
name: kubeconfig
hostAliases:
-
hostnames:
-
kubernetes
ip: 127.0.0.1
hostNetwork: true
volumes:
- hostPath:
path: /etc/kubernetes/super-admin.conf
name: kubeconfig
status: {}
正常初始化集群

可以看到kube-vip 已启动

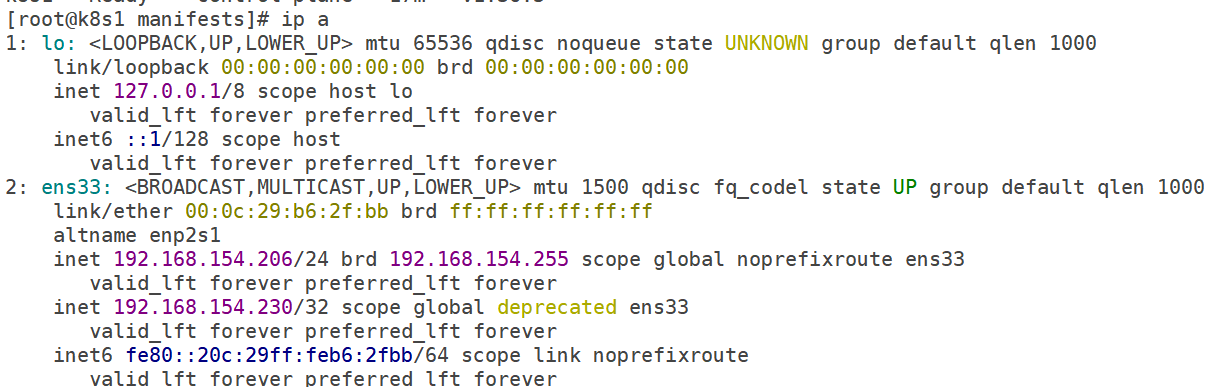
查看vip
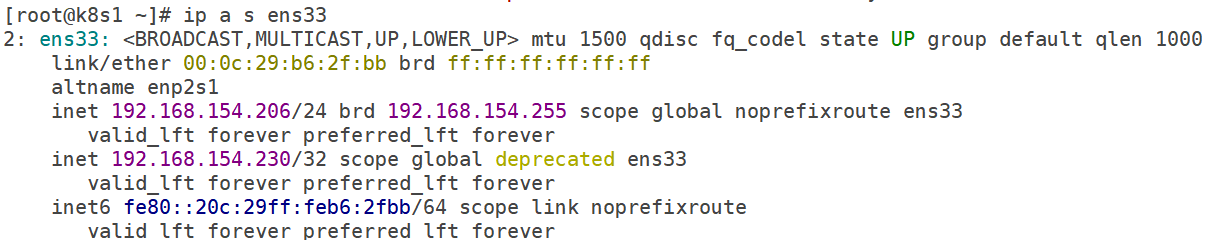
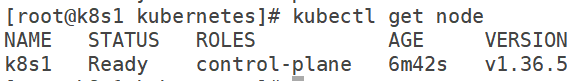
其它master节点直接使用命令创建即可
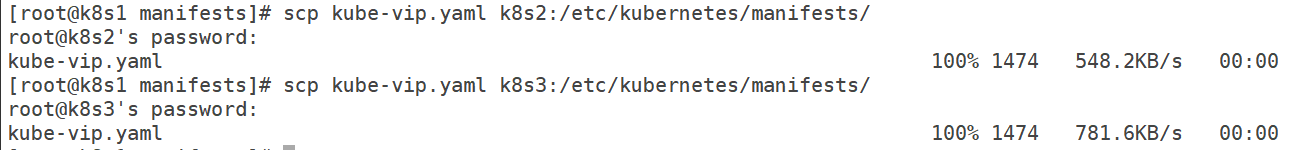
使用命令创建部署文件
kubeadm init --config=kubeadm-config.yml --upload-certs
测试
目前vip在k8s1上
将k8s1关机后vip漂移到了k8s2上