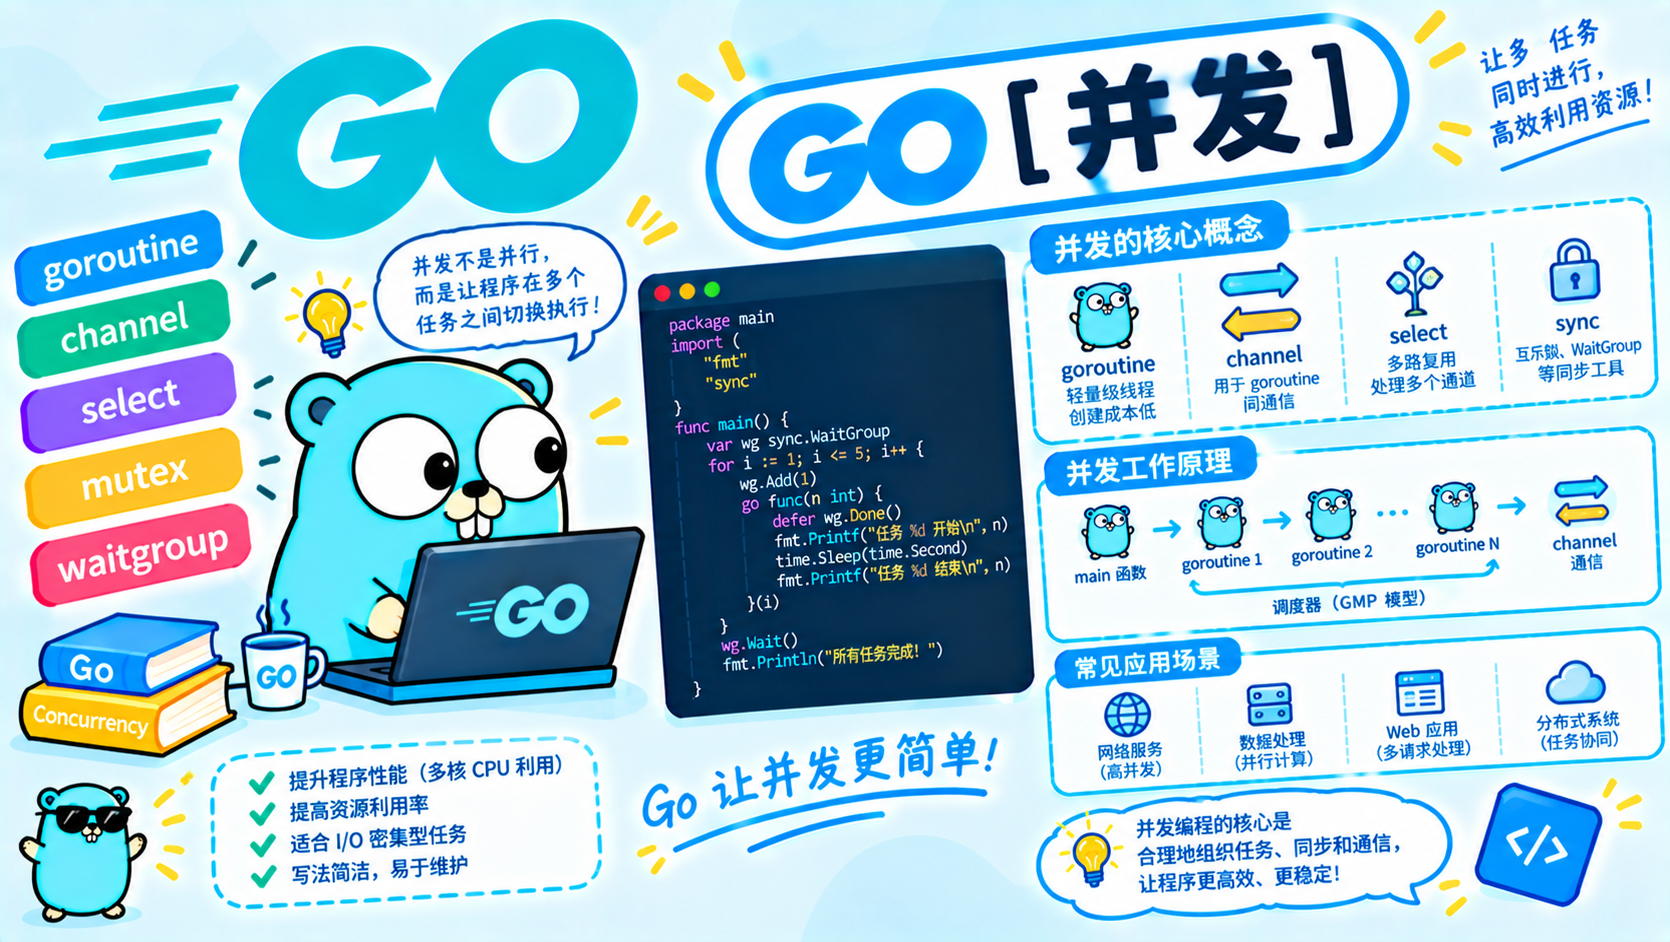
前面我们已经学习了 Go 的变量、常量、数据类型、输入输出、条件控制、切片、字符串、映射表、指针、结构体、函数、方法、接口、类型、错误、文件和反射。接下来开始学习 Go 语言中最有代表性的能力:并发(concurrency)。
很多初学者第一次接触 Go 并发时,记住的是一句代码:在函数调用前面加上 go。这句话当然正确,但只记住它还不够。一个真正可用的并发程序,还必须回答下面这些问题:
- 谁负责启动 goroutine?
- 谁负责等待 goroutine 结束?
- goroutine 之间如何传递数据?
- 哪一个 goroutine 拥有 channel,谁负责关闭它?
- 任务执行到一半,如何取消?
- 多个 goroutine 同时读写同一份数据时,如何避免数据竞争?
- 任务失败以后,其他 goroutine 是否继续工作?
- 所有任务完成后,结果 channel 什么时候关闭?
按照 Go 官方语言规范:Go statements 的定义,go 语句会让一个函数调用在同一地址空间中的独立 goroutine 里执行。它不会把返回值交给调用方,也不会自动等待函数执行完成。
Go 官方文档在 Effective Go:Concurrency 中给出了一个很重要的设计建议:不要通过共享内存来通信,而要通过通信来共享内存 。这不是说所有共享状态都必须改成 channel,sync.Mutex 和 sync/atomic 仍然非常重要;它真正强调的是,应该先明确数据的所有权和同步关系,再决定使用 channel 还是锁。
本篇是并发系列的基础篇,按照"官方定义 → 协程 → 管道 → select → WaitGroup → Context → 锁 → 原子同步"的顺序展开。后续文章会继续讲 Go 运行时调度器,以及生产者消费者、阻塞队列和唤醒队列等完整项目。
本篇重点学习:
- 协程(goroutine)的启动、退出和生命周期;
- 管道(channel)的创建、读写、无缓冲、有缓冲、单向管道和
for range; sync.WaitGroup如何等待一组并发任务;close、range、nil channel 和关闭 channel 的规则;select如何实现多路通信、超时和非阻塞操作;Mutex、RWMutex、atomic和 channel 的使用边界;context.Context、valueCtx、cancelCtx和timerCtx如何传播数据、取消和超时;sync.Mutex、sync.RWMutex和sync.Cond的使用边界;sync/atomic提供的原子读写、加法和 CAS 操作;- 使用
go test -race检测数据竞争; - 使用 channel、WaitGroup 和 context 实现一个有界并发工作池。
本文代码在 Go 1.27.0 darwin/arm64 环境中实际编译运行。goroutine 的调度顺序、任务完成顺序和输出顺序不固定,示例输出只展示一种可能结果。
并发不等于并行
先把两个经常混在一起的概念分开。
**并发(concurrency)**描述的是程序结构:多个任务在时间上相互交错,每个任务都可以独立推进。**并行(parallelism)**描述的是执行方式:多个任务在同一时刻由多个 CPU 核心真正同时执行。
| 概念 | 关注点 | Go 中的例子 |
|---|---|---|
| 并发 | 如何组织多个独立任务 | 多个 goroutine、channel、select |
| 并行 | 是否同时使用多个 CPU 核心 | runtime.GOMAXPROCS、CPU 密集型 worker |
| 异步 | 调用方是否立即返回 | 启动 goroutine 后继续执行 |
| 同步 | 是否等待某个事件完成 | channel 接收、Mutex、WaitGroup |
一个程序可以是并发的,但不一定会并行。比如机器只有一个可运行的 CPU,多个 goroutine 仍然可以交替运行;它们是并发的,但没有同时执行。
查看 Go 运行时允许同时执行用户级 Go 代码的最大 CPU 数量:
package main

import (
	"fmt"
	"runtime"
)

func main() {
	fmt.Println("logical CPUs:", runtime.NumCPU())
	fmt.Println("GOMAXPROCS:", runtime.GOMAXPROCS(0))
}
运行结果与机器环境有关:
logical CPUs: 10
GOMAXPROCS: 10
runtime.GOMAXPROCS(0) 只读取当前设置,不修改它。Go 官方 runtime 文档说明,GOMAXPROCS 限制的是可以同时执行用户级 Go 代码的操作系统线程数量;被系统调用阻塞的线程不计入这个限制。
因此,学习 goroutine 时不要把"启动了 1000 个 goroutine"直接理解成"使用了 1000 个 CPU"。goroutine 是任务组织方式,调度器会把大量 goroutine 复用到较少的操作系统线程上。
协程(goroutine)是什么
goroutine 是一个由 Go 运行时管理的轻量级执行单元。它和其他 goroutine 共享同一个地址空间,但拥有自己的栈和执行位置。
最基本的写法如下:
package main

import (
	"fmt"
	"time"
)

func say(message string) {
	for i := 1; i <= 3; i++ {
		fmt.Println(message, i)
		time.Sleep(10 * time.Millisecond)
	}
}

func main() {
	go say("goroutine")

	fmt.Println("main return")
}
这段代码不保证打印出三行 goroutine。因为 main 函数返回时,整个程序就结束了,仍然运行中的 goroutine 也会被一起终止。
一次可能的输出是:
main return也可能是:
goroutine 1
main return
这里没有任何错误,问题在于程序没有建立"后台任务完成以后,main 才能退出"的同步关系。
使用匿名函数启动 goroutine
如果只需要执行一小段逻辑,可以直接使用函数字面量:
go func() {
	fmt.Println("异步执行")
}()
最后的 () 不能省略。func() { ... } 只是一个函数值,只有调用它,函数体才会执行。
如果需要传入变量,推荐把变量作为参数传入匿名函数:
package main

import (
	"fmt"
	"sync"
)

func main() {
	var wg sync.WaitGroup

	for i := 1; i <= 3; i++ {
		wg.Add(1)
		go func(number int) {
			defer wg.Done()
			fmt.Println("task", number)
		}(i)
	}

	wg.Wait()
}
这里的 i 在启动 goroutine 时作为参数求值,goroutine 收到的是本次调用对应的 number。
循环变量捕获问题
如果直接在闭包中引用循环变量,要特别小心变量捕获语义。下面的写法会让 goroutine 共享外层变量:
package main

import (
	"fmt"
	"sync"
)

func main() {
	var wg sync.WaitGroup
	var i int

	for i = 0; i < 5; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			fmt.Println(i)
		}()
	}

	wg.Wait()
}
这些 goroutine 读取的是同一个 i。循环可能已经结束,输出就可能全部接近 5;同时循环递增和 goroutine 读取还会产生数据竞争。官方 Race Detector 文档把这个例子列为典型错误。
安全写法有两种。
第一种是显式传参:
for i := 0; i < 5; i++ {
	value := i
	wg.Add(1)
	go func(number int) {
		defer wg.Done()
		fmt.Println(number)
	}(value)
}
第二种是在每次循环中重新声明变量:
for i := 0; i < 5; i++ {
	i := i
	wg.Add(1)
	go func() {
		defer wg.Done()
		fmt.Println(i)
	}()
}
无论采用哪一种方式,核心目标都是让每个 goroutine 读取自己拥有的任务参数,而不是和循环共享一个不断变化的变量。
使用 WaitGroup 等待任务完成
sync.WaitGroup 是一个计数器。启动任务之前调用 Add 增加计数,任务结束时调用 Done 减少计数,调用 Wait 的 goroutine 会一直阻塞到计数器归零。
package main

import (
	"fmt"
	"sync"
	"time"
)

func main() {
	var wg sync.WaitGroup

	for i := 1; i <= 3; i++ {
		wg.Add(1)
		go func(id int) {
			defer wg.Done()
			time.Sleep(time.Duration(id) * 20 * time.Millisecond)
			fmt.Println("task finished:", id)
		}(i)
	}

	wg.Wait()
	fmt.Println("all tasks finished")
}
运行结果的顺序不固定,但 all tasks finished 一定是最后一行:
task finished: 1
task finished: 2
task finished: 3
all tasks finished
defer wg.Done() 是很重要的习惯。任务函数中间如果增加了 return,或者后面加入了新的错误分支,也不会忘记减少计数。
WaitGroup 的正确使用顺序
下面这条规则必须记住:
- 在启动 goroutine 之前调用
Add; - goroutine 开始执行后使用
defer Done; - 所有任务都提交完成以后调用
Wait; - 不要复制已经使用过的
WaitGroup。
不要把 Add 放进新启动的 goroutine:
// 不推荐:Wait 可能在 Add 执行前看到计数器为 0 并提前返回。
go func() {
	wg.Add(1)
	defer wg.Done()
	doWork()
}()
wg.Wait()
应该由创建任务的 goroutine 先增加计数:
wg.Add(1)
go func() {
	defer wg.Done()
	doWork()
}()
wg.Wait()
Go 1.25 以后,WaitGroup 还提供了 Go 方法,可以把"增加计数、启动 goroutine、任务结束减少计数"合并起来:
var wg sync.WaitGroup

wg.Go(func() {
	fmt.Println("task 1")
})

wg.Go(func() {
	fmt.Println("task 2")
})

wg.Wait()
WaitGroup.Go 适合简单任务,但它仍然只负责等待,不负责传递结果和错误。官方文档要求传给 Go 的函数不能 panic;如果需要捕获错误,仍然要显式设计错误通道或使用更高层的任务组。
WaitGroup 不能替代 channel
WaitGroup 只回答"所有任务是否完成",它不回答下面这些问题:
- 任务返回了什么结果?
- 任务是否失败?
- 任务之间如何传递数据?
- 任务是否应该被取消?
因此,实际程序中经常把 WaitGroup 和 channel 组合使用:任务通过结果 channel 返回数据,WaitGroup 负责在所有发送完成以后关闭结果 channel。
管道(channel):goroutine 之间的通信
channel 是 Go 内置的并发通信类型。它保存指定类型的数据,并且发送和接收本身可以建立同步关系。
管道的创建
创建 channel 使用 make:
numbers := make(chan int)    // 无缓冲 channel
results := make(chan int, 4) // 容量为 4 的有缓冲 channel
发送数据:
numbers <- 10接收数据:
value := <-numbers关闭 channel:
close(numbers)如果只声明而不使用 make,channel 的零值是 nil。nil channel 不是一个可用的通信管道,读写都会永久阻塞。后面讲 select 时会专门利用这个特性动态禁用一个通信分支。
管道的读写
发送表达式的方向是从当前 goroutine 流向 channel,接收表达式的方向是从 channel 流向当前 goroutine:
messages := make(chan string, 1)

messages <- "hello" // 写入
message := <-messages // 读取
fmt.Println(message)
发送和接收的阻塞行为取决于 channel 是否有缓冲,以及另一端是否已经准备好。读写不是普通赋值,它们同时可能产生 goroutine 之间的同步。
单向管道
按照 Go 语言规范:Channel types,channel 可以是双向的,也可以限制为只发送或只接收:
chan int   // 可以发送,也可以接收
chan<- int // 只能发送
<-chan int // 只能接收
单向 channel 最常见的用途是把函数的职责写进函数签名:
func produce(out chan<- int) {
	defer close(out)
	for i := 1; i <= 3; i++ {
		out <- i
	}
}

func consume(in <-chan int) {
	for value := range in {
		fmt.Println(value)
	}
}
produce 无法从 out 接收数据,consume 无法向 in 发送数据。编译器会帮助我们检查方向错误。
无缓冲管道:发送和接收握手
无缓冲 channel 的发送,必须等到另一个 goroutine 接收;接收也必须等到另一个 goroutine 发送。它不仅传数据,还提供同步点。
package main

import "fmt"

func main() {
	done := make(chan struct{})

	go func() {
		fmt.Println("worker finished")
		done <- struct{}{}
	}()

	<-done
	fmt.Println("main continues")
}
运行结果:
worker finished
main continues
主 goroutine 接收到 done 之前,不会执行下一行。这里的 struct{}{} 不占用实际字段空间,常用于只表达"事件发生"的 channel。
Go 内存模型说明:一个 channel 的发送发生在对应接收完成之前。发送前对普通变量的写入,在接收方继续执行时可以被可靠观察到。
package main

import "fmt"

func main() {
	message := ""
	done := make(chan struct{})

	go func() {
		message = "hello, Go"
		done <- struct{}{}
	}()

	<-done
	fmt.Println(message)
}
这段程序保证打印:
hello, Go保证来自 channel 的同步关系,而不是来自 time.Sleep。用睡眠等待是不可靠的:睡眠时间太短,任务可能没完成;睡眠时间太长,又会浪费时间。
有缓冲管道:有限容量的队列
有缓冲 channel 可以在容量未满时完成发送,不必立即等待接收者:
package main

import "fmt"

func main() {
	queue := make(chan string, 2)

	queue <- "first"
	queue <- "second"

	fmt.Println(<-queue)
	fmt.Println(<-queue)
}
如果继续发送第三个值,而没有 goroutine 接收,发送就会阻塞:
queue := make(chan string, 2)
queue <- "first"
queue <- "second"
// queue <- "third" // 阻塞,因为缓冲区已满
有缓冲 channel 可以看成一个有固定容量的并发队列,但它不等于一个通用队列。容量应该表达明确的背压策略:生产者太快时,是等待、丢弃、超时还是取消,都应该由业务决定。
len(channel) 可以查看当前缓冲区中已经排队的元素数量,cap(channel) 可以查看容量:
queue := make(chan int, 3)
queue <- 1
queue <- 2

fmt.Println(len(queue)) // 2
fmt.Println(cap(queue)) // 3
不要根据 len(queue) 和 cap(queue) 做复杂的并发判断。检查结果和下一次发送之间可能已经被其他 goroutine 改变;真正的同步应该使用发送、接收或 select。
管道使用时的注意点
有几个规则需要在写代码时反复确认:
- 无缓冲 channel 的发送和接收必须在两个可以继续推进的 goroutine 之间配对,否则会死锁;
- 有缓冲 channel 只是有限容量,不是无限队列,容量满了以后发送仍然会阻塞;
- 发送方必须明确什么时候不再发送,只有在这个事实确定以后才能关闭 channel;
- 不能向已关闭的 channel 发送,不能重复关闭 channel;
- 不要使用
len(ch)作为并发正确性的判断依据,因为检查之后状态可能立即变化; - channel 如果只传递"完成"事件,优先使用
chan struct{},不要为了占位创建无意义的数据对象。
管道作为并发信号量
有缓冲 channel 还可以限制同时执行的任务数量:
package main

import (
	"fmt"
	"sync"
	"time"
)

func main() {
	limit := make(chan struct{}, 2)
	var wg sync.WaitGroup

	for i := 1; i <= 5; i++ {
		wg.Add(1)
		go func(id int) {
			defer wg.Done()

			limit <- struct{}{} // 获取一个名额
			defer func() { <-limit }() // 释放名额

			fmt.Println("running:", id)
			time.Sleep(20 * time.Millisecond)
		}(i)
	}

	wg.Wait()
}
limit 的容量是 2,所以最多只有两个任务同时进入真正的工作区域。这种写法和 Go 内存模型中使用 buffered channel 实现计数信号量的示例是一致的。
关闭管道与 for range
关闭 channel 不是删除 channel,也不是立即删除里面的数据。关闭表示"以后不会再有新的值发送了"。缓冲区中已经存在的值仍然可以被接收。
发送方负责关闭 channel 是最容易维护的规则:
func produce(out chan<- int) {
	defer close(out)
	for i := 1; i <= 3; i++ {
		out <- i
	}
}

func main() {
	values := make(chan int)
	go produce(values)

	for value := range values {
		fmt.Println(value)
	}

	fmt.Println("producer closed channel")
}
for range 会持续接收,直到 channel 被关闭并且缓冲区中的值全部读完。它特别适合消费由一个生产者负责关闭的管道。
如果需要区分"收到零值"和"channel 已关闭",使用双返回值形式:
value, ok := <-values
if !ok {
	fmt.Println("channel is closed")
	return
}
fmt.Println("received:", value)
channel 关闭后的行为可以整理成表格:
| 操作 | 结果 |
|---|---|
| 从已关闭且已清空的 channel 接收 | 返回元素类型零值,ok == false |
| 从已关闭但仍有缓冲值的 channel 接收 | 先读出缓冲值,之后才返回零值和 false |
| 向已关闭的 channel 发送 | panic |
| 重复关闭 channel | panic |
| 从 nil channel 接收 | 永久阻塞 |
| 向 nil channel 发送 | 永久阻塞 |
| 关闭 nil channel | panic |
关闭 channel 的责任必须清晰。多个 goroutine 都可能发送时,不能让每个发送者都尝试关闭;可以让一个协调者等待所有发送者结束后再关闭:
func merge(inputs ...<-chan int) <-chan int {
	var wg sync.WaitGroup
	out := make(chan int)

	copyValues := func(input <-chan int) {
		defer wg.Done()
		for value := range input {
			out <- value
		}
	}

	wg.Add(len(inputs))
	for _, input := range inputs {
		go copyValues(input)
	}

	go func() {
		wg.Wait()
		close(out)
	}()

	return out
}
这里的关闭顺序非常重要:必须确保所有发送 out <- value 的 goroutine 都结束以后,才能 close(out)。Go 官方博客 Pipelines and cancellation 使用了同样的 fan-in 思路。
select:同时等待多个通信操作
select 的语法看起来像 switch,但每个 case 必须是 channel 的发送或接收操作。按照 Go 语言规范:Select statements,执行 select 时:
- 先计算所有 case 中的 channel 和发送值;
- 如果有多个通信操作可以继续,随机选择一个;
- 如果没有 case 可以继续且存在
default,执行default; - 如果没有 case 可以继续且没有
default,当前 goroutine 阻塞。
同时等待结果和取消信号
func receive(ctx context.Context, results <-chan string) (string, error) {
	select {
	case result := <-results:
		return result, nil
	case <-ctx.Done():
		return "", ctx.Err()
	}
}
这里有两种可能事件:任务返回结果,或者调用方取消等待。哪个事件先发生,就执行哪个分支。
使用 select 实现超时
package main

import (
	"fmt"
	"time"
)

func slowOperation() <-chan string {
	result := make(chan string, 1)
	go func() {
		time.Sleep(100 * time.Millisecond)
		result <- "operation done"
	}()
	return result
}

func main() {
	timer := time.NewTimer(20 * time.Millisecond)
	defer timer.Stop()

	select {
	case result := <-slowOperation():
		fmt.Println(result)
	case <-timer.C:
		fmt.Println("timeout")
	}
}
运行结果:
timeout如果使用 time.After,代码会更短:
select {
case result := <-slowOperation():
	fmt.Println(result)
case <-time.After(20 * time.Millisecond):
	fmt.Println("timeout")
}
循环中的长时间任务更适合显式创建并复用 time.Timer,并在不需要时调用 Stop,这样可以更清楚地管理定时器生命周期。
使用 default 实现非阻塞操作
select {
case value := <-results:
	fmt.Println("received:", value)
default:
	fmt.Println("no result is ready")
}
有 default 的 select 不会等待。如果当前没有结果,就立即执行 default。这适合轮询或"尽力而为"的操作,但不能把它放进没有节奏控制的死循环,否则会变成忙等,持续消耗 CPU。
如果确实需要轮询,通常还要配合 time.Ticker:
ticker := time.NewTicker(10 * time.Millisecond)
defer ticker.Stop()

for {
	select {
	case <-ticker.C:
		checkSomething()
	case <-ctx.Done():
		return ctx.Err()
	}
}
nil channel 可以动态禁用 case
因为 nil channel 永远不能发送或接收,所以可以通过把 channel 设为 nil,临时禁用某个 select 分支:
for left != nil || right != nil {
	select {
	case value, ok := <-left:
		if !ok {
			left = nil
			continue
		}
		fmt.Println("left:", value)
	case value, ok := <-right:
		if !ok {
			right = nil
			continue
		}
		fmt.Println("right:", value)
	}
}
某一路 channel 关闭后,把它设为 nil,后续 select 就不会再次选中这一路。这个技巧经常用于同时合并多个输入流。
锁:保护共享数据
Go 的并发程序不只有 channel。一旦多个 goroutine 同时访问同一个变量,并且至少有一个访问是写入,就必须建立同步关系。
下面的代码存在数据竞争:
package main

import (
	"fmt"
	"sync"
)

func main() {
	var count int
	var wg sync.WaitGroup

	for i := 0; i < 1000; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			count++
		}()
	}

	wg.Wait()
	fmt.Println(count)
}
count++ 不是不可分割的单次操作,它至少包含读取、加一、写回三个步骤。多个 goroutine 可能在同一时刻读到相同的旧值,最终结果通常小于 1000。
互斥锁(Mutex)
package main

import (
	"fmt"
	"sync"
)

type Counter struct {
	mu    sync.Mutex
	value int
}

func (counter *Counter) Add(delta int) {
	counter.mu.Lock()
	defer counter.mu.Unlock()
	counter.value += delta
}

func (counter *Counter) Value() int {
	counter.mu.Lock()
	defer counter.mu.Unlock()
	return counter.value
}

func main() {
	var counter Counter
	var wg sync.WaitGroup

	for i := 0; i < 1000; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			counter.Add(1)
		}()
	}

	wg.Wait()
	fmt.Println(counter.Value())
}
运行结果:
1000Mutex 适合保护一组需要一起修改的状态。比如 map 的读取、判断和写入通常必须放在同一个临界区内,否则即使单个操作看起来很短,也可能在多个步骤之间被其他 goroutine 插入。
读写锁(RWMutex)
sync.RWMutex 把锁分成读锁和写锁:多个 goroutine 可以同时持有读锁,但写锁必须等待所有读锁释放,并且写锁持有期间不能再有其他读者或写者进入。
package main

import (
	"fmt"
	"sync"
)

type ConfigStore struct {
	mu     sync.RWMutex
	values map[string]string
}

func NewConfigStore() *ConfigStore {
	return &ConfigStore{values: make(map[string]string)}
}

func (store *ConfigStore) Get(key string) (string, bool) {
	store.mu.RLock()
	defer store.mu.RUnlock()
	value, ok := store.values[key]
	return value, ok
}

func (store *ConfigStore) Set(key, value string) {
	store.mu.Lock()
	defer store.mu.Unlock()
	store.values[key] = value
}

func main() {
	store := NewConfigStore()
	store.Set("mode", "debug")
	value, ok := store.Get("mode")
	fmt.Println(value, ok)
}
运行结果:
debug true读写锁适合读操作确实很多、读临界区很短的场景。它并不是"比 Mutex 更高级的锁":如果写操作频繁,或者读临界区很长,读者之间的并发反而可能增加调度和锁管理成本。是否使用 RWMutex,应该通过基准测试验证。
条件变量(Cond)
sync.Cond 用于等待某个共享条件发生变化。它必须绑定一个 Locker,通常是 *sync.Mutex。等待者先持有锁,确认条件不满足后调用 Wait;Wait 会原子地释放锁并阻塞,唤醒后重新加锁再返回。
下面用条件变量实现一个只有一个名额的停车位:
package main

import (
	"fmt"
	"sync"
	"time"
)

type ParkingSpot struct {
	mu      sync.Mutex
	cond    *sync.Cond
	occupied bool
}

func NewParkingSpot() *ParkingSpot {
	spot := &ParkingSpot{}
	spot.cond = sync.NewCond(&spot.mu)
	return spot
}

func (spot *ParkingSpot) Enter(id int) {
	spot.mu.Lock()
	defer spot.mu.Unlock()

	for spot.occupied {
		spot.cond.Wait()
	}
	spot.occupied = true
	fmt.Println("enter:", id)
}

func (spot *ParkingSpot) Leave(id int) {
	spot.mu.Lock()
	defer spot.mu.Unlock()

	spot.occupied = false
	fmt.Println("leave:", id)
	spot.cond.Signal()
}

func main() {
	spot := NewParkingSpot()
	var wg sync.WaitGroup

	for i := 1; i <= 2; i++ {
		wg.Add(1)
		go func(id int) {
			defer wg.Done()
			spot.Enter(id)
			time.Sleep(10 * time.Millisecond)
			spot.Leave(id)
		}(i)
	}

	wg.Wait()
}
运行结果的进入顺序可能不同,但同一时刻只有一个任务占用车位:
enter: 2
leave: 2
enter: 1
leave: 1
这里必须使用 for 检查条件,而不能写成 if。被唤醒只代表"可以重新检查条件",不代表条件一定满足;多个等待者被唤醒、其他 goroutine 抢先占用资源时,都可能让条件再次变为假。
很多简单场景不需要直接使用 sync.Cond:关闭一个 channel 可以广播唤醒,向一个 channel 发送值可以唤醒一个接收者。Cond 更适合条件本身是共享内存状态,且需要精确控制 Signal 或 Broadcast 的场景。
同步:原子操作
如果共享状态只是一个整数计数器,可以使用 sync/atomic:
package main

import (
	"fmt"
	"sync"
	"sync/atomic"
)

func main() {
	var count atomic.Int64
	var wg sync.WaitGroup

	for i := 0; i < 1000; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			count.Add(1)
		}()
	}

	wg.Wait()
	fmt.Println(count.Load())
}
atomic 更适合独立的计数、状态标志和指针交换;如果需要同时维护多个字段的一致性,应该优先使用 Mutex 或把数据所有权交给单独的 goroutine。
CompareAndSwap(CAS)
原子操作不只是 Add。CompareAndSwap 会比较当前值和旧值,只有相等时才写入新值,并返回是否成功。它常用于只允许状态从一种值转换到另一种值的场景。
package main

import (
	"fmt"
	"sync/atomic"
)

func main() {
	var state atomic.Int32

	if state.CompareAndSwap(0, 1) {
		fmt.Println("state changed to", state.Load())
	}

	if !state.CompareAndSwap(0, 2) {
		fmt.Println("state is already owned")
	}
}
运行结果:
state changed to 1
state is already owned
原子操作只保证单个原子变量的读写不会被拆开。它不会自动保证多个变量之间的一致性,也不会自动把复杂业务逻辑变成无锁安全代码。使用 CAS 循环时,还要考虑活锁、饥饿和 ABA 等问题。
并发工具如何选择
| 场景 | 更适合的工具 | 原因 |
|---|---|---|
| 一个 goroutine 产生数据,另一个 goroutine 消费 | channel | 数据流和同步点都清晰 |
| 多个字段需要一起保持一致 | sync.Mutex |
临界区表达直接 |
| 读多写少且锁粒度明确 | sync.RWMutex |
允许多个读者并发读取 |
| 简单计数器或状态位 | sync/atomic |
操作粒度小,开销低 |
| 只需要等待一组任务结束 | sync.WaitGroup |
不承载业务数据 |
| 只初始化一次 | sync.Once |
保证初始化逻辑只执行一次 |
Go 官方 MutexOrChannel 也强调:不要把"使用 channel"变成教条。数据本来就属于一个共享对象时,用 Mutex 往往比专门启动一个 goroutine 管理它更简单。
Go 内存模型和 happens-before
并发代码最难的地方不是语法,而是"一个 goroutine 写入的数据,另一个 goroutine 什么时候一定能看到"。这由 Go 内存模型规定。
Go Memory Model 把访问分成普通读写和同步操作。常见的同步关系包括:
- goroutine 创建:启动 goroutine 的动作发生在新 goroutine 开始执行之前;
- channel 发送和接收:发送发生在对应接收完成之前;
- channel 关闭和接收:关闭发生在接收方读到关闭状态之前;
- Mutex 解锁和后续加锁:解锁发生在之后成功加锁之前;
WaitGroup.Done和被它解除阻塞的Wait返回之间存在同步关系。
需要特别注意,goroutine 自然退出并不会自动同步给其他 goroutine 。下面的代码不能保证 message 已经被写入:
var message string

func main() {
	go func() {
		message = "done"
	}()

	fmt.Println(message)
}
如果必须观察 goroutine 的结果,就使用 channel、WaitGroup、Mutex 或其他明确的同步手段。不要用"应该已经执行完了"的直觉代替 happens-before 关系。
context:取消、超时和请求范围数据
context.Context 不是一个普通的参数字典,也不会强制杀死 goroutine。它的核心职责是把取消信号、截止时间和少量请求范围数据沿调用链向下传递。
官方 context 包文档 推荐把 Context 作为函数的第一个参数:
func Do(ctx context.Context, request Request) error {
	// ...
	return nil
}
WithCancel
package main

import (
	"context"
	"fmt"
	"time"
)

func worker(ctx context.Context) {
	for i := 1; ; i++ {
		select {
		case <-ctx.Done():
			fmt.Println("worker stopped:", ctx.Err())
			return
		default:
			fmt.Println("working", i)
			time.Sleep(20 * time.Millisecond)
		}
	}
}

func main() {
	ctx, cancel := context.WithCancel(context.Background())
	defer cancel()

	go worker(ctx)
	time.Sleep(60 * time.Millisecond)
	cancel()
	time.Sleep(20 * time.Millisecond)
}
调用 cancel 后,ctx.Done() channel 会被关闭。worker 必须主动选择这个 channel 并返回,取消才真正完成。
CancelFunc 不会等待工作停止。因此,如果调用方需要确认 goroutine 已经退出,还需要配合 WaitGroup 或接收一个完成信号。
WithTimeout
func doRequest(ctx context.Context) error {
	select {
	case <-time.After(200 * time.Millisecond):
		return nil
	case <-ctx.Done():
		return ctx.Err()
	}
}

func main() {
	ctx, cancel := context.WithTimeout(context.Background(), 50*time.Millisecond)
	defer cancel()

	err := doRequest(ctx)
	fmt.Println(err)
}
运行结果:
context deadline exceeded如果没有 defer cancel(),超时上下文关联的计时器和资源要等到父上下文结束后才能释放。只要创建了 WithCancel、WithTimeout 或 WithDeadline,就应该在当前函数负责的生命周期结束时调用 cancel。
valueCtx:Context 如何保存请求范围数据
context.WithValue 返回的具体类型不是一个公开的 ValueContext,而是 context 包内部的 valueCtx。Go 1.27 源码中的结构可以概括成:
type valueCtx struct {
	Context
	key, val any
}
它把父 Context 嵌入自身,再保存一组 key 和 value。调用 Value 时,先比较当前节点的 key;如果不匹配,就沿着父 Context 链继续查找。
实际使用时应该定义自己的 key 类型,避免不同包使用相同字符串导致碰撞:
package main

import (
	"context"
	"fmt"
)

type requestIDKey struct{}

func WithRequestID(ctx context.Context, requestID string) context.Context {
	return context.WithValue(ctx, requestIDKey{}, requestID)
}

func RequestID(ctx context.Context) (string, bool) {
	requestID, ok := ctx.Value(requestIDKey{}).(string)
	return requestID, ok
}

func main() {
	ctx := WithRequestID(context.Background(), "req-1001")
	requestID, ok := RequestID(ctx)
	fmt.Println(requestID, ok)
}
运行结果:
req-1001 truerequestIDKey{} 每次创建的值相等,因此可以取出对应数据;关键在于它的类型是包内私有类型,其他包无法意外构造同类型 key。key 必须是可比较类型,使用切片、map 或函数作为 key 会 panic。
Context 的 Value 查找是沿父链进行的。如果同一个 key 被多次写入,离当前 Context 最近的一层优先:
type key string

ctx := context.WithValue(context.Background(), key("mode"), "outer")
ctx = context.WithValue(ctx, key("mode"), "inner")

fmt.Println(ctx.Value(key("mode"))) // inner
这也说明了为什么不应该把 Context 当成通用 map。每次 WithValue 都是在 Context 树上增加一个包装节点,适合少量、请求范围、只读的元数据,不适合保存可变业务对象。
timerCtx:Context 如何实现超时
context.WithTimeout(parent, timeout) 的官方实现可以理解为:
func WithTimeout(parent context.Context, timeout time.Duration) (context.Context, context.CancelFunc) {
	return context.WithDeadline(parent, time.Now().Add(timeout))
}
WithDeadline 在内部创建 timerCtx。它在 cancelCtx 的基础上增加了计时器和截止时间:
type timerCtx struct {
	cancelCtx
	timer    *time.Timer
	deadline time.Time
}
创建 timerCtx 时,context 包会注册一个 time.AfterFunc。计时器到期后,内部取消函数会关闭 Done channel、记录 DeadlineExceeded,并向下游子 Context 传播取消。
可以用下面的代码观察 Deadline、Done 和 Err 的关系:
package main

import (
	"context"
	"fmt"
	"time"
)

func main() {
	ctx, cancel := context.WithTimeout(context.Background(), 30*time.Millisecond)
	defer cancel()

	deadline, ok := ctx.Deadline()
	fmt.Println("has deadline:", ok)
	fmt.Println("remaining positive:", time.Until(deadline) > 0)

	<-ctx.Done()
	fmt.Println("err:", ctx.Err())
}
运行结果:
has deadline: true
remaining positive: true
err: context deadline exceeded
如果父 Context 已经有一个更早的截止时间,WithDeadline 不会再创建一个更晚的 timerCtx,而是沿用父 Context 的更早取消时间。调用返回的 cancel 函数仍然很重要:任务提前完成时,调用 cancel 可以停止计时器并从父 Context 的子节点集合中移除当前节点。
Context 的取消树
Context 更像一棵树,而不是一个单独的对象:
Background
    └── valueCtx(request-id)
          └── cancelCtx
                └── timerCtx(30ms)
                      └── worker context
父 Context 被取消时,取消会向下游传播;子 Context 被单独取消时,不会反向取消父 Context。cancelCtx 使用互斥锁保护子节点集合,并用原子值保存错误和 Done channel 的状态;timerCtx 负责把时间事件转换成取消事件;valueCtx 只负责在 Context 链上保存和查找键值。
这里的 valueCtx、cancelCtx 和 timerCtx 都是 context 包的内部实现细节,业务代码不能直接构造它们。我们学习它们的意义,是理解公开 API 背后分别对应"值传递、取消传播、时间触发"三种职责。
context 只能合作式取消
下面的函数不会及时响应取消,因为它在一个不检查 context 的长循环中工作:
func badWorker(ctx context.Context) {
	for i := 0; i < 1_000_000_000; i++ {
		// 没有检查 ctx.Done()
	}
}
正确做法是定期检查:
func goodWorker(ctx context.Context) error {
	for i := 0; i < 1_000_000_000; i++ {
		if i%1000 == 0 {
			select {
			case <-ctx.Done():
				return ctx.Err()
			default:
			}
		}
	}
	return nil
}
阻塞在 channel 发送或接收时,也必须把 ctx.Done() 放进同一个 select,否则取消信号可能永远无法被处理。
select {
case output <- value:
	return nil
case <-ctx.Done():
	return ctx.Err()
}
context 的 Value 只适合保存请求范围的元数据,例如 trace ID 或认证信息。不要把可选业务参数、数据库连接、可变共享状态全部塞进 context。
使用 race detector 检查数据竞争
数据竞争发生在:两个 goroutine 并发访问同一变量,至少一个访问是写入,而且它们之间没有同步关系。
Go 自带竞态检测器。可以直接运行:
go run -race main.go也可以运行测试:
go test -race ./...竞态检测器会在编译时插入额外的内存访问记录,运行时发现未同步的读写后打印报告。它只能发现实际执行到的竞争路径,因此测试覆盖率很重要。
可以用下面的代码验证:
package main

import (
	"sync"
)

func main() {
	var value int
	var wg sync.WaitGroup

	for i := 0; i < 2; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			value++
		}()
	}

	wg.Wait()
}
使用 go run -race 运行时,报告会指出两个 goroutine 对 value 的冲突读写。修复方式不是给结果加一个 time.Sleep,而是使用 Mutex、atomic 或 channel 建立真正的同步关系。
竞态检测有额外开销,官方文档说明它可能让内存使用增加数倍、执行时间增加更多;它适合测试和压测环境,不需要一直用于生产构建。
实现一个可取消的并发工作池
前面的知识点已经足够写出一个小型工作池。这个工作池的目标不是替代成熟的任务库,而是把 goroutine、channel、WaitGroup 和 context 的职责放在同一段完整代码里。
先明确工作池的需求
我们先不急着写代码,先把数据结构的约束列出来:
| 需求 | 实现方式 |
|---|---|
| 固定同时执行的任务数 | 创建固定数量的 worker goroutine |
| 限制排队任务数量 | 使用有缓冲 jobs channel |
| 提交任务时支持取消 | Submit 中选择 ctx.Done() |
| 每个任务返回结果和错误 | Result[T] 通过 results channel 输出 |
| 所有 worker 结束后关闭结果 | WaitGroup 等待后关闭 results |
| 正常结束 | 生产者关闭 jobs,worker 读完后退出 |
| 提前停止 | 调用 Cancel,worker 合作式退出 |
这个设计有一个明确的所有权约定:提交任务的一方拥有 jobs channel,并且提交完成后负责调用 Close;worker 只接收 jobs,不关闭 jobs;worker 是 results 的发送方,工作池内部负责在所有 worker 结束后关闭 results。
先定义任务和结果类型:
type Job[T any] struct {
	ID  int
	Run func(context.Context) (T, error)
}

type Result[T any] struct {
	ID    int
	Value T
	Err   error
}
Job[T] 使用泛型表示"任务最终返回 T 类型的值"。任务函数接收 context,这样每个具体任务都可以主动响应取消。
定义 WorkerPool
type WorkerPool[T any] struct {
	ctx    context.Context
	cancel context.CancelFunc

	jobs    chan Job[T]
	results chan Result[T]

	workers    sync.WaitGroup
	closeJobs  sync.Once
	done       chan struct{}
}
字段的职责如下:
ctx和cancel:控制整个工作池的生命周期;jobs:生产者向 worker 发送任务;results:worker 向消费者发送结果;workers:等待所有 worker 退出;closeJobs:保证关闭任务 channel 的操作只执行一次;done:通知调用方工作池已经完全结束。
接下来编写构造函数:
func NewWorkerPool[T any](
	parent context.Context,
	workerCount int,
	queueSize int,
) *WorkerPool[T] {
	if workerCount <= 0 {
		panic("workerCount must be positive")
	}
	if queueSize < 0 {
		panic("queueSize must not be negative")
	}

	ctx, cancel := context.WithCancel(parent)
	p := &WorkerPool[T]{
		ctx:     ctx,
		cancel:  cancel,
		jobs:    make(chan Job[T], queueSize),
		results: make(chan Result[T], queueSize),
		done:    make(chan struct{}),
	}

	p.workers.Add(workerCount)
	for i := 0; i < workerCount; i++ {
		go p.worker()
	}

	go func() {
		p.workers.Wait()
		close(p.results)
		close(p.done)
	}()

	return p
}
构造函数创建固定数量的 worker,并额外启动一个协调 goroutine。协调 goroutine 不处理业务任务,只做两件事:等待所有 worker 退出,关闭 results 和 done。
编写 worker
func (p *WorkerPool[T]) worker() {
	defer p.workers.Done()

	for {
		select {
		case <-p.ctx.Done():
			return

		case job, ok := <-p.jobs:
			if !ok {
				return
			}

			// 如果任务已经排队,但在取出前工作池被取消,
			// 不再启动新的任务。
			if err := p.ctx.Err(); err != nil {
				return
			}

			value, err := job.Run(p.ctx)
			result := Result[T]{
				ID:    job.ID,
				Value: value,
				Err:   err,
			}

			select {
			case p.results <- result:
			case <-p.ctx.Done():
				return
			}
		}
	}
}
worker 有三个退出路径:
jobs被关闭,说明生产者不会再提交任务;ctx.Done()被关闭,说明工作池被取消;- 当前任务返回以后,结果发送阶段发现 context 已取消。
这里有一个很容易忽略的细节:job.Run 返回错误并不会自动关闭工作池。错误被封装在 Result.Err 中,由调用方决定是否继续处理其他任务。如果业务要求"一个任务失败,所有任务立即停止",可以在消费者收到错误后调用 pool.Cancel()。
编写提交、关闭和等待方法
func (p *WorkerPool[T]) Submit(job Job[T]) error {
	if job.Run == nil {
		return fmt.Errorf("job %d has nil Run function", job.ID)
	}
	if err := p.ctx.Err(); err != nil {
		return err
	}

	select {
	case p.jobs <- job:
		return nil
	case <-p.ctx.Done():
		return p.ctx.Err()
	}
}

func (p *WorkerPool[T]) Results() <-chan Result[T] {
	return p.results
}

func (p *WorkerPool[T]) Close() {
	p.closeJobs.Do(func() {
		close(p.jobs)
	})
}

func (p *WorkerPool[T]) Cancel() {
	p.cancel()
}

func (p *WorkerPool[T]) Wait() {
	<-p.done
}
这段代码需要在文件顶部导入 fmt、context 和 sync:
import (
	"context"
	"fmt"
	"sync"
)
Submit 使用 select 同时等待两个事件:任务进入有界队列,或者工作池被取消。队列满时,调用方会产生背压;如果调用方不想一直等待,可以在外部再包一层带超时的 context。
Close 只关闭 jobs,不关闭 results。因为 results 仍然可能有 worker 在发送数据,只有等所有 worker 退出以后,协调 goroutine 才能安全地关闭 results。
Wait 只等待工作池结束,不会自动调用 Close。正常流程必须先提交任务、调用 Close,再调用 Wait;如果提前取消,则调用 Cancel 后再调用 Wait。如果既不关闭 jobs 也不取消 context,worker 没有退出条件,Wait 就会一直阻塞。
这里还要强调一个 API 使用约定:调用 Close 以后不能继续调用 Submit,也不要让多个 goroutine 同时无序地调用 Close 和 Submit。 关闭 channel 和发送 channel 必须有清晰的所有权。如果需要允许多个生产者并发提交,应该再设计提交状态锁,不能只靠 sync.Once 解决发送和关闭之间的竞争。
编写一个可取消的任务
下面的任务模拟耗时计算:
func square(ctx context.Context, number int) (int, error) {
	timer := time.NewTimer(30 * time.Millisecond)
	defer timer.Stop()

	select {
	case <-timer.C:
		return number * number, nil
	case <-ctx.Done():
		return 0, ctx.Err()
	}
}
任务没有直接调用 time.Sleep,而是等待计时器或取消信号。这样工作池被取消时,任务可以尽快返回。
完整测试代码
package main

import (
	"context"
	"fmt"
	"sync"
	"time"
)

type Job[T any] struct {
	ID  int
	Run func(context.Context) (T, error)
}

type Result[T any] struct {
	ID    int
	Value T
	Err   error
}

type WorkerPool[T any] struct {
	ctx    context.Context
	cancel context.CancelFunc

	jobs    chan Job[T]
	results chan Result[T]

	workers   sync.WaitGroup
	closeJobs sync.Once
	done      chan struct{}
}

func NewWorkerPool[T any](
	parent context.Context,
	workerCount int,
	queueSize int,
) *WorkerPool[T] {
	if workerCount <= 0 {
		panic("workerCount must be positive")
	}
	if queueSize < 0 {
		panic("queueSize must not be negative")
	}

	ctx, cancel := context.WithCancel(parent)
	p := &WorkerPool[T]{
		ctx:     ctx,
		cancel:  cancel,
		jobs:    make(chan Job[T], queueSize),
		results: make(chan Result[T], queueSize),
		done:    make(chan struct{}),
	}

	p.workers.Add(workerCount)
	for i := 0; i < workerCount; i++ {
		go p.worker()
	}

	go func() {
		p.workers.Wait()
		close(p.results)
		close(p.done)
	}()

	return p
}

func (p *WorkerPool[T]) worker() {
	defer p.workers.Done()

	for {
		select {
		case <-p.ctx.Done():
			return
		case job, ok := <-p.jobs:
			if !ok {
				return
			}
			if err := p.ctx.Err(); err != nil {
				return
			}

			value, err := job.Run(p.ctx)
			result := Result[T]{ID: job.ID, Value: value, Err: err}

			select {
			case p.results <- result:
			case <-p.ctx.Done():
				return
			}
		}
	}
}

func (p *WorkerPool[T]) Submit(job Job[T]) error {
	if job.Run == nil {
		return fmt.Errorf("job %d has nil Run function", job.ID)
	}
	if err := p.ctx.Err(); err != nil {
		return err
	}

	select {
	case p.jobs <- job:
		return nil
	case <-p.ctx.Done():
		return p.ctx.Err()
	}
}

func (p *WorkerPool[T]) Results() <-chan Result[T] {
	return p.results
}

func (p *WorkerPool[T]) Close() {
	p.closeJobs.Do(func() { close(p.jobs) })
}

func (p *WorkerPool[T]) Cancel() {
	p.cancel()
}

func (p *WorkerPool[T]) Wait() {
	<-p.done
}

func square(ctx context.Context, number int) (int, error) {
	timer := time.NewTimer(30 * time.Millisecond)
	defer timer.Stop()

	select {
	case <-timer.C:
		return number * number, nil
	case <-ctx.Done():
		return 0, ctx.Err()
	}
}

func main() {
	ctx, cancel := context.WithTimeout(context.Background(), time.Second)
	defer cancel()

	pool := NewWorkerPool[int](ctx, 3, 2)

	// 必须并发消费结果,否则结果缓冲区填满以后,worker 会阻塞,
	// 进而让 Submit 也产生背压。
	printerDone := make(chan struct{})
	go func() {
		defer close(printerDone)
		for result := range pool.Results() {
			if result.Err != nil {
				fmt.Printf("task %d error: %v\n", result.ID, result.Err)
				continue
			}
			fmt.Printf("task %d result: %d\n", result.ID, result.Value)
		}
	}()

	for i := 1; i <= 8; i++ {
		number := i
		err := pool.Submit(Job[int]{
			ID: number,
			Run: func(ctx context.Context) (int, error) {
				return square(ctx, number)
			},
		})
		if err != nil {
			fmt.Println("submit error:", err)
			break
		}
	}

	// 生产者提交完成后关闭 jobs,worker 会把队列中的任务读完再退出。
	pool.Close()
	pool.Wait()
	<-printerDone

	fmt.Println("pool stopped")
}
一次可能的运行结果:
task 2 result: 4
task 1 result: 1
task 3 result: 9
task 5 result: 25
task 4 result: 16
task 6 result: 36
task 8 result: 64
task 7 result: 49
pool stopped
任务顺序不是提交顺序,也不是固定顺序。工作池只保证每个任务最多由一个 worker 执行一次,并且 pool stopped 出现在所有结果输出之后。
工作池内部发生了什么
把整个执行过程拆开,可以得到下面的流程:
NewWorkerPool创建 jobs、results 和 context;- 固定数量的 worker 阻塞等待 jobs;
Submit把任务放入有界 jobs channel;- 任意空闲 worker 取出一个任务并执行;
- worker 把
Result放入 results channel; - 消费者从 results 读取结果;
- 生产者调用
Close,表示不会再有新任务; - worker 读完 jobs 后退出;
- WaitGroup 归零,协调 goroutine 关闭 results;
- 消费者的
range结束,Wait返回。
这里的 jobs 和 results 都有界,所以系统具备背压:生产速度超过处理速度时,提交方会在 jobs 满时等待。这个等待不是 bug,而是有界系统保护内存和下游的方式。
让一个错误取消整个工作池
如果业务规定任何一个任务失败都应该停止剩余任务,可以在结果消费者中调用 Cancel:
for result := range pool.Results() {
	if result.Err != nil {
		pool.Cancel()
		fmt.Println("cancel because of error:", result.Err)
		continue
	}
	fmt.Println(result.Value)
}
这只是发出取消信号。正在执行的任务是否立即停止,取决于任务函数有没有检查 context;阻塞在网络、磁盘或第三方库调用中的任务,还需要使用支持 context 的 API。
一个简单的 pipeline:生成、处理、汇总
工作池是固定 worker 模型,pipeline 则更强调阶段之间的数据流。下面实现一个三阶段流程:
-
generate生成数字; -
squareStage计算平方; -
sum汇总结果。func generate(ctx context.Context, values ...int) <-chan int {
out := make(chan int)
go func() {
defer close(out)
for _, value := range values {
select {
case out <- value:
case <-ctx.Done():
return
}
}
}()
return out
}func squareStage(ctx context.Context, input <-chan int) <-chan int {
out := make(chan int)
go func() {
defer close(out)
for value := range input {
result := value * value
select {
case out <- result:
case <-ctx.Done():
return
}
}
}()
return out
}func sum(ctx context.Context, input <-chan int) (int, error) {
total := 0
for {
select {
case value, ok := <-input:
if !ok {
return total, nil
}
total += value
case <-ctx.Done():
return 0, ctx.Err()
}
}
}
调用方式:
ctx := context.Background()
numbers := generate(ctx, 1, 2, 3, 4)
squares := squareStage(ctx, numbers)
total, err := sum(ctx, squares)
fmt.Println(total, err)
运行结果:
30 <nil>pipeline 的每一个阶段都遵循两个规则:发送方关闭自己的输出 channel;发送操作和接收操作都能够响应 context 取消。这样下游提前退出时,上游不会因为一次无人接收的发送而永久泄漏 goroutine。
常见错误和避坑提醒
误区一:启动 goroutine 就会自动等待
不会。main 返回时,程序结束。使用 WaitGroup、完成 channel 或其他明确同步方式等待。
误区二:用 time.Sleep 等待任务完成
睡眠只能碰运气,不能表达 happens-before。应使用 channel、WaitGroup、Mutex 或 context。
误区三:把 WaitGroup 复制给另一个函数
WaitGroup 在第一次使用后不能复制。应该传递 *sync.WaitGroup,或者让创建它的结构体拥有它。
误区四:在 worker 或接收方关闭 jobs
关闭 channel 的一方必须拥有"不会再发送"的事实。通常由生产者关闭 jobs,消费者只负责接收。接收方不知道是否还有其他生产者,不能擅自关闭。
误区五:多个发送者同时关闭同一个 channel
重复关闭会 panic。需要由协调者使用 WaitGroup 等待所有发送者完成,再由一个 goroutine 统一关闭输出 channel。
误区六:发送到已关闭 channel
接收关闭 channel 会得到零值,但发送关闭 channel 会 panic。不要把"关闭后还能读"误解成"关闭后还能写"。
误区七:range channel 没有关闭
for value := range values {
	fmt.Println(value)
}
这段代码只有在 values 被关闭后才会结束。如果发送方永远不关闭,接收方会永久阻塞。
误区八:忽略 nil channel
nil channel 的发送和接收都会永久阻塞。它可以用来动态禁用 select 分支,但普通业务代码中如果意外得到 nil channel,很容易造成 goroutine 泄漏。
误区九:context cancel 后认为 goroutine 一定结束
cancel() 只关闭 Done channel,不会强行终止 goroutine。任务函数必须主动检查 context,调用方如果需要确认退出,还要等待完成信号。
误区十:把 channel 当成万能锁
如果只是保护一个对象的几个字段,Mutex 可能更清楚;如果是自然的数据流,channel 更合适。不要为了遵守一句口号而引入额外的 goroutine。
误区十一:把有缓冲 channel 当成无限队列
有缓冲 channel 只有固定容量。生产速度持续超过消费速度时,发送方最终仍然会阻塞。容量越大,只是把问题延后,不能消除背压。
误区十二:结果无人消费导致 worker 泄漏
如果 worker 向 results 发送,而没有消费者读取,results 缓冲区满以后 worker 会阻塞,WaitGroup 永远不会归零。工作池、pipeline 和 fan-in 代码都必须设计结果的消费生命周期。
误区十三:只在本地正常运行,不使用 race detector
并发错误往往不会每次复现。对并发代码至少执行一次:
go test -race ./...并发代码速查表
| 需求 | 推荐写法 |
|---|---|
| 启动后台任务 | go function() |
| 等待多个 goroutine | sync.WaitGroup |
| 传递任务或结果 | chan T |
| 限制 channel 方向 | chan<- T、<-chan T |
| 结束一条数据流 | 由发送方 close(ch) |
| 等待多个 channel | select |
| 超时 | context.WithTimeout 或 timer + select |
| 取消任务 | ctx.Done() + ctx.Err() |
| 保护多个共享字段 | sync.Mutex |
| 保护独立计数器 | sync/atomic |
| 检查数据竞争 | go test -race ./... |
| 固定 worker 数量 | worker pool |
| 多阶段数据处理 | pipeline |
总结
本篇我们学习了 Go 并发和协程的语言层基础:
go语句会启动一个独立 goroutine,但不会自动等待它结束;- goroutine 之间共享地址空间,因此必须明确同步关系;
WaitGroup用于等待一组任务完成,不负责传递结果和错误;- 无缓冲 channel 同时完成通信和同步;
- 有缓冲 channel 可以表达有限队列和并发上限;
- 单向 channel 可以把发送和接收责任写进函数签名;
- 通常由发送方关闭 channel,接收方使用
range读取到结束; - 从关闭 channel 接收会得到零值和
ok == false,向关闭 channel 发送会 panic; - nil channel 永久阻塞,但可以用来动态禁用 select 分支;
select用于多路通信、超时、取消和非阻塞操作;- channel、Mutex 和 atomic 都能建立同步关系,但适用场景不同;
- Go 内存模型中的 happens-before 决定了跨 goroutine 的可见性;
valueCtx通过父 Context 链保存请求范围数据,最近的一层 key 优先;timerCtx使用计时器把 deadline 转换成 Done 关闭和DeadlineExceeded;context的取消是合作式的,CancelFunc不负责等待 goroutine 退出;sync.Mutex保护复合状态,sync.RWMutex适合读多写少,sync.Cond等待共享条件;sync/atomic适合独立计数、状态位和 CAS,不会自动保证多个字段的一致性;go test -race可以帮助发现实际执行路径中的数据竞争;- pipeline 和 worker pool 都必须处理关闭顺序、背压、取消和结果消费;
- 工作池的核心不是"启动很多 goroutine",而是限制并发、传递结果、清理资源并保证 goroutine 最终退出。
真正理解 Go 并发之后,就不会把它简单理解成"在函数前面加一个 go"。更准确的理解是:goroutine 负责独立执行,channel 负责传递数据和建立同步,WaitGroup 负责等待生命周期,context 负责取消传播,Mutex 和 atomic 负责保护共享状态,而正确的关闭顺序和数据所有权决定了整个并发结构能否安全结束。
官方资料
- Go 语言规范:Go statements
- Go 语言规范:Channel types
- Go 语言规范:Select statements
- Go 官方文档:Effective Go - Concurrency
- Go 内存模型
- Go 官方文档:sync 包
- Go 官方文档:sync.Mutex
- Go 官方文档:sync.RWMutex
- Go 官方文档:sync.Cond
- Go 官方文档:sync/atomic 包
- Go 官方文档:context 包
- Go 官方源码:context/context.go
- Go 官方源码:sync/cond.go
- Go 官方博客:Pipelines and cancellation
- Go 官方博客:Timing out, moving on
- Go 官方文档:Data Race Detector
- Go 官方文档:runtime.GOMAXPROCS
- A Tour of Go:Concurrency