Java对接DeepSeek
一,注册DeepSeek API Key
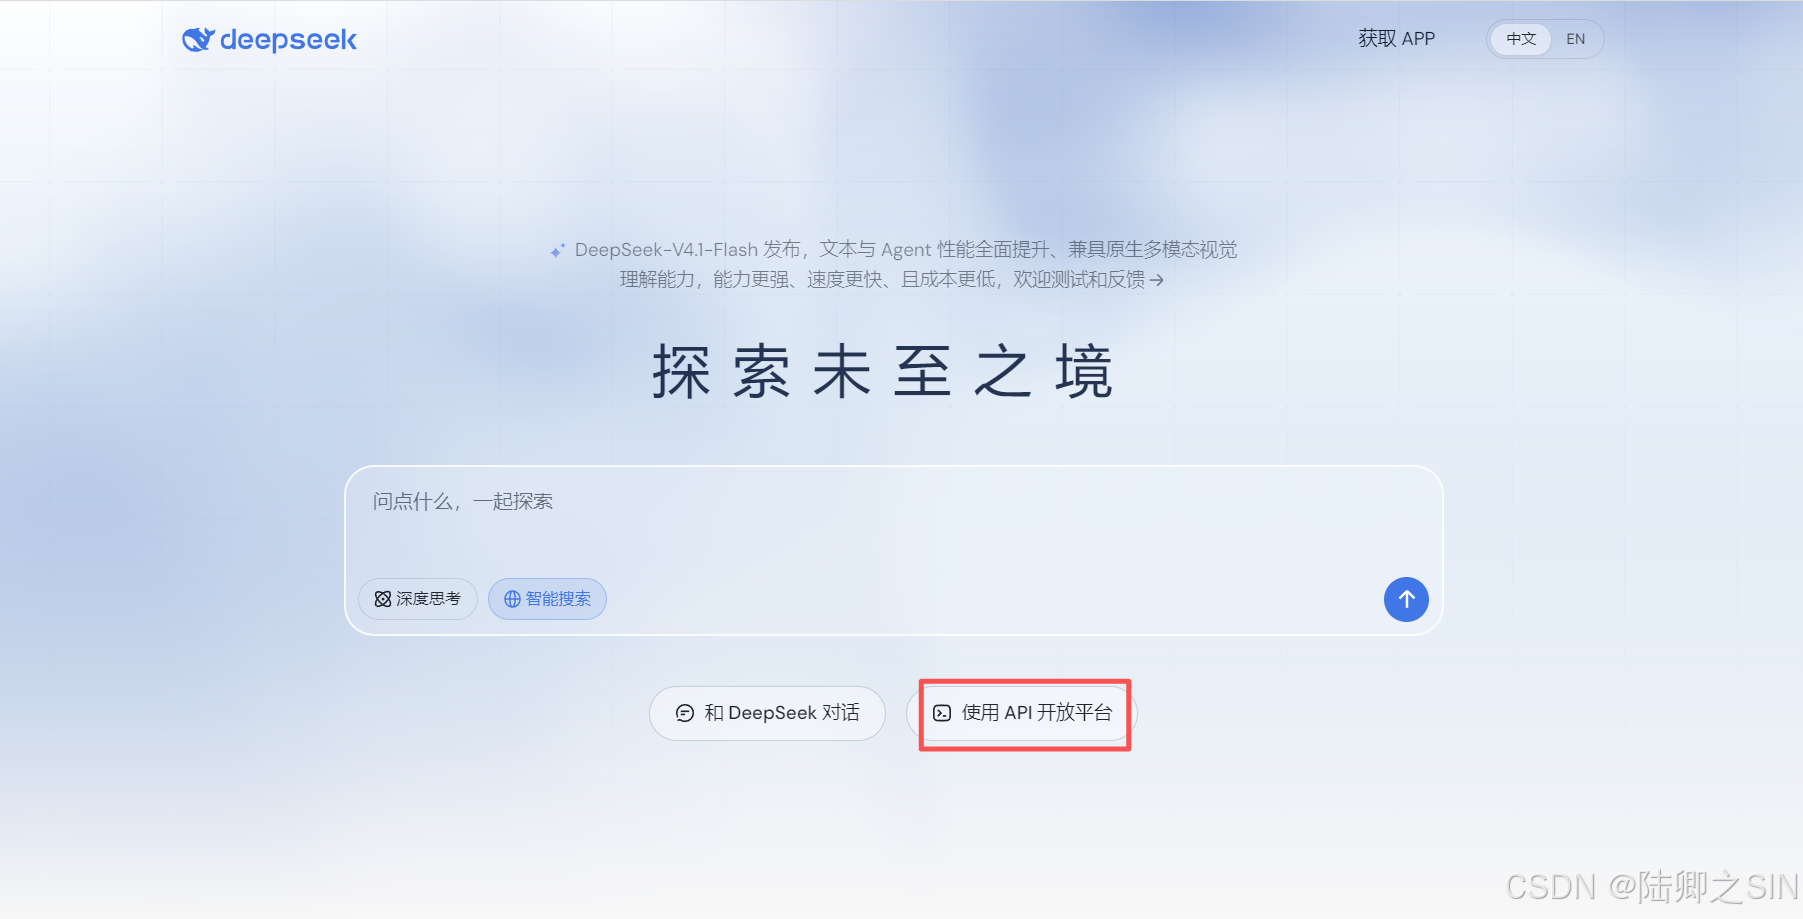
1,访问DeepSeek官网并进入【API开发平台】
在浏览器地址https://www.deepseek.com/官网地址,
点击使用API开发平台
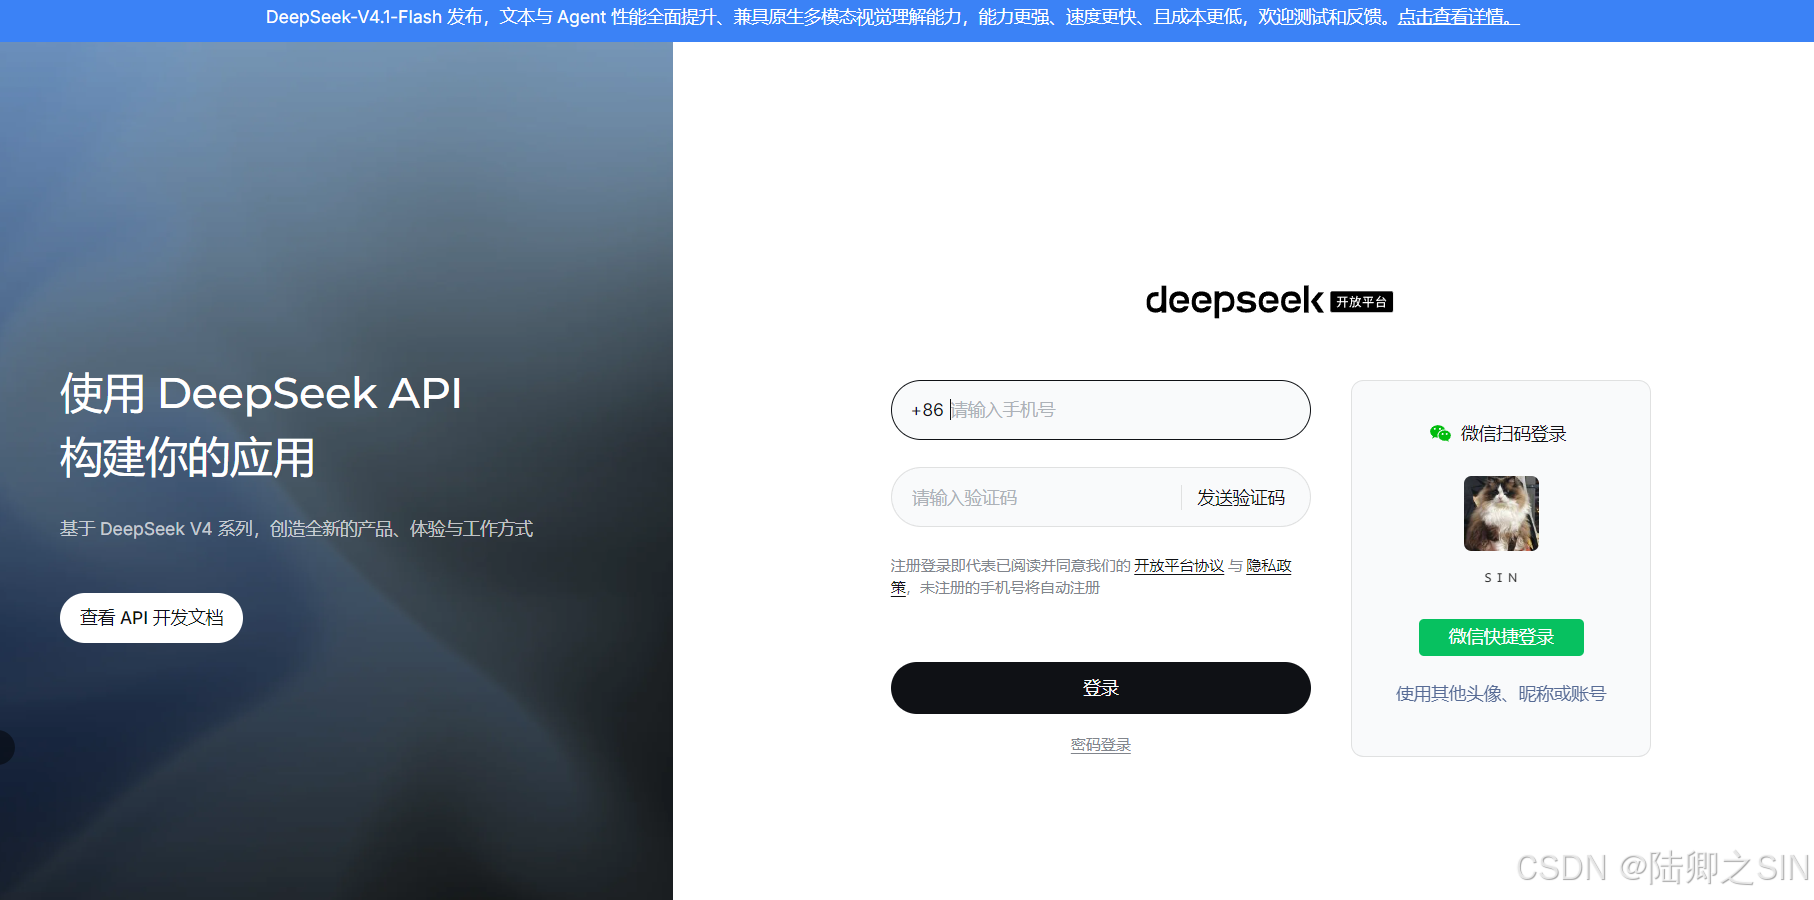
2,注册/登录DeepSeek开发平台
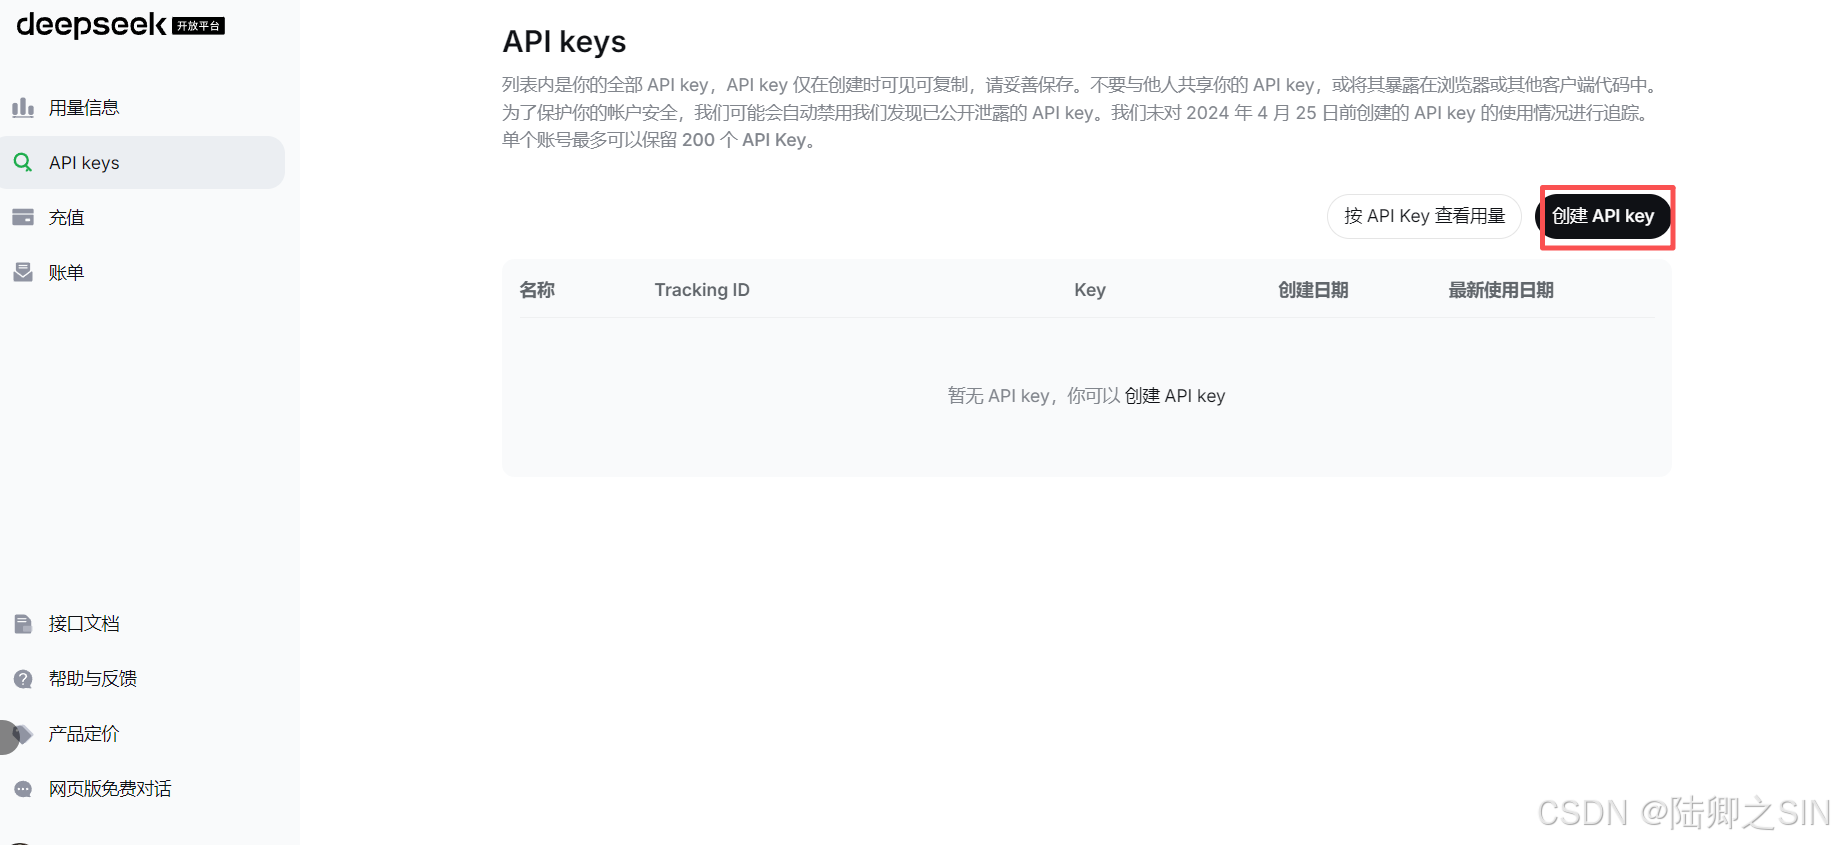
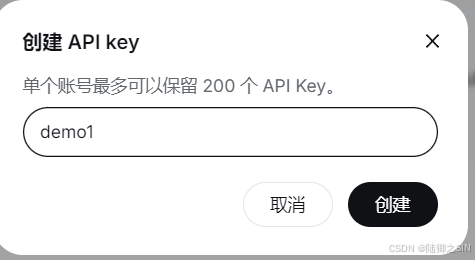
3,进入API keys管理界面并创建key
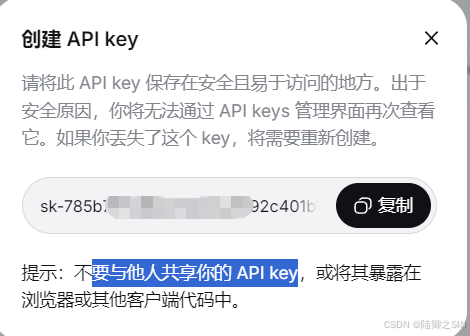
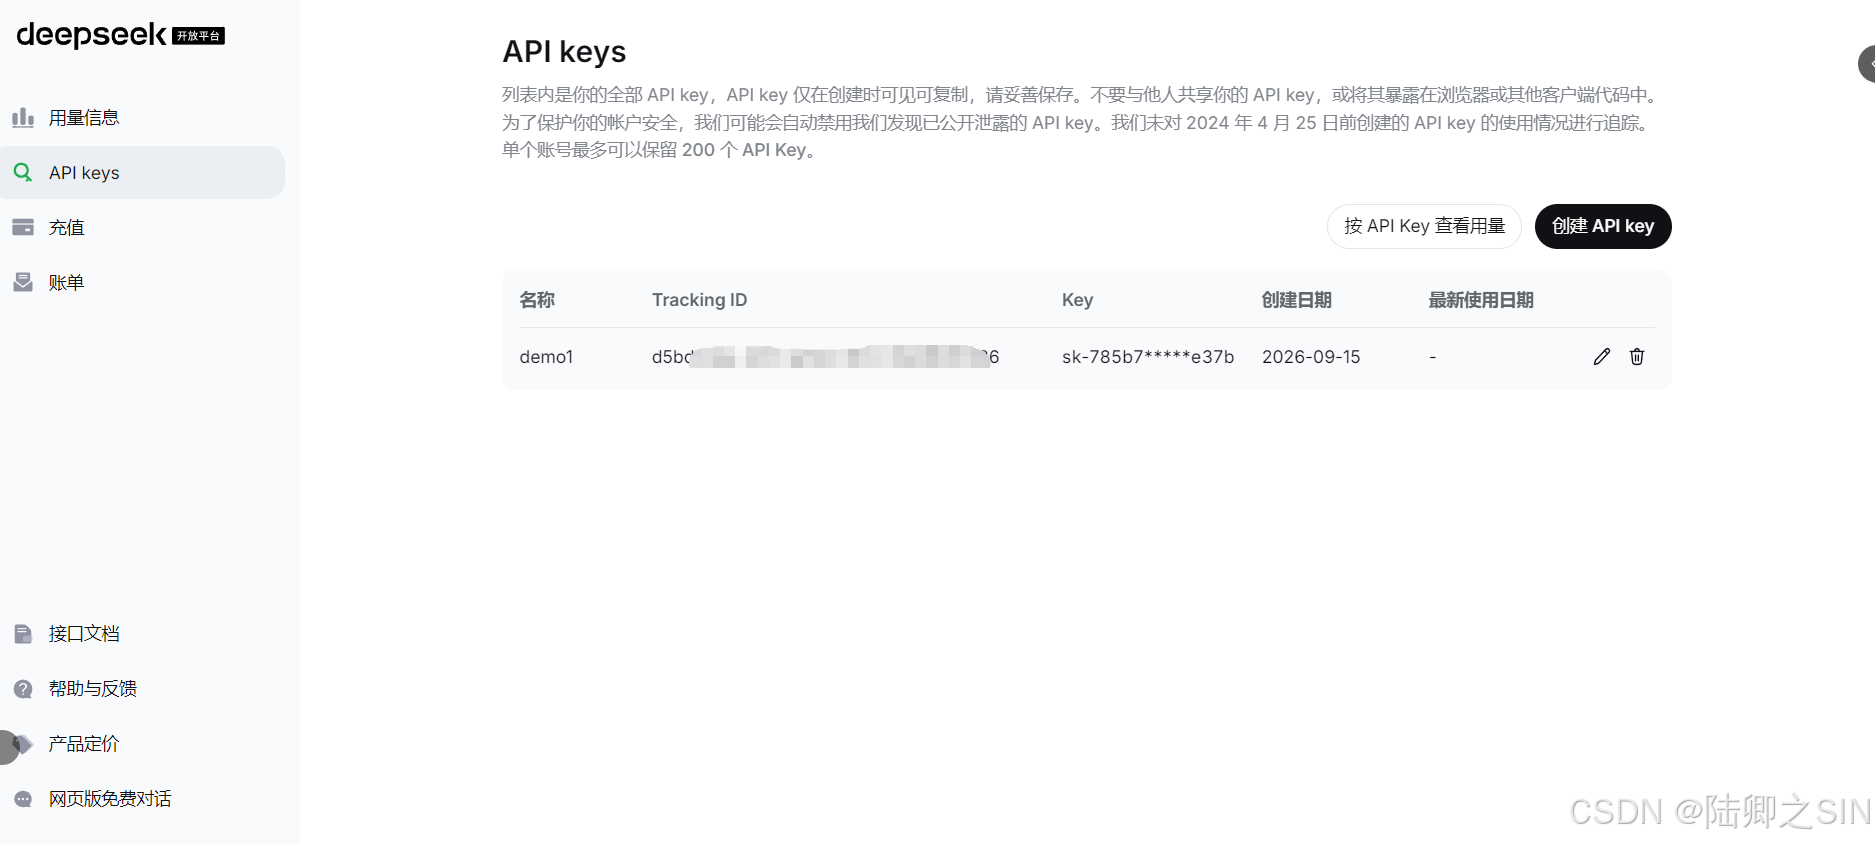
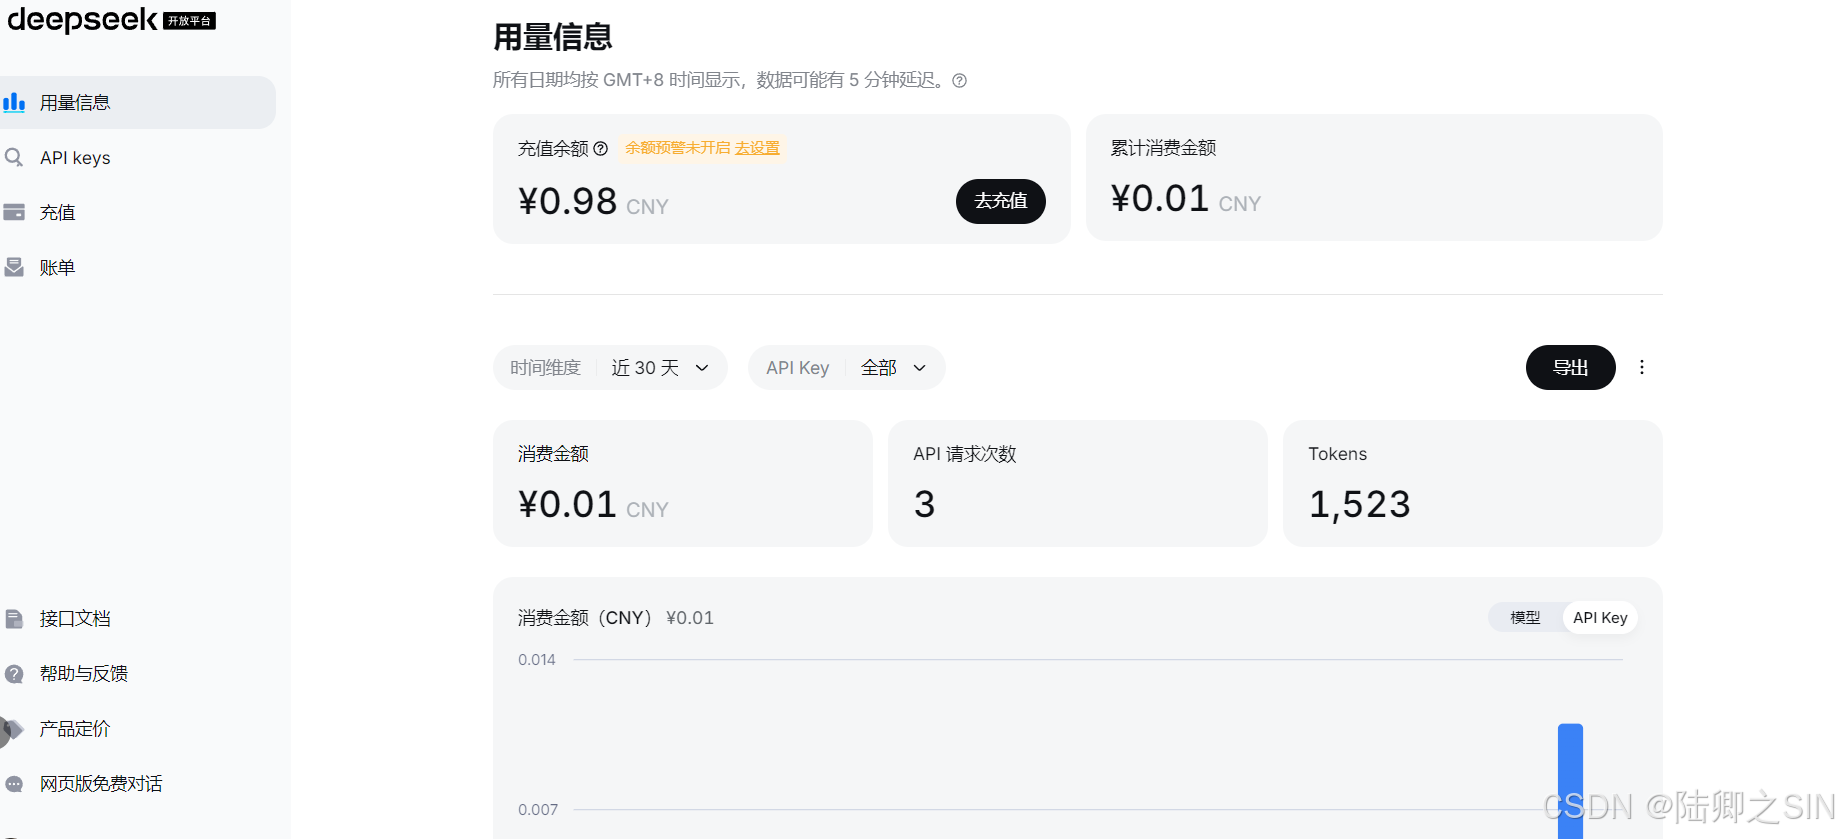
4,充值账户余额
二,创建项目
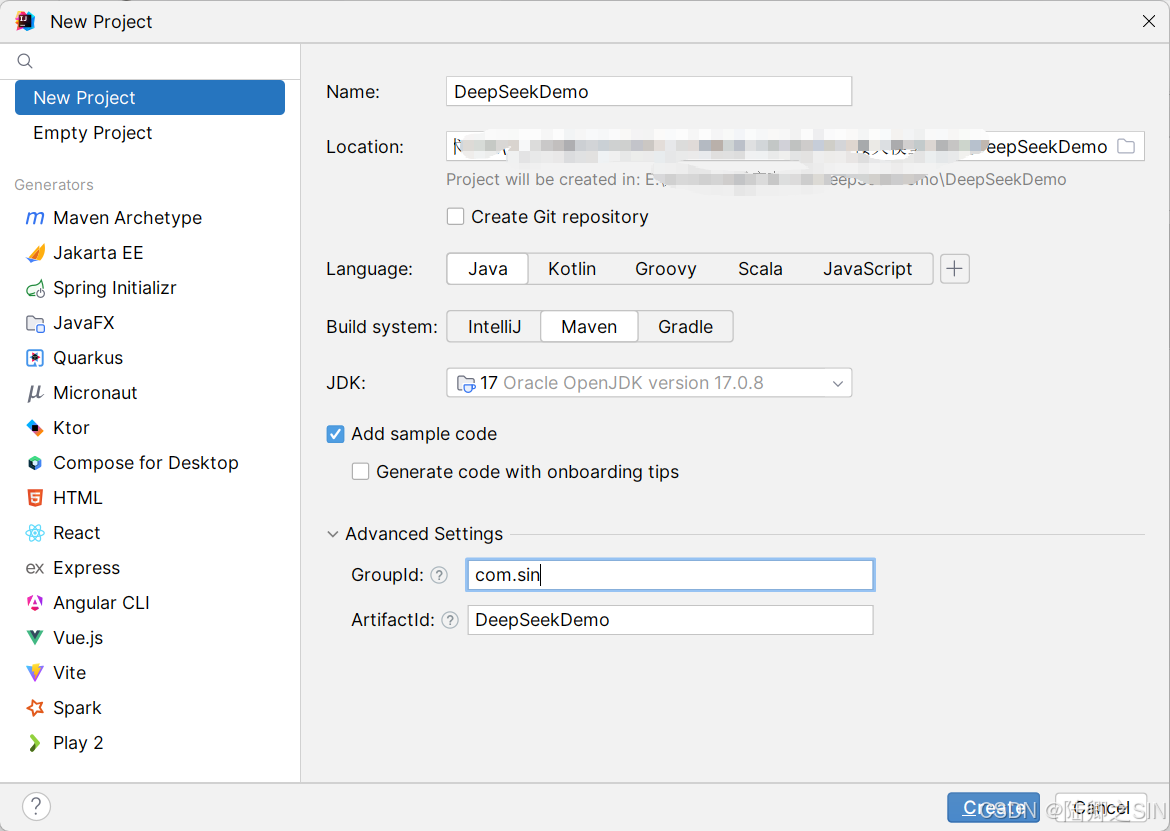
pom.xml
xml
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>com.sin</groupId>
    <artifactId>DemoModel</artifactId>
    <version>1.0-SNAPSHOT</version>

    <properties>
        <java.version>1.8</java.version>
    </properties>

    <dependencies>

        <!-- ========== 1. Java 工具库 ========== -->
        <!-- 说明:
             作用:Hutool 是一个 Java 工具库,提供了大量静态方法,简化了文件、IO、网络、JSON、
                  加密、日期、集合等常见操作。使用 "hutool-all" 可获得全部模块。
             为什么用这个版本:5.7.20 是 2021 年的稳定版本,与项目其他依赖(如 POI 4.1.2、
                  Elasticsearch 7.14.0)发布时间相近,兼容性好。若需新特性可升级至 5.8.x。
             典型使用场景:
               - JSON 处理(JSONObject / JSONArray)------ 如您前面的代码所示。
               - 字符串工具(StrUtil)、集合工具(CollUtil)。
               - HTTP 客户端(HttpUtil)可替代原生 HttpURLConnection。
               - 文件读写(FileUtil)、加密(SecureUtil)等。
             注意事项:引入所有模块可能增加包体积,但开发便利性更高;若只需 JSON 模块,可替换为
               hutool-json 以减小依赖。
        -->
        <dependency>
            <groupId>cn.hutool</groupId>
            <artifactId>hutool-all</artifactId>
            <version>5.7.20</version>
        </dependency>


        <!-- ========== 2. Apache POI - Office 文档读写 ========== -->
        <!-- 说明:
             作用:POI 是 Java 操作 Microsoft Office 格式文件的开源库。poi-ooxml 模块专门处理
                    Office 2007+ 的 XML 格式(.xlsx, .docx, .pptx)。
            为什么用这个版本:4.1.2 是 2020 年发布的稳定版本,支持 Office Open XML 格式完整操作,
                    与 Elasticsearch 7.14.0 和 Hutool 5.7.20 无已知冲突。更新版本(5.x)已发布,
                    但可能引入模块拆分变化,需评估兼容性。
            典型使用场景:
                - 从 Excel (.xlsx) 读取数据批量导入系统。
                - 生成 Excel 报表(支持样式、公式、图表)。
                - 读取 Word 模板并填充内容生成文档。
                - 与 AI 模型结合:例如将大模型生成的内容写入 Excel 或 Word 文档。
                注意:poi-ooxml 会自动传递依赖 poi 和 poi-ooxml-schemas,无需单独引入。
                建议:处理大文件时注意内存使用,可配合 SAX 模式(XSSFReader)或升级到 5.x 使用
                streaming 模块。
        -->
            <dependency>
                <groupId>org.apache.poi</groupId>
                <artifactId>poi-ooxml</artifactId>
                <version>4.1.2</version>
            </dependency>


        <!-- ========== 3. Java 核心客户端库 ========== -->
        <!-- 说明:
           作用:Elasticsearch 的 Java 核心客户端库,用于与 Elasticsearch 集群通信,执行
                索引、搜索、聚合等操作。注意:这是 Transport Client 的依赖(7.x 中尚可用),
                 但 Elasticsearch 官方从 7.x 开始推荐使用 Java High Level REST Client 或
                 新的 Java API Client (8.x+)。此依赖包本身包含低级和高级客户端的部分代码。
           为什么用这个版本:7.14.0 是 2021 年发布的稳定版本,与您的 POI 和 Hutool 版本年代
                接近,兼容性风险低。同时,7.x 是广泛使用的版本,很多生产环境仍在使用。
           典型使用场景:
             - 将大模型生成的文本内容存储到 Elasticsearch 中,构建知识库或搜索索引。
             - 从 ES 检索相关文档作为上下文,输入给大模型(检索增强生成,RAG)。
             - 对用户对话历史进行向量化存储与相似度检索。
           注意事项:
             - 若您的 ES 服务器版本是 7.14.0,此依赖匹配;若版本不同,建议客户端与服务端
               主要版本一致(如服务端 7.17.x 也可用 7.14.0 客户端)。
             - 从 7.15 开始,官方逐步废弃 TransportClient,建议迁移到
               `elasticsearch-rest-high-level-client`。
             - 使用此依赖时,通常还需要引入 `org.elasticsearch.client:elasticsearch-rest-high-level-client`
               以获得更友好的 REST API 封装。
           替代方案:对于新项目,推荐使用 `co.elastic.clients:elasticsearch-java` (8.x+)
                配合 Jackson 或 JSON-B。
      -->
        <dependency>
            <groupId>org.elasticsearch</groupId>
            <artifactId>elasticsearch</artifactId>
            <version>7.14.0</version>
        </dependency>

        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <version>5.1.49</version>
        </dependency>


        <!-- 旧版 .ppt 用(HSLFSlideShow) -->
        <dependency>
            <groupId>org.apache.poi</groupId>
            <artifactId>poi-scratchpad</artifactId>
            <version>4.1.2</version>
        </dependency>

        <!-- Apache Commons IO,POI 5.2.x 解析 .ppt 时必须 -->
        <dependency>
            <groupId>commons-io</groupId>
            <artifactId>commons-io</artifactId>
            <version>2.12.0</version>
        </dependency>

        <!-- Apache POI 核心(必须显式引入,ThreadLocalUtil 在这里) -->
        <dependency>
            <groupId>org.apache.poi</groupId>
            <artifactId>poi</artifactId>
            <version>4.1.2</version>
        </dependency>

    </dependencies>
    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
                <version>2.7.9</version>
                <configuration>
                    <excludes>
                        <exclude>
                            <groupId>org.projectlombok</groupId>
                            <artifactId>lombok</artifactId>
                        </exclude>
                    </excludes>
                </configuration>
            </plugin>
        </plugins>
    </build>
    <!--配置阿里云仓库下载-->
    <repositories>
        <repository>
            <id>nexus-aliyun</id>
            <name>nexus-aliyun</name>
            <url>https://maven.aliyun.com/nexus/content/groups/public/</url>
            <releases>
                <enabled>true</enabled>
            </releases>
            <snapshots>
                <enabled>false</enabled>
            </snapshots>
        </repository>
    </repositories>
    <pluginRepositories>
        <pluginRepository>
            <id>public</id>
            <name>nexus-aliyun</name>
            <url>https://maven.aliyun.com/nexus/content/groups/public/</url>
            <releases>
                <enabled>true</enabled>
            </releases>
            <snapshots>
                <enabled>false</enabled>
            </snapshots>
        </pluginRepository>
    </pluginRepositories>
</project>
对接DeepSeek API进行对话
java
package com.sin; // 声明当前类所在的包,包名通常与目录结构对应

// 导入 Hutool 工具库中的 JSON 相关类,用于方便地构建和解析 JSON

import cn.hutool.json.JSONArray;   // 表示 JSON 数组
import cn.hutool.json.JSONObject;  // 表示 JSON 对象
import cn.hutool.json.JSONUtil;    // 提供 JSON 字符串与对象之间的转换工具

// 导入 Java 原生 IO 和网络相关类
import java.io.BufferedReader;     // 带缓冲的字符输入流,用于高效读取响应内容
import java.io.InputStream;        // 字节输入流,用于获取响应体
import java.io.InputStreamReader;  // 将字节流转换为字符流,并指定编码
import java.io.OutputStream;       // 字节输出流,用于发送请求体
import java.net.HttpURLConnection; // Java 原生的 HTTP 连接类
import java.net.URL;               // 表示统一资源定位符
import java.nio.charset.StandardCharsets; // 提供标准字符集常量,如 UTF-8

/**
 * @createTime 2026/9/14 10:44
 * @createAuthor SIN
 * @use DeepSeek 大模型 API 调用示例
 * 功能:发送一条信息,完整接收 AI 返回的 JSON 数据并打印
 */
public class DemoModel1 {


    // ==================== 常量定义 ====================

    // 1. API Key(DeepSeek 的 key 以 sk- 开头)
    // 注意:生产环境请勿硬编码在代码中!建议使用环境变量、配置中心或密钥管理服务。
    private static final String API_KEY = "sk-360a513df*************af38c53";

    // 2. DeepSeek API 地址
    // DeepSeek 的聊天补全接口与 OpenAI 格式兼容,完整端点为:
    // https://api.deepseek.com/chat/completions
    private static final String API_URL = "https://api.deepseek.com/chat/completions";

    /**
     * 程序入口方法
     *
     * @param args 命令行参数(本示例未使用)
     */
    public static void main(String[] args) {
        try {
            // ==================== 第一步:构建请求体 JSON ====================

            // 创建最外层的 JSON 对象,用于承载整个请求体
            JSONObject requestBody = new JSONObject();

            // 指定要调用的模型名称
            // deepseek-chat 是 DeepSeek 的通用对话模型
            // 如果需要推理模型,可以改为 deepseek-reasoner
            requestBody.put("model", "deepseek-chat");

            // 是否使用流式输出
            // false 表示一次性返回完整结果;true 表示以 SSE 流的方式逐块返回
            // 这里为了简化,设为 false,方便一次性读取完整 JSON
            requestBody.put("stream", false);

            // 构建 messages 数组,用于存放对话历史
            // DeepSeek 要求 messages 是一个数组,每个元素包含 role 和 content
            JSONArray messages = new JSONArray();

            // 创建一条用户消息对象
            JSONObject userMessage = new JSONObject();
            // 指定消息角色为 "user",表示这是用户发送的内容
            userMessage.put("role", "user");

            // 定义用户提问内容
            String question = "你好";
            System.out.println("用户向大模型提出的问题是:" + question);
            // 将问题文本放入 content 字段
            userMessage.put("content", question);

            // 将这条用户消息添加到 messages 数组中
            messages.put(userMessage);
            // 将 messages 数组放入最外层的请求体对象中
            requestBody.put("messages", messages);

            // 此时 requestBody 的结构大致为:
            // {
            //   "model": "deepseek-chat",
            //   "stream": false,
            //   "messages": [
            //     { "role": "user", "content": "你好" }
            //   ]
            // }

            // ==================== 第二步:建立 HTTP 连接 ====================

            // 根据 API 地址创建 URL 对象
            URL url = new URL(API_URL);
            // 打开连接,并强制转换为 HttpURLConnection,以便设置请求方法和请求头
            HttpURLConnection con = (HttpURLConnection) url.openConnection();

            // 设置请求方法为 POST(DeepSeek 聊天接口要求 POST)
            con.setRequestMethod("POST");

            // 设置请求头 Content-Type,告诉服务器请求体的格式是 JSON,并使用 UTF-8 编码
            // 注意:原代码中曾拼写成 appliaction/json,这里是正确写法
            con.setRequestProperty("Content-Type", "application/json; charset=UTF-8");

            // 设置认证请求头
            // DeepSeek 使用 Bearer Token 认证,格式为:Authorization: Bearer <API_KEY>
            // 注意 Bearer 与 Key 之间必须有一个空格
            con.setRequestProperty("Authorization", "Bearer " + API_KEY);

            // 允许向连接中写入数据(发送请求体)
            con.setDoOutput(true);
            // 允许从连接中读取数据(接收响应体)
            con.setDoInput(true);

            // ==================== 第三步:发送请求 ====================

            // 获取输出流,并使用 try-with-resources 确保流自动关闭
            try (OutputStream os = con.getOutputStream()) {
                // 将 JSON 对象转换为字符串,再按 UTF-8 编码为字节数组,写入输出流
                os.write(requestBody.toString().getBytes(StandardCharsets.UTF_8));
                // 刷新缓冲区,确保所有数据立即发送到服务器
                os.flush();
            }

            // ==================== 第四步:获取并读取响应 ====================

            // 获取 HTTP 响应状态码
            // 常见状态码:200:成功。401:认证失败。402:余额不足。429:请求过多。500:服务器错误
            int responseCode = con.getResponseCode();
            System.out.println("HTTP响应码为:" + responseCode);

            // 根据响应码选择输入流:
            // 如果状态码是 2xx,表示成功,使用 getInputStream() 读取正常响应体;
            // 否则使用 getErrorStream() 读取错误信息,避免抛出 IOException。
            InputStream inputStream = (responseCode >= 200 && responseCode < 300) ? con.getInputStream() : con.getErrorStream();

            // 使用 BufferedReader 按行读取响应内容,并拼接成完整的字符串
            StringBuilder responseSb = new StringBuilder();

            // try-with-resources 语法:括号内声明的资源会在 try 代码块结束后自动关闭,
            try (BufferedReader reader = new BufferedReader(
                    // InputStreamReader 的作用是将字节流转换为字符流。
                    // 第一个参数 inputStream 是原始的字节输入流,
                    // 第二个参数 StandardCharsets.UTF_8 指定使用 UTF-8 字符集解码字节,
                    // 这是为了正确读取中文等多字节字符,避免使用系统默认编码导致乱码。
                    new InputStreamReader(inputStream, StandardCharsets.UTF_8))) {

                // 声明一个字符串 line,用于临时存放每次读取到的一行文本
                String line;

                // 循环读取每一行,直到流末尾。

                while ((line = reader.readLine()) != null) {

                    // 将当前读取到的这一行内容追加到 StringBuilder 中。
                    // 注意:readLine() 已经去掉了行尾的换行符,所以拼接后的字符串不会保留换行。
                    // 对于 JSON 响应来说,这通常没有问题,因为 JSON 解析器不依赖换行符,
                    // 而且 JSON 字符串内部的换行会以转义形式 \n 存在,不会被 readLine() 切掉。
                    responseSb.append(line);
                }
            }


            // 得到完整的响应 JSON 字符串
            String responseBody = responseSb.toString();
            System.out.println("完整响应 JSON:");
            System.out.println(responseBody);

            // ==================== 第五步:解析 AI 回答 ====================

            // 仅当 HTTP 状态码为 200 时,才认为请求成功,进行 JSON 解析
            if (responseCode == 200) {
                // 使用 Hutool 的 JSONUtil 将响应字符串解析为 JSONObject
                JSONObject jsonResponse = JSONUtil.parseObj(responseBody);

                // 获取 choices 数组,DeepSeek 的响应结构与 OpenAI 一致
                // choices 是一个数组,通常只有一个元素,代表模型生成的一个回复
                JSONArray choices = jsonResponse.getJSONArray("choices");

                if (choices != null && !choices.isEmpty()) {
                    // 取出第一个 choice 对象
                    JSONObject firstChoice = choices.getJSONObject(0);
                    // 从 choice 中获取 message 对象
                    JSONObject message = firstChoice.getJSONObject("message");
                    // 从 message 中获取 content 字段,即 AI 生成的文本
                    String content = message.getStr("content");
                    System.out.println("\n=== AI 回答 ===");
                    System.out.println(content);
                } else {
                    // 如果 choices 为空,说明响应结构异常
                    System.out.println("未找到 choices 字段");
                }
            } else {
                // 非 200 响应,提示用户检查 API Key 或余额
                System.out.println("请求失败,请检查 API Key 或余额。");
            }

        } catch (Exception e) {
            // 捕获所有异常并打印,便于调试
            System.out.println("异常信息:" + e);
            e.printStackTrace();
        }
    }
}
对接DeepSeek API生成Excel数据表
java
package com.sin;

import cn.hutool.json.JSONArray;
import cn.hutool.json.JSONObject;
import cn.hutool.json.JSONUtil;
import org.apache.poi.ss.usermodel.*;
import org.apache.poi.xssf.usermodel.XSSFWorkbook;

import java.io.*;
import java.net.HttpURLConnection;
import java.net.URL;
import java.nio.charset.StandardCharsets;

/**
 * @createTime 2026/9/17 8:37
 * @createAuthor SIN
 * @use 对接DeepSeek API 生成Excel表
 */
public class DemoModel2 {


    // ==================== 常量定义 ==================== //

    // 1. API Key(DeepSeek 的 key 以 sk- 开头)
    private static final String API_KEY = "sk-360a513df*************af38c53";

    // 2. DeepSeek API 地址(聊天补全接口,与 OpenAI 格式兼容)
    private static final String API_URL = "https://api.deepseek.com/chat/completions";

    // 3. 生成的 Excel 文件路径(相对项目根目录)
    private static final String EXCEL_PATH = "E:\\***\\***\\****\\AI生成的表格.xlsx";
    /**
     * 程序入口方法
     *
     * @param args 命令行参数(本示例未使用)
     */
    public static void main(String[] args) {
        try {

            // ==================== 第一步:构建请求体 JSON ====================

            // 创建最外层的 JSON 对象,用于承载整个请求体
            JSONObject requestBody = new JSONObject();

            // 指定要调用的模型名称
            // deepseek-chat 是 DeepSeek 的通用对话模型
            // 如果需要推理模型,可以改为 deepseek-reasoner
            requestBody.put("model", "deepseek-chat");

            // 是否使用流式输出
            // false 表示一次性返回完整结果;true 表示以 SSE 流的方式逐块返回
            // 这里为了简化,设为 false,方便一次性读取完整 JSON
            requestBody.put("stream", false);

            // 低温度可以让模型输出更稳定、格式更可控,适合"要 JSON 不要废话"的场景
            requestBody.put("temperature", 0.2);

            // 构建 messages 数组,用于存放对话历史
            JSONArray messages = new JSONArray();

            // ---------- 系统消息:约束模型的角色与输出格式 ----------
            JSONObject systemMessage = new JSONObject();
            systemMessage.put("role", "system");
            systemMessage.put("content", // 开始设置 content 字段(一段规则文本)
                    "你是一个数据生成助手。你只能输出一个合法的 JSON 对象," // 规则第一段:限定角色和输出类型
                            + "禁止输出任何解释性文字、禁止使用 markdown 代码块(不要出现 ```)。"); // 规则第二段:禁止多余文字和 markdown 代码块
            messages.put(systemMessage);

            // ---------- 用户消息:明确要求生成表格数据 ----------
            JSONObject userMessage = new JSONObject();
            // 指定消息角色为 "user",表示这是用户发送的内容
            userMessage.put("role", "user");

            // 定义用户提问内容:要求返回固定结构的 JSON,方便程序直接解析成 Excel
            String question =
                    "请生成一份【2026年公司员工信息表】的数据,要求:\n"
                            + "1. 列包含:姓名、年龄、部门、职位、入职日期、月薪;\n"
                            + "2. 提供 20 条示例数据,内容合理、不重复;\n"
                            + "3. 严格按下面的 JSON 结构返回,不要添加任何其他字段和文字:\n"
                            + "{\n"
                            + "  \"sheetName\": \"员工信息表\",\n"
                            + "  \"headers\": [\"姓名\",\"年龄\",\"部门\",\"职位\",\"入职日期\",\"月薪\"],\n"
                            + "  \"rows\": [\n"
                            + "    [\"张三\", 28, \"研发部\", \"后端工程师\", \"2023-05-10\", 18000],\n"
                            + "    [\"李四\", 32, \"市场部\", \"市场经理\", \"2021-08-01\", 22000]\n"
                            + "  ]\n"
                            + "}";

            System.out.println("用户向大模型提出的问题是:\n" + question); // 打印用户提问,方便观察程序运行过程

            // 将问题文本放入 content 字段
            userMessage.put("content", question);

            // 将这条用户消息添加到 messages 数组中
            messages.put(userMessage);
            // 将 messages 数组放入最外层的请求体对象中
            requestBody.put("messages", messages);

            // 此时 requestBody 的结构大致为:
            // {
            //   "model": "deepseek-chat",       // 模型字段
            //   "stream": false,                // 非流式
            //   "temperature": 0.2,             // 温度
            //   "messages": [                   // 消息数组
            //     { "role": "system", "content": "..." }, // 系统消息
            //     { "role": "user",   "content": "..." }  // 用户消息
            //   ]                                // 消息数组结束
            // }                                  // 结构右花括号

            // ==================== 第二步:建立 HTTP 连接 ====================

            // 根据 API 地址创建 URL 对象
            URL url = new URL(API_URL);
            // 打开连接,并强制转换为 HttpURLConnection,以便设置请求方法和请求头
            HttpURLConnection con = (HttpURLConnection) url.openConnection();

            // 设置请求方法为 POST(DeepSeek 聊天接口要求 POST)
            con.setRequestMethod("POST");

            // 设置请求头 Content-Type,告诉服务器请求体的格式是 JSON,并使用 UTF-8 编码
            con.setRequestProperty("Content-Type", "application/json; charset=UTF-8");

            // 设置认证请求头
            // DeepSeek 使用 Bearer Token 认证,格式为:Authorization: Bearer <API_KEY>
            // 注意 Bearer 与 Key 之间必须有一个空格
            con.setRequestProperty("Authorization", "Bearer " + API_KEY);

            // 允许向连接中写入数据(发送请求体)
            con.setDoOutput(true);
            // 允许从连接中读取数据(接收响应体)
            con.setDoInput(true);

            // ==================== 第三步:发送请求 ====================

            // 获取输出流,并使用 try-with-resources 确保流自动关闭
            try (OutputStream os = con.getOutputStream()) {
                // 将 JSON 对象转换为字符串,再按 UTF-8 编码为字节数组,写入输出流
                os.write(requestBody.toString().getBytes(StandardCharsets.UTF_8));
                // 刷新缓冲区,确保所有数据立即发送到服务器
                os.flush();
            }

            // ==================== 第四步:获取并读取响应 ====================

            // 获取 HTTP 响应状态码 作用
            // 常见状态码:200:成功。401:认证失败。402:余额不足。429:请求过多。500:服务器错误
            int responseCode = con.getResponseCode();
            System.out.println("HTTP响应码为:" + responseCode);

            // 根据响应码选择输入流:
            // 如果状态码是 2xx,表示成功,使用 getInputStream() 读取正常响应体;
            // 否则使用 getErrorStream() 读取错误信息,避免抛出 IOException。
            InputStream inputStream = (responseCode >= 200 && responseCode < 300)
                    ? con.getInputStream()
                    : con.getErrorStream();

            // 使用 BufferedReader 按行读取响应内容,并拼接成完整的字符串
            StringBuilder responseSb = new StringBuilder();

            // try-with-resources 语法:括号内声明的资源会在 try 代码块结束后自动关闭
            try (BufferedReader reader = new BufferedReader(
                    // InputStreamReader 的作用是将字节流转换为字符流。
                    // 第二个参数 StandardCharsets.UTF_8 指定使用 UTF-8 字符集解码字节,
                    // 这是为了正确读取中文等多字节字符,避免使用系统默认编码导致乱码。
                    new InputStreamReader(inputStream, StandardCharsets.UTF_8))) {

                // 声明一个字符串 line,用于临时存放每次读取到的一行文本
                String line;

                // 循环读取每一行,直到流末尾
                while ((line = reader.readLine()) != null) {
                    // 将当前读取到的这一行内容追加到 StringBuilder 中
                    responseSb.append(line);
                }
            }

            // 得到完整的响应 JSON 字符串
            String responseBody = responseSb.toString();
            System.out.println("完整响应 JSON:");
            System.out.println(responseBody);
            // ==================== 第五步:解析 AI 回答 ====================

            // 仅当 HTTP 状态码为 200 时,才认为请求成功,进行 JSON 解析
            if (responseCode != 200) { // 如果响应码不是 200
                System.out.println("请求失败,请检查 API Key 或余额。");
                return;
            }

            // 使用 Hutool 的 JSONUtil 将响应字符串解析为 JSONObject
            JSONObject jsonResponse = JSONUtil.parseObj(responseBody);

            // 获取 choices 数组,DeepSeek 的响应结构与 OpenAI 一致
            JSONArray choices = jsonResponse.getJSONArray("choices");
            if (choices == null || choices.isEmpty()) {
                System.out.println("未找到 choices 字段");
                return;
            }

            // 取出第一个 choice → message → content,即 AI 生成的文本
            JSONObject firstChoice = choices.getJSONObject(0); // 取 choices 的第一个元素(下标 0)
            JSONObject message = firstChoice.getJSONObject("message"); // 从 choice 中取出 message 对象
            String content = message.getStr("content"); // 从 message 中取出 content 字符串,即 AI 生成的文本

            System.out.println("\n=== AI 返回的内容 ===");
            System.out.println(content);

            // ==================== 第六步:把 AI 返回的 JSON 转成 Excel ====================

            // 模型偶尔会画蛇添足地包一层 ```json ... ```,这里先做一次清洗
            String tableJsonText = clearJson(content); // 调用 cleanJson 方法,得到纯 JSON 字符串

            // 解析成表格结构对象
            JSONObject tableData = JSONUtil.parseObj(tableJsonText); // 把纯 JSON 字符串解析成 JSONObject

            // 工作表名称(做一次合法性兜底)
            String sheetName = safeSheetName(tableData.getStr("sheetName", "Sheet1")); // 取 sheetName,缺省为 Sheet1,再走一遍合法性处理

            // 表头数组,例如 ["姓名","年龄","部门","职位","入职日期","月薪"]
            JSONArray headers = tableData.getJSONArray("headers"); // 从 tableData 中取出 headers 数组

            // 数据行数组,例如 [["张三",28,...], ["李四",32,...]]
            JSONArray rows = tableData.getJSONArray("rows"); // 从 tableData 中取出 rows 数组

            if (headers == null || headers.isEmpty()) { // 如果 headers 为 null 或空
                System.out.println("AI 返回的数据中缺少 headers 字段,无法生成 Excel。"); // 打印提示
                return; // 结束 main 方法
            } // if 结束

            // 写出 .xlsx 文件
            writeExcel(EXCEL_PATH, sheetName, headers, rows); // 调用 writeExcel 方法把数据写成 Excel 文件

            System.out.println("\n=== Excel 生成完成 ===");
            System.out.println("文件位置:" + new java.io.File(EXCEL_PATH).getAbsolutePath()); // 打印文件的绝对路径

        } catch (Exception e) { // 捕获 try 块中可能抛出的所有异常
            // 捕获所有异常并打印,便于调试
            System.out.println("异常信息:" + e); // 打印异常对象信息
            e.printStackTrace(); // 打印异常调用栈,便于定位问题
        } // catch 结束
    } // main 方法结束

    /**
     * 把 AI 返回的文本清洗成纯 JSON 字符串。
     * 处理两种常见"污染":
     * 1. 被 markdown 代码块包裹:```json ... ```
     * 2. 前后带有多余的解释性文字
     *
     * @param content AI 返回的原始文本
     * @return 纯 JSON 字符串
     */
    private static String clearJson(String content) {
        // 如果原始文本数据为空则返回空字符串,避免后续空指针
        if (content == null) {
            return "";
        }
        // 去掉首尾空白字符(空格,换行,制表符等),
        String text = content.trim();

        // 去掉开头的```json```
        if (text.startsWith("```")) {
            // 找到第一个换行符的位置
            int firstLineEnd = text.indexOf('\n');
            // 如果有换行符
            if (firstLineEnd > 0) {
                // firstLineEnd(换行符在哪个索引位置) + 1  (后面索引位置的数据)
                // substring (截取字符串(后一个元素)赋值给当前text从而弥补空缺)
                text = text.substring(firstLineEnd + 1);
            }
        }
        // 去掉结尾的```
        if (text.endsWith("```")) {
            // 去掉结尾的三个```然后重新赋值给text
            text = text.substring(0, text.length() - 3);
        }
        // 兜底操作,截取第一个{和最后}之间的内容
        // 找到第一个{的索引位置
        int start = text.indexOf('{');
        // 找到最后一个}的索引位置
        int end = text.lastIndexOf('}');
        // 如果两者之间顺序正确
        if (start >= 0 && end > start){
            // 截取两者之间的内容
            text = text.substring(start,end + 1);
        }

        // 再次去除掉首位的空白并返回
        return text.trim();
    }


    /**
     * 保证Excel表名称合法性: 不能超过31个字符,且不含Excel的禁止字符:\/?* []
     *
     * @param raw 原始的名称
     * @return 合法的Excel表名称
     */
    private static String safeSheetName(String raw) {
        // 判断参数是否为空
        if (raw == null || raw.trim().isEmpty()) {
            // 返回默认的名称
            return "Sheet1";
        }
        // 去除首尾空格,并把Excel禁止字符替换成下划线
        String name = raw.trim().replaceAll("[:\\\\/?*\\[\\]]", "_");
        // 如果文件名称长超过31个进行截取,否则返回原名称
        return name.length() > 31 ? name.substring(0, 31) : name;
    }

    /**
     * 根据表头与数据行生成 .xlsx 文件
     *
     * @param filePath  输出文件路径
     * @param sheetName 工作表名称
     * @param headers   表头数组(JSONArray,元素为字符串)
     * @param rows      数据行数组(JSONArray,元素为 JSONArray)
     * @throws Exception 文件写入异常
     */
    private static void writeExcel(String filePath, String sheetName, // 定义私有静态方法 writeExcel,接收路径与表名
                                   JSONArray headers, JSONArray rows) throws Exception { // 继续接收表头与数据行,并声明可能抛异常

        // Workbook 代表一个 Excel 文件;XSSFWorkbook 对应 .xlsx 格式
        // 与 FileOutputStream 一起放在 try-with-resources 中,确保自动关闭、不占用文件句柄
        try (Workbook workbook = new XSSFWorkbook(); // 创建 XSSF 工作簿对象(内存中的 Excel)
             FileOutputStream fos = new FileOutputStream(filePath)) { // 创建文件输出流,指向目标 .xlsx 路径

            // 创建一个工作表
            Sheet sheet = workbook.createSheet(sheetName); // 在工作簿中按名称创建一张工作表

            // ---------- 表头样式:加粗 + 居中 ----------
            CellStyle headerStyle = workbook.createCellStyle(); // 创建单元格样式对象
            Font headerFont = workbook.createFont(); // 创建字体对象
            headerFont.setBold(true);          // 设置字体为加粗
            headerStyle.setFont(headerFont); // 把字体应用到样式上
            headerStyle.setAlignment(HorizontalAlignment.CENTER); // 设置水平对齐方式为居中

            // ---------- 写表头(第 0 行) ----------
            int rowIndex = 0; // 声明行号计数器,从 0 开始
            Row headerRow = sheet.createRow(rowIndex++); // 在工作表中创建第 0 行,并把 rowIndex 自增到 1
            for (int i = 0; i < headers.size(); i++) { // 遍历表头数组的每个下标
                Cell cell = headerRow.createCell(i); // 在表头行中第 i 列创建单元格
                cell.setCellValue(headers.getStr(i)); // 把表头第 i 个字符串写入单元格
                cell.setCellStyle(headerStyle); // 为表头单元格应用加粗居中样式
            } // for 循环结束

            // ---------- 写数据行 ----------
            if (rows != null) { // 如果 rows 不为 null
                for (Object rowObj : rows) { // 遍历 rows 中的每个元素
                    // Hutool 迭代 JSONArray 时元素是 Object,需要转回 JSONArray
                    JSONArray rowArray = (JSONArray) rowObj; // 把当前元素强转为 JSONArray
                    Row row = sheet.createRow(rowIndex++); // 创建新的一行,并把行号自增

                    for (int i = 0; i < rowArray.size(); i++) { // 遍历当前行的每个单元格数据
                        Object value = rowArray.get(i); // 取出第 i 个数据(可能是字符串、数字等)
                        Cell cell = row.createCell(i); // 在当前行第 i 列创建单元格

                        // 数值类型写成真正的数字,这样 Excel 里可以直接求和/排序;
                        // 其它类型(字符串、日期、null)统一按文本写入
                        if (value instanceof Number) { // 如果值是 Number 及其子类
                            cell.setCellValue(((Number) value).doubleValue()); // 用 double 形式写入,保证在 Excel 中是数值
                        } else {
                            cell.setCellValue(value == null ? "" : value.toString()); // null 写空串,其余写字符串
                        }
                    }
                }
            }

            // ---------- 自动列宽 ----------
            for (int i = 0; i < headers.size(); i++) {
                sheet.autoSizeColumn(i); // 根据内容自动调整第 i 列宽度
                // autoSizeColumn 对中文支持一般,这里额外留出一点宽度,避免文字被截断
                sheet.setColumnWidth(i, sheet.getColumnWidth(i) + 1024); // 在原宽度基础上再加 1024 单位
            } // for 结束

            // 把内存中的工作簿写入文件流
            workbook.write(fos); // 把工作簿内容写出到文件输出流
        }
    }
}
对接DeepSeek API创建数据库,数据表,数据
java
package com.sin;

import cn.hutool.json.JSONArray;
import cn.hutool.json.JSONObject;
import cn.hutool.json.JSONUtil;

import java.io.*;
import java.net.HttpURLConnection;
import java.net.URL;
import java.nio.charset.StandardCharsets;
import java.sql.*;

/**
 * @createTime 2026/9/17 8:37
 * @createAuthor SIN
 * @use 对接 DeepSeek API,把数据库连接信息告诉 AI,让 AI 生成 SQL,程序连数据库执行并展示结果
 */
public class DemoModel3 {

    // ==================== 常量定义 ====================

    // DeepSeek 的 API Key(生产环境请用环境变量,不要硬编码)
    private static final String API_KEY = "sk-360a513df*************af38c53";

    // DeepSeek 聊天补全接口地址 // 说明该常量的用途
    private static final String API_URL = "https://api.deepseek.com/chat/completions";

    // ---------- 数据库基础信息(改这里,提示词和连接串会同步变) ---------- // 分节说明下面这组常量
    private static final String DB_HOST = "localhost"; // 数据库主机地址,本机用 localhost
    private static final String DB_PORT = "3306";      // 数据库端口,MySQL 默认 3306
    private static final String DB_NAME = "employee_db3"; // 要操作的数据库名
    private static final String DB_USER = "root";      // 数据库用户名
    private static final String DB_PWD = "123456";    // 数据库密码

    // 程序连接用 JDBC URL:由上面的基础信息拼出来
    private static final String JDBC_URL = // 私有静态常量:完整 JDBC 连接串
            "jdbc:mysql://" + DB_HOST + ":" + DB_PORT + "/" + DB_NAME // 协议 + 主机 + 端口 + 库名
                    + "?useSSL=false&serverTimezone=Asia/Shanghai"    // 关 SSL,指定东八区时区,避免时区报错
                    + "&allowPublicKeyRetrieval=true&characterEncoding=UTF-8" // MySQL8 允许公钥检索,字符集 UTF-8
                    + "&user=" + DB_USER + "&password=" + DB_PWD;    // 拼上用户名与密码(URL 参数形式)

    public static void main(String[] args) { // 程序入口方法:public 外部可访问,static 无需实例化,void 无返回值
        try { // 开始 try 块,捕获可能出现的各种异常

            // ==================== 第一步:构建请求体 ====================

            JSONObject requestBody = new JSONObject(); // 最外层请求体对象,承载整个请求数据
            requestBody.put("model", "deepseek-chat");  // 指定调用的模型为 deepseek-chat(通用对话模型)
            requestBody.put("stream", false);           // 关闭流式输出,一次拿完整 JSON
            requestBody.put("temperature", 0.2);        // 低温度,让模型输出格式更稳定、更可控

            JSONArray messages = new JSONArray(); // 消息数组,用于承载对话历史(system + user)

            // 系统消息:约束模型只输出 SQL // 分节注释
            JSONObject systemMessage = new JSONObject(); // 创建一个 JSONObject 表示系统消息
            systemMessage.put("role", "system"); // 该消息角色设为 system,用于设定模型行为规则
            systemMessage.put("content", // 开始设置 content 字段(一段规则文本)
                    "你是一个数据库脚本生成助手。只输出可执行的 MySQL 5 的 SQL 语句," // 规则第一段:限定角色和输出类型
                            + "每条语句以分号结尾,禁止输出任何解释文字,禁止使用 markdown 代码块。"); // 规则第二段:禁止多余文字
            messages.put(systemMessage); // 把系统消息加入 messages 数组

            // 用户消息:把数据库连接信息写进 content,让 AI 知道要操作哪个库
            JSONObject userMessage = new JSONObject(); // 创建一个 JSONObject 表示用户消息
            userMessage.put("role", "user"); // 该消息角色设为 user,表示这是用户发送的内容

            String question = // 声明并开始拼接字符串 question(要发给 AI 的提示词)
                    "数据库连接信息如下:\n" // 第一段:开头标题,\n 是换行
                            + "- 主机:" + DB_HOST + "\n"   // 拼接主机信息
                            + "- 端口:" + DB_PORT + "\n"   // 拼接端口信息
                            + "- 数据库名:" + DB_NAME + "\n" // 拼接库名信息
                            + "- 用户名:" + DB_USER + "\n" // 拼接用户名信息
                            + "- 密码:" + DB_PWD + "\n"    // 拼接密码信息
                            + "\n"                          // 空行,用于排版
                            + "请基于以上连接信息,生成一份员工管理系统的初始化 SQL,要求:\n" // 任务描述
                            + "1. 在 " + DB_NAME + " 库中创建员工表 employee4,字段:" // 要求 1:建表(注意表名是 employee4)
                            + "id(INT 主键 自增)、name、age、department、position、hire_date、salary;\n" // 字段列表
                            + "2. 插入 20 条示例数据;\n" // 要求 2:插入数据
                            + "3. 最后查询所有员工并按 id 升序。\n" // 要求 3:查询
                            + "只输出 SQL 语句,不要解释。"; // 收尾:再次强调只输出 SQL

            System.out.println("提问:\n" + question); // 打印用户提问,方便观察程序运行过程

            userMessage.put("content", question); // 把拼接好的 question 写入用户消息的 content 字段
            messages.put(userMessage);            // 把 userMessage 加入 messages 数组
            requestBody.put("messages", messages); // 把 messages 数组挂到最外层请求体的 messages 字段

            // ==================== 第二步:发 HTTP 请求 ====================

            URL url = new URL(API_URL); // 用接口地址字符串构造 URL 对象
            HttpURLConnection con = (HttpURLConnection) url.openConnection(); // 打开连接并强转为 HttpURLConnection

            con.setRequestMethod("POST"); // 设置请求方法为 POST
            con.setRequestProperty("Content-Type", "application/json; charset=UTF-8"); // 声明请求体是 JSON,UTF-8
            con.setRequestProperty("Authorization", "Bearer " + API_KEY); // 设置认证头:Bearer + 空格 + Key
            con.setDoOutput(true); // 允许向连接写入数据(发送请求体)
            con.setDoInput(true);  // 允许从连接读取数据(接收响应体)

            // 写出请求体
            try (OutputStream os = con.getOutputStream()) { // 获取输出流,try-with-resources 自动 close
                os.write(requestBody.toString().getBytes(StandardCharsets.UTF_8)); // 请求体 JSON 字符串按 UTF-8 编码后写出
                os.flush(); // 刷新缓冲区,立即发送
            }

            // ==================== 第三步:读响应 ====================

            int responseCode = con.getResponseCode(); // 读取 HTTP 响应状态码
            System.out.println("HTTP响应码:" + responseCode); // 打印状态码

            InputStream inputStream = (responseCode >= 200 && responseCode < 300) // 三元表达式判断是否 2xx
                    ? con.getInputStream()  // 是 2xx:用正常输入流
                    : con.getErrorStream(); // 否则:用错误输入流,避免抛 IOException

            StringBuilder responseSb = new StringBuilder(); // 创建 StringBuilder,用于高效拼接字符串
            try (BufferedReader reader = new BufferedReader( // 用 BufferedReader 包装字符流,逐行读取
                    new InputStreamReader(inputStream, StandardCharsets.UTF_8))) { // 用 UTF-8 把字节流解码成字符流
                String line; // 声明局部变量 line,暂存每行文本
                while ((line = reader.readLine()) != null) { // 读取一行,返回 null 表示流末尾
                    responseSb.append(line); // 把当前行追加到 StringBuilder
                }
            }
            String responseBody = responseSb.toString(); // 把 StringBuilder 转成普通字符串

            if (responseCode != 200) { // 如果不是 200
                System.out.println("请求失败:" + responseBody); // 打印失败响应体
                return;
            }

            // ==================== 第四步:取出 AI 返回的 SQL 文本 ====================

            JSONObject jsonResponse = JSONUtil.parseObj(responseBody); // 把响应字符串解析成 JSON 对象
            JSONArray choices = jsonResponse.getJSONArray("choices"); // 从响应中取出 choices 数组
            if (choices == null || choices.isEmpty()) { // 如果 choices 为空或 null
                System.out.println("未找到 choices 字段"); // 打印提示
                return;
            }

            // choices[0] → message → content // 说明下面这组链式调用
            String content = choices.getJSONObject(0) // 取 choices 第一个元素
                    .getJSONObject("message")         // 从 choice 中取 message
                    .getStr("content");               // 从 message 中取 content 字符串(AI 生成的 SQL)

            System.out.println("\n=== AI 返回的 SQL ==="); // 打印分隔标题
            System.out.println(content); // 打印 AI 返回的原始 SQL 文本

            // 清洗掉可能出现的 markdown 代码块 ```sql ... ```
            String sqlText = clearMarkdown(content); // 调用 clearMarkdown 方法,得到纯 SQL 文本

            // ==================== 第五步:执行 SQL ====================

            executeSql(sqlText); // 调用 executeSql 方法执行 SQL

            System.out.println("\n=== 全部完成 ==="); // 打印完成标题

        } catch (Exception e) { // 捕获 try 块中可能抛出的所有异常
            System.out.println("异常信息:" + e); // 打印异常对象信息
            e.printStackTrace(); // 打印异常调用栈,便于定位问题
        }
    }

    /**
     * 去掉 AI 可能带上的 markdown 代码块包裹。
     *
     * @param content AI 返回的原始文本
     * @return 纯 SQL 文本
     */
    private static String clearMarkdown(String content) { // 定义私有静态方法 clearMarkdown
        if (content == null) return ""; // 如果入参为 null,返回空串,避免空指针
        String text = content.trim(); // 去掉首尾空白字符,赋给 text

        // 去掉开头的 ```或 ```sql
        if (text.startsWith("```")) { // 如果 text 以三个反引号开头
            int firstLineEnd = text.indexOf('\n'); // 找到第一个换行符的位置
            if (firstLineEnd > 0) { // 如果存在换行符
                text = text.substring(firstLineEnd + 1); // 截掉第一行(即 ```或 ```sql),保留后续内容
            } // 内层 if 结束
        } // 外层 if 结束
        // 去掉结尾的 ```
        if (text.endsWith("```")) { // 如果 text 以三个反引号结尾
            text = text.substring(0, text.length() - 3); // 去掉末尾三个反引号
        }
        return text.trim(); // 再次去除首尾空白并返回
    }

    /**
     * 连接到数据库,把 AI 生成的 SQL 按分号拆开,逐条执行。
     * 查询语句会把结果打印出来。 // 补充说明
     *
     * @param sqlText AI 返回的纯 SQL 文本
     * @throws Exception JDBC 异常
     */
    private static void executeSql(String sqlText) throws Exception {

        // 把 JDBC_URL 里的 "/employee_db3" 换掉,得到不带库名的服务器 URL
        String serverUrl = JDBC_URL.replace("/" + DB_NAME, "/");

        try (Connection conn = DriverManager.getConnection(serverUrl);
             Statement stmt = conn.createStatement()) {

            String createDbSql = "CREATE DATABASE IF NOT EXISTS `" + DB_NAME
                    + "` DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci";
            System.out.println("\n[建库] " + createDbSql);
            stmt.executeUpdate(createDbSql);
            System.out.println("数据库已就绪:" + DB_NAME);
        }


        // ---------- 第二步:连到刚建的库,逐条执行 AI 生成的 SQL ----------
        try (Connection conn = DriverManager.getConnection(JDBC_URL);
             Statement stmt = conn.createStatement()) {

            String[] statements = sqlText.split(";");

            for (String raw : statements) {
                String sql = raw.trim();
                if (sql.isEmpty()) continue;

                String upper = sql.toUpperCase();

                // 跳过 USE / CREATE DATABASE(程序已处理)
                if (upper.startsWith("USE ") || upper.startsWith("CREATE DATABASE")) {
                    System.out.println("[跳过] " + sql);
                    continue;
                }

                System.out.println("\n[执行] " + sql);

                if (upper.startsWith("SELECT")) {
                    try (ResultSet rs = stmt.executeQuery(sql)) {
                        printResultSet(rs);
                    }
                } else {
                    int affected = stmt.executeUpdate(sql);
                    System.out.println("影响行数:" + affected);
                }
            }
        }
    }

    /**
     * 把 ResultSet 打印成「表头 + 数据行」的简单表格。
     *
     * @param rs JDBC 查询结果集
     * @throws SQLException 读取元数据或数据时可能抛出
     */
    private static void printResultSet(ResultSet rs) throws SQLException { // 定义私有静态方法 printResultSet
        ResultSetMetaData meta = rs.getMetaData(); // 获取结果集的元数据(列名、列数、类型等)
        int colCount = meta.getColumnCount(); // 取得列数

        // 打印表头
        StringBuilder header = new StringBuilder(); // 创建 StringBuilder 用于拼表头
        for (int i = 1; i <= colCount; i++) { // JDBC 列下标从 1 开始,遍历每一列
            header.append(meta.getColumnName(i)); // 追加第 i 列的列名
            if (i < colCount) header.append("\t"); // 如果不是最后一列,追加制表符
        } // for 结束
        System.out.println(header); // 打印表头行
        System.out.println("----------------------------------------");

        // 打印数据行
        int rowNo = 0; // 记录已打印行数
        while (rs.next()) { // 游标下移,返回 true 表示还有下一行
            StringBuilder row = new StringBuilder(); // 创建 StringBuilder 用于拼当前行
            for (int i = 1; i <= colCount; i++) { // 遍历每一列
                String v = rs.getString(i); // 以字符串形式读出第 i 列的值(null 会返回 null)
                row.append(v == null ? "NULL" : v); // null 显示为 NULL,其余直接追加
                if (i < colCount) row.append("\t"); // 不是最后一列则加制表符
            } // 内层 for 结束
            System.out.println(row); // 打印当前行
            rowNo++; // 行数自增
        }
        System.out.println("----------------------------------------");
        System.out.println("共 " + rowNo + " 行。"); // 打印总行数
    }
}
处理上传的文档
- .sql → 解析后直接执行 SQL
- .docx → 提取文本 → 让 AI 总结/改写/提取要点
- .pptx → 提取文本 → 让 AI 总结/生成大纲
- .xlsx → 提取数据 → 让 AI 分析
- .txt → 直接送给 AI
java
// 声明当前类所在的包,包名 com.sin 与目录结构 com/sin 对应,Java 要求目录结构与包名一致
package com.sin;
// 导入 Hutool 的 JSONArray 类,用于表示 JSON 数组(如 choices、messages)
import cn.hutool.json.JSONArray;
// 导入 Hutool 的 JSONObject 类,用于表示 JSON 对象(键值对结构)
import cn.hutool.json.JSONObject;
// 导入 Hutool 的 JSONUtil 工具类,提供 JSON 字符串与对象之间的相互转换
import cn.hutool.json.JSONUtil;
// 导入 POI 的 Cell 接口,表示 Excel 中的一个单元格
import org.apache.poi.ss.usermodel.Cell;
// 导入 POI 的 DateUtil 工具类,用于判断某个单元格是否被格式化为日期
import org.apache.poi.ss.usermodel.DateUtil;
// 导入 POI 的 Row 接口,表示 Excel 中的一行
import org.apache.poi.ss.usermodel.Row;
// 导入 POI 的 XMLSlideShow 类,用于读取 .pptx(Office 2007+)格式的 PPT 文件
import org.apache.poi.xslf.usermodel.XMLSlideShow;
// 导入 POI 的 XSLFShape 接口,表示 .pptx 幻灯片上的一个形状(文本、图片、图形等)
import org.apache.poi.xslf.usermodel.XSLFShape;
// 导入 POI 的 XSLFSlide 类,表示 .pptx 中的一页幻灯片
import org.apache.poi.xslf.usermodel.XSLFSlide;
// 导入 POI 的 XSLFTextShape 接口,表示 .pptx 中含有文本的形状
import org.apache.poi.xslf.usermodel.XSLFTextShape;
// 导入 POI 的 XSSFSheet 类,表示 .xlsx 工作簿中的一张工作表
import org.apache.poi.xssf.usermodel.XSSFSheet;
// 导入 POI 的 XSSFWorkbook 类,表示一个 .xlsx 工作簿文件
import org.apache.poi.xssf.usermodel.XSSFWorkbook;
// 导入 POI 的 XWPFDocument 类,表示一个 .docx Word 文档
import org.apache.poi.xwpf.usermodel.XWPFDocument;
// 导入 POI 的 XWPFParagraph 类,表示 .docx 文档中的一个段落
import org.apache.poi.xwpf.usermodel.XWPFParagraph;
// 导入 POI 的 XWPFTable 类,表示 .docx 文档中的一张表格
import org.apache.poi.xwpf.usermodel.XWPFTable;
// 导入 POI 的 XWPFTableCell 类,表示 .docx 表格中的一个单元格
import org.apache.poi.xwpf.usermodel.XWPFTableCell;
// 导入 POI 的 XWPFTableRow 类,表示 .docx 表格中的一行
import org.apache.poi.xwpf.usermodel.XWPFTableRow;
// 导入 POI 的 HSLFSlideShow 类,用于读取旧版 .ppt(Office 2003 及更早)格式的 PPT 文件
import org.apache.poi.hslf.usermodel.HSLFSlideShow;
// 导入 POI 的 HSLFSlide 类,表示旧版 .ppt 中的一页幻灯片
import org.apache.poi.hslf.usermodel.HSLFSlide;
// 导入 POI 的 HSLFShape 接口,表示旧版 .ppt 幻灯片上的一个形状
import org.apache.poi.hslf.usermodel.HSLFShape;
// 导入 POI 的 HSLFTextShape 接口,表示旧版 .ppt 中含有文本的形状
import org.apache.poi.hslf.usermodel.HSLFTextShape;
// 导入 java.io 包下的所有类,包括文件流、缓冲流、异常类等
import java.io.*;
// 导入 HttpURLConnection 类,用于发送 HTTP 请求并接收响应
import java.net.HttpURLConnection;
// 导入 URL 类,用于表示统一资源定位符,即 API 接口地址
import java.net.URL;
// 导入 StandardCharsets 类,提供 UTF-8 等标准字符集常量
import java.nio.charset.StandardCharsets;
// 导入 java.sql 包下的所有类,包括 Connection、Statement、ResultSet 等 JDBC 对象
import java.sql.*;
// 导入 Matcher 类,用于对字符串执行正则匹配并获取结果
import java.util.regex.Matcher;
// 导入 Pattern 类,用于编译正则表达式
import java.util.regex.Pattern;
// 定义一个公开类,类名必须与文件名 DemoModel4.java 一致
public class DemoModel4 {
// 定义私有静态常量,表示 DeepSeek 平台的 API 密钥,用于身份认证
private static final String API_KEY = "sk-360a513df21c49d1aef38cbfaaf38c53";
// 定义私有静态常量,表示 DeepSeek 聊天补全接口的完整 URL 地址
private static final String API_URL = "https://api.deepseek.com/chat/completions";
// 定义私有静态常量,表示 MySQL 数据库的主机地址
private static final String DB_HOST = "localhost";
// 定义私有静态常量,表示 MySQL 数据库的端口号
private static final String DB_PORT = "3306";
// 定义私有静态常量,表示 MySQL 数据库的用户名
private static final String DB_USER = "root";
// 定义私有静态常量,表示 MySQL 数据库的密码
private static final String DB_PWD = "123456";
// 定义私有静态常量,表示发送给 AI 的内容最大长度,防止 token 超出模型限制
private static final int MAX_CONTENT_LEN = 10000;
// 定义程序入口方法,JVM 启动时会调用此方法
public static void main(String[] args) {
// 使用 try-catch 包裹主流程,捕获可能出现的所有异常
try {
// 调用 pickFile 方法获取待处理文件的路径,args 是命令行参数
String filePath = pickFile(args);
// 如果返回的路径为 null,说明没有可用文件,直接结束程序
if (filePath == null) return;
// 根据文件路径创建 File 对象,用于后续操作
File file = new File(filePath);
// 在控制台打印该文件的绝对路径
System.out.println("📂 文件:" + file.getAbsolutePath());
// 在控制台打印该文件的字节大小
System.out.println("📏 大小:" + file.length() + " 字节");
// 获取文件扩展名并转为小写,便于后续判断类型
String ext = getExtension(file.getName()).toLowerCase();
// 在控制台打印文件扩展名
System.out.println("🔖 类型:." + ext);
// 在控制台打印一条分隔线,便于阅读
System.out.println("----------------------------------------");
// 使用 switch 语句根据扩展名分发到不同的处理方法
switch (ext) {
// 如果是 sql 文件,调用 handleSqlFile 方法执行 SQL 脚本
case "sql": handleSqlFile(file); break;
// 如果是 docx 文件,调用 handleDocxFile 方法提取并 AI 总结
case "docx": handleDocxFile(file); break;
// 如果是 pptx 文件,穿透到下面的 ppt 分支
case "pptx":
// 如果是 ppt 文件,调用 handlePptFile 方法提取并 AI 总结
case "ppt": handlePptFile(file); break;
// 如果是 xlsx 文件,调用 handleXlsxFile 方法提取并 AI 分析
case "xlsx": handleXlsxFile(file); break;
// 如果是 txt 文件,调用 handleTxtFile 方法交给 AI 总结
case "txt": handleTxtFile(file); break;
// 默认分支,处理不支持的文件类型
default:
// 在控制台打印不支持提示
System.out.println("❌ 暂不支持的文件类型:." + ext);
}
// 全部处理完毕后,在控制台打印完成信息
System.out.println("\n=== 全部完成 ===");
// 捕获 try 块中抛出的任何异常
} catch (Exception e) {
// 打印异常对象的简要信息
System.out.println("❌ 异常信息:" + e);
// 打印异常的完整堆栈信息,便于定位问题
e.printStackTrace();
}
}
// 定义私有静态方法 pickFile,用于确定要处理的文件路径,返回字符串
private static String pickFile(String[] args) {
// 声明局部变量 path,用三元表达式决定取值
String path = (args.length > 0)
// 如果命令行有参数,取第一个参数作为文件路径
? args[0]
// 否则使用下面这个固定的绝对路径作为默认值
: "E:\\志奇科技\\重庆青年职业技术学院\\人工智能技术应用\\smart_travel.sql";
// 根据路径字符串创建 File 对象
File f = new File(path);
// 判断该文件是否存在
if (!f.exists()) {
// 如果不存在,打印错误信息并附上绝对路径
System.out.println("❌ 文件不存在:" + f.getAbsolutePath());
// 返回 null 让上层终止流程
return null;
}
// 判断该路径是否指向一个普通文件
if (!f.isFile()) {
// 如果不是文件(例如是目录),打印错误信息
System.out.println("❌ 路径不是文件:" + f.getAbsolutePath());
// 返回 null 让上层终止流程
return null;
}
// 打印确认使用的文件路径
System.out.println("📥 使用文件:" + f.getAbsolutePath()
// 拼接文件大小信息,一并打印
+ "(" + f.length() + " 字节)");
// 返回最终确定的文件路径字符串
return path;
}
// 定义私有静态方法 handleSqlFile,处理 SQL 脚本文件
private static void handleSqlFile(File file) throws Exception {
// 读取文件内容,先清除 markdown 包裹,再得到纯 SQL 文本
String sqlText = clearMarkdown(readTextFile(file));
// 在控制台打印 SQL 脚本内容
System.out.println("📜 SQL 脚本内容:\n" + sqlText);
// 在控制台打印即将开始执行的提示
System.out.println("\n▶ 开始执行 SQL ...");
// 调用 executeSql 方法,真正连接数据库执行 SQL
executeSql(sqlText);
}
// 定义私有静态方法 handleDocxFile,处理 Word 文档
private static void handleDocxFile(File file) throws Exception {
// 调用 parseDocx 方法从 Word 中提取全部文本
String content = parseDocx(file);
// 在控制台打印提取到的文本长度
System.out.println("📄 Word 提取文本长度:" + content.length());
// 调用 askAI 方法,把文本发给 AI 总结
String summary = askAI(
// 系统提示:限定 AI 的角色与输出结构
"你是一个文档处理助手。请阅读用户提供的 Word 内容,输出:\n"
// 要求 1:输出总体概括
+ "1) 一段 100 字以内的总体概括;\n"
// 要求 2:输出核心要点
+ "2) 3-5 条核心要点(以列表形式)。",
// 用户内容:截断后传入,防止过长
truncate(content));
// 在控制台打印标题
System.out.println("\n=== 🤖 AI 对 Word 的总结 ===");
// 在控制台打印 AI 总结结果
System.out.println(summary);
}
// 定义私有静态方法 handlePptFile,处理 PPT 文件
private static void handlePptFile(File file) throws Exception {
// 调用 parsePpt 方法,内部根据扩展名选择 HSLF 或 XSLF
String content = parsePpt(file);
// 在控制台打印提取到的文本长度
System.out.println("📊 PPT 提取文本长度:" + content.length());
// 调用 askAI 方法,把 PPT 文本发给 AI 总结
String summary = askAI(
// 系统提示:限定 AI 的角色与输出结构
"你是一个 PPT 处理助手。请阅读用户提供的 PPT 内容(含页码标记),输出:\n"
// 要求 1:主题与核心观点
+ "1) 整个 PPT 的主题与核心观点;\n"
// 要求 2:按页要点
+ "2) 按页给出简要要点。",
// 用户内容:截断后传入
truncate(content));
// 在控制台打印标题
System.out.println("\n=== 🤖 AI 对 PPT 的总结 ===");
// 在控制台打印 AI 总结结果
System.out.println(summary);
}
// 定义私有静态方法 handleXlsxFile,处理 Excel 文件
private static void handleXlsxFile(File file) throws Exception {
// 调用 parseXlsx 方法提取所有工作表的单元格内容
String content = parseXlsx(file);
// 在控制台打印提取到的内容长度
System.out.println("📈 Excel 提取内容长度:" + content.length());
// 调用 askAI 方法,把 Excel 内容发给 AI 分析
String summary = askAI(
// 系统提示:限定 AI 的角色与输出结构
"你是一个数据分析助手。请阅读用户提供的 Excel 数据,输出:\n"
// 要求 1:数据整体说明
+ "1) 数据整体说明;\n"
// 要求 2:发现或建议
+ "2) 3-5 条发现或建议。",
// 用户内容:截断后传入
truncate(content));
// 在控制台打印标题
System.out.println("\n=== 🤖 AI 对 Excel 的分析 ===");
// 在控制台打印 AI 分析结果
System.out.println(summary);
}
// 定义私有静态方法 handleTxtFile,处理纯文本文件
private static void handleTxtFile(File file) throws Exception {
// 调用 readTextFile 方法读取整个文本内容
String content = readTextFile(file);
// 在控制台打印内容长度
System.out.println("📃 TXT 内容长度:" + content.length());
// 调用 askAI 方法,把文本发给 AI 总结
String summary = askAI(
// 系统提示:限定 AI 的输出结构
"你是一个文本处理助手。请阅读用户提供的文本,输出一段总结和 3-5 条要点。",
// 用户内容:截断后传入
truncate(content));
// 在控制台打印标题
System.out.println("\n=== 🤖 AI 总结 ===");
// 在控制台打印 AI 总结结果
System.out.println(summary);
}
// 定义私有静态方法 parseDocx,从 Word 文档中提取段落和表格文本
private static String parseDocx(File file) throws Exception {
// 创建 StringBuilder 用于拼接提取到的所有文本
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 打开 Word 文档,结束时自动关闭
try (XWPFDocument doc = new XWPFDocument(new FileInputStream(file))) {
// 遍历文档中的所有段落
for (XWPFParagraph p : doc.getParagraphs()) {
// 获取当前段落的纯文本内容
String text = p.getText();
// 如果文本不为 null 且去掉空白后不是空字符串
if (text != null && !text.trim().isEmpty()) {
// 把该段文本追加到 StringBuilder,并在末尾换行
sb.append(text).append("\n");
}
}
// 遍历文档中的所有表格
for (XWPFTable table : doc.getTables()) {
// 在表格开始处添加一个标记
sb.append("[表格]\n");
// 遍历表格中的每一行
for (XWPFTableRow row : table.getRows()) {
// 遍历该行中的每一个单元格
for (XWPFTableCell cell : row.getTableCells()) {
// 把单元格文本追加到 StringBuilder,并用制表符分隔
sb.append(cell.getText()).append("\t");
}
// 每行结束后追加换行
sb.append("\n");
}
}
}
// 返回拼接完成的字符串
return sb.toString();
}
// 定义私有静态方法 parsePpt,根据扩展名分发到 HSLF 或 XSLF 解析
private static String parsePpt(File file) throws Exception {
// 获取文件名并转为小写,便于判断后缀
String name = file.getName().toLowerCase();
// 用三元表达式:以 .pptx 结尾走 parsePptx,否则走 parsePptOld
return name.endsWith(".pptx") ? parsePptx(file) : parsePptOld(file);
}
// 定义私有静态方法 parsePptx,解析新版 .pptx 文件
private static String parsePptx(File file) throws Exception {
// 创建 StringBuilder 用于拼接提取到的所有文本
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 打开 .pptx 文件,结束时自动关闭
try (XMLSlideShow ppt = new XMLSlideShow(new FileInputStream(file))) {
// 定义页码计数器,从 1 开始
int i = 1;
// 遍历所有幻灯片
for (XSLFSlide slide : ppt.getSlides()) {
// 添加页码标记,并把计数器自增
sb.append("【第 ").append(i++).append(" 页】\n");
// 遍历该页上的所有形状
for (XSLFShape shape : slide.getShapes()) {
// 判断形状是否为文本形状
if (shape instanceof XSLFTextShape) {
// 把形状强转为文本形状并获取文本
String text = ((XSLFTextShape) shape).getText();
// 如果文本非空
if (text != null && !text.trim().isEmpty()) {
// 追加文本并换行
sb.append(text).append("\n");
}
}
}
// 每页结束后追加一个空行,便于阅读
sb.append("\n");
}
}
// 返回拼接完成的字符串
return sb.toString();
}
// 定义私有静态方法 parsePptOld,解析旧版 .ppt 文件
private static String parsePptOld(File file) throws Exception {
// 创建 StringBuilder 用于拼接提取到的所有文本
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 打开 .ppt 文件,结束时自动关闭
try (HSLFSlideShow ppt = new HSLFSlideShow(new FileInputStream(file))) {
// 定义页码计数器,从 1 开始
int i = 1;
// 遍历所有幻灯片
for (HSLFSlide slide : ppt.getSlides()) {
// 添加页码标记,并把计数器自增
sb.append("【第 ").append(i++).append(" 页】\n");
// 遍历该页上的所有形状
for (HSLFShape shape : slide.getShapes()) {
// 判断形状是否为文本形状
if (shape instanceof HSLFTextShape) {
// 把形状强转为文本形状并获取文本
String text = ((HSLFTextShape) shape).getText();
// 如果文本非空
if (text != null && !text.trim().isEmpty()) {
// 追加文本并换行
sb.append(text).append("\n");
}
}
}
// 每页结束后追加一个空行
sb.append("\n");
}
}
// 返回拼接完成的字符串
return sb.toString();
}
// 定义私有静态方法 parseXlsx,解析 Excel 文件
private static String parseXlsx(File file) throws Exception {
// 创建 StringBuilder 用于拼接提取到的所有文本
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 打开工作簿,结束时自动关闭
try (XSSFWorkbook wb = new XSSFWorkbook(new FileInputStream(file))) {
// 遍历工作簿中的每一张工作表
for (int s = 0; s < wb.getNumberOfSheets(); s++) {
// 根据索引获取工作表对象
XSSFSheet sheet = wb.getSheetAt(s);
// 添加工作表名标记
sb.append("【Sheet: ").append(sheet.getSheetName()).append("】\n");
// 遍历工作表中的每一行
for (Row row : sheet) {
// 遍历该行中的每一个单元格
for (Cell cell : row) {
// 调用 getCellValue 获取单元格文本值,用制表符分隔
sb.append(getCellValue(cell)).append("\t");
}
// 每行结束后换行
sb.append("\n");
}
// 每张表结束后追加一个空行
sb.append("\n");
}
}
// 返回拼接完成的字符串
return sb.toString();
}
// 定义私有静态方法 readTextFile,以 UTF-8 编码读取纯文本文件
private static String readTextFile(File file) throws Exception {
// 创建 StringBuilder 用于拼接读取到的所有行
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 打开文件,使用 BufferedReader 按行读取
try (BufferedReader reader = new BufferedReader(
// 用 InputStreamReader 把字节流按 UTF-8 解码为字符流
new InputStreamReader(new FileInputStream(file), StandardCharsets.UTF_8))) {
// 声明局部变量 line,用于暂存每行文本
String line;
// 循环读取每一行,直到返回 null 表示读到文件末尾
while ((line = reader.readLine()) != null) {
// 把当前行追加到 StringBuilder,并补充换行符
sb.append(line).append("\n");
}
}
// 返回拼接完成的字符串
return sb.toString();
}
// 定义私有静态方法 getCellValue,把 Excel 单元格转换为字符串
private static String getCellValue(Cell cell) {
// 如果单元格为 null,返回空字符串,避免空指针
if (cell == null) return "";
// 根据单元格的类型进行分支处理
switch (cell.getCellType()) {
// 字符串类型
case STRING:
// 返回单元格的字符串值
return cell.getStringCellValue();
// 数字类型
case NUMERIC:
// 先判断该单元格是否被格式化为日期
if (DateUtil.isCellDateFormatted(cell)) {
// 按日期格式返回其本地日期的字符串形式
return cell.getLocalDateTimeCellValue().toLocalDate().toString();
}
// 不是日期则按数值返回
return String.valueOf(cell.getNumericCellValue());
// 布尔类型
case BOOLEAN:
// 返回布尔值的字符串形式
return String.valueOf(cell.getBooleanCellValue());
// 公式类型
case FORMULA:
// 返回单元格中的公式文本
return cell.getCellFormula();
// 其他类型(如空白、错误)
default:
// 返回空字符串
return "";
}
}
// 定义私有静态方法 getExtension,用于获取文件扩展名
private static String getExtension(String fileName) {
// 找到文件名中最后一个点的索引
int dot = fileName.lastIndexOf('.');
// 如果没有点则返回空串,否则返回点后面的部分
return dot < 0 ? "" : fileName.substring(dot + 1);
}
// 定义私有静态方法 truncate,用于截断过长内容
private static String truncate(String content) {
// 如果内容为 null,返回空字符串
if (content == null) return "";
// 用三元表达式判断是否超长
return content.length() <= MAX_CONTENT_LEN
// 未超长则原样返回
? content
// 超长则截取前 MAX_CONTENT_LEN 个字符,并附加提示
: content.substring(0, MAX_CONTENT_LEN) + "\n...(内容过长,已截断)";
}
// 定义私有静态方法 clearMarkdown,去除 AI 返回文本中可能存在的 markdown 代码块包裹
private static String clearMarkdown(String content) {
// 如果内容为 null,返回空字符串
if (content == null) return "";
// 去除首尾空白,并赋给局部变量 text
String text = content.trim();
// 如果以三个反引号开头
if (text.startsWith("```")) {
// 找到第一个换行符的位置
int firstLineEnd = text.indexOf('\n');
// 如果找到换行符,去掉第一行
if (firstLineEnd > 0) text = text.substring(firstLineEnd + 1);
}
// 如果以三个反引号结尾
if (text.endsWith("```")) {
// 去掉末尾三个反引号
text = text.substring(0, text.length() - 3);
}
// 再次去除首尾空白并返回
return text.trim();
}
// 定义私有静态方法 askAI,用于向 DeepSeek 发送对话请求并返回回答文本
private static String askAI(String systemPrompt, String userPrompt) throws Exception {
// 创建最外层请求体 JSON 对象
JSONObject requestBody = new JSONObject();
// 指定调用的模型名称
requestBody.put("model", "deepseek-chat");
// 关闭流式输出,一次性返回完整结果
requestBody.put("stream", false);
// 设置温度为 0.3,让结果相对稳定
requestBody.put("temperature", 0.3);
// 创建 messages 数组,用于承载对话历史
JSONArray messages = new JSONArray();
// 创建系统消息对象
JSONObject sys = new JSONObject();
// 设置系统消息角色为 system
sys.put("role", "system");
// 设置系统消息内容为传入的 systemPrompt
sys.put("content", systemPrompt);
// 把系统消息加入 messages 数组
messages.put(sys);
// 创建用户消息对象
JSONObject user = new JSONObject();
// 设置用户消息角色为 user
user.put("role", "user");
// 设置用户消息内容为传入的 userPrompt
user.put("content", userPrompt);
// 把用户消息加入 messages 数组
messages.put(user);
// 把 messages 数组放入请求体的 messages 字段
requestBody.put("messages", messages);
// 用接口地址字符串构造 URL 对象
URL url = new URL(API_URL);
// 打开连接并强转为 HttpURLConnection
HttpURLConnection con = (HttpURLConnection) url.openConnection();
// 设置请求方法为 POST
con.setRequestMethod("POST");
// 声明请求体为 JSON,编码 UTF-8
con.setRequestProperty("Content-Type", "application/json; charset=UTF-8");
// 设置认证头,Bearer 与 Key 之间必须有空格
con.setRequestProperty("Authorization", "Bearer " + API_KEY);
// 允许向连接写出数据
con.setDoOutput(true);
// 允许从连接读取数据
con.setDoInput(true);
// 用 try-with-resources 获取输出流,结束时自动关闭
try (OutputStream os = con.getOutputStream()) {
// 把请求体字符串按 UTF-8 编码后写出
os.write(requestBody.toString().getBytes(StandardCharsets.UTF_8));
// 刷新缓冲区,确保数据立即发送
os.flush();
}
// 获取 HTTP 响应状态码
int code = con.getResponseCode();
// 根据响应码选择正常输入流或错误输入流
InputStream is = (code >= 200 && code < 300)
// 2xx 使用正常输入流
? con.getInputStream()
// 否则使用错误输入流
: con.getErrorStream();
// 创建 StringBuilder 用于拼接响应内容
StringBuilder sb = new StringBuilder();
// 用 try-with-resources 逐行读取响应
try (BufferedReader reader = new BufferedReader(
// 使用 UTF-8 解码字节流
new InputStreamReader(is, StandardCharsets.UTF_8))) {
// 声明局部变量 line
String line;
// 循环读取每一行直到流末尾
while ((line = reader.readLine()) != null) sb.append(line);
}
// 如果响应码不是 200,抛出异常
if (code != 200) {
// 抛出包含状态码与响应体的 RuntimeException
throw new RuntimeException("AI 请求失败 HTTP " + code + ":" + sb);
}
// 把响应字符串解析为 JSON 对象
JSONObject resp = JSONUtil.parseObj(sb.toString());
// 依次从 choices[0].message.content 中取出回答文本
return resp.getJSONArray("choices")
// 取第一个 choice
.getJSONObject(0)
// 取其 message 对象
.getJSONObject("message")
// 取其 content 字符串
.getStr("content");
}
// 定义私有静态方法 executeSql,用于执行 SQL 脚本
private static void executeSql(String sqlText) throws Exception {
// 调用 extractDbName 从脚本中提取数据库名
String dbName = extractDbName(sqlText);
// 如果未识别出数据库名
if (dbName == null) {
// 打印错误提示
System.out.println("❌ 未从 SQL 脚本中识别出数据库名,"
// 拼接提示内容
+ "请确保脚本里包含 CREATE DATABASE xxx 或 USE xxx;");
// 终止方法
return;
}
// 打印识别出的数据库名
System.out.println("\n🎯 从脚本中识别出数据库名:" + dbName);
// 拼接连接 MySQL 服务器(不指定库名)的 URL
String serverUrl = "jdbc:mysql://" + DB_HOST + ":" + DB_PORT + "/"
// 附加参数:关闭 SSL、指定东八区时区
+ "?useSSL=false&serverTimezone=Asia/Shanghai"
// 附加参数:允许公钥检索、使用 UTF-8
+ "&allowPublicKeyRetrieval=true&characterEncoding=UTF-8"
// 附加参数:用户名与密码
+ "&user=" + DB_USER + "&password=" + DB_PWD;
// 用 try-with-resources 获取数据库连接与 Statement
try (Connection conn = DriverManager.getConnection(serverUrl);
// 创建 Statement 对象
Statement stmt = conn.createStatement()) {
// 拼接建库 SQL,带 IF NOT EXISTS 与 utf8mb4 字符集
String createDbSql = "CREATE DATABASE IF NOT EXISTS `" + dbName
// 附加字符集与排序规则
+ "` DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci";
// 打印将要执行的建库语句
System.out.println("[建库] " + createDbSql);
// 执行建库语句
stmt.executeUpdate(createDbSql);
// 打印库已就绪
System.out.println("数据库已就绪:" + dbName);
}
// 拼接连接目标库的 JDBC URL
String dbUrl = "jdbc:mysql://" + DB_HOST + ":" + DB_PORT + "/" + dbName
// 附加参数:关闭 SSL、指定东八区时区
+ "?useSSL=false&serverTimezone=Asia/Shanghai"
// 附加参数:允许公钥检索、使用 UTF-8
+ "&allowPublicKeyRetrieval=true&characterEncoding=UTF-8"
// 附加参数:用户名与密码
+ "&user=" + DB_USER + "&password=" + DB_PWD;
// 用 try-with-resources 获取连接与 Statement
try (Connection conn = DriverManager.getConnection(dbUrl);
// 创建 Statement 对象
Statement stmt = conn.createStatement()) {
// 以分号为分隔符,把整段 SQL 拆成数组
String[] statements = sqlText.split(";");
// 遍历每一条语句
for (String raw : statements) {
// 去掉首尾空白
String sql = raw.trim();
// 如果为空语句则跳过
if (sql.isEmpty()) continue;
// 转成大写,便于关键字前缀判断
String upper = sql.toUpperCase();
// 若以 USE 或 CREATE DATABASE 开头则跳过,因为前面已经处理
if (upper.startsWith("USE ") || upper.startsWith("CREATE DATABASE")) {
// 打印跳过提示
System.out.println("[跳过] " + sql);
// 跳过当前循环
continue;
}
// 打印即将执行的 SQL
System.out.println("\n[执行] " + sql);
// 如果以 SELECT 开头
if (upper.startsWith("SELECT")) {
// 用 try-with-resources 执行查询,自动关闭结果集
try (ResultSet rs = stmt.executeQuery(sql)) {
// 调用 printResultSet 打印查询结果
printResultSet(rs);
}
// 否则为更新类语句
} else {
// 执行更新,返回受影响行数
int affected = stmt.executeUpdate(sql);
// 打印受影响行数
System.out.println("影响行数:" + affected);
}
}
}
}
// 定义私有静态方法 extractDbName,从 SQL 文本中提取数据库名
private static String extractDbName(String sqlText) {
// 入参为 null 时直接返回 null
if (sqlText == null) return null;
// 编译正则,匹配 CREATE DATABASE [IF NOT EXISTS] xxx
Pattern p1 = Pattern.compile(
// 表达式:允许反引号/引号包裹,捕获组为库名
"CREATE\\s+DATABASE\\s+(?:IF\\s+NOT\\s+EXISTS\\s+)?[`\"']?([a-zA-Z0-9_]+)[`\"']?",
// 忽略大小写
Pattern.CASE_INSENSITIVE);
// 在 SQL 文本上创建匹配器
Matcher m1 = p1.matcher(sqlText);
// 若匹配到
if (m1.find()) {
// 返回捕获组中的数据库名
return m1.group(1);
}
// 编译备用正则,匹配 USE xxx
Pattern p2 = Pattern.compile(
// 表达式:允许反引号/引号包裹,捕获组为库名
"USE\\s+[`\"']?([a-zA-Z0-9_]+)[`\"']?",
// 忽略大小写
Pattern.CASE_INSENSITIVE);
// 在 SQL 文本上创建匹配器
Matcher m2 = p2.matcher(sqlText);
// 若匹配到
if (m2.find()) {
// 返回捕获组中的数据库名
return m2.group(1);
}
// 都没匹配到则返回 null
return null;
}
// 定义私有静态方法 printResultSet,将查询结果打印到控制台
private static void printResultSet(ResultSet rs) throws SQLException {
// 获取结果集的元数据
ResultSetMetaData meta = rs.getMetaData();
// 取得列数
int colCount = meta.getColumnCount();
// 创建 StringBuilder 用于拼接表头
StringBuilder header = new StringBuilder();
// JDBC 列下标从 1 开始遍历
for (int i = 1; i <= colCount; i++) {
// 追加列名
header.append(meta.getColumnName(i));
// 若不是最后一列,追加制表符
if (i < colCount) header.append("\t");
}
// 打印表头
System.out.println(header);
// 打印分隔线
System.out.println("----------------------------------------");
// 行数计数器
int rowNo = 0;
// 遍历结果集的每一行
while (rs.next()) {
// 创建 StringBuilder 用于拼接当前行
StringBuilder row = new StringBuilder();
// 遍历每一列
for (int i = 1; i <= colCount; i++) {
// 以字符串形式读取该列的值
String v = rs.getString(i);
// 若为 null 则显示 NULL,否则显示值
row.append(v == null ? "NULL" : v);
// 若不是最后一列,追加制表符
if (i < colCount) row.append("\t");
}
// 打印当前行
System.out.println(row);
// 行数计数器加一
rowNo++;
}
// 打印分隔线
System.out.println("----------------------------------------");
// 打印总行数
System.out.println("共 " + rowNo + " 行。");
}
}