一、引言
在 Spark、Flink、MapReduce 等大数据计算引擎中,Shuffle 往往是作业稳定性和性能的关键瓶颈。随着云原生、弹性伸缩、存算分离和混部调度成为主流,传统依赖本地磁盘和 Executor 生命周期的 Shuffle 模式逐渐暴露出资源利用率低、失败恢复成本高、扩缩容受限等问题。
Celeborn 的思路是把 Shuffle 数据交给一个独立服务管理。计算引擎的任务不再把 Shuffle 数据只写在本地 Executor 磁盘上,而是推送到 Celeborn Worker,由 Worker 负责存储、合并、复制和服务下游读取。
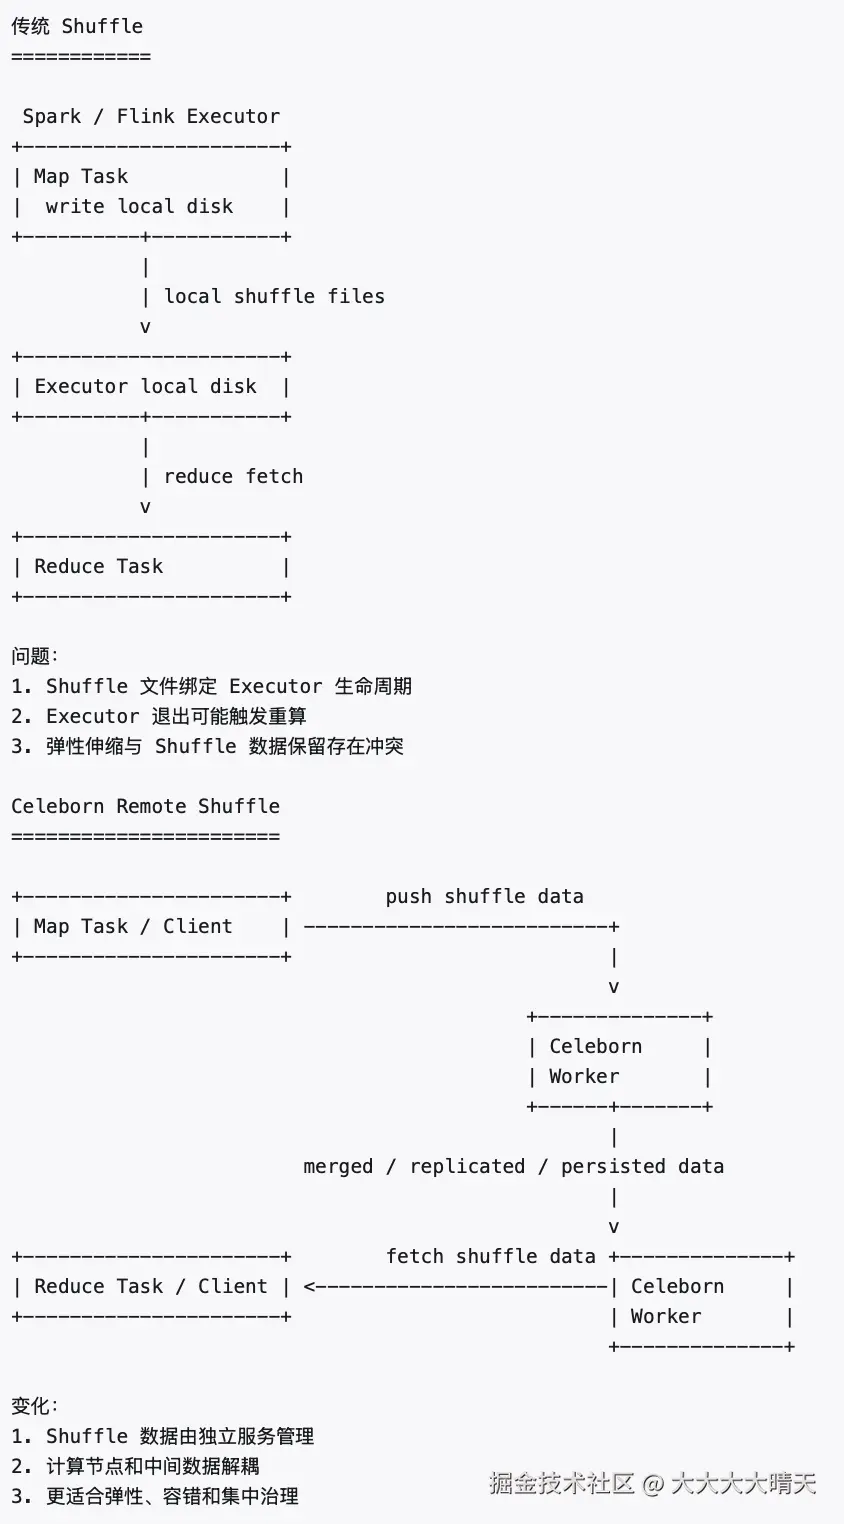
二、Celeborn介绍
Apache Celeborn 是 Apache 顶级项目,定位为面向大数据计算引擎的中间数据服务,当前重点解决 Shuffle 数据管理问题。它通过 Remote Shuffle Service 的方式,将 Shuffle 数据从计算节点生命周期中解耦出来,提供独立的 Master、Worker、Client 架构,并支持 Spark、Flink Batch、MapReduce 等引擎接入,其核心特性包括存算分离、push-based shuffle write、merged shuffle read、高可用和高容错。
从工程视角看,Celeborn 不是替代 Spark、Flink 或 Hadoop 的计算框架,而是位于计算引擎和存储资源之间的 Shuffle 数据服务层。它接管的是中间数据的写入、读取、合并、复制、清理和资源分配,让计算引擎可以更专注于任务调度和算子执行。
Celeborn 的架构可以分为三个核心组件:Master、Worker、Client。Master 负责资源管理并基于 Raft 同步共享状态,Worker 处理读写请求并为每个 Reducer 合并数据,LifecycleManager 维护每个 Shuffle 的元数据并运行在 Spark Driver 中。
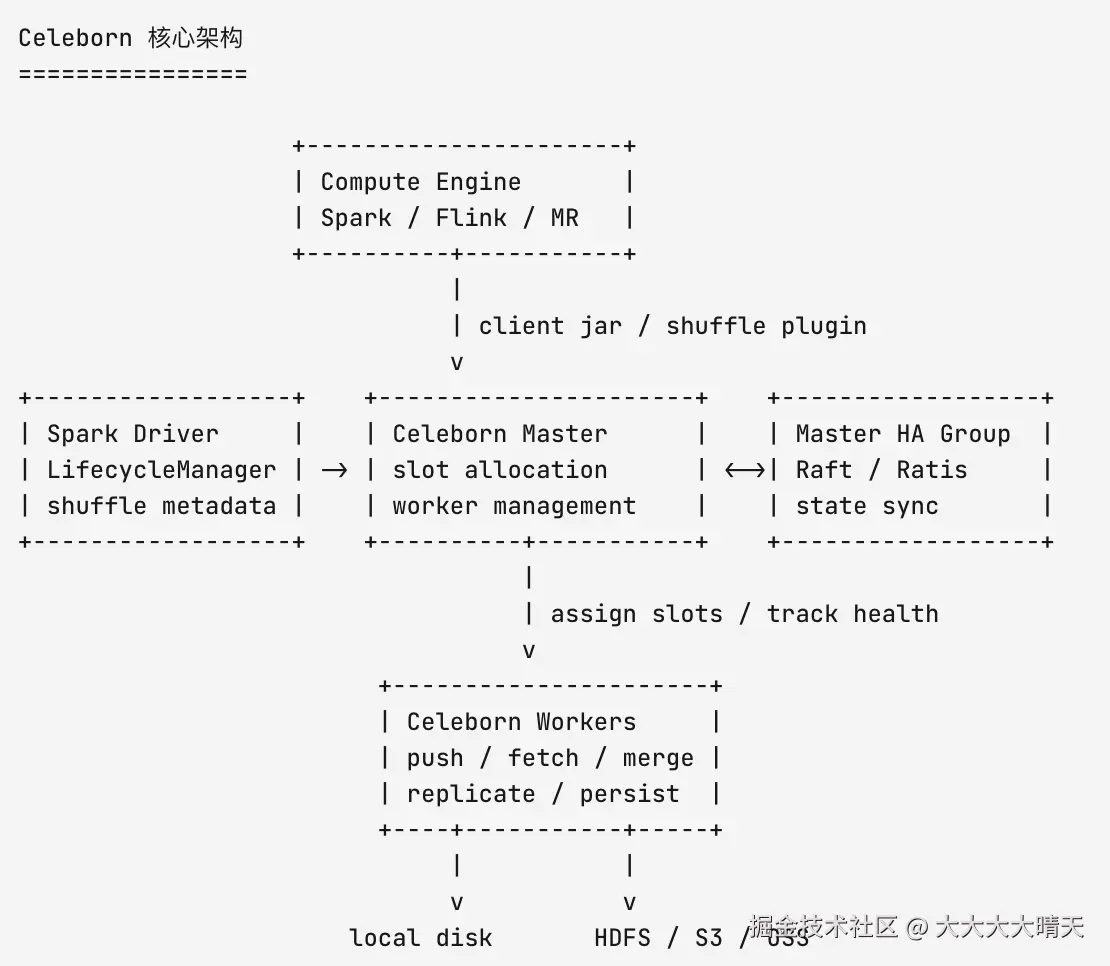
Master 更像 Celeborn 集群的"大脑"。它管理 Worker 注册、资源分配、Slot 分配、健康状态和集群元数据;在高可用部署中,Master 支持基于 Raft 的 HA 模式。
Worker 是真正处理数据读写的组件。Map 端任务通过 Client 将 Shuffle 数据推送到 Worker,Worker 负责接收、缓存、刷盘、复制、合并和最终提供给 Reduce 端读取;Celeborn 支持本地磁盘,也支持 HDFS、S3、OSS 等后端。
Client 是计算引擎侧的接入层。Spark 通过配置spark.shuffle.manager=org.apache.spark.shuffle.celeborn.SparkShuffleManager 接入 Celeborn,Flink 通过shuffle-service-factory.class 或 Hybrid Shuffle 外部 Tier 接入,MapReduce 则通过 MapOutputCollector 和 Reduce Shuffle Consumer 插件接入。
三、Shuffle 流程
Celeborn 的 Shuffle 流程可以理解为"先注册,再分配,再推送,再提交,最后读取"。Mapper 懒加载请求 LifecycleManager 注册 Shuffle,LifecycleManager 向 Master 请求 Slots,Worker 预留 Slots 并创建文件,Mapper 获取 Worker 位置后推送数据,Worker 合并并复制数据,周期性刷盘,Map 任务完成后触发提交,Reducer 再请求文件位置并读取数据。
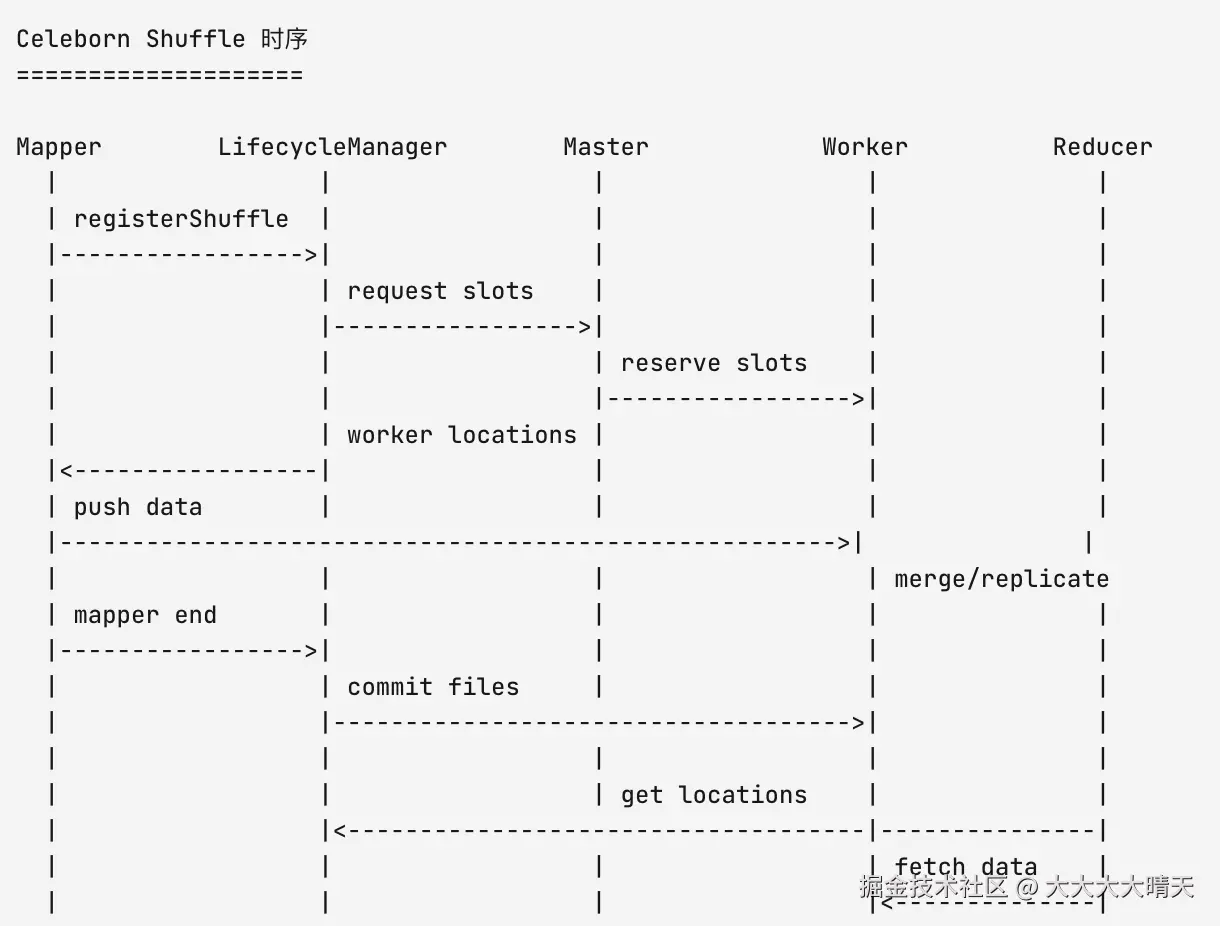
这个流程背后的核心收益,是把 Shuffle 文件从"散落在 Executor 本地磁盘上的临时副产物",变成"由独立服务管理的中间数据"。当计算资源需要扩缩容时,Shuffle 数据不再天然依附于 Executor 存活状态;当 Worker 压力较高或磁盘异常时,Master 也有机会基于资源状态做更集中化的分配和规避。
四、核心特性与优势
- 存算解耦:Celeborn 可与 Spark、Flink、MapReduce 等引擎集成,使这些引擎向 Celeborn 写入和读取 Shuffle 数据。
- 高可用和容错:Master 支持 Raft-based HA,Worker 侧支持数据复制、失败重试、磁盘监控、内存水位控制、优雅关闭等机制。
- 多引擎支持:Celeborn 支持 Spark 3.0 到 4.2、Flink 1.18 到 2.3、Hadoop MapReduce 3,并列出了不同 Java 和 Scala 版本下的兼容矩阵;另外Flink引擎当前仅支持批作业。
- 多存储后端:Celeborn 可用本地 HDD/SSD,也可配置 HDFS、S3、OSS。
Celeborn 的优势并不只是"把 Shuffle 放到远端"。它真正解决的是大规模计算集群里 Shuffle 数据的生命周期管理问题。
| 维度 | 传统本地 Shuffle | Celeborn Remote Shuffle |
|---|---|---|
| 数据生命周期 | 绑定 Executor 或 Task 本地目录 | 由 Celeborn Worker 独立管理 |
| 弹性伸缩 | Executor 释放可能影响 Shuffle 数据 | 更适合动态资源分配和弹性计算 |
| 容错恢复 | Executor 丢失可能触发上游重算 | 可通过复制、重试、集中管理降低失败影响 |
| 资源治理 | 分散在计算节点本地磁盘 | 独立 Shuffle 集群,便于容量和健康管理 |
| 引入成本 | 引擎默认能力,架构简单 | 需要部署 Master/Worker,并维护服务稳定性 |
| 性能边界 | 本地读写路径短,但易受 Executor 资源竞争影响 | 网络多一跳,但可通过合并、复制、集中 I/O 优化收益 |
实际选型时,不应简单地认为"Remote Shuffle 一定更快"。它更适合 Shuffle 数据大、任务多、Executor 生命周期不稳定、需要动态资源分配或集群资源混部的场景。如果你的作业规模小、Shuffle 很轻、本地磁盘充足且失败代价低,引入独立 Shuffle 服务可能会增加系统复杂度。
五、适用场景
Celeborn 适合第一类场景:大规模 Spark SQL、ETL、Join、聚合、排序等 Shuffle 密集型任务。尤其是存在大宽表 Join、倾斜 Join、超大聚合、长链路 DAG 的场景,Shuffle 数据量常常远超单个 Executor 的稳定承载能力。
第二类场景是需要动态资源分配或云原生弹性的集群。Spark 自身也长期围绕 Shuffle Tracking、External Shuffle Service、Dynamic Allocation 做演进,而 Celeborn 的价值在于让 Shuffle 数据独立于计算容器生命周期。
第三类场景是存算分离或混部集群。Celeborn 为异构环境中的在线和离线服务混部提供了基础条件,并帮助提升在线服务和大数据集群的联合调度与利用率。
第四类场景是希望集中治理 Shuffle 资源的组织。比如为 Shuffle 单独规划 SSD、本地盘、HDFS 或对象存储后端,统一监控 Worker 磁盘健康、网络吞吐、复制失败、应用 Shuffle 占用等指标,而不是让每个 Spark Executor 各自处理本地临时数据。
六、部署使用
Celeborn 最小部署由 Master 和 Worker 组成。
markdown
最小化部署流程
==============

1. 下载并解压
   apache-celeborn-<VERSION>-bin.tgz

2. 配置存储目录
   celeborn.worker.storage.dirs=$CELEBORN_HOME/shuffle

3. 启动 Master
   ./sbin/start-master.sh

4. 启动 Worker
   ./sbin/start-worker.sh celeborn://<Master IP>:<Master Port>

5. 接入计算引擎
   Spark / Flink / MapReduce client jar + engine config
生产部署一般不建议只部署单 Master,建议配置多个 Master endpoint,并启用celeborn.master.ha.enabled true,同时为每个 Master 配置唯一节点 ID、RPC 端口、Ratis 端口和 Raft 存储目录。
Spark 接入时,需要把对应 Spark 大版本的 Celeborn client jar 放入$SPARK_HOME/jars/ ,并设置spark.shuffle.manager org.apache.spark.shuffle.celeborn.SparkShuffleManager 、spark.serializer org.apache.spark.serializer.KryoSerializer 、spark.celeborn.master.endpoints 等配置;建议启用 AQE,并在使用 Celeborn 时将spark.sql.adaptive.localShuffleReader.enabled 设置为false 以获得更好的 Celeborn 性能表现。
一个典型 Spark 配置片段如下:
arduino
spark.shuffle.manager org.apache.spark.shuffle.celeborn.SparkShuffleManager
spark.serializer org.apache.spark.serializer.KryoSerializer
spark.celeborn.master.endpoints clb-1:9097,clb-2:9097,clb-3:9097
spark.shuffle.service.enabled false
spark.celeborn.client.push.replicate.enabled true
spark.sql.adaptive.enabled true
spark.sql.adaptive.skewJoin.enabled true
spark.sql.adaptive.localShuffleReader.enabled false
Flink 接入时,要先确认你的作业类型,Celeborn 当前只支持 Flink batch jobs;对于 Flink 1.16 及以上,可用 Remote Shuffle Service 方式,设置shuffle-service-factory.class: org.apache.celeborn.plugin.flink.RemoteShuffleServiceFactory 和execution.batch-shuffle-mode: ALL_EXCHANGES_BLOCKING ;对于 Flink 1.20 及以上,也可通过 Hybrid Shuffle 外部 remote tier 集成 Celeborn。
MapReduce 接入则需要把 Celeborn MR client jar 加入 MapReduce 和 YARN classpath,并配置mapreduce.job.map.output.collector.class 为org.apache.hadoop.mapred.CelebornMapOutputCollector ,配置mapreduce.job.reduce.shuffle.consumer.plugin.class 为org.apache.hadoop.mapreduce.task.reduce.CelebornShuffleConsumer 。
七、选型建议
如果你已经在大规模使用 Spark SQL 或离线 ETL,并且经常遇到 Shuffle 文件丢失、Executor 退出导致重算、动态资源分配困难、磁盘 I/O 抖动或大作业长尾问题,Celeborn 值得进入技术验证范围。它的价值在于把 Shuffle 从"每个作业自己处理的临时文件问题",提升为"集群级中间数据服务问题"。
但如果你的集群规模不大,Shuffle 数据量有限,任务失败成本低,或者团队尚未建立稳定的监控、容量规划和独立服务运维能力,直接引入 Celeborn 可能会增加复杂度。Celeborn 自身也需要高可用部署、磁盘规划、网络规划、版本兼容治理和故障排查机制。
一个务实的落地路径是先选择几类 Shuffle 重、失败代价高、运行频率稳定的 Spark Batch 作业做灰度验证。验证指标可以包括作业耗时、失败率、Executor 重算次数、Shuffle fetch 失败、Worker 磁盘利用率、网络吞吐、Celeborn Master/Worker 稳定性和升级恢复表现。
八、与Uniffle的异同
两者都是 Apache 体系下的 Remote Shuffle Service,目标都是把 Shuffle 从计算节点本地磁盘中解耦出来。
Celeborn 更像"Master + Worker + 引擎侧 Client"的远程 Shuffle 集群。Master 负责资源管理和共享状态同步,Worker 负责读写、合并、复制、刷盘,Spark 场景中的 LifecycleManager 运行在 Driver 内并维护 Shuffle 元数据。
Uniffle 更强调"Coordinator + Shuffle Server + 可选远端存储"的分配模型。Coordinator 收集 Shuffle Server 心跳和状态,决定作业使用哪些 Shuffle Server;Shuffle Server 接收 Shuffle 数据、合并并写入本地或远端存储。
sql
Celeborn
========

Spark / Flink / MR Client
        |
        v
+----------------+
| Master         |  资源管理、slot 分配、HA 状态同步
+----------------+
        |
        v
+----------------+
| Worker         |  push / fetch / merge / replicate / persist
+----------------+
        |
        v
Local Disk / HDFS / S3 / OSS


Uniffle
=======

Spark / MR / Tez Client
        |
        v
+----------------+
| Coordinator    |  收集 Shuffle Server 状态、分配节点、下发动态配置
+----------------+
        |
        v
+----------------+
| Shuffle Server |  receive / merge / write / serve
+----------------+
        |
        v
Memory / LocalFile / HDFS 等| 你的场景 | 更建议 |
|---|---|
| 优先评估 Spark 3.x/4.x 为主,并且希望跟进较新的 Spark 版本 | Celeborn |
| Flink Batch 是重要场景 | Celeborn |
| Hadoop MapReduce + Tez 是重要场景 | Uniffle |
| 希望 Remote Shuffle 服务兼顾 Spark、Flink Batch、MapReduce | Celeborn |
| 希望强化 Coordinator 动态客户端配置、远端存储路径分配、访问控制候选列表 | Uniffle |
| 希望使用 Raft-based Master HA,并以 Master/Worker 模型统一管理 Shuffle 资源 | Celeborn |
| 已经有较多 HDFS 混合存储、Memory + Local + Remote Storage 经验 | Uniffle |
- 选 Celeborn :Spark/Flink Batch/MapReduce 通用性更重要,想要较新的 Spark/Flink 版本覆盖,偏向 Master/Worker + Raft HA 的架构。
- 选 Uniffle :Spark + MapReduce/Tez 更重要,偏向 Coordinator 分配模型、Memory/Local/Remote 混合存储、动态客户端配置和远端 Merge。
- 不要只看"谁更快" :两者性能都依赖网络、磁盘、存储后端、分区规模、数据倾斜和客户端参数,必须用真实作业压测后再定。