✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
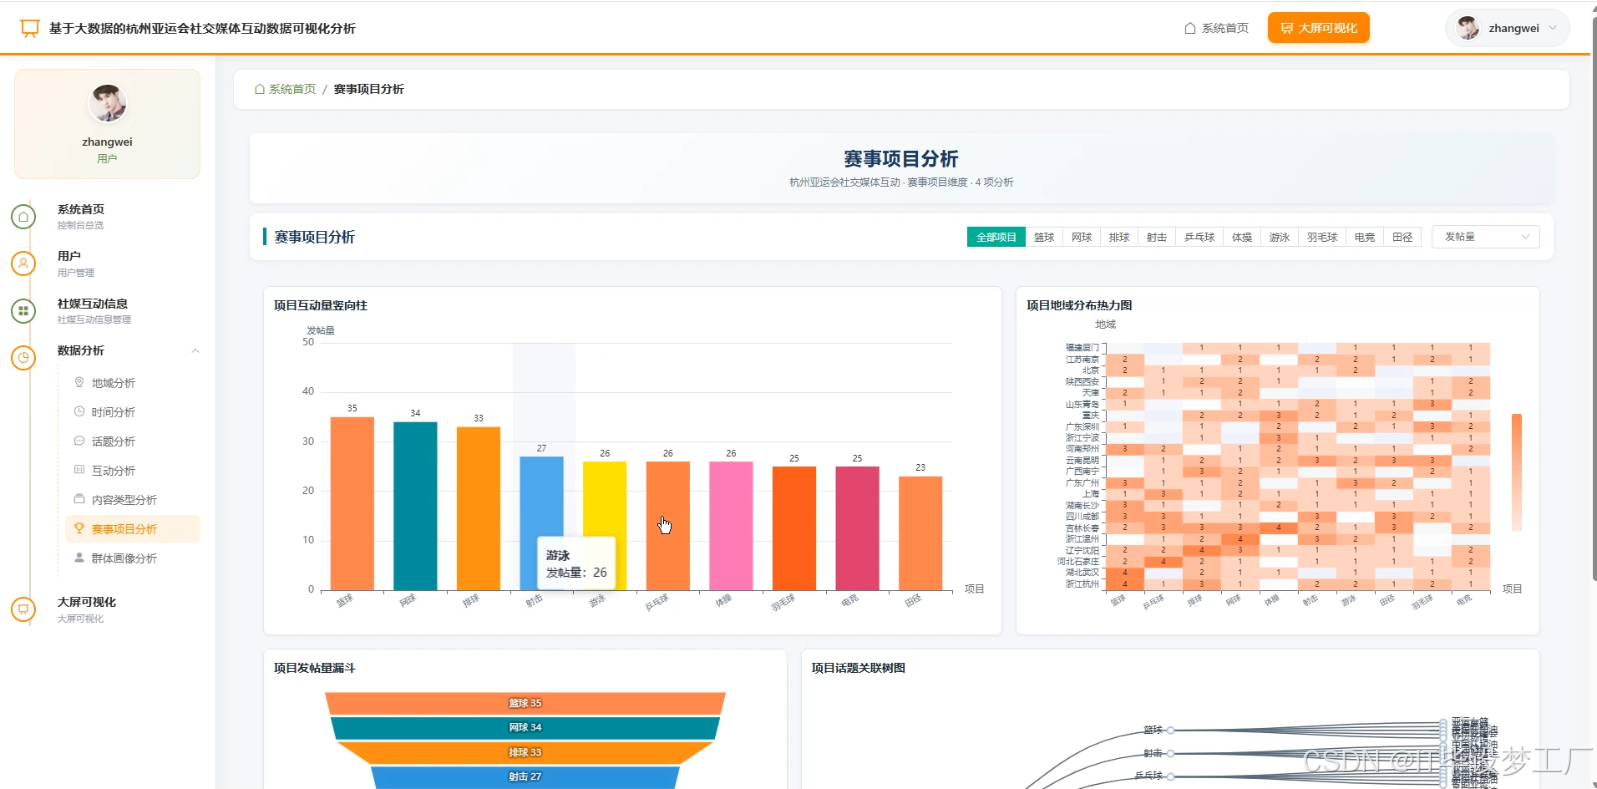
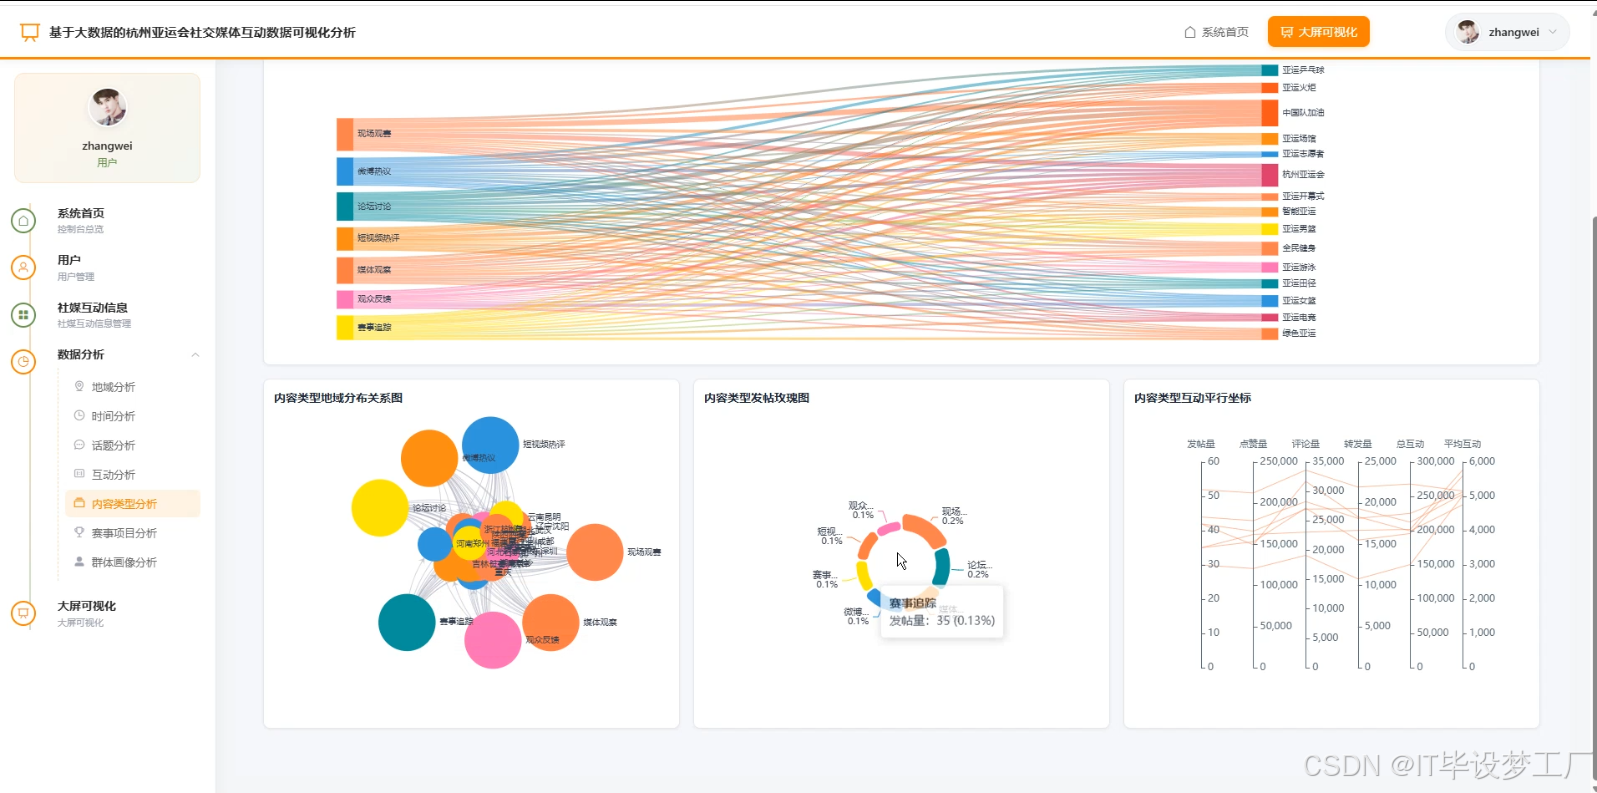
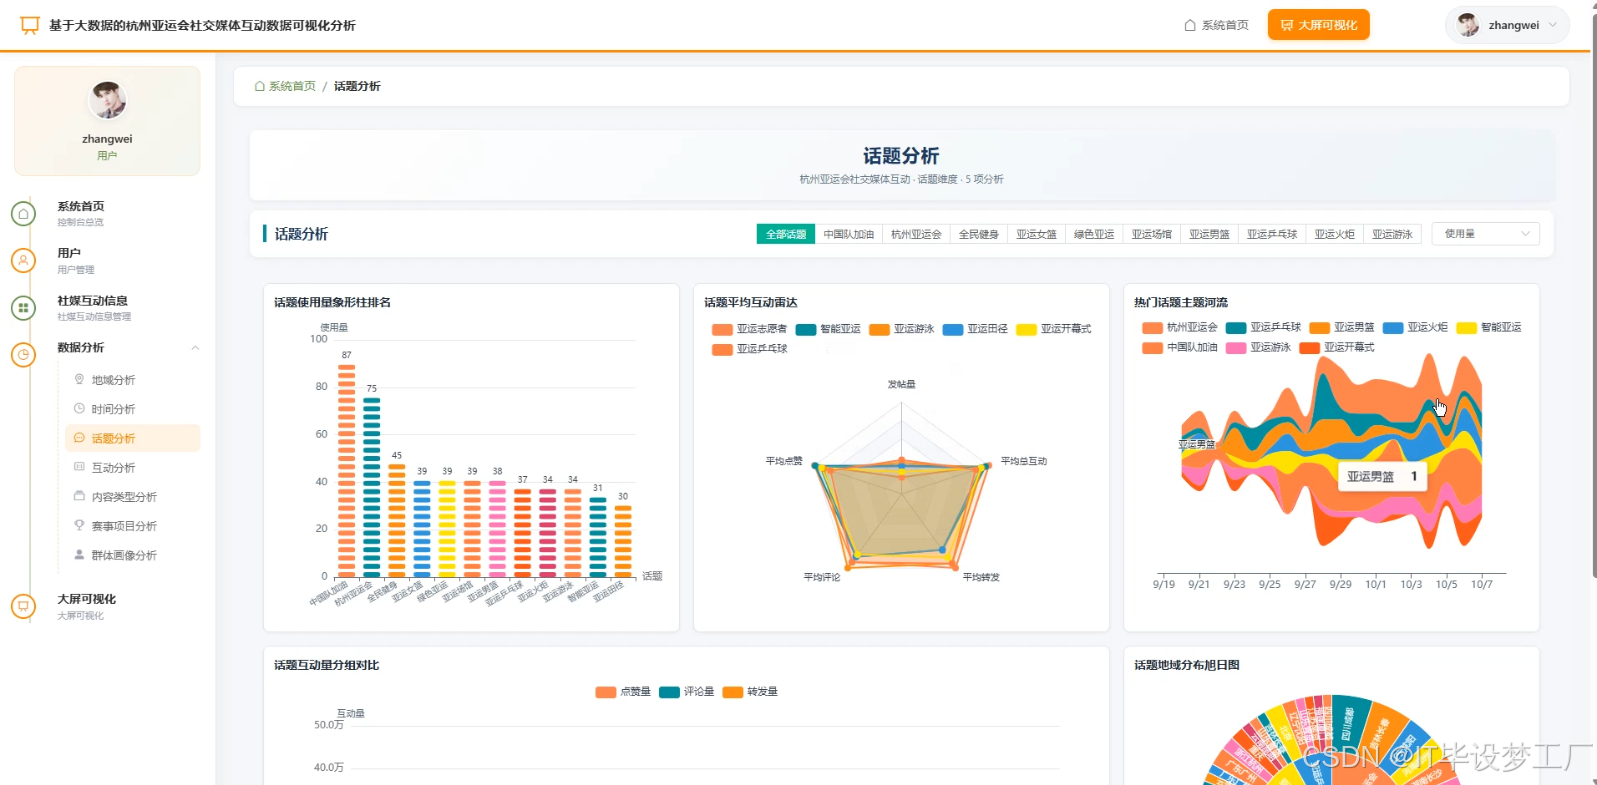
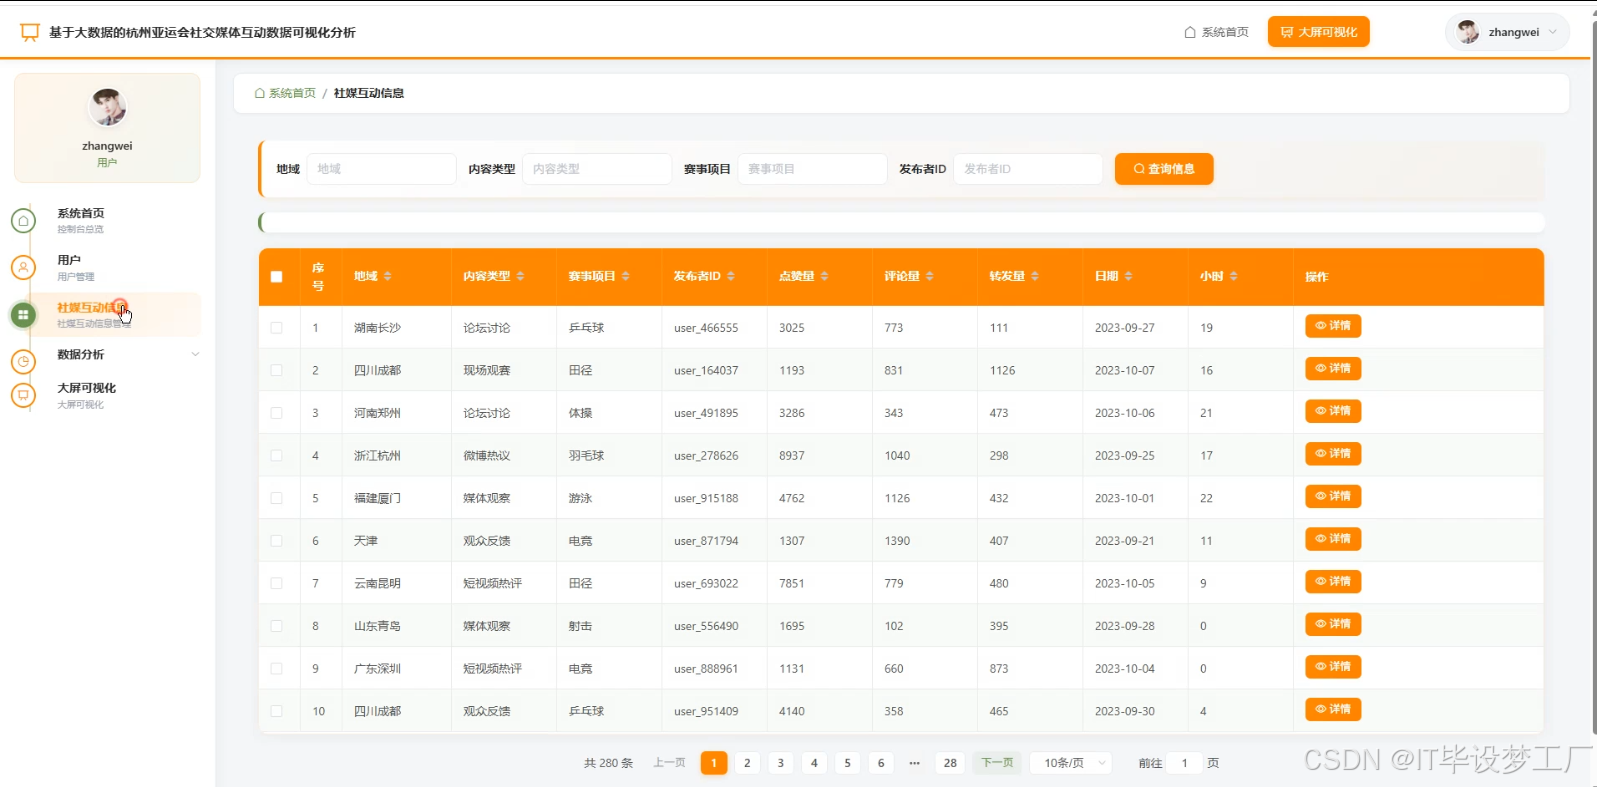
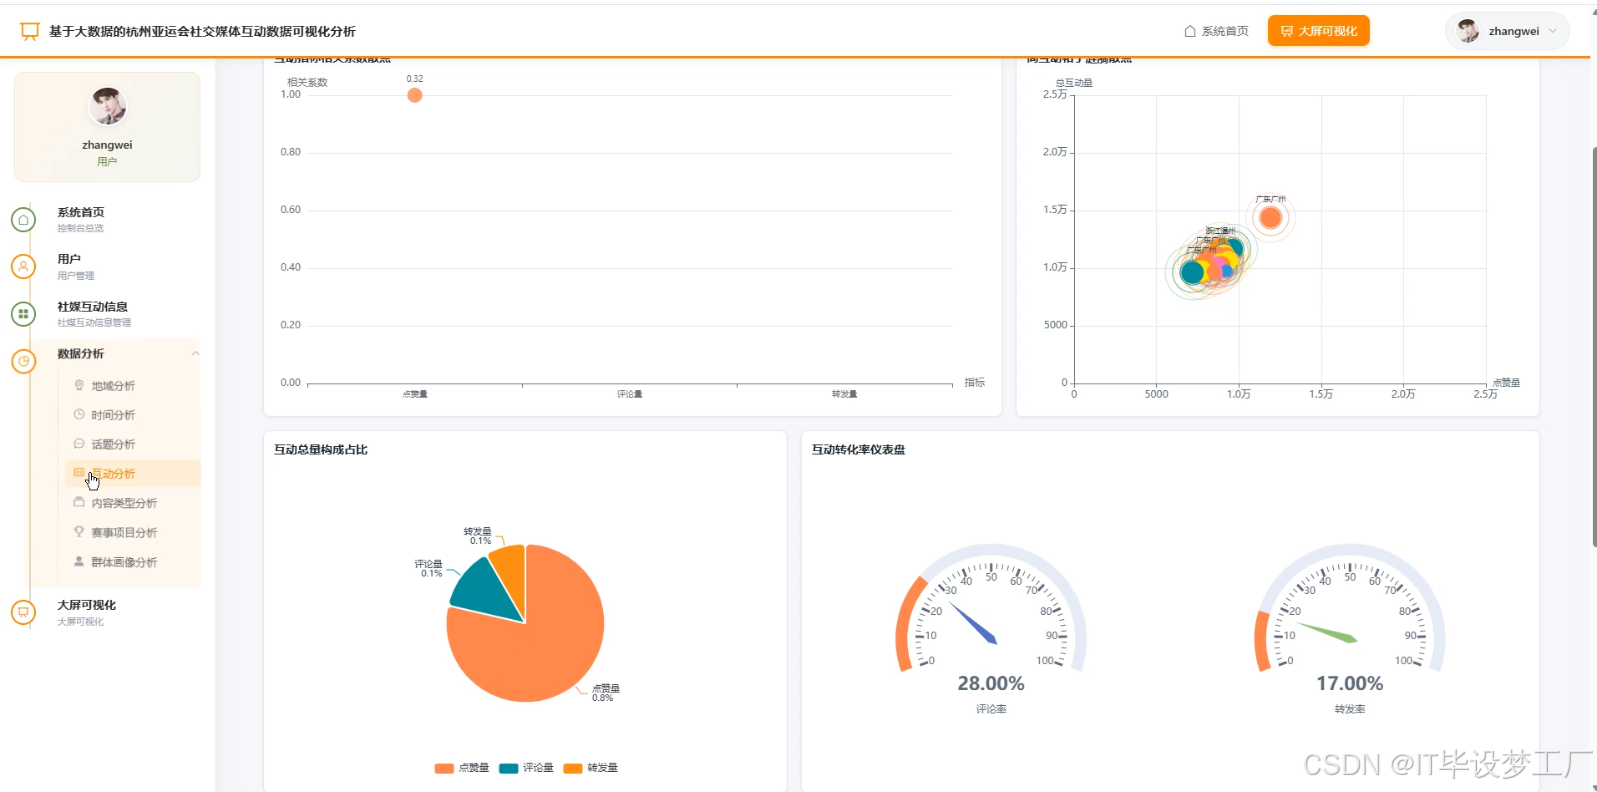
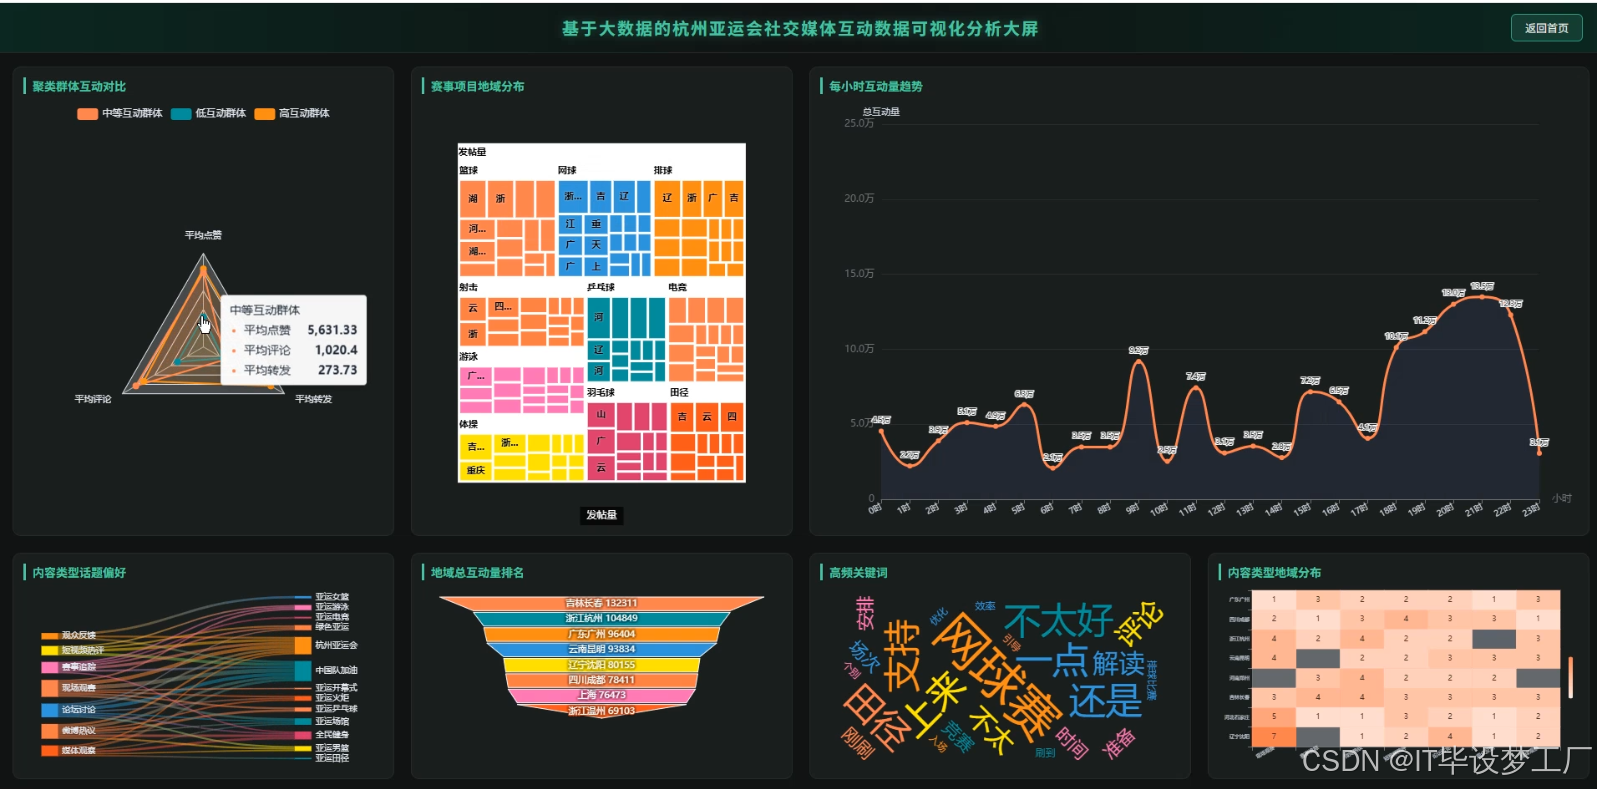
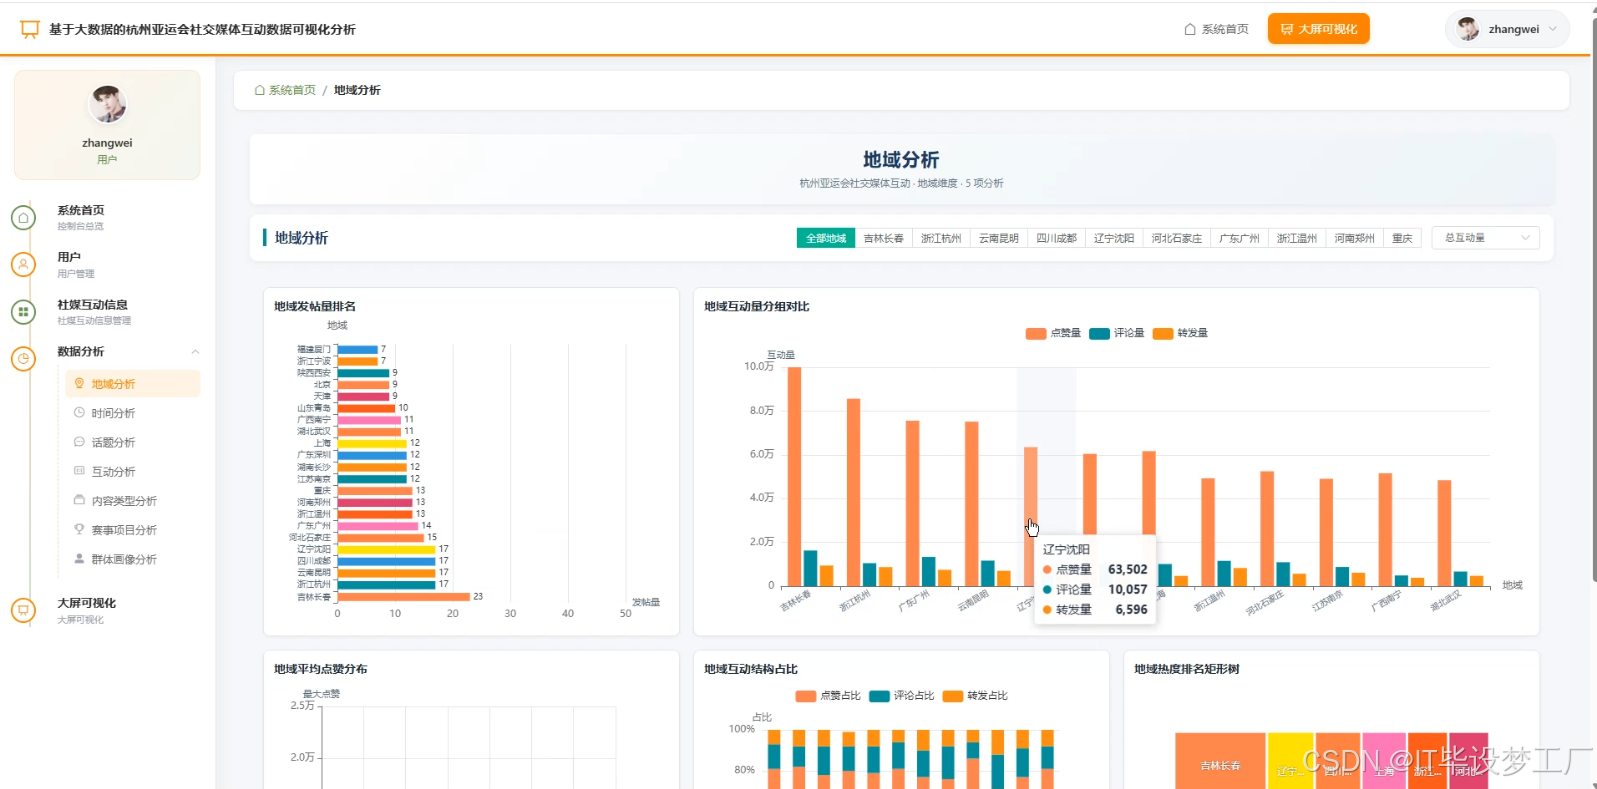
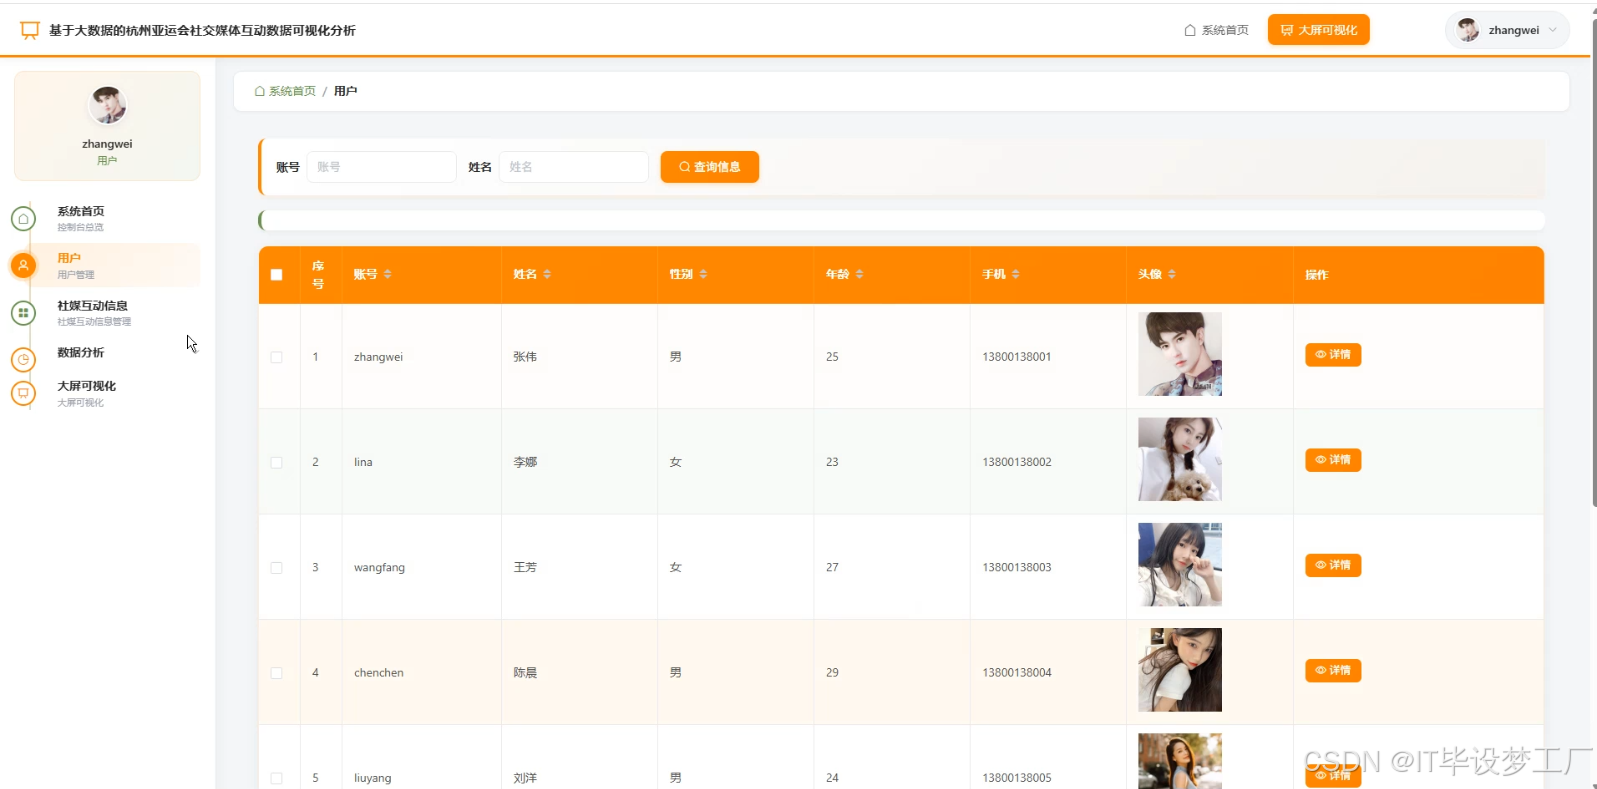
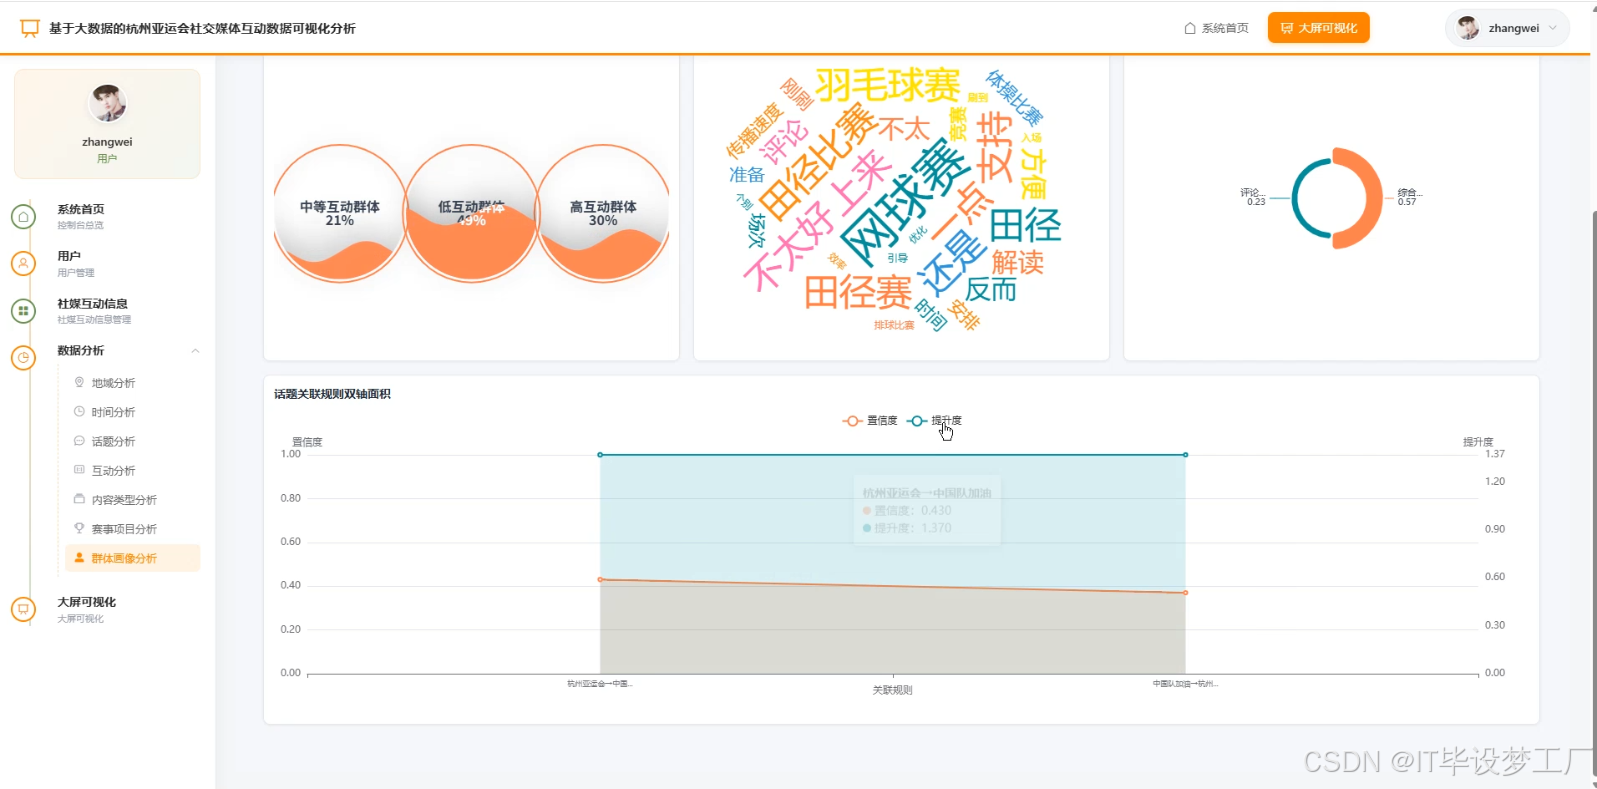
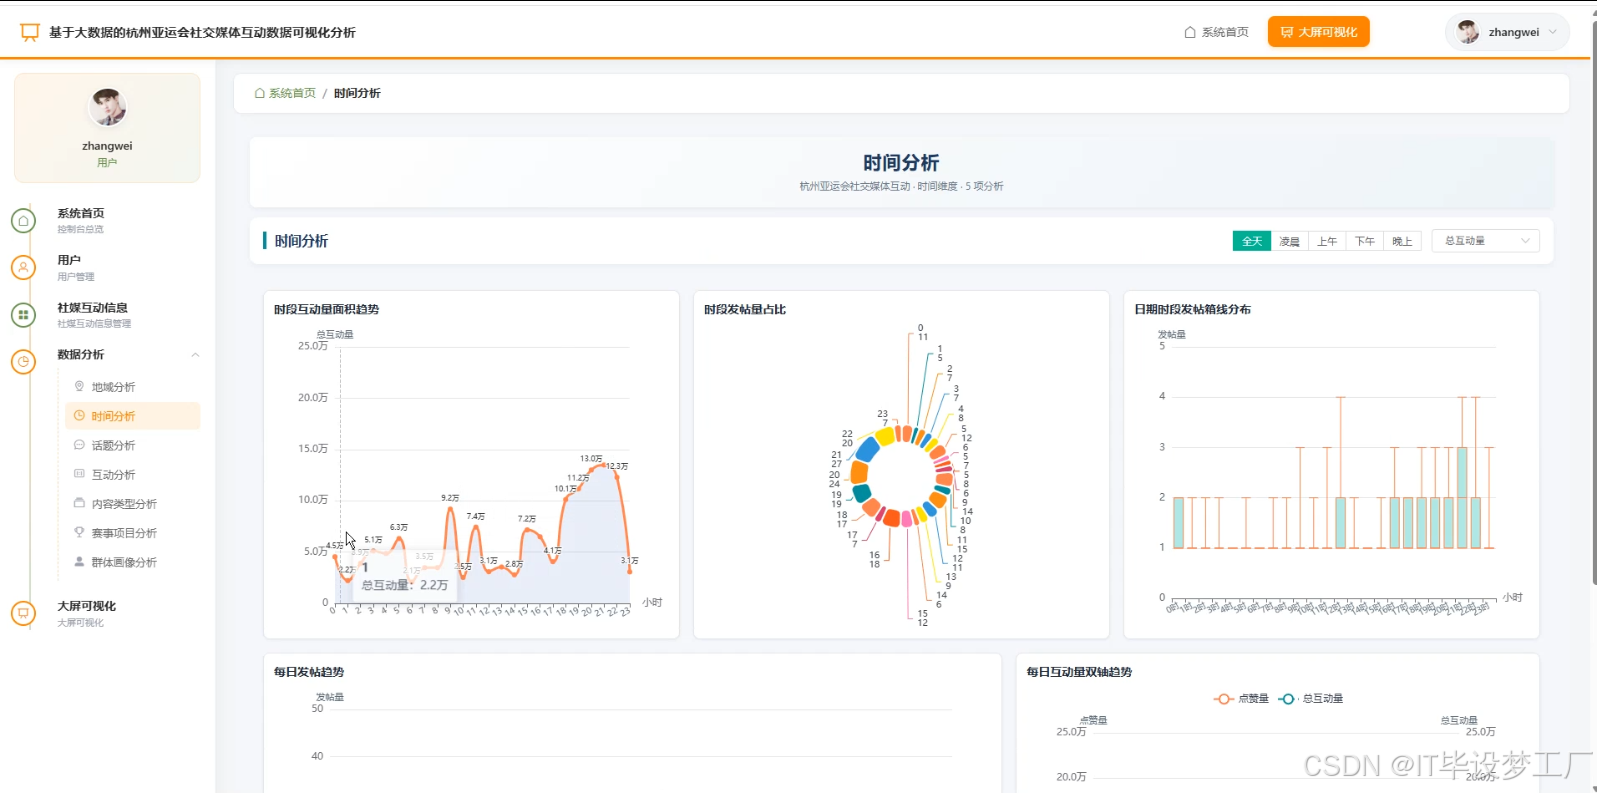
本系统《基于大数据的杭州亚运会社交媒体互动数据可视化分析》主要围绕杭州亚运会期间社交媒体上的互动数据展开,用Hadoop和HDFS做数据存储,借助Spark和Spark SQL完成数据清洗、聚合、统计和排行计算,Pandas、NumPy用来做一些辅助处理,最后把分析结果写入MySQL。后端提供Python+Django和Java+Spring Boot两个版本,前端用Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery来展示页面和图表。功能上包括系统首页、大屏可视化、用户管理、社媒互动信息管理、数据分析、地域分析、时间分析、话题分析、互动分析、内容类型分析、赛事项目分析、群体画像分析、个人信息和修改密码。用户可以查看点赞、评论、转发等互动指标,也能按地域、时间、话题、内容类型和赛事项目观察传播变化,并通过大屏和图表直观看到杭州亚运会社媒互动的整体情况。系统重点放在Spark SQL分析链路和可视化呈现上,适合作为计算机专业毕设中大数据方向的一个完整实践。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的杭州亚运会社交媒体互动数据可视化分析系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
from pyspark.sql import SparkSession, functions as F
from django.http import JsonResponse
spark = SparkSession.builder.appName("HangzhouAsianGamesSocialMedia").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def interaction_analysis(request):
    df = spark.read.option("header", "true").csv("hdfs:///hangzhou_asia/social_interaction/*.csv")
    df = df.withColumn("likes", F.col("likes").cast("int"))
    df = df.withColumn("comments", F.col("comments").cast("int"))
    df = df.withColumn("shares", F.col("shares").cast("int"))
    df = df.withColumn("interaction_total", F.col("likes") + F.col("comments") + F.col("shares"))
    df = df.withColumn("stat_date", F.to_date(F.col("publish_time")))
    df.createOrReplaceTempView("social_interaction")
    result = spark.sql("""
        select platform,
               stat_date,
               sum(likes) as like_count,
               sum(comments) as comment_count,
               sum(shares) as share_count,
               sum(interaction_total) as total_interaction,
               count(distinct user_id) as user_count
        from social_interaction
        group by platform, stat_date
        order by total_interaction desc
    """)
    data = [row.asDict() for row in result.collect()]
    mysql_url = "jdbc:mysql://localhost:3306/asia_games?useSSL=false&characterEncoding=utf8"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    result.write.mode("overwrite").jdbc(mysql_url, "interaction_analysis_result", props)
    return JsonResponse({"code": 200, "msg": "互动分析完成", "data": data[:50]})
def topic_analysis(request):
    df = spark.read.option("header", "true").json("hdfs:///hangzhou_asia/social_content/*.json")
    df = df.filter(F.col("content").isNotNull())
    df = df.withColumn("topic_array", F.split(F.col("content"), "#"))
    topic_df = df.select(F.explode("topic_array").alias("topic"), "user_id", "likes", "comments", "shares", "publish_time")
    topic_df = topic_df.withColumn("topic", F.trim(F.col("topic")))
    topic_df = topic_df.filter(F.length("topic") > 1)
    topic_df = topic_df.withColumn("likes", F.col("likes").cast("int"))
    topic_df = topic_df.withColumn("comments", F.col("comments").cast("int"))
    topic_df = topic_df.withColumn("shares", F.col("shares").cast("int"))
    topic_df = topic_df.withColumn("interaction_total", F.col("likes") + F.col("comments") + F.col("shares"))
    topic_df.createOrReplaceTempView("topic_data")
    result = spark.sql("""
        select topic,
               count(1) as mention_count,
               sum(interaction_total) as interaction_total,
               count(distinct user_id) as user_count,
               max(publish_time) as last_time
        from topic_data
        group by topic
        order by interaction_total desc, mention_count desc
    """)
    data = [row.asDict() for row in result.collect()]
    mysql_url = "jdbc:mysql://localhost:3306/asia_games?useSSL=false&characterEncoding=utf8"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    result.write.mode("overwrite").jdbc(mysql_url, "topic_analysis_result", props)
    return JsonResponse({"code": 200, "msg": "话题分析完成", "data": data[:50]})
def region_analysis(request):
    df = spark.read.option("header", "true").csv("hdfs:///hangzhou_asia/user_region/*.csv")
    df = df.withColumn("likes", F.col("likes").cast("int"))
    df = df.withColumn("comments", F.col("comments").cast("int"))
    df = df.withColumn("shares", F.col("shares").cast("int"))
    df = df.withColumn("interaction_total", F.col("likes") + F.col("comments") + F.col("shares"))
    df = df.withColumn("province", F.when(F.col("region").isNull(), "未知").otherwise(F.col("region")))
    df.createOrReplaceTempView("region_interaction")
    result = spark.sql("""
        select province,
               count(distinct user_id) as user_count,
               sum(likes) as like_count,
               sum(comments) as comment_count,
               sum(shares) as share_count,
               sum(interaction_total) as total_interaction,
               round(avg(interaction_total), 2) as avg_interaction
        from region_interaction
        group by province
        order by total_interaction desc
    """)
    data = [row.asDict() for row in result.collect()]
    mysql_url = "jdbc:mysql://localhost:3306/asia_games?useSSL=false&characterEncoding=utf8"
    props = {"user": "root", "password": "123456", "driver": "com.mysql.cj.jdbc.Driver"}
    result.write.mode("overwrite").jdbc(mysql_url, "region_analysis_result", props)
    return JsonResponse({"code": 200, "msg": "地域分析完成", "data": data[:50]})
五、论文参考
- 计算机毕业设计选题推荐-基于大数据的杭州亚运会社交媒体互动数据可视化分析系统-论文参考:
六、系统视频
- 基于大数据的杭州亚运会社交媒体互动数据可视化分析系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的杭州亚运会社交媒体互动数据可视化分析|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇