引子:为了让一个难题做对,我们最顺手的办法是「多抽几次、选最好的」------best-of-N、self-consistency 都这么干。但 UCLA 9 月 23 日放出的 PTTS(Planned Test-Time Scaling,arXiv 2609.27374)戳破了一个温水煮青蛙的事实:同一个策略独立抽 k 次,分支会塌缩到同一条主导推理路径上,多花的算力买来的是重复尝试,而不是新覆盖。PTTS 的改法很轻------给每个分支先发一张不同的「大纲」,让它们各走各路。它不训大模型,却把 pass@k 最高抬了 13.4 个点,还顺手把所需算力砍掉一半以上。
一、旧范式的原罪:重复采样在「碰运气」
测试时扩展(test-time scaling)的核心动作,是把一个问题并行跑 k 个分支,再从中挑一个最好的答案。这套打法有两个名字大家最熟:
- best-of-N / 拒绝采样:对同一个 prompt 采样 N 次,用奖励模型或验证器挑分最高的。
- self-consistency(自一致性):对多步推理题采样多条思维链,投票决定答案。
它们都共享一个隐含假设:k 个分支是从同一个策略 π 独立、同分布抽出来的。问题恰恰出在这里。
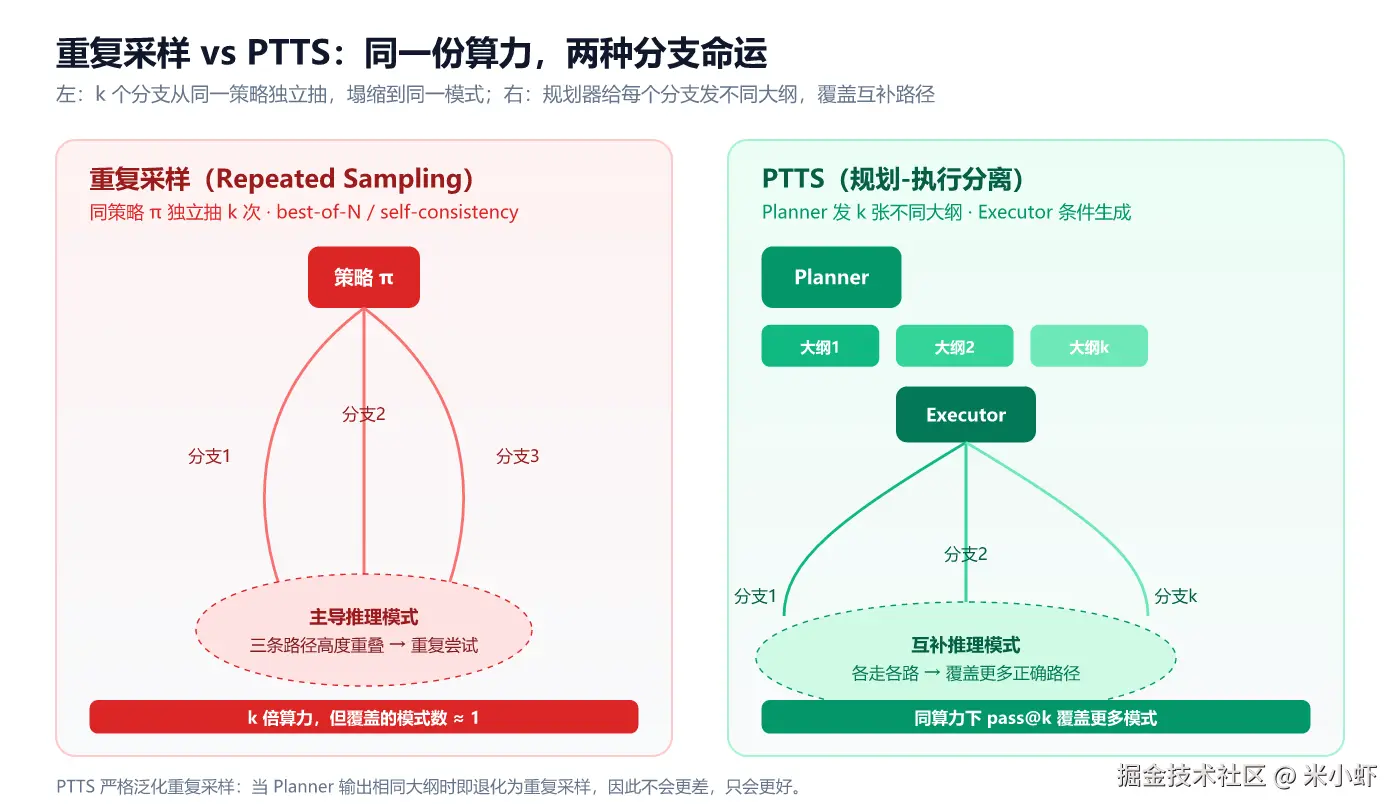
论文在「推理模式选择」的简化设定里证明了一个尖锐的结论:以 pass@1 为目标的边际策略会塌缩到单一主导模式(mode collapse)。换句话说,当模型「最擅长」某条路时,它抽出来的 k 个分支会高度相似,反复重放同一类失败。此时额外算力只是把你已经试过的错路再试一遍。
css
重复采样:        π ──┬─> 分支1 ──> 主导模式 A
                      ├─> 分支2 ──> 主导模式 A   ← 高度重叠
                      └─> 分支3 ──> 主导模式 A
收益:k 倍算力,覆盖的模式数 ≈ 1
对一个只有单一正确解路径的简单题,这无所谓;但对那些「需要互补思路才能覆盖正确解」的难题(比如一道能用代数、几何、数论三种路径去碰的奥数题),重复采样的 pass@k 曲线会早早饱和。这不是模型不够强,是采样方式把多样性锁死了。
二、PTTS 的原理:规划-执行分离
PTTS 把「抽 k 个独立样本」换成一个协调的联合策略(coordinated joint policy):
- Planner(规划器) 一次性为 k 个分支各生成一份差异化的解题大纲(outline),把分支往不同的推理路径上推;
- Executor(执行器) 在各自大纲的条件下,产出完整解答。
css
PTTS:           Planner ──┬─> 大纲1 ──> Executor ──> 分支1 ──> 互补模式 A
                          ├─> 大纲2 ──> Executor ──> 分支2 ──> 互补模式 B
                          └─> 大纲k ──> Executor ──> 分支k ──> 互补模式 C
收益:同算力下,pass@k 覆盖更多正确路径
「啊哈」时刻 :这本质上是个协调问题,不是采样问题。难点从来不是「多抽几次」,而是「让每次抽取去探索还没被覆盖的思路」。一旦显式地规划大纲,pass@k 就从「重复抽奖」变成「分工勘探」。
形式上,论文证明 PTTS 严格泛化(strictly generalizes)重复采样 :当 Planner 给所有分支输出相同大纲时,PTTS 就退化成重复采样------所以它保证不会比重复采样更差,只会更好。在同一简化设定里,直接以 pass@k 为目标的 Planner 会主动促进互补推理模式的覆盖,从而拿到比 pass@1 优化更好的 pass@k 扩展曲线。
论文给出两个落地形态:
- PTTS-ZS(零样本) :用一个基础 LLM 当 Planner(利用其更广的生成多样性),冻结一个强推理模型当 Executor;所有 k 份大纲在一次自回归生成里联合产出。简单到可以纯 prompt 实现,且天然支持端到端优化。
- PTTS-RL(强化学习) :冻结 Executor,直接用 k 个分支解的 pass@k 作为奖励去优化 Planner。关键技巧是训练时截断 Executor 的推理预算------不让 Executor 用「想得更久」来抢救一份烂大纲,从而把信用分配(credit assignment)精准地压到 Planner 头上,同时大幅降低 rollout 成本。
三、N 个优势(都用数据说话)
实验在 Qwen3-1.7B 和 4B 两个Executor、五个数理推理基准上完成:
| 方案 | pass@64 相对重复采样 | 算力开销 |
|---|---|---|
| 重复采样(基线) | --- | k 次完整推理 |
| PTTS-ZS(零样本) | 最高 +6.7 点 | 约等于基线 |
| PTTS-RL(强化学习) | 最高 +13.4 点 | 半预算即超越基线(>2× 算力效率) |
几个值得记住的点:
- 算力效率是真金白银:PTTS-RL 只用一半采样预算就超过了重复采样,等价于 2 倍以上 compute-efficient。
- Planner 可迁移 :用 PTTS-RL 训出的 Planner 能套到训练时没见过的 Executor 上------更大的推理模型 +4.4 pass@64,用多样性 RL 训过的 Executor 也 +4.4。说明它和「Executor 侧改进」是互补而非替代关系。
- 可叠加:既然 Planner 层和 Executor 层解耦,你完全可以先把底层模型训得更强,再在上面叠一层 PTTS,两层收益互不抵消。
四、理想丰满,现实骨感:N 个工程死结
专业度的来源就在这里------PTTS 不是银弹。
- 长输出会「跑题」:大纲只是软约束。Executor 在长链思维里仍可能偏离初始大纲,一旦跑偏,所谓「互补路径」就名存实亡。论文自己也点出这是未跨过的门槛。
- Planner 有天花板:PTTS-ZS 的收益依赖基础模型本身的多样性。若 Planner 太弱,生成的大纲并不真正互补,增益就缩水。零样本版的上限,本质上受限于你手头那个「会写大纲」的模型。
- 评测面太窄 :五个基准全是数学推理。它能否迁移到代码、开放问答、Agent 工具调用等「分支间依赖更强、验证更模糊」的场景,尚无可信证据。
- k 不能无限大:联合生成 k 份大纲本身有成本,且分支过多时协调收益递减。它不是「k 越大越好」的免费午餐。
五、解法与缓解
- PTTS-RL 的截断预算本身就是对症药:通过禁止 Executor 用更长思考兜底,强迫 Planner 学会「写好大纲」而非「甩锅给执行」。
- Executor 侧多样性 RL 与 PTTS 互补,两层一起上能逼近更高 ceiling。
- Planner 保持轻量:它不需要是大模型,一个基础 LLM 足以,部署成本低。
六、生产现实:真正跑起来是什么样
PTTS 的最佳定位是「架在现有推理模型上的推理时包装层」------你不用重训那个贵的大模型,只需挂一个轻量 Planner(甚至零样本 prompt 基础模型)。
markdown
你在用 best-of-N 吗?
├─ 否 → 先上 best-of-N 拿到基础收益
└─ 是 → 你的题是否需要「互补思路」才覆盖正确解?
         ├─ 否(单主导路径)→ 重复采样已够,PTTS 增益有限
         └─ 是 → 上 PTTS:
               ├─ 想要零改动 → PTTS-ZS(prompt 基础模型当 Planner)
               └─ 想要极致效率 → PTTS-RL(训一个小 Planner,半预算超基线)
什么场景赚 :问题有多种有效推理模式、你有固定算力预算、且已经在做 best-of-N。此时 PTTS 严格占优。 什么场景亏:任务只有单一解法路径(塌缩不伤)、或 Executor 本身太弱(规划救不了执行)------「给弱模型发好大纲,它也走不到答案」。
七、我的判断
测试时计算正在从「堆采样」变成一门工程学科 :规划(让分支互补)、预算(决定算多少)、选择(用验证器挑)三者分离。PTTS 贡献的是一个清晰的协调层,它和 Executor 改进、验证器选择是正交的三件事,可以叠加。
最值得盯的下一个信号:RL 训出来的 Planner 能否根据问题难度自适应调整大纲多样性------简单的题少分支、难的题多分支,把「该分配多少算力给规划」也变成可学出来的策略。
参考与数据来源:arXiv 2609.27374(Planned Test-Time Scaling with Coordinated Reasoning Paths,UCLA,2026-09-23 提交,未 peer-review);关键数字(pass@64 +6.7 / +13.4、半预算 2× 效率、迁移 +4.4)均来自论文摘要与正文报告。评测基于 Qwen3-1.7B/4B 与五个数理基准,迁移结论来自论文 transfer 实验。本文为技术解读,落地前请以原论文与你的实测为准。