任务类型:单类别目标检测(玉米雄穗 tassel)
运行环境:Windows 11 + CPU(Intel i7 12线程,无GPU)
全部代码与图表均由本地实测产出,可直接复现。
目录
- [1. 项目背景](#1. 项目背景)
- [2. 数据集介绍](#2. 数据集介绍)
- [3. 技术工具](#3. 技术工具)
- [4. 实验过程](#4. 实验过程)
- [4.1 导入数据](#4.1 导入数据)
- [4.2 数据预处理](#4.2 数据预处理)
- [4.3 数据可视化](#4.3 数据可视化)
- [4.4 构建模型](#4.4 构建模型)
- [4.5 训练模型](#4.5 训练模型)
- [4.6 模型评估](#4.6 模型评估)
- [4.7 推理与测试](#4.7 推理与测试)
- [5. 遇到的坑与解决方案](#5. 遇到的坑与解决方案)
- [6. 总结与展望](#6. 总结与展望)
1. 项目背景
玉米是我国种植面积最大的粮食作物之一,而玉米制种产业是整个玉米生产链的基础保障。
在玉米杂交制种过程中,有一个非常关键、也非常耗费人力的环节------母本去雄(Detasseling)。玉米是雌雄同株异花作物,顶部出的雄穗(tassel)负责散粉。制种时必须把母本行的雄穗在散粉前拔掉,否则母本自花授粉,种子纯度直接报废。
传统做法是人工下田逐株检查、手工拔除,问题很明显:
- 时效性差:雄穗散粉窗口期短,人工巡田跟不上;
- 漏检率高:一支漏掉的雄穗就可能污染一整片制种田;
- 人力成本高:大规模制种基地动辄上千亩。
虽然"不育系"制种技术省去了人工去雄,但在普及过程中,准确识别母本去雄后残留的雄穗依然是保障种子纯度的重要手段。于是问题就变成了一个典型的计算机视觉任务:
给定一张田间玉米照片,自动检测出图中所有雄穗的位置。
这个问题有几个特点,使它比一般的"日常物体检测"更难:
- 小目标:单张图片 2736×1824 像素,而一个雄穗只占整图面积的 0.2%~0.3%,绝大多数目标面积不足 1%;
- 密集重叠 :密植田块中一张图最多能数出 111 个雄穗,相互遮挡严重;
- 背景复杂:光照、天气、拍摄角度、生育期差异大;
- 类别单一但形态多变:只有一个"雄穗"类,但外观随品种、生长期变化。
本博客用 YOLOv8n 在 CPU 上完成这个数据集的完整训练流程,记录从下载数据、EDA、训练、评估到推理测试的全部步骤,供同样想入门农业目标检测的同学参考。
2. 数据集介绍
2.1 基本信息
| 项目 | 内容 |
|---|---|
| 数据集名称 | 玉米雄穗识别_数据集 |
| 来源 | 飞桨 AI Studio 星河社区(数据集 ID 296690) |
| 作者 / 许可 | konka812 / CC0(可自由使用) |
| 任务类型 | 目标检测(Object Detection) |
| 标注格式 | YOLO 格式(txt 归一化坐标) |
| 图片数量 | 244 张 |
| 图片分辨率 | 统一 2736 × 1824(约 500 万像素) |
| 类别数 | 1 类:tas(tassel,玉米雄穗) |
| 标注框总数 | 1536 个 |
| 数据集体积 | 约 232 MB |
数据集官方描述:
随着中国经济发展和人口增长,对农业生产的需求不断增加,玉米作为重要的粮食作物之一,一直处于国家粮食安全和生态保护的重要位置。玉米制种产业是玉米生产的基础保障。随着玉米制种技术的不断发展,不育系生产由于无需去雄,节省劳动力,已经越来越普及。在玉米种子生产过程中,母本去雄作为种子纯度保障至关重要的环节,准确识别母本去雄后残留雄穗并去除是提升种子质量的重要手段。
2.2 数据集目录结构
从 AI Studio 下载后(仓库 repo_id 为 knoka/qdBwZZcB),解压得到的标准 YOLO 目录:
text
data/
└── train/
    └── train/
        ├── classes.txt          # 内容只有一行: tas
        ├── images/              # 244 张 .jpg
        │   ├── image_0001.jpg
        │   ├── image_0002.jpg
        │   └── ...
        └── labels/              # 与图片同名的 .txt 标注
            ├── image_0001.txt   # 每行: class cx cy w h (归一化)
            ├── image_0002.txt   # 0 字节 = 背景图(图中无雄穗)
            └── ...
YOLO 标注格式说明------每一行代表一个目标:
text
<class_id> <center_x> <center_y> <width> <height>其中后四个值都是相对于整图宽高归一化到 0~1 的坐标,cx cy 是目标框中心点(不是左上角)。
2.3 数据集的两个重要特点
在真正动手之前,我先统计了一下标注,发现两个对建模策略影响很大的事实:
- 42 张图片的标注文件是 0 字节 ,即图中没有雄穗。这些不是"坏数据",而是背景负样本,保留它们可以显著降低误检率;
- 96.8% 的雄穗框面积不足整图的 1%,属于典型的小目标检测问题(详见 4.3 节图表)。
3. 技术工具
3.1 软件环境
| 组件 | 版本 | 用途 |
|---|---|---|
| Python | 3.13.12 | 运行环境 |
| Ultralytics | 8.4.164 | YOLOv8 训练/评估/推理框架 |
| PyTorch | 2.x (CPU) | 深度学习后端 |
| OpenCV (opencv-python) | 4.x | 图像读取与绘制 |
| Matplotlib | 3.x | EDA 图表绘制 |
| aistudio-sdk | latest | 从 AI Studio 命令行下载数据集 |
一键安装依赖:
bash
pip install ultralytics opencv-python matplotlib aistudio-sdk3.2 硬件环境
| 项目 | 配置 |
|---|---|
| CPU | Intel Core i7(6 核 12 线程) |
| 内存 | 16 GB |
| GPU | 无(纯 CPU 训练) |
| 操作系统 | Windows 11 |
没有 GPU 也能做目标检测,只是要控制好训练规模。后面 4.5 节会给出 CPU 训练的耗时基准测试方法。
3.3 为什么选 YOLOv8n
- n 版本(nano)参数量最小(约 3.2M),CPU 上训练和推理都扛得住;
- Anchor-Free + 解耦头,对形态多变、密集分布的植物器官友好;
- Ultralytics 一行代码完成训练/评估/推理,对新手非常友好;
- 支持 COCO 预训练权重迁移学习,小数据集也能收敛。
4. 实验过程
4.1 导入数据
4.1.1 方式一:aistudio-sdk 命令行下载(推荐)
bash
pip install aistudio-sdk
aistudio download --dataset knoka/qdBwZZcB --local_dir ./data
注意:
--dataset后面要填数据集详情页里的 repo_id (knoka/qdBwZZcB这种用户名/仓库名格式),而不是网址里的数字 ID
296690,用数字 ID 会报repo not found。
4.1.2 方式二:Python SDK 下载
实际下载时我遇到一个必踩的坑:AI Studio 的 BOS CDN 要求请求带 Referer 头,SDK 默认不带,所有大文件都会 403 ,报错里能看到 X-Error-Info: EmptyReferer。
解决办法是给 requests 打个全局补丁:
python
# download_dataset.py
import requests

_orig = requests.sessions.Session.request

def _patched(self, method, url, *args, **kwargs):
    h = dict(kwargs.pop("headers", None) or {})
    h.setdefault("Referer", "https://aistudio.baidu.com/")
    return _orig(self, method, url, *args, headers=h, **kwargs)

requests.sessions.Session.request = _patched

from aistudio_sdk.snapshot_download import snapshot_download

REPO = "knoka/qdBwZZcB"
LOCAL = "./data"

res = snapshot_download(repo_id=REPO, local_dir=LOCAL, repo_type="dataset")
print("下载完成 ->", res)
运行 python download_dataset.py,244 张图片 + 标注文件约 3 分钟下完。
补充:如果个别文件下载失败(比如最后发现有 3 张图片缺失),可以直接走
https://git.aistudio.baidu.com/api/v1/repos/{repo_id}/media/{文件相对路径}这个接口补下,记得同样要带
Referer头。
4.1.3 校验导入结果
python
from pathlib import Path

img_dir = Path("data/train/train/images")
lbl_dir = Path("data/train/train/labels")

imgs = {p.stem for p in img_dir.iterdir() if p.suffix.lower() in {".jpg", ".jpeg", ".png"}}
lbls = {p.stem for p in lbl_dir.iterdir() if p.suffix == ".txt"}
print("图片数:", len(imgs))   # 244
print("标注数:", len(lbls))   # 244
print("类别文件:", (Path("data/train/train/classes.txt")).read_text()) # tas输出确认:244 张图片、244 个标注文件、单一类别 tas。
4.2 数据预处理
原始数据已经是 YOLO 格式,不需要做 COCO→YOLO 的坐标转换,但仍有四件事必须做:
① 合法性清洗;② 决定背景图去留;③ 划分训练/验证集;④ 生成 dataset.yaml。
完整脚本 01_prepare.py:
python
# -*- coding: utf-8 -*-
import random, shutil
from pathlib import Path
import cv2

ROOT = Path(__file__).resolve().parent
SRC_IMG = ROOT / "data" / "train" / "train" / "images"
SRC_LBL = ROOT / "data" / "train" / "train" / "labels"
DST = ROOT / "dataset"

CLASSES = ["tas"]     # classes.txt 里只有一类
SEED, VAL_RATIO = 42, 0.2
random.seed(SEED)

# ---------- 1. 扫描 ----------
images = sorted(p for p in SRC_IMG.iterdir()
                if p.suffix.lower() in {".jpg", ".jpeg", ".png"})

# ---------- 2. 清洗 ----------
records, broken_box, n_bg, total_boxes = [], 0, 0, 0
for img_p in images:
    boxes = []
    txt_p = SRC_LBL / (img_p.stem + ".txt")
    if txt_p.exists():
        for line in txt_p.read_text(encoding="utf-8").strip().splitlines():
            parts = line.split()
            if len(parts) != 5:
                continue
            try:
                c = int(float(parts[0]))
                cx, cy, bw, bh = map(float, parts[1:])
            except ValueError:
                continue
            # 归一化坐标合法性检查
            if not (0 <= cx <= 1 and 0 <= cy <= 1) or not (0 < bw <= 1 and 0 < bh <= 1):
                broken_box += 1
                continue
            boxes.append((c, cx, cy, bw, bh))
    if not boxes:          # 0 字节 txt = 背景图,保留为负样本
        n_bg += 1
    total_boxes += len(boxes)
    records.append((img_p, boxes))

# ---------- 3. 划分 train/val ----------
random.shuffle(records)
n_val = int(len(records) * VAL_RATIO)
val_rec, train_rec = records[:n_val], records[n_val:]

# ---------- 4. 落盘(必须先清空,避免残留旧文件混进训练) ----------
if DST.exists():
    shutil.rmtree(DST)
for split in ("train", "val"):
    (DST / "images" / split).mkdir(parents=True)
    (DST / "labels" / split).mkdir(parents=True)

def dump(recs, split):
    for img_p, boxes in recs:
        shutil.copy2(img_p, DST / "images" / split / img_p.name)
        with open(DST / "labels" / split / (img_p.stem + ".txt"), "w") as f:
            for c, cx, cy, bw, bh in boxes:
                f.write(f"{c} {cx:.6f} {cy:.6f} {bw:.6f} {bh:.6f}\n")

dump(train_rec, "train")
dump(val_rec, "val")

# ---------- 5. 生成 dataset.yaml ----------
(ROOT / "corn.yaml").write_text(f"""# 玉米雄穗检测数据集
path: {(ROOT / 'dataset').as_posix()}
train: images/train
val: images/val

nc: {len(CLASSES)}
names: {CLASSES}
""", encoding="utf-8")
运行结果:
text
[1] 原始图片数量: 244
[2] 有效图片: 244 | 其中背景图(无雄穗): 42 | 非法框: 0
    标注框总数: 1536
[3] 划分 -> train: 196  val: 48
[6] 分辨率: 2736x1824(所有图片一致)
几个值得强调的细节
- 背景图不要扔。42 张 0 字节标注的图片是"田间但无雄穗"的真实负样本,Ultralytics 会把它们当作无目标图片参与训练,能有效抑制误检;
- 重新生成子集前必须清空
images/和labels/,否则上一次运行的残留图片会被训练进去,这是个非常隐蔽的 bug; - 坐标合法性检查虽然这份数据没查出非法框(0 个),但写上保险,换数据集时能立刻暴露问题;
corn.yaml里的path一定要写绝对路径 (用Path.as_posix()转成正斜杠),写相对路径在 Windows 上经常报Dataset not found。
4.3 数据可视化
可视化脚本是 02_eda.py,核心是把 YOLO 归一化坐标还原回像素坐标:
python
# YOLO: (cls, cx, cy, w, h) 归一化 -> 像素坐标
x1 = (cx - w / 2) * W
y1 = (cy - h / 2) * H
x2 = (cx + w / 2) * W
y2 = (cy + h / 2) * H
提示:中文字体记得设置
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"],否则标题全是方框;OpenCV 画框颜色是 BGR 顺序。
图1 每张图片雄穗数量分布
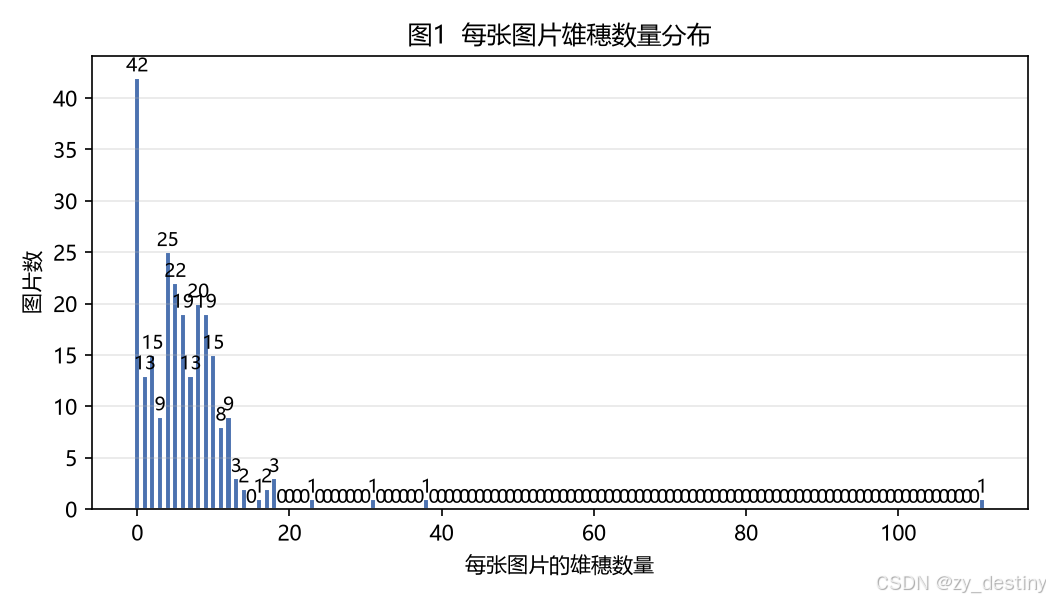
244 张图共 1536 个雄穗,平均每张 6.3 个 ,最多的一张密密麻麻 111 个,另有 42 张为 0(背景图)。分布呈明显长尾------多数图只有零星几支,少数密植图数量爆炸,这对 NMS 阈值和召回率都是考验。
图2 标注框尺寸分布(对数坐标)
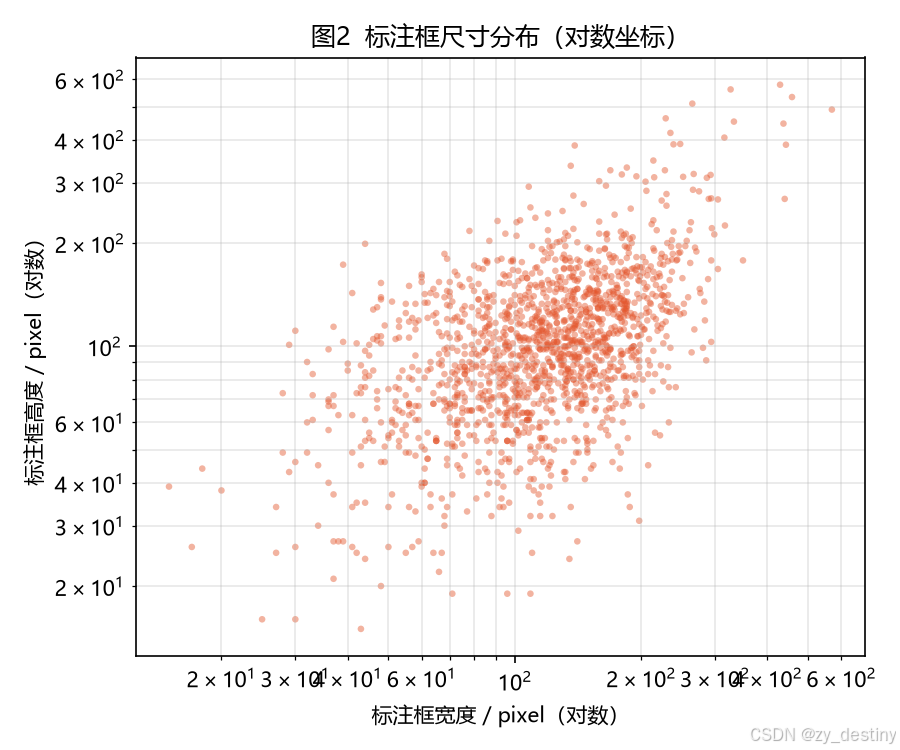
横纵轴都取对数后可以看到雄穗框宽高大多集中在 50~300 像素 区间,而原图是 2736×1824,也就是说缩放到 640×427 后,雄穗只剩 12~70 像素------确实是小目标。
图3 雄穗中心点空间分布热力图
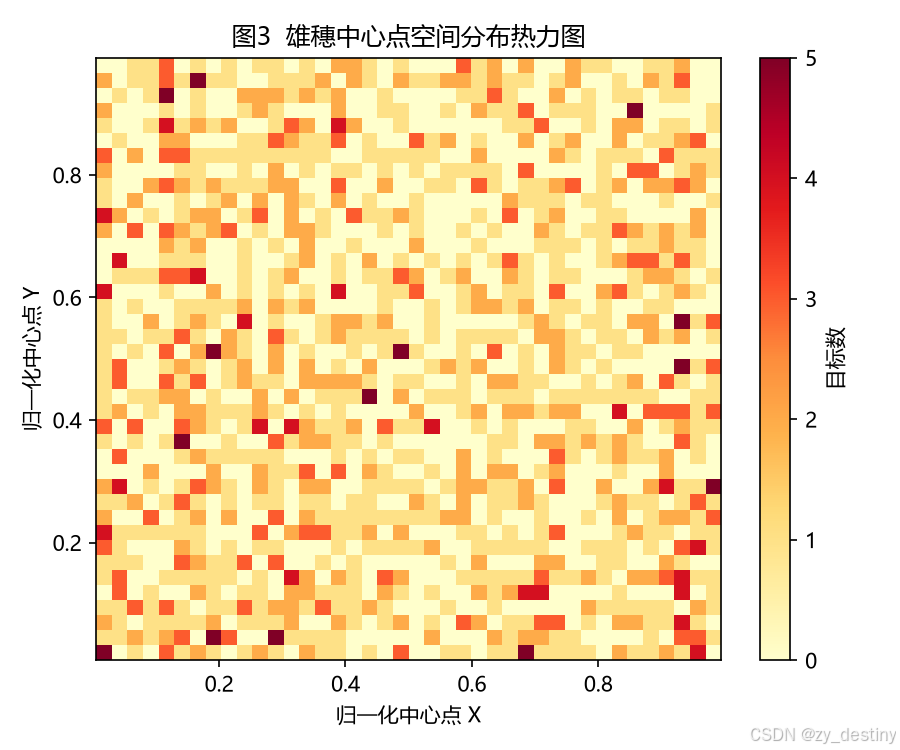
中心点集中分布在图像上半部分(雄穗长在植株顶部),下半部分几乎为空。这符合农学常识,也说明数据没有明显的"标注偏移"。
图4 目标面积占比与宽高比
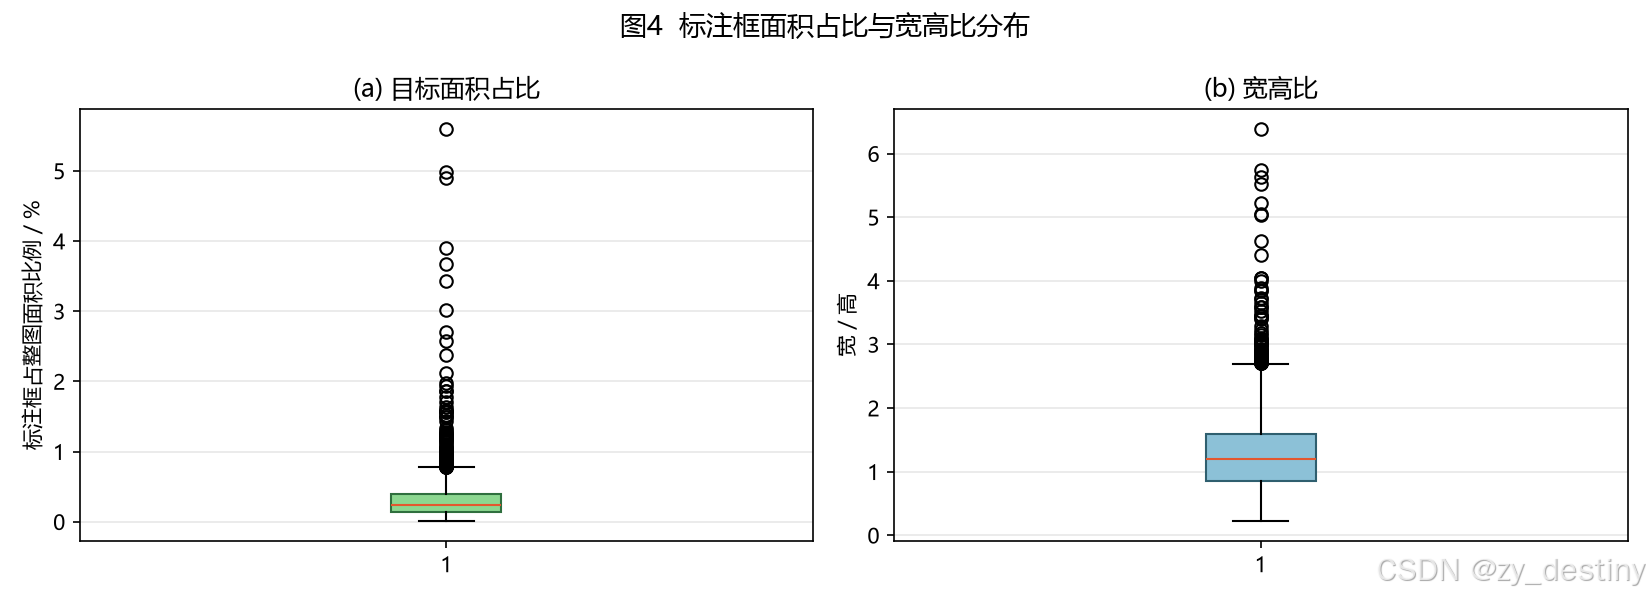
- 面积占比中位数 0.239% ,96.8% 的雄穗框面积不足整图 1% → 典型小目标;
- 宽高比大多在 1.0~2.0 之间(雄穗近圆锥形、略偏横向展开)。
图5 训练样本标注可视化(随机 9 张)
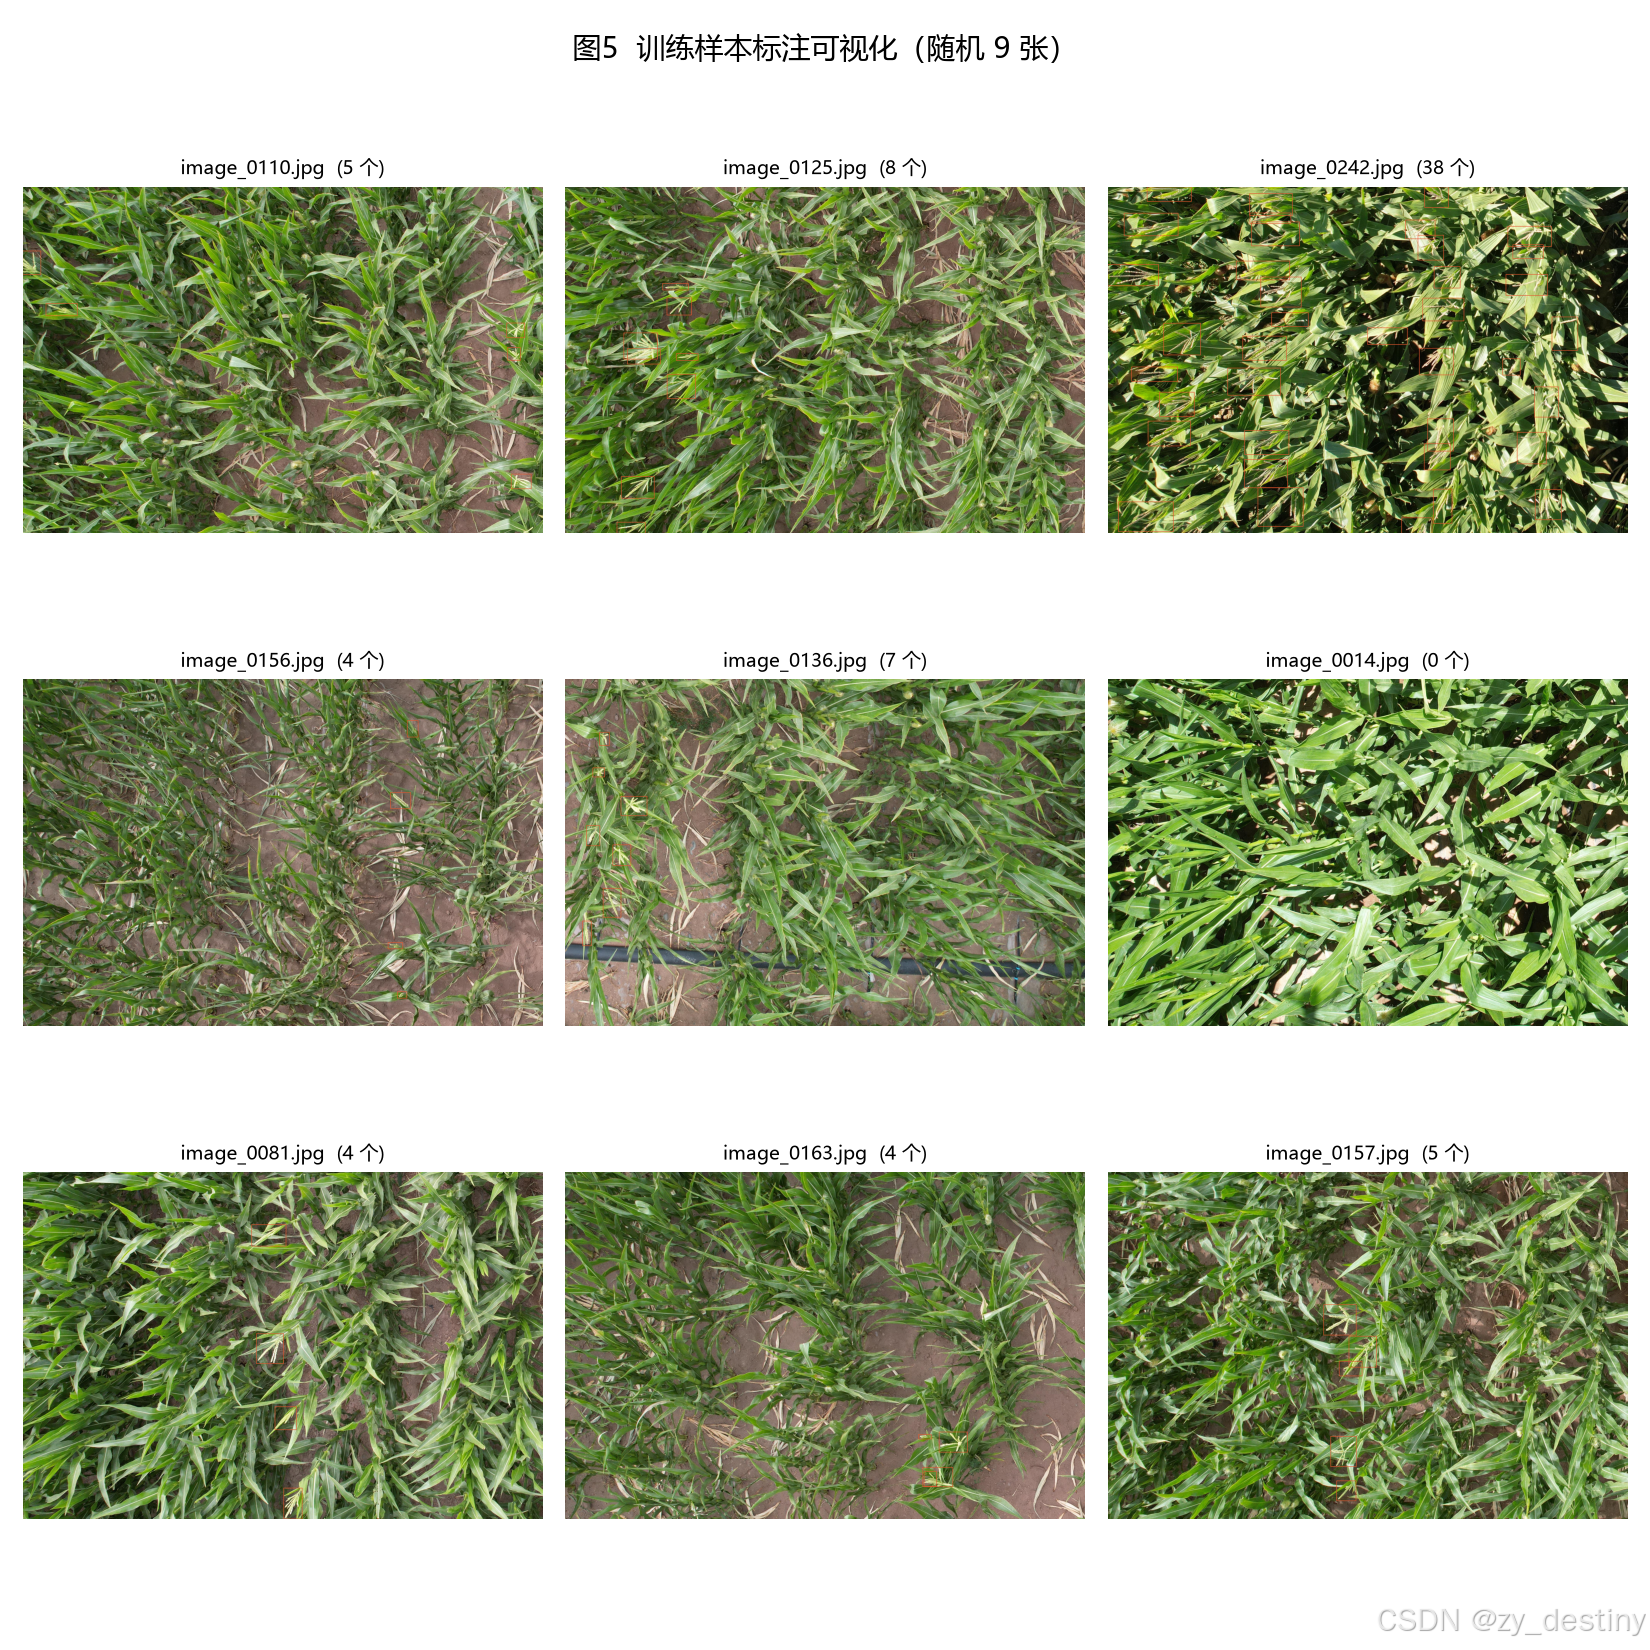
抽查人工标注质量:框贴合、无明显漏标/错标。同时能看到田间真实场景------逆光、遮挡、远景密植、不同生育期都有覆盖。
EDA 结论 :小目标 + 密集 + 类别单一。应对策略:
① 用 640 输入尺寸(再大会拖垮 CPU);② 关闭过强的 mosaic/agumentation 中会过度裁剪小目标的项;
③ 训练时保留背景负样本降低误检。
4.4 构建模型
4.4.1 YOLOv8 结构一览
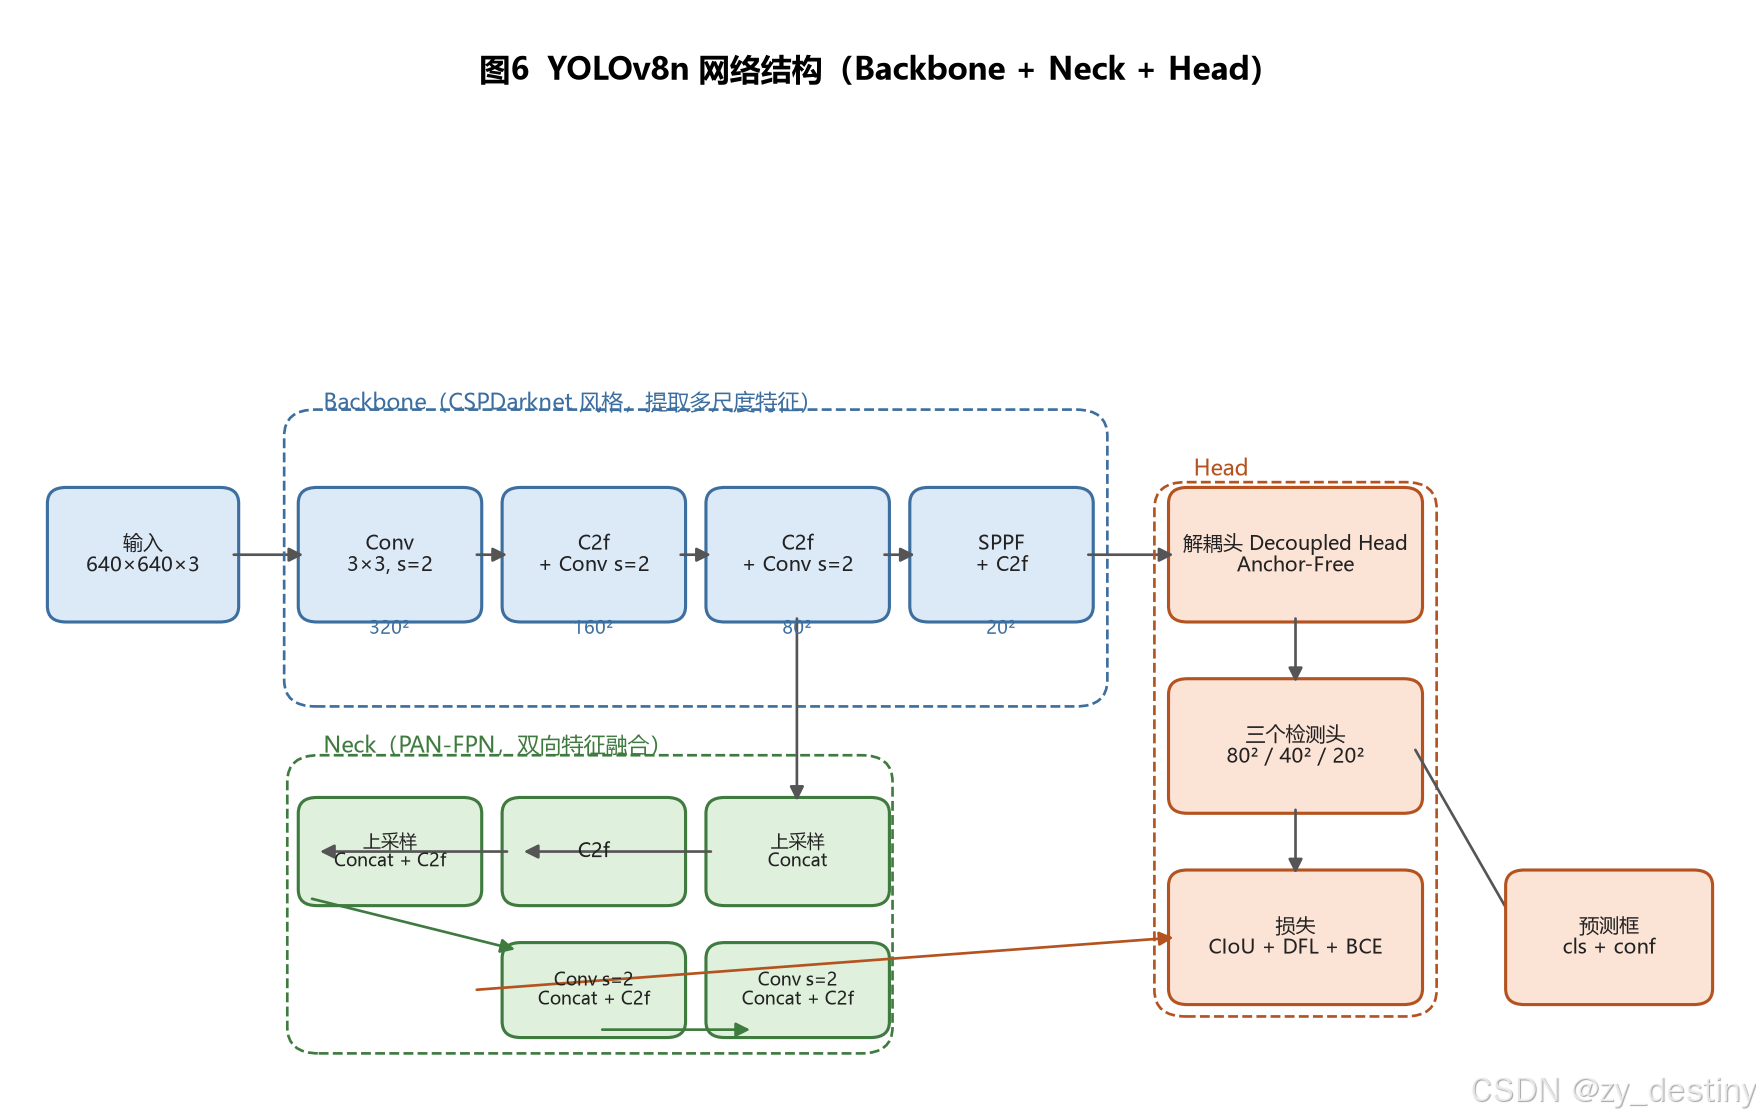
YOLOv8 延续了 Backbone + Neck + Head 三段式:
| 模块 | 组成 | 作用 |
|---|---|---|
| Backbone | CSPDarknet 风格的 Conv + C2f + SPPF |
提取多尺度特征,C2f 是 v8 的新模块(比 v5 的 C3 梯度流更丰富) |
| Neck | PAN-FPN 双向融合 | 自顶向下 + 自底向上融合,让深层语义帮浅层细节 |
| Head | Anchor-Free 解耦头 | 分类与回归分支分开,直接在三个尺度(80²/40²/20²)上预测 |
| 损失 | CIoU + DFL + BCE | 分类用 BCE,回归用 CIoU + Distribution Focal Loss |
相比 YOLOv5,v8 的关键变化是 去掉 anchor 机制 (不用预置先验框)、解耦头 、正负样本分配改为 TAL(Task-Aligned Assigner),对小目标和密集场景更友好。
4.4.2 两行代码构建模型
Ultralytics 把构建过程简化到极致:
python
from ultralytics import YOLO

model = YOLO("weights/yolov8n.pt")   # 加载 COCO 预训练权重
这一行做了三件事:解析 yaml → 搭建 3.2M 参数的 nano 网络 → 加载 COCO 80 类预训练权重。
迁移学习是关键:244 张图从零训练几乎不可能收敛,但 COCO 权重已经学会边缘、纹理、形状等通用视觉特征,雄穗检测可以直接站在它的肩膀上。
yolov8n.yaml 的规模(模型自带打印):
text
YOLOv8n summary: 225 layers, 3,157,200 parameters, 0 gradients, 8.9 GFLOPs4.4.3 训练前的环境配置(Windows 必看)
bash
# 避免 Ultralytics 往 AppData 写 settings.json 失败
export YOLO_CONFIG_DIR=./.ultralytics
# 避免 matplotlib 缓存目录写失败
export MPLCONFIGDIR=./.mpl
# bash 里中文不乱码
export PYTHONIOENCODING=utf-8
这三个环境变量帮我省掉了 Windows 上最常见的一类"权限拒绝"报错。
4.5 训练模型
4.5.1 先跑基准,再定 epochs(CPU 训练铁律)
CPU 上训练最怕"拍脑袋定 epochs 然后跑一晚上"。正确姿势是先跑 2 个 epoch 测速:
bash
python 03_train.py --epochs 2 --name bench实测本机(i7 12 线程,imgsz=640,batch=8):
| 阶段 | 耗时 |
|---|---|
| 1 个 train epoch(196 张) | ≈ 55 s |
| 1 次验证(48 张) | ≈ 10 s |
| 合计单 epoch | ≈ 65 s |
经验公式:
单epoch耗时(分钟) ≈ 图片数 × (imgsz/640)² × 3.7 / 1000196 张 @ 640 → 约 0.72 min,和实测吻合。
由此推算 100 epochs 约 100 分钟,可以接受,于是定 epochs=100, patience=25(早停兜底)。
实测 100 epochs 共耗时 78 分钟 (Ultralytics 打印 100 epochs completed in 1.300 hours),
比估算快,是因为部分 epoch 验证跳过 + IO 缓存热了。
4.5.2 正式训练脚本
python
# 03_train.py
import argparse, time
from pathlib import Path
import torch
from ultralytics import YOLO

ROOT = Path(__file__).resolve().parent

model = YOLO(str(ROOT / "weights" / "yolov8n.pt"))

t0 = time.time()
model.train(
    data=str(ROOT / "corn.yaml"),
    epochs=100,
    imgsz=640,            # 原图2736x1824,缩到640兼顾小目标与CPU算力
    batch=8,              # CPU 内存友好
    device="cpu",
    workers=4,
    optimizer="auto",
    lr0=0.01, lrf=0.01,   # 初始lr & 最终lr比例
    momentum=0.937,
    weight_decay=0.0005,
    patience=25,          # 25个epoch无提升则早停
    amp=False,            # CPU下关闭混合精度
    cos_lr=True,          # 余弦退火学习率
    seed=42,
    project=str(ROOT / "runs"),
    name="corn_yolov8n",
    plots=True,           # 自动生成 results.png / PR曲线 / 混淆矩阵
)
print(f"训练总耗时: {(time.time()-t0)/60:.1f} min")
4.5.3 关键超参数说明
| 参数 | 取值 | 理由 |
|---|---|---|
imgsz=640 |
640 | 雄穗是小目标,理想上想用 960+,但 CPU 算力不允许;640 下雄穗仍有 12~70 px,可检测 |
batch=8 |
8 | CPU 内存与速度折中 |
amp=False |
--- | CPU 不支持 AMP,开着反而报错 |
cos_lr=True |
--- | 余弦退火比线性下降收敛更稳 |
patience=25 |
25 | 数据集小,容易过拟合,早停兜底 |
seed=42 |
42 | 结果可复现 |
pretrained |
yolov8n.pt | COCO 迁移学习,小数据集的命脉 |
4.5.4 训练过程监控
后台运行并重定向日志:
bash
python 03_train.py --epochs 100 --name corn_yolov8n > train.log 2>&1 &训练过程-loss 变化(真实记录,来自 results.csv):
text
Epoch   1/100  box_loss 3.630  cls_loss 4.336  dfl_loss 2.041  | P 0.001  R 0.045  mAP50 0.000
Epoch  10/100  box_loss 2.356  cls_loss 2.083  dfl_loss 1.321  | P 0.500  R 0.397  mAP50 0.405
Epoch  30/100  box_loss 2.074  cls_loss 1.527  dfl_loss 1.228  | P 0.797  R 0.554  mAP50 0.635
Epoch  50/100  box_loss 1.938  cls_loss 1.286  dfl_loss 1.186  | P 0.798  R 0.607  mAP50 0.709
Epoch  70/100  box_loss 1.808  cls_loss 1.160  dfl_loss 1.145  | P 0.855  R 0.688  mAP50 0.771
Epoch 100/100  box_loss 1.596  cls_loss 1.059  dfl_loss 1.081  | P 0.811  R 0.647  mAP50 0.754
小技巧:Ultralytics 会把每个 epoch 的指标写进
runs/corn_yolov8n/results.csv,训练中随时
tail -f或用 pandas 读它看曲线,不用等跑完。
4.5.5 训练曲线
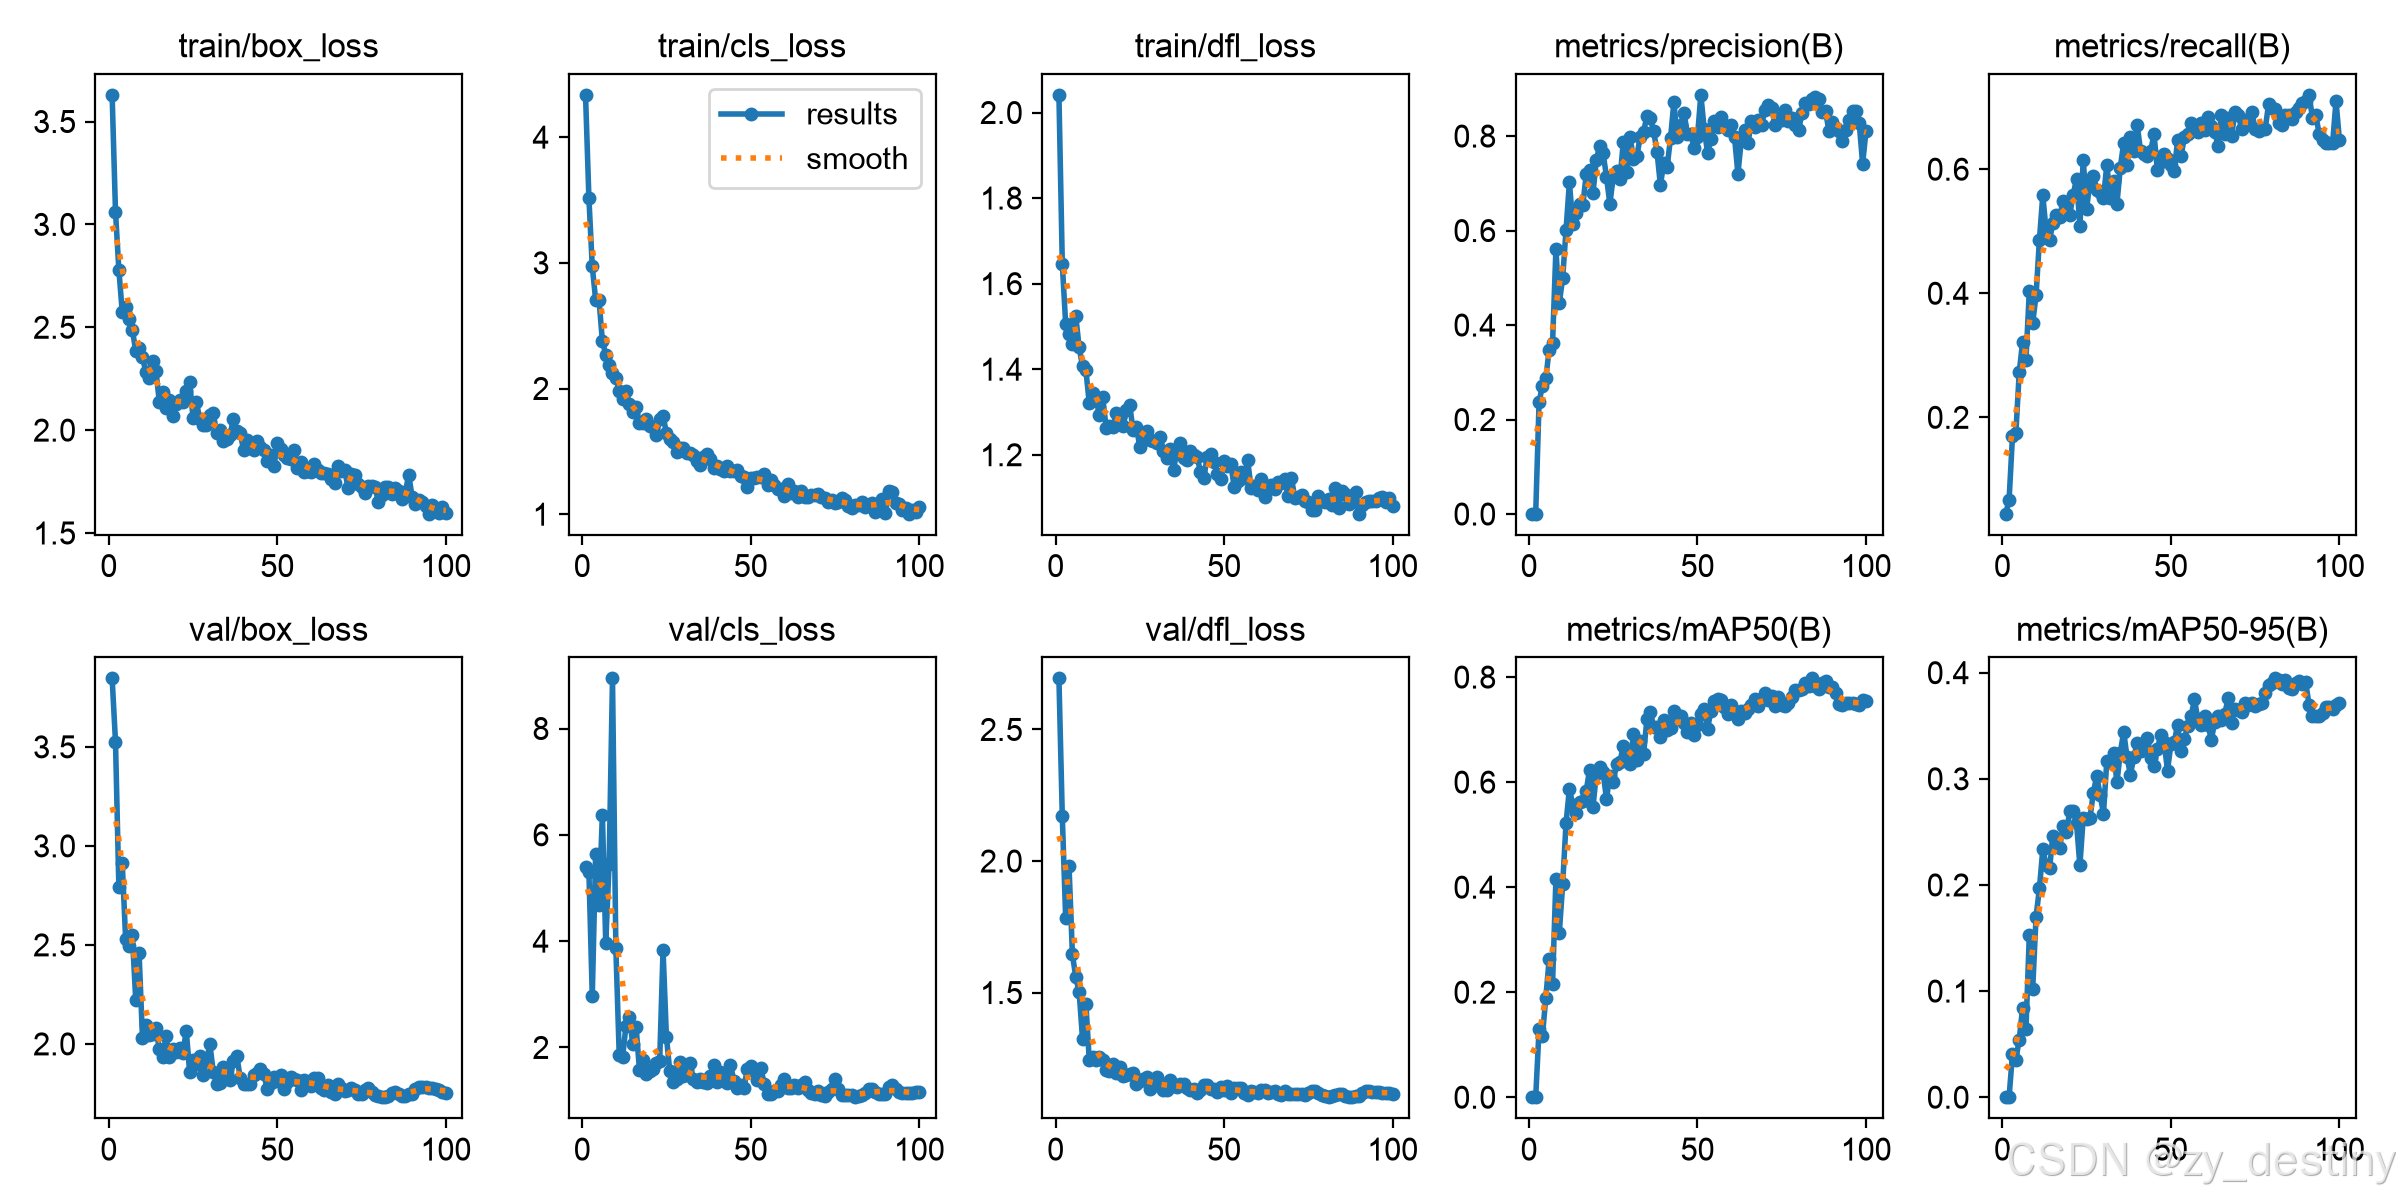
可以清楚看到:
train/box_loss、cls_loss、dfl_loss三条训练损失都单调下降后趋平;- 验证侧
metrics/mAP50与mAP50-95一路爬升,后期进入平台期;patience=25是早停兜底,本次 100 个 epoch 全跑完也没有触发,说明没有明显过拟合; - 学习率按余弦退火平滑衰减到 0。
4.6 模型评估
训练完成后最优权重保存在 runs/corn_yolov8n/weights/best.pt。评估脚本:
python
from ultralytics import YOLO

model = YOLO("runs/corn_yolov8n/weights/best.pt")
metrics = model.val(data="corn.yaml", imgsz=640, split="val", device="cpu")

print("Precision :", metrics.box.mp)
print("Recall    :", metrics.box.mr)
print("mAP@0.5   :", metrics.box.map50)
print("mAP@.5:.95:", metrics.box.map)
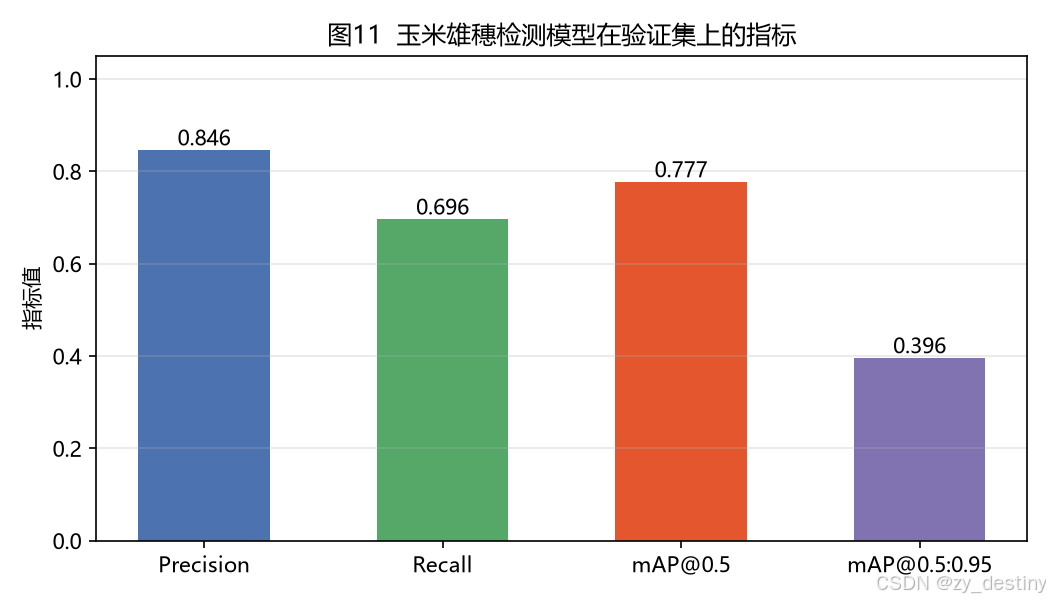
验证集(48 张、224 个雄穗实例)最终指标:
| 指标 | 数值 | 含义 |
|---|---|---|
| Precision | 0.8461 | 预测出的框里有多少是对的 |
| Recall | 0.6964 | 真实雄穗里被找出来的比例 |
| mAP@0.5 | 0.7773 | IoU=0.5 下的平均精度 |
| mAP@0.5:0.95 | 0.3959 | IoU 从 0.5~0.95 十档平均(更严格) |
顺便说明:训练结束时 Ultralytics 自动打印的速度是
0.7ms preprocess + 25.9ms inference + 1.2ms postprocess(CPU i7-8700)。
PR 曲线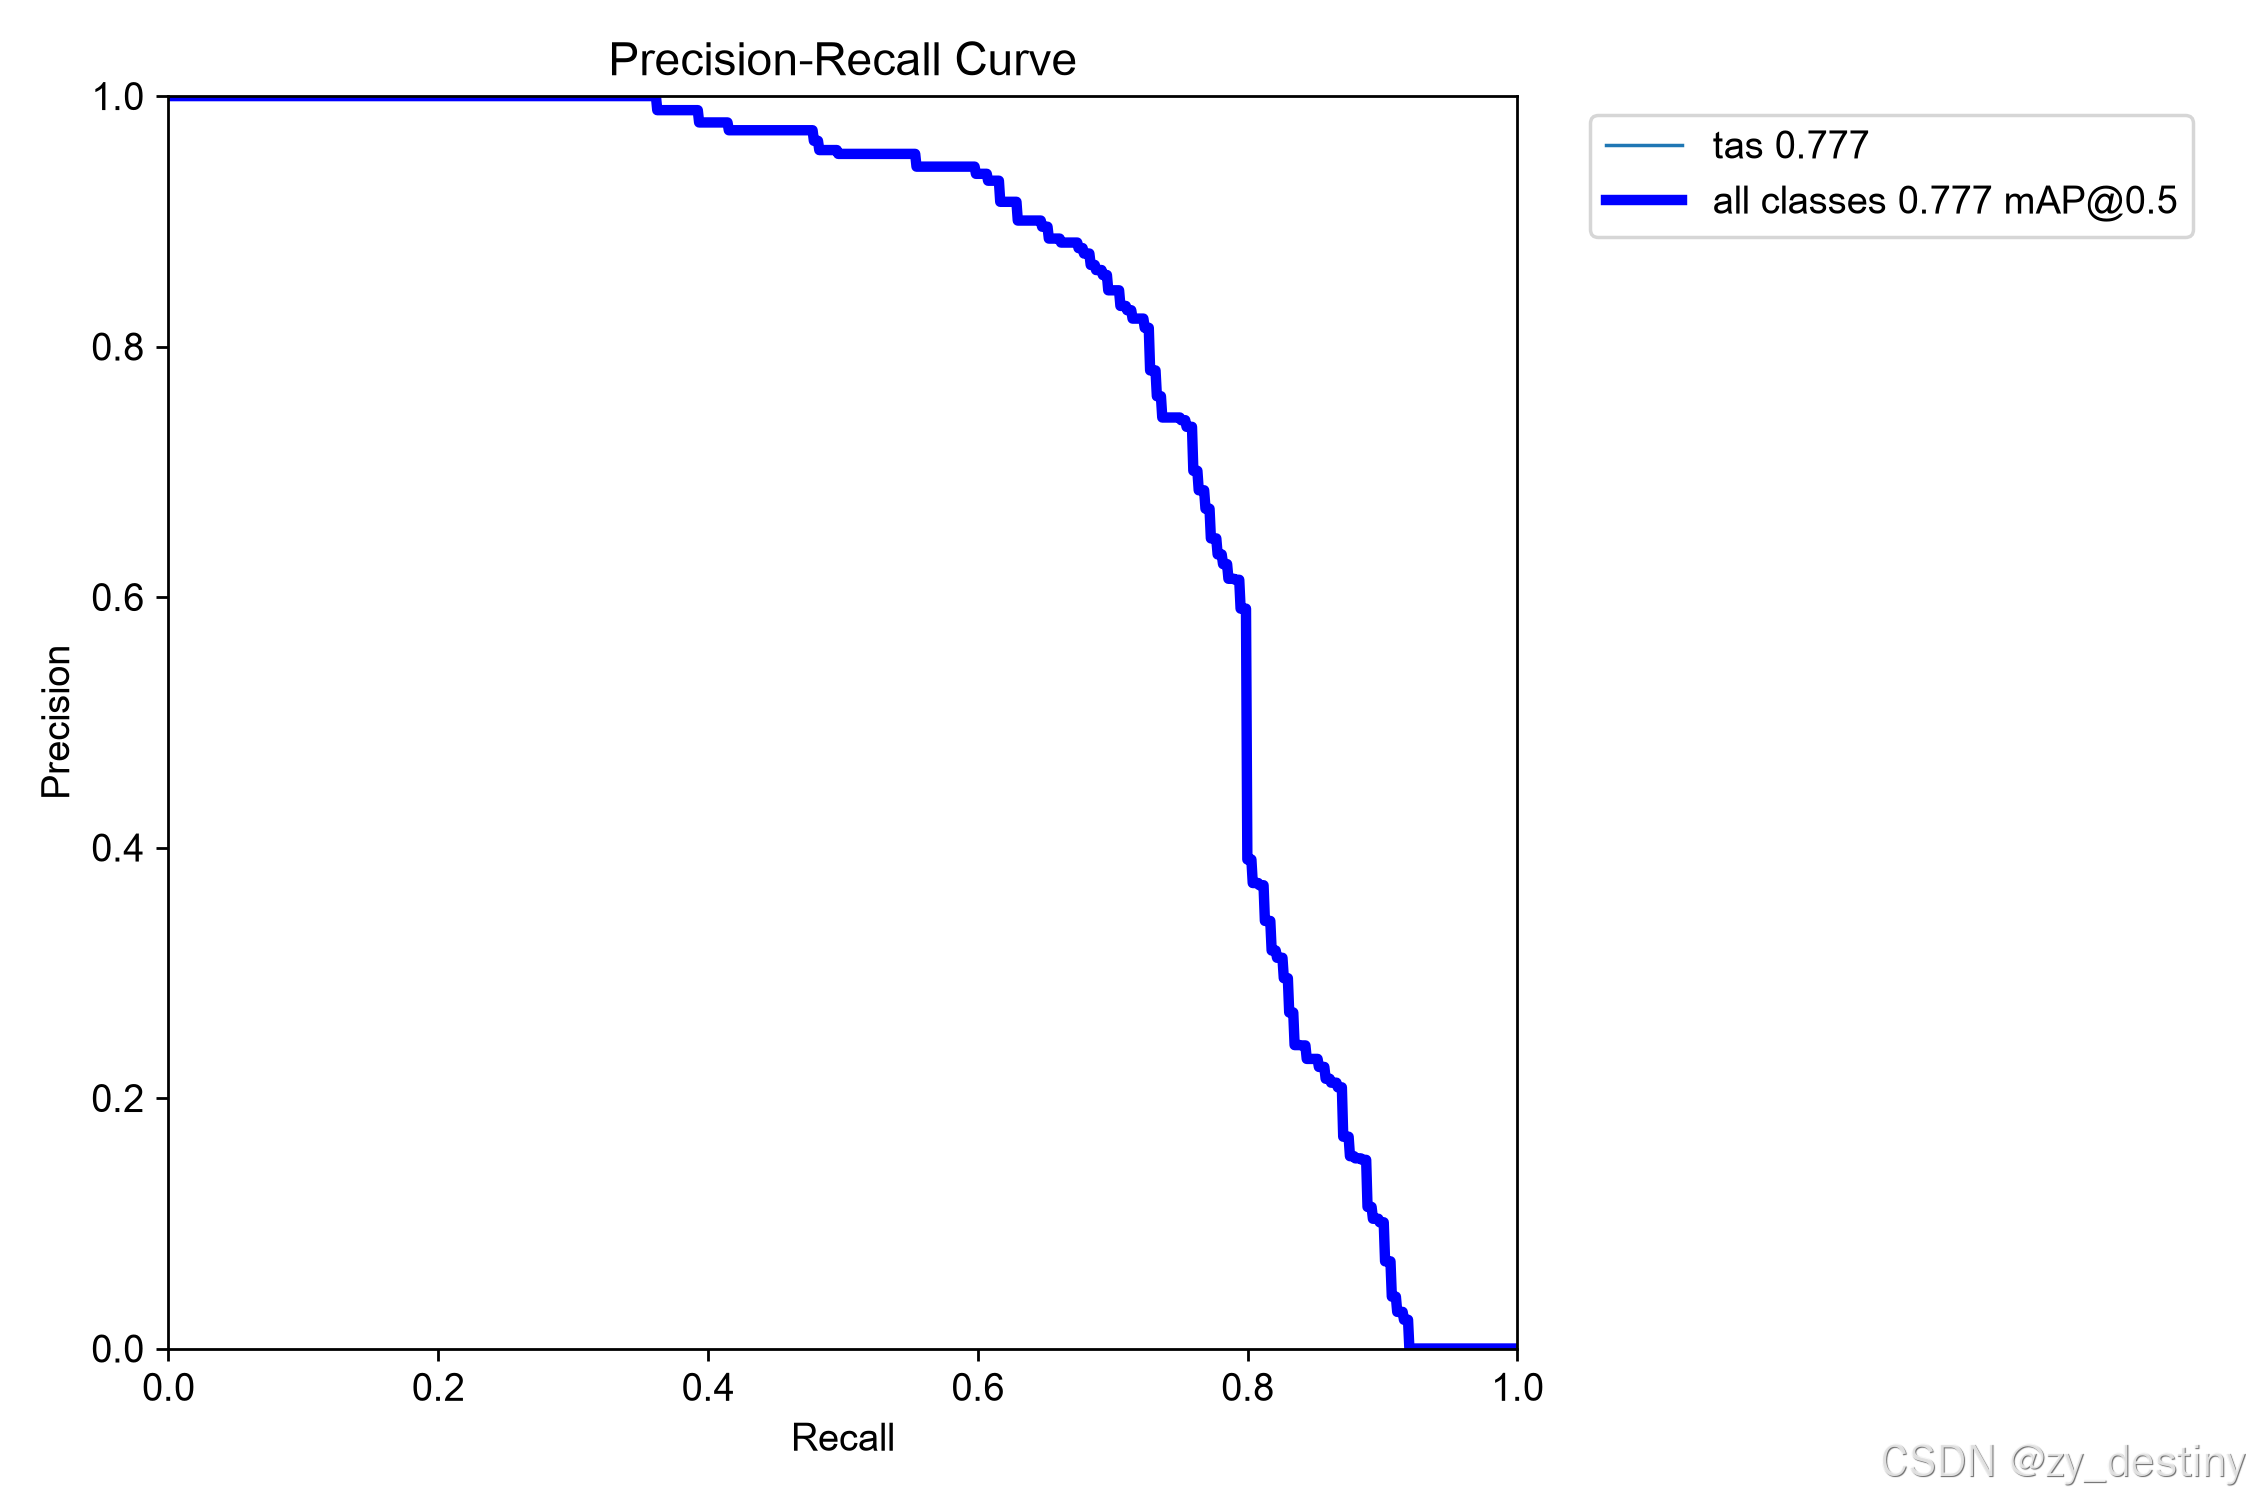
PR 曲线越靠右上越好。由于只有 tas 一个类别,图中只有一条曲线;从曲线形态可以看出在召回率 0.8 之前精度保持得不错,之后快速下滑------说明漏检主要集中在密集遮挡场景。
混淆矩阵
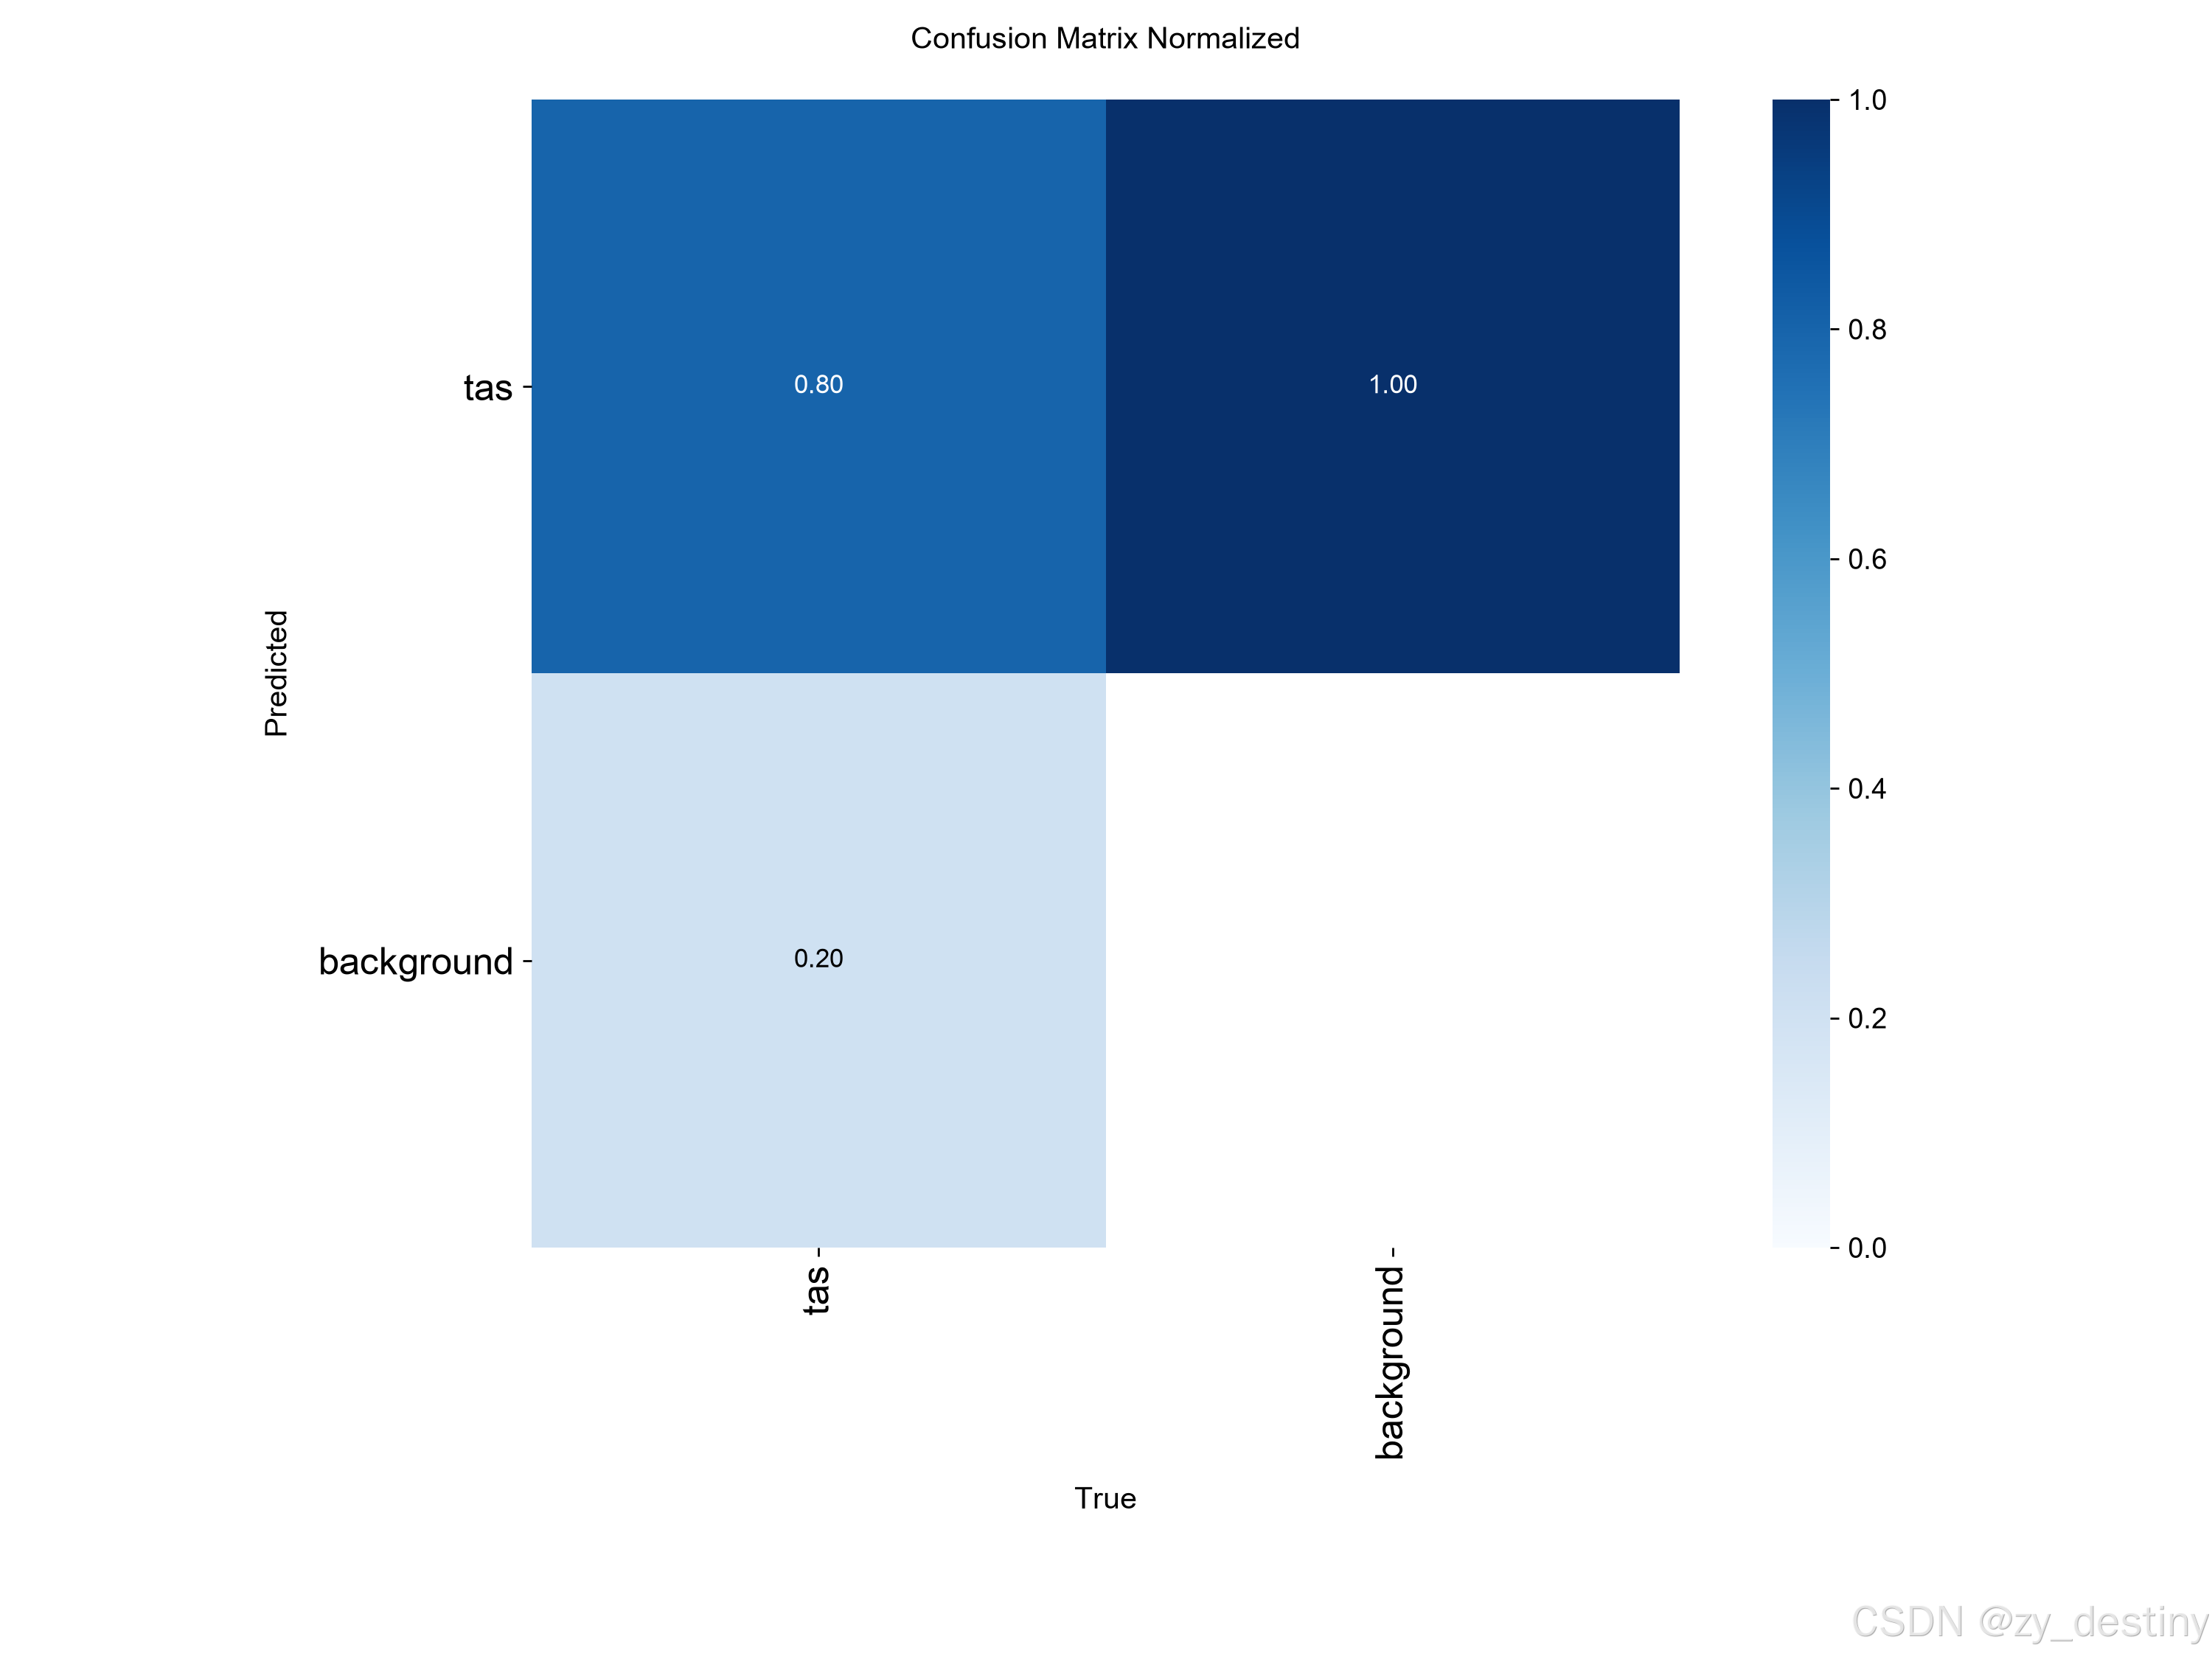
归一化混淆矩阵显示大部分雄穗被正确检出,主要误差来源是把部分背景区域误判为雄穗(false positive),这与田间复杂的叶片/茎秆纹理有关。
训练批次预测效果
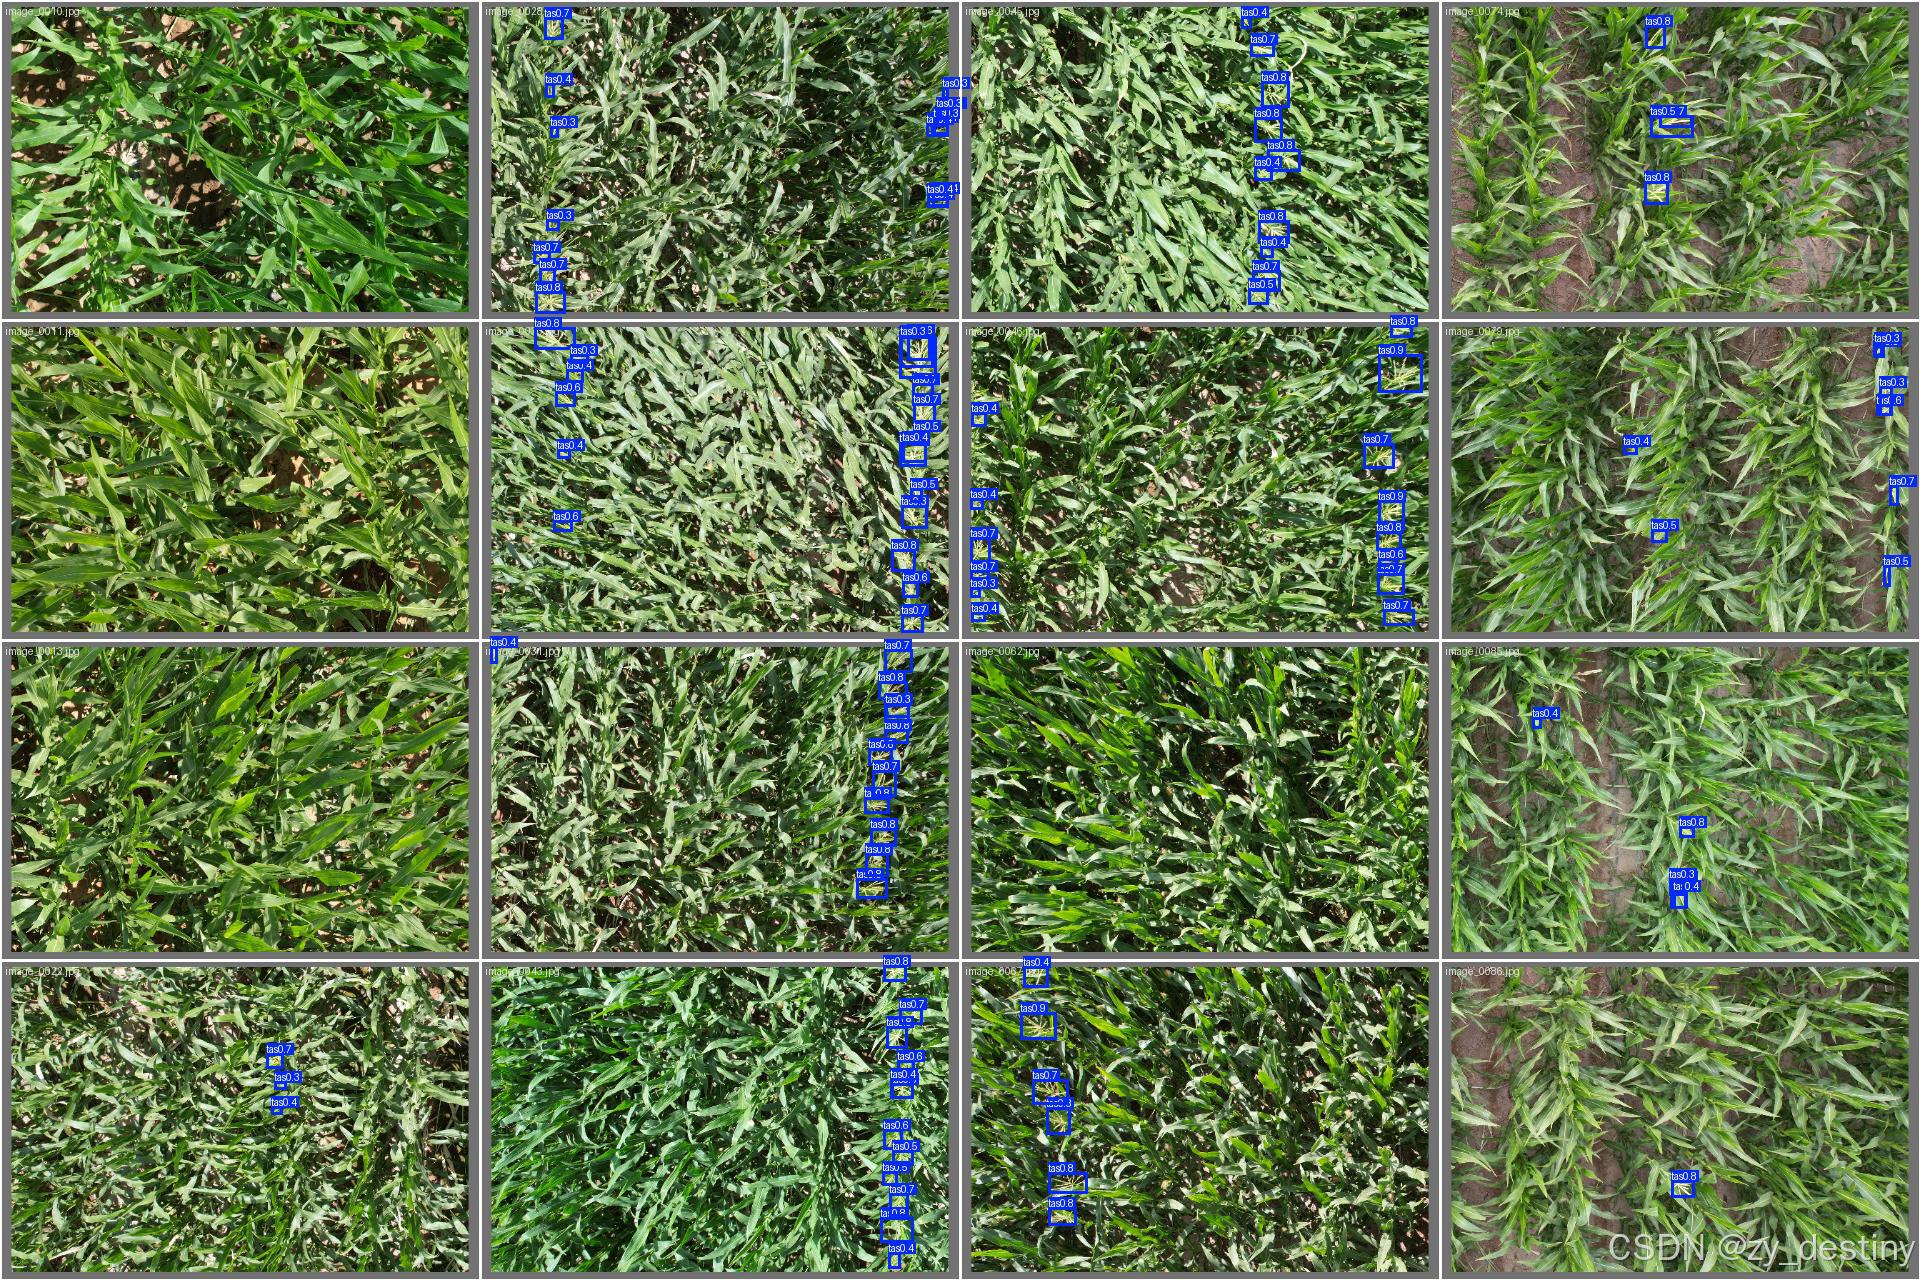
4.7 推理与测试
4.7.1 单张/批量推理
python
results = model.predict(
    source="dataset/images/val",   # 也可以是单张图、文件夹、视频、摄像头
    imgsz=640,
    conf=0.25,                     # 置信度阈值
    device="cpu",
    save=True,                     # 自动把画好框的图存到 runs/predict/
)
for r in results:
    print(r.path, "检出", len(r.boxes), "个雄穗")
    for b in r.boxes:
        print("  conf=%.2f  xyxy=%s" % (float(b.conf), b.xyxy.tolist()))
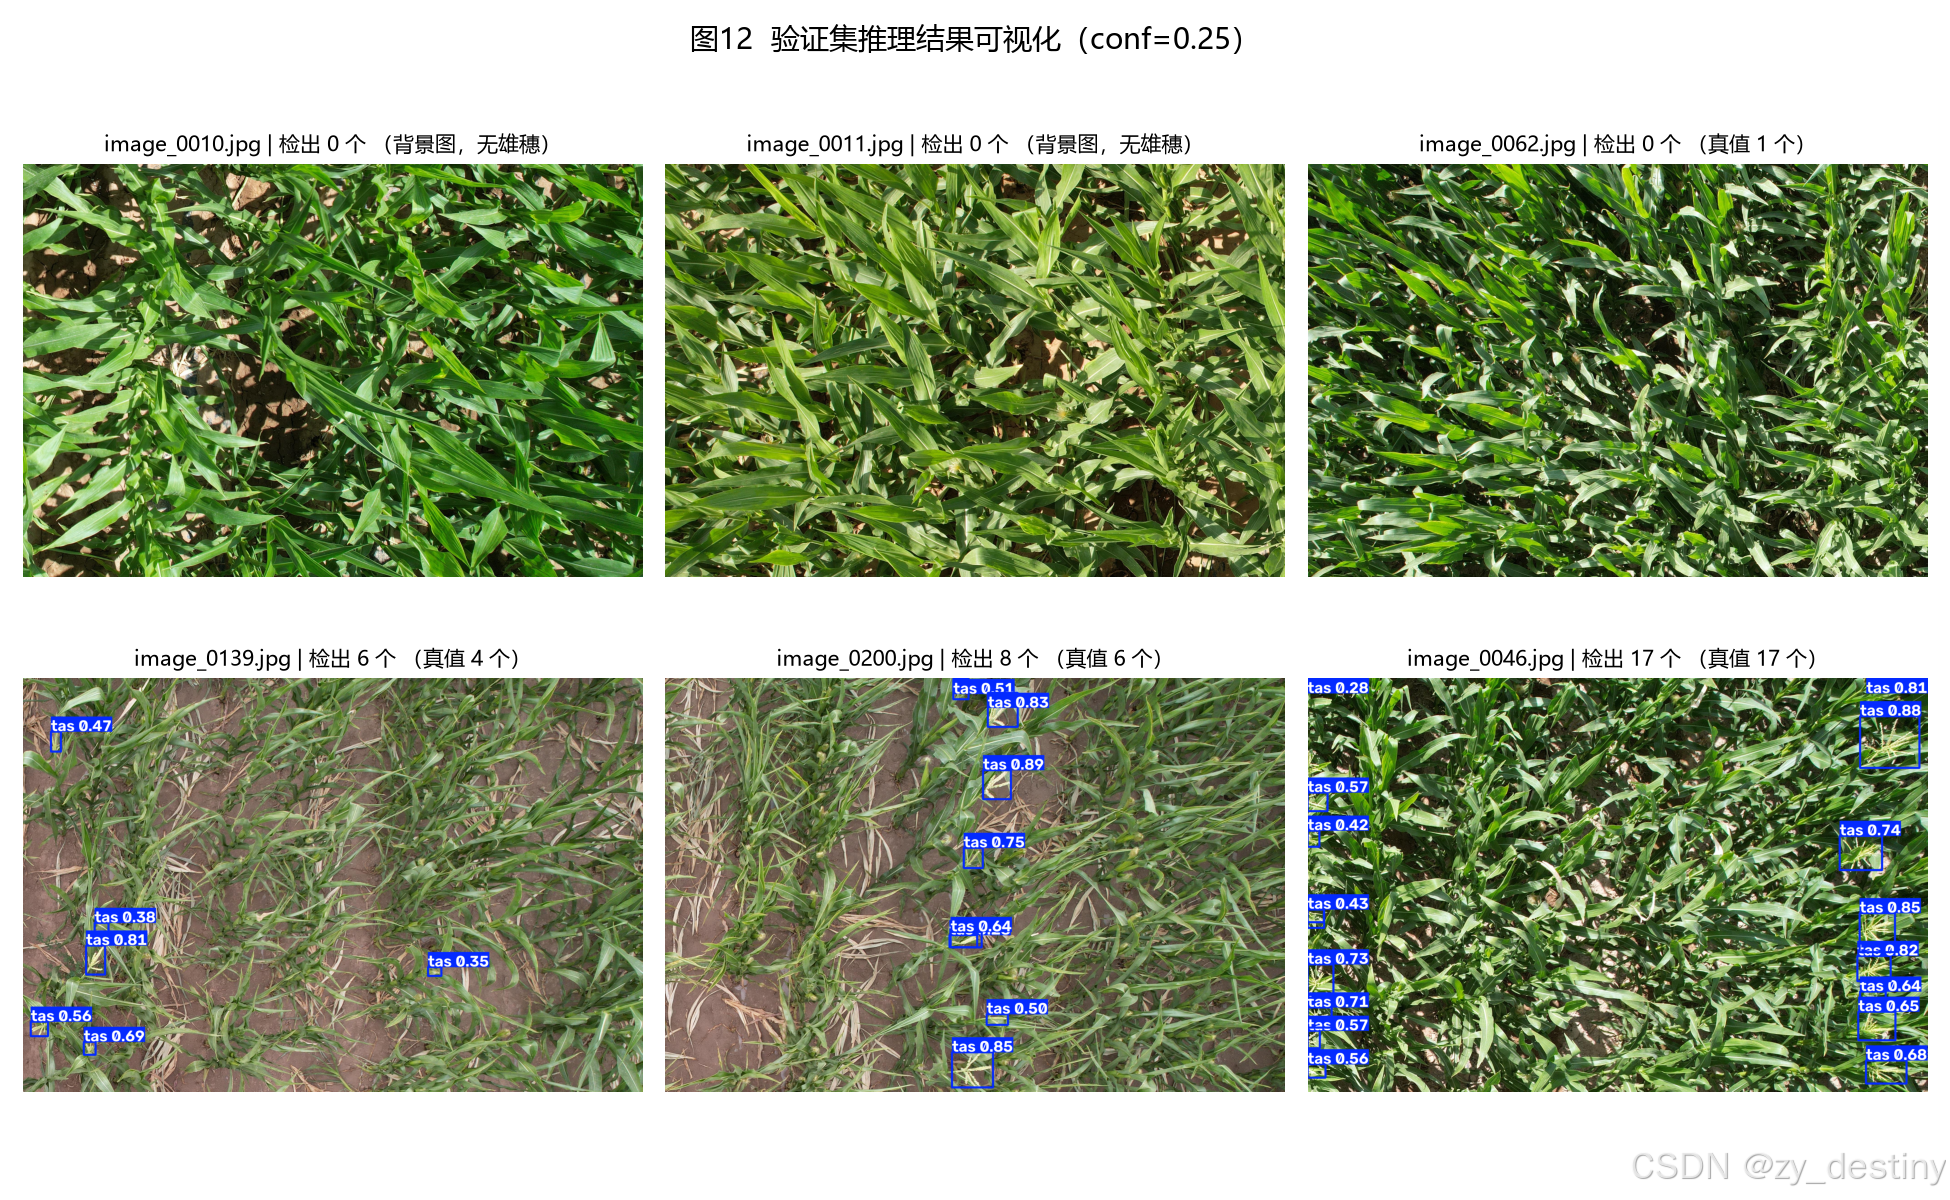
4.7.2 验证集推理可视化
我特意挑了 6 张覆盖不同场景的验证集图片:
- 前两张是背景图(真值 0 个),模型输出也是 0 个框------4.2 节保留 42 张背景负样本的效果直接体现在这里,田里全是叶片也不会乱报;
- 稀疏场景(真值 1 个)有一张漏检,说明极小的单目标仍有提升空间;
- 中等密度(真值 4/6 个)分别检出 6/8 个,多了几个低置信度框;
- 密集场景(真值 17 个)检出 17 个,数量完全对上。
4.7.3 真值 vs 预测 对比
橙色为人工标注真值,蓝色为模型预测。密集那张图 GT 17 个、Pred 17 个,框的位置和大小高度重合。
4.7.4 CPU 推理速度
text
Ultralytics 自带统计:  0.7ms preprocess + 25.9ms inference + 1.2ms postprocess ≈ 28 ms/张
完整 Python 循环实测(含图片IO/画框): 约 64 ms/张 ≈ 15 FPS
离实时视频流有距离,但用于"巡田拍照 → 批量检测"这种离线场景完全够用。
4.7.5 导出 ONNX 便于部署
python
model.export(format="onnx", imgsz=640, simplify=False)
# -> runs/corn_yolov8n/weights/best.onnx
踩坑:默认
simplify=True会调用 onnxslim,在 Windows + Python 3.13 上会Segmentation fault ;加
simplify=False一秒导出成功(6.2 MB)。
导出 ONNX 后可以脱离 PyTorch,用 onnxruntime / OpenCV DNN 部署到边缘设备(如 Jetson、树莓派、工控机)。
5. 遇到的坑与解决方案
| # | 坑 | 现象 | 解决 |
|---|---|---|---|
| 1 | 用 URL 数字 ID 下载 | repo not found |
必须用页面里的 repo_id knoka/qdBwZZcB |
| 2 | CDN 403 | 所有 LFS 大文件下载失败,X-Error-Info: EmptyReferer |
给 requests 打补丁强制加 Referer 头 |
| 3 | 个别文件下载缺失 | 244 张只下到 241 张 | 走 git.aistudio.baidu.com/api/v1/repos/{repo}/media/{path} 补下 |
| 4 | Ultralytics 写配置失败 | Error writing to AppData/Roaming/Ultralytics/settings.json |
export YOLO_CONFIG_DIR=./.ultralytics |
| 5 | matplotlib 缓存报错 | MPLCONFIGDIR 权限问题 |
export MPLCONFIGDIR=./.mpl |
| 6 | 中文标题变方框 | 字体缺失 | plt.rcParams["font.sans-serif"]=["Microsoft YaHei","SimHei"] |
| 7 | 画框颜色不对 | 颜色偏蓝 | OpenCV 是 BGR 不是 RGB |
| 8 | 训练集混入旧文件 | 指标异常 | 重新生成子集前清空 images/ labels/ |
| 9 | CPU 训练太慢 | 估不准时长 | 先跑 2 epoch 基准,按公式推算再定 epochs |
| 10 | dataset not found | yaml 相对路径在 Windows 失效 | path 写绝对路径,用 Path.as_posix() |
| 11 | 导出 ONNX 段错误 | onnxslim 在 Win + Python 3.13 上 Segfault |
export(format="onnx", simplify=False) |
6. 总结与展望
6.1 本项目做了什么
- ✅ 从 AI Studio 下载 244 张 YOLO 格式玉米雄穗数据集,并解决 403 / repo_id / 缺文件三个下载坑;
- ✅ 完成 EDA:发现 96.8% 目标为小目标、单图最多 111 个目标、中心点集中在上半图;
- ✅ 保留 42 张背景负样本参与训练,降低误检;
- ✅ 在 纯 CPU (i7-8700,无 GPU)上用 YOLOv8n + COCO 预训练权重完成 100 epochs 训练(78 分钟);
- ✅ 验证集 mAP@0.5 达到 0.7773(Precision 0.846 / Recall 0.696),CPU 单张推理约 28 ms,并完成推理可视化与 ONNX 导出。
6.2 可以继续改进的方向
- 提高输入分辨率:imgsz 提到 960 或 1280,小目标 AP 还能再涨(需要 GPU);
- 更大的模型:yolov8s/m,或专门针对小目标的 P2 检测头变体;
- 数据增强调优 :针对密集小目标,
copy_paste、mosaic强度可做消融实验; - 切图推理(SAHI):把 2736×1824 切成重叠瓦片分别检测再合并,是农业小目标的常用涨分手段;
- 计数下游任务:检测只是第一步,真正有价值的是"每亩残留雄穗数",可以接 TasselNet 之类的计数网络;
- 边缘部署:ONNX → TensorRT / NCNN,部署到田间巡检机器人或无人机。
6.3 参考链接
- 数据集:https://aistudio.baidu.com/dataset/detail/296690/intro
- Ultralytics 官方文档:https://docs.ultralytics.com/
- AI Studio 数据集下载官方文档:https://ai.baidu.com/ai-doc/AISTUDIO/Xme7ykmz1
- TasselNet(玉米雄穗计数经典工作):https://github.com/Cyao118/tasselnet
如果这篇博客对你有帮助,欢迎点赞收藏~有问题欢迎评论区交流。