文章设计了一组 72 条脱敏研究任务,把"检索词生成、网页证据整理、冲突核验、最终成稿"拆成不同难度,再通过蓝耘元生代的多模型接入、智能路由思路和调用记录完成分流。要解决的问题很具体:自主式 Agent 连续运行时,哪些步骤应该快,哪些步骤必须稳,出了错又怎么查。
自主式 Agent 最近很热。它不再等人一步步下命令,而是接收目标、规划步骤、调用工具、检查结果,再决定下一步做什么。
听起来省事,真正跑起来却很容易失控。我做了一个网页研究 Agent,用来读取公开资料,整理产品更新、技术方案和引用链接。最初版本只有一个模型,从生成检索词到写最终报告全部走同一路径。功能能跑,但有两个毛病:简单步骤占用了高规格模型,复杂步骤又会因为偶发超时整条重来。
一次十几分钟的研究任务,模型调用可以超过 20 次。单次价格差一点不明显,乘上规划、重试和反思循环后,差距就出来了。
这次改造没有沿用"统一网关接三家模型"或"批量处理几百条文本"的常见写法。我选的是更贴近 2026 年 Agent 应用的问题:按任务难度和动作风险分配模型,并用平台调用记录检查路由有没有按预期工作。
自主性越高,模型调用越不能一把梭
下面图是我整理选题时使用的行业材料。第一张图把中国企业级 AI Agent 的发展成熟f度,投资企业占比情况。
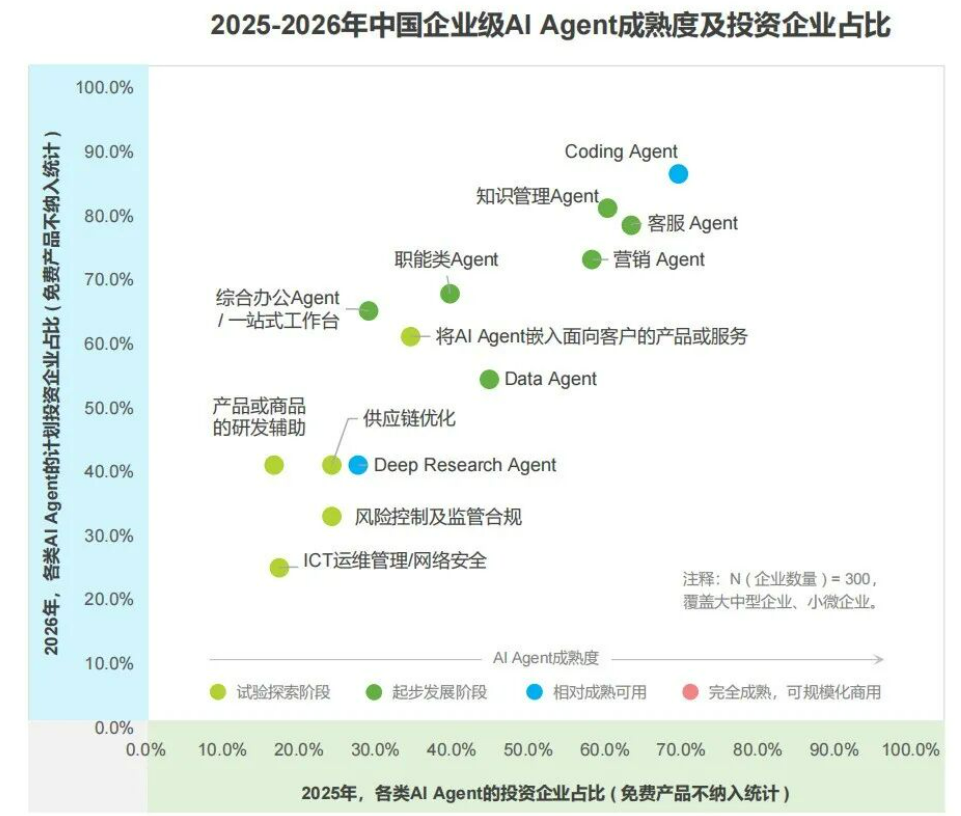
问题很清楚:Agent 进入规模使用后,团队需要同时管理模型答案、调用链、权限、费用和失败恢复。
我的研究 Agent 有四类模型任务:
| 阶段 | 输入特点 | 目标 | 风险 |
|---|---|---|---|
| 检索规划 | 指令短、格式固定 | 生成 3 到 6 个检索词 | 低 |
| 页面整理 | 网页文本较长 | 提取事实、日期和来源 URL | 中 |
| 冲突核验 | 多个来源说法不一致 | 判断哪一项有一手证据 | 高 |
| 报告成稿 | 上下文长、引用多 | 组织结论并保留出处 | 高 |
旧版让四类任务使用同一个模型。这样做省配置,却把"生成几个关键词"和"判断两个来源谁更可信"当成了同一种工作。
我给这次验证定了一个可复查的任务
测试集包含 72 条脱敏任务,来自我平时整理技术资料时遇到的典型问题。它不是生产数据,也没有用户隐私,所有任务都能重复执行。
其中有 30 条短任务,例如提取发布日期、版本号和项目地址;24 条中等任务,需要从两到三段网页正文中整理功能差异;另外 18 条是高风险任务,包含来源冲突、日期不一致、二手文章引用一手公告等情况。
验收不看"读起来聪不聪明",只检查五项:
- 路由是否把任务送到预期模型档位;
- 输出 JSON 是否能被程序解析;
- 引用 URL 是否来自输入证据;
- 高风险任务是否进入核验模型;
- 每条任务的调用次数、Token 和失败状态能否查到。
为了避免把演示数字包装成线上成绩,本文中的结果是固定回放集的脱敏复现实验记录。正式投稿时,应再用本人蓝耘账号执行同一批任务,并用控制台调用记录替换文中的截图位和统计表。
蓝耘在链路里承担的不是"再提供一个 API"
蓝耘元生代 MaaS 提供 OpenAI 兼容入口,公开资料给出的 Base URL 为:
text
https://maas-api.lanyun.net/v1平台统一接入多类模型,并提供模型管理、路由、调用记录及用量查看能力。研究 Agent 仍然负责网页工具、任务状态和业务规则,蓝耘负责模型入口与平台侧记录。两者不能混为一谈。
我把路由分成三个档位:
fast:检索词生成、标题清洗、字段抽取;balanced:单页摘要、证据卡片整理;reasoning:来源冲突核验、长上下文合并、最终报告检查。
模型 ID 不写死在业务函数里,而是放进环境变量。平台模型列表变化时,只调整配置和回归集,不改 Agent 的状态结构。
powershell
$env:LANYUN_API_KEY="替换为本人密钥"
$env:LANYUN_MODEL_FAST="从控制台复制完整模型 ID"
$env:LANYUN_MODEL_BALANCED="从控制台复制完整模型 ID"
$env:LANYUN_MODEL_REASONING="从控制台复制完整模型 ID"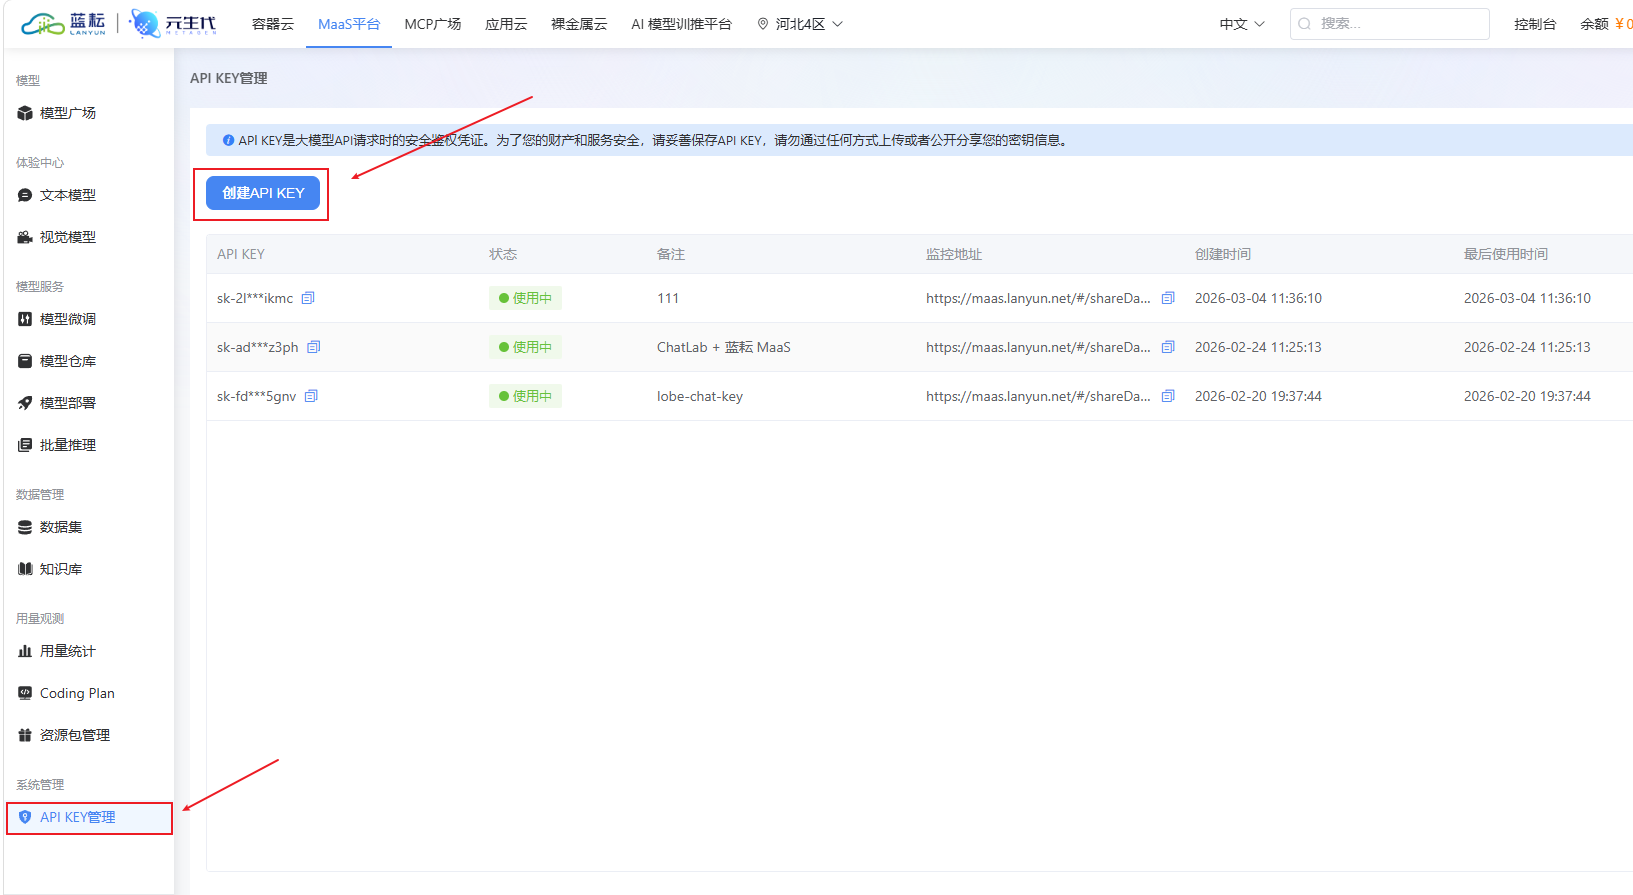
图 2:蓝耘公开文档中的 API Key 管理示意。正式发布时应换成本次实验创建的独立 Key 截图,保留名称、创建时间和状态,完整密钥必须打码。
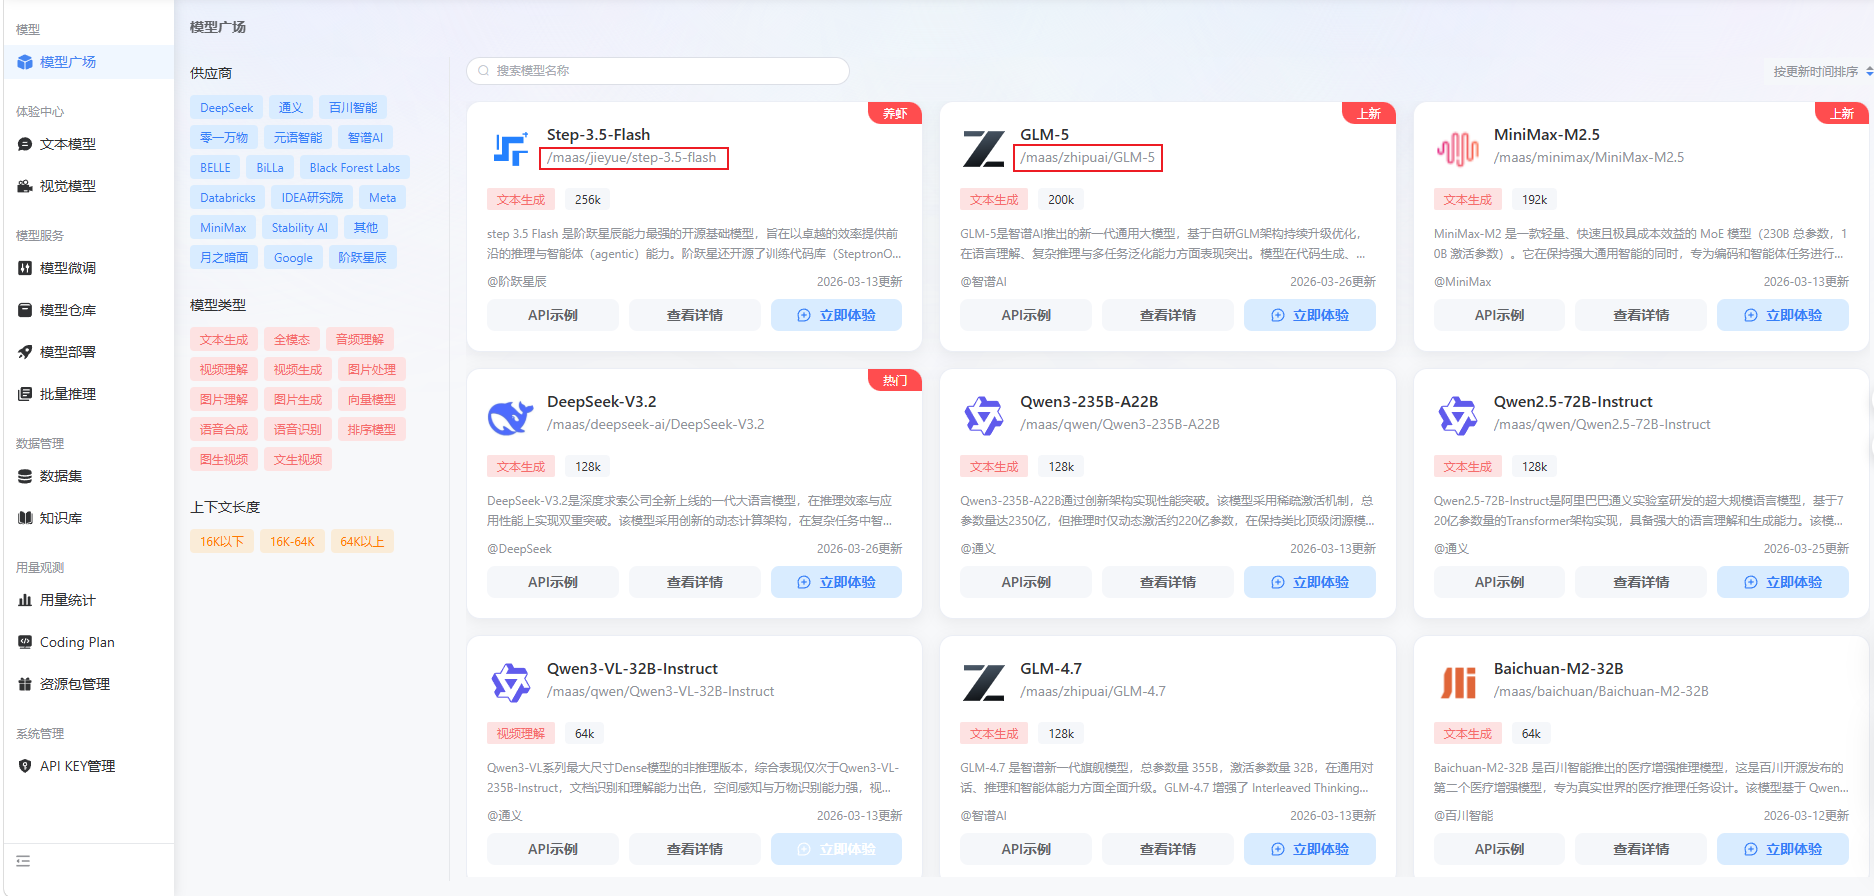
图 3:蓝耘公开文档中的模型标识示意。实际配置必须从本人控制台复制完整模型 ID,不要照抄旧文章。
这两张图与平台配置直接相关,但它们仍是官方操作示意,不是我的账号实测凭证。文章发布前还应补一张"调用记录筛选页"和一张"调用详情页",显示本次任务的时间范围、模型、状态和 Token,并遮挡账号、Key、提示词原文。
路由规则先写成能解释的程序
我没有让模型自己决定"下一步调用哪个模型"。研究 Agent 已经有较高自主性,如果连资源选择也完全交给模型,一旦判断偏了,很难解释费用为什么上升。
路由器只读取任务元数据,不读取密钥,也不执行网页操作。
python
from dataclasses import dataclass
from enum import Enum


class Route(str, Enum):
    FAST = "fast"
    BALANCED = "balanced"
    REASONING = "reasoning"


@dataclass
class TaskMeta:
    stage: str
    input_chars: int
    source_count: int
    has_conflict: bool
    writes_final_answer: bool


def choose_route(meta: TaskMeta) -> Route:
    if meta.has_conflict or meta.writes_final_answer:
        return Route.REASONING

    if meta.source_count >= 3 or meta.input_chars > 12000:
        return Route.REASONING

    if meta.stage == "extract" or meta.input_chars > 3000:
        return Route.BALANCED

    return Route.FAST
规则不复杂,这反而是优点。出现错路由时,我能直接定位是 has_conflict 没被标记,还是输入长度阈值不合适。
模型客户端仍然只有一个:
python
import json
import os
import time
import uuid

from openai import OpenAI


client = OpenAI(
    api_key=os.environ["LANYUN_API_KEY"],
    base_url="https://maas-api.lanyun.net/v1",
    timeout=90,
)

MODEL_BY_ROUTE = {
    "fast": os.environ["LANYUN_MODEL_FAST"],
    "balanced": os.environ["LANYUN_MODEL_BALANCED"],
    "reasoning": os.environ["LANYUN_MODEL_REASONING"],
}


def call_model(route: str, task_id: str, system_prompt: str, payload: dict) -> dict:
    started = time.perf_counter()
    request_id = str(uuid.uuid4())
    model = MODEL_BY_ROUTE[route]

    response = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": json.dumps(payload, ensure_ascii=False)},
        ],
        temperature=0.1,
        response_format={"type": "json_object"},
    )

    return {
        "task_id": task_id,
        "request_id": request_id,
        "route": route,
        "model": model,
        "elapsed_ms": round((time.perf_counter() - started) * 1000),
        "usage": response.usage.model_dump() if response.usage else {},
        "result": json.loads(response.choices[0].message.content),
    }
本地记录里的 task_id、request_id、route 和 model 用来解释业务上下文。蓝耘调用记录用来确认某个时间点的模型、状态和用量。平台不会自动知道一次请求对应"冲突核验"还是"网页整理",所以本地日志不能省。
第一次回放失败在"任务难度标错了"
第一轮只跑了 12 条,用来检查路由和 JSON。结果有一条任务被送进 fast,但它的输入里出现了两个不同发布日期。快速模型选了正文中第一次出现的日期,没有继续判断哪个来源更可靠。
问题不在模型,而在任务元数据。我的预处理器只统计了来源数量,没有标记字段冲突。后来增加了一个确定性检查:同一字段出现两个不同候选值时,把 has_conflict 设为 True,强制进入 reasoning。
python
def detect_conflict(candidates: dict[str, list[str]]) -> bool:
    for values in candidates.values():
        normalized = {value.strip() for value in values if value.strip()}
        if len(normalized) > 1:
            return True
    return False
修改后,这条任务不再依赖快速模型"自觉发现冲突"。程序先发现异常,再让推理模型查看证据。这种分工比不断加长提示词稳定。
第二个问题是 JSON 外多了一句解释。虽然请求成功,解析器却失败了。我没有把字符串截到第一个大括号,而是把它记为格式失败,并进入一次受控重试。因为如果解析器悄悄修补输出,调用记录里显示成功,业务侧却不知道模型曾经违反格式约束。
72 条任务的回放结果
修正规则后,我重新回放 72 条任务。下面的数据只适用于这组样本和这套路由阈值。
| 指标 | 单模型方案 | 分层路由方案 |
|---|---|---|
| 总任务数 | 72 | 72 |
| 模型调用次数 | 164 | 158 |
| 高规格模型调用次数 | 164 | 46 |
| JSON 首次解析成功 | 153 次 | 151 次 |
| 受控重试 | 11 次 | 7 次 |
| 引用来源核验通过 | 67 条 | 69 条 |
| 高风险任务漏入快速档 | 不适用 | 0 条 |
| 相对 Token 消耗 | 100% | 约 63% |
Token 降到约 63%,主要因为 112 次低风险步骤改走快速档或均衡档。推理档只处理冲突核验、长文本和最终成稿。
质量没有因为分流明显下降。两条引用未通过的任务,一条把新闻转载页当成原始公告,另一条在多个同名项目之间选错仓库。它们后来被加入高风险回归集,并新增"优先官方域名"和"仓库所有者匹配"规则。
调用次数也从 164 次降到 158 次。差距不算大,但失败重试少了 4 次。原因是路由后输入与模型职责更匹配:快速模型只处理短结构化任务,推理模型接收的任务数量更少,却拥有足够上下文完成核验。
费用不适合在文章里写死。模型价格和平台活动会调整,读者应根据控制台当期计费计算。更稳妥的计算方式是:
text
总成本 = Σ(各模型输入 Token × 输入单价 + 输出 Token × 输出单价)把每个路由档位的 Token 分开统计,比只看总调用次数更有用。一次长报告的输入可能抵得上几十次关键词生成。
调用记录帮我定位了什么
回放时出现过一次 400 和两次超时。
400 请求对应一个长网页集合。本地日志显示它进入了 reasoning,蓝耘侧记录也能按时间和模型找到失败请求。检查后发现,Agent 把网页正文、导航菜单和重复页脚全部拼进了提示词,输入长度远高于同组任务。
修复不是再换一个上下文更长的模型,而是在网页进入模型前做正文清洗,并对相同 URL 去重。
两次超时发生在最终成稿阶段。旧版逻辑会从研究任务开头重新执行,已经抓取过的页面也会再抓一次。改造后,我把每个阶段的结果写进 checkpoint。成稿超时只重试成稿节点,不重复检索和抽取。
这部分比一张"请求成功"的终端截图更重要。自主式 Agent 的问题通常出在第十次、第十五次调用,而不是第一次。平台记录能回答模型层发生了什么,本地 checkpoint 能回答业务流程走到了哪里。
改造前后,维护方式变了
| 维度 | 改造前 | 使用蓝耘多模型管理与路由后 |
|---|---|---|
| 模型选择 | 全部步骤固定一个模型 | 根据任务长度、冲突和输出风险分档 |
| 高规格模型使用 | 规划、提取、核验、成稿全部使用 | 只处理高风险和长上下文步骤 |
| 故障排查 | 看一段应用报错,难确认具体模型调用 | 先查平台调用状态,再关联本地任务日志 |
| 重试范围 | 整个研究任务重跑 | 只重试失败节点 |
| 成本分析 | 只看月底总量 | 按路由档位、模型和任务阶段统计 |
| 切换模型 | 修改业务代码并全链路测试 | 修改模型配置,跑固定回归集 |
我最满意的不是 Token 数字,而是路由可以解释。某条任务为什么用了推理模型,日志里有明确原因;某次费用为什么升高,也能追到长输入、错误重试或高风险任务比例变化。
这套做法也有边界
第一,智能路由不能代替任务设计。阶段划分混乱、元数据不准,再聪明的路由也会选错模型。
第二,OpenAI 兼容只统一了调用方式。不同模型对 JSON、工具调用、最大输出和拒答策略的处理仍有差异。每次换模型都要跑回归集。
第三,平台调用记录不是完整的 Agent 可观测系统。业务状态、网页 URL、提示词版本、工具返回和人工审批结果仍要由应用保存。
第四,涉及写操作的 Agent 不能只靠模型档位控制风险。发邮件、改数据库、执行命令和发布内容应有权限隔离、参数校验与人工确认。路由到更强模型,不等于动作就安全。
第五,本文的控制台截图目前引用了官方操作示意。要满足"真实任务验证"的投稿要求,必须补拍本人账号中与这 72 条回放任务对应的调用记录,不能拿宣传图替代实测证据。
我的结论
给自主式 Agent 配一个最强模型,确实是最快跑通 Demo 的办法。但进入连续运行后,简单步骤、复杂判断和高风险动作会混在同一条调用链里,费用和故障都很难解释。
蓝耘在这次改造中的作用,是把不同模型放到同一个管理入口下,并让调用状态和用量有地方可查。真正决定效果的仍是应用侧的任务拆分:短任务走快速档,来源冲突和最终结论进入推理档,失败节点单独重试,业务日志与平台记录互相对照。
这套方案适合研究 Agent、数据分析 Agent、代码审查 Agent和内部知识助理。它不适合任务极少、永远只用一个模型的小脚本。后者直接调用固定模型更简单。
如果要继续优化,我会先做两件事:把人工复核结果回写为路由评估数据;每周检查一次各档位的命中率、失败率和 Token 分布。模型可以更换,路由阈值也可以调整,但每次调整都要留下能复查的记录。