1 问题描述
某历史项目,被反馈 HTTP 请求失败率高,一直超时。遂,排查之。# 2 排查过程
2 排查过程
2.1 信息收集
根据调用 API,找到对应的服务、服务自身的日志文件、项目源码,以及调用方的日志。##
2.2 根据日志文件的初步分析:
shell
I0928 16:26:43.937340 30062 MyHttpServer-- body:...
I0928 16:26:43.937624 30062 http response finised . result:...
根据日志信息显示,服务在不到 1ms 的时间就已经完成处理并返回响应了。反馈给调用方,让其排查自身。约半个时辰后,调用方反馈自身没有问题。好吧,something wrong...
重新进行自身日志和对方日志,按照时间线,核对,发现了两个问题:
- 1.调用方,短时间内很多请求,但是自身服务,根据日志来看来只接收到一条. 类似于有某种过滤,或者限制频率的处理层存在.
- 2.对方接收到的响应回复时间,是在整个自身服务的所有操作日志完成后的.
分析问题:
- 1.这个暂时没有头绪,先放下.
- 2.一种猜想,那就是我自身的日志打印的回复时间,并不是真正的回复时间.发送的回复应该是确实处理好了,但是因为某种原因,一直被阻塞住,没发出来.
ok,那需要进一步的信息收集和真伪信息的验证.
采用tcpdump对服务接口进行抓包.
shell
# tcpdump -U -i eth0 port 服务端口 -w ~/http.pcap &分析抓包结果,回复确实是,30秒之后才真正发出的.这已经超时了.

2.3 结合服务源码深入分析
发现该服务使用的libevent创建的.所有的业务是在一个注册的http的处理函数中进行的.
cpp
	// 设置回调函数
	//指定generic callback - 这是也给通用回调
	evhttp_set_gencb(_httpd, httpd_handler, NULL);
httpd_handler 内部做了两件事
- 1.处理计算请求,得出结果.进行http响应回复.
- 2.将处理结果,更新到数据库中.需要更新几个表中的记录.
没有学习过libevent,但是根据事实证据推断:
- 1.对于第一步的响应,应当是在整个回调走完,回到libevent自身的运行层面时,才做的真正发送.
- 2.第一步生成响应的整体处理时间,也就最多1ms以内就完成了.那么,延迟应该是出现在了后续的数据库操作中.此时看数据库的操作日志,能够看出一些延迟端倪,但是,具体延迟的原因,尚不清楚.
2.4 结合抓包,查看,验证mysql操作的延迟
重新针对mysql的操作进行抓包. 这一步收集的网络包,可以确认延迟发生在哪一段,是数据库本身延迟,还是自身服务处理的延迟问题.
shell
tcpdump -U -i eth0 -w /root/mysql.pcap 'host mysql服务ip and port mysql服务端口'分析网络包发现:
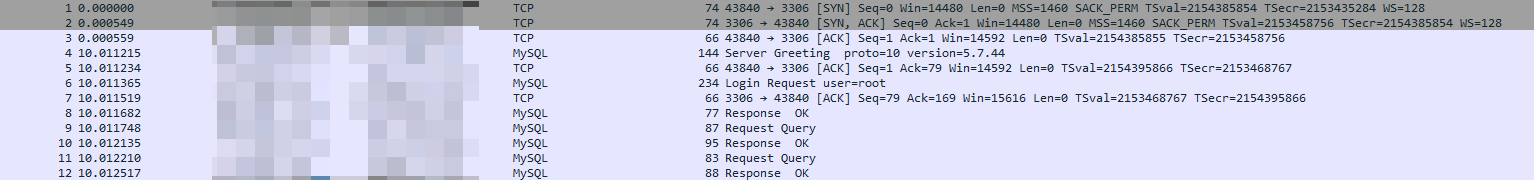
在本服务对mysql进行建立连接时,延迟巨大. 服务端响应 Server Greeting 稳定耗时10秒延迟.
进一步,查看服务项目代码,发现
- 1.每次对mysql的操作,都是重新建立连接,操作完成后断开.
- 2.而每个请求,需要进行三次数据库操作.
至此,请求超时的30秒原因,已经查明:
- 1.libevent的真正回复处理时机是在,回调函数完成后.
- 2.回调函数中对mysql的数据库操作延迟问题,造成了整体的回复延迟问题.
3 总结处理
3.1 针对问题2
本次排查的核心经验是:服务日志显示处理完成,并不代表响应已经真正发出 。日志打印时间与实际网络发送时间之间存在时间差,排查超时问题时,必须结合抓包工具(如 tcpdump)从网络层验证真实行为,而不能只依赖应用日志。
最终定位到根因:libevent 的回调函数完成后才真正发送响应,而回调中对 MySQL 的每次操作都重新建立连接(每个请求三次),单次建连耗时约 10 秒,叠加后导致整体响应延迟 30 秒。
解决方案:修改本服务,以维护一个连接池,或者一个长连接 MySQL 的方式,避免每次请求都重新连接数据库的延迟问题。修复后回归验证,响应时间恢复正常。
3.2 针对问题1
截止目前还没有确定,因为在调用方和本服务中间,应该是没有所谓的过滤服务的.现在想,大概率是:* 1.延迟状态的项目源码,在libevent的单个回调没有执行完成时,阻塞的时间过长.
- 2.导致在调用方短时间发送的后续请求,被丢弃,甚至直接在网络层面,就没有被从网卡取回.
这个需要在修复问题2的延迟问题后,后续再做验证.