博主介绍:程序喵大人
- 35 - 资深C/C++/Rust/Android/iOS客户端开发
- 10年大厂工作经验
- 嵌入式/人工智能/自动驾驶/音视频/游戏开发入门级选手
- 《C++20高级编程》《C++23高级编程》等多本书籍著译者
- 更多原创精品文章,首发gzh,见文末
- 👇👇记得订阅专栏,以防走丢👇👇
😉C++基础系列专栏
😃C语言基础系列专栏
🤣C++大佬养成攻略专栏
🤓C++训练营
👉🏻个人网站
好文推荐:
【C++入门】编译链接模型 - 01 一个 C++ 程序是怎样变成可执行文件的
在任何一个 C++ 源文件里写下 #include "math.h" 再敲下回车,你心里大概知道这行代码的意思是"把 math.h 里的东西拿过来用"。但"拿过来"到底是怎么拿的、发生在什么时候、拿过来之后编译器看到的东西长什么样,这三个问题如果没有亲手拆过预处理输出,答案多半是模糊的。
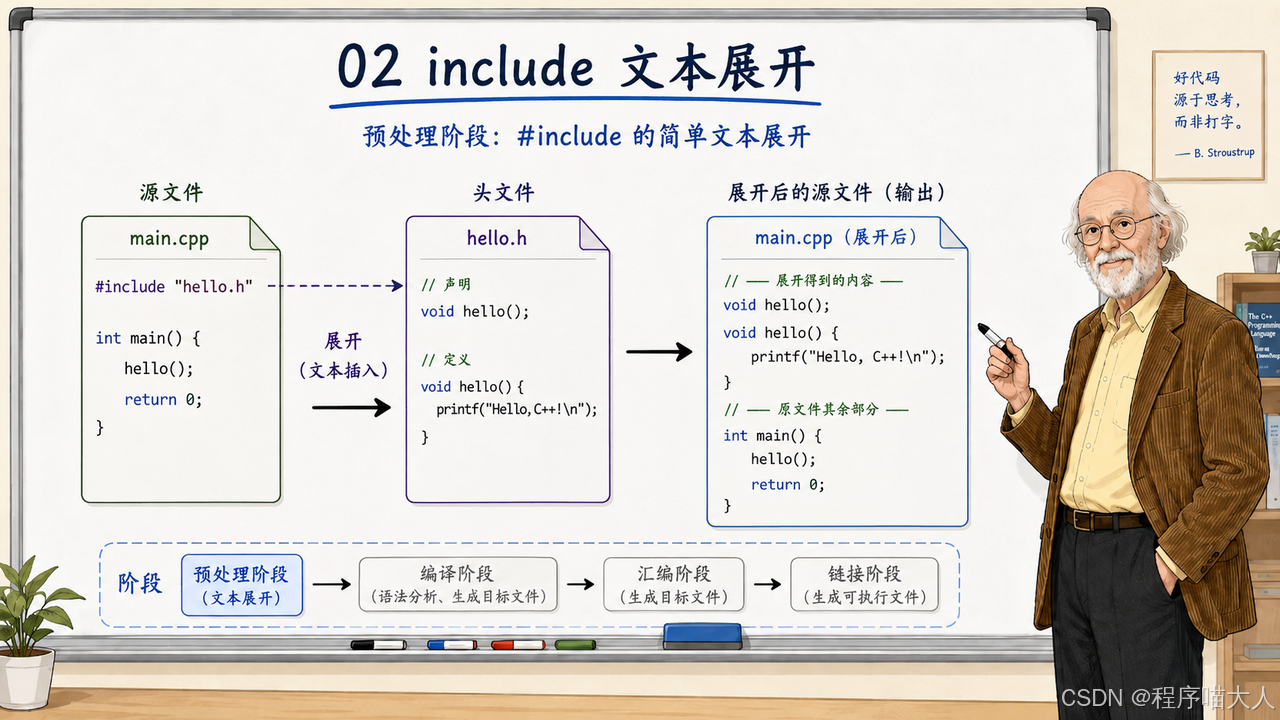
拿一套最小例子来看。准备两个文件:math.h 里定义一个简单的结构体 Score,main.cc 里 include 它并使用 Score。
cpp
// math.h
struct Score {
  int value = 0;
};
cpp
// main.cc
#include "math.h"

int main() {
  Score s{42};
  return s.value;
}
让编译器在预处理阶段停下来,把输出写到文件里:
bash
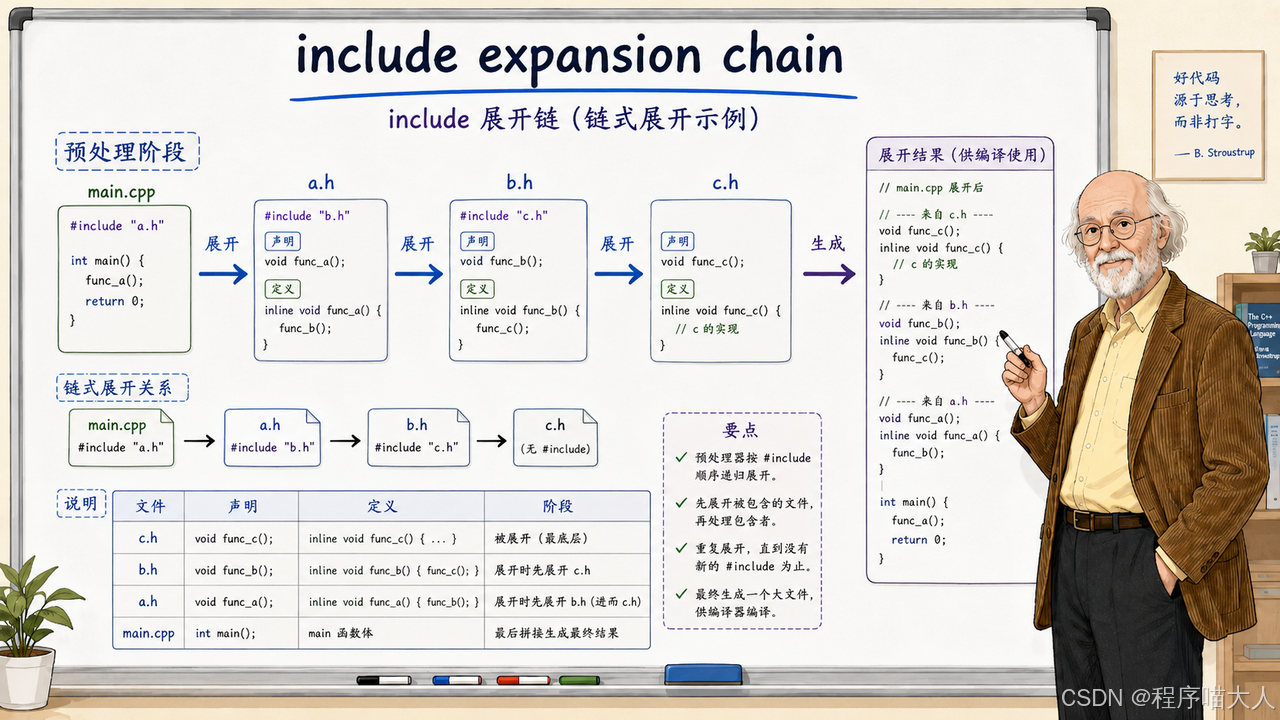
clang++ -std=c++20 -E main.cc -o main.i打开 main.i 翻一翻,你会发现 math.h 的内容(整个 struct Score { int value = 0; };)已经原封不动地出现在了 main.i 里面,而且就插在原先 #include "math.h" 那行的位置。这行 #include 指令本身消失了,取而代之的是被包含文件的完整文本。预处理器做的事情用一句话就能概括:把 #include 指令替换成对应文件的全部内容。这个替换是递归的:如果 math.h 里面又 include 了别的文件,那些文件的内容也会被展开进来,形成一棵以当前源文件为根的包含树。最终形成的是一份巨大的、没有任何预处理指令残留的纯 C++ 源码文本,这份文本就是第 3 章要讲的翻译单元(translation unit)的雏形。
一个值得注意的地方是 -E 产出的 .i 文件里还夹杂着一些 #line 标记。这些标记以一个数字和文件名组成,比如 # 1 "main.cc",告诉编译器下一段文本来自哪个原始文件的第几行。它们是预处理阶段插入的路标,用来让编译器的错误信息能够定位回原始源文件和行号,而不是指向已经被拍扁的 .i 文件的某一行。读者在阅读 .i 输出时可以忽略这些 #line 标记,但知道它们存在的意义有助于理解为什么编译器能把预处理输出中的错误报回到正确的源文件位置。
这份 main.i 有多大,取决于你包含了什么。上面的例子只 include 了一个自己写的 math.h,main.i 很小,肉眼就能看完。但如果你把 #include "math.h" 改成 #include <iostream>,预处理输出会膨胀到近十万行。<iostream> 本身包含了 <ios>、<streambuf>、<istream>、<ostream> 等一整套标准库头文件,这些头文件又各自包含更多头文件,预处理器沿着这条包含链逐层展开,最终把整个标准 I/O 子系统的声明全部拉进了你的源文件。你写的 main 函数安安静静地待在文件的最后面,在它前面是几万行标准库的类定义、函数声明、模板和内联函数。这些声明铺开了编译器接下来做类型检查所需要的全部信息:std::cout 的类型是什么、operator<< 有哪些重载、std::ios_base::Init 的构造函数会在什么时候被调用。编译器在第 2 章之后的所有工作,都是在这一份展开后的文本上进行的。
关于 #include,有两个容易忽略的细节值得展开。第一个是尖括号和引号的区别:#include <iostream> 和 #include "math.h" 都会触发文本包含,但预处理器搜索文件的路径不同。<> 形式在系统的标准包含路径里搜索(比如 macOS 上 Xcode 工具链的 /usr/include/c++/v1/ 或 Linux 上 GCC 的 /usr/include/c++/版本号/),"" 形式先在当前源文件所在目录搜索,搜不到再退回到标准包含路径。这意味着如果你的项目里有一个名叫 vector 的头文件,写成 #include "vector" 找到的是你的本地文件,而 #include <vector> 找到的是标准库的 <vector>。日常开发中遵循一条简单的惯例:标准库和第三方库用 <>,项目自己的头文件用 ""。更精确地说,"" 的搜索路径可以由编译器参数 -I 追加的自定义包含目录来扩展,这也是构建系统中 target_include_directories 最终转化成的编译器命令行参数。
第二个细节是 #include 后面可以跟宏展开的结果,不限于字面文件名。预处理器在处理 #include MACRO 时会先展开宏,再用展开后的路径字符串去搜索。比如 #define PLATFORM_HEADER "linux/impl.h" 然后用 #include PLATFORM_HEADER,在特定场景下可以用于跨平台头文件选择。这个技巧会让代码的包含关系变得隐晦:读者无法直接从 #include 行看出到底包含了哪个文件,需要追溯宏的定义链。工程中除非有明确且必要的理由,否则更推荐用条件编译配合多条显式 #include 指令来表达平台差异。
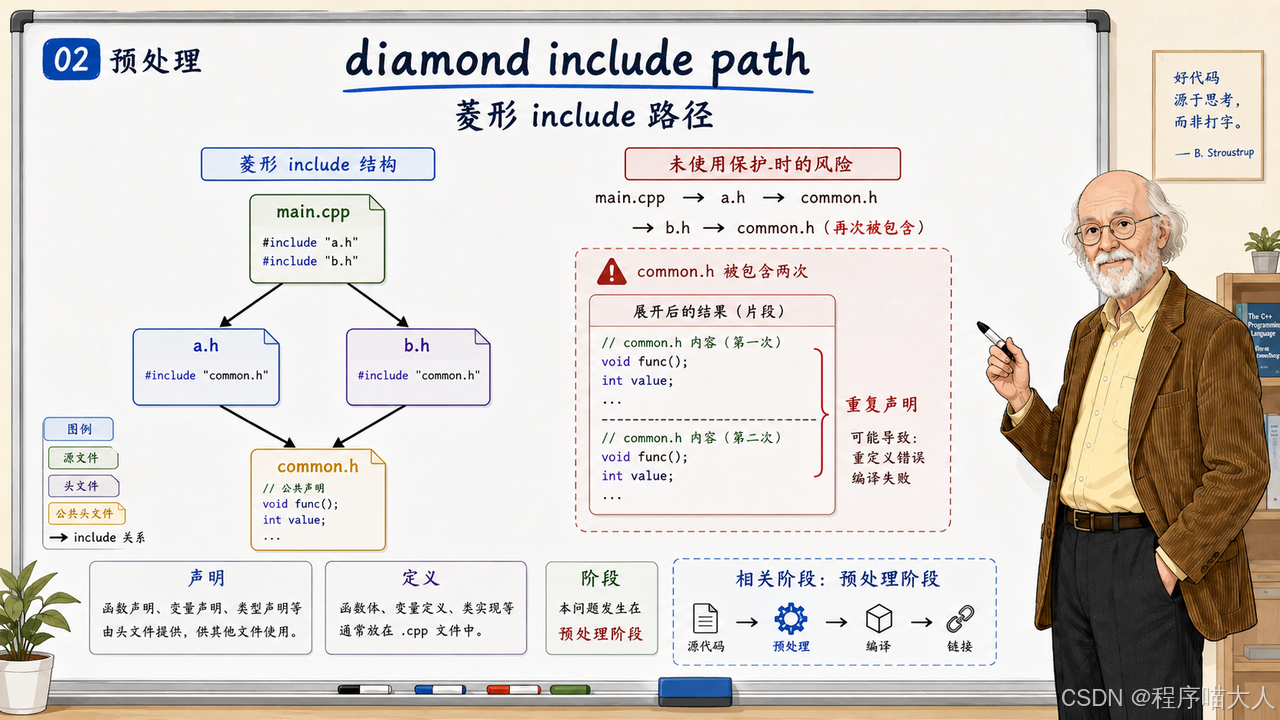
预处理的文本替换直觉建立起来之后,一个直接的问题会冒出来:如果同一个头文件被 include 了两次会怎样?这在真实项目里很容易发生。假设 a.h 和 b.h 都 include 了 common.h,而 main.cc 同时 include 了 a.h 和 b.h。
cpp
// common.h
struct Score {
  int value = 0;
};
cpp
// a.h
#include "common.h"

Score MakeScoreA();
cpp
// b.h
#include "common.h"

Score MakeScoreB();
cpp
// main.cc
#include "a.h"
#include "b.h"

Score MakeScoreA() {
  return Score{10};
}

Score MakeScoreB() {
  return Score{20};
}

int main() {
  const Score a = MakeScoreA();
  const Score b = MakeScoreB();
  return a.value + b.value;
}预处理阶段沿着包含路径展开:main.cc 先展开 a.h,a.h 里展开 common.h,于是 Score 的定义第一次出现;接着 main.cc 展开 b.h,b.h 再次展开 common.h,于是 Score 的定义第二次出现在同一个预处理输出文件中。编译器对这种情况会直接报错:同一个作用域内重复定义同一个类型是语法错误。这个编译错误会明确告诉你 Score 被重复定义了,但不会告诉你重复发生的路径,你需要自己沿着 include 链追溯。这种"同一个头文件在预处理过程中被多次展开进同一个翻译单元"的情形,就是 include guard 要解决的唯一问题。
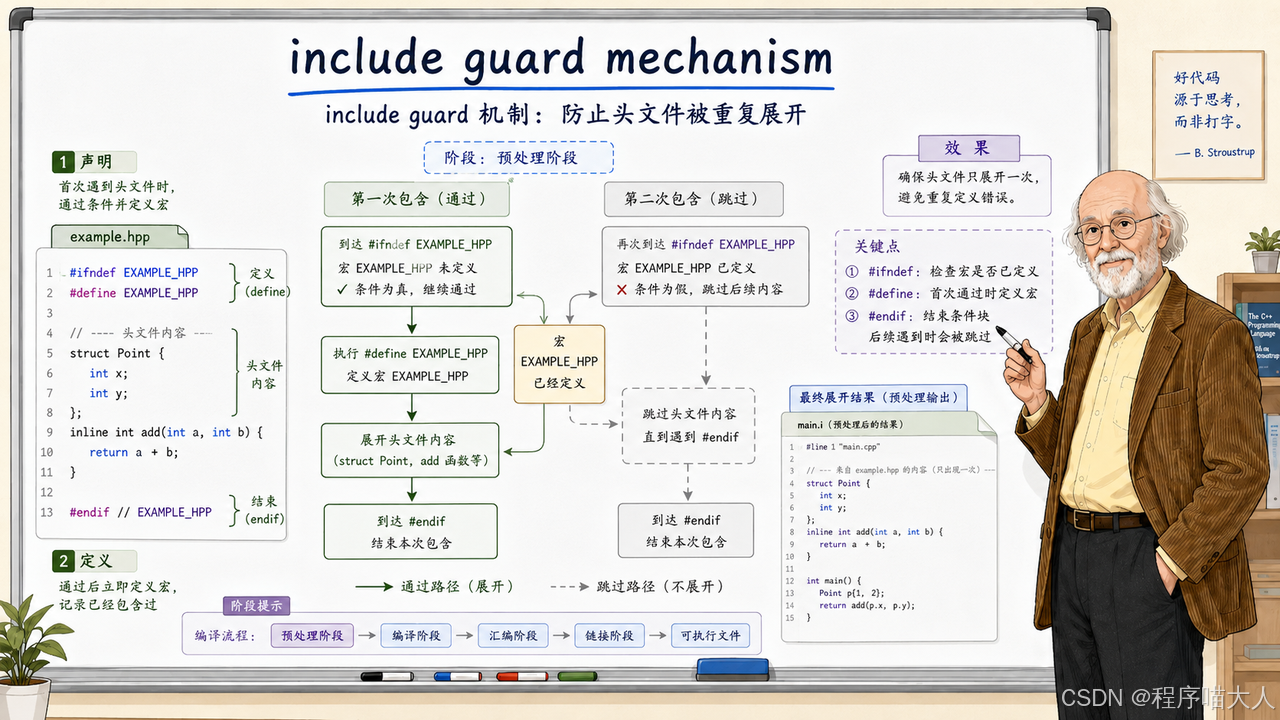
Include guard 的写法几乎所有 C++ 程序员都见过:
cpp
#ifndef COMMON_H_
#define COMMON_H_

struct Score {
  int value = 0;
};

#endif  // COMMON_H_
机制很直观:第一次遇到 #include "common.h" 时,宏 COMMON_H_ 还没有定义,#ifndef 条件成立,预处理器进入保护区域,把 Score 的定义展开进输出,同时执行 #define COMMON_H_ 把这个宏标记为已定义。当同一个头文件在同一个翻译单元内再次被 #include 时,COMMON_H_ 已经存在,#ifndef 条件不成立,预处理器跳过整个 #ifndef 到 #endif 之间的全部内容,Score 的定义不会再次出现。
Include guard 的宏名选择有一个隐含要求:全局唯一。两个不同的头文件如果意外使用了相同的 guard 宏名,后展开的那个会被 guard 挡住,头文件的内容根本不会被编译器看到。实际工程中,命名约定通常包含项目名、模块名和文件名,以大幅降低冲突概率。常见的模式包括 PROJECT_MODULE_FILE_H_ 或 PATH_TO_HEADER_H_。有些团队用随机字符串或者 UUID 作为宏名的一部分来进一步确保唯一性。
#pragma once 是大多数主流编译器支持的简化写法:
cpp
#pragma once

struct Score {
  int value = 0;
};它的语义一目了然:这个文件在每个翻译单元里只被展开一次。不需要想宏名,不用担心命名冲突。#pragma once 不属于 C++ 标准,但在 Clang、GCC、MSVC 上都工作得很好,已经是工程中的事实标准。它的工作机制与 include guard 不同:不依赖宏名匹配,而是靠编译器或预处理器内部记录文件标识(通常是标准化后的文件路径或文件系统级别的 inode 信息),再次遇到同一个文件时直接跳过。一个细节是,如果同一个文件在文件系统中有多个路径指向它(比如通过符号链接或硬链接),某些旧版本编译器的 #pragma once 实现可能无法正确识别它们是同一个文件,导致重复展开。现代主流编译器已经通过比较 inode 等文件系统层面的标识来规避这个问题,在常规项目布局下基本不会遇到。传统 include guard 没有这个隐患,因为它依赖的是程序员显式声明的宏名。
Include guard 能解决单个翻译单元内的重复展开,但它管不到不同翻译单元之间的重复定义,这个边界是本系列反复出现的主题。如果一个头文件里放了普通函数定义(函数体),即使有 include guard,两个 .cpp 各自 include 这个头文件后,链接阶段仍会因为两份函数定义同时存在而报 multiple definition 错误。Include guard 确保每个 .cpp 只展开一次头文件,但它无法阻止两个 .cpp 各自展开一次、各自产生一份函数定义的目标代码。举个具体例子:头文件 common.h 里写了 int GetValue() { return 42; }(一个带有函数体的普通函数定义),它正确使用了 include guard。a.cc include 它之后,预处理展开一次,编译器生成包含 GetValue 函数体的 a.o;b.cc include 它之后,预处理同样展开一次,编译器生成包含 GetValue 函数体的 b.o。到这里每一步都是合法的。链接阶段,链接器需要把 a.o 和 b.o 合并成一个可执行文件,它发现两个目标文件各提供了一个同名的外部可见函数 GetValue,无法决定用哪一个,于是报 multiple definition of 'GetValue()'。Include guard 确保了头文件在每个翻译单元内只展开一次(没有重复的 GetValue 定义出现在同一个 .cc 的预处理输出中),但它拿两个不同的翻译单元之间的事情毫无办法。这个问题第 5 章会完整拆解。
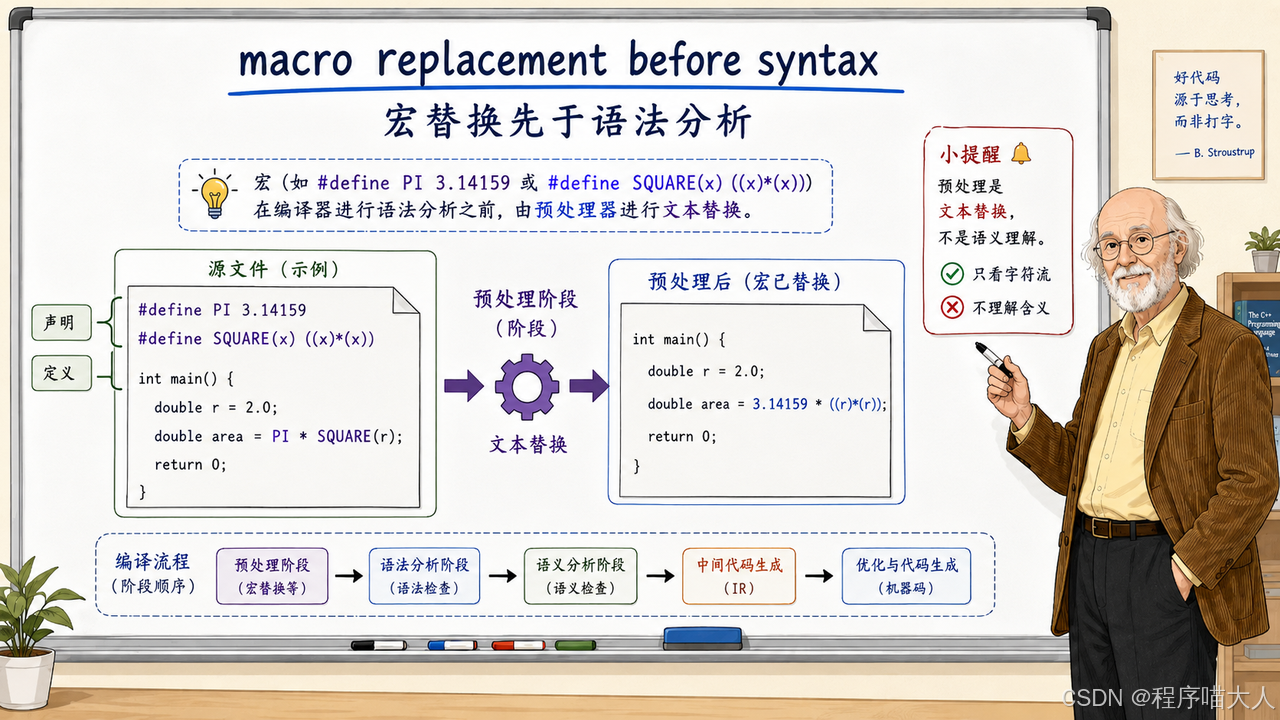
预处理器处理的不仅仅是 #include。在编译器真正开始分析 C++ 语法之前,预处理器还负责宏替换和条件编译,此外还有 #line 标记注入(告知编译器后续文本的原始出处)、#error 指令(在预处理阶段主动中止编译并输出自定义错误)以及 #pragma 指令的通用机制。宏的替换发生在 token 层面,它完全不理解 C++ 语义:
cpp
#define SCORE_DEFAULT 0

struct Score {
  int value = SCORE_DEFAULT;
};
预处理器看到 SCORE_DEFAULT 这个 token 时,直接把它替换成 0,然后把替换后的文本交给编译器。编译器实际接收到的是一份带有 int value = 0; 的完整 struct 定义。整个过程发生在任何语法分析之前,编译器拿到的已经是替换后的代码,它完全不知道 SCORE_DEFAULT 这个宏曾经存在过。
正是因为宏在语法分析之前工作,它可以制造出"不同翻译单元看到不同代码"的效果。设想一个场景:某个头文件根据 #ifdef ENABLE_FEATURE 条件决定是否声明某个函数,两个 .cpp 分别在 include 该头文件之前定义和不定义 ENABLE_FEATURE 宏,那么两个翻译单元展开后的内容就不一致。编译器会独立检查每个翻译单元,各自都能通过编译(因为各自的声明是自洽的),直到链接阶段符号表出现分歧,问题的表现形式可能是某个函数找不到定义,或者是函数签名不一致导致的链接错误。这种因宏状态差异而产生的"同一份头文件在不同翻译单元展开成不同内容"的情况,排查起来远不如显式的声明缺失直观。
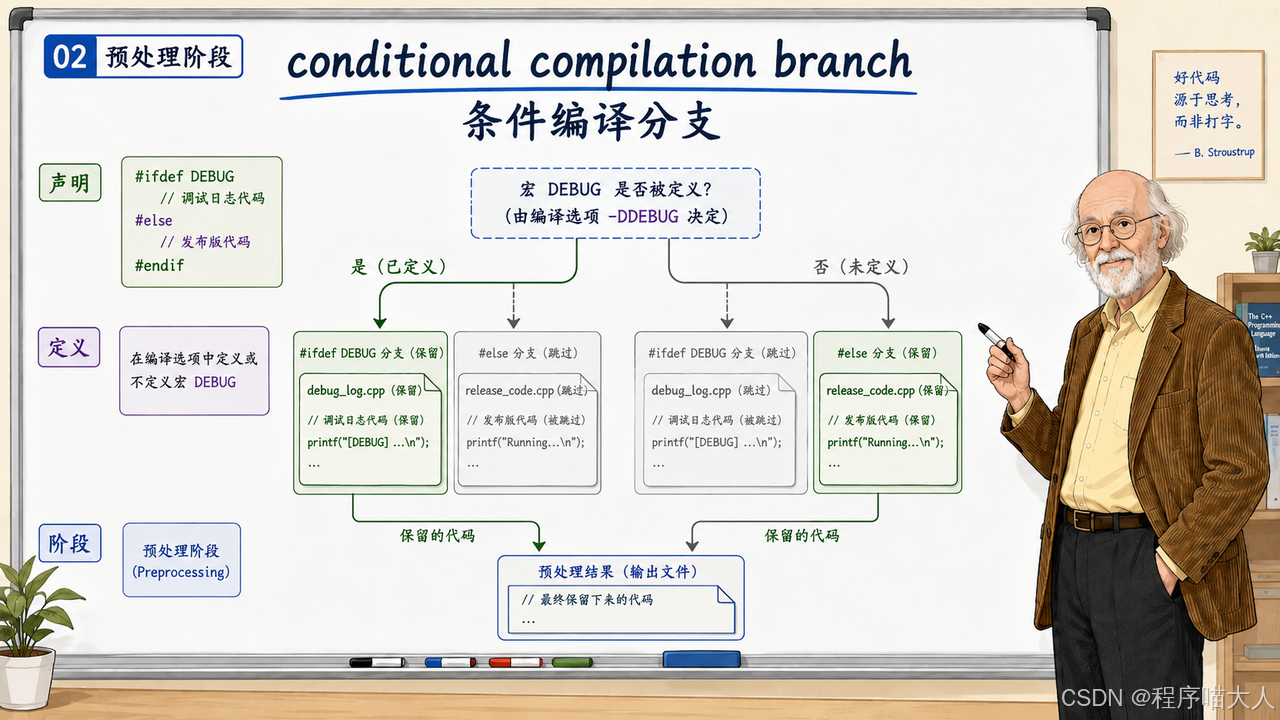
条件编译是宏在工程中最常见的合理用途。#ifdef、#ifndef、#if、#else、#elif、#endif 这组指令让预处理器根据宏的状态选择把哪部分文本保留下来,哪部分直接丢弃。Include guard 本身就是一个典型的条件编译应用。跨平台代码也经常用它来选择不同平台的实现路径:在 macOS 上用 #ifdef APPLE 走 Mach-O 相关的逻辑,在 Linux 上走 ELF 路径,在 Windows 上走 PE/COFF 路径。条件编译的分支是不可见的:编译器只看到被选中的那条分支,被丢弃的分支在语法层面完全消失,这里面可能出现的一种问题是:你修改了一条 #else 分支里的代码,但因为当前平台的宏状态把它屏蔽了,本地编译完美通过,换一个平台构建却炸了。
宏在工程中的使用有一条底线:能不用宏解决的事情,尽量不用宏。能用 constexpr 常量替代的数值宏,用常量,因为 constexpr 变量有类型、有作用域、编译器能对它做完整的语义检查。能用 inline 函数替代的函数式宏,用函数,因为 inline 函数有参数类型检查、有正常的求值语义,不会出现宏展开后参数被多次求值的经典陷阱。能用 using 或 typedef 替代的类型宏,用类型别名。宏真正的价值阵地是 include guard、条件编译、少量确实需要 token 层面文本替换的场景(比如日志宏中需要用到 FILE 和 LINE),以及跨平台编译开关。宏不尊重作用域、不尊重命名空间、不尊重类型系统,它在编译器介入之前就已经完成替换,后续所有工具(编译器、静态分析器、调试器、IDE)看到的都是替换后的结果而非你写的原始代码。宏用得越少,这些工具能告诉你的信息就越多。
函数式宏有一个经典陷阱值得单独拿出来看:
cpp
#define SQUARE(x) x * x

int main() {
  int result = SQUARE(1 + 2);  // 展开为 1 + 2 * 1 + 2,结果是 5 而非 9
}
SQUARE(1 + 2) 展开后变成 1 + 2 * 1 + 2,由于乘法优先级高于加法,实际计算的是 1 + (2*1) + 2 = 5。这个问题的修复方式是在宏定义中给每个参数和整个表达式加括号:#define SQUARE(x) ((x) * (x))。但这种括号策略治标不治本:如果把 SQUARE(++i) 传进去,++i 会被展开两次,产生未定义行为。换成 inline 函数 inline int Square(int x) { return x * x; } 直接消除了这两类问题。内联函数的参数只被求值一次,运算符优先级也不会有意外。
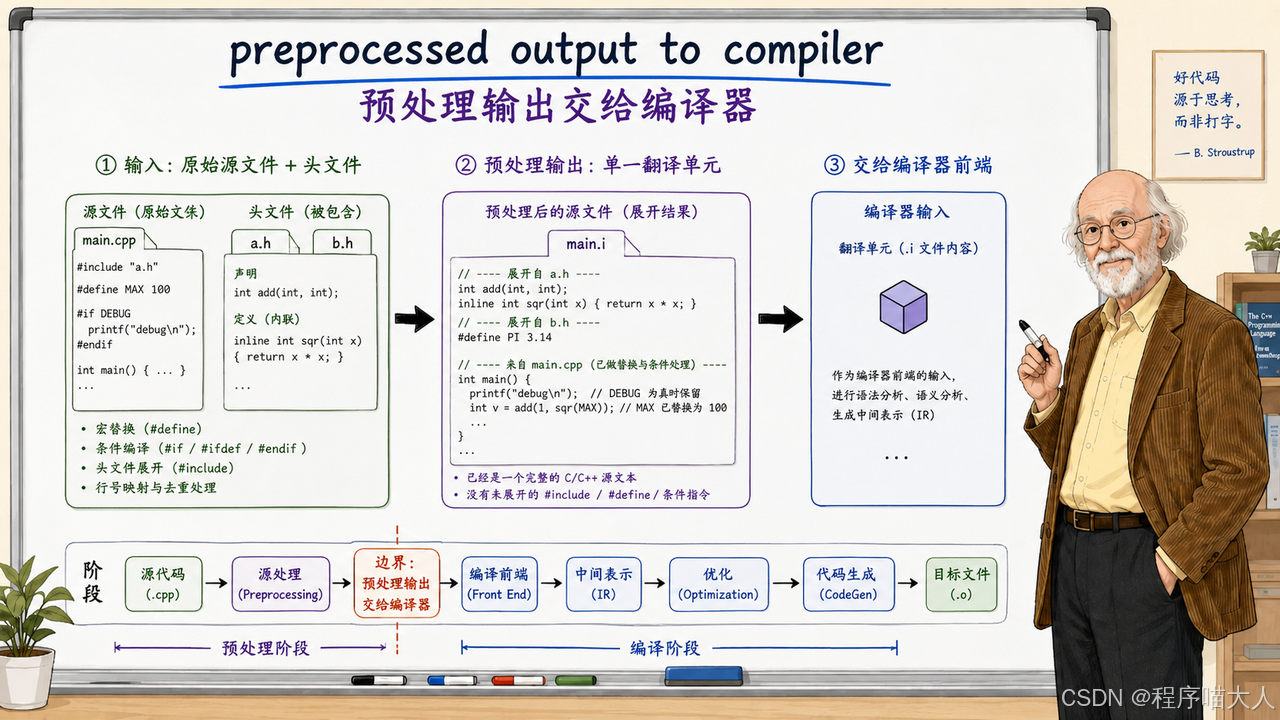
预处理输出的另一个实用价值是排查编译阶段的疑难杂症。当编译器报错说找不到某个类型、函数签名对不上、或者某个声明和预期不一致,而你又确认头文件路径和代码看起来都没问题时,用 clang++ -E 把预处理输出导出来,在输出里直接搜索相关的标识符,往往能看到头文件实际展开后的真实面貌。常见的情况包括:宏意外改变了标识符的名称或签名,条件编译剪掉了你以为存在的声明,include 顺序导致某个宏的状态与预期不同,头文件被意外地从一个不同的路径找到了。预处理输出不会说谎,它就是编译器真正面对的那份完整文本。
在实际排查中,阅读几万行的预处理输出不可能从头到尾逐行看。更有效的策略是直接跳到文件末尾找到自己的代码,确认周围上下文中展开的头文件内容是否符合预期;或者在输出中搜索特定标识符,核实它最终来自哪个头文件、被宏替换后长什么样。Clang 的 -E 输出还附带一个 -dM 变体,它不输出完整展开文本,只列出预处理结束后所有已定义的宏及其值,这在调查宏污染和条件编译分支问题时比完整输出更方便。日常开发中不需要频繁查看预处理输出,但知道怎么生成、怎么阅读,能让你在遇到"编译器说的和代码写的不一样"的情况时,有一个不依赖猜测的核实手段。
某些大型项目的头文件包含树非常深,一个源文件 include 了三五个头文件,预处理输出却可能有几十万行。阅读这种规模的预处理输出,一般不需要从头到尾逐行看。更有价值的阅读方式是:直接跳到文件末尾,找到自己写的函数声明或定义,确认它周围的上下文是否正确;或者在输出中搜索特定标识符,核实它来自哪个头文件、展开后长什么样。编译器在预处理输出中插入的 #line 标记(形如 # 1 "main.cc")记录了每一段文本的原始出处,这些标记在阅读预处理输出时可以作为路标使用,帮你定位某段展开文本对应的是哪个原始文件。
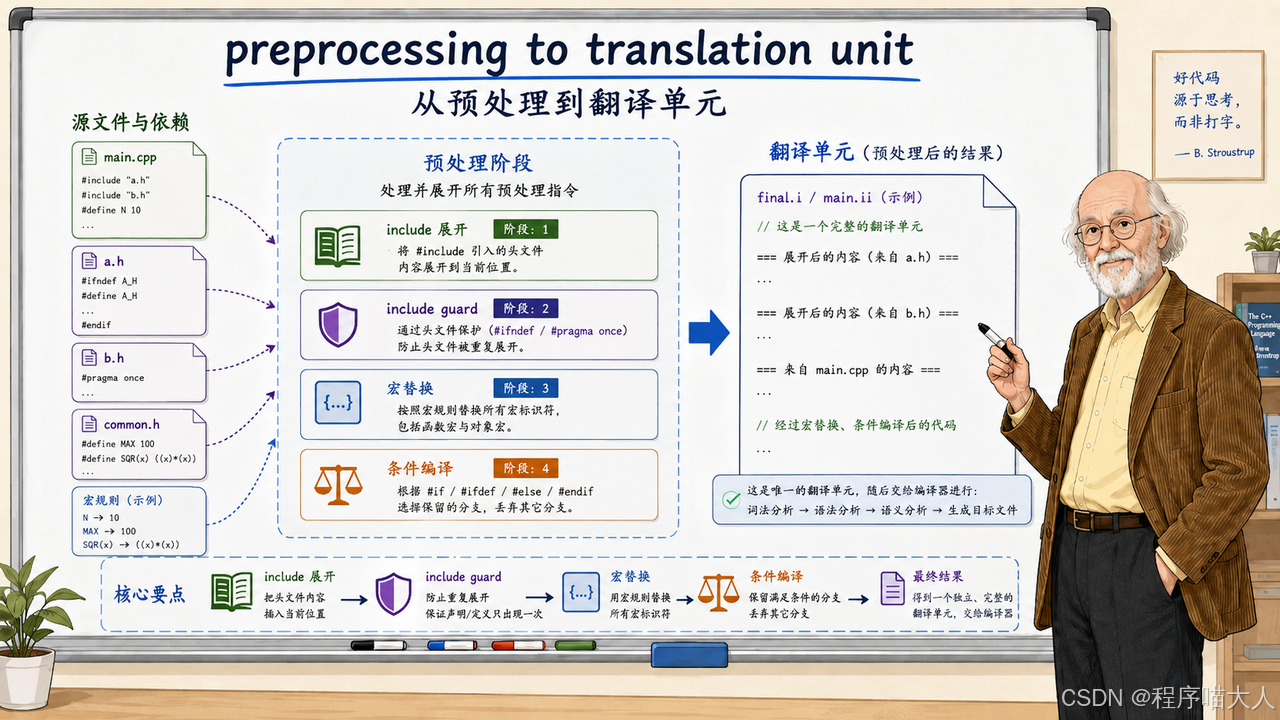
回看预处理阶段在整个构建链路中的位置,它是源码进入工具链之后的第一道加工。这一道加工把程序员组织的多文件源码结构拍平成一个自包含的文本流。#include 完成文件内容的递归合并,include guard 和 #pragma once 控制合并时的重入次数,宏和条件编译在文本层面完成选择和替换。预处理结束之后,产物是一份不再包含任何预处理指令的纯 C++ 源码文本。下一章把这个产物和它的源文件来源绑定在一起,明确 C++ 标准中的一个核心概念:翻译单元。编译器一次只处理一个翻译单元,多个 .cpp 通过头文件共享接口但编译期彼此不可见,这个机制是整个分离编译模型的基础。
码字不易,欢迎大家点赞,关注,评论,谢谢!