一台机器跑到半夜,磁盘告警,第一反应是查谁在写大文件,翻下去发现是 rustfs.log 一个文件占了十几 G。这种事在没配日志目录的部署上很常见。RustFS 的日志行为由可观测性那一组环境变量管。轮转时间、保留份数、总大小预算这三个默认值单独看都合理,合在一起却会互相影响,这也是日志目录最容易悄悄涨满的原因。只是真涨满的时候,往往不是这三条规则漏了。
日志往哪儿走,主要看目录变量怎么填
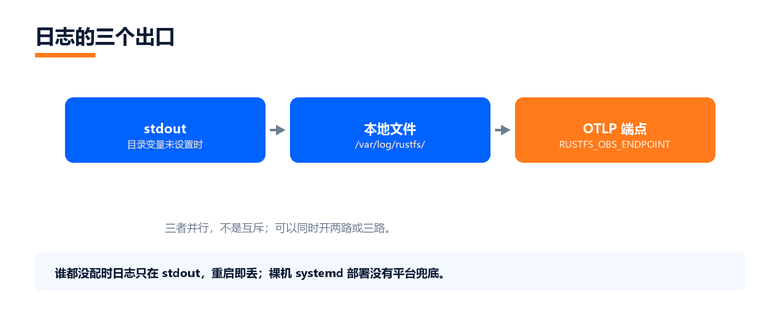
RUSTFS_OBS_LOG_DIRECTORY 是决定性的那个。它的默认值是未设置,文档写明未设置时日志走 stdout;如果给它一个 URL 值,日志会发到远端端点;给一个普通路径,日志就落到本地磁盘。配套的几个是 RUSTFS_OBS_LOG_FILENAME,默认值 rustfs.log,决定落在目录下的文件名;RUSTFS_OBS_LOGGER_LEVEL,默认值未设置,是日志级别的过滤器,取值如 info、debug;RUSTFS_OBS_LOGS_EXPORT_ENABLED,默认 true,控制是否把日志导出到 OTLP 端点。
这几项是并行的,不是互斥的。日志可以既写本地文件、又导出到 OTLP,也可以只走 stdout。三种组合里最容易踩的是最后一种:谁都没配,日志全在 stdout 里,容器重启之后就找不回来了。跑在容器里的时候问题不大,因为平台会把 stdout 收走;跑在裸机 systemd 上就没这个兜底了。
目录的读写权限是这一节里最容易漏的一项。RUSTFS_OBS_LOG_DIRECTORY 指向的目录,运行 RustFS 的那个用户必须能写。容器里是 uid 10001,裸机部署要看 systemd 单元里写的是哪个用户。权限不对的时候症状很安静:日志写不进去,服务照常响应请求,读写成功率一片正常,只有日志文件的修改时间不再往前走。RustFS 的文件日志走非阻塞写入,写失败不会卡住业务线程,所以不会有报错堆到应用层,想发现它得主动看目录。
轮转时间有三档,默认按小时切
RUSTFS_OBS_LOG_ROTATION_TIME 的默认值是 hourly,可选 daily、hourly、minutely 三个值。这个默认值偏激进:一台访问量正常的机器,按小时切出来的日志量也不小,一个月攒下来几十个文件很正常。
把它设成 minutely 只在一种情况下有意义:日志量小到按分钟才攒出几 KB,需要精确的时间定位。生产环境按分钟轮转的常见问题在文件数上:清理规则里的份数先到,导致只保留了不到一天的内容,真要回溯三天前的故障时才发现中间那段被截掉了。要缩短时间粒度,顺手把保留份数按倍数抬上去,两个值要一起算。
还有一层风险更隐蔽,它跟文件大小无关,只跟文件个数有关:inode。按分钟轮转一天就是 1440 个文件,每个压缩后可能只有几十 KB,加起来远远不到 2 GiB,但目录里已经多了上千个条目。inode 是文件系统一级的固定配额,磁盘剩一半也照样可能建不出新文件,而容量告警在这个场景下完全不会响,日志那边却已经开始丢。开 minutely 之前先 df -i 看一眼余量,比等它真把文件数耗光了再去调保留份数省事。
顺带说清两个默认值背后的时间窗。RUSTFS_OBS_LOG_MIN_FILE_AGE_SECONDS 是 3600,意思是文件要满一小时才进入清理的视野;RUSTFS_OBS_LOG_CLEANUP_INTERVAL_SECONDS 是 1800,清理任务半小时才扫一次。这两个数字叠起来解释了为什么新部署的机器上日志会先攒一阵子才开始被回收,也解释了为什么磁盘占用曲线是台阶状而不是平滑下降。判断保留策略是否生效,要按小时看,不要按分钟。
按天轮转还容易忽略一件事:轮转靠时间触发,文件大小取决于这一段时间内的访问量,业务高峰月的日志可能比平时大几倍。所以总大小预算是兜底,份数规则才是常规约束。
保留 30 个文件,还有一条 2 GiB 的线
RUSTFS_OBS_LOG_KEEP_FILES 默认 30,含义是保留 30 个轮转后的文件。这条规则管的是「份数」。
RUSTFS_OBS_LOG_MAX_TOTAL_SIZE_BYTES 默认 2147483648,也就是 2 GiB,文档对它的描述是清理前的日志目录总大小预算。这条规则管的是总量,但它统计的范围比「目录里所有文件加起来」要窄:当前正在写的那个活跃文件不计入。
这跟清理任务的工作方式有关。它每隔一段时间扫一遍日志目录,找的是已经不再活跃的文件,压缩、按份数截断、按总量截断都发生在这批归档文件身上,正在写的那一个从头到尾不参与。所以 2 GiB 约束的是历史文件,跟目录当前实际占用是两码事。
真正的上限要看另一个变量:RUSTFS_OBS_LOG_MAX_SINGLE_FILE_SIZE_BYTES,默认值 0,也就是不设限。活跃文件能长到多大,只看日志级别和访问量,这两条预算都管不到。开篇那个十几 G 的 rustfs.log,两条规则都拦不住它。
想盯活跃文件,只有一条现成的指标:rustfs_log_cleaner_active_file_size_bytes。它采样的是当前那个文件的大小,判断预算够不够、清理有没有跟上,看它比拿磁盘总占用倒推要准。
两条规则同时起作用,实际效果是两者哪个先到算哪个。文件数量先到,就按份数截断;总大小先到,就按大小截断。把轮转时间设成 minutely 而保留份数仍是 30,一天就是 720 个文件,磁盘还没到 2 GiB 但 inode 已经很紧张了;反过来把保留份数调到 300 而轮转是 daily,文件数永远到不了 300,最后起作用的一定是 2 GiB 那条线。
ini
RUSTFS_OBS_LOG_DIRECTORY=/var/log/rustfs/
RUSTFS_OBS_LOG_ROTATION_TIME=daily
RUSTFS_OBS_LOG_KEEP_FILES=14
RUSTFS_OBS_LOG_MAX_TOTAL_SIZE_BYTES=1073741824
RUSTFS_OBS_LOGGER_LEVEL=info
给这条路留预算的时候,这一块要单独算。系统盘和数据盘分开的部署,日志目录放在系统盘上,给它 1 到 2 GiB 完全不影响数据面。
日志目录和数据卷放在同一块盘上则更麻烦,因为日志涨满的时机往往正好是业务最需要写进去的时候。故障期间重试、超时、连接拒绝会连着刷出大量错误日志,日志在这一刻翻倍,盘也在这同一刻被打满,对象写入跟着失败,失败又继续产出日志。走这条路的部署,除了把 2 GiB 算进容量规划,最好再往数据面留出一截能扛住日志尖峰的余量,不然这三件事会挤在一起发生。
压缩默认开着,算法可换
RUSTFS_OBS_LOG_COMPRESS_OLD_FILES 默认 true,即轮转之后的文件会被压缩,文档写明默认算法是 zstd,可以通过 RUSTFS_OBS_LOG_COMPRESSION_ALGORITHM 换掉。
压缩能省多少,取决于日志内容。结构化 JSON 日志压缩比通常在 5 到 10 倍之间,这直接影响上面那条 2 GiB 预算的实际含义:预算约束的是压缩后的体积,所以开着压缩时,2 GiB 的归档对应的是 20 GiB 上下的原始文本。反过来,如果关掉压缩去省 CPU,同样预算能留下的原始日志量就只有十分之一。
这里有个排查上的实际用处。线上出问题需要回溯几小时前的日志时,先确认压缩是开着的,再按文件名定位,不要以为文件不存在是日志被清掉了。
同时留一份到 stdout 的使用场景
RUSTFS_OBS_LOG_STDOUT_ENABLED 默认值未设置,文档的说法是当文件日志或 OTLP 日志处于激活状态时,额外把日志镜像一份到 stdout。它在容器化部署里比较顺手:日志以文件形式落在挂载的目录里便于持久化,同时镜像到 stdout 让平台的日志采集器能直接收走,不用额外配一个文件 tail。
RUSTFS_OBS_USE_STDOUT 是另一个开关,默认值未设置,作用是强制遥测输出走 stdout。两个名字接近,作用范围不同,一起写之前先确认自己要的是「镜像」还是「强制」,设错了会出现日志只出现在一处、排查时以为没日志的情况。
至于导出端,RUSTFS_OBS_ENDPOINT 是 traces、metrics、logs 三者的根地址,文档给的例子是 http://otel-collector:4318;不设的话日志走 stdout 或本地文件。另有 RUSTFS_OBS_TRACE_ENDPOINT、RUSTFS_OBS_METRIC_ENDPOINT、RUSTFS_OBS_LOG_ENDPOINT 三个按信号覆盖的入口,想只把日志送到一处、其余两路走默认时用它。
指标采集间隔是另外一组变量
日志归日志,指标有独立的间隔配置。文档给出的命名规律是 RUSTFS_METRICS_<SCOPE>_INTERVAL_SEC,作用域包括 DEFAULT、SYSTEM、CLUSTER、BUCKET、NODE、RESOURCE、AUDIT、NOTIFICATION 和 BUCKET_REPLICATION_BANDWIDTH,例子中 RUSTFS_METRICS_CLUSTER_INTERVAL_SEC=60 就是让集群指标的导出间隔变成 60 秒。
指标这一组和日志是分开的:它不跟随上面任何一条轮转配置,改日志预算不会影响指标上报的频率,反之亦然。排查「指标点太密 / 太稀」时往这一组里找,排查「日志目录涨得快」时往轮转那五个变量里找,两边不要混着试。
本地文件完好,不代表远端没丢
OTLP 那侧的失败模型和审计日志不是一套,别混着看。审计日志有个显式的磁盘队列开关,形如 RUSTFS_AUDIT_WEBHOOK_QUEUE_DIR_PRIMARY,配了目录,待投递的记录就先落到磁盘,收集端恢复之后能接着重放;不配的话这个目标会直接标成不启用重放。普通业务日志走的是 OTLP 导出器,没有对应的落盘选项,网络抖动或端点不可达时,待发的那批日志只在进程内存里排队。
这个区别在实际运维里的后果是:OTLP 收集端停服的那段时间,本地日志文件可能一个不少地按轮转规则留存,远端那条时间线上却缺了一段。事后翻日志系统发现某一小时整段没有数据,而磁盘上文件都在,很容易往收集端的存储上怀疑。判断依据要分开建:本地那侧看文件的修改时间和归档连续性,远端那侧看到达量,两边谁也替不了谁。
内存队列还有一层含义:进程一重启,没发出去的那批跟着内存一起没了。调整日志级别、改端点配置之后重启服务,不要假设远端能补上这一段。
最后回到开关本身。RUSTFS_OBS_LOGS_EXPORT_ENABLED 默认 true,导出到端点的日志在网络抖动时会自动重试,本地文件仍然按轮转规则保留,两者互不影响。想只留一份就用 RUSTFS_OBS_LOG_DIRECTORY 留空,想两边都留就把 RUSTFS_OBS_LOG_STDOUT_ENABLED 打开。
收尾前要过一遍的几件事
| 检查项 | 说明 |
|---|---|
RUSTFS_OBS_LOG_DIRECTORY 是否设置 |
未设置时日志只走 stdout,重启即丢 |
| 日志目录的属主与权限 | 运行用户写不进去时服务不报错,只是日志静默不涨 |
| 日志目录所在磁盘 | 是否和数据卷分开,是否留出日志尖峰的余量 |
| 轮转时长与保留份数的组合 | 两者哪一个先触发决定了实际上限 |
| 文件系统的 inode 余量 | 轮转粒度细的时候,容量够不代表还能建文件 |
| 是否需要镜像到 stdout | 容器化部署时避免采集器收不到日志 |
把这几条过一遍,日志这块基本不会在半夜给你制造惊喜。RustFS 的默认值对开发和小规模部署是合适的,问题只出在没人看过它们。
排查的时候还有一个开关值得试试。RUSTFS_OBS_LOG_DRY_RUN 打开之后,清理任务会把要删哪些文件、能腾出多少空间报出来,但不真的删。拿它验证一遍保留策略是否符合预期,比等磁盘真的满一次要早得多。
还有一条顺序问题容易被跳过:改了 RUSTFS_OBS_* 之后要完整重启服务才生效,环境变量不会热加载。重启之后再用 curl -fsS http://<node>:9000/health/ready 确认节点回到就绪状态。多节点部署上按滚动方式重启,各节点的日志目录如果落在不同大小的磁盘上,总预算的实际效果会有差异,逐个核对比一次全停更稳。
还有一条实践上的看法:日志量大的集群,真正需要保留的是检索能力而不是原始文件。接进 OTLP 之后,短期原始日志可以压到 3 到 5 天,需要长期留存的部分放进检索系统。这样 RUSTFS_OBS_LOG_KEEP_FILES 可以调小,2 GiB 的预算压力也随之下降,而日志检索能力并不损失。
日志级别也顺带说一下。RUSTFS_OBS_LOGGER_LEVEL 默认未设置,提到 debug 之后日志量常常涨一个数量级,2 GiB 预算会在几天内被打满。排查问题时临时调高,问题解决后调回来,比长期开着更划算。