Redis 的 String 是最常打交道的类型,缓存对象、计数器、分布式锁都靠它。它的底层不是一个 C 的 char *,而是自己实现的一套叫 SDS(Simple Dynamic String)的东西。
先看 C 字符串在这里到底哪里不够用。
C 字符串的问题
c
char *s = "hello";
strlen(s);   // 5
C 里的字符串就是一个以 \0 结尾的字节数组,长度没有任何地方记录,strlen 只能从头往后一个字节一个字节地扫,碰到 \0 停下。Redis 做很多操作都要拿长度,STRLEN、APPEND、SETRANGE 都得知道当前多长,每次都 O(n) 扫一遍不能接受。
第二个问题是二进制不安全。\0 是结尾标记,字符串中间就不能出现 \0:
c
char *s = "ab\0cd";   // 以为存了 5 个字节
strlen(s);            // 2,扫到第一个 \0 就断了
图片、压缩数据、protobuf、序列化后的二进制,中间出现 \0 太正常了。用 C 字符串存,这些数据会被截断。
第三个是拼接。往后面接内容,得先算新长度、malloc 一块新的、memcpy 两段、free 旧的。这些活交给调用方,忘一次 free 就是内存泄漏,长度算错一次就是缓冲区溢出。
SDS 要解决的就三件事:长度 O(1) 拿得到、能存二进制、拼接扩容别让调用方操心。
SDS 的结构
c
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len;         // 当前字符串长度
    uint8_t alloc;       // buf 分配的总容量,不含头部和结尾的 \0
    unsigned char flags; // 低 3 位标类型,高 5 位没用
    char buf[];
};
len 直接记长度,STRLEN 读一下返回,O(1)。真正的结尾是 buf[len],不再靠 \0 判断,所以中间出现多少 \0 都不影响,二进制安全就是这么来的。
buf 末尾那个 \0 还是留着,为了兼容 C 的字符串函数。printf("%s", s->buf) 这类用法还能用,Redis 内部调 strcasecmp、strchr 的时候也不用改。
alloc 是已分配的容量,和 len 一比就知道还能塞多少。__attribute__ ((__packed__)) 是让编译器别做内存对齐,不加的话 flags 后面会补齐到 4 字节,平白多几个字节。
len 和 alloc 用多宽,有五种组合:
| 类型 | 长度字段 | 能表示的最大长度 | 头部大小 |
|---|---|---|---|
sdshdr5 |
无,编进 flags | 31 | 1 字节 |
sdshdr8 |
uint8_t |
255 | 3 字节 |
sdshdr16 |
uint16_t |
65535 | 5 字节 |
sdshdr32 |
uint32_t |
4G | 9 字节 |
sdshdr64 |
uint64_t |
2^64 | 17 字节 |
存一个 5 字节的短字符串用 sdshdr8,头部只要 3 字节;如果不管长度一律用 sdshdr64,光头部就 17 字节,小字符串一半内存都是头。按实际长度选最窄的那个,这就是要分五种的原因。sdshdr5 更极端,把长度直接编进 flags 那一个字节里,连 len 字段都省了,代价是长度一改就得重新分配。
扩容
APPEND 到 SDS 上,如果 len 已经追上 alloc,就要扩容。策略和手动 realloc 不一样:
text
新长度 <  1MB   →  分配 2 * 新长度
新长度 >= 1MB   →  分配 新长度 + 1MB
小于 1MB 直接翻倍,连续 APPEND 很多次也不用每次都真的去 realloc,摊还下来是 O(1)。超过 1MB 就不翻倍了,大字符串翻倍浪费太多内存,改成每次多给 1MB。
缩短字符串的时候,SDS 不立刻把内存还回去,len 变小但 alloc 不动,留着给后面的 APPEND 用,这叫惰性释放。要真收回内存得有明确的信号,比如整个 SET 一个新值。
扩容记两个数就够了:小于 1MB 翻倍,超过 1MB 每次多加 1MB。缩的时候不还,留着下次用。
三种编码
SDS 是 String 底层统一的东西,但 OBJECT ENCODING 看到的却是另外三个名字,int、embstr、raw。它们说的是 robj 和 SDS 怎么组合,第 1 篇里区分过的类型和编码,在这里就是最典型的一组。
int
shell
127.0.0.1:6379> SET counter 100
OK
127.0.0.1:6379> OBJECT ENCODING counter
"int"
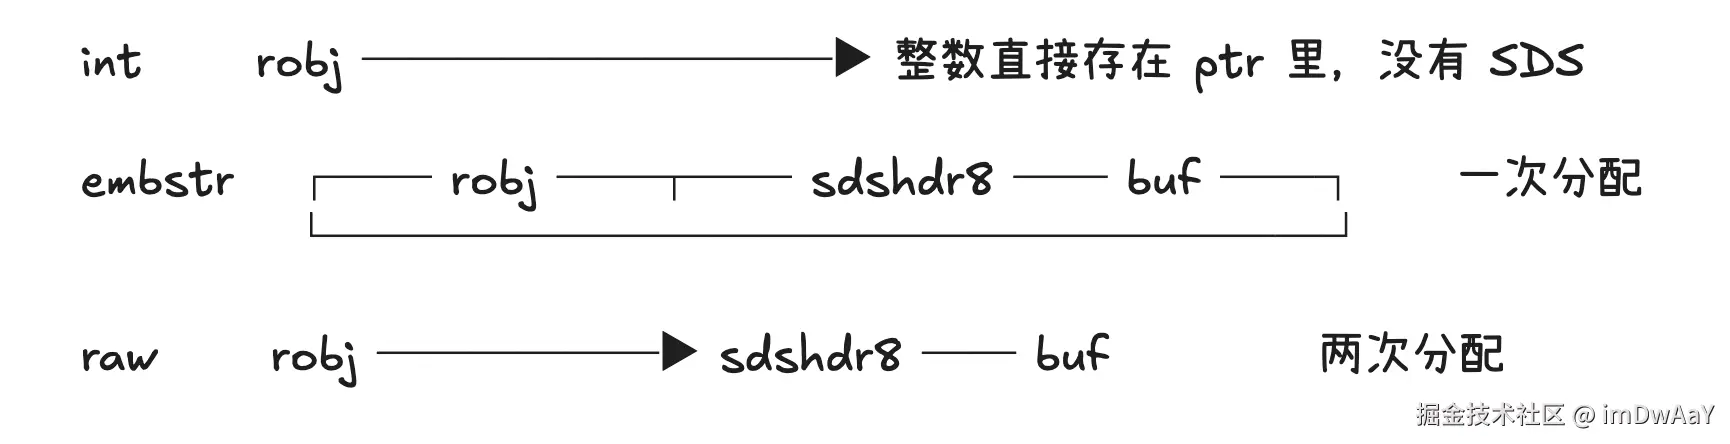
值是整数、能塞进 long long(长度不超过 20 字节),就不分配 SDS,直接把整数存进 ptr。INCR 系列认准这种编码,读出来加一,写回去还是 int,全程不碰字符串。
embstr
shell
127.0.0.1:6379> SET greeting "hello redis"
OK
127.0.0.1:6379> OBJECT ENCODING greeting
"embstr"
长度不超过 44 字节的字符串用 embstr。它的特点是 robj 和 sdshdr 连着分配在同一块内存里,一次 malloc 拿到,释放也是一次。
44 这个数不是拍脑袋来的,算出来刚好卡在 64:
text
robj        16 字节
sdshdr8      3 字节
buf         44 字节
\0           1 字节
--------------------
合计         64 字节
jemalloc 按 8、16、32、48、64、80... 一档一档地分配,64 是一档。把 embstr 的上限压在 63 字节以内,一次分配正好占满 64 这一档;再多一个字节就要跳到 80 那一档,白浪费 16 字节,那还不如直接换成 raw。所以是 44。
embstr 被标成只读。它和 robj 连着分配,改内容要重新分配、还要处理两边的引用,不划算。任何修改(APPEND、SETRANGE、INCR)都会先把它转成 raw 再改:
shell
127.0.0.1:6379> APPEND greeting "!"
(integer) 12
127.0.0.1:6379> OBJECT ENCODING greeting
"raw"
raw
超过 44 字节,或者被改动过的,就是 raw:robj 和 sdshdr 分两次分配,内容可变。
三种编码的内存布局:
什么时候会切换
| 操作 | 编码变化 |
|---|---|
SET k 123 |
→ int |
SET k 短字符串(≤44 字节) |
→ embstr |
SET k 长字符串(>44 字节) |
→ raw |
对 embstr 做 APPEND / SETRANGE |
→ raw |
对 int 做 INCR / INCRBY |
还是 int |
对 int 做 APPEND |
→ raw,整数变成字符串了 |
这里和 Hash、Set 那种单向升级不太一样。String 的编码切换是双向的,一个 SET 就能把它重置回去,新值长什么样就对应什么编码。
应用场景
缓存对象。 把对象序列化成 JSON 存进去,SET user:1 '{"name":"tom"}'。整个对象读、整个写,不需要按字段操作,String 最省事。要频繁改单个字段,用 Hash,见哈希表那篇
计数器。 INCR、INCRBY、DECRBY 都是原子的,单线程下天然没有并发问题,文章阅读数、点赞数靠它。值是 int 编码,连 SDS 都不占。
分布式锁。 SET lock 1 NX EX 10,一条命令同时表达"key 不存在才设置"和"10 秒后过期"。别写成 SETNX 再加一条 EXPIRE,两条命令中间进程挂了,锁就永远解不开了。
Session 共享。 把 session 序列化成 JSON 存 String,多台机器读同一份,这是早期做无状态服务最常用的办法。
String 能有多大
String 的 value 上限是 512MB,来自 Redis 协议里单个 bulk string 的限制 proto-max-bulk-len,默认就是 512MB。
这个数和 bit 操作对得上。512MB 等于 2^29 个字节,也就是 2^32 个 bit,所以 SETBIT 的 offset 最大能到 2^32 - 1。用 String 当 bitmap 的时候,这个上限就是天花板,见 签到、UV、附近的人那篇。