有同事问我,本地大模型能不能直接读公司的产品文档,别张嘴就瞎编。我前阵子用 AnythingLLM 搭过一套本地知识库,能用,但中间踩了三个坑,今天把过程和调参的地方写下来。
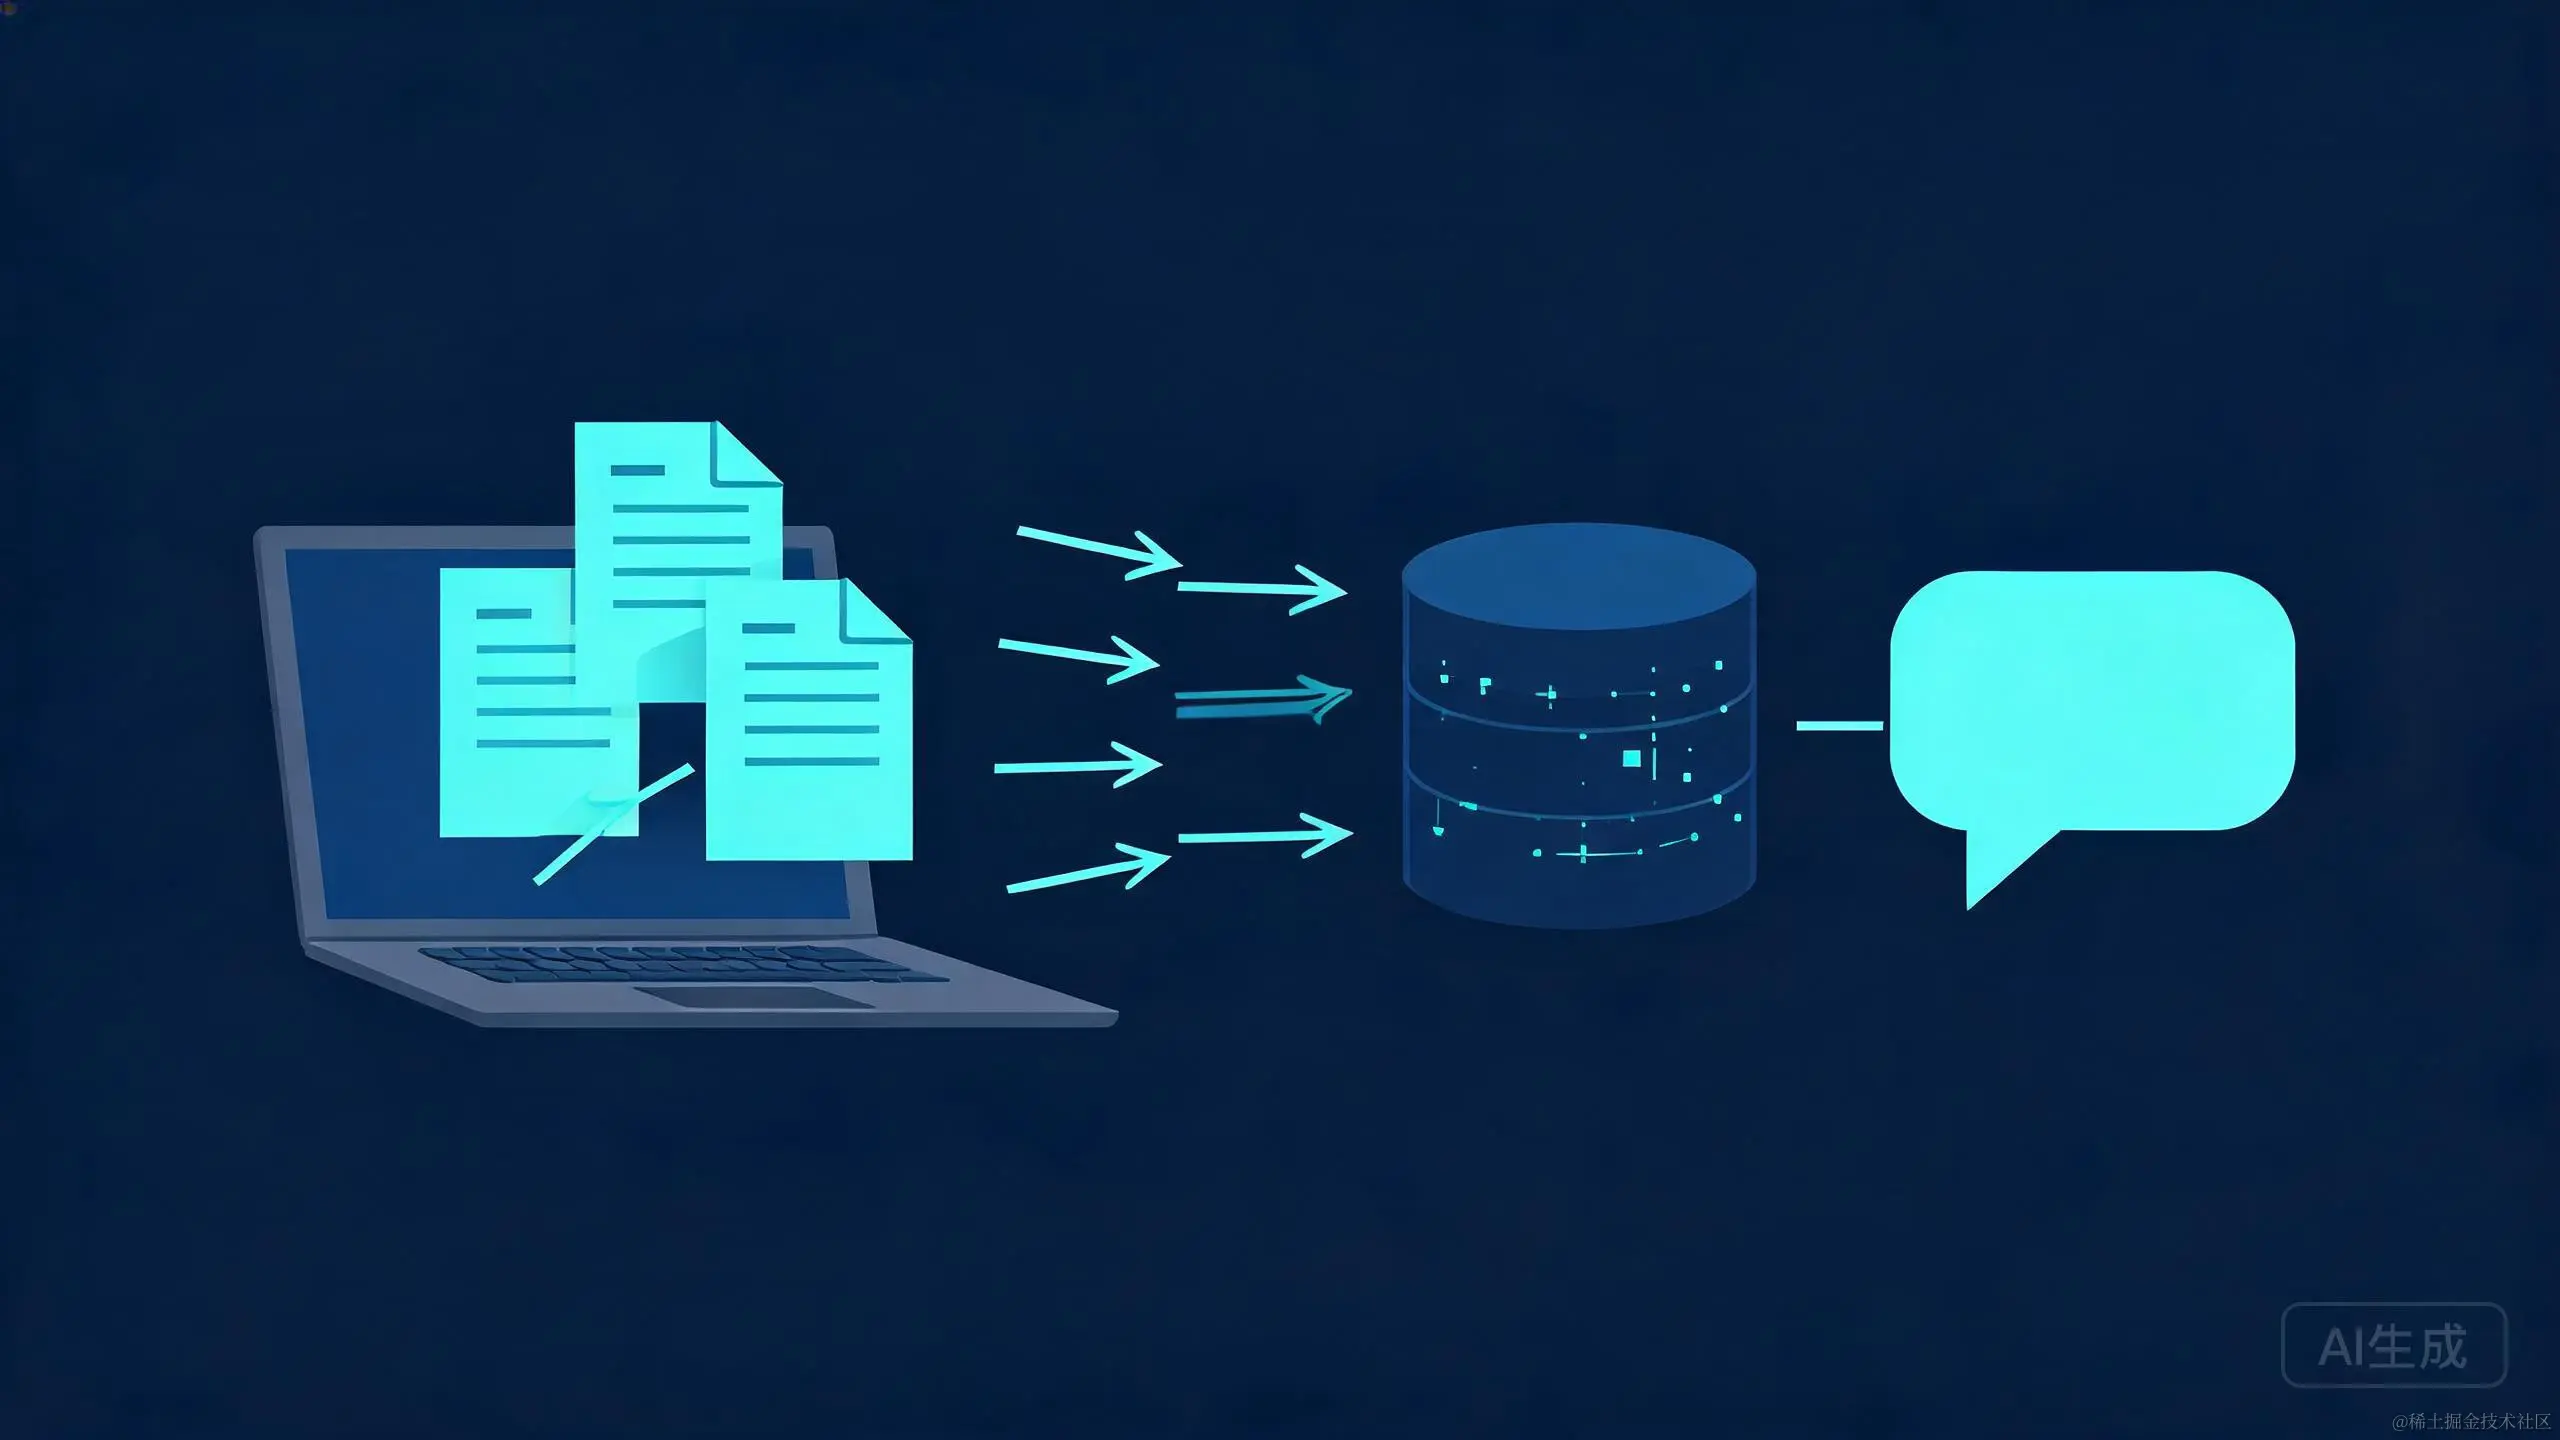
先说这套东西在干嘛。让模型回答文档里的问题,靠的是 rag:把文档切成小段,算成向量存进向量库,你提问时先捞出最相关的几段,再交给模型拼答案。AnythingLLM 就是把这些环节串起来,另外带个网页界面,省得自己写胶水代码。
它跑在本地,文档不出机器,这也是我选它的原因。
两条命令把它拉起来
我用 Docker 跑的,桌面版应该更省事,但我习惯容器。
docker run -d -p 3001:3001 -v anythingllm:/app/server/storage --name anythingllm mintplexlabs/anythingllm
镜像名是 mintplexlabs/anythingllm,端口映射到本机 3001,浏览器打开 localhost:3001 就能见到界面。那个 -v 参数别省,工作区、文档、向量库都落在里面,容器删了重装数据还在。
界面起来先接模型。设置里 LLM 选 Ollama,地址填 host.docker.internal:11434,聊天模型我用的 qwen2.5:7b。这里跟容器里找不到 Ollama 是同一个老问题,容器里的 localhost 指它自己,不是你的电脑,得用 host.docker.internal 这个别名。
坑一:光配聊天模型不够
我配完聊天模型就直接传文档,点 Save and Embed 报错,提示大意是 embedding 失败。愣了一会儿才想起来,向量模型是单独一份,得自己拉。
ollama pull nomic-embed-text
然后在 AnythingLLM 的 Embedder 那一栏选 Ollama,模型名填 nomic-embed-text,地址还是上面那个。这一步没做,文档永远进不了库。
坑二:传上去不等于进了库
这是最容易懵的地方。AnythingLLM 里的文档先落在暂存区,我理解它是个草稿箱,你还要点 Move to Workspace 挪进工作区,再点 Save and Embed 才真正切片入库。我第一步只做了上传,提问时它回我一句工作区里没有文档。界面上文件明明躺着,我盯着看了半分钟才反应过来是没挪进去。
坑三:回答不准,多半是切片切坏了
前两个坑解决完能问答了,但答案不对味。我那份手册里有两章内容很像,模型回答时把两边的说法揉在一起讲,还编了个中间版本的参数出来。
问题在切片长度。工作区设置里的 Text Splitter 有两项,chunk size 和 overlap。默认切得偏长,一个片段里混了好几个主题,检索出来就是一堆夹生料。我把它调成 chunk size 700、overlap 100,重新 embed 了一遍,同样的问题再问,它只引用该引用的那一章,不再串台。
overlap 的含义是相邻片段的重叠字数,留一点能防止一句话被从中间切断。这个值给太大片段会重复,给 0 又容易丢上下文,100 上下我觉得够用。
召回这块还能再调两个地方
工作区设置里 Search Preference 我选的 Accuracy Optimized,下面的 TopN 从 4 调到 6。TopN 是一次捞几个片段给模型,给少了信息不够,给多了噪声进来反而答偏。
还有个相似度阈值,这个得拿自己的文档试。设低了不相关的片段也会被捞进来,答非所问;设高了经常一条都匹配不上,模型回你一句没找到相关内容。我现在的值是 0.25,你的文档得自己磨。
现在的效果
我日常工作区里放了十几份文档,问具体条款、问参数含义基本能答到点上,答的时候会带上引用的片段,方便我核对。要一句能转给同事的话:先把 nomic-embed-text 拉下来配上 Embedder,再确认文档 Move to Workspace 后 Save and Embed,最后把 chunk size 压到 700 附近,八成的答不准都在这三步里。
本地部署还有一层安心是文档不出门,但别把端口随手开到公网,那是另一个话题了。
这篇是本地大模型系列第三篇,前两篇写了怎么给命令行套网页界面、怎么按显卡选模型。后面我打算写 Ollama 部署 gguf 报兼容性错误怎么排查,还有 AnythingLLM 里向量库换成 Chroma 的差别,都是自己踩过的。想看后续关注一下账号。