本次导航
- 内存分析:
INFO memory、MEMORY USAGE、内存碎片 - 慢查询:谁在偷偷拖慢 Redis?
- Big Key 的危害与查找:大对象是性能杀手
- Hot Key 检测:Redis 8.6 的
HOTKEYS命令 - 实战优化手段:lazy free、内存淘汰策略
发车前提醒:建议先熟悉 Redis 基本命令,优化思路和具体版本无关,但 Hot Key 检测使用 Redis 8.6+ 会更方便。
一、内存分析:内存都去哪儿了?
1.1 常用内存查看命令
bash
INFO memory这条命令会返回很多指标,不同版本略有差异,但以下几个核心字段基本都有:
| 字段 | 含义 |
|---|---|
used_memory_human |
实际使用的内存(含数据和开销) |
used_memory_rss_human |
操作系统看到的内存(RSS) |
maxmemory_human |
配置的最大内存限制 |
maxmemory_policy |
内存淘汰策略 |
内存碎片率:
碎片率 = used_memory_rss / used_memory1.0 ~ 1.5:正常范围。> 1.5:碎片严重,可以重启或执行MEMORY PURGE(部分版本有效)。< 1.0:发生了 swap,内存不足,赶紧加内存或扩容。
1.2 查看某个 Key 的内存占用
bash
MEMORY USAGE user:1001返回该 Key 占用的字节数。对 Hash、Set、List 等复杂类型特别有用,可以找到"胖 Key"。
1.3 内存淘汰策略(maxmemory-policy)
当内存达到 maxmemory 限制时,Redis 根据策略淘汰数据:
| 策略 | 行为 |
|---|---|
noeviction |
不淘汰,写操作返回错误(默认) |
allkeys-lru |
所有 key 中淘汰最近最少使用的 |
volatile-lru |
只在设置了过期时间的 key 中淘汰 LRU |
allkeys-lfu |
所有 key 中淘汰最不常使用的(7.0+) |
volatile-lfu |
只在有过期时间的 key 中淘汰 LFU |
allkeys-random |
随机淘汰 |
volatile-random |
在有过期时间的 key 中随机淘汰 |
volatile-ttl |
淘汰剩余寿命最短的 |
生产推荐 :allkeys-lru 或 allkeys-lfu(如果你知道热点数据)。
二、慢查询:找到"龟速"命令
2.1 原理
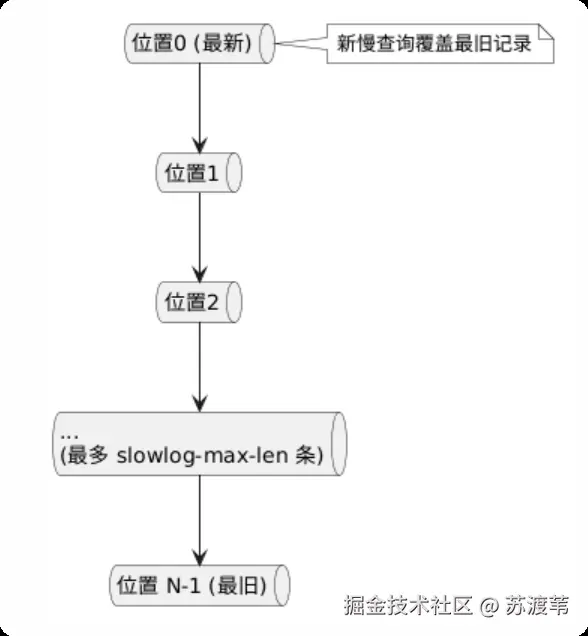
Redis 会把执行时间超过某个阈值的命令记录到慢查询日志(内存中的环形队列,不会写磁盘)。
配置项:
conf
slowlog-log-slower-than 10000   # 微秒,10 毫秒以上的算慢查询
slowlog-max-len 128             # 最多保留 128 条
2.2 查看慢查询
bash
SLOWLOG GET 10      # 取最近 10 条
SLOWLOG LEN         # 当前日志数量
SLOWLOG RESET       # 清空
输出示例:
bash
1) 1) (integer) 7           # 日志 ID
   2) (integer) 1735689600  # 时间戳
   3) (integer) 15000       # 执行耗时(微秒),即 15 毫秒
   4) 1) "KEYS"             # 命令及参数
      2) "user:*"
2.3 常见慢查询原因
KEYS *:遍历所有 key,数据量大时直接卡死 → 用SCAN替代。HGETALL/SMEMBERS:大 Hash 或大 Set 全量取 → 用HSCAN/SSCAN。ZRANGE范围太大。LUA脚本执行时间过长。
三、Big Key:性能杀手第一名
3.1 什么是 Big Key?
通常指一个 Key 存储的数据过大:
- String 类型值 > 10 KB
- Hash / Set / List / Sorted Set 元素个数 > 5000
3.2 Big Key 的危害
- 内存不均:集群环境下,某个节点内存飙升。
- 网络阻塞 :
HGETALL一个 1MB 的 Hash,QPS 稍高就能打满网卡。 - 慢查询:读写大对象耗时高。
- 删除阻塞:删除大 Key 时,会卡住服务几秒甚至几十秒(极端情况)。
为什么 DEL 删除大 Key 会阻塞?
Redis 的
DEL命令是同步执行的。当删除一个包含大量元素的复合数据结构(如 Hash、Set、ZSet、List)时,Redis 主线程必须:
- 遍历整个数据结构的所有元素
- 逐个释放内存
- 通知内存分配器回收空间
这个过程的时间复杂度是 O(N),N 为元素数量。在此期间,主线程无法处理任何其他客户端请求。
3.3 如何找到 Big Key?
方法一:--bigkeys 扫描(线上慎用)
bash
redis-cli --bigkeys它会遍历所有 Key,按类型统计最大和平均长度。
注意:线上大实例执行会消耗 CPU,建议在从库跑。
方法二:MEMORY USAGE 逐个检查
结合 SCAN 命令:
bash
SCAN 0 MATCH * COUNT 1000
MEMORY USAGE <key>
可以写脚本批量扫描。
方法三:使用 redis-rdb-tools(离线分析)
把 RDB 文件拿到本地,用工具分析出最大的 Key。
3.4 Big Key 优化方案
| 类型 | 优化方式 |
|---|---|
| 大 String | 压缩(gzip)、拆分成多个小 String |
| 大 Hash | 拆分成多个 Hash,按字段 ID 分桶 |
| 大 List / Set | 拆分成多个 List/Set,按时间或 ID 取模 |
| 大 Sorted Set | 冷热分离,只存热点数据,历史数据归档 |
删除大 Key 的正确姿势 :不要直接 DEL,会阻塞。用 UNLINK 命令(Redis 4.0+)异步删除:
bash
UNLINK big_key四、Hot Key:流量尖兵
4.1 什么是 Hot Key?
某个 Key 被大量请求访问,比如爆款商品信息、热门微博、秒杀库存。
4.2 Hot Key 的危害
- 单个 Redis 实例 CPU 飙高
- 集群模式下流量倾斜,某个节点被打垮
- 缓存击穿(大量请求同时打到 DB)
4.3 如何发现 Hot Key?
Redis 8.6+ 原生支持 HOTKEYS 追踪
从 Redis 8.6 开始,引入了 Hot Keys Tracking 功能,可手动启动追踪、查询、停止。
完整操作流程:
- 启动追踪:指定要追踪的指标(如网络流量、CPU 时间)和采样率。
bash
# 只追踪 CPU 指标
HOTKEYS START METRICS 1 CPU

# 只追踪网络指标
HOTKEYS START METRICS 1 NET

# 同时追踪 CPU 和网络(推荐)
HOTKEYS START METRICS 2 CPU NET

# 带采样率(50% 采样)和持续时间(300秒)
HOTKEYS START METRICS 2 CPU NET SAMPLE 50 DURATION 300
参数说明:
METRICS count:必须为 1 或 2,后面跟上对应的指标(CPU和/或NET)。SAMPLE ratio:采样百分比(1-100),默认 100。DURATION seconds:自动停止时间,不填则需手动停止。COUNT k:指定要获取的热点 Key 数量,默认 10。
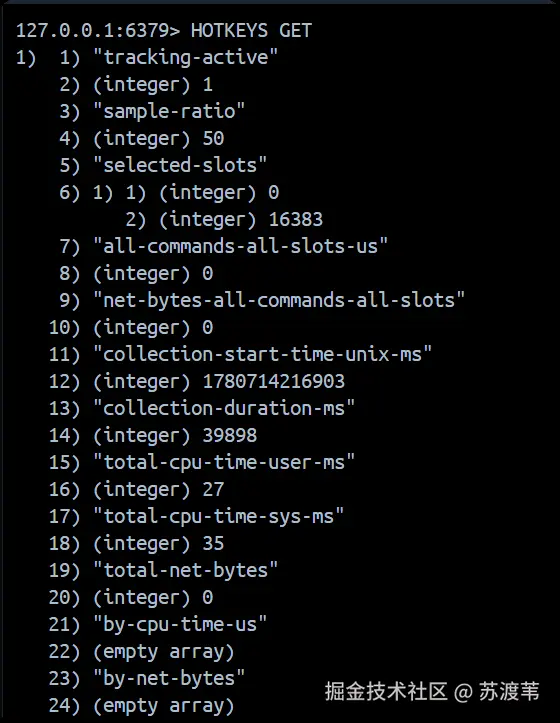
- 查询热点 Key:
bash
HOTKEYS GET返回结果是一个列表,其中会按指标分组,比如 by-cpu-time-us(CPU 时间微秒)、by-net-bytes(网络字节数)。每个分组下列出 Key 及其数值。
- 停止追踪:
bash
HOTKEYS STOP- 重置数据:
bash
HOTKEYS RESET示例输出片段 (HOTKEYS GET):
vbnet
...
by-net-bytes:
1) "product:detail:1001"
2) (integer) 5242880
3) "user:session:abc123"
4) (integer) 2097152
...
注意 :
HOTKEYS不是直接HOTKEYS 10就能用的,必须按START→GET→STOP流程操作。生产环境开启追踪会有一定性能开销,建议采样率不要太高,用完及时停止。
4.4 Hot Key 优化方案
| 方案 | 说明 |
|---|---|
| 本地缓存 | 客户端(如 JVM 缓存)存热点数据,减少访问 Redis 次数 |
| 读写分离 | 主库写,多个从库分担读(对热 Key 仍然所有从库都有压力) |
| Key 拆分 | 把热点 Key 复制多份,如 product:1001:1、product:1001:2,随机访问不同副本 |
| 限流降级 | 在 Redis 前加一层限流,保护后端 |
五、综合优化 checklist
- 配置
maxmemory并设置合理的maxmemory-policy - 开启慢查询日志,定期检查
SLOWLOG GET - 扫描并拆分 Big Key,删除用
UNLINK - 找到 Hot Key,加本地缓存或拆副本
- 监控内存碎片率,过高则重启或调优
- 避免使用
KEYS *,用SCAN代替 - 避免全量命令
HGETALL、SMEMBERS,用HSCAN/SSCAN
六、实操演练:亲手体验 Big Key 与 Hot Key
下面咱们在真实的 Redis 里跑一遍,感受 Big Key 和 Hot Key 的"威力"以及排查手段。
可用第 2 篇的方法使用 Docker 跑一个 Redis。
如果没有,先执行:
bashdocker run -d --name redis-demo -p 6379:6379 redis:latest
实操 1:制造一个 Big Key 并安全删除
步骤 1:写入一个包含 10 万个字段的 Hash
打开 redis-cli:
bash
docker exec -it redis-demo redis-cli然后用 Lua 脚本在服务端生成:
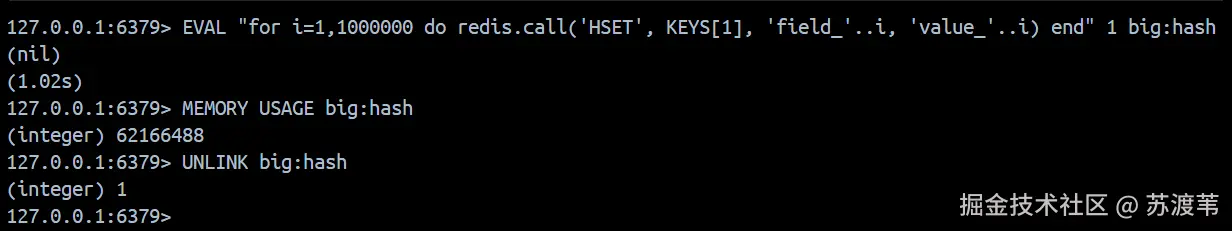
bash
127.0.0.1:6379> EVAL "for i=1,1000000 do redis.call('HSET', KEYS[1], 'field_'..i, 'value_'..i) end" 1 big:hashLua 脚本的问题我们下次再说。先挖个坑。
等待几秒,执行完毕。然后查看内存占用:
bash
127.0.0.1:6379> MEMORY USAGE big:hash
(integer) 62166488
步骤 2:模拟 Big Key 删除阻塞
直接 DEL 这个 Key,你会感觉到明显的卡顿(可能 0.5~1 秒):
bash
127.0.0.1:6379> DEL big:hash
(integer) 1如果数据更大,卡顿更明显。推荐做法 :用 UNLINK 异步删除,Redis 会立刻返回,后台慢慢回收内存:
bash
127.0.0.1:6379> UNLINK big:hash
(integer) 1
着重提醒 :记住 UNLINK 代替 DEL 的习惯。
实操 2:用 50 万个 Key 触发慢查询并查看日志
步骤 1:写入 50 万个测试 Key
在 redis-cli 中执行以下 Lua 脚本(一次性写入,耗时几秒):
bash
127.0.0.1:6379> EVAL "for i=1,500000 do redis.call('SET', 'test:'..i, 'value_'..i) end" 0等待执行完成。
步骤 2:执行一个"臭名昭著"的慢命令------KEYS *
bash
127.0.0.1:6379> KEYS *你会感觉到明显的卡顿,Redis 会遍历所有 50 万个 Key 并返回它们。
注意:生产环境绝对禁止这样做,这里只是演示。
步骤 3:查看慢查询日志
bash
127.0.0.1:6379> SLOWLOG GET 2输出示例:
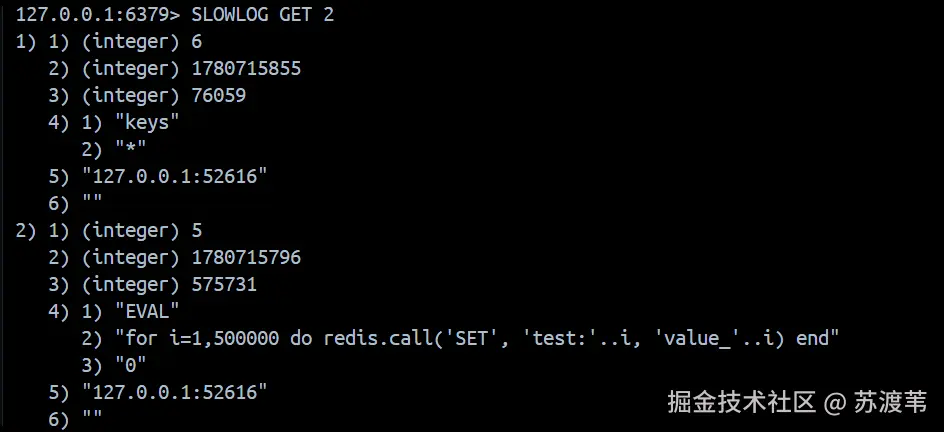
步骤 4:正确的替代方案------SCAN
bash
127.0.0.1:6379> SCAN 0 MATCH test:* COUNT 1000SCAN 不会阻塞 Redis,每次只返回一小部分 Key(游标迭代)。对其他请求无影响。
步骤 5:清理测试数据
bash
127.0.0.1:6379> EVAL "for i=1,500000 do redis.call('DEL', 'test:'..i) end" 0或者直接删库(测试环境):FLUSHDB。
实操 3:模拟 Hot Key 并用 HOTKEYS 检测(Redis 8.6+,Windows Docker 环境)
步骤 1:启动热点追踪
bash
127.0.0.1:6379> HOTKEYS START METRICS 2 CPU NET步骤 2 :制造热点访问,直接在 redis-cli 里用 Lua 脚本在服务端制造访问
在 redis-cli 里直接执行下面这个脚本,它会一次性在 Redis 内部对 hot:key 增加 10000 次,不走网络往返:
bash
127.0.0.1:6379> EVAL "for i=1,10000 do redis.call('INCR', KEYS[1]) end return 'done'" 1 hot:key执行完后,hot:key 的值是 10000。
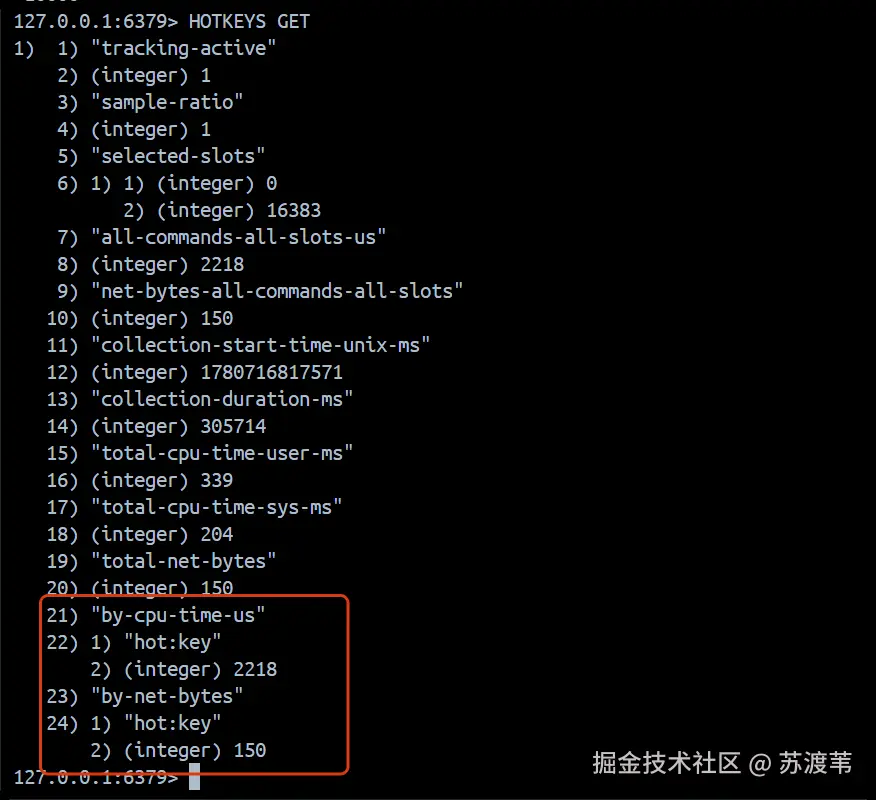
步骤 3:查询热点 Key
bash
127.0.0.1:6379> HOTKEYS GET观察输出中的 by-cpu-time-us 或 by-net-bytes 分组,能看到 hot:key 出现在热 Key 列表中:
步骤 4:停止追踪
bash
127.0.0.1:6379> HOTKEYS STOP步骤 5:查看热 Key 最终值
bash
127.0.0.1:6379> GET hot:key
(integer) 10000
本次导航结束,欢迎 关注、点赞、转发。