第 3 讲 日志系统:一条 SQL 更新语句是如何执行的
redo log、binlog 与两阶段提交
------ 基于 percona-server-9.7.1-1 源码(MySQL 9.7 LTS)
一、开篇问题引入
第 02 讲看完一条查询怎么走,这一讲看它的"写兄弟":update T set c=c+1 where id=2; 你可能会问三个问题------第一,MySQL 为什么不直接改磁盘上的数据页,而要先在内存里改?第二,为什么既要写 InnoDB 的 redo log、又要写 Server 层的 binlog,两份日志不冗余吗?第三,如果改到一半机器掉电,重启后数据会不会错乱、丢失?这三个问题,正好对应 MySQL 写入链路的三个支柱:缓冲池(Buffer Pool)、WAL(Write-Ahead Logging)、两阶段提交(2PC)。读懂它们,你就掌握了 InnoDB 崩溃恢复与 MySQL 主从复制共同的地基。
二、原理剖析
1. 为什么不直接改磁盘:Buffer Pool 与 WAL
直接随机改磁盘数据页代价极高(一次随机写可能十几毫秒),而内存访问是纳秒级。所以 InnoDB 把数据页缓存在 Buffer Pool,更新只改内存页并打上"脏页"标记,由后台线程异步刷盘。但内存易失,掉电就丢------于是引入 WAL 原则:任何对数据的修改,必须先写日志(redo log)并落盘,才能算"已提交",数据页可以稍后再刷。这样即使脏页还没写回磁盘就断电,重启后也能凭 redo log 把修改重放出来,保证持久性(crash-safe)。redo log 是 InnoDB 特有的物理日志,记录"某个数据页的某个偏移做了什么改动",循环写、空间固定。
2. redo log:InnoDB 的崩溃安全网
redo 在 9.7 由容量模型统一管理:总容量由 innodb_redo_log_capacity 控制(默认 100MB,见 storage/innobase/handler/ha_innodb.cc:23746 的 DEFAULT(100 _ 1024 _ 1024);注意若开启 innodb_dedicated_server 且未显式指定,9.7 会按 min(vCPU/2, 16) × 1GB 自动放大这个默认值,见 ha_innodb.cc:4963-4970),引擎在 #innodb_redo 目录下动态维护若干 redo 文件循环复用,不再有"固定 N 个文件 × 单文件大小"的手工配比(innodb_log_file_size / innodb_log_files_in_group 自 8.0.30 起弃用、9.7 已移除)。环上有 write pos(当前写入点)和 checkpoint(已刷盘、可覆写点)。写满时推进 checkpoint 把老脏页刷盘,腾出空间。9.7 沿用了 8.0 引入的日志架构:用户线程只把 redo 写入 log buffer(通过 log_buffer_reserve 预留空间、mtr_commit 成组提交),真正的落盘由独立的 log writer 线程与 log flusher 线程异步完成,用户线程不必亲自做 IO。redo 写盘策略由 innodb_flush_log_at_trx_commit 控制(=1 表示每次提交都 fsync 到磁盘,最安全)。
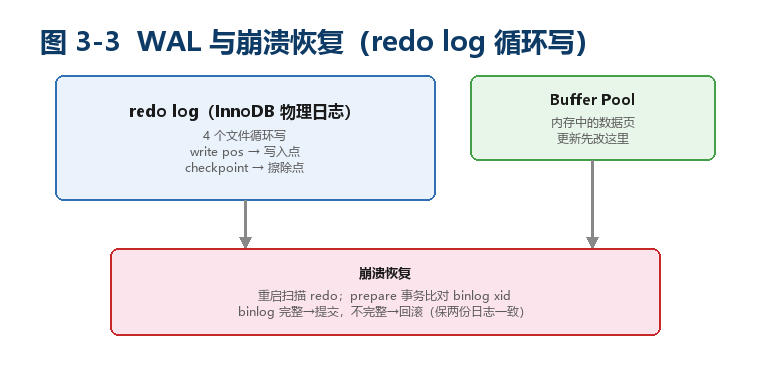
图 3-3 WAL 与崩溃恢复(redo log 循环写)
3. binlog:Server 层的逻辑日志
binlog 是 MySQL Server 层、与引擎无关的二进制日志,以"事件"形式追加记录每条 SQL 或每行的前后像,用于主从复制与时间点恢复(PITR)。它逻辑、追加写、不会覆盖。binlog 有三种格式:statement(记 SQL,可能因函数/不确定性导致主从不一致)、row(记行变更,最安全,9.7 默认)、mixed(由优化器择机)。注意:binlog_format 在 9.7 已被标记为 DEPRECATED(sql/sys_vars.cc:1589/1593),未来版本将只保留 ROW,不要为"省 binlog 空间"而切回 statement/mixed;确有体积压力应改用 binlog_transaction_compression。redo log 与 binlog 职责根本不同:redo 解决"单机崩溃不丢已提交事务",binlog 解决"把变更同步给从库 / 按时间点回放"。历史上是先有 binlog(用于复制),后来 InnoDB 作为插件加入时为了 crash-safe 才引入 redo,二者长期并存,靠两阶段提交保证一致。
4. 一条 UPDATE 的完整执行链路
把链路串起来(见图 3-1):① 客户端发来 UPDATE;② 执行器通过 handler 把 id=2 所在数据页读进 Buffer Pool;③ 在内存页上执行 c=c+1,同时写 undo log(用于回滚与 MVCC 快照);④ InnoDB 把这次改动以 mtr(mini-transaction, redo 的原子写入单元)成组写入 redo log buffer,并把事务标记为 prepare 状态;⑤ Server 层把该事务写入 binlog 并 flush 到磁盘;⑥ 执行器通知 InnoDB 把事务置为 commit 状态,redo 由 log writer 刷盘;⑦ 向客户端返回 OK。注意"先 redo(prepare) 后 binlog 再 redo(commit)"的顺序,正是两阶段提交的关键。
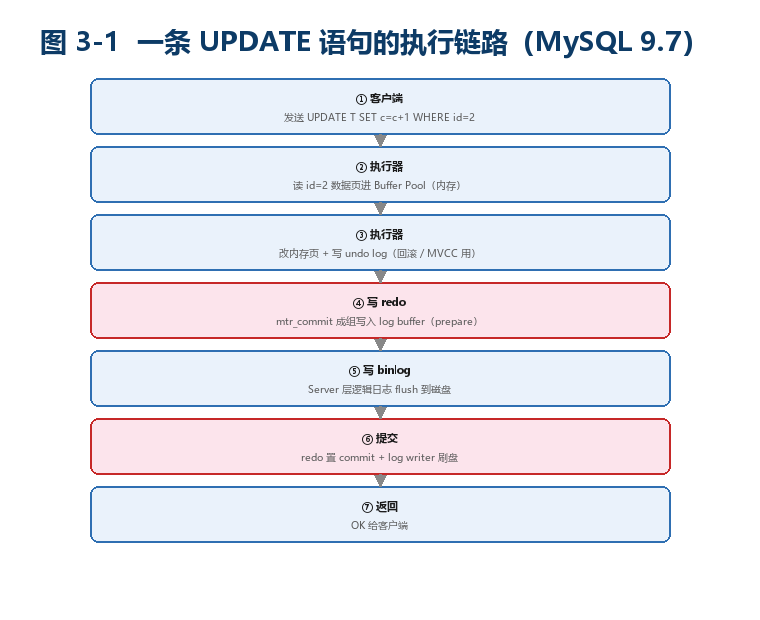
图 3-1 一条 UPDATE 语句的执行链路(MySQL 9.7)
5. 两阶段提交(2PC):让两份日志逻辑一致
为什么需要两阶段而非"写完 redo 再写 binlog"?因为这两份日志是先后写、可能被中断,必须保证它们对"某事务是否已提交"的判断一致,否则会出现:binlog 有、redo 没有 → 从库比主库多数据;或 redo 有、binlog 没有 → 主库比从库多数据。2PC 用 prepare / commit 两个阶段化解(见图 3-2):阶段一,InnoDB 写 redo 并把事务置 prepare;阶段二,Server 写 binlog,再让 InnoDB 把事务置 commit。崩溃恢复时,重启扫描 redo 中处于 prepare 的事务,去 binlog 里按事务 XID 查找:若 binlog 中该 XID 完整(已落盘),说明事务应提交,InnoDB 补做 commit;若 binlog 中没有,说明 binlog 没写完,事务回滚。这样无论断电发生在哪个瞬间,主从两份日志最终都一致。
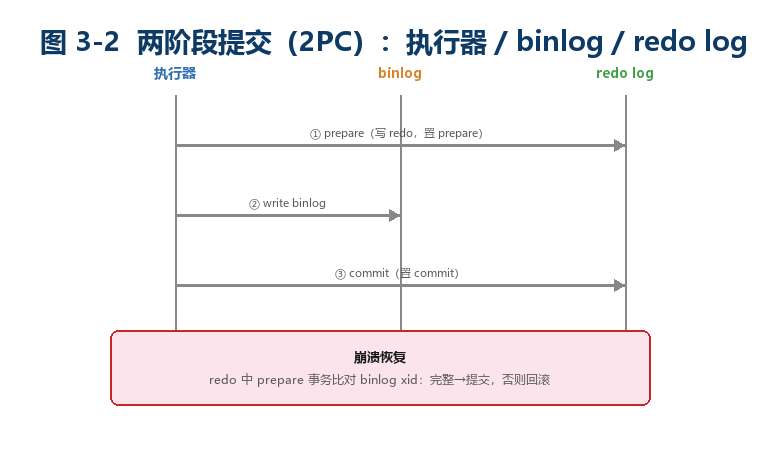
图 3-2 两阶段提交(2PC):执行器 / binlog / redo log
6. redo log 再深入:LSN、checkpoint 与日志文件大小
理解 redo 要抓住一个核心概念:LSN(Log Sequence Number),它是一个单调递增的逻辑序号,既标记 redo 日志写到哪里,也标记每个数据页被修改到了哪个版本。内存中的脏页按 LSN 排进 flush list,checkpoint 推进到"最老脏页的 LSN",意味着该 LSN 之前的所有修改都已刷回数据文件,这部分 redo 空间即可覆写。redo 在 9.7 由容量模型统一管理,总容量由 innodb_redo_log_capacity(默认 100MB)控制(innodb_log_file_size / innodb_log_files_in_group 自 8.0.30 起弃用、9.7 已移除),引擎在 #innodb_redo 目录动态维护文件(单文件默认约 3MB,即 100MB 总容量 ÷ 32 个文件,9.7 可配更大)决定:调大能降低 checkpoint 触发频率、减少脏页突发刷新、提升写入吞吐,但代价是崩溃后要重放的 redo 更多、恢复变慢------这是个典型的"恢复时间 vs 写入平滑度"权衡。flush list 上的脏页由 page cleaner 线程按一定节奏刷盘,刷盘进度直接反映在 Innodb_buffer_pool_wait_free 与 checkpoint age 上。
[sql]
观察 redo / checkpoint 状态
SHOW ENGINE INNODB STATUS\G
LOG 段:Log sequence number / Log flushed up to Last checkpoint at ------ 三者差即待刷 redo 量
7. undo log 再深入:回滚、MVCC 与 purge
undo log 与 redo log 常被一起提,但职责相反:redo 保"提交的修改不丢",undo 保"未提交/历史版本可回滚与可读"。undo 分两类:insert undo 记录插入行的回滚信息,事务提交后即可丢弃;update/delete undo 记录修改前的值,不仅要支持本事务回滚,还要供其他事务的 MVCC 快照读(通过 read view 读取"该事务启动时已提交"的历史版本)。这些过期 undo 由后台 purge 线程异步清理------但前提是没有任何活跃事务还需要它们。于是"长事务"成为 undo 膨胀的头号元凶:一个跑了半小时未提交的事务,会挡住它启动之后所有版本的 purge,回滚段(rollback segment)持续膨胀,甚至可能把 undo 表空间撑满。这正好呼应第 08 讲 MVCC 与第 31 讲误删恢复------很多"数据删了还能找回",靠的就是尚未被 purge 的 undo 历史版本。
8. binlog 再深入:行格式事件与组提交
binlog 在 row 格式下,把变更编码成具体事件:Write_rows(插入)、Update_rows(更新,含前像后像)、Delete_rows(删除)。事务执行期间,binlog 先写入每个会话私有的 binlog cache(由 binlog_cache_size 控制,超出则落临时文件),提交时再把 cache 刷进 binlog 文件。高并发下真正决定吞吐的是组提交(group commit):同一时刻多个准备提交的事务,由 binlog 统一协调,依次经历 flush(写文件缓冲)、sync(fsync 到磁盘)、commit(通知引擎提交)三个阶段,每一阶段都可把多个事务合并成一次 IO。也就是说 sync_binlog=1 时,不是每个事务各 fsync 一次,而是一批事务共享一次 fsync------这正是 MySQL 能扛住高 TPS 写入的关键。binlog 文件按 max_binlog_size 自动切换并连续编号,构成主从复制的事件流。
[sql]
观察某事务在 binlog 中写入的事件
SHOW BINLOG EVENTS IN 'binlog.000123' LIMIT 20;
-- 9.7 默认基名为 binlog(sql/mysqld.cc:7013 的 default_binlogfile_name = "binlog",5.7 时代是 mysql-bin),
而且默认就开启 binlog:log_bin 是 READ_ONLY NON_PERSIST NO_CMD_LINE 变量、DEFAULT(true)(sql/sys_vars.cc:2484-2486)。
改名用 --log-bin[=基名](不带参数时基名为 HOSTNAME-bin),
关闭用 --skip-log-bin;
切勿在 my.cnf 里写 log_bin=ON ------ 该变量没有命令行选项,
也不接受 SET GLOBAL / SET PERSIST
典型序列: Gtid / Query(BEGIN) /  Update_rows / Xid(提交)
9. 崩溃恢复逐场景推演与双 1 取舍
把 2PC 与断电点结合,可以精确推演三种情况:① 断电发生在 binlog 写盘之前------redo 中该事务处于 prepare,但 binlog 里找不到对应 XID,重启后判定为未完成,回滚;② 断电发生在 binlog 写完后、redo commit 之前------binlog 已有完整 XID,重启后 InnoDB 补做 commit,事务生效;③ 断电发生在 redo commit 之后------事务本就已提交,正常走完。三种情况都保证:主库数据状态与 binlog 事件流完全一致,从库重放后不会丢也不会多。这正是 2PC 存在的全部意义。
落到参数,这就是著名的"双 1":innodb_flush_log_at_trx_commit=1(每次提交都 fsync redo)+ sync_binlog=1(每次提交都 fsync binlog),提供金融级不丢数据保证,但每次提交都要两次 fsync,吞吐受限于磁盘 IOPS。若业务可接受"极端宕机丢最近极少量事务",可放宽为 innodb_flush_log_at_trx_commit=2(redo 只写 OS 缓冲,靠 OS 周期性刷盘)+ sync_binlog=N(每 N 个事务 fsync 一次),换取数倍写入提升------这是一致性与性能的经典权衡,第 23 讲会专门展开。
10. 双写缓冲(doublewrite buffer):防御页断裂
redo 能保证"已提交事务不丢",但有一个前提:被修改的数据页本身是完整的。InnoDB 的数据页通常是 16KB,而磁盘扇区往往只有 4KB;若写页过程中断电,会出现"页断裂"(partial page write),页内字节半新半旧、本身已损坏。此时 redo 无能为力------因为 redo 记录的是"页内某偏移改成某值",前提是那页完整。双写缓冲(innodb_doublewrite=ON,默认开)就是第二道保险:脏页先顺序写一份到双写区(两次写,顺序 IO 很快),再写回原位置;崩溃恢复时若发现原页损坏,用双写区副本修复。所以 redo 负责逻辑重放、doublewrite 负责物理完整,二者缺一不可。
11. 崩溃恢复的 redo 重放与 fuzzy checkpoint
崩溃恢复时,InnoDB 按 LSN 顺序重放 redo,且重放是幂等的:已提交事务的修改被重做,未完成(无 commit 标记)的事务靠 undo 回滚,因此即便 redo 里混着"半截"事务也安全。checkpoint 本身是 fuzzy 的------做检查点时并不阻塞写入,只是记录"此刻最老脏页的 LSN",恢复只需从最近一次 checkpoint 之后的 redo 开始重放,而非从头全量,这使重启恢复时间可控。理解这两点,就不会再担心"redo 里还有没提交的事务会不会把库搞乱"。
12. 写入瓶颈的实战观测
判断写入慢在哪一层,有几个一手指标:Innodb_log_waits > 0 表示 redo buffer 不够、事务在等日志落盘;Innodb_data_pending_writes 反映脏页刷盘的排队长度;Binlog_cache_disk_use / Binlog_cache_use 的比值若偏高,说明 binlog cache 频繁溢出到临时文件、binlog 写入存在额外 IO(9.7 并未导出 Binlog_commits / Binlog_group_commits 这类组提交计数);慢查询日志里的 Rows_examined 远大于 Rows_sent,则暴露"扫了过多行"的索引问题。把这几个指标与图 3-1 的链路对照,才能确定瓶颈到底在 redo 写盘、binlog fsync 还是引擎刷脏页。
13. redo 与 binlog 对比一览(记忆卡)
一句话区分:redo 是物理日志(记页内偏移的改动)、属于 InnoDB 层、循环写、大小固定、目的是 crash-safe;binlog 是逻辑日志(记 SQL 或行事件)、属于 Server 层、追加写、可无限增长、目的是复制与时间点恢复。两者由 2PC 对齐成一致的整体。记不住时,回到图 3-1 与图 3-2 即可一目了然。
14. 一条 UPDATE 的日志体量直觉
一次只改几列的更新,redo 只记录这几字节的物理增量(极小),而 row 格式的 binlog 包含整行的前像与后像(较大)------这也是为什么 binlog 通常比 redo 增长更快、为什么大事务的 binlog 会把 binlog cache 撑满甚至落临时文件。理解这个体量差异,有助于合理规划日志盘容量、设置 max_binlog_size 与备份窗口。把本章与第 02 讲合起来看:查询走"连接器 → 分析 → 优化 → 执行 → 引擎"的只读五层链路,更新则在此基础上叠加"Buffer Pool 改内存 + undo + redo(prepare) + binlog + redo(commit)"的写链路------读链路决定快不快,写链路决定丢不丢,二者共同构成 MySQL 的内核骨架,也是后续索引、锁、事务、复制各讲的地基。
15. 大事务的连锁危害
把本章机制串起来,就能解释"大事务为什么危险":它一次性产生巨量 redo 与 binlog,撑爆 binlog cache;它长期不提交,挡住 undo 的 purge,回滚段持续膨胀;它持有锁时间长,容易引发锁等待与死锁(见第 21 讲)。一条删全表的大事务,可能让 binlog 暴涨、undo 表空间打满、从库严重延迟。所以"分批删除、控制事务大小"不是编码风格问题,而是对本章机制的直接尊重------第 13、31 讲会给出具体的安全操作法。
16. innodb_flush_log_at_trx_commit 三档对照
该参数三档含义务必记牢:=0 时事务提交只写 redo buffer,后台每秒 fsync 一次,宕机可能丢约 1 秒内的事务;=1 时每次提交都 fsync,绝不丢已提交事务(最安全,默认);=2 时每次提交写 redo 到 OS 缓冲、由操作系统周期刷盘,进程宕但主机未断电不丢,主机断电则可能丢。它与 sync_binlog 组合,构成"双 1(都=1,最强一致)"到"都放松(最高性能)"的完整谱系,第 23 讲会结合业务等级给出选型矩阵。
17. 主从一致性正是 binlog 链路的延伸
本章的 binlog 不只是崩溃恢复用,更是主从复制的载体:主库把 binlog 事件发给从库,从库回放(SQL 线程或并行回放线程)得到相同数据。GTID(全局事务号)让"某个事务是否已复制"可被精确追踪,主库故障切换时从库据此补齐缺口(见第 27 讲 GTID 切换)。可以说,没有 2PC 保证的 binlog 与 redo 一致,就不会有可靠的主从复制------本章是后续高可用各讲的根。
18. doublewrite 的性能代价与缓解
双写缓冲多一次顺序写,理论上增加写入开销,但它是顺序 IO、且可与写原页并行,现代 SSD 下代价很小;只有极端写敏感场景才考虑关闭(风险自负)。更稳妥的缓解是把日志盘与数据盘分离、使用带掉电保护的 RAID 卡缓存(BBU),让 fsync 既快又真安全。这再次说明:MySQL 的持久性不是单点保证,而是一组机制(WAL + redo + doublewrite + 2PC)协同的结果,任一层缺失都会在极端场景暴露。
小结一下:一条更新语句的代价,远不止"改一行"那么简单------它触发内存改页、undo 记录、redo prepare、binlog 写入、redo commit 一整条链路。理解每条日志的角色与协作,你才能在"写慢了""主从不一致""断电后数据对不对"这类问题面前,迅速定位到图 3-1/3-2/3-3 中的具体环节,而不是盲目调参。
最后强调一个工程常识:redo 与 binlog 的写入都会打到日志盘,若日志盘与数据盘共用且是机械盘,写入吞吐会被 fsync 串行化严重拖累。生产环境务必将日志盘(redo + binlog)放在低延迟设备上,这是性价比最高的"写性能"投资,远比盲目调大缓冲来得实在。本章所有机制------WAL、doublewrite、2PC、group commit------在 Percona 9.7 中与社区版行为一致。但 Percona 额外提供了 log_slow_verbosity(sql/log.cc:869/893/939),可把查询计划与 InnoDB 的 IO/锁等待明细直接写进慢日志,正是"判断写入慢在哪一层"的更强抓手,社区版没有------既然用 Percona,就别浪费它。记住一句判断口诀:读慢看索引与 Buffer Pool,写慢看 redo/binlog 落盘与组提交,主从不一致看 binlog 与 GTID------它正对应本章的三张图。
若你只想记住一页纸:第 02 讲是"读的五层",本章是"写的五步";读的快慢由优化器与 Buffer Pool 决定,写的安危由 WAL、doublewrite 与 2PC 决定。把这两页贴在案头,后续 43 讲的每个知识点都能找到归处,不至于在索引、锁、复制的细节里迷失全局。而 9.7 相对 5.x 旧版最显著的两处架构变化,正是查询缓存的彻底移除与迭代器执行器(ExecuteIteratorQuery)的全面落地------它们分别改写了第 02 讲的读链路与执行模型,值得在通读全本时反复对照。
三、9.7 源码佐证
trx_prepare(trx_t *trx) ------ storage/innobase/trx/trx0trx.cc:3043,阶段一:将事务标记为 prepare。

trx_commit(trx_t *trx) ------ storage/innobase/trx/trx0trx.cc:2273,阶段二提交;内部 trx_commit_in_memory(:1979) 清理事务,trx_flush_log_if_needed(:1799) 保证 redo 落盘。

log_buffer_reserve / log_write_up_to ------ storage/innobase/log/log0buf.cc,redo 在 log buffer 中预留与写入。

binlog_prepare(...) ------ sql/binlog.cc:2585,binlog_hton->prepare = binlog_prepare(注册于 :1531);binlog_commit 注册于 :1533。

MYSQL_BIN_LOG::commit(THD *thd, bool all) ------ sql/binlog.cc:7417,binlog 侧提交入口(TC_LOG::enum_result)。

ha_commit_trans(THD *thd, bool all, ...) ------ sql/handler.cc:1715,Server 层统一提交;ha_prepare_low ------ sql/handler.cc:2408。

mtr_commit(&mtr) ------ 调用点见 storage/innobase/mtr/mtr0mtr.cc:1129(函数定义位于同文件更靠前的位置),mini-transaction 成组提交 redo。

[cpp]
sql/binlog.cc:1531-1533 ------ 注册 binlog 为事务参与者
binlog_hton->commit = binlog_commit;
binlog_hton->prepare = binlog_prepare;

storage/innobase/trx/trx0trx.cc:3043 ------ 阶段一 prepare
static void trx_prepare(trx_t *trx) {
写 redo,置事务为 prepare 状态
}

崩溃恢复(简化):prepare 事务比对 binlog xid
binlog 完整 -> 提交;否则 -> 回滚
四、实战验证与要点总结
生产环境有两条铁律,直接源于上述机制:innodb_flush_log_at_trx_commit = 1(每次提交 fsync redo,不丢已提交事务)与 sync_binlog = 1(每次提交 fsync binlog,不丢复制日志),即所谓"双 1"参数,是金融级一致性的基础。想观察写入行为,可看 Innodb_log_waits(redo 写等待)、Binlog 文件序列、以及组提交(group commit)效果------同一时刻多个事务的 binlog 可合并一次 fsync,这是高并发下吞吐的关键。若 redo log 写满而 checkpoint 来不及推进,会出现大量"脏页刷新"拖慢写入(与第 12 讲"抖一下"同源)。断电恢复一般无需人工介入,InnoDB 重启会自动走 2PC 恢复流程。
【本章要点】
• 更新先改 Buffer Pool 内存页,依赖 WAL + redo 保证持久性;
• redo(物理/循环写/crash-safe)与 binlog(逻辑/追加写/复制)职责不同、长期并存;
• 更新链路:读页 → 改内存+undo→redo prepare→ 写 binlog→redo commit;
• 2PC 用 prepare/commit 两阶段 + XID 比对,保证两份日志一致;
• 双 1 参数(redo fsync=1, sync_binlog=1)是强一致基石。
【思考题】若断电发生在"binlog 已写完、redo 还没 commit"之间,重启后如何恢复?为什么 redo 必须'先 prepare 后写 binlog',反过来行不行?