Qwen-Image-2.1-viggle-turbo便携包 在 ComfyUI 上跑通,3060显卡40 秒出1080P图
便携整合包 :ComfyUI 本体、Python 环境、GGUF 插件、三个模型权重、两套工作流全部内置,解压双击就能跑,第一次运行不需要联网。
验证硬件:RTX 3060 12G,1088×1920 竖屏单张约 40 秒。
📦 下载
夸克网盘:https://pan.quark.cn/s/1d4fc1b71967
解压即用,不用装 Python,不用装 ComfyUI,不用配环境变量。
硬件要求
先对一下机器,对不上就别下了:
| 项目 | 要求 |
|---|---|
| 显卡 | NVIDIA,6GB 显存起步,12GB 舒适(本包在 RTX 3060 12G 上验证) |
| 驱动 | 支持 CUDA 12.4,即驱动 ≥ 551 系列 |
| 内存 | ≥ 16GB |
| 磁盘 | 包体约 19GB,解压后另留空间 |
| 网络 | 首次运行不需要。ComfyUI 联网只用于你主动拉别的模型 |
显存低于 8GB 也能跑,启动命令加 --lowvram(见第三节)。
这篇按「为什么能这么快 → 拿到包怎么用 → 里面是什么 → 参数怎么调 → 踩了哪些坑」的顺序写,全是能直接抄的操作。
一、快在哪:三层叠加的压缩
能在 3060 上 40 秒出竖屏图,不是单一优化。是三层压缩叠在一起乘出来的。
第一层:蒸馏,25~50 步砍成 4 步
viggle-turbo 是 DMD2(Distribution Matching Distillation v2)蒸馏出来的。做法是拿一个跑得慢但质量好的多步教师模型,训出一个几步就收敛的学生,直接去匹配教师的输出分布,而不是跟着教师一步步走。
ComfyUI 官方的 image_qwen_image_2_1_image_edit.json 用的是完整 base 模型,采样要 25~50 步。turbo 4 步就收敛,这是倍数级收益,也是三层里唯一真正改变计算量的一层。
顺带一个副作用:蒸馏把 CFG 那一维压掉了。学生直接学到了教师在引导之后的分布,不再需要 classifier-free guidance 去外推。所以 CFG 只能锁 1.0------调高不会「更有引导性」,只会把输出推到训练分布外面去,表现为颜色断层、对比度爆掉。
第二层:量化,4bit 权重既压显存也压延迟
主模型是 GGUF 的 Q4_K_M,5.56GB。4bit 权重比 8bit 少一半的字节要搬。
关键在于 4 步的时候瓶颈不在算力,在显存带宽。每一步都要把整个模型从显存读一遍过一遍,4 步就是读 4 遍 5.5GB。这阶段算力利用率上不去,等的是数据。所以权重大小基本直接决定单步延迟,砍一半就快一截。
这也是 6GB 显存能跑的唯一原因。bf16 主模型加上文本编码器,12G 卡大概率要开 lowvram 硬扛。
第三层:文本编码器也量化,w4a8
qwen3vl_8b_w4a8_heretic.safetensors 是 8B 的 Qwen3-VL 文本编码器,w4a8 = 4bit 权重 + 8bit 激活。
它每次出图只跑一次,不像 UNet 要跑 4 遍。但在 4 步这个尺度上,「只跑一次」的开销占比被放大了------文本编码很可能是整个流程里除 UNet 外最大的一块。所以它也一起量化,省显存的同时省掉那一次前向的时间。
附:一个隐含的压缩------VAE latent 打包
Qwen 用 16 通道 latent(常规 SD 系是 4 通道)配 2×2 patchify。1088×1920 经 VAE 8 倍下采样得 136×240,再 patchify 成 68×120 = 8160 token 的网格。token 数就是 UNet 的序列长度,直接决定注意力开销。
这就是边长必须整除 16 的原因------不对齐的话 patchify 要塞 padding,白烧算力。
代价
- 量化有损 → GGUF 输出和上游 bf16 不完全一致
- 蒸馏有损 → 4 步的细节上限低于 25 步
- 两者叠加 → 正式生产前用同 prompt + 同 seed 跟 bf16 原模型对比一轮
一句话:4 步 × 4bit 权重 × 4bit 文本编码器,三层相乘,才换来 3060 上 40 秒。单独拿出来任何一层都做不到。
二、三步跑起来
- 整个目录解压到任意位置(路径可以带中文、可以带空格、可以换盘符)
- 双击
start.bat - 浏览器会自动打开 http://127.0.0.1:8188(没自动开就手动输这个地址)
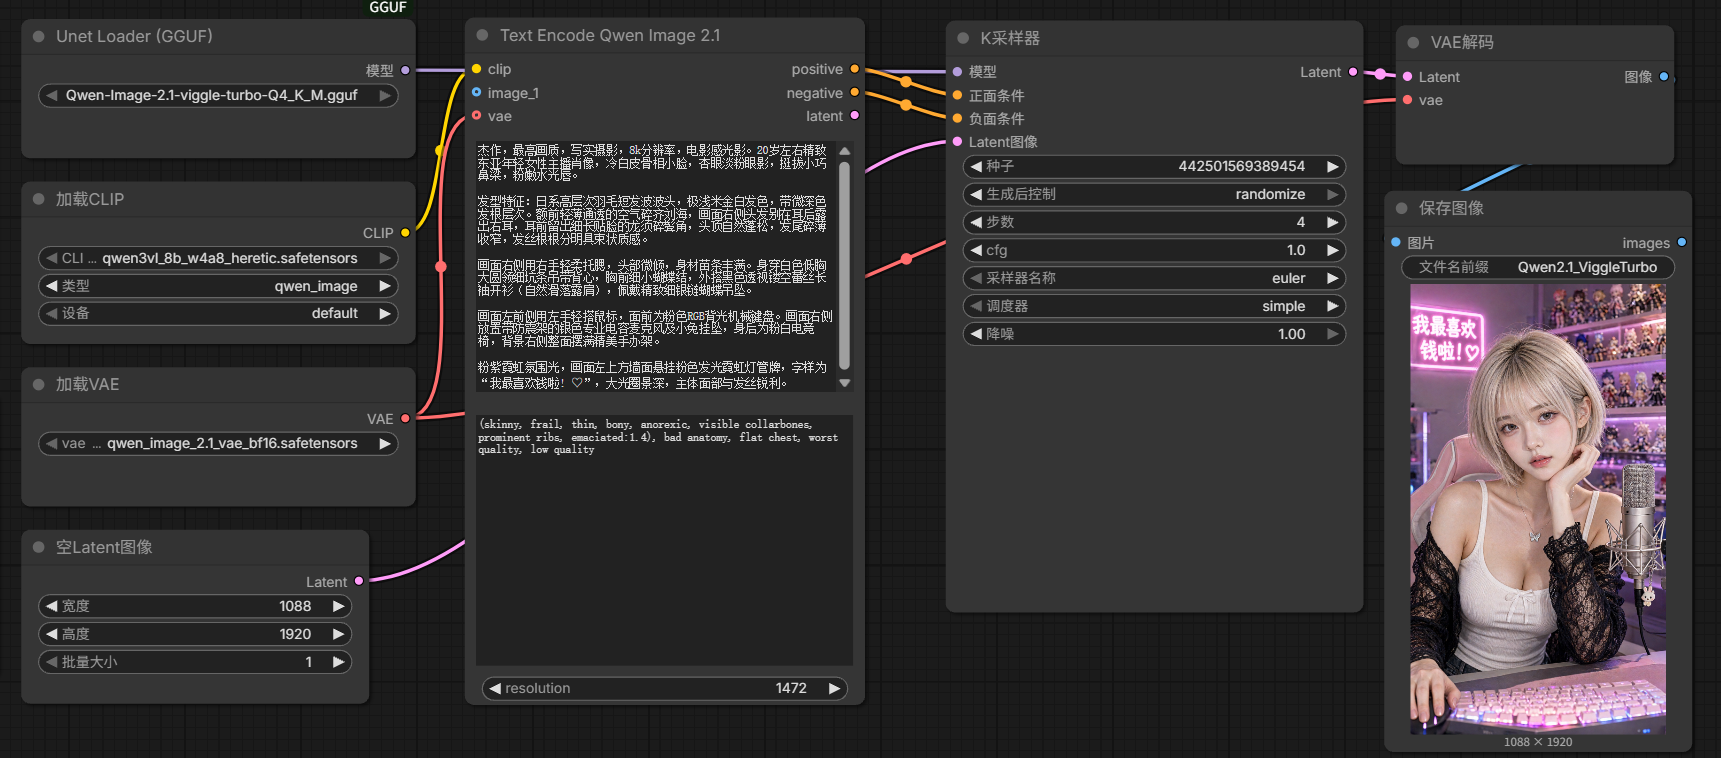
进 ComfyUI 后,左侧「工作流」→ 打开 Qwen2.1_ViggleTurbo ,在 TextEncodeQwenImage21 节点里改提示词 → 点运行。图片出在 ComfyUI/output/。
停服:关掉黑色命令行窗口,或窗口里按 Ctrl+C。
三、显存不够怎么办
前面硬件表说了 6GB 是起步线。显存低于 8GB 时,在启动窗口里 Ctrl+C,然后:
bat
start.bat --lowvram四、包里装了什么
QwenImage21-ViggleTurbo-ComfyUI\
├── start.bat                     ← 唯一入口,双击这个
├── README.md
├── python311\                    ← 嵌入式 Python 3.11.9 + PyTorch 2.6.0+cu124
├── ComfyUI\                      ← ComfyUI v0.37.0 本体
│   ├── custom_nodes\ComfyUI-GGUF\   ← GGUF 加载插件(依赖已装)
│   ├── models\diffusion_models\Qwen-Image-2.1-viggle-turbo-Q4_K_M.gguf   5.56 GB
│   ├── models\text_encoders\qwen3vl_8b_w4a8_heretic.safetensors           6.31 GB
│   ├── models\vae\qwen_image_2.1_vae_bf16.safetensors                    675 MB
│   └── user\default\workflows\
│       ├── Qwen2.1_ViggleTurbo.json      ← 文生图(默认 1088×1920 竖屏)
│       └── Qwen2.1_ViggleTurbo_i2i.json  ← 图生图 / 编辑
└── .runtime\                     ← 全部缓存,可整个删掉,不影响运行
文本编码器选的是 w4a8 量化版(6.3GB)。比 int8 版再省 3.5GB 显存,画质差异基本看不出来。
五、文生图参数
工作流 8 个节点,关键参数:
| 节点 | 参数 |
|---|---|
| EmptyLatentImage | width=1088 / height=1920 / batch=1 ← 分辨率在这改 |
| TextEncodeQwenImage21 | 正向提示词 / 负向 / resolution=1472 |
| KSampler | steps=4 / cfg=1.0 / sampler=euler / scheduler=simple / denoise=1.0 |
改分辨率就改 EmptyLatentImage 的 width / height。 边长必须是 16 的倍数(原因见第一节)。1080 不是(1080÷16=67.5),填 1080 会被自动上取整成 1088,所以要精确竖屏直接填 1088。推荐值:1088×1920(9:16)、1024×1024、768×1344、1344×768。
TextEncodeQwenImage21 里的 resolution=1472 只在接了参考图 时才参与计算,纯文生图不用管,保持不动即可。规则是 resolution = √(宽 × 高),√(1088×1920) ≈ 1445,取的 1472。
CFG 必须锁死 1.0(原因见第一节)。也因为 CFG=1.0,负向提示词在数学上被完全忽略,工作流里那串 negative 是装饰,留空或保留都一样。
六、图生图 / 编辑工作流
包内第二个 Qwen2.1_ViggleTurbo_i2i.json,不用下任何额外权重。
用法:LoadImage 选图 → 在 TextEncodeQwenImage21 写编辑指令 → 运行。选图可以直接把文件拖到节点上。
提示词写法是关键,这是编辑指令,不是重新描述画面:
✗ a red dress, a woman, an arch hall        ← 等于重画,参考图白给
✓ transform the golden gown into a deep crimson red silk dress,
keep her pose, face, hairstyle and background exactly the same核心是说清「改什么」+「保留什么」。保留项写得越明确,人物和背景的 likeness 越稳。
包内 JSON 的实际值:steps=4 / denoise=0.9 / resolution=1088。实测 3060 12G 上 steps=4 约 163 秒,steps=8 约 123 秒(编辑更稳,包内 Note 建议改 8 步)。比文生图慢是因为要额外编码参考图。
多图可以接 image_1~image_10,提示词里用 <image1> <image2> 指代。
⚠️ 这套 i2i 不是官方模板。官方那套用的是完整 base 模型 (
qwen_image_2.1_int8_convrot+qwen3vl_8b_int8_convrot,合计 16.6GB),25~50 步。本包为了控制体积只装了 4 步蒸馏的 Viggle Turbo GGUF,所以上面这个是 turbo 改造版:能用、速度可以,但编辑精细度不如官方 base 模型。
七、三个模型从哪来
国内走 hf-mirror 直连:
| 文件 | 仓库 |
|---|---|
Qwen-Image-2.1-viggle-turbo-Q4_K_M.gguf |
realrebelai/Viggle_Qwen-Image-2.1-Turbo_GGUFs |
qwen3vl_8b_w4a8_heretic.safetensors |
pottokao/Qwen-Image-2.1-Text-Encoder-Heretic-W4A8 |
qwen_image_2.1_vae_bf16.safetensors |
abenzerps/Qwen-Image-2.1-Uncensored-GGUF |
这里踩了两个大坑,参考文档给的信息对不上实际上游:
1.上游 realrebelai 仓库实际只有 Q2_K / Q3_K_M / Q4_K_M / Q5_K_M / Q6_K / Q8_0 六档,本包用的是的 Q4_K_M.gguf。
- 文本编码器 是去审查版
_heretic,托管在pottokao/Qwen-Image-2.1-Text-Encoder-Heretic-W4A8。
另外 hf download 带子目录时会自动建一层同名文件夹,下载完必须 mv 出来,否则 ComfyUI 扫不到。
八、常见问题
| 现象 | 处理 |
|---|---|
| 双击闪退 | 命令行 cd 到本目录执行 start.bat,看报错信息 |
| 端口 8188 被占 | 跑 start.bat --port 8189,浏览器改 8189 |
提示 UnetLoaderGGUF 节点不存在 |
插件被删了,重装后跑 python311\python.exe -m pip install -r ComfyUI\custom_nodes\ComfyUI-GGUF\requirements.txt |
| 首次加载特别慢 | GGUF 首次加载有编译缓存,属正常,之后就快了 |
| 杀毒软件拦端口 | 关掉程序级网络管控(联想/火绒/360 的「网络防护」常见) |
| 画质不如原版 bf16 | GGUF 量化有损。生产前用同 prompt + 同 seed 与 bf16 对比一轮;要更高质量换 Q5_K_M / Q6_K 档,12G 卡跑得动 Q6_K |
| 想彻底重置 | 删掉整个 .runtime\,重启自动重建 |
九、几个别踩的坑
- 不要再叠那个 340MB 的 Viggle LoRA。 Q4_K_M GGUF 本身已经是完整蒸馏后的 transformer,叠上去是重复蒸馏,画质反而劣化。包内默认没装,需要就自己丢到
ComfyUI\models\loras\。 - 分辨率边长必须整除 16。 1080 会被自动上取整。
- CFG 永远锁 1.0。 别手滑调到 1.5。
- GGUF 与上游 bf16 输出不完全一致。 拿去做商品图正式生产前,先用同 prompt + 同 seed 跟原模型对比一轮画质,别直接上线。
十、便携性是怎么做的
start.bat 里做了三件事,这也是「免安装」能成立的原因:
- 路径全部走
%~dp0相对定位 ,cd /d到包根再启动,所以换盘、带中文带空格都不影响 - Python 走包内嵌入版
python311\python.exe,并设PYTHONNOUSERSITE=1隔离系统级 site-packages,防止和机器上别的 Python 环境串味 - 缓存全部重定向到
.runtime\(HF_HOME / TORCH_HOME / inductor / triton / TMP / TEMP),一个字符都不写用户目录。代价是首次启动慢一点,删掉.runtime\就能彻底重置
另外内置了 PIP_CONFIG_FILE 指空索引,防止启动时 pip 手贱去联网;还把 torch 的 libiomp5md.dll 复制成 libomp140.x86_64.dll,避免 fbgemm 加载报错。
十一、想改点什么
- 换量化档 :去
realrebelai/Viggle_Qwen-Image-2.1-Turbo_GGUFs下Q6_K,丢进models\diffusion_models\,在UnetLoaderGGUF节点里改文件名 - 升级 ComfyUI :包内
ComfyUI\是纯净源码(已删.git)。要升级就重新 clone 官方 tag,再把models\和custom_nodes\拷回去 - 重装依赖 :
pip-build.ini是构建期用的镜像配置(阿里云 PyPI + 上交 torch cu124 源),装完依赖即可删