摘要: 生产线数据采集升级的难点,通常不是"如何多采几个点",而是原有数据链是否能够支撑设备规模扩大、采集频率提升和业务系统增加。边缘计算网关 部署在设备控制层与业务应用层之间,可以把PLC通信、数据整理和现场处理从MES中解耦出来,使数采架构更容易维护。
导语: 一条已经运行多年的生产线,如果最初只为了设备监控而采集少量PLC变量,随着MES、OEE、质量追溯和设备分析逐渐上线,原有数采方式很容易遇到瓶颈。此时升级边缘计算网关 ,真正需要调整的并不是单一硬件,而是设备、数据和应用之间的分工。
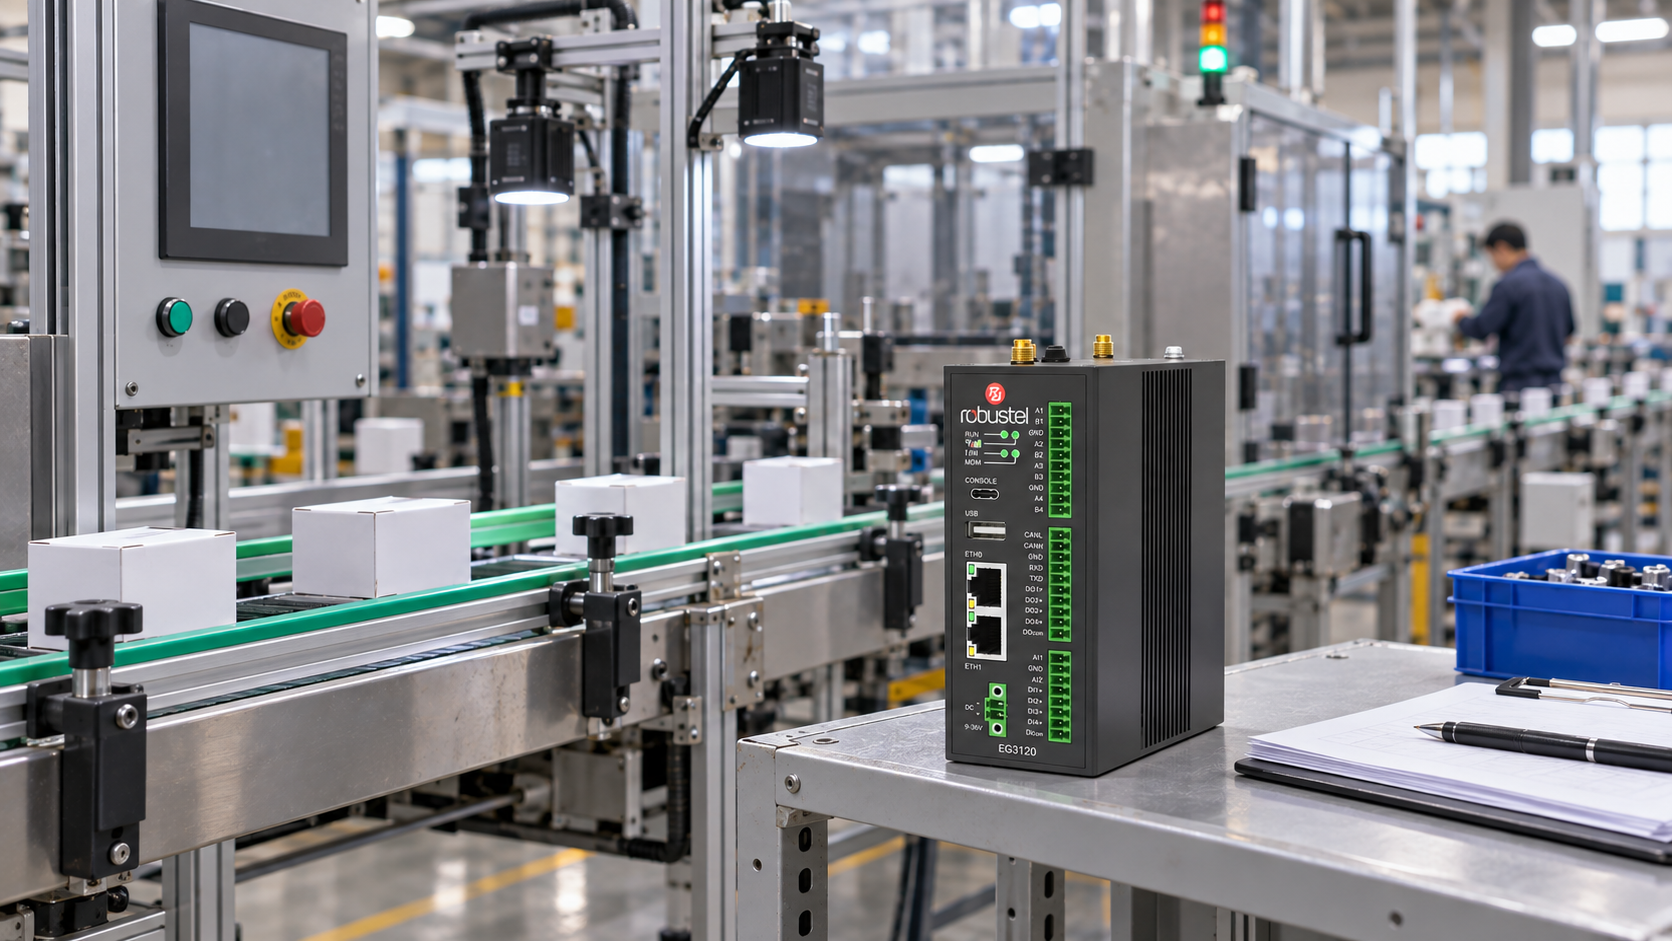
生产线数采架构最常见的问题,是让上层系统直接面对PLC。项目规模小时,这种方式实施简单;一旦设备品牌增加、采集点位变多,上层系统就需要持续维护不同通信协议和变量定义。更合理的结构,是保留PLC的控制职责,在设备侧增加独立采集层。边缘计算网关负责与PLC、仪表等设备通信,将底层变量整理为统一的数据标签,再提供给MES、数据库或其他应用。
升级过程中首先要重新定义采集策略。一个变量是否需要100毫秒采一次、1秒采一次还是只在状态变化时采集,应该由业务用途决定。设备运行状态、生产计数、能耗累计值和高频过程参数显然不应该采用同一采集周期。如果只是把旧系统中的所有变量原样搬到新网关上,硬件升级并不能解决数据量膨胀和后端压力问题。
边缘侧处理的意义也在这里体现。生产线现场可能持续产生大量重复状态和短时波动,上层系统真正需要的往往是关键状态变化、异常事件或经过整理的统计结果。边缘计算网关可以承担格式转换、过滤、缓存和简单逻辑处理,使进入MES的数据更接近业务需求。当然,这并不意味着所有计算都应该下沉到边缘,跨设备分析、长期历史数据和复杂业务逻辑仍然更适合平台侧处理。
数据模型同样需要在升级阶段统一。不同产线可能使用不同PLC地址和变量名称,但到了MES层,"运行状态""计划产量""当前产量""报警代码"等业务字段应该尽量形成统一定义。边缘计算网关作为设备数据进入业务系统前的最后一层,非常适合承担这种映射工作。这样即使后续更换PLC或增加新设备,上层应用也不必重新理解每一种底层变量。
在部署位置上,也不应简单追求"所有设备集中接到一台网关"。应根据设备通信距离、网络拓扑和产线边界划分采集区域。单条产线可以采用一个或多个边缘节点,关键是让设备通信保持清晰,同时控制单节点的采集负载。对于多产线项目,更适合先形成标准化的数据标签和接口规则,再复制到其他区域。
升级后的系统还应明确故障边界。PLC控制不应依赖网关是否在线;网关异常不应影响生产设备继续运行。对于要求数据连续的业务,可以设计缓存和恢复策略;对于只关注最新状态的业务,则不必为了完整记录所有瞬时数据而增加不必要复杂度。将"生产连续性"和"数据连续性"分开设计,是工业数采系统成熟的重要标志。
FAQ:
问题1:生产线数采升级需要更换原PLC吗?
答:通常不需要,重点是建立独立的数据采集层,尽量不改变原有控制逻辑。
问题2:边缘计算网关应该采集多少变量?
答:没有统一数量,应由业务用途、采集周期和设备通信能力共同决定。
问题3:边缘计算网关与MES之间应该怎样分工?
答:网关负责设备通信和现场数据处理,MES负责生产业务管理和跨系统应用。
问题4:什么时候需要在边缘侧做缓存?
答:当网络可能中断,而业务又要求数据连续时,应考虑相应缓存和恢复机制。
总结: 生产线数据采集升级不应理解为一次硬件替换。真正有效的边缘计算网关 部署,是重新划分PLC、采集层和MES之间的职责,把设备差异留在现场,把结构清晰的数据交给业务系统。这样,生产线后续增加设备、提高采集精度或扩展新应用时,原有架构才能继续使用。