一、大纲
不管是 2D 还是 3D,大家都在干三件事
- ① 找点(哪里值得看,检测)
- ② 编身份证(这个点长什么样,描述)
- ③ 比对身份证找对应(两张图/两片云里的同一个点,匹配)
| 2D | 3D | |
|---|---|---|
| 检测(找点) | FAST / Harris / Shi-Tomasi / DoG | 均匀采样、半径搜索 (3D一般不强调独立检测器) 、ISS关键点、SIFT3D |
| 描述(编身份证) | SIFT(128) / SURF(64) / ORB(256位) | SPFH、FPFH、SHOT(352维)、3DSC / Spin Image 、VFH(全局描述) |
| 使用(对比匹配) | 暴力匹配(BF)、FLANN(KD-tree加速)、距离比值检验筛选、VFH(全局描述) | SAC-IA(粗匹配,给ICP初值)、RANSAC-3点、4PCS/Super4PCS → ICP/NDT精配准 → 抓取/定位/重建 |
① 找点:半径搜索 + 体素降采样
② 编身份证:FPFH+ SHOT
③ 使用:SAC-IA(粗)→ ICP / point-to-plane ICP(精)→ 位姿输出
万变不离其宗的三句话:
- 找点 = 找"独一无二、经得起折腾"的位置
- 编身份证 = 只记录相对量(角度/比值/梯度方向),切 bin 投票抗噪声 → 换来不变性
- 使用 = 先鲁棒抽样找大致对应(粗),再纯几何迭代磨精度(精)
二、底层概念
1. bin(直方图的"格子/柱子")
bin 就是投票箱上的一个格子,上面贴着标签
下面这个直方图里面有8个bin
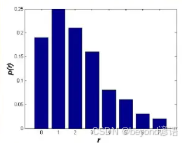
直方图:把连续的数值切成一段一段,每段计数/加权计数,得到的柱状图
- SIFT:角度切成 36 个 bin(每 10° 一个投票箱)
- FPFH:每个角度切成 11 个 bin
- "直方图"就是一排 bin 的计数结果
为什么要切成格子?
因为抗噪声------某个邻居算歪了一点,只是让某格多一票,整个柱子的"形状"基本不变。就像民意调查,个别人乱答不影响整体趋势。
2. 描述子(Descriptor)
描述子 = 这个点的身份证号码
- 它是一串固定长度的数字(SIFT 是 128 个数,FPFH 是 33 个数)
- 由该点周围的局部特征计算而来
- 设计目标:同一个物理点在两张图里 → 身份证几乎相同;不同点 → 身份证差异大
为什么要身份证? 因为坐标没法直接比------图 A 里点在 (342,187),图 B 里同一个点在 (521,93),数值天差地别。但两者的身份证(周围长什么样)是一样的 → 比身份证就能找到对应。
三、2D 图像家族(SIFT / SURF / FAST / ORB)
1. 找点(特征点/角点检测)
| 算法 | 原理 | 特点 | 应用场景 |
|---|---|---|---|
| Harris | 窗口移动时灰度变化矩阵的行列式判角 | 经典、有旋转不变、无尺度不变 | 通用角点检测 |
| Shi-Tomasi | 取两个特征值中较小的那个(min λ) | Harris 的简化改进 | 光流跟踪(goodFeaturesToTrack) |
| FAST | 16像素圆圈上连续9个点比中心亮/暗很多 | 极快,不求导;无尺度无旋转 | 实时系统、ORB 的前端 |
| DoG(Difference of Gaussians) | 多尺度高斯模糊金字塔相邻层相减找极值 | 尺度不变;找的不只是角点还有斑点 | SIFT 的找点环节 |
| Hessian 矩阵极值 | 二阶导矩阵行列式的极值(盒子滤波近似) | SURF 版的多尺度找点 | SURF 的找点环节 |
| SIFT 极值点(完整版) | DoG 多尺度 + 亚像素精修 + 边缘剔除 | 最稳但最慢 | 高精度离线匹配 |
①Harris
思路:拿一个小窗口在图上滑,统计窗口往 x、y 方向移动时灰度变化的剧烈程度,打包成一个 2×2 矩阵 M。
- 两个方向变化都猛 → 两个特征值都大 → 角点
- 一个猛一个平 → 边缘
- 都平 → 空白
用打分公式 det(M) − k·tr(M)² 代替直接算特征值,一张响应图出来后取局部极大值。
核心思想:角点 = "往哪推窗都变脸"的点。
②Shi-Tomasi
思路:和 Harris 一模一样的矩阵 M,但打分更简单粗暴------直接取两个特征值里较小的那个 min(λ₁, λ₂)。
- 逻辑:一个方向变化再猛,只要另一个方向平(小特征值小),就不算好角点
- "木桶效应"打分,实测比 Harris 更稳定 → OpenCV 光流跟踪的默认找点法
③FAST
思路:不求导、不建矩阵,纯比亮度。
- 圆圈上取 16 个像素,先测 1 和 9 号(上下左右)------如果都和中心差不太多,直接淘汰(省算力)
- 否则继续测:连续 9 个点都比中心亮 20% 以上(或暗 20% 以上)→ 宣布这是角点
- 再对所有角点打分、非极大值抑制去重
核心思想:角点处的圆圈必然"半边亮半边暗"------一条规则测到底,快到能实时。
缺点:噪声敏感、没有方向和尺度。
④DoG 金字塔(SIFT 的找点)
思路:同一个东西近拍大、远拍小,只在原图找会漏 → 建"多层模糊"金字塔全找一遍。
- 图像反复高斯模糊(σ 递增),叠成金字塔
- 相邻两层相减 → DoG 图(突出"这一层尺度特有的边缘斑点")
- 每个像素和本层 8 邻居 + 上下两层各 9 个邻居(共 26 个)比大小 → 局部极值 = 关键点
- 亚像素精修 + 剔除边缘响应点
核心思想:眯眼看找轮廓、睁眼看细节------两种视力下都显眼的才是真特征。
⑤Hessian 矩阵极值(SURF 的找点)
思路:和 DoG 同构,但把"高斯模糊+相减"换成 Hessian 矩阵(二阶导)行列式的极值,且用盒子滤波近似------方块核代替圆滑核,配合积分图让任意尺度的滤波都是 O(1)。
核心思想:用"粗糙但极快"的近似换速度,金字塔搭建成本从贵变白菜价。
2. 编身份证(描述子)
| 描述子 | 维度/形式 | 核心思想 | 特点 |
|---|---|---|---|
| SIFT | 128 维浮点 | 主方向对齐 + 4×4 格子 × 8 方向梯度直方图(bin投票) | 祖师爷:尺度+旋转不变,精度高,慢 |
| SURF | 64 维浮点 | 盒子滤波+积分图近似,Haar 小波响应统计 | SIFT 加速 3 倍,精度小降 |
| ORB | 256 位 0/1 串 | FAST找点 + 主方向 + Rotated BRIEF | 快上百倍、免费、够用 → SLAM 标配 |
①SIFT(祖师爷,128维)
定位:2D 特征点检测 + 描述的开山经典(1999 年),后面所有算法都是它的变体。
完整流程四步(用外卖小哥认人打比方):
① DoG 金字塔 找关键点 → "在人群里锁定值得看的目标"
② 精修+去模糊点 → "站稳了,别晃"
③ 统计主方向 → "看他面朝哪边"(旋转不变的来源),统计关键点周围像素的梯度方向直方图(36 个 bin),最高柱子的方向 = 该点朝向 → 后续一切都相对它算 → 旋转不变
④ 编 128 维身份证 → "记下他的衣着特征组合"
"尺度不变"怎么实现:远看近看都是同一个人 → 因为在多个模糊程度(尺度)上都找过一遍。
核心思想:把"我周围的明暗走向分布"按自己的朝向摆正后记下来------转了、放大了,这本账都不变。
补充:DoG 金字塔(检测环节的核心)
把照片故意模糊成一摞"近视眼看到的版本",从最清晰到最模糊层层叠起来,像金字塔一样,在每一层里找亮点。
   △ 最模糊(σ=8)  ← 只剩大轮廓
  △△ 中模糊(σ=4)   ← 中等结构
 △△△ 较清晰(σ=2)
△△△△ 最清晰(σ=1) ← 满地细节- 高斯模糊:让图像变"糊",细节被抹掉 → 模拟"眯眼看"
- DoG(高斯差分):相邻两层相减 模糊₁ − 模糊₂ → 抵消共同部分,留下的就是"这一层尺度特有的信息(边缘、斑点)
- 在每层 DoG 里找局部极值点 → 这些点是"在某个模糊程度下最显眼的结构"
为什么需要它:同一个角点,近拍占 50 像素、远拍占 5 像素------只在原图找,远的就丢了。多尺度全找一遍,远近通吃。
打比方:找人时,既戴 normal 眼镜看细节,也眯眼看看轮廓------两种"视力"下都显眼的,才是真特征。
②SURF(SIFT 的加速版)
SIFT 效果好但计算贵(要一层层做模糊+找极值),SURF 用"作弊技巧"把它提速 3 倍
思路:完全模仿 SIFT 流程,但每一步都用"近似+积分图"提速:
- 尺度:盒子滤波(矩形求和)代替高斯
- 方向:邻域 Haar 小波响应在 x/y 投影取最大方向
- 描述子:统计 Haar 响应在 4×4 格子里 x/y 方向的和与平方和 → 每格 4 个数 → 64 维
核心思想:SIFT 的平替------"差不多的信息,用便宜的计算"。
核心两点:
- 盒子滤波:高斯模糊的圆滑核 → 换成粗糙的方块核(矩形求和)
- 积分图:预先算好"前缀和",之后任何矩形区域的和 = 4 次加减查表,不管矩形多大
描述子从 128 维砍到 64 维,速度快 3 倍,精度略降。
SURF ≈ SIFT 的"经济适用版"
补充:FAST(只管"找点",不管"描述")
原理极其简单粗暴:
取一个点 P,围绕它画 16 个像素的圆圈:
如果圈上【连续 9/16 个点】都比 P 亮很多(或暗很多) → P 是角点!报警!
- 优点:不求导、不建金字塔,快到能实时跑
- 缺点:只会说"这里有角点",不会描述它长什么样;对噪声敏感;没有尺度/旋转不变性
- 定位:流水线里的安检门------只负责"有没有",不负责"是谁"
③ORB(FAST + 描述子的组合拳,SLAM 主力)
ORB(Oriented FAST and Rotated BRIEF)的组装:
- FAST 负责快速找角点
- 给角点加主方向(解决旋转不变)
- 描述子用 BRIEF:不再算直方图,而是在关键点周围随机选 256 对位置,每对比大小------亮=1,暗=0 → 得到 256 位的 0/1 串
- 比对 0/1 串用异或(XOR)------CPU 一条指令搞定,比欧氏距离快百倍
核心思想:FAST 的快 + SIFT 的不变性框架 + BRIEF 的二进制比对 = 免费且够用,SLAM 首选。
SIFT(精度高、最慢)→ SURF(快3倍,精度小降)→ ORB(快上百倍,精度够用)← 所以 ORB 是视觉 SLAM 标配(vins-mono、ORB-SLAM 全用它)
3. 使用(匹配与应用)
| 方法 | 原理 | 特点 |
|---|---|---|
| 暴力匹配 BF | 每个描述子和所有候选逐一算距离 | 简单,O(N²),点少时用 |
| FLANN | KD-tree/LSH 索引加速检索 | 大规模匹配标配,快几个量级 |
| 比值检验 | 最近距离/次近距离 < 0.8 才收 | Lowe 提出,剔除模糊匹配 |
| RANSAC 后处理 | 随机抽样剔除误匹配点对 | 去除外点,求单应矩阵/基础矩阵 |
①暴力匹配 BF
思路:图 A 每个描述子,逐个和图 B 所有描述子算欧氏(或汉明)距离,最近的就是候选。
O(N×M),简单可靠,点少时用。
②FLANN
思路:先建索引再查------把图 B 的描述子建 KD-tree(浮点型)或 LSH(二进制型),查询时按树剪枝,不用逐个比。百万级匹配快几个量级。"近似最近邻"------允许漏掉一点点最优,换数量级速度。
③Lowe比值检验
思路:误匹配往往"最近的和次近的差不多"(这个描述子跟谁都像 → 它其实没辨识度)。
规则:最近距离 / 次近距离 < 0.7~0.8 才收下。用"自信度"筛人:只有明显比第二名强的才算真匹配。
④RANSAC(剔误匹配 / 求变换)
思路:和点云拟合同款思想------随机抽 4 对点算单应矩阵 → 数有多少点对支持这个矩阵(投影误差小)→ 重复上千次取票王。
核心思想:让模型和大多数数据投票一致,少数误匹配是搅不动大盘的。
四、3D 点云家族(SPFH → FPFH / SHOT / SAC-IA)
1. 找点(关键点/邻域选取)
3D 和 2D 的最大区别:点云每个点自带 xyz + 法向量,几何信息天然存在,所以一般不做独立的"角点检测"
| 方法 | 原理 | 原图 |
|---|---|---|
| 半径搜索 / K近邻 | 以某点为中心取半径 r 内所有点 | 算法线/FPFH 的基础操作 |
| 均匀采样 / 体素降采样 | 网格里每格保留一个代表点 | 加速、去冗余 |
| ISS 关键点 | 邻域协方差矩阵特征值(类似 3D Harris)取显著点 | 减少参与配准的点数 |
工业实际做法:通常不挑关键点,全点算 FPFH + 降采样控速------简单粗暴且够用。
①半径搜索 / K近邻
思路:KD-tree(3D 空间八叉/二叉分割)索引点云,查询"距 p 点 r 内所有点 / 最近 k 个点"------算特征前圈定邻域的基础设施,本身不是检测算法。
②均匀采样 / 体素降采样
思路:把空间切成小立方体(体素),每格只留一个代表点(或质心)。点云从千万级降到十万级,密度均匀 → 后续计算提速且不偏科。
③ISS 关键点
思路:3D 版 Harris------对每个点的邻域算协方差矩阵,取特征值:
- 三个特征值都大 → 邻域在各方向都"张开" → 几何显著点(3D角点)
- 按 λ₃/λ₁ 阈值筛 + 非极大值抑制
核心思想:把 2D 的"两个方向都变脸"推广到 3D 的"三个方向都张开"。
2. 编身份证(3D 描述子)
| 描述子 | 维度 | 核心思想 | 特点 |
|---|---|---|---|
| PFH | ~125+ 维 | 邻域内每对点互相算角度四元组 → 直方图 | 最原始,O(k²) 慢,已被淘汰 |
| SPFH | 33维 | PFH 的拆解版:每点只和自己邻居算(省掉两两互算) | FPFH 的原料/半成品 |
| FPFH | 33维 | SPFH + 邻居SPFH距离加权汇总(信息传播一跳) | 速度与精度均衡 → 工业主力 |
| SHOT | 352 维 | 稳定 LRF 参考框架 + 空间 32 格子 × 法向 11 bin | 罗盘稳、区分度强;慢 10 倍 |
- 配准找对应 → FPFH(默认)/ SHOT(精度优先)
- 物体识别("这是什么")→ VFH 系列全局描述
- 点太多要提速 → 先 ISS 关键点或降采样
①PFH(开山鼻祖,已淘汰)
思路:取点 p 的邻域,邻域内每两个点 (qᵢ, qⱼ) 组成一对:
- 用 qᵢ 的法向建局部坐标系
- 算三个角度 (α, φ, θ) + 距离 d
- 每个量切 bin 投票 → 所有点对的结果累加成直方图
k 个点有 k²/2 对 → O(k²),太慢 → 被 SPFH 取代。
②SPFH(FPFH 的原料)
SPFH = 单个点"只看自己直接邻居"统计出的 33 维小直方图。
思路:把 PFH 拆两步走的第一步------每个点只和自己的直接邻居算 (α, φ, θ),不搞两两互算 → 复杂度降到 O(k)。
3 个角度 × 11 bins = 33 维。缺陷:p 不知道"邻居的邻居",信息闭塞。
计算过程:
- 点 p 和每个邻居 q 组成一对
- 用 p 的法向量建一个局部坐标系(像给 p 建了个"自己专用的罗盘")
- 在这个罗盘里量三个角度:α(邻居法向扭转)、φ(邻居方位)、θ(第三个夹角)
- 每个角度切 11 个 bin 投票 → 3 × 11 = 33 维直方图
- 对所有邻居累加 → p 的 SPFH
为什么旋转后身份证不变? 因为量的是"我和邻居之间的相对夹角"------整片点云转 90°,我跟邻居的相对夹角纹丝不动。这就是"局部坐标系"的魔法。
SPFH 的缺陷:信息闭塞------p 只知道自己的直接邻居,不知道"邻居的邻居"。两个几何环境相似但更大范围不同的点,SPFH 可能长得一样 → 区分度不够。
③FPFH(Fast Point Feature Histogram)
FPFH = SPFH + 邻居们的经验汇总,专门治"信息闭塞"。
FPFH(p) = 自己的SPFH + (1/k) × Σ [距离权重 × 邻居的SPFH],离得近的邻居,发言权大
相当于:先每人各自填一张表(SPFH),再把周围人的表按远近加权抄一抺进自己的(FPFH)------信息传播了一跳,区分度立刻上来了。
"Fast" 名字的由来:它的前身 PFH 要对邻域内每两个点都算交互(k 个点要算 k² 次),FPFH 拆成"各算各的 SPFH(k 次)→ 再加权合并",复杂度从 O(k²) 降到 O(k)------快了一个数量级,精度只掉一点。
33 维、速度快、最常用------工业粗配准默认选它。
④SHOT(Signature of Histograms of Orientations)
SHOT = 更豪华、更稳定的身份证(352 维),专治 FPFH 的"罗盘翻转"问题。
FPFH 的软肋:局部坐标系靠单个法向量撑起来------在对称面、平坦区,法向量可能翻转 180° → 罗盘指向反了 → 身份证算出来也反了 → 匹配失败。
SHOT 的解法:
- 换更稳的罗盘(LRF 局部参考框架):不用单个法向,而是统计整个邻域点分布的协方差矩阵,特征值分解出三个稳定轴------由"一群点"共同决定方向,单个噪声点翻不了天
- 切更细的格子:以点为中心把空间切成 2(方位)×8(仰角)×2(径向) = 32 个小格子
- 每个格子里统计法向分布(各 11 bin)→ 32 × 11 = 352 维
思路三步:
- 建稳罗盘 LRF:对邻域点的协方差矩阵做特征分解 → 得到三个稳定轴(由整个邻域共同决定,法向翻转也不怕)
- 切空间格子:以点为中心,方位 2 × 仰角 8 × 径向 2 = 32 个格子
- 每格投票:统计格内点法向与三轴的夹角直方图(11 bins)→ 32 × 11 = 352 维
核心思想:罗盘更稳(LRF)+ 分区更细(32格)→ 区分度碾压 FPFH,代价是慢 10 倍。
④SPFH、FPFH和SHOT对比
| SPFH | FPFH | SHOT | |
|---|---|---|---|
| 角色 | 原料/半成品 | 成品·主力 | 成品·豪华 |
| 维度 | 33 | 33 | 352 |
| 信息范围 | 只看直接邻居 | +邻居的邻居 | 整个邻域的空间分布 |
| 罗盘 | 法向(会翻) | 法向(会翻) | LRF(稳) |
| 速度 | 快 | 快 | 慢 10 倍 |
| 适用 | - | 点多、要快 | 精度优先、点云干净 |
3. 使用(配准与应用)
| 方法 | 角色 | 原理一句话 | 特点 |
|---|---|---|---|
| SAC-IA | 粗配准 | FPFH 身份证匹配 + 随机抽样 + Huber打分取最优 | 不精确但给初值;用描述子的算法 |
| RANSAC-3点 | 粗配准 | 随机3对点→验三角形边长一致→内点投票 | 快、纯几何(可不用描述子) |
| 4PCS / Super4PCS | 粗配准 | 共面4点集"比例一致"解析求变换 | 低重叠率时鲁棒 |
| ICP | 精配准 | 最近邻对应 + SVD 求 R,T 迭代 | 纯几何(不用身份证);初值敏感 |
| point-to-plane ICP | 精配准 | 残差只算沿法向的穿透深度 | 收敛更快(二次收敛) |
| GICP | 精配准 | 马氏距离统一点对点/点对面 | 精度好,SLAM常用 |
| NDT | 精配准/定位 | 体素内高斯分布匹配 | 大规模点云稳 |
①SAC-IA(粗配准)
SAC-IA = 粗配准的媒人------拿着 FPFH/SHOT 身份证,在两片点云之间随机抽样配对,找出一个"大致对齐"的变换,给 ICP 当起点。
注意它的定位:SAC-IA 是使用描述子的算法,它自己不编身份证------身份证是 FPFH 算的。
四步流程(相亲版):
① 从源点云随机挑 n 个"征婚者"(要求彼此距离够远 → 身份证各不相同)
② 拿每人的 FPFH 身份证去目标点云里海选 → 找到"身份证相似"的候选 → 随机配一个
③ 用这批配对算一个刚体变换(转+移)
④ 打分:变换后所有配对点的距离误差和(Huber 罚函数)→ 重复①~④上千次,取分最高那次的变换
核心思想:身份证配对 + 大力出奇迹(随机多试几次)→ 不求精确,只求"大致摆对"给 ICP 当起点。
结果特点:大致对齐但不精确(误差可能毫米~厘米级)→ 只能当粗配准,正好喂给 ICP 做精修。
②RANSAC-3 点(粗配准)
思路:纯几何、不用身份证
- 随机抽 3 对点
- 检查三角形边长是否一致(源三角形 ≈ 目标三角形 → 才可能是真对应)
- 一致 → 算变换 → 数内点(变换后重合的点数)
- 重复取票王
核心思想:3 个点定一个刚体变换,"三角形形状对得上"就是最朴素的验证。
③4PCS / Super4PCS(粗配准)
思路:在源点云里找共面的 4 个点组成基,目标点云里搜"对应边长度比例相同"的 4 点集(比例在刚体变换下不变)→ 解析求变换 → RANSAC 验证。
核心思想:用"4点比例不变量"代替特征描述子 → 在重叠率很低(特征都对不上)时仍能工作。 Super4PCS 把搜索从 O(n²) 优化到 O(n)。
④ICP(精配准)
思路(四步循环,纯几何不看身份证):
- 源点云每个点,在目标里找最近邻 → 假装它们是对应的
- 丢掉距离超过阈值的差对
- SVD 解最优 R,t:让所有点对的平方距离和最小(H = Σ(p−p̄)(q−q̄)ᵀ → R = VUᵀ)
- 应用变换 → 回到第 1 步,直到变化量 < ε
核心思想:"先假定最近的就是对应的 → 据此求最优变换 → 变换后对应更准了 → 再来一轮"------期望最大化(EM)思想的几何版。
死穴:初值差就陷局部最优(所以要 SAC-IA 先摆个大概)。
⑤point-to-plane ICP(精配准变体)
思路:改误差度量------不算点到点的完整 3D 距离,只算源点沿目标点法向方向的穿透深度 nᵀ(p−q)。
直觉:表面上"谁挨着谁"本来就分不清(沿面滑动无伤大雅),只有"扎进去多深"是硬伤 → 约束少 → 收敛快(接近二次收敛)。代价:要法向量。
⑥GICP(精配准变体)
思路:把 point-to-point 和 point-to-plane 统一------给每对点之间建一个协方差矩阵,用马氏距离(考虑了各方向的不确定性)代替欧氏距离。形式优雅、精度好,激光 SLAM 常用。
⑦NDT(正态分布变换)
思路:反着来------不匹配点,匹配分布。
- 把目标点云装进体素格子,每格统计高斯分布(均值+协方差)
- 源点云变换后,看每个点"落在目标各格高斯分布里的概率"
- 优化变换使总概率最大(牛顿法迭代)
核心思想:把目标点云变成一张"概率地形图",源点云往概率高的山头爬。 对初值比 ICP 宽容,适合大场景定位。
四、全景联系图
1. 2D 图像线
找点: FAST(快报警) / DoG金字塔(SIFT的多尺度找点) / Hessian(SURF的找点)
↓
编身份证: SIFT(128维,祖师爷) → SURF(64维,加速版) → ORB(256位0/1串,极速版)
↓
使用: 两图匹配对应像素点 → 全景拼接/SLAM/识别
2. 3D 点云线
找点: 半径搜索/均匀采样(3D一般不单独强调检测)
↓
编身份证: SPFH(原料,只看邻居) → FPFH(成品,33维,主力)
→ SHOT(豪华,352维,稳)
↓
使用: SAC-IA(拿身份证配对→粗配准初值) → ICP(纯几何精配准) → 6DoF位姿
五、对应关系
| 2D | 3D | 共性 |
|---|---|---|
| bin(投票格子) | bin(投票格子) | 直方图抗噪声 |
| SIFT 描述子 | FPFH/SHOT 描述子 | 局部相对几何 → 编成身份证 → 不变性 |
| DoG 金字塔(多尺度找点) | 法向量估计(多邻域半径) | "看多大范围"决定抓到什么 |
| ORB 的 FAST 找点 | 半径搜索找邻域 | 先确定"看哪里" |
| 暴力匹配 + 比值筛选 | SAC-IA 相似检索 | 比对身份证找对应 |
| 用于:拼接/SLAM 前端 | 用于:粗配准给 ICP 初值 | 都是"先找到大致对应" |
拍了两张图 / 扫了两片点云,要对齐它们:
- 先找点------2D 用 FAST/DoG 在图里找显眼的角点斑点;3D 在点云里取有代表性的点
- 编身份证------围绕每个点统计"周围长什么样":
- 2D:数梯度方向投票 → 切成 bin → SIFT 128 维(祖师爷)/ SURF 64 维(加速)/ ORB 0/1 串(极速)
- 3D:量"我和邻居法向的夹角"投票 → SPFH 半成品 → FPFH 33 维(加邻居汇总)/ SHOT 352 维(换稳罗盘+切更细)
- 比身份证找对应------2D 直接最近邻+比值筛;3D 用 SAC-IA 抽样配对打分 → 得到粗配准
- 精修------把粗配准结果喂给 ICP,纯几何迭代磨到毫米级 → 拿到最终位姿
流程:
找点 → 编身份证(bin 投票成直方图 = 描述子)→ SAC-IA 比身份证做粗配准 → ICP 精修;2D 线的同构版本是 DoG/FAST → SIFT/SURF/ORB → 匹配。
六、总结
【2D】
找点:  Harris/Shi-Tomasi(梯度统计)  FAST(亮度规则)  DoG(多尺度差分)
         └────────────── 都在回答"λ₁ λ₂ 是不是都大 / 哪层最显眼"

身份证:  SIFT(梯度直方图128) → SURF(积分图近似64) → ORB(FAST+方向+二进制256)
         └────────────── 都在回答"把我周围的明暗模式按不变的方式记下来"

使用:    BF/FLANN检索 → 比值检验 → RANSAC剔误匹配 → 求H矩阵对齐
【3D】
找点:  半径搜索/降采样(基础设施)   ISS(3D版Harris,少用)

身份证:  PFH(两两互算,k²太慢) → SPFH(只看邻居,半成品) → FPFH(+邻居汇总,33维主力)
                                                    ↘ SHOT(稳LRF+32格,352维豪华)
         └────────────── 都在回答"量我和邻居法向的夹角,切bin投票"

使用:    SAC-IA(身份证配对,粗) ─┐
         RANSAC-3点(三角形验证,粗) ├→ 给 ICP/NDT(纯几何,精) 当初值 → 6DoF位姿
         4PCS(4点比例,低重叠粗)  ─┘