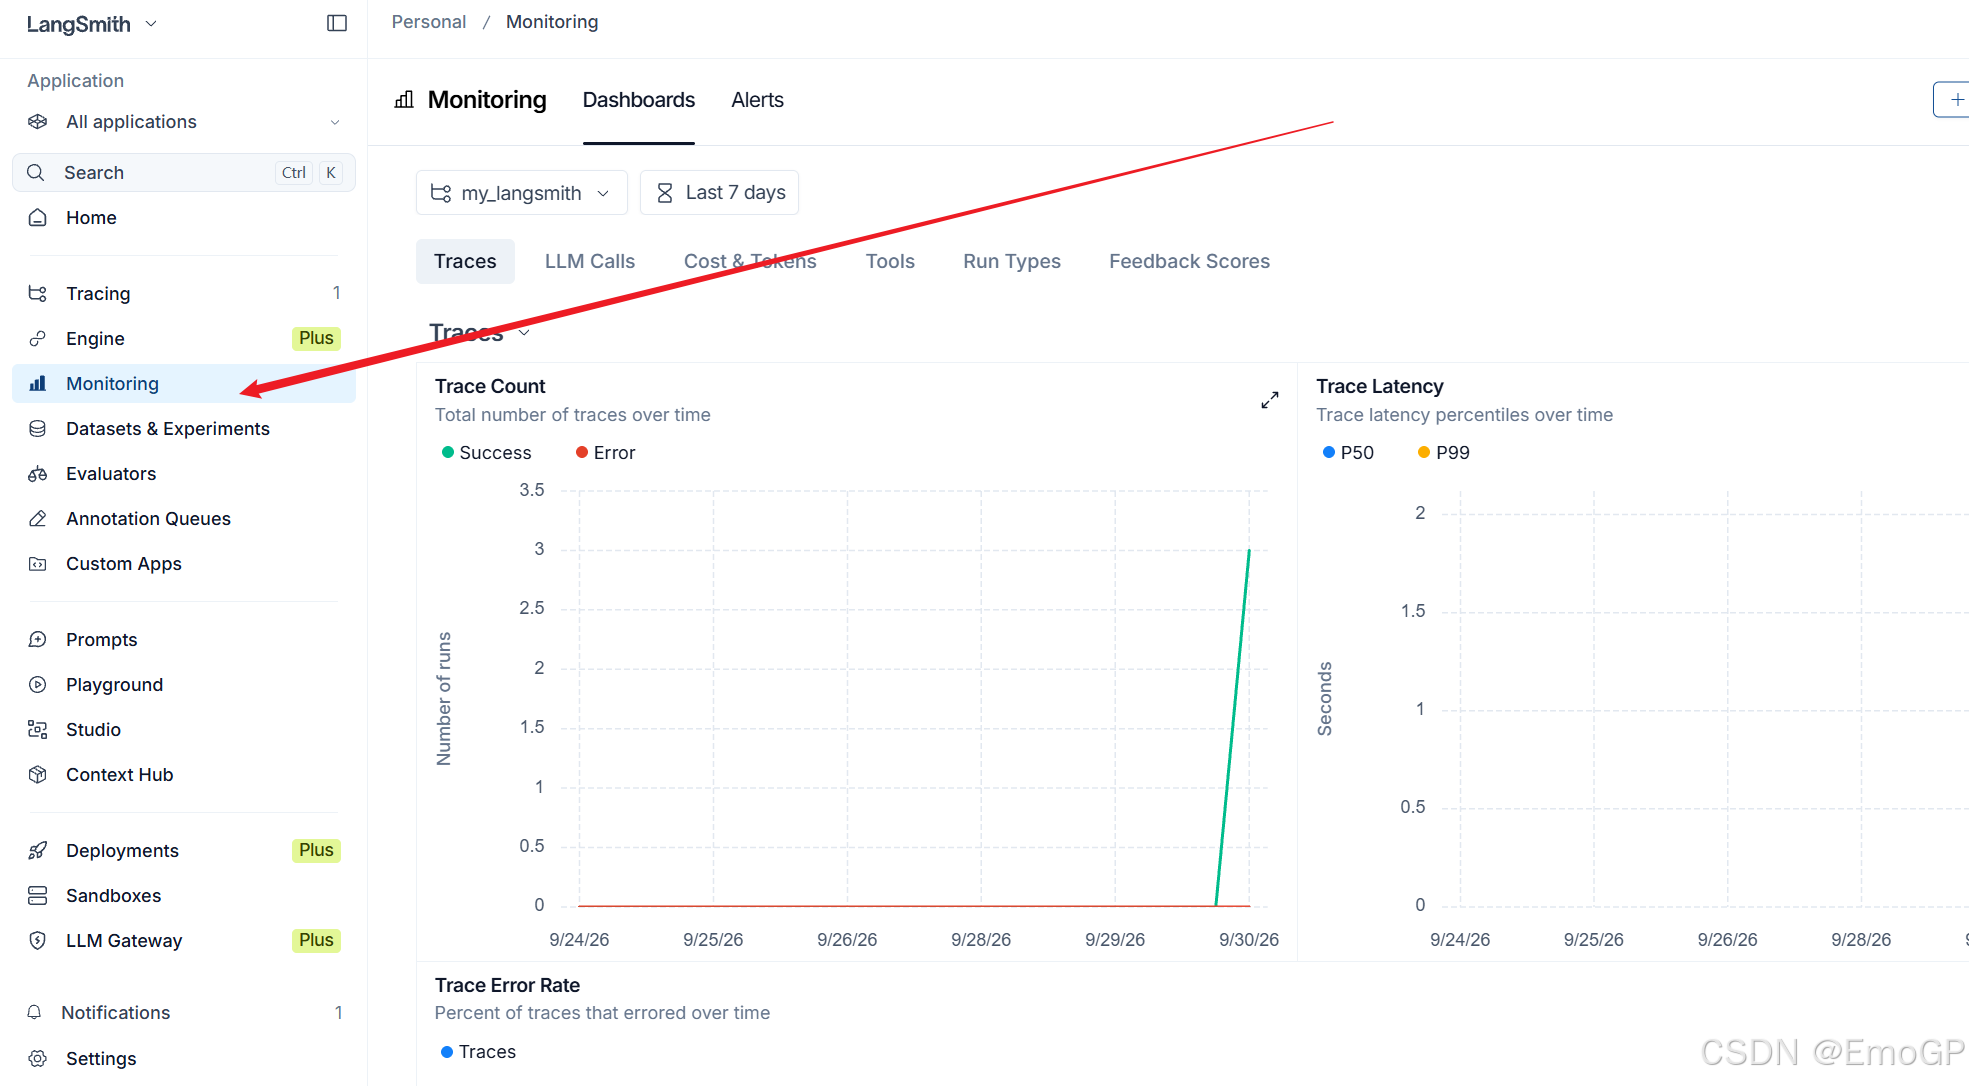
什么是LangSmith?
LangSmith是LangChain生态系统中专门用于LLM(大预言模型)应用调试、监控、评估和管理的平台。
追踪(tracing):记录每次LLM调用的详细信息
监控(monitoring):实时查看应用性能
调试(debug):排查问题和优化性能
评估(evaluate):系统化测试LLM应用
访问官网:
https://smith.LangChain.com
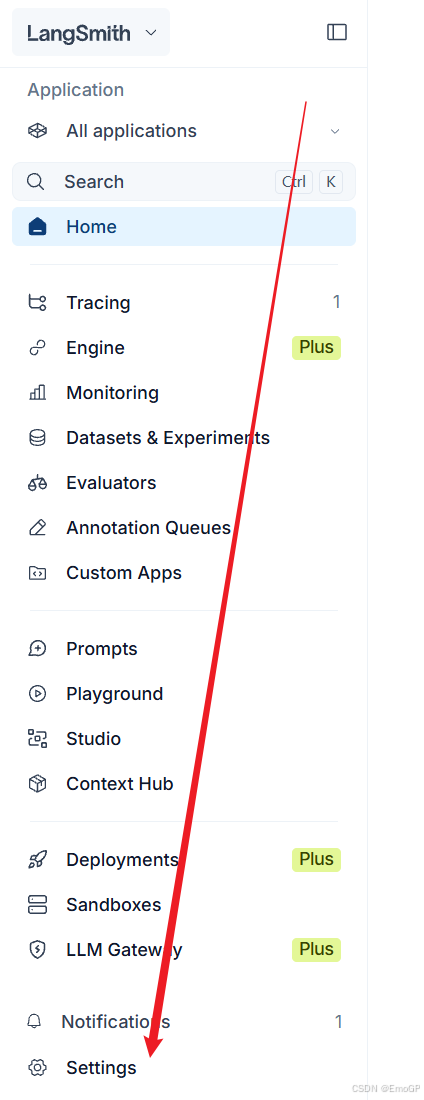
我们进行监控也需要API KEY
打开settings
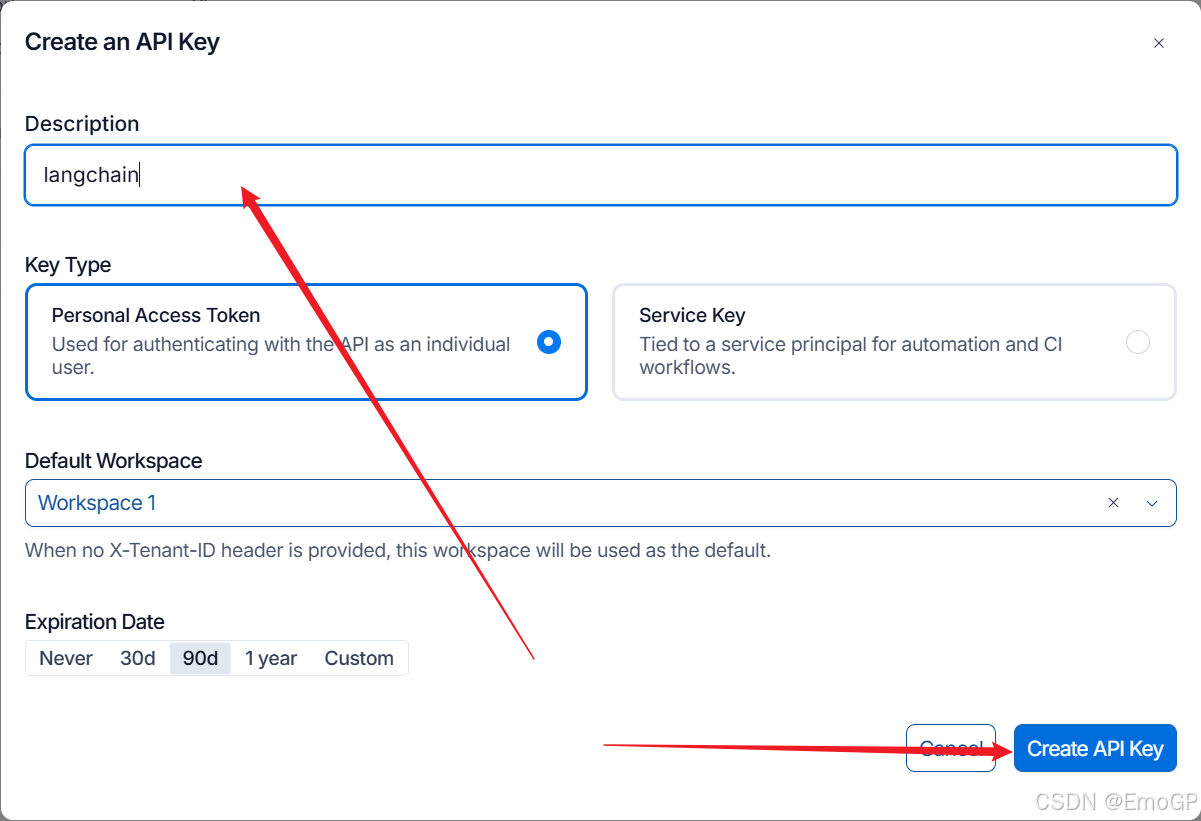
新增环境变量
在.env配置文件中,添加四个环境变量:
bash
# 是否启用Langsmith监控功能
LANGSMITH_TRACING=true
# Langsmith监控WebUI地址
LANGSMITH_ENDPOINT=https://api.smith.LangChain.com
# 创建的API_KEY
LANGSMITH_API_KEY=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
# 自定义项目名称,可以在Langsmith WebUI监控页面根据名称查看对应的运行记录
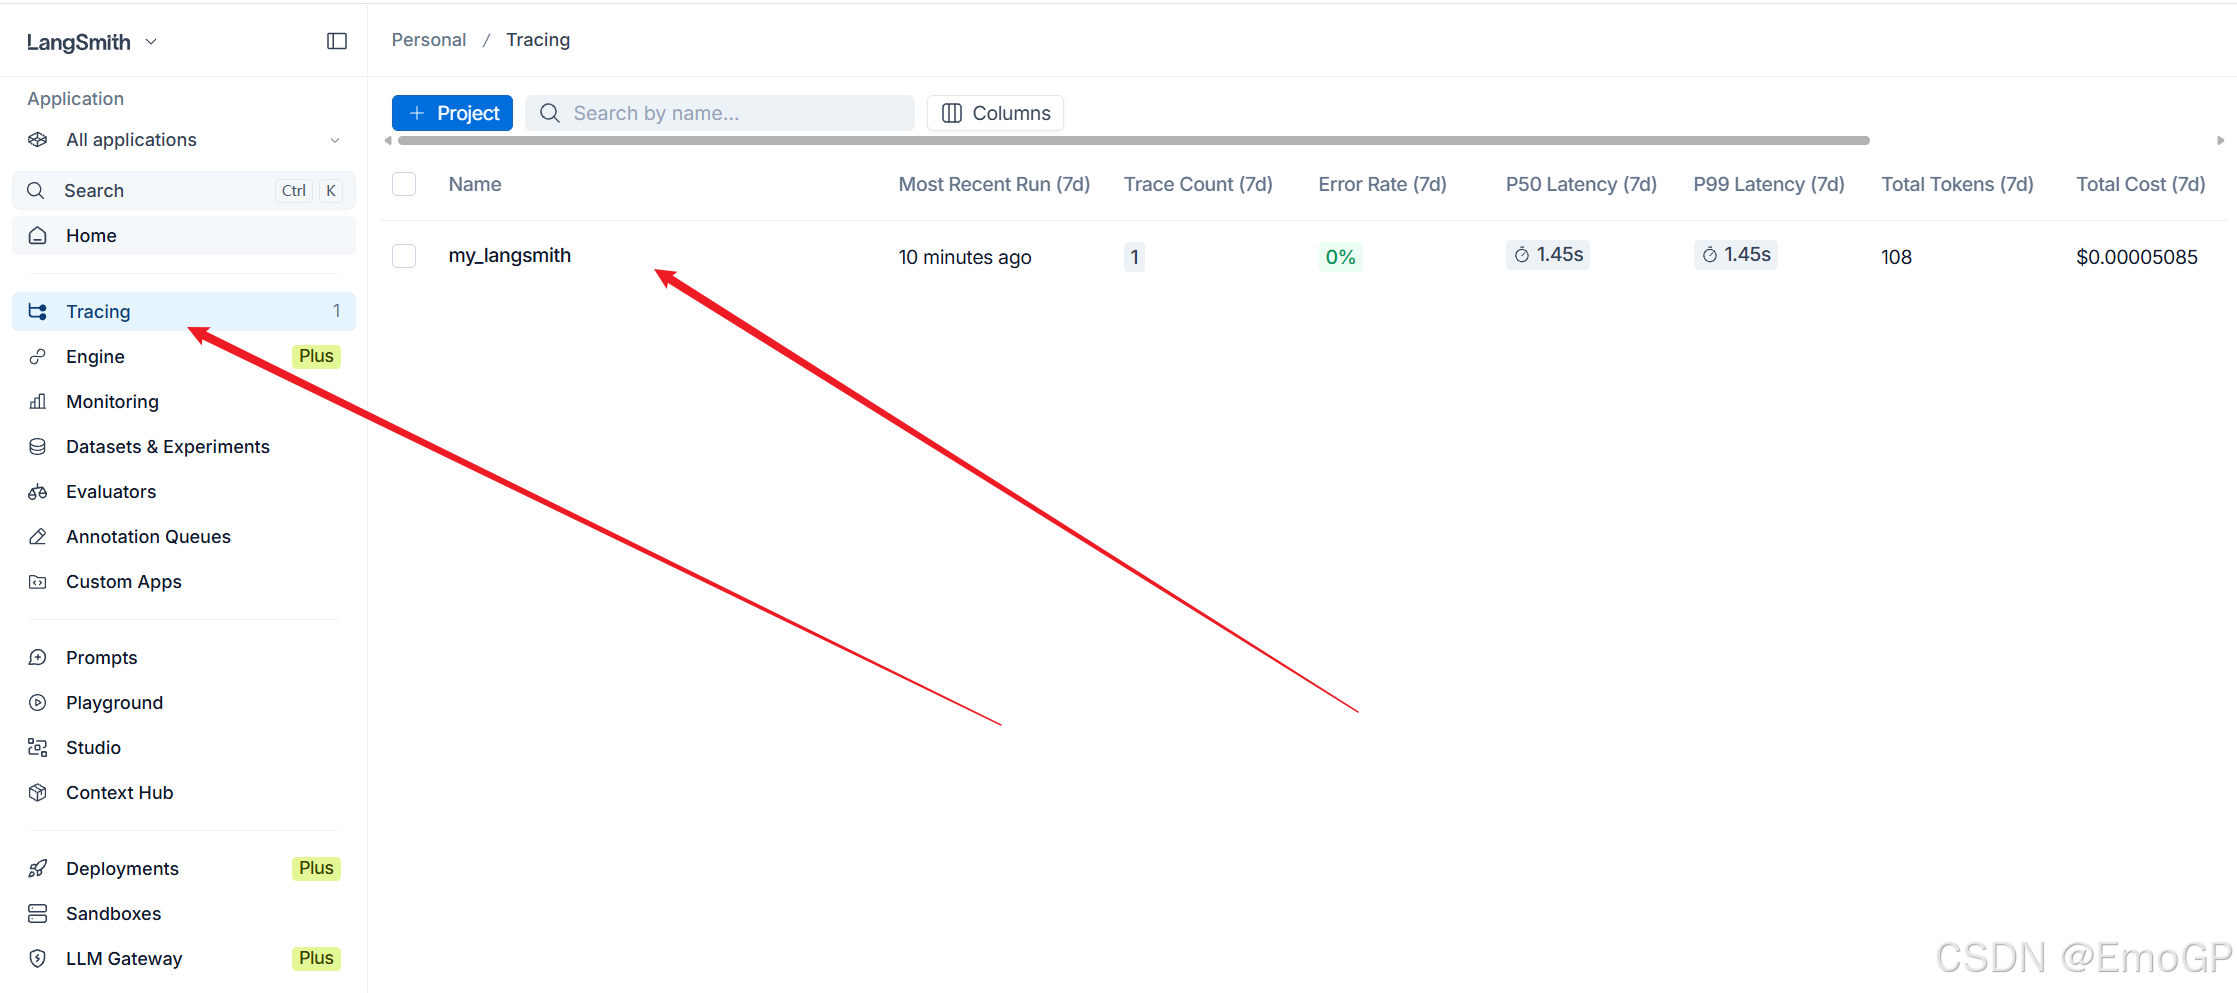
LANGSMITH_PROJECT="my_langsmith"
测试:
bash
import os

from dotenv import load_dotenv
from langchain_deepseek import ChatDeepSeek

load_dotenv(override=True)

model = ChatDeepSeek(
    model_name = "deepseek-v4-flash"
)

print(model.invoke("你好"))
运行代码后去langsmith查看
举例2:
bash
from langchain.chat_models import init_chat_model

from dotenv import load_dotenv

load_dotenv(override=True)

CLOSEAI_API_KEY = os.getenv("CLOSEAI_API_KEY")
CLOSEAI_API_BASE = os.getenv("CLOSEAI_API_BASE")

model = init_chat_model(
    model = "openai:deepseek-v4-flash",
    api_key = CLOSEAI_API_KEY,
    base_url = CLOSEAI_API_BASE,
)

print(model.invoke("你好"))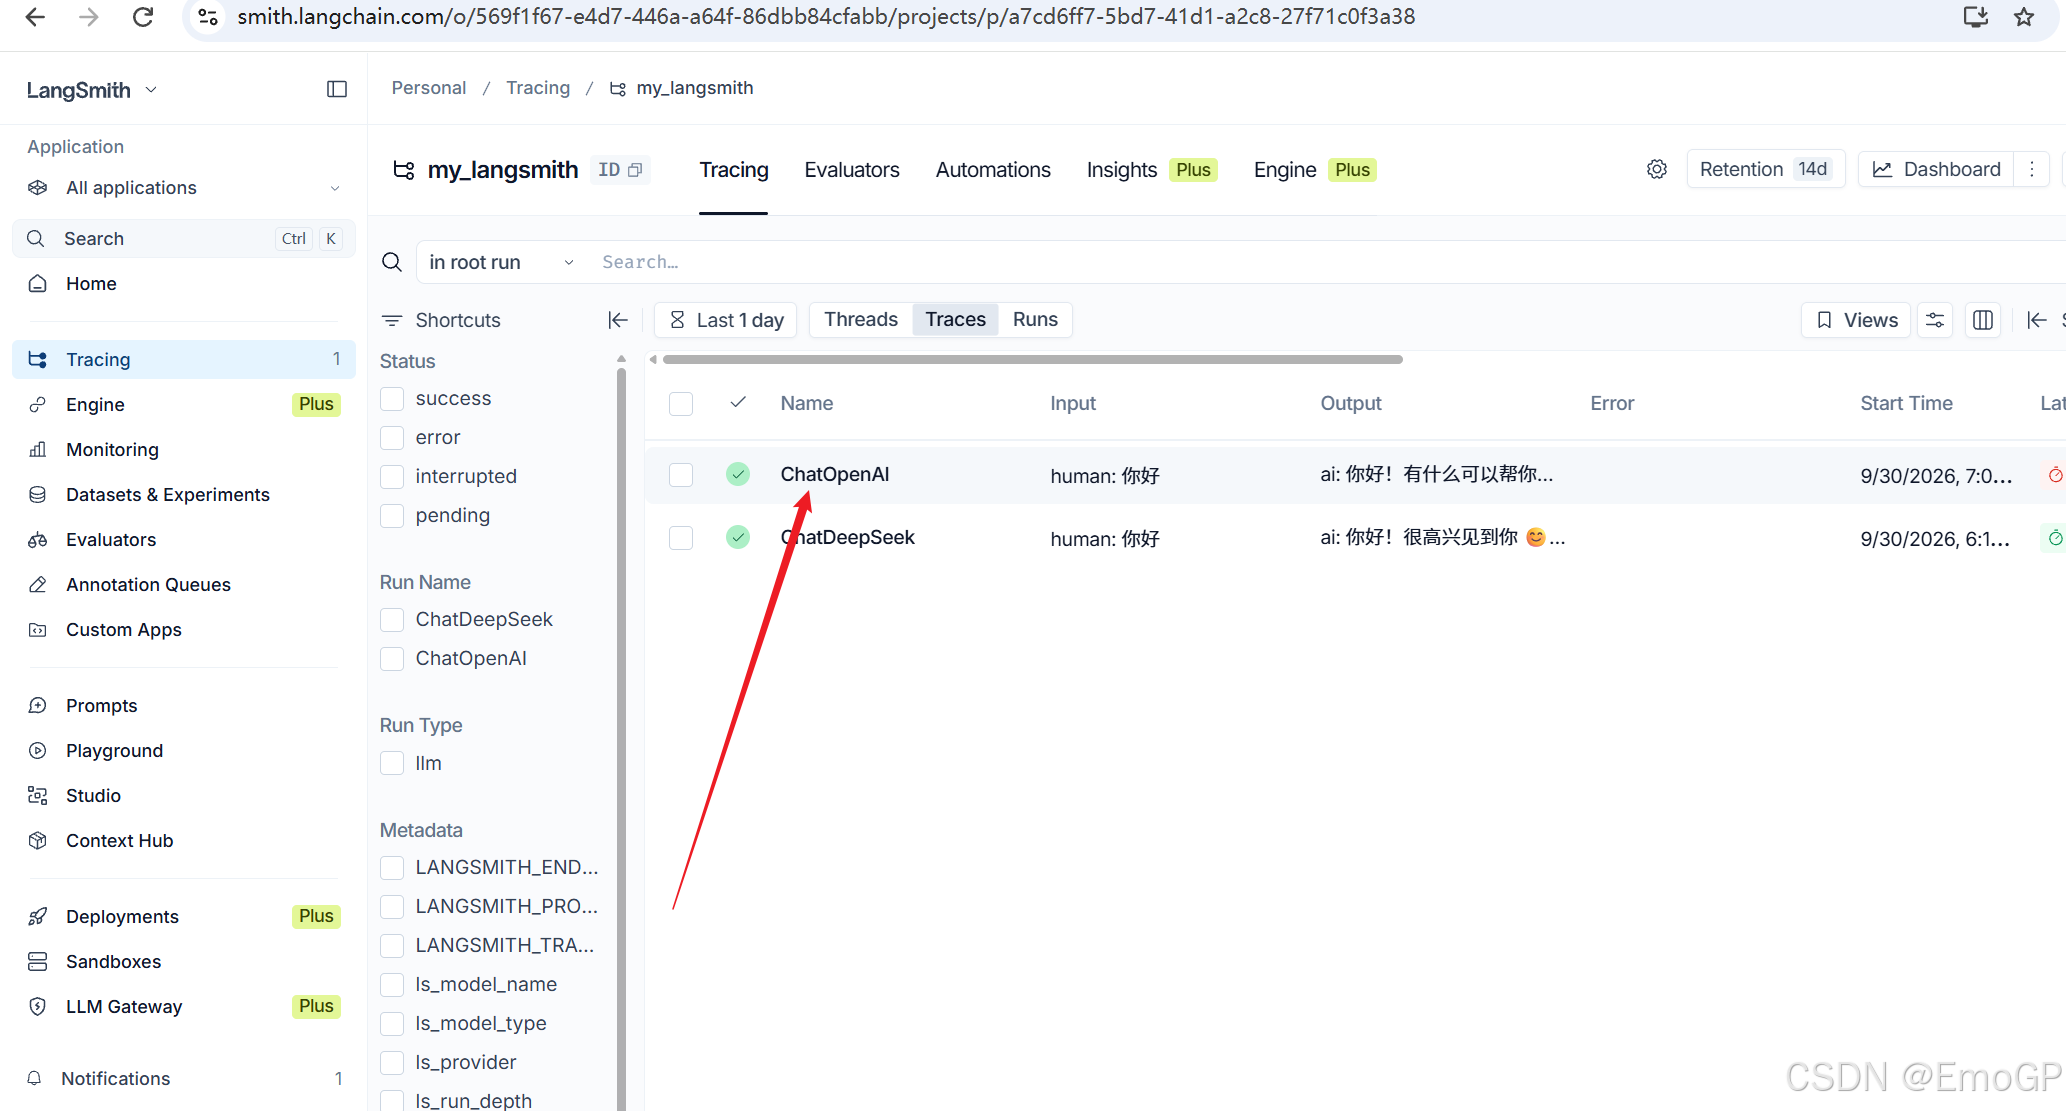
举例3:
bash
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
import os
from rich import print as rprint
# 从.env文件中加载环境变量
load_dotenv(override=True)
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
DEEPSEEK_BASE_URL = os.getenv("DEEPSEEK_BASE_URL")
# 1. 初始化模型
model = init_chat_model(
    model="deepseek-v4-flash",
    model_provider="deepseek",
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
    temperature=0.2,
    max_tokens=500,
    # 指定可调整参数
    configurable_fields=("model", "model_provider", "temperature",
"max_tokens"),
)
# 2. 准备 config 字典
config = {
    "run_name": "joke_generation", # 在LangSmith中这次运行会显示为"joke_generation"
    "tags": ["my_tag1", "my_tag2"], # 打上标签便于分类查找
    "metadata": {
        "user_id": "my", # 记录用户ID
        "session_id": "sess_123" # 记录会话ID
},
    "configurable": {
        "model": "deepseek-v4-pro", # 配置模型参数
        "model_provider": "openai", # 配置模型提供商参数
        "temperature": 0.7, # 配置温度参数
        "max_tokens": 1000 # 配置最大令牌数
        }
}
# 3. 调用模型并传入config
response = model.invoke(
    "1 + 2 = ?",
    config=config
)
rprint(response)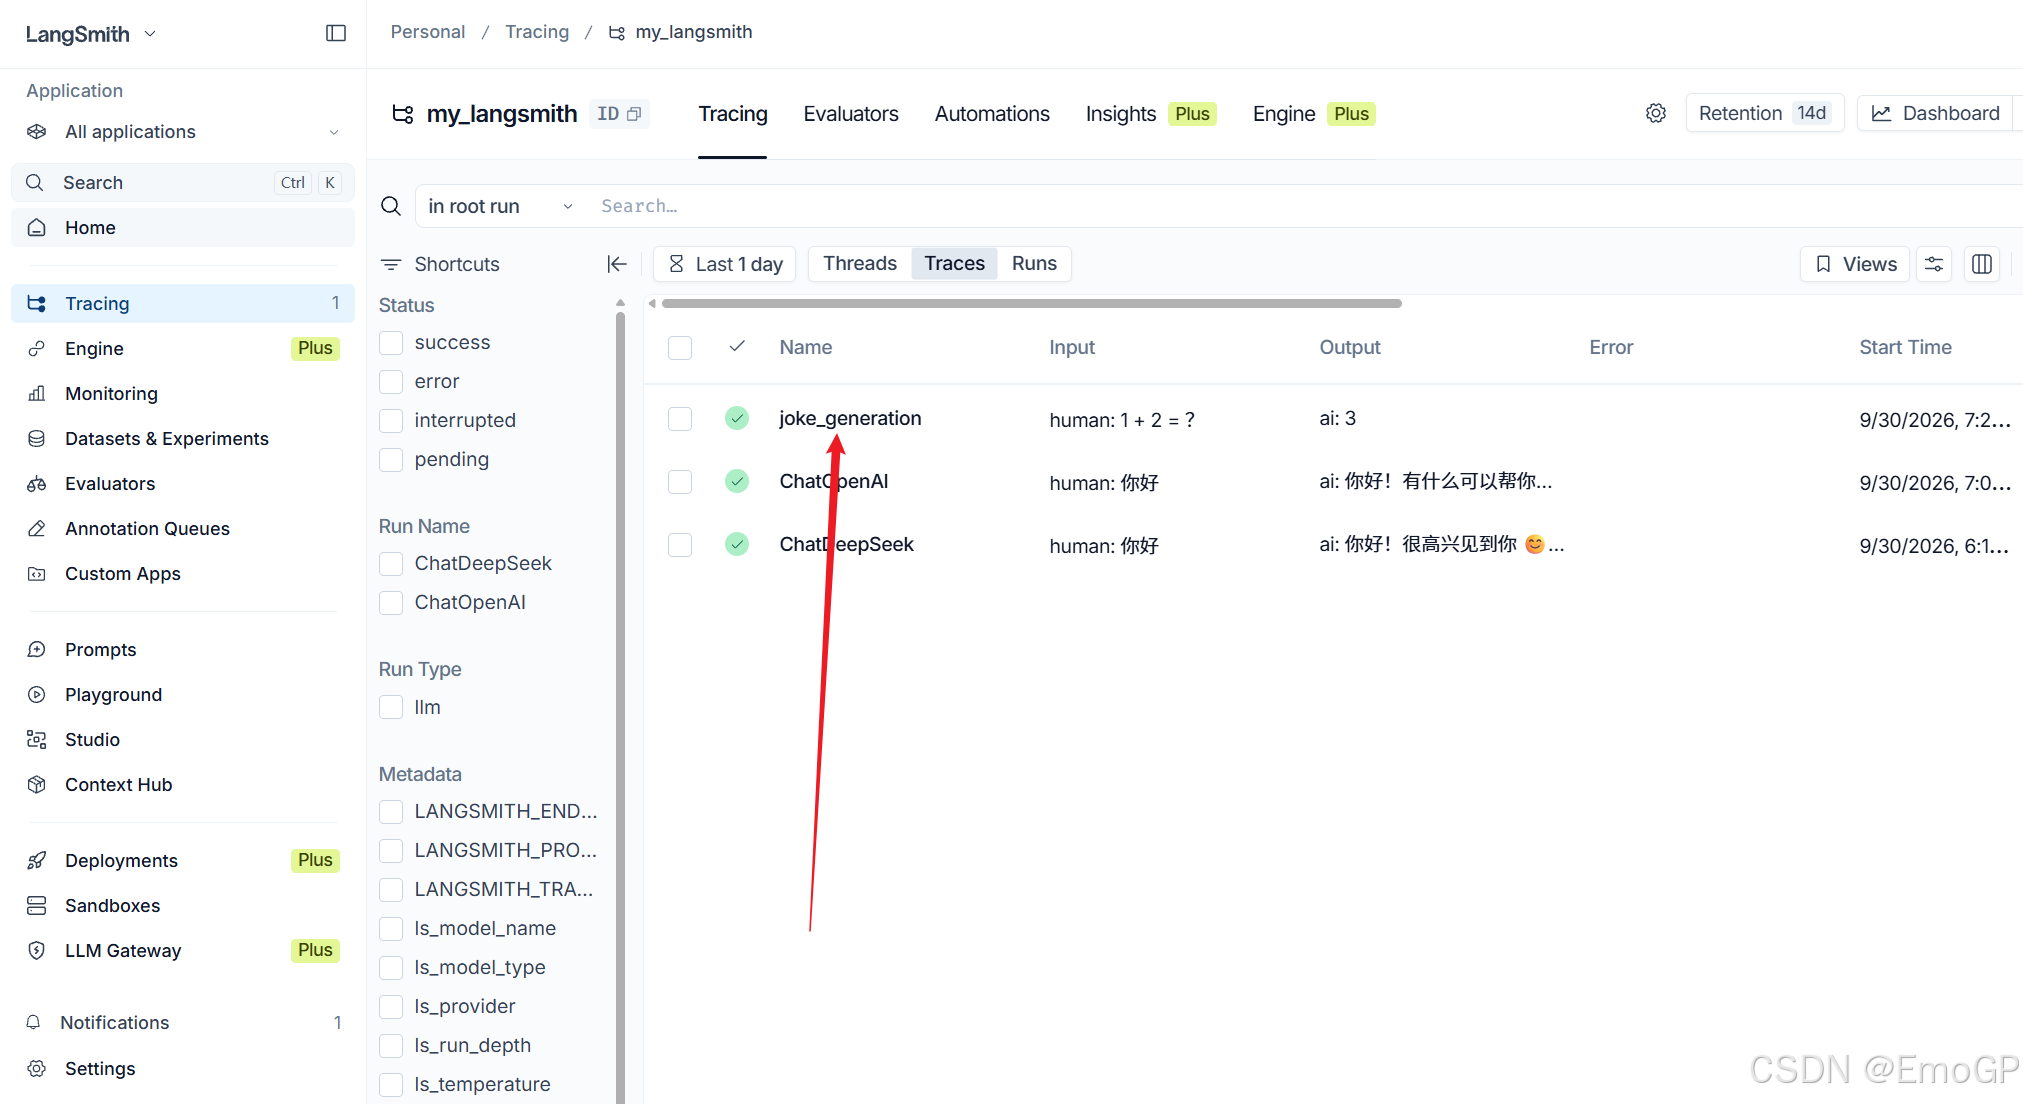
查看运行报表