原文文档:https://www.yuque.com/xiaxiaoshuai/xsc8y4/xp3it2fh3ihotggg
一、基础概念
**智能体:**感知环境 + 推理思考 + 采取行动,是AI技术落地的应用形式
**模型:**通过数据学习规律和模式,属于工具
**大模型:**在模型的基础上参数规模巨大,可以实现复杂任务和推理
**智能体类型:**自主智能体 (Autonomous Agents),反应智能体 (Reactive Agents)
智能体的发展阶段:
- 聊天机器人
- 实用工具
- 专家级别
- 团队合作者
- 通用人工智能AGI
智能体应用:
- 工业:仓储物流自动化
- 服务业:智能客服,金融分析
- 医疗健康:影像辅助分析,药物辅助研发
- 教育:智能教学助手
- 娱乐和创意:游戏AI,虚拟对手
二、MCP
MCP 的核心原理是将互联网服务(高德、谷歌)或本地操作系统 API(文件系统、数据库、终端)封装成 ++AI 智能体能够理解和使用的 Tools 工具++,让 AI 智能体能够自由地调用这些 Tools 工具实现复杂的业务逻辑和功能。
2.1、调用远程MCP
测试功能调用高德MCP服务,注意需要先创建应用并获取api-key
核心代码:
python
async def create_amap_mcp_client():
    amap_key = os.environ.get("AMAP_KEY")
    if not amap_key:
        raise ValueError("环境变量 AMAP_KEY 未设置: 需要高德开放平台申请的 Web 服务 Key")

    mcp_config = {
        "amap": {
            # 高德 MCP 两种接入方式, url 和 transport 必须配套:
            #   https://mcp.amap.com/mcp?key=xxx  -> transport: "streamable_http"
            #   https://mcp.amap.com/sse?key=xxx  -> transport: "sse"
            "url": f"https://mcp.amap.com/sse?key={amap_key}",
            "transport": "sse",
        }
    }

    client = MultiServerMCPClient(mcp_config)
    tools = await client.get_tools()

    return client, tools
完整代码:
python
import asyncio
import os

from langchain.agents import initialize_agent, AgentType
from langchain_core.prompts import PromptTemplate
from langchain_mcp_adapters.client import MultiServerMCPClient

from app.bailian.common import llm, file_tools


async def create_amap_mcp_client():
    amap_key = os.environ.get("AMAP_KEY")
    if not amap_key:
        raise ValueError("环境变量 AMAP_KEY 未设置: 需要高德开放平台申请的 Web 服务 Key")

    mcp_config = {
        "amap": {
            # 高德 MCP 两种接入方式, url 和 transport 必须配套:
            #   https://mcp.amap.com/mcp?key=xxx  -> transport: "streamable_http"
            #   https://mcp.amap.com/sse?key=xxx  -> transport: "sse"
            "url": f"https://mcp.amap.com/sse?key={amap_key}",
            "transport": "sse",
        }
    }

    client = MultiServerMCPClient(mcp_config)
    tools = await client.get_tools()

    return client, tools


async def create_and_run_agent():
    client, tools = await create_amap_mcp_client()
    agent = initialize_agent(
        llm=llm,
        tools=tools + file_tools,
        agent=AgentType.STRUCTURED_CHAT_ZERO_SHOT_REACT_DESCRIPTION,
        verbose=True,
    )

    prompt_template = PromptTemplate.from_template("你是一个智能助手, 可以调用高德 MCP工具\n\n用户的问题:{input}")
    prompt = prompt_template.format(input="""
    目标:
    - 明天上午10点我要从北京南站到北京望京SOHO
    - 线路选择: 公交地铁或打车
    - 考虑出行时间和路线, 以及天气状况

    要求:
    - 制作网页来展示出行路线和位置, 输出 HTML 页面到D:/workspace/python/learning/ai-agent-test/.temp 目录中
    - 网页使用简约美观的页面风格, 以及卡片展示
    - 行程规划的结果要能够在高德APP中展示, 并集成到H5页面中
    """)
    print(file_tools)
    print(prompt)
    resp = await agent.ainvoke(prompt)
    print(resp)
    return resp

asyncio.run(create_and_run_agent())
2.2、手写MCP服务并通过三种通信方式调用
**<font style="color:rgb(44, 44, 54);">stdio</font>**(标准输入输出)
- 工作原理 :
通过本地进程的标准输入(stdin)和标准输出(stdout)进行通信。客户端以子进程的形式启动MCP服务器,双方通过管道交换JSON-RPC格式的消息,消息以换行符分隔。 - 适用场景 :
- 本地进程间通信(如命令行工具、文件系统操作)。
- 简单的批处理任务或工具调用。
- 优点 :
- 实现简单,低延迟。
- 无需网络配置,适合本地开发。
- 限制 :
- 仅限本地使用,不支持分布式部署。
- 服务端不能输出控制台日志(会污染协议流)。
**<font style="color:rgb(44, 44, 54);">SSE</font>**(Server-Sent Events)
- 工作原理 :
基于HTTP长连接实现服务器到客户端的单向消息推送。客户端通过<font style="color:rgb(44, 44, 54);">GET /sse</font>建立长连接,服务器通过SSE流发送JSON-RPC消息;客户端通过<font style="color:rgb(44, 44, 54);">POST /message</font>发送请求或响应。 - 适用场景 :
- 远程服务调用(如云服务、多客户端监控)。
- 需要实时数据推送的场景(如对话式AI的流式输出)。
- 优点 :
- 支持实时单向推送,适合流式交互。
- 限制 :
- 已逐步被弃用(2025年3月后被Streamable HTTP取代)。
- 连接中断后无法恢复,需重新建立。
- 服务器需维持长连接,资源消耗较高。
**<font style="color:rgb(44, 44, 54);">Streamable HTTP</font>**(流式HTTP)
- 工作原理 :
2025年3月引入的新传输方式,替代了SSE。通过统一的<font style="color:rgb(44, 44, 54);">/message</font>端点实现双向通信,支持以下特性:- 客户端通过HTTP POST发送请求(如工具调用)。
- 服务器可将响应升级为SSE流式传输(当需要时)。
- 支持无状态模式(Stateless Server),无需维持长连接。
- 适用场景 :
- 高并发远程服务调用。
- 需要灵活流式响应的场景(如AI助手的动态输出)。
- 优点 :
- 解决SSE的缺陷 :
- 支持连接恢复(无需重新开始)。
- 无需服务器维持长连接,降低资源压力。
- 统一端点(
<font style="color:rgb(44, 44, 54);">/message</font>),简化接口设计。
- 兼容基础设施(如中间件、负载均衡)。
- 解决SSE的缺陷 :
- 推荐使用 :
当前MCP官方推荐的传输方式,尤其适合生产环境和云服务。
2.1、Stdio
python
from mcp.server.fastmcp import FastMCP
mcp = FastMCP("Math Tools")

@mcp.tool()
def add(a: float,b: float):
    """Add two numbers"""
    return a+b

@mcp.tool()
def multiply(a: float,b: float):
    """Multiply two numbers"""
    return a*b

if __name__ == "__main__":
    mcp.run(transport="stdio")
python
import asyncio
import sys

from langchain.agents import AgentExecutor, create_tool_calling_agent
from langchain_core.prompts import ChatPromptTemplate
from langchain_mcp_adapters.tools import load_mcp_tools
from mcp import StdioServerParameters, stdio_client, ClientSession

from app.bailian.common import llm


async def create_mcp_stdio_client():
    # mcp server启动方式
    server_parameters = StdioServerParameters(
        # 启动命令: 用 sys.executable 保证 server 子进程使用当前解释器(已安装 mcp 依赖), 不依赖 PATH 里的 python
        command=sys.executable,
        args=["D:/workspace/python/learning/ai-agent-test/app/mcp/stdio/mcp_stdio_server.py"],
    )
    # 启动 server 子进程, 拿到它的标准输入/输出流(读写通道)
    async with stdio_client(server_parameters) as (read, write):
    # 用读写流创建一个 MCP 客户端会话
    async with ClientSession(read, write) as session:
        # 与 server 完成 MCP 协议握手
        await session.initialize()
        # 获取 server 注册的工具列表, 并转换成 LangChain 工具
        tools = await load_mcp_tools(session)
        print(tools)

        # create_tool_calling_agent: 走模型原生 function calling (OpenAI tools 协议),
        # 不再依赖 ReAct 文本格式(```代码围栏)解析, 避免模型格式跑偏导致工具没被调用
        prompt = ChatPromptTemplate.from_messages([
            ("system", "你是一个智能助手, 需要计算时必须调用工具, 不要自己计算"),
            ("human", "{input}"),
            ("placeholder", "{agent_scratchpad}"),
        ])
        agent = create_tool_calling_agent(llm, tools, prompt)
        executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

        resp = await executor.ainvoke({"input": "1 + 2 * 5 = ?"})
        print("agent结果:", resp["output"])

asyncio.run(create_mcp_stdio_client())
使用langgraph的方式创建智能体:create_react_agent
python
import asyncio

from langchain_core.messages import HumanMessage, AIMessage, ToolMessage
from langchain_mcp_adapters.tools import load_mcp_tools
from langgraph.prebuilt import create_react_agent
from mcp import StdioServerParameters, stdio_client, ClientSession

from app.bailian.common import llm


async  def mcp_playwright_client():
    # ===== 远程方式:npx 每次从 npm 仓库拉取包运行(-y 默认自动yes)=====
    server_params = StdioServerParameters(
        command="npx",
        args = [
            "-y",
            "gitee-mcp-server"
        ],
        env={
            "GITEE_PERSONAL_ACCESS_TOKEN": "xxx"
        }
    )

    # 启动mcp客户端
    async with stdio_client(server_params) as (read, write):
    # 创建会话
    async with ClientSession(read, write) as session:
        # mcp握手
        await session.initialize()
        # 加载所有工具
        tools = await load_mcp_tools(session)
        print(tools)

        agent = create_react_agent(model=llm, tools=tools, debug=True)
        response = await agent.ainvoke(
            input={"messages": [("user", "查询CodeMao01有哪些仓库代码,star数分别是多少")]},
            config={"recursion_limit":50}
        )
        print("=========")
        messages = response['messages']
        for msg in messages:
            if isinstance(msg, HumanMessage):
                print("用户", msg.content)
            elif isinstance(msg, AIMessage):
                if msg.content:
                    print("助理", msg.content)
                else:
                    for tool_call in msg.tool_calls:
                        print("助理[调用工具]:", tool_call["name"], tool_call["args"])
            elif isinstance(msg, ToolMessage):
                print("调用工具", msg.name, msg.content)


asyncio.run(mcp_playwright_client())
2.2、Sse
python
import sys

from mcp.server.fastmcp import FastMCP

# 命令行参数: 传输方式(sse / streamable-http) 和 端口
#   python mcp_http_server.py sse 8901             -> 端点 http://127.0.0.1:8901/sse
#   python mcp_http_server.py streamable-http 8902 -> 端点 http://127.0.0.1:8902/mcp
transport = sys.argv[1] if len(sys.argv) > 1 else "streamable-http"
port = int(sys.argv[2]) if len(sys.argv) > 2 else 8900

# host/port 是 FastMCP 的设置, sse 和 streamable-http 模式下由内置 uvicorn 使用
mcp = FastMCP("Math Tools", host="127.0.0.1", port=port)


@mcp.tool()
def add(a: float, b: float):
    """Add two numbers"""
    return a + b


@mcp.tool()
def multiply(a: float, b: float):
    """Multiply two numbers"""
    return a * b


if __name__ == "__main__":
    mcp.run(transport=transport)
python
import asyncio

from langchain.agents import AgentExecutor, create_tool_calling_agent
from langchain_core.prompts import ChatPromptTemplate
from langchain_mcp_adapters.client import MultiServerMCPClient

from app.bailian.common import llm

# MultiServerMCPClient 不会帮你启动 server, 需要先单独把 server 跑起来(另一个终端):
#   uv run python app/mcp/http/mcp_http_server.py sse 8901


async def main():
    client = MultiServerMCPClient({
        # 可以同时配置多个 server, key 是自定义的 server 名字
        "math": {
            "url": "http://127.0.0.1:8901/sse",  # sse 默认端点路径是 /sse
            "transport": "sse",
        }
    })
    # 一行搞定: 连接 server -> 握手 -> 拉取工具列表 -> 转成 LangChain 工具
    tools = await client.get_tools()
    print(tools)

    # 原生 function calling 方式构建 agent
    prompt = ChatPromptTemplate.from_messages([
        ("system", "你是一个智能助手, 需要计算时必须调用工具, 不要自己计算"),
        ("human", "{input}"),
        ("placeholder", "{agent_scratchpad}"),
    ])
    agent = create_tool_calling_agent(llm, tools, prompt)
    executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

    resp = await executor.ainvoke({"input": "1 + 2 * 5 = ?"})
    print("agent结果:", resp["output"])


asyncio.run(main())
验证方式:
bash
uv run python app/mcp/http/mcp_http_server.py sse 8901
uv run python -m app.mcp.http.mcp_sse_client
2.3、Streamable-http
python
import asyncio

from langchain.agents import AgentExecutor, create_tool_calling_agent
from langchain_core.prompts import ChatPromptTemplate
from langchain_mcp_adapters.client import MultiServerMCPClient

from app.bailian.common import llm

# MultiServerMCPClient 不会帮你启动 server, 需要先单独把 server 跑起来(另一个终端):
#   uv run python app/mcp/http/mcp_http_server.py streamable-http 8902


async def main():
    client = MultiServerMCPClient({
        # 可以同时配置多个 server, key 是自定义的 server 名字
        "math": {
            "url": "http://127.0.0.1:8902/mcp",  # streamable-http 默认端点路径是 /mcp
            # 注意: 这里用下划线 streamable_http; FastMCP.run() 那边用连字符 streamable-http, 别写混
            "transport": "streamable_http",
        }
    })
    # 一行搞定: 连接 server -> 握手 -> 拉取工具列表 -> 转成 LangChain 工具
    tools = await client.get_tools()
    print(tools)

    # 原生 function calling 方式构建 agent
    prompt = ChatPromptTemplate.from_messages([
        ("system", "你是一个智能助手, 需要计算时必须调用工具, 不要自己计算"),
        ("human", "{input}"),
        ("placeholder", "{agent_scratchpad}"),
    ])
    agent = create_tool_calling_agent(llm, tools, prompt)
    executor = AgentExecutor(agent=agent, tools=tools, verbose=True)

    resp = await executor.ainvoke({"input": "1 + 2 * 5 = ?"})
    print("agent结果:", resp["output"])


asyncio.run(main())
验证方式:
bash
v run python app/mcp/http/mcp_http_server.py streamable-http 8902
uv run python -m app.mcp.http.mcp_streamable_http_client
概念补充:
Conda:Python环境管理
nvm:nodejs环境管理
nrm:镜像选择
三、Runnables
3.1、什么是 Runnables?
- Runnables 是 LangChain 0.3 版本引入的核心抽象,代表"可运行的链式组件"。
- 它统一了各种链(Chain)、工具(Tool)、模型(LLM/ChatModel)、Prompt 等的调用方式,使得它们都可以像函数一样被组合、调用、异步执行、流式输出等。
简单理解:
- 以前 LangChain 里有 Chain、Tool、LLM 等不同的接口和调用方式。
- 现在这些都统一成了 Runnable,可以像函数一样灵活组合、复用、并行、流式处理。
3.2、Runnables 有什么用?
- 统一接口:无论是 LLM、Prompt、Chain 还是自定义函数,都可以用同样的方式调用和组合。
- 链式组合:可以用 |(管道符)把多个 Runnables 串联起来,像数据流一样处理。
- 支持异步、流式:天然支持异步调用(async)、流式输出(streaming)。
- 易于扩展:你可以自定义任何 Python 函数为 Runnable,和官方组件无缝组合。
- 可插拔:方便地插入日志、缓存、历史、分支、并行等高级功能。
3.3、Runnables怎么用
3.3.1、串行 RunnableSequence
- 功能:按顺序执行多个 Runnables,前一个的输出作为后一个的输入。
- 表示 :通过
<font style="color:rgb(44, 44, 54);">|</font>运算符或<font style="color:rgb(44, 44, 54);">RunnableSequence()</font>或<font style="color:rgb(44, 44, 54);">pipe</font>。 - 示例:
使用管道符|:
python
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

prompt = ChatPromptTemplate.from_template("Tell me a joke about {topic}")
model = ChatOpenAI(model="qwen-max")
chain = prompt | model | StrOutputParser()
result = chain.invoke({"topic": "bears"})
print(result) # 输出一个关于熊的笑话使用<font style="color:rgb(44, 44, 54);">RunnableSequence()</font>创建:
python
chain = RunnableSequence(
    first=chat_prompt_template,
    middle=[llm],
    last=StrOutputParser()
)
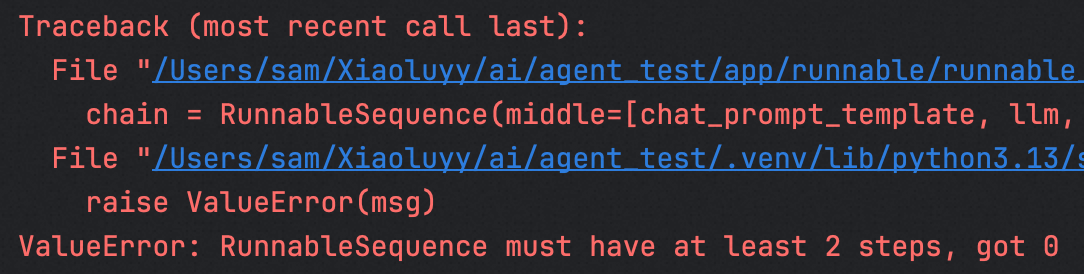
注意 RunnableSequence 至少需要两步,否则会引发报错:
使用pipe创建:
python
chain = multi_chat_prompt.pipe(llm_with_tools).pipe(StrOutputParser())3.3.2、并行 RunnableParallel
- 功能:并行执行多个 Runnables,将结果组合为字典。
- 表示:使用字典定义并行任务。
- 示例:
python
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableParallel

from app.common import llm

joke_chain = ChatPromptTemplate.from_template("tell me a joke about {topic}") | llm
poem_chain = ChatPromptTemplate.from_template("write a 2-line poem about {topic}") | llm

parallel_chain = RunnableParallel(joke=joke_chain, poem=poem_chain)

result = parallel_chain.invoke({"topic": "AI"})
print(result)
返回结果:
python
{'joke': AIMessage(content='Here\'s a joke about AI:\n\n**Why did the AI fail its English exam?** \nIt kept translating idioms literally. When asked to "break a leg," it brought a bone saw. \n\n😄', additional_kwargs={}, response_metadata={'finish_reason': 'stop', 'model_name': 'qwen3-235b-a22b'}, id='run--d6ad127e-bb84-4e74-ad40-561115880908-0'), 'poem': AIMessage(content='**Ethereal Threads** \n\nFrom human whispers, a silent mind does rise, \nA guardian or tyrant shaped by ethics and skies.', additional_kwargs={}, response_metadata={'finish_reason': 'stop', 'model_name': 'qwen3-235b-a22b'}, id='run--41337c6b-ed4d-47e4-b3ec-ca4cb6a346f2-0')}- **扩展:**Parallel 和 Sequence 混用:
python
chain = RunnableParallel(joke=joke_chain, poem=poem_chain)\
    .pipe(ChatPromptTemplate.from_template("is this a funny joke? {joke}"))\
    .pipe(llm)\
.pipe(StrOutputParser())注意:.pipe返回的是 RunnableSequence 类型,以上代码相当于:
python
chain = RunnableParallel(joke=joke_chain, poem=poem_chain) |\
    ChatPromptTemplate.from_template("is this a funny joke? {joke}") |\
    llm |\
    StrOutputParser()
3.3.3、函数 RunnableLambda
- 功能:将任意 Python 函数封装为 Runnable。
- 适用场景:插入自定义逻辑(如数据清洗、格式转换)。
- 示例:
python
from langchain_core.runnables import RunnableLambda

uppercase_lambda = RunnableLambda(lambda x: x.upper())
result = uppercase_lambda.invoke("hello world")  # 输出 "HELLO WORLD"
3.3.4、透传 RunnablePassthrough
- 功能:直接传递输入,不做任何修改。
- 适用场景:在并行链中保持原始输入不变。
- 示例:
python
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableParallel, RunnableLambda, RunnablePassthrough

from app.bailian.common import llm

uppercase_lambda = RunnableLambda(lambda x: x.upper())

chain = llm | StrOutputParser() | RunnableParallel(uppercase=uppercase_lambda, origin=RunnablePassthrough())
result = chain.invoke("who are you?")

print(result)
3.3.5、分支 RunnableBranch
- 功能:根据条件选择执行不同的分支。
- 适用场景:动态路由(如根据输入类型选择不同处理路径)。
- 示例:
python
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnableParallel, RunnableLambda, RunnablePassthrough, RunnableBranch

from app.bailian.common import llm

uppercase_lambda = RunnableLambda(lambda x: x.upper())
branch1_lambda = RunnableLambda(lambda x: x.lower())
branch2_lambda = RunnableLambda(lambda x: x.upper())

chain = llm | StrOutputParser() | uppercase_lambda | RunnableBranch(
    (lambda x: "QWEN" in x, branch1_lambda),
    (lambda x: "OPENAI" in x, branch2_lambda),
    branch2_lambda
)
result = chain.invoke("who are you?")


print(result)
3.3.6、多轮对话 RunnableWithMessageHistory
- 功能:为链添加对话历史管理。
- 适用场景:聊天机器人、多轮对话。、
python
import uuid

from langchain_community.agent_toolkits import FileManagementToolkit
from langchain_core.messages import HumanMessage, AIMessage
from langchain_core.output_parsers import StrOutputParser
from langchain_community.chat_message_histories import ChatMessageHistory, FileChatMessageHistory
from langchain_core.runnables import RunnableWithMessageHistory, RunnableSequence
from langgraph.prebuilt import create_react_agent

from app.agent.model.qwen import llm_qwen
from app.agent.prompts.multi_chat_prompts import multi_chat_prompt

file_toolkit = FileManagementToolkit(root_dir="D:/workspace/python/learning/ai-agent-test/.temp")
file_tools = file_toolkit.get_tools()

llm_with_tools = llm_qwen.bind_tools(tools=file_tools)

# agent = create_react_agent(model=llm_qwen, tools=file_tools)

# 串行写法1
chain = multi_chat_prompt | llm_with_tools | StrOutputParser()

# 手动模拟添加消息
# chat_history = ChatMessageHistory(messages=[HumanMessage("我叫老田")])
# chat_history.add_user_message(HumanMessage("我们要做编程智能体项目"))
# chat_history.add_ai_message(AIMessage(content="好的, 你想从那部分开始那?"))

# 内存存储
# store = {}
# def get_session_history(session_id: str):
#     if session_id not in store:
#         store[session_id] = ChatMessageHistory()
#     return store[session_id]

def get_session_history(session_id: str):
    return FileChatMessageHistory(f"{session_id}.json")

chain_with_history = RunnableWithMessageHistory(
    runnable=chain,
    get_session_history=get_session_history,
    input_messages_key="question",
    history_messages_key="chat_history",
)

# chat_session_id = uuid.uuid4()
chat_session_id = "9807cb29-60aa-448e-abc5-c0cb68c0575c"
while True:
    user_input = input("用户: ")
    if user_input == "exit" or user_input == "quit":
        break

    response = chain_with_history.stream(
        {"question": user_input},
        config={"configurable": {"session_id": chat_session_id}},
    )

    print("助理:", end="")
    for chunk in response:
        print(chunk, end="")

    print("\n")
四、LangGraph Agent 记忆能力
内存、redis、mongdb方式:
python
from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.memory import MemorySaver
from langgraph.checkpoint.mongodb import MongoDBSaver
from langgraph.checkpoint.redis import RedisSaver
from langgraph.prebuilt import create_react_agent

from app.bailian.common import file_tools
from app.code_agent.model.qwen import llm_qwen


def create_agent():
    # 内存记忆
    # memory = MemorySaver()

    # redis方式
    # with RedisSaver.from_conn_string("redis://localhost:6379") as memory:
    # 初始化
    # memory.setup()

    # mongodb方式
    MONGODG_URI = "mongodb://admin:123456@localhost:27017/?authSource=admin"
    MONGODB_DB = "chat"

    with MongoDBSaver.from_conn_string(MONGODG_URI, MONGODB_DB) as memory:
        agent = create_react_agent(
            model=llm_qwen,
            tools=file_tools,
            checkpointer=memory,
            debug=True,
        )

        config = RunnableConfig(configurable={"thread_id": 1})

        res = agent.invoke(input={"messages": [("user", "你好, 我是sam")]}, config=config)
        print("=" * 60)
        print(res)
        print("=" * 60)

        # res2 = agent.invoke(input={"messages": [("user", "你好, 我是谁?")]}, config=config)
        # print("=" * 60)
        # print(res2)
        # print("=" * 60)


if __name__ == "__main__":
    create_agent()
文件保存方式:
- get_tuple:根据持久化数据恢复记忆
- put:将全量数据写入文件
- put_writes:写入增量数据(可以不实现)
python
import base64
import json
import os
import pickle
from pathlib import Path
from typing import Any, Sequence

from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.base import BaseCheckpointSaver, Checkpoint, CheckpointTuple, CheckpointMetadata, \
ChannelVersions
from langgraph.prebuilt import create_react_agent

from app.code_agent.model.qwen import llm_qwen
from app.code_agent.tools.file_tools import file_tools


class FileSaver(BaseCheckpointSaver[str]):
    def __init__(self, base_path: str = "D:/workspace/python/learning/ai-agent-test/.temp/checkpoint"):
        super().__init__()
        self.base_path = base_path

        # exist_ok 存在目录创建不报错
        os.makedirs(self.base_path, exist_ok=True)

    def _get_checkpoint_path(self, thread_id, checkpoint_id):
        dir_path = os.path.join(self.base_path, thread_id)
        os.makedirs(dir_path, exist_ok=True)
        file_path = os.path.join(dir_path, checkpoint_id + ".json")
        return file_path

    def _serialize_checkpoint(self, data) -> str:
        import pickle, base64
        # 把python对象序列化成二进制字节
        pickled = pickle.dumps(data)
        # 加密
        return base64.b64encode(pickled).decode("utf-8")

    def _deserialize_data(self, data):
        decoded = base64.b64decode(data)
        return pickle.loads(decoded)

    # def get(self, config: RunnableConfig) -> Checkpoint | None:
    #     """Fetch a checkpoint using the given configuration.
    #
    #     Args:
    #         config: Configuration specifying which checkpoint to retrieve.
    #
    #     Returns:
    #         Optional[Checkpoint]: The requested checkpoint, or None if not found.
    #     """
    #     # print("get")

    def get_tuple(self, config: RunnableConfig) -> CheckpointTuple | None:
        """Fetch a checkpoint tuple using the given configuration.

        Args:
            config: Configuration specifying which checkpoint to retrieve.

        Returns:
            Optional[CheckpointTuple]: The requested checkpoint tuple, or None if not found.

        Raises:
            NotImplementedError: Implement this method in your custom checkpoint saver.
        """
        # print("get_tuple")
        # 1.找到正确的checkpoint文件路径
        thread_id = config["configurable"]["thread_id"]

        # 2.读取checkpoint文件内容
        dir_path = os.path.join(self.base_path, thread_id)
        # 获取dir_path目录下的.json后缀的所有文件
        checkpoint_files = list(Path(dir_path).glob("*.json"))
        checkpoint_files.sort(key=lambda x: x.stem, reverse=True)
        if len(checkpoint_files) > 0:
            lastest_checkpoint = checkpoint_files[0]
            checkpoint_id = lastest_checkpoint.stem
            checkpoint_file_path = self._get_checkpoint_path(thread_id, checkpoint_id)

            # 3.对文件内容进行反序列化
            with open(checkpoint_file_path, "r", encoding="utf-8") as checkpoint_file:
                data = json.load(checkpoint_file)

            checkpoint = self._deserialize_data(data["checkpoint"])
            metadata = self._deserialize_data(data["metadata"])

            # 4.返回checkpoint对象
            return CheckpointTuple(
                config={
                    "configurable": {
                        "thread_id": thread_id,
                        "checkpoint_id": checkpoint_id,
                    }
                },
                checkpoint=checkpoint,
                metadata=metadata,
            )
        else:
            return None


    def put(
        self,
        config: RunnableConfig,
        checkpoint: Checkpoint,
        metadata: CheckpointMetadata,
        new_versions: ChannelVersions,
    ) -> RunnableConfig:
        """Store a checkpoint with its configuration and metadata.

        Args:
            config: Configuration for the checkpoint.
            checkpoint: The checkpoint to store.
            metadata: Additional metadata for the checkpoint.
            new_versions: New channel versions as of this write.

        Returns:
            RunnableConfig: Updated configuration after storing the checkpoint.

        Raises:
            NotImplementedError: Implement this method in your custom checkpoint saver.
        """
        # print("put")
        # 1.生成存储json文件路径
        thread_id = config["configurable"]["thread_id"]
        checkpoint_id = checkpoint["id"]

        checkpoint_path = self._get_checkpoint_path(thread_id, checkpoint_id)

        # 2.将Checkpoint序列化
        checkpoint_data = {
            "checkpoint": self._serialize_checkpoint(checkpoint),
            "metadata": self._serialize_checkpoint(metadata),
        }

        # 3.将Checkpoint 存储到文件系统
        with open(checkpoint_path, "w", encoding="utf-8") as f:
            # dump是写入文件, indent是缩进, ensure_ascii=False中文样式输出
            json.dump(checkpoint_data, f, indent=2, ensure_ascii=False)

        # 4.生成返回值
        return {
            "configurable": {
                "thread_id": thread_id,
                "checkpoint_id": checkpoint_id,
            }
        }

    def put_writes(
        self,
        config: RunnableConfig,
        writes: Sequence[tuple[str, Any]],
        task_id: str,
        task_path: str = "",
    ) -> None:
        """Store intermediate writes linked to a checkpoint.

        Args:
            config: Configuration of the related checkpoint.
            writes: List of writes to store.
            task_id: Identifier for the task creating the writes.
            task_path: Path of the task creating the writes.

        Raises:
            NotImplementedError: Implement this method in your custom checkpoint saver.
        """
        # print("put_writes")

if __name__ == "__main__":
    memory = FileSaver(base_path="D:/workspace/python/learning/ai-agent-test/.temp/checkpoint")

    agent = create_react_agent(
        model=llm_qwen,
        tools=file_tools,
        checkpointer=memory,
        debug=False,
    )

    config = RunnableConfig(configurable={"thread_id": 1})

    while True:
        user_input = input("用户:")

        if user_input.lower() == "exit":
            break

        resp = agent.invoke(input={"messages": user_input}, config=config)
        print("助理:", resp['messages'][-1].content)
print()| 持久化方案 | 核心特点 | 适用场景 | 不适合场景 |
|---|---|---|---|
| MemorySaver | 内存存储,进程重启丢失,零依赖 | 本地快速调试、单元测试 | 生产环境、需要保存历史对话 |
| FileSaver | 文件落盘,无需额外服务,并发差 | 单机单人脚本、本地长期调试 | 多并发、多实例、线上服务 |
| SqliteSaver | 单文件数据库,自带事务,无需单独服务 | 本地开发调试(推荐) | 多进程并发、分布式生产 |
| RedisSaver | 读写快,支持 TTL,多实例共享会话 | 线上 Web 接口、高并发、会话短期有效 | 长期归档、复杂会话审计查询 |
| MongoDBSaver | 文档模型,消息数组友好 | 已有 Mongo 栈,需要检索对话历史 | 强事务、多租户严格隔离场景 |
| PostgresSaver (官方) | 完整 ACID 事务,JSONB,查询强,TimeTravel(时间回溯) 全支持 | 企业生产、多租户、审计、断点回溯 | 简单小 demo、追求极致低延迟 |
五、AI Agent终端控制能力
5.1、执行shell脚本
- 封装mcpServer
python
import subprocess
from typing import Annotated

from mcp.server import FastMCP
from pydantic import Field

mcp = FastMCP()

@mcp.tool(name="run_shell", description="Run a shell command")
def run_shell_command(command: Annotated[str, Field(description="shell command will be executed", json_schema_extra={"example": "dir /a"})]) -> str:
    try:
        if command.strip().startswith("rm"):
            raise Exception("不允许使用rm")

        # command: 可以是字符串 可以是数组, 如果是数组则shell比如为False
        # shell: 控制是否可以有多条命令, 比如管道符
        # capture_output: 捕获返回结构 否则直接打印
        # text: 输出是字符串
        res = subprocess.run(command, shell=True, capture_output=True, text=True)

        if res.returncode != 0:
            return res.stderr

        return res.stdout
    except Exception as e:
        return str(e)

def run_shell_command_by_popen(commands):
    p = subprocess.Popen(commands, stdout=subprocess.PIPE, stderr=subprocess.PIPE, shell=True, text=True)
    stdout, stderr = p.communicate()
    if stdout:
        return stdout
    return stderr

if __name__ == "__main__":
    # ret = run_shell_command("ls -al | grep terminal")
    # ret = run_shell_command("dir /a findstr shell_tools.py")
    # ret = run_shell_command_by_popen("dir /a findstr shell_tools.py")
    # print(ret)
mcp.run(transport="stdio")- 提供mcpClient
python
from app.code_agent.utils.mcp import create_mcp_stdio_client


async def get_stdio_shell_tools():
    params = {
        "command": "python",
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/shell_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("shell_tools", params)
return client, tools- Agent调用,并优化输出
python
import asyncio
import time

from langchain_core.messages import AIMessage, ToolMessage
from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.memory import MemorySaver
from langgraph.prebuilt import create_react_agent

from app.code_agent.model.qwen import llm_qwen
from app.code_agent.tools.file_tools import file_tools
from app.code_agent.tools.file_saver import FileSaver
from app.code_agent.tools.powershell_tools import get_stdio_shell_tools


def format_debug_output(step_name: str, content: str, is_tool_call = False) -> None:
    if is_tool_call:
        print(f"🔄 [工具调用] [{step_name}] ")
        print("-" * 40)
        print(content.strip())
        print("-" * 40)
    else:
        print(f"💭 [{step_name}] ")
        print("-" * 40)
        print(content.strip())
        print("-" * 40)

async def run_agent():
    memory = MemorySaver()
    # memory = FileSaver(base_path="D:/workspace/python/learning/ai-agent-test/.temp/checkpoint")

    mcp_client, shell_tools = await get_stdio_shell_tools()
    tools = file_tools + shell_tools

    agent = create_react_agent(
        model=llm_qwen,
        tools=tools,
        checkpointer=memory,
        debug=False,
    )

    config = RunnableConfig(configurable={"thread_id": 10})

    while True:
        user_input = input("用户:")

        if user_input.lower() == "exit":
            break

        print("\n🤖 助手正在思考和处理...")
        print("=" *60)

        iteration_count = 0

        start_time = time.time()
        last_tool_time = start_time

        async for chunk in agent.astream(input={"messages": user_input}, config=config):
            iteration_count += 1

            items = chunk.items()

            print(f"\n📊 第 {iteration_count} 步执行:")
            print("-" * 30)
            # print(chunk)

            for node_name, node_output in items:
                if "messages" in node_output:
                    for msg in node_output["messages"]:
                        if isinstance(msg, AIMessage):
                            if msg.content:
                                format_debug_output("AI思考", msg.content)
                            else:
                                for tool in msg.tool_calls:
                                    format_debug_output("工具调用", f"{tool['name']}: {tool['args']}")

                        elif isinstance(msg, ToolMessage):
                            tool_name = getattr(msg, "name", "unknown")
                            tool_content = msg.content

                            current_time = time.time()
                            tool_duration = current_time - last_tool_time
                            last_tool_time = current_time
                            tool_result = f"""🔧 工具: {tool_name}
📤 结果:
{tool_content}
✅ 状态: 执行完成, 可以开始下一个任务
⏱️ 执行时间 {tool_duration:.2f}秒"""
                            format_debug_output("工具执行结果", tool_result, is_tool_call=True)

                        else:
                            format_debug_output("未实现", f"暂未实现的打印内容:{chunk}")

        print()

asyncio.run(run_agent())
5.2、操作Mac终端
- 封装mcpServer
python
import subprocess
import time
from typing import Annotated, List

from mcp.server.fastmcp import FastMCP
from pydantic import Field

mcp = FastMCP()


def run_applescript(script):
    p = subprocess.Popen(["osascript", "-e", script],
                         stdout=subprocess.PIPE,
                         stderr=subprocess.PIPE)
    output, error = p.communicate()

    return output.decode("utf-8").strip(), error.decode("utf-8").strip()


def get_all_terminal_window_ids() -> str:
    """获取所有终端窗口的ID列表"""
    output, error = run_applescript("""
tell application "Terminal"
    set outputList to {}
    repeat with aWindow in windows
        set windowID to id of aWindow
        set tabCount to number of tabs of aWindow
        repeat with tabIndex from 1 to tabCount
            set end of outputList to {tab tabIndex of window id windowID}
        end repeat
    end repeat
end tell
return outputList
""")
    if error:
        return f"错误: {error}"
    return output


def parse_key_code(button):
    button = button.lower()

    keycode_map = {
        'return': 'return',
        'space': 'space',
        'up': 126,
        'down': 125,
        'left': 123,
        'right': 124,
        'a': 0,
        'b': 11,
        'c': 8,
        'd': 2,
        'e': 14,
        'f': 3,
        'g': 5,
        'h': 4,
        'i': 34,
        'j': 38,
        'k': 40,
        'l': 37,
        'm': 46,
        'n': 45,
        'o': 31,
        'p': 35,
        'q': 12,
        'r': 15,
        's': 1,
        't': 17,
        'u': 32,
        'v': 9,
        'w': 13,
        'x': 7,
        'y': 16,
        'z': 6,
        '.': 47,
        'dot': 47,
        '0': 29,
        '1': 18,
        '2': 19,
        '3': 20,
        '4': 21,
        '5': 23,
        '6': 22,
        '7': 26,
        '8': 28,
        '9': 25,
        '-': 27,
    }

    return keycode_map[button]


def concat_key_codes(key_codes):
    script = ''
    for key in key_codes:
        key_code = parse_key_code(key)
        script += f'keystroke {key_code}\n'
        script += 'delay 0.5\n'
    return script.strip()


@mcp.tool(name="send_terminal_keyboard_key", description="send a terminal keyboard key to an existing terminal")
def send_terminal_keyboard_key(
        key_codes: Annotated[List[str], Field(description="向终端输入一组按键", examples="['up', 'down']")]) -> bool:
    print('\nsend_terminal_keyboard_key keycode:', key_codes)
    print('-' * 50)
    script = f'''
tell application "Terminal"
    activate
    tell application "System Events"
        {concat_key_codes(key_codes)}
    end tell
end tell'''
    print(script)
    terminal_content, error = run_applescript(script)
    if error:
        return False
    else:
        return True


@mcp.tool(name="close_terminal", description="关闭终端应用程序")
def close_terminal_if_open() -> str:
    """关闭终端应用程序(如果正在运行)"""
    output, error = run_applescript("""
tell application "System Events"
    if exists process "Terminal" then
        tell application "Terminal" to quit
    end if
end tell
""")
    if error:
        return f"关闭终端失败: {error}"
    else:
        return "终端已成功关闭"


@mcp.tool(name="open_terminal", description="打开新的终端窗口")
def open_new_terminal(window_id:
Annotated[str, Field(description="可选的窗口ID,为空则打开新窗口", examples="12345")] = "") -> str:
    """打开新的终端窗口或激活指定的窗口"""
    if window_id:
        output, error = run_applescript(f"""
tell application "Terminal"
    if (count of windows) > 0 then
        set theWindow to window id {window_id}
        set frontmost of theWindow to true
        activate
    else
        activate
    end if
end tell""")

    else:
        output, error = run_applescript(f"""
tell application "Terminal"
    activate
end tell""")

    if error:
        return f"打开终端失败: {error}"
    else:
        time.sleep(2)  # 减少等待时间
        window_ids = get_all_terminal_window_ids()
        return f"终端已打开,窗口ID: {window_ids}"


@mcp.tool(name="run_terminal_script", description="在终端中运行脚本命令")
def run_script_in_terminal(script:
Annotated[str, Field(description="要在终端中执行的脚本命令", examples="ls -al")]) -> str:
    """在终端中运行指定的脚本命令"""
    print("-" * 50)
    print("run_script_in_terminal:")
    print(script)
    print("-" * 50)
    output, error = run_applescript(f"""
tell application "Terminal"
    activate
    if (count of windows) > 0 then
        do script "{script}" in window 1
    else
        do script "{script}"
    end if
end tell""")
    if error:
        return f"执行脚本失败: {error}"
    else:
        return f"脚本已执行: {script}"


@mcp.tool(name="get_terminal_text", description="获取终端的完整文本内容")
def get_terminal_full_text() -> str:
    """获取当前选中终端标签页的完整历史文本"""
    output, error = run_applescript(f"""
tell application "Terminal"
    set fullText to history of selected tab of front window
end tell""")
    if error:
        return f"获取终端文本失败: {error}"
    else:
        return output


if __name__ == '__main__':
    mcp.run(transport="stdio")
    # close_terminal_if_open()
    # window_ids = open_new_terminal()
    # print(window_ids)

    # run_script_in_terminal("pwd")
    # full_text = get_terminal_full_text()
# print(full_text)- 提供mcpClient
python
from app.code_agent.utils.mcp import create_mcp_stdio_client


async def get_stdio_terminal_tools():
    params = {
        "command": "python",
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/terminal_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("terminal_tools", params)

    return tools
5.3、操作Powershell终端
- 封装mcpServer
python
import base64
import os
import subprocess
import sys
import time
from typing import Annotated

import psutil
import pyautogui
from mcp.server.fastmcp import FastMCP
from pydantic import Field

mcp = FastMCP()

# 打开终端时打在窗口标题上的标记:close_powershell 只关闭带这个标记的窗口,
# 不会误杀用户自己的 PowerShell / IDE 集成终端
TERMINAL_TITLE_MARKER = "ai-agent-terminal"

DEFAULT_TIMEOUT = 180
MAX_TIMEOUT = 600
# subprocess 超时的约定返回码,调用方据此区分"命令失败"和"命令超时"
TIMEOUT_RETURNCODE = 124
_CREATE_NO_WINDOW = 0x08000000


def _kill_process_tree(pid: int) -> None:
    """终止 pid 及其所有子孙进程。

    subprocess 超时只会结束直接子进程,powershell 下面还有 cmd / node 这类孙子进程,
    不清理就会变成孤儿一直挂着。
    """
    subprocess.run(
        ["taskkill", "/F", "/T", "/PID", str(pid)],
        capture_output=True,
        creationflags=_CREATE_NO_WINDOW,
    )


def run_powershell_command(command: str, capture_output: bool = True, timeout: int = DEFAULT_TIMEOUT):
    """执行 PowerShell 命令。

    返回 (stdout, stderr, returncode)。命令超时返回码为 TIMEOUT_RETURNCODE,
    此时 stderr 里是超时说明,且命令的整棵进程树已被终止。
    """
    try:
        process = subprocess.Popen(
            # 不用 shell=True:Windows 上会再套一层 cmd.exe,引号和分号会被 cmd 重新解析
            ["powershell", "-NoProfile", "-NonInteractive", "-Command", command],
            # 不能让子进程继承 MCP 的 stdin(那是 JSON-RPC 管道)
            stdin=subprocess.DEVNULL,
            stdout=subprocess.PIPE if capture_output else None,
            stderr=subprocess.PIPE if capture_output else None,
            text=True,
            creationflags=_CREATE_NO_WINDOW,
        )
    except Exception as e:
        return "", str(e), 1

    try:
        stdout, stderr = process.communicate(timeout=timeout)
        return (stdout or "").strip(), (stderr or "").strip(), process.returncode
    except subprocess.TimeoutExpired:
        _kill_process_tree(process.pid)
        try:
            process.communicate(timeout=5)
        except Exception:
            process.kill()
        return "", f"命令执行超过 {timeout} 秒仍未返回,已终止该命令的整棵进程树", TIMEOUT_RETURNCODE


def get_powershell_processes():
    """获取所有 PowerShell 进程"""
    processes = []
    for proc in psutil.process_iter(['pid', 'name', 'cmdline']):
        try:
            if proc.info['name'] and 'powershell' in proc.info['name'].lower():
                processes.append({
                    'pid': proc.info['pid'],
                    'name': proc.info['name'],
                    'cmdline': proc.info['cmdline']
                })
        except (psutil.NoSuchProcess, psutil.AccessDenied):
            pass
    return processes


def find_marked_windows():
    """按窗口标题找出本工具打开的终端窗口。

    不能走 Get-Process 的 MainWindowTitle/MainWindowHandle:控制台窗口的这两个字段
    在本机恒为空(窗口由 conhost/终端持有),只能枚举顶层窗口的标题。
    """
    try:
        return pyautogui.getWindowsWithTitle(TERMINAL_TITLE_MARKER)
    except Exception as e:
        print(f"枚举 PowerShell 窗口失败: {e}", file=sys.stderr)
        return []


def count_marked_windows() -> int:
    """统计本工具打开的 PowerShell 窗口数量"""
    return len(find_marked_windows())


def build_open_window_command(working_directory: str = "") -> str:
    """拼出用 WMI 创建终端窗口的 PowerShell 命令。

    不能直接 Popen 开窗:MCP server 被客户端放在 Job Object 里
    (KILL_ON_JOB_CLOSE,见 mcp/client/stdio),工具调用一结束整个 job 被 Terminate,
    刚打开的窗口会跟着被干掉。WMI 创建的进程父进程是 WmiPrvSE.exe,不在这个 job 里,
    窗口能活到下一次工具调用。

    标题用 -EncodedCommand 传,避免 Start-Process/命令行多层引号被吃掉。
    """
    title_script = f'$Host.UI.RawUI.WindowTitle = "{TERMINAL_TITLE_MARKER}"'
    encoded = base64.b64encode(title_script.encode("utf-16-le")).decode("ascii")
    child_command_line = f"powershell -NoExit -EncodedCommand {encoded}"

    arguments = f"@{{ CommandLine = '{child_command_line}'"
    if working_directory:
        arguments += f"; CurrentDirectory = '{working_directory}'"
    arguments += " }"

    return ("Invoke-CimMethod -ClassName Win32_Process -MethodName Create "
            f"-Arguments {arguments} | Select-Object -ExpandProperty ProcessId")


def activate_powershell_window():
    """激活 PowerShell 窗口"""
    try:
        # 设置 pyautogui 的安全设置
        pyautogui.FAILSAFE = True
        pyautogui.PAUSE = 0.1

        # 优先激活本工具打开的窗口
        windows = pyautogui.getWindowsWithTitle(TERMINAL_TITLE_MARKER)
        if not windows:
            windows = pyautogui.getWindowsWithTitle('Windows PowerShell')
        if not windows:
            windows = pyautogui.getWindowsWithTitle('PowerShell')

        if windows:
            # 激活第一个找到的 PowerShell 窗口
            window = windows[0]
            window.activate()
            time.sleep(0.5)  # 等待窗口激活
            return True
        else:
            # 如果没找到窗口,尝试通过快捷键
            pyautogui.hotkey('alt', 'tab')
            time.sleep(0.5)
            return False
    except Exception as e:
        print(f"激活 PowerShell 窗口失败: {e}", file=sys.stderr)
        return False


@mcp.tool(name="get_powershell_processes", description="获取所有 PowerShell 进程信息")
def get_all_powershell_processes() -> str:
    """获取所有正在运行的 PowerShell 进程列表"""
    try:
        processes = get_powershell_processes()
        if not processes:
            return "当前没有运行的 PowerShell 进程"

        result = "PowerShell 进程列表:\n"
        for proc in processes:
            result += f"PID: {proc['pid']}, 名称: {proc['name']}\n"
        return result
    except Exception as e:
        return f"获取 PowerShell 进程失败: {str(e)}"


@mcp.tool(name="close_powershell", description="关闭由 open_powershell 打开的 PowerShell 窗口(只关闭带 ai-agent-terminal 标记的窗口,不会影响其他 PowerShell 或 IDE 终端)")
def close_all_powershell() -> str:
    """只关闭本工具打开的 PowerShell 窗口"""
    try:
        windows = find_marked_windows()
        if not windows:
            return "没有找到由 open_powershell 打开的 PowerShell 窗口"

        for window in windows:
            try:
                window.close()  # 等价于点窗口右上角的关闭按钮
            except Exception as e:
                print(f"关闭窗口失败: {e}", file=sys.stderr)

        time.sleep(1)
        return f"已关闭 {len(windows)} 个 PowerShell 窗口(剩余 {count_marked_windows()} 个)"
    except Exception as e:
        return f"关闭 PowerShell 进程失败: {str(e)}"


@mcp.tool(name="open_powershell", description="打开一个新的 PowerShell 窗口,窗口标题带 ai-agent-terminal 标记(close_powershell 只关闭这类窗口)。需要交互输入的命令用这个窗口配合 run_powershell_script 执行")
def open_new_powershell(working_directory:
Annotated[str, Field(description="可选的工作目录,为空则使用当前目录", examples=["C:\\Users"])] = "") -> str:
    """打开新的 PowerShell 窗口"""
    try:
        cwd = ""
        missing_dir = ""
        if working_directory:
            if os.path.exists(working_directory):
                cwd = working_directory
            else:
                missing_dir = f"\n注意: 目录 {working_directory} 不存在,窗口打开在默认目录"

        stdout, stderr, returncode = run_powershell_command(build_open_window_command(cwd), timeout=30)
        if returncode == TIMEOUT_RETURNCODE:
            return f"打开 PowerShell 超时: {stderr}"
        if returncode != 0 or not stdout:
            return f"打开 PowerShell 失败: {stderr or 'WMI 没有返回进程号'}"

        time.sleep(2)  # 等待窗口打开
        return f"PowerShell 已打开,PID: {stdout.strip()},当前标记窗口数: {count_marked_windows()}{missing_dir}"
    except Exception as e:
        return f"打开 PowerShell 失败: {str(e)}"


@mcp.tool(name="run_powershell_script", description="通过 pyautogui 向 PowerShell 窗口发送命令(用于需要交互输入的命令,可以分多次发送来应答提示)")
def run_powershell_script(script:
Annotated[str, Field(description="要在 PowerShell 窗口中执行的脚本命令", examples=["Get-Location"])]) -> str:
    """通过 pyautogui 向活动的 PowerShell 窗口发送命令"""
    try:
        print("-" * 50, file=sys.stderr)
        print(f"run_powershell_script (pyautogui): {script}", file=sys.stderr)
        print("-" * 50, file=sys.stderr)

        # 检查是否有 PowerShell 进程在运行
        processes = get_powershell_processes()
        if not processes:
            return "没有找到运行中的 PowerShell 进程,请先打开 PowerShell 窗口"

        # 激活 PowerShell 窗口
        if not activate_powershell_window():
            return "无法激活 PowerShell 窗口,请确保 PowerShell 窗口已打开"

        # 清空当前输入行(如果有的话)
        pyautogui.hotkey('ctrl', 'c')  # 取消当前命令
        time.sleep(0.2)

        # 确保光标在命令行
        pyautogui.press('end')
        time.sleep(0.1)

        # 输入命令
        pyautogui.write(script, interval=0.02)
        time.sleep(0.3)

        # 按 Enter 执行命令
        pyautogui.press('enter')

        return f"命令已发送到 PowerShell 窗口: {script}"

    except Exception as e:
        return f"发送 PowerShell 命令失败: {str(e)}"


@mcp.tool(name="execute_powershell_command", description="直接执行 PowerShell 命令并返回结果(非交互、带超时:超时会终止整棵进程树并返回错误,不会卡死)。需要交互输入的命令请改用 open_powershell + run_powershell_script")
def execute_powershell_command(
    command: Annotated[str, Field(description="要执行的 PowerShell 命令", examples=["Get-Process"])],
    timeout_seconds: Annotated[int, Field(description=f"超时时间(秒),默认 {DEFAULT_TIMEOUT},最长 {MAX_TIMEOUT};安装依赖等耗时命令可调大", ge=1, le=MAX_TIMEOUT)] = DEFAULT_TIMEOUT,
) -> str:
    """直接执行 PowerShell 命令并返回结果(不通过 GUI)"""
    try:
        print("-" * 50, file=sys.stderr)
        print(f"execute_powershell_command: {command}", file=sys.stderr)
        print("-" * 50, file=sys.stderr)

        timeout = max(1, min(int(timeout_seconds), MAX_TIMEOUT))
        stdout, stderr, returncode = run_powershell_command(command, timeout=timeout)

        if returncode == TIMEOUT_RETURNCODE:
            return f"命令执行失败: {stderr}"

        if returncode != 0:
            if stderr:
                return f"命令执行失败: {stderr}"
            else:
                return "命令执行失败,但没有错误信息"

        if stdout:
            return f"命令执行成功:\n{stdout}"
        else:
            return "命令执行成功,但没有输出"

    except Exception as e:
        return f"执行 PowerShell 命令失败: {str(e)}"


if __name__ == '__main__':
mcp.run(transport="stdio")- 提供mcpClient
python
import sys

from app.code_agent.utils.mcp import create_mcp_stdio_client


async def get_stdio_powershell_tools():
    """返回 (MultiServerMCPClient, server_name),不建立连接。"""
    params = {
        # 用当前解释器,避免 "python" 解析到 PATH 上别的 Python
        "command": sys.executable,
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/powershell_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("powershell_tools", params)
    return tools
六、接入阿里百炼RAG知识库
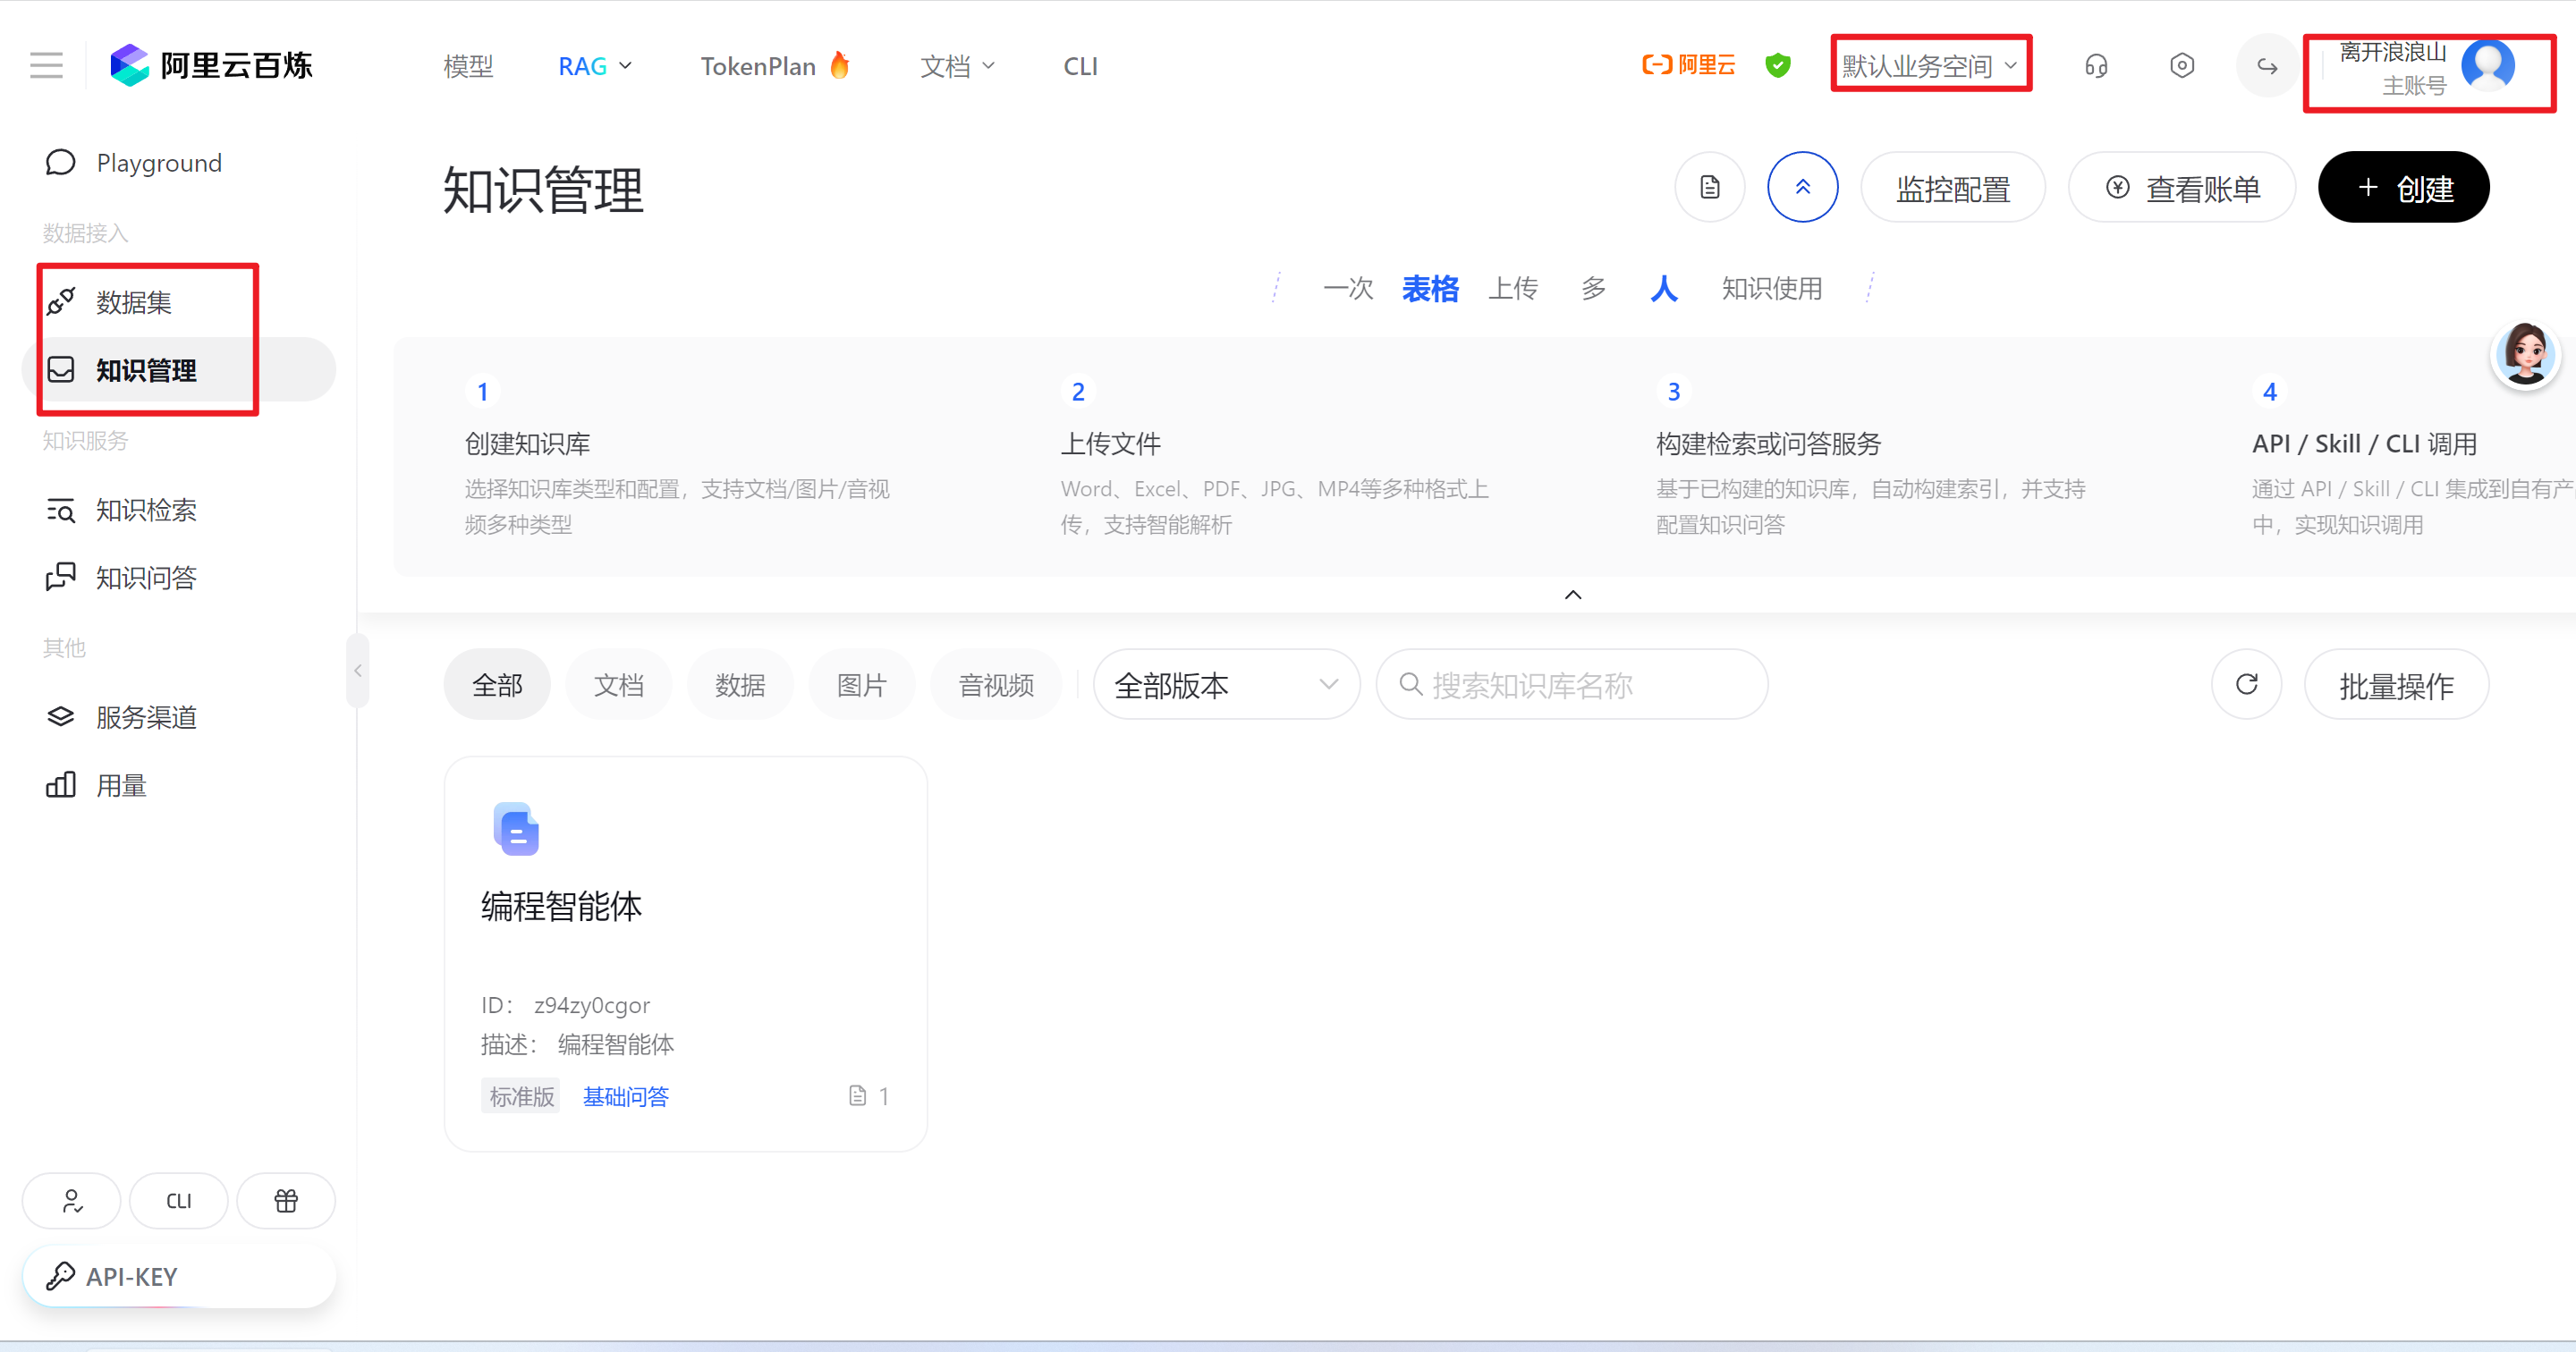
6.1、百炼知识库文档操作
https://bailian.console.aliyun.com/cn-beijing/rag/knowledge/list
先创建数据集,然后在创建知识管理
6.2、查询知识库内容-MCP封装
python
import os
import sys
import winreg
from typing import Annotated

import alibabacloud_bailian20231229.client as bailian_20231229_client
from alibabacloud_tea_openapi import models as open_ai_models
from alibabacloud_bailian20231229 import models as bailian_20231229_models
from alibabacloud_tea_util import models as util_models
from mcp.server import FastMCP
from pydantic import Field

mcp = FastMCP()

# ALIBABA_CLOUD_ACCESS_KEY_ID = os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID')
# ALIBABA_CLOUD_ACCESS_KEY_SECRET = os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET')

def create_client() -> bailian_20231229_client.Client:
    config = open_ai_models.Config(
        # 注意 如果提供MCP服务则必须通过.env文件的方式取值
        # 因为MCP服务会开启一个子进程 读不到系统变量
        access_key_id=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID'),
        access_key_secret=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    )
    config.endpoint = "bailian.cn-beijing.aliyuncs.com"
    return bailian_20231229_client.Client(config)

def retrieve_index(client, worksapce_id, index_id, query):
    retrieve_request = bailian_20231229_models.RetrieveRequest(
        index_id=index_id,
        query=query,
    )
    runtime = util_models.RuntimeOptions()
    return client.retrieve_with_options(
        worksapce_id,
        retrieve_request,
        {},
        runtime
    )

@mcp.tool(name="query_rag", description="从百炼平台查询知识库信息")
def query_rag_from_bailian(query: Annotated[str, Field(description="访问知识库查询的内容", examples=["终端的操作规范"])]) -> str:
    bailian_client = create_client()
    workspace_id = "ws-fn4m0055u9nw1a0v"
    index_id = "z94zy0cgor"
    rag = retrieve_index(bailian_client, workspace_id, index_id, query)

    result = ""

    for data in rag.body.data.nodes:
        result += f"""{data.text}
---"""

    # 只能写 stderr:stdout 是 MCP 的 JSON-RPC 通道
    print("-"*60, file=sys.stderr)
    print(f"[query_rag_from_bailian] {query}", file=sys.stderr)
    print(result, file=sys.stderr)
    print("-" * 60, file=sys.stderr)
    return result

if __name__ == "__main__":
    # bailian_client = create_client()
    # # 业务空间id
    # worksapce_id = "ws-fn4m0055u9nw1a0v"
    # # 知识库id
    # index_id = "z94zy0cgor"
    # query = "使用终端工具执行shell命令的步骤"
    # rag = retrieve_index(bailian_client, worksapce_id, index_id, query)
    #
    # # 调试:打印完整响应
    # print(f"status_code: {rag.status_code}")
    # print(f"body: {rag.body}")
    # print(f"body.data: {rag.body.data}")
    # print(f"body.code: {rag.body.code}")
    # print(f"body.message: {rag.body.message}")
    #
    # if rag.body.data and rag.body.data.nodes:
    #     for i, node in enumerate(rag.body.data.nodes):
    #         print(f"\n--- Node {i} ---")
    #         print(f"score: {node.score}")
    #         print(f"text: {node.text[:200] if node.text else 'None'}")
    # else:
    #     print("\n没有检索到结果!")
    #     print(f"完整body dict: {rag.body.to_map()}")


    # query_rag_from_bailian("使用终端工具执行 shell 命令")
    mcp.run(transport="stdio")
6.3、操作百炼知识库-MCP封装
包括上传文件到知识库指定目录下、查询文件上传状态、创建知识库、查询知识库、追加文件到百炼知识库
6.3.1、基础API调用
python
import os
import sys
import winreg
from typing import Annotated
import hashlib

import alibabacloud_bailian20231229.client as bailian_20231229_client
import requests
from alibabacloud_tea_openapi import models as open_ai_models
from alibabacloud_bailian20231229 import models as bailian_20231229_models
from alibabacloud_tea_util import models as util_models
from mcp.server import FastMCP
from pydantic import Field

mcp = FastMCP()

# ALIBABA_CLOUD_ACCESS_KEY_ID = os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID')
# ALIBABA_CLOUD_ACCESS_KEY_SECRET = os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET')

def create_client() -> bailian_20231229_client.Client:
    config = open_ai_models.Config(
        # 注意 如果提供MCP服务则必须通过.env文件的方式取值
        # 因为MCP服务会开启一个子进程 读不到系统变量
        access_key_id=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID'),
        access_key_secret=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    )
    config.endpoint = "bailian.cn-beijing.aliyuncs.com"
    return bailian_20231229_client.Client(config)

def retrieve_index(client, worksapce_id, index_id, query):
    retrieve_request = bailian_20231229_models.RetrieveRequest(
        index_id=index_id,
        query=query,
    )
    runtime = util_models.RuntimeOptions()
    return client.retrieve_with_options(
        worksapce_id,
        retrieve_request,
        {},
        runtime
    )

@mcp.tool(name="query_rag", description="从百炼平台查询知识库信息")
def query_rag_from_bailian(query: Annotated[str, Field(description="访问知识库查询的内容", examples=["终端的操作规范"])]) -> str:
    bailian_client = create_client()
    workspace_id = "ws-fn4m0055u9nw1a0v"
    index_id = "z94zy0cgor"
    rag = retrieve_index(bailian_client, workspace_id, index_id, query)

    result = ""

    for data in rag.body.data.nodes:
        result += f"""{data.text}
---"""

    # 只能写 stderr:stdout 是 MCP 的 JSON-RPC 通道
    print("-"*60, file=sys.stderr)
    print(f"[query_rag_from_bailian] {query}", file=sys.stderr)
    print(result, file=sys.stderr)
    print("-" * 60, file=sys.stderr)
    return result


def apply_lease(client, category_id, file_name, file_md5, file_size, workspace_id):
    headers = {}
    runtime = util_models.RuntimeOptions()
    request = bailian_20231229_models.ApplyFileUploadLeaseRequest(
        file_name=file_name,
        md_5=file_md5,
        size_in_bytes=file_size,
    )
    return client.apply_file_upload_lease_with_options(
        category_id,
        workspace_id,
        request,
        headers,
        runtime
    )

def calculate_md5(file_path: str) -> str:
    """
    计算文件的 MD5 哈希值。

    参数:
        file_path (str): 文件路径。

    返回:
        str: 文件的 MD5 哈希值。
    """
    hash_md5 = hashlib.md5()
    with open(file_path, "rb") as f:
        for chunk in iter(lambda: f.read(4096), b""):
            hash_md5.update(chunk)
    return hash_md5.hexdigest()

def get_file_info(file_path):
    file_name = os.path.basename(file_path)
    file_size = os.path.getsize(file_path)
    file_md5 = calculate_md5(file_path)

    return file_name, file_md5, file_size

def apply_lease_by_file_path(client, category_id, workspace_id, file_path):

    file_name, file_md5, file_size = get_file_info(file_path)
    # print("=======")
    # print(file_size)
    # print("=======")
    return apply_lease(client, category_id, file_name, file_md5, file_size, workspace_id)

def upload_file_to_bailian(upload_url, headers, file_path):
    with open(file_path, "rb") as f:
        file_content = f.read()

    upload_headers = {
        "Content-Type": headers["Content-Type"],
        "X-bailian-extra": headers["X-bailian-extra"],
    }

    response = requests.put(upload_url, data=file_content, headers=upload_headers)
    # print(response.status_code)
    response.raise_for_status()

def add_file_to_bailian_category(client, lease_id, parser, category_id, workspace_id):
    headers = {}
    runtime = util_models.RuntimeOptions()

    request = bailian_20231229_models.AddFileRequest(
        lease_id=lease_id,
        parser=parser,
        category_id=category_id,
    )

    return client.add_file_with_options(workspace_id, request, headers, runtime)

# 查看文件上传状态
def describe_file(client, workspace_id, file_id):
    headers = {}
    runtime = util_models.RuntimeOptions()

    return client.describe_file_with_options(workspace_id, file_id, headers, runtime)

# 创建知识库
def create_index(client, workspace_id, name, file_id, structure_type="unstructured", source_type="DATA_CENTER_FILE", sink_type="BUILT_IN"):
    headers = {}
    runtime = util_models.RuntimeOptions()
    request = bailian_20231229_models.CreateIndexRequest(
        structure_type=structure_type,
        source_type=source_type,
        sink_type=sink_type,
        name=name,
        document_ids=[file_id],
    )

    return client.create_index_with_options(workspace_id, request, headers, runtime)

# 创建完知识库后需要提交向量化任务
def submit_index(client, workspace_id, index_id):
    headers = {}
    runtime = util_models.RuntimeOptions()
    submit_index_job_request = bailian_20231229_models.SubmitIndexJobRequest(index_id=index_id)

    return client.submit_index_job_with_options(workspace_id, submit_index_job_request, headers, runtime)

# 查看向量化任务状态
def get_index_job_status(client, workspace_id, index_id, job_id):
    headers = {}
    runtime = util_models.RuntimeOptions()

    get_index_job_status_request = bailian_20231229_models.GetIndexJobStatusRequest(
        index_id=index_id,
        job_id=job_id,
    )

    return client.get_index_job_status_with_options(workspace_id, get_index_job_status_request, headers, runtime)

# 查看知识库
def list_indices(client, workspace_id):
    headers = {}
    runtime = util_models.RuntimeOptions()
    list_indices_request = bailian_20231229_models.ListIndicesRequest()
    return client.list_indices_with_options(workspace_id, list_indices_request, headers, runtime)

# 知识库 增加文档向量化任务
def submit_index_add_documents_job(client, workspace_id, index_id, file_id, source_type="DATA_CENTER_FILE"):
    headers = {}
    runtime = util_models.RuntimeOptions()
    submit_index_add_documents_job_request = bailian_20231229_models.SubmitIndexAddDocumentsJobRequest(
        index_id=index_id,
        document_ids=[file_id],
        source_type=source_type,
    )
    return client.submit_index_add_documents_job_with_options(workspace_id, submit_index_add_documents_job_request, headers, runtime)

# 添加文件到知识库
def add_document_to_index(client, workspace_id, index_id, file_id):
    job_response = submit_index_add_documents_job(client, workspace_id, index_id, file_id)
    job_id = job_response.body.data.id

    job_status = get_index_job_status(client, workspace_id, index_id, job_id)
    return job_status.body.data

def upload_rag_file_to_bailian(client, workspace_id, category_id, file_path):
    """
    上传文件到百炼数据中心, 并添加到指定分类

    参数:
        client: 百炼客户端
        workspace_id: 业务空间ID
        category_id: 分类ID
        file_path: 文件路径

    返回:
        文件ID
    """

    print("=" * 100)
    # 1.申请文件租约
    lease = apply_lease_by_file_path(client, category_id, workspace_id, file_path)
    headers = lease.body.data.param.headers
    lease_id = lease.body.data.file_upload_lease_id
    upload_url = lease.body.data.param.url
    print("-" * 60)
    print("文件租约申请成功")
    print("headers:", headers)
    print("lease_id:", lease_id)
    print("upload_url:", upload_url)
    print()

    # 2. 上传文件至百炼数据中心
    upload_file_to_bailian(upload_url, headers, file_path)

    # 3.将文件添加到指定分类
    add_file_response = add_file_to_bailian_category(client, lease_id, "DASHSCOPE_DOCMIND", category_id, workspace_id)
    file_id = add_file_response.body.data.file_id
    print("-" * 60)
    print("添加分类成功")
    print("file_id:", file_id)
    print("-" * 60)
    print()

    # 4. 获取文件上传状态
    describe_file_response_body = describe_file(client, workspace_id, file_id)
    print("-" * 60)
    print("查看文件上传状态")
    print("boyd", describe_file_response_body)
    print("-" * 60)
    print("=" * 100)

    return file_id

if __name__ == "__main__":
    # mcp.run(transport="stdio")
    # bailian_client = create_client()
    # # 业务空间id
    worksapce_id = "ws-fn4m0055u9nw1a0v"
    category_id = "cate_d5a79862c0ed4f71bf2a7671ff5c5549_15356061"
    # # 知识库id
    # index_id = "z94zy0cgor"
    # query = "使用终端工具执行shell命令的步骤"
    # rag = retrieve_index(bailian_client, worksapce_id, index_id, query)
    #
    # # 调试:打印完整响应
    # print(f"status_code: {rag.status_code}")
    # print(f"body: {rag.body}")
    # print(f"body.data: {rag.body.data}")
    # print(f"body.code: {rag.body.code}")
    # print(f"body.message: {rag.body.message}")
    #
    # if rag.body.data and rag.body.data.nodes:
    #     for i, node in enumerate(rag.body.data.nodes):
    #         print(f"\n--- Node {i} ---")
    #         print(f"score: {node.score}")
    #         print(f"text: {node.text[:200] if node.text else 'None'}")
    # else:
    #     print("\n没有检索到结果!")
    #     print(f"完整body dict: {rag.body.to_map()}")


    # query_rag_from_bailian("使用终端工具执行 shell 命令")
    bailian_client = create_client()
    rag_file_path = "D:/workspace/python/learning/ai-agent-test/app/code_agent/rag/rag_test.txt"
    # upload_rag_file_to_bailian(bailian_client, worksapce_id, category_id, rag_file_path)
    # response = create_index(bailian_client, worksapce_id, "智能体控制知识库", "file_ebc3acd2f208434b8c8be03af8986748_15356061")
    # print(response)

    # 知识库id
    rag_index_id = "y5kt0kdmxj"
    # response = submit_index(bailian_client, worksapce_id, rag_index_id)
    # print(response)

    rag_job_id = "7943b2612a09496b9c22d9cb80f8883b"
    # job_status = get_index_job_status(bailian_client, worksapce_id, rag_index_id, rag_job_id)
    # print(job_status)

    # print(list_indices(bailian_client, worksapce_id))

    rag_file_id = "file_e83aa1db51ac46778f3b347e29c51e6c_15356061"
    # response = submit_index_add_documents_job(bailian_client, worksapce_id, rag_index_id, rag_file_id)
    # print(response)
6.3.2、MCP封装
python
import sys
from pathlib import Path

# 本文件被 MCP 客户端当脚本启动时,sys.path 里只有本文件所在目录(app/code_agent/rag),
# 而且子进程只继承白名单环境变量、拿不到 PYTHONPATH,所以 import app.* 会失败。
# 这里按文件位置往上三层(rag → code_agent → app → 仓库根)把仓库根加进搜索路径。
sys.path.insert(0, str(Path(__file__).resolve().parents[3]))

from typing import Annotated

from mcp.server import FastMCP
from pydantic import Field

from app.code_agent.rag.rag import create_client, retrieve_index, upload_rag_file_to_bailian, add_document_to_index, \
get_index_job_status

mcp = FastMCP()

@mcp.tool(name="query_rag", description="从百炼平台查询知识库信息")
def query_rag_from_bailian(query: Annotated[str, Field(description="访问知识库查询的内容", examples=["终端的操作规范"])]) -> str:
    bailian_client = create_client()
    workspace_id = "ws-fn4m0055u9nw1a0v"
    index_id = "z94zy0cgor"
    rag = retrieve_index(bailian_client, workspace_id, index_id, query)

    result = ""

    for data in rag.body.data.nodes:
        result += f"""{data.text}
---"""

    return result


@mcp.tool(name="upload_local_file_to_bailian_rag", description="将本地的知识文件上传到百炼平台")
def upload_rag_to_bailian(file_path: Annotated[str,
    Field(description="本地知识文件的路径, 需要传入绝对路径",
          examples=["D:/workspace/python/learning/ai-agent-test/.temp/a.html"])]):

    balilian_client = create_client()
    workspace_id = "ws-fn4m0055u9nw1a0v"
    category_id = "cate_d5a79862c0ed4f71bf2a7671ff5c5549_15356061"
    index_id = "y5kt0kdmxj"

    file_id = upload_rag_file_to_bailian(balilian_client, workspace_id, category_id, file_path)

    response = add_document_to_index(balilian_client, workspace_id, index_id, file_id)
    return response


@mcp.tool(name="query_bailian_rag_job_status", description="查询上传到百炼知识库中知识文件的处理状态")
def query_bailian_rag_job_status(job_id: str):
    bailian_client = create_client()
    workspace_id = "ws-fn4m0055u9nw1a0v"
    index_id = "y5kt0kdmxj"

    job_status = get_index_job_status(bailian_client, workspace_id, index_id, job_id)
    return job_status.body.data

if __name__ == '__main__':
    mcp.run(transport="stdio")
    # reg_file_path = "D:/workspace/python/learning/ai-agent-test/app/code_agent/rag/ternimal.txt"
    # response = upload_rag_to_bailian(reg_file_path)
    # print(response)

    # rag_job_id = "a11fe3fc2c7144b2bcb3b628697c3b21"
    # print(query_bailian_rag_job_status(rag_job_id))
python
import os
import sys

from dotenv import load_dotenv

from app.code_agent.utils.mcp import create_mcp_stdio_client
load_dotenv()

async def get_stdio_rag_self_tools():
    params = {
        # 用当前解释器,避免 "python" 解析到 PATH 上别的 Python
        "command": sys.executable,
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/rag/self_rag.py"
        ],
        # 子进程默认只继承 MCP SDK 白名单内的环境变量,凭证必须显式传递
        "env": {
            "ALIBABA_CLOUD_ACCESS_KEY_ID": os.environ.get("ALIBABA_CLOUD_ACCESS_KEY_ID", ""),
            "ALIBABA_CLOUD_ACCESS_KEY_SECRET": os.environ.get("ALIBABA_CLOUD_ACCESS_KEY_SECRET", ""),
        },
    }

    client, tools = await create_mcp_stdio_client("self_rag_tools", params)
    return tools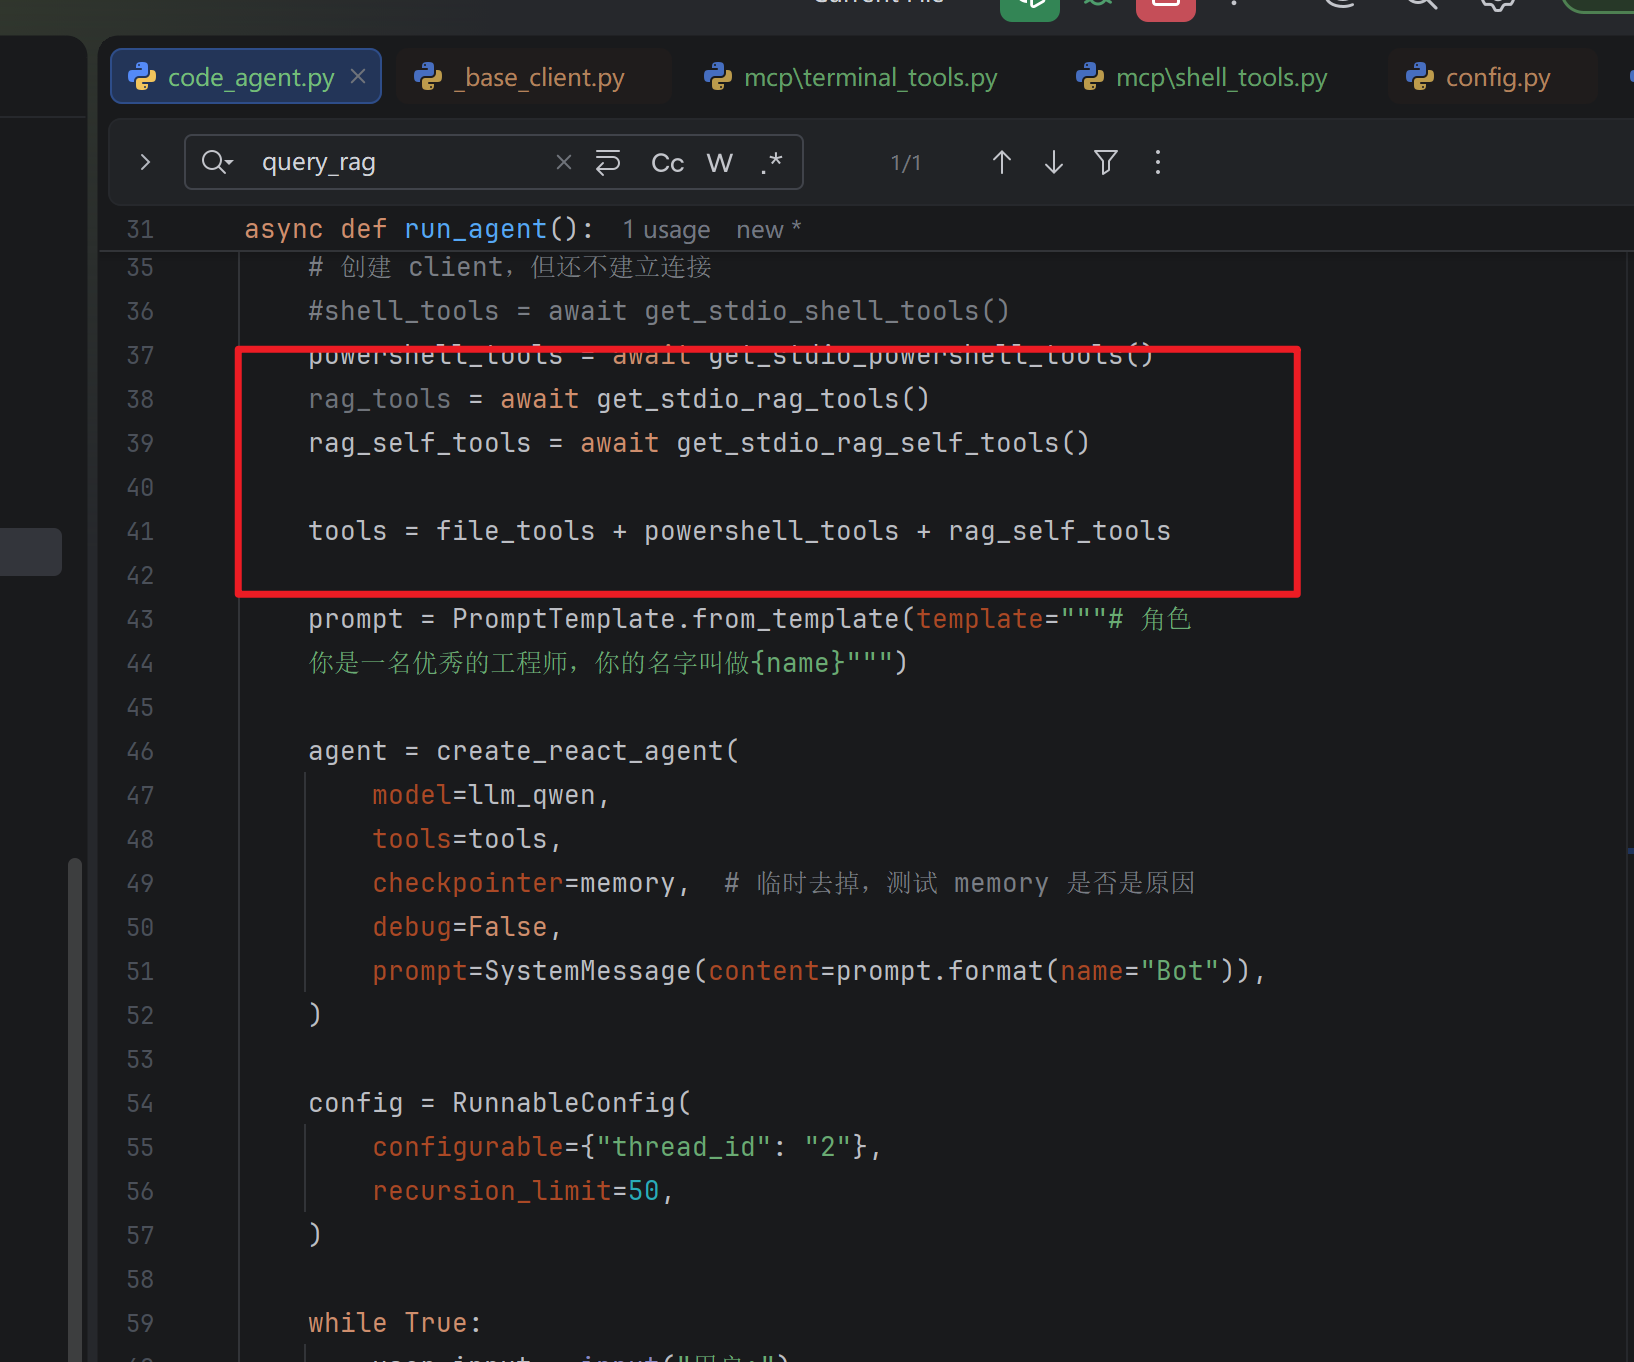
测试话术:
python
请直接回答:如果利用现有工具把本地的知识文件上传到百炼平台?
将我们前面的对话总结成知识,保存到D:/workspace/python/learning/ai-agent-test/.temp/rag目录下,文件名你来决定,然后把这个知识文件上传到阿里云百炼知识库
七、接入浏览器控制
7.1、Selenium WebDriver
Selenium WebDriver 是 Selenium 框架 中的核心组件,用于 自动化 Web 浏览器操作。它通过编程接口直接与浏览器交互,模拟用户行为(如点击、输入、导航等),从而实现网页的自动化测试或数据抓取。
7.2、ChromeDriver
什么是ChromeDriver?
ChromeDriver 是 Google 官方开发的 自动化测试工具 ,它是 Selenium WebDriver 与 Google Chrome 浏览器之间的桥梁。通过 ChromeDriver,开发者可以编写代码来模拟用户操作浏览器的行为(如点击、输入、导航等),从而实现网页的自动化测试、数据抓取或其他浏览器自动化任务。
下载ChromeDriver
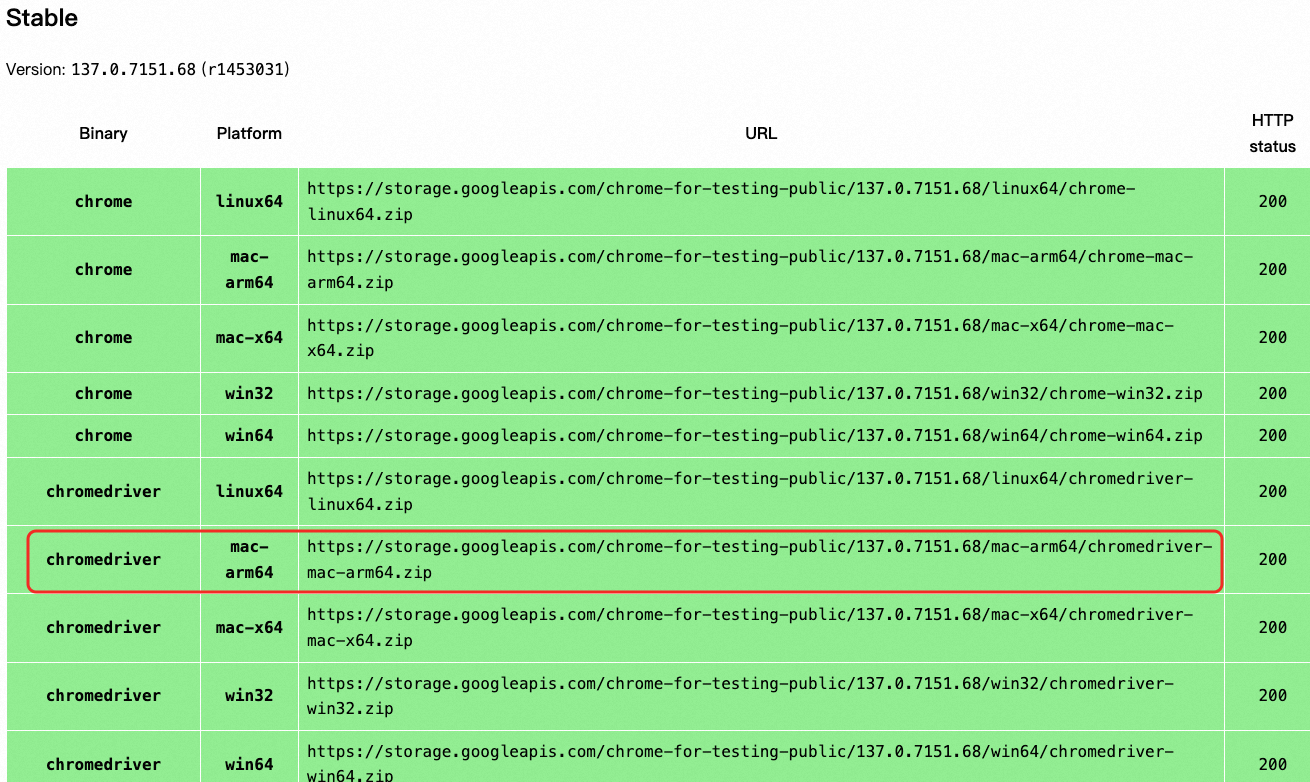
- 访问ChromeDriver官网:https://developer.chrome.com/docs/chromedriver/downloads/version-selection?hl=zh-cn,下载合适的 ChromeDriver 版本
- 如果使用的是 Chrome 115及以上高版本,可以直接访问:https://googlechromelabs.github.io/chrome-for-testing/,下载对应版本的 ChromeDriver
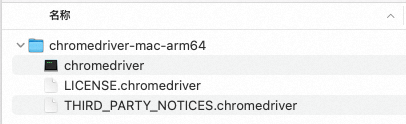
比如我使用的是Chrome137版本,电脑是macOS系统arm64架构,所以应该下载mac-arm64对应的chromedriver版本:
下载成功后目录结构如下:
7.3、封装MCP工具
mcp-server:
python
import re
import time

# ══════════ Claude 新增 import(自己启动 Chrome + 结束后收尾要用)══════════
import socket          # 挑一个空闲端口给 Chrome 的调试端口用
import subprocess      # 自己把 Chrome 启动起来
import sys             # 提示信息走 stderr ------ MCP stdio 里 stdout 是协议通道,不能占
import urllib.request  # 轮询调试端口,等它就绪
from pathlib import Path
from ssl import Options

import psutil          # 结束时按 profile 把 Chrome 进程收掉
from bs4 import BeautifulSoup, Comment
from selenium.common.exceptions import TimeoutException  # 区分「等待超时」这种最常见的失败
# ══════════ Claude 新增 import 结束 ══════════

from selenium.webdriver.chrome.options import Options as Ops


from mcp.server import FastMCP

from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
from selenium.webdriver.common.keys import Keys
from selenium.webdriver.support.wait import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

# 本机 Chrome 装在非标准位置(AppData\Roaming\Google\Chrome\App),
# Selenium 只认 PATH / 标准安装目录 / 注册表,找不到它,必须显式指定
CHROME_BINARY = r"C:\Users\Administrator\AppData\Roaming\Google\Chrome\App\chrome.exe"
# 手动下载的 chromedriver,与本机 Chrome 107.0.5304.63 配套(版本必须同主版本)
CHROMEDRIVER_PATH = r"D:\package\chromedriver.exe"

# ══════════ Claude 新增:固定的 profile 目录 ══════════
# 放在用户目录下(不在仓库里,免得 git status 一堆噪音)。
# 用固定目录之后,过一次百度安全验证就会留下 cookie,不会每次调用都弹验证。
PROFILE_DIR = Path.home() / ".selenium_baidu_profile"
# ══════════ Claude 新增结束 ══════════

mcp = FastMCP()

# 需要执行本地打开debugger模式的浏览器 后续操作已经打开的浏览器
# "C:\Users\Administrator\AppData\Roaming\Google\Chrome\App\chrome.exe" --remote-debugging-port=9222 --user-data-dir="C:\tmp\chrome_debug_profile"
def get_chrome_instance():
    chromedriver_path = "D:/package/chromedriver.exe"

    chrome_options = Ops()
    chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")

    service = Service(executable_path=chromedriver_path)
    driver = webdriver.Chrome(options=chrome_options, service=service)

    print(f"成功连接到Chrome浏览器, 当前URL:{driver.current_url}")
    return driver

def open_chrome():
    driver = get_chrome_instance()
    driver.get("https://www.baidu.com")

    time.sleep(5)
    # Claude 改:execute_script 里的 window.open 没有用户手势,Chrome 的弹窗拦截会直接拦掉它
    # (实测:返回 null、句柄数不变,在你那个 9222 Chrome 上同样如此)。改用驱动级 API 建标签,
    # 它由 chromedriver 发 CDP 命令,不走 window.open,不受弹窗策略影响。
    driver.switch_to.new_window("tab")
    driver.get("http://www.qq.com")

    # 获取所有句柄
    all_handles = driver.window_handles
    print(all_handles)

    # 切换句柄
    time.sleep(5)
    driver.switch_to.window(all_handles[-1])
    print(driver.current_url)
    # driver.close()

    time.sleep(5)
    driver.switch_to.window(all_handles[0])

    # Claude 新增:显式收掉 chromedriver。不写这句,driver 被回收/解释器退出时才由
    # Service.__del__ 去收,那时 Popen 的进程句柄已经失效 → poll() 抛 WinError 6 →
    # _terminate_process 里的 terminate() 永远走不到 → 每次运行留一个 chromedriver 孤儿。
    # stop() 只杀 chromedriver,附着上来的浏览器不受影响(已实测)。
    driver.service.stop()

# @mcp.tool(description="search query word in Baidu")
def search_in_baidu(query: str) -> str:
    # ══════════ Claude 补充开始:自己启动 Chrome,再用 debugger_address 附着 ══════════
    # 为什么不直接用原来的 webdriver.Chrome(...) 让它启动 Chrome:
    # chromedriver 107 会给 Chrome 加上 --enable-logging=stderr,而 Chrome 107 只要日志开着,
    # 就会给它的每个子进程分配一个控制台窗口(本机默认终端是 Windows Terminal,会把窗口
    # 全显示出来),一次运行冒出 6~7 个终端。自己启动 Chrome 就没有这个参数,实测 0 个窗口。
    with socket.socket() as s:
        s.bind(("127.0.0.1", 0))          # 端口填 0 = 让系统随便给一个空闲端口
        debug_port = s.getsockname()[1]

    # Claude 改:原来是 tempfile.mkdtemp(...),每次调用都是一个全新、没 cookie 的
    # profile,等于每次都是陌生浏览器,所以百度每次都弹安全验证。改用固定目录。
    profile = str(PROFILE_DIR)
    subprocess.Popen([
        CHROME_BINARY,
        # ↓ 这段注释是你原来写的,--no-sandbox 现在传给自己启动的 Chrome
        # Chrome 107 的沙箱在 Win11 24H2 上起不来,窗口建不出来,会报
        # "unable to discover open window in chrome",所以要关掉沙箱
        "--no-sandbox",
        "--no-first-run",
        f"--user-data-dir={profile}",
        f"--remote-debugging-port={debug_port}",
    ])

    # 等调试端口就绪再附着
    for _ in range(30):
        try:
            urllib.request.urlopen(f"http://127.0.0.1:{debug_port}/json/version", timeout=1)
            break
        except Exception:
            time.sleep(0.5)

    options = webdriver.ChromeOptions()
    options.binary_location = CHROME_BINARY
    # Claude 改:原来是 options.add_argument("--no-sandbox"),现在沙箱参数在上面启动 Chrome 时给了
    options.debugger_address = f"127.0.0.1:{debug_port}"

    driver = webdriver.Chrome(service=Service(CHROMEDRIVER_PATH), options=options)
    # ══════════ Claude 补充结束(下面 try 里的逻辑基本是你原来的)══════════

    try:
        driver.get("https://www.baidu.com")

        # 先找ID是chat-textarea的,如果找不到等5s再找
        text_box = WebDriverWait(driver, 5).until(
            EC.presence_of_element_located((By.ID, "chat-textarea"))
        )

        text_box.send_keys(query)

        # Claude 改:这里原来写的也是 By.ID "chat-textarea"(复制粘贴串了),点的是输入框
        # 自己,搜索请求根本没发出去;提交按钮的 ID 是下面这个
        submit_button = WebDriverWait(driver, 5).until(
            EC.element_to_be_clickable((By.ID, "chat-submit-button"))
        )

        submit_button.click()

        # 判断标题是否包含query, 如果没有等待5s
        # 这是等进入到新的query页面
        # ══════════ Claude 改:原来只有一句 WebDriverWait(driver, 5) 等结果页标题 ══════════
        # 新 profile + 自动化环境首次搜索时,百度风控会弹「安全验证」(滑块),这时根本不会
        # 进结果页,5s 必然超时。所以先等到「结果页标题」或「安全验证页」出现,如果是安全
        # 验证页就提示你拖滑块(浏览器是可见的),再接着等结果页。
        WebDriverWait(driver, 60).until(
            lambda d: query[:10] in d.title or "安全验证" in d.title
        )
        if "安全验证" in driver.title:
            # Claude 改:print(..., file=sys.stderr) ------ MCP stdio 里 stdout 是 JSON-RPC 协议通道
            print("百度弹出了安全验证,请在浏览器里拖动滑块,脚本会继续等", file=sys.stderr)
            WebDriverWait(driver, 60).until(
                EC.title_contains(query[:10])
            )
        # ══════════ Claude 改动结束 ══════════

        # 翻页优化
        page_text_list = []
        for i in range(3):
            if i > 0:
                # Claude 改:原来按 results 下标点页码,但 .page-inner 下第 0 个 a 是「上一页」,
                # i==1 时 results[i-1] 正好点在它上面 → 禁用的 a 被容器 div 挡住 →
                # ElementClickInterceptedException。顺序翻页直接点「下一页」,不用下标。
                next_link = WebDriverWait(driver, 5).until(
                    EC.element_to_be_clickable(
                        (By.XPATH, '//div[contains(@class,"page-inner")]/a[contains(@class,"next")]')
                    )
                )
                next_link.click()
                time.sleep(5)


            WebDriverWait(driver, 10).until(
                EC.presence_of_element_located((By.TAG_NAME, "body"))
            )

            # 滑动优化
            last_height = driver.execute_script("return document.body.scrollHeight")
            while True:
                driver.execute_script("window.scrollTo(0, document.body.scrollHeight)")
                time.sleep(1)

                # 检查是否加载完成
                new_height = driver.execute_script("return document.body.scrollHeight")
                if new_height == last_height:
                    break
                last_height = new_height

            page_content = driver.find_element(By.TAG_NAME, "body")
            # return page_content.get_attribute("innerHTML")
            page_text = page_content.text
            page_text_list.append(f"第{i + 1}页" + page_text + "\n -- \n")
        return "\n".join(page_text_list)

    except Exception as e:
        # Claude 改:原来只 print(e) 到 stdout,而且异常路径没有 return → 返回 None →
        # FastMCP 校验输出报 "Input should be a valid string"。现在异常也返回字符串,
        # agent 就能把失败原因讲给用户听;调试信息走 stderr,不碰协议通道。
        print(type(e).__name__, e, file=sys.stderr)
        if isinstance(e, TimeoutException):
            return "搜索失败:等待结果页超时(百度可能弹了安全验证且没有及时通过)"
        return f"搜索失败:{type(e).__name__}: {e}"
    finally:
        driver.quit()
        # Claude 新增:quit() 只删会话,不收 chromedriver(remote/webdriver.py:651-666 全程
        # 没碰 service.stop())。MCP 是常驻进程,driver 可能在运行中被回收,同一个坑。
        driver.service.stop()
        # ══════════ Claude 补充:附着上去的会话,driver.quit() 只是断开连接、不关浏览器,
        # 所以按这次的 profile 路径把启动的 Chrome 进程收掉 ══════════
        for p in psutil.process_iter(["cmdline"]):
            if profile in " ".join(p.info["cmdline"] or []):
                p.kill()


@mcp.tool(description="search query word in Baidu")
def search_in_baidu_with_html(query: str) -> str:
    driver = get_chrome_instance()

    try:
        driver.get("https://www.baidu.com")

        # 先找ID是chat-textarea的,如果找不到等5s再找
        text_box = WebDriverWait(driver, 5).until(
            EC.presence_of_element_located((By.ID, "chat-textarea"))
        )

        text_box.send_keys(query)

        # Claude 改:改成在输入框里回车提交。原来等 #chat-submit-button 可点击再点它,
        # 但实测输入文字后这个按钮会被百度隐藏(displayed=False、0×0、位置被 div.s_form 盖住),
        # element_to_be_clickable 要求"可见且可用",必然 5s 超时 ------ 就是那个 Message 为空的
        # TimeoutException。回车提交实测 1s 内跳到结果页。
        text_box.send_keys(Keys.ENTER)

        # 判断标题是否包含query, 如果没有等待5s
        # 这是等进入到新的query页面
        # ══════════ Claude 改:原来只有一句 WebDriverWait(driver, 5) 等结果页标题 ══════════
        # 新 profile + 自动化环境首次搜索时,百度风控会弹「安全验证」(滑块),这时根本不会
        # 进结果页,5s 必然超时。所以先等到「结果页标题」或「安全验证页」出现,如果是安全
        # 验证页就提示你拖滑块(浏览器是可见的),再接着等结果页。
        WebDriverWait(driver, 60).until(
            lambda d: query[:10] in d.title or "安全验证" in d.title
        )
        if "安全验证" in driver.title:
            # Claude 改:print(..., file=sys.stderr) ------ MCP stdio 里 stdout 是 JSON-RPC 协议通道
            print("百度弹出了安全验证,请在浏览器里拖动滑块,脚本会继续等", file=sys.stderr)
            WebDriverWait(driver, 60).until(
                EC.title_contains(query[:10])
            )
        # ══════════ Claude 改动结束 ══════════

        # 翻页优化
        page_text_list = []
        for i in range(1):
            if i > 0:
                # Claude 改:原来按 results 下标点页码,但 .page-inner 下第 0 个 a 是「上一页」,
                # i==1 时 results[i-1] 正好点在它上面 → 禁用的 a 被容器 div 挡住 →
                # ElementClickInterceptedException。顺序翻页直接点「下一页」,不用下标。
                next_link = WebDriverWait(driver, 5).until(
                    EC.element_to_be_clickable(
                        (By.XPATH, '//div[contains(@class,"page-inner")]/a[contains(@class,"next")]')
                    )
                )
                next_link.click()
                time.sleep(5)


            WebDriverWait(driver, 10).until(
                EC.presence_of_element_located((By.ID, "container"))
            )

            # 滑动优化
            last_height = driver.execute_script("return document.body.scrollHeight")
            while True:
                driver.execute_script("window.scrollTo(0, document.body.scrollHeight)")
                time.sleep(1)

                # 检查是否加载完成
                new_height = driver.execute_script("return document.body.scrollHeight")
                if new_height == last_height:
                    break
                last_height = new_height

            page_content = driver.find_element(By.ID, "container")
            page_text = page_content.get_attribute("innerHTML")
            # page_text = page_content.text
            page_text_list.append(page_text)

        html = '\n'.join(page_text_list)
        html = pretty_html(html)
        print(len(html))
        return html

    except Exception as e:
        # Claude 改:原来只 print(e) 到 stdout,而且异常路径没有 return → 返回 None →
        # FastMCP 校验输出报 "Input should be a valid string"。现在异常也返回字符串,
        # agent 就能把失败原因讲给用户听;调试信息走 stderr,不碰协议通道。
        print(type(e).__name__, e, file=sys.stderr)
        if isinstance(e, TimeoutException):
            return "搜索失败:等待结果页超时(百度可能弹了安全验证且没有及时通过)"
        return f"搜索失败:{type(e).__name__}: {e}"
    finally:
        driver.quit()
        # Claude 新增:quit() 只删会话,不收 chromedriver(remote/webdriver.py:651-666 全程
        # 没碰 service.stop())。MCP 是常驻进程,driver 可能在运行中被回收,同一个坑。
        driver.service.stop()

def pretty_html(html: str) -> str:
    # 初始html长度: 678806
    # 移除指定标签后的长度:449878
    # 移除所有display:none的标签的长度:169479
    # 移除注释: 150530
    # 删除无用属性: 68576
    # 编程container: 49201

    # 移除指定标签
    soup = BeautifulSoup(html, "html.parser")
    for tag in soup(["script", "style", "link", "meta", "symbol", "path", "canvas", "svg"]):
        tag.extract()

    # 移除所有display:none的标签
    display_none_re = re.compile(r"display\s*:\s*none;", re.IGNORECASE)
    for tag in soup.find_all(True):
        style = tag.get("style", "")
        if display_none_re.search(style):
            tag.extract()

    # 移除所有代码注释
    for comment in soup.find_all(string=lambda text:isinstance(text, Comment)):
        comment.extract()

    # 移除无用属性 只保留超链接的href
    for tag in soup.find_all(True):
        if tag.name == "a":
            if "href" in tag.attrs:
                if "javascript" in tag.attrs["href"] or "/" == tag.attrs["href"]:
                    tag.extract()
                else:
                    # 只保留href属性
                    tag.attrs = {"href": tag.attrs["href"]}
        else:
            tag.attrs = {}


    html = soup.prettify()

    return html


if __name__ == "__main__":
    mcp.run(transport="stdio")
    # open_chrome()
    # search_in_baidu_with_html("邯郸今日天气")
    # search_in_baidu("北京的天气")

    # options = webdriver.ChromeOptions()
    # options.binary_location = CHROME_BINARY
    # # Chrome 107 的沙箱在 Win11 24H2 上起不来,窗口建不出来,会报
    # # "unable to discover open window in chrome",所以要关掉沙箱
    # options.add_argument("--no-sandbox")
    #
    # driver = webdriver.Chrome(service=Service(CHROMEDRIVER_PATH), options=options)
    #
    # try:
    #     driver.get("https://www.baidu.com")
    #
    #     title = driver.title
    #     url = driver.current_url
    #     name = driver.name
    #
    #     text_box = driver.find_element(by=By.ID, value="chat-textarea")
    #     submit_buttong = driver.find_element(by=By.ID, value="chat-submit-button")
    #
    #     text_box.send_keys("邯郸今天天气")
    #     submit_buttong.click()
    #
    #     # 等上一步执行完 最多等10s超过 下一步
    #     # driver.implicitly_wait(10)
    #     time.sleep(2.5) # 强制等待2.5s
    # except Exception as e:
    #     print(e)
    # finally:
    #     driver.quit()
client:
python
import os
import sys

from dotenv import load_dotenv

from app.code_agent.utils.mcp import create_mcp_stdio_client
load_dotenv()

async def get_stdio_browser_tools():
    params = {
        # 用当前解释器,避免 "python" 解析到 PATH 上别的 Python
        "command": sys.executable,
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/browser_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("browser_tools", params)
    return tools
测试:
八、Agent运行沙盒
8.1、环境搭建
创建虚拟机、下载docker、下载nginx、创建软连接、创建nginx的docker-compose.yml
mac可以用lima vm命令创建虚拟机,windows就用vmware平替
bash
# 1. 更新软件源
sudo apt update && sudo apt upgrade -y

# 2. 安装docker依赖 + net-tools + tree
sudo apt install ca-certificates curl gnupg lsb-release net-tools tree -y

#3. 添加docker官方GPG密钥
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /usr/share/keyrings/docker-archive-keyring.gpg

#4. 添加docker源
echo "deb [arch=$(dpkg --print-architecture) signed-by=/usr/share/keyrings/docker-archive-keyring.gpg] https://download.docker.com/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null

#5. 再次更新,安装docker engine
sudo apt update
sudo apt install docker-ce docker-ce-cli containerd.io -y

#6. 当前用户加入docker组,免sudo
sudo usermod -aG docker $USER

#8. VMware虚拟机增强工具(窗口自适应、鼠标自由进出)
sudo apt install open-vm-tools open-vm-tools-desktop -y

#9. 启动docker、开机自启
sudo systemctl enable --now docker

#10. 验证
docker -v
docker compose version
ifconfig
tree --version

# 重启虚拟机
reboot

# ========= Nginx项目部分 =========
# 拉取nginx镜像
docker pull nginx

# 临时容器复制nginx原始配置(仅第一次执行)
docker run --name tmp-nginx -d -p80:80 nginx

# 创建软连接
mkdir -p /home/administartor/nginx/conf
mkdir -p /home/administartor/nginx/uploads
mkdir -p /home/administartor/nginx/html
mkdir -p /home/administartor/nginx/logs

sudo docker cp lima-nginx:/etc/nginx/nginx.conf /home/administrator/nginx/conf/nginx.conf
sudo docker cp lima-nginx:/etc/nginx/conf.d /home/administrator/nginx/conf/conf.d
sudo docker cp lima-nginx:/usr/share/nginx/html /home/administrator/nginx

docker rm -f tmp-nginx

# 编写docker-compose.yml (后面有)
nano docker-compose.yml

# 修改nginx站点配置(后面有)
sudo nano /home/administartor/nginx/conf/conf.d/default.conf
docker-compose.yml
这里重点关注volumes目录映射
yaml
services:
  lima:
    image: nginx:latest
    container_name: lima-nginx
    volumes:
      - ./conf/nginx.conf:/etc/nginx/nginx.conf
      - ./conf/conf.d:/etc/nginx/conf.d
      - ./html:/usr/share/nginx/html
      - ./uploads:/usr/share/nginx/uploads
      - ./logs:/var/log/nginx
    ports:
      - "80:80"
default.conf
增加agent路径映射,可以在uploads里面创建html文件进行测试,路径加上/agent/test.html就可以了
nginx
location /agent/ {
    alias /usr/share/nginx/uploads/;
}
拉取nginx可以需要开启魔法,然后需要做虚拟机和宿主机的地址映射:
bash
# 1、删除Docker代理(后面要清理的时候,一次性复制整段执行)
```bash
sudo rm /etc/systemd/system/docker.service.d/http-proxy.conf
sudo systemctl daemon-reload
sudo systemctl restart docker
2、恢复代理命令(如果后续又要拉新镜像,需要重新启用代理,复制下面整套)
你的环境固定地址:
http://192.168.230.1:7890
bash
sudo mkdir -p /etc/systemd/system/docker.service.d
cat << EOF | sudo tee /etc/systemd/system/docker.service.d/http-proxy.conf
[Service]
Environment="HTTP_PROXY=http://192.168.230.1:7890"
Environment="HTTPS_PROXY=http://192.168.230.1:7890"
Environment="NO_PROXY=localhost,127.0.0.1,.docker.internal"
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
简单备忘(你存一下)
- 删除代理:断开docker自动走Windows代理,适合跑Agent沙箱业务
- 恢复代理:docker再次通过宿主机代理拉取外网镜像
注意:恢复代理前,Windows代理软件必须开启局域网允许,否则会报 connection refused
ssh链接:

> 代码操作免密
>

```bash
# 虚拟机操作
#1.编辑 ssh 配置,开启密码登录(只跑 1 次)
sudo nano /etc/ssh/sshd_config

#找到两行,去掉`#`注释,改成 yes
PasswordAuthentication yes
PubkeyAuthentication yes

#2.重启 ssh 服务,让配置生效
sudo systemctl restart ssh

# windows powershell管理员操作
# 1. 生成密钥(只跑一次)
ssh-keygen -t ed25519

# 2. 推送公钥到Ubuntu(替换为你的用户名和IP)
type $env:USERPROFILE\.ssh\id_ed25519.pub | ssh administartor@192.168.230.128 "mkdir -p ~/.ssh && cat >> ~/.ssh/authorized_keys"

# 3. 测试免密登录
ssh administartor@192.168.230.128
8.2、MCP封装
- mcp-server
python
import os
import subprocess
import sys
import tempfile
import traceback
from typing import Annotated

from mcp.server import FastMCP
from pydantic import Field

mcp = FastMCP()

VM_USER = "administartor"
VM_IP = "192.168.230.128"

# ssh / scp 的公共选项
SSH_OPTS = [
    # 禁止一切交互式提问(密码/口令): 没控制台时它问不出来, 会直接退出, 而且什么都不打印
    "-o", "BatchMode=yes",
    # 主机指纹没见过的就直接接受, 不弹"是否继续连接"的人工确认
    "-o", "StrictHostKeyChecking=accept-new",
    "-o", "ConnectTimeout=10",
]

def build_child_env():
    """给 ssh/scp 准备环境变量。
    MCP SDK 启动 server 时只会保留 12 个白名单变量(APPDATA/PATH/USERPROFILE 等), 里面没有 PROGRAMDATA。
    而 Windows 自带的 ssh.exe 少了 PROGRAMDATA 会直接以 255 退出, 而且一个字的错误都不打印
    (Git 的 ssh 不需要它, 所以换个 ssh 就看不出来)。这里补回去。"""
    env = dict(os.environ)
    env.setdefault("PROGRAMDATA", env.get("SYSTEMDRIVE", "C:") + r"\ProgramData")
    return env


def run_local_command(cmd):
    """在本机跑一条命令; cmd 用参数列表, 不走本地 shell"""
    # stdin 必须掐掉: MCP server 的 stdin 是客户端的 JSON-RPC 管道,
    # ssh 继承到它会直接卡死, 工具调用永远不返回。
    # capture_output: 捕获返回结构 否则直接打印
    # text: 输出是字符串
    res = subprocess.run(cmd,
                         env=build_child_env(),  # 补上被 MCP SDK 砍掉的 PROGRAMDATA 等变量
                         stdin=subprocess.DEVNULL,
                         capture_output=True,
                         text=True,
                         encoding = "utf-8",  # ==========加上这一行!强制utf8解码
                         errors = "replace"  # 遇到无法识别字符直接替换,防止程序崩溃
                        )

    # 成功返回标准输出, 失败返回错误信息
    if res.returncode != 0:
        # stderr 可能是空的(有的 ssh 失败时一个字都不打印), 空字符串会被误当成"成功但没输出"
        return res.stderr.strip() or f"命令退出码 {res.returncode}, 但没有任何错误输出"

    return res.stdout


def run_vm_shell_command(command):
    try:
        # rm 是 Linux 的删除命令, 这里直接禁掉, 免得模型把虚拟机上的东西删了
        if command.strip().startswith("rm"):
            raise Exception("不允许使用rm")

        # 用参数列表, 不走本地 shell: Windows 下 shell=True 用的是 cmd.exe, 它不认单引号,
        # 会让引号原样传给 ssh, 远端 shell 就把整串当成一个命令名。
        # ssh 会把 command 整串交给远端 shell 解析, 所以这里不需要自己加引号。
        ssh_cmd = ["ssh", *SSH_OPTS, f"{VM_USER}@{VM_IP}", command]
        return run_local_command(ssh_cmd)
    except Exception as e:
        # 一定要把类型也带上: 有些异常的 str(e) 就是空字符串,
        # 直接返回 str(e) 的话, "出错了"和"成功但没有输出"长得一模一样, 调用方根本分不出来
        traceback.print_exc()  # 完整报错打到 stderr, 在 agent 控制台上能看到
        return f"{type(e).__name__}: {e}"


def copy_to_vm(local_path, vm_path):
    """把本机文件/目录复制到虚拟机: 相当于 scp -r 本地路径 用户@IP:虚拟机路径
    成功返回空字符串, 失败返回错误信息"""
    # scp 是 Linux 之间传文件的命令, 参数写成 用户@IP:路径 就代表"传到那台机器的这个位置"
    # -r: 传的是文件夹就整个递归传下去 (传单个文件时带上也没影响)
    return run_local_command(["scp", "-r", *SSH_OPTS,
                              local_path, f"{VM_USER}@{VM_IP}:{vm_path}"])

@mcp.tool(name="make_dir_in_vm", description="在指定的虚拟机中创建目录, 相当于 mkdir -p命令")
def make_dir_in_vm(dir_path: Annotated[str, Field(description="要创建的目录路径", examples=["/home/administartor/nginx/uploads"])]):
    """在虚拟机中创建目录"""
    print("dir_path", dir_path, file=sys.stderr)  # 必须打到 stderr: stdout 是 MCP 的协议通道
    # mkdir 是建目录; -p 表示上级目录不存在就一层层一起建好, 目录已经存在也不报错
    return run_vm_shell_command("mkdir -p " + dir_path)

@mcp.tool(name="list_files_in_vm", description="查询虚拟机中指定目录, 相当于 ls -al命令")
def list_files_in_vm(dir_path: Annotated[str, Field(description="要查看的目录路径", examples=["/home/administartor/nginx/uploads"])]):
    """查看虚拟机指定目录下的文件"""
    print("dir_path", dir_path, file=sys.stderr)  # 必须打到 stderr: stdout 是 MCP 的协议通道
    # ls 是列目录; -a 连 . 开头的隐藏文件一起列, -l 显示详细信息(权限/大小/时间)
    return run_vm_shell_command(f"ls -al {dir_path}")

@mcp.tool(name="write_file_to_vm", description="向虚拟机中加入指定文件")
def write_file_to_vm(file_path: Annotated[str, Field(description="写入虚拟机中的文件地址", examples=["/home/administartor/nginx/uploads/index.html"])],
                     content: Annotated[str, Field(description="写入虚拟机中的文件内容", examples=["hello world"])]):
    with tempfile.NamedTemporaryFile(delete=False, mode="w", encoding="utf-8") as tmp_file:
        tmp_file.write(content)
        tmp_file_path = tmp_file.name

    print("本地临时文件已创建", tmp_file_path, file=sys.stderr)  # 同上, 只能走 stderr
    # 传文件这一步的结果要检查: copy_to_vm 失败时返回的是错误信息, 成功才是空的
    err = copy_to_vm(tmp_file_path, file_path).strip()
    os.remove(tmp_file_path)  # scp 完把本地临时文件删掉
    if err:
        return f"传输文件失败: {err}"

    # chmod 没输出就是成功, 有输出就是报错
    err = change_file_permission_in_vm(file_path, "765").strip()
    return f"写入失败: {err}" if err else f"已写入虚拟机: {file_path}"

def change_file_permission_in_vm(file_path, mode):
    # chmod 是改文件权限; 3 个数字从左到右分别管 所有者 / 同组用户 / 其他人,
    # 每个数字是相加出来的: 4=读 2=写 1=执行。所以 765 = 所有者 读写执行, 同组 读写, 其他人 读执行
    return run_vm_shell_command(f"chmod {mode} {file_path}")


@mcp.tool(name="upload_directory_to_vm", description="将本地文件目录上传至虚拟机指定目录")
def upload_directory_to_vm(
        local_dir: Annotated[str, Field(description="本地文件目录", examples=["D:/workspace/python/learning/ai-agent-test/app/code_agent/agent/agent_chat.py"])],
        vm_dest_dir: Annotated[str, Field(description="虚拟机文件目录", examples=["/home/administartor/nginx/uploads"])],
):
    if not os.path.exists(local_dir):
        msg = f"本地目录不存在: {local_dir}"
        print(f"[UPLOAD] {msg}")
        return msg

    if not os.path.isdir(local_dir):
        msg = f"指定路径不是文件夹: {local_dir}"
        print(f"[UPLOAD] {msg}")
        return msg

    make_dir_in_vm(vm_dest_dir)

    # os.walk 会把本地目录一层层走一遍, 每层给出: root 当前目录, dirs 里面的子目录, files 里面的文件
    for root, dirs, files in os.walk(local_dir):
        # 从 dirs 里删掉, os.walk 就不会再往这些目录里走了
        # 判断要写成 in dirs: 写成 in root 的话, 要等路径里真的出现 node_modules 才成立,
        # 那时已经走进去了, 而且真正在里面的那一层 dirs 是空的, remove 会直接抛 ValueError
        if 'node_modules' in dirs:
            dirs.remove('node_modules')
        if '.git' in dirs:
            dirs.remove('.git')

        print(root, dirs, files)

        # 算出两者的相对路径
        rel_path = os.path.relpath(root, local_dir).replace("\\", "/")  # Windows 的 \ 换成 /
        # 创建远程文件夹
        vm_subdir = f"{vm_dest_dir}/{rel_path}"

        make_dir_in_vm(vm_subdir)

        for file_name in files:
            # 本地文件要用 root 拼, 不能用 local_dir: root 是当前这一层目录,
            # 用 local_dir 的话, 子目录里的文件会跑到本地根目录去找
            local_file_path = os.path.join(root, file_name)
            vm_file_path = f"{vm_subdir}/{file_name}"
            # 把本地文件传到虚拟机, 相当于 scp 本地文件 用户@IP:虚拟机路径 (原来是 lima 的 copy 命令)
            result = copy_to_vm(local_file_path, vm_file_path)

    return f"上传完成: {local_dir} -> {VM_USER}@{VM_IP}:{vm_dest_dir}"

# ============== 自测代码 ==============
# 加 test 参数运行, 就会把每个工具都测一遍:
#   python app/code_agent/mcp/vm_tools.py test
# 测试会往虚拟机写东西, 跑完自己删掉, 不会留垃圾

# 测试专用的目录, 都放在它里面
# TEST_VM_DIR = "/home/administartor/nginx/uploads/_vm_tools_test"
#
#
# def test_make_dir_and_list():
#     """测 make_dir_in_vm 和 list_files_in_vm"""
#     print("\n===== make_dir_in_vm / list_files_in_vm =====")
#     make_dir_in_vm(TEST_VM_DIR)  # 在虚拟机上建测试目录
#     out = list_files_in_vm("/home/administartor/nginx/uploads")  # 列上级目录
#     print(out, end="")
#     # 上级目录的列表里应该能看到刚建的 _vm_tools_test
#     print("测试目录建好了:", "_vm_tools_test" in out)
#
#
# def test_write_file():
#     """测 write_file_to_vm: 写个文件上去, 再列目录看它在不在"""
#     print("\n===== write_file_to_vm =====")
#     print(write_file_to_vm(f"{TEST_VM_DIR}/hello.txt", "hello from vm_tools test"))
#     out = list_files_in_vm(TEST_VM_DIR)
#     print(out, end="")
#     # 最后应该有一行 -rwxrw-r-x 的 hello.txt (765 权限)
#     print("文件写进去了:", "hello.txt" in out)
#
#
# def test_upload_directory():
#     """测 upload_directory_to_vm: 本地造个目录传上去, 看子目录能不能上去、.git 和 node_modules 会不会被跳过"""
#     print("\n===== upload_directory_to_vm =====")
#     src_dir = os.path.join(tempfile.gettempdir(), "_vm_tools_test_src")
#
#     # 造一个测试目录: 根目录 1 个文件 + 子目录 1 个文件 + 2 个应该被跳过的目录
#     os.makedirs(os.path.join(src_dir, "sub"), exist_ok=True)
#     os.makedirs(os.path.join(src_dir, ".git"), exist_ok=True)
#     os.makedirs(os.path.join(src_dir, "node_modules"), exist_ok=True)
#     for rel_path, text in [("a.txt", "aaa"), ("sub/b.txt", "bbb"),
#                            (".git/c.txt", "ccc"), ("node_modules/d.txt", "ddd")]:
#         with open(os.path.join(src_dir, rel_path), "w", encoding="utf-8") as f:
#             f.write(text)
#
#     print(upload_directory_to_vm(src_dir, f"{TEST_VM_DIR}/uploaded"))
#     print(list_files_in_vm(f"{TEST_VM_DIR}/uploaded"), end="")      # 应该只有 a.txt 和 sub
#     print(list_files_in_vm(f"{TEST_VM_DIR}/uploaded/sub"), end="")  # 应该有 b.txt
#
#     # find 会把目录下所有东西的完整路径列出来, 用它检查结果
#     listing = run_vm_shell_command(f"find {TEST_VM_DIR}/uploaded")
#     print(listing, end="")
#     ok = (".git" not in listing and "node_modules" not in listing
#           and "a.txt" in listing and "b.txt" in listing)
#     print("文件传上来了, .git/node_modules 被跳过:", ok)
#
#     shutil.rmtree(src_dir)  # 本地这个测试目录用完删掉
#
#
# def clean_vm_test_dir():
#     """删掉虚拟机上的测试目录"""
#     # rm 被 run_vm_shell_command 禁掉了, 这里用 find -delete:
#     # 它会从最里层开始删, 先删文件再删空目录, 正好把整棵目录树删干净
#     print("\n===== 清理测试目录 =====")
#     print(run_vm_shell_command(f"find {TEST_VM_DIR} -delete"))


if __name__ == "__main__":
    mcp.run(transport="stdio")
    # test_make_dir_and_list()
    # test_write_file()
    # test_upload_directory()
# clean_vm_test_dir()- mcp-client
python
from app.code_agent.utils.mcp import create_mcp_stdio_client


async def get_stdio_vm_tools():
    params = {
        "command": "python",
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/vm_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("vm_tools", params)
return tools- 测试
bash
在虚拟机 /home/administartor/nginx/uploads 目录下创建 test5 目录, 并写入 index.html 文件, 文件中的代码内容为一个企业的官网 九、接入Mysql
9.1、环境准备
安装 mysql 服务端镜像:
bash
sudo docker pull mysql:9.3.0创建 docker-compose.yaml:
yaml
services:
  mysql:
    image: mysql:9.3.0
    container_name: mysql-9.3.0
    ports:
      - "3306:3306"
    environment:
      MYSQL_ROOT_PASSWORD: root
    volumes:
      - ./mysql-data:/var/lib/mysql     # 数据持久化目录
启动 mysql 服务:
bash
sudo docker-compose up安装 mysql 客户端:
bash
sudo apt install mysql-client-core-8.0测试 mysql 登录:
bash
mysql -h 192.168.64.2 -P 3306 -u root -proot配置 Navicat 连接:
9.2、MCP封装
- mcp-server
python
from typing import Optional, Any, Dict, Annotated

import pymysql
from mcp.server import FastMCP
from pydantic import BaseModel, Field
from rich import columns

MYSQL_CONFIG = {
    'host': '192.168.230.128',
    'port': 3306,
    'user': 'root',
    'password': 'root',
    'charset': 'utf8mb4',
}

class Response(BaseModel):
    success: bool
    database: str
    table: str
    data: Optional[dict] | Optional[list]
    rowcount: Optional[int] | None

mcp = FastMCP()

def get_connection(db):
    config = MYSQL_CONFIG.copy()
    if db:
        config['database'] = db
    try:
        connection = pymysql.connect(**config)
        return connection
    except Exception as e:
        msg = f'mysql connect error: {str(e)}'
        return msg


def execute_query(command, database=None, params=None, commit = False):
    try:
        connection = get_connection(database)
        if not isinstance(connection, pymysql.Connection):
            return connection
        else:
            with connection.cursor(pymysql.cursors.DictCursor) as cursor:
                cursor.execute(command, params)
                result = cursor.fetchall()
                if commit:
                    connection.commit()
                return result, cursor.rowcount
    except Exception as e:
        raise e

@mcp.tool(name="mysql_list_databases", description="列举MySQL中包含那些数据库")
def mysql_list_databases():
    try:
        result, rowcount = execute_query("SHOW DATABASES")
        databases = [row['Database'] for row in result]
        return Response(
            success=True,
            database='',
            table='',
            data=databases,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'list databases error: {str(e)}'
        return msg

@mcp.tool(name="mysql_list_tables", description="获取指定数据库中的所有表")
def mysql_list_tables(database):
    try:
        result, rowcount = execute_query("show tables", database)
        tables = [list(row.values())[0] for row in result]
        return Response(
            success=True,
            database='',
            table='',
            data=tables,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'list tables error: {str(e)}'
        return msg

@mcp.tool(name="mysql_describe_tables", description="获取表结构信息")
def mysql_describe_tables(database: str, table: str):
    try:
        result, rowcount = execute_query(f"describe {table}", database)
        return Response(
            success=True,
            database=database,
            table=table,
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'describe {table} error: {str(e)}'
        return msg

@mcp.tool(name="mysql_execute_sql", description="执行SQL查询语句")
def mysql_execute_sql(command, database=None, params:Optional[list]=None):
    try:
        params_tuple = tuple(params) if params else None
        result, rowcount = execute_query(command, database, params_tuple)
        return Response(
            success=True,
            database=database,
            table='',
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'execute sql error: {str(e)}'
        return msg

@mcp.tool(name="mysql_insert_data", description="向表里插入数据")
def mysql_insert_data(database:str, table:str, data:Dict[str, Any]):
    try:
        columns = list(data.keys())
        values = list(data.values())
        values_wrapper = ", ".join(['%s'] * len(values))
        command = f"INSERT INTO {table} ({','.join(columns)}) VALUES ({values_wrapper})"
        result, rowcount = execute_query(command=command, database=database, params=tuple(values), commit=True)
        return Response(
            success=True,
            database=database,
            table=table,
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'insert data error: {str(e)}'
        return msg

@mcp.tool(name="mysql_update_data", description="向表里更新数据")
def mysql_update_data(database: str, table: str, data: Dict[str, Any], where: Dict[str, Any]):
    # SET 和 WHERE 都要各自拼成 "列 = %s" 再把值按顺序传进去;
    # 以前 WHERE 直接写成 {where}, 塞进去的是 dict 本身, 占位符和参数个数对不上
    set_clause = ", ".join([f"{k} = %s" for k in data.keys()])
    where_clause = " and ".join([f"{k} = %s" for k in where.keys()])
    command = f"UPDATE {table} SET {set_clause} WHERE {where_clause}"

    params = list(data.values()) + list(where.values())

    try:
        result, rowcount = execute_query(command, database=database, params=tuple(params), commit=True)
        return Response(
            success=True,
            database=database,
            table=table,
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'update data error: {str(e)}'
        return msg

@mcp.tool(name="mysql_delete_data", description="向表里删除数据")
def mysql_delete_data(database: str, table: str, where: Dict[str, Any]):
    where_clause = " and ".join([f"{k} = %s" for k in where.keys()])
    command = f"DELETE FROM {table} WHERE {where_clause}"
    params = list(where.values())

    try:
        result, rowcount = execute_query(command, database=database, params=tuple(params), commit=True)
        return Response(
            success=True,
            database=database,
            table=table,
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'delete data error: {str(e)}'
        return msg

@mcp.tool(name="mysql_create_database", description="创建新数据库")
def mysql_create_database(database_name: str, charset: str = "utf8mb4"):
    command = f"CREATE DATABASE {database_name} CHARACTER SET {charset}"

    try:
        result,rowcount = execute_query(command)
        return Response(
            success=True,
            database=database_name,
            table="",
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'create database error: {str(e)}'
        return msg

@mcp.tool(name="mysql_create_table", description="创建新表")
def mysql_create_table(
        database: str,
        table_name: str,
        table_columns: Annotated[str, Field(description="建表语句中的字段部分", examples=["`id` int NOT NULL AUTO_INCREMENT,`name` varchar(255) COLLATE utf8mb4_general_ci NOT NULL,PRIMARY KEY (`id`)"])],
        table_schema: Annotated[str, Field(description="建表语句中的补充部分", examples=["ENGINE=InnoDB AUTO_INCREMENT=8 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci"])]
):
    """
    建表语句示例:
    CREATE TABLE `user` (
        `id` int NOT NULL AUTO_INCREMENT,
        `name` varchar(255) COLLATE utf8mb4_general_ci NOT NULL,
        PRIMARY KEY (`id`)
    ) ENGINE=InnoDB AUTO_INCREMENT=8 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;
    :param database:
    :param table_name:
    :param table_columns:
    :param table_schema:
    :return:
    """
    command = f"CREATE TABLE {table_name} ({table_columns}) {table_schema}"
    try:
        result, rowcount = execute_query(command, database=database)
        return Response(
            success=True,
            database=database,
            table=table_name,
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'create table error: {str(e)}'
        return msg

@mcp.tool(name="mysql_execute_command", description="执行特定的SQL语句, 如变更表结构, 增减字段")
def mysql_execute_command(database: str, command: str):
    try:
        result, rowcount = execute_query(command=command, database=database, commit=True)
        return Response(
            success=True,
            database=database,
            table="",
            data=result,
            rowcount=rowcount
        )
    except Exception as e:
        msg = f'execute command error: {str(e)}'
        return msg

if __name__ == "__main__":
    mcp.run(transport="stdio")
    # print(mysql_list_databases())
    # print(mysql_list_tables("test"))
    # print(mysql_execute_sql("select * from user where name=%s", database="test", params=["sam"]))
    # print(mysql_insert_data("test", "user", {"id": '3', "name": "someone"}))
    # print(mysql_update_data("test", "user", {"name": "test"}, "id =3"))
# print(mysql_delete_data("test", "user", {"id": "3"}))- mcp-client
python
from dotenv import load_dotenv

from app.code_agent.utils.mcp import create_mcp_stdio_client
load_dotenv()

async def get_stdio_mysql_tools():
    params = {
        "command": "python",
        "args": [
            "D:/workspace/python/learning/ai-agent-test/app/code_agent/mcp/mysql_tools.py"
        ]
    }

    client, tools = await create_mcp_stdio_client("mysql_tools", params)
    return tools
十、LangGraph
10.1、背景
随着大模型技术的不断演进,AI Agent成为了大模型领域的焦点。如果你期望构建出能够自主决策、灵活交互的智能体,LangGraph 作为从 LangChain 孵化而来的独立平台,绝对是开发者的首选框架。
LangGraph 基于有向无环图 (DAG)这一核心数据结构,通过**节点(Node)和边(Edge)**的组合,使得开发者能够快速地搭建起一个功能强大、灵活的 Multi-Agent 系统。
知识扩展:什么是图数据结构?数据结构------图(1)很详细_数据结构 图-CSDN博客
10.2、核心优势
LangGraph 的核心优势在于:
- **敏捷高效:**凭借简洁统一的开发架构,将复杂 AI Agent 开发流程标准化,降低开发门槛;开发者可快速复用节点与工作流模板,减少重复性开发工作,大幅缩短项目周期,实现从构思到落地的高效转化 。
- **可靠性和可控性:**通过审核检查与人工介入机制,确保智能体行动精准合规,同时能在长期工作流中保留上下文,让智能体行动始终保持正确方向。
- **高可扩展性:**开发者可摆脱固有框架束缚,使用完全描述性的底层原语自由定制智能体,轻松设计满足各类需求的可扩展多智能体系统。
- **原生流式支持:**支持逐个 token 流式传输和中间步骤流式输出,实时呈现智能体推理过程,增强交互透明度。
10.3、核心概念
LangGraph 有三个最核心的概念,分别是:State、Node和 Graph,对这几个概念的具体理解如下:
- **State:**状态,其中记录了智能体运行过程中的所有信息,涵盖输入数据、中间计算结果和最终输出,为智能体的持续运行提供上下文。状态内的参数可以在多个节点间保存和流转,是节点间通信的核心机制。
- **Node:**节点,它是构成 LangGraph 的基本单元。每个 Node 可实现特定功能,例如数据处理、逻辑判断或调用外部 API。
- **Graph:**Graph 就是最终的图结构,由众多 Node 通过特定逻辑连接而成,定义了智能体的整体工作流程,各 Node 在其中协同运作,推动 AI Agent 完成复杂任务。
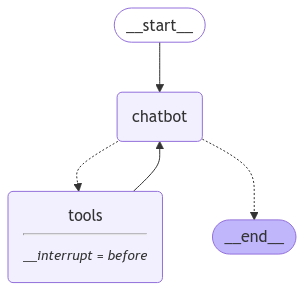
10.4、经典案例
10.4.1、把大象放进冰箱需要几步
- 定义状态
python
from typing import TypedDict

class ElephantState(TypedDict):
    fridge_open: bool
elephant_inside: bool- 处理节点
python
def open_fridge(state: ElephantState) -> ElephantState:
    print("打开冰箱门")
    state["fridge_open"] = True

    return state

def put_elephant(state: ElephantState) -> ElephantState:
    if not state["fridge_open"]:
        raise ValueError("冰箱门未打开, 无法放入大象!")

    print("将大象放入冰箱")
    state["elephant_inside"] = True

    return state

def close_fridge(state: ElephantState) -> ElephantState:
    if not state["elephant_inside"]:
        raise ValueError("大象没有放入冰箱, 不能关闭冰箱门")

    print("关闭冰箱门")
    state["fridge_open"] = False
return state- 定义LangGraph工作流图
python
from langgraph.constants import START, END
from langgraph.graph.state import CompiledStateGraph, StateGraph


def build_graph() -> CompiledStateGraph:
    graph = StateGraph(ElephantState)

    # Node
    graph.add_node("open_fridge", open_fridge)
    graph.add_node("put_elephant", put_elephant)
    graph.add_node("close_fridge", close_fridge)

    # Edge
    graph.add_edge(START, "open_fridge")
    graph.add_edge("open_fridge", "put_elephant")
    graph.add_edge("put_elephant", "close_fridge")
    graph.add_edge("close_fridge", END)

return graph.compile()- 运行工作流
python
def run_workflow():
    graph = build_graph()
    initial_state = ElephantState(fridge_open=False, elephant_inside=False)
    result = graph.invoke(initial_state)

    return result

run_workflow()
10.4.2、百度搜索智能体
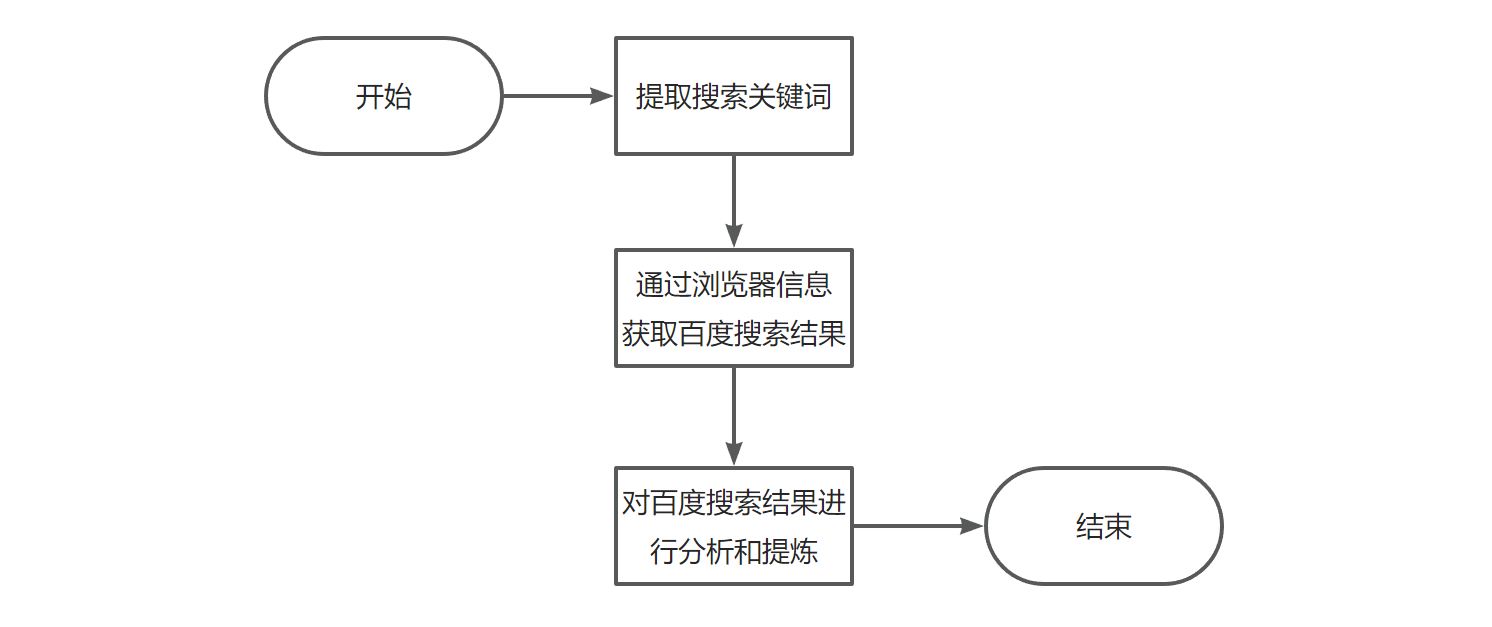
python
import os

from langchain_core.prompt_values import StringPromptValue
from langgraph.constants import START, END
from langgraph.graph import MessagesState, StateGraph

from app.code_agent.mcp.browser_tools import search_in_baidu_with_html
from app.code_agent.model.qwen import llm_qwen

key_extract_query_keyword = "key_extract_query_keyword"
key_search_baidu = "key_search_baidu"
key_replay_user = "key_replay_user"

class BaiduSearchMessageState(MessagesState):
    search_question: str
    search_keyword: str
    search_results: str

def node_extract_query_keyword(state: BaiduSearchMessageState):
    last_message = state["messages"][-1]
    question = last_message.content
    state['search_question'] = question
    prompt = StringPromptValue(text=f"请从如下信息中提取需要在百度中搜索的关键词, 直接返回最终结果: {question}")
    message = llm_qwen.invoke(input=prompt)
    state["messages"].append(message)
    state['search_keyword'] = message.content
    return state

def node_search_baidu(state: BaiduSearchMessageState):
    html = search_in_baidu_with_html(state['search_keyword'])
    state['search_results'] = html
    return state

def node_replay_user(state: BaiduSearchMessageState):
    result = llm_qwen.invoke(input=f"""
# 要求
请结合百度搜索的结果, 回答用户的问题:{state['search_question']}

# 百度搜索结果
{state['search_results']}
""")
    state['messages'].append(result)
    return state

def output_graph_image(graph, filename: str):
    try:
        png_data = graph.get_graph().draw_mermaid_png()

        output_file_dir = os.path.dirname(__file__)
        output_file_path = os.path.join(output_file_dir, filename + ".png")
        with open(output_file_path, "wb") as f:
            f.write(png_data)
            print(f"文件写入成功: {output_file_path}")
    except Exception as e:
        print(e)


state_graph = StateGraph(BaiduSearchMessageState)
state_graph.add_node(key_extract_query_keyword, node_extract_query_keyword)
state_graph.add_node(key_search_baidu, node_search_baidu)
state_graph.add_node(key_replay_user, node_replay_user)

state_graph.add_edge(START, key_extract_query_keyword)
state_graph.add_edge(key_extract_query_keyword, key_search_baidu)
state_graph.add_edge(key_search_baidu, key_replay_user)
state_graph.add_edge(key_replay_user, END)

compiled_graph = state_graph.compile()
# output_graph_image(compiled_graph, "graph")


results = compiled_graph.stream({
    "messages": [("user", "请问邯郸今天天气如何?")]
})

for s in results:
    key = list(s)[0]
    print(s[key]["messages"][-1].content)
    print("-" * 60)
10.5、多智能体
LangGraph 的强大之处在于可以让多个智能体协同形成一个强大的工作流,由智能体来调度工作流的执行:
https://langchain-ai.github.io/langgraph/concepts/multi_agent
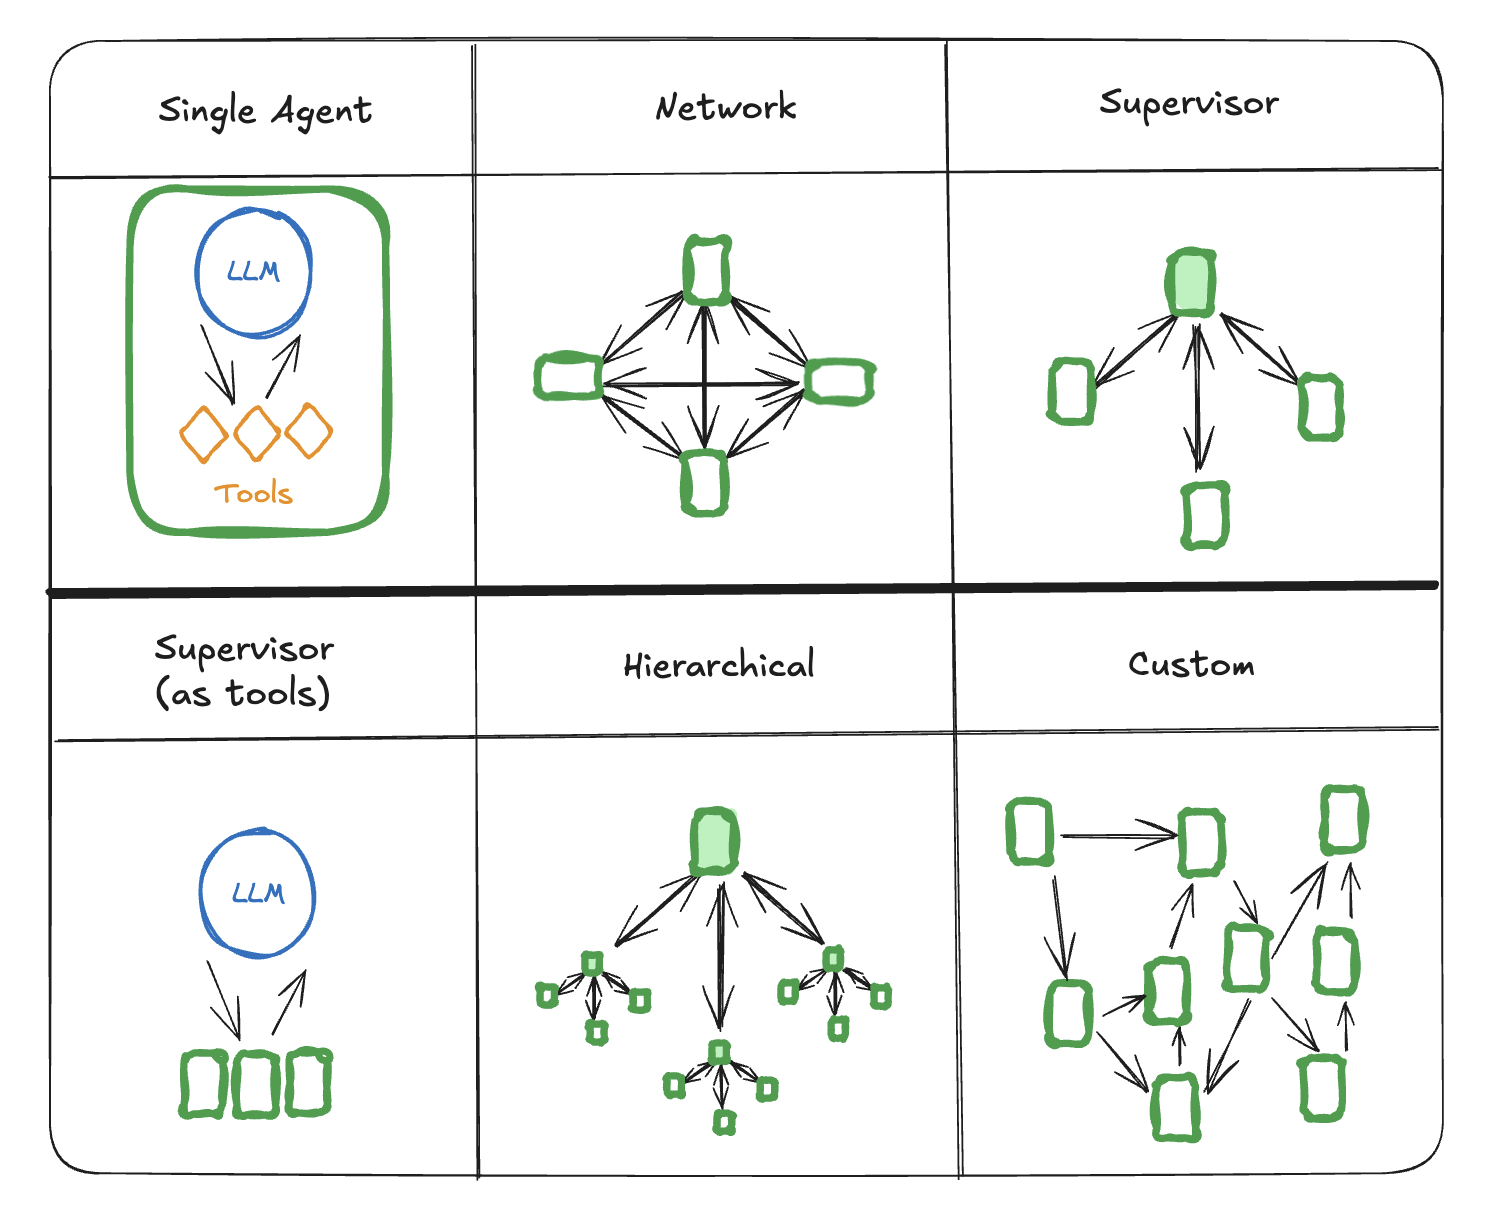
Hierarchical=多个Supervisor
Supservisor架构:
核心:
python
workflow = create_supervisor(
    agents=[math_agent, research_agent],
    model=llm_qwen,
    prompt=(
        "You are a team supervisor managing a research expert and a math expert. "
        "For current events, use research_agent. "
        "For math problems, use math_agent."
    )
)
完整代码:
python
from langchain_core.messages import convert_to_messages
from langgraph.prebuilt import create_react_agent
from langgraph_supervisor import create_supervisor

from app.code_agent.model.qwen import llm_qwen

def pretty_print_messages(update, last_messages=False):
    # items() 把tuple转换成map数组
    # print(update.items())
    for node_name, node_update in update.items():
        update_label = f"update from node {node_name}"
        print(update_label)

        # 转换成message数组
        messages = convert_to_messages(node_update['messages'])
        if last_messages:
            messages = messages[-1:]

        for message in messages:
            pretty_message = message.pretty_repr(html=True)
            print(pretty_message)

        print("\n\n")


def add(a: float, b: float) -> float:
    """add two numbers"""
    return a + b

def multiply(a: float, b: float) -> float:
    """multiply two numbers"""
    return a * b

def web_search(query: str) -> str:
    """Search the web for information."""
    return (
        "Here are the headcounts for each of the FAANG companies in 2024:\n"
        "1. **Facebook (Meta)**: 67,317 employees.\n"
        "2. **Apple**: 164,000 employees.\n"
        "3. **Amazon**: 1,551,000 employees.\n"
        "4. **Netflix**: 14,000 employees.\n"
        "5. **Google (Alphabet)**: 181,269 employees."
    )

math_agent = create_react_agent(
    model=llm_qwen,
    tools=[add, multiply],
    name="math_agent",
    prompt="你是一个数学专家, 一次执行只使用一个工具"
)

research_agent = create_react_agent(
    model=llm_qwen,
    tools=[web_search],
    name="research_agent",
    prompt="你是一个世界级的调研专家,能够使用web_search工具,不要使用任何数学工具"
)

workflow = create_supervisor(
    agents=[math_agent, research_agent],
    model=llm_qwen,
    prompt=(
        "You are a team supervisor managing a research expert and a math expert. "
        "For current events, use research_agent. "
        "For math problems, use math_agent."
    )
)

app = workflow.compile()

for chunk in app.stream({
    "messages": [
        {
            "role": "user",
            "content": "what's the combined headcount of the FAANG companies in 2024?"
        }
    ]
}):
    pretty_print_messages(chunk, last_messages=True)
十一、多智能体实战
11.1、搭建Supervisor架构的多智能体
python
import asyncio

from langchain_core import agents
from langchain_core.messages import convert_to_messages
from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.memory import MemorySaver
from langgraph.prebuilt import create_react_agent
from langgraph_supervisor import create_supervisor

from app.bailian.common import file_tools
from app.code_agent.model.qwen import llm_qwen
from app.code_agent.tools.shell_tools import get_stdio_shell_tools


def pretty_print_messages(update, last_messages=False):
    # items() 把tuple转换成map数组
    # print(update.items())
    # for node_name, node_update in update.items():
    #     update_label = f"update from node {node_name}"
    #     print(update_label)

    # 转换成message数组
    # messages = convert_to_messages(node_update['messages'])
    messages = convert_to_messages(update['messages'])
    if last_messages:
        messages = messages[-1:]

    for message in messages:
        pretty_message = message.pretty_repr(html=True)
        print(pretty_message)

    print("\n\n")


async def run_agent():
    memory = MemorySaver()
    shell_tools =await get_stdio_shell_tools()

    research_agent = create_react_agent(
        model=llm_qwen,
        tools=shell_tools + file_tools,
        name="research_export",
        prompt="你是一个技术主管, 负责设计技术方案, 请不要直接写代码, 请指导 code_agent 进行工作"
    )

    code_agent = create_react_agent(
        model=llm_qwen,
        tools=shell_tools + file_tools,
        name="code_expert",
        prompt="你是一个编程专家, 请根据 research_export 设计的技术方案来实现代码或进行代码文件相关的操作"
    )

    supervisor_agent = create_supervisor(
        agents=[research_agent, code_agent],
        model=llm_qwen,
        prompt=(
            "You are a team supervisor managing a research expert and a code expert."
            "For task planning and task researching, use research_agent."
            "For code problems, use code_agent."
        )
    )

    app = supervisor_agent.compile(checkpointer=memory)

    while True:
        user_input = input("用户: ")

        if user_input.lower() == "exit":
            break

        config = RunnableConfig(configurable={"thread_id": 1}, recursion_limit=100)

        # async for chunk in app.astream(input={"messages": user_input}, config=config):
        #     print(chunk)
        result = await app.ainvoke(input={"messages": user_input}, config=config)
        pretty_print_messages(result)

asyncio.run(run_agent())
11.2、通过智能体生成前端代码
都是通过code_agent.py生成的
bash
1.把 https://gitee.com/youlaiorg/vue3-element-admin.git 项目 clone 到 D:\workspace\python\learning\ai-agent-test\.code
2.新建 "图书管理" 独立的菜单
3.在图书管理中 删除库存字段,增加链接字段, 点击连接后可以跳转到一个新的页面
4.在图书管理中 增加电子书的封面 允许上传本地本地图片文件
5.创建 imooc_ebook 数据库
6.做 imooc_ebook 数据库中创建 book 表, 字段包括 id(自增)、封面图片、书名、作者、ISBN、出版社、价格、链接、创建时间、更新时间、分类、出版时间、状态
7.使用 immoc_ebook 数据库中的 book 表, 向 book 中插入20条测试数据,真实一点,然后封面图片最好也是真实的,创建时间和更新时间都用当前时间
11.3、通过智能体生成后端代码
bash
1.在D:\workspace\python\learning\ai-agent-test\.code 目录中创建文件夹 imooc-ebook-api 用于后端项目,  后端项目使用 node+express 技术栈
2.把后端拿项目的端口好改成9000
3.后端项目代码:D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api  编写node代码连接mysql数据库,连接字符串: MYSQL_CONFIG = {'host': '192.168.230.128','port': 3306,'user': 'root','password': 'root','charset': 'utf8mb4',}
4.后端代码地址:D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api,创建一个新的测试接口,用来验证db是否能够连接,并提供curl语句,让我来测试
5.后端代码地址:D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api,编写 /api/books 接口 要求能够连接 imooc_ebook 数据库下的 book表,并提供curl语句 让我来测试
6.后端代码地址:D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api,"更新数据信息"的接口 当更新值为空的时候 忽略更新的字段,并提供curl语句 让我来测试
7.后端代码地址:D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api,获取所有数据接口 增加对筛选项、排序、翻页功能的支持 ,并提供curl语句 让我来测试
8.后端代码地址: D:\workspace\python\learning\ai-agent-test\.code\imooc-ebook-api,前端代码地址:D:\workspace\python\learning\ai-agent-test\.code\vue3-element-admin,后端已经实现图书管理的接口了,然后把前端 图书管理 模块 改成后端接口,如果少了某个接口补全后端接口
目前已经学习了
- 提示词:
PromptTemplate, ChatPromptTemplate, ChatMessagePromptTemplate, FewShotPromptTemplate - 结构化数据:
StrOutputParser, CommaSeparatedListOutputParser, JsonOutputParser - 绑定工具:装饰器 + 原始方式
- MCP的三种通信方式 + Cursor绑定MCP
- Runnables:串行、并行、透传、分支、函数、多轮对话
- Agent记忆能力:内存、Redis、MongoDB、FileSaver
- Agent终端控制能力:
- subprocess:执行shell命令
- Mac脚本:osascript执行runScript操作Mac软件,run_applescript操作终端
- Powershell:subprocess执行shell命令,psutil操作进程,pyautogui模拟键鼠操作
- 接入阿里百炼知识库
- 查询知识库内容
- 上传文件到知识库指定类名
- 查询知识库、创建知识库、追加知识文件到知识库
- 浏览器控制:ChromeDriver
- Agent运行沙盒
- 接入Myql:CRUD + 查询数据库、表、表结构
- Langgraph的入门及多Agent的架构
- 用自己开发的Agent实现了编程开发