当前,大模型正加速进入真实应用场景。
伴随模型能力提升,模型评测也面临新的挑战:部分高难度评测集存在题目或答案错误的情况。同时,一些评测集上模型表现逐渐趋于稳定,前沿模型能力差异难以得到有效区分。而长期固定的评测题目一旦被纳入训练数据,模型取得高分也并不能准确反映其实际能力,评测结果可能因此失真。
行业需要的,是更准确、更可信,且能够持续区分模型能力的高质量评测基准。
围绕这一挑战,晓天衡宇亮相 2026 云栖大会,分享了对"什么是好评测"的思考,以及评测基准、裁判模型、真实任务评测及开放评测社区等实践成果。
评模型之前,也要评评测
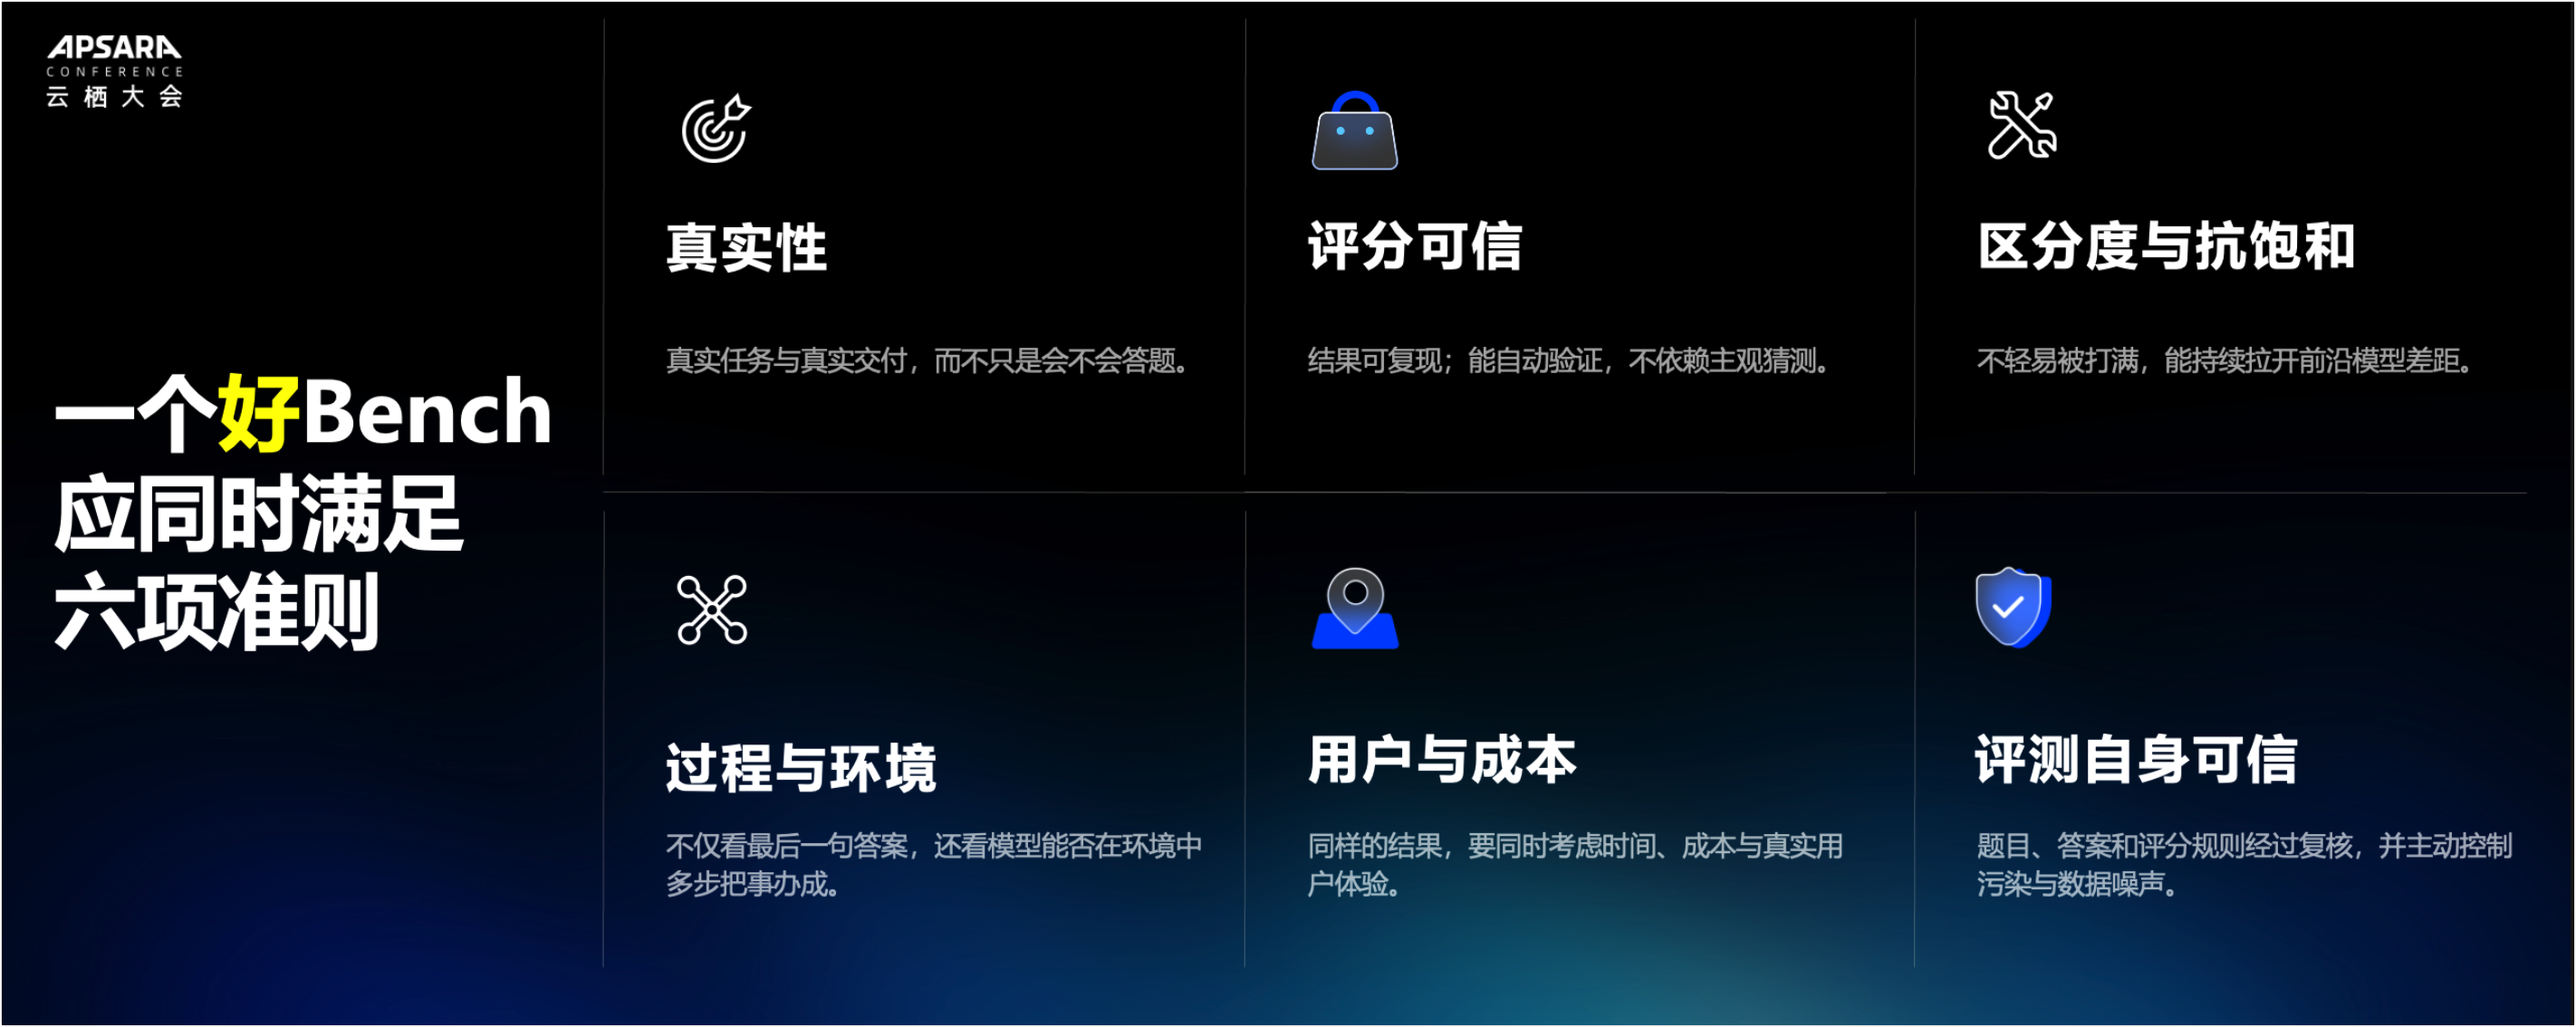
什么样的评测才是好评测?
晓天衡宇认为,好评测要能准确、稳定、诚实地验证模型在真实任务中的能力。
这意味着,评测不能只停留在选择题和单轮问答,更要走向真实任务交付,在具体环境中考量模型的实际表现,还应将任务耗时、成本和用户体验纳入考量。
同时,评分应尽可能做到可验证、可复现,针对不同评测任务,应在自动验证的基础上结合 Agent 裁判与人工复核,减少主观判断带来的偏差。
评测本身也需要经得起检验:题目、答案和评分规则需持续复核,主动识别数据污染与评测噪声等问题。评测还需要保持对前沿模型的区分能力,避免评测结果饱和。
基于上述关于好评测的思考,晓天衡宇从两个层面展开探索:一方面建立衡量评测集的可量化框架,另一方面则通过对具体评测集的复核与修订,将这些准则落实到实践中。
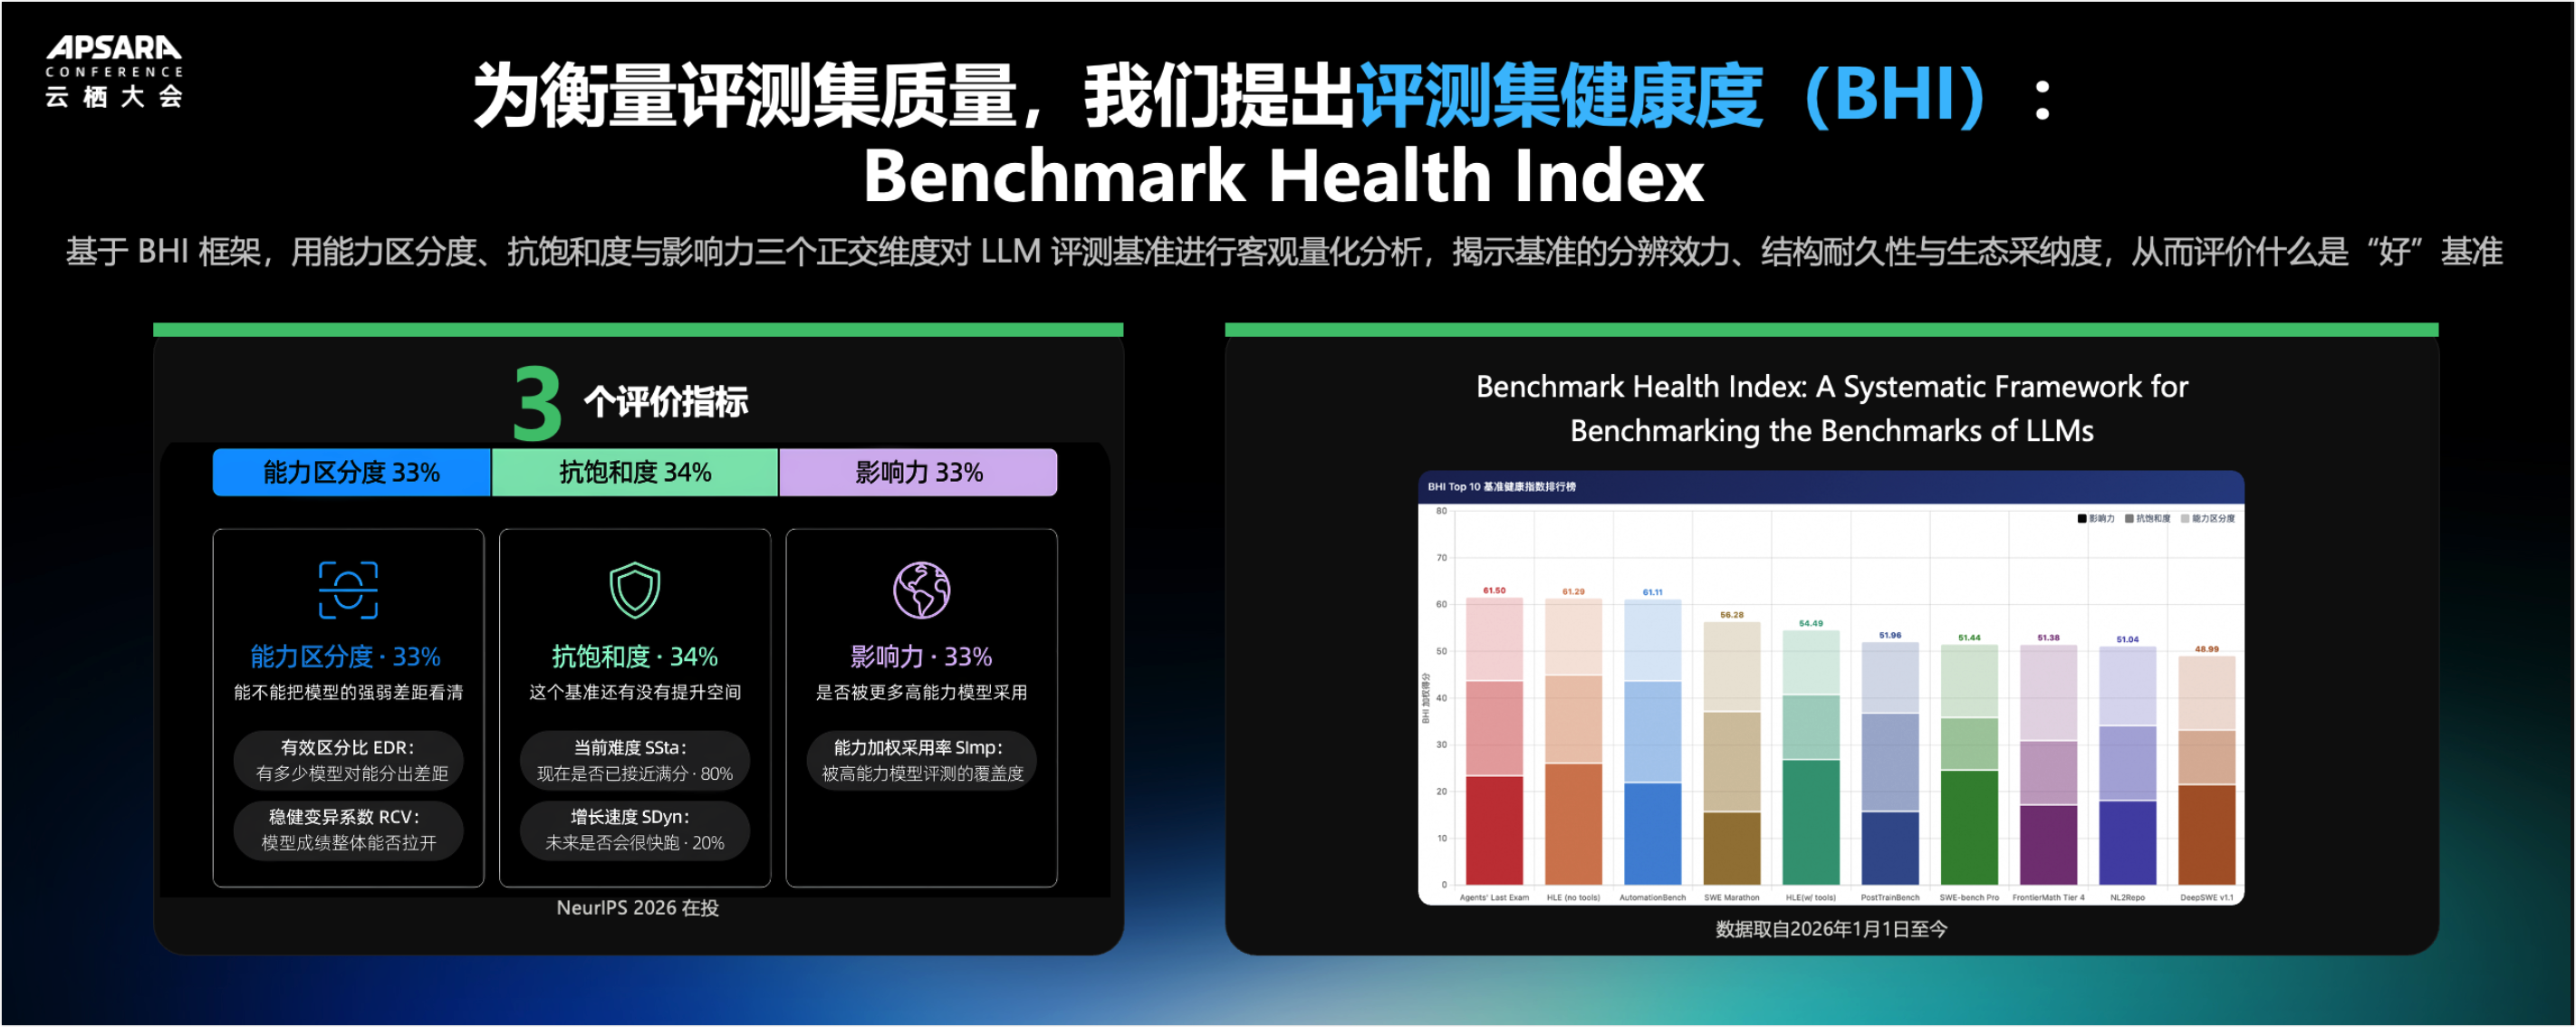
在量化框架层面,晓天衡宇提出评测集健康度(Benchmark Health Index),从能力区分度、抗饱和度与影响力三个维度,对大模型评测基准进行量化分析,衡量其分辨效力、结构耐久性和生态采纳度。
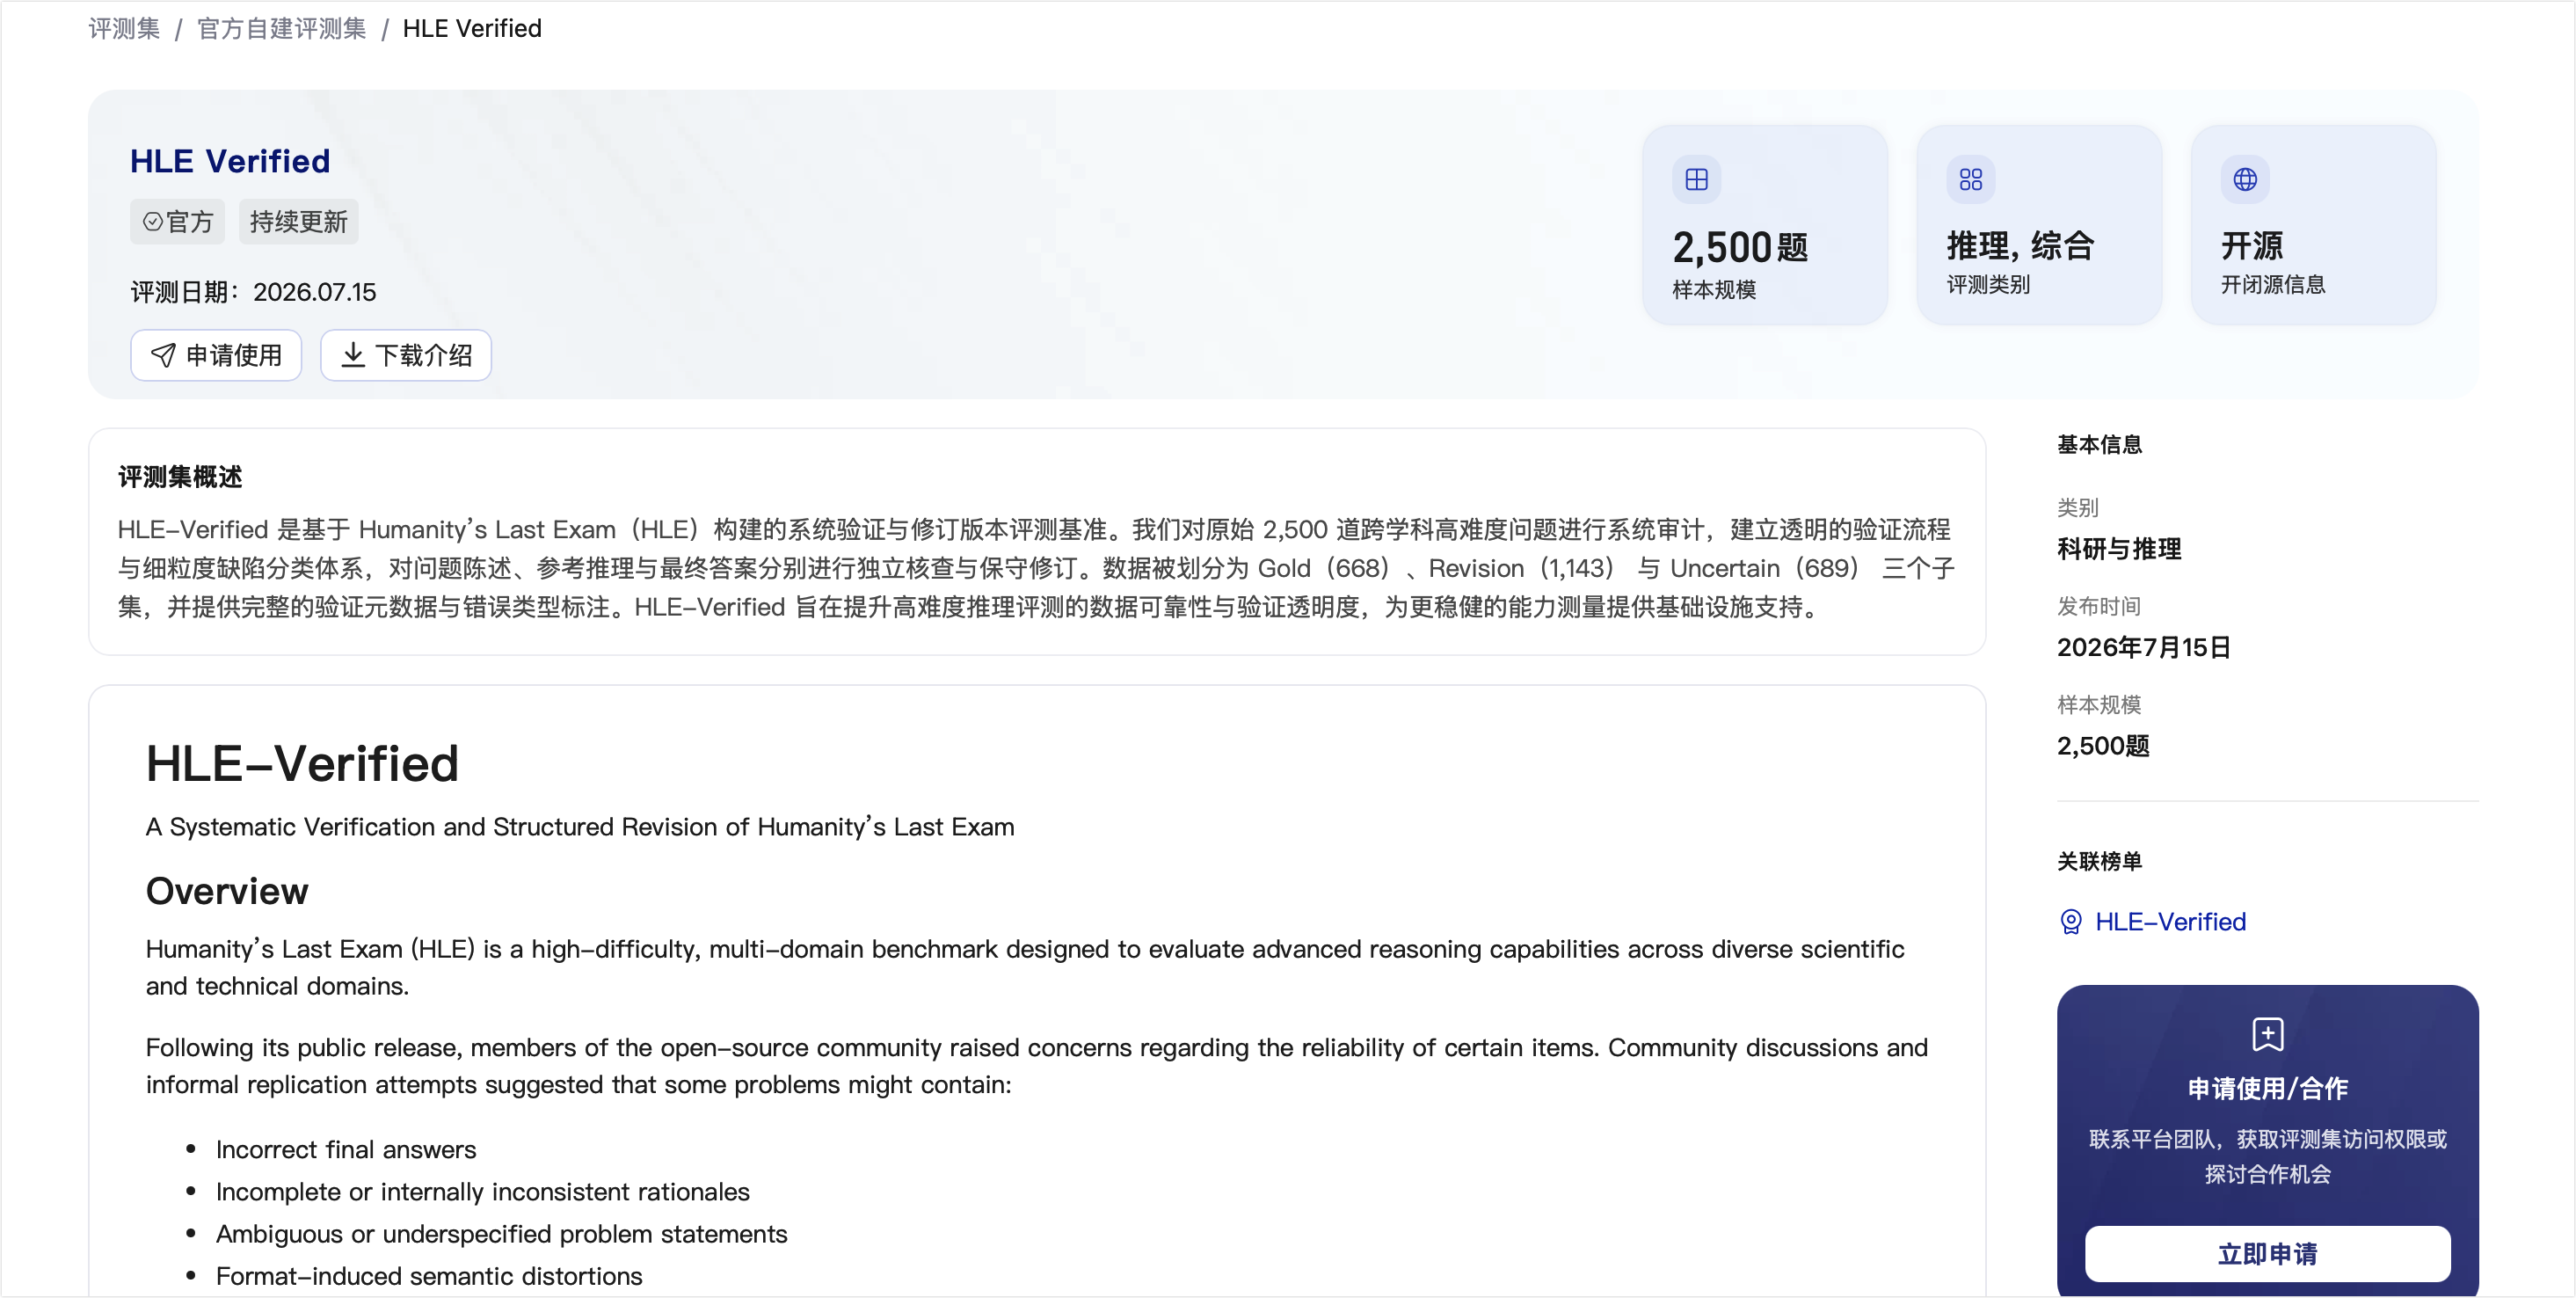
在评测集可靠性层面,晓天衡宇推出了 HLE-Verified 自建评测集,对高难度、跨学科评测基准"Humanity's Last Exam"进行系统化复核:先通过多模型诊断性求解定位疑似问题,再由领域专家独立修订,最后通过多模型交叉验证复核,从而减少题目与参考答案错误对评测结果造成的干扰。
评测结果显示,纠错后多款模型得分平均提升 7-10 个百分点,相关成果已被 Google、ByteDance 等多家模型厂商引用。
截至目前,晓天衡宇已构建 30 余个评测集,形成 11 篇相关论文,持续验证并完善评测方法。
好评测,更需要好裁判
高质量的评测不仅要解决怎么测,还要解决怎么判。
文生图、图像编辑、语音合成、多步推理等开放式任务往往难以通过标准答案或固定规则验证,而人工评审还面临成本高、周期长、主观判断存在偏差等问题。
为此,晓天衡宇上线了开源裁判模型矩阵,为多类评测任务提供专业、开放的评测工具。
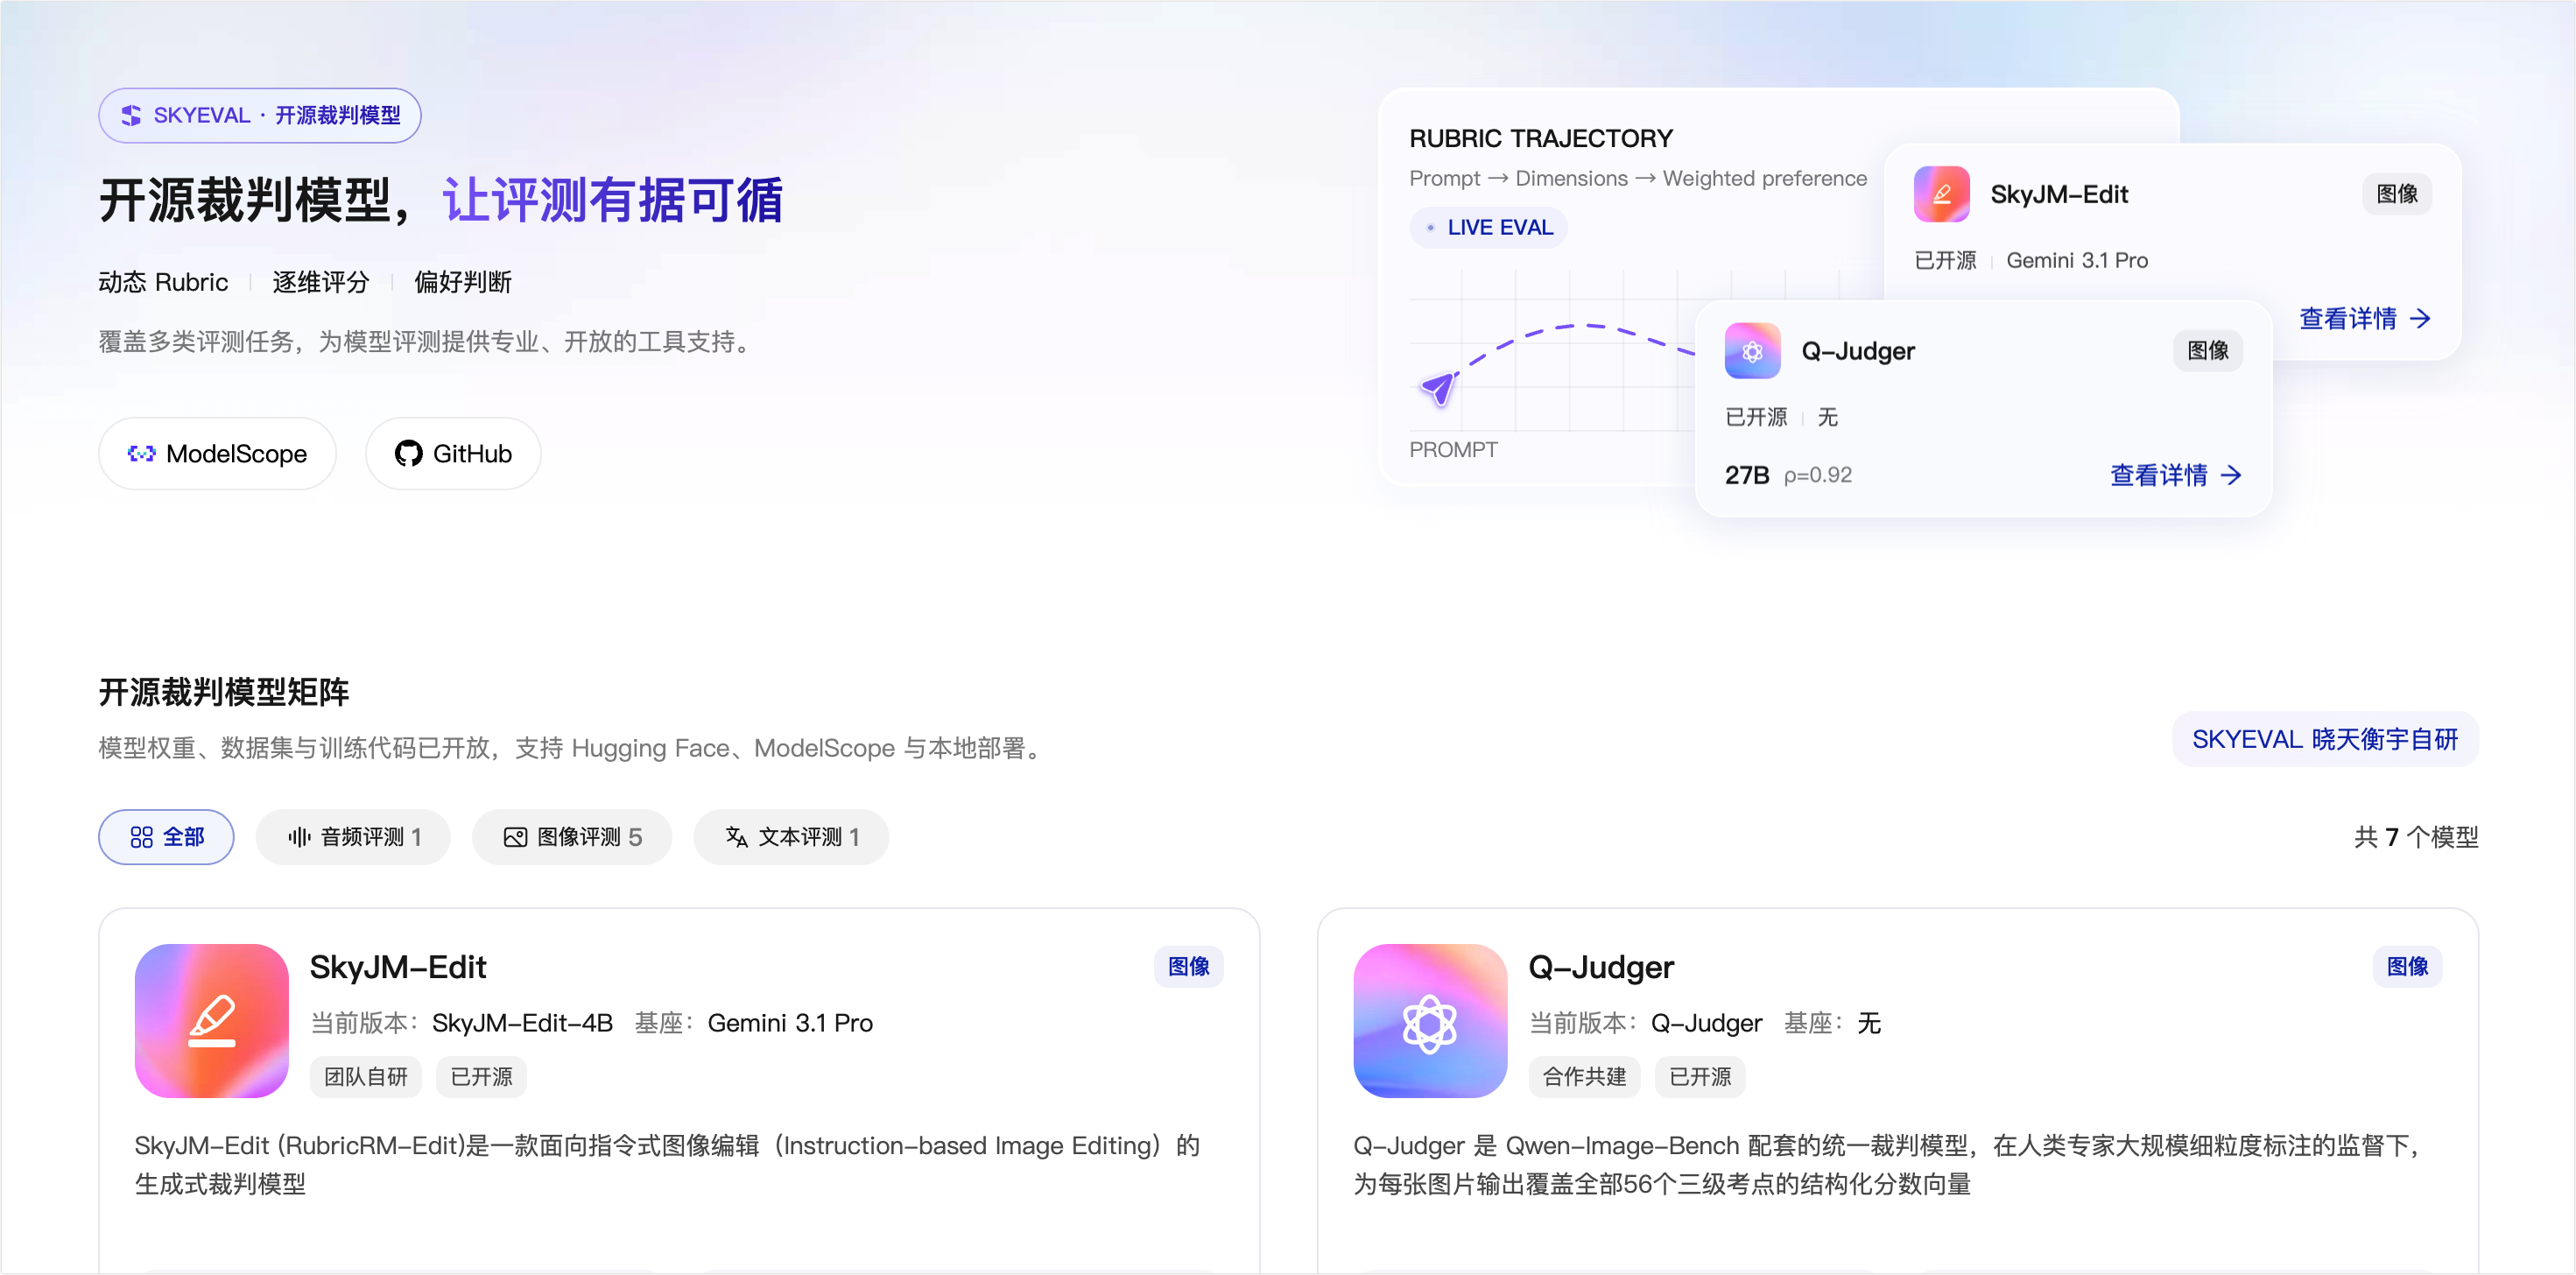
在图像生成与编辑场景中,SkyJM-Gen 和 SkyJM-Edit 两款生成式裁判模型可根据每条具体指令动态生成评分 Rubric,分别从生成质量、指令对齐和内容保留等维度进行判断。
文生图裁判模型 Q-Judger 则面向真实创作场景,在画面质量、美学与图文对齐之外,进一步加入真实世界还原与创意生成评判维度,并通过 56 项细粒度标准自动诊断模型生成能力。其整体排序与人工专家判断高度一致。
面向复杂推理任务,全局视角过程奖励模型 GPRM-4B 则融合了细粒度评估与全局洞察力,在判断单个步骤时,同时考察历史过程、后续步骤和任务目标,从而减少脱离完整推理链路进行孤立评分的情况。
从动态评分标准、细粒度诊断到全局过程建模,晓天衡宇不断提升自动评测工具在复杂任务中的判断力,更有效地衡量模型表现。
WorkEval,衡量 Agent 真实工作能力
当 Agent 走进职场,有效的评测需要体系化回答一个关键问题:它们是否真的能将一项工作做好,而不仅仅是做完。
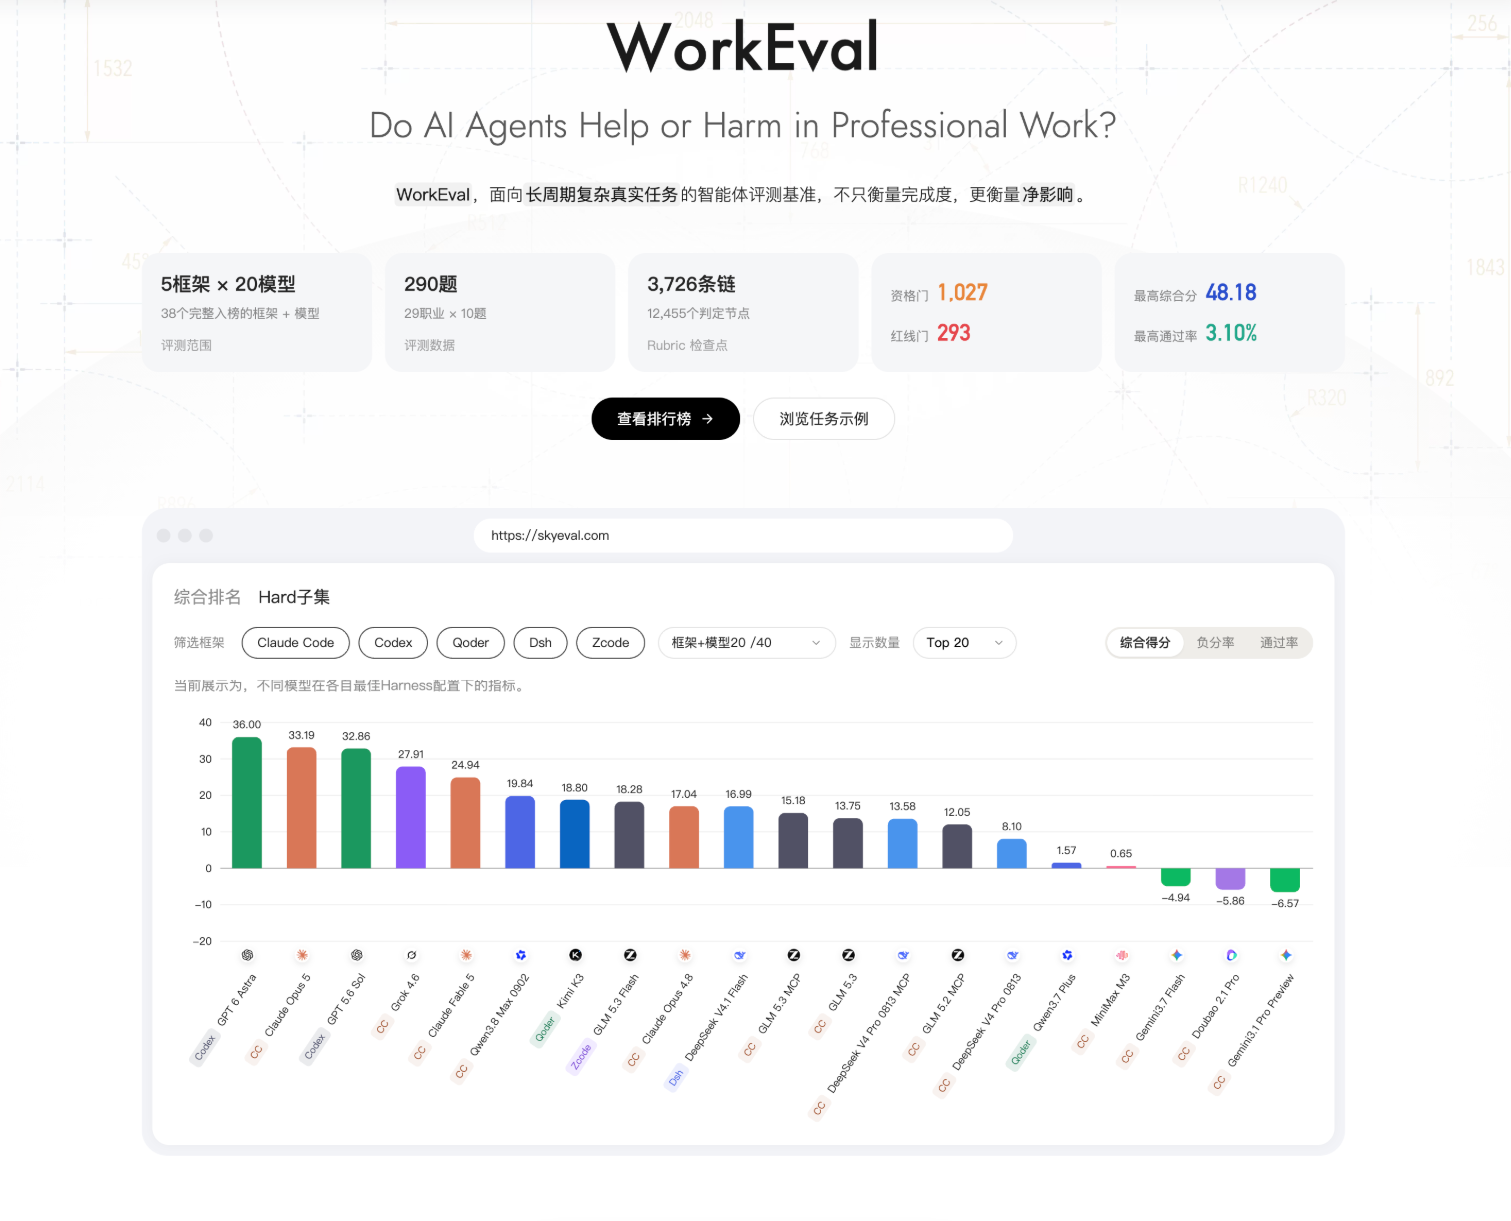
WorkEval 正是晓天衡宇面向模型实际落地价值的一次具体实践。评测覆盖中国职场 29 个职业,共 290 个真实任务。该评测基于自研 NAV 净可采用值衡量 Agent 的交付结果,也将完成任务所需时间、资源与成本等效率指标纳入考虑,观察 Agent 能否真正完成一项工作。
评测结果显示,更高的资源消耗并不必然带来更好的任务结果。评判 Agent 实际应用价值时,比起单纯比较分数,更值得关注的是模型与运行环境的组合、完成任务的效率以及负任务比例。
晓天衡宇评测社区,让评测结果更可感知
专业的模型评测不能止步于榜单数字与模型名次,更要成为理解模型能力、进行模型选型和应用决策的可靠依据。
围绕这一目标,晓天衡宇评测社区面向开发者、研究者及模型用户,持续建设覆盖榜单、竞技场、评测集、评测工具与评测资讯的评测内容体系。
榜单提供稳定、可比较的模型能力参照;竞技场则将模型置于真实、开放的多样化动态任务中,观察模型在不同场景下的实际表现;评测集、评测工具与评测资讯补充了评测依据、方法与解读,构成从结果到依据、从能力衡量到应用参考的完整价值链。
晓天衡宇
晓天衡宇评测社区海外版 skyeval.ai 也已正式上线,进一步面向海外市场,为全球用户提供模型评测与能力观察。
结语
从评测集质量的衡量与提升,到评测方法与裁判工具的探索;从真实任务中的模型能力验证,到评测结果的应用转化,晓天衡宇始终探索一个核心问题:什么样的评测,真正值得相信。
未来,晓天衡宇将持续完善评测基准、方法与应用体系,为行业提供更加系统的模型能力参考与决策依据,回应 AI 落地加速过程中不断涌现的新命题。