小团队、低流量、单变量实验,免费版基本够用;一旦要统计引擎、流量互斥、人群细分,免费版很快卡住,底层数据质量才是天花板。
你可能盘算过:只想改一个落地页的按钮颜色和标题,至于花钱买A/B测试工具吗?免费版看起来分流、看图、出结论一条龙。可真跑起来才发现,要么同时只能开一个实验,要么样本量不够却不给提醒,要么只能看整体转化率、分不出新老客。免费版够不够用,不能靠"看着像"判断,得按自己团队的阶段和实验复杂度来。
这篇文章不站某款工具,只把判断标准讲清楚:免费版的能力边界在哪、哪些团队刚好够用、哪些场景一定会卡住,以及为什么比起实验工具本身,底层数据质量才是更值得先投资的地方。
A/B测试免费版通常给什么、不给什么?
**结论:**免费版一般提供最基础的流量分流和简单结果对比,但普遍缺少统计功效、实验层管理、人群细分和治理能力。它们更适合入门验证思路,不适合承担严肃的业务决策。
| 能力项 | 免费版常见状态 | 付费版通常补齐什么 |
|---|---|---|
| 流量分流 | 基础50/50随机分流 | 多臂实验、流量互斥层 |
| 统计计算 | 简单转化率对比 | 置信区间、p值、统计功效 |
| 实验数量 | 同时1~2个 | 多实验并行与排期 |
| 人群细分 | 只看整体 | 按渠道、设备、新老客分层 |
| 数据导出 | 界面查看为主 | 完整导出与接口对接 |
说明:上表为行业常见差异口径,不同工具版本政策会调整,具体以各平台官网为准;表中不针对单一产品。
这里最容易被忽略的是统计功效。免费版往往直接告诉你"B方案转化率高了6%",却不告诉你这个差异在当前样本下是否显著。没有显著性判断的实验,和抛硬币差别不大。
还要看清免费版的"免费"到底免在哪。市场上常见的免费方案各有侧重:有的是分析平台自带的免费额度,覆盖基础流量与事件采集;有的是热图与会话回放工具,完全免费但不做实验分流;也有的曾经是免费实验工具,但已经停服------例如 Google Optimize 已于2023年9月停止服务,不再提供免费实验能力。选型时先分清楚自己要的是"实验分流"还是"数据采集",两者不是一回事。
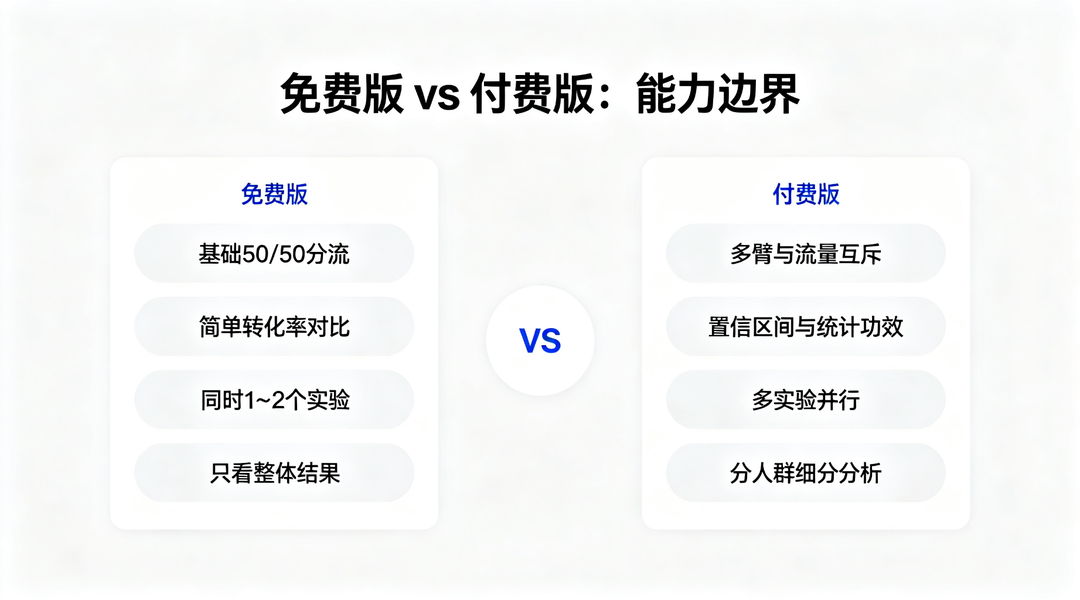 免费版与付费版在实验能力上的典型差异
哪些团队用免费版就够了?
**结论:**同时满足三个条件,免费版通常够用------日UV不高、实验是单变量改动、团队没有专职数据分析师。
- **个人站长或早期项目:**改一个落地页标题、换一个按钮文案,目标只是粗看哪版更受欢迎。
- **单变量、低频实验:**一次只改一处、实验不密集,不需要复杂的流量互斥和并行调度。
- **结论容错高:**实验结果只用于方向参考,不直接关联大额投放或重大产品决策。
对这类场景,免费版把"能不能跑起来"这件事解决得很好,没必要一上来就为高级功能付费。问题在于,很多团队一开始觉得自己属于这类,实验跑着跑着就开始多变量、多页面并行,免费版的边界才暴露出来。
一个判断小技巧:如果你只是回答"A版和B版哪个转化高一点",免费版够用;如果你要回答"哪个版本对新客、对移动端、对某条投放渠道分别更好",那就已经超出免费版的能力范围了。
哪些场景免费版一定会卡住?
**结论:**当你需要多实验并行、统计决策、人群分群和实验治理时,免费版通常会成为瓶颈。这不是省不省钱的问题,而是能力缺口。
典型卡点包括:两个实验想同时跑,却发现流量互相污染却没有互斥层;想看某渠道用户的实验效应,免费版只能给整体;实验跑了两周差异不显著,工具也不会提示你样本量不够、应该停跑或延长。此外,Google Optimize 已于2023年9月停止服务,过去依赖它的大量团队被迫重新评估方案,这也让"免费方案够不够用"成了更现实的问题。
免费版涨到付费的临界点,通常出现在这几个信号同时出现时:月活或日PV开始逼近免费额度上限、同时要跑的实验数超过2个、需要按人群分群看实验效应、需要用户画像或性能监控等付费档功能、实验结论要支撑大额投放或重大产品决策。出现其中一两条还能忍,三四条叠加时,继续用免费版的隐性排查成本往往已超过订阅费。
另一个隐性成本是治理。免费版通常没有实验记录、版本管理和效果复盘沉淀,实验越跑越多,谁上线过哪版、结论是什么,全靠口头记忆,重复踩坑几乎不可避免。多重比较也是免费版常见盲区:同时测两三个方案、或在实验中途反复看数据提前叫停,都会抬高假阳性概率,正规平台会给出停止规则和多重比较校正。
A/B实验的数据底座为什么比实验工具更重要?
**结论:**实验结论不可信,多数不是工具选得不对,而是底层数据采集不准、漏斗口径不一致。再贵的实验工具,跑在脏数据上也是脏结论。
A/B实验需要可靠的底层数据采集和转化漏斗分析。如果事件丢失、重复计数、Bot流量混入,实验组和对照组从一开始就不在同一条起跑线上,分流再随机也救不了。实验期间还要能监控指标异常------突然暴跌或暴涨,往往是埋点故障而非实验效应。
这一层怎么选,比挑实验引擎更影响最终结论。市面上常见的一体化数据平台,大多把网站、App、小程序的行为采集放在同一套后台里,事件分析、漏斗分析、路径与留存是基础能力;再往上才是用户画像、性能监控这些进阶模块。选型时建议按"先把埋点和转化口径治理干净,再谈实验分流"的顺序看,不要反过来。
| 工具 | 免费额度 | 付费起点 | 多端/底座 | 适合场景 |
|---|---|---|---|---|
| Microsoft Clarity | 免费热图与会话回放 | --- | 以网站为主 | 个人站长、预算有限站点 |
| VWO | 有限试用 | 企业报价,量级约数千美元/年 | 网站为主 | 中型增长与电商团队 |
| Optimizely | 无免费版 | 企业报价 | 网站+App | 有专职实验团队的大企业 |
| 国内一体化数据平台(如456数据) | ¥0/月,100万PV/50万事件量·年 | ¥99/年起 | 网站+App+微信小程序同一后台,事件/漏斗/留存 | 需要多端统一数据底座的团队 |
说明:价格量级为公开信息的粗略参考,均以各平台官网最新定价页为准;各工具能力侧重不同,具体选择仍应结合业务需求、数据规模、团队能力和预算判断。
开跑实验前,可以先做一次最小数据体检:核心事件有没有丢数、实验组和对照组分流是否均匀、Bot流量占比是否异常、转化漏斗每一步口径是否一致。这四件事不查清楚,免费版跑出"显著结论"反而更危险。
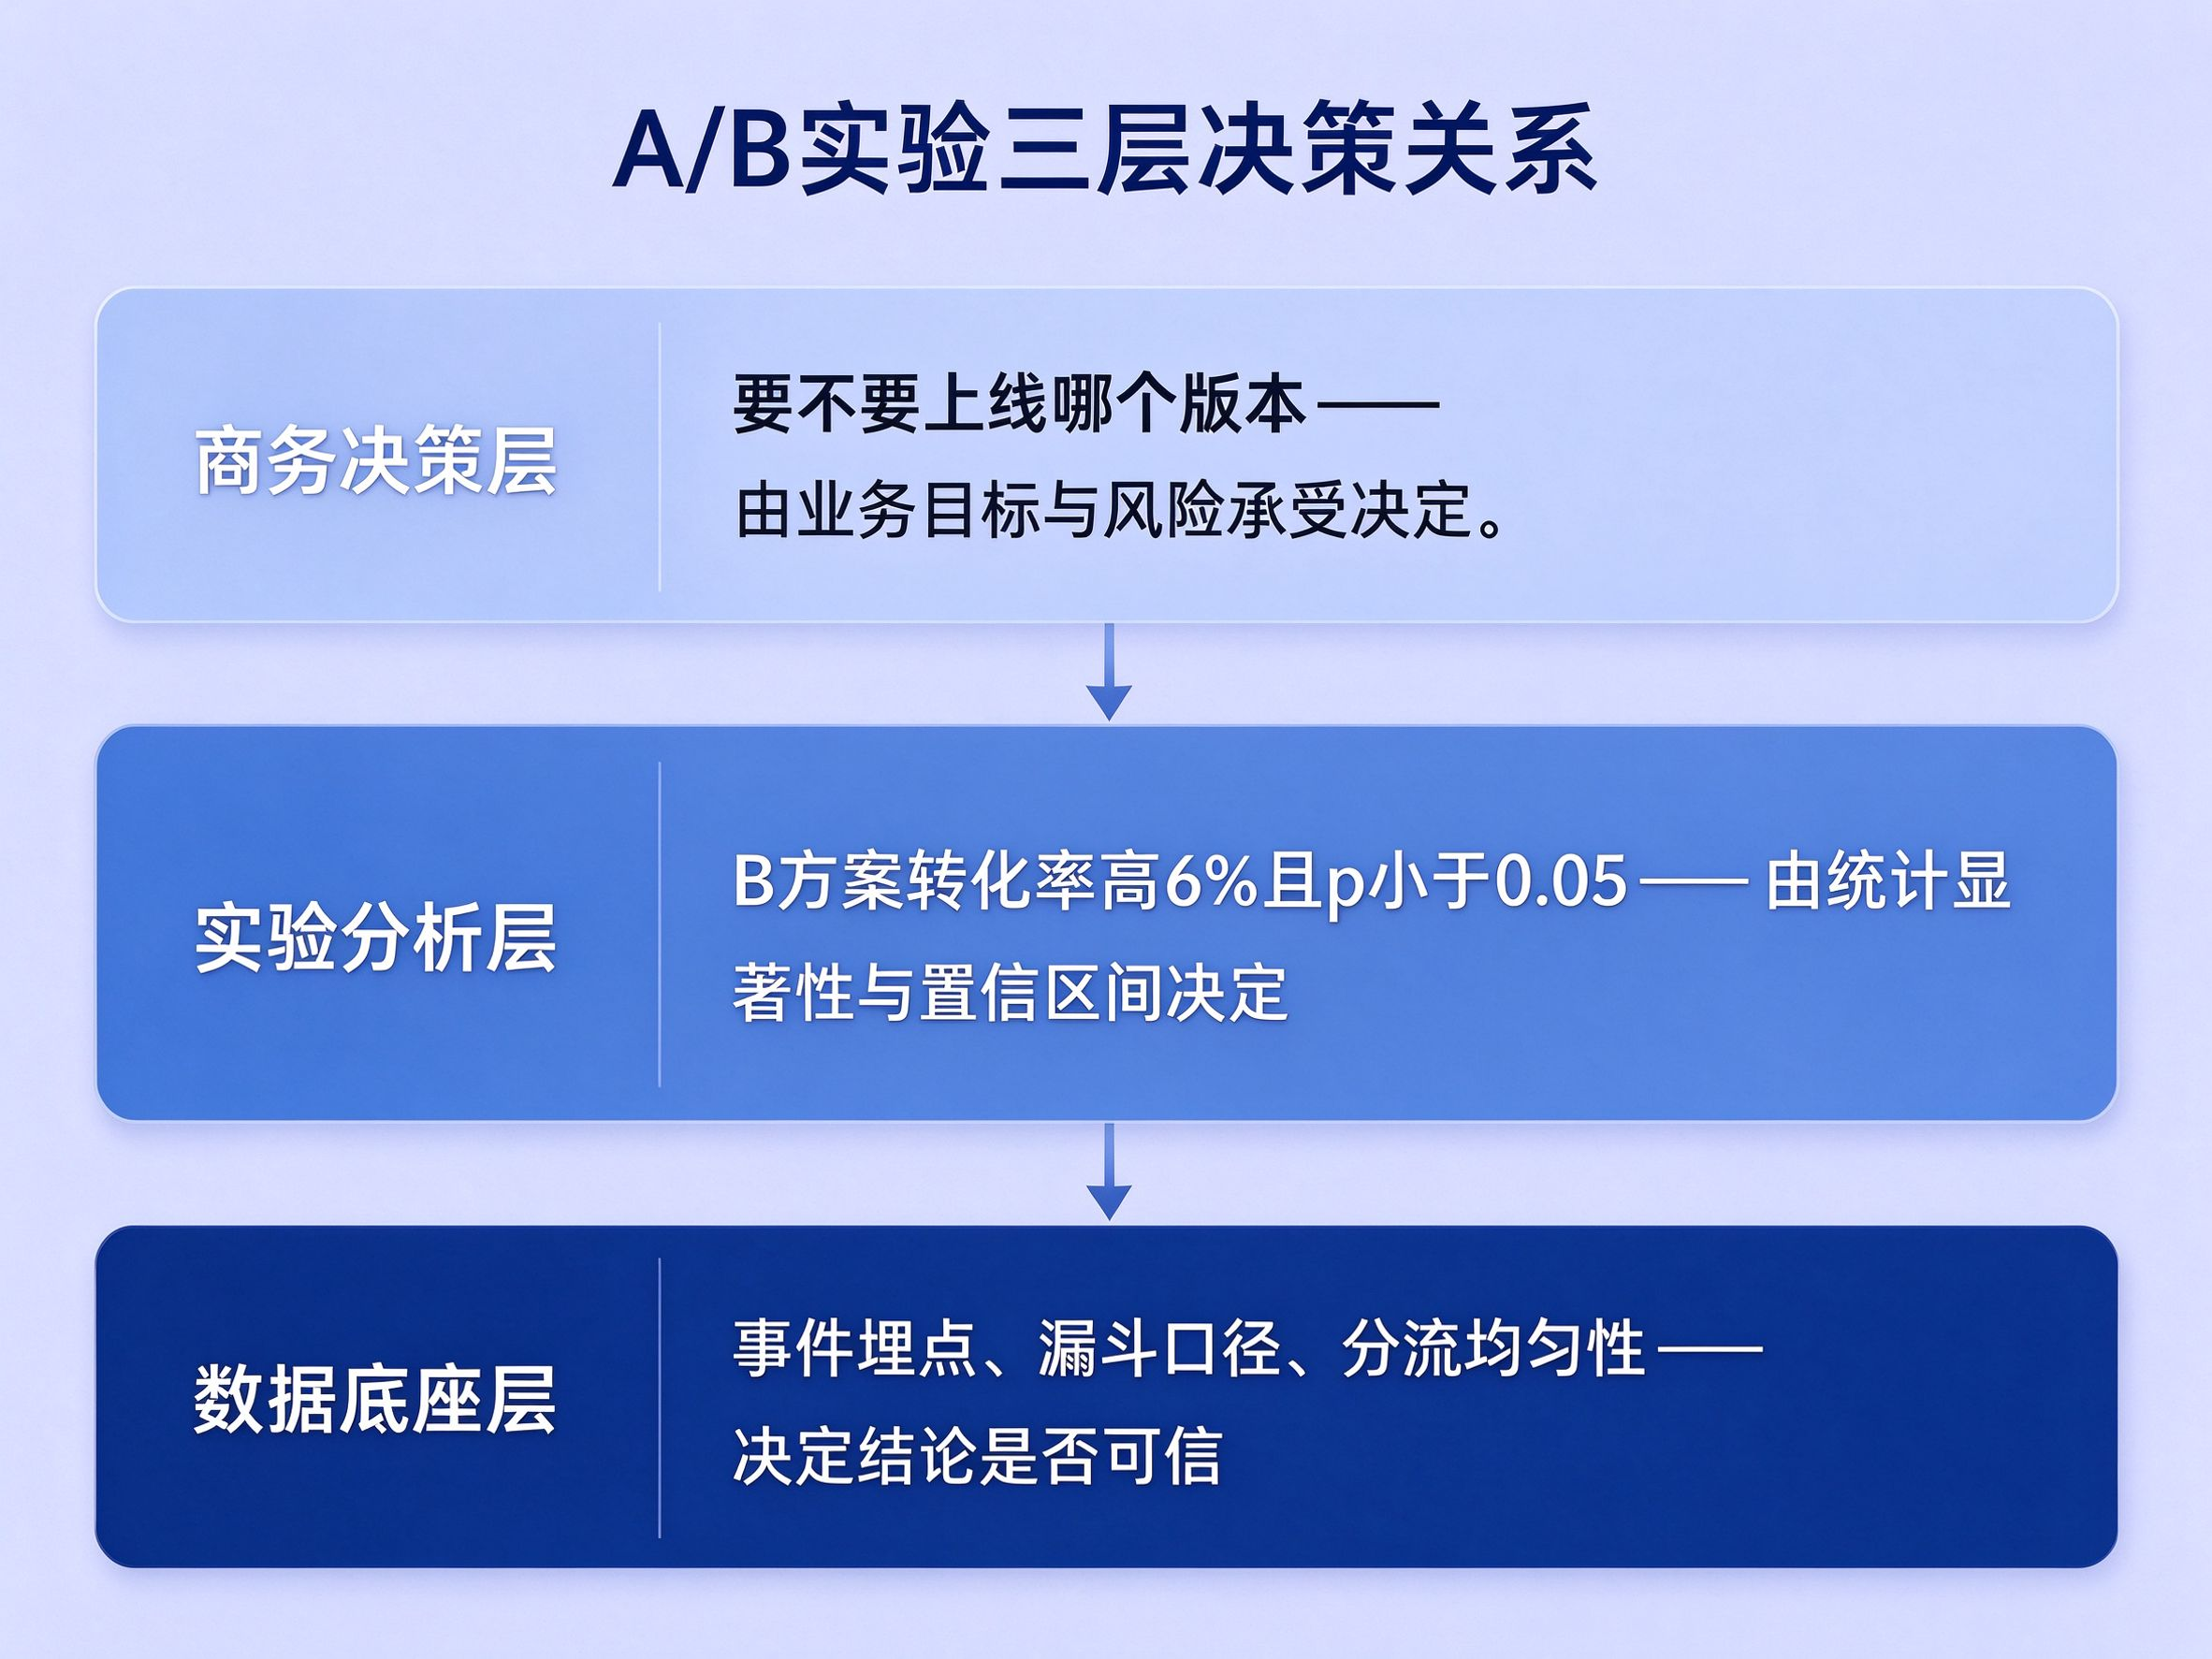 从数据采集到实验决策的分层关系
免费版评估清单
- 算清日均流量与免费额度的余量,预估能撑几个月。
- 确认免费版是否提供置信区间、p值与统计功效,而非只给比例对比。
- 盘点未来一个季度的实验数量,是否会同时超过2个。
- 检查是否需要按渠道、设备、新老客分群看实验效应。
- 确认底层事件与漏斗口径能否先治理干净,否则换工具也跑不出可信结论。
据中国互联网络信息中心(CNNIC)第57次报告(2026年2月发布),我国网民规模已超11亿,移动端成为绝对主流;流量盘子越大,实验样本量越容易凑齐,但同时也对分流均匀性和数据治理提出更高要求,免费版的简陋统计在大盘流量下反而更容易放大假阳性。
还有一个常被忽略的成本是"实验沉没成本"。免费版跑出来的不显著结果,往往没有完整的实验档案和停止规则,团队事后复盘时连当初的假设和样本量估算都找不到,下次开新实验只能重新踩坑。付费版的价值,很多时候不在统计引擎本身,而在于它逼你把实验当成一套有记录、有复盘、有沉淀的流程,而不是一次次凭感觉的试探。
常见问题
Q1:免费A/B测试工具能跑多久的实验?
A:没有统一上限,免费版通常对同时运行实验数、月事件量或流量有限制;实际能跑多久取决于你的流量和免费额度,建议先看官方额度说明。
Q2:免费版算出的转化率差异可信吗?
A:要看样本量和实验时长。免费版常只给简单比例对比,不提供置信区间和统计功效;样本不足时,5%的差异可能只是随机波动,不能直接下结论。
Q3:Google Optimize停服后免费方案怎么选?
A:Google Optimize 已于2023年9月停止服务。国内团队可转向开源实验框架、云厂商实验平台或带免费额度的商业工具,同时把底层数据采集与漏斗分析搭好。
Q4:小流量网站能做A/B测试吗?
A:能做但容易不显著。流量小意味着需要更长周期或更大效应量;跑之前先估算所需样本量,否则很可能跑很久仍得不到可判断的结果。
Q5:A/B实验的数据不准是谁的问题?
A:多半是底层埋点和漏斗口径问题,而不是实验工具本身。事件丢失、重复计数、Bot流量混入,都会让实验组和对照组的对比失真,应先治理数据再谈实验。
免费版够不够用,取决于团队所处阶段和实验复杂度。小团队、单变量、方向探索阶段,免费版完全可以起步;一旦进入多实验并行、人群细分、统计决策和治理沉淀阶段,就要认真评估付费工具。
数据来源
- Google Optimize 停止服务官方公告(2023年9月)
- VWO 官方定价与功能说明(持续更新)
- Optimizely 官方产品与实验平台说明(2025年)
- Microsoft Clarity 免费分析与热图说明(2024年)
- 中国互联网络信息中心(CNNIC)第57次报告(2026年2月发布)