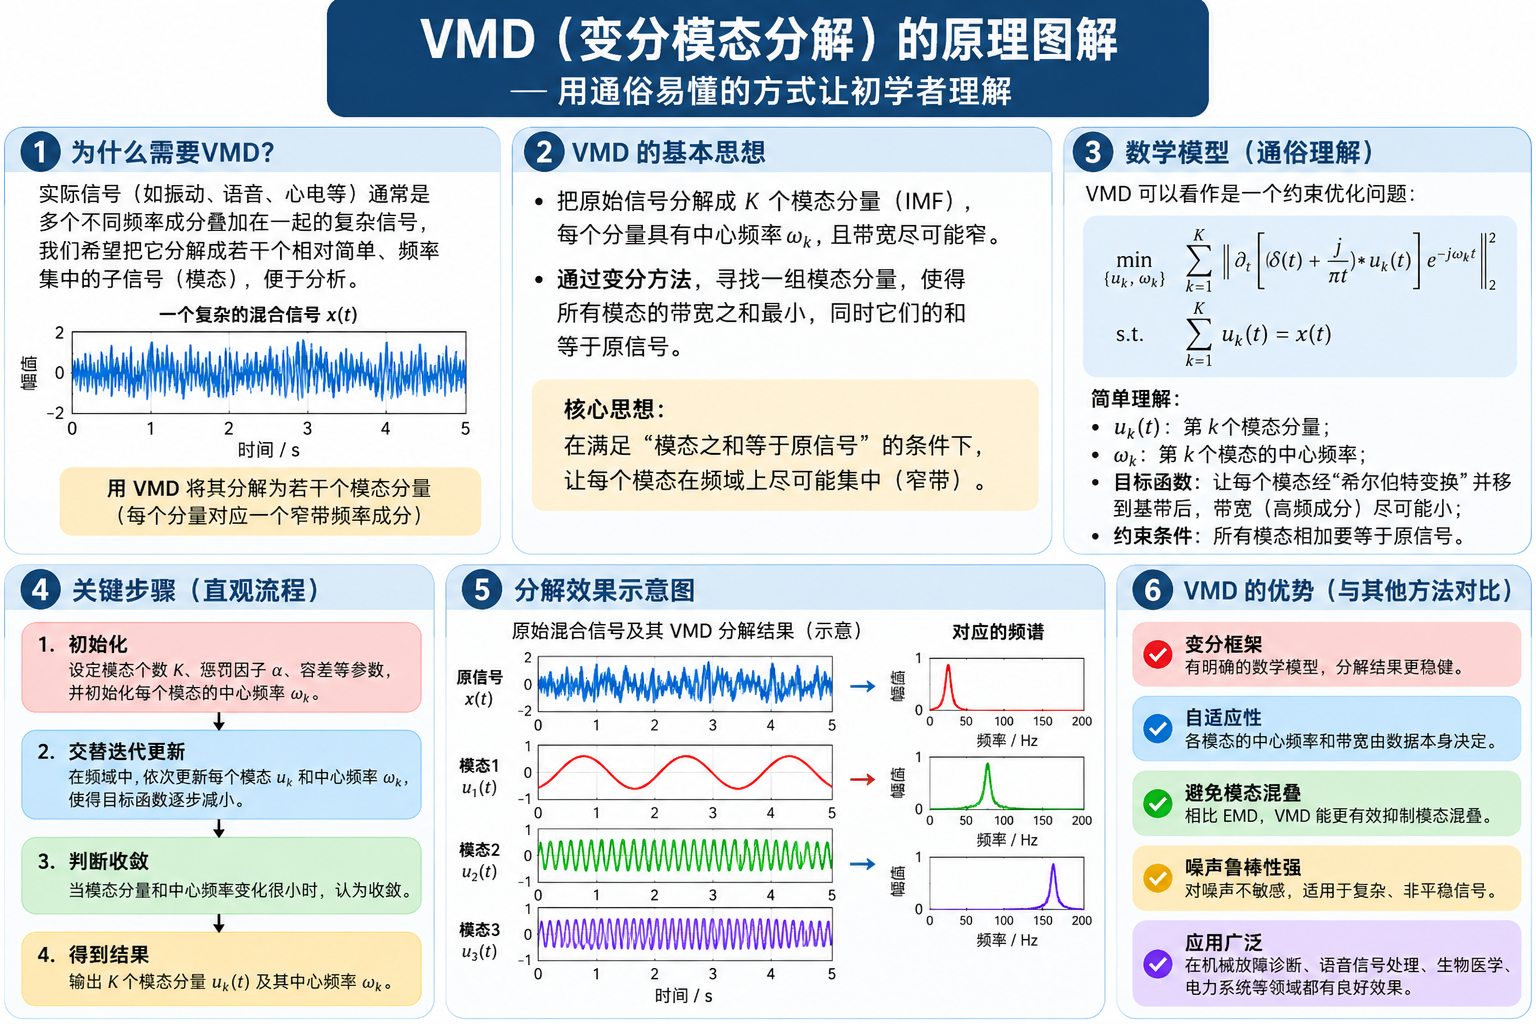
VMD 的本质,就是把一条复杂时间序列,拆成若干条"频率相对集中的简单波",而且这些简单波加起来还能还原原始信号。
如果这句话真正理解了,VMD 已经懂了一半。
一、先不用公式:VMD 到底在干什么?
假设你现在看到这样一条信号:
x(t)=sin(2π5t)+0.5sin(2π20t) x(t) = \sin(2\pi 5t) + 0.5\sin(2\pi 20t) x(t)=sin(2π5t)+0.5sin(2π20t)
里面实际上混了两个东西:
一个是比较慢的 5 Hz 波动 ,另一个是比较快的 20 Hz 波动 。
你看到的原始信号却是两者叠加后的结果。
VMD 想干的事情就是:
x(t)⟶{u1(t)≈sin(2π5t)u2(t)≈0.5sin(2π20t) x(t) \longrightarrow \begin{cases} u_1(t)\approx \sin(2\pi 5t)\\ u_2(t)\approx 0.5\sin(2\pi 20t) \end{cases} x(t)⟶{u1(t)≈sin(2π5t)u2(t)≈0.5sin(2π20t)
而且满足:
x(t)≈u1(t)+u2(t) x(t)\approx u_1(t)+u_2(t) x(t)≈u1(t)+u2(t)
所以可以把 VMD 想象成一个"自动分频器"。
二、用音乐来理解 VMD 最容易
假设一段音乐里面同时有:
低音鼓、男低音、人声、高音吉他、细碎噪声。
你耳朵听到的是一个整体:
音乐=低频+中低频+中频+高频+噪声 \text{音乐} = \text{低频} + \text{中低频} + \text{中频} + \text{高频} + \text{噪声} 音乐=低频+中低频+中频+高频+噪声
VMD 就像让计算机说:
"我把这段混合声音拆成 K 条频率集中的音轨。"
例如设:
K=4 K=4 K=4
VMD 可能得到:
u1,u2,u3,u4 u_1, u_2, u_3, u_4 u1,u2,u3,u4
其中:
| 模态 | 可能代表 |
|---|---|
| u1u_1u1 | 慢趋势 |
| u2u_2u2 | 低频周期 |
| u3u_3u3 | 中频变化 |
| u4u_4u4 | 高频快速波动 |
并满足:
f(t)≈u1(t)+u2(t)+u3(t)+u4(t) f(t)\approx u_1(t)+u_2(t)+u_3(t)+u_4(t) f(t)≈u1(t)+u2(t)+u3(t)+u4(t)
这就是 VMD 最核心的思想。
三、为什么时间序列要先"分解"?
这里一定要搞明白。
假设电力负荷是:
P(t) P(t) P(t)
它看起来是一条曲线,但实际上可能同时包含很多不同的变化机制:
P(t)=T(t)⏟长期趋势+D(t)⏟日周期+H(t)⏟小时级波动+R(t)⏟快速扰动 P(t) = \underbrace{T(t)}{\text{长期趋势}} + \underbrace{D(t)}{\text{日周期}} + \underbrace{H(t)}{\text{小时级波动}} + \underbrace{R(t)}{\text{快速扰动}} P(t)=长期趋势 T(t)+日周期 D(t)+小时级波动 H(t)+快速扰动 R(t)
例如商业负荷:
早晨 8 点开门,负荷快速上涨;
白天保持较高水平;
晚上关门,快速下降;
周末和工作日规律不同;
天气突然变热,空调负荷增加;
某一时刻又可能出现突发用电。
如果把所有这些变化直接交给一个 LSTM:
Pt−L:t→Pt+3 P_{t-L:t} \rightarrow P_{t+3} Pt−L:t→Pt+3
那么 LSTM 要同时学习:
趋势、周期、快速扰动、慢变化。
这就像让一个学生同时在一张卷子里做:
代数、几何、概率、微积分。
VMD 的思路是:
先拆题。
P(t)→VMDu1(t),u2(t),u3(t),u4(t) P(t) \xrightarrow{VMD} u_1(t), u_2(t), u_3(t), u_4(t) P(t)VMD u1(t),u2(t),u3(t),u4(t)
然后模型分别看到不同尺度的信息。
四、VMD 分出来的东西叫什么?
叫:
Mode \boxed{\text{Mode}} Mode
中文通常叫:
模态分量 。
VMD 假定每个模态大致可以写成:
uk(t)=Ak(t)cos(ϕk(t)) u_k(t) = A_k(t)\cos(\phi_k(t)) uk(t)=Ak(t)cos(ϕk(t))
这里非常重要。
Ak(t)A_k(t)Ak(t) 是:
幅值 \text{幅值} 幅值
也就是这个波有多强。
ϕk(t)\phi_k(t)ϕk(t) 是:
相位 \text{相位} 相位
而瞬时频率为:
ωk(t)=dϕk(t)dt \omega_k(t) = \frac{d\phi_k(t)}{dt} ωk(t)=dtdϕk(t)
所以 VMD 并不要求每个模态一定是:
sin(ωt) \sin(\omega t) sin(ωt)
这种完美正弦波。
它允许:
Ak(t) A_k(t) Ak(t)
慢慢变化,也允许频率略微变化。
所以它比单纯 Fourier 分解灵活得多。
五、案例 1:两个正弦波混在一起
假设:
x(t)=sin(2π5t)+0.5sin(2π20t) x(t) = \sin(2\pi 5t) + 0.5\sin(2\pi 20t) x(t)=sin(2π5t)+0.5sin(2π20t)
如果设:
K=2 K=2 K=2
理论上 VMD 会得到:
u1(t)u_1(t)u1(t) 中心频率靠近 5 Hz;
u2(t)u_2(t)u2(t) 中心频率靠近 20 Hz。
也就是:
x(t)→5Hz+20Hz x(t) \rightarrow \boxed{5\text{Hz}} + \boxed{20\text{Hz}} x(t)→5Hz+20Hz
这个例子说明:
VMD 是按照"频率结构"来拆,而不是随便把序列切成几段。
六、案例 2:趋势 + 周期
假设:
x(t)=0.01t+2sin(2πt/24) x(t) = 0.01t + 2\sin(2\pi t/24) x(t)=0.01t+2sin(2πt/24)
这里有:
0.01t0.01t0.01t 一个非常缓慢的趋势;
还有:
2sin(2πt/24)2\sin(2\pi t/24)2sin(2πt/24) 24 个时间单位一个周期。
如果使用:
K=2 K=2 K=2
VMD 很可能得到:
u1≈趋势/超低频 u_1 \approx \text{趋势/超低频} u1≈趋势/超低频
u2≈24周期波动 u_2 \approx \text{24周期波动} u2≈24周期波动
这对于电力负荷特别重要。
因为电力负荷经常具有:
趋势 + 日周期 + 局部波动 \boxed{\text{趋势 + 日周期 + 局部波动}} 趋势 + 日周期 + 局部波动
七、案例 3:电力负荷
假设一天 24 小时负荷:
夜间:
500 MW 500\,\text{MW} 500MW
早晨开始上升;
中午:
900 MW 900\,\text{MW} 900MW
下午又出现一个峰值;
晚上下降。
如果数据每 5 min 一个点,那么一天:
24×60/5=288 24\times 60/5 = 288 24×60/5=288
个点。
一个月大概:
288×30=8640 288\times 30 = 8640 288×30=8640
个点。
这条负荷序列中可能同时存在:
周周期 \text{周周期} 周周期
日周期 \text{日周期} 日周期
小时级变化 \text{小时级变化} 小时级变化
分钟级扰动 \text{分钟级扰动} 分钟级扰动
设:
K=4 K=4 K=4
VMD 可能产生:
P(t)=u1(t)+u2(t)+u3(t)+u4(t) P(t) = u_1(t)+u_2(t)+u_3(t)+u_4(t) P(t)=u1(t)+u2(t)+u3(t)+u4(t)
你可以粗略理解为:
u1: 低频趋势 u_1:\ \text{低频趋势} u1: 低频趋势
u2: 日周期相关成分 u_2:\ \text{日周期相关成分} u2: 日周期相关成分
u3: 较快速波动 u_3:\ \text{较快速波动} u3: 较快速波动
u4: 高频细节 u_4:\ \text{高频细节} u4: 高频细节
但这里特别注意:
不能机械地说 IMF1 一定是噪声、IMF2 一定是日周期。
真正含义应该根据:
中心频率、功率谱、时间曲线以及业务规律
来解释。
八、那么 VMD 和 Fourier 分解有什么区别?
傅里叶变换认为:
x(t)=∑kAkcos(ωkt+ϕk) x(t) = \sum_k A_k\cos(\omega_k t+\phi_k) x(t)=k∑Akcos(ωkt+ϕk)
这里每个基本成分主要是固定频率的正弦/余弦。
VMD 更灵活,它允许:
uk(t)=Ak(t)cos(ϕk(t)) u_k(t) = A_k(t)\cos(\phi_k(t)) uk(t)=Ak(t)cos(ϕk(t))
所以:
Ak(t)A_k(t)Ak(t) 可以变化,
ϕk′(t)\phi_k'(t)ϕk′(t) 也可以变化。
简单说:
Fourier 更像"固定音高的琴键"。
VMD 更像"一个音轨允许轻微变调和强弱变化"。
因此对非平稳时间序列,VMD 通常更加合适。
九、现在开始进入 VMD 真正的数学思想
VMD 的目标是:
给定原始信号:
f(t) f(t) f(t)
寻找:
K K K
个模态:
u1(t),u2(t),...,uK(t) u_1(t), u_2(t), \dots, u_K(t) u1(t),u2(t),...,uK(t)
以及各自中心频率:
ω1,ω2,...,ωK \omega_1, \omega_2, \dots, \omega_K ω1,ω2,...,ωK
满足:
∑k=1Kuk(t)=f(t) \sum_{k=1}^{K} u_k(t) = f(t) k=1∑Kuk(t)=f(t)
同时要求:
每个 uku_kuk 的频带尽量窄。
所以 VMD 实际解决的是:
重构原始信号+每个模态尽可能窄带 \boxed{\text{重构原始信号} + \text{每个模态尽可能窄带}} 重构原始信号+每个模态尽可能窄带
十、"窄带"是什么意思?
这个概念非常关键。
假设一个分量的频谱主要集中在:
9∼11 Hz 9\sim 11\,\text{Hz} 9∼11Hz
那么它比较窄:
10 Hz±1 Hz \boxed{10\,\text{Hz} \pm 1\,\text{Hz}} 10Hz±1Hz
另一个分量的频谱横跨:
2∼30 Hz 2\sim 30\,\text{Hz} 2∼30Hz
那么它就很宽。
VMD 希望:
uku_kuk 对应的频谱都围绕一个中心:
ωk \omega_k ωk
比较集中。
可以直观想成:
text
频率
0 ----5----10----15----20----25----30
Mode 1
      ███
中心 ≈ 5Hz
Mode 2
                     ████
中心 ≈ 20Hz
而不是:
text
Mode
██████████████████████████
这就是 VMD 的"模态"概念。
十一、为什么需要 Hilbert 变换?
这里很多初学者第一次会懵。
VMD 为了知道一个模态的频率集中在哪里,要先得到它的:
解析信号 \boxed{\text{解析信号}} 解析信号
一个实信号:
uk(t) u_k(t) uk(t)
通过 Hilbert 变换构造:
uka(t)=uk(t)+jHuk(t) u_k^a(t) = u_k(t) + j\mathcal{H}u_k(t) uka(t)=uk(t)+jHuk(t)
这里:
H⋅ \mathcal{H}\\cdot H⋅
就是 Hilbert 变换。
为什么这么干?
因为普通实信号的频谱有:
正频率 + 负频率。
解析信号基本保留:
正频率 \text{正频率} 正频率
这样更方便估计瞬时频率和中心频率。
你不需要一开始深入 Hilbert 的所有数学细节。
先记:
Hilbert变换的作用≈让实信号变成便于分析瞬时幅值和频率的复信号 \boxed{\text{Hilbert变换的作用} \approx \text{让实信号变成便于分析瞬时幅值和频率的复信号}} Hilbert变换的作用≈让实信号变成便于分析瞬时幅值和频率的复信号
十二、VMD 最漂亮的一步:搬到基带
假设一个模态中心频率:
ωk \omega_k ωk
在 20 Hz。
VMD 会乘:
e−jωkt e^{-j\omega_k t} e−jωkt
相当于把它的频谱:
20 Hz 20\,\text{Hz} 20Hz
搬到:
0 Hz 0\,\text{Hz} 0Hz
附近。
通信里叫:
解调 \boxed{\text{解调}} 解调
例如:
20 Hz→0 Hz 20\,\text{Hz} \rightarrow 0\,\text{Hz} 20Hz→0Hz
这时候如果这个模态本身非常窄,那么搬到 0 附近以后,它变化就会很慢。
所以:
ddt \frac{d}{dt} dtd
的能量也比较小。
因此 VMD 用"解调后信号导数的平方能量"来衡量:
带宽 \boxed{\text{带宽}} 带宽
这就是那个看起来很可怕的公式背后的简单思想。
十三、VMD 核心公式终于来了
标准 VMD 优化问题是:
min{uk},{ωk}∑k=1K∥∂t(δ(t)+jπt)∗uk(t)e−jωkt∥22 \min_{\{u_k\},\{\omega_k\}} \sum_{k=1}^K \left\| \partial_t \left \\left( \\delta(t)+\\frac{j}{\\pi t} \\right)\*u_k(t) \\right e^{-j\omega_k t} \right\|2^2 {uk},{ωk}mink=1∑K ∂t(δ(t)+πtj)∗uk(t)e−jωkt 22
满足:
∑k=1Kuk(t)=f(t) \sum{k=1}^{K} u_k(t) = f(t) k=1∑Kuk(t)=f(t)
不要被吓到。
我们把它拆开。
十四、逐项翻译这个公式
先看:
uk(t) u_k(t) uk(t)
就是:
第 kkk 个模态。
然后:
(δ(t)+jπt)∗uk(t) \left(\delta(t)+\frac{j}{\pi t}\right)*u_k(t) (δ(t)+πtj)∗uk(t)
本质就是:
构造解析信号。
再乘:
e−jωkt e^{-j\omega_k t} e−jωkt
意思是:
把当前模态的中心频率搬到 0 Hz。
然后:
∂t \partial_t ∂t
意思是:
看基带信号变化得有多快。
最后:
∥⋅∥22 \|\cdot\|_2^2 ∥⋅∥22
表示:
变化能量大小。
所以整个式子翻译成人话:
找到 K 个模态,使每个模态围绕自己的中心频率尽可能集中,同时这些模态的和必须恢复原始信号。
也就是:
min 所有模态总带宽 \boxed{\min\ \text{所有模态总带宽}} min 所有模态总带宽
subject to
f(t)=∑kuk(t) \boxed{f(t)=\sum_k u_k(t)} f(t)=k∑uk(t)
VMD 的思想到这里其实已经完全清楚了。
十五、"变分"两个字到底是什么意思?
很多学生看到:
变分模态分解
以为是什么特别玄学的东西。
其实"变分"简单理解就是:
不是直接写出答案,而是先定义一个目标函数,然后寻找使这个目标函数最小的函数。
普通机器学习:
minθL(θ) \min_\theta L(\theta) θminL(θ)
是在找参数。
VMD:
min{uk},{ωk}J \min_{\{u_k\},\{\omega_k\}} J {uk},{ωk}minJ
是在同时找:
模态函数 uk(t)u_k(t)uk(t)
以及中心频率 ωk\omega_kωk。
所以叫:
变分优化 \boxed{\text{变分优化}} 变分优化
十六、但是有个约束怎么办?
我们还有:
∑kuk=f \sum_k u_k = f k∑uk=f
这个约束。
VMD 使用:
增广拉格朗日法
把约束问题转成更容易优化的形式。
增广 Lagrangian 大致为:
\\mathcal{L} \\alpha\\sum_k B_k + \\left\| f-\\sum_k u_k \\right\|_2\^2 + \\left\\langle \\lambda,\\ f-\\sum_k u_k \\right\\rangle 这里: 这里: 这里: B_k KaTeX parse error: Can't use function '$' in math mode at position 6: 表示第 $̲k$ 个模态带宽。 \\alpha
控制:
你有多强烈地要求每个模态窄带。
而:
λ \lambda λ
是拉格朗日乘子。
最终用:
ADMM \boxed{ADMM} ADMM
交替方向乘子法求解。
十七、ADMM 可以怎么理解?
不用先学 ADMM 理论。
你可以把它理解成:
几个人轮流修改自己的答案,直到大家互相不打架。
开始随机猜:
u1,u2,...,uK u_1, u_2, \dots, u_K u1,u2,...,uK
然后:
固定其他模态,更新:
u1 u_1 u1
再固定其他模态,更新:
u2 u_2 u2
......
然后更新:
ω1,ω2,... \omega_1, \omega_2, \dots ω1,ω2,...
再更新约束误差。
不断重复:
n=1,2,3,... n=1,2,3,\dots n=1,2,3,...
直到:
ukn+1≈ukn u_k^{n+1} \approx u_k^n ukn+1≈ukn
就停止。
十八、VMD 最核心的更新式
在频域中,第 kkk 个模态更新大致写成:
\\hat{u}_k\^{n+1}(\\omega) ### \\frac{ \\hat{f}(\\omega) \\sum_{i\\ne k}\\hat{u}*i(\\omega) + \\frac{\\hat{\\lambda}(\\omega)}{2} }{ 1+2\\alpha(\\omega-\\omega_k)\^2 } 这个公式特别值得理解。先看分子: 这个公式特别值得理解。 先看分子: 这个公式特别值得理解。先看分子: \\hat{f} - \\sum* {i\\ne k}\\hat{u}_i
是什么意思?
就是:
原信号减去别人已经解释掉的部分。
剩下:
残差 \text{残差} 残差
就交给:
uk u_k uk
解释。
再看分母:
1+2α(ω−ωk)2 1+2\alpha(\omega-\omega_k)^2 1+2α(ω−ωk)2
如果:
ω≈ωk \omega \approx \omega_k ω≈ωk
那么:
(ω−ωk)2≈0 (\omega-\omega_k)^2\approx 0 (ω−ωk)2≈0
分母小,这部分频率被保留。
如果:
ω \omega ω
离中心频率很远:
(ω−ωk)2 (\omega-\omega_k)^2 (ω−ωk)2
很大,分母变大,该频率被压制。
所以这个公式本质上像:
围绕 ωk 的自适应带通滤波器 \boxed{\text{围绕 }\omega_k\text{ 的自适应带通滤波器}} 围绕 ωk 的自适应带通滤波器
非常漂亮。
十九、中心频率怎么更新?
VMD 使用:
\\omega_k \\frac{ \\displaystyle\\int_0\^\\infty \\omega,\|\\hat{u}_k(\\omega)\|\^2,d\\omega }{ \\displaystyle\\int_0\^\\infty \|\\hat{u}_k(\\omega)\|\^2,d\\omega } 这看起来复杂,其实就是: 这看起来复杂,其实就是: 这看起来复杂,其实就是: \\boxed{\\text{频率的能量加权平均}}
例如某个模态:
| 频率 | 能量 |
|---|---|
| 8 Hz | 1 |
| 9 Hz | 2 |
| 10 Hz | 10 |
| 11 Hz | 2 |
| 12 Hz | 1 |
| 那么中心频率自然大概是: | |
| $$ | |
| 10,\text{Hz} | |
| $$ | |
| 和求"重心"是一样的。 |
二十、一个完整的 VMD 工作过程
可以把算法记成:
f(t) f(t) f(t)
↓
初始化:
uk, ωk, λ u_k,\ \omega_k,\ \lambda uk, ωk, λ
↓
依次更新:
u1,u2,...,uK u_1, u_2, \dots, u_K u1,u2,...,uK
↓
更新:
ω1,ω2,...,ωK \omega_1, \omega_2, \dots, \omega_K ω1,ω2,...,ωK
↓
更新:
λ \lambda λ
↓
判断是否收敛
↓
得到:
u1,...,uK u_1, \dots, u_K u1,...,uK
最终满足:
f(t)≈∑k=1Kuk(t) f(t)\approx\sum_{k=1}^K u_k(t) f(t)≈k=1∑Kuk(t)
二十一、案例 4:把 VMD 当成"筛子"
假设一个信号里有:
2 Hz,10 Hz,30 Hz 2\,\text{Hz},\quad 10\,\text{Hz},\quad 30\,\text{Hz} 2Hz,10Hz,30Hz
三种主要频率。
取:
K=3 K=3 K=3
VMD 最终可能学习三个中心:
ω1≈2 \omega_1\approx 2 ω1≈2
ω2≈10 \omega_2\approx 10 ω2≈10
ω3≈30 \omega_3\approx 30 ω3≈30
于是形成三个自适应"筛子":
text
原信号频谱
  2Hz        10Hz                     30Hz
   ▲           ▲                        ▲
██████      ███████                   █████
------------------------------------------------ frequency
VMD
Mode1
██████
Mode2
            ███████
Mode3
                                      █████
这就是 VMD 最直观的理解。
二十二、参数 K 是最重要的参数
K K K
代表:
分成几个模态 \boxed{\text{分成几个模态}} 分成几个模态
这是初学者最容易问的问题:
K 越大是不是越好?
不是。
假如真实信号只有:
低频 + 中频 + 高频,
你却设:
K=10 K=10 K=10
那么可能发生:
过分解 \boxed{\text{过分解}} 过分解
同一个物理成分被硬拆成几块。
反之如果:
K=2 K=2 K=2
但实际有五种尺度,就可能:
欠分解 \boxed{\text{欠分解}} 欠分解
多个频率被混在同一个模态里。
二十三、怎么选 K?
实际中最常用的思路是:
观察中心频率、频谱分离程度、重构误差以及下游任务效果。
例如尝试:
K=2,3,4,5,6 K=2,3,4,5,6 K=2,3,4,5,6
得到:
| K | 情况 |
|---|---|
| 2 | 两个模态频带明显混合 |
| 3 | 基本分开 |
| 4 | 分离较清晰 |
| 5 | 有两个中心频率非常接近 |
| 6 | 出现明显重复模态 |
| 那么: | |
| $$ | |
| K=4 | |
| $$ | |
| 可能比较合适。 | |
| 如果你的最终目标是预测,更科学的做法是: | |
| $$ | |
| K \rightarrow \text{验证集预测误差} | |
| $$ | |
| 然后由训练/验证数据选择。 | |
| 绝对不要: |
看测试集哪个 K 最好就选哪个。
那会发生测试集泄漏。
二十四、参数 α\alphaα 是什么?
VMD 里面另一个重要参数:
α \alpha α
叫:
bandwidth constraint / penalty factor
可以简单理解成:
α=你有多强烈地要求模态频率集中 \boxed{\alpha = \text{你有多强烈地要求模态频率集中}} α=你有多强烈地要求模态频率集中
当:
α \alpha α
较大,模态倾向:
更窄频带 \text{更窄频带} 更窄频带
当:
α \alpha α
较小,模态:
允许更宽频带 \text{允许更宽频带} 允许更宽频带
比如论文里面经常看到:
α=2000 \alpha=2000 α=2000
但这绝不是万能值。
二十五、案例 5:α\alphaα 太小会怎样?
假设原信号包含:
10 Hz+15 Hz 10\,\text{Hz} + 15\,\text{Hz} 10Hz+15Hz
如果:
α \alpha α
太小,一个模态可能同时覆盖:
8∼18 Hz 8\sim 18\,\text{Hz} 8∼18Hz
导致:
10 Hz 10\,\text{Hz} 10Hz
和:
15 Hz 15\,\text{Hz} 15Hz
没有分清楚。
这叫:
模态混叠 \boxed{\text{模态混叠}} 模态混叠
二十六、α\alphaα 太大会怎样?
如果 α\alphaα 非常大:
每个模态被强制变得特别窄。
可能导致:
真实的宽带变化被切碎,
或者:
某些瞬态信息难以完整表示。
因此:
α \alpha α
不是越大越好。
二十七、VMD 和 EMD 最大的区别
这个一定要会,硕士答辩很可能问。
| 对比 | EMD | VMD |
|---|---|---|
| 核心思想 | 局部极值点筛分 | 全局变分优化 |
| 是否预设模态数 | 通常不用 | 需要 K |
| 数学框架 | 经验式 | 优化问题 |
| 模态混叠 | 较容易发生 | 一般较弱 |
| 稳定性 | 相对敏感 | 通常更稳定 |
| 参数 | 较少 | K、α 等 |
| 计算方式 | 迭代筛分 | ADMM 优化 |
| 模态中心频率 | 不显式优化 | 显式优化 |
| 一句话记: |
EMD 是"根据信号局部极值一点一点筛"。
VMD 是"同时寻找多个最优窄带模态"。
二十八、案例 6:为什么 VMD 往往比 EMD 稳?
假设:
x(t)=sin(10t)+sin(12t)+noise x(t) = \sin(10t) + \sin(12t) + \text{noise} x(t)=sin(10t)+sin(12t)+noise
10 和 12 很接近。
EMD 根据局部极值进行筛分,有可能把两个成分混在一起:
IMF1=10 Hz+12 Hz IMF_1 = 10\,\text{Hz} + 12\,\text{Hz} IMF1=10Hz+12Hz
这叫:
mode mixing \text{mode mixing} mode mixing
VMD 则直接寻找不同中心频率:
ω1,ω2 \omega_1, \omega_2 ω1,ω2
通过频域带宽约束,使两个模态更容易分离。
当然:
VMD 也不是一定不会模态混叠。
参数设置不好一样会有问题。
二十九、VMD 和小波有什么区别?
小波变换:
x(t)→预先定义的小波基 x(t) \rightarrow \text{预先定义的小波基} x(t)→预先定义的小波基
比如:
Daubechies、Morlet 等。
本质上:
你先规定"尺子长什么样"。
VMD:
不提前规定每一个具体波形,而是通过优化自适应寻找模态。
所以:
小波:基函数驱动 \boxed{\text{小波:基函数驱动}} 小波:基函数驱动
VMD:数据驱动的频带分解 \boxed{\text{VMD:数据驱动的频带分解}} VMD:数据驱动的频带分解
三十、VMD 与滤波器有什么区别?
普通滤波器可能是人为设定:
0∼5 Hz 0\sim 5\,\text{Hz} 0∼5Hz
5∼15 Hz 5\sim 15\,\text{Hz} 5∼15Hz
15∼30 Hz 15\sim 30\,\text{Hz} 15∼30Hz
VMD 不需要你事先精确规定每个频带范围。
它会学习:
ω1,ω2,...,ωK \omega_1, \omega_2, \dots, \omega_K ω1,ω2,...,ωK
所以可以把它理解为:
一组自动寻找中心频率的自适应带通滤波器 \boxed{\text{一组自动寻找中心频率的自适应带通滤波器}} 一组自动寻找中心频率的自适应带通滤波器
这个比喻非常适合初学者。
三十一、案例 7:温度为什么可能用 VMD?
假设温度:
T(t) T(t) T(t)
受到:
昼夜变化、天气过程、短时波动
影响。
可以粗略写成:
T(t)=Ttrend+Tdaily+Tshort T(t) = T_{\text{trend}} + T_{\text{daily}} + T_{\text{short}} T(t)=Ttrend+Tdaily+Tshort
VMD:
T(t)→T1(t),T2(t),T3(t) T(t) \rightarrow T_1(t), T_2(t), T_3(t) T(t)→T1(t),T2(t),T3(t)
模型便可以同时看到:
慢趋势、
日周期、
快速变化。
这就是你前面那篇论文使用 VMD 做特征处理的基本动机。
不过需要注意:
如果原始温度采样频率本来很低,只是人为插值成高频数据,那么 VMD 是否真正有价值,必须通过消融实验验证。
三十二、案例 8:机械振动故障诊断
VMD 在故障诊断里也非常常见。
比如轴承振动信号:
x(t)=转频+故障冲击+结构共振+噪声 x(t) = \text{转频} + \text{故障冲击} + \text{结构共振} + \text{噪声} x(t)=转频+故障冲击+结构共振+噪声
直接看:
x(t) x(t) x(t)
很乱。
经过:
VMD VMD VMD
得到:
u1,u2,u3,u4 u_1, u_2, u_3, u_4 u1,u2,u3,u4
可能:
低频模态对应转动;
中高频模态含故障冲击;
最高频模态含噪声。
然后对各模态提取:
峭度、包络谱、能量、熵
再做:
故障分类 \text{故障分类} 故障分类
这是 VMD 特别典型的应用。
三十三、案例 9:股票价格
股票价格:
Pt P_t Pt
也可以想成:
Pt=长期趋势+中期波动+短期波动+随机扰动 P_t = \text{长期趋势} + \text{中期波动} + \text{短期波动} + \text{随机扰动} Pt=长期趋势+中期波动+短期波动+随机扰动
VMD 可以:
Pt→u1+u2+u3+u4 P_t \rightarrow u_1+u_2+u_3+u_4 Pt→u1+u2+u3+u4
然后分别预测。
不过金融数据噪声很强,所以不能简单认为:
分解出来的模态都有稳定经济意义。
这里 VMD 更多是一种:
信号表示方法 \text{信号表示方法} 信号表示方法
而不是因果解释。
三十四、VMD 在深度学习中通常怎么用?
主要有两种套路。
第一种:
x→VMDu1,u2,...,uK x \xrightarrow{VMD} u_1, u_2, \dots, u_K xVMD u1,u2,...,uK
然后每个模态单独建一个模型:
u1→LSTM1 u_1 \rightarrow LSTM_1 u1→LSTM1
u2→LSTM2 u_2 \rightarrow LSTM_2 u2→LSTM2
......
最后:
y^=∑ky^k \hat{y} = \sum_k \hat{y}_k y^=k∑y^k
叫:
分解---预测---重构 \boxed{\text{分解---预测---重构}} 分解---预测---重构
第二种:
把所有模态作为多通道特征:
Xt=u1,t,u2,t,...,uK,t X_t = u_{1,t}, u_{2,t}, \\dots, u_{K,t} Xt=u1,t,u2,t,...,uK,t
一起输入:
LSTM/Transformer LSTM / Transformer LSTM/Transformer
即:
u1,...,uK→LSTM→y^ u_1, \\dots, u_K \rightarrow LSTM \rightarrow \hat{y} u1,...,uK→LSTM→y^
你前面那篇论文更接近第二类思想。
三十五、为什么第二种有时更合理?
因为不同模态并不是完全独立的。
例如:
低频趋势正在上升,
高频波动也许会随着负荷水平增加。
如果每个分量单独预测:
uk→modelk u_k \rightarrow model_k uk→modelk
可能忽略:
ui↔uj u_i \leftrightarrow u_j ui↔uj
之间的关联。
而多通道输入:
u1,u2,u3,u4→LSTM u_1, u_2, u_3, u_4 \rightarrow LSTM u1,u2,u3,u4→LSTM
可以让网络学习跨尺度关系。
三十六、VMD 最容易犯的一个大错:未来信息泄漏
这个问题对于你的负荷预测研究特别重要。
假设你有:
2023/1/1∼2023/6/30 2023/1/1 \sim 2023/6/30 2023/1/1∼2023/6/30
完整数据。
很多人先对:
整个半年序列 \text{整个半年序列} 整个半年序列
做一次 VMD。
然后:
70%训练+15%验证+15%测试 70\%\text{训练} + 15\%\text{验证} + 15\%\text{测试} 70%训练+15%验证+15%测试
这是有风险的。
为什么?
因为 VMD 在分解早期数据时,实际上已经看到了:
未来测试数据 \boxed{\text{未来测试数据}} 未来测试数据
所以训练数据中的模态可能带有未来信息。
三十七、正确的预测型 VMD 应该怎么做?
预测起点是:
t t t
只能看到:
x1,x2,...,xt x_1, x_2, \dots, x_t x1,x2,...,xt
所以应该:
xt−L+1,...,xt\] \[x_{t-L+1}, \\dots, x_t\] \[xt−L+1,...,xt
做 VMD。
不能使用:
xt+1,xt+2,... x_{t+1}, x_{t+2}, \dots xt+1,xt+2,...
例如预测:
t+3 t+3 t+3
正确结构是:
xt−L+1:t→VMDu1:t(1),...,u1:t(K)→Model→x^t+3 \boxed{ x_{t-L+1:t} \xrightarrow{VMD} u_{1:t}^{(1)}, \dots, u_{1:t}^{(K)} \rightarrow Model \rightarrow \hat{x}_{t+3} } xt−L+1:tVMD u1:t(1),...,u1:t(K)→Model→x^t+3
这叫:
因果窗口分解 \boxed{\text{因果窗口分解}} 因果窗口分解
或者:
causal decomposition \text{causal decomposition} causal decomposition
这比直接把全序列分解后切训练测试严谨得多。
三十八、但这样又出现一个问题:端点效应
假设每次只分解:
xt−L+1:t x_{t-L+1:t} xt−L+1:t
那么:
t t t
正好是窗口边界。
大多数信号分解方法在边界附近估计会比较困难。
因为它不知道:
t t t
后面是什么。
所以最后几个点的 VMD 模态可能发生:
端点漂移 \boxed{\text{端点漂移}} 端点漂移
这叫:
end effect \text{end effect} end effect
也正是实际预测中 VMD 的一个重要问题。
三十九、为什么镜像延拓能缓解端点效应?
假设序列末尾:
5,6,7,8\] \[5, 6, 7, 8\] \[5,6,7,8
直接在:
8 8 8
处截断很突然。
镜像延拓可以变成:
5,6,7,8,7,6,5\] \[5, 6, 7, 8, 7, 6, 5\] \[5,6,7,8,7,6,5
这样边界附近显得更平滑。
VMD 在估计频率时就不会认为:
8→0 8 \rightarrow 0 8→0
突然断掉。
因此很多实际算法使用:
mirror extension \boxed{\text{mirror extension}} mirror extension
四十、给你一个完整的电力负荷 VMD 案例
假设:
采样间隔:
5 min 5\,\text{min} 5min
预测未来:
15 min 15\,\text{min} 15min
所以:
H=3 H=3 H=3
历史窗口:
L=288 L=288 L=288
也就是:
24 h 24\,\text{h} 24h
当前时刻:
t t t
输入:
Pt−287:t P_{t-287:t} Pt−287:t
第一步:
Pt−287:t→VMD(K=4)u1,u2,u3,u4 P_{t-287:t} \xrightarrow{VMD(K=4)} u_1, u_2, u_3, u_4 Pt−287:tVMD(K=4) u1,u2,u3,u4
得到:
Xt=u1,t−287:tu2,t−287:tu3,t−287:tu4,t−287:t X_t = \begin{bmatrix} u_{1,t-287:t}\\ u_{2,t-287:t}\\ u_{3,t-287:t}\\ u_{4,t-287:t} \end{bmatrix} Xt= u1,t−287:tu2,t−287:tu3,t−287:tu4,t−287:t
再加入:
温度 TTT
湿度 HHH
日期类型 DDD
得到:
Xt=u1,u2,u3,u4,T,H,D X_t = u_1, u_2, u_3, u_4, T, H, D Xt=u1,u2,u3,u4,T,H,D
输入:
LSTM LSTM LSTM
输出:
ΔPt+3 \Delta P_{t+3} ΔPt+3
最后:
P^t+3=Pt+ΔP^t+3 \hat{P}{t+3} = P_t + \widehat{\Delta P}{t+3} P^t+3=Pt+ΔP t+3
这就是:
VMD+增量预测+LSTM \boxed{VMD + \text{增量预测} + LSTM} VMD+增量预测+LSTM
完整的一条逻辑链。
四十一、为什么预测"增量"而不是直接预测绝对值?
假设当前:
Pt=1500 MW P_t = 1500\,\text{MW} Pt=1500MW
15 min 后:
Pt+3=1512 MW P_{t+3} = 1512\,\text{MW} Pt+3=1512MW
直接预测:
1512 1512 1512
模型既要学习:
基础水平 1500
又要学习:
变化量 12。
增量建模改成:
ΔPt+3=Pt+3−Pt \Delta P_{t+3} = P_{t+3} - P_t ΔPt+3=Pt+3−Pt
即:
12 MW 12\,\text{MW} 12MW
模型只需要预测:
12 12 12
最后:
1500+12=1512 1500+12=1512 1500+12=1512
所以 VMD 可以负责:
分离尺度 \text{分离尺度} 分离尺度
LSTM 负责:
时序关系 \text{时序关系} 时序关系
增量学习负责:
局部变化 \text{局部变化} 局部变化
这三者职责其实是不一样的。
四十二、用一句更工程化的话理解 VMD
原始负荷:
P(t) P(t) P(t)
是一个复杂信号。
VMD 相当于建立:
P(t)=Pslow⏟低频+Pmedium⏟中频+Pfast⏟高频+Pdetail⏟细节 P(t) = \underbrace{P_{\text{slow}}}{\text{低频}} + \underbrace{P{\text{medium}}}{\text{中频}} + \underbrace{P{\text{fast}}}{\text{高频}} + \underbrace{P{\text{detail}}}_{\text{细节}} P(t)=低频 Pslow+中频 Pmedium+高频 Pfast+细节 Pdetail
于是神经网络不再面对:
一锅粥 \boxed{\text{一锅粥}} 一锅粥
而是面对:
已经按变化尺度整理好的信息 \boxed{\text{已经按变化尺度整理好的信息}} 已经按变化尺度整理好的信息
四十三、简单 Python 示例
如果用常见 VMD Python 实现,思路大概是:
python
import numpy as np
import matplotlib.pyplot as plt
from vmdpy import VMD
fs = 1000
t = np.arange(0, 1, 1/fs)
# 两个频率混合
x = np.sin(2*np.pi*50*t) + 0.5*np.sin(2*np.pi*120*t)
# VMD参数
alpha = 2000
tau = 0
K = 2
DC = 0
init = 1
tol = 1e-7
u, u_hat, omega = VMD(x, alpha, tau, K, DC, init, tol)
print("中心频率:", omega[-1])
plt.figure()
plt.plot(t, x)
plt.title("Original Signal")
plt.show()
for k in range(K):
    plt.figure()
    plt.plot(t, u[k])
    plt.title(f"VMD Mode {k+1}")
    plt.show()
运行以后,你会看到:
原始信号:
50 Hz+120 Hz 50\,\text{Hz} + 120\,\text{Hz} 50Hz+120Hz
被拆成两个模态。
一个主要是:
50 Hz 50\,\text{Hz} 50Hz
另一个主要是:
120 Hz 120\,\text{Hz} 120Hz
这其实是初学 VMD 最应该亲手做的第一个实验。
四十四、然后把实验升级一级
第二个实验建议把信号改成:
x(t)=sin(2π10t)+0.6sin(2π30t)+0.2 ϵ(t) x(t) = \sin(2\pi 10t) + 0.6\sin(2\pi 30t) + 0.2\,\epsilon(t) x(t)=sin(2π10t)+0.6sin(2π30t)+0.2ϵ(t)
其中:
ϵ(t)∼N(0,1) \epsilon(t)\sim N(0,1) ϵ(t)∼N(0,1)
然后测试:
K=2 K=2 K=2
K=3 K=3 K=3
K=4 K=4 K=4
观察:
中心频率、模态波形、频谱、重构误差。
你会真正理解:
K K K
是如何影响结果的。
四十五、第三个实验:改变 α\alphaα
固定:
K=3 K=3 K=3
然后测试:
α=200 \alpha=200 α=200
α=1000 \alpha=1000 α=1000
α=2000 \alpha=2000 α=2000
α=10000 \alpha=10000 α=10000
观察每个模态的频谱宽度。
你会亲眼看到:
α↑ \alpha\uparrow α↑
通常意味着:
频带约束更强 \text{频带约束更强} 频带约束更强
比背定义有用得多。
四十六、初学者最应该掌握的判断标准
做完 VMD,不是看见四条曲线就说:
"分解成功。"
至少要检查下面几个量:
重构误差=∥f−∑kuk∥ \text{重构误差} = \left\| f-\sum_k u_k \right\| 重构误差= f−k∑uk
是否小。
检查不同模态中心频率:
ω1,ω2,... \omega_1, \omega_2, \dots ω1,ω2,...
是否合理分离。
检查频谱是否存在:
严重重叠 \text{严重重叠} 严重重叠
检查是否出现:
两个几乎完全一样的模态。
检查下游任务,例如预测:
RMSEVMD+LSTM<RMSELSTM RMSE_{\text{VMD+LSTM}} < RMSE_{\text{LSTM}} RMSEVMD+LSTM<RMSELSTM
否则不能证明 VMD 真正有价值。
四十七、这是很多论文最容易犯的逻辑错误
论文经常写:
原始负荷具有非平稳性,因此采用 VMD 分解,VMD 能够降低非平稳性,因此能够提高预测精度。
前半句只能说明:
VMD VMD VMD
"可能合理"。
不能推出:
VMD 一定提高预测精度 \boxed{\text{VMD 一定提高预测精度}} VMD 一定提高预测精度
真正需要实验验证:
LSTMvsVMD+LSTM LSTM \quad vs \quad VMD+LSTM LSTMvsVMD+LSTM
如果:
RMSEVMD+LSTM>RMSELSTM RMSE_{VMD+LSTM} > RMSE_{LSTM} RMSEVMD+LSTM>RMSELSTM
那就说明:
至少在这个任务里,VMD 没产生有效增益。
所以:
合理性 ≠ 有效性。
这个科研思维非常重要。
四十八、把 VMD 最后压缩成一个完整心智模型
你以后看到 VMD,就在脑子里形成这样一张图:
复杂非平稳信号 \boxed{\text{复杂非平稳信号}} 复杂非平稳信号
↓
寻找:
K K K
个模态
↓
每个模态拥有自己的:
ωk \omega_k ωk
↓
要求:
每个模态频谱围绕 ωk 尽量集中 \text{每个模态频谱围绕 }\omega_k\text{ 尽量集中} 每个模态频谱围绕 ωk 尽量集中
同时:
∑kuk=f \sum_k u_k = f k∑uk=f
↓
利用 ADMM 交替优化:
uk↔ωk↔λ u_k \leftrightarrow \omega_k \leftrightarrow \lambda uk↔ωk↔λ
↓
得到:
u1,u2,...,uK u_1, u_2, \dots, u_K u1,u2,...,uK
↓
用于:
降噪、特征提取、故障诊断、预测 \text{降噪、特征提取、故障诊断、预测} 降噪、特征提取、故障诊断、预测
这就是 VMD。
四十九、如果只允许你记住 5 句话
- VMD 是把复杂信号分解成 K 个窄带模态。
- 每个模态:
uk(t)=Ak(t)cosϕk(t) u_k(t) = A_k(t)\cos\phi_k(t) uk(t)=Ak(t)cosϕk(t)
都有自己的中心频率:
ωk \omega_k ωk - VMD 本质优化:
min 总带宽 \boxed{\min\ \text{总带宽}} min 总带宽
同时满足:
∑kuk=f \boxed{\sum_k u_k = f} k∑uk=f - 它通过:
Hilbert→解调到基带→测带宽→ADMM优化 \text{Hilbert} \rightarrow \text{解调到基带} \rightarrow \text{测带宽} \rightarrow \text{ADMM优化} Hilbert→解调到基带→测带宽→ADMM优化
完成分解。 - 在机器学习里,VMD 只是特征表示方法,不是用了 VMD 就一定提高预测精度,必须通过消融实验验证。
最后再用一个特别通俗的比喻
假设原始信号是一碗:
什锦豆子 \boxed{\text{什锦豆子}} 什锦豆子
里面混着:
红豆、绿豆、黄豆、黑豆。
LSTM 直接预测,相当于:
对着整碗豆子直接学习。
VMD 则先:
红豆绿豆黄豆黑豆 \text{红豆} \quad \text{绿豆} \quad \text{黄豆} \quad \text{黑豆} 红豆绿豆黄豆黑豆
分类摆好。
再交给模型。
但最关键的一点是:
分好了不代表一定更好预测。
最终必须通过:
原模型vsVMD+原模型 \boxed{\text{原模型} \quad vs \quad \text{VMD+原模型}} 原模型vsVMD+原模型
来证明。