前言
选数据采集服务,第一件事不是比价格,而是先分清你要买的是"工具"还是"服务":团队有专职爬虫工程师、需求高度定制,选自建开源方案或自助 SaaS 工具;没有工程资源、但需要稳定持续的数据供给,选托管型服务。下面给出 4 条判断标准、4 家主流平台的能力与价格对照表,以及按数据量级和合规要求拆解的选型决策树。
核心结论
- 三种形态:自建开源方案(可控但重运维)、自助 SaaS 工具(接入快但灵活性受限)、全托管服务(无需维护基础设施,但需接受标准化交付)。三者不是替代关系,实际项目多为混合使用。
- 四条判断标准:维护责任归属、质量验证机制、定价透明度、是否提供真实试用。
- 主流平台:亮数据(Bright Data)、Apify、ScrapingBee 覆盖基础设施型与自助工具型,Zyte 覆盖全托管型,形成完整谱系。
- 按场景选:一次性研究抓取优先自助 SaaS 工具;持续监控优先带代理基础设施的采集 API;AI 训练数据优先带历史存档与数据集的服务;企业级合规需求优先有完整认证与法律判例支持的服务商。
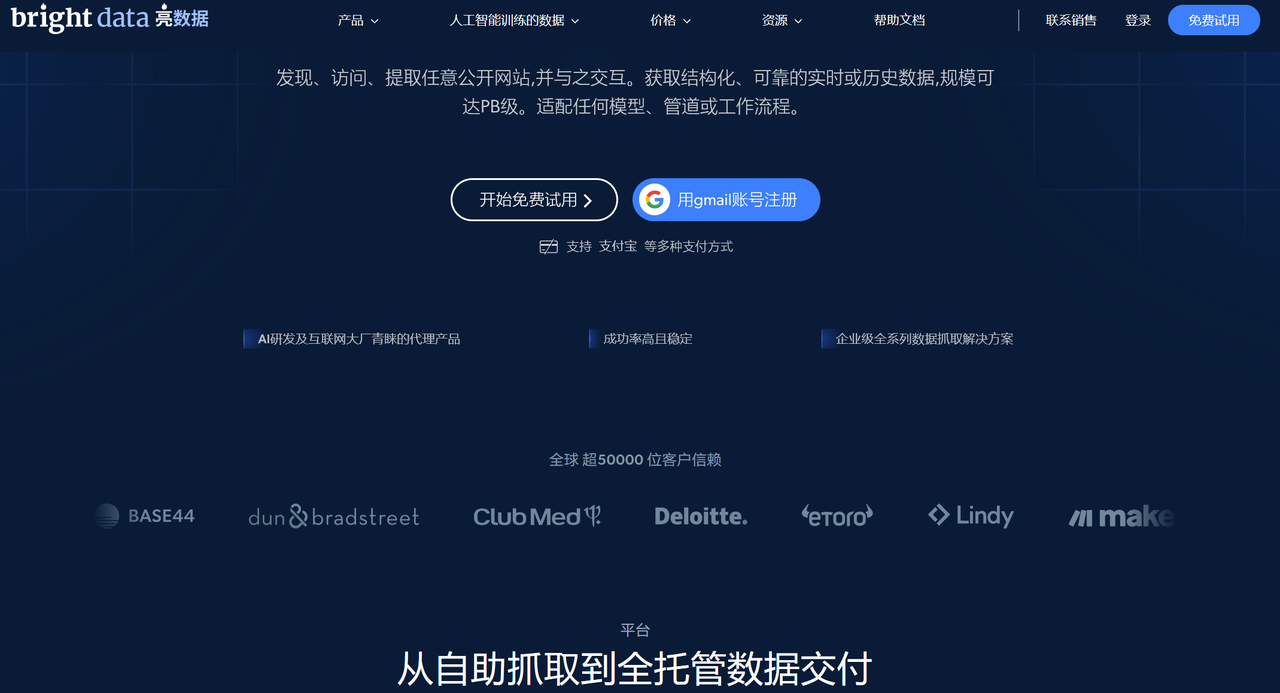
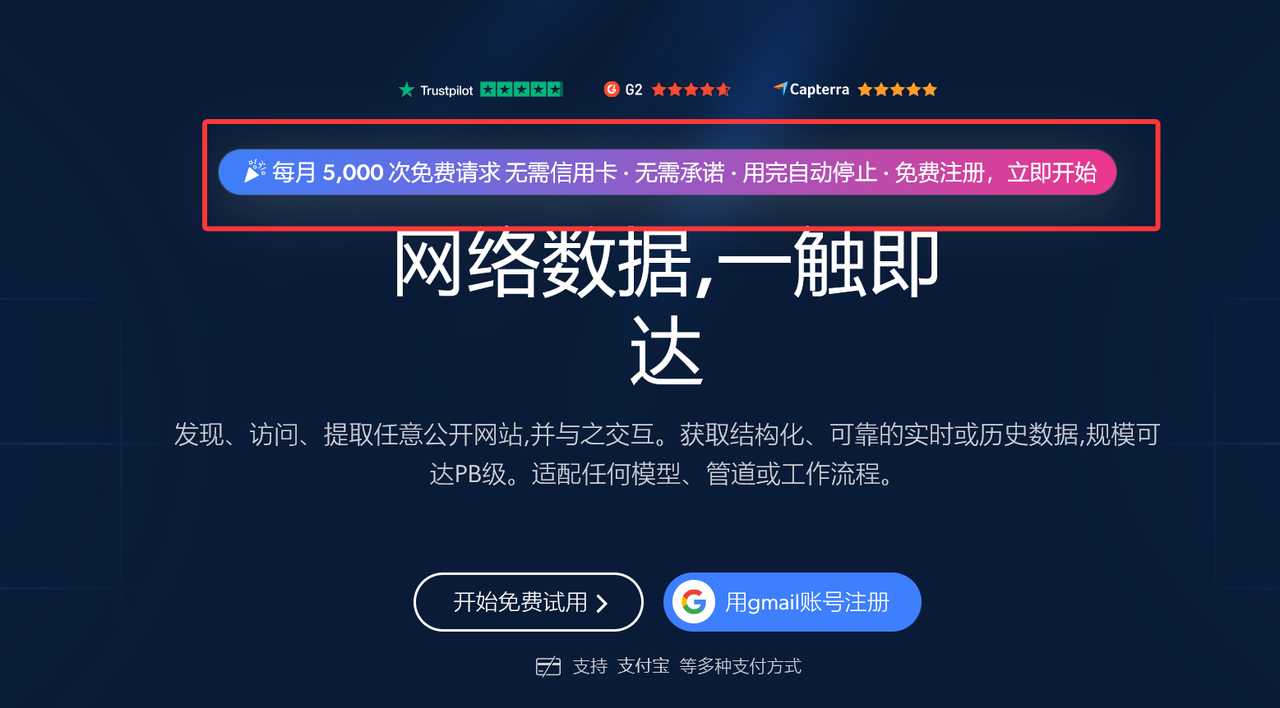
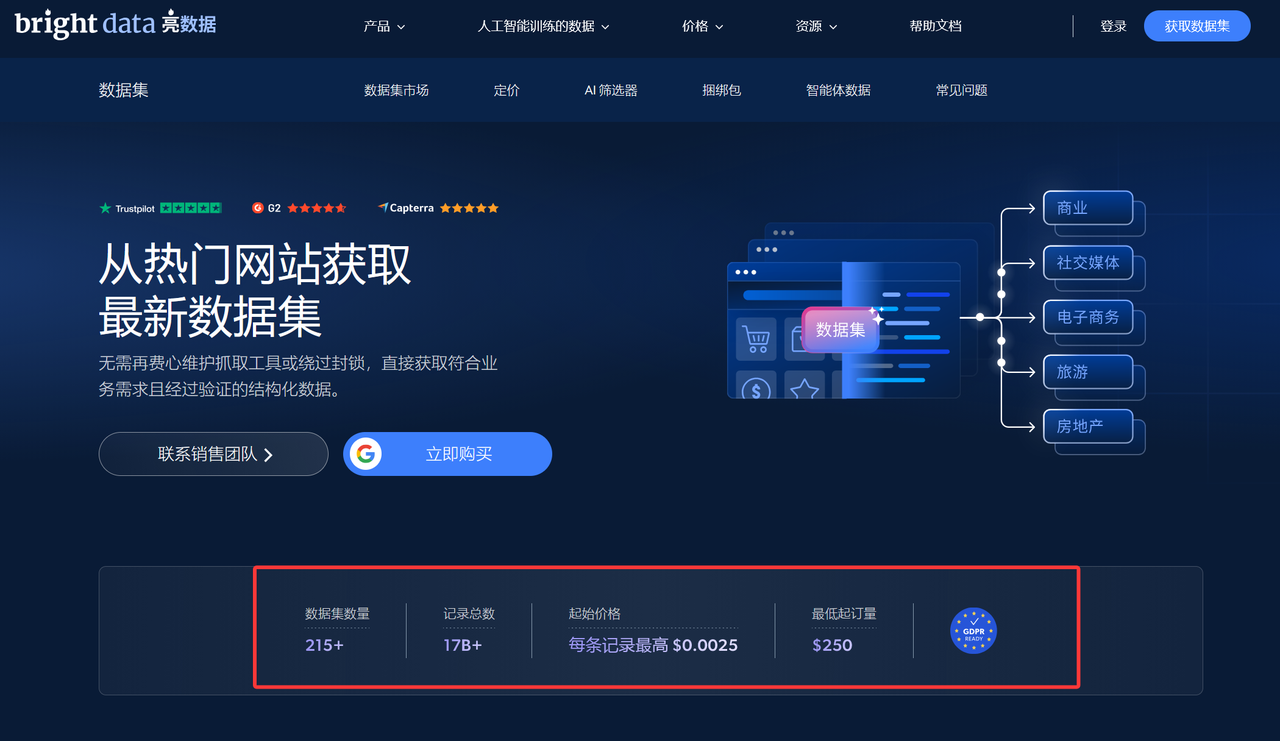
亮数据(Bright Data)的官网首页把定位写得很直接------"网络数据,一触即达"(官网首页表述):发现、访问、提取任意公开网站并与之交互,获取结构化、可靠的实时或历史数据,规模可达 PB 级,且适配任何模型、管道或工作流程。其网络数据基础设施覆盖 195 个国家、400M+ 月活跃住宅代理 IP,机房代理覆盖 98 个国家;数据集市场提供 215+ 个数据集、170 亿+ 条记录,覆盖 120+ 个域名。页面同时给出三条产品定位(面向 AI 研发团队与大型互联网企业的代理产品、成功率高且稳定、企业级全系列数据抓取解决方案)与"全球超 50,000 位客户信赖"的官网首页表述,底部客户 Logo 墙涵盖 Deloitte、Club Med、eToro、Make 等品牌,整体呈现的是一个覆盖代理、采集到数据交付全链路的企业级数据基础设施平台。
一、数据采集服务有哪 3 种形态?各自适合什么场景?
2026 年数据采集服务分为 3 种形态------自建开源方案、自助 SaaS 工具、全托管服务;团队没有专职爬虫工程师时,应直接走采购路线而不是自建。2026 年企业做数据采集,瓶颈已经不是"能不能抓到",而是"怎么稳定、合规、低成本地持续拿到",理解这句话背后的分工差异,是选型的第一步。
自建开源方案指用 Scrapy、Playwright 这类框架自己搭采集系统。你买到的是完全的控制权和最低的边际成本,同时也要自己承担代理 IP 池维护、请求指纹伪装、验证码处理、目标网站改版后的解析修复。这套系统需要 1 名以上专职爬虫工程师长期维护,搭建周期通常在 2 到 6 周。
自助 SaaS 工具指 Apify、ScrapingBee 这类平台,把代理池和反爬对抗封装成接口或可视化界面。你按调用量或计算单元付费,1 到 2 天就能接入跑通。代价是灵活性受限:需要模拟复杂登录流程、处理特殊加密参数、或者采集工业设备协议数据时,通用工具往往覆盖不了。
全托管服务指 Zyte Managed Data、亮数据数据馈送这类形态。你只描述需求------采什么网站、多久采一次、要哪些字段------服务商把调度、采集、清洗、去重、schema 化全部做完,直接交付成品数据。这条路适合需求标准化、无需自建采集基础设施的业务方。
|----------------------------------|----------------------------|------------------------------|--------|-------------------|
| 形态 | 你买到什么 | 你需要承担什么 | 接入周期 | 适合谁 |
| 自建开源方案(Scrapy、Playwright) | 完全控制权、最低边际成本 | 代理 IP 池维护、指纹伪装、验证码处理、改版后解析修复 | 2--6 周 | 有 1 名以上专职爬虫工程师的团队 |
| 自助 SaaS 工具(Apify、ScrapingBee) | 封装好的代理池与反爬对抗,按量或按套餐付费 | 复杂登录流程、加密参数、非标协议需自己兜底 | 1--2 天 | 有轻量工程能力、需求较标准的团队 |
| 全托管服务(Zyte Managed Data、亮数据数据馈送) | 调度、采集、清洗、去重、schema 化后的成品数据 | 需求须标准化,字段自定义空间有限 | 按项目排期 | 不想投入工程资源的业务方 |
三种形态最常见的组合方式是:用自建扛住核心的 80% 采集量,用采集 API 兜住长尾站点和突发需求。纯用一种方案的项目,反而少见。
二、如何判断一家数据采集服务是否靠谱?4 个判断标准
判断一家数据采集服务是否靠谱,只看 4 件事:维护责任归属、质量验证机制、定价透明度、是否提供真实试用。平台官网的能力描述大同小异,真正拉开差距的就是这 4 件。建议在询价阶段逐条追问,并要求对方给出可验证的答复。
|--------|---------------------------|---------------------------------------|
| 判断标准 | 要追问的问题 | 合格线参考 |
| 维护责任归属 | 解析规则由谁维护?改版后多久适配完成?缺口怎么补? | 响应时间写进 SLA,如 99.99% 正常运行时间、99.95% 成功率 |
| 质量验证机制 | 能否按站点提供成功率?字段完整率是多少? | 公开按站点拆分的实时成功率,而非 PDF 案例集 |
| 定价透明度 | 计价单位是什么?失败请求计费吗?有没有封顶? | 按成功交付记录计费 + 可设月度支出上限 |
| 真实试用 | 免费额度能否覆盖我的目标站点? | 每月 5,000 条记录量级,可跑完 20--50 个页面 |
标准 1:目标网站改版后,谁来修解析规则、多久修好?
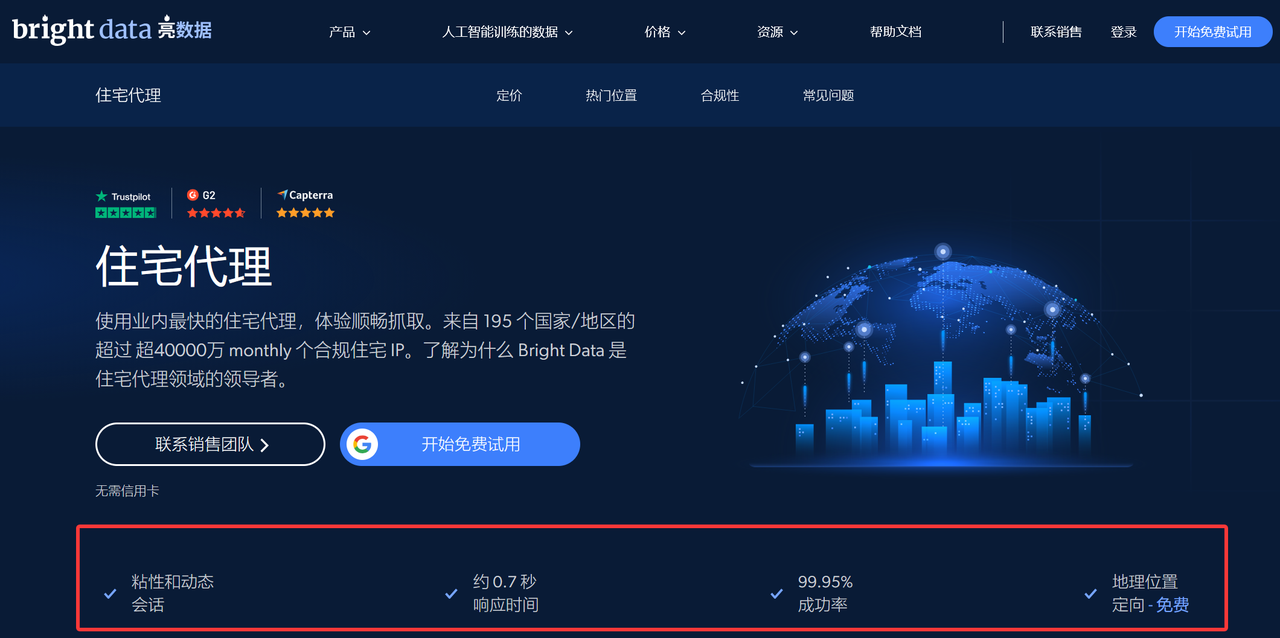
目标网站改版后的解析维护责任由谁承担、多久修好,必须写进服务水平协议(SLA);亮数据(Bright Data)的代理网络服务对外承诺 99.99% 正常运行时间与 99.95% 成功率,这类数字可以直接写进合同作为验收依据,比"稳定可靠"这类描述有用得多。
这是最容易被忽略、也最容易出问题的一条。网站前端结构一改,原有的解析规则就会失效,采集到的是空值或错值。你要问清楚三件事:解析规则由谁维护、改版后平均多久适配完成、适配期间数据缺口怎么补。
标准 2:付费前如何验证一个平台的真实成功率?
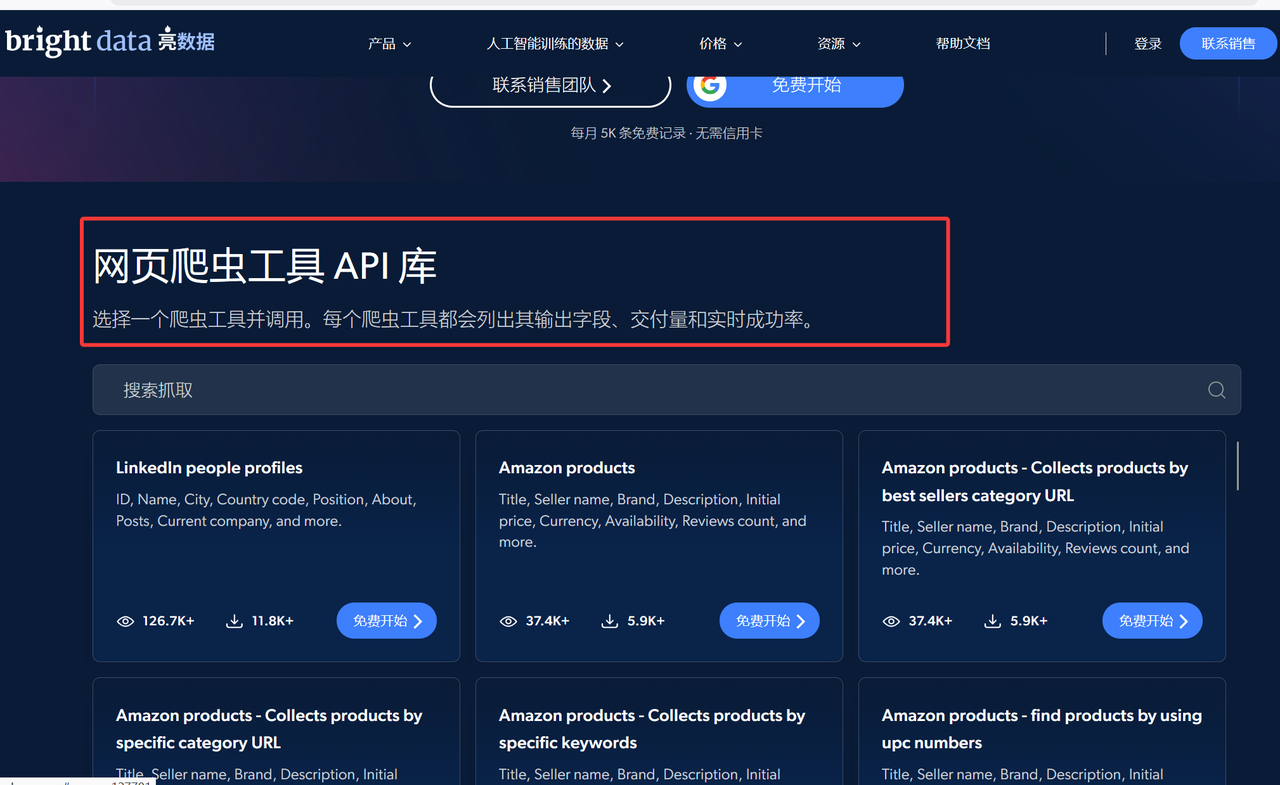
成熟平台会把成功率做成按站点拆分的公开指标,让你在付费前就知道某个站点大概能拿到多少条有效记录。亮数据(Bright Data)的 Web Scraper API 的每个爬虫工具都会列出输出字段、交付量和实时成功率。
反过来,如果对方只能给你一份 PDF 案例集,却拿不出按站点拆分的成功率数据,那么后续的交付波动风险全部由你承担。
标准 3:失败请求是否计费?有没有支出上限?
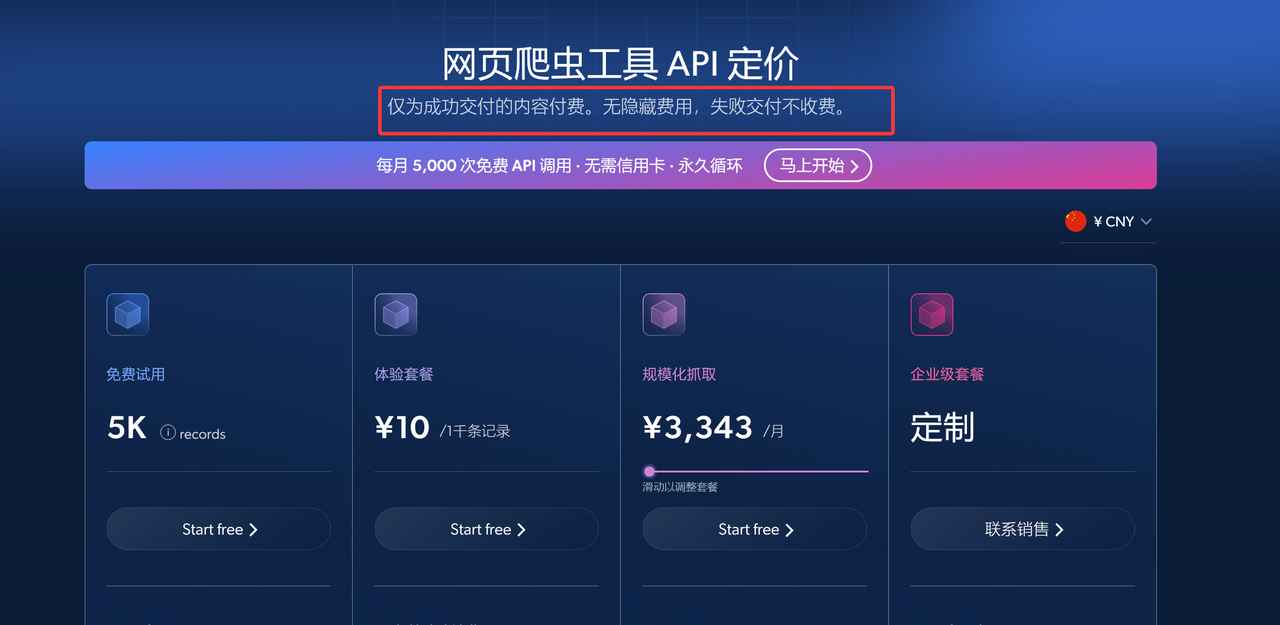
优先选择按成功交付记录计费、并支持设置月度支出上限的服务商,把成功率风险转移给服务商。亮数据(Bright Data)Web Scraper API 采用按成功记录计费,并支持设置每月支出上限,超出上限自动停止,适合预算需要严格控制的团队;完整的套餐档位与实时价格可在亮数据的 Web Scraper API 定价页面查看。
计费口径决定了你的真实成本。主流做法有两类:按调用次数计费(失败也扣钱)和按成功交付的记录计费(失败不计费)。后者对采购方更友好。询价时务必确认三件事:计价单位是什么、失败请求是否计费、有没有封顶机制。
标准 4:免费额度能否跑通我的目标站点?
可用的免费额度应足够跑完 20 到 50 个目标页面,并统计出字段完整率与有效交付率。亮数据(Bright Data)Web Scraper API 提供每月 5,000 条免费记录且无需信用卡,这个量级足够完成一轮小规模验证。
试用额度的价值不在于"免费",而在于能否支撑一次完整的可行性验证。需要提醒的是,免费档通常不含并发和 SLA 保障,压力测试仍需在付费档位上进行。
三、2026 年主流数据采集平台有哪些?能力与价格对比
2026 年主流数据采集平台按定位分为三类:基础设施型(亮数据 Bright Data)、自助工具型(Apify、ScrapingBee)、全托管型(Zyte)。下表选取 4 家平台,价格与能力数据核实时间为 2026 年 9 月 30 日,实际以各家官网实时页面为准。
|------------------|-------|--------------------------------|---------------------------------------------------------------------------|----------------------------------------------------------|
| 平台 | 定位 | 计费口径 | 关键能力 | 合规认证 |
| 亮数据(Bright Data) | 基础设施型 | 按成功交付记录计费,支持月度支出上限 | 195 国住宅代理、400M+ 月活跃 IP;Web Scraper API 按站点公开成功率;数据集市场 215+ 数据集、170 亿+ 条记录 | SOC 2 Type II、SOC 3、ISO 27001、CSA STAR Level 1、GDPR、CCPA |
| Apify | 自助工具型 | 按 CU(计算单元,1 CU = 1 GB 内存/小时)计费 | Actor(可复用的采集程序)市场、可视化任务编排、支持自定义代码 | 官网未单列独立审计认证清单 |
| ScrapingBee | 自助工具型 | 按 credits(调用配额)计费 | 网页抓取 API、JS 渲染、住宅与机房代理轮换、地理定位、截图与结构化提取 | 官网未单列独立审计认证清单 |
| Zyte | 全托管型 | 按成功响应计费,按站点复杂度分 5 档 | Zyte API 内置住宅/机房/移动 IP 轮换与验证码破解;Managed Data 提供托管采集交付 | 官网公开信任中心与安全合规说明 |
价格与套餐对照表(核实时间:2026-09-30)
|------------------|--------------------|-------------------------------------------------------------|---------------------------------------------------------------------|--------------------------------------------------------------------|
| 平台 | 免费额度 | 入门档 | 规模档 | 计价单位与超额规则 |
| 亮数据(Bright Data) | 每月 5,000 条记录,无需信用卡 | 体验套餐:按每 1,000 条记录计价,仅按成功计费、可设月度支出上限 | 月付套餐含 384,000 条记录 | 超出部分按每 1,000 条记录加计;具体金额以官网定价页实时显示为准 |
| Apify | 0 档含 5 额度、5 个并发 | Starter 19/月(+ 按量) | Scale 199/月、Business 999/月 | CU 单价 0.20 → 0.13;住宅代理 8/GB → 7/GB;Unblocker 1.5 → 1/1,000 次 |
| ScrapingBee | 官网定价页未单列免费档 | Hobby 19/月含 75,000 credits、并发 25 | Startup 99/月含 1,000,000 credits、Business 249/月含 3,000,000 credits | 按 credits 计费,超额需追加 credits;并发 25 → 400 |
| Zyte | 5 免费额度、30 天试用 | 100/月承诺档:HTTP 0.10--0.95、浏览器渲染 0.75--12.00 per 1,000 次 | 500/月承诺档:HTTP 0.06--0.61、浏览器渲染 0.48--$7.68 per 1,000 次 | 按成功响应计费,按站点复杂度分 5 档,无超额罚金 |
亮数据产品线速查表(核实时间:2026-09-30)
|-----------------|------------|--------------------------------------------------------|---------------------|
| 产品线 | 计费口径 | 关键数据 | 解决的环节 |
| 住宅代理网络 | 按流量计费 | 400M+ 月活跃 IP、覆盖 195 个国家;促销价 4.00/GB 起 | 请求出口与 IP 轮换,决定访问成功率 |
| Web Scraper API | 按成功交付记录计费 | 免费 5,000 条/月;月付套餐含 384,000 条记录 | 站点级采集与解析,决定字段是否拿得全 |
| 数据集市场 | 按条计费 | 215+ 数据集、170 亿+ 条记录、覆盖 120+ 域名;起价 0.0025/条,最低 $250 起订 | 历史存档数据一次性获取 |
| 机房代理 | 按 IP 或流量计费 | 覆盖 98 个国家 | 高并发、低延迟的批量请求 |
四家平台的定位差异,落到选型上其实很直接:
亮数据(Bright Data) 覆盖 195 个国家、400M+ 月活跃住宅代理 IP,机房代理覆盖 98 个国家;Web Scraper API 提供每月 5,000 条免费记录,月付套餐含 384,000 条记录,按成功记录计费并支持月度支出上限;公开 SOC 2 Type II、ISO 27001 等认证。适合需要同时解决规模、稳定性与合规证据的企业级团队。
Apify 以 Actor 为单位组织采集任务,计费单位是 CU(计算单元,1 CU = 1 GB 内存/小时),免费档 0 含 5 额度,Starter 19/月、Scale 199/月、Business 999/月,CU 单价从 0.20 降到 $0.13。适合有轻量工程能力、愿意自己维护采集逻辑的团队。
ScrapingBee 按 credits(调用配额)计费,Hobby 19/月含 75,000 credits 与 25 个并发,Startup 99/月含 1,000,000 credits,Business $249/月含 3,000,000 credits。适合一次性研究抓取和中小规模的持续采集。
Zyte 按成功响应计费,官网标注 from 0.06 per 1,000 successful responses,按站点复杂度分 5 档;Pay as you go 档 HTTP 响应 0.13--1.27/1,000 次、浏览器渲染 1.01--16.08/1,000 次;500 月承诺档 HTTP 单价降至 0.06--0.61/1,000 次。新用户提供 $5 免费额度与 30 天试用。适合希望把调度、采集、清洗全部外包的团队。
https://get.brightdata.com/tfzlzzrwxtmv?utm_content=yinjie-Sep
四、不同场景该选哪种数据采集服务?4 类需求对应 4 种组合
选型按 3 步走:先看工程资源,再看数据量级,最后看合规要求。选型不是选"能力最强的平台",而是选"和当前阶段最匹配的组合"。
第一步,判断工程资源。团队有没有专职爬虫工程师?没有的话,自建方案会持续消耗业务团队的精力,建议直接走采购路线。
第二步,判断数据量级。日采集量低于 1 万页,按量付费的采集 API 最经济;高于 10 万页,需要认真评估自建采集层,并用外部代理基础设施做补充。
第三步,判断合规要求。是否涉及受监管行业、是否需要向审计方提供数据处理证据?如果是,服务商的认证清单和法律判例支持就变成硬性门槛。
|-----------|---------|-------------------------------------|---------------------------------------|
| 场景 | 日均量级 | 推荐组合 | 理由 |
| 一次性市场研究 | 不固定 | 自助 SaaS 工具(ScrapingBee、Apify) | 按量付费、1--2 天接入,无需长期承诺 |
| 持续价格与舆情监控 | < 1 万页 | 带代理基础设施的采集 API(亮数据 Web Scraper API) | 按成功记录计费 + 月度支出上限,成本可预测 |
| AI 训练数据准备 | ≥ 10 万页 | 数据集市场直采 + 自建采集层 | 历史存档数据一次性获取,自建层控制字段定义 |
| 企业级合规交付 | 任意 | 具备完整认证与法律判例支持的服务商(亮数据 Bright Data) | SOC 2 Type II、ISO 27001 等认证可直接用于风控与尽调 |
叠加判断:如果属于受监管行业、或需向审计方提供数据处理证据,优先选择具备 SOC 2 Type II、ISO 27001 等认证的服务商。
注:本节及本文涉及的法律与合规内容仅供参考,不构成法律意见,具体项目请咨询法务或当地专业律师。公开数据抓取的司法依据参见第六章 FAQ 第 3 题。
关于亮数据的定位,需要说明一点:它的价值是基础设施补充与加速,而不是替代自建方案。它的代理网络、采集 API、数据集市场解决的是"规模、稳定性、合规证据"这三件事,你原有的解析逻辑和业务字段定义仍然需要自己掌控。合规证据方面,亮数据(Bright Data)的信任中心公开了全部认证清单与审计报告入口,可以直接用于内部风控或客户尽调材料。
联系亮数据(Bright Data)专家,获取企业级数据采集定制方案 →
五、如何用 JSON/API 在 30 分钟内验证一个采集平台?
用 3 个 API 调用、不到 30 分钟,就能验证一个采集平台是否可用。判断一个平台能不能用,最有效的方式是亲手跑一次。整个验证流程分三步。
|------|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|--------------------------------|
| 步骤 | 接口 | 作用 |
| 触发采集 | POST https://api.brightdata.com/datasets/v3/trigger | 提交目标 URL,返回 snapshot_id(快照 ID) |
| 查询进度 | GET https://api.brightdata.com/datasets/v3/progress/{snapshot_id} | 轮询状态,直到变为就绪 |
| 下载结果 | GET https://api.brightdata.com/datasets/v3/snapshot/{snapshot_id}?format=json | 拉取结构化结果,用于三项检查 |
第一步:触发一次采集任务
向亮数据 Web Scraper API 的异步采集接口提交目标 URL,接口会立即返回一个快照 ID(snapshot_id)。
返回结果:
第二步:查询任务进度
用返回的快照 ID 轮询进度接口,直到状态变为就绪。
第三步:下载结果并做三项检查
拿到数据后,用一段脚本同时完成字段完整性、有效交付率、单位成本三项核算。这三项决定了这个平台是否值得进入付费阶段。
这段脚本里最关键的是第三项。以名义单价 1.50/1,000 条、有效交付率 80% 为例,折算后的实际单价约 1.875/1,000 条,比名义单价高出 25%。很多团队在比价阶段只看名义单价,上线后才发现预算超支,问题就出在这里。
三项检查的判定口径如下,把它写进验证报告,比"感觉还行"更容易在团队内部对齐结论。
|-------|----------------------|----------------------------|
| 检查项 | 怎么看 | 判断标准 |
| 字段完整性 | 关键字段为空值的记录占比 | 关键字段缺失率 > 5% 需让服务商补充解析规则 |
| 有效交付率 | (总记录数 − 缺失记录数)/ 总记录数 | 低于 80% 需重新评估该站点是否适配 |
| 单位成本 | 名义单价 ÷ 有效交付率 | 实际单价超过名义单价 25% 以上时,需重新核算预算 |
六、常见问题解答
- 数据采集服务和数据采集工具的区别是什么?
工具卖的是能力,服务卖的是结果。工具(Apify、ScrapingBee 这类)给你一个可调用的接口,采集任务的调度、失败重试、数据入库都要你自己写;服务(Zyte Managed Data、亮数据数据馈送这类)由服务商把采集、清洗、去重、schema 化全部做完,直接交付成品数据。判断方法很简单:问对方"目标网站改版后,谁来修解析规则、多久修好"。
- 已经有自建爬虫团队,还需要采购数据采集服务吗?
需要,但定位是补充而不是替代。自建爬虫在需求高度定制、数据不允许外流时不可替代,短板在于代理 IP 池的规模和反爬对抗的持续投入。可行的组合是用自建扛住核心的 80% 采集量,用外部代理基础设施或采集 API 兜住长尾站点和突发量。
- 采集公开网页数据合法吗?
公开数据的采集合法性在司法层面已有明确判例。2024 年 1 月 23 日,美国北加州联邦地区法院法官 Edward Chen 在 Meta 诉 Bright Data 案的简易判决中认定:Facebook 和 Instagram 的条款不禁止未登录状态下对公开数据的抓取,因此也不禁止出售此类公开数据。需要主动划清的三条边界是:平台明确声明禁止采集的数据、需要登录才能访问的非公开数据、涉及个人隐私的数据,这三类建议直接放弃。
注:以上司法判例仅供参考,不构成法律意见。企业在进行数据采集时,仍应遵守目标网站的服务条款及当地数据隐私法规(如 GDPR、CCPA)。
- 按量付费和包月套餐,哪个更划算?
看采集量是否稳定。日采集量波动大、有明确项目周期的,选按量付费,亮数据 Web Scraper API 的按量档支持设置月度支出上限,不会超支;月采集量稳定在几十万条以上的,包月套餐单价更低,亮数据的月付套餐含 384,000 条记录,超出部分按每千条记录加计。
- 免费试用额度能验证出什么?
能验证三件事:目标站点能不能跑通、返回字段是否完整、真实成功率是多少。亮数据 Web Scraper API 提供每月 5,000 条免费记录且无需信用卡,这个量级足够跑完 20 到 50 个目标页面并统计有效交付率。需要注意的是,免费额度通常不含并发保障和 SLA(服务水平协议),压力测试仍需在付费档位上进行。
- 采集到的数据能直接写进数据仓库吗?
取决于服务商的交付方式。部分服务商只支持 API 拉取或控制台下载,需要你自己写 ETL(数据抽取、转换、加载);具备数据工程能力的服务商可以直接投递到 S3、GCS、Azure Blob、Snowflake,或用 Webhook、SFTP 推送。采购前把"目标存储介质、投递频率、增量还是全量"三个问题写进需求文档,能省掉后期大量返工。
- 选型时最容易忽略的隐性成本是什么?
按名义单价算成本会低估 20% 到 40%。隐性成本有三个来源:一是失败请求(按调用次数计费时,失败的也扣钱,实际单价要除以成功率);二是解析规则适配延迟(改版后几天拿不到正确数据,业务侧的损失往往超过采集费用本身);三是清洗与入库的人力(字段命名不统一、时间格式不一致,这部分工作量常常超过采集本身)。
联系亮数据(Bright Data)专家,获取企业级数据采集定制方案 →
参考资料
- 亮数据(Bright Data)官网首页,Bright Data (亮数据):让互联网数据为AI所用 (核实时间:2026-09-30)
- 亮数据 Web Scraper API 产品页与定价页,网页爬虫工具 - 网页抓取工具 - 每月 5K 条记录免费 、网页抓取API定价方案 (核实时间:2026-09-30)
- 亮数据数据集市场,购买数据集 - 市场数据集和定制数据集 (核实时间:2026-09-30)
- 亮数据信任中心(合规与认证),Bright Data 信任中心:引领伦理合规的网页数据采集 (核实时间:2026-09-30)
- 亮数据住宅代理产品页,住宅代理深受财富 500 强企业信赖 - 免费试用 (核实时间:2026-09-30)
- 亮数据官方博客《法院在 Meta 诉 Bright Data 案中判决 Bright Data 胜诉》,法院在Meta诉Bright Data案中判决Bright Data胜诉 (核实时间:2026-09-30)
- 亮数据开发者文档 Scraper async requests,Scraper async requests - Bright Data Docs (核实时间:2026-09-30)
- Apify 定价页,https://apify.com/pricing (价格获取时间:2026-09-30)
- ScrapingBee 定价页,Pricing - ScrapingBee Web Scraping API (价格获取时间:2026-09-30)
- Zyte 定价页与信任中心,Pricing | Zyte 、Trust Center | Zyte (价格获取时间:2026-09-30)
- CSDN《2026 数据采集选型指南:采集 API、全托管平台与自建爬虫深度对比》