Cost Based Optimizer(CBO)成本优化,根据统计信息和查询条件,自动选择最低成本的执行计划来确定语句的访问路径。CBO对数据敏感,一旦数据发生变化,重新收集统计信息后,执行计划会自动做出相应变化。因为数据库的数据是变化的,在某一时刻使用这个执行计划是最优的,在另一个时刻,却可能很差,这也是CBO 取代RBO的原因之一,规则是死的,而数据是时刻变化的,为了获得最正确的执行计划,只有知道表中数据的实际情况,通过计算各种执行计划的成本,择其最优,才是最科学的,这就是CBO的工作机制。
CBO成本优化:最核心思想就是选择最小成本的执行计划来尽可能地减少语句的访问路径,如通过建索引、建分区这种方式减少对全表的扫描。
统计信息
数据库统计信息提供有关数据库上的负载类型以及数据库使用的内部和外部资源的信息。
--执行了收集统计信息的动作,才会获取真实的统计信息
sql
SQL> create table test as select * from dba_objects where 1=2;
SQL> select blocks,empty_blocks,num_rows from dba_tables where table_name='TEST';
    BLOCKS EMPTY_BLOCKS   NUM_ROWS
---------- ------------ ----------
SQL> insert into test select * from dba_objects;
SQL> commit;
SQL> select blocks,empty_blocks,num_rows from dba_tables where table_name='TEST';
    BLOCKS EMPTY_BLOCKS   NUM_ROWS
---------- ------------ ----------

SQL> exec dbms_stats.gather_table_stats('SYS','TEST');
PL/SQL procedure successfully completed.

SQL> select blocks,empty_blocks,num_rows from dba_tables where table_name='TEST';
    BLOCKS EMPTY_BLOCKS   NUM_ROWS
---------- ------------ ----------
      1073            0      75603

SQL> delete from test;
SQL> commit;

SQL> select blocks,empty_blocks,num_rows from dba_tables where table_name='TEST';
    BLOCKS EMPTY_BLOCKS   NUM_ROWS
---------- ------------ ----------
      1073            0      75603

SQL> exec dbms_stats.gather_table_stats('SYS','TEST');
PL/SQL procedure successfully completed.

SQL> select blocks,empty_blocks,num_rows from dba_tables where table_name='TEST';
    BLOCKS EMPTY_BLOCKS   NUM_ROWS
---------- ------------ ----------
      1073            0          0
统计信息默认会自动收集,工作日每天晚上22:00-2:00,周末全天
sql
select client_name,status from DBA_AUTOTASK_CLIENT;
select * from DBA_AUTOTASK_WINDOW_CLIENTS;
select t1.window_name,t1.repeat_interval,t1.duration from dba_scheduler_windows t1,dba_scheduler_wingroup_members t2
where t1.window_name=t2.window_name and
t2.window_group_name='MAINTENANCE_WINDOW_GROUP';
如果想关闭统计收集可以使用包DBMS_AUTO_TASK_ADMIN
关闭周一自动优化器统计信息收集
sql
BEGIN
  DBMS_AUTO_TASK_ADMIN.DISABLE(
    client_name => 'auto optimizer stats collection',
    operation => NULL,
    window_name => 'MONDAY_WINDOW');
END;
select WINDOW_NAME,OPTIMIZER_STATS from DBA_AUTOTASK_WINDOW_CLIENTS;
如果想修改统计信息收集的时间段可以使用包DBMS_SCHEDULER
修改周五的统计信息收集时间持续时间长为3小时
sql
BEGIN
  DBMS_SCHEDULER.SET_ATTRIBUTE(
  name => '"SYS"."FRIDAY_WINDOW"',
  attribute => 'DURATION',
  value => numtodsinterval(180,'minute'));
  END;
select t1.window_name,t1.repeat_interval,t1.duration from dba_scheduler_windows t1,dba_scheduler_wingroup_members t2
where t1.window_name=t2.window_name and
t2.window_group_name='MAINTENANCE_WINDOW_GROUP';
难点:曾经遇到过500GB的超大的非分区表,对该表收集统计非常慢,非常麻烦,有没有什么方法可以解决,可以尝试以下三种方式
1、启用并行
EXEC DBMS_STATS.GATHER_TABLE_STATS(degree => DBMS_STATS.AUTO_DEGREE);
2、增量收集
EXEC DBMS_STATS.SET_TABLE_PREFS('SCHEMA_NAME', 'TABLE_NAME', 'INCREMENTAL', 'TRUE');
3、19C新功能
实时统计信息(Real-Time Statistics)减少手动收集频率
执行计划
查看执行计划的执行顺序的方法:
由上至下找到第一个并列的两列开始,从上至下,从右向左。
由上至下:在执行计划中一般含有多个节点,相同级别(或并列)的节点,靠上的优先执行,靠下的后执行
从右向左:在某个节点下还存在多个子节点,先从最靠右的子节点开始执行。
下图执行计划顺序是:3542610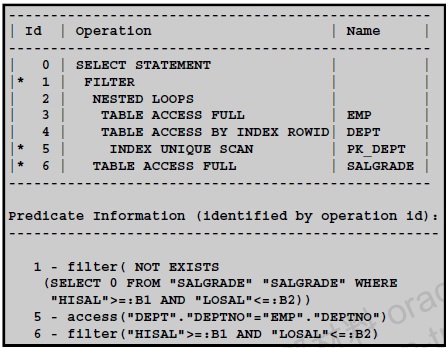
查看SQL语句的执行计划和统计信息的最好方法是如下
SQL>SET AUTOTRACE TRACEONLY
SQL>执行需要查看执行计划的SQL语句
或
SQL>执行需要查看执行计划的SQL语句
SQL>select * from table(dbms_xplan.display_cursor);
查找已经执行过的sql的执行计划
select * from table(dbms_xplan.display_cursor(v$sql.HASH_VALUE,0,'advanced'));
执行计划中的display_cursor游标是指共享游标(shared cursor),跟pl/sql语句中定义的游标(session cursor)不是一个概念。
共享游标:是用户提交SQL或PL/SQL程序块到Oracle的share pool之后,在library cache中生成的一个可执行对象,这个对象我们称之为游标(cursor)。是SQL语句在进行硬解析时生成的,其元数据被在视图Vsqlarea与vsqlarea与vsqlarea与vsql中具体化。
PL/SQL游标:则是用于存放SQL语句的执行结果,用户可以通过这个中间缓冲区逐条取出游标中的记录并对其处理,直到所有的游标记录被逐一处理完毕。需要声明、打开、提取、关闭。
共享游标包括父游标和子游标。
父游标:是在进行硬解析时产生的。将SQL语句的文本进行哈希得到哈希值并在library cache寻找相同的哈希值(SQL语句必须完全一致包括大小写、空格回车等才能共享),如不存在则生存父游标且保存在library cache中,按顺序完成后续步骤。如果此时存在父游标,则进一步判断是否存在子游标。若存在相同的子游标,则直接调用其子游标的执行计划执行该SQL语句,否则转到下一步进行逻辑优化。
子游标:在发生硬解析时,在产生父游标的同时,则跟随父游标会产生相应的子游标,此时V$SQL.CHILD_NUMBER的值为0。如果存在父游标,由于不同的运行环境,此时同样会产生新的子游标,新子游标的CHILD_NUMBER在已有子游标基础上以1为单位累计。v$sql中的每一行表示了一个child cursor子游标,根据sql_id与父cursor关联。child cursor有自己的address,即v$sql.child_address。如果你想确定是由那种原因造成的子游标,需要查看v$sql_shared_cursor。
1.父游标的关键信息是sql文本,子游标的关键信息是执行计划和执行环境。
2.硬解析通常是由于不可共享的父游标造成的,如经常变动的SQL语句,或动态SQL或未使用绑定变量等。解决硬解析的办法则通常是使用绑定变量来解决。
3.与父游标SQL文本完全一致的情形下,多个相同的SQL语句可以共享一个父游标。
4.SQL文本、执行环境完全一致的情形下,子游标能够被共享,否则如果执行环境不一致则生成新的子游标。如果SQL文本相同,但是可能提交SQL语句的用户不同,或者用户提交的SQL语句所涉及到的对象为同名词等,都有可能生成不同的子游标。因为这些SQL语句的文本虽然完全一样,但是上下文环境却不一样,因此这样的SQL语句不是一个可执行的对象,必须细化为多个子游标后才能够执行。
5.游标是可以被所有进程共享的,也就是说如果100个进程都执行相同的SQL语句,那么这100个进程都可以同时使用该SQL语句所产生的游标,从而节省了内存。
两条一模一样的语句但是在不同的schema下执行的两种结果
如sys和system都执行select * from t1.test则V$SQL只有一条记录,谁先执行则PARSING_SCHEMA_NAME显示谁。
如sys和system都执行select * from test则V$SQL中有两条记录,两条记录的CHILD_NUMBER和PARSING_SCHEMA_NAME不一样
硬解析和软解析概念
当客户端进程,将SQL语句通过监听器发送到Oracle时, 会触发一个Server process生成,来对该客户进程服务。Server process得到SQL语句之后,对SQL语句进行Hash运算,然后根据Hash值到library cache中查找,如果存在,则直接将library cache中的缓存的执行计划拿来执行,最后将执行结果返回该客户端,这种SQL解析叫做软解析;如果不存在,则会对该SQL进行解析parse,然后执 行,返回结果,这种SQL解析叫做硬解析。
SQL规范肯定是要绑定变量的,数据倾斜也并非什么常态,实际情况下adaptive cursor sharing还是用的比较少的,遇到没有绑定变量的情况下就把参数cursor_sharing改成force吧
绑定变量,可以减少硬解析(sql语句一模一样,在语义分析过程中生成的hash value才会一样,大小写不一样或空格不一样都属于不同的sql语句)
select * from tab where col=A
select * from tab where col=B
上面两个sql语句的方式应该如下
select * from tab where col=&
BIND PEEKING
Bind Peeking 就是当在WHERE条件中使用绑定变量的时候,CBO会根据第一次使用的真实变量值来生成一个执行计划。在这个cursor的整个生命周期中,CBO不会再对相同的SQL进行hard parse。这种办法的优点是:如果索引字段的值是均匀分布的,hard parse就降低了,性能提高。但是缺点也很明显:如果字段分布不均匀,并且第一次使用值不具有普遍性,那么执行计划就将非常糟糕。即字段数据分布倾斜严重时,使用绑定变量进行查询时,bind peeking可能导致产生不正确的执行计划.
解决这个问题就是Oracle11g 提供的一个新特性Adpative Cursor Sharing
CURSOR_SHARING参数
FORCE
使用了绑定变量可以使用同一个执行计划游标,并运行创建一个新的执行计划游标(即adaptive cursor sharing可以和CURSOR_SHARING共存)
EXACT
一模一样的SQL文本才能共用一个执行计划游标
cursor_sharing=force
意味着Oracle会对SQL谓词值进行强制的绑定变量替换,这样谓词不一样的SQL会认为是一模一样的SQL。使用第一次的bind peeking值生成执行计划,之后全部使用这个执行计划。这种方式实现了游标共享,避免出现大量的library cache硬解析。
如果这种SQL语句本身是"Good SQL",也就是条件列分布比较平均,没有出现过大的偏移分布。我们认为这种FORCE是很有益的。但是如果数据列分布不平均,这样借用第一次输入的bind peeking生成并且共享执行计划就很成问题,也就是说在cursor_sharing取值FORCE遇到的潜在问题和我们使用绑定变量时候使用的bind peeking值问题是相同的,但是11G之后这个问题都不存在了,11G的时候就算CURSOR_SHARING=force时也会使用adaptive cursor sharing功能。
adaptive cursor sharing自适应游标共享
默认启动的(_optimizer_adaptive_cursor_sharing参数默认为true)。
其允许一个使用绑定变量的SQL语句使用多个执行计划。即具有绑定变量的sql语句可能会生成多个游标。如果没有adaptive cursor sharing则数据存在数据倾斜的情况下使用绑定变量倒可能是最差的方式。
执行计划中逻辑读(当前读+一致性读),物理读,多块读,单块读的理解
逻辑读=db block gets(当前读)+consistent gets(一致性读)
逻辑读:我们都知道,数据块是oracle最基本的读写单位,但用户所需要的数据,并不是整个块,而是块中的行或列。从SGA中的Data Buffer Cache的块中读取行的过程,就是逻辑读。
当前读:指读取数据库中数据块当前的最新提交版本。通常用于DML语句(INSERT/UPDATE/DELETE)中,需要获取相应的锁。
一致性读:读取基于查询开始时的SCN(System Change Number)的一致快照,不会看到查询开始后其他事务提交的更改,通过undo段实现多版本,不需要获取锁,不会阻塞写操作。
物理读:从磁盘中读取到SGA的Data Buffer Cache中,消耗的是IO
多块读:分散读取通常是多块读取。 多块读的场景是Full Table Scan和Index Fast Full Scans
单块读:顺序读取是单块读取。
执行计划中三种连接关系
Hash join
哈希连接:将行源1计算成一张基于连接键的hash表,行源2的每条记录也计算成hash值去依次扫描这张hash表,找到匹配的记录放到结果集。(只能用于等值连接 where a=b或inner join a=b),非N*M的关联方式
Nested loops
循环嵌套连接:行源1的每一条记录,依次去匹配行源2的每条记录,将符合连接条件的记录放在结果集中,直到行源1的所有记录都完成这个操作。N*M的关联方式(行源1只执行一次,把N行结果都返回父操作,行源2如果有M行,则行源2需要执行M次,每次都去匹配父操作中的N行记录中一条记录,直到N行记录匹配完毕)
Nested Loops的一个例子
例如,表连接只返回一条记录,存在2张表,一个10条记录,一个1000万条记录,若2表都存在连接字段索引
小表为驱动表的代价:10*(通过索引在大表查询一条记录的代价),大概105
大表为驱动表的代价:1000万 (通过索引在小表查询一条记录的代价),大概1000万*3
通过索引获取一条记录(取一条记录那在表里肯定就是一个块了,除非那行大于块的大小8k),10行的表代价通常在3 blocks,索引2块,表1块。1000万的表代价通常5 blocks,索引可能达到4块,表1块
Driving Table(驱动表): 该表又称为外层表(OUTER TABLE)。通俗的理解就是执行计划中NESTED LOOPS先执行的那个表
Probed Table(匹配表): 该表又称为内层表(INNER TABLE)
--假如sql执行的方式如下,那么A就是驱动表,B表就是匹配表
sql
select ...from A, B where A.id=B.id;
Array A=(select * from A);
Array B=(select id from B);
for(int i=0;i<A.length;i++)
{
   for(int j=0;j<B.length;j++)
  {
      if(A[i].id==B[j].id)
     {
         resultSet.add(A[i]);
         break;
      }
  }
}
return resultSet;
A表(即驱动表)每返回一条记录,都要去B表去轮询一次,得到与其匹配的数据,推送到结果集中。所以在嵌套循环的使用中,必须设置返回记录少的表作为驱动表,可以通过以下两点来提高嵌套循环的速度。
第一:尽量提高A表取记录的速度(A表的连接列上创建索引)
第二:尽量提高B表记录匹配速度(B表的连接列上创建索引)
Sort merge join
排序合并连接:行源1和行源2的数据分别排序,然后将两个排序的源表合并,符合连接条件的记录放到结果集中。
执行计划中Hint的作用
Hint 是Oracle 提供的一种SQL 语法,它允许用户在SQL 语句中插入相关的语法,从而影响SQL 的执行方式,Hint就是Oracle提供的一种机制,用来告诉优化器按照告诉它的方式生成执行计划。Hint的缺点的就是它不会去适应新的变化。比如数据结构、数据规模发生了重大变化,但使用Hint的语句是不会感知变化并产生更优的执行计划。
语法格式:SQL>select /*+ rule */ column_name from table_name;
工作中用到Hint的情况:select /*+ parallel(t 4) */ * from table; --并行执行
执行计划中访问表和索引的方式
多块读的场景
Full Table Scan --全表扫描
Index Fast Full Scans --索引快速全扫描,不带order by情况下常发生
单块读的场景
Rowid Scans --直接通过Rowid获取,最快的访问数据方式
Index Unique Scans --索引唯一扫描,通过唯一索引查找一个数值
Index Range Scans --索引局部扫描,一般WHERE限制条件中使用了范围操作符号(>,<,between)
Index Skip Scans --索引跳跃扫描,where条件列是非索引的前提情况下常发生
Index Full Scans --索引全扫描
全表扫描(Full Table Scans FTS)
为实现全表扫描,Oracle 读取表中所有行,并检查每一行是否满足语句的WHERE限制条件,全表扫描时一次I/O 能读取多个数据库块(db_file_multiblock_read_count参数设定),而不是只读取一个数据块,即多块读,这极大的减少了I/O 总次数,提高了系统的吞吐量。
索引扫描(Index Scan或index lookup)
我们先通过index查找到数据对应的rowid值(对于非唯一索引可能返回多个rowid值),然后根据rowid直接从表中得到具体的数据,这种查找方式称为索引扫描或索引查找(indexlookup)。一个rowid唯一的表示一行数据,该行对应的数据块是通过一次I/0得到的,在此情况下该次I/0只会读取一个数据库块,即单块读。
在索引中,除了存储每个索引的键值外,索引还存储具有此键值的行对应的ROWID值。
索引扫描由2步组成:
1 扫描索引得到对应的rowid 值。
2 通过找到的rowid 从表中读出具体的数据。
每步都是单独的一次I/O,但是对于索引,由于经常使用,绝大多数都已经CACHE 到内存中,所以第1 步的I/O 经常是逻辑I/O,即数据可以从内存中得到。但是对于第2 步来说,如果表比较大,则其数据不可能全在内存中,所以其I/O 很有可能是物理I/O,这是一个机械操作,相对逻辑I/O 来说,是极其费时间的。
索引跳跃:复合索引,前导列或前导列组合的结果可选择性小,即不同值少,才会发生索引跳跃,这样后面的列单独作为条件也会走这个复合索引
全表扫描比索引扫描还快的场景
因为逻辑读物理读单位是次块(一次读取相同或不同块数情况下,看读取了多少次,当然逻辑读没有IO,只有物理读有IO),数据总块数一样的情况下,多块读的话,读取次数就少,逻辑读或物理读就少了,而全表扫描就是多块读。
个人理解:一个IO就是一个IO,不管多块,还是单块,都是一个次IO。就好比你花1块钱买了1颗糖,有人1块能买10颗糖,消耗的成本其实都是1块钱。再比如一秒内要读完10个块,单块读的话1次读一个块,需要10次,多块读的话假如1次读10个块,需要1次。虽然两者产生的IO吞吐量都是一样的,但是前者的IOPS是10,后者的IOPS是1,而一次IO的开启和结束是要消耗操作系统很多资源的。
索引扫描可能不如全表扫描的场景的理解__纯粹数据量而言,不涉及CLUSTERING_FACTOR
案例1
假定多块读,一次读取5个数据库块,一张大表10000个数据库块,100个索引块,如果要取出的数据大于总量的20%,使用索引扫描,因为两步的每一步都是单独的一次I/O,且每一次I/O都是单块读只能读取一个数据库块,所以要扫描的次数=索引块的数量+全部数据块的20%的数量=100+10000*20%=2100次,如果都是物理读那么其中IO次数就是2100;使用全表扫描,一次就读取5个数据块,所以要扫描的次数=全部数据块/5=10000/5=2000,如果都是物理读那么IO次数就是2000。
案例2
假设一张表含有10万行数据--------100000行
我们要读取其中20%(2万)行数据----20000行
这张表一共有10000个数据块--------10000块(一个块10行,每行800字节)
索引占100个数据块
通过索引读取20000行数据 = 100+约20000个table access by rowid = 需要处理20100个块来执行这个查询,但是,整个表只有10000个块,所以:如果按照索引读取全部的数据的20%相当于将整张表平均读取了2次。
当然也不能说索引读取行数大于整表的块数,就会选择全表扫描了,还要考虑读取的块是逻辑读还是物理读。
如果都是逻辑读,两者都没有产生IO
如果都是物理读,不是CLUSTERING_FACTOR极端的情况下,肯定是索引扫描次数大于全表扫描次数
--比如上面案例2索引扫描虽然要处理20000个块,但是这20000个块,肯定不是都是物理读,其中物理读IO正常情况下大概也就2000个块(占整表块的20%),索引扫描的话如果都是物理读那么IO是100+2000=2100次,全表扫描的话如果都是物理读且多块读每次4个块的话那么IO是10000/4=2500次。当然如果这20%的数据分布极端散列,分布在了表的所有块上, 也就是10000个块上,如果索引扫描和全表扫描都是物理读,那么索引扫描的IO=100+10000,全表扫描的IO=10000/4=2500。
CLUSTERING_FACTOR
查看ALL_INDEXES的CLUSTERING_FACTOR*值来判断索引字段值(对应查询where条件的字段)对应的数据在整个表数据块中的离散程度,如果值接近表的块数,则不离散走索引。如果值接近表的行数,则离散走全表扫描
假如表的总块数是5000个块,有100000行,如果表的数据太离散,带上where 条件object_id=100的数据只有6000行,但是分布在太多不同的块上假如就是5000个块,可能走索引回表6000次就需要在5000个不同的块上取数据,成本等于5000个数据块+索引块数,那肯定走全表扫描了。如果表的数据不那么离散,object_id=100的数据分布就在200个块上,那回表6000次还是回到那200个块上取数据,这时成本等于200个数据块+索引块数,那走索引扫描了
总结全表扫描比索引扫描还快的场景
1、如果较大表进行索引扫描,取出的数据如果大于总量的5%---10%,使用索引扫描可能效果还不如全表扫描
2、特别小的表比如才5个数据块的小表进行扫描,全表扫描多块读每次5个块可能才一次IO,但是索引扫描可能有6次IO
3、某个索引CLUSTERING_FACTOR存储数据太散,该索引键值对应的数据分布在表的所有数据块上
一模一样的SQL重新解析即重新生成执行计划的方法(19C只有以下2,5,6可行了)
1.对SQL中的对象analyze收集统计信息
SQL> analyze table TEST_OWNER.TEST_TABLE compute statistics;
--11G可以,但是19C不行了
2.对SQL中的对象gather_table_stats加no_invalidate=>FALSE收集统计信息
SQL> exec dbms_stats.gather_table_stats('TEST_OWNER','TEST_TABLE',no_invalidate=>FALSE);
3.在SQL引用的对象上执行了DDL操作,甚至是结构发生了变化,比如新增一个索引或comment。
SQL> comment on column TEST_TABLE.TEST_COLUMN is 'column is test for sqlplan';
--11G可以,但是19C不行了
4.对SQL引用的对象进行了权限更改。
SQL> grant all on TEST_OWNER.TEST_TABLE to TEST_OWNER2
--11G可以,但是19C不行了
5.单独清除这个sql在共享池中的信息
Exec DBMS_SHARED_POOL.PURGE('v$sql.ADDRESS,v$sql.HASH_VALUE','c')
虽说10G开始sql_id等同于address+hash value的作用,但此处不能使用sql_id
6.SQL长时间没有执行,被刷出SHARED POOL,或直接刷新共享池,再次执行时需要重新解析。
SQL> alter system flush shared_pool;
索引
B-Tree索引理解
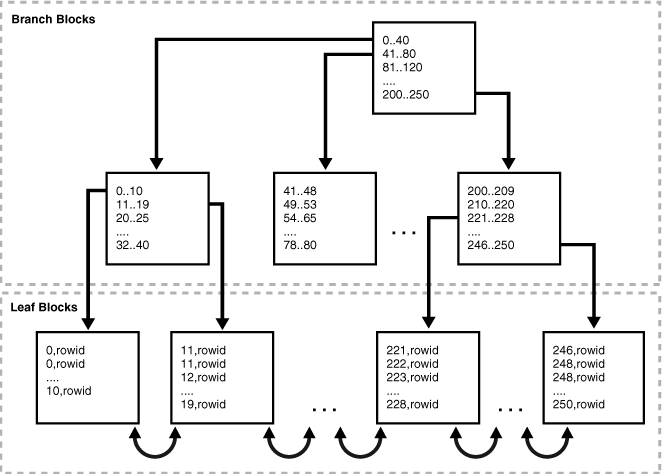
BTree中B代表Balanced(平衡),叶子块包含排序后的数据值和用于定位实际行的相应rowid
分支节点块(包括根节点块):其所包含的索引条目都是按照顺序排列的(缺省是升序排列)。每个索引条目(也称索引自身的每条记录)都具有两个字段。第一个字段表示当前该分支节点块下面所链接的索引块中所包含的最小键值,就是表的字段值;第二个字段表示所链接的索引块的地址,该地址指向下面一个索引块。在一个分支节点块中所能容纳的记录行数由数据块大小以及索引键值的长度决定。如图《BTree索引图理解》,对于根节点块来说,包含三条记录,分别为(0 B1)、(500 B2)、(1000 B3),它们指向三个分支节点块。其中的0、500和1000分别表示这三个分支节点块所链接的键值的最小值。而B1、B2和B3则表示所指向的三个分支节点块的地址。
叶子节点块:其所包含的索引条目与分支节点一样,都是按照顺序排列的。每个索引条目也具有两个字段。第一个字段表示索引的键值,就是表的字段值。第二个字段表示键值所对应的记录行的ROWID,该ROWID是记录行在表里的物理地址。
举个例子来了解B-Tree索引
test1表的数据信息
sql
SQL> create table test1 as select * from hr.jobs;
SQL> set linesize 200
SQL> select rowid,a.* from test1 a;
ROWID              JOB_ID     JOB_TITLE                           MIN_SALARY MAX_SALARY
------------------ ---------- ----------------------------------- ---------- ----------
AAAS29AABAAAWCBAAA AD_PRES    President                                20080      40000
AAAS29AABAAAWCBAAB AD_VP      Administration Vice President            15000      30000
AAAS29AABAAAWCBAAC AD_ASST    Administration Assistant                  3000       6000
AAAS29AABAAAWCBAAD FI_MGR     Finance Manager                           8200      16000
AAAS29AABAAAWCBAAE FI_ACCOUNT Accountant                                4200       9000
AAAS29AABAAAWCBAAF AC_MGR     Accounting Manager                        8200      16000
AAAS29AABAAAWCBAAG AC_ACCOUNT Public Accountant                         4200       9000
AAAS29AABAAAWCBAAH SA_MAN     Sales Manager                            10000      20080
AAAS29AABAAAWCBAAI SA_REP     Sales Representative                      6000      12008
AAAS29AABAAAWCBAAJ PU_MAN     Purchasing Manager                        8000      15000
AAAS29AABAAAWCBAAK PU_CLERK   Purchasing Clerk                          2500       5500
AAAS29AABAAAWCBAAL ST_MAN     Stock Manager                             5500       8500
AAAS29AABAAAWCBAAM ST_CLERK   Stock Clerk                               2008       5000
AAAS29AABAAAWCBAAN SH_CLERK   Shipping Clerk                            2500       5500
AAAS29AABAAAWCBAAO IT_PROG    Programmer                                4000      10000
AAAS29AABAAAWCBAAP MK_MAN     Marketing Manager                         9000      15000
AAAS29AABAAAWCBAAQ MK_REP     Marketing Representative                  4000       9000
AAAS29AABAAAWCBAAR HR_REP     Human Resources Representative            4000       9000
AAAS29AABAAAWCBAAS PR_REP     Public Relations Representative           4500      10500
MIN_SALARY字段建立索引ind_minsal
SQL> create index ind_minsal on test1(MIN_SALARY);
ind_minsal索引存储的信息类似如下:排序过的表字段MIN_SALARY的值和rowid
sql
SQL> select MIN_SALARY,rowid from test1 order by MIN_SALARY;
MIN_SALARY ROWID
---------- ------------------
      2008 AAAS29AABAAAWCBAAM
      2500 AAAS29AABAAAWCBAAN
      2500 AAAS29AABAAAWCBAAK
      3000 AAAS29AABAAAWCBAAC
      4000 AAAS29AABAAAWCBAAO
      4000 AAAS29AABAAAWCBAAR
      4000 AAAS29AABAAAWCBAAQ
      4200 AAAS29AABAAAWCBAAE
      4200 AAAS29AABAAAWCBAAG
      4500 AAAS29AABAAAWCBAAS
      5500 AAAS29AABAAAWCBAAL
      6000 AAAS29AABAAAWCBAAI
      8000 AAAS29AABAAAWCBAAJ
      8200 AAAS29AABAAAWCBAAF
      8200 AAAS29AABAAAWCBAAD
      9000 AAAS29AABAAAWCBAAP
     10000 AAAS29AABAAAWCBAAH
     15000 AAAS29AABAAAWCBAAB
     20080 AAAS29AABAAAWCBAAA
以上,如果执行select * from test1 where MIN_SALARY=4200查找MIN_SALARY字段值为4200的行,如果没有索引,就得全表扫描。如果有索引,则扫描索引,因为索引是顺序的,可以很快定位到这个字段值在索引中的位置,再通过rowid可以很快找到表中的行。表字段越多行数越多,索引的效果越明显。
索引组织表(Index Organization Table)
表的行数据和B*树索引是物理存贮在一起的。是表不是索引但是只有索引段,没有数据段。
sql
SQL> create table test2(ID varchar2(10),NAME varchar2(20),constraint pk_id primary key(ID)) organization index;
SQL> insert into test2 values(1,'1');
SQL> select index_name from dba_indexes where table_name='TEST2';
SQL> select SEGMENT_TYPE,BYTES from dba_segments where segment_name='TEST2';--没有结果
SQL> select SEGMENT_TYPE,BYTES from dba_segments where segment_name='PK_ID';--有结果
反向键索引
其实就是oracle在索引中存储索引键值的时候,将数据反向存储,比如说12345反向之后就变成了54321.
这样做的目的: 当程序需要访问 12345 和12346 和12347等等这种比较连续的数值时,不至于导致访问的数据在同一个索引块上。通过"反转",本来连续的数据就变得相距甚远,对这些索引键值的插入就会分散到多个块上,从而有效降低大批量数据插入是对同一数据块的"争用",避免"热快"的产生,从而提高效率。
位图索引 Bitmap index
适用场合:列的基数很少,可枚举,重复值很多,数据不会被经常更新,比如sex字段,只有man和woman两个字段
监控索引
打开监控:alter index 索引名 monitoring usage
关闭监控:alter index 索引名 nomonitoring usage
查询索引是否被使用过:select * from V$OBJECT_USAGE where INDEX_NAME='索引名'
--V$OBJECT_USAGE只能当前用户自己的索引信息,看不到其他用户的索引信息
INSERT产生最少的Undo,Update产生的Undo居中,而Delete操作产生的Undo最多
对于INSERT操作,回滚段只需要记录插入记录的rowid,如果回退,只需将该记录根据rowid删除即可;
对于UPDATE操作,回滚段只需要记录被更新字段的旧值即可(前镜像),回退时通过旧值覆盖新值即可完成回退;
对于DELETE操作,Oracle则必须记录整行的数据,在回退时,Oracle通过一个反向操作恢复删除的数据。
DML语句对索引的影响
若表存在索引,对表执行DML操作,即insert、delete与update命令时,为了使索引即时反应表中数据的状态,也会对索引进行相应修改。下面分别说明这三种语句对索引的影响。
INSERT:对于表来说,insert操作比较简单,记录添加到的具体位置没有什么限制,只要添加到有空闲空间的数据块就可以了。对于索引来说,为了保持索引列值的顺序,索引列值添加至的具体位置是确定的,而不是添加到有空闲空间的数据块(这就是所谓的数据离散,索引连续,当然这个连续是指逻辑连续而不是物理连续)。若新的索引列值添加至的叶结点数据块已经没有空闲空间,则会导致数据块分裂,即把此数据块内的数据均分为二,一份留到原数据块,一份移至另外一个空数据块中,同时把数据块中指向前后数据块的指针做相应修改。
DELETE:对表的记录执行delete操作时,只是将其标记为删除,其所占用数据块中的空间并未释放,当有新行添加入此数据块时,这些标记为删除的空间才会释放,从而这些空间可以被重用。与此相似,被删除的记录在索引中对应的列值也会在数据块中标记为删除,当有新的索引列值加入此数据块时,这些标记为删除的索引行所占用的空间才会释放。
UPDATE:对索引列值执行update操作,相当于在索引中对update操作之前的原值先执行delete操作,然后再把update之后的新值添加(insert)至索引。
索引高度
假如一个字段长为50字节,总计1000万行
需要多少个block的叶子节点
叶子节点的一个条目=字段键值+rowid=50+6=56B
一个block容量=8KB
block=1000万*56/8K=7万
需要多少block二级分支节点
分支节点的一个条目=字段键值+rowid=50+6=56B
一个block容量=8KB
block=7万*56/8K=490
需要多少block一级分支节点
分支节点的一个条目=字段键值+rowid=50+6=56B
一个block容量=8KB
block=490*56/8K=3.43
需要多少根节点
根节点的一个条目=字段键值+rowid=50+6=56B
一个block容量=8KB
block=3.43*56/8K=0.0.2
得出结论索引高度为3,索引段大小=(1+4+490+7万)*8KB=563M
如果字段长度为10,则索引段大小=(4/5+490/5+7万/5)*8KB=112M,索引高度为2,因为4/5小于1,所以一级分支节点就不要再分了,就是根节点了
一个索引条目最小为7B(字段1B大小,rowid 6B大小),一个索引块最多可以存放8K/7=1142个索引条目,根节点最多指向1142个分支节点,分支节点最多指向1142个叶子节点
索引高度为0,索引段最大8KB
索引高度为1,索引段最大(1+1142)8KB=8.92M
索引高度为2,索引段最大(1+1142+1142 1142)8KB=10G
索引高度为3,索引段最大(1+1142+1142 1142+114211421142)*8KB=11T
折中一下,平时一个字段20B,索引条目26B,一个索引块最多可以存放307个索引条目,根节点最多指向307个分支节点,分支节点最多指向307个叶子节点
索引高度为0,索引段最大8KB
索引高度为1,索引段最大(1+307)8KB=2.4M
索引高度为2,索引段最大(1+307+307 307)8KB=739M
索引高度为3,索引段最大(1+307+307 307+307307307)*8KB=221G
为什么大家常说Mysql表最多2千万行?
其实和索引高度有关,因为Mysql是索引组织表,所以一定有主键,如果没有主键默认rowid就是主键,那么Mysql索引组织表那这索引树最大的行数总量等于根节点行数分支节点行数 叶子节点行数
主键假设8Byte,那么根节点里的一条数据是12Byte左右(4B页号+8B主键)。整个数据页16k,除去页头页尾页目录的1k,剩下的15k除以12Byte就是1280,也就是可以指向1280个分支节点,每个分支节点和跟节点一样,这样分支节点也可以指向1280个叶子节点
叶子节点除去页头页尾页目录的1k也剩下15KB可用,叶子节点里放的是真正的行数据。假设一条行数据1KB,所以叶子节点里能放15行数据。
这样根节点行数分支节点行数 叶子节点行数=12801280 15=2.5kw,就是我们常说的单表建议最大行数2kw的由来。三层数据页对应最多三次磁盘IO,比较合理,如果再加一层分支节点,数据就更大了,当然上面假设单行数据用了1kb,所以一个数据页能放个15行数据。如果我单行数据只有100Byte。那么单个数据页能放150行数据。那么单表支持的行数就是12801280150=2.5亿行了。所以说Mysql表最多2千万行是个伪命题,作为DBA关注表时需要关注表中每行数据多大,关注索引是就需要关注索引字段多大。
大页内存
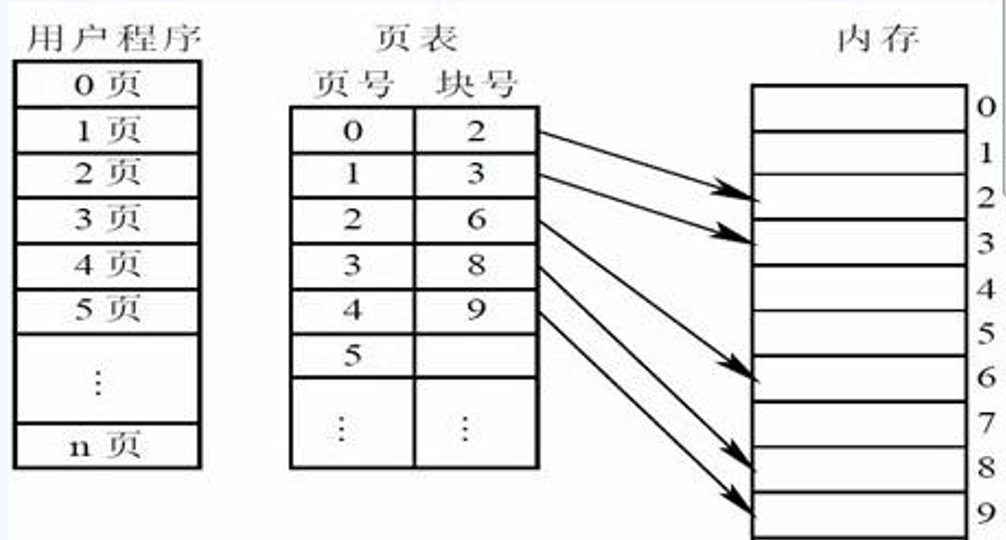
分页存储管理,是将一个进程的逻辑地址空间分成若干个大小相等的片,称为页,并为各页加以编号,从0开始,如第0页、第1页等,这些页又是页表的页号
页表大小=页号个数×页表项大小
页表项大小,32位系统就是4B,64位系统就是8B
页若太小,一方面虽然可使内存碎片减小,从而减少了内存碎片的总空间,有利于提高内存利用率,但另一方面也会使每个进程占用较多的页,从而导致进程的页表过长,占用大量内存;此外,还会降低页换进换出的效率。然而,如果选择的页较大,虽然可以减少页表的长度,提高页换进换出的速度,但却又会使页内碎片增大。
可能需要配置大页内存的场景
1.CPU100%,但是TOP命令显示user%不高,只是sys%非常高
2./proc/meminfo显示PageTables页表非常大好几个G
AWR
AWR收集、处理、维护性能统计数据,用于问题检测和性能调优。这些数据都在内存中,并存储在数据库中。
把AWR信息写入数据库的后台进程是Manageability Monitor Processes (MMON and MMNL)。
AWR在数据库里就是由一个个snapshot组成,AWR某段期间的报告就是这段时间内对应的snapshot的的统计信息生成的报表数据,超过保留期限的snapshot会自动删除。
Snapshot快照是特定时间段的历史数据集。
AWR快照的保留时间、收集间隔,默认保存8天,每隔1小时自动收集一次;
select * from DBA_HIST_WR_CONTROL;
通过包DBMS_WORKLOAD_REPOSITORY来修改设置,修改为保留14天,每15分钟收集一次
sql
begin
 DBMS_WORKLOAD_REPOSITORY.MODIFY_SNAPSHOT_SETTINGS(retention=>14*24*60,interval=>15);
end;
select * from DBA_HIST_WR_CONTROL;
AWR每自动收集一次产生一个snapshot,如果1小时收集一次,则1小时生成1个snapshot,如果15分钟收集一次,则1小时产生4个snapshot,快照也可以手工生成,调用
sql
dbms_workload_repository.create_snapshot
select * from dba_hist_snapshot order by 1 desc;
begin
 dbms_workload_repository.create_snapshot;
end;
select * from dba_hist_snapshot order by 1 desc;
BASELINE:
基线中包含的快照被排除在自动AWR清除过程中。
基线就是不会被AWR自动清理的就算过期也要保留的snapshot
基线作用:因为保留下来了,以后出现问题,可以使用这些基线的snapshot作为基准生成awr报告,比对出现问题期间的awr报告。
基线中的snapshot具体保留多长时间,见DBMS_WORKLOAD_REPOSITORY.CREATE_BASELINE的expiration参数,默认是永久保
查询基线
select * from dba_hist_baseline;
创建基线
sql
begin
 DBMS_WORKLOAD_REPOSITORY.CREATE_BASELINE(start_snap_id=>7550,end_snap_id=>7660,baseline_name=>'am_baseline');
end;
注意点:
AWR报告不能跨重启前后的snapshot
ORA-20200: The instance was shutdown between snapshots XX and YY
Oracle自带脚本生成AWR报告的方法
SQL>@$ORACLE_HOME/rdbms/admin/awrrpt.sql
SQL语句生成AWR报告的方法
select * from dba_hist_snapshot order by 1 desc
select * from table(dbms_workload_repository.awr_report_html(DBID, INSTANCE_NUMBER, startsnapid,endsnapid))
ADDM
Automatic Database Diagnostic Monitor
每次生成AWR的snapshot时,都会执行ADDM分析,并将结果保存在数据库中。
意思是:每个snapshot一生成,addm相关后台进程就自动启动,自动和上一个snapshot分析,生成一份addm报告
要手动产生两个历史不相邻的snap_shot期间的一个ADDM,则使用@?/rdbms/admin/addmrpt.sql
查看自动生成的ADDM信息(需要sys用户)
select task_id,task_name,description from dba_advisor_tasks order by 1 desc
select dbms_advisor.get_task_report('dba_advisor_tasks.task_name') from dual
sql_trace和10046跟踪记录一个或者多个sql语句在执行时的运行状态
sql_trace的使用方法
SQL> ALTER SESSION SET sql_trace=true;
SQL> SQL语句;
SQL> alter session set sql_trace=false;
SQL> select * from v$diag_info where NAME='Default Trace File';
备注:Sql_trace参数千万不要在system级设置,否则所有会话都会跟踪,将极大影响性能
10046的使用方法
SQL> ALTER SESSION SET EVENTS '10046 trace name context forever, level 12';
SQL> SQL语句;
SQL> ALTER SESSION SET EVENTS '10046 trace name context off';
SQL> select * from v$diag_info where NAME='Default Trace File';
tkprof命令可以格式化sql_trace或10046的trace文件,使之具有更好的可读性