凌晨三点,一个电商直播间还在开播:主播表情自然、口型同步、能实时回答弹幕里的尺码问题,连续 8 小时不休息、不喝水、不走神。镜头背后没有真人------驱动它的是一套数字人直播系统。
这正是 LingCast 灵播这类数字人直播方案要解决的问题:把"形象、声音、大脑、推流"组装成一条可 7×24 小时运转的直播流水线。它不是一个单点模型,而是一套由语音识别、大语言模型、语音合成、数字人驱动与直播推流组成的实时系统工程。
本文将从数字人直播的真实需求出发,拆解 LingCast 灵播所代表的技术架构:五层流水线如何协同、流式实时性如何保证、本地与云端部署如何选择、以及落地时最容易踩的坑。需要先说明:截至本文检索,公开渠道暂未检索到"LingCast灵播"的官方仓库与版本文档,因此本文聚焦数字人直播这一品类的通用技术架构(结合LiveTalking、metahuman-stream等主流开源方案的公开资料),不虚构具体项目数据。
一、 LingCast 灵播是什么:先厘清数字人直播的定位
数字人直播,是用 AI 生成的虚拟形象替代(或辅助)真人完成直播:形象负责"出镜",语音负责"说话",大模型负责"思考与应答",推流模块负责把合成画面送到抖音、淘宝、视频号等直播平台。
理解它,先区分两种本质不同的模式:
|---------|----------------------------|-----------|----------------|
| 模式 | 工作方式 | 互动能力 | 典型场景 |
| 播报式(单向) | 按预设话术/商品脚本循环播报,TTS 驱动口型 | 弱,不实时应答弹幕 | 商品轮播、夜间挂机、品牌宣传 |
| 交互式(双向) | 实时采集弹幕/语音,LLM 生成回复,数字人即时开口 | 强,可对话、可打断 | 带货答疑、客服、知识问答 |
LingCast 灵播这类方案的价值核心在交互式:它要做到"观众提问---数字人听懂---生成回答---开口说出"整条链路在秒级内闭环,这也是技术难度真正集中的地方。
二、五层技术架构:一条实时流水线
一套完整的数字人直播系统,可以拆成五层,数据像流水线一样从左到右流动。
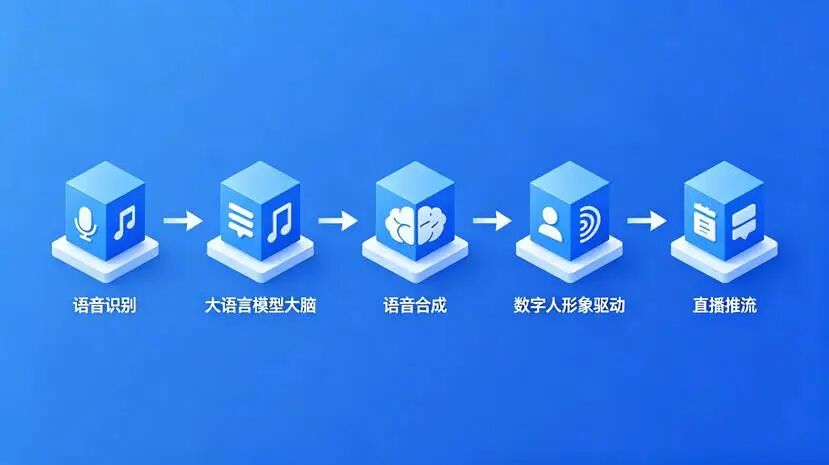
五层流水线:语音识别 → 大模型大脑 → 语音合成 → 数字人形象驱动 → 直播推流。
|----------|----------------|------------------------------------------|
| 层级 | 职责 | 主流技术选型(公开方案) |
| ① 输入/感知层 | 采集弹幕文本、观众语音 | 平台弹幕接口、ASR(Whisper / FunASR / 讯飞) |
| ② AI 大脑层 | 理解意图、结合知识库生成回复 | LLM(Qwen、GPT 等)+ RAG 商品知识库 |
| ③ 语音合成层 | 把回复文本转成带情感的语音 | TTS(EdgeTTS、GPT-SoVITS、CosyVoice,支持声音克隆) |
| ④ 形象驱动层 | 音频驱动口型、表情、动作 | Wav2Lip、MuseTalk、SadTalker、LivePortrait |
| ⑤ 推流输出层 | 合成视频流推送到直播平台 | WebRTC(低延迟交互)/ RTMP(直播推流)+ OBS |
这五层里,①②③决定"数字人聪不聪明、说得好不好听",④决定"像不像真人",⑤决定"能不能稳定开播"。任何一层成为瓶颈,观众的体感都会明显下降。
三、关键技术逐层拆解
3.1 感知层:弹幕采集与语音识别
带货直播的输入主要是弹幕文本(通过平台接口或采集工具获取),客服/连麦场景则需要 ASR 把观众语音转成文字。ASR 的关键指标是识别准确率与首字延迟,工程上通常用流式ASR(边说边出字)而非整句识别,为后续环节争取时间。
3.2 大脑层:LLM + 商品知识库
裸用通用大模型做直播带货,会出现"不知道自家商品参数""回答前后矛盾"的问题。工程做法是 RAG:把商品库、话术库、活动规则做成知识库,LLM 基于检索到的资料生成回答。同时用系统提示词约束人设(如"活泼可爱的主播""永远不透露自己是 AI")与回答边界(价格、售后以知识库为准)。
3.3 语音层:TTS 与声音克隆
TTS 决定数字人的"声音质感"。公开方案中,EdgeTTS 胜在开箱即用、成本低;GPT-SoVITS、CosyVoice 支持声音克隆,用少量真人录音即可复刻专属音色,更适合品牌化直播。情感韵律(停顿、重音、语气词)是这一层拉开差距的关键。
3.4 形象层:音频驱动的说话头生成
这是数字人"像不像"的核心。主流开源路线各有取舍:
|--------------|-----------------|----------------------------------|
| 驱动方案 | 原理特点 | 优势 / 局限 |
| Wav2Lip | 音频特征驱动唇部画面合成 | 轻量、帧率高(消费级显卡可达较高 fps),唇形稳定;表情较单一 |
| MuseTalk | 实时唇形同步,画质与自然度更好 | 效果均衡,社区活跃;算力要求略高 |
| SadTalker | 单张照片生成说话头部动画 | 形象定制门槛低;实时性偏弱,适合非强实时 |
| LivePortrait | 表情迁移与生动度强 | 表情自然,可作为唇形方案的补充 |
工程上还会叠加"视频编排":数字人不说话时播放预录的待机动作视频,避免长时间静止造成的诡异感;支持被打断(观众插话时立即切换应答)是交互式直播的重要体验点。
3.5 推流层:WebRTC 与 RTMP 的分工
WebRTC 主打毫秒级低延迟,适合实时对话与连麦;RTMP 是直播平台的标准推流协议,适合向抖音、淘宝等平台稳定推流。实际系统通常是"内部 WebRTC 预览 + 对外 RTMP 推流",或用 OBS 采集数字人画面后推到平台。
四、实时性:为什么 " 流式 " 是数字人直播的生命线
数字人直播最大的技术挑战不是"能不能做",而是"够不够快"。观众提问后,如果数字人要等 5 秒才开口,直播节奏就断了。实时性来自三个设计:
①全链路流式化。ASR 边听边出字、LLM 边生成边吐 token、TTS 按句切片合成、形象层拿到一段音频就立即驱动,而不是等上一环节全部完成。各环节以"句/片段"为单位流水线并行,总延迟被压缩到各环节延迟的叠加而非串行等待。
②模块解耦、可替换。成熟方案(如 LiveTalking、metahuman-stream)普遍采用模块化架构,ASR、LLM、TTS、Avatar 各层可独立替换:本地算力够就本地跑,追求效果就调云端 API。
③算力与帧率匹配。形象驱动是最吃 GPU 的环节,公开实测显示不同模型在不同显卡上帧率差异明显(如 Wav2Lip 在消费级显卡上可达到较高帧率,MuseTalk 对显卡要求更高)。选型必须按目标帧率与并发路数倒推硬件。
五、部署形态:本地部署与云端方案怎么选
|-------|-------------------------|---------------|
| 维度 | 本地/私有化部署 | 云端 API / SaaS |
| 硬件要求 | 需独立 GPU(形象驱动吃显存),内存要求较高 | 普通电脑即可,算力在云端 |
| 成本结构 | 一次性硬件投入,长期边际成本低 | 按调用量/时长/路数付费 |
| 数据安全 | 数据不出内网,适合敏感行业 | 依赖服务商合规能力 |
| 定制自由度 | 形象、声音、模型全可替换 | 受平台能力边界约束 |
| 运维门槛 | 需懂环境、驱动、模型部署 | 开箱即用,运维由服务商承担 |
选型建议:追求长期 7×24 开播、多路并发、形象声音强定制的团队,倾向本地或混合部署;快速验证、轻量运营、没有算法团队的商家,优先云端方案降低起步门槛。
六、应用场景
|-------|--------------------|-----------------|
| 场景 | 用法 | 核心价值 |
| 电商带货 | 商品轮播讲解、弹幕答疑、夜间无人直播 | 延长开播时长、降低主播人力 |
| 智能客服 | 数字人坐席实时解答咨询 | 形象化交互,比纯文字更有亲和力 |
| 在线教育 | 虚拟讲师授课、答疑 | 课程内容标准化、可复用 |
| 政务/展厅 | 虚拟讲解员、导览 | 多语言、全天候、形象稳定 |
| 品牌 IP | 专属虚拟主播做内容矩阵 | IP 形象统一,跨平台分发 |
七、挑战与合规边界
①真实感与恐怖谷。唇形对得上但表情僵硬、长时间静止、眼神不自然,都会让观众出戏,需要表情驱动、待机动作与微表情补偿。
②长时长稳定性。连续开播数小时,可能出现口型漂移、音画不同步、显存泄漏,需要断流重连、资源监控与自动重启机制。
③回答可控性。LLM 可能"自由发挥"导致价格说错、承诺过度,必须用知识库约束、敏感词过滤与回答边界兜底。
④合规要求。数字人直播受平台规则与监管约束,多数平台要求对 AI 生成内容进行标识,部分场景限制纯无人直播,声音与形象克隆需获得本人授权。上线前务必核对目标平台最新规则,避免违规封号。
八、总结
LingCast 灵播所代表的数字人直播,本质是一条"感知---思考---表达---出镜---推流"的实时 AI 流水线:ASR 与弹幕负责听懂,LLM 加知识库负责想对,TTS 与声音克隆负责说好听,Wav2Lip/MuseTalk 等驱动模型负责看起来像真人,WebRTC/RTMP 负责稳定开播。真正的工程门槛不在单点模型,而在全链路流式协同、长时长稳定与合规可控。
对于商家,它是延长开播时长、摊薄人力成本的工具;对于开发者,它是一个由多个可替换模块组成的系统集成练兵场;对于行业,它正在把"直播间"从人力密集型变成算力与内容驱动型。但它不是万能的:真人的即兴感染力、信任背书与突发应对仍不可替代,数字人更适合标准化、高频、长时长的环节,人机协同才是当前最稳妥的落地姿势。